专业综合实践2-TuGraph平台医疗知识图谱及问答系统
·
目录
三、在TuGraph中使用cypher语句+Python交互
一、TuGraph-安装、启动
(1)安装wsl
(注:以下步骤仅适用于通过docker安装tugraph的windows用户)
上篇文章已经安装了docker
win+R,powershell打开终端,
先安装wsl
wsl --install安装完成后一般要重启计算机
随后将wsl2设为默认版本
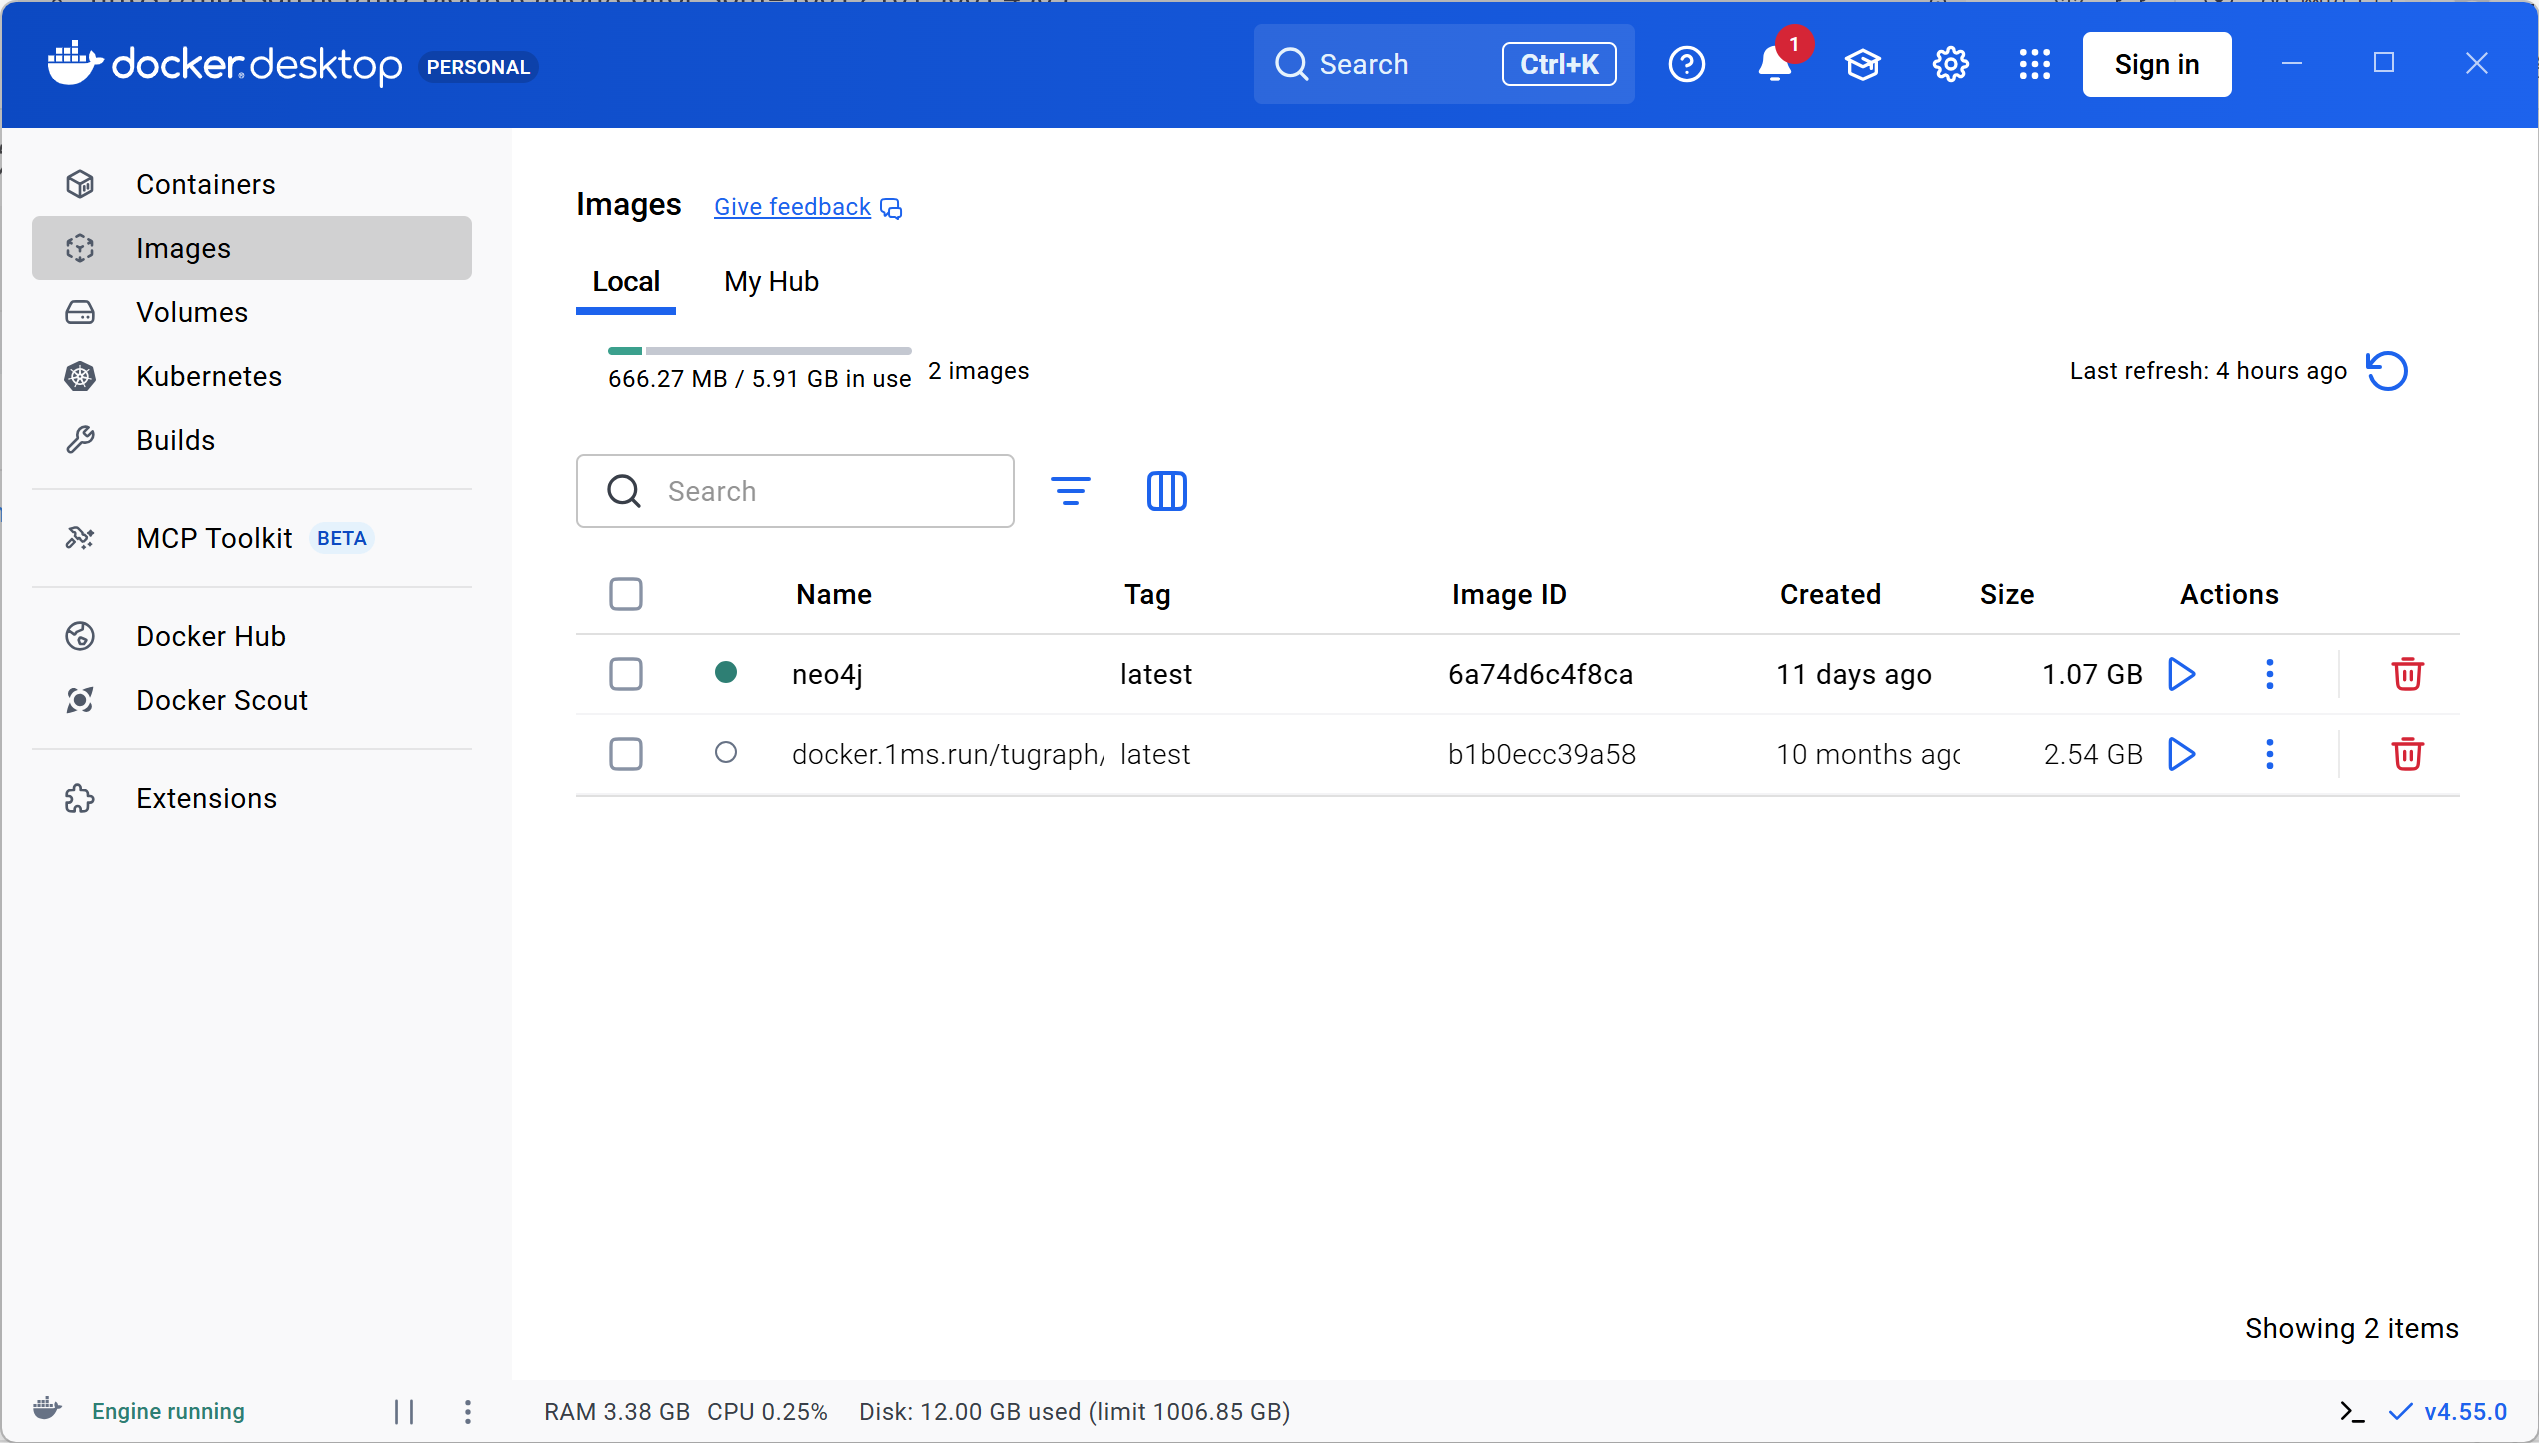
wsl --set-default-version 2(2)镜像拉取tugraph
docker pull tugraph/tugraph-runtime-centos7:latestdocker出现tugraph证明成功
(3)报错
如果发现无法进入,可能是端口未正确印射,删除原容器,创建新容器,印射7070和7687端口
# 停止容器
docker stop tugraph-server

# 删除容器
docker rm tugraph-server

#创建容器
docker run -d --name tugraph-server -p 7070:7070 -p 7687:7687 -v D:/tugraph_data:/var/lib/lgraph/data tugraph/tugraph-runtime-centos7:latest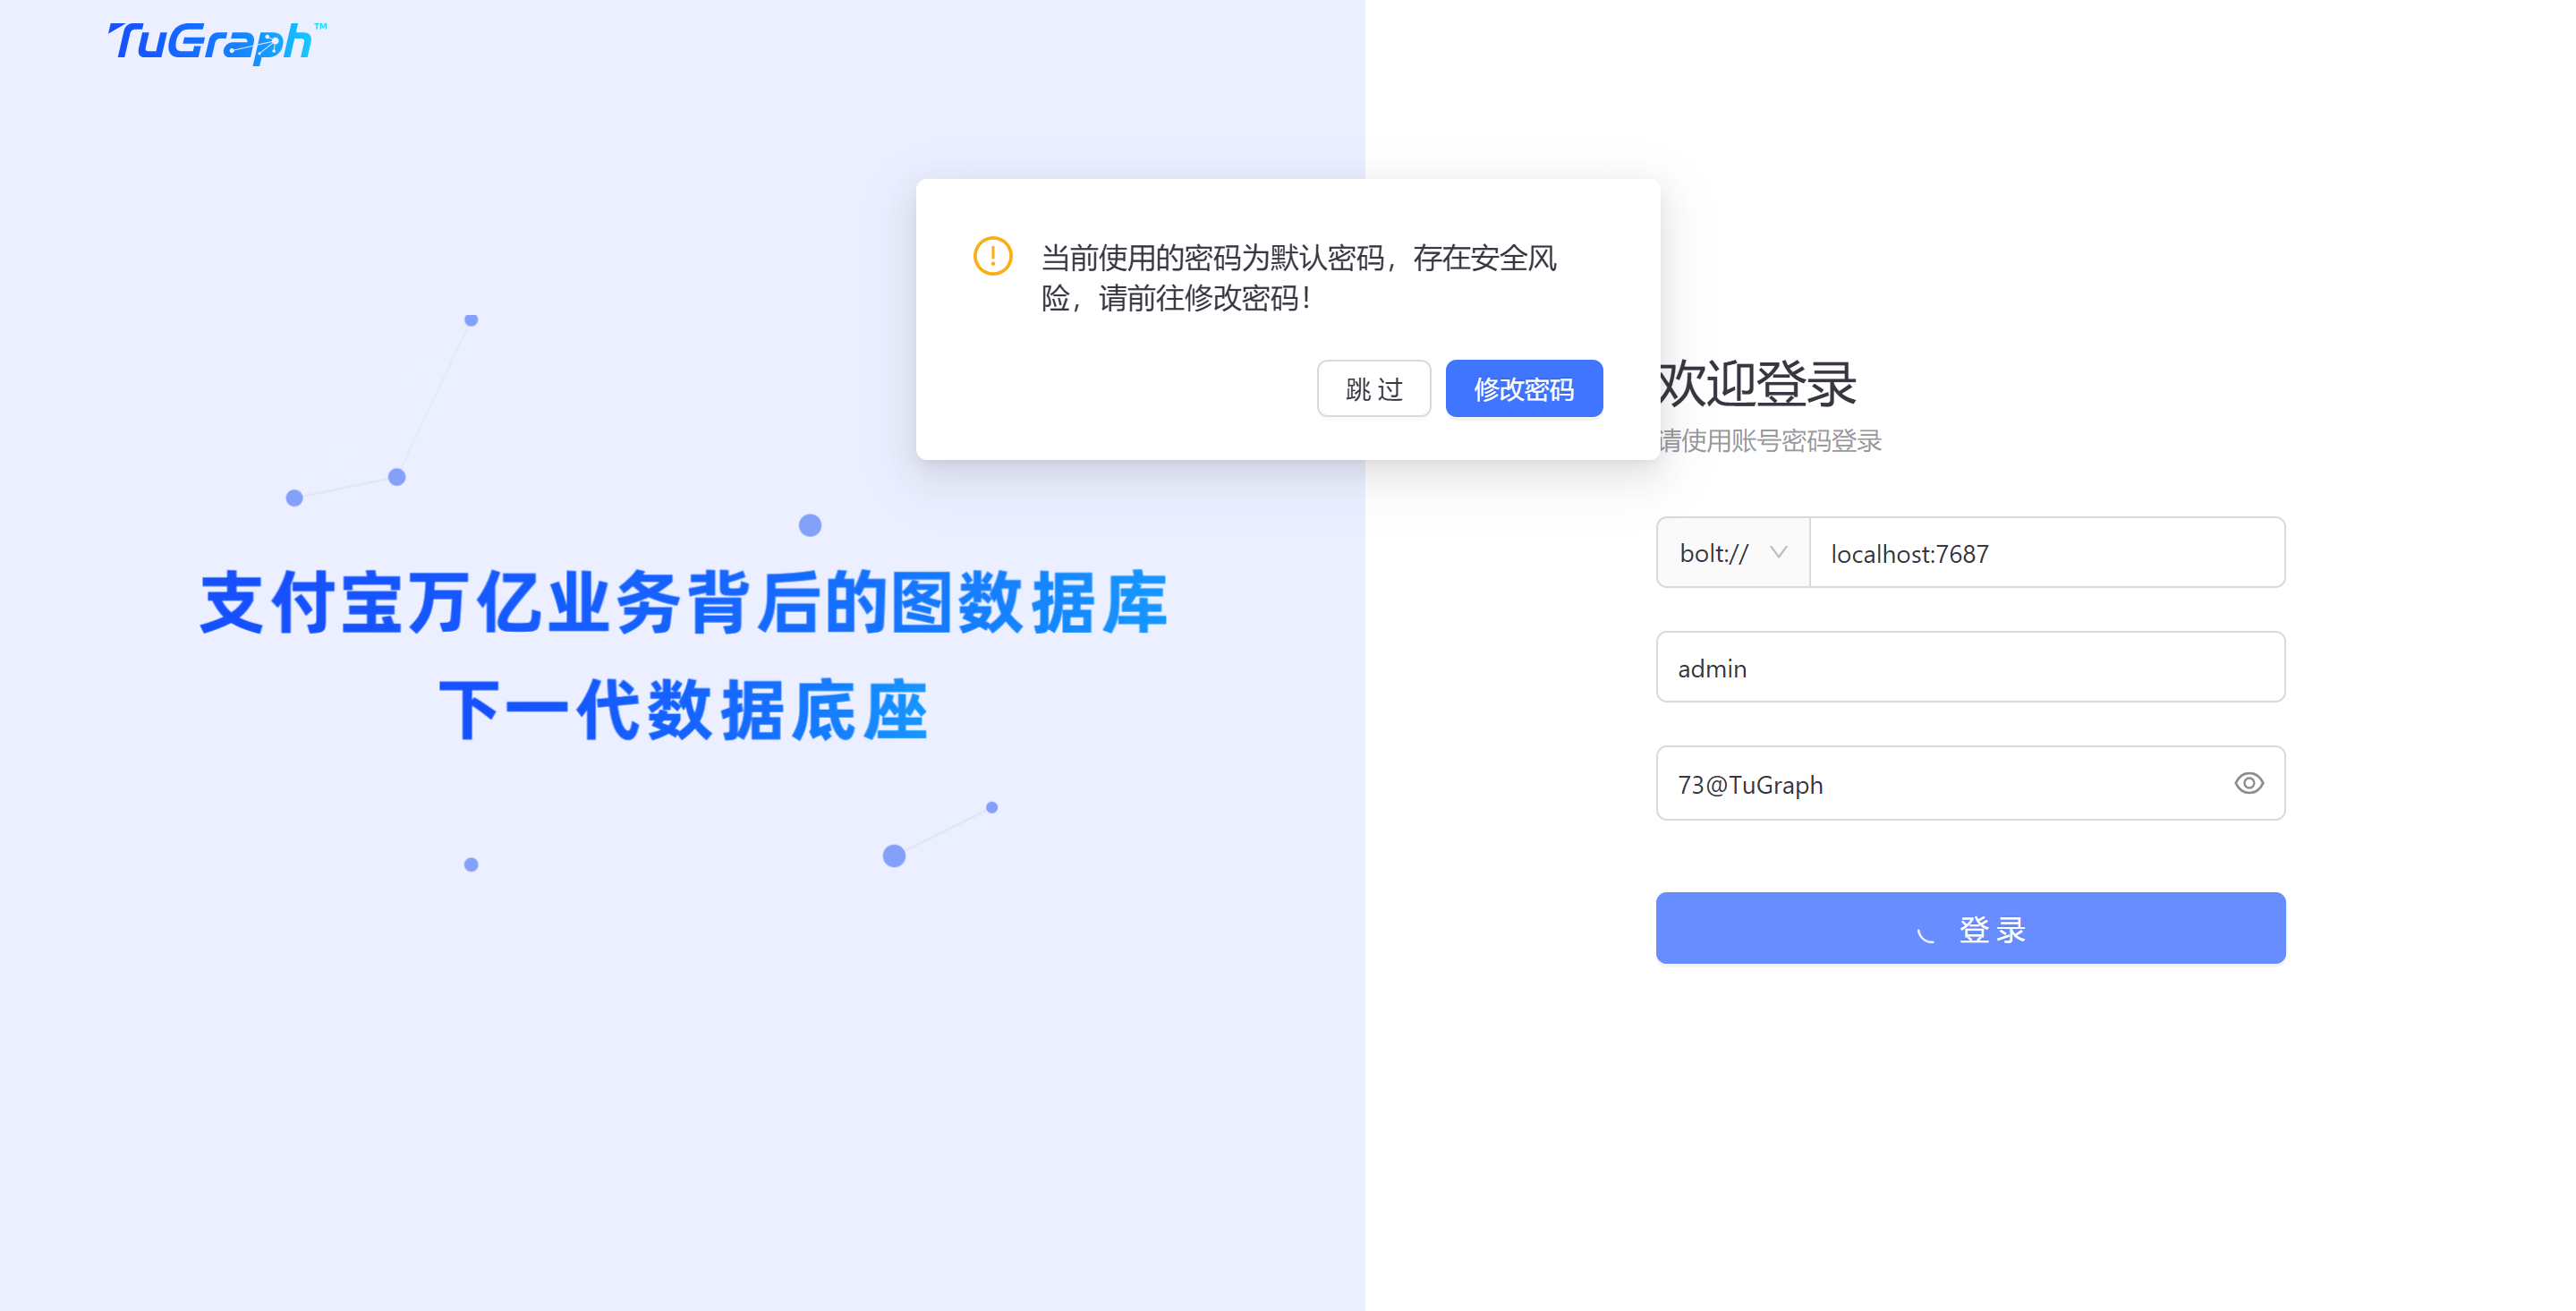
二、数据导入和图谱构建
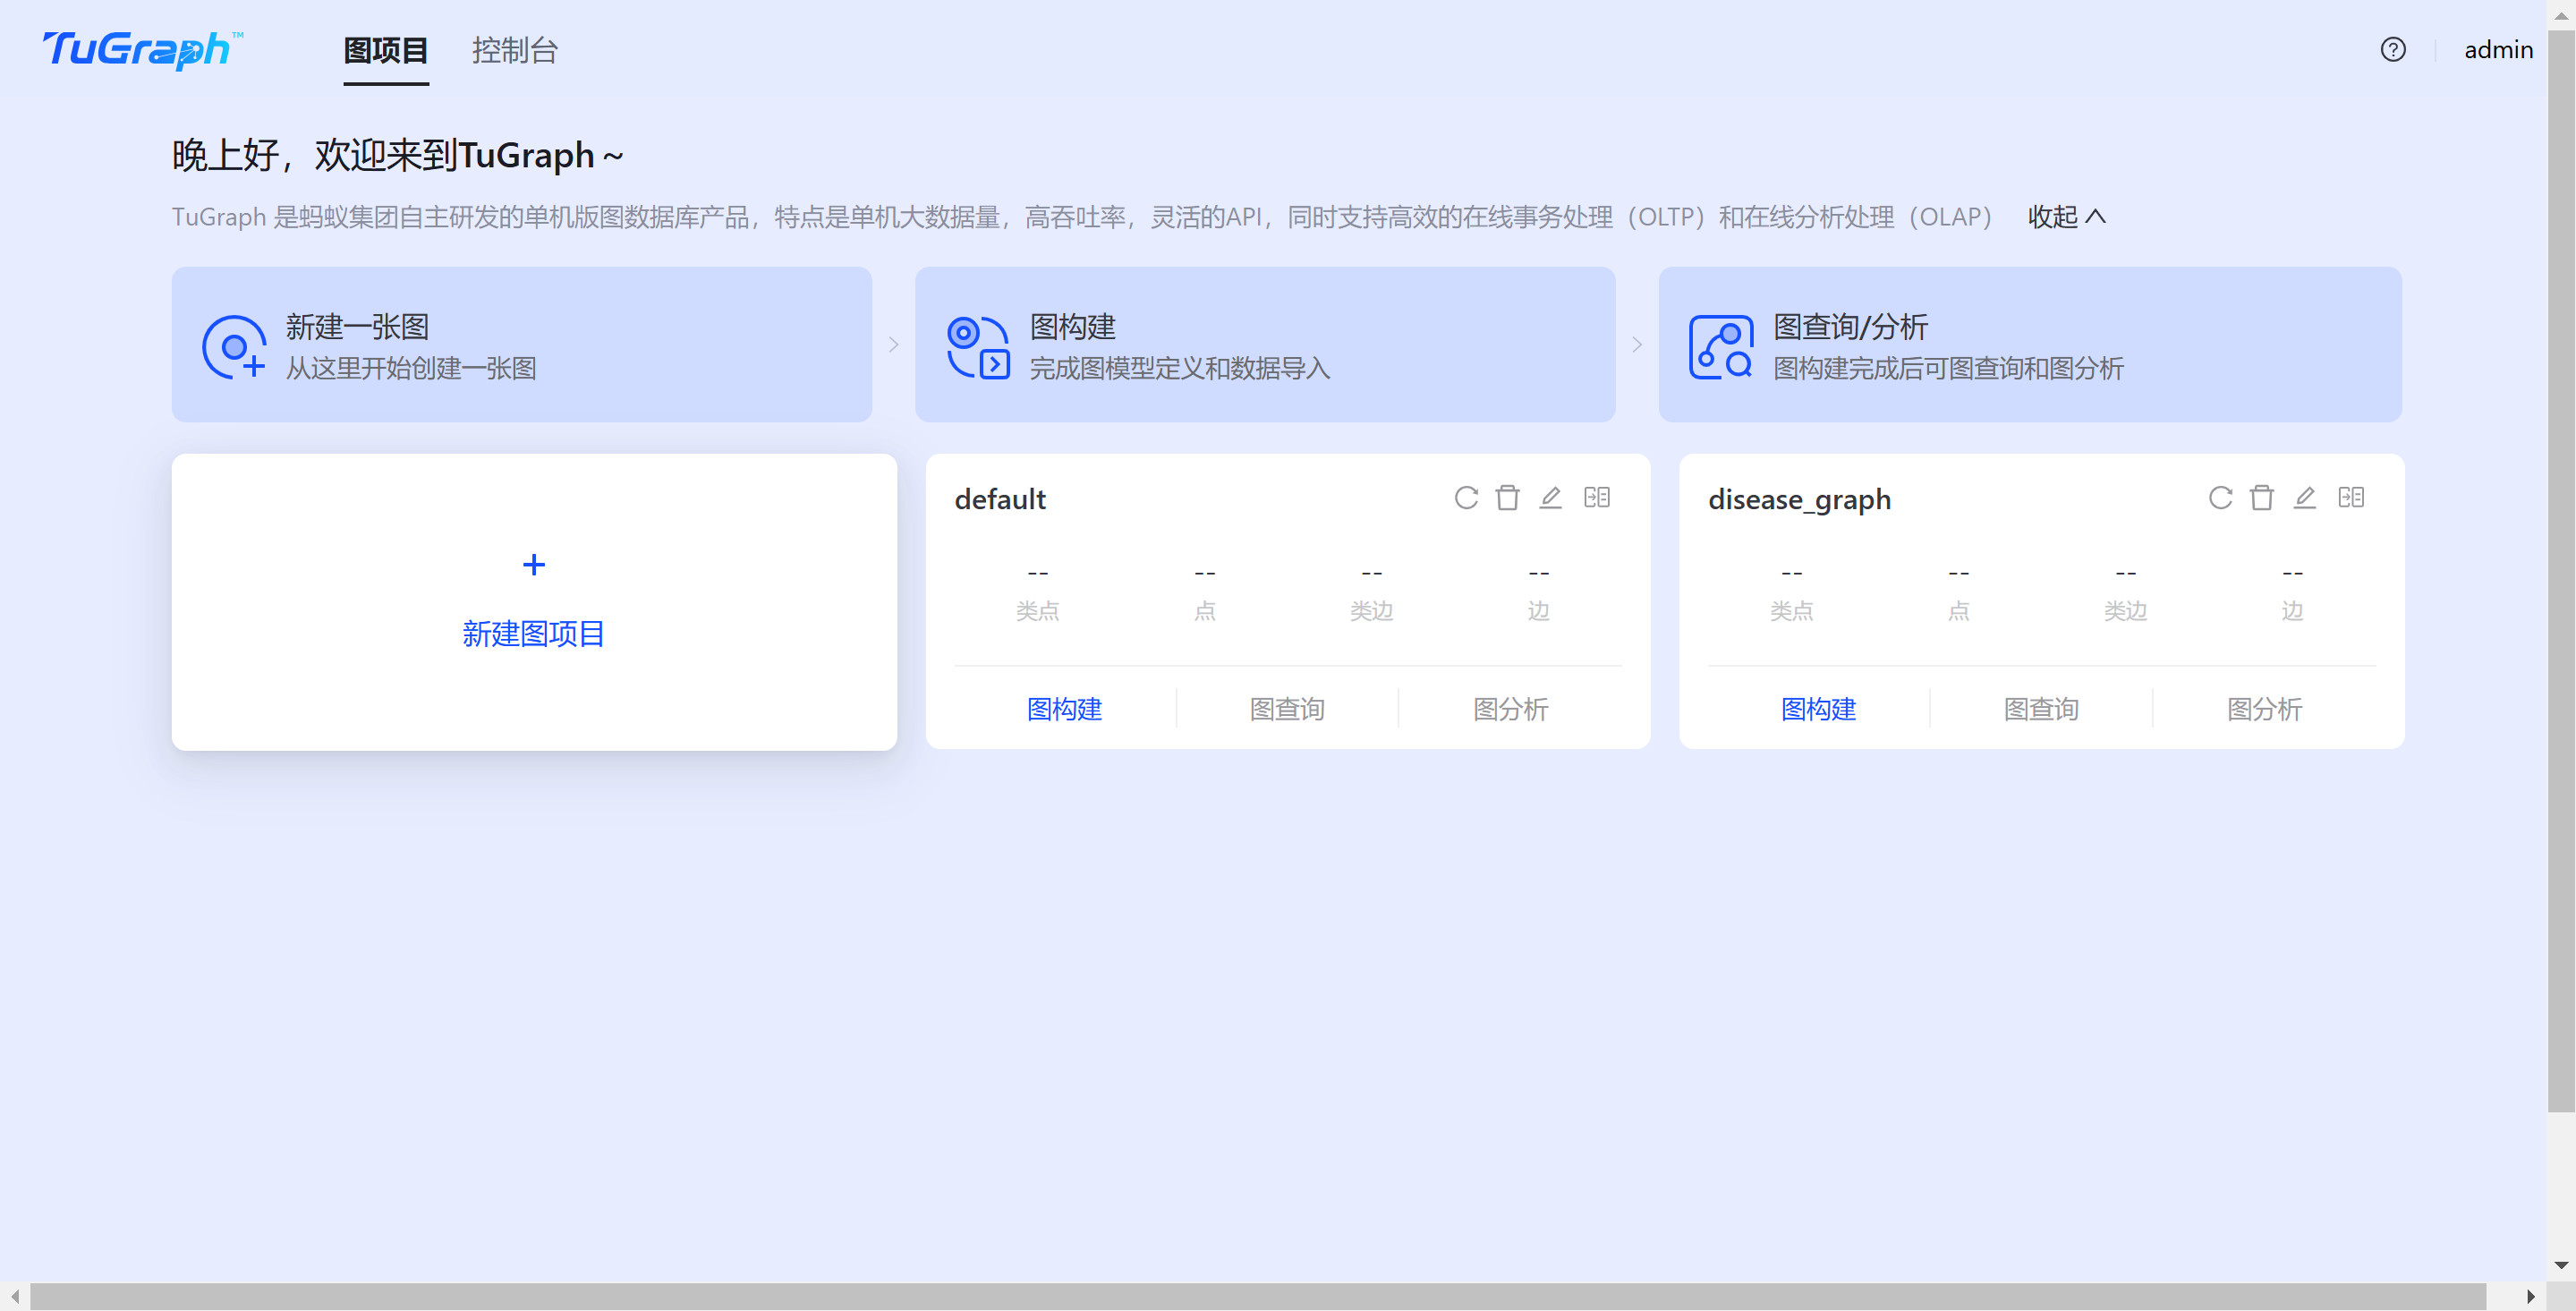
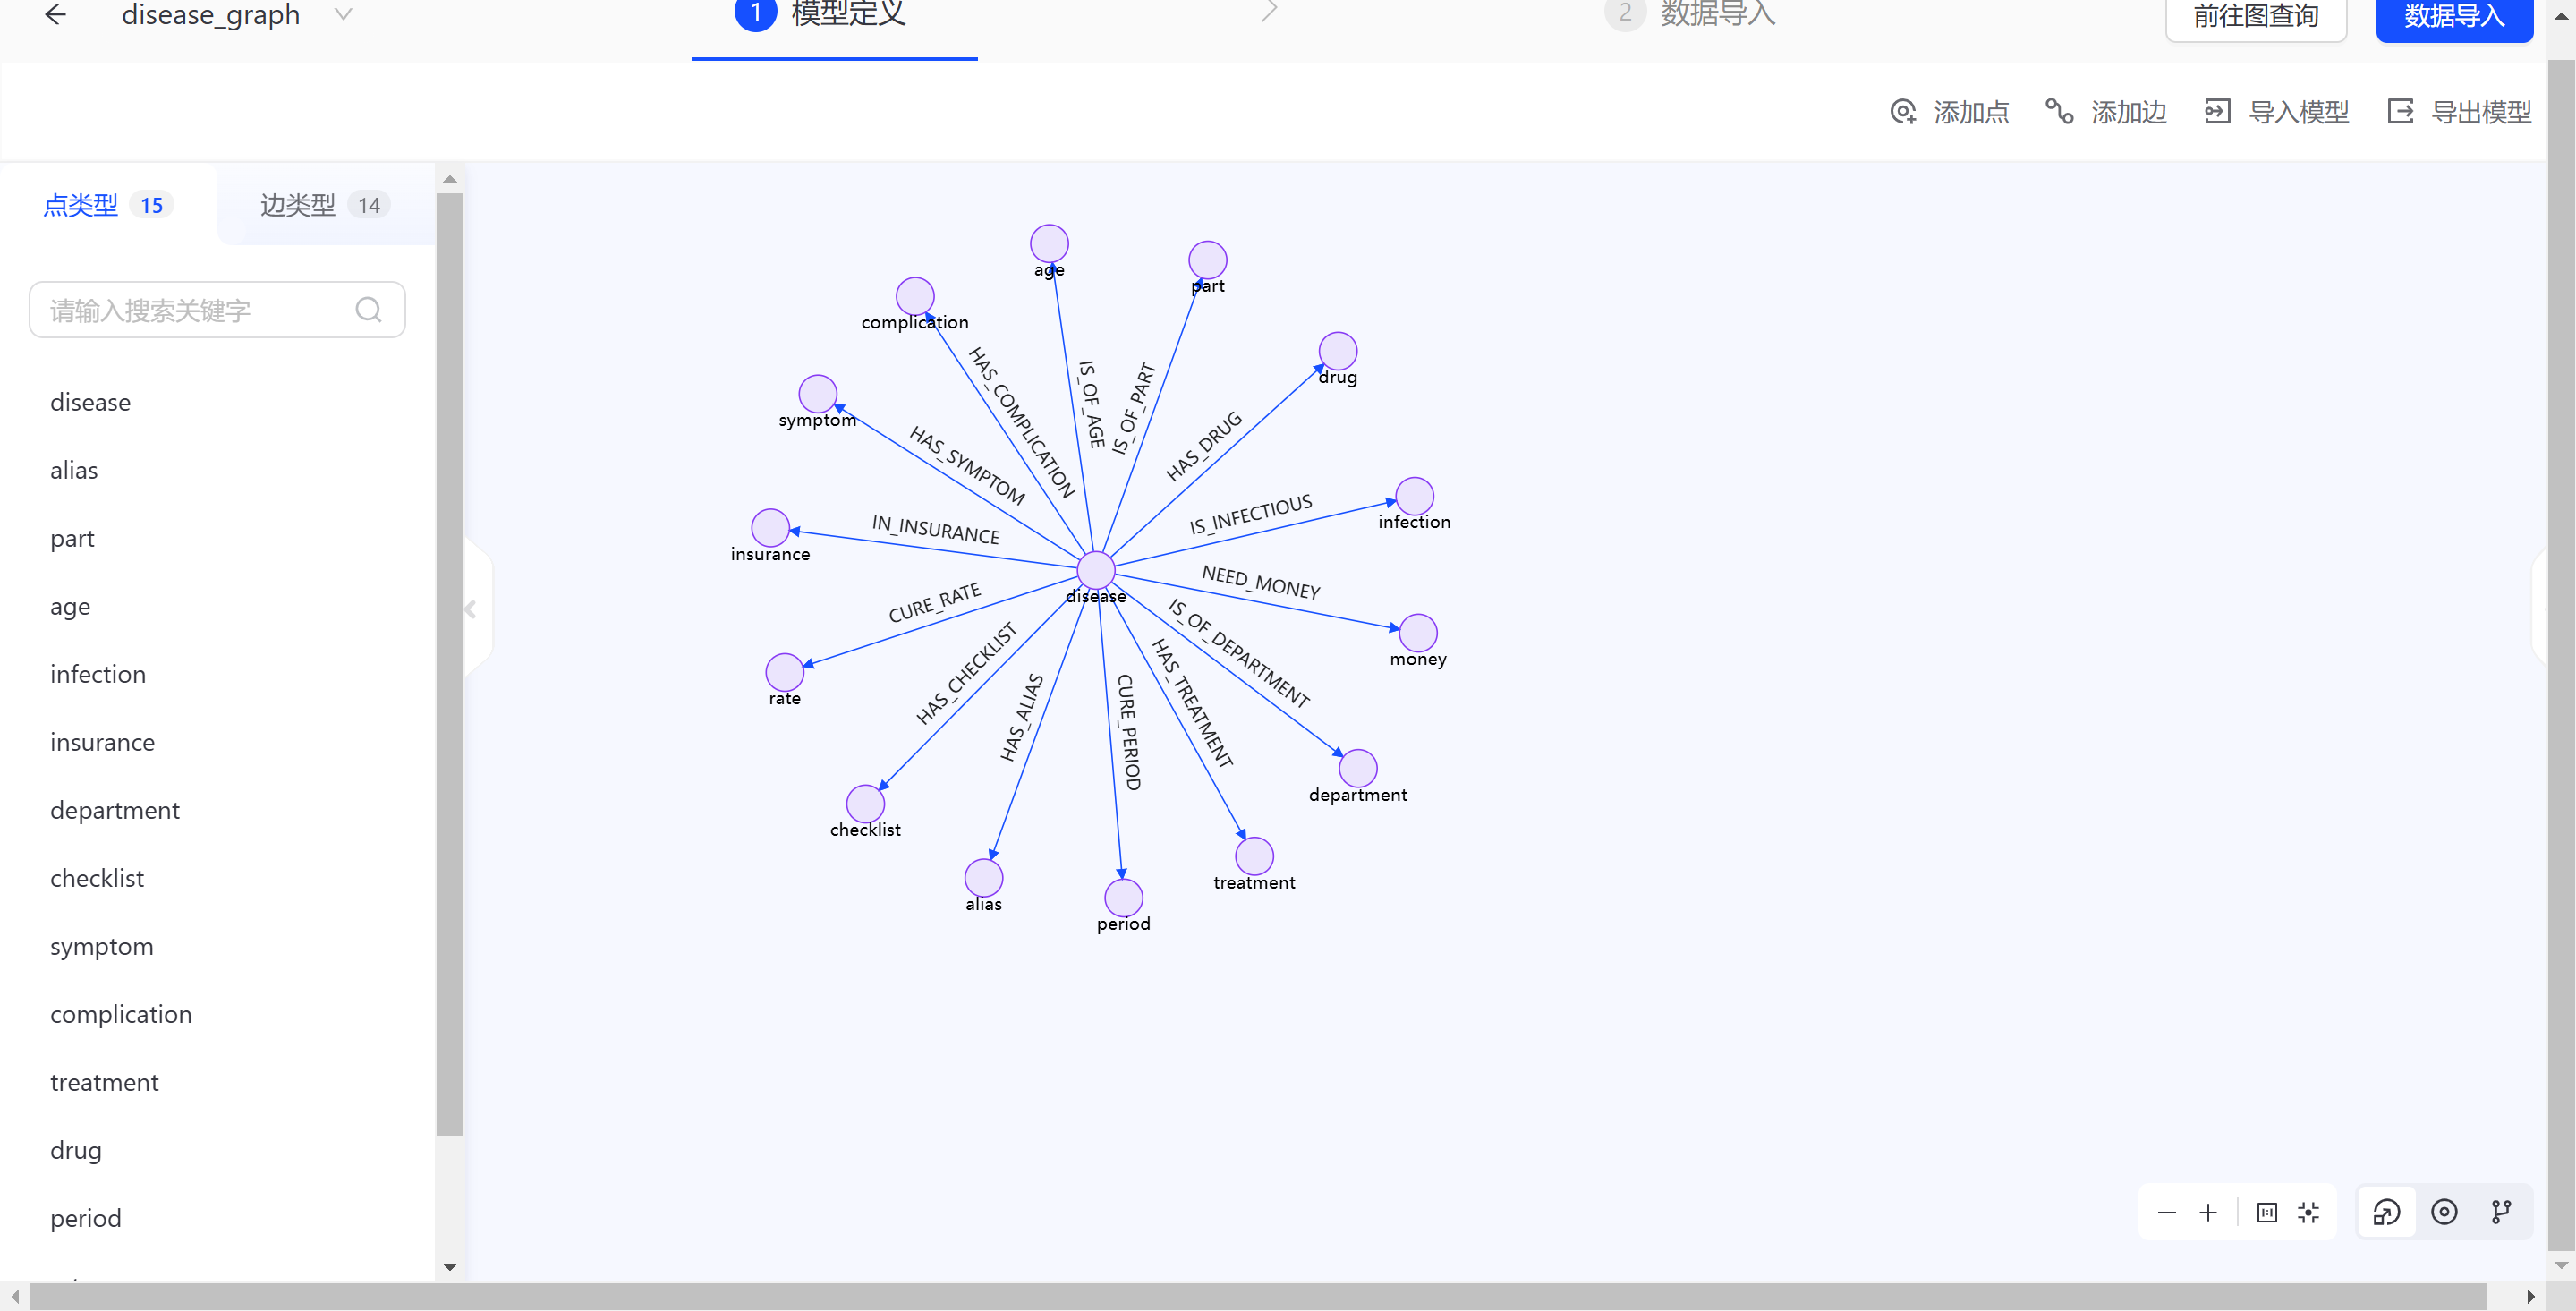
(1)创建图表、点、边
“新建图项目”-创建图命名为disease_graph
(2)数据预处理、导入
将disease3.csv分解为点标签文件和边标签文件
import pandas as pd
import os


def preprocess_disease_data():
    """预处理疾病数据,生成节点和边文件"""
    # 原始数据路径 - 修改为您的实际路径
    data_path = r'文件位置\disease3.csv'

    # 输出目录路径 - 同样在桌面文件夹
    output_path = r'文件输出位置\output'

    # 读取原始数据
    try:
        df = pd.read_csv(data_path, encoding='utf-8')
        print(f"成功读取数据,共 {len(df)} 条记录")
    except Exception as e:
        print(f"读取数据失败: {e}")
        return

    # 定义节点和边标签列表
    node_name_list = ["Alias", "Part", "Age", "Infection", "Insurance", "Department",
                      "Checklist", "Symptom", "Complication", "Treatment", "Drug",
                      "Period", "Rate", "Money"]
    edge_name_list = ["HAS_ALIAS", "IS_OF_PART", "IS_OF_AGE", "IS_INFECTIOUS",
                      "In_Insurance", "IS_OF_Department", "HAS_Checklist", "HAS_SYMPTOM",
                      "HAS_Complication", "HAS_Treatment", "HAS_Drug", "Cure_Period",
                      "Cure_Rate", "NEED_Money"]

    # 创建输出目录
    if not os.path.exists(output_path):
        os.makedirs(output_path)

    # 初始化输出文件
    node_filenames = []
    for k in range(0, 14):
        node_filenames.append(os.path.join(output_path, node_name_list[k] + ".csv"))

    edge_filenames = []
    for k in range(0, 14):
        edge_filenames.append(os.path.join(output_path, edge_name_list[k] + ".csv"))

    disease_file = os.path.join(output_path, "Disease.csv")

    # 清空现有文件
    for filename in node_filenames + edge_filenames + [disease_file]:
        if os.path.exists(filename):
            os.remove(filename)

    # 遍历所有疾病数据
    total_diseases = len(df)
    print(f"开始处理 {total_diseases} 条疾病数据...")

    disease_count = 0
    for i in range(total_diseases):
        disease_name = str(df.iloc[i, 0]).strip()
        if not disease_name or disease_name == 'nan':
            continue

        disease_count += 1

        # 写入疾病节点
        with open(disease_file, mode="a", encoding="utf-8") as log:
            print(disease_name, file=log)

        # 遍历14个属性字段
        for k in range(1, 15):
            cell_value = str(df.iloc[i, k])
            if cell_value.strip() == "" or cell_value == "nan":
                continue

            # 分割多个值
            values = cell_value.split()
            for value in values:
                node_value = value.strip()
                if not node_value:
                    continue

                # 写入属性节点(去重)
                node_file = node_filenames[k - 1]
                existing_nodes = set()
                if os.path.exists(node_file):
                    with open(node_file, 'r', encoding='utf-8') as f:
                        existing_nodes = set(line.strip() for line in f)

                if node_value not in existing_nodes:
                    with open(node_file, mode="a", encoding="utf-8") as log1:
                        print(node_value, file=log1)

                # 写入边关系
                with open(edge_filenames[k - 1], mode="a", encoding="utf-8") as log2:
                    print(f"{disease_name},{node_value}", file=log2)

    print(f"\n数据预处理完成!")
    print(f"处理疾病数量: {disease_count}")
    print(f"输出目录: {output_path}")

    # 统计生成的文件
    total_files = 0
    print("\n生成文件统计:")
    print(f"Disease.csv: 存在 - {os.path.exists(disease_file)}")

    for i in range(14):
        node_file = node_filenames[i]
        edge_file = edge_filenames[i]
        node_exists = os.path.exists(node_file)
        edge_exists = os.path.exists(edge_file)

        if node_exists:
            with open(node_file, 'r', encoding='utf-8') as f:
                node_count = len(f.readlines())
        else:
            node_count = 0

        if edge_exists:
            with open(edge_file, 'r', encoding='utf-8') as f:
                edge_count = len(f.readlines())
        else:
            edge_count = 0

        print(f"{node_name_list[i]}.csv: {node_count} 个节点, {edge_name_list[i]}.csv: {edge_count} 条边")
        if node_exists or edge_exists:
            total_files += 2

    print(f"\n总计生成文件: {total_files} 个")


if __name__ == "__main__":
    preprocess_disease_data()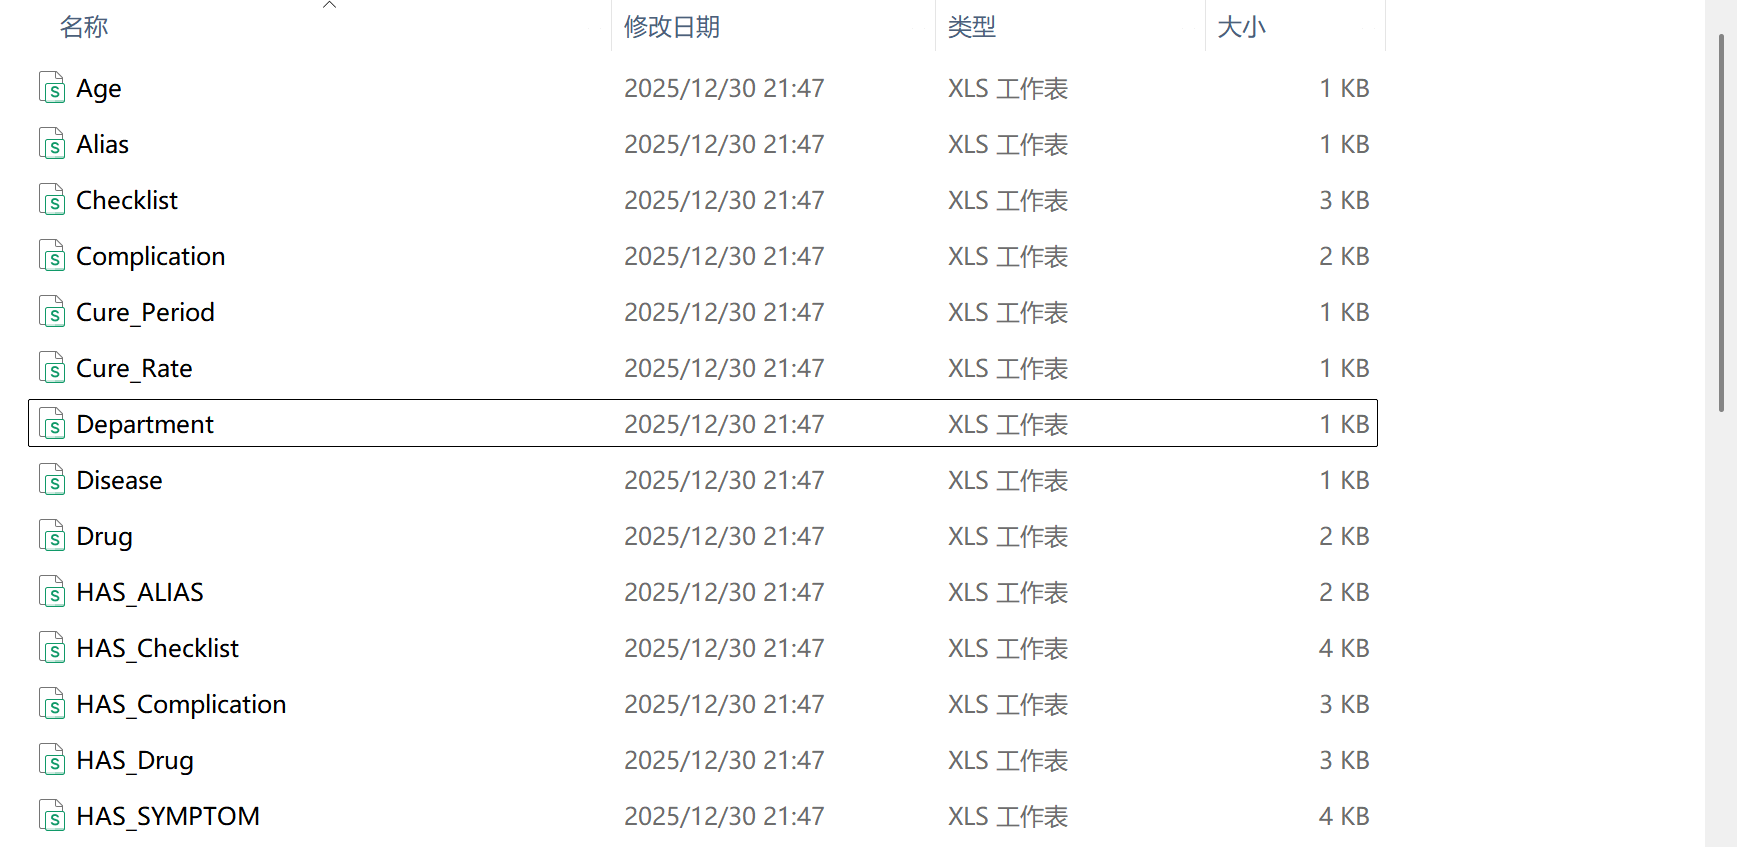
将csv文件挨个导入
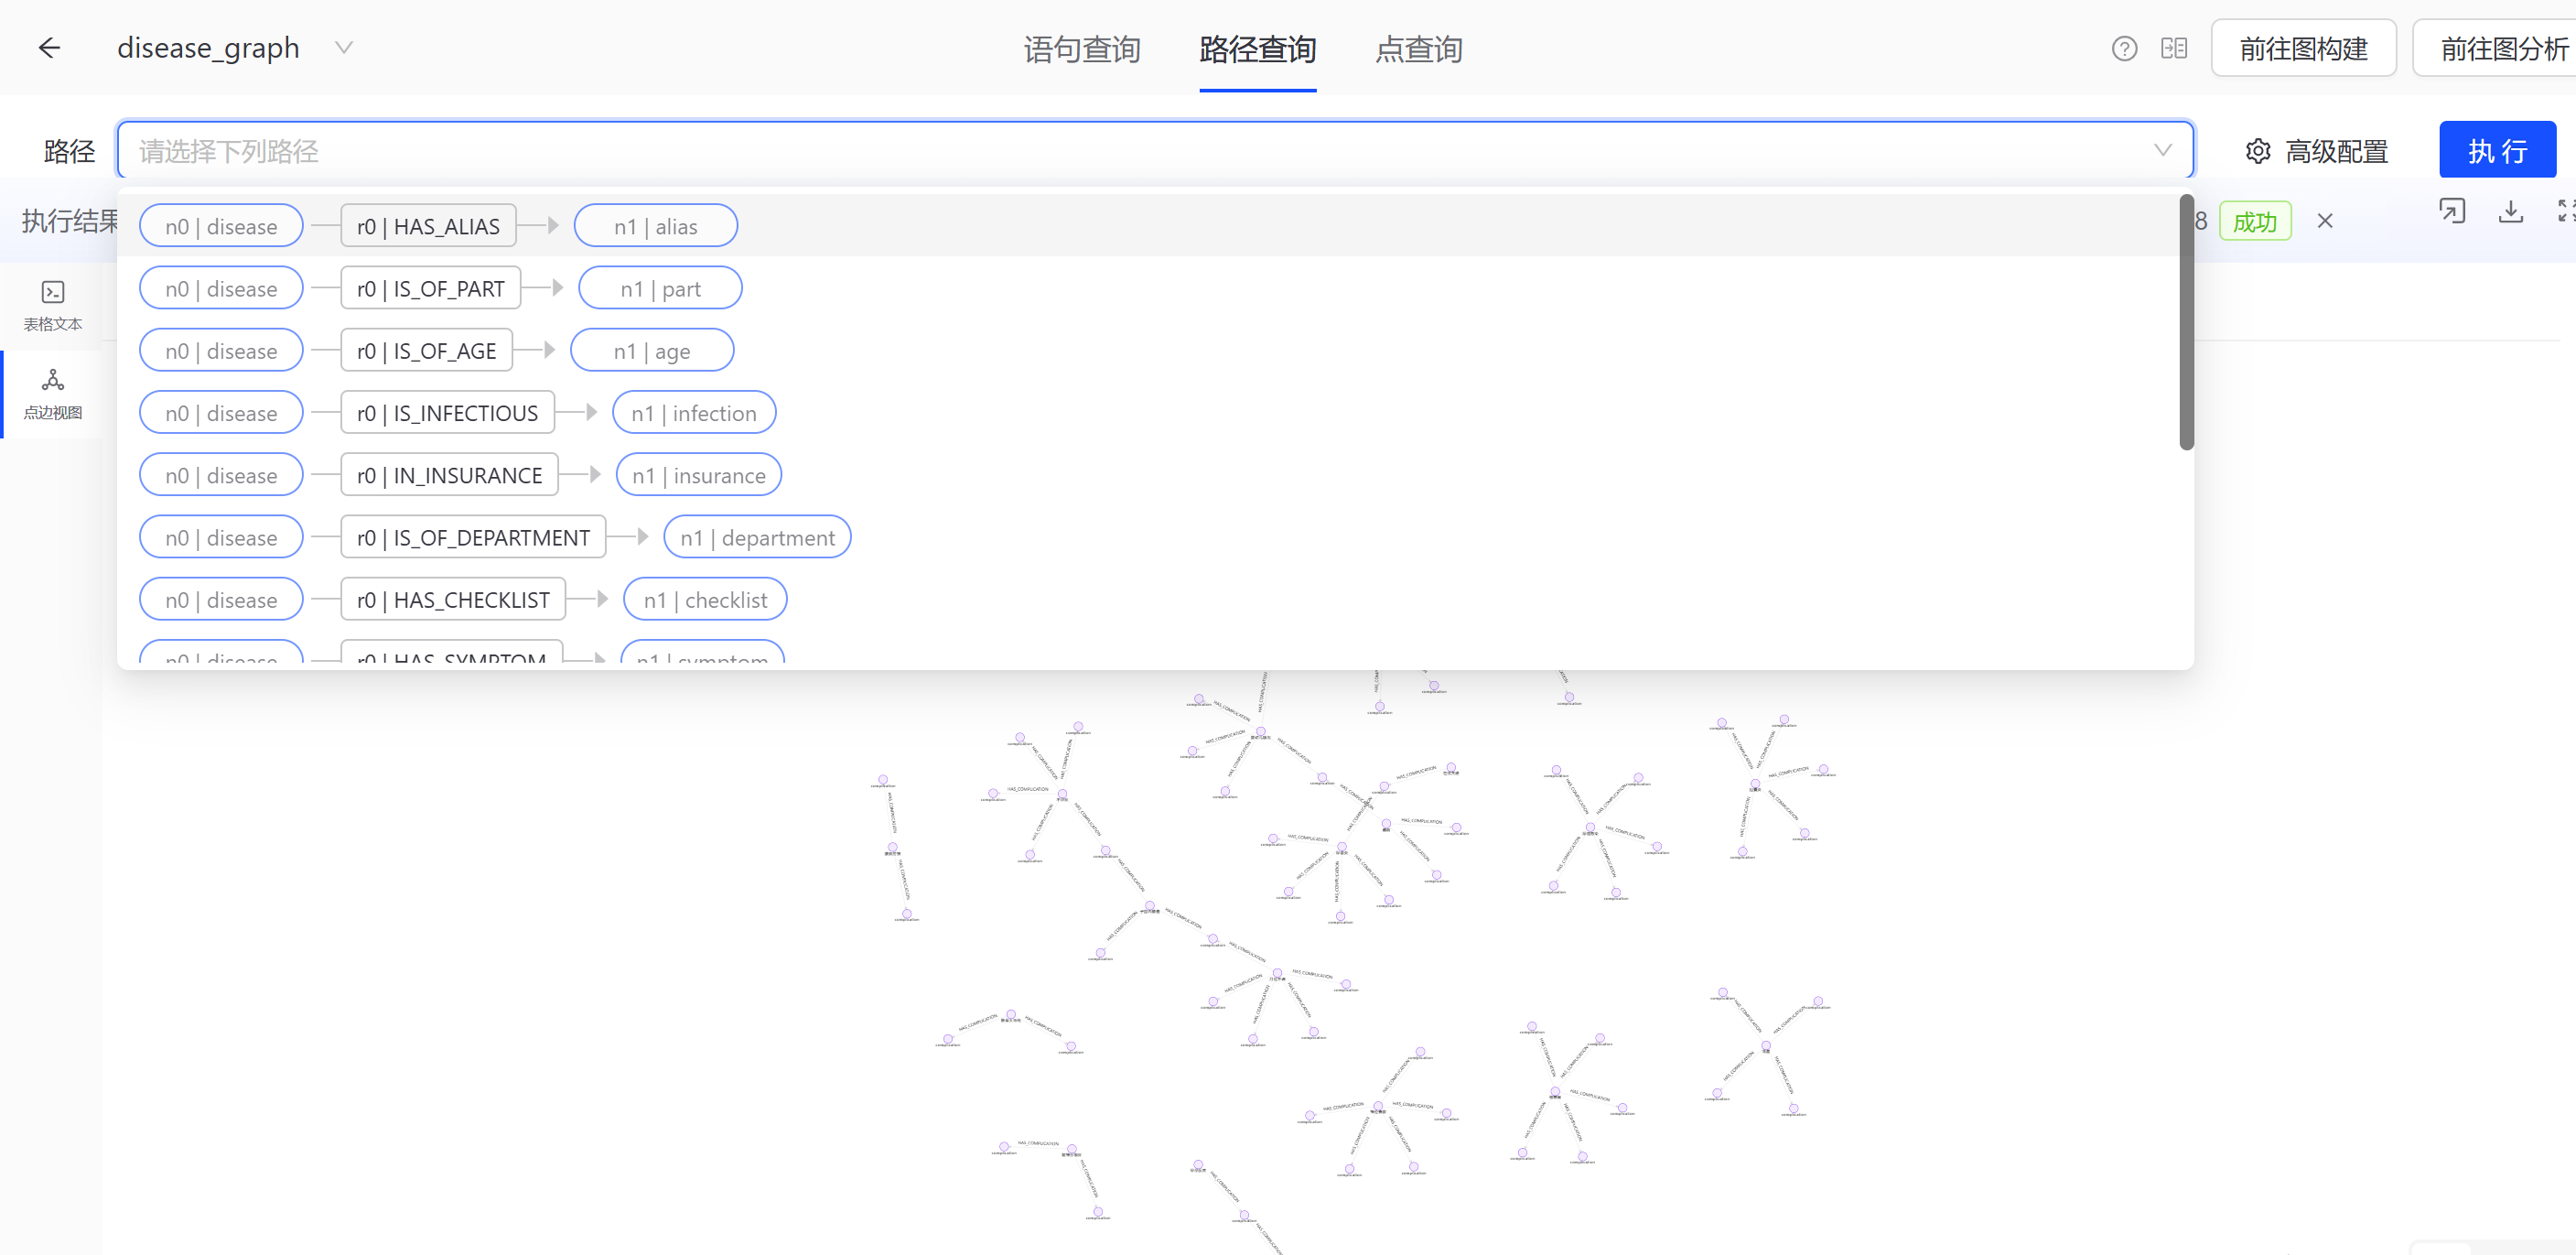
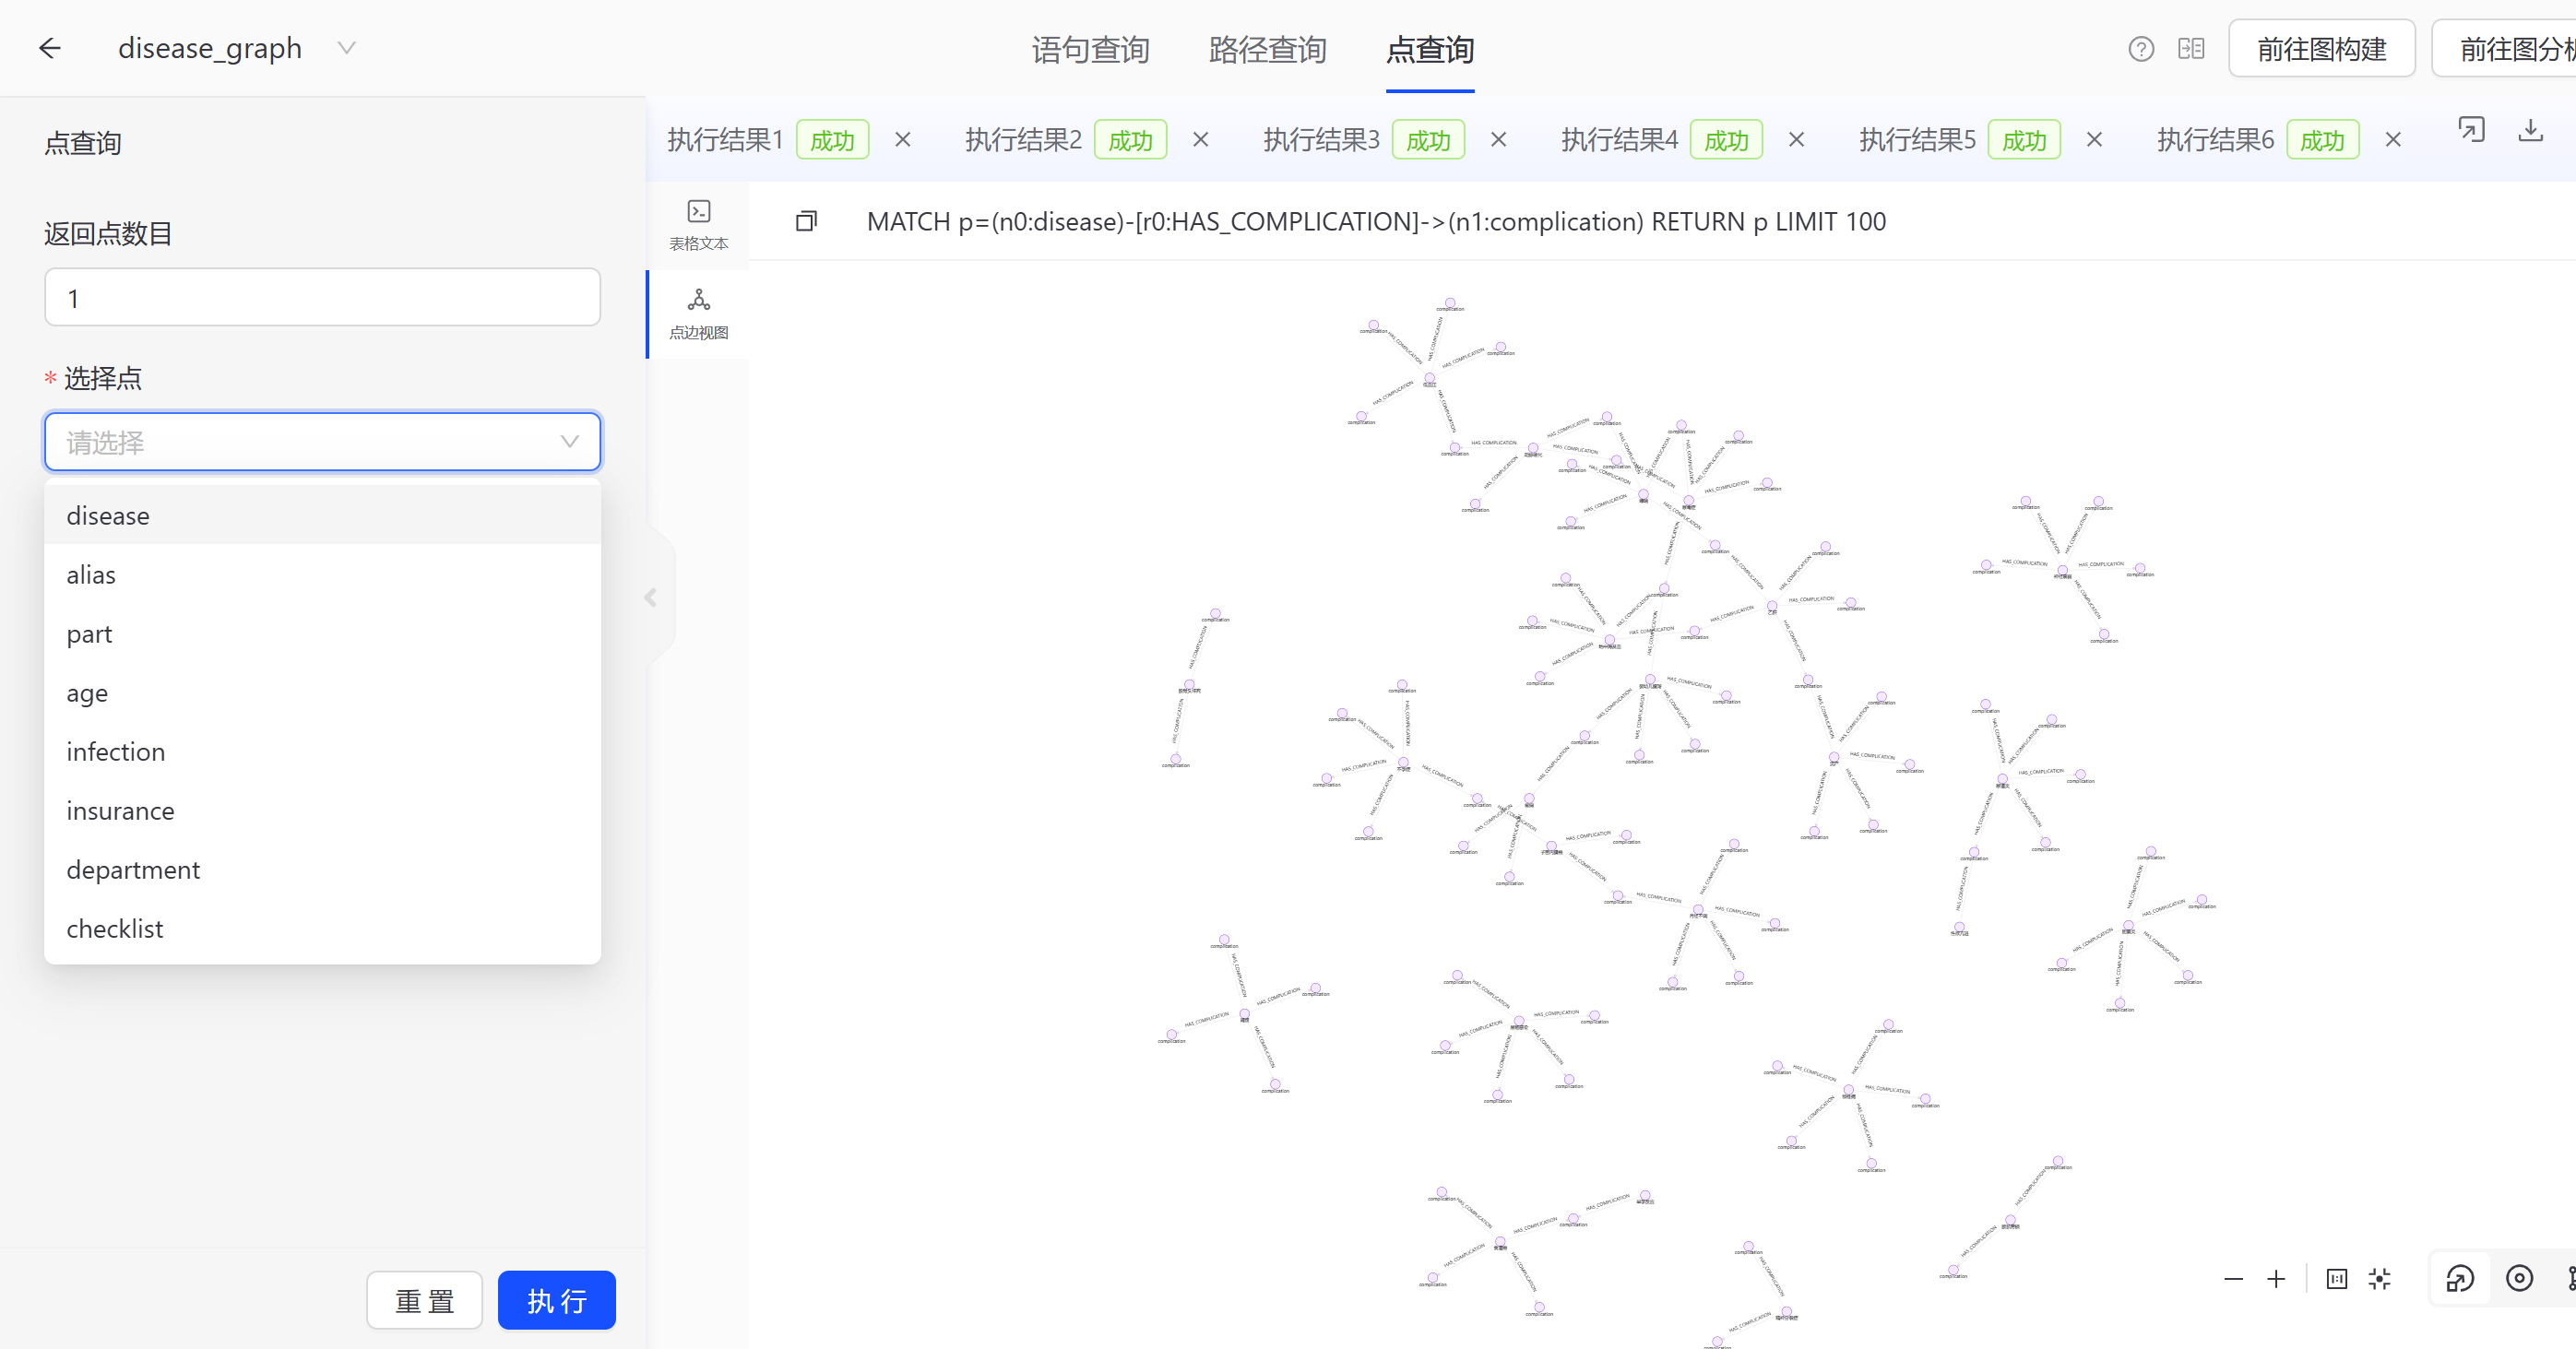
(3)查询示例
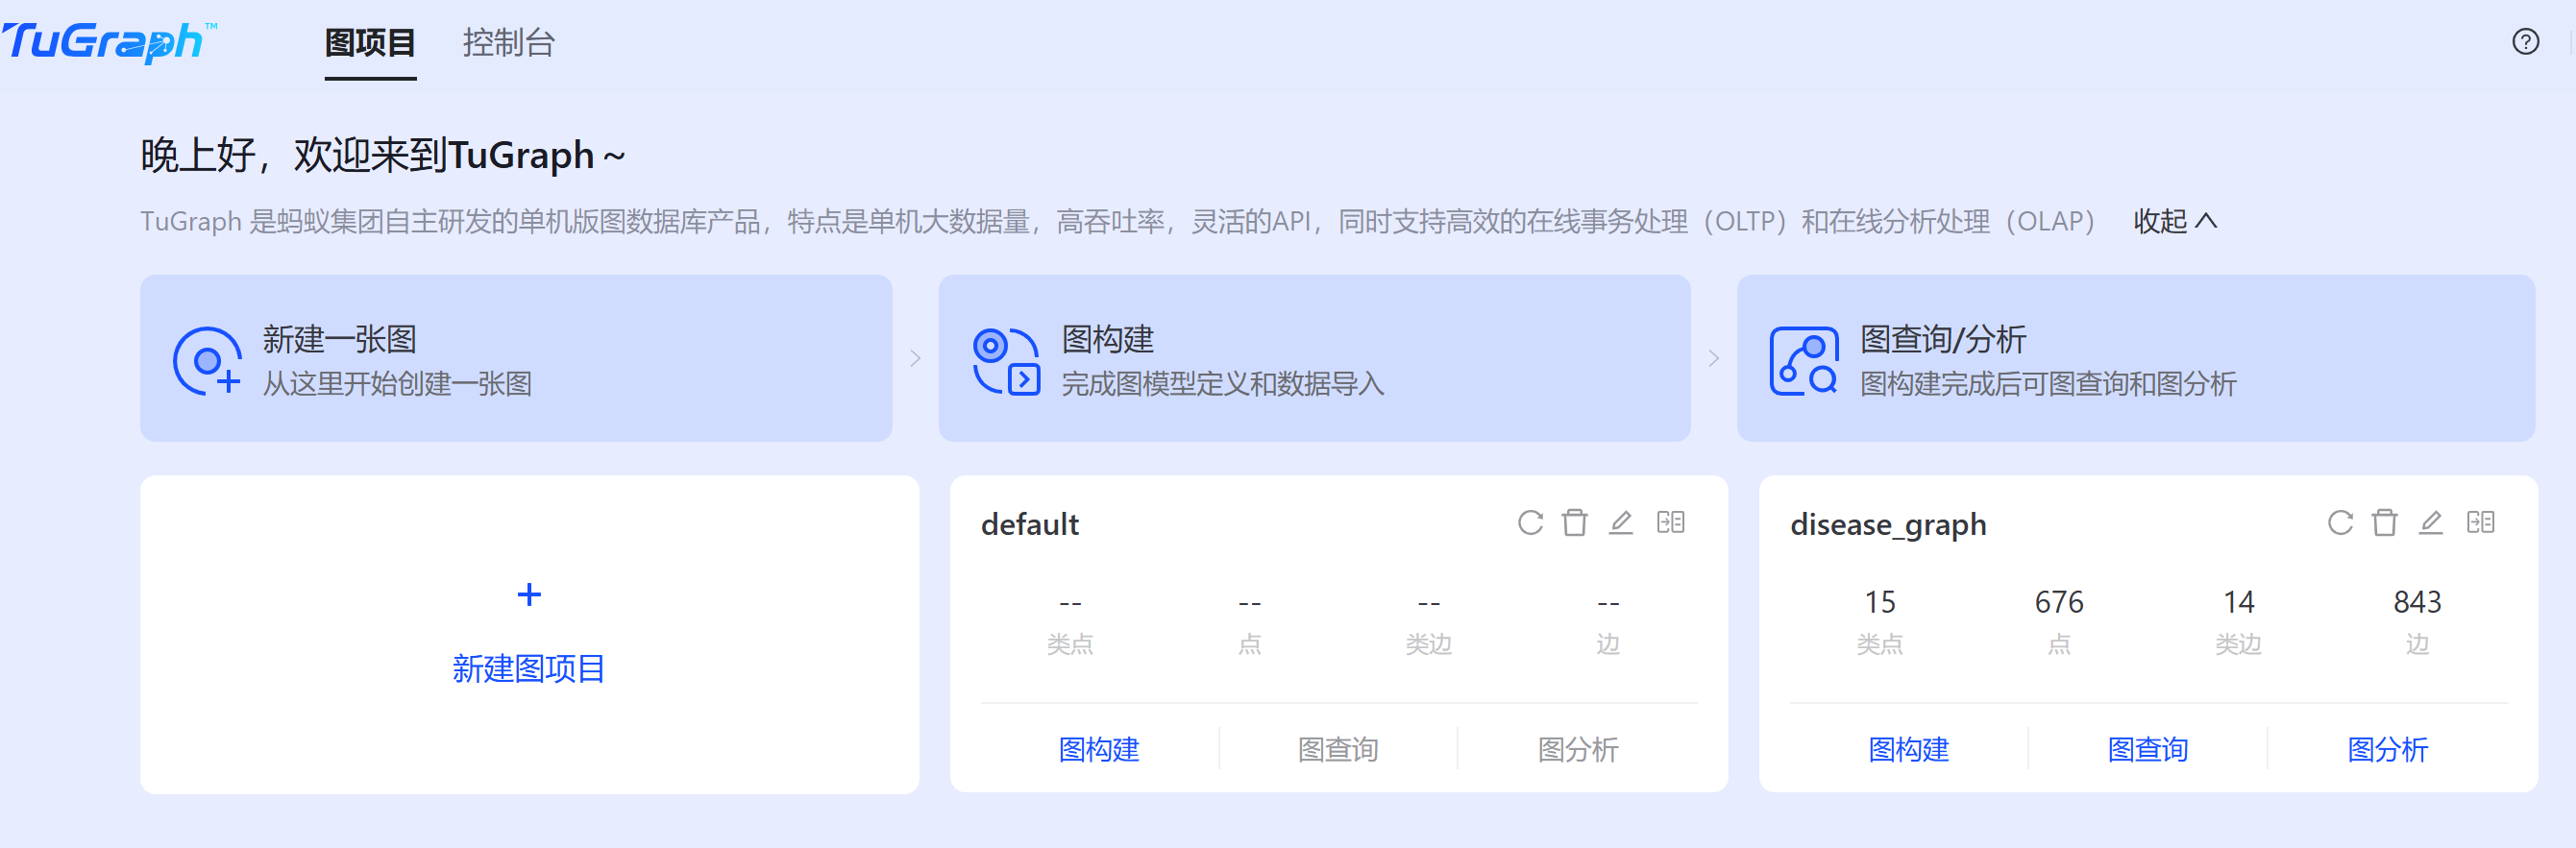
路径查询
点查询
三、在TuGraph中使用cypher语句+Python交互
在Tugraph查询与“哮喘”相关的所有内容
MATCH (d:disease {name: '哮喘'})-[r]->(related_node)
RETURN
  d.name AS 核心疾病,
  TYPE(r) AS 关联关系,
  LABELS(related_node)[0] AS 关联节点类型,
  related_node.name AS 关联节点名称
ORDER BY 关联节点类型; 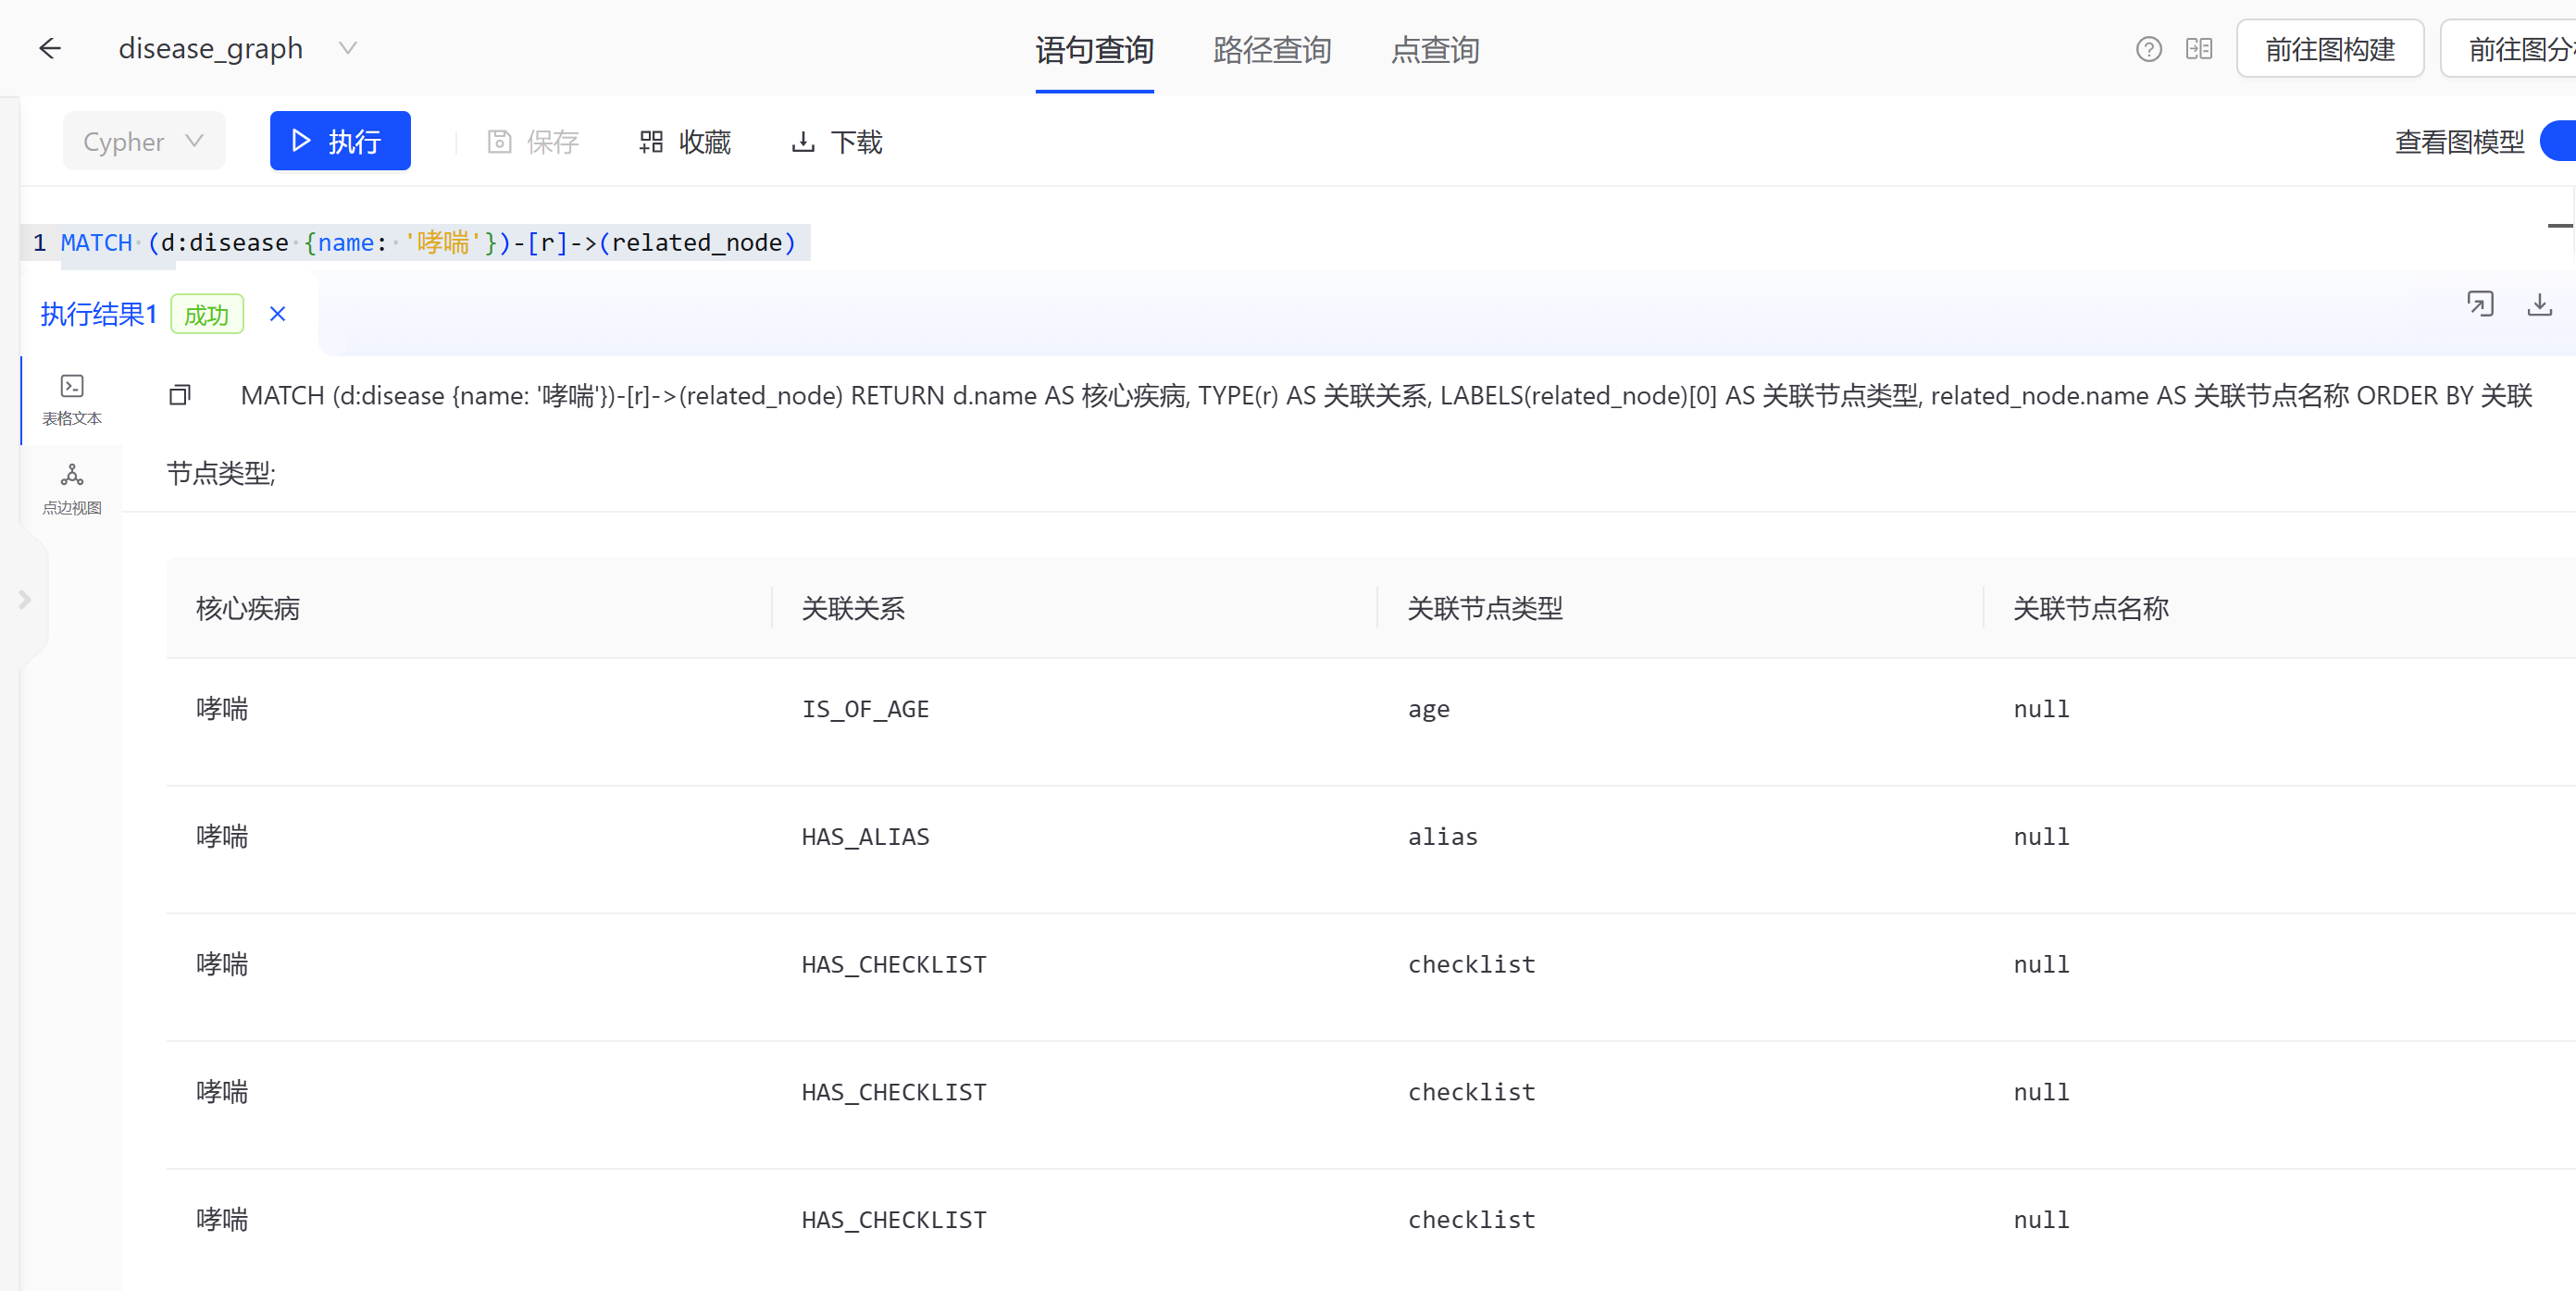
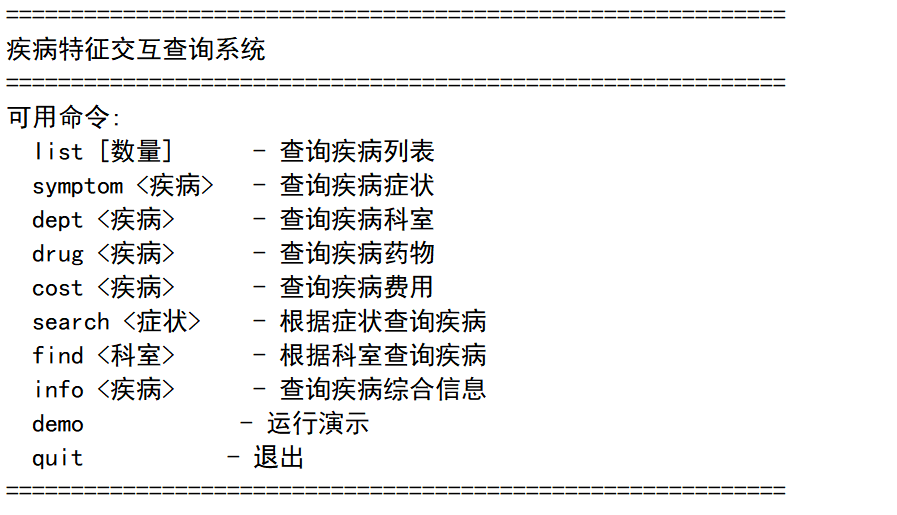
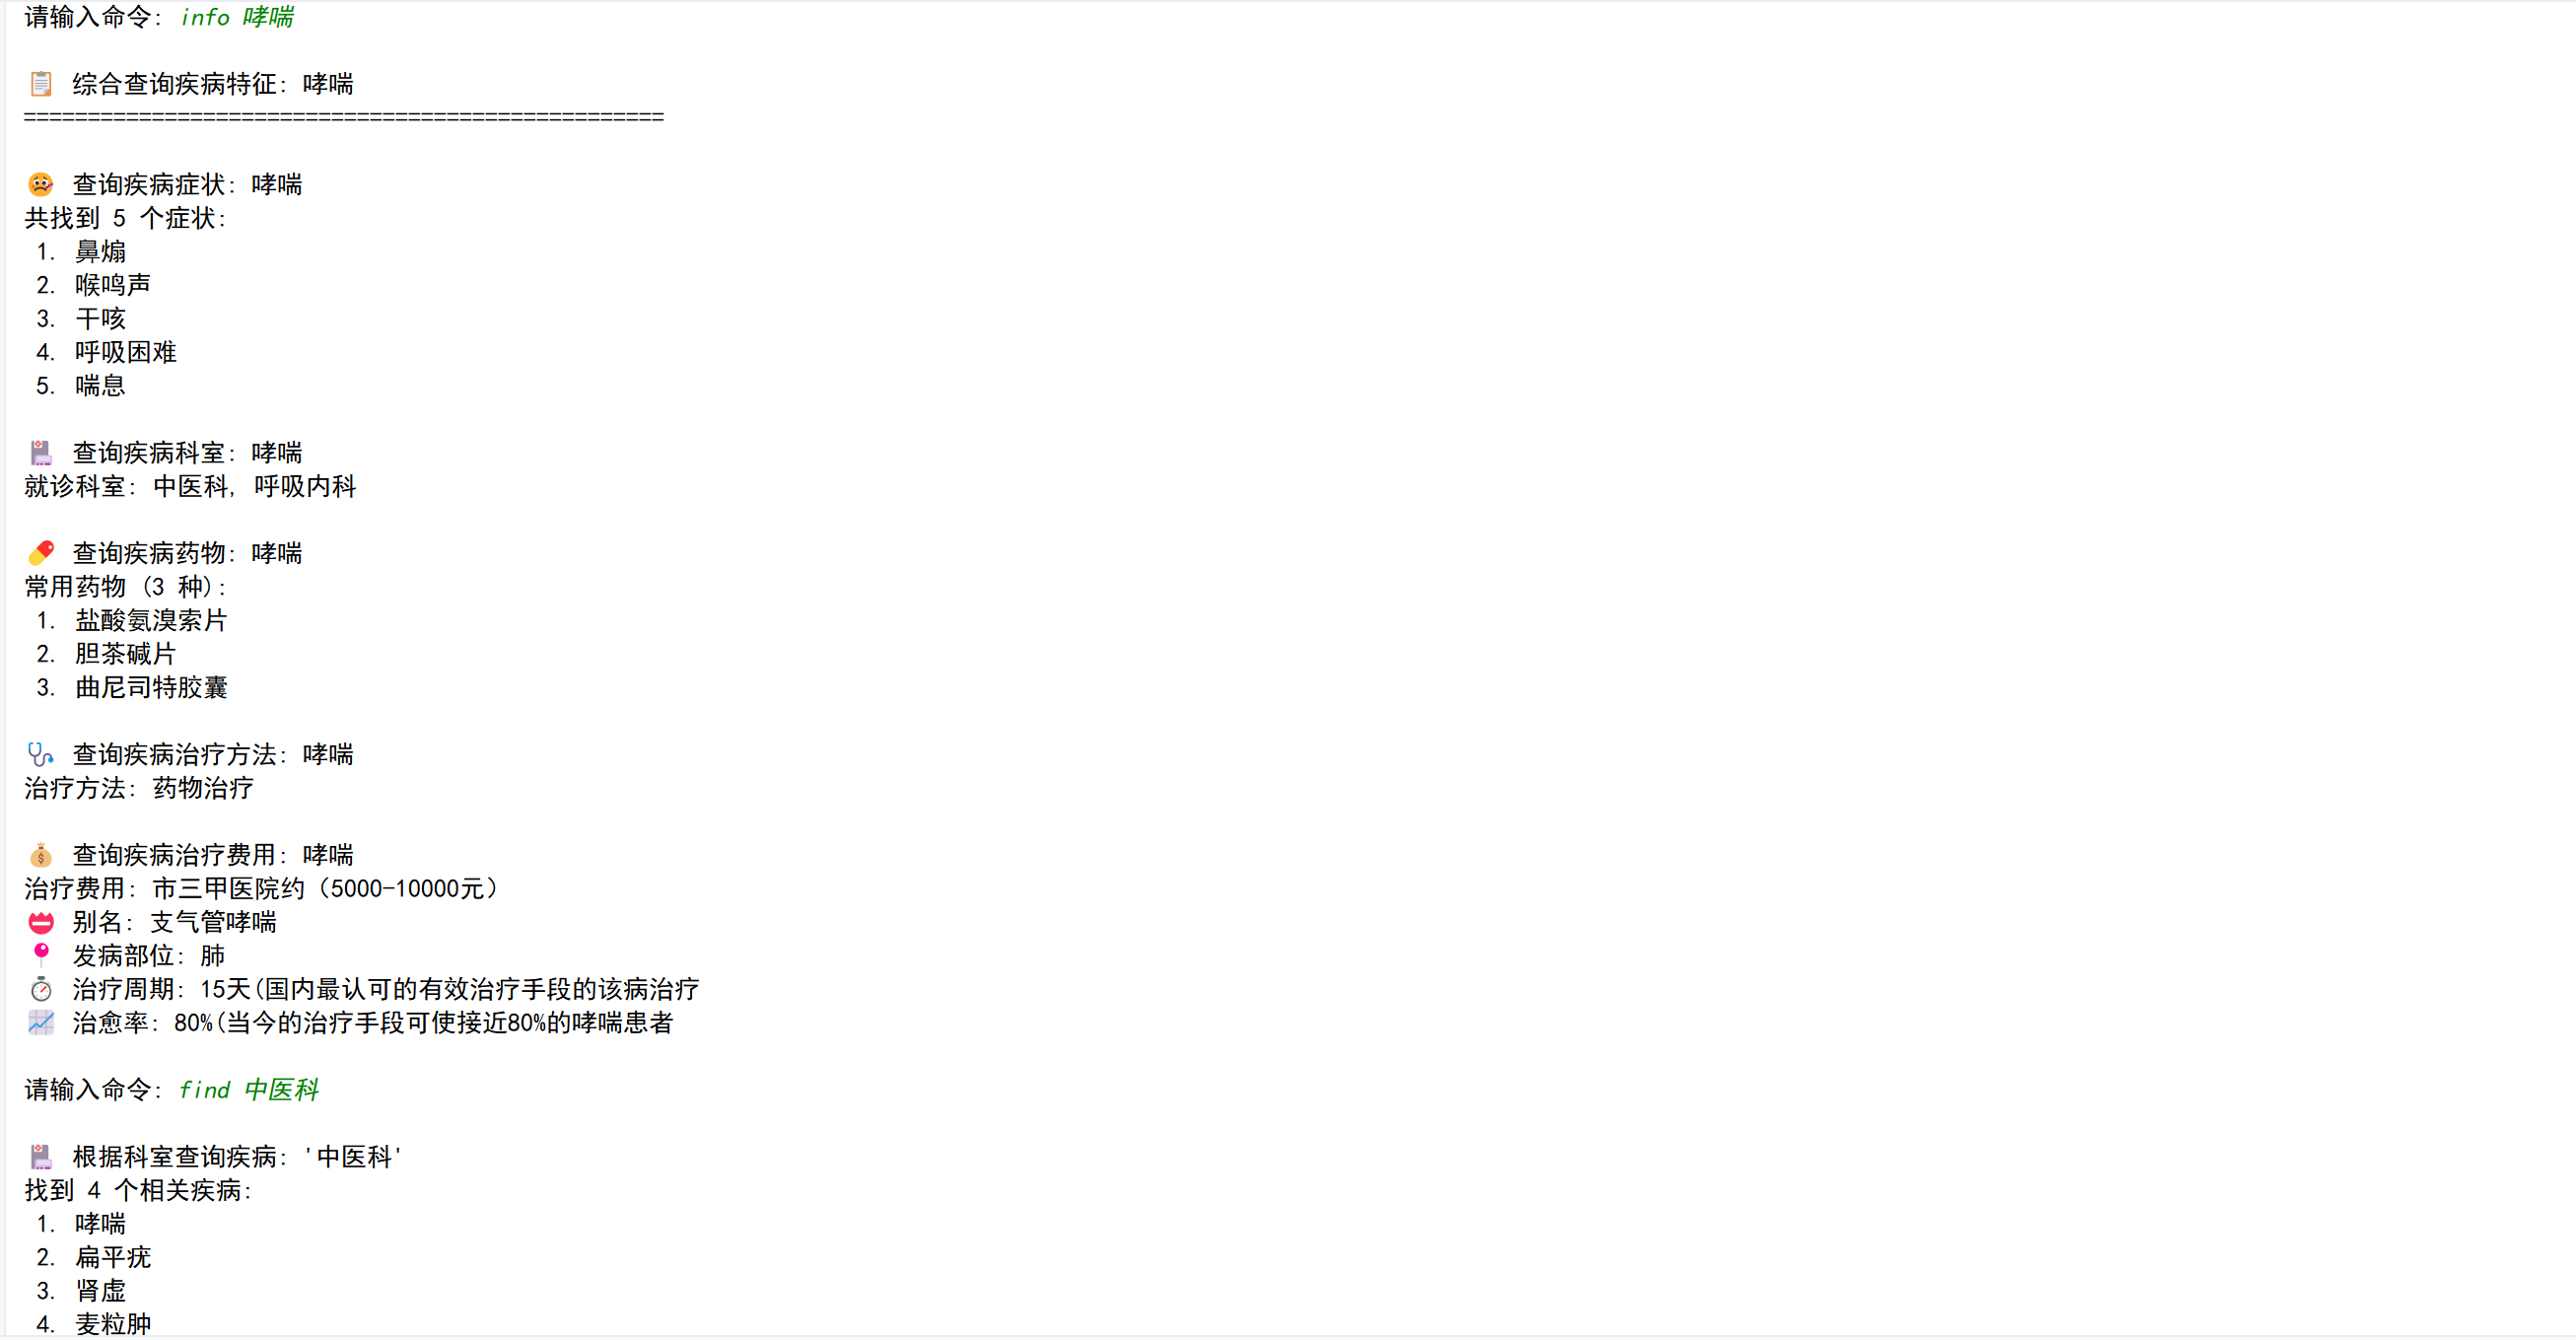
在python交互
四、医疗知识图谱对话系统
"""
医疗知识图谱对话系统 -
"""
from neo4j import GraphDatabase
import os
import re
from datetime import datetime
import random
class MedicalChatbotFinal:
def __init__(self, uri="bolt://localhost:7687", username="admin", password="73@TuGraph"):
"""初始化医疗对话机器人 """
self.uri = uri
self.username = username
self.password = password
self.database = "disease_graph"
self.driver = None
self.conversation_history = []
self.user_context = {}
print("=" * 60)
print("🤖 医疗知识图谱对话系统")
print("=" * 60)
self._connect()
self._load_resources()
self._init_query_map()
def _connect(self):
"""连接数据库"""
try:
self.driver = GraphDatabase.driver(self.uri, auth=(self.username, self.password))
with self.driver.session(database=self.database) as session:
result = session.run("RETURN 1 as test")
if result.single()["test"] == 1:
print("✅ 数据库连接成功")
else:
print("❌ 连接测试失败")
self.driver = None
except Exception as e:
print(f"❌ 连接失败: {e}")
self.driver = None
def _load_resources(self):
"""加载资源"""
# 从数据库加载疾病列表
if self.driver:
try:
query = "MATCH (d:disease) RETURN d.name as name"
results = self.execute_query_simple(query)
self.disease_list = [r['name'] for r in results if r.get('name')]
print(f"✅ 加载疾病列表: {len(self.disease_list)} 个疾病")
except Exception as e:
print(f"❌ 加载疾病列表失败: {e}")
self.disease_list = []
# 问候语
self.greetings = [
"您好!我是医疗助手,可以为您解答疾病相关问题。",
"欢迎使用医疗知识图谱系统,请问有什么可以帮您?",
"您好!我可以查询疾病症状、治疗方法、就诊科室等信息。",
"医疗助手为您服务,请问您想了解什么疾病信息?"
]
def _init_query_map(self):
"""初始化查询映射表"""
self.query_map = {
"alias": {
"relation": "HAS_ALIAS",
"label": "alias",
"property": "alias",
"keywords": ["别名", "又叫", "学名", "全称", "也称为"],
"reply_template": "【{disease}】的别名包括:{values}",
"empty_reply": "暂时没有找到【{disease}】的别名信息。"
},
"part": {
"relation": "IS_OF_PART",
"label": "part",
"property": "part",
"keywords": ["部位", "哪里", "哪个部位", "发病部位", "位置"],
"reply_template": "【{disease}】的发病部位是:{values}",
"empty_reply": "暂时没有找到【{disease}】的发病部位信息。"
},
"age": {
"relation": "IS_OF_AGE",
"label": "age",
"property": "age",
"keywords": ["人群", "年龄", "易感", "好发", "什么人容易得"],
"reply_template": "【{disease}】的易感人群包括:{values}",
"empty_reply": "暂时没有找到【{disease}】的易感人群信息。"
},
"infection": {
"relation": "IS_INFECTIOUS",
"label": "infection",
"property": "infection",
"keywords": ["传染", "感染", "传染性", "会不会传染"],
"reply_template": "【{disease}】的传染性:{values}",
"empty_reply": "暂时没有找到【{disease}】的传染性信息。"
},
"insurance": {
"relation": "IN_INSURANCE",
"label": "insurance",
"property": "insurance",
"keywords": ["医保", "报销", "保险", "能不能报销"],
"reply_template": "【{disease}】的医保情况:{values}",
"empty_reply": "暂时没有找到【{disease}】的医保信息。"
},
"department": {
"relation": "IS_OF_DEPARTMENT",
"label": "department",
"property": "department",
"keywords": ["科室", "挂什么科", "看哪个科", "就诊科室", "应该看什么科"],
"reply_template": "【{disease}】应该就诊的科室包括:{values}",
"empty_reply": "暂时没有找到【{disease}】的就诊科室信息。"
},
"checklist": {
"relation": "HAS_CHECKLIST",
"label": "checklist",
"property": "checklist",
"keywords": ["检查", "检测", "做什么检查", "检查项目", "需要检查什么"],
"reply_template": "诊断【{disease}】通常需要做以下检查:{values}",
"empty_reply": "暂时没有找到【{disease}】的检查项目信息。"
},
"symptom": {
"relation": "HAS_SYMPTOM",
"label": "symptom",
"property": "symptom",
"keywords": ["症状", "表现", "临床表现", "有什么症状", "症状有哪些"],
"reply_template": "【{disease}】的常见症状包括:{values}",
"empty_reply": "暂时没有找到【{disease}】的症状信息。"
},
"complication": {
"relation": "HAS_COMPLICATION",
"label": "complication",
"property": "complication",
"keywords": ["并发症", "合并症", "并发", "会引起什么", "可能导致"],
"reply_template": "【{disease}】可能出现的并发症包括:{values}",
"empty_reply": "暂时没有找到【{disease}】的并发症信息。"
},
"treatment": {
"relation": "HAS_TREATMENT",
"label": "treatment",
"property": "treatment",
"keywords": ["治疗", "方式", "怎么治", "治疗方法", "治疗方案", "怎么治疗"],
"reply_template": "【{disease}】的常用治疗方法包括:{values}",
"empty_reply": "暂时没有找到【{disease}】的治疗方法信息。"
},
"drug": {
"relation": "HAS_DRUG",
"label": "drug",
"property": "drug",
"keywords": ["药", "药物", "用药", "吃什么药", "药品", "药物有哪些"],
"reply_template": "治疗【{disease}】的常用药物包括:{values}",
"empty_reply": "暂时没有找到【{disease}】的药物信息。"
},
"period": {
"relation": "CURE_PERIOD",
"label": "period",
"property": "period",
"keywords": ["周期", "多久能好", "治疗时间", "疗程", "需要治疗多久"],
"reply_template": "【{disease}】的治疗周期一般为:{values}",
"empty_reply": "暂时没有找到【{disease}】的治疗周期信息。"
},
"rate": {
"relation": "CURE_RATE",
"label": "rate",
"property": "rate",
"keywords": ["治愈率", "成功率", "预后", "治愈", "能不能治好"],
"reply_template": "【{disease}】的治愈率:{values}",
"empty_reply": "暂时没有找到【{disease}】的治愈率信息。"
},
"money": {
"relation": "NEED_MONEY",
"label": "money",
"property": "money",
"keywords": ["费用", "多少钱", "花费", "治疗费用", "需要多少钱"],
"reply_template": "治疗【{disease}】的费用大约为:{values}",
"empty_reply": "暂时没有找到【{disease}】的治疗费用信息。"
}
}
def close(self):
"""关闭连接"""
if self.driver:
self.driver.close()
print("数据库连接已关闭")
def execute_query_simple(self, query, parameters=None):
"""执行Cypher查询 - 简化版"""
if not self.driver:
return []
try:
with self.driver.session(database=self.database) as session:
result = session.run(query, parameters)
records = []
for record in result:
rec_dict = {}
for key in record.keys():
value = record[key]
if value is not None:
rec_dict[key] = str(value)
else:
rec_dict[key] = ""
records.append(rec_dict)
return records
except Exception as e:
print(f"查询执行失败: {e}")
return []
def extract_disease_name(self, text):
"""从文本中提取疾病名称"""
if not self.disease_list:
return None
# 精确匹配
for disease in self.disease_list:
if disease in text:
return disease
return None
def identify_query_type(self, text):
"""识别查询类型"""
text_lower = text.lower()
for qtype, config in self.query_map.items():
for keyword in config["keywords"]:
if keyword in text_lower:
return qtype
# 通用查询
if "什么" in text_lower or "哪些" in text_lower or "怎么" in text_lower or "信息" in text_lower:
return "general"
return None
def query_disease_info(self, disease_name, query_type):
"""查询疾病信息"""
if query_type not in self.query_map:
return []
config = self.query_map[query_type]
query = f"""
MATCH (d:disease {{name: $disease_name}})-[:{config['relation']}]->(n:{config['label']})
RETURN n.{config['property']} as value
"""
results = self.execute_query_simple(query, {"disease_name": disease_name})
# 收集和去重
values = []
seen = set()
for r in results:
value = r.get('value', '').strip()
if value and value not in seen:
seen.add(value)
values.append(value)
return values
def query_general_info(self, disease_name):
"""查询疾病的通用信息"""
info = {
'disease': disease_name,
'symptoms': [],
'departments': [],
'treatments': [],
'drugs': []
}
# 分别查询各种信息
queries = [
('symptoms', 'HAS_SYMPTOM', 'symptom', 'symptom'),
('departments', 'IS_OF_DEPARTMENT', 'department', 'department'),
('treatments', 'HAS_TREATMENT', 'treatment', 'treatment'),
('drugs', 'HAS_DRUG', 'drug', 'drug'),
]
for field, relation, label, property_name in queries:
query = f"""
MATCH (d:disease {{name: $disease_name}})-[:{relation}]->(n:{label})
RETURN n.{property_name} as value
"""
results = self.execute_query_simple(query, {"disease_name": disease_name})
# 收集和去重
values = []
seen = set()
for r in results:
value = r.get('value', '').strip()
if value and value not in seen:
seen.add(value)
values.append(value)
info[field] = values
return info
def format_response(self, disease_name, query_type, query_results):
"""格式化响应"""
if not query_results:
if query_type == "general":
return f"抱歉,没有找到关于【{disease_name}】的详细信息。"
else:
config = self.query_map[query_type]
return config["empty_reply"].format(disease=disease_name)
if query_type == "general":
# 通用信息查询
info = query_results
response = f"关于【{disease_name}】的综合信息:\n\n"
has_info = False
if info.get('departments'):
departments = info['departments']
if departments:
response += f"🏥 就诊科室:{'、'.join(departments[:5])}\n"
has_info = True
if info.get('symptoms'):
symptoms = info['symptoms']
if symptoms:
response += f"🤒 主要症状:{'、'.join(symptoms[:5])}\n"
has_info = True
if info.get('treatments'):
treatments = info['treatments']
if treatments:
response += f"💊 治疗方法:{'、'.join(treatments[:3])}\n"
has_info = True
if info.get('drugs'):
drugs = info['drugs']
if drugs:
response += f"💉 常用药物:{'、'.join(drugs[:5])}\n"
has_info = True
if not has_info:
response += "暂时没有相关信息。\n"
return response
else:
# 特定类型查询
config = self.query_map[query_type]
if not query_results:
return config["empty_reply"].format(disease=disease_name)
# 确保是列表
if not isinstance(query_results, list):
query_results = [query_results]
# 过滤空值
valid_results = [r for r in query_results if r and str(r).strip()]
if not valid_results:
return config["empty_reply"].format(disease=disease_name)
if len(valid_results) > 5:
response = config["reply_template"].format(
disease=disease_name,
values="、".join(valid_results[:5]) + f" 等{len(valid_results)}项"
)
else:
response = config["reply_template"].format(
disease=disease_name,
values="、".join(valid_results)
)
return response
def get_help_text(self):
"""获取帮助文本"""
help_text = """
🤖 医疗知识图谱对话系统
========================================
我可以回答关于29种常见疾病的各种问题:
支持的查询类型:
1. 症状查询
例:阳痿有什么症状?
2. 科室推荐
例:乙肝应该挂什么科?
3. 治疗方案查询
例:怎么治疗癫痫?
4. 药物查询
例:乙肝吃什么药?
5. 费用咨询
例:治疗阳痿要多少钱?
支持的疾病包括:
阳痿、乙肝、癫痫、月经不调、颈椎病、腰肌劳损、股骨头坏死等29种疾病。
输入'疾病列表'查看所有支持的疾病
输入'退出'结束对话
========================================
"""
return help_text
def process_user_input(self, user_input):
"""处理用户输入"""
# 检查特殊命令
if user_input.lower() in ["退出", "exit", "quit", "bye", "再见"]:
return {"type": "exit", "message": "感谢使用,祝您健康!👋"}
if user_input.lower() in ["帮助", "help", "怎么用", "使用方法"]:
return {"type": "help", "message": self.get_help_text()}
if user_input.lower() in ["疾病列表", "所有疾病", "有哪些疾病"]:
diseases_text = f"当前知识图谱包含 {len(self.disease_list)} 种疾病:\n"
for i, disease in enumerate(self.disease_list[:20], 1):
diseases_text += f"{i:2d}. {disease}\n"
if len(self.disease_list) > 20:
diseases_text += f"... 等 {len(self.disease_list)} 种疾病"
return {"type": "disease_list", "message": diseases_text}
# 提取疾病名称
disease_name = self.extract_disease_name(user_input)
if not disease_name:
return {
"type": "error",
"message": "抱歉,我没有识别出疾病名称。\n请明确指定疾病,例如:'阳痿有什么症状?'\n\n输入'疾病列表'查看所有支持的疾病。"
}
# 识别查询类型
query_type = self.identify_query_type(user_input)
if not query_type:
# 默认查询通用信息
query_type = "general"
# 执行查询
if query_type == "general":
query_results = self.query_general_info(disease_name)
else:
query_results = self.query_disease_info(disease_name, query_type)
# 格式化响应
response = self.format_response(disease_name, query_type, query_results)
return {
"type": "response",
"disease": disease_name,
"query_type": query_type,
"response": response
}
def run_interactive(self):
"""运行交互式对话"""
# 问候
print("\n您好!我是医疗助手,可以为您解答疾病相关问题。")
print("\n" + "=" * 60)
while True:
try:
user_input = input("\n👤 您: ").strip()
if not user_input:
continue
# 处理用户输入
result = self.process_user_input(user_input)
if result["type"] == "exit":
print(f"\n🤖 {result['message']}")
break
elif result["type"] == "help":
print(f"\n{result['message']}")
elif result["type"] == "disease_list":
print(f"\n{result['message']}")
elif result["type"] == "error":
print(f"\n🤖 {result['message']}")
elif result["type"] == "response":
print(f"\n🤖 {result['response']}")
except KeyboardInterrupt:
print("\n\n💬 对话已结束")
break
except Exception as e:
print(f"\n系统错误:{e}")
continue
def main():
"""主函数"""
print("启动医疗知识图谱问答系统...")
# 创建对话机器人
chatbot = MedicalChatbotFinal(
uri="bolt://localhost:7687",
username="admin",
password="73@TuGraph"
)
if not chatbot.driver:
print("数据库连接失败,无法启动对话系统")
return
try:
# 测试数据库连接
test_query = "MATCH (d:disease) RETURN COUNT(d) as count"
result = chatbot.execute_query_simple(test_query)
if result and result[0].get('count'):
print(f"✅ 数据库连接成功,有 {result[0].get('count')} 个疾病")
# 启动对话
chatbot.run_interactive()
else:
print("❌ 数据库中没有疾病数据,请先导入数据")
except Exception as e:
print(f"系统错误: {e}")
finally:
chatbot.close()
if __name__ == "__main__":
main()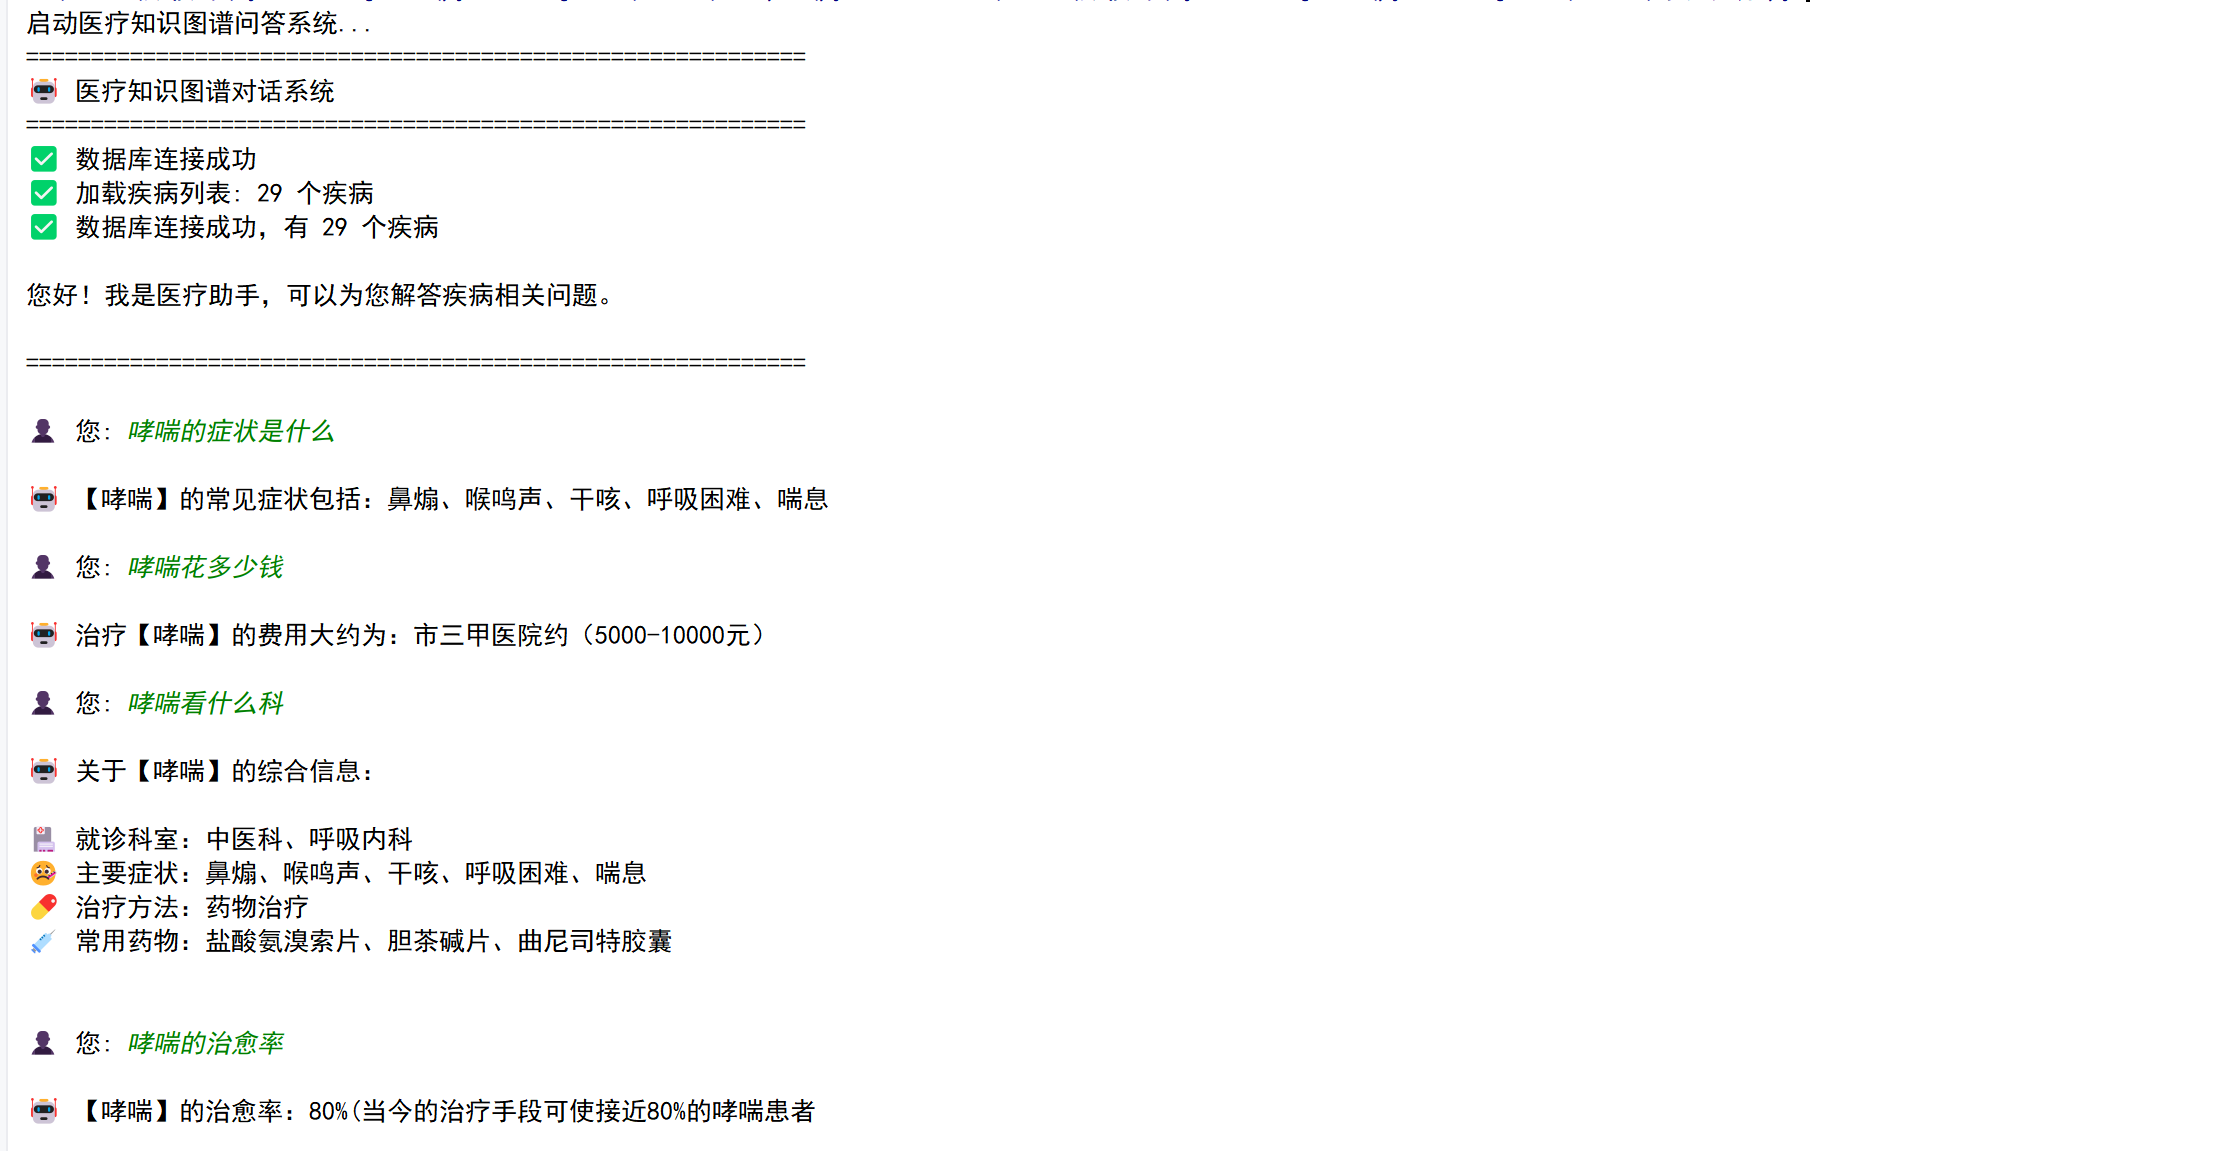

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)