51c自动驾驶~合集63
我自己的原文哦~ https://blog.51cto.com/whaosoft143/14402401
#L4数据闭环
三端统一Trigger框架,让异常事件自动长成问题单系列小结:
- 01:最重要的第一步——给整个组织选对 Loss Function(MPI / MPS / MPD)。
- 02:L4 无人车的实时打点与业务心跳。
- 03:自动驾驶数据闭环的“地基工程”:数据分级上传与 Case / 文件映射。
- 04:每车每秒的标签体系与 FastDM / FreeDM 的历史数据挖掘。
前四篇更多在搭“地基”和“管道”。从这一篇开始,我们正式走到中枢神经——异常事件如何被自动发现、自动归因、自动长成问题单,并最终汇总成头部问题。
这一切的核心,就是一个三端统一的 Trigger 框架。
一、从“看 log 找 bug”到“数据自己长成问题单”
在很多自动驾驶团队里,问题排查的原始形态大概是这样:
- 车上出了一次急刹车 / 大转向 / 停车不走;
- 运维 / 研发打开回放系统,盯着一堆 log 窗口:
- 感知障碍物框;
- 预测轨迹;
- 规划选路;
- 控制指令;
- 底盘 CAN、错误码……
- 凭经验判断:
- “这个更像感知漏检”;
- “这个是规划犹豫”;
- “这个是底盘异常”;
- 然后手动在问题管理系统里提工单、选模块、分配给某位同学。
这种方式的问题你自己也体会过:
1. 强依赖少数“老法师”
- 经验全在几个人脑子里,很难系统化沉淀;
- 人一换,诊断质量大概率掉一截。
2. 云 / 车 / 仿真三套逻辑各写一遍
- 车端写一套在线监控逻辑;
- 云端挖历史数据又写一套;
- 仿真评测再写一套。
名义上都是“急刹车判断”,细节阈值却不一样,结论经常打架。
3. 问题聚类和头部问题发现很难做
- 每次排查都是一个个“散点”;
- 很难系统性回答: > “这个月我们最该优先解决的头部问题究竟是哪几类?”
如果把整个组织类比成一个“强化学习系统”:
- MPI / MPS / MPD 是顶层的 Loss Function;
- 每一次异常 / bug,其实都是推动系统学习的一次“样本”。
那我们真正想要的是:
异常事件不用人盯着才出现,而是顺着日志自己长成一条条结构化的“问题样本”——自动发现、自动归因、自动分发,再自动汇总成头部问题。
这就是 Trigger 框架要干的事。
二、先说清楚:Trigger 在这个体系里到底是什么?
在这个系列里,“Trigger”这个词已经出现了很多次。在这一篇里,我们给它一个稍微“学术一点”的定义:
Trigger = 特征工程 + Tokenizer
问题分类 = Token 序列上的 Classifier
- 特征工程(Feature Engineering)
从原始日志(姿态、感知结果、轨迹、底盘 CAN、错误码、模块中间结果……)中,抽取一批“中间事件”:
- “第 3 秒,前方某个障碍物的尺寸突然从 1.2m 变成 3.5m”;
- “第 5 秒,车辆纵向加速度 < -3.5m/s²,疑似急刹车”;
- “第 7 秒,控制输出方向盘角度瞬间跳变,超过某个阈值”。
- Tokenizer
把这些中间事件,按时间轴打成一个个“Token”: - 每个 Token 带上类型(比如 perception_box_jump)、时间戳、附加属性(距离、速度、类别等)。
- Classifier
对同一个 case 内的一串 Token 序列(加上场景标签),去判断: - 这是感知漏检?
- 还是误检导致的急刹?
- 还是 PnC 纵向调节过度?
- 还是地图 / 路况 / 底盘问题?
Trigger 做的是前半段:把时间序列原始信号变成“可供分类的 Token 序列”。
后面的问题分类、聚类、头部问题分析,都是在这堆 Token / 标签 / Case 上做文章。
三、为什么一定要“三端统一”的 Trigger?
如果不统一,一般会长成这样三套:
1. 车端 Trigger(在线监控 + 数据采集)
- 为了实时性和资源占用,逻辑写得很轻;
- 语言 / 框架可能跟云端完全不一样。
2. 云端 Trigger(历史数据挖掘 + 回溯统计)
- 通常是 ODPS 上一套 Python UDF + SQL;
- 负责扫 microlog / mini log 做历史回刷。
3. 仿真 Trigger(回归评测)
- 仿真平台内部再写一套 case 触发和评测的逻辑。
结果就是:
- 同一个“急刹车”的定义,三处阈值略不同;
- 同一段数据,仿真里是 OK,线上算 Bad,怎么都对不齐;
- 出了问题之后,扯皮成本巨大。
所以三端统一 Trigger 的目标非常朴素:
关于“什么算一次事件 / 什么算一个问题”的逻辑,只写一份 Trigger 代码,
云端 / 车端 / 仿真三端都用这一份。
四、Trigger 框架总体设计:一套 Python,三端 Runtime
在实现上,我给 Trigger 做了两个“死规定”:
- Trigger 逻辑必须用纯 Python 写,遵守一套统一接口;
- 多端适配、性能优化、可视化增强,全部藏在框架里,业务同学只写 Trigger。
整体分成三层:
- Trigger 定义层(元数据 + 文档)
- Trigger Runtime(执行引擎)
- Trigger 管理与调度(Manager + 发布系统)
4.1 Trigger 定义层:元数据 + LLM 可读文档
每一个 Trigger 都有自己的“身份证”:
-
trigger_id:唯一标识; - 名称 / 描述;
- 所属模块(感知 / 预测 / PnC / 定位 / 硬件 / 场景 / 基础设施等);
- 输入依赖:
- 订阅哪些 channel;
- 需要哪些字段(pose、microlog 字段、障碍物、多边形、轨迹、错误码等);
- 输出标签:
- 生成哪些 Token 类型;
- 最终会写哪些 case / 标签字段;
- 复杂度等级:
- 可以车端在线跑;
- 还是只能云端 / 仿真离线跑。
另外,还有一份专门给大模型看的“可读文档”,
后面用 LLM 帮忙写 Trigger、做自动归因的时候会用到。
4.2 Trigger Runtime:三端统一的执行接口
Runtime 对 Trigger 提供了一个统一的执行接口,大致是:
-
init() -
eval() -
analysis()
与其记细节,不如把这三步当成一个固定“人生三段论”来理解。
4.2.1 init():声明你要看的数据 + 初始化状态
init() 做两件事:
1.声明数据依赖(订阅 channel)
- 告诉框架:这一条 Trigger 需要哪些 channel、哪些字段:
- pose、车速、加速度、航向角;
- microlog 中的算法中间结果;
- 感知障碍物多边形、预测轨迹;
- 控制输出、错误码等。
- 框架用这些订阅信息做两层优化:
- 云端:在拼 microlog / mini log 时做初筛,只读需要的字段,减少 IO;
- 车端:只把必要的数据推给 Trigger 沙箱,减少对主流程干扰。
2.初始化 Trigger 级的“全局状态”
- 在 init() 中定义跨帧需要保存的状态:
- 比如上一帧的障碍物位置、累计时间、状态机阶段;
- 这些状态在实现上是 Trigger 实例的成员变量,
在 eval() 中可以不断更新。
简单讲:**init() 决定“我要看什么”和“我要记什么”。**
4.2.2 eval():一帧一帧往前走,离线是 for 循环,车端是实时流
eval() 是 Trigger 的主战场。框架保证:
- 按时间顺序调用:
- 云端:对一个 case 的数据做 for loop,按时间戳从小到大调用 eval();
- 车端:接收到实时 channel 数据,就按顺序回调 eval();
- 仿真:在仿真回放时按仿真时间依次调用。
- 业务逻辑“离线 / 实时无差别”:
- 对 Trigger 作者来说,写 eval() 不用关心“当前在哪个平台”;
- 你只需要假设:每次 eval() 被调用,就是又来了一帧时间序列数据。
典型的 eval() 逻辑会:
- 读这一帧订阅到的各类字段;
- 和之前的状态做对比(上一帧 / 前几帧);
- 判断是否出现某种模式:
- 盒子突变、轨迹跳变;
- 加速度异常、方向盘抖动;
- 某个错误码持续时间超过阈值;
- 如果命中,就记录一个中间事件(Token)到内部列表。
因为 eval() 调用频繁,性能很关键。
框架已经把很多昂贵的几何运算用 C++ 做了高性能实现,比如:
- 多边形是否相交;
- 多边形之间的最小距离;
- 点到多边形 / 线段的距离等。
Trigger 脚本里只需要调用 Python 接口,例如:
# 伪代码示意
if geom.poly_intersect(poly_a, poly_b):
    self.events.append({
        "ts": ts,
        "type": "perception_poly_intersect",
        "extra": {...}
    })
对 Trigger 作者来说,就是一个普通 Python 函数调用;
对 Runtime 来说,底层实际走的是高性能 C++ 库。
4.2.3 analysis():一段数据跑完之后做“总结发言”
analysis() 在跑完一段时间片之后调用:
- 云端 / 离线:
- 通常以 case 为单位,当这个 case 的所有帧都跑完 eval(),
Runtime 会调用一次 analysis();
- 车端 / 实时:
- 可以配置滑动窗口,比如“每 60 秒 / 每个 road_case 完结时”调用一次。
analysis() 有两个要求:
1. 输出一批标准字段
- 事件类型(例如感知误检导致急刹、PnC 跟车策略保守、定位跳变等);
- 关键事件发生的时间点;
- 所属
road_case_id / bad_case_id; - 严重程度、建议归属模块等(如果这个 Trigger 负责分类)。
2. 可以输出扩展字段做平台差异化展示
- 仿真平台上:
- 可以顺带输出“有问题的时刻截图的路径”、关键状态的可视化信息;
- 云端离线批处理时:
- 可以只输出结构化信息,不输出重资源字段,节省存储和带宽。
可以把整套流程理解成:
init():我要看什么 + 我要记什么;eval():每来一帧,我更新状态、记下中间事件;analysis():这一段看完了,我输出一个结构化结论。
三个方法接口在云端 / 车端 / 仿真端完全一致,
差异全由 Runtime 层屏蔽。
4.3 急刹 Trigger 也是这么长出来的
前几篇提到的“万公里急刹 MPI”的精确口径,其实背后就是一组 Trigger:
- 判断急刹的特征:
- 100Hz 姿态数据上的加速度阈值;
- 是否过滤掉低速小抖动;
- 在多帧上积分 / 平滑;
- road_case 切片规则:
- 一分钟内多次急刹算一次 road_case;
- 用 microlog 回刷 MPI 的精确逻辑。
这些逻辑都在 Trigger 库里固化成代码,经团队内部确认后公示、评审后合入仓库:
- 云端回刷历史数据 → 执行的是这一套 Trigger;
- 车端在线检测体感事件 → 执行的还是这一套;
- 仿真里评测 MPI / 体感指标 → 也是同一套。
所有“急刹怎么算”的争议,都可以直接“对着代码说话”,
不再出现云 / 车 / 仿真口径不一致的情况。
4.4 Trigger 的跨平台执行:甚至可以在纯前端网页里跑
为了让一线同学调试更方便,Trigger 框架在跨平台这件事上做得比较极端:
- 云端 / 仿真端:
- 直接在服务端 Python 环境中跑 Trigger;
- 云端是 ODPS + Python UDF,仿真端是本地 / 集群执行。
- 车端:
- 嵌入式 Python + C++ 加速库,运行在沙箱环境里;
- 与主算法流程隔离,只在闲时 / 限定资源下执行。
- 纯前端 Web 环境:
- 使用 JS 版 Python 解释器(例如 Pyodide 这类技术路线),
- 也可以把 Trigger 脚本加载到浏览器里执行。
这样研发 / QA / 运维可以在一套 Web 工具里做到:
- 选一个 case;
- 选择一条 Trigger;
- 点击“执行”,在浏览器本地就能看到 Token / 事件结果,
- 完全不需要本地搭 Python 环境,极大降低调试门槛。
4.5 框架库 vs Trigger 库:双仓架构与发布流水线
整个 Trigger 体系在工程上不是一个“大杂烩仓库”,
而是刻意拆成了两个代码库:
- 框架库:Trigger Runtime + 多端适配 + 性能优化 + 可视化增强
- Trigger 逻辑库:具体各类 Trigger 规则,由研发共同维护
4.5.1 框架库:核心 Runtime + 各平台适配
框架本体在一个独立仓库里,由少数几个核心开发维护。包含:
-
init / eval / analysis 的调度逻辑; - 云端 ODPS / 车端 Orin / 仿真平台 / Web 前端 的多端适配;
- 通用高性能工具(C++ 几何库等),并对外暴露统一 Python 接口;
- 通用的可视化增强能力。
框架发版流程:
- 打 Tag → 编译 / 打包成各平台可用执行包;
- 发布到内部包仓库 / 分发服务;
- 云端 / 车端 / 仿真在执行 Trigger 时,按指定版本号拉取框架本体。
好处:
- Trigger 作者只依赖稳定的框架接口,不需要知道 Orin / ODPS / 浏览器如何适配;
- 线上定位问题时,只要说明“Trigger 版本 + 框架版本”,就能完整复现环境。
4.5.2 Trigger 逻辑库:研发共建 + CI + 自动化测试
每一条 Trigger 的业务逻辑(急刹、大转向、停车不走、模块级中间结果 Trigger 等), 统一放在另一个仓库:
- 仓库对算法 / QA / 数据同学开放;
- 每条 Trigger 有自己的文件 / 元数据;
- 仓库接入 CI 流水线和自动化测试卡口。
合入流程:
- 所有修改必须走 CI:
- 运行框架提供的单元测试 / 回归测试;
- 校验不会破坏现有 Trigger 行为;
- 一级指标相关 Trigger 还有专门回归用例;
- 所有测试通过后,才允许合入主干。
针对需要下发到车端执行的 Trigger,还有一道台架性能闸门:
- 在台架上用真实 / 录制数据流跑 Trigger;
- 统计 CPU / 内存 / 带宽消耗;
- 只有性能达标的 Trigger 才允许打上“可下发车端”的标记。
这样:
- Trigger 逻辑可以自由演进,越来越多、越来越复杂;
- 但跑在车端的那一小撮,都是在性能约束下挑出来的轻量子集;
- 云端 / 仿真则可以充分使用全部 Trigger 做分析。
4.6 大模型 + RAG:Trigger 编写有了“专属 AI 助手”
Trigger 体系一旦搭好,会有一个自然的演化:
不同模块的同学开始写越来越多的 Trigger。
目前除了一级指标相关少数几条 Trigger,
各模块同学已经写了几百条 Trigger,其中大量用来解析算法中间结果、辅助问题分类。
为了降低 Trigger 的编写门槛,我们干了两件事:
1. 把框架说明和示例 Trigger 写成提示词 + 文档
- 把
init / eval / analysis 的用法、常见模式、注意事项写清楚; - 把已经发布的 Trigger(急刹、大转向、停车不走、典型模块问题)整理成知识库。
2. 用这些文档 + 历史 Trigger 作为 RAG 知识库,做一个“Trigger 编写助手”
- 研发同学只需要用自然语言描述需求: > “我要监控感知模块中某类目标,在 3 秒内尺寸变化超过 3 倍,且车辆速度 > 20km/h 的场景。”
- AI 助手会:
- 自动生成 i
nit() 需要订阅的 channel 和字段; - 生成
eval() 的状态机骨架代码; - 生成
analysis() 的标准输出结构; - 参考历史相似 Trigger 的实现,给出可复用片段。
最终效果是:
很多原来只有“资深算法工程师”写得出来的 Trigger,
现在一线研发同学也能快速写出规范实现,
并且通过 CI / 台架闸门后,变成可复用的“可执行经验”。
这些 Trigger 不仅帮助各自团队排查问题,更重要的是:
把原本散落在脑子里的调试经验,沉淀成了代码,
变成整个系统的“知识库 + 工具箱”。
五、从 Trigger 到 Case:异常事件是怎样被“长出来”的?
有了统一 Trigger 之后,一次异常是如何从“体感表现”一路长成结构化的 case 的?
大致流水线是这样:
1. 体感 Trigger 发现“可疑事件” → 生成 road_case
- 例如急刹、大转向、停车不走等一级体感指标;
- 子 Trigger 在秒级 / 100Hz 姿态数据上扫描,一旦命中,就以“自然分钟”为粒度切出一段时间片;
- 这一分钟的时间片会被赋予一个
road_case_id,这一分钟内所有命中的 Token 都挂在这个 case 下。
2. microlog & mini log 为 case 提供“证据包”
- microlog:无损的姿态 / 算法关键指令二进制包;
- mini log:压缩后可视化的最小 channel 集(轨迹、障碍物、红绿灯、车道线等);
- 云端根据体感 Trigger 命中情况,决定这一段 case 需要上传 / 保留哪些 microlog / mini log 切片。
3. 云端 Trigger 在这段 case 上做“第二轮精细识别”
- 在 microlog / mini log 的基础上,再跑一轮更复杂的 Trigger:
- 感知相关(漏检 / 误检 / 尺寸估计错误 / 轨迹跳变);
- PnC 相关(纵向 / 横向振荡、长时间犹豫);
- 定位 / 地图 / 硬件相关(定位跳变、地图元素缺失、底盘异常等)。
- 这些 Trigger 产出的 Token 会补充到
road_case 下。
4. 从一个 road_case 拆出多个 bad_case(按模块 / 问题划分)
- 一个
road_case 可能同时涉及多个模块问题:
- 感知误检 + PnC 跟车策略保守;
- 我会从同一个
road_case 派生出多个 bad_case_id: -
bad_case_id_p:归感知; -
bad_case_id_c:归 PnC; - 每个
bad_case 在时间窗 / Token 子集上略有差异,方便分发给对应团队。
5. 所有 case / Token / 标签,最终落到统一的数据表上
-
road_case 表:按体感事件切出来的一分钟级 case; -
bad_case 表:按模块 / 问题拆分出来的子 case; -
case_token 表:case 内的 Token 序列(时间戳 + 类型 + 属性); - 后续的自动分类、聚类、头部问题统计,都从这里出发。
可以理解为:
Trigger 负责在时间轴上不断产生“局部判断”;
Case / Token / 标签体系把这些局部判断串成了一段段“完整的故事”。
六、问题分类:从规则树到 LLM + Trigger Token 的闭环分类器
有了 Token 序列,剩下的问题就是:
“这一段 case,应该叫什么问题名?该分给哪个团队?严重程度如何?”
6.1 第一阶段:纯规则树分类
最早时,我们用纯规则树做分类:
- 先看有没有感知类 Token(比如 perception_box_jump);
- 再看是否伴随急刹 Token;
- 再看场景(路口 / 干线 / 场内 / 雨天等);
- 一层层 if/else 下去,最终输出:
- 一级模块(感知 / 预测 / PnC / 定位 / 场景 / 硬件 …);
- 二级问题类型(漏检 / 误检 / 尺寸估计错误 / 轨迹跳变 / 刹车超调等)。
优点:可解释,逻辑清晰。
缺点也明显:
- 规则全靠有经验的人写;
- 一旦组合情况变多,逻辑树非常难维护;
- 新问题出现时,很难快速扩展。
6.2 第二阶段:Trigger Token 序列 + LLM 做 Classifier
在积累了足够多 case 之后,我们开始让 LLM 站到规则树肩膀上:
1. 把 Trigger 产出的 Token 序列转成“事件脚本”文本
- 例如:
- 第 3 秒,前方一辆小客车的感知框宽度从 1.2m 变为 3.5m;
- 第 4 秒,该目标的速度估计从 10km/h 变为 -5km/h;
- 第 5 秒,车辆纵向加速度达到 -3.5m/s²,触发急刹;
- 当前场景:城市园区,非机动车道,周围有多名行人……
- 再拼上秒级标签(天气、路型、车速范围等)。
2. 把这段脚本丢给 LLM,让它输出“问题标签”
- 模块归属:感知 / 预测 / PnC / 定位 / 硬件 / 场景;
- 问题类型:漏检 / 误检 / 尺寸估计错误 / 跟车策略保守 / 刹车过猛等;
- 严重程度:致命 / 严重 / 一般 / 轻微;
- 建议分发团队 / 责任小组。
3. 把自然语言结果映射回结构化字段
- 用统一 schema,把 LLM 输出的自然语言转换成结构化字段:
-
problem_module、problem_type、severity、assign_team 等;
- 回写到
bad_case 表中,对每一条 bad_case 做自动分类。
用前文那句“装一点”的说法:
Trigger 在这里扮演 Tokenizer 的角色,
LLM 扮演 Classifier 的角色。
- Trigger 做特征工程 + 时间序列 Token 化;
- LLM 在 Token 序列的语义空间中完成分类与归因。
七、自动分类之后:自动提单、自动回归、自动 Close 的工单闭环
仅仅“给每个 case 打上问题标签”还不够,真正有价值的是:
这个问题从被发现,到验证是否已解决,尽量都不需要人反复在系统之间跑腿。
在 Trigger + LLM 自动分类之后,我们又往上叠了一层“工单 + 仿真”的自动闭环。
7.1 自动提 Aone 工单:模块、描述、紧急程度都自动带上
当一条 bad_case 被 LLM 分类好之后,我们会把它自动转成一条结构化工单(以 Aone 为例):
- 工单标题:
- 由 LLM 根据 Token 序列 + 场景标签生成一行摘要;
- 尽量包含“场景 + 模块 + 表现”,比如: > 【园区-低速-雨天】感知误检消防栓为儿童导致急刹
- 工单描述:
- case 的事件脚本(LLM 生成的自然语言描述);
- 核心指标(MPI / MPS / 是否造成 MPD);
- 场景信息(道路类型、天气、车速范围、地图要素等);
- 关键 Token 序列及时间戳。
- 自动填入:
- 附件 / 链接:
- 对应的 mini log 回放链接;
- 关键帧截图(如果有);
- 数据平台 / 仿真平台跳转链接。
- 模块归属与责任团队:
- 直接用自动分类结果填 assign_team;
- 也可以根据团队维护的路由表二次映射到具体责任人。
- 紧急程度(优先级):
- 不再完全靠人工拍脑袋;
- 由一套“规则 + LLM”混合策略给出:
- 如果命中 MPD(资损 / 有人受伤 / 明显危险),直接打到最高级;
- 如果 MPI / MPS 有明显恶化趋势,在某个园区集中暴露,优先级提高;
- 否则交给 LLM 在上下文中综合判断成「致命 / 严重 / 一般 / 低」。
最终,Aone 里出现的是一条几乎不用再补充背景信息的工单,
研发点开就能直接干活,而不是先花半小时还原现场。
7.2 自动加入对应团队的仿真回归集
每一类问题本质上都对应一批“典型 case”。
自动提单之后,我们同时会:
- 把这条
bad_case 加入到对应团队维护的仿真回归集合:
- 感知团队:典型的误检 / 漏检 / 尺寸估计问题集;
- PnC 团队:典型的急刹 / 大转向 / 停车不走;
- 定位 / 地图团队:典型的跳变、地图缺失场景;
- 这些集合本身在仿真平台里就是一个个“回归测试集”,
与 CI / 准出流程是打通的。
这样,每一个新发现的问题,不仅有工单,
还自动变成了后续版本必须回归的一条样本。
7.3 多版本共存:用最新准出版本自动跑回归,看问题是否已解决
L4 量产环境一个现实情况是:线上一定是多版本共存,
有些老版本的问题,在新版本上可能已经被修掉了。
为了避免“同一个问题被不同版本重复提单、重复验证”,
我们在 Dify 工作流里这样串联:
- 当某条工单关联的
bad_case 已经被加入回归集合后:
- 每次有新的“准出版本”上线前,
- CI 会自动在仿真平台用最新准出版本跑一遍这批 case。
- 仿真回归结果通过 MCP 接口反馈给大模型 / 工作流:
- 如果在最新准出版本上,这批 case 全部过掉:
- 即使线上老版本还存在这个问题,也会标记: > “新版本已修复,老版本问题无需继续推进,只要等待升级。”
- 如果最新准出版本仍然失败:
- 工单保持打开状态,继续提醒对应团队处理。
- 对已经上线一段时间的老问题:
- 工作流会定期检查:
- 关联的准出版本是否已经通过这批 case 的回归;
- 一旦确认某个问题在新版本上稳定通过且已大面积升级:
- 可以自动把工单状态改为“已在版本 X 中修复并验证通过”,
甚至直接 Close(视团队流程而定)。
这样,多版本共存不再变成“大量重复劳动 + 无穷无尽的追问”,
而是由仿真回归 + 工作流自动回答:
“这个问题在最新准出版本上是不是已经被解决了?
如果解决了,老版本就不要再反复折腾。”
7.4 用 Dify 串起 LLM + RAG + MCP:把系统接口当“工具”用
整条链路看下来,其实大模型做的是“脑”,
但真正跑腿的是一堆具体系统:
- 数据平台(FastDM / 标签库 / case 库);
- 仿真平台(导入 case、触发回归、拉结果);
- Aone(创建 / 更新工单);
- 各种内部服务(版本信息、责任团队路由表等)。
为了不让 LLM 变成“写文案的挂件”,
我们用开源的 Dify 把这一堆能力串成一个完整工作流:
- 每个外部系统的接口(REST / RPC)都被封装成一个 MCP 工具;
- LLM 在 Dify 流程里看到的是“可以调用的一组函数”:
-
create_aone_ticket(...) -
add_case_to_sim_suite(...) -
query_latest_release_version(...) -
update_ticket_status(...)
- RAG 知识库中存的是:
- Trigger 文档;
- case 字段含义;
- 各团队负责模块说明;
- 历史问题的处理经验等。
工作流大致逻辑是:
识别异常 → 找到对应 bad_case → LLM 归因 & 分类 →
调用 MCP 创建工单 + 更新仿真回归集 →
等待仿真回归结果 → 再次调用 MCP 更新工单状态。
整条链路从工程角度看非常干净:
系统之间是接口对接,大模型只是决策层的“胶水”和“翻译”。
7.5 钉钉机器人前端:运维在群里发截图就能拉起工作流
为了让一线运维 / 运营真正用起来,我们没有要求大家登陆各种平台点来点去,
而是做了一个很简单的入口:钉钉机器人。
- 在每个关键运维群里,都拉了这个机器人进来;
- 当运维同学遇到一个现场问题:
- 直接在群里发一张截图(云端座舱画面 / 报错界面);
- 顺便打一两句自然语言描述;
- 机器人后面的工作流会做几件事:
- 用多模态大模型(VLM)理解这张截图 + 文本;
- 去数据平台里自动对齐到对应的 case_id / 时间窗口;
- 根据问题初筛的结果判断优先级以及创建对应数据上传任务
- 数据上传之后跑云端的分析trigger并且生成该 case 的 Token / 秒级标签 / Trigger 结果;
- 调用问题分类的工作流:
- 自动归因 + 分类;
- 自动提 Aone 工单;
- 自动加入仿真回归集;
- 把工单链接和回放链接回贴到钉钉群里。
运维同学看到的是:
“我只是在群里说了一句‘这辆车刚才莫名其妙急刹了一脚’,
结果工单已经在 Aone 里起好了,仿真回归也准备好了。”
而一线研发同学看到的是:
群里的“打扰”本质上已经被机器人“缓冲 +结构化”了一遍,
收到的是一个已经带齐现场信息、分类结果和回放链接的工单,
而不是一堆零散的“兄弟你帮我看下这个”。
这就是“自动分类 → 自动提单 → 自动回归 → 自动 Close”的工单闭环。
八、自动分类准不准?用研发的“反手一刀”来评估
自动分类是不是靠谱,不能靠“感觉还行”,
而是要用事实数据说话。
我们的评估方式是:
1. 只统计有“研发反馈”的 case
- 每个
bad_case 最终会落到问题管理系统; - 我们只看“研发同学有回复”的问题:
- 有人认领说明这是他们认可的真实问题。
2. 看研发是否修改了模块 / 类型标签
- 自动分类结果也会显示在问题单里;
- 如果研发认领后:
- 不改模块 / 类型 → 认为这次分类正确;
- 修改了模块 / 类型 → 认为这次分类错误,记为 bad case。
3. 把这些“被改掉的 bad case”,反向喂给 LLM
- 把 Token 序列 + 研发最终结论一起写回 LLM 的 few-shot / RAG 知识库;
- 让下一轮分类更接近真实使用习惯。
这样,自动分类就变成了一个闭环系统:
Trigger 提供稳定的 Token;
LLM 给出初始分类;
研发通过修改问题单提供监督信号;
分类器在使用中持续迭代。
九、从一条条 case 到“头部问题”:聚类只是时间问题
有了:
-
road_case / bad_case; - 秒级标签;
- Trigger Token 序列;
- 自动分类标签(模块 / 类型 / 严重程度);
- 以及“是否已经在最新准出版本上回归通过”的状态;
问题聚类与头部问题发现就有了非常扎实的基础。例如:
- 按模块 / 问题类型 / 场景做 group by,
看一个阶段内各类问题的分布; - 把 case 在地图上打点,看哪些路口 / 路段出现频次特别高;
- 利用 Token 序列模式做聚类 / 统计,
找出一段时间内“重复出现次数最多、影响 MPI / MPD 最大”的那几类问题。
更进一步的 case 相似度聚类、多模态向量检索、自动发现“还没有名字的长尾模式”,
会涉及到向量空间 / Qwen-VL / 多模态 embedding,这一块会专门拆一篇聊。
十、小结:Trigger 框架是数据闭环的“中枢神经”
回头看这一篇,我们其实讲了两层东西:
1. 底层:三端统一 Trigger 框架 + Case / Token 体系
- 解决的是“怎么把异常事件从原始日志中“长”出来”。
2. 上层:LLM + 工作流驱动的工单 & 仿真闭环
- 解决的是“怎么让问题从被发现,到被验证解决,尽量少依赖人肉搬运”。
它把前面几篇搭好的地基串了起来:
- 数据分级上传 + case / 文件逻辑映射;
- 每车每秒标签体系;
- 再到:
- Trigger 统一 Runtime;
- Case / Token 表;
- 自动分类;
- 自动提单;
- 自动仿真回归;
- 自动关闭老问题。
从工程视角看:
Trigger 框架是数据闭环的“中枢神经系统”;
上面可以挂 LLM 做分类与归因;
再往上可以挂问题管理、仿真回归、向量检索、世界模型仿真等更高阶能力。
等后面几篇,我们再从“问题发现与提单”继续往前推,
聊聊如何用这些 Case / Token / 标签,去支撑自动聚类、自动评测、自动回归,
把“bug driven”这条路走得更系统、更可持续。
....
#比亚.迪超越特斯.拉
首次!比.亚.迪超.越.特.斯.拉,全球电动汽车销量第一
美国电动汽车制造商特斯拉公司2日公布的数据显示,该公司2025年全球交付汽车163.6万辆,同比下降约8.6%。这是特斯拉有史以来首次在全年电动汽车销量上被中国汽车制造商比亚迪超越。
特斯拉表示,该公司2025年第四季度共交付41.8万辆汽车,同比下降15.6%,低于分析师预期的约43.4万辆。全年交付量为163.6万辆,较2024年的179万辆明显下降,也低于市场预期的约165万辆。
中国汽车巨头比亚迪1月1日发布的数据显示,比亚迪2025年总体新车销量超460万辆,同比增长约8%,其纯电动汽车新车销量超225万辆,同比增长约28%。比亚迪首次登顶全球纯电动汽车销量榜。
与此同时,比亚迪内部也在抓紧智能驾驶的研发进度,25年二月初发布天神之眼,打响了智驾平权的第一枪。
据xxx了解到的信息,内部也在加快端到端的研发,希望26年能给我们带来新惊喜。
我们也来复盘几家头部新势力的销量情况。
零跑汽车以全年交付596,555辆,同比增长103.1%的成绩,成为新势力最大黑马,超额完成50万辆的年度目标,达成率119.31%。
小米汽车以全年交付35万辆、达成率108.57%的成绩,成为新势力中增速最快的品牌。
小鹏汽车全年交付429,445辆,同比增长125.94%,达成率122.7%,虽12月交付量(37,508辆)未达四季度指引,但全年增长势头强劲。
理想汽车全年交付量406343辆,同比下降18.81%,完成70万辆目标的58.05%。
蔚来汽车全年交付326,028辆,同比增长46.88%,完成44万辆目标的73.42%。
....
#Momenta和华.为智.驾谁能胜出?
中国市场太卷了,智驾没有芯片根本没有议价权。
我们回顾历史来说明一下。历史虽然不能说明一切,但是历史却是现实的一面镜子。
在 2004 年至 2010 年间。全球视频监控市场正经历从模拟信号向数字和网络监控。
当时的行业话语权掌握在德州仪器(Texas Instruments, TI)和安霸(Ambarella)等老牌半导体巨头手中 。
TI 作为通用 DSP(数字信号处理)领域的霸主,其方案如经典的 DM365、DM368 系列芯片,本质上是通用的计算引擎。
这意味着下游的安防器材厂商不仅要购买昂贵的芯片,还需要配备庞大的软件团队,在底层的 DSP 上进行极具挑战性的视频编解码开发和图像算法调优。
对于当时的中小型安防企业而言,TI 的方案就像是一个没有说明书的精精密复杂“黑盒”。
下游厂商需要投入长达一至两年的研发周期,才能推出一款勉强可用的数字摄像机产品。
而安霸则走在另一条路上,其方案虽然图像效果卓越,但定位极高端且架构相对封闭,昂贵的“入门费”让大多数中国厂商望而却步。
当时的市场格局是:芯片厂商只管卖硅片,而软件和应用算法的重担全部压在缺乏技术积淀的设备商身上。2004 年海思成立初期,在公开市场上几乎处于边缘地位。
然而,华为敏锐地察觉到了安防行业向数字化、高清化转型的趋势。
2007 年,海思通过与大华股份签订 H.264 视频编码芯片合同,正式切入安防赛道。
海思之所以能迅速席卷市场,核心在于其对“买芯片,送解决方案”这一商业模式的极致运用。
与 TI 的通用架构不同,海思将复杂的视频编解码算法、图像处理算法(ISP)甚至最初级的人工智能算法,通过硬件加速的方式直接固化在 SoC 芯片内核中。
海思提供的不只是硅片,而是一整套“交钥匙”(Turnkey)解决方案。这意味着下游厂商(如海康威视、大华股份等)不再需要高深的算法积累,只要按照海思提供的参考设计进行简单的硬件集成和应用软件开发,就能在几个月内推出高性能、低功耗的产品。
这种模式对 TI 和安霸构成了致命的“降维打击”。
海思方案不仅降低了技术门槛,更通过规模化效应大幅削减了成本。
到了 2010 年以后,海思大规模进入全球最大的安防厂家海康威视,其 DVR 芯片在鼎盛时期占据了全球 79% 的市场份额。
TI 最终因无法跟上这种“算法与芯片深度绑定”的迭代节奏,于 2016 年左右逐渐退出了安防市场 。
这种海思在IPC SOC视频监控芯片中一家独大的局面,一直持续到台积电不让海思流片为止。
海思的真正高明之处,在于其在芯片端直接打包赠送了原本昂贵的算法。最为经典的案例是“车牌识别”算法的免费集成。
通过在芯片端固化这一识别能力,海思直接催生了“无卡停车”这一巨大的蓝海市场 。
这种将核心应用能力“预置化”的做法,使得华为海思在 IPC SoC 领域建立了一种基于“效率与成本”的行业统治力,让中国安防产业在全球范围内实现了从“跟随”到“主导”的跨越。
这段往事向我们展示了一个核心真理:在技术变革期,谁能通过底层技术的垂直整合,极大地降低下游客户的开发难度和使用成本,谁就能最终掌握行业的定价权和统治权。
说道,这里,大家肯定以为我在吹华为乾崑 ADS。
不过,我觉得,Momenta的对手,不是华为乾崑 ADS。
可能是地平线。
地平线创始人余凯曾表示地平线是“软件公司伪装成的芯片公司”。
其自研的 SuperDrive (HSD) 方案是国内首个全栈自研的城市智驾系统。
地平线通过自研 BPU 架构芯片(如征程 6P)深度优化算法表现,打造其“样板房”方案。
目前看,Momenta的竞争对手不是华为,而是地平线。
地平线的 HSD 正在挤压第三方算法供应商的空间。
在 2026 年前的智驾“大逃杀”中,谁能率先通过垂直整合将城市 NOA 方案做到“既好用又便宜”,谁就能垄断中国 70% 的中低端汽车市场。
通过我和车企交流,基本上,要是在车企上部署软件,特别是出货量大的车企,其对软件供应商的提出的压榨要求,还是令人发指的。
所以,能够提供从智驾芯片到智驾方案一体的公司,天然的就有更多的筹码。
如果说海思在 IPC 时代的成功是基于芯片层面的整合,那么华为乾崑 ADS 则是要在汽车空间内实现“芯-硬-软-云”的全栈闭环。
并且,大家别忘了。
还有一众厂商的自研芯片+智驾方案。
比如比亚迪,比如蔚小理。
在 IPC 时代,华为海思通过“买芯片送方案”击败了 TI;在智驾时代,华为正在试图通过“入股引望送品牌赋能”来重演这段历史。
然而,汽车产业的复杂度远非监控芯片可比,其对品牌调性、全球化准入以及“灵魂控制权”的敏感,为其他厂商留下了宽广的战略纵深。
但是,这些战略纵深,更是从芯片+智驾方案的垂直整合的供应商。
而,我更看好地平线,如果没有地平线,也有其他的智驾芯片+智驾方案一体厂商的出现。
或者,这样的问题,我们也可以问问车企自己。
车企在智能化转型中主要面临三种路径的选择:全栈自研(封闭系统): 对于追求极致差异化和掌控力的车企,自研芯片是实现软硬一体化的最优路径。这种模式虽然能达成最佳性能,但更像是一个服务于自身品牌的“封闭系统”,研发成本极高。
“买芯片+改方案”的灵活模式: 这正是地平线与 Momenta 争夺最激烈的阵地。地平线将其定位为“武器库”,提供从芯片 IP 授权、工具链协作到“样板房”级应用算法开源的多种开放模式。车企可以根据自身研发能力,在地平线的底层架构上进行二次开发。
深度绑定技术合伙人: 随着竞争加剧,过去车企追求的软硬解耦(白盒交付)正在向深度绑定的“共生”模式转变。车企通过与 Momenta 或地平线建立联合开发体系,来对冲研发成本失控和人才稀缺的风险。
在未来,智驾方案正不可逆转地走向标准化。
智能驾驶域控方案的供应格局将趋于收敛,智驾方案的标准化程度将显著提升。
2026 年被视为 L3 级自动驾驶的转折点。
届时,行业将从依靠“配置冗余”的探索阶段,迈向硬件配置、算法、算力协同方案统一的新阶段。
这种标准化将成为相关法规制定和产品规模化落地的根本前提。
未来的标准化方案将不再仅仅比拼技术上限,而是比拼“系统效率优化”。
地平线依托超过 1000 万套的芯片出货量,地平线已经在大量国产自主品牌中形成了事实上的硬件底座标准。
总结而言,车企最终会投票给那些能够提供“高兼容性、低成本且符合标准化趋势”的平台。
在 2026 年行业“大逃杀”结束前,谁能率先定义 15 万元级别车型的智驾标准方案,谁就能掌握行业的话语权。
从这方面来看,除去车企自研之外(看好比亚迪的自研芯片,能够有效的分摊成本,毕竟一年几百万辆车。)
这个以后会越来越多,传统的供应商模式,在智驾这个时代,水土不服。
其他家能够采用的,大概率就是
中高端华为的乾坤智驾方案,
中低端地平线全栈交付方案。
其他的不太乐观。
....
#特斯拉FSD首次横穿美国
Model3实现1万英里零干预,马斯克预言兑现了
在 2025 年最后一天,一个名为 David Moss 的小哥完成了一项壮举:
成功实现世界上首次美国西海岸到东海岸的全自动驾驶.之旅,同时也成为世界上第一个连续驾驶特斯拉 FSD 行驶 10000 英里的人。

他开着一辆搭载 FSD V14.2 的 2025 款 Model 3,从洛杉矶的 Tesla Diner 出发,历时 2 天 20 小时,走了 2732.4 英里(约 4400 公里),最终抵达南卡罗来纳州的 Myrtle Beach。

一起完成壮举的搭档
整个过程零干预,甚至包括所有停车和在 Tesla 超级充电站充电的环节都没有人为接管。

他特别强调这是完全靠 FSD 完成的,并且数据可以通过 Whole Mars 的 FSD 数据库公开验证。

你可在这里追踪他的 FSD 里程 https://fsddb.com/profile/DavidMoss,数据显示,他使用 FSD 在 Model 3 上行驶了 1 万多英里,从未亲自驾驶过车辆。
Moss 在一张地图上详细标注了横跨美国的路线图:

并列出了大约 30 个超级充电站的几乎完整的停留信息:

有网友在评论区询问:过程中是否出现过险情,Moss 表示完全没有。即使对于人类驾驶员来说,这也是不容易实现的。

马斯克看后直接转发并回复「Cool。」

特斯拉 AI 主管 Ashok Elluswamy 称赞道:「这是世界上首次全自动海岸到海岸驾驶,感谢 David Moss!」

马斯克预言终兑现
Andrej Karpathy (特斯拉自动驾驶团队前领导、OpenAI 创始成员)也在第一时间发来贺电。他说,横跨美国的 coast-to-coast 自动驾驶,一直是 Autopilot 团队从立项之初就设定的目标。
事实上,马斯克最初预计,这一里程碑可以在 2017 年底实现。
「为了完成它,团队投入了大量时间。无数个深夜,大家围坐在一起进行马拉松式的片段复盘,一条条查看自动接管的录像:先分流、再归类、再拆解问题,逐项规划项目,把每一个缺口补上,目标只有一个 —— 把干预次数降到零。」

FSD v14.2(Full Self-Driving v14.2)是特斯拉在 2025 年底推出的一次关键自动驾驶软件更新,属于其 FSD 路线的最新进化版本,也允许用户跟踪他们在自动驾驶模式下行驶了多少英里。
相较此前的 v14.1.x,这一版本在驾驶表现、感知能力和决策逻辑上都有明显强化。
从特斯拉官方和社区的普遍反馈来看,FSD v14.2 明显朝着「更像人开车」演进。它在感知和决策上更稳定,对复杂路口、无保护左转、车道博弈的处理更果断,整体驾驶节奏更连贯。
虽然从定义上看,它依然是需要驾驶员监督的 L2 级系统,但在真实道路中的完成度已经显著提升。
小鹏汽车 CEO 何小鹏曾这样评价特斯拉 FSD v14.2:「我最近在美国花了四个小时试驾了特斯拉的 FSD V14.2。一句话总结:如果 FSD 在 2024 年仅仅是『不错的 L2 级驾驶辅助』,那么这个最新版本让我相信 L4 级自动驾驶指日可待。」

特斯拉 vs Waymo:两条路线的较量
消息刷屏后,有 X 友 Yuchen Jin 向 Andrej Karpathy 抛出了一个尖锐的问题:你现在还认为 Waymo 的软件更好吗,还是特斯拉已经领先了?
要知道,Karpathy 过去的判断是 ——Waymo 有硬件问题,特斯拉有软件问题。
他回复说,如今两者都堪称「完美驾驶」,虽存在差异,但要么需要时间才能显现,要么只能在大规模车辆数据中被统计出来。

不久前发生在旧金山的一次停电,或许提供了一个现实注脚。停电导致 Waymo 的服务大面积中断,而特斯拉 FSD 基本未受影响。
网友分析指出,原因在于两条技术路线的根本差异。
Waymo 采用高度模块化的系统,依赖高清地图、激光雷达、多传感器融合、5G 网络以及多套神经网络协同工作。在一切条件正常时,它表现非常出色。但只要其中一个关键模块失效,系统就会迅速退化。
当交通信号灯断电后,现实世界已经发生变化,而 HD 地图无法即时反映,车辆无法确认状态,只能回退到最保守的策略 —— 直接停车(brick 模式),车辆还失去了与远程人工接管员的连接,进一步放大了系统的脆弱性。
而特斯拉 FSD 走的是端到端:一个巨大的神经网络,直接把摄像头的像素输入,转换为转向和制动控制。这正是 Andrej 所提出的 Software 2.0 思想 —— 不再为每一种场景手写 C++ 逻辑,而是用数十亿英里的人类驾驶数据去训练模型,代码本身就是模型权重。因此,它的驾驶方式更像人类。
一些观察者认为,如今真正面临软件瓶颈的,反而是 Waymo。模块化架构在规模化与依赖关系上,可能是一种长期的陷阱。长期来看,赢家会是特斯拉 FSD。

迈向真正的自动驾驶
122 年前,汽车先驱 Horatio Jackson 和 Sewall Crocker (以及他们在途中收养的斗牛犬)曾从旧金山驾车前往纽约,用整整 63 天 横穿美国,只为证明汽车并非昙花一现的新奇玩意。
他们因此成为历史上第一批驾车横跨美国的人类 —— 以及那只狗。

今天的这场壮举,或许只是自动驾驶迈出的一小步,但对「自动驾驶即机器人」而言,却可能是一记关键跳跃。
马斯克正在持续加码无人驾驶。6 月,特斯拉已在德克萨斯州奥斯汀推出一项有限规模的机器人出租车服务,使用的是搭载 FSD 的改装版 Model Y。更值得注意的是,马斯克近期透露,这批车辆已进入前排不再配备安全监控员的测试阶段。
从「有人盯着的自动驾驶」,到「系统自己负责」,这一变化幅度貌似不大,却触及了自动驾驶从辅助工具走向真正自主体的临界点。
参考链接:
https://x.com/DavidMoss/status/2006255297212358686
https://x.com/karpathy/status/2006436622909452501?s=20
https://x.com/Yuchenj_UW/status/2003173409665212629?s=20
https://x.com/SawyerMerritt/status/2006042728983908626?s=20
https://x.com/SawyerMerritt/status/2006042725385195766?s=20
https://x.com/elonmusk/status/2006290674761736346?s=20
#2# ~ 马斯克10年梦成真!特斯拉全球首次自动驾驶横穿美国,人类0接管
2026年第一天,自动驾驶迎来历史时刻——特斯拉FSD完成人类首次「零接管」横穿美国!全球科技圈都被引爆了,马斯克端到端自动驾驶彻底胜利。方向盘,可以退出历史舞台了?
刚刚,特斯拉FSD,完成全球首个完全自动驾驶的横穿美国。
从今天起,人类的自动驾驶,到达了全新的里程碑!
就在2025年的最后一天,当全世界都在准备倒数跨年时,车主David Moss静悄悄地扔出了一枚深水炸弹——
他驾驶搭载FSD V14.2的Model 3,完成了全球首次、经由第三方数据验证的「零接管」横贯美国之旅。
从美国西海岸开到东海岸,2天20小时,人类0次接管。
物理世界的「自动驾驶奇点」,终于降临!
这条推特,也彻底引爆了全球科技圈和AI圈。
由此,他也成为全世界第一个全程凭借自动驾驶横穿美国的人。
可以说,这是特斯拉正式通过了公路上的图灵测试。

这场AI主导的公路旅行,直接震撼了全球特斯拉车主。
前特斯拉AI总监Karpathy兴奋高呼:这一刻终于来了,这是端到端神经网络的胜利,这是「软件2.0」在物理世界的完全接管,不再需要人类写下的规则!
特斯拉官方账号,表扬了这次壮举。
一位特斯拉车主赞叹:「我们已步入自动驾驶穿越美洲大陆的时代。」
特斯拉掌门人马斯克,也激动转发莫斯的推文:「酷!」
十年前,马斯克许下「Coast-to-Coast」的诺言,2026年1月1日,终于实现了!
或者真如Karpathy所说:从此,方向盘只是车上的一个装饰品?
全球首次
人类零接管
下面这份数据,让人难以抑制心头的震撼。
- 总里程:2732.4英里(约等于4397公里)
- 耗时:2天20小时
- 软件版本:FSD v14.2
- 人工接管:0
当特斯拉从v12开始抛弃传统的C++,转向端到端神经网络,AI就从数百万小时的视频中,真正学会了开车。
在这场横跨美国大陆的旅途中,David Moss没有任何一刻,触摸车里的方向盘,或者踩过踏板!
想象一下:坐在驾驶座上,盯着方向盘整整68个小时(2天20小时),看着它自行转动,穿过繁忙的洛杉矶街道,汇入州际高速,避让加州的摩托车手,在德克萨斯的暴雨中稳住车身,最后停在南卡罗来纳州的海滩边。
他从洛杉矶的特斯拉餐厅出发,最终到达南卡罗来纳州默特尔海滩,穿越了24个州。
如果你亲自开过这段行程,就会明白全程的路况有多么复杂。然而从加州的高速公路,到中部的城市街道,再到东海岸的复杂路况,FSD一次性全部搞定了!
,时长00:30
天气多变,交通拥挤,甚至夜间驾驶、自动化充电,都没让系统掉链子。
Moss评价说——整个过程中,从未出现过一次险情,即使在人类驾驶员中,这也实属罕见。
对于好奇的网友,Moss表示,你可以登录FSD数据库,验证所有数据。
同时,David Moss晒出了充电记录。注意,在所有站点的停车,也都是由特斯拉FSD自动完成的。
这次横穿美国大陆,不仅体现了FSD V14.2的技术能力,也向整个行业证实——
即使在现实的复杂场景,L4自动驾驶也有可能实现!
十几年前,这样的壮举还只是工程师的技术梦想。
从2016年,特斯拉的FSD系统就开始宣传「零干预横贯美国」的目标。
在发布Autopilot 2.0时,Elon Musk就放话,说2017年底就能实现。
这是一个迟到了八年的承诺,但当它终于兑现时,仍然让人感到吃惊!
一位特斯拉FSD的死忠粉
其实在25年底,David Moss就曾创下纪录。
当时,他在特斯拉FSD V14上,连续驾驶了超过10000英里,且全程无干预,实现了真正的100%自动驾驶。
当时的路线图是这样的。
而这个消息出来后,网友们纷纷表示,不可能,这绝不可能!
有人说,自己每天都在用FSD 14.2.2.1,虽然体验很棒,但绝不可能实现完全自动驾驶。
然而David Moss晒出的仪表盘显示,FSD V14千真万确完成了100%的完全自动驾驶。
在去年年底,他就立下宏愿:成为第一个完全依靠FSD用自动驾驶横跨美国(洛杉矶→佛罗里达)的人。
时隔一年,他果然完成了这个目标,实现了一个更宏大的路线图。
这完全出于他对驾驶的热爱,并不是为了炒作。
马斯克:那个「该死的」2017 预言
回到2016年10月。
彼时,马斯克意气风发,豪言:「到2017年底,特斯拉将能够从洛杉矶自动驾驶到纽约,全程哪怕你碰一下方向盘都算我输。」
后来的故事我们都知道了。
2017年过去了,2020年过去了,甚至到了2024年,马斯克不断跳票!
这个承诺就像是一个「永远的明年」。
由于技术路线的反复横跳(从雷达+视觉到纯视觉,从规则代码到神经网络),特斯拉的自动驾驶曾一度陷入瓶颈,甚至被谷歌旗下的Waymo在无人出租车领域抢尽风头。
Gemini生成的特斯拉自动驾驶技术路线图
直到FSD V12 版本的出现,特斯拉彻底抛弃了原来的代码逻辑,转向了「端到端」神经网络。
简单说,就是让AI像人类一样,直接通过看视频学会开车,而不是由工程师一行行写代码告诉它「红灯停、绿灯行」。
尽管特斯拉坚信端到端神经网络技术,但这绝非自动驾驶领域的共识方案。
大多数其他自动驾驶研发公司都采用传感器密集型、模块化的驾驶方式。虽然这类系统在初期开发和调试可能更容易,但其复杂性也不容忽视。
特斯拉AI负责人Ashok Elluswam,在国际计算机视觉大会ICCV介绍了端到端方案的优势:
- 将人类价值观系统化极其困难,从数据中了解它们则容易得多。
- 感知、预测和规划之间的接口定义不明确。在端到端架构中,梯度从控制端一直流向传感器输入端,从而整体优化整个网络。
- 易于扩展,可处理现实世界机器人技术的庞大而长尾需求。
- 具有确定性延迟的同构计算。
- 总的来说,相对于过去的苦涩教训,这种方法在规模化方面处于正确的位置。
更绝的是,为了自动驾驶数据打造的神经网络「世界模拟器」,同样可以模拟多种真实场景,训练擎天柱。。
而这次「人类零接管」的关键在于「端到端」的最后一块拼图。
在V14之前,特斯拉的AI虽然眼神好使(视觉感知强),但脑子里的地图还是传统的导航模块。
这就好比一个老司机虽然车技好,但他脑子里只有一张死板的纸质地图,一旦遇到修路或者地图没更新,就容易发懵。
而在V14.2中,特斯拉将导航和路径规划也整合进了神经网络。
现在的FSD不再是「看着地图开车」,而是像本地人一样,能根据眼前的路况实时理解该怎么走。
一次成功的「零接管」,不等于这套系统已经完美。
统计学告诉我们,如果事故率是万分之一,那么跑一次几千公里的长途可能正好没遇上,但这并不代表它能安全应对几百万辆车的日常通勤。
不过,FSD V14.2的这次表现,最大的意义在于它有力回应了「纯视觉方案无法实现长途全自动」的质疑。
它证明了不需要昂贵的激光雷达,不需要高精地图,仅凭摄像头和算力,AI真的可以处理从繁华都市到荒凉公路的几乎所有场景。
对于普通人来说,这意味着什么?
官方仍是SAE L2(需监督),但车辆完成100%驾驶任务,驾驶员仅作安全监督,完全有可能。
也许,还要等上几个版本,甚至要等到硬件Hardware 5.0的普及,我们才能真正放心地在车里睡大觉。
但看着David Moss那辆横跨大陆的Model 3,那个曾经被嘲笑为「科幻小说」的未来,确实已经把轮胎压在了现实的沥青路上。
参考资料:
https://x.com/DavidMoss/status/2006255297212358686
https://www.youtube.com/watch?v=dnLswbNB0SU&t=4s
....
#某头部~~公司创始团队的“裂痕”
25年对于某头部xx公司来说,可谓是喜忧参半。
一方面,随着资本的追捧,估值不断飙升破百亿,而且订单也不断增长;另一方面,创始人之间也逐渐出现分歧,围绕着是卷量产商业化还是前沿技术,产生了分歧。
该头部xx公司内部创始人之间逐渐出现了两派:量产派和学术派。
量产派,主要是来自于智驾行业背景的。这部分人相信“沿途下蛋”的发展路径,专注于商业化,聚焦于目前能出货的场景和需求,投入资源把量产交付做好,然后把出货量做起来。
学术派,主要是来自于高校教师背景的,也就是业界的学术大牛。这部分人带有一定的学术思维,相信应该“直奔珠峰”,喜欢探索xx技术的上限,认为打造高泛化的模型才是最重要的。
两派人马围绕着该做简单场景还是高难度场景,以及该把资源投向什么方向,产生争论。
两派人马的争论和前几年的自动驾驶相似。众所周知,在20年左右的时候,自动驾驶行业也曾出现过分歧争论:到底应该是“直奔珠峰”做L4还是“沿途下蛋”先做乘用车的量产。
量产派经历过智驾行业的锤炼,目睹过智驾行业的风云变幻,以及许多公司的命运起伏,所以更相信“沿途下蛋“的成长逻辑。而且,今年该xx公司打通了市场销路,订单暴涨。所以,量产派更认为把商业化的量产交付做好是最重要的。
而且,量产派这些人也继承了前东家的风格:非常能卷。比如,今年订单爆了,但因为创始团队之前都是做软件算法的,缺乏xx本体的制造能力,导致每个月手搓的产量只能满足一半订单需求,量产派创始人就亲自带队”头拱地“的卷制造。
朝向量产做商业化,背后有着如何生存的现实考量。xx公司的估值越来越高,一旦超过百亿,资本就不再只是看技术demo展示,而是要评估商业化能力。如果只有算法模型却没有商业化收入规模,后续的融资就会非常艰难。另外,该头部xx公司筹备明后年IPO,IPO也需要一定的商业化收入做支撑。
该头部xx公司两派人马的分歧如何解决是个问题。目前来看,对公司具有主导权的是量产派,量产派的股份多,而学术派的股份少。但在融资过程中,学术派的履历光环起的作用非常大,投资人非常看重。学术派的走和留,会影响到后续的融资。
其实不止该头部xx公司,一堆的xx公司里面CTO、首席科学家都是找了学术大牛担任。许多学术大牛原本是不看好xx创业的,但因为从去年开始资本疯狂追逐xx,xx公司估值疯狂飙涨,所以才选择加入。不过,大多数是类似兼职的方式,一边在高校做着科研,一边拿着xx公司的股份,并没有All in进去,甚至有一些认为学术前景更重要。
一位投资机构的朋友表示,以前机构都是非常忌惮这种兼职行为的,但因为机构都在哄抢xx的投资机会,所以就没那么计较了,不过目前来看这会引发一系列问题。
....
#L4数据闭环最重要的第一步
选对整个组织的LossFunction
前言:看到一个问题有感而发写了一个关于数据闭环的整体的文章,发现引起了很多同学的共鸣,那就再写一写里面我认为很关键的点(踩坑记录),希望也给还在做自动驾驶的各位同学一些不一样的思路。
原问题:目前各家做的自动驾驶数据闭环平台真的闭环了吗?
【数据闭环驱动问题解决·01】
把自动驾驶团队当成一个强化学习模型:
为什么我放弃 MPI,改用 MPS / MPD 做“损失函数”?
2025 年都快结束了,我也来分享一下我们在做数据闭环过程中,踩过的一些坑。
先简单自报下家门:
我在自动驾驶行业做数据相关已经 7 年多了,从最早拿着硬盘从工控机里拷数据,一路做到现在负责一条 L4 物流无人车线上的 数据闭环 & 质量体系。
这几年做下来,我越来越确信一件事:
如果把整个自动驾驶组织想象成一个强化学习模型,
那么我们定义的一级指标,其实就是这个模型的「损失函数 / 奖励函数」。
- 你告诉这个“大模型”什么是好(奖励),什么是坏(惩罚),
- 它就会沿着这个方向不断“梯度下降”:
算法怎么改、策略怎么调、运营怎么排、运维怎么干,
都会被这几个指标牵着走。
也就是说:
一级指标选什么,本质上决定了整个组织在往哪儿“收敛”。
而在自动驾驶里,最常被当成“一级指标”的,是 MPI(Miles Per Intervention)。
但我自己的实践结论是:
MPI 很适合拿来汇报和做健康度侧影,
但非常不适合当成「驱动问题解决」的损失函数。
我们现在真正挂在墙上的,是两类东西:
- MPS:Miles Per Stupid
——每发生一次「不智能表现」(Stupid 行为),平均跑了多少里程; - MPD:Miles Per Dangerous
——每发生一次「危险行为 / 险情 / 事故」(Dangerous 行为),平均跑了多少里程。
从强化学习视角看:
- MPI 优化的是:“人多久来救一次场?”
- MPS / MPD 优化的是:“车自己干蠢事 / 干危险事的频率能不能降下去?”
后者,才更接近我们真正想要的“系统表现”。
这篇就来详细讲讲:
为什么我不再用 MPI 做一级指标,以及我们是怎么用 MPS / MPD + 一堆 Trigger,搭出一套真正自我迭代的数据闭环的。
一、先把组织当成一个大模型:一级指标 = 损失函数
先抽象一层。
在我们这条 L4 物流无人车线里,整个「数据闭环」的形态,其实非常像一个强化学习系统:
- 环境(Environment):真实道路、园区、天气、路侧设施、其它交通参与者;
- Agent:不只是车上的算法,还包括云端调度、远程驾驶策略、运维 / 运营流程;
- 状态(State):传感器数据、地图信息、车辆状态、上游系统的各种输入;
- 动作(Action):转向、油门、刹车、停车、请求远程接管、通知运维等;
- 奖励 / 惩罚(Reward / Penalty):各种「好表现 / 坏表现」事件,被我们打成标签,反馈回各个团队,驱动他们改代码、调策略、改流程。
你可以粗暴地把「整个组织」的更新过程想象成:
- 车每天在真实环境里跑,产生大量行为轨迹;
- 通过 Trigger + 指标体系,我们从这堆行为中提取出各种「该奖励 / 该惩罚」的片段;
- 感知 / 规控 / 地图 / 硬件 / 运维 / 运营等团队,基于这些片段更新自己的「参数」:模型、规则、阈值、SOP;
- 新版本上线,再看这些指标有没有朝「我们想要的方向」收敛。
在这个视角下:
一级指标就是整个组织共同在优化的「损失函数」。
- 指标选对了,组织就会 朝你想要的行为分布收敛;
- 指标选错了,组织会非常努力地「梯度下降」,结果越干越偏。
所以,“数据闭环驱动问题解决”的第一步,其实不是「上了多少 GPU、用了什么大模型」,而是:
先想清楚:
我到底用什么指标来衡量「跑得好不好」?
我到底给整个组织设计了一个什么样的损失函数?
二、为什么 MPI 做不好这个「损失函数」的角色?
先说说行业最常见的那位主角:MPI(Miles Per Intervention)。
定义很简单:
MPI = 总行驶里程 / 接管次数
直觉上很好理解:
- MPI 越高,说明「每次人工干预之间跑得越远」;
- 很多公司会用 MPI 来对外宣传「我们的自动驾驶有多成熟」。
如果把 MPI 当成「全组织的损失函数」,
那大家做的事情其实就是:
让「人类接管的频率」尽可能低。
听上去很合理?
问题是 —— 这是 L2/L3 + 车上有安全员时代的直觉。
我们做的是 L4 物流无人车:
- 车上 99% 的时间没有人;
- 出问题的时候,一般是车先「感觉不太对」,
然后主动通过云端系统呼叫远程驾驶员来接管 / 守护。
在这个世界里,MPI 作为「损失函数」,有三个天然缺陷:
- 接管时刻 ≠ 问题发生时刻(时序严重错位);
- 「接管原因」极难被结构化,难以转化成可训练信号;
- 它优化的是「人多久救一次场」,而不是「车在路上干了多少蠢事 / 危险事」。
1. 远程接管:接管那一刻,往往已经是「忍无可忍」的结果
先看时序问题。
现实中的 L4 远程接管流程大概是这样的:
- 车自己先在园区 / 道路里跑;
- 在这段时间里,可能已经发生了各种「体感很差」的行为:
- 急刹车、画龙、停车不走;
- 感知抖动、预测乱跳、规控时走时停;
系统根据一套安全规则,觉得「我可能要叫个人来帮忙」;
这时候才发起呼叫,远程驾驶员接入;
人接了管,MPI 统计 +1。
从时间轴上看:
真正「有问题的动作」往往发生在接管前几十秒甚至几分钟前,
接管那一刻只是系统忍无可忍之后的结果。
你如果把损失函数设计成「MPI 越大越好」,实际上是在告诉整个系统:
「尽量少让人来接管。」
这会产生几个很微妙、但很真实的「坏梯度」:
- 一些策略会倾向于 更晚请求接管 —— 否则你 MPI 看起来就难看;
- 很多「已经发生但没触发接管的蠢操作 / 危险行为」,
在你的优化目标里是 不可见 的。
从强化学习的话术说,就是:
你把惩罚信号绑在了一个
「延迟且非常间接的事件」(有人按了接管键)上,
而不是绑在真正的「bad action」上。
说明一下:我们也做「接管自动归因」,但不拿它当损失
我们现在内部其实也有一套 接管自动归因:
- 底层用统一的 Trigger 体系,
把接管前后一段时间内的所有 Trigger 打在时间轴上; - 这条「事件时间线」转成大模型能看懂的文本;
- 用 LLM + RAG 去推理:这次接管更像是感知问题?规控问题?地图/环境问题?远程操作策略问题?
但这套东西在我们的体系里,只承担一个角色:
「这段时间窗优先看一下」的高优先级样本入口。
真正当「损失函数」来优化的目标,是接管前后那一长段里面:
- 车干了哪些蠢事(Stupid);
- 车干了哪些危险事(Dangerous)。
2. 「接管原因」非常难变成稳定的训练数据
第二个问题,是 「接管原因」的采集和结构化几乎做不成一个长期可用体系。
我们基本把能想到的方式都折腾了一遍。
尝试 A:让驾驶员 / 远程司机语音上报「为什么接管」
设计是这样的:
- 接完管之后按个键,说一句「刚才为什么接管」;
- 云端语音识别转文字,记录为「接管原因」。
实战体验:
- 大多数司机没有自动驾驶算法背景,他们能看到的只是表象:
- 「车辆无故停车不动」;
- 「刚才无故急刹了一脚」;
- 但从系统角度,其实 没有真正「无缘无故」的异常:
- 不是感知误检,就是规则太怂;
- 不是设施故障,就是环境极端;
- 只是这些全都藏在内部 log 里,人看不到。
结果就是,我们拿到的「接管原因」,大量是:
「感觉不对」「怕撞到人」「无故停车」「无故急刹」。
对工程分析来说,这些信号 主观、模糊、不可复现,很难变成真正可训练的 reward。
尝试 B:副驾坐工程师,盯日志 + 画面,实时判断
这个方案一度看起来很「专业」:
- 副驾固定坐一个懂系统的工程师;
- 一边看路,一边看实时日志、可视化面板;
- 一有接管,就尝试现场判断原因并记录。
现实情况:
1. 成本高得离谱:
一个车配一个工程师,只能短期做专项,无法规模化。
2. 效果出奇地差:
在线日志量巨大,人眼实时看属于心理安慰,
真正靠谱的分析还是要靠事后重放 + 各模块联调。
3. 为了让人看日志开的各种监控本身,会「污染环境」:
实时可视化、额外统计、实时订阅,都会占用算力和带宽,
我们甚至排查出过「副驾监控工具本身就是性能噪声源」的问题。
尝试 C:所有接管片段上传云端,人工统一打标「接管原因」
这是最「严肃」的打法:
- 所有接管相关的日志 + 视频 + 传感器数据上传云端;
- 内部搭起一个问题打标平台;
- 让几位熟练工长期做「接管原因标注」。
短期效果确实不错:
- 能打出一套还算准的接管原因标签体系。
但问题也同样典型:
- 成本爆炸:车队规模上去之后,人力和时间都不可控;
- 经验全在熟练工脑子里:
- 哪种 log 模式意味着哪类问题,全靠那几个人的「直觉」;
- 人一走,新人接手,打标正确率肉眼可见地下滑;
很难沉淀为可复用的规则:
- 规则容易过拟合某个版本;
- 一次架构升级,半套规则就废了。
用机器学习的话术说,就是:
你想用「接管原因」来构造 reward,
结果发现这是一个 昂贵、噪声大、标注高度依赖个体经验 的信号,
不适合作为长期稳定的损失函数。
三、换个角度:不问「人什么时候出手」,改看「车到底干了什么」
既然「人接管」这个信号不够好用,
那我们就把视角从 「人」 挪到 「车的行为」 上:
不再问「人什么时候救场?」,
而是问「车自己干了哪些蠢事 / 危险事?」
这就是我们现在实际挂在墙上的两组指标:
- MPS:Miles Per Stupid
- 每万公里急刹次数
- 每万公里大转向 / 画龙次数
- 每万公里停车不走事件次数(按时长分桶)MPD:Miles Per Dangerous
- 「每发生一次不智能表现(Stupid 行为),平均跑多少里程?」
- 实际统计时,我们更常用反写:
- 「每发生一次危险行为 / 险情 / 事故(Dangerous 行为),平均跑多少里程?」
- 同样,用「每万公里险情 / 事故次数」来表达。
在「损失函数」的语境里可以这么理解:
- MPS = 对「蠢行为」的惩罚项(体感很差但未必立刻撞车);
- MPD = 对「危险行为」的重惩罚项(真安全红线)。
整个组织的 self-play 过程,就是围着这两个损失项做「梯度下降」:
- 在不牺牲任务完成率 / 效率的情况下,
让 MPS / MPD 尽可能低,且任何异常波动都能解释清楚。
最关键的是:
「蠢行为 / 危险行为」本身是可以用 Trigger 精准定义和自动捕捉的,
而不是依赖人拍脑袋。
下面用具体例子展开说。
四、MPS 具体长什么样:急刹、画龙、停车不走
1)急刹车:变坏要查,变好得离谱也要查
急刹这件事,大家都能体会:
坐在车里的感受就是:「哐」一下,整个人往前一冲;
在我们的定义里,急刹是一个严格的 Trigger:
- 减速度超过某个阈值;
- 持续时间超过某个阈值;
- 才会记一次急刹事件。
我们统计的是:
每万公里急刹次数
(按城市 / 场景 / 车型 / 版本等维度拆开)
很多人第一反应是:急刹当然越少越好啊,最好 0 次。
但实践下来,我们现在的共识是:
急刹是体温计,不是清零 KPI。
真正有用的是「急刹曲线什么时候不对劲了」。
我举三个我们真实遇到过的例子:
例子 A:天气降温 → 急刹暴涨
有一次,我们发现某个城市某条线路上:
- 急刹曲线在几天内突然抬头;
- 版本没变,场地没变,路线没变。
按「医生的四步走」(望闻问切)来查:
- 望:多维度看——按车、按时间、按场景拆开;
- 闻:问现场运营,有没有什么肉眼可见的变化;
- 问:问算法 / 底盘团队有没有灰度开关;
- 切:把对应时段的日志 + BMS 数据 + 底盘报文切出来细看。
最后发现真正的原因是:
当地突然降温;
低温下电池温度偏低,BMS + 制动系统里关于能量回收的逻辑被触发;
在某些速度 / 载重工况下,制动力更容易「超调」;
体感上,就变成了「急刹变猛、变多」。
这个问题,在事前你很难靠脑补想到。
但只要你有「每万公里急刹」的体感指标,一旦曲线抬头,就有机会顺藤摸瓜把它揪出来。
例子 B:雨天急刹反而明显减少 → 激光雷达「半瞎」
另一个更加反直觉的例子:
- 按常识,下雨天感知难度上升,误检更多;
- 大家直觉上会认为「雨天急刹应该变多」。
结果我们在数据上发现:
- 某几台车在雨天的「每万公里急刹次数」反而明显 下降;
- 而且跟任何版本 / 策略更新都对不上。
这种就是我们常说的「好得离谱」,也是要重点排查的。
我们把这批车的数据单独拉出来分析,发现:
平时这些车的激光雷达外壳上积了不少灰;
一下雨,灰 + 水在雷达表面形成了一层「膜」;
激光发射能量被削、回波点数减少;
再加上雨天很多障碍物表面更光滑,漫反射降低;
最终表现为——雷达「部分致盲」,很多障碍物没看见。
以前会触发急刹的障碍物,现在被漏检了:
- 感知眼里「前面没东西」;
- 规划觉得「环境很干净,不需要刹车」;
- 急刹指标就「好看」了;
但其实:
急刹指标变好,风险是实打实上去了。
后来我们的做法是:
- 加上激光雷达有效点数监控:
- 点数突然持续减少,直接降速 + 告警;
- 运维侧收到告警:
- 主动安排擦雷达 / 检查设备,而不是等出事。
这个例子很典型地说明:
体感指标不是绝对值好看就行,
关键是:任何「变坏」和「好得离谱」,都要能被解释清楚。
例子 C:被追尾——算法都「各有道理」,人觉得离谱
还有一种我们经常见到的情况:
我们的车被后车追尾,比我们追别人尾多得多。
从系统内部看:
- 感知说:「我前面有障碍物」;
- 规控说:「前面有障碍,我必须刹车,这是安全第一原则」。
从后车司机的视角看:
- 他可能在看手机、走神;
- 抬头一看,前面明明空着,你的车突然急刹;
- 他的认知就是:「你这车无故急刹」。
这种情况下:
- 如果你只盯 MPI,统计的是「有没有人接管」;
- 你会完全看不到这类「别人追尾我们」的急刹风险聚集在哪里。
但如果你有:
- 「每万公里急刹次数」;
- 「其中前方无真障碍 + 被后车追尾的子集占比」;
你就可以针对这些「客观上造成危险的急刹」,
单独拉一套样本出来分析:
- 是感知误检?
- 还是规控策略太激进?
- 能不能在后车跟车太近时,更偏向缓刹 + 亮灯提醒?
- 某些场景能不能优先绕行?
这才是「损失函数」真正给到的梯度方向。
2)画龙:从体感「不稳」到主动运维的入口
第二类常见的 MPS 事件,是 大转向 / 画龙。
现象很好理解:
在一段本应该直直过去的路上,车却总是在左右小幅修正,整体轨迹抖得像条龙。
背后常见原因包括:
- 标定略偏;
- 胎压不对;
- 控制参数超调 / 欠调;
- 车道线 / 边界线识别抖动,导致规划轨迹不断重算。
我们统计的是:
每万公里大转向 / 画龙事件次数
(同样按城市 / 场景 / 车型 / 版本拆开)
更有意思的是,画龙还帮我们发现过 纯物理世界的「慢性病」。
例子:长期碾坑 → 转向机轻微变形 → 某几台车画龙异常
有些园区路况确实不太好:
- 某些车每天都要压着同一个坑 / 减速带过去;
- 大部分车没事,但时间长了个别车就出问题。
在数据上表现出来就是:
- 同一个场景、同一条路线、同一版本;
- 车队中大多数车「每万公里画龙次数」都在一个合理区间;
- 只有少数几台车,画龙指标长期偏高。
把这些车单独拉出来检查,会发现:
转向机构 / 悬挂存在轻微变形或松旷。
人开的话,会感觉「方向有点虚、有点飘」;
但 L4 无人车上没人握方向盘,这种变化是无法被主观感知到的。
系统的行为就是:
「我偏了 → 我修一下 → 又偏了 → 再修一下」,
最后在轨迹上就表现为 异常密集的画龙行为。
于是我们现在的流程是:
- 每天按 VIN 统计画龙指标;
- 自动把「画龙事件率异常高的几台车」拉出清单;
- 给运维团队,做重点检查和保养。
这就是一个典型的:
把 MPS_steer 当损失函数,
直接反向更新到了「硬件运维策略」的例子。
3)停车不走:分时长分象限看,不然全被拥堵噪声淹没
第三类典型的 Stupid 行为,是 停车不走。
对体验和运营的打击不用多说:
- 客户看着着急;
- 运营看着抓狂;
- 技术看着头疼,因为原因谱太复杂了。
我们不会简单看「停车不走次数」,而是:
每万公里停车不走事件数(按时长分桶)
大致会分几个档:
- 0–1 分钟:很多是正常起停 / 礼让;
- 1–3 分钟:偏长,主要看整体趋势;
- 3–10 分钟:可疑,值得具体分析;
- 10–30 分钟 / 30 分钟以上:基本可判定为严重异常。
实际原因常见的几类:
- 纯客观交通原因:
- 前方长时间堵车;
- 超长红绿灯相位;
- 大车缓慢掉头 / 转弯挡路;
- 其他交通参与者行为:
- 违规停车占道装卸货;
- 行人 / 电动车一直在车前乱穿;
- 设施 / 环境异常:
- 信号灯坏了:红灯亮,绿灯不亮,或者干脆整组灭灯;
- 道闸不抬杆、门禁 / 扫码 / 人脸识别系统卡死;
- 地图 / 规则理解问题:
- 地图上是通路,现实被铁栏杆封死;
- 现实变成单行 / 临时封路,导航还让车往前冲;
- 复杂路口的让行关系写得过于保守;
- 系统自我保护逻辑:
- 多个传感器信息冲突;
- 某模块健康度自检不过;
- 频繁异常触发,让系统直接进入「冻结等待人工确认」模式。
例子:坏红绿灯 + 策略打架 → 在路口一停半小时
有一次,我们就遇到过一个非常典型的事故:
- 某个路口的红灯正常亮,绿灯经常不亮;
- 车辆的逻辑是:
- 红灯亮 → 正常等红灯;
- 所有灯都不亮 → 认为信号灯异常,等待一段时间后请求远程接管。
现实情况变成:
- 红灯灭了,绿灯没亮 → 进入「灯异常等待 30 秒」;
- 这 30 秒里,绿灯可能短暂亮了一会又变回红灯;
- 远程接管没及时接上(人力有限 / 调度延迟);
- 又回到「正常等红灯」的逻辑;
- 如此循环往复。
最终效果就是:
这辆车在路口,一停就是半小时。
如果没有「每万公里 3 分钟以上停车不走事件数,按路口拆分」这种指标, 这类问题很容易就被归结为一句模糊的吐槽:
「那个路口好像老堵。」
然后就没下文了。
五、MPD:Miles Per Dangerous —— 把安全红线也放进损失函数
说完 MPS(Stupid 行为),再说两句 MPD(Dangerous 行为)。
相比 MPS,MPD 关注的是接近事故的那一小撮事件:
- 真事故 / 剐蹭 / 被追尾;
- 高速下的高风险急刹(后车 TTC 极短);
- 失控倾向、持续打滑;
- 持续多次的碰撞预警等。
这些事件的特点是:
- 数量很少;
- 每一条的「惩罚权重」都非常高。
在我们的实际流程里,MPD 事件基本都会触发:
- 单独拉样本集合;
- 做多模态回放(视频 + 点云 + 轨迹 + 控制命令 + 车身状态);
- 从感知 / 预测 / 规控 / 硬件 / 地图 / 环境 / 运营多个维度做复盘;
- 最终落到明确的策略 / 参数 / 结构性改动上。
在损失函数里,你可以把它理解为:
MPS = 体验惩罚项(车表现得蠢、不智能、不舒服);
MPD = 安全惩罚项(真触碰安全边界)。
整个系统的目标就是:
- 让 MPD 尽可能趋近于 0;
- 同时用 MPS 去约束不要通过极端方式「压低 MPD」:
- 不能靠「啥都不动」来不出事故;
- 也不能靠「看不见就当没事」。
六、回到强化学习的比喻:好的指标 = 好的损失函数
现在再回头看一眼我们一开始的类比:
「我想做的是一个自我迭代的系统,类比强化学习,
给出目标和损失函数就很重要。」
这放到自动驾驶数据闭环里,其实就是:
- 把整个组织当成一个大模型;
- 一级指标就是我们给它设定的损失函数 / 奖励函数;
- MPI 更像是在优化「人多久出手救一次场」;
- MPS / MPD 更像是在优化「车在真实世界中干蠢事 / 干危险事的频率」。
从工程可用性来看:
1. MPS / MPD 的信号更加「贴行为」
- Trigger 可以统一定义这些行为;
- 每个事件都对应完整上下文(micro log / mini log + 视频 + 传感器);
- 可以直接喂给规则引擎 + 大模型做自动归因和问题分发。
2. 一级指标必须少而有力
- 我见过太多「动辄列二三十个指标交给数据团队」的场景:
数据团队辛辛苦苦都做了,最后这些指标的主要用途是——
年终汇报 PPT 截图两页。
- 真正能「当损失函数使唤」的一级指标,
一般不超过三五个,而且大家每天都盯着看。
3. 好的指标天然带有「梯度方向」
- 每万公里急刹 / 画龙 / 停车不走 / 险情,在什么场景抬头,是可以拆解和优化的;
- 「指标什么时候变坏 / 好得离谱」,会自然引导资源往最有价值的问题上投;
- 这才是一个组织级强化学习系统应该有的行为。
七、小结:先把「损失函数」选对,数据闭环才有意义
用一句稍微「上点逼格」的话收个尾:
在「数据闭环驱动问题解决」这件事上,
一级指标 = 组织的损失函数。
你用什么来惩罚 / 奖励,
决定了整个团队会往哪儿收敛。
- 如果你把 MPI 当成核心指标,
全公司优化的是「人多久来救一次场」; - 如果你用 MPS / MPD 这种以「行为表现」为中心的指标,
全公司优化的是「车在真实世界里干蠢事 / 干危险事的频率」。
在这个系列的后几篇,我会再聊:
- 在这个损失函数之下,Trigger / 标签体系怎么设计;
- 问题怎么自动路由到合适团队,而不是「所有人都被 @」;
- 生成式数据在哪些地方真有用,哪些地方更多是自嗨。
但无论后面怎么展开,第一步永远是今天这件事:
先把「全组织的损失函数」——也就是一级指标,选对。
如果你现在也在搭数据闭环、做自动驾驶 / 无人车相关的系统,不妨回头看一眼:
- 你挂在墙上的一级指标,更像 MPI,还是更像 MPS / MPD?
- 它们,是在鼓励「少报问题」,还是在鼓励「多发现问题、多关掉问题」?
- 它们,真的在给整个组织一个正确的梯度方向吗?
....
#ColaVLA
滴滴最近在加速了!潜在认知推理的分层并行VLA框架(清华&港中文&滴滴)
滴滴最近开始加速算法预研了,清华&港中文mmlab&滴滴最新的VLA工作 - ColaVLA。很有意思的一篇工作,提出“Cognitive Latent Reasoner”实现驾驶场景理解、关键目标识别、Latent Rethinking和驾驶决策的生成,“Hierarchical Parallel Planner”利用多尺度的Target和驾驶决策实现分层并行的轨迹解码,由粗到细的生成更优的自车轨迹。开闭环上的结果还不错,比ImpromptuVLA高一些。
- 论文标题:ColaVLA: Leveraging Cognitive Latent Reasoning for Hierarchical Parallel Trajectory Planning in Autonomous Driving
- 论文链接:https://arxiv.org/abs/2512.22939
自动驾驶需要从复杂的多模态输入中生成安全可靠的轨迹。传统模块化流水线将感知、预测和规划分离开来,而近年来的端到端(E2E)系统则对这些任务进行联合学习。
视觉-语言模型(VLMs)通过引入跨模态先验知识和常识推理进一步丰富了这一范式,但当前基于VLM的规划器面临三大核心挑战:
- (i)离散文本推理与连续控制之间的模态不匹配;
- (ii)自回归思维链解码带来的高延迟;
- (iii)效率低下或非因果的规划器设计限制了实时部署能力。
本文提出ColaVLA,一种统一的视觉-语言-动作框架,该框架将推理过程从文本域迁移至统一潜变量空间,并与分层并行轨迹解码器相结合。认知潜变量推理器通过自车自适应选择机制和仅两次VLM前向传播,将场景理解压缩为紧凑的、面向决策的元动作嵌入。分层并行规划器随后在单次前向传播中生成多尺度、因果一致的轨迹。这些组件协同工作,既保留了VLM的泛化性和可解释性,又实现了高效、准确且安全的轨迹生成。在nuScenes基准数据集上的实验表明,ColaVLA在开环和闭环设置下均达到了当前最优性能,同时具备优异的效率和鲁棒性。
一、背景回顾
自动驾驶的目标是从丰富的多模态观测数据中预测安全舒适的运动轨迹。早期系统采用感知-预测-规划分离的模块化架构,包含专用的3D感知模块、预测模块和规划模块。近年来的端到端方法则将这些模块统一整合,在统一流水线中实现从像素到路径点或控制指令的学习。与此同时,视觉-语言模型(VLMs)正被日益广泛地整合到自动驾驶系统中,以注入跨模态先验知识和世界知识——其应用形式包括作为输出控制指令或轨迹的智能体规划模型,或作为引导端到端模块的推理辅助器。

尽管取得了快速进展,但基准数据集上的精度与实际部署中的可靠性之间仍存在显著差距。模块化系统具备可解释的组件和强大的几何先验知识,但脆弱的模块接口可能导致误差传播,且难以实现全局优化。端到端系统减少了人工设计的接口,实现了较高的开环精度,但往往依赖稀疏的轨迹监督信号,将感知与控制以模糊因果结构的方式交织在一起,且在分布外场景中泛化能力较弱。基于文本的VLM规划器虽添加了强大的先验知识,但也引入了一些实际问题:
- (1)模态不匹配。离散文本token与轨迹的连续几何特性和动力学特性不匹配,可能导致格式违规或物理上不一致的路径点。
- (2)思维链推理延迟。自回归解码的计算开销源于其逐token迭代生成过程——每个新token依赖于先前生成的token,导致序列长度随时间增长,显著增加推理延迟。
为弥补上述差距,本文重新审视了VLM在驾驶任务中的作用,提出将推理过程从显式文本思维链转向统一潜变量推理。核心思路是在统一的潜变量空间中完整执行推理过程,并结合一个在并行解码时保持因果结构的规划器。这种设计既保留了VLM的知识先验和推理能力,又避免了冗长的自回归推理及其带来的延迟。总体而言,ColaVLA包含两个核心组件:将场景证据提炼为紧凑元动作先验的认知潜变量推理器,以及在因果保持机制下将这些先验转换为多尺度轨迹的分层并行规划器。
首先,认知潜变量推理器通过两次前向传播高效完成场景理解和最终元动作决策。具体而言,在第一次前向传播中,推理器构建包含固定驾驶提示、多视角视觉图像和自车状态的多模态输入序列,并将其输入VLM以获得经过完整上下文交互的统一token。然而,视觉token中包含大量与驾驶决策无关的冗余信息。为从场景中提取决策相关信息,我们引入自车自适应调制机制,使这些token与车辆瞬时状态对齐,随后通过一个轻量级路由器对token进行评分并筛选出Top-K个安全关键视觉token。在第二次前向传播中,我们将筛选后的上下文与可学习的元查询拼接作为输入,使每个元动作嵌入能够通过交叉注意力机制查询驾驶关键上下文,最终得到驾驶决策。
在推理器决策的引导下,分层并行规划器采用与推理器相同的VLM,通过并行解码预测多尺度细粒度轨迹。具体而言,根据选定的决策从动作库中检索对应的元动作嵌入;利用该元动作嵌入,通过时间嵌入实例化全时域动作块,并将其重采样为S个嵌套的、从粗到细的尺度;最后,将所有尺度的嵌入与筛选后的上下文拼接作为规划器输入,在单次前向传播中并行解码生成轨迹。该设计实现了连贯且因果一致的规划过程,生成多尺度连续轨迹的同时大幅降低了推理延迟。
本文的主要贡献如下:
- (1)提出ColaVLA,一种面向端到端自动驾驶的统一视觉-语言-动作框架,直接对连续轨迹进行建模,在利用VLM先验知识的同时避免了模态不匹配问题。
- (2)设计认知潜变量推理器,将推理过程从文本思维链迁移至统一潜变量空间,通过自车自适应路由和元信息压缩,使模型能够广泛观测、选择性聚焦、审慎重思考并高效决策。
- (3)提出分层并行规划器,在单次前向传播中解码所有时间尺度和模态,在严格的延迟约束下实现高效、合理且安全的轨迹生成。
- (4)在nuScenes基准数据集上的综合实验表明,ColaVLA在开环和闭环评估中均达到当前最优性能,同时保持了较强的可解释性和计算效率。
二、ColaVLA算法详解

框架概述
给定包含多视角图像、激光雷达点云、雷达网格、文本提示、自车状态(或其子集)的多模态表示 ,轨迹规划任务可简化为将 映射到一个K步轨迹 。现有规划系统通常由两个统一的可学习组件构成:推理器 (通常实现为ResNet、PointNet、Q-Former或VLM Transformer,用于提取和融合多模态特征,或可选地通过思维链进行优化)和规划器 (通常实例化为确定性MLP规划器、随机扩散采样器或标准Transformer解码器,用于注入动作查询并回归连续路径点)。两者的交互可简洁表示为:
其中 是潜变量token序列, 表示可学习的动作库。该抽象涵盖了领域内三种主流范式:
- (1)包含独立感知、决策和规划阶段的经典模块化流水线;
- (2)无显式推理过程的端到端规划器;
- (3)将规划表述为带思维链推理的自回归文本生成任务的基于VLM的模型。
为统一VLM的泛化能力与基于动作的规划器的效率,本文在图2所示的统一视觉-语言-动作(VLA)框架下重新构建轨迹规划任务。不同于依赖文本思维链推理,本文所提出的认知潜变量推理完全在统一潜变量空间中执行,仅需两次前向传播即可生成可解释、面向决策的元表示。这种紧凑的元动作先验捕获了高层意图和上下文感知能力,且无需自回归解码带来的高延迟。基于此,ColaVLA采用分层并行规划器,在因果保持混合注意力掩码下执行结构化轨迹优化。该设计支持多尺度轨迹生成和并行多模态解码,在单次前向传播中完成,搭建了知识驱动推理与连续控制之间的桥梁,形成统一、可解释且低延迟的规划流水线。
认知潜变量推理
近年来的视觉-语言模型通过模拟人类驾驶员的推理过程(感知场景、识别关键实体、审慎重思考并制定最终策略),在自动驾驶中展现出强大的泛化能力。然而,大多数现有方法在文本层面实现该推理过程,导致自回归解码带来的高延迟和暴露偏差。受大型语言模型潜变量空间推理研究进展的启发,本文将这一认知过程迁移至统一潜变量空间。推理器仅需两次前向传播即可完成推理,既保留了基于语言推理的语义丰富性,又避免了token生成的额外开销。这种可解释的设计为分层并行规划奠定了高效基础。
驾驶场景理解:人类驾驶员的认知过程始于对环境的整体观察。为模拟这一步骤,我们构建了混合输入序列:将固定驾驶提示编码为文本嵌入 、感知前端生成的多视角视觉嵌入 ,以及代表车辆状态的自车token。共享VLM Transformer (D_{VLM}) 处理该序列后,我们仅保留隐藏状态中的视觉部分:
更新后的文本和自车嵌入被丢弃,以确保提示保持不变且不引入冗余信息。由此得到的 提供了时空因果一致的空间语义、车道拓扑和动态智能体表示,为后续关键实体识别奠定了稳定基础。
关键目标识别:仅选择安全关键线索对效率和可靠性至关重要。本文引入自车自适应路由器 ,首先通过FiLM调制使视觉token与当前自车状态对齐:
其中尺度因子 和偏移量 通过两个独立的线性投影从自车token生成。该调制过程突出了与自车速度、航向和曲率一致的场景元素,强调碰撞锥内的动态智能体和车道边界,同时抑制无关背景细节。
随后,路由器对经过自车调制的token进行评估,并筛选出信息最丰富的子集:
训练阶段,采用Gumbel-Softmax松弛使选择过程可微分,形成K-热掩码;推理阶段则直接保留Top-K个token。最终得到的紧凑集合 有效捕获了最关键的安全相关视觉线索(如车道、邻近车辆、行人及交通灯),为后续潜变量推理阶段提供了高效的信息瓶颈。
潜变量重思考:剔除无关线索后,人类驾驶员会重新评估浓缩后的证据并形成初步规划。为模拟这一过程,我们拼接四个组件:固定驾驶提示 、K个显著视觉token 、自车token ,以及包含C个可学习元查询的集合 。该序列输入共享VLM Transformer进行第二次前向传播:
共享VLM确保了时空和语义一致性,而较小的token规模()保证了计算效率。每个 初始化为代表对应元动作(如直线巡航、无保护左转或紧急制动),这些元动作通过聚类训练轨迹得到。更新后的嵌入 代表不同的驾驶策略,为最终决策做好准备。
策略决策合成:元查询嵌入 通过FiLM调制适配自车状态,并与驾驶关键视觉token 进行交叉注意力交互,随后对元token执行自注意力操作。一个共享的两层MLP将每个优化后的元token映射为动作类别对数概率,采用焦点损失(focal loss)进行训练,以强调困难案例和安全关键案例。通过将推理空间限制在C个元动作token内,该过程实现了熵减,并生成多个可能的驾驶策略,为后续预测提供结构化先验。
分层并行规划
本文提出的分层并行规划器通过“意图-运动”多阶段解码生成轨迹。它集成了时间抽象、因果保持注意力机制和置信度引导多模态解码,具备三大核心特性:(i)意图-运动优化,将最终目的地逐步细化为详细运动规划;(ii)阶段独立性,支持跨时间尺度并行解码以实现高效推理;(iii)置信度感知多样性,保留多个合理模态以提升鲁棒性。
阶段感知轨迹查询:给定预测时域 步(),我们将其划分为S个嵌套阶段 ,其中早期阶段代表粗时间分辨率,后续阶段逐步细化轨迹。对于每个尺度 ,认知推理器选择的元动作查询 与时间嵌入结合形成轨迹目标 ,并按照预定义顺序重采样为多尺度子集 。筛选后的上下文与所有尺度目标按时间顺序拼接,形成完整的多尺度输入流:
其中 代表编码历史和环境信息的筛选后上下文。这种分层结构确保粗轨迹先于细粒度优化,为后续因果保持掩码机制在单次前向传播中执行结构化多模态规划奠定基础。
因果保持混合注意力:本文设计混合注意力掩码 以调节筛选后上下文与多尺度轨迹token之间的信息流(如图3所示)。该掩码满足三大原则:
- (i)同类token间双向交互,确保上下文token和同尺度轨迹token保持局部一致性;
- (ii)全局上下文聚合,允许每个轨迹token关注所有上下文token;
- (iii)因果保持,尺度 的token仅能访问前一粗尺度 的token,避免未来细尺度的信息泄露。

形式上,掩码定义为:
且其他情况
其中 是筛选后上下文的长度, 索引当前尺度, 表示拼接后的序列。该掩码允许每个尺度 的token同时关注筛选后上下文和紧邻的前一尺度 ,但禁止访问未来尺度 。这种设计有效结合了全局上下文聚合与严格的因果优化,确保轨迹解码以物理一致的“从粗到细”方式进行。
置信度引导并行解码:最终解码阶段,规划器同时处理多个候选驾驶策略,每个策略生成一组潜变量轨迹目标。两个轻量级MLP头独立工作:一个估计置信度分数,另一个回归对应多尺度轨迹。训练阶段,基于每个预测轨迹与真实轨迹的距离分配独热监督信号,仅最接近的假设获得直接回归监督。这种置信度引导机制使模型能够优先选择最可靠的轨迹,同时保留假设间的多样性。并行解码在单次前向传播中处理所有候选,确保高效率的同时有效防止模态崩溃,提升泛化能力。
实验结果分析实现细节
实现基于LLaVA v1.5框架,采用LLaMA-7B作为语言模型。遵循现有工作,图像编码器初始化采用EVA-02-L,并采用SQFormer架构以提升视觉推理性能。检测解码器和车道解码器遵循StreamPETR,分别使用900个目标查询和300个车道查询。
训练采用多阶段策略:
- 第一阶段:在OmniDrive-nuScenes的问答对上预训练VLM,通过LoRA层高效提示和适配VLM,实现感知-规划对齐。
- 第二阶段:集成基于动作的规划器并进行联合微调。VLM内部仅更新LoRA参数,以保留预训练知识并提升决策能力。
训练使用AdamW优化器,采用余弦退火调度,权重衰减为 ,初始学习率为 。
与SOTA对比
开环规划结果:表1报告了nuScenes开环基准测试结果。在基于动作的方法中,ColaVLA取得了最佳的整体准确性和安全性,平均L2误差最低(0.30米),平均碰撞率最低(0.23%)。与最强的现有基于动作基线SOLVE-E2E(平均L2误差0.31米;平均碰撞率0.30%)相比,本文方法将L2误差降低3%,碰撞率降低23%,表明轨迹预测更精确、更安全。值得注意的是,ColaVLA在避免自回归文本解码的同时,与最新基于文本的VLM规划器也具备竞争力。通过将推理迁移至潜变量空间并引入认知潜变量推理与分层并行解码,该框架的VLM前向传播次数比典型基于文本的流水线减少超过5倍,在直接操作潜变量动作空间的同时彰显了卓越效率。

闭环规划结果:在NeuroNCAP闭环基准测试中(表2),ColaVLA达到新的当前最优性能,NeuroNCAP评分为3.48,较最强现有方法ImpromptuVLA绝对提升1.10(相对提升53%)。安全性方面,模型将平均碰撞率从65.1%降至36.8%,其中静态碰撞率改善尤为显著(54.8%→32.3%,降低约41%),侧碰撞性能也达到最佳。更低的整体碰撞率和显著更高的NeuroNCAP评分凸显了其强大的闭环鲁棒性。需要注意的是,ImpromptuVLA是基于文本的VLM,训练使用了额外的精选数据,而ColaVLA无需文本思维链推理和额外安全关键数据即可实现更高分数。这些结果验证了认知潜变量推理和分层并行规划器的有效性:将推理迁移至视觉对齐潜变量空间,并通过单次并行解码生成轨迹,转化为更优的决策质量和闭环评估下的安全性提升。

推理耗时比较:如表3所示,ColaVLA在所有对比方法中实现了最低延迟,同时保持了优异的规划准确性和安全性。与依赖文本层面自回归思维链推理的SOLVE-VLM和OmniDrive相比,本文的潜变量推理和单次分层解码实现了超过5倍的推理加速,支持高效、可解释的规划。

定性结果
图4展示了分层并行规划器的定性结果。在直线和转弯场景中,粗轨迹(红色)捕获全局意图,而细粒度尺度(黄色、紫色)逐步优化空间细节和曲率,最终与真实轨迹(绿色)高度吻合。这些结果表明,分层解码在单次前向传播中即可生成平滑、准确的规划。

消融实验
本节通过系统消融所提组件和关键超参数,评估其单独及组合贡献。实验在nuScenes上进行,采用两个互补指标:开环L2平均误差和闭环NeuroNCAP评分。
潜变量推理的消融:如表4所示,对推理模块的消融实验验证了其有效性。引入潜变量推理显著增强了模型的推理能力,实现了更准确的预测并降低了平均L2误差。此外,添加重思考(Rethink)阶段使模型能够重新评估当前驾驶场景的压缩关键信息,优化视觉理解并为后续阶段提供更优决策支持。这种渐进式推理过程提升了模型在复杂或动态交通场景中的泛化能力和鲁棒性。

基于动作的规划器的消融:由于基于动作的规划器通常能实现相近的开环指标,本文重点评估其闭环性能以更好地反映真实驾驶行为。为隔离规划器的贡献,对比中禁用了推理模块。如表5所示,在NeuroNCAP基准测试中,分层并行规划器显著优于基于MLP和扩散模型的规划器。特别是在静态和正面场景中,本文方法实现了大幅性能提升,凸显其生成更平滑、稳定、安全轨迹的能力。通过“从粗到细”解码轨迹并保持跨时间尺度的因果依赖,规划器有效优化了中间预测,能够稳健适应复杂或动态交通条件,展现出更优的安全性和泛化能力。
保留关键token数量K的消融:进一步分析了自车自适应路由器中保留视觉token数量K的影响。原始目标和车道查询分别包含900和300个token。如表6所示,保留token过少会限制表示能力,导致视觉信息大量丢失和性能下降;反之,保留过多token会引入冗余,增加训练和推理阶段的计算开销。最终选择 作为默认配置,在语义覆盖和计算效率之间实现最佳平衡。

分层回归策略的消融:研究了不同分层轨迹回归策略,所有变体采用相同的并行解码框架,但跨尺度轨迹子集的选择策略不同:
- 单尺度(Single scale)基线:无时间抽象,直接回归最终轨迹,作为非因果参考。
- 顺序策略(Sequential):从起点向前扩展轨迹。
- 反向策略(Reverse):从终点向后传播。
- 插值策略(Interpolate,本文提出):先预测关键端点,再跨尺度填充中间点,与驾驶运动的因果结构对齐。
如表7所示,所有多尺度设计均优于单尺度基线,证明了时间抽象的优势。其中,插值策略取得了最佳性能,验证了其在结构化、因果一致轨迹推理中的有效性。
四、结论
本文提出ColaVLA,一种面向端到端自动驾驶的统一视觉-语言-动作框架。通过将推理过程从文本域迁移至统一潜变量空间,并与分层并行规划器相结合,ColaVLA弥合了VLM认知与连续动作生成之间的鸿沟。其认知潜变量推理器通过自车自适应token选择,高效将场景理解压缩为紧凑的元动作表示;而因果保持规划器在单次前向传播中解码多尺度轨迹。该设计实现了高效、可解释且安全的规划,延迟极低。在nuScenes上的实验表明,ColaVLA在开环和闭环评估中均建立了新的当前最优性能,同时保持了强大的泛化能力、效率和鲁棒性。这些结果表明,将推理从文本域迁移至潜变量空间,为构建高效、知识驱动的自动驾驶系统提供了可扩展路径。
....
#摸底地平线HSD一段式端到端的方案设计
本文主要概述一下地平线一段式端到端方案(HSD)的两篇核心文章: DiffusionDrive + ResAD。
DiffusionDrive给读者们梳理了整体pipeline,ResAD则着重于性能提升的关键:轨迹残差设计。两篇文章都很精彩,也感谢地平线的分享,给从业者带来很多启发。
DiffusionDrive
图1: diffisonDrive整体架构
DiffusionDrive的整体架构如图1,可以拆成三部分:1. 感知信息 2.导航信息 3.轨迹生成
感知信息
感知信息本文没有过多着墨,主要是障碍物(动态/静态)、红绿灯、地图元素(车道线/roadmarker/特殊车道信息如可变车道)、可行驶区域(freespace/occ)。从端到端的角度来说,核心就是将感知任务的信息表征传递给planner任务。二段式时,是结构化的障碍物、车道线、红绿灯、可行驶区域等等感知信息。一段式时,纯dense感知方案可以是感知的Bev feature map;纯sparse方案,可以是每个query的instance feature,玩法很多,一般都会结合公司现有的技术栈来适配。我挺推荐Sparse4D和VAD两个系列,对障碍物和map元素的建模我觉得很干净,也容易复现。
导航信息
从交付角度来说,不跟导航代价其实很大,比如高速不下匝道,几乎是不能被接受的。本文没有过多着墨,但实践过程中怎么让模型可以不走错路,是非常有挑战的工作。比如上海就是典型的导航难度大的城市,路口车道多且设计多样,高架上短时多次多匝道,可变和潮汐车道。根据导航信息的平台不同、导航信息丰富度不同、定位能力不同,算法的设计也千差万别,需要从实践过程中积累经验。
轨迹生成
本文核心想说的就是轨迹生成部分,所谓“Truncated Diffusion”。文章指出人类驾驶行为并不是随机分布的,具备fix patterns。从这个观察出发,文中
- 从训练集中K-Means出N个轨迹序列,描述常见的人类驾驶行为
- 训练过程中,对这N个轨迹的加噪比较弱,对应的你去噪的step也不用很多
- 训练时和真值轨迹最接近的anchor计算denoising轨迹的loss,每个anchor都预测存在性
这么做的好处很多,可以降低训练收敛的难度且推理时去噪的次数需求更少(指和没有这么做的那些算法,对DDIM的去噪次数的需求,现在也有很多生成算法在研究更少的推理去噪次数)。此外,上车时可以根据你的算法来设计anchor的个数,降低推理成本。
轨迹生成和感知信息以及导航信息的交互文中也没展开说,diffusion中加入条件控制的文章很多,比如Classifier-Free Guidance就蛮好的,比较干净,更多的玩法读者可以自行探究。
Comment
本文的核心贡献就在其anchor based的轨迹生成,训练难度降低,推理实时性高,是很好的idea。但是我在读的时候就有一个困惑,时序上轨迹的稳定性怎么保证?文章也没有谈到system的时序模块(这显然是需要的)。
ResAD
图2:ResAD整体架构
残差监督
我觉得本文最有意思的部分就是这个残差设计,本文没有直接去生成未来轨迹,而是预测未来轨迹和惯性外推下的惯性未来轨迹的残差。
残差正则
但显然距离当前时刻的间隔越远,残差会越大,所以需要正则化。对于时序上的残差们,对其进行正则化得到:
其中用来压缩区间
文中这张图对残差的作用表述的非常清楚:
图3:轨迹和轨迹残差的分布对比
可以看到不管未来不同时刻的轨迹分布一致的多,而这种一致性是非常有好处的。Loss上,轨迹的预测误差不会再被距离自车比较远的点给拉住;学习难度上,不平衡的分布下模型更容易偷懒。
惯性参考扰动
考虑到其残差的设计,其生成过程中噪声的扰动也有所不同,其噪声直接作用在了初始速度上,通过控制噪声在lat和lon方向上的不同大小,调整横纵向不同的学习难度和关注程度。所以有
会设置K种噪声,infer时可以根据需求(算力大小,下游对多模的依赖程度)设置不同的。
轨迹Ranker
ResAD提到了他们的轨迹selector,将topk的轨迹预测编码当作Q,环境信息(同diffusionDrive中感知和导航信息)当作K,V,过transformer;额外的将ego status的embedding也加进来,去预测metric scores。预测多少metric可以自己设计。
Comment
正则化的残差监督是非常令人印象深刻的,这么做可以将惯性部分从预测中抽离掉,模型关注真正的多样性的部分,可以有效对抗不平衡的数据分布(数采中匀速数据太多太多,真正值得学习的东西会被淹没)。
轨迹Ranker算是部分解答了我DiffusionDrive轨迹稳定性的疑惑,引入多个metric scores,也给了下游更多发挥的空间,但我觉得可以进一步设计成时序的,提升选择的稳定性。
小结
总的来说,地平线的这两篇文章都非常出色,也给从业者带来了很多思考和引导,期待更多更好的文章,也期待更优秀的产品。
....
#世界模型和数字孪生的本质是什么
怎么赋能自动驾驶?
「倾斜摄影、MVSNET、
NERF、3DGS等主流技术总结」
在自动驾驶领域,离不开的话题是世界模型和数字孪生。
自动驾驶感知模型在虚拟环境中训练,然后应用到现实世界中。因此现有研究很多关注于怎么构建世界模型/数字孪生模型,以及如何缩小感知模型在虚拟环境和现实世界中的差距(如域自适应这一虚实迁移的范式)。本文主要探讨前者。
1 世界模型
参考资料:世界模型应用总结:https://www.51cto.com/aigc/5655.html
概念火热但应用分散,存在概念混淆:世界模型是物理世界建模的终极目标,但当前存在严重的概念泛化问题
- 心理学起源(1971):人类通过抽象外部世界为简化元素及其关系来感知和预测,为AI世界模型奠定认知基础。
- Ha等人引入AI(2018):首次系统构建世界模型作为"心理模拟器",让智能体在内部推演行动后果以指导决策,类似MBRL范式。
- LeCun的JEPA框架(2022):通过潜在变量高效建模世界状态,模拟人类"快-慢"双系统思维,实现深度推理与规划能力。
- LLMs的隐性世界知识(2023):大语言模型内部存在认知地图等类脑结构,能隐性感知时空关系并预测事件,但非显式物理模拟。
- Sora作为世界模拟器(2024):OpenAI的Sora实现从隐性理解到显性模拟的跃迁,能生成符合物理规律的视频并动态模拟环境变化。
定义的世界模型是以视频为底座,核心是 “时空认知”,所以它需要大量视频数据。这些视频数据从哪来?
游戏是一个很重要的训练数据来源。比如腾讯最近推了一个版本,就是拿游戏来训的。在游戏里我按一下 “往前”“左转”“跳起来”,游戏引擎会自然渲染下一帧变成什么样。模型就能学到:前面是这样,我做了这个动作,后面变成那样。把这个逻辑迁移到真实世界,就是 “我在这个世界里运动会发生什么”。
两大研究分支:分为"内部表示"(用潜在变量建模环境以辅助决策)和"未来预测"(生成真实视频并转向xx交互)两大学派。【在决策任务中,了解环境是制定优化策略的主要任务。因此,决策中的世界模型应该包括对环境的全面理解。】
核心共识:所有路径共同认为世界模型的本质目的是理解世界动态并预测未来场景。
xx环境的世界模型
本文将概念具象在:作为xx环境的世界模型
xx环境的世界模型的开发对于模拟和预测智能体如何与外部世界互动和适应至关重要。
xx世界模型的开发正从单纯模拟视觉动态(视频)转向构建包含空间结构和物理交互的沉浸式交互环境,从而更真实地反映现实世界,为智能体提供全面平台以学习和适应复杂的真实场景。
现有研究关注 静态(室内、室外)、动态
核心目标:模拟智能体与外部世界的交互与适应,从视觉模拟升级为完全交互式的xx模拟
关键演进:整合空间表示和物理交互,从视频过渡到沉浸式xx环境
作为xx环境的世界模型所关注的重点:理解世界和预测未来
- 在自动驾驶中,世界模型需要实时感知路况[195,177]并准确预测其演变[127,167,241],特别关注即时的环境感知和复杂趋势的预测。
- 对于机器人技术,世界模型对于导航[160]、物体检测[183]和任务规划[62]等任务至关重要,需要对外部动态有精确的理解[47],并能够生成交互式的xx环境[132]。
真正的世界模型应该具备:
- 物理一致性: 遵循物理定律的动态演化
- 多尺度时空建模: 从毫秒到分钟,从厘米到公里
- 因果推理能力: 理解行为与结果的因果关系
三大应用方向(核心作用):
- 预训练: 作为基础模型的预训练方式
- 仿真和数据生成: 补充真实数据的不足
- 端侧推理: 实时预测环境变化
xx世界模型的应用场景
室内环境
特点:受控结构化场景,支持物体操作、导航等细粒度任务
发展:从纯视觉(AI2-THOR)→多模态(iGibson加激光雷达、AVLEN加音频)→社交交互(GRUtopia加NPC)→LLM驱动指令生成任意环境
挑战:在有限空间内融合视觉、语言、声音等多模态输入
室外环境
挑战:规模大、可变性高,比室内更复杂
早期:MetaUrban通过检索3D资产创建城市环境,支持上下文感知导航
突破:UrbanWorld用3D生成模型构建可定制城市;MineDOJO模拟程序生成的沙盒环境(如《我的世界》),推动持续探索与适应
动态环境
革命性:从静态预定义环境转向生成式模型实时动态模拟
代表工作:
UniSim:根据动作/文本/相机参数动态生成机器人操作视频
Pandora:扩展UniSim到更广域的室内外人类/机器人动作
Streetscapes:自回归视频扩散模拟城市天气/交通变化
核心优势:可扩展、适应性强、减少手动配置,提供第一人称训练
技术路径分析:
3D高斯为基础: 可能是最有前景的表征方式,但需要解决 核函数优化问题
神经辐射场融合: NeRF + 动态建模的组合值得探索
分层建模: 不同抽象层次的世界模型服务不同目的
自动驾驶怎么用世界模型
自动驾驶怎么用世界模型?
学习隐式表示
- 定义:通过感知数据(摄像头、激光雷达、点云)在潜在空间构建世界状态的抽象表征
- 核心功能:将多模态输入转化为几何/语义空间,预测交通参与者未来轨迹与行为
- 流程:感知模块(检测/分割)→预测模块(轨迹/行为预测)→潜在空间建模世界状态
- 技术演进:PointNet处理点云→CNN图像感知→Transformer多摄像头BEV融合→多模态LLM应用(TOKEN/OmniDrive)
- 目标:提升决策可靠性,处理长尾场景
世界模拟器
- 定义:直接生成车辆感知数据(如视频、3D占据网格),模拟未来世界状态
- 核心功能:闭环控制、高保真数据生成、场景可控性
- 传统局限:几何空间模拟需多模块级联,信息丢失、计算昂贵、控制困难
- 视频生成方案:扩散模型(GAIA-1/DriveDreamer)直接生成逼真相机数据,支持文本控制
- 其他形式:OccWorld预测3D占据网格,Copilot4D预测雷达点云,更好反映空间特征
数据的表示形态有哪些?
- 图像/视频:GAIA-1生成多视角驾驶视频
- BEV(鸟瞰图):BEVWorld统一感知-预测-规划
- 3D占用网格(OG):OccSora/Copilot4D预测空间占据
- 点云(PC/4D):Copilot4D预测雷达点云变化
- 混合表示:MaskGWM结合视频掩码重建,提升泛化能力
在自动驾驶中的具体应用场景
- 场景理解:利用LLM的通用场景理解能力处理长尾问题(如TOKEN将整个交通场景标记为对象级知识)
- 运动预测:预测多智能体未来轨迹,如Trajectron++用条件VAE计算概率分布
- 仿真与数据合成
1、优势:生成Corner Case(罕见场景),降低实车路测成本
2、案例:MagicDrive3D实现可控3D场景生成;DriveDreamer-2用LLM增强多样性
端到端驾驶:BEVWorld通过统一潜在空间整合感知、预测和规划,实现端到端优化
交通场景模拟通常在几何空间中进行。这些模拟所依赖的场景数据通常由自动驾驶车辆的感知模块收集或手动构建
【视频空间】基于扩散的视频生成模型作为世界模型部分解决了上述问题
【3D空间】OccWorld[237]和OccSora[185]通过预测3D占据网格来预测世界的未来状态
车企落地情况

2 仿真与数字孪生
数字孪生的作用?
数字孪生只是看看?数字孪生参与迭代!
闭环仿真技术实际上是在构建一个可控的平行交通宇宙,在其中可以进行"反事实推理"和"历史重演"
究竟什么是数字孪生?
一句话概括:在虚拟世界中定义好 自动驾驶车群的各个环节、各个要素,并依据一定的逻辑和规则自由切换时空,低成本、高效率地研究自动驾驶中的关键技术与方案,进而驱动现实世界中自动驾驶技术的发展与落地,进而建立起物理世界和虚拟世界之间的联系。
以自动驾驶传感感知为例,数字孪生体现在以下几个层次
【物理世界建模/数字化】将现实世界的交通场景元素映射到虚拟空间,方便在虚拟空间上开展进一步的工作。
【模型迭代】虚拟环境中有大量数据,可以用于感知模型的训练、优化与迭代
【系统迭代】在虚拟仿真软件中对传感感知系统进行研究,找出问题与解决方案,进一步应用到现实世界中。
相关技术
倾斜摄影
图像预处理:对采集的倾斜图像做畸变校正、曝光均衡,剔除模糊或过曝的无效图像。
空中三角测量:通过匹配图像间的同名点,结合 GNSS/IMU 原始数据,解算所有图像的精确内外参(位置、姿态、相机参数),形成统一的测量坐标系。
密集匹配:基于校正后的图像和精确参数,用立体匹配算法(如 SGM、深度学习算法)计算每个像素的深度信息,生成高密度点云。
网格构建:对高密度点云进行去噪、精简后,构建不规则三角网(TIN),形成三维几何网格模型,还原地物轮廓。
纹理映射:将原始倾斜图像的纹理信息,精准贴到对应的三维网格面上,生成纹理逼真、细节丰富的三维模型。
模型优化与输出:检查并修复模型漏洞、纹理错位等问题,最终导出 OBJ、OSGB、3DTiles 等通用格式,用于后续应用。
MVSNET

输入准备:接收参考图像、多幅源图像,以及所有图像对应的相机内参和外参(用于计算视图间投影关系)。
特征提取:通过共享权重的卷积神经网络,对所有输入图像提取像素级特征(生成高维特征图),增强匹配鲁棒性。
代价体构建:针对参考图像的每个像素,预设一系列深度假设;利用相机参数将源图像的特征投影到参考图像视角下的对应深度假设位置,通过计算参考特征与投影特征的相似度(如余弦距离),构建三维代价体(维度为:深度假设数 × 图像高 × 图像宽)。
代价体正则化:用 3D 卷积网络对代价体进行滤波,聚合空间与深度维度的上下文信息,抑制噪声,增强正确匹配的代价信号。
深度图回归:对正则化后的代价体,通过 softmax 计算每个像素在不同深度假设上的概率分布,取概率最大的深度作为初始深度图;部分变体还会通过迭代优化(如分层精修)提升精度。
后处理:通过多视图一致性检查去除异常值,进一步优化深度图。
SLAM(见slam感知)
NERF
NeRF 用神经网络“记住”一个3D场景,然后可以从任意角度“拍照”出逼真的图像
核心思想
NeRF 用一个连续的体积函数来表示一个3D场景:
输入:空间中的一个3D坐标 x = (x, y, z) 和视角方向 d = (θ, φ)
1.球坐标系:其中θ是极角(从正z轴向下倾斜的角度,范围(0,π),φ是方位角(在 xy平面上的旋转角度,范围[0,2π]。对应的笛卡尔单位向量为:

训练过程
- 输入一组已知视角的照片(带相机参数)
- 对每个像素,从相机中心发射一条射线
- 在射线上采样多个3D点
- 用神经网络预测每个点的颜色和密度
- 用体积渲染公式将这些点合成一个像素颜色
Tij是透光率,光线到达第 i 点还活着的概率
αi是遮挡概率:该点对光线的“阻挡程度”

与真实照片颜色比较,优化神经网络参数
推理过程
生成新视角的射线
采样 3D 点
用同一个 MLP 查询 (c, σ) 【也就是MLP神经网络】
用体积渲染合成像素颜色
优缺点
渲染质量极高,接近照片级真实感
可以从任意视角合成图像
训练慢(原始版本每场景需数小时到数天)
渲染慢(每张图需神经网络推理数千次)
内存占用大,难以扩展到大场景
后续改进

为什么 NeRF 要用体积渲染公式?它为什么有效?
体积渲染公式是 NeRF 能将“3D 体积”变成“2D 图像”的唯一可微桥梁,它既物理合理,又数学可导,适合端到端训练。
模拟的是光线在参与介质中传播的物理过程
密度 σ 越高 → 光线越容易被“挡住”或“吸收”
颜色 c 是该点对光线的“贡献”
前面的点会“挡住”后面的点( occlusion )
和MVSNET多视图立体匹配的区别?
MVSNet 是“先测深度 ➜ 再融合点云/网格”的显式几何流水线;
NeRF 是“直接学一个连续 5D 函数 ➜ 用体渲染倒推几何”的隐式场方法。
MVSNet:本身不原生支持任意视角合成;先生成点云/网格,再用传统图形学渲染(可微光栅化或纹理贴图),边缘、遮挡处常出现裂缝或空洞。
NeRF:天生为 Novel View 而生, continuous 场+体渲染保证任意视角直接可微生成,照片级真实感。
MVSNet:可以“一次训练 ➜ 测试任意新场景”(generalizable);用 3D 代价体结构学跨场景先验,3~7 张图也能推理。
原始 NeRF:每场景单独过拟合,需要 20~100 张图训练;后续出现 PixelNeRF、MVS-NeRF 等加图像特征,才做到跨场景泛化。
NERF在跨场景泛化方面有哪些工作?【目标:实现5 张输入图、1~3 min 训练、任意新场景高质量新视角合成】
感悟:即使是改进后的可泛化 NeRF 方法,也需要在多个场景上进行预训练,并且在面对新场景时,往往还需要一定的微调过程 https://arxiv.org/pdf/2405.01333【nerf in robotics综述】
场景信息从「MLP 权重」搬到「外挂特征体/点云/哈希格」,权重即可共享。
1、代价体编码 MVSNeRF (ICCVW 21) 先用 3D CNN 在平面扫描代价体里提取「场景特征体」,NeRF-head 只在特征体里插值,网络其余权重跨场景共享,单张 GPU 即可对全新场景做 3-view 推理。
2、点云特征外挂 Point-NeRF (CVPR 22) 用 MVS 点云做骨架,把多视图 CNN 特征附着在点上;任意新场景只需换点云+特征,无需重新初始化 MLP,渲染质量超越 MVSNeRF。
3、哈希格子+共享解码 Instant-NGP (22, NVIDIA) 用多分辨率哈希格取代坐标 MLP,坐标→哈希向量→共享小 MLP。同一套哈希表/权重可在不同场景间“即插即跑”,仅需 5-15 min 微调就收敛。
用注意力或 Transformer 聚合多视图,打破单射线局部假设。
1、IBRNet (CVPR 21) 对射线采样点投影到 全部输入视图 → 取 CNN 特征 → 用 Transformer 做「点-视图」双路径注意力 → 输出颜色/密度。核心思想:把 NeRF 的“点查询”改成“跨视图特征查询”,因此权重天然跨场景通用。
2、GeoNeRF (ICCV 21) 在级联代价体上同时生成「视图无关 token」和「视图相关 token」,再用 Transformer 融合;公开代码可直接推理 DTU/NeRF-Synthetic 无需重训。
3、NeuRay (21) 先用代价体算「可见性先验」,体渲染时把可见性当成置信度加权,显著降低浮游物,提升零样本泛化。
引入 2D 大模型(扩散、CLIP、DINO)做语义-外观先验,零样本亦可行
1、DreamFusion / Magic3D / ProlificDreamer (22-23) 用扩散模型 SDS/VSD 损失替代 2D RGB 损失,NeRF 渲染图只要“像照片”即可,无需真实拍摄;同一套扩散权重可生成任意类别的 3D 物体,实现“文本 → 3D”零样本。
2、LERF (ICRA 23) 把 CLIP 特征体渲染到 3D,再与 NeRF 联合优化;训练后可用文本在全新场景里查询 3D 区域,无需重新建模。
3、语义-几何对齐 多篇工作将 DINO/CLIP 特征与哈希格或点云特征做 cosine 对齐,强迫不同场景的同一物体/材质落在统一特征空间,提升下游识别与编辑泛化。
元学习/预训练/微调三级流程,让网络“先学通用 3D 常识,再适应具体场景”。
1、Meta-NeRF (21) 用 MAML 框架把「梯度下降」本身学成另一个网络;面对新场景时,Teacher 网络直接输出 Student NeRF 的初始权重,仅需 50-100 步微调即可渲染。
2、MINE (22) 将 IBRNet 先在大规模多场景数据集(RealEstate10K + ACID)预训练,再提供「在线 3 min 微调」接口,手机拍一圈即可得新模型。
3、Block-NeRF / UrbanNeRF (22-23) 对城市场景做「分块 + 外观码」建模,每块独立哈希格,权重共享;新城市只需继续增量训练未覆盖块,实现城市级泛化
最新趋势:大尺度生成式 3D 网络
1、GeNVS / Point-E / Shape-E (OpenAI, 23) 直接把「单图 → 3D 隐式场」做成生成大模型,NeRF 解码器权重固定,只改潜码即可输出全新物体/场景。
2、扩散-NeRF 联合蒸馏 2024-2025 多篇工作将 2D 扩散模型蒸馏成 3D 一致性蒸馏场,同一套权重可 zero-shot 生成人脸、汽车、家具等多类别 3D 资产,完成“2D 大模型 → 3D 大模型”的跃迁
3DGS
参考资料:
2401 3DGS综述 https://arxiv.org/pdf/2401.03890
2407 3DGS综述 https://arxiv.org/pdf/2407.17418
3DGS的应用(分割、编辑、生成):https://arxiv.org/pdf/2508.09977v1
三维重建:Scene reconstruction techniques for autonomous driving: a review of 3D Gaussian splatting
NERF局限:神经辐射场(NeRF)虽实现高质量渲染,但存在计算密集(慢速训练和渲染)和编辑困难(隐式表示难以直接修改)
核心思想
3D 高斯基元定义:每个基元以高斯分布建模,包含位置、尺度、旋转等 7 个可学习几何参数,以及不透明度、球谐函数(SH)系数等外观参数,通过协方差矩阵重参数化保证几何约束。
把整幅三维场景显式地建模成数百万个可学习的 3D 高斯球(3D Gaussian primitives)。
每个高斯球只干四件事:
位置 μ(3-D)
协方差 Σ(3×3,决定椭球形状与朝向)
不透明度 α(1-D,可看成“体积密度”)
视角相关颜色 c(用球谐 SH 系数表示,3×k 维)

训练流程:从稀疏点云或随机初始化基元,通过梯度观察自适应增删基元(克隆、分裂、剪枝),优化过程中周期性重置不透明度以减少伪影。
渲染机制:采用 EWA splatting 方法将 3D 高斯投影到当前视角的 2D 平面,按深度顺序通过 α 混合计算像素颜色,实现高效渲染。
因为整个过程可微,所以只需最小化渲染图与真图差异,就能端到端优化所有高斯参数——既不需要体素网格,也无需隐式 MLP,因而兼顾了NeRF 级质量与点云级速度。
基本流程

初始化 用 COLMAP 做 SfM,得到稀疏点云 + 相机位姿;每个点直接变成一个初始高斯球。
高斯空间建模 为每个球赋予初始 Σ(椭球)、α、SH 颜色系数。
视锥剔除 根据当前相机参数,把落在视锥外的球直接剪掉,节省后续计算。
可微分投影 把 3D 高斯按视图-投影矩阵变换到 2D,得到2D 协方差矩阵 Σ′ = JWΣWᵀJᵀ 其中W是视图变换,J是投影仿射近似的雅可比。
分块光栅化(Tile-based splatting)
1、屏幕被划分为 16×16 像素块(tile)
2、每个球根据 2D 包围盒落入对应 tile
3、同一 tile 内按深度排序后,并行执行 α-混合 该步骤 CUDA 并行度极高,是实时渲染的关键。
损失计算 & 反向传播 损失 = λ₁·L₁ + λ₂·L_D-SSIM 梯度一路流回 μ, Σ, α, SH 所有参数。
自适应密度控制 每迭代 N 帧:
梯度大+尺寸大 → 克隆(clone)
梯度大+尺寸小 → 分裂(split)
α 接近 0 → 剪枝(prune):保证细节区域自动“长”出更多高斯,空洞区域自动填充。
可微渲染:
泼溅(Splatting):将3D高斯投影到2D图像空间。
分块并行:图像划分为16×16像素的tiles,高斯按深度排序后并行渲染,实现实时性能。
Alpha混合:通过类似NeRF的alpha合成公式计算像素颜色,但采用前向光栅化而非光线追踪。
优化过程:
损失函数:L1损失 + D-SSIM损失。
参数更新:优化旋转(四元数)和缩放(3D向量)而非直接优化协方差矩阵,避免非正定问题。
自适应密度控制:克隆小高斯(欠重建区域)和分裂大高斯(过重建区域),并剪枝透明和过大的高斯。
3DGS是怎么做自适应增删基元(也即是密度控制)的?
核心目标:
自适应增删基元是 3DGS 平衡重建质量与效率的核心机制
增基元:补充场景细节,解决 “欠重建” 区域(如边缘、纹理复杂处)的表征不足。
删基元:移除冗余基元(如空旷区域、贡献度低的基元),降低存储与计算开销。
平衡:避免基元数量过多导致效率下降,或过少导致重建质量受损。
判断增基元的依据
梯度反馈:观察基元位置属性在视图空间的梯度,梯度大说明该区域未充分拟合(欠重建),需要增加基元。
几何特征:低不透明度区域、深度渲染误差高的区域,或 SDF 值接近表面的区域,优先增基元。
多视角一致性:未被多个关键帧观测到但语义重要的区域,通过克隆补充覆盖。
增基元的实现方式
克隆:直接复制现有高斯基元,微调位置或属性,快速填充欠重建区域,适用于需要快速补充数量的场景。
分裂:将单个基元拆分为多个子基元,子基元继承原基元的部分属性(如尺度、旋转)并独立优化,适用于需要细化局部细节的场景(如纹理密集处)。
约束机制:通过高斯发散显著性(GDS)或 KL 散度限制相邻基元过近,避免过度密集。
判断删基元的依据
全局重要性评分:结合基元的体积、在训练视图上的命中次数、不透明度,计算全局贡献度,低评分基元优先剪枝。
多视角一致性:在所有虚拟视图中不可见但在真实视图中可见的基元,或未被 3 个以上关键帧观测到的新增基元,视为冗余。
几何特征:尺度过小、远离场景表面(通过 SDF 值判断),或与相邻基元 KL 散度过小(高度相似)的基元,予以删除。
可学习掩码:部分方法引入可学习参数,自动识别并屏蔽非必要基元。
剪枝的实现方式
直接删除:训练过程中周期性筛选冗余基元,直接从表征集合中移除。
软剪枝:通过降低冗余基元的不透明度权重,逐步弱化其对渲染结果的影响,避免突变伪影。
候选池策略:将剪枝后的基元存入候选池,后续需补充时可复用,减少重复初始化开销。
关键约束与优化
周期性执行:增删动作不会实时触发,而是在训练的特定阶段(如每隔一定迭代次数)执行,保证优化稳定性。
不透明度重置:增删过程中会周期性将所有基元不透明度重置为 0,避免剪枝后残留伪影。
任务适配:稀疏视角场景减少增基元频率,避免过拟合;动态场景增加时间维度约束,确保基元增删符合运动规律。
自动驾驶+3DGS
3D Gaussian Splatting(3DGS)凭借 “高效渲染 + 精准几何纹理表征” 的核心优势,正成为自动驾驶感知、场景建模、仿真验证等核心环节的关键技术。其在自动驾驶领域的应用可从场景重建、感知增强、动态建模、仿真闭环四大核心方向展开,具体技术落地价值与对应链接研究如下:
一、高精度场景重建:自动驾驶 “数字底座” 的核心支撑
自动驾驶需要实时构建高精度、高保真的环境模型(如高精地图、周围静态场景),传统点云 / 体素方法存在 “细节丢失”“效率低” 问题,3DGS 通过显式高斯表征实现 “精度 + 效率” 双突破,相关链接研究从框架优化、自监督学习、光照适配三大维度提供解决方案:
AutoSplat 框架(AutoSplat: Constrained Gaussian Splatting for Autonomous Driving Scene Reconstruction):专为自动驾驶场景设计的约束优化型 3DGS 重建方案,可实现高度逼真的场景还原。其核心创新是通过 “物理约束(如道路边界、建筑物结构)+ 高斯参数优化”,解决传统 3DGS 在城市场景中 “边缘模糊”“动态物体干扰” 问题,例如在高速公路场景中,能精准重建护栏、车道线、路侧标识等关键静态元素,为高精地图更新提供 “像素级” 细节支撑。
GaussianOcc 自监督重建(GaussianOcc: Fully Self-supervised and Efficient 3D Occupancy Estimation with Gaussian Splatting):突破 “依赖人工标注” 的行业痛点,通过全自监督 3D 占用估计技术,直接从多视图图像中学习场景的高斯分布特征。在无 LiDAR 标注的城区场景中,可自动区分 “可行驶区域(路面)”“不可行驶区域(绿化带、障碍物)”,占用预测精度比传统监督方法提升 15%-20%,大幅降低高精地图构建的标注成本,适配大规模城市道路的快速建模需求。
LumiGauss 光照适配(LumiGauss: High-Fidelity Outdoor Relighting with 2D Gaussian Splatting):解决自动驾驶 “极端光照场景重建失效” 问题。传统 3D 重建在强光、逆光、雨夜等场景中易出现 “纹理失真”,LumiGauss 通过 2D 高斯表征与环境光照建模结合,可实时调整高斯点的颜色、透明度参数以匹配当前光照条件,例如在暴雨天气下,仍能清晰重建道路标线、交通信号灯等关键视觉元素,保障感知系统的环境鲁棒性。
EGSRAL 自动化标注(EGSRAL:An Enhanced 3D Gaussian Splatting based Renderer with Automated Labeling for Large-Scale Driving Scene):仅依赖训练图像即可完成大规模驾驶场景的 3D 重建与语义标注,无需额外 LiDAR 或人工标注数据。其核心是通过 “高斯点语义聚类 + 多视图一致性校验”,自动为重建场景中的元素(如树木、路灯、交通标志)分配语义标签,例如在城市路口场景中,可同步输出 “行人横道 - 语义标签 + 3D 坐标”“交通灯 - 状态(红 / 绿)+ 空间位置”,为感知模型的半监督训练提供高质量标注数据。
二、感知能力增强:突破 “多模态融合” 与 “深度估计” 瓶颈
自动驾驶感知需要融合视觉、LiDAR 等多模态数据,3DGS 作为 “桥梁” 可实现 “几何(LiDAR)+ 纹理(视觉)” 的统一表征,同时提升深度估计精度,相关链接研究从多模态融合、深度关联两大方向提供技术支撑:
DepthSplat 深度关联(DepthSplat: Connecting Gaussian Splatting and Depth):首次实现 3DGS 与深度估计的直接联动,解决 “视觉 - LiDAR 深度不一致” 问题。其技术逻辑是通过 “高斯点的 3D 位置→投影到 2D 图像像素→与 LiDAR 深度值匹配优化”,建立 “视觉纹理 - 几何深度” 的映射关系,例如在复杂路口场景中,可修正 LiDAR 因 “遮挡(如大型车辆遮挡行人)” 导致的深度跳变,使感知系统对 “弱势交通参与者(行人、骑行者)” 的深度估计误差降低至 5cm 以内,提升目标检测的安全性。
3DGS 与 SLAM 融合(How NeRFs and 3D Gaussian Splatting are Reshaping SLAM: A Survey):传统 SLAM(同步定位与地图构建)在动态场景中易出现 “定位漂移”,3DGS 通过 “动态高斯点过滤 + 静态场景稳定表征”,为 SLAM 提供更可靠的环境模型。例如在拥堵路段,链接 18 的综述研究指出,3DGS-SLAM 可实时区分 “静态背景(道路、建筑物)” 与 “动态物体(行驶车辆、行人)”,仅基于静态高斯点进行定位计算,使定位误差从传统 SLAM 的 0.5m 降低至 0.1m 以内,保障自动驾驶在城区复杂路况下的定位精度。
三、动态场景建模:应对 “复杂交通流” 的核心技术突破
自动驾驶面临的环境包含大量动态物体(车辆、行人、骑行者),传统静态重建方法无法捕捉运动状态,3DGS 通过 “动态高斯表征” 实现对运动物体的精准建模,相关链接研究聚焦 “全场景动态覆盖” 与 “运动状态预测”:
DrivingGaussian 环视动态建模(DrivingGaussian):专为环视相机设计的复合 3DGS 方案,可实现 360° 全方位动态场景重建。其核心创新是 “分区域高斯建模”—— 将环视视野划分为 “近场(0-50m,重点跟踪行人、非机动车)”“远场(50-200m,重点跟踪远距离车辆)”,针对不同区域优化高斯点的密度与更新频率,例如在环岛场景中,可实时捕捉多方向来车的运动轨迹、速度、转向意图,为决策系统提供 “动态风险地图”。
GaussianCity 无边界城市场景(GaussianCity: Generative Gaussian Splatting for Unbounded 3D City Generation):南洋理工大学提出的大规模动态城市场景重建方案,解决 3DGS “场景规模受限” 问题。通过 “高斯点分层存储 + 动态加载” 技术,将城市场景的重建速度提升 60 倍,可实现 “平方公里级” 区域的实时建模(如整个 CBD 区域),同时支持动态交通流的持续更新 —— 例如实时添加新进入场景的车辆、移除离开的物体,为自动驾驶的 “全局路径规划” 提供动态更新的环境模型。
四、仿真闭环:加速自动驾驶算法迭代的 “数字孪生引擎”
自动驾驶算法需要海量场景验证,传统仿真依赖 “人工建模”,存在 “场景覆盖率低”“与真实世界差异大” 问题,3DGS 通过 “高保真场景生成 + 实时交互” 构建更真实的仿真环境,相关研究从 “仿真场景生成”“算法验证” 提供支撑。
3DGS+动态场景
S³Gaussian:自监督动态场景分解的奠基者
技术原理与架构:S³Gaussian(Self-Supervised Street Gaussians)由 UC 伯克利团队提出,核心目标是无需人工标注即可动态分解街道场景中的静态背景与移动物体。其架构包含两大模块:
时空场网络(Spatial-Temporal Field Network)采用多分辨率 Hexplane 编码器,将 4D 输入网格分解为动态特征平面(时空平面)和静态特征平面(仅空间平面)。例如,道路、建筑等静态元素存储于空间平面,而车辆、行人等动态元素通过时空平面捕获时序变化。
多头高斯解码器(Multi-Head Gaussian Decoder)基于编码后的特征,预测高斯点的变形偏移量(如位置、SH 系数),实现动态物体的逐帧更新。例如,行驶中的车辆高斯点会根据运动轨迹实时调整位置。
自监督学习策略
4D 一致性约束通过最小化相邻帧之间的渲染误差(如光度损失、几何一致性损失),隐式区分静态与动态区域。例如,若某高斯点在多帧中位置稳定且颜色一致,则被归类为静态。
CLIP 辅助建模引入 CLIP 模型提取语义特征(如 “车辆”“行人”),增强动态物体的语义感知能力。例如,在无标注数据中,CLIP 可辅助识别车辆区域并优化其高斯参数。
DrivingGaussian:环视动态场景建模的领跑者
技术原理与架构:DrivingGaussian 由北京大学团队提出,专为环视多相机动态场景设计,采用分层建模策略:
增量静态高斯(Incremental Static Gaussians)
按自车运动顺序将场景划分为多个区域(Bin),逐区域渐进式建模静态背景。例如,首先基于 LiDAR 点云初始化近处道路的高斯点,再逐步融合远处建筑的高斯点。
复合动态高斯图(Composite Dynamic Gaussian Graph)
为每个动态目标(如车辆、行人)构建独立的 4D 高斯图,记录其时空属性(如出现时间、运动轨迹)。例如,一辆汽车的高斯图会随其行驶路径动态扩展。
多传感器融合与优化
LiDAR 先验引入:使用 LiDAR 点云初始化高斯点的位置和协方差矩阵,提升几何精度。实验显示,LiDAR 辅助使静态背景重建误差降低 40%。
遮挡处理机制:根据高斯点与摄像机的距离调整不透明度,确保动态目标在遮挡时仍能正确渲染。例如,近景车辆的高斯点不透明度高于远景树木,避免穿透现象。
来源:https://zhuanlan.zhihu.com/p/1972236801889514053
....
#更现实的商业化路线不是一直等「完美单体」
从自驾到~
这两年“xx智能”很热。热到一个现象越来越常见:一提xx智能,很多人脑子里立刻浮现人形机器人;一谈商业化,讨论就自动切换到“什么时候能有一台全能保姆机器人走进千家万户”。仿佛只有等到单体足够通用、足够聪明、足够可靠,而且最好完全无人,才配谈规模化。
但如果把镜头从“单体能力”挪到“商业路径”,会更容易看到另一条更现实的路线:xx智能的第一波商业化,很可能不会等到完美单体,而会像自动驾驶一样,先把一套体系跑通,再让单体在运营中持续变强。
所谓“体系”,不是一句口号,而是一套可复制的链路:现场有能动手的物理执行单元,大部分时间自动完成高频流程;少数关键卡点允许远程短时介入兜底;云端提供更强的模型能力(VLA/多模态/规划与质检),按需付费、持续升级;全流程可审计、可追责、可复盘;数据回流反哺模型与流程,让远程介入越来越少、越来越短;最终提升一个人覆盖多个智能体的能力(NVM),把成本摊薄到商业化成立的区间。
把这条链路看清楚,再回头看“从自动驾驶到xx智能”,会发现变化的不是“有没有人形”,而是同一套方法论在扩场景:从“开车”扩展到“干活”,从“道路”扩展到“家庭、楼宇、园区、城市服务”,从“车辆”扩展到各种机器人与物理执行单元。
1. 先看一个正在发生的铺垫:无人物流车为什么被称为“爆发前夜”
无人物流车/无人配送车的关键,并不只是“车会自己开了”。更重要的是,它在商业上把“开车”这件事改造成了一种可远程接入的服务:
- 大部分时间:车辆在限定场景里自己跑,系统完成常规行驶;
- 少数关键时刻:复杂路口、临停装卸、非标障碍、临时管制、极端边界,由远程人员短时接入兜底。
这一步非常关键:驾驶不再是“必须在场的劳动”,而变成“按需插针的远程服务”。远程人员不需要全程盯一台车,只在必要时介入几十秒到几分钟。只要插针越来越少、越来越短,一个远程人员能覆盖的车就越来越多,人车比(1 对 N)提升,单位成本才可能掉头向下。
而无人物流的规模化收益,也并不只来自“车更聪明”,还来自“运营更会摊成本”:
- 拓市场:从一城一域复制到更多城市/区域;
- 拓规模:车越多、订单越多,调度、远程兜底、运维体系越能共享;
- 降一点成本:不是追求一次性完全无人,而是持续压低介入频次、介入时长、恢复时间;
- 跨区域摊平差异:不同地区的人力与运营成本差异,可以通过远程能力与统一调度体系被摊平,形成更稳定、可复制的商业模型。
这就是典型的“体系先跑通”。而xx智能的商业化,很可能就是把这套模式迁移到更广泛的物理世界任务里。
2. xx智能不等于人形机器人:商业化看的不是形态,而是成本结构与可治理性
人形机器人当然重要:腿能解决轮式到不了的“最后 100 米”,按电梯、开门、跨越障碍等动作更贴合人类环境默认接口。近年来下半身控制能力的成熟,也让“能走、能稳、能越障”的门槛明显下降。
但商业化先看成本结构:稳定交付、一致性、风险边界、责任治理、成本曲线。形态再像人,如果每做一单都要一个人全程盯着、全程遥控,成本结构就不成立。
更关键的是,真实世界永远有长尾。问题不在长尾是否存在,而在长尾能不能被“流程化、治理化”:触发条件是什么?远程介入开放哪些视角与权限?如何留痕审计?出了问题怎么追责?如何复盘并沉淀到模型和流程里?这些能力决定了体系能否扩张,也决定了商业化能否成立。
因此更现实的判断是:xx智能最先规模化的,往往不是“最像人”的那种,而是“最能把体系跑通”的那种。 人形机器人会越来越重要,但它不是商业化的唯一入口,更不是商业化的前置条件。
3. 这套“体系”到底包含什么:把xx智能拆成五层就清晰了
为了避免概念乱用,可以把xx智能体系拆成五层(这五层和自动驾驶的产业结构高度同构):
第一层:物理执行单元(在现场“动手”)
可以是轮式+机械臂、四足、人形、半人形,也可以是固定机械臂与家庭执行器网络(门锁、阀门、开关、升降等)。关键不是形态多酷,而是:覆盖一批高频动作、稳定、可维护、可量产、能复制。
第二层:端侧底座能力(实时、安全、断网可用)
基础感知、低级控制、安全刹停、局部避障导航、状态监测等。这层追求的是“够用、稳定、可控”,而不是“在本地塞进最强大脑”。
第三层:云端高能力(更聪明、更泛化、可迭代)
复杂语义理解、跨任务规划、长程任务编排、复杂异常归因、策略生成、质检复盘、知识更新、模型持续优化等。这里的关键词不是“部署一次就完”,而是“服务化、持续升级、按需付费”。
第四层:远程介入与调度(把长尾从事故变成流程)
远程不是为了长期遥控,而是为了短时插针。更重要的是插针要被系统化:触发、权限、留痕、追责、复盘、沉淀。
第五层:运营治理与数据闭环(让系统越跑越稳)
调度、运维、培训、质检、保险与责任边界、合规审计、事故处置流程,决定体系能否规模化。数据闭环则决定插针能不能越打越薄、人机比能不能越做越高。
这五层一旦连起来,所谓“人机共生”才从一句趋势判断,变成了一个可运营的产业结构:人不消失,但从持续劳动者变成稀缺的异常处理资源与运营资产;系统越跑越稳,人力越“高杠杆”。
4. NVM(一个人覆盖多个智能体)为什么重要:它决定成本能不能被摊薄
很多人提 NVM,会把重点放在“远程操作很酷”。但 NVM 的本质不是酷,而是成本结构是否成立。
要让一个人覆盖多个智能体成立,需要满足三个条件:
1)把持续操作变成短时插针:人只在关键节点介入,而不是全程接管。
2)把插针门槛做低:远程介入更像给目标、给确认、给少量动作,而不是高强度精细操控。
3)把插针结果变成资产:每一次插针都沉淀为训练数据、流程模板、质检样本,推动下一轮减少插针。
VR/AR、手柄、空间对齐等技术的价值也在这里:不是为了炫酷,而是降低操作的心智负担,把复杂操作变成更低维、更可训练的交互;现场执行单元负责避障、越障、稳定控制,远端做高层意图与关键动作。远程人力才能像“云服务”一样被调度和共享,而不是被一台设备绑死。
5. 家政为什么是“最难但也最典型”的场景:不需要等全自主,先把服务关系重构掉
家政是典型的长尾地狱:家庭环境非结构化、物体种类多、摆放随意、任务碎、交互复杂,还叠加隐私与信任问题。但家政同时也是刚需大市场——越难,反而越能检验“体系”的价值。
如果把前提设定为“家政机器人必须完全自主完成所有任务才能落地”,那商业化会被卡很久。但体系化路径是:把家政服务从“陌生人上门”重构为“远程任务化服务 + 现场执行单元”。
用户下单不再是“请一个人来家里干活”,而是一张张任务单:
- 台面整理、餐具归位
- 玩具收纳、垃圾分类
- 做饭流程中的标准步骤(洗切配、上锅、收尾清洁)
- 安全确认(燃气阀门、门窗、电源)并生成记录
执行单元先把能稳定做的大部分完成:移动、避障、抓取放置、简单清洁、按固定流程操作家电。真正难的那 1%(阀门型号千奇百怪、门把手结构多样、抽屉卡住、触控面板反光识别不准等),由远程人员短时插针解决,完成后立刻退出,让系统回到自动流程。
这套模式还有一个被低估的好处:它把传统家政的信任风险重新组织了。传统上门服务存在“人进屋”的不确定性;而远程任务化服务是权限可控、过程可审计的服务供给。平台上可以出现不同技能水平的远程服务人员(会做饭、会整理、会维修),但操作对象始终是家里同一个执行单元,服务关系更稳定、更可追责,甚至更容易沉淀出“家庭偏好档案”和“任务模板”。
此外,家庭成员自己也能成为“远程服务供给”的一部分:例如出门后忘关煤气、忘关电器,完全可以用便携控制设备远程确认或短时处理;或者把任务下放给平台,让远程服务人员接单解决。就像网约车把“开车这件事”平台化之后催生了多样化服务供给一样,家庭端的物理执行单元一旦普及,也会催生更丰富的服务产品形态。
6. 隐私与信任怎么过关:靠机制,不靠口头承诺
远程介入一出现,隐私与安全就会被放大讨论。这是正常的,也必须正面回答:远程人员能看到什么?能做什么?出了事怎么算?
可规模化的做法不是“直播”,而是受控窗口 + 匿名化 + 证据链:
- 敏感区域默认不开放或只开放局部视野
- 人脸、照片墙、证件、门牌号、窗外地标等自动遮挡
- 变声、头像替换、背景模糊等匿名化手段,让“能操作”与“能识别身份”分离
- 最小权限:按单授权,任务结束自动回收
- 全程留痕:视频/指令/关键帧审计,可回放、可追责、可复盘
AIGC 相关技术的进步,让匿名化与受控展示更容易做到工程化落地:看得到完成任务所需信息,但看不到身份与敏感细节。规模化服务最需要的不是“保证永远没事”,而是“出了事能说清、能追责、能改进”。
7. 不止无人物流:清洁、巡检、政务服务等场景,本质上都是同一套路线
xx智能最先落地的场景,通常具备一些共同特征:高频、任务可拆解、流程可标准化、环境相对可控、易审计易复盘。因此它不会只发生在家庭,也不会只发生在无人物流:
- 城市清洁车、扫地机器人:高频任务,异常可插针
- 园区巡检、楼宇运维:流程明确、路径稳定、易审计易复盘
- 政务/服务机器人:大量问题是交互长尾,远程兜底能把服务做稳定
- 商场、酒店、医院等服务场景:任务模板化程度高,更适合体系先跑通
“腿/四足/人形”的价值会在这些场景中逐步显现:不是为了更像人,而是为了覆盖更多现场环境,把轮式到不了的地方纳入执行范围,减少必须人工到场的比例。
8. 算力这件事,决定了xx智能会不会“像手机一样普及”
很多人聊xx智能时默认一个前提:每台设备都得在本地跑一个特别大的模型。但从商业化角度看,这个前提反而经常不成立。
更自然、也更容易规模化的方式是:本地算力 + 云端算力分层,并形成市场化分档。
- 本地侧负责实时、安全、断网可用的底座:基础感知、低级控制、安全刹停、局部避障导航等。追求“够用、稳定、可控”。
- 云端侧负责更强的理解与泛化:复杂语义理解、跨任务规划、长程任务编排、异常归因、策略生成、质检复盘、知识更新等。追求“强大、可迭代、可升级、按量付费”。
于是自然出现“不同价格对应不同体验”的市场化分层:
用户可以买低本地算力版本保证基础可用,也可以买更强云端能力套餐获得更少插针、更高一致性、更强复杂任务处理能力。价格由市场决定,而不是由“每台都得顶配”的工程理想决定。
这也是为什么xx智能很可能会像“手机 + 云服务”一样演进:硬件成本被标准化量产摊薄,能力通过订阅与服务持续升级。对于产业链来说,这种结构更健康;对于用户来说,这种结构更可负担、更可选择。
9. 家政反而更适合云端:实时性要求更低、可等待、可调度
自动驾驶有很强的实时闭环约束,很多决策与控制必须端侧完成,云端更多用于低频更新与离线训练。但家政/室内服务任务不同,很多任务天然是“非紧急、可等待、可排队”的:
整理收纳、擦桌拖地、按步骤做饭、检查阀门、收拾玩具……云端推理延迟几秒甚至几十秒,通常并不影响体验。
这带来几个很实在的好处:
- 云端可以集中更强算力,用更大模型,单位成本反而更低(利用率更高);
- 平台可以做峰谷调度,把重算力任务放到低峰时段;
- 远程人力更容易共享,一个操作员可以同时照看多个家庭端任务;
- 商业化更容易先跑起来,因为约束更少、调度空间更大。
因此“家政服务机器人什么时候能大规模落地”这个问题,答案很可能不是“等到某个完美单体出现”,而是“体系能否把插针做薄、把调度做起来、把成本做下去”。
10. 常识、规则、偏好与隐含约束:为什么家庭场景需要“语言”这一层
xx智能在家庭场景的难点,从来不只是“看见”和“动作”,更难的是“理解任务”。
“把客厅收拾一下”具体包含哪些子任务?收纳标准是什么?玩具进哪一格?垃圾怎么分类?
“把厨房整理干净”是台面清空还是只擦拭?调料瓶要归位还是按使用频次摆放?
“帮忙做个晚饭”不是一步动作,而是多阶段流程:找食材、洗切配、上锅、控制火候、收尾清洁,还要注意燃气安全与卫生。
“别吵到孩子睡觉”“不要把猫吓到”“这套杯子是纪念品别动”“地上那堆线别绊倒”这类隐含约束,很多不是靠视觉直接推出来的。
这些背后是人类社会积累的常识体系:物体用途、家庭习惯、卫生与安全规则、风险优先级、任务完成的“好坏标准”。语言这一层的价值,不是“让机器人能聊天”,而是让这些常识、规则、偏好、隐含约束能被表达、被检索、被推理、被对齐,从而在没见过的家庭、没见过的摆放方式、没见过的设备型号面前仍能泛化。
同时,它还能让远程插针更高效:一次插针不只是记录动作轨迹,还能记录“为什么这样做”“当时的约束是什么”“判断依据是什么”。这些可解释的语义信息,会让后续训练与流程沉淀效率显著更高,飞轮也更容易转起来。
11. 地方转型与岗位重构:从信息平权到资源再组织
xx智能体系的商业化,不只是技术路线,也与地方转型、服务供给不足、产业结构调整强相关。自动化一定会带来岗位结构重构,关键不在于“替代不替代”,而在于迁移路径是否平滑。
远程介入与运营体系会催生一批新岗位:远程操作员、调度员、维保运维、质检培训、流程设计、数据复盘等。工作不再强绑定地理位置,二三线乃至县域也能参与服务供给。对于很多地方来说,这既是承接新制造的机会,也是承接新服务、重建就业结构的机会。
如果说互联网的上半场更像信息平权,那么物联网与xx智能体系更像下一步:让能力与资源跨地域流动,形成更有机的资源分布与重新组织。
结语:从自动驾驶到xx智能,变的是场景,不变的是“体系商业化”的底层逻辑
把这些串起来,会发现“从自动驾驶到xx智能”迁移的不是某个算法,而是一套被验证过的商业化逻辑:
- 大部分时间自动完成高频流程
- 少数关键时刻远程短时插针兜底
- 长尾流程化,可审计、可追责、可复盘
- 本地算力够用就好,云端能力按需购买
- 家政等低实时任务更适合云端调度与异步推理
- 数据闭环把插针越打越薄,人机比越做越高
- 扩市场扩规模摊平固定成本,产业链外溢带来运维维保与新岗位
与其反复追问“人形机器人什么时候普及”,不如换一个更现实的问题:哪些场景最先能把这套体系跑通?本地+云端分层之后,人机比与单位成本能不能持续向下? 这才是xx智能商业化真正的拐点所在。
....
#比亚.迪组织架构地震
撤销第13事业部......
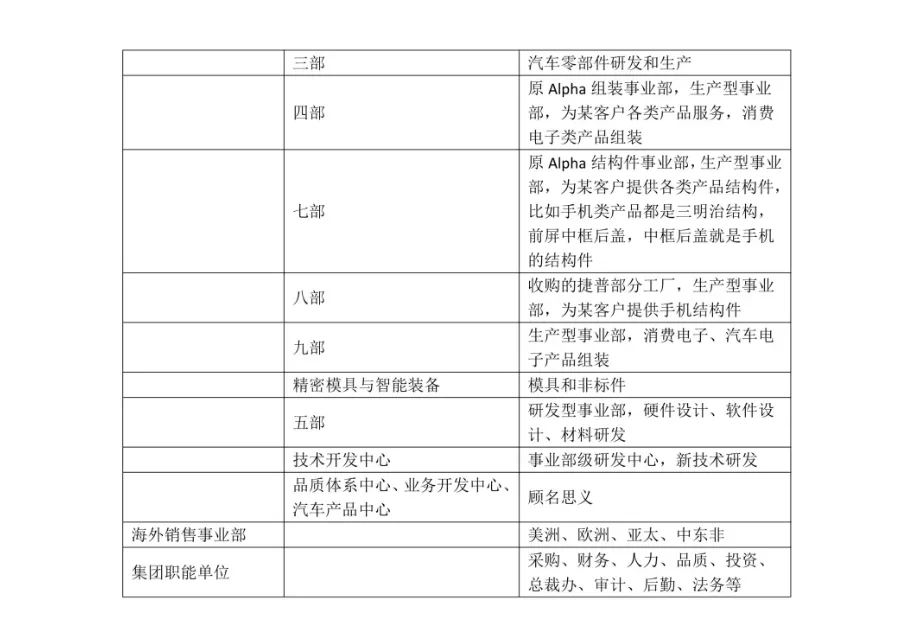
12月27日,比.亚.迪集团启动新一轮组织架构优化,核心变革聚焦汽车事业群,原第十三事业部正式撤销,其模具与车灯业务分别划归汽车工程研究院(L1事业部级)及第十一事业部(L1事业部级)。同步落地的人事任免与事业群体系重构,标志着比.亚.迪在组织效率提升与资源整合上迈出关键一步,旨在进一步巩固其在新能源汽车领域的领先地位。

调整细节:剥离非核心职能,强化垂直管理
此次调整的核心是对原第十三事业部的拆分重组。公开资料显示,第十三事业部前身为2005年成立的弗迪精工,长期聚焦汽车零部件研发与制造,核心业务包括模具设计制造(覆盖整车冲压、焊接等工艺模具开发)、车灯及注塑配件生产(含矩阵式LED大灯、贯穿式尾灯等)、轨道交通零部件(如云轨减震组件)。
调整后,其模具业务划归汽车工程研究院(L1事业部级),车灯业务则整体并入第十一事业部(L1事业部级)。值得关注的是,第十一事业部原本负责整车冲压、焊接、涂装、总装四大工艺及内外饰生产,车灯业务的加入可实现关键零部件与整车制造的无缝衔接;模具业务归入汽车工程研究院,则能强化研发与制造环节的技术联动,缩短新产品开发周期。
人事方面,原商用车事业部总经理罗忠良被任命为汽车事业群商用车事业部总经理(兼,A1级);吴衡出任第十一事业部总经理(总裁直管,B3级),统筹整合后的整车制造及车灯业务;原商用车事业部总经理田春龙调任副总经理(职级降至C2级),免去总经理职务;廉玉波不再兼任第十三事业部总经理(A3级)。

战略意图:应对竞争红海,提升全链条效率
分析人士指出,此次调整是比.亚.迪应对新能源汽车市场竞争加剧的主动求变,核心目标在于“剥离非核心职能、强化垂直管理”,通过组织精简与资源整合提升研发效率、降低跨部门协作成本。
当前,新能源汽车市场已进入“红海竞争”阶段,技术创新速度与成本控制能力成为企业突围的关键。比.亚.迪通过撤销第十三事业部这一“中间层”,将模具、车灯等零部件业务直接融入研发或整车制造体系,可减少管理层级冗余,推动技术需求与制造能力的快速对接。例如,模具业务归入汽车工程研究院后,研发团队可直接参与模具设计优化,避免因跨部门沟通导致的效率损耗;车灯业务并入第十一事业部,则能通过规模化生产与整车工艺协同,降低零部件成本并提升质量稳定性。
此外,调整后的事业群体系进一步明确为汽车、电池、电子、轨道交通四大核心板块,辅以独立型事业部及海外销售单元。其中,汽车事业群作为营收主力,旗下工程研究院与新技术研究院将重点攻关智能驾驶、电驱系统等前沿技术;电池事业群则通过全球生产基地加速钠离子电池等新技术落地。这种“核心板块+专项攻坚”的架构,有助于集中资源突破关键技术瓶颈,应对特斯拉、大众等国际车企的技术追赶。
市场与品牌效应:支撑海外扩张与高端化突破
组织架构优化对海外市场拓展与高端品牌建设亦具重要意义。近年来,比.亚.迪新能源汽车已进入欧洲、东南亚、拉美等多个市场,但海外用户对产品交付周期与技术响应速度的要求更高。通过调整,研发与生产环节的协同效率提升,可更快响应海外市场需求变化,缩短定制化产品开发周期,强化出海竞争力。
在高端品牌领域,比.亚.迪正通过整合资源推动品牌向上。此前,王朝系列与海洋网虽占据主流市场,但高端品牌腾势、仰望的市场表现仍需突破。此次调整后,汽车事业群对乘用车、商用车全链条研发的统筹能力增强,工程研究院与新技术研究院的前沿技术成果(如智能驾驶、电驱系统)可更高效地赋能高端产品线,助力打造差异化竞争优势,打破“性价比”标签,实现品牌价值跃升。
焉知观点:从撤销第十三事业部到重构事业群体系,比.亚.迪此次组织架构调整并非简单的部门合并,而是基于“效率优先、聚焦核心”的战略选择。通过将非核心职能剥离、强化垂直管理与研发协同,比.亚.迪正以组织变革为抓手,为技术研发提速、成本控制优化、海外扩张深化及高端品牌突破铺路。在全球新能源汽车竞争格局加速演变的背景下,这场“刀刃向内”的改革,或将为其巩固行业领先地位注入新动能。
....
#绝大多数的「数据闭环」都是伪闭环
搞自驾这七年,绝大多数的「数据闭环」都是伪闭环
2025 年年底了,我也来回答一下。
先说结论:据我能接触到的一圈国内玩家,大家嘴里的“数据闭环”,绝大多数还是各个算法团队内部的“小闭环”,离当年 PPT 里畅想的那种“数据直接解决问题”的大闭环,还有好几层台阶。
先简单说下我自己的背景(方便大家判断我是不是在瞎说)
我从事自动驾驶行业大概 7 年多了,从最早那种“开完车工程师拎着硬盘,从工控机上拔下来,抱着去机房拷数据”的年代一路干到现在。
这几年主要在一家互联网大厂的物流无人车项目里,从封闭园区到高速公路再到城市公开道路,从载人到拉货都有涉及,负责整车的数据体系和质量体系搭建,带团队做的事情大致包括:
- 设计并落地一整套触发器(Trigger)体系:从车端实时触发,到云端历史数据挖掘、仿真评价,做到代码级统一;
- 搭建从“线上问题发现 → 自动分发 → 数据挖掘 → 训练 / 仿真验证 → 上线回归 → 指标追踪”的闭环平台;
- 把多模态大模型(LLM + VLM)嵌进来,做问题自动分类、自动路由到对应团队,以及辅助研发 / 测试写 Trigger 规则;
- 把“每一次急刹车、每一次接管、每一次奇怪行为”都结构化、可计算,减少拍脑袋和微信群里吵架。
日常工作基本就是跟各种 log、Trigger、标注平台、仿真平台、QA 流程和一堆诡异 bug 打交道,是一个比较典型的“数据闭环 + 质量体系”视角。
下面所有观点,都是站在这个视角下的个人经验,不代表任何公司官方意见。
一、先对齐一下:什么叫“真的数据闭环”?
我心目中“真闭环”,至少要满足三层:
1. 问题发现自动化
不是靠“司机吐槽 + 群里截图 + 领导试驾骂了一句”触发,而是系统能从海量运行数据里自动发现异常行为:
- 急刹、急打方向、蛇形行驶、异常接管激增;
- 某些路段/路口的安全指标或体验指标显著变差;
- 难得一见的安全边缘场景(险撞、鬼探头、复杂博弈)。
- 问题到方案的路径是“可重复、可量化”的
简单讲就是:
一个线上问题 → 自动被归类、建成数据集 → 自动进训练 / 仿真 → 产出候选方案 → 自动评估效果
人主要做的是定义目标 & 拍板,而不是从 0 到 1 手工搬砖。
2. 解决效果可量化、可复盘
新版本上线后,系统要能持续回答三件事:
- 这个问题的发生频率有没有下去?
- 有没有引入新的负面问题?(典型:安全好了体验全崩)
- 这次数据、算力、开发投入,值不值?
一句话概括:
真正的数据闭环,是“问题会自己长脚走完从『被发现』到『被解决并被验证』的路径”,人是设计规则和做决策的,不是不断重复体力劳动的。
二、现实里大多数厂商在做什么?
比较诚实的说法:
今天很多所谓“数据闭环”,其实是“数据驱动的研发流程 + 一些自动化工具”,
而且大多局限在单个算法团队的小视角。
一个典型流水线大概是:
- 线上触发 / 抽取
- 各模块(感知 / 预测 / 规划 / 控制……)各自定义一些 Trigger,捞“疑似有问题”的包;
- 清洗 & 标注
- 离线脚本过滤脏数据;
- 扔给标注平台做 2D/3D/语义/地图各类标注;
- 好一点的有自动 / 半自动标注。
- 训练 / 回归
- 算法选一堆 case 训练,离线回归集跑指标;
- 有条件的多加一步仿真 / 重放。
- 上线 & 监控
- A/B、灰度,上线;
- 继续靠新一轮 Trigger+人工发现问题。
这一套当然也算“闭环”,但更多是模块级、算法视角的小闭环,离“系统级的闭环”差得不少。
三、为什么说“还没真闭”?几个典型断点
1. 起点是“被动闭环”,不是“自动发现问题”
现在大量问题还是这样来的:
- 司机反馈:某个路口老出事;
- 运营/客户投诉:体验太差;
- 领导试驾了一圈觉得某段路不对劲;
- 测试同学肉眼刷录像刷出来的坏 case。
然后才反推:
“我们加个 trigger 把这种情况捞上来吧。”
这其实是问题驱动数据,而不是数据自动发现问题。
理想状态是:
- 安全 / 体验 /效率等指标被持续量化;
- 某个区域、某个版本、某个车型某项指标异常偏离,系统自动报警;
- 自动聚类对应数据包,把相似问题聚成“问题簇”。
这一块目前能做得比较好的厂并不多,大多数还是停留在“若干 Trigger + 一些报表”。
2. 归因困难:只知道“有坑”,但不知道“谁填坑”
同一个现象背后,往往是高度耦合的组合原因:
- 感知偶发漏检 → 预测轨迹偏差 → 规划保守 → 控制多次点刹;
- 地图拓扑错误 → 规划路径不合理;
- 标定漂 / 传感器轻微移位 → 融合结果整体偏。
没有成体系的诊断工具,就容易变成:
- 每个团队都说“不是我,是他”;
- 或者大家各改一点,谁也说不清到底哪步真正解决了问题。
现实里,很多地方还是靠有经验工程师肉眼跳 N 个界面,一点点分析,离“数据自己定位问题”远得很。
3. 数据到“方案”的链路,停在了“数据到模型”
很多团队的闭环,其实可以概括成:
数据 → 标注 → 训练 → 离线指标涨了 → 上线
但是:
- 解决了哪个线上“真实问题”?
- 这次改动的经验,以后能不能自动复用?
- 这次投入算下来值不值?
要么没人追,要么追得很粗。
大多数只是在“技术指标”的层面闭环,
不是在“问题 / 业务”的层面闭环。
4. “自愈”的程度非常有限
PPT 里常见的一条线:
线上问题 → 自动收集 → 自动标注 → 自动训练 → 自动评估 → 自动上线
现实里更像:
- 自动收集:有一部分自动,但经常被各种异常打断;
- 自动标注:有预标,但人力复核仍然是大头;
- 自动训练:流水线是自动的,但选数据、配配置很多手动;
- 自动评估:离线指标自动,仿真和线上表现难以完全自动;
- 自动上线:真到“上路要负责”这一步,大家都不敢真全自动。
所以现在很多所谓“闭环平台”,本质是一个高度自动化的工厂生产线,
而不是一个可以自我决策的“自愈系统”。
5. 组织结构天然把闭环“拆成几节”
还有一个被低估的问题:组织结构本身就是断点。
- 感知、预测、规划、控制、地图、云平台,各有各的 OKR;
- Tier1、整车厂、云服务商,各有各的边界;
- 数据安全、合规、成本,随时可以卡你。
于是:
- 每个团队内部都能画出一条“还挺漂亮”的小闭环;
- 拼在一起,从系统角度看,就是一堆多边形战士。
四、我自己在做的一套数据闭环实践
上面说的是行业横截面,下面讲讲我自己这几年在做的一整套实践。
不敢说“完美闭环”,但我自认为无论是理念还是落地程度,在国内自动驾驶里算比较激进的那一拨:我们是真把“数据当产品、指标当第一公民”来设计的。
整体思路可以概括成一句话:
从“体感指标”出发,用 Trigger 把世界离散成 token,
再用 LLM 做分类和路由,最后用统一代码把“发现”和“验证”串起来。
1. 从“体感指标”出发:先把真实世界的“痛”量化出来
我们做的是物流无人车,乘客不在车里,但客户和路人是有“体感”的:
急刹、急转、蛇形、频繁停、莫名其妙慢,都会投诉。
所以我们从数据上传设计的第一天起,就把一批绝对真实、用户有感的体感指标当作“第一公民”:
- 急刹车次数(按不同等级划分严重度);
- 接管次数(包括现场接管、远程接管、异常切人工);
- 大幅转向、频繁修正方向;
- 一些“体验上明显不对”的行为(比如场景不复杂却极度保守)。
要求很简单也很残酷:
所有的接管、所有的急刹,必须 100% 被记录下来。
不靠人工挑“看起来像问题”的,而是完整如实记录现象。
在云端,这些体感行为会沉淀成类似:
- 每万公里急刹车率(按不同等级分桶);
- 不同道路类型 / 场景下的接管率;
- 不同版本 / 不同区域的体感指标对比。
没有这一层客观、全面的统计,后面讲什么闭环,基本都是 PPT。
同时,我们也彻底放弃那套“拷盘式”数据上传方式,而是做得更像互联网埋点:
- 不是把原始传感器数据一股脑上传;
- 而是按事件上报:
- 事件发生时间;
- 当前驾驶模式(自动 / 远程 / 人工);
- 若干关键环境信息:
- 道路类型(高速 / 城快 / 主干 / 支路 / 园区路 / 场地);
- 周围障碍物的数量级;
- 是否处于路口 / 汇入 / 会车等关键场景。
这样做的目的是:把“真实世界发生了什么”先说清楚,
至于原因之后再慢慢分析。
2. 车端 Trigger:高召回 + 极低开销的 micro log / mini log 机制
我们的车上只有一颗 Orin X,要跑完整套 L4 算法,算力压榨得非常狠,所以车端有几个硬约束:
- Trigger 必须实时,但极其轻量;
- 优先保证高召回,而不是一开始就追求高精度——宁可多报,不能漏报。
车端一旦发生:
- 接管;
- 急刹车;
- 大幅转向;
- 或者其他体感明显不好的动作;
就由一个高召回 Trigger,将前后若干秒的数据打包成一段micro log,加入上传队列。
- micro log 是一段很小的“问题线索”日志切片:
- 带上关键状态、姿态、部分中间结果;
- 体积很小,但足够做第一轮判断。
micro log 上传到云端之后,还会再过一遍云端规则 / 模型管线:
- 用更复杂的规则判断“这是不是一个真正意义上的急刹车 / 异常事件”;
- 比如要求连续若干帧减速度超过阈值、持续时间达标、场景符合要求等。
通过这一步,我们从“高召回的疑似事件”,筛出客观可信的指标事件。
被认定为严重急刹车等一级指标的事件,会触发下一步:
给这一小段时间下发更大粒度数据的上传任务(mini log)。
mini log 里会包含:
- 更多中间结果(比如感知/预测/规划的细致输出);
- 一小段压缩后的视频(十几秒,几 MB 量级),人能看清,又不会压垮带宽和存储。
3. 按团队定制“拉更细数据”:解决问题而不是“只记 KPI”
mini log 到了云端,还要解决一个关键问题:
“这个问题具体应该扔给哪个团队?扔过去之后,他们到底需要什么数据?”
我们先用一拨人工问题分发团队做初分:
- 看 mini log + 短视频,大概分一下:感知 / 规控 / 地图 / 硬件 / 其他;
- 人工分发结果本身,会被记录下来,用于给后面的 LLM 分类做训练数据。
一个重要的设计是:
不是简单地给各团队“记 KPI”,
而是根据分发结果,再给各团队定制上传他们真正需要的数据。
典型比如:
- 分到规控团队:再下发任务,让车上传规划轨迹、约束、代价函数等更细的中间结果;
- 分到感知团队:下发任务拉原始传感器数据,或者更高分辨率/码率的视频,用于重放和训练;
- 分到硬件 / 底盘团队:多拉完整的 CAN 报文、电源状态、温度、电机、传感器健康状态等。
也就是说:
第一层触发只上传非常轻量的“问题线索”,
确认这个线索值钱之后,再有选择地拉重数据上来,
避免一开始就“云端无限吞吐原始数据”的浪费。
4. 代码级统一:车端挖掘 / 云端挖掘 / 仿真验证用“同一段代码”
这一点是我个人非常看重、也觉得很多团队没做到的:
我们把车端数据挖掘、云端历史数据挖掘、仿真验证评价
做到了Trigger 逻辑代码级统一。
什么意思?
- 定义“什么叫一个问题”的那段逻辑(Trigger),
既可以在车上实时跑,也可以在云上跑全量历史数据;
- 同一段 Trigger 逻辑,也可以直接在仿真 / 重放的验证集上跑,用来评估新版本是否改善了这个问题。
好处很直接:
- 一套规则,从“线上发现问题”到“仿真里验证问题是否被修复”,完整走一圈;
- 中间没有“语义断层”和“实现偏差”;
- 真正做到:
同一段代码定义的问题 → 挖训练 / 验证数据 → 改算法 →
再用同一段代码去验证“这个问题在线上和仿真里是不是都变好了”。
在我看来,这一层才能称得上是真正的“从发现到验证”的闭环。
很多团队只是在“数据采集”和“模型训练”之间画了一条线,就说完成数据闭环,其实差了这一大块。
五、问题自动分发:把 Trigger 体系当成领域专用 tokenizer + classifier
再往下一层,就是怎么把“问题线索”自动、可靠地分发到对应团队。
我们做了一套比较“学术味”的设计,本质上是:
在多模态时序日志上,构建一个领域专用 tokenizer + classifier 的两阶段架构:
前半段是特征工程,后半段是时序分类。
- Trigger = 领域专用的时序 tokenizer / 特征工程
线上所有的数据流(传感器、状态机、控制指令、报文……),都会被各种 Trigger 扫一遍:
- 每个 Trigger 都可以看作一个领域专用 tokenizer:
- 在原始连续时序信号上,识别出某类“事件片段”;
- 把它编码成一个离散 token:发生时间 + 事件类型 + 若干关键属性。
- 这本质上就是特征工程:
- 把“车速、加速度、障碍物尺寸、预测轨迹、控制指令”等底层数值,
映射成“障碍物尺寸突变”“预测线跳变”“因某障碍物急刹车”这样的高层语义事件。
最终得到的是一串多模态时序事件序列,可以类比成:
从波形到音素 / subword 的过程 —— 先切分,后建模。
2. 文本化:把这些 token 对齐到 LLM 的词表空间
为了让通用大模型(LLM)能直接利用这些结构化事件,我们会把上述时序 token 再做一次文本化映射:
- 把某段 micro/mini log 对应的 Trigger 序列,转写成一段 LLM 易于理解的“事件时间线”;
- 比如:
第 3 秒:前方某障碍物的感知尺寸出现明显跳变,疑似距离估计不稳定;
第 5 秒:同一障碍物的预测轨迹发生明显跳动;
第 10 秒:车辆因为该障碍物触发了紧急制动事件。
从模型视角看,这一步就是把我们自定义的 token 序列,
投射到通用 LLM 的词表空间里,完成一次语义对齐。
3. LLM = 时序事件序列 classifier
在这个表示之上,我们把 LLM 当成一个时序事件序列的 classifier 来用:
- 输入:一段“车辆从正常驾驶到急刹的文本时间线”;
- 输出:
- 对这次事件的主导原因归因(感知估计波动 / 预测不稳定 / 规划博弈失败 / 控制执行异常 / 底盘异常……);
- 建议的责任域 / 团队路由(感知 / 规控 / 地图 / 硬件 / 其他)。
用机器学习的话说,就是很标准的:
feature engineering(Trigger + 文本化) → sequence classification(LLM)的流水线。
Trigger 把原始高维、多模态、长时序信号压成“抽象 token 序列”,
LLM 在这串 token 上建模时序依赖,做判别。
4. 用真实“改派行为”做弱监督,形成 online 学习闭环
更关键的是,我们不是拍脑袋觉得“分类应该挺准”,
而是用真实的研发“改派行为”做弱监督标签,形成一个在线学习闭环:
- 所有自动分发出去的问题,都会挂在统一的问题管理系统;
- 我们只统计研发真实有回复的问题:
- 如果研发回复时,并没有修改自动分发的团队 / 子模块 → 记为一次命中;
- 如果研发回复时,把问题从“感知问题”改成“规控问题” → 记为一个 bad case。
- 所有 bad case 会自动回流到 LLM 的分类知识库,用来更新分类边界。
从 ML 视角看,就是:
用研发“改派”作为弱监督标签,在真实线上分布下做 continual learning,
让 classifier 在真实业务分布下越用越准。
六、Trigger 框架统一:Python + 大模型,让“写规则”变成大众技能
前面说了,我们做到了“车端挖掘 / 云端挖掘 / 仿真验证用一套 Trigger 代码”。
这里补充一个实现细节,也是我非常在意的一点:
所有 Trigger 逻辑统一用纯 Python 实现,并且跨平台可跑。
为什么这么做?因为这直接决定:
- Trigger 上手门槛有多高;
- 有多少非算法的同学(测试、运营、QA)也能参与写规则;
- 有多少经验能从“嘴上说说”变成“代码”。
我们做了几件事:
1. 统一 Trigger 框架与接口
- 不管跑在车端、云端历史数据挖掘,还是仿真评价,
写 Trigger 面对的是同一套 Python 接口和运行模型; - 只要会一点 Python,测试 / 数据 / 运营同学都能写自己的“问题触发器”。
2. 写好大模型“看得懂”的文档和示例
- 给 Trigger 框架写了结构化、示例丰富的文档,
让 LLM 能理解“Trigger 怎么写、输入输出是什么”; - 然后做一个小工具:研发 / 测试只需要用自然语言描述“想监控什么现象”;
LLM 根据文档 + 示例,生成一段可跑的 Trigger 代码,人再微调。
3. 更多、更细的 Trigger → 更“密”的标签
当写 Trigger 不再是某几个资深算法的特权,而是:
“懂业务 + 一点 Python + LLM 辅助”就能上手
自然结果就是:
- Trigger 的数量和覆盖度急剧增加;
- 每一帧数据上被打的标签越来越多维度(体感行为、场景属性、算法中间状态……);
- 这反过来进一步提升:
- LLM 做问题分类 / 根因分析的输入质量;
- 自动数据挖掘和构建训练 / 仿真数据集的效率。
本质上,我们是用“Python Trigger 框架 + LLM”
把过去散落在脑子和会议里的经验,逐步固化成一个可协同维护、可演进的“规则代码库”,
并直接挂在数据闭环的主链路上。
4. 量产环境中的解耦:挖数 Trigger 当“配置”,脚本跑在车端沙箱里
现实里还有一个非常关键、但容易被忽略的工程问题:
量产环境的版本更新是非常慢的
同一时间路上可能跑着一堆不同版本,
但数据挖掘的需求却是高度实时、强时效性的。
举个特别常见的例子:
某个城市突然下大雪,就这几天;
你必须在有限的时间窗口里,把雪天的数据赶紧挖上来;
不可能等一个“带新 Trigger 的版本”完整上线全网。
为了解决这个矛盾,我们在设计里把“数据挖掘 Trigger”和“线上算法版本”彻底解耦:
- 挖数 Trigger 在车端更像是规则标签的组合,是“配置”而不是固化在主代码里
算法同学如果有新增的挖掘需求,不需要等主版本发版;
云端可以下发一份“挖掘配置”(哪类 trigger、什么场景、什么条件组合),车辆收到后按配置执行挖掘逻辑。
- 在车辆行驶过程中,可以下发挖数脚本,这些脚本跑在车端沙箱环境中,由于性能限制,我们只在车辆不再执行自动驾驶任务的时候执行脚本,沙箱环境与正式线上算法解耦,不会影响主流程安全和实时性;
允许我们针对某一段时间 / 某一类场景,快速上线一段挖掘逻辑,
比如“只在雪天 + 城市主干路 + 车速 30km/h 以下时挖某类数据”。
- 挖数行为在云端可控:不是“开了就忘”,而是动态启停
在量产环境中,数据挖掘绝对不可能无限制,
我们会在云端对挖掘策略做动态控制:
一旦某个挖掘任务的数据量“够了”(覆盖了必要的场景和分布),
云端会自动下发关闭 / 降采样的指令;
这样可以避免:
大量重复、无意义的数据;
不必要的带宽、存储成本浪费。
整体来看,这一套机制保证了:
挖数能力不跟随主版本节奏慢吞吞走,可以相对灵活地应对突发场景(例如极端天气);
同时又不破坏量产环境的稳定性,安全、实时的主算法和“更激进的挖数逻辑”严格隔离;
挖数本身也在闭环:数据够了就自动收手,不做无意义堆量。
七、区分“世界标签”和“算法标签”,以及向量检索的正确用法
有了这么多标签,还有一个经常被忽略但非常重要的点:
要把“客观物理世界的标签”和“算法中间结果标签”严格区分。
1. 世界标签 vs 算法标签:两条不同的轴
我们体系里维护两类标签:
- 客观物理世界 / 场景标签(world-level)
不依赖当前算法好坏,尽量接近“世界本身”:
- 天气:晴 / 阴 / 雨 / 雾 / 夜间等;
- 场景:高速 / 城市快速 / 主干 / 支路 / 园区 / 停车场;
- 道路结构:有无遮挡路口 / 十字 / T 字 / 环岛 / 无路口;
- 交通参与者:行人、非机动车、机动车的大致数量区间;
- 车速、流量、车道数等。
- 用于支撑更精细的筛选和分布分析,比如:
- “只看雨天、城市支路、车速 <30 km/h 的急刹车”;
- “只看有弱势交通参与者、且在路口附近的接管”。
- 算法中间结果 / 表现标签(model-level)
强依赖算法实现: - 感知的检测框是否抖、尺寸是否异常变化;
- 预测轨迹是否短时间大幅跳变;
- 规划是否频繁重规划、是否在安全约束边缘抖动;
- 控制是否出现“油门刹车来回切”的不稳定模式。
- 更适合作为归因与调参的特征,而不是描述世界本身。
这两类如果不分,就容易变成:
你以为在看“现实世界的难度分布”,
实际上是在看“当前算法在哪些地方表现得更差”。
2. “全靠向量检索”的伪闭环:为什么不适合做粗筛
还有一个常见误区:
“把原始数据丢给一个模型做 embedding,再用以图搜图 / 向量最近邻检索,就能搞定数据挖掘。”
这类方法当然有用,但绝对不是主力入口,尤其面对海量存量数据时问题很大:
- 未筛选的全量数据做向量检索:
- 召回太大、成本太高;
- embedding 语义受训练分布影响很大,“看起来相似其实不相干”的情况很多;
- 你真正想要的长尾场景很容易被淹没。
更合理的姿势是:向量检索做精筛,不做粗筛。
我们的做法:
- 先用结构化标签规则,把 80%–90% 的无效数据筛掉
比如想挖“老奶奶过马路”的场景,即便感知里没有“老奶奶”这个类别,也可以先用规则过滤一遍:
- 必须在路口附近;
- 车辆有明显减速甚至短暂停车;
- 周围存在近距离行人目标。
- 先把高速、畅通路段全扔掉,再往下看。
- 在规则过滤后的子集上,用向量检索补做语义级细筛
- 此时数据量已大幅缩小;
- 模型可以在这个子集中进一步区分:老年人 vs 年轻人、独自 vs 有人陪同、慢速穿越 vs 停顿再走等;
- 整体效率更高,算力浪费更少。
总结一句:
向量检索是精细手术刀,不是砍树的斧子。
对存量数据,一定要先靠结构化标签缩小空间,再让 embedding 去“挑刺”。
八、生成式 / 仿真数据:用得上,但不能拿来“自嗨”
最后讲讲最近很火的“生成式数据 / 仿真数据”,以及它在这套体系里的位置。
我们团队也有比较成熟的仿真数据生产能力(包括基于高斯表征的场景生成等),但内部有个共识:
生成式数据是用来补长尾训练短板的手段, 不是用来替代真实评测的万灵药。
1. 生成数据主要用在“现实里很难凑齐”的长尾场景
在训练层面,我们重点把生成式数据投到:
现实中很难大量遇到、但又很关键的场景,比如: 路上的锥桶、临时围挡; 路面坑洼、塌陷、突出结构; 某些复合稀有工况。
目的很简单:
扩大模型在这些长尾 case 上的“见世面”; 给模型一个“这类东西可能出现”的先验; 在真实数据不够丰富时,把召回先拉起来一点。
但 最终用于评测和放行的评测集,我们仍然坚持只用真实数据。 因为你永远无法证明自己“完全模拟了真实世界”,只能让真实世界来兜底。
2. 只看“召回涨了”是不够的:误检的副作用常被忽视
以感知为例,生成式数据拉召回,很容易引入另一个风险:
在已有评测集上,召回率确实能看到在涨; 但在未知分布 / 新场景里,误检可能在悄悄恶化。
更麻烦的是,现实流程里:
增量标注几乎都优先关注漏检(FN); 误检(FP)很难在评测集中完全覆盖: 你不可能预先知道模型将来会“哪里莫名其妙多出框”,也就无法在所有潜在位置都画一遍真值。
于是就容易出现一种错觉:
评测集上召回涨了,FP 指标表面看着也还好, 大家都很开心, 但真实线上有些区域模型已经开始“到处乱看东西”。
3. 我们的做法:版本间逐帧全量 diff,不先争真值,先看差异模式
我们在这块的策略是:
对两个版本,在同一批数据上的逐帧全量差分,系统性监控副作用。
具体步骤:
- 选一批有代表性的真实评测集;
- 用版本 A 和版本 B 分别跑一遍,拿到两套感知结果;
- 对结果做逐帧、逐目标的全量比对,标记所有“不一致”的地方。
一个关键点是:
只要两个版本在某一帧某位置给出的结果不一样,
那么就一定是“有一个错,或者两个都错”。
至于谁对谁错,我们可以先不急着判断。
在“不争真值”的前提下,我们先做的是差异模式分析:
- 给差异打维度标签:
- 距离段(0–20m、20–40m……);
- 方位(前 / 侧 / 后);
- 类别维度:是多了目标,还是少了目标;
- 对这些维度做统计和排序:
- 看哪些距离段 / 类别 / 方位,在新版本下“差异特别多”。
接着再结合人工抽查、可视化检查:
- 哪些差异是“召回真正变好”;
- 哪些是“误检开始泛滥”。
如果在某些维度新版本的误检明显爆炸,
那么在我们这边,即便研发同学拿着召回曲线说“涨了很多”,
QA 这边这关也是不会放行的。
工程实践里,“涨多少”不是唯一指标,“涨得干不干净”同样重要。
尾声:从 Data-Driven 到 Bug-Driven,再到真正的数据驱动
写了这么多“数据闭环 / 数据驱动”,如果让我给现在这套东西起一个更诚实的名字,我反而会叫它:
Bug-Driven 开发体系。
听上去一点也不“高大上”,甚至有点土,但这几年实践下来,真正在一线推动车辆迭代往前走的,往往就是一个个具体的 bug:
- 某个路口总是左转犹豫;
- 某段路总是在鬼畜急刹;
- 某种障碍物在某种光照下经常漏检 / 误检。
我们搭建的所有数据体系,本质上就是:
更快、更准、更系统地发现这些 bug,量化这些 bug,跟踪这些 bug 的出现与消失。
如果说现在这套体系还有什么让我不敢说“已经跑顺了”的,那卡口已经不在“发现问题”这一侧,而是在:
“谁来解决问题、怎么解决问题”这一侧。
哪怕我能:
- 把问题发现得再多、分类再精细、优先级排得再合理,
- 真正能“动手解决”的,始终是团队里那几拨研发同学。
人的带宽是刚性的,长尾问题也不是一朝一夕能搞定的:
- 对感知来说,解决一个问题往往还是:采集数据 → 标注真值 → 训练 → 回归 → 上线;
- 标注这件事尽管业界都在宣传什么自动标注率,但从标注公司生意的景气程度就能看出来:
人工标注依然是非常硬的一环; - 仿真验证这边,也绕不开那句老话:
仿真结果到底能不能代表真实世界?
你说完全能,自己都不会信;你说完全不能,又很难支撑大规模自动化验证。
这些都是当下整条数据闭环链路里普遍存在的问题:
问题可以被越来越精准地“抬上手术台”,但做手术的人、手术刀的效率、术后评估体系,还远远没有那么优雅。
好消息是,最近这两年有两个方向,我觉得是值得乐观一点的:
1. 端到端 / 模仿学习类架构的兴起
在端到端视角下,“标签”更多直接对齐人类驾驶员的行为表现:
- 中间结果的对错、模块边界的划分没那么重要;
- 可以更直接地用“人类怎么开”去约束整体行为。
这在某种程度上绕开了很多“中间真值极难标”的问题,也给“真值标注”找到了一个更自然的出口。 - 闭环仿真 / 世界模型的快速发展
大家频繁讨论的世界模型,本质上就是想把:
“在仿真里充分暴露问题、充分迭代”
这一环做得更接近真实世界。
一些头部玩家公开说他们有非常大的工程投入砸在最后的验证环节上,本质也是在强调:
如果闭环仿真这一环不做扎实,前面的“数据闭环”很难给真正的安全感。
我自己的判断是:
如果未来我们能够真正降低解决一个 bug 的边际成本,
让端到端 / 世界模型类的方法在验证和安全约束上更可控,
再叠加这几年在 Trigger 体系、标签体系、自动分类、代码统一这些工程实践上的积累,
那么大家这些年挂在嘴边的“Data-Driven”,
才有可能从口号,变成一套能持续跑、能算账、能规模化复制的基础设施。
到那时候,“数据闭环”大概就不会再被拿来当卖点讲,
就像今天没人再把 CI/CD 当成卖点一样——
....
#百度X-Driver
可闭环评测的VLA
VLA01 02系列中EMMA OpenEMMA都没有在闭环的场景下验证,其实很关键,因为开环和闭环评测根本不是一回事,开环的指标也并不靠谱,这个志琦大佬的文章很早就讨论的这个问题:
那么前段时间,哈工大和百度的X-Driver:Explainable Autonomous Driving with Vision-Language Models 终于有闭环评测指标了,闭环因为要实际控车,所以这种闭环指标才是衡量一个端到端方案的性能的更合理方案。今天继续来学习,看看闭环怎么做~
X-Driver
- 论文链接:https://arxiv.org/pdf/2505.05098
- 代码:不开源
Motivation
目前基于 MLLM 的框架难以进行闭环评估,在现实世界的驾驶场景中存在幻觉和缺乏稳定轨迹输出,现有的方案在闭环评估中的成功率仍然很低,因此把怎么把VLA跑闭环非常重要。
那么就提出来了X-Driver,一个专为闭环自动驾驶而设计的统一多模态大型语言模型(MLLMs) 框架,利用思维链 (CoT) 和自回归建模来增强感知和决策。
核心强调两点:
- 使用 CARLA 仿真环境进行闭环测试( Bench2Drive)在多个自动驾驶任务中验证 X-Driver。
- 也是采用了结构化COT推理的方式(和EMMA做法趋同)
方法架构:
系统利用具有集成 CoT 推理机制的 MLLM来增强自动驾驶决策,MLLM 执行场景理解、导航指令解释和交通规则理解
输入:来自摄像头数据的图像和 表示导航命令和提示的文本。
输出:思维链推理过程,最后的是驾驶决策(waypoints)
该系统以闭环方式运行,执行的动作会影响现实世界的环境,生成新的感知数据以进行持续优化
核心组件:LLaVA
LLaVA就和原生多模态大模型不一样了,是特征对齐后的多模态大模型。
模型结构:使用CLIP的image encoderViT-L/14的最后一层提取image embedding,然后使用一个映射网络将image embedding映射到text embedding维度空间,然后输入vicuna微调的LLaMa网络。
LLaVA系列解读可以看这里:lumosity:多模态理解-LLaVA系列:LLaVA, LLaVA-1.5, LLaVA-NeXT, LLaVA-OneVersion等
对于于公式:
T:文本输入,所有提示、导航命令和场景描述都统一到一个文本序列中,I :表示每个时间步的帧图像输入
方法:CoT fusion 训练
利用具有高质量 CoT 提示数据的监督微调 (SFT) 来增强自动驾驶场景中的推理和决策能力。
将分步推理示例整合到模型输入中,以鼓励结构化、合乎逻辑的思维,而不是让模型仅仅输出孤立的决策。
CoT 推理框架两个关键维度上,也比较合理:
- 包括对复杂 3D 驾驶环境的准确感知和解释,包括对动态物体的位置、速度和轨迹的精确预测。这些物体包括步行速度和意图不同的行人、可能突然改变方向的骑行者,以及表现出不同驾驶行为(如加速、制动或变道)的不同大小的车辆(例如,汽车、卡车、摩托车)。此外,它还确保实时识别障碍物,例如道路碎片、建筑障碍物和静止车辆,以及精确的空间定位,以保持安全导航。
- 包括对导航指令的深入理解和对交通法规的遵守,包括通过区分标准红、黄和绿信号来识别交通信号灯状态,以及更复杂的变化,例如闪烁的黄灯或行人控制信号。此外,它还需要解释交通标志,包括监管标志(例如,停止、让行、限速)、警告标志(例如,急转弯、人行横道)和信息标志(例如,高速公路出口、距离标记)。准确的车道检测和决策也至关重要,包括检测不同条件下的车道边界(例如,褪色的标记、车辆的遮挡)、区分实线和虚线以进行合法变道,以及识别特殊车道,例如公交车道、自行车道和转弯车道,以确保合法和高效的驾驶。
图像编码器选择(VQ-VAE会丢失信息):
为了确保更高的性能和对图像的理解和不丢失场景信息,不使用 VQ-VAE这样的离散编码方法。相反,我们采用连续图像编码方法,首先将原始图像通过 ViT encoder 来获得低维特征图。可保留更丰富的场景信息。
实验发现,当远处出现红绿灯时,使用 VQ-VAE 编码可能会导致有关红绿灯的关键信息丢失。相反,使用 VAE 编码可以有效地保留这些基本信息。
SFT训练过程:
CoT 方法基本上将原始任务分解为四个子任务,例如对象检测、红绿灯状态、交通标志和车道信息。然后,该模型将这些中间结果整合为历史tokens,并利用当前传感器输入(单帧前视),以生成最终驾驶决策并预测下一个waypoint。
方法:CoT Reasoning 过程
从生成高质量的 CoT 训练数据开始,结合摄像头输入、当前车速组成训练数据。
随后,MLLM 对这些传感器输入进行深度多模态融合和分析,在 CoT 提示的系统指导下,阐明一个清晰的、循序渐进的推理过程。模型首先确定对象的位置、运动方向和类别。如下图所示
然后,它根据上下文线索分析该对象是否值得关注。如果认为有必要注意,该模型会为关注对象提供基于推理的解释,并随后相应地更新其最终决策。
表 1 说明了自动驾驶中遇到的典型驾驶场景,并附有指导 MLLM 完成明确、合乎逻辑的决策步骤的详细提示。
这些提示指导模型要求模型严格遵守安全准则和交通规则,从而减少错误的驾驶决策。
方法:Closed-loop Autonomous Driving Framework(重点)
MLLM 根据当前单帧图像输入和车速 预测 实时驾驶命令和相应的waypoints。
随后,ego车辆根据这些waypoints和决策命令动态调整其运动,从而获得新的传感器输入和车速,从而维持一个闭环控制机制。
闭环仿真实验
这里重点看看闭环实验~
定性分析:
上图是不用CoT的,直接把人创倒了,但是我很好奇下图的第一帧没有行人出现,为什么COT推理还是要求停车呢?
在 4 所示的闭环消融实验中,CoT 方法的明显优势是显而易见的。CoT 版本成功识别过马路的行人并迅速启动制动以避免碰撞。
定量分析:
★
Bench2Drive数据集介绍:具有 200 万+ 帧的仿真基准测试,用于评估不同条件(城市、高速公路、恶劣天气)下的闭环驾驶性能。 (非真实传感器仿真,而是游戏引擎类生成的数据)
使用 CARLA 仿真环境闭环评估,重点关注Driving Score和Success Rate作为关键指标。
Driving Score 通过考虑路线遵守、速度控制和交通规则合规性等因素来评估整体驾驶质量
Success Rate 衡量成功完成驾驶任务的百分比,确保车辆在没有碰撞或重大违规的情况下到达目的地。
Bench2Drive 数据集上使用 500K 和 2.2M 样本与 UniAD对比。表 4 中描述的结果表明,进一步证实了纳入 CoT 推理可以显着提高 MLLM 的决策准确性。
可以看到成功率仍然惨不忍睹
总结:
目前来看闭环仿真器上的成功率还是处于20%的程度,本文没有披露使用了多少数据量来做。另外使用仿真数据测试和现实也存在GAP,不能完全考虑。
目前来看MLLM结合Cot能做一个大概的驾驶决策,但直接控车效果太差了,所以现在大家还是倾向用于慢系统作为一个决策轨迹初始解,来加速下游的planning搜索
....
#深扒了学术界和工业界的「空间智能」
更多的还停留在表层......
“空间智能不仅是看清世界,更是理解世界是如何在三维空间中运作的。” —— 随着李飞飞(Fei-Fei Li)对 Spatial Intelligence 的定义深入人心,2025 年成为了自动驾驶从“感知驱动”向“空间智能”全面转型的分水岭。
先回答第一个问题,什么是空间智能?广义上来说:空间智能是 对空间信息(位置、距离、方位、形状、运动、拓扑关系等)进行感知、表征、推理、决策与交互的综合能力,是智能体(人类、机器人、自动驾驶系统)与物理世界交互的核心基础。其本质是将三维物理空间的复杂信息转化为可计算、可理解的模型,进而支撑导航、避障、操作、场景理解等任务。
所以很多技术都可以和空间智能相结合,BEV感知、端到端、VLA、世界模型等等。今天xx就和大家盘一下自驾领域内和空间智能相关的工作,主要分为四大模块:
- 世界模型在重构物理世界的“预演能力”
- 多模态推理实现从“语义描述”到“几何推理”
- 三维物理实体的“实时数字孪生”
- xx融合——打破“车”与“人”的空间隔阂
一、世界模型在重构物理世界的“预演能力”
1. GAIA-2 & GAIA-3 (Wayve)
- GAIA-2 模型:
- 论文标题:GAIA-2: A Controllable Multi-View Generative World Model for Autonomous Driving
- 论文链接:https://arxiv.org/pdf/2503.20523
一句话总结:GAIA-2 是一种面向自动驾驶的多视图生成式世界模型。它通过潜在扩散技术,将自车动力学、道路语义及多智能体交互作为控制条件,生成符合物理规律且时空一致的驾驶视频。通过统一的生成框架,支持从零构建场景、长序列预测及精准内容编辑等多种推理模式,为破解自动驾驶的长尾效应(Edge Cases)提供了关键的数据闭环方案。
- GAIA-3模型:
- 论文标题:GAIA-3: Scaling World Models to Power Safety and Evaluation
- 项目主页:https://wayve.ai/thinking/gaia-3/
GAIA-2 到 GAIA-3 的进化: GAIA-3 将规模提升 5 倍,旨在通过捕获细粒度的时空上下文(如行人的微表情与车辆动态),表征现实世界的物理因果结构。
空间关联: 它们不仅是在生成视频,而是在构建一个具备物理常识的“沙盒”。
空间突破: 通过潜在扩散模型(LDM)和超高空间压缩比(),GAIA 系列实现了多相机视角下的时空一致性。这意味着 AI 真正理解了多摄像头之间的几何关联,能够生成符合三维拓扑规律的长序列驾驶场景,解决了“幻觉”导致的空间扭曲。
2. ReSim (NeurIPS 2025)
- 论文标题:ReSim: Reliable World Simulation for Autonomous Driving
- 论文链接:https://arxiv.org/pdf/2506.09981
- 提出机构:香港中文大学、香港大学、上海AI Lab、英伟达、小米、上海交通大学、德国霍宾根大学
一句话总结:ReSim通过将真实世界的专家轨迹与模拟器(如 CARLA)生成的非专家/危险行为数据进行异构融合,利用扩散 Transformer 架构实现了在开放场景下对极端与罕见驾驶行为的高保真、强可控模拟。
空间关联: 解决了 AI 对极端空间状态(如碰撞、违章)的认知缺失。
空间突破: 它将真实专家轨迹与模拟器的“危险动作”异构融合。利用扩散 Transformer,AI 不再只学习“怎么开”,更学会了“撞车瞬间的空间演变”,实现了对罕见、高风险物理交互的高保真模拟。
二、多模态推理实现从“语义描述”到“几何推理”
3. SIG (NeurIPS 2025)
- 论文标题:Towards Physics-informed Spatial Intelligence with Human Priors: An Autonomous Driving Pilot Study
- 论文链接:https://arxiv.org/pdf/2510.21160
- 提出机构:霍普金斯大学
一句话总结:该研究提出了一种名为“空间智能网格(SIG)”的结构化图谱方案,通过将场景布局、物体关系及物理先验显式编码为网格语义,替代了传统的纯文本提示(VQA),并建立了配套的 SIGBench 基准,旨在解决多模态大模型在自动驾驶中依赖语言捷径、缺乏真实几何推理能力的难题。
空间关联: 挑战大模型的“语言捷径”,强制进行结构化几何推理。
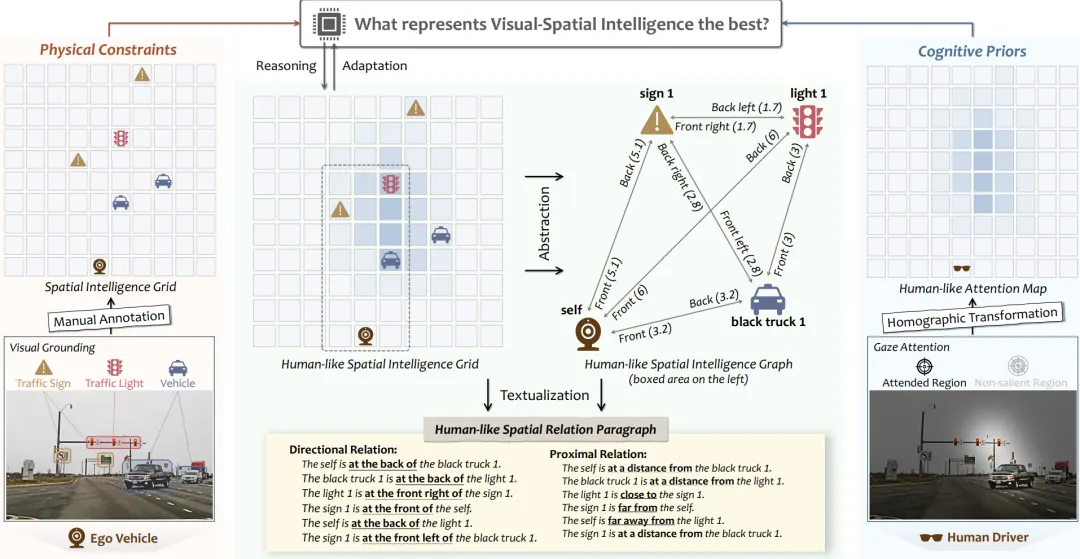
4. OmniDrive (CVPR 2025)
- 论文标题:OmniDrive: A Holistic Vision-Language Dataset for Autonomous Driving with Counterfactual Reasoning
- 论文链接:https://arxiv.org/html/2504.04348v1
- 提出机构:英伟达、香港理工大学、北京理工大学
一句话总结:OmniDrive通过引入“反事实推理”生成大规模 3D 问答数据集,并配合 Omni-L/Q 代理模型,实现了视觉语言模型从 2D 认知向 3D 空间理解与规划的深度对齐
空间关联: 实现 2D 语义向 3D 空间规划 的对齐。
空间突破: 引入“反事实推理”(如果我当时左转会怎样?)。它通过大规模 3D 问答数据集,弥补了语言逻辑与物理轨迹之间的鸿沟,让 VLM 能够真正理解三维环境下的风险评估。
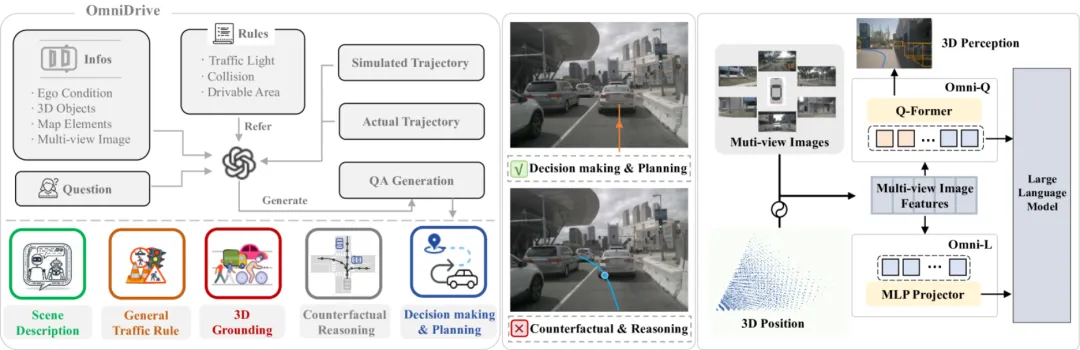
5. SimLingo (CVPR 2025)
- 论文标题:SimLingo: Vision-Only Closed-Loop Autonomous Driving with Language-Action Alignment
- 论文链接:https://arxiv.org/pdf/2503.09594
- 提出机构:Wayve、德国霍宾根大学
一句话总结:SimLingo 是一款基于通用视觉语言模型且仅依赖摄像头的闭环自动驾驶系统,它通过引入“动作梦境”任务解决了言行不一的难题,实现了驾驶行为与语义指令的高度对齐,并在 CARLA 2024 挑战赛中夺魁。
空间关联: 解决“言行不一”,达成语言与物理动作的高度同步。
空间突破: 提出“动作梦境(Action Dreaming)”任务。AI 不再只是在屏幕上说“我要停车”,而是必须预测出精确的物理执行信号,证明了通用大模型在理解复杂城市空间后的实时决策潜力。
三、三维物理实体的“实时数字孪生”
6. DrivingRecon (NeurIPS 2025)
- 论文标题:DrivingRecon: Large 4D Gaussian Reconstruction Model For Autonomous Driving
- 论文链接:https://neurips.cc/virtual/2025/loc/mexico-city/poster/118906
- 提出机构:香港科技大学(广州)、加州大学伯克利分校、鉴智机器人
一句话总结:DrivingRecon 是一款通用型 4D 高斯重建大模型,它通过直接从环视视频中预测 4D 高斯(Gaussian Splatting)参数,并结合创新的 PD-Block 空间优化与动静解耦技术,实现了高效、高保真的自动驾驶场景动态重建与多任务仿真应用
空间关联: 将静态照片升维为动态 4D 物理实体。
空间突破: 传统的 3DGS 需要数小时优化,DrivingRecon 实现了端到端 4D 高斯重建。它通过“动静解耦”技术,精准捕捉路面背景与动态障碍物的几何特征,为自动驾驶提供了近乎实时的物理环境数字孪生。
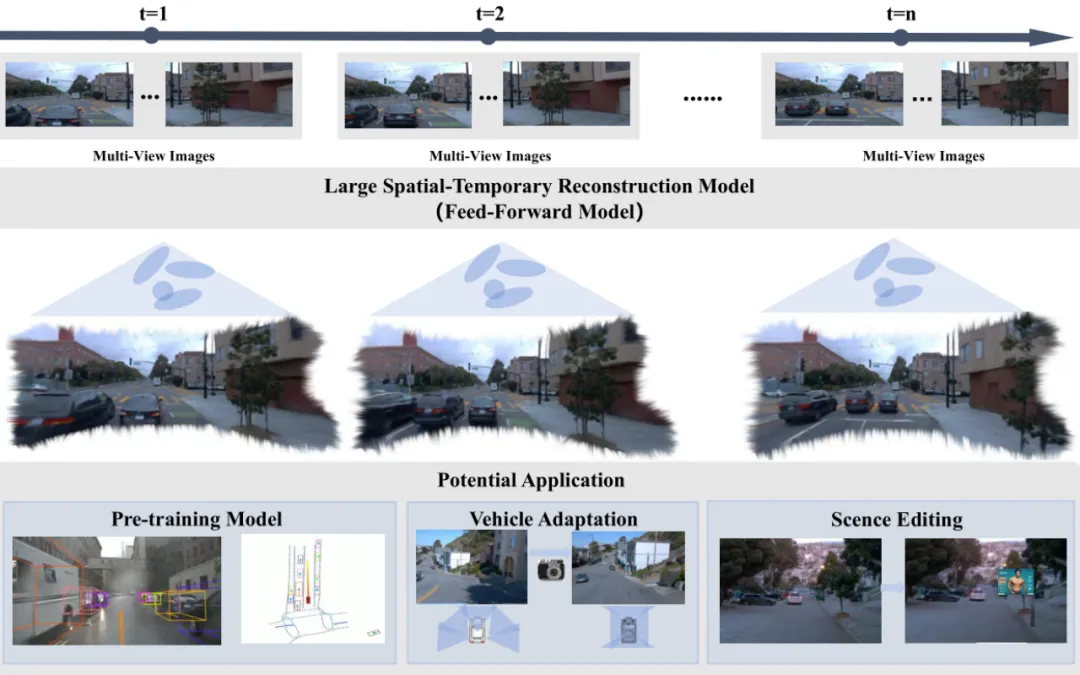
7. VR-Drive (NeurIPS 2025)
- 论文标题:VR-Drive: Viewpoint-Robust End-to-End Driving with Feed-Forward 3D Gaussian Splatting
- 论文链接:https://neurips.cc/virtual/2025/loc/san-diego/poster/118352
- 提出机构:韩国KAIST、42dot
一句话总结:VR-Drive 通过引入“前馈 3D 高斯泼溅”作为辅助任务,实现了无需逐场景优化的在线新视角合成,显著增强了智驾系统在不同相机配置和视角偏差下的鲁棒性
空间关联: 赋予 AI “视角无关”的鲁棒空间感知能力。
空间突破: 解决了硬件适配的痛点。通过“前馈 3D 高斯泼溅”,模型能实时预测新视角。即使相机安装角度偏了 5 度,AI 也能通过空间想象力补齐偏差,确保感知与规划在不同物理配置下的稳定性。
四、xx融合——打破“车”与“人”的空间隔阂
8. MiMo-Embodied (2025)
- 论文标题:MiMo-Embodied: X-Embodied Foundation Model Technical Report
- 论文链接:https://arxiv.org/pdf/2511.16518
- 提出机构:小米
一句话总结:MiMo-Embodied 是小米推出的全球首个开源跨xx(Cross-embodied)通用大模型,它通过多阶段学习、思维链(CoT)及强化学习(RL)微调,首次实现了自动驾驶与xx智能两大领域的深度融合,并证明了这两个领域的空间推理能力具有显著的正向迁移与相互增强效应。
空间关联: 验证了空间推理能力的跨领域迁移。
空间突破: 这是全球首个开源跨xx大模型。小米通过实验证明:车辆对宏观交通流的空间感知,可以增强机器人的导航;而机器人对微观物体交互的理解,能反哺车辆的决策。这标志着“自动驾驶”正式被纳入“xx智能”的宏大版图。
9. DriveGPT4-V2 (CVPR 2025)
- 论文标题:DriveGPT4: Interpretable End-to-end Autonomous Driving via Large Language Model
- 论文链接:https://openaccess.thecvf.com/content/CVPR2025/papers/Xu_DriveGPT4-V2_Harnessing_Large_Language_Model_Capabilities_for_Enhanced_Closed-Loop_Autonomous_CVPR_2025_paper.pdf
- 提出机构:香港大学、清华大学、美团
一句话总结:DriveGPT4-V2 是一款基于多模态大语言模型(MLLM)的闭环端到端自动驾驶框架,通过多视角视觉标记器(MV-VT)融合环视图像与车辆状态,并引入专家 LLM 进行在线模仿学习,实现了能够直接输出底层控制信号的高性能、可解释驾驶决策系统。
空间关联: 闭环系统中的实时空间执行力。
空间突破: 重点在于从“看图说话”进化到“闭环控制”。通过多视角视觉标记器(MV-VT),AI 在环视视野中保持了极高的局部空间细节,直接输出转向、加速等底层物理指令,实现了端到端空间智能的闭环落地。
工业界
2025年,工业界在自动驾驶架构设计上达成了一个高度共识:即从传统的模块化架构(感知、预测、规划分离)向端到端的VLA架构演进。这一转变旨在利用大语言模型(LLM)的常识推理能力来辅助驾驶决策。
1. Waymo的EMMA与通用基础模型
Waymo在2025年展示了其端到端多模态模型EMMA。该模型构建在Gemini等大规模预训练模型之上,直接将原始摄像头传感器数据映射为驾驶轨迹、感知对象和道路图元素 。EMMA的核心理念是将所有非传感器输入(如导航指令、车辆状态)和输出(如轨迹坐标、3D位置)均表示为自然语言文本。这种方法允许模型在一个统一的语言空间内处理多样化的驾驶任务,并利用大模型的预训练世界知识进行复杂推理。
此外,Waymo提出了“快速思考与慢速思考(System 1 and System 2)”的架构 。其中,传感器融合编码器(System 1)负责快速的反应性动作,而驾驶VLM(System 2)负责处理复杂的语义推理。例如,当车辆遇到路面起火的罕见场景时,虽然物理空间可能畅通,但System 2能够通过语义分析命令车辆采取绕行决策。
2. DeepRoute.ai与可解释的VLA
在国内市场,元戎启行(DeepRoute.ai)在IAA Mobility 2025上推出的DeepRoute IO 2.0架构,该架构的核心优势在于引入了思维链推理,有效解决了端到端模型长期存在的“黑盒”问题。
DeepRoute IO 2.0通过大语言模型的集成,赋予了系统强大的逻辑解释能力。系统不仅能执行驾驶动作,还能通过语言模型解释其决策路径(例如,“因为前方卡车遮挡了盲区视线,系统决定提前减速”),这种可追溯性极大地提升了用户对自动驾驶系统的信任度 。此外,该模型具备强大的空间意识和光学字符识别(OCR)能力,能够实时解读复杂的路牌信息和临时的交通指令。
3. 统一xx智能:MiMo-Embodied
MiMo-Embodied这一统一基础模型的出现,标志着自动驾驶与xx机器人(Humanoid Robotics)在空间智能层面的合流 。该模型通过在包括室内机器人任务和室外自动驾驶场景在内的异构数据集上进行四阶段递进式训练,打破了不同xx形态之间的领域差距。它在12项自动驾驶基准测试(如环境感知、状态预测、路径规划)以及17项机器人基准测试中均创造了新记录
4. 理想汽车:MindVLA
理想的MindVLA引入了空间智能的概念,主要体现在3D Feature上,视觉和Lidar经由3D Encoder得到时序融合后的特征,看起来和以往BEV感知的方法相似,再经由3D projector传递到下游的MindGPT中。
....
#DiffusionDriveV2核心代码解析
DiffusionDrive: Truncated Diffusion Model for End-to-End Autonomous Driving
https://github.com/hustvl/DiffusionDrive
https://github.com/hustvl/DiffusionDriveV2
DiffusionDrive的整体架构
DiffusionDriveV2: Reinforcement Learning-Constrained Truncated DiffusionModeling in E2E AD
整体架构
环境编码(bev和自车状态)
参考文献:TransFuser代码
TransFuser: Imitation with Transformer-Based Sensor Fusion for Autonomous Driving
参考文献:GoalFlow代码
GoalFlow: Goal-Driven Flow Matching for Multimodal Trajectories Generation in End-to-End Autonomous Driving
# bev_feature_upscale(bz,64,64,64), bev_feature(bz,512,8,8)
bev_feature_upscale, bev_feature, _ = self._backbone(camera_feature, lidar_feature)
bev_feature = self._bev_downscale(bev_feature).flatten(-2, -1).permute(0, 2, 1) # (bz,64,256)

#自车当前状态编码
status_encoding = self._status_encoding(status_feature) # (1,256)
keyval = torch.concatenate([bev_feature, status_encoding[:, None]], dim=1)  # (bz,64 + 1,256)
keyval += self._keyval_embedding.weight[None, ...]

query = self._query_embedding.weight[None, ...].repeat(batch_size, 1, 1)
# 参考detr目标检测,直接预测自车和多个障碍物
query_out = self._tf_decoder(query, keyval)
trajectory_query, agents_query = query_out.split(self._query_splits, dim=1)
Trajectory Planning Module
多尺度bev特征
concat_cross_bev = keyval[:,:-1].permute(0,2,1).contiguous().view(batch_size, -1, concat_cross_bev_shape[0], concat_cross_bev_shape[1])
# upsample to the same shape as bev_feature_upscale
concat_cross_bev = F.interpolate(concat_cross_bev, size=bev_spatial_shape, mode='bilinear', align_corners=False)

cross_bev_feature = bev_feature_upscale
cross_bev_feature = torch.cat([concat_cross_bev, cross_bev_feature], dim=1)
cross_bev_feature = self.bev_proj(cross_bev_feature.flatten(-2,-1).permute(0,2,1))
cross_bev_feature = cross_bev_feature.permute(0,2,1).contiguous().view(batch_size, -1, bev_spatial_shape[0], bev_spatial_shape[1])
planner anchor归一化+加噪+反归一化
- 获取anchors: 首先在训练数据集上对自车未来轨迹的真值进行K-Means聚类,得到一系列anchors ,每一个anchor 是一条轨迹线:。
- 在anchors上加入高斯噪声: 传统的扩散步骤是不断地在每一个都加入一些噪声,而在本文中是基于anchors的位置加入高斯噪声的。
其中表示第个step。
plan_anchor = np.load(plan_anchor_path) # [bs, 20,8,2]
self.plan_anchor = nn.Parameter(torch.tensor(plan_anchor, dtype=torch.float32), requires_grad=False,)

plan_anchor = self.plan_anchor.unsqueeze(0).repeat(bs,1,1,1)
odo_info_fut = self.norm_odo(plan_anchor)
timesteps = torch.randint(0, 50, (bs,), device=device )
noise = torch.randn(odo_info_fut.shape, device=device)
noisy_traj_points = self.diffusion_scheduler.add_noise(original_samples=odo_info_fut, noise=noise, timesteps=timesteps,).float()
noisy_traj_points = torch.clamp(noisy_traj_points, min=-1, max=1)
noisy_traj_points = self.denorm_odo(noisy_traj_points)
投射带噪声的planner anchor轨迹点的pos embed为query
traj_pos_embed = gen_sineembed_for_position(noisy_traj_points,hidden_dim=64) # [bs, 20, 8, 64]
traj_pos_embed = traj_pos_embed.flatten(-2) # [bs, 20, 512]
traj_feature = self.plan_anchor_encoder(traj_pos_embed)
traj_feature = traj_feature.view(bs,noisy_traj_points.shape[1],-1)
对时间进行编码
time_embed = self.time_mlp(timesteps)
time_embed = time_embed.view(bs,1,-1)
轨迹预测(前向加噪)
- 轨迹和bev特征的cross attention
traj_feature = self.cross_bev_attention(traj_feature,noisy_traj_points,bev_feature,bev_spatial_shape)

attention_weights = self.attention_weights(queries)
attention_weights = attention_weights.view(bs, num_queries, num_points).softmax(-1)
attention_weights = attention_weights.unsqueeze(1)

value = self.value_proj(bev_feature)
grid = normalized_trajectory.view(bs, num_queries, num_points, 2)
# Sample features
sampled_features = torch.nn.functional.grid_sample(value, grid,  mode='bilinear',
   padding_mode='zeros', align_corners=False) # bs, C, num_queries, num_points

out = (attention_weights * sampled_features).sum(dim=-1)
out = out.permute(0, 2, 1).contiguous()  # bs, num_queries, C
out = self.output_proj(out)- 轨迹和agents_query特征的cross attention
self.cross_agent_attention(traj_feature, agents_query,agents_query)[0]- 轨迹和ego_query特征的cross attention
ego_query=trajectory_query
self.cross_ego_attention(traj_feature, ego_query,ego_query)[0]- 轨迹和时间t特征的尺度和偏移融合
# feedforward network
traj_feature = self.norm3(self.ffn(traj_feature))
traj_feature = self.time_modulation(traj_feature, time_embed,global_cond=None,global_img=global_img)

self.scale_shift_mlp = nn.Sequential(nn.Mish(), nn.Linear(condition_dims, embed_dims*2),)
scale_shift = self.scale_shift_mlp(global_feature)
scale,shift = scale_shift.chunk(2,dim=-1)
traj_feature = traj_feature * (1 + scale) + shift- 轨迹分类分数和去噪轨迹预测
将扩散(加噪声)后得到的个带噪声的轨迹输入到diffusion decoder中,预测分类分数和去噪后的轨迹,整个过程可以用公式表述为:
其中是conditional information,本文中用的是感知特征来进行控制。
poses_reg, poses_cls = self.task_decoder(traj_feature) #bs,20,8,3; bs,20

traj_feature = traj_feature.view(bs, ego_fut_mode,-1)
plan_cls = self.plan_cls_branch(traj_feature).squeeze(-1)
traj_delta = self.plan_reg_branch(traj_feature)
plan_reg = traj_delta.reshape(bs,ego_fut_mode, self.ego_fut_ts, 3)
# 最终轨迹 = 轨迹偏移 + 原始轨迹
poses_reg[...,:2] = poses_reg[...,:2] + noisy_traj_points
poses_reg[..., StateSE2Index.HEADING] = poses_reg[..., StateSE2Index.HEADING].tanh() * np.pi
Mode Selector
基本机制流程
轨迹生成(反向去燥):根据plan_anchor,记录网络输出的所有中间去燥的结果,以及最终的去燥结果。
plan_anchor = self.plan_anchor.unsqueeze(0).unsqueeze(0).repeat(bs,num_groups, 1, 1, 1)
plan_anchor = plan_anchor.view(bs, num_groups * self.ego_fut_mode, *plan_anchor.shape[3:]) # bs num_groups * 20, 8, 2
diffusion_output = self.norm_odo(plan_anchor)
trunc_timesteps = torch.ones((bs,), device=device, dtype=torch.long) * 8
diffusion_output = self.diffusionrl_scheduler.add_noise(original_samples=diffusion_output, noise=noise, timesteps=trunc_timesteps)

# roll_timesteps [18, 16, 14, 12, 10, 8, 6, 4, 2, 0]
roll_timesteps = (np.arange(0, step_num) * step_ratio).round()[::-1].copy().astype(np.int64)
roll_timesteps = torch.from_numpy(roll_timesteps).to(device)

for i, k in enumerate(roll_timesteps[:]):
    poses_reg_list, poses_cls_list = self.diff_decoder(
        traj_feature, noisy_traj_points, bev_feature, bev_spatial_shape,
        agents_query, ego_query, time_embed, status_encoding, global_img)

    prev_sample, log_prob, _ = self.diffusionrl_scheduler.step(
        model_output=x_start, timestep=k, sample=diffusion_output, eta=eta,)
    diffusion_output = prev_sample
    all_diffusion_output.append(prev_sample) # BG N 8 2
使用PDM评分器计算网络输出的所有模态的轨迹以及真值轨迹的cost:
scores_np - 主评分矩阵:基于PDM评分器对轨迹的多个维度进行评估后的综合分数
metric_cache - 指标缓存:每个场景计算过程中用到的中间结果和参考数据(避免重复计算)
sub_scores - 子项评分:轨迹在不同维度上的细分评分
# 安全性检查(碰撞检测、驶出道路等)
safety_score = check_safety(traj, scenario_data['agents'], scenario_data['map'])
# 舒适性评估(加速度、加加速度、曲率连续性)
comfort_score = check_comfort(traj)
# 规则遵守(交通灯、车道保持、速度限制)
rule_score = check_rules(traj, scenario_data['traffic_rules'])
# 进度评估(是否到达目标)
progress_score = check_progress(traj, scenario_data['goal'])
# 物理可行性(动力学约束)
feasibility_score = check_feasibility(traj, vehicle_dynamics)
# 综合评分(加权平均)
total_score = (
            safety_weight * safety_score +
            comfort_weight * comfort_score +
            rule_weight * rule_score +
            progress_weight * progress_score +
            feasibility_weight * feasibility_score
        )
我们提出锚点内GRPO(Intra-Anchor GRPO)。对于每个锚点,首先通过随机高斯噪声和探索噪声对其进行扩散,生成个轨迹变体组成的组;随后在该组内执行GRPO更新,而非跨不同锚点的组进行更新。该方法将策略优化约束在每个特定行为意图的状态空间内,引导模型生成更安全、更面向目标的轨迹,同时不损害其多模态能力。强化学习损失函数可表示为:
其中为折扣系数,用于缓解早期去噪步骤中的不稳定性;为优势函数,GRPO通过计算组相对优势进行估计,无需价值模型:
为基于最终去噪轨迹计算的单一奖励估计值,该奖励被应用于扩散链中的所有去噪步骤,且每个步骤的影响通过去噪折扣进行缩放。
# 计算生成轨迹的基础优势函数
reward_group = reward_group.view(bs, num_groups, self.ego_fut_mode)  # (B,G,N)
mean_grouped_rewards = reward_group.mean(dim=1)
std_grouped_rewards = reward_group.std(dim=1)
advantages = (reward_group - mean_grouped_rewards.unsqueeze(1)) / (std_grouped_rewards.unsqueeze(1) + 1e-4)

# 只保留 “好于 GT” 的正向样本,对比学习:通过与ground truth对比来定义"好"轨迹
mask_positive = (reward_group > (reward_gt-1e-6))                  # (B,G) bool
advantages = advantages.clamp(min=0) * mask_positive.float()       # 负 adv 归 0
锚点内GRPO虽能防止模式崩溃,但完全隔离不同模式会引发新问题:优势估计丧失全局可比性。例如,某一模式中次优但安全的轨迹可能获得负优势,而另一模式中危险且存在碰撞的轨迹若为其组内“最优”样本,则可能获得正优势。这种依赖局部组内比较的方式会向模型传递误导性学习信号。
具体实现方式为修改锚点内GRPO的优势估计:将所有负优势截断为0,并对存在碰撞的轨迹分配-1的强惩罚:
这一设计为模型提供了清晰且一致的学习信号。随后,该截断优势将替代公式(7)中的用于强化学习损失计算。
# 根据子奖励调节优势
if k == 'no_collision' or k == 'drivable_area':
    # 对于安全性指标: 如果不满足条件(值不为1),优势设为-1
    zero_mask = (v != 1)
    advantages = torch.where(zero_mask, torch.full_like(advantages, -1.0), advantages)

# 创建时间折扣因子
# discount: [0.8^3, 0.8^2, 0.8^1, 0.8^0] = [0.512, 0.64, 0.8, 1.0]
discount = torch.tensor(
    [
        0.8 ** (step_num - i - 1)  # 指数衰减: 越远的未来折扣越大
        for i in range(step_num)
    ]
).to(advantages.device)  # 形状: (T,)
# 未来时间步的奖励权重降低
advantages = advantages * discount  # (B, M, T)
Loss
DiffusionDrive采用DDIM更新规则,将去噪步数大幅减少。该更新规则通常通过设置作为确定性采样器使用。为实现更广泛的探索并避免狄拉克分布下的似然计算问题,我们在训练阶段设置以引入探索噪声(等价于采用DDPM),而在验证阶段保持以实现确定性推理。然而,由于轨迹的近端段与远端段存在固有尺度不一致性,直接在每个点施加加法高斯噪声会破坏轨迹的结构完整性,降低探索质量。
如图3(a)所示,对标准化轨迹施加加法高斯噪声后,生成的探索路径通常呈锯齿状(类似折线),丧失了原始轨迹的平滑性。为保留轨迹连贯性,我们提出仅添加两个乘法高斯噪声(一个纵向噪声、一个横向噪声),其表达式为,其中。这种尺度自适应乘法噪声确保生成的探索路径保持平滑,如图3(b)所示。
在强化学习中,引入探索噪声是推动模型探索新行为的重要手段,
- 加性噪声:轨迹的近端(proximal segments)和远端(distal segments)存在固有的尺度不一致性。简单地在每个点上添加相同的加性高斯噪声,会导致轨迹的结构完整性被破坏,使其变得不连贯且“锯齿状”(jagged),如图 3(a) 所示。这会降低探索的质量
- 乘性噪声:它不是直接添加噪声,而是通过一个乘法因子来调整轨迹的每个点。具体来说,它只添加两个乘法高斯噪声:一个沿纵向(longitudinal),一个沿横向(lateral)。这种乘法形式使得噪声的大小能够根据轨迹自身的尺度自动调整。对于轨迹上距离较远、坐标值较大的点,相同的乘法噪声会产生更大的绝对扰动,反之亦然,从而自然地保持轨迹的连贯性和平滑性,如图 3(b) 所示。
if prev_sample is None:
    # 乘性噪声
    variance_noise_horizon = randn_tensor(
        [model_output.shape[0],model_output.shape[1],1,1], generator=generator, device=model_output.device, dtype=model_output.dtype
    ) * std_dev_t_mul + 1.0
    variance_noise_vert = randn_tensor(
        [model_output.shape[0],model_output.shape[1],1,1], generator=generator, device=model_output.device, dtype=model_output.dtype
    ) * std_dev_t_mul + 1.0

    variance_noise_mul = torch.cat((variance_noise_horizon,variance_noise_vert),dim=-1)
    variance_noise_mul = variance_noise_mul.repeat(1,1,model_output.shape[2],1)

    # 加性噪声
    variance_noise_x = randn_tensor(
        [model_output.shape[0],model_output.shape[1],1,1], generator=generator, device=model_output.device, dtype=model_output.dtype
    )
    variance_noise_y = randn_tensor(
        [model_output.shape[0],model_output.shape[1],1,1], generator=generator, device=model_output.device, dtype=model_output.dtype
    )
    variance_noise_add = torch.cat((variance_noise_x,variance_noise_y),dim=-1)
    variance_noise_add = variance_noise_add.repeat(1,1,model_output.shape[2],1)

    prev_sample = prev_sample_mean * variance_noise_mul + std_dev_t_add * variance_noise_add
根据计算的每一步加噪输出,计算log_prob?
std_dev_t_mul = torch.clip(std_dev_t, min=0.1)
log_prob = (
    -((prev_sample.detach() - prev_sample_mean) ** 2) / (2 * (std_dev_t_mul**2))
    - torch.log(std_dev_t_mul)
    - torch.log(torch.sqrt(2 * torch.as_tensor(math.pi)))
)
log_prob = log_prob.sum(dim=(-2, -1))
此外,与原始GRPO通过添加策略模型与参考模型之间的KL散度实现正则化类似,我们引入额外的模仿学习损失,以防止模型过拟合并保障其通用驾驶能力。组合损失函数为
其中为权重系数。
- 真值监督:先用anchors和真值匹配,得到和真值最接近的anchor,然后这个anchor周围的“噪声轨迹”作为正样本(),其他的则看作是负样本()
target_traj = targets["trajectory"]
dist = torch.linalg.norm(target_traj.unsqueeze(1)[...,:2] - plan_anchor, dim=-1)
dist = dist.mean(dim=-1)
mode_idx = torch.argmin(dist, dim=-1)
mode_idx = mode_idx[...,None,None,None].repeat(1,1,ts,d)
best_reg = torch.gather(poses_reg, 1, mode_idx).squeeze(1)
target_classes_onehot = torch.zeros([bs, num_mode],
   dtype=poses_cls.dtype, layout=poses_cls.layout, device=poses_cls.device)
target_classes_onehot.scatter_(1, cls_target.unsqueeze(1), 1)

loss_cls = self.cls_loss_weight * py_sigmoid_focal_loss(
   poses_cls, target_classes_onehot, weight=None,
gamma=2.0, alpha=0.25, reduction='mean', avg_factor=None)- loss由“轨迹恢复”和“分类置信度”两部分组成:是loss权重
reg_loss = self.reg_loss_weight * F.l1_loss(best_reg, target_traj)....
#小结世界模型的学习成果
哼哧哼哧搞了小半年,小结一下这段时间的学习成果。
什么是世界模型?
值得注意的是,世界模型不是一个具体的模型或者范式。实际上有好几个不同方向的都管自己叫世界模型。差不多是各说各的,因此大家在阅读文章时需要仔细辨析。
World model 的流行要归功于Jurgen2018年的world .其对world model的定义是" a mental model of the world", 即世界在大脑中的映射。更具体一点是
The image of the world around us, which we carry in our head, is just a model. Nobody in his head imagines all the world, government or country. He has only selected concepts, and relationships between them, and uses those to represent the real system. (Forrester, 1971)
世界模型是图像(当然可以有其他输入)在大脑中形成的概念与关系。它不仅仅是简单的映射,而是要反映出物体空间、时间上的关系。例如dino是一个好的视觉模型,可以感知物体的concept,但是它不能感知物体的运动,所以不是世界模型。Jurgen提出了如下的world model。
V(Vision)代表视觉模型. M (memory) 赋予时间关系以及逻辑。
LeCun 也提出了世界模型 ,并强调Common sense knowledg。那常识又是什么呢?
Common sense knowledge does not just allow animals to predict future outcomes, but also to fill in missing information, whether temporally or spatially.
常识可以理解为2个方面一个是预测,一个是猜测。例如,一个关着的宝箱插入钥匙,我们可以预测接下来宝箱会打开。又或者,给出宝箱关闭和打开的2张图,可以想象宝箱被插入钥匙的过程。那么对此建模,就是最大化 p(o|key|c), p(key|o|c). 即求得联合概率p(key,o|c)。这就是v-jepa:
生成式世界模型。如果说以上2种world models是大脑对世界的建模(mental world model),那么generative world model则是对真实世界的建模 (physical world model)。2者有本质区别。mental world model 关注的是抽象concepts之间的联系,并不关注真实的物理细节。例如风吹落叶,我们可以通知机器人来清理落叶了。至于落叶具体什么颜色、飘落时候的姿态都不重要。我们只需要叶子的抽象表示,而不是具体表示,评价mental world model以能否完成任务为标准。而physical world model则关注对真实世界的重构,对世界进行直接仿真。评价physical world model通常使用SSIM等为标准。
目前来说很难给出最终答案:到底哪种模型才是真·世界模型。Generative模型模仿的是GPT,认为当数据达到一定规模时,相应的智能会涌现。因为模型能准确预测图像的前提是它学会了物体的关系,以及相应的物理规律,只要有足够的数据量去cover所有的规律与关系。而jurgen的世界模型其实是对model-based RL的重新包装。同时也有着很强的局限性:真实世界的action是难以获取的。LeCun的世界模型则缺少对action的建模,导致难以迁移到新任务。在上一篇论文阅读中,有提到一些世界模型的缺点
世界模型的应用:自动驾驶方向
虽然这个方向的论文还是蛮多的,但是许多模型过于复杂。下面我将介绍2个工作,来探讨如何将世界模型应用于自动驾驶中的轨迹预测 (Latent World Model for Trajectory Prediction)。
Task Setting
使用nuScenes 做开环评估。该数据集由 1000 段驾驶场景组成,采集自波士顿与新加坡——两座以交通密集、驾驶情境复杂著称的城市。每段场景时长 20 秒,经人工挑选,涵盖多样化的驾驶操作、交通状况与突发行为。nuScenes 丰富的复杂度将推动面向城市环境、每帧包含数十个交通对象的安全驾驶算法研究。跨洲采集的数据使研究者得以检验计算机视觉算法在不同地区、天气、车辆类型、植被、道路标线及左右舵交通条件下的泛化能力。以 2 Hz 频率为全部场景中的 23 类目标标注了精确的 3D 边界框,并进一步提供目标的可见性、动作及姿态等属性标签。2019 年 3 月,nuScenes 完整数据集正式发布,包含全部 1000 段场景,共约 140 万张相机图像、39 万次激光雷达扫描、140 万次毫米波雷达扫描,以及 4 万关键帧中的 140 万个目标边界框。
轨迹预测:通过车辆的GPS数据可以构造出轨迹信息。模型需要根据6个cameras的视觉信息以及command,预测接下来的轨迹。 L2 指预测的整条轨迹(3 秒、2 Hz 共 6 个waypoint)与真值轨迹之间每一点的欧氏距离(L2-norm),最后对所有航点取平均,单位为米。数值越小,说明模型给出的未来位置越接近真实行车路线;↓ 表示“值越低越好”。Collision (%)
把预测轨迹投影到自车 3D 包围盒上,检查在 3 秒时间窗内是否与数据集中已标注的任何物体发生几何重叠。重叠帧数占总帧数的比例即为碰撞率,以百分比表示。数值越低,意味着模型给出的轨迹越安全;同样 ↓ 表示“越低越好”。
数据样本
使用世界模型增强轨迹预测(LAW)
这篇来自中科院自动化所、中科大和中科院香港创新研究院的论文“Enhancing End-to-End Autonomous Driving with Latent World Model描述了一个极简的世界模型。仅仅通过预测下一时刻的latents,就能增强轨迹预测的效果。其方法如下
encoder将6个cameras编码为36个visual tokens(latent variables)。以waypoint作为条件预测一下时刻的latents。
文中描述了2种结构的encoder:perception-free and perception-based。以perception-free为例,轨迹预测的过程为
图像feature--> latents -->waypoint
waypoint decoder会为每个样本产生三条轨迹,然后根据command选择正确的轨迹。
Intention-aware World Model
来自中科院自动化所、理想汽车、鹏程实验室、新加坡国立大学和清华大学的论文“World4Drive: End-to-End Autonomous Driving via Intention-aware Physical Latent World Model”对LAW进行了改进。整体框架如下所示
整体上的思路是
- 将轨迹离散化,得到8192条预设的轨迹。可以认为这8192条轨迹是驾驶员操纵车辆产生轨迹的总和。这有助于减少误差。
- Intention points. 使用k-means算法,为每个command构建K(6)条intention points (PI)。这相当于做了一次粗筛,intention就是大致的6条轨迹路线。
- latent encoder结合时间、空间信息,进一步精炼轨迹。
Latent encoder
3D Spatial Encoding. 2D图像缺少深度信息,因此使用一个深度模型为每个token添加距离信息。
Temporal Aggregation。使用cross-attention 聚合时间信息。为了生成当前的世界潜表征 L_t,我们首先保留前一时刻 (t-1) 的视觉特征 Fˆ_t−1。随后,通过交叉注意力机制将这些历史特征融入当前的视觉特征中,从而有效地注入时间信息。我们提出的物理世界潜编码器通过整合空间、语义和时间三个维度的信息,极大地丰富了该潜表征。这种丰富的表征为模型提供了对动态驾驶环境的整体理解,是预测未来世界的关键基础。
Planning
Action encoding. 前面我们获得了K个intention,那么我们可以获得K个action。这表示,假如我们选择某个意图,那么它对应的action是什么。
Intention-aware World Model Prediction. 那么我们进一步,我们可以获得每一个intention下的world model。模型从K个intention中找到最好的那个计算重构loss,并计算一个scorenet用以选择正确的模型(inference阶段使用)。
Loss:
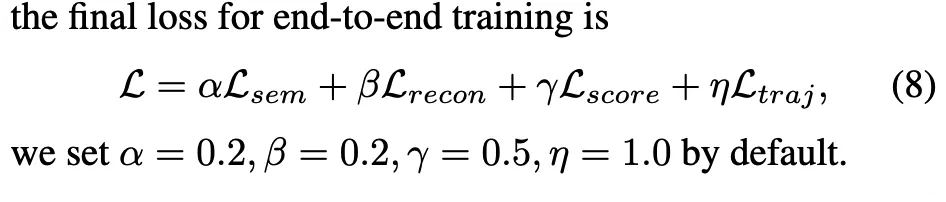
结果
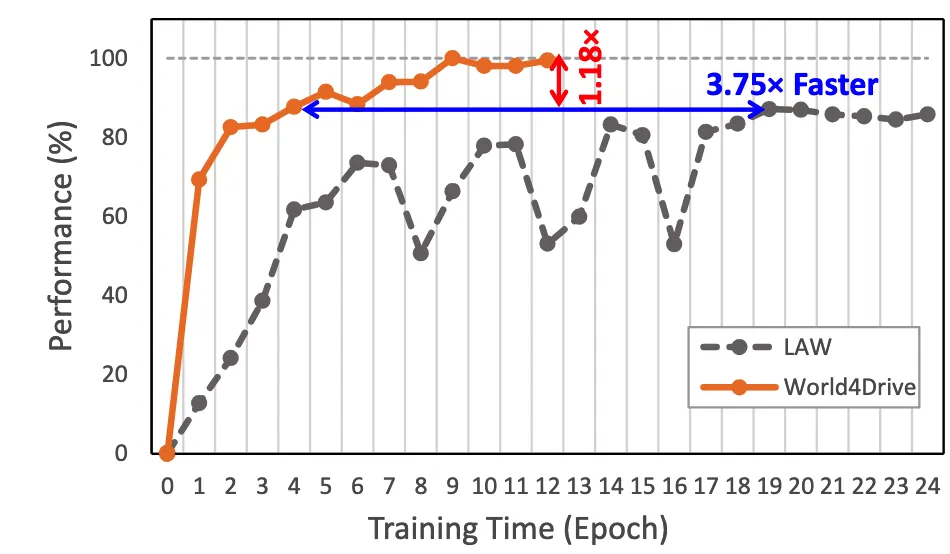
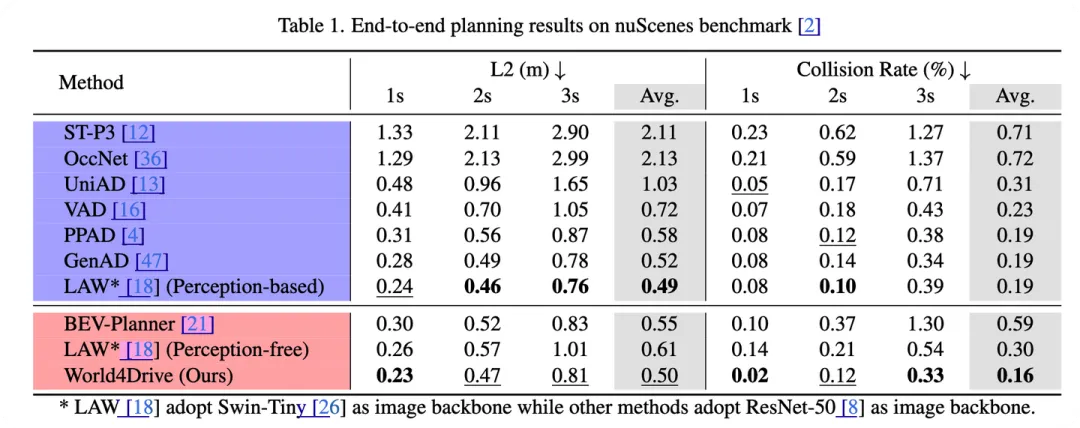
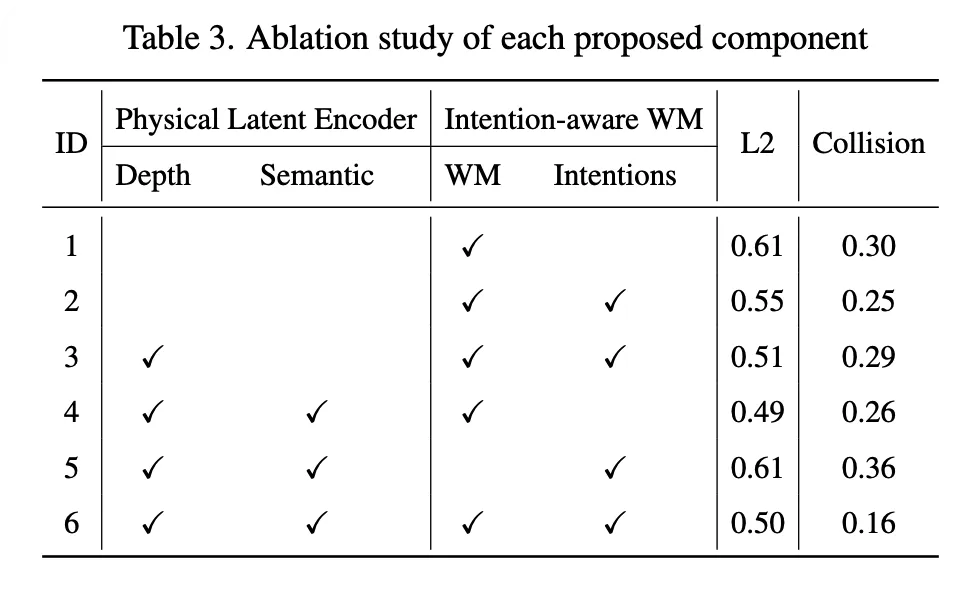
3秒的L2,Collision. Row 1 等效LAW(backbone为resnet50). 14说明增强表示的语义信息对L2,collisiion都有帮助。5说明只有intention是不work的。
思考:
- 如何更好地利用世界模型?
- 如何更好地利用现有模型,如dinov3、VGGT?
参考
- Ha, David, and Jürgen Schmidhuber. "World models." arXiv preprint arXiv:1803.10122 2.3 (2018).
- LeCun, Yann. "A path towards autonomous machine intelligence version 0.9. 2, 2022-06-27." Open Review 62.1 (2022): 1-62.
- Bruce, Jake, et al. "Genie: Generative interactive environments." Forty-first International Conference on Machine Learning. 2024.
- Agarwal, Niket, et al. "Cosmos world foundation model platform for physical ai." arXiv preprint arXiv:2501.03575 (2025).
- Li, Yingyan, et al. "Enhancing end-to-end autonomous driving with latent world model." arXiv preprint arXiv:2406.08481 (2024).
- Zheng, Yupeng, et al. "World4Drive: End-to-End Autonomous Driving via Intention-aware Physical Latent World Model." arXiv preprint arXiv:2507.00603 (2025).
- Wei Yin, Chi Zhang, et al. Metric3d: Towards zero-shot metric 3d prediction from a single image. In ICCV, 2023. 4
....
#最近的蔚来,让人倒吸一口凉气
蔚来触底反弹来的如此干脆,出乎了很多人的意料——仿佛一场蓄谋已久的暴风雨,雷霆般地洗掉了那些重到化不开的质疑迷雾。
今年初,市场还在用那些阶段性的片面数字不停地拷问蔚来;转眼间,蔚来已以一系列凌厉的战术转身、技术突围与组织焕新,撕掉了旧标签。
速度之快,效率之高,效果之显著,不仅令整个行业侧目,更让诸多业内人士也倒吸一口凉气。
01 全新ES8的“饱和式交付”
12月18日,蔚来全新ES8的交付正式突破3万台,创造了40万元以上纯电车型交付破三万的最快纪录,并向着4万台迈进。
对蔚来而言,这份成绩来之不易。从年初的最具挑战财务报表,再到每个季度的盈利拷问,蔚来面临的质疑从未停止,而这份质疑,也变成了李斌“内修武功”,不断反思和改变的核心动力。
巧合的是,蔚来今年NIO Day的主题是“生长”,也是对蔚来这一年最浓缩的概括,相较于此前遵循“算大账”的发展逻辑,这一年,李斌用CBU机制重塑了整个公司的体系架构,每个人都要对自己所负责的事情经营结果负责,蔚来的“变与不变、急与不急”,都开始变得愈发清晰。
“守得云开见月明”是近年来媒体圈都喜欢用的一句俗语,但这句话放在蔚来身上却尤为合适。
在蔚来走向成熟的背后,谁也不知道李斌为了做出改变吃了多少苦头、熬了多少夜,能见到的唯有上半年不断调整的组织架构,和逐渐提升的销量成绩。
在蔚来全新ES8和乐道L90的助力下,蔚来公司的销量正不断突破瓶颈,截至11月30日,蔚来公司累计交付量已经达到95万台。
此时,是蔚来走过的第十一个年头,距离累计百万销量的里程碑,仅差一步。
02 从年初到年尾,一场“翻身仗”
2025年是蔚来的转折之年,除了重铸公司体系外,多年深打地基的努力,也让蔚来迎来了产品力和技术积累的质变节点,对此,李斌将其称为“兑现期”。
在内部变化和技术收获期的双重叠加下,蔚来全新ES8和乐道L90对外呈现出了不一样的蔚来——对产品线更为聚焦,通过技术降本,并瞄向更清晰的用户市场。
最终带来的结果是,乐道L90的首个完整交付月交付10,575辆,上市86天交付突破30,000台,连续四周跻身大型SUV周销量TOP3。
蔚来全新ES8更是取得了意想不到的成绩,在9月20日晚开启锁单后,10天内有近15万人进行了试驾,其中不乏不少用户深夜到访。
9月21日,蔚来全新ES8正式开始交付,仅上市41天交付就突破了上万台,随着订单存量不断增加,蔚来也快速调整了工厂产能,加强交付能力,上市70天时交付量突破了2万台,上市89天交付突破三万台,创造了40万元以上纯电车型交付破三万的最快记录。
对蔚来而言,这是一件既意外,又不意外的事。
但不可否认的是,蔚来全新ES8正站在一个独特的时间节点,除了产品爆火之外,更代表着打通了任督二脉的蔚来在一年的时间实现了快速“翻身”。
在蔚来全新ES8和乐道L90等几款旗舰大车的带动下,蔚来的产品均价被迅速拉高,“高价值、高毛利”的产品特点进一步强化了蔚来的盈利能力,同时也为旗下的其他车型带来了活性。
今年下半年,蔚来三个品牌的销量开始不断攀升,在爆品的带动下,第三季度交付量达87,071辆,同比增长40.8%,刚过去的11月里,蔚来交付36,275辆,同比增长76.3%。其中,蔚来品牌交付新车18,393台,连续四个月增长。
此外,11月乐道品牌交付11,794台,firefly萤火虫品牌交付6,088台。其中,乐道品牌同比增长高达132.1%,firefly品牌交付量则连续四个月创下历史新高。
值得一提的是,作为蔚来目前的旗舰级车型,蔚来全新ES8目前已经能够做到19天时间交付一万台新车,平均一天能够交付527台。
这一数字代表着蔚来已经完成了产能爬坡,在接下来的时间里,蔚来全新ES8的交付速度将会得到进一步提升,并呈现在12月份的报表中。
从走路到奔跑,蔚来在交付量不断突破历史新高的同时,以旁人意想不到的姿态跨上了增长快车道,这意味着相较于之前品牌、调性上的执着,如今的蔚来彻底打通了品牌、产品与消费者之间的完整链条,变得更务实、更注重经营。
在今年一季度财报会上,李斌曾说到:“蔚来能够,也必须要在第四季度实现盈利”,对此,李斌给出的目标是在Q4季度交付12万台到12.5万台。10月和11月,蔚来公司已经累计交付76,672台新车。
此时,蔚来距离完成交付指引目标,仅差一步。
03 李斌的坚持与改变
“生长”是蔚来今年NIO Day的主题,同时也在蔚来全新ES8上得到了集中兑现。
时间回到2025年初,彼时,处于平台换代和产品空窗期的蔚来陷入了新的舆论场,薄弱期被无限放大,甚至被媒体调侃堪比2019年的至暗时刻。在空前的压力下,蔚来开始了大刀阔斧的变革。
这一动作被内部解读为“一场从务虚转为务实的组织变革”,李斌清楚的知道,当下蔚来面临的挑战远比2019年更为严峻,提高经营效率,算好每一笔账,是当下最重要的事情。
“本质上抓经营就是低效的投资少做,高效的投资坚决做;低效的项目少干不干,高效的项目坚决干。这个大逻辑适用于所有事。”李斌在内部讲话中反复提及。
对外而言,渠道统一管理、CBU机制推行、节省开支等等动作,大多是蔚来在意识到问题后的防御姿态,但对内而言,“什么要坚持、什么该改变”开始越来越清晰。
从结果来看,蔚来最大的改变是成为了一家“抠门”的公司,李斌以CBU机制重构了经营逻辑,将公司业务划分为12个核心经营单元,覆盖研发、市场、生产等关键领域,每个单元设定明确经营目标与可量化投入回报。
而蔚来一直以来所坚持的纯电、换电、用户导向、长期主义等赖以生存的根本,却并没有一丝动摇,依然在智驾芯片、充换电基建、全域整车操作系统等重金投入,等待下一个“技术兑现期”。
在这一逻辑下,李斌进入到了“急与不急”的阶段。
不急是蔚来找到了自身的问题,积极做出改变,并安心等待技术和产品的爆发期,“胸有成竹”体现在李斌的脸上。
而急,则是蔚来已经走过了高投入期,在收获期不断摸索,通过各种各样的尝试去实现四季度盈利的终极目标。
在多次媒体沟通会上,李斌提到:“公司内部的反思,在所有行业中都是一个没有终点的过程。我始终认为,做企业最难的是判断——什么是该坚持的,什么又是需要变化的。这是一个需要持续修炼和思考的过程。”
很快,乐道L90发布,蔚来的“改变与坚持”,迎来了第一场考验。
乐道L90作为蔚来在近两年左右的第一款真正意义上的爆品,无论是渠道、营销还是供应链,蔚来都有着极大的压力——这意味着以往犯过的错误不能再犯,每一个节点都要慎之又慎。
蔚来真的应该感谢这次变化,蔚来顶住了压力,提前从传播节奏、展车到店、产能预备、生产调节等多个环节做出准备,乐道L90取得了远超预期的成功:8月份上市首月就交付了超万台,打破纯电大型SUV细分市场月销普遍低于万台的行业常态,连续四周跻身大型SUV周销量TOP3,上市86天交付突破3万台。
如今ES8复刻了乐道L90的成功,甚至超越,代表着蔚来已经拥有了持续的爆品输出能力和承接能力。
更重要的是,毛利在规模效应下开始逐渐提升,蔚来开始走向了高质量增长的道路。最新的财报内容显示,乐道L90和蔚来全新ES8的毛利率均在15%-20%之间。
在诸多因素加持下,从今年一季度财报会开始,往后的每一个季度财报会,李斌对未来预期的看法越来越笃定,每次媒体见面会时的眼神也越来越明亮。
据李斌透露,Q4季度盈利目标将不会改变,并预计销量将会持续走高,整车毛利持续提升,维持高质量经营。CBU机制也将会持续深化,整体经营效率会进一步提升。
在内部正向预期下,如今整个公司都在向着Q4季度盈利而付出努力。
04 2025,拐点已至
在前不久的广州车展上,李斌用了几页PPT去讲述2025年是新能源汽车市场的拐点时刻。
2025年是极为特殊的一年,这一年新能源车企正式吹响了反攻号角。
今年9月,中国汽车市场纯电大三排SUV单月销量达到35,530台,首次同时超越增程、插混和燃油三大动力类型的同类车型,这表明消费者对高端纯电车的接受度正在以极快的速度攀升。
相对来看,去年30万以上市场中,纯电动汽车的渗透率只有12%,今年三季度已经达到18%。更值得注意的是,这个价位段的纯电动车销量同比增长33%,而增程式汽车却同比下滑了10%。
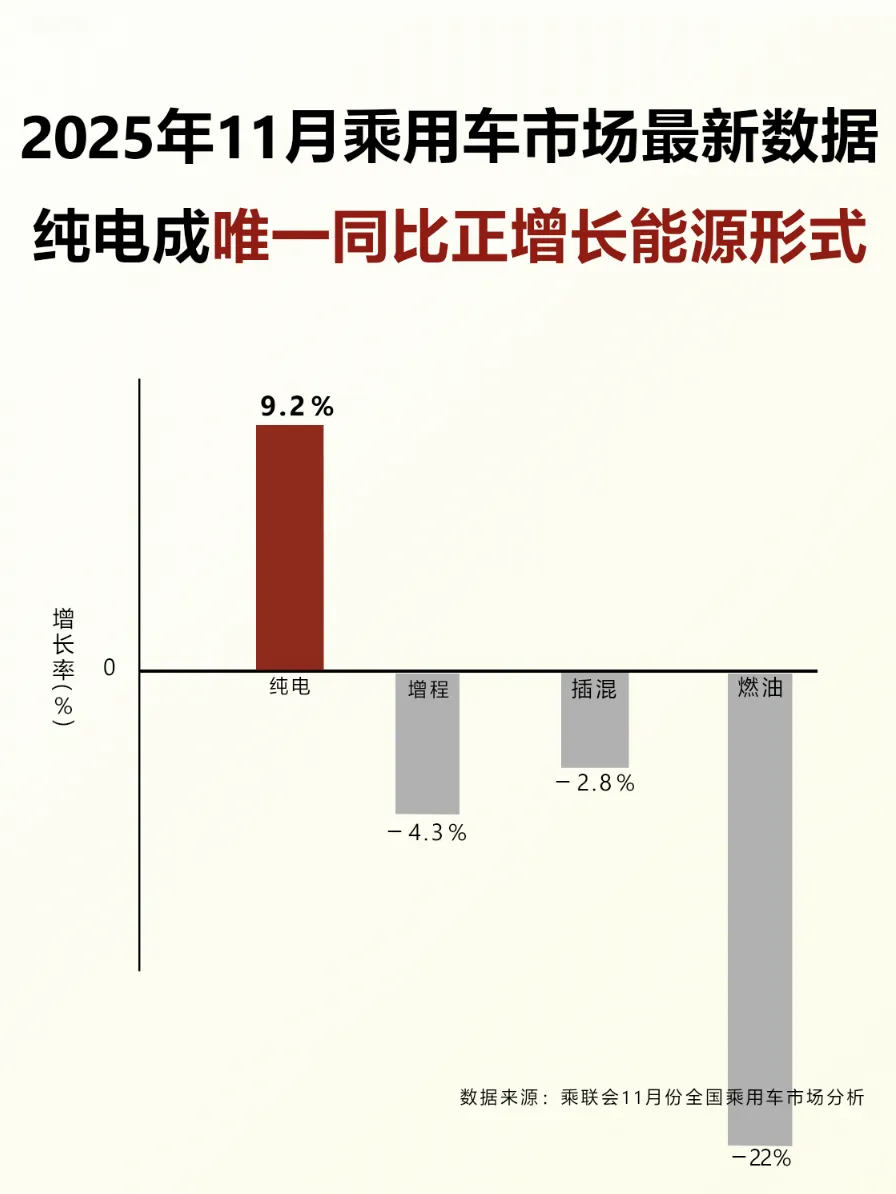
11 月纯电大三排 SUV销量在蔚来全新ES8、乐道L90、特斯拉 Model Y L等车型推动下,已经连续三个月排名所有动力形式第一,较其他动力形式的销量领先优势持续拉大。增程销量则持续遇冷,连续五个月同比下滑。
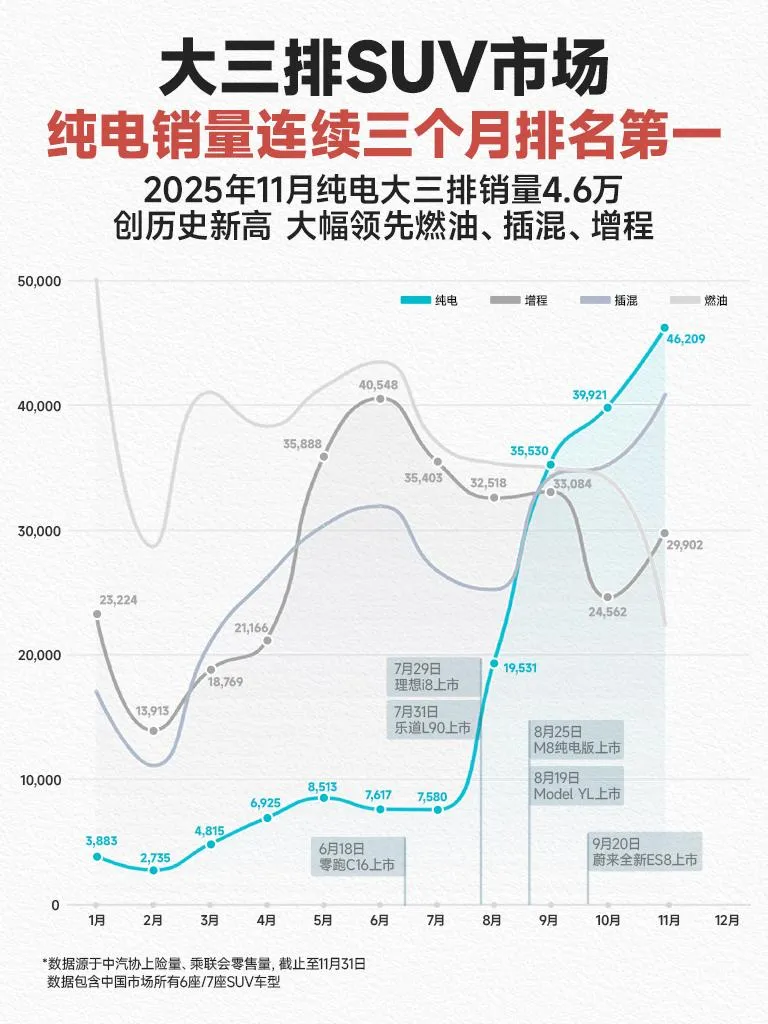
体验还是最核心原因,目前全国公共充电桩已经超过500万根,高速公路服务区充电桩覆盖率超过90%,充电焦虑已经得到极大缓解。
重要的是,纯电能够给产品带来足够的想象力,除了远低于增程和燃油车型的发动机噪音和震动,原生纯电架构的大三排SUV在乘坐和装载能力上远超其他种类车型,以乐道L90和新蔚来ES8为例,乐道L90前备舱达到240L,新蔚来ES8也能达到230L。
更何况,纯电车只有一套动力系统,结构相对简单,维护成本通常低于同时拥有两套动力系统的增程车型,大大降低了用户使用门槛。
作为专注纯电高端车型的车企,蔚来早早就占领了高点,多年的用户运营下,蔚来早已成为高端新能源车型的代名词,这一点从蔚来全新ES8的用户情况也能有所感知。
随着新能源市场的进一步增长,蔚来将会有着更多的发展空间。
据李斌透露,蔚来全新ES8和乐道L90在明年上半年仍处于新车周期,此外,明年蔚来还将会发布三款大车:乐道L80、蔚来ES9以及换代ES7,会按照明年二季度推出两款、三季度推出一款的节奏发布,而萤火虫品牌则不会推出新的车型,其余产品也不会因为阶段性政策变化而调整发布节奏。
在李斌看来,这几款车型的销量将会非常可观,首先蔚来的产品布局与市场趋势高度契合,无论是纯电市场扩大还是大三排SUV市场的崛起,蔚来都在关键位置。其次,蔚来拥有着清晰的产品优势以及充换电网络的独特优势,这也是明年整体销量增长的关键。
这也意味着,蔚来坚持了十一年的换电基础建设,也随着产品一起迎来兑现期,目前,蔚来全国3,631座换电站已经能够完整覆盖全国主要公路网络,甚至能够实现318国道的完整补能体验,解决用户的补能焦虑。
此外,蔚来还拥有包括NIOHouse、蔚来服务、悦享出行、用户社区等,诸多优势使得蔚来站稳一线豪华品牌阵营,也让蔚来拥有了更多想象空间。
除了国内市场,海外市场也在蔚来的规划当中,今年上半年,蔚来就已经在大力拓展海外经销商,据李斌透露,目前已经确定的合作伙伴就已经达到数十家,乐道和萤火虫品牌也会逐步进入到全球市场。
对蔚来而言,盈利是公司现阶段上下一心的终极目标,只有盈利,才能在接下来的日子里卖更多的车,向下扎根,向上发展。
但对于李斌而言,盈利已经更多变成了一个执念。蔚来是一家成立了十一年的公司,曾经有过辉煌,有过低谷,可从没有过放弃,只有活着,才有继续走下去的权利。
李斌在面对老车主们时,曾坦言:“我的责任,就是把蔚来经营好,让蔚来活下去,这是对我们80万用户最大的责任。”
这句话并不动听,却很真诚。
如今蔚来已经翻过了一个又一个山头:10月交付新车超4万台、乐道L90连续三月蝉联大型纯电SUV销量冠军、蔚来全新ES8创造40万元以上纯电车型交付破三万的最快记录等等...
如今,蔚来距离盈利仅差一步。
....
#一见Auto采访小米陈光的一些信息分享......
2025年,智能驾驶行业出现“名词过载”现象,从VLA、VA、到WA,分化出多个派别,争鸣不断。
理想汽车智驾团队从端到端+世界模型全面切向VLA(Vision Language Action),在算法架构中引入大语言模型(LLM)。和理想一样坚定选择VLA的还有智驾供应商元戎启行。
行业里也有坚定的VLA反对派。华为表示,不会走向VLA,而是会坚定选择WA(World Action,世界模型)。和华为一样尝试去掉Language环节的还有小鹏。
而在这场争鸣中,端到端仍展现出巨大的潜力,小米汽车就是在这一方向持续深耕的企业。
“现在竞争太激烈,大家会产生一些焦虑,倾向于通过各种方式或技术让用户觉得更先进。”小米汽车端到端负责人陈光告诉《21汽车·一见Auto》,“但无论VA、WA还是VLA,在我看来其实都一样,都是看如何让模型的智能密度最大。”
现有头部新势力中,小米汽车启动端到端研发较晚。2024年,小米在内部正式整合成立“端到端算法与功能部”,负责量产方案开发。而理想、蔚来都比小米早了至少3个月。
但小米追赶很快。今年2月,小米正式向用户全量推送了300万Clips的端到端(HAD),7月再次推送了1000万Clips版本的端到端。11月21日,小米汽车在广州车展正式发布Xiaomi HAD增强版。
陈光介绍,新版本相较前两个版本,最大的不同是引入世界模型+强化学习。“在HAD增强版中,模型不但要知道去模拟老司机开车,而且知道为什么这样做。从认知层面上,这个模型具备开放世界的知识性,以及推断复杂场景因果的能力。”
但在端到端算法中引入世界模型和强化学习,小米并不是第一个。陈光认为,小米会把世界模型+强化学习做得“更坚决”。
他补充,强化学习作为一种出现多年的技术,在智能驾驶里用好它会面临两个难题:一是世界模型很难做到完全保真,这就需要在世界模型里放入大量、可编辑的数字资产; 二是并行探索的效率会面临很大挑战,因为算力需要合理分配。
“在一个模拟环境里,你会希望模型能少探索简单的场景,以节省算力;在复杂场景下,你又希望它多探索,以探寻最优路径。”
坚定选择端到端,并不意味着小米就放弃了其他路线的预研。当前小米的智能驾驶团队主要分成了三拨团队:
《21汽车·一见Auto》独家获悉,除开端到端、VLA,市面上的所有路线,包含WA、VA,在小米内部都有预研。除开VLA由陈龙负责外,剩下做路线预研的团队都由陈光管理。
陈光是小米端到端研发大部门的第一位负责人,此前该部门都由小米汽车智能驾驶业务负责人叶航军直管。
在加入小米前,陈光在一汽研究院待了四年,2024年初成为一汽研究院的总架构师,带领着近600人的团队。
陈光称,面对技术路径的选择上,小米从来不是“一刀切”。他认为,新技术的引入需要循序渐进,技术是否先进,并不代表体验一定更好,最终能否被用户感知、信任和长期使用,才是判断标准。
“从技术上来说,有时候你不一定能找到最强的技术,但你一定能找到最适合你的技术。大家讲一大堆新的名词,最终还是会落到用户体验上。用户体验不好,大家不会觉得是技术的问题,只会觉得是你出了问题。”
相较其他新势力,小米智驾团队有自己的独特性。一方面,它虽然不是成立最早的智驾团队,却是组建最快、追赶最猛的团队。
2021年3月30日晚,小米官宣造车,当天晚上,小米集团董事长雷军钦点时任小米技术委员会主席叶航军博士总领智能驾驶团队。成立第一年,小米组建了500人团队——那时,理想组建700人智驾团队已花费两年,小鹏花费3年。
4年间,小米智能驾驶团队已经超1800名成员,2024年3月SU7上市以来,小米从高精度地图进化到无图,近一年间又推送了三个版本的端到端,实现了在智驾技术方案上“一年追三代”。而此前其他新势力在智能驾驶路线上的摸索都至少经历了三年的时间。
“基建做得好,找新方向时不用投入太多人。”陈光告诉《21汽车·一见Auto》,“而本身科技企业的属性,使得小米天然就有一些优势。”截至三季度,小米2025年已经投入了235亿元研发费用,其中1/4的资金用于AI研发。
“云端的基建能力是可以相互借鉴的,而且经验可复制。就好比做饭,已经有人告诉你每一步应该怎么干,做起来就会很快。”陈光说。
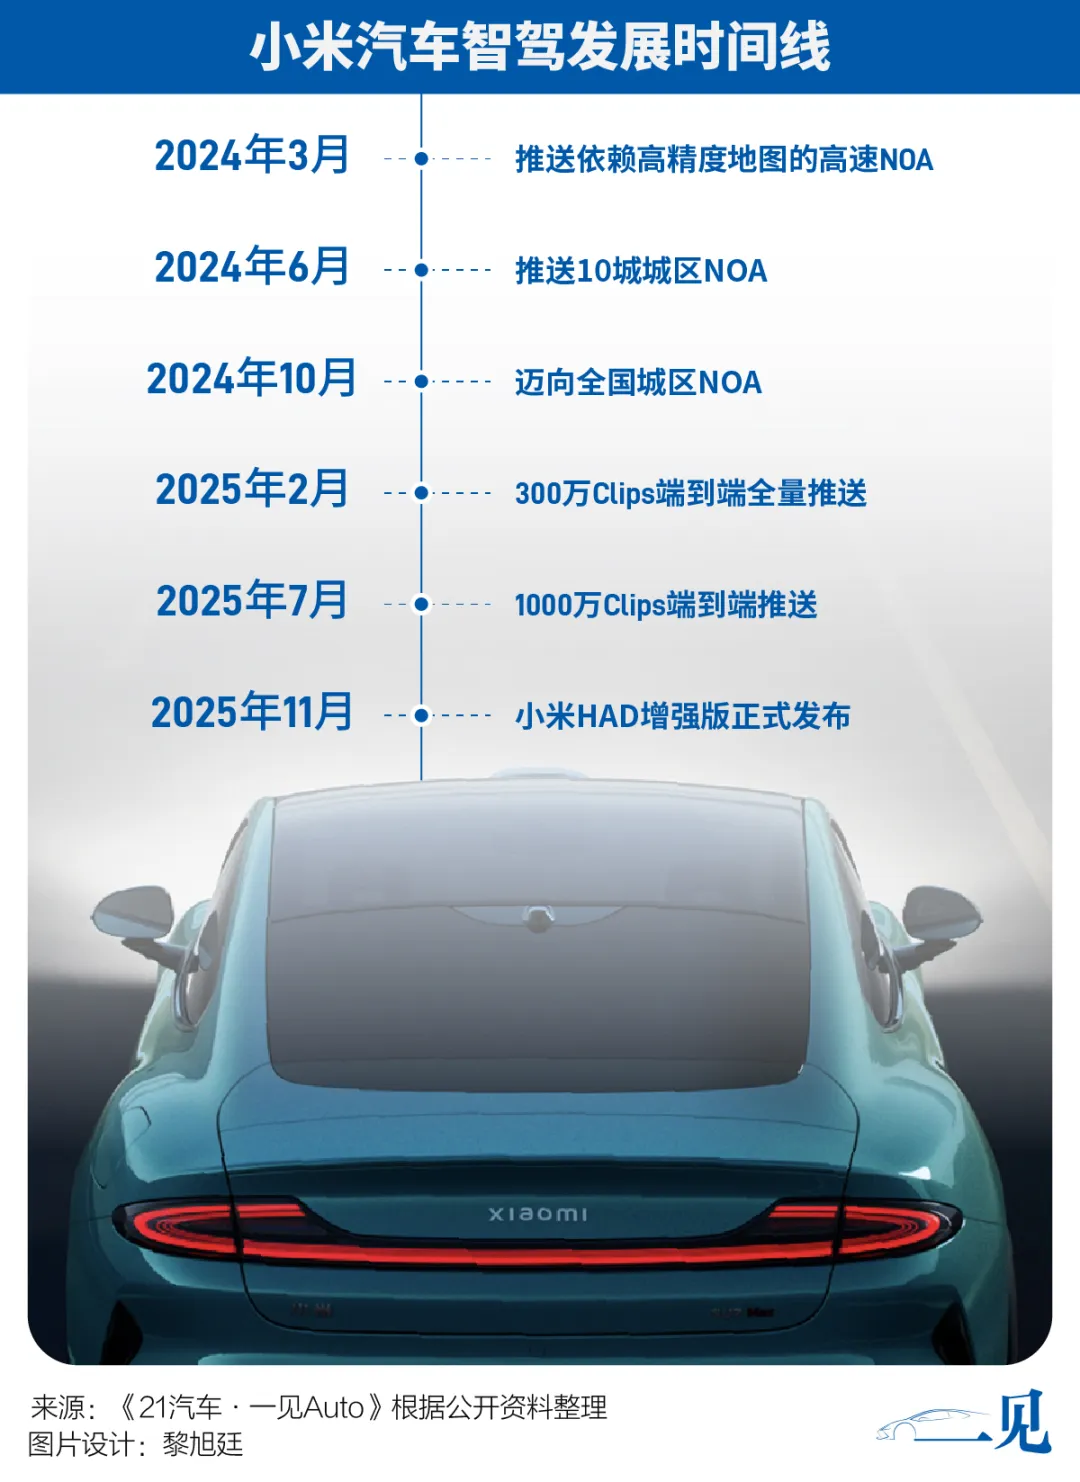
另一面,当下社会对辅助驾驶的讨论常伴批判与谴责,作为后来者的小米辅助驾驶团队,更遭遇了国内同行未曾经历的舆论危机。
陈光认为,这是备受外界关注的公司不可避免需要经历的课题,“不能只享受聚光灯下的掌声,而不承受台后各种困难带来的千锤百炼。得扛住压力继续向前。”
质疑与压力之下,小米从没有想过“跳代”。叶航军此前在采访中表示,小米智驾一直都是沿着“规则驱动——数据驱动——认知驱动”的行业发展阶段一步一脚印去做拓展,“从有图到无图,端到端、世界模型、VLA等主流技术栈,小米都有参与,且有不少论文产出。”
而眼下,摆在陈光面前最重要的任务是在年内完成Xiaomi HAD增强版的量产。
今年11月,时值Xiaomi HAD增强版发布前夕,《21汽车·一见Auto》和小米汽车端到端负责人陈光做了一次专访,我们谈了谈技术分野、行业未来的发展趋势、小米的基建能力、仿真能力。
以下是采访实录,内容经摘编:
“我们不想再制造技术焦虑了”
《21汽车·一见Auto》:小米HAD增强版和去掉“L”的VLA路线有何区别?
陈光:无论是VA、WA还是VLA,在我看来其实都一样,最后就是看你怎么使模型的智能密度最大。因为算力是有限的,在相同算力下如何让可承载的信息量对不同场景的理解能力更强,这是各家努力的方向。
无论是世界模型加强化学习,还是VLA大模型,说明大家发现了靠单纯的数据驱动解决不了所有问题,大家需要走向认知驱动的阶段。而数据驱动,你无法覆盖所有长尾场景,你也很难去平衡不同场景下的数据分布以及优化方式。
虽然我们这个版本叫增强版,但实际上已经走进认知驱动阶段了。这次的新版本,我们希望给用户扎实的体验。
《21汽车·一见Auto》:怎么区分认知驱动、数据驱动?
陈光:一个简单的端到端,只是模仿学习,它一定只是数据驱动。但一旦走到强化学习、世界模型、VLA阶段,一定是认知驱动。因为他不是简单模仿,而是知道为什么这么做以及应该怎么做,让他们自主去探索可能性,学会推理因果逻辑,这个能力是世界模型、强化学习或者VLA独有的。
可能不需要纠结于用哪个技术比哪个技术更好,或者哪个技术是谁的升级。大家还是围绕着一个目标、用一些认知驱动的技术方案去探索。
《21汽车·一见Auto》:但我们也看到小米内部另一个团队在预研VLA,你们这两个团队是怎么配合的?
陈光:“端到端+强化学习+世界模型”这一整套系统,更多还是解决直觉的问题。我们认为针对更多中等难度或者非极端困难场景,本能的反应是更快的。人遇到突然冲出来的行人,下意识肯定是先踩刹车。而不会是我要想个几秒,看看我是不是旁边借道。
《21汽车·一见Auto》:端到端+世界模型是不是对现阶段行业来说智能驾驶路线的最好解法?
陈光:是一个很好的解法,但我不能说最好,因为我们也在探索有没有更好的思路。从技术上来说,有时候你不一定能找到最强的技术,但你一定能找到最适合你的系统方案。其实各家解的问题不一样,比方说我们可能遇到一些问题,我们觉得用端到端来解更好;另外一些车企可能觉得VLA或者一些不一样的技术去解更好。
这都是大家的选择。大家讲一大堆新的名词,最终还是会落到用户体验上。用户体验不好,大家不会觉得是技术出了问题,只会觉得是你出了问题。
《21汽车·一见Auto》:既然多种方案有互补性,为什么行业里其他友商会执着地只选择一种路线?
陈光:行业竞争比较激烈,大家有时候会陷入技术焦虑上,希望找到一种方式把问题全解决。
友商只是探索一种新的开发方式。他们当前遇到一些问题,需要用新的方式去更好地解决。小米HAD增强版也是一样的。
无论是小米还是友商,大家其实心里都比较清晰,技术先进性未必能带来产品体验上的绝对进步。毕竟智驾是一个系统工程,你需要仔细考虑它的收益和潜在问题,在这中间取得一个平衡,最终落地的还是产品的体验感。
如果不能给用户带来更好产品体验,这个技术短期可能不具备成熟量产的必要性。
把所有问题都依赖于一套新方案来解决,有一定风险
《21汽车·一见Auto》:小米整个智驾团队多少人?
陈光:超过1800人。
《21汽车·一见Auto》:目前市场主流的VLA、VA、WA在内的主流技术方案你们都有在看,如何分配研发资源?
陈光:主流方案都在看。除了VLA,其他方案都是我这个团队在做,WA和VA都是我们在做。我们的WA,这版增强版可能更强调在仿真器/模拟器里面使用。其它方向的应用,内部会有一个小的精英团队在做方案的探索。
这么大一个团队,里面优秀的人挺多。但对于一个新的方向,不需要有大量的人一下子全投入。因为数据驱动和基建是一致的,你只需要有少量人在这方面做一些快速的探索,人多了不一定解决事。
《21汽车·一见Auto》:端到端方案能保证能力下限,但它的一个缺点是没有办法保证能力上限,所以需要世界模型。之前跟智驾供应商的人聊天,从去年年底今年年初,智驾供应商就坚决不做VLA。因为他们觉得在很多时候只需要用直觉判断,不需要去通过L(语言)那个环节。
陈光:只有特别复杂的场景下才需要调用思维链,否则会很累。就跟看轻喜剧和悬疑片一样。看轻喜剧,会很轻松;但看悬疑片,需要动脑子。这就需要你得有一个比较大的算力,或者有一个比较强劲的硬件去提升。
还是跟马斯克说的一样,怎么在有限的硬件条件下,能训练出来一个智能密度最大的模型,大家不要过分卷一些算力。
《21汽车·一见Auto》:为什么友商还是会选择走大模型、大算力的路线?
陈光:只要成本能cover住就行。如果成本cover不住,就需要在有限算力下做更多事。
你看各家都在讲不同算力,但是最终对于用户来说,用户不关心你有多大的算力,最终就是你体验能否更好。华为什么时候讲过华为的算力?即使特斯拉的算力非常大,特斯拉也从来不讲自己到底有多少算力。
只要我的体验足够好,我给用户带来足够愉悦的产品使用体验,就没有必要向外宣传自己的算力到底多大。
《21汽车·一见Auto》:端到端的下一步,会是VLA吗?还是说技术路线也不一定?
陈光:双方能打配合。端到端加世界模型加强化学习,主要解决直觉问题。VLA要解决的就是长序思考的问题。
但我们会不会一步就走到了VLA?我觉得一方面得看VLA技术迭代的速度和最终效果,如果VLA在各种场景下都比端到端好,那我们全面切向新方案。
《21汽车·一见Auto》:现在有一些友商在做VLA之后,会把所有资源都投入到新的技术方案上,原来的端到端就不做了。这会是一种很好的解法吗?
陈光:把所有问题都依赖于新方案来解决,有一定风险。不过,做任何技术判断都有风险。主要看各家的技术判断。他们觉得VLA是未来,全面切没问题。
基建做得好,找新方向时不用投入太多人
《21汽车·一见Auto》:小米不是第一个做端到端的车企,相比于友商,小米HAD增强版的优势在哪里?
陈光:奖惩制度上做得比较好,算法会在世界模型里反复练习,走错了就扣分,对了就加分,在奖励机制下不断尝试,找到更优的开车思路。我来之后,对这版本主要做了一些配合数据驱动的基建或者流程的优化,现在这套方案的数据驱动更加顺畅、效率更高了。
《21汽车·一见Auto》:底层的技术方案没有做优化吗?
陈光:如果整个研发架构是高效的,技术方案就不用大改。理想去年端到端做得很好,也是因为底层基建做得比较高效。
今天有人说VLA,有人说世界模型,对于底层的数据驱动来说是一致的。只要你的基建够强大,我可以快速尝试不同方案,看哪个方案对你当前遇到的困难有帮助。
《21汽车·一见Auto》:这里的基建怎么理解?
陈光:基建指的是以数据为核心的研发效能的提升。
《21汽车·一见Auto》:怎么判断一个基建好还是不好、效率高还是不高?
陈光:比方说我发现一个问题,我能多快地把类似问题从已有数据挖掘出来,并且形成标注过的高质量数据,以及整个模型训练够不够快,评测够不够自动化,都是判断基建好坏的维度。只要自动化率做上来,效率也可以很高。
《21汽车·一见Auto》:基建,很像之前智能驾驶团队里数据闭环团队做的事情。
陈光:可以这么理解。这一定是各家的knowhow(技术诀窍)。特斯拉什么时候吹过自己是端到端,什么时候吹过自己是VLA,他每次跟你讲都是说我当前遇到什么问题,做了什么样的方案,这个迭代效率有多快,这才是符合正常研发的逻辑——遇到问题,当前的哪一段需要调整,调整之后进行测试实验,看好不好,不好再调,好了就用。一定是这种快速迭代、小步快跑的思路。
《21汽车·一见Auto》:但小米2024年才发布了第一款车,智驾到今天也只是进展了一年,一年干了别人三年的活,小米是怎么在短时间之内把这个基建能力建设起来的?
陈光:本身科技企业的属性使得小米天然就有一些优势。
《21汽车·一见Auto》:小米其他业务也可以赋能到这边?
陈光:云端的基建能力是可以相互借鉴的。小米的其他业务底层基建打得很扎实,汽车业务能够对其他业务进行快速复用。
就好比做饭。如果现在厨房里,已经有人告诉你,洗好的菜在哪、案板在哪、锅在哪、油盐酱醋在哪,每一步应该怎么干,你难道还需要从头学一遍吗?
基建的经验是可复刻的。不然大家做云,没有意义。做云的意义就在于,能共用的东西尽量共用。现在智驾的整个开发其实跟大模型的开发越来越类似了。整个开发效率快,基建能力能不能吞吐掉这么多的数据,这个能力其实是共用的。
《21汽车·一见Auto》:除了基建能力强大,还有没有其他的优势让小米在一年之内快速追赶友商?
陈光:小米汽车测试资源、数据资源非常充沛。对我们来说,很容易拿到高质量的场景数据。
有基建的能力,自己对专属的素材跟测试的重视,才造就了现在小米的“快”。
“不能只享受聚光灯下的掌声,而不承受困难带来的千锤百炼”
《21汽车·一见Auto》:小米经常处于舆论风暴的中心,这些舆论有影响你的决策吗?
陈光:没有。任何个人团队或者企业,你不可能只享受台前聚光灯下的掌声,而避免承受台后各种困难带来的千锤百炼。
《21汽车·一见Auto》:面对外界对于小米辅助驾驶的质疑,团队当时的心态是什么?
陈光:团队会有一些紧张和担心,也会很有压力。我作为负责人,还是希望大家能用长线思维去思考这个问题。比如,针对这个问题有没有可以快速的新解决方式?新方案引入的代价、收益分别是什么?如果它的代价大于它的收益,那我们就不要着急在短期立刻按照新的方案进行调整。试试看看有没有更好的方案可以平衡最后的收益,同时降低风险。
《21汽车·一见Auto》:你加入小米之后,做的第一件事是什么?
陈光:当时可能主要是先找到当前技术方案的性能短板,分析背后的技术路线是否合理,同时要看是否有可以调整的机会。
《21汽车·一见Auto》:之前端到端的整个团队都是叶航军博士自己在带,你是第一个接替他管理端到端的人,也是小米智能驾驶成立以来第二个端到端大业务部门的负责人。作为空降高管,你在管理上有什么方法论吗?比如每个月会定一个目标去达成?
陈光:我个人偏共创共识型。如果有一个比较好的方案或者研发范式,我会先和核心骨干、核心主管反复沟通,把共创共识做得扎实一些。希望核心方向、这个组聚焦的方向要保持一致。
对于这种大的技术方案,我们强调初期要抓大放小,不要把所有的困难揉在一起,想靠一条路给他走通。这个可能不一定合适,但是你的主线任务一旦确定,主线方案一旦聚焦,这是最核心的点。
《21汽车·一见Auto》:共创共识,当发生分歧的时候,谁来当裁判官?
陈光:共创共识最开始肯定是各个部门的主管,他们要先商量,遇到不行的地方,也需要更大老板来做出决定。
《21汽车·一见Auto》:我们这次的Xiaomi HAD增强版本在推出的过程中,在共创共识上是否遇到过比较大的分歧?有没有记印象特别深刻的那一两个场景?
陈光:会有一些讨论,但非常激烈的场景没有。小米这边都挺nice的,整个公司文化就是peace and love。
但我们有时候会拒绝一些新的需求。比方我们觉得某个需求,业务的时间确实有点赶不上。产品同事的第一反应可能是,是不是你不想干。但你只要跟他讲清楚,为什么当前我做不了这件事,拿一些指标性的数据去做证明。产品同事也不会只听我们,他们也会挑战我们,比如他们会说,其他家做到了,为什么小米不可以?
被挑战,在小米很正常,只有这样,才能螺旋上升。
《21汽车·一见Auto》:你们一般开共创会的频次是怎么样的?
陈光:看需求、看事情的紧急程度。七月交完了新版本之后,我们共创频次相对高一些。因为要迅速地找到当前方案存在的问题,并开始布局下一个方案。
《21汽车·一见Auto》:友商会为了超车也会进行一些封闭式训练,你们是这个打法吗?
陈光:封闭式训练,是传统科技企业或者互联网企业强调的war room文化。我们历史上应该经历过,但不多。一般在一些特别急的产品方案交付过程中,需要把隶属于不同小团队或者小部门的核心骨干聚在一起,让大家交流更加快速。
仿真在训练的时候,看起来占比不多,但价值比较高
《21汽车·一见Auto》:把强化学习应用在智驾系统上,小米不是第一个。和友商相比,小米的独特性在哪里?
陈光:强化学习不是新的技术,它是非常经典的机器学习理论,大家过去把它应用在了不同的方向上。在世界模型的模拟器、强化学习的使用上,我们比一般友商要坚决。
如果要用强化学习对已经训练好的系统做一些后训练,需要比较好的模拟系统能看到这些原始的信息。这就需要我们使用世界模型去构建高保真的虚拟环境,让智能体或者智驾系统在世界模型构建的虚拟环境去自由探索,我们同时还得保证这个虚拟环境和真实道路上的探索没有差别。
《21汽车·一见Auto》:为什么要做这件事?
陈光:开发者希望强化学习能在相同场景下通过使用不同的奖励和惩罚措施,来找到该场景下最优的驾驶行为,这就需要场景必须具有一定的可复现性。
但特别危险的场景,很难遇到,而且也很难在这种场景下不停地测试算法的性能、去做数据的增强,这就需要先做一个比较好的仿真环境,让智能体或者强化学习的算法进行自由探索。
《21汽车·一见Auto》:在智驾里面引入强化学习有哪些难点?
陈光:一是世界模型要做得足够保真、同时场景容易编辑生成。二是并行探索的效率要高。
《21汽车·一见Auto》:怎么判断一个好的仿真环境?
陈光:首先,它需要足够逼真、真实,符合几何和物理的规律。同时还需要有比较强的场景编辑能力,比如可以改变一些环境要素,包括光照、天气、路面的湿滑程度、引入交通参与者等。
大家说仿真不好,主要原因是有些企业的生成质量不高。我们这一代仿真数据的生成质量很强。
《21汽车·一见Auto》:怎么保证仿真数据足够好?
陈光:我们会有一些评价指标,我们根据真实指标,对仿真环境中规模化生成的图像和对应点云进行评估保证一致性要好。
第二步就是你只能让它像,但你不能让它像得完美。
过去游戏引擎做得很真,那种真是把所有的事物都做得很完美的。但对于智驾业务来说,你希望他能模拟道路里面的一些残缺的真实性。
比如智驾会很害怕相机的脏污,激光雷达在一些水面反射会消失,这个水会吸掉激光一些点,这些东西都希望模拟器能进行仿真。
《21汽车·一见Auto》:原来用仿真更多侧重于未出现场景的模拟,但现在用仿真,好像更多是对已经发生的真实场景的还原。
陈光:还原只是其中一环。自动化生成新场景,使得它变得更加的广泛。比方说同样都是一个雨天,你可能希望这个场景里可以插入一些交通事故,同时也会希望插入到不同湿滑程度地面对传感器的影响。
《21汽车·一见Auto》:在我们这次推出的Xiaomi HAD增强版里,仿真数据占据了多少比例
陈光:对比真实数据,占比较高。
针对我们所有的实车测试里程,我们希望在仿真里面至少是100倍的。这样才符合整个测试三支柱里对模拟开发的要求。
《21汽车·一见Auto》:测试三支柱怎么理解?
陈光:仿真测试、场地测试和实车测试。从一个完美的测试理论来说,仿真测试能帮你做一个快速验证,这是最核心的。
第二个是场地测试。这步主要是把整个车的能力给调动起来,在一个场地里模拟一些极端场景,去看系统整体的反应。
最后才是上实车。按照这个理论,我们的仿真数据是严格按照百倍以上比例去做的。
《21汽车·一见Auto》:训练的话,仿真数据和真实数据会怎么分配比例?
陈光:二八分,真实数据占80%,仿真数据做到20%的比例就已经顶天了。
因为你肯定是使用更多真实场景的数据,仿真只能解决你真实场景下很难遇到的问题,实车都能遇到的数据,为什么还需要仿真呢?
训练的时候,如果90%的数据都是仿真,那就说明实车测试数据不够。你的数据是不是有问题?因为绝大部分场景还是普通场景,这些数据是真的没有办法采集到吗?
《21汽车·一见Auto》:20%的仿真数据,能够减少多少人力成本?
陈光:如果没有20%的仿真,人力成本至少得翻个几倍。
仿真要解决的是你实车不好遇到的问题,所以你要去采那种不好遇到的场景,非常困难。
举个简单例子,高速路上遇到运输几十米的大风叶,这种场景直接在路上采,很难遇到,一个月能采集到一个场景,就不错了。但这个场景,在仿真器里面就很好做,这部分人力成本就能省下来不少。
仿真在训练的时候,看起来占比不多,但价值比较高。它主要是解决了你实车不好遇到、不好收集和挖掘的数据。仿真还是非常重要的。
《21汽车·一见Auto》:在你加入之前,小米有做仿真吗?
陈光:在做一些,但是最开始业务没有那么聚焦,我来之后就帮大家一起梳理了一下。
《21汽车·一见Auto》:在你刚加入小米的时候,仿真是你在分析完当前系统之后决定大力投入的事情吗?
陈光:是的,我觉得需要投入。但是当时遇到的问题,仿真可能没办法解决,问题出在整个系统方案上,得需要做重新梳理。
做VLA要自研芯片吗?看需求
《21汽车·一见Auto》:自己做VLA的话,有必要自己去研发自动驾驶芯片吗?
陈光:看需求,看是不是划算。做芯片的好处就是首先做出来,做好之后,它的成本会相对可控一些。因为你要自己用,BOM成本还会低。第二个,软硬件的配合上可能会好一点。
坏处是你前期投入很大,芯片这个东西回本比较辛苦。所以说主要看需求,不同的企业需求不一样。
《21汽车·一见Auto》:如果自研的第一代智能驾驶芯片上车,一般来说会遇到哪些问题?
陈光:从一颗芯片迁移到另一颗芯片时,往往会面临“部署偏差”的问题。一方面,不同芯片在算子支持和优化方式上存在差异,部分模型结构需要相应调整;另一方面,由于计算精度和实现机制不同,同一模型在不同芯片上运行时,其数值分布和输出结果也可能出现不一致。因此,在模型上车前,需要基于目标芯片的实际特性进行针对性的优化和校准,确保模型在不同芯片平台上的表现一致、稳定。
《21汽车·一见Auto》:优化的工作量大吗?需要提前多长时间做?
陈光:需要6~10个月,甚至更久的时间。假设我在A芯片跑得很好,有个B芯片我需要切过来,原封不动切换芯片,可能也需要六个月。
英伟达的芯片从Orin迁移到Thor,很多企业也花了不少的时间。何况英伟达都是同一套供应链、同一套底层GPU。更别说你从A芯片迁移到B芯片。假如今天用高通,明天用TI,这个迁移成本是存在的。
这也是芯片企业的护城河。如果迁移成本很低,客户的选择空间自然会更大。
《21汽车·一见Auto》:那小米从Orin迁移到Thor上,花了多少时间?
陈光:我们比一般企业要快很多,因为它是一家企业的两款芯片。
《21汽车·一见Auto》:为什么小米可以做到比别人快?
陈光:投入就行了。
《21汽车·一见Auto》:小米什么时候开始迁移的?
陈光:3月,我刚来小米的时候,迁移就已经基本完成了。
L4一定会做成,车企也会慢慢涉足到L4
《21汽车·一见Auto》:你加入小米辅助驾驶之前,在百度阿波罗、一汽南京研究院都待过,履历更多集中在L4。从Robotaxi转到乘用车辅助驾驶,有哪些可以复用的经验?
陈光:我加入小米之前,有很长一段时间做Robotaxi。但在上一家企业,也做了不少辅助驾驶相关工作。
从我的视角来看,无论L2还是L4,现在的技术栈都越来越走向统一了。之前在规则驱动的开发范式下,针对不同的感知、预测、决策、规控等不同模块,大家有不同的技术栈。但数据驱动、认知驱动下,两者的开发逻辑越来越相同了,只是场景化上有差异。
L2更多强调任意场景下点到点的通行,L4强调特定区域下的点到点通行。L2需要平衡安全、效率、舒适性,L4对安全系数更高,需要做更多的安全冗余,做到绝对安全。
《21汽车·一见Auto》:L2、L4哪个对你的挑战会更大一些?
陈光:目前还是L2挑战更大。因为它受限于车上有限的算力、有限的传感器,以及需要不停地平衡用户的驾乘习惯跟驾乘体验,这就要求我们在做系统设计时候,更加仔细、优化更彻底。
《21汽车·一见Auto》:最近路权放开了,很多Robotaxi的公司都开始上市了。比如小马智行,文远知行。你怎么看待Robotaxi这波回春潮?
陈光:这是一个很好的现象。2016年,以百度阿波罗为代表,很多企业都在发力Robotaxi,大家进行了大量方案的设计探索。2020年开始,L4公司发现当时的技术方案已经解决不了遗留下的超长尾的问题,行业就进入了一段时间的低谷。
2022年底,以GPT为代表的大模型方案,让整个人工智能发现,机器可以掌握比人类更全的知识。面对一些新的问题,机器同样具备一定推理思考、长时间探索的能力。
现在的自动驾驶和辅助驾驶的这种核心技术理念已经越来越一致了。唯一的不一致是安全,L4最后兜底的事情需要由系统来解决。那就要求在整个系统方案设计时候要充分考虑各种各样的冗余,安全冗余、软件冗余、硬件冗余,以及最危险场景下的风险控制。这是当前L4在着重解决的事情。
L2作为辅助驾驶,它主要是辅助,可能人类驾驶员作为最终对这个系统要进行监督和把控的责任方,他需要不停去平衡机器和驾驶员之间的一些喜好。考虑的事情跟L4考虑的事情有些出入,这可能是唯一的区别。
L4一定是会做成的,从车企的角度来说,也慢慢会涉足到L4。
....
#WAM-Diff
刷新NAVSIM SOTA!端到端自动驾驶新框架Masked Diffusion
随着 VLA(Vision-Language-Action)模型的兴起,端到端自动驾驶正经历从「模块化」向「大一统」的范式转移。然而,将感知、推理与规划压缩进单一模型后,主流的自回归(Auto-regressive)生成范式逐渐显露出局限性。现有的自回归模型强制遵循「从左到右」的时序生成逻辑,这与人类驾驶员的思维直觉存在本质差异 —— 经验丰富的驾驶员在处理复杂路况时,往往采用「以终为始」的策略,即先确立长期的驾驶意图(如切入匝道、避让行人、靠边停靠),再反推当前的短期操控动作。此外,基于模仿学习的模型容易陷入「平均司机」陷阱,倾向于拟合数据分布的均值,导致策略平庸化,难以在激进博弈与保守避让之间灵活切换。
针对上述痛点,复旦大学与引望智能联合提出了 WAM-Diff 框架。该研究创新性地将离散掩码扩散模型(Discrete Masked Diffusion)引入 VLA 自动驾驶规划,并结合稀疏混合专家(MoE)架构与在线强化学习(GSPO),构建了一套不再受限于单向时序的生成式规划系统。
在权威评测基准 NAVSIM 中,WAM-Diff 展现了卓越的性能,在 NAVSIM-v1 和 v2 榜单上分别取得了 91.0 PDMS 和 89.7 EPDMS 的 SOTA 成绩,有力证明了非自回归生成范式在复杂自动驾驶场景下的巨大潜力。
- 论文标题: WAM-Diff: A Masked Diffusion VLA Framework with MoE and Online Reinforcement Learning for Autonomous Driving
- 论文链接: https://arxiv.org/abs/2512.11872
- 开源项目: https://github.com/fudan-generative-vision/WAM-Diff
核心创新:重新思考生成逻辑
从数值回归到离散序列生成
为了在统一的特征空间内实现对世界的理解与动作规划,WAM-Diff 首先引入了混合离散动作分词(Hybrid Discrete Action Tokenization)技术。研究团队将连续的 2D 轨迹坐标量化为高精度的离散 Token(误差控制在 0.005 以内),并将其与代表驾驶指令(如「左转」、「避让」、「停靠」)的语义 Token 置于共享词表中。
在此基础上,WAM-Diff 采用 Masked Diffusion 作为生成骨干。与逐个预测下一个 Token 的自回归模型不同,Masked Diffusion 从一个全掩码序列出发,利用双向上下文信息,在每一步迭代中并行预测所有位置的 Token。这种机制不仅大幅提升了推理效率,更重要的是赋予了模型全局优化的能力,使其能够同时利用过去和未来的信息来推断当前的最优动作。
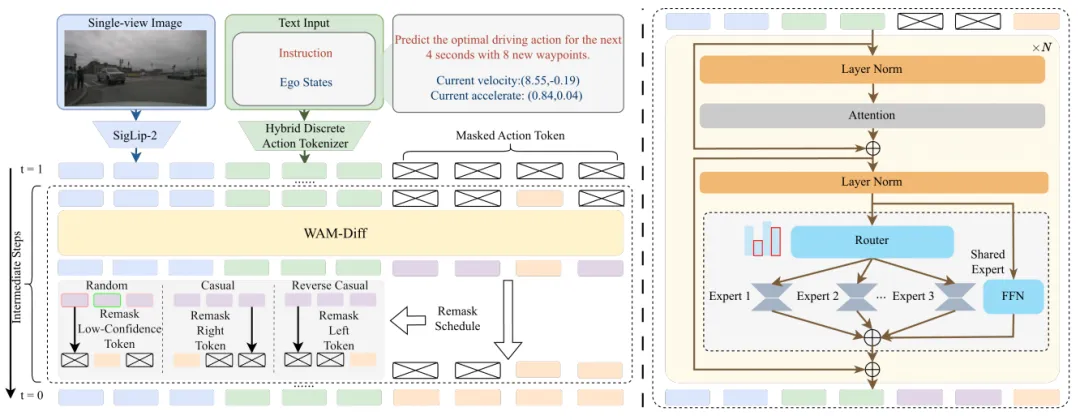
Figure 1 : WAM-Diff 的模型总体架构图。
解码策略验证「反因果」规划的有效性
摆脱了「从左到右」的时序束缚后,模型该如何安排轨迹生成的优先级?WAM-Diff 深入探索了因果序(Causal)、反因果序(Reverse-Causal)和随机序(Random)三种解码调度策略。实验结果揭示了一个反直觉但极具价值的现象:反因果序策略在闭环指标上表现最佳。这意味着,先确定远处的终点状态,再倒推近处的轨迹细节,这种「以终为始」的生成逻辑能显著提升规划的一致性与安全性。这一发现从模型层面验证了人类驾驶员在复杂博弈场景下的直觉思维。
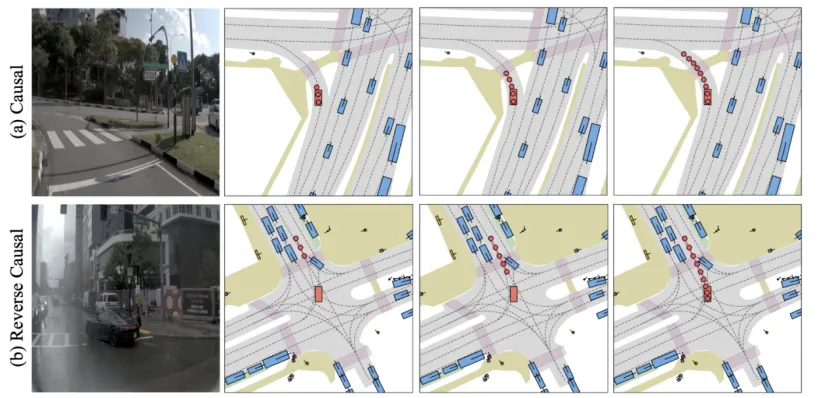
Figure 2 : Masked Diffusion 的不同解码调度策略。
MoE 混合专家与 GSPO 在线强化学习
面对多变的驾驶场景,单一模型往往难以兼顾各种极端情况。WAM-Diff 通过在主干网络中集成 LoRA-MoE(Low-Rank Adaptation Mixture-of-Experts)架构来解决这一难题。模型包含 64 个轻量级专家,通过门控网络实现动态路由与稀疏激活。在推理过程中,模型能够根据当前场景自动激活最匹配的驾驶专家,在控制计算开销的同时显著提升了模型的容量与适应性。此外,团队采用了多任务联合训练策略,使模型在学习轨迹预测的同时,通过驾驶 VQA 任务理解场景语义。这使得专家网络不仅掌握了驾驶技能,更理解了驾驶决策背后的因果逻辑,显著增强了规划的可解释性与泛化能力。
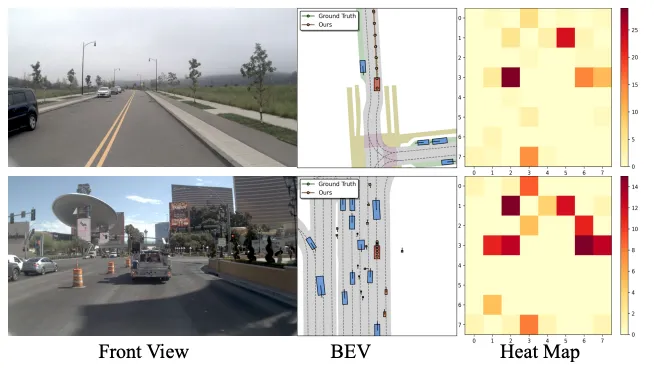
Figure 3 : MoE 组件的定性分析。不同场景下规划轨迹的 BEV 可视化与专家激活热力图。
与此同时,单纯的模仿学习容易导致模型在长尾场景下缺乏鲁棒性,且难以显式优化安全指标。为此,WAM-Diff 引入了分组序列策略优化(GSPO, Group Sequence Policy Optimization)算法,旨在弥合开环训练与闭环执行之间的鸿沟。GSPO 的核心思想是将优化粒度从「单步 Token」提升至「完整轨迹序列」。系统在仿真环境中采样一组候选轨迹,并依据安全性(碰撞检测)、合规性(车道保持)及舒适性(加减速平滑度)等多维指标对整条轨迹进行评分。通过计算组内相对优势,模型被显式引导向「高安全、高舒适」的区域更新。这种序列级的价值对齐机制,从根本上确保了规划结果不仅「像人」,而且比人类驾驶数据更安全、更规范。
实验结果
为了验证 WAM-Diff 的有效性,我们在权威的 NAVSIM 自动驾驶评测基准上进行了广泛实验。结果显示,该方法在 NAVSIM-v1 和 v2 榜单上均取得了具有竞争力的表现。具体而言,在 NAVSIM-v1 中,WAM-Diff 达到了 91.0 的 PDMS 分数,超越了 DiffusionDrive、ReCogDrive 以及 DriveVLA-W0 等主流基线模型。
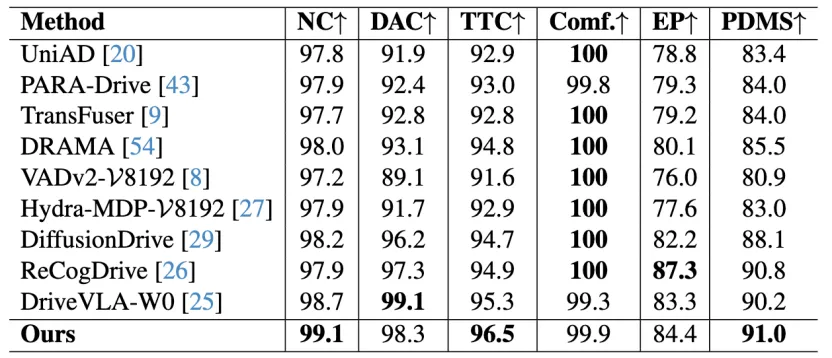
Table 1 : 在 NAVSIM-v1 上与最先进方法(SOTA)的对比。
进一步地,在引入了交通规则遵循度与舒适性等更严格指标的 NAVSIM-v2 测试中,模型依然保持了稳健性,取得了 89.7 的 EPDMS 成绩,相较于 DiffusionDrive 提升了 5.2 分。这表明 WAM-Diff 能够有效平衡驾驶的安全性与合规性,在面对贴近真实驾驶的复杂评测体系时仍能生成高质量的规划轨迹。
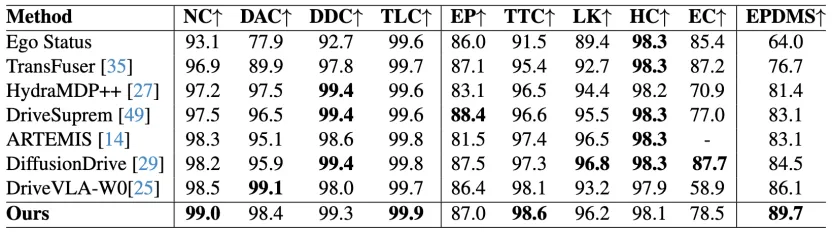
Table 2 : 在 NAVSIM-v2 上与最先进方法(SOTA)的对比。
此外,我们对掩码扩散的解码策略进行了深入的消融研究。实验对比了随机序、因果序与反因果序三种模式,结果发现反因果序策略取得了最佳的闭环性能(91.0 PDMS)。这一数据有力支持了 “以终为始” 的规划直觉:优先确立远期驾驶意图,再反推近端动作细节,有助于生成在时序上更一致、安全的可执行轨迹。
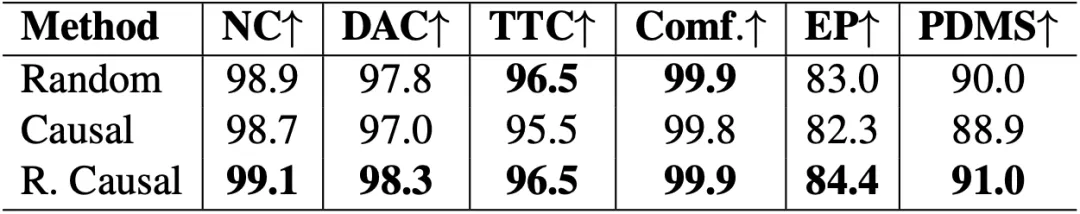
Table 3 :掩码解码调度策略的消融研究。
定性实验与可视化结果进一步展示了模型在复杂博弈场景下的稳定性,验证了 MoE 架构与在线强化学习(GSPO)组件在提升长尾场景鲁棒性方面的作用。
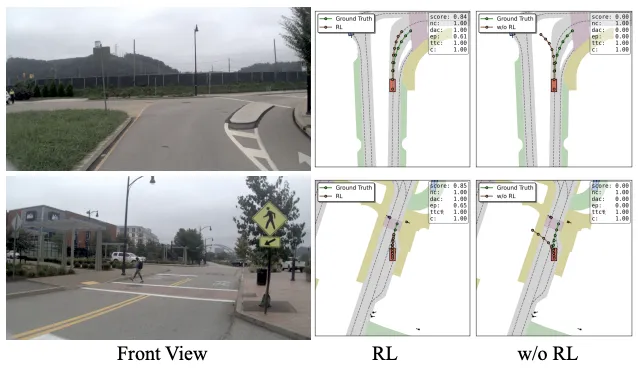
Figure 4 : 强化学习 GSPO 在不同驾驶场景下的定性消融分析。
总结
WAM-Diff 的出现,标志着端到端自动驾驶规划向离散化、结构化、闭环化迈出了重要一步。它并未简单地堆砌模型参数,而是通过 Masked Diffusion 重构了时序生成的逻辑,利用 MoE 解决了策略单一性的瓶颈,最后通过 RL 守住了安全的底线。对于业界而言,WAM-Diff 证明了在 VLA 时代,「如何生成」与「生成什么」同样重要。这种具备反向推理能力且风格多变的规划器,或许正是通往 L4 级自动驾驶的一块关键拼图。
....
#如何做好高保真虚拟数据集的构建与感知?
端到端下半场~
01 前言
随着自动驾驶技术的日益升级,以UniAD、FSD V12为代表的“端到端”架构正重构行业格局。这一架构试图通过单一神经网络直接建立从传感器输入到车辆控制的映射,从而突破传统模块化累积误差的局限。
然而端到端模型对数据分布的广度与深度均有着高要求,尤其是对缺乏归纳偏置的Transformer架构而言,“数据规模”与“场景覆盖度”可谓直接决定了模型上限。
现实路测数据面临极端的长尾工况数据局限,如实车采集“采不到、标不准、测不起、太危险”。在此背景下,“虚拟数据集”成为了大家关注的热点,通过构建涵盖极端天气、复杂交互及事故场景的高保真虚拟数据,我们不仅能够以低成本、高效率的方式生成海量带标签的样本,更能为端到端模型提供闭环训练环境。虚拟数据集已不再是现实数据的简单补充,而是训练高阶端到端模型不可或缺的一环。
为满足自动驾驶算法对高质量数据资产的迫切需求,并有效应对真实路测的局限,本文将全面阐述高保真虚拟数据集SimData的构建方法。我们将深入解析aiSim2nuScenes工具链如何实现从物理级虚拟数据生成、标准化格式转换,直至最终数据集评测与验证的全流程闭环。
图1:虚拟数据集SimData样本示例
02 SimData数据集概述
面对自动驾驶算法对高质量数据的需求,传统真实路测正面临着巨大压力,一是资金密集型的车队运营与指数级增长的维护成本,导致其缺乏规模效应,难以支撑感知模型的数据吞吐;二是人工3D标注在恶劣天气与远距视角下的主观偏差及真值缺失,直接限制模型精度的上限;三是海量低价值的数据稀释训练价值,导致“长尾”场景捕获效率极低;最后法律与伦理的红线,更致使缺少关键的“事故临界态”数据。
在此背景下,虚拟仿真凭借数字化优势成为直面以上压力的关键角色。它不仅能通过边际成本递减打破资金壁垒,还能利用自动化真值生成彻底消除了人工噪声,实现了像素级精确标注。此外虚拟仿真更能够实现全要素可控,进而可自由重构复杂交通流与极端工况。
对此,基于aiSim高保真仿真器,本文给大家介绍SimData虚拟数据集,以便能够针对感知算法痛点进行攻关。以下是该数据集的简要介绍与获取方式:(更多介绍可阅读SimData深度解析:高保真虚拟数据集的构建与评测)
- 规模与密度: 数据集包含15张高精度地图和45个独立场景,单传感器数据量级突破18,000帧,总样本量(Samples)达到215,472帧,目标实例(Instances)超过64,000个;
- 场景多样性: 覆盖高速公路(Highway)、城市峡谷(Urban)和立体停车场(Parking)三大核心ODD。特别是针对真实路测中难以捕捉的施工区域、高速匝道汇入、无保护路口以及光照剧烈变化的室内车库进行了重点建模;
- 类别均衡性:针对真实数据集中“类别不平衡”的问题,SimData在保证Car、Pedestrian等基础类别密度的同时,增加了Trailer(拖车)、Barricade(路障)、Traffic Cone(交通锥)、Van(面包车)等稀缺类别的样本比例。这种人为干预的数据分布优化,直接提升了模型对异形障碍物的检出能力。
图2:Highway(左)、Urban(中)、Parking(右)
图3:数据集数据的分布统计,数据集包含了880个实例(Instances),215,472个关键帧数据(Sample Data)以及64,190个标注信息(Annotations)
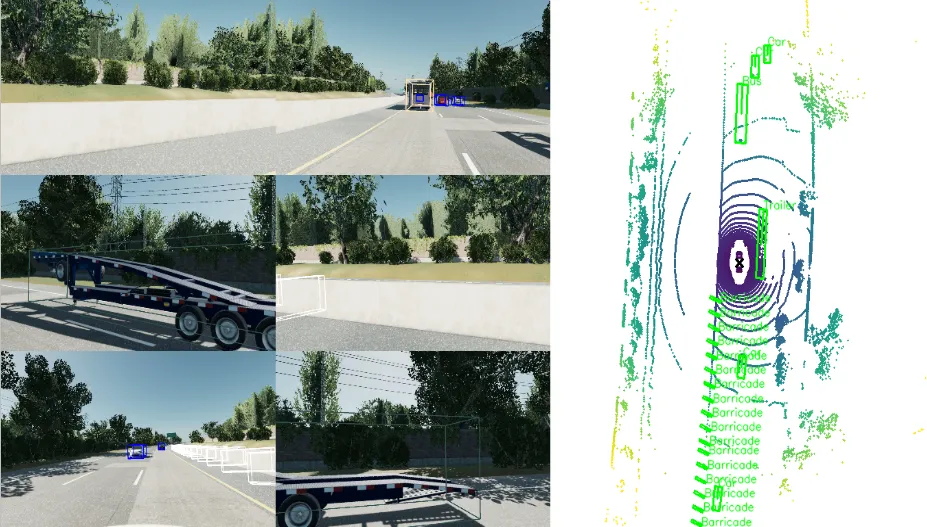
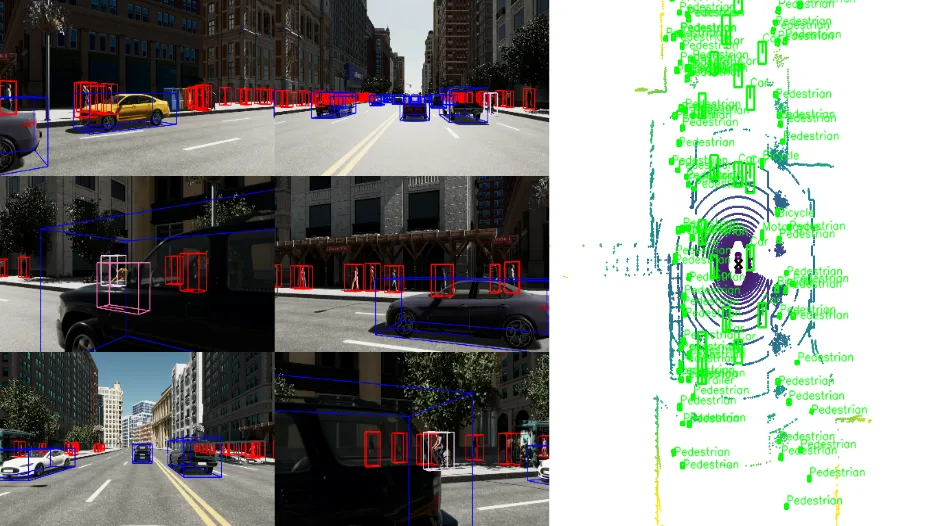
图4:simData标注真值在6环视相机以及bev视角下的可视化
以下视频来源于
康谋自动驾驶
,时长01:41
SimData整体可视化展示
目前,虚拟合成数据集SimData-V1已正式开源,可以通过以下链接直接获取:
完整版:https://huggingface.co/datasets/Keymotek/simData-Dataset
mini版:https://huggingface.co/datasets/Keymotek/simData_mini-Dataset
03 自动化工具链:aiSim2nuScenes
在自动驾驶从研发迈向落地的关键阶段,如何高效、标准化地将虚拟仿真环境转化为算法可直接摄取的高价值数据资产,已成为决定工程化成败的核心挑战。对此,本文介绍的 aiSim2nuScenes 工具链,其并非单纯的数据转换接口,而是一套构建了从虚拟世界到算法应用标准桥梁的端到端合成数据生产与闭环评测体系。
该工具链以流水线作业的形式,无缝串联起高保真数据合成、标准化格式迁移以及自动化闭环测评三大关键环节。它不仅能基于物理引擎批量生成包含多模态传感器信息的原始数据,并能将其自动化映射为通用的 nuScenes 标准格式,彻底消除仿真平台与主流训练框架间的“隔阂”。
无缝集成的生态兼容性
为了降低工程团队的迁移成本,aiSim2nuScenes实现了对行业标准nuScenes-devkit的原生级支持。该工具链提供脚本(Script)批处理与图形化界面(GUI)双模式,能够自动解析aiSim导出的原始数据,并将其重构为nuScenes标准文件结构:
- 视觉数据: 自动完成从无损TGA格式到JPG的转换,并智能抽帧(默认每10帧提取关键帧),非关键帧自动归档至sweeps,保留了时序信息的完整性;
- 点云数据: 实现LiDAR数据从LAS到BIN、Radar数据从JSON到PCD的格式清洗与转换;
- 元数据自动化: 自动生成category.json(类别定义)、ego_pose.json(自车位姿)、calibrated_sensor.json(传感器外参)及sample_annotation.json(真值标注),彻底消除了人工标注引入的认知偏差与随机误差,实现了“生成即真值”。
微秒级多传感器时空同步
多模态融合算法对时间同步的敏感度极高。SimData数据集配置了经典的L2+传感器布局:6路环视相机(360° FOV)+ 1个顶置高线束LiDAR + 5个周视毫米波Radar。aiSim2nuScenes在数据生成阶段,通过确定性的仿真时钟,保证了所有传感器数据在同一时间戳下的严格对齐,同步精度达到微秒级,完美满足BEV算法对时空一致性的严苛要求。
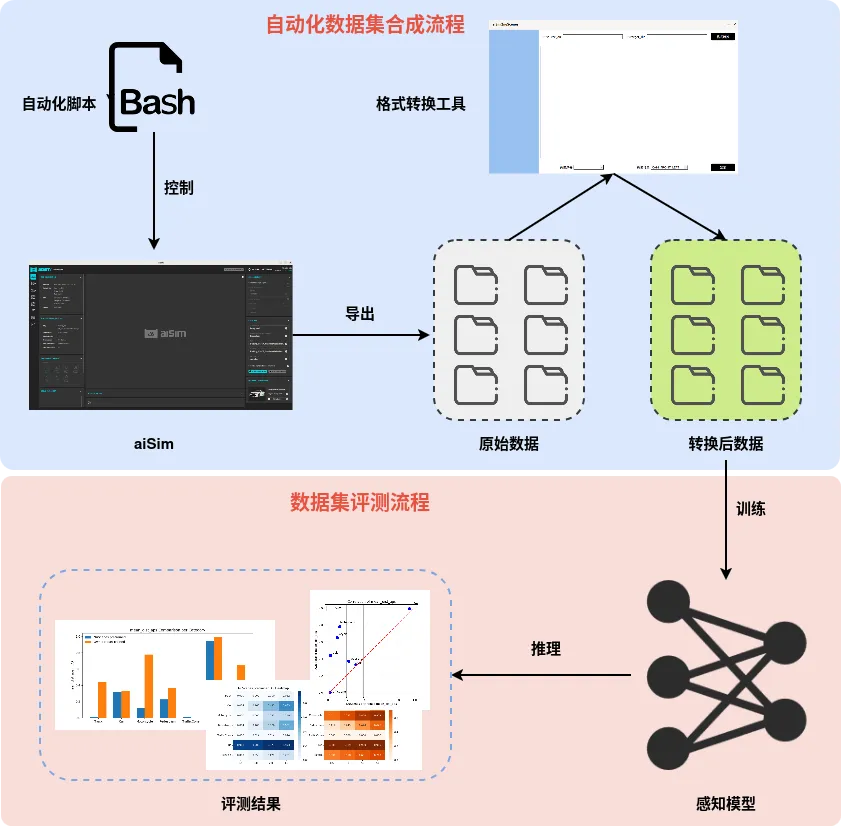
图5:从aiSim场景配置、仿真运行,到数据导出、自动化格式转换,再到最终感知模型训练的完整闭环
以下视频来源于
康谋自动驾驶
,时长01:56
simdata2nuScenes工具功能视频:从数据格式转换到真值可视化
04 算法实证:性能跨越与鲁棒性验证
“仿真数据能否训练出在真实世界可用的模型?”这是所有算法工程师关注的问题。为此,本文基于BEVFormer-tiny,设计了严谨的定量评测实验,用数据回答了关于收敛性、一致性与迁移能力的质疑。
良好的收敛性
在纯虚拟数据集上进行的训练实验显示,模型在30个Epoch内迅速收敛,最终mAP达到0.446,NDS(nuScenes Detection Score)达到0.428。特别是在Bus(AP 0.989)、Motorcycle(AP 0.778)等大尺寸目标上,检测精度极高。这证明aiSim生成的数据在统计分布和特征维度上是良构的,能够被深度神经网络有效拟合。
虚实一致性
为了探究模型“学到了什么”,本文对比了“SimData训练模型”与“nuScenes官方预训练模型”在SimData测试集上的表现。
- AP相关性分析:两者在不同类别上的AP值呈现显著正相关(Pearson系数接近1);
- Attention Heatmap分析:检测热力图显示,两个模型在距离感知和空间关注点上高度重合。无论是近处车辆的纹理特征,还是远处行人的轮廓信息,虚拟数据训练的模型展现出了与真实数据模型一致的注意力机制。这从可解释性角度有力证明了aiSim数据的高保真度。
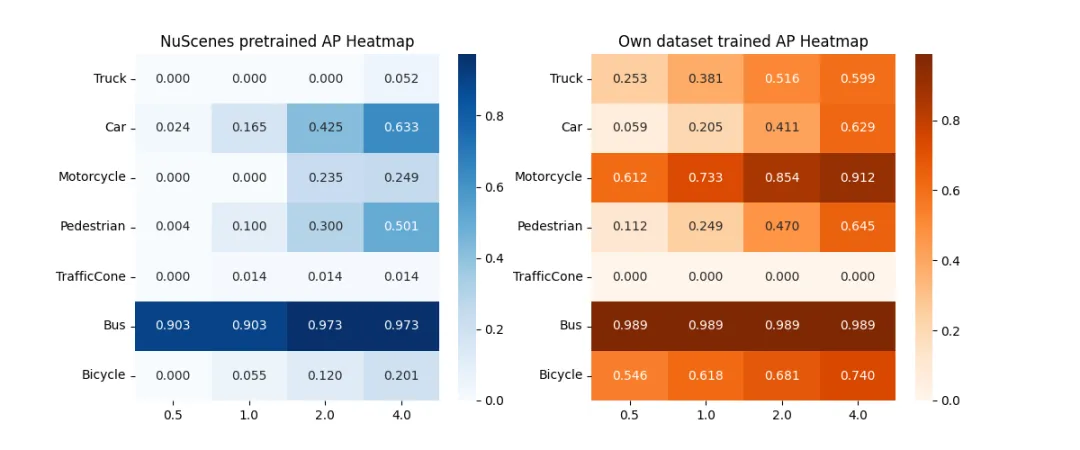
图6:热力图显示,SimData训练的模型(右)与真实数据模型(左)在空间关注模式上高度一致,证明了两者在特征提取层面的同源性。
迁移学习
最具工程价值的发现来自于域适应实验。本文实验对比了三种策略:(1) 仅SimData训练,(2) 仅nuScenes训练,(3) nuScenes预训练 + SimData微调(Pre-train + Fine-tune)。
结果显示,“Pre-train + Fine-tune”策略在绝大多数类别上实现了性能的全面超越;比如在Pedestrian(行人)、Trailer(拖车)、Barricade(路障)等长尾类别上,微调后的模型检测精度均有显著提升。
因此可证明虚拟数据并非真实数据的简单替代,而是其完美的互补。“真实先验 + 仿真多样性”的组合,能够有效抑制过拟合,帮助模型学习到更具泛化能力的特征表示,从而显著提升模型在面对真实世界未见场景时的鲁棒性。
图7:实验数据显示,“Pre-train + Fine-tune”方案在几乎所有类别上包围了对比方案,证明了高保真合成数据在提升模型泛化能力方面的巨大潜力
验证结论
总结来看,以上实验结果表明,aiSim生成的数据在统计分布与特征维度上具备高度的良构性,不仅支持深度神经网络在纯虚拟环境下的迅速收敛与高精度检测,更在注意力机制展现了与真实世界模型高度一致的特征同源性。这证明了高质量的仿真数据能够让算法“学会”与现实世界通用的感知逻辑。
在域适应实验中,“真实先验 + 仿真多样性”的混合训练策略展现了超越单一数据源的SOTA性能。虚拟数据并未止步于对真实数据的简单替代,而是凭借其对长尾场景(如路障、特殊车辆)的覆盖能力,成为了真实数据的完美互补。这种组合有效抑制了过拟合,显著增强了模型在面对未知场景时的泛化能力与鲁棒性。
高质量虚拟数据集的核心在于对真实物理世界的准确建模能力。只有当仿真数据在成像机理与信号生成层面具备确定性和一致性,才能真正服务于自动驾驶算法训练。
具体分析本文采用的aiSim仿真器,其基于自研渲染引擎,在底层架构上实现了对真实物理过程的系统化映射。此外采用融合式渲染架构,将光栅化的高效性、光线追踪的物理精度以及神经渲染在细节表达上的优势相结合,在复杂光照变化及雨、雾、雪等极端环境下,仍可保持像素级物理一致性,为感知模型提供高置信度输入。
在此基础上,aiSim又进一步实现了从像素级到信号级的确定性建模。无论是相机中的成像噪声、景深与运动模糊,还是激光雷达与毫米波雷达中的光束发散、多径效应与材质反射特性,均基于物理机理进行建模,使生成数据在统计特性与分布形态上高度接近真实传感器输出。
因此可以说,aiSim为大规模、高真实性虚拟数据集合成提供了可靠基础,有效支撑感知算法在复杂场景下的快速迭代与验证。
,时长00:30
aiSim渲染场景(左)与真实场景(右)的像素级对比视频:无论是大气散射效果,还是路面材质的微观纹理,aiSim都展现了极高的物理一致性
05 结语
总结来看,自动驾驶的下半场,本质上是数据规模与数据质量的角逐。在摩尔定律失效、Scaling Laws主导的今天,高保真仿真技术已成为打破数据瓶颈的最优解。
康谋通过aiSim仿真平台、aiSim2nuScenes自动化工具链以及SimData数据集的扎实落地,向行业展示了一条清晰的技术路径:通过引入物理级高保真的虚拟数据,不仅能够大幅降低数据采集与标注的边际成本,规避极端工况测试的道德与安全风险,更能通过“虚实结合”的训练策略,显著提升感知模型在复杂现实世界中的表现。
随着端到端大模型与世界模型的兴起,对高质量合成数据的需求将呈指数级增长。可以看到,aiSim提供的高保真虚拟世界,正在成为连接算法代码与物理现实的坚实桥梁,加速自动驾驶从“有限场景”迈向“全域通达”!
....
#年末L4的商业化落地被九识悄悄打响了......
柱哥上周末盘了部分L4公司的融资情况,有几家公司xxx近期也在展开深度调研。在低速物流赛道,像九识、新石器做的都还不错。
宏观层面上,L3牌照开始密集发放,L4市场端大量车型也相继推出,Robotaxi、无人配送、重卡、矿卡。很多L2的量产技术都在快速下沉到这些领域。像OCC、一段式/两段式端到端、无图感知、VLA等等。就像柱哥之前分享的观点:智驾技术走向成熟,才是真正大规模量产的起点。
本月15日,我们注意到九识智能与东风达成了新的战略合作,其实也是在顺应这个趋势。在智能汽车产业进入深水区后,从传感器配置到地图的“轻”与“重”之分,再到芯片的采用,主机厂的每一次合作选择,都呈现出对技术和成本的考量。
据悉,本次合作指向了载货车、环卫车、VAN车、客车等多个细分车型,显露出更强的商业化导向。
从技术和成本两个维度拆解,这一选择并非偶然。
“长期可用”——L4能力的工程化成熟度
对东风这样的央企而言,自动驾驶合作的首要门槛是工程化成熟度。
L4系统必须在复杂道路、极端环境下保持稳定,这对感知、决策、地图和系统架构提出了更高要求。
九识智能在技术路径上,明显选择了一条“为复杂城配场景而生”的路线。
在感知层,九识自研的 OCC 时序模型是关键能力之一。不同于传统单帧感知,OCC模型通过多帧时序数据构建三维空间占据信息,使车辆不仅“看到物体”,还能理解其运动趋势和潜在风险。在异形车辆、低矮障碍物、非标准路况等长尾场景中,这种能力直接决定了系统是否可靠。
更进一步,九识将目标检测与跟踪进行端到端一体化建模,直接输出轨迹级结果,减少模块间信息损耗。这种架构在多目标、高密度交通环境中优势明显,也更符合实际城市运行需求。
在规控层,九识已经完成 PnC端到端模型的落地,并在毫秒级完成多因素决策。这种能力并不追求“激进驾驶”,而是强调稳定性、可解释性和一致性,更贴合主机厂对安全冗余的要求。
此外,九识在地图路线上的选择也值得关注。其全面落地轻地图技术,降低对高精地图的依赖,同时在复杂城市路网中仍能实现厘米级定位。这一点,对需要跨区域、跨城市部署的车系尤为重要。
从系统架构来看,九识在长期运行、可用性上进行了系统性设计,这正是主机厂最看重的能力。
九识的成本模型为何成立
如果说技术决定“能不能合作”,那么成本结构决定“能不能走远”。
L4级自动驾驶技术的早期问题是:技术可行,但商业账不成立。而九识是少数从一开始就围绕“降本”做系统设计的企业。
首先是硬件层面。九识坚持整车、滑板底盘、传感器架构的高度自研,而非简单集成外部方案。这使其能够在传感器选型、算力配置、整车冗余上实现更优的性价比组合。
例如,九识无人车采用激光雷达、摄像头在内的多传感器融合方案,同时完成了全套车规级升级,在 -30℃ 到 +55℃ 的环境中稳定运行超过 5 年。这种“工程级可靠性”反而减少了长期维护成本。
另外,九识投入大量时间和资源所构建的仿真系统和大数据平台,结合每日积累的海量真实场景数据,以及AIGC数据,都令算法以相对较低的成本,高效、持续地进行迭代和进化。
更重要的是,九识在规模化生产与运营层面已经验证了成本模型。通过平台化车型设计,其 Z 系列、L 系列覆盖 2~10 立方、1~1.8 吨重载等多个区间,显著降低了单车型的研发和制造摊销成本。
靠体系化降本,九识实现了“把无人车价格打下来”。对于正面临新能源与智能化双重成本压力的东风而言,这样的合作对象显然更具现实价值。
用“生态智能”,描绘智能化版图
值得注意的是,九识并未将自身定位为“单一车型供应商”,而是围绕 L4 能力打造了可扩展的产品与生态体系。
九识已经形成了成熟的 RoboVan 产品体系,并在此基础上,联合北控北斗、极景智能、江铃改装等合作伙伴,拓展出燃气巡检车、饲料投喂车、安防巡检车等多种生态无人车形态。
这些产品建立在真实运营数据之上。截至目前,近1.6万台九识无人车已在全球 300 多座城市落地运营,累计安全运行里程超过 7000 万公里,覆盖物流配送、工业运输、市政巡检等多个高频场景。
对东风而言,这意味着合作对象不仅能提供 L4级的“技术引擎”,还能共同探索载货车、环卫车、VAN 车、客车等多车型智能化路径,并在未来形成可复制的商业模式。
从这个角度看,这次合作更像是一种 “能力级合作”:东风提供整车制造与产业体系优势,九识提供成熟的 L4 技术与商业化经验,双方共同扩展智能化版图。
随着政策层面对 L3 的逐步放行,以及 L4 级无人车的持续落地,自动驾驶行业正在进入一个比拼“谁更赚钱”新的阶段。在这个阶段,主机厂的选择自然会更理性。东风选择九识,既是对其技术路线的认可,也是对其成本控制与商业化能力的判断。
....
#UniLION
华科&港大提出UniLION:基于线性组 RNN 的统一自动驾驶模型
UniLION 震撼发布,由香港大学、华中科技大学和百度联合研发。这一创新的统一自动驾驶框架通过线性组 RNN 技术,成功解决了处理大规模点云数据和多视角图像时的计算效率问题,为自动驾驶领域带来了全新的技术范式。
摘要
尽管 Transformer 在各个领域展示了卓越的能力,但其二次方复杂度的注意力机制在处理长序列数据时引入了显著的计算开销。本文提出了一种统一的自动驾驶模型 UniLION,它基于线性组 RNN 运算符(即对分组特征执行线性 RNN)高效处理大规模 LiDAR 点云、高分辨率多视角图像,甚至时序。值得注意的是,UniLION作为单一多功能架构,且无需显式的时序或多模态融合模块,便可无缝支持多种不同设置(即LiDAR-only、Temporal LiDAR、LiDAR-Camera和Temporal LiDAR-Camera)。
此外,UniLION 在广泛的核心任务中持续提供具有竞争力甚至最先进的性能,包括 3D 感知(如 3D 物体检测、3D 物体跟踪、3D 占用预测、BEV 地图分割)、预测(如运动预测)和规划(如端到端规划)。这种统一的范式自然简化了多模态和多任务自动驾驶系统的设计,同时保持卓越的性能。最终,我们希望 UniLION 能为自动驾驶领域的 3D 基础模型开发提供全新视角。
项目链接:https://github.com/happinesslz/UniLION
📝 项目简介
UniLION 是一种基于线性组RNN(也可以看作为linear attention)的统一自动驾驶模型,它能够高效处理大规模 LiDAR 点云、高分辨率多视角图像和时间序列数据。UniLION作为单一多功能架构,且无需显式的时序或多模态融合模块,便可无缝支持多种不同设置(即LiDAR-only、Temporal LiDAR、LiDAR-Camera和Temporal LiDAR-Camera)。
🔍 研究背景与挑战
当前自动驾驶系统在处理多模态数据和时序信息时面临以下挑战:
- 计算效率问题:传统的 Transformer 模型在处理长序列数据时,其二次方复杂度的注意力机制引入了显著的计算开销。
- 多模态融合复杂性:现有方法通常需要专门设计的融合模块来整合来自不同传感器的信息,增加了系统的复杂性。
- 时序信息处理:有效地处理和整合时序信息对于准确的环境感知和预测至关重要,但这通常需要额外的专用模块。
- 多任务学习难度:在单一框架中同时处理感知、预测和规划等多种任务具有挑战性,往往需要复杂的架构设计。
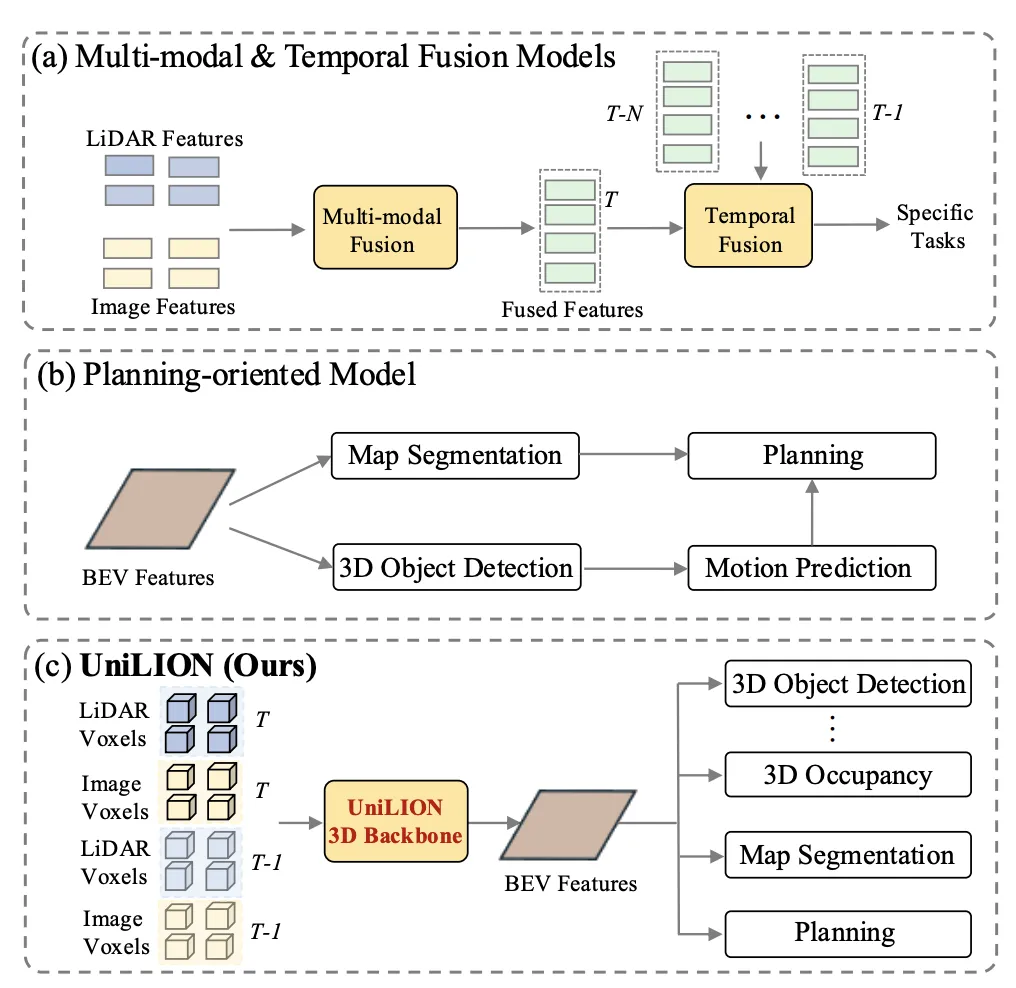
💡 UniLION 的创新点
UniLION 展现出四个显著特点:
- 统一的 3D 骨干网络:基于线性组 RNN,UniLION 提供了一个统一的 3D 骨干网络,能够无缝处理不同模态和时序信息,无需任何显式融合模块。
- 线性计算复杂度:利用线性组 RNN 的线性计算复杂度,直接将多视图像、LiDAR 点云和时序信息,直接转成token进行拼接(类似VIT形式),在3D空间中进行统一的融合,消除了对显式融合模块的需求。
- 紧凑统一的 BEV 表示:UniLION 能够将异构多模态信息和时间序列压缩成紧凑、统一的鸟瞰图 (BEV) 特征表示,作为多种下游任务的共享特征。
- 多任务并行学习:UniLION采用多任务共享的 BEV,能够通过并行多任务学习,无缝处理感知、预测和规划等多种自动驾驶任务。
🛠️ 技术架构
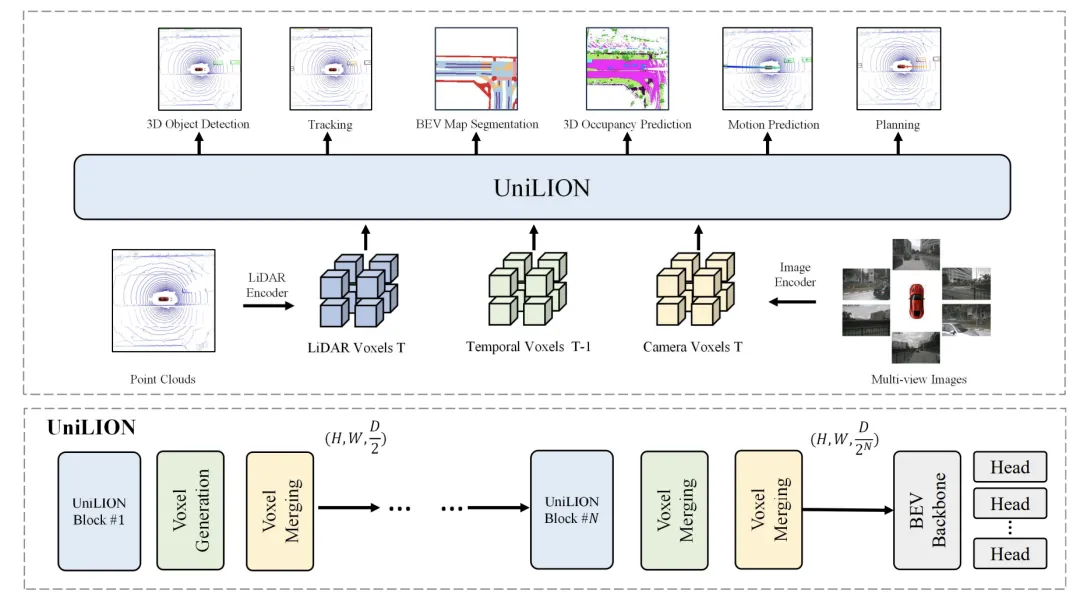
UniLION Block
UniLION Block 是 UniLION 架构的核心组件,它由以下部分组成:
- UniLION Layer:利用线性组 RNN 操作符实现长距离特征交互。每个 UniLION Layer 包含两个线性组 RNN 操作符,分别基于 X 轴和 Y 轴窗口划分执行特征交互,从而获得更充分的特征表示。
- 3D 空间特征描述器:解决将 3D 体素特征展平为 1D 序列时可能丢失的空间信息问题。该描述器由 3D 子流形卷积、LayerNorm 层和 GELU 激活函数组成,为 UniLION Layer 提供丰富的 3D 局部位置感知信息。
- 体素合并与体素扩展:体素合并用于特征下采样,体素扩展用于特征上采样,使网络能够获取多尺度特征。这些操作专为高度稀疏的点云数据设计,解决了不规则数据格式的处理问题。
- 自回归体素生成:通过利用线性组 RNN 的自回归能力,在前景体素周围生成扩散体素,解决体素合并可能导致的信息丢失问题。该策略通过沿不同方向扩散选定的前景体素,并利用 UniLION Block 的自回归能力有效生成扩散特征。
UniLION Block 采用层次化结构,能够更好地提取多尺度特征,为下游任务提供丰富的特征表示。
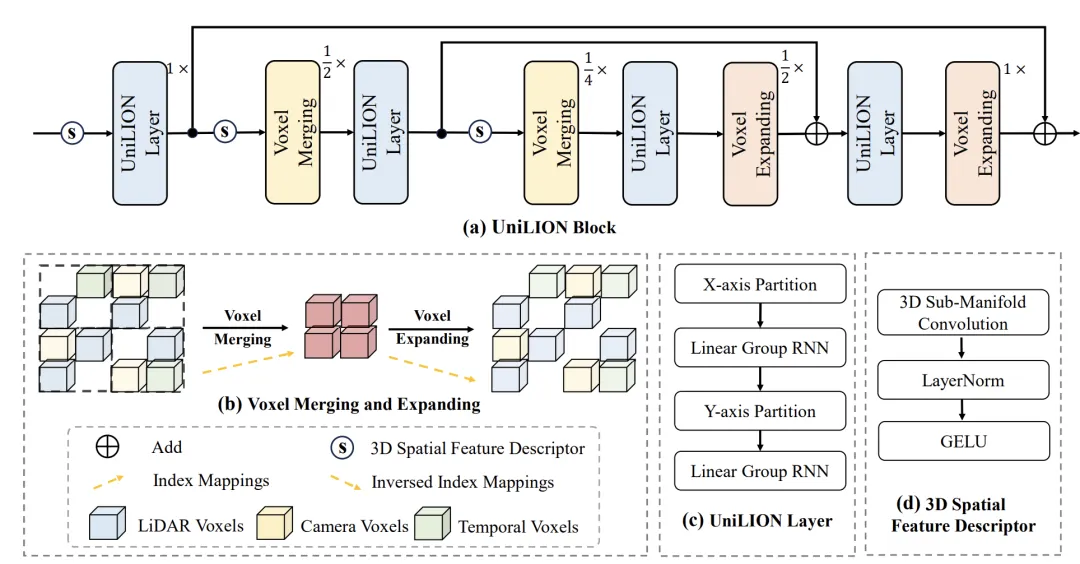
统一特征表示 (Unified Feature Representation)
与传统方法不同,UniLION 不需要额外设计的融合模块来实现多模态或时序融合。其统一特征表示能力主要体现在以下两个方面:
- 多模态特征学习:
- LiDAR 点云提供精确的几何结构,而相机图像贡献丰富的语义外观信息,两者在自动驾驶场景中展现出强互补性。
- UniLION 首先将点云量化为体素,并使用体素特征编码器(VFE)提取 LiDAR 体素特征。
- 对于多视角图像,采用图像骨干网络提取特征,并通过深度预测网络将图像特征转换为相机体素特征。
- 将 LiDAR 体素特征和相机体素特征连接,生成多模态体素特征,并通过体素合并策略处理重叠的多模态体素。
- 最终将合并后的多模态体素直接输入 UniLION 3D 骨干网络,在 3D 空间中进一步提取多模态特征。
- 时序特征学习:
- 时序信息对自动驾驶系统的准确运动预测和轨迹规划至关重要。
- 对于当前帧的多模态体素,UniLION 从时序记忆库中获取历史多模态体素(如果可用)。
- 使用数据集提供的变换矩阵进行空间对齐,确保跨时间帧的空间一致性。
- 将历史体素和当前体素连接构建时序体素,并采用体素合并策略处理跨时间帧可能占据相同 3D 位置的多个体素。
- 直接将合并后的体素输入 UniLION 3D 骨干网络,自适应学习时序信息。
通过线性组 RNN 强大的长距离建模能力,UniLION 能够将多视角图像、LiDAR 点云和时间信息整合到统一的 3D 骨干网络中,无需额外的融合模块,为下游任务提供紧凑统一的特征表示。
动态多任务损失 (Dynamic Multi-task Loss)
作为一个统一模型,UniLION 消耗点云、多视角图像和历史信息,生成用于自动驾驶感知、预测和规划的统一 BEV 表示。基于这种紧凑的 BEV 特征,UniLION 部署任务特定的头部网络,同时输出各个任务的结果。
得益于模块化并行架构,UniLION 可以在推理阶段选择性地执行不同任务,降低计算开销。然而,多任务训练需要解决多任务平衡问题。为了尽可能保持每个任务的性能,UniLION 采用动态损失平衡策略:
给定检测损失 、占用损失 、BEV 地图分割损失 、运动预测损失 和规划损失 ,计算动态损失权重以将每个任务的损失 与 对齐:
最终损失可以表示为:
其中 、、、 和 是损失权重。
🔬 实验结果与分析
UniLION在多种自动驾驶任务上展现出卓越的性能,通过一系列实验验证了其有效性、鲁棒性和灵活性。
整体性能表现
UniLION在nuScenes数据集上的实验结果表明,它在3D物体检测、多目标跟踪、BEV地图分割和3D占用预测等任务上均达到了具有竞争力甚至最先进的性能。基于Swin-Tiny图像骨干网络的UniLION的多模态版本模型,在3D物体检测上达到了74.9% NDS和72.2% mAP,在多目标跟踪上达到了76.2% AMOTA,在BEV地图分割上达到了72.3% mIoU,在3D占用预测上达到了50.8% RayIoU。对于最强的时序多模态UniLION,在所有评估任务中均达到了最先进或极具竞争力的性能表现:检测任务达到75.4% NDS和73.2% mAP,跟踪任务达到76.5% AMOTA,地图分割达到73.3% mIoU,占用预测达到51.3% RayIoU,车辆运动预测达到0.57 minADE,行人运动预测达到0.37 minADE,以及规划任务中极低的0.18%碰撞率,值得注意的是,我们在规划任务中没有使用自车状态信息。
不同图像骨干网络的影响
我们提供了一个轻量级版本的UniLION,采用ResNet-50作为图像骨干网络,图像分辨率为256×704。与基础模型(使用Swin-tiny作为图像骨干网络,分辨率为384×1056)相比,轻量级版本仍然获得了令人满意的性能:73.6% NDS、70.8% mAP(3D检测)、75.0% AMOTA(多目标跟踪)、71.8% mIoU(地图分割)和50.2% RayIoU(3D占用)。这表明即使在计算资源受限的情况下,UniLION也能保持良好的性能。
不同线性RNN操作符的灵活性
为了验证框架的灵活性,我们评估了另一种代表性的线性RNN操作符RWKV。虽然UniLION-RWKV的性能略低于UniLION-Mamba,但它仍然在多个自动驾驶任务上取得了优异的结果,有效地证明了我们框架的灵活性。在使用Swin-Tiny时,与RWKV相比,UniLION使用Mamba产生了一致的性能提升(0.6% NDS、0.8% mAP、1.1% AMOTA、0.3% mIoU和0.9% RayIoU)。
组件消融研究
我们对UniLION的各个组件进行了消融研究,包括3D空间特征描述器和体素生成模块:
- 3D空间特征描述器:将3D空间特征描述器集成到基线模型中,带来了显著的性能提升(0.7% NDS、0.8% mAP、1.9% AMOTA、0.5% mIoU和1.1% RayIoU)。这证明了所提出的3D空间特征描述器在补偿线性RNN有限的空间建模能力方面的有效性。
- 体素生成模块:体素生成模块通过增强前景体素特征表示,相比基线模型提升了0.6% NDS、1.1% mAP、2.7% AMOTA、0.1% mIoU和0.3% RayIoU的性能。
- 组件组合:当所有组件结合使用时,UniLION达到了73.6% NDS、70.8% mAP、75.0% AMOTA、71.8% mIoU和50.2% RayIoU,相比基线模型分别提升了0.7% NDS、1.8% mAP、3.1% AMOTA、1.6% mIoU和1.8% RayIoU。
动态损失机制的有效性
动态损失机制在大多数任务上带来了一致的性能提升:检测任务提升了0.3% NDS,跟踪任务提升了0.9% AMOTA,地图分割任务提升了0.6% mIoU。然而,我们观察到3D占用预测任务性能略有下降。这可能是因为动态损失机制鼓励UniLION优先考虑整体任务平衡,这可能会以牺牲个别任务优化为代价,特别是对于占用预测任务。
多任务学习的影响
我们研究了联合训练对不同任务性能的影响。当联合训练3D检测和地图分割任务时,地图分割任务的性能显著提升(71.7% mIoU vs. 68.3% mIoU)。当进一步加入占用预测任务时,模型在检测任务上性能略有下降,但在占用预测任务上获得了2.7% RayIoU的显著提升,这表明检测任务通常可以增强3D占用估计能力。总体而言,我们的联合训练方法相比单任务模型达到了可比甚至更优的性能,证明了UniLION 3D骨干网络提取的紧凑BEV特征表示的有效性。
窗口大小和组大小的鲁棒性
UniLION的一个基本优势在于通过线性RNN实现长距离依赖建模的能力。为了评估我们方法的泛化能力和参数敏感性,我们对不同窗口大小和组大小进行了全面的鲁棒性分析。实验表明,UniLION在不同窗口和组大小配置下表现出显著的稳定性和一致性能。这表明UniLION具有良好的外推能力,不过度依赖手工设计的先验知识。
传感器错位的鲁棒性
传感器错位问题可能出现在大多数自动驾驶系统中。因此,探索对传感器错位的鲁棒性对于确保自动驾驶系统的安全至关重要。我们模拟了LiDAR和相机模态之间的传感器错位,具体而言,"低"、"中"和"高"错位级别分别表示相机外参矩阵沿垂直方向旋转1.5°、3.0°和5.0°,并平移0.15m、0.30m和0.50m。
在低错位级别下,UniLION在不同任务上保持了与对齐模型相当的性能。此外,即使在高错位级别下,我们的UniLION也仅出现了适度的性能下降(0.8% NDS、1.3% mAP、1.0% AMOTA、0.3% mIoU和1.4% RayIoU),展示了强大的鲁棒性。值得注意的是,尽管存在相机-LiDAR错位,多模态UniLION仍然始终优于仅使用LiDAR的UniLION。这些实验有力地证明了UniLION对传感器错位挑战的鲁棒性。
计算效率分析
UniLION通过线性组RNN的线性计算复杂度,显著降低了计算资源需求和推理时间。与基于Transformer的方法相比,UniLION在处理大规模点云数据和高分辨率多视角图像时展现出更高的计算效率,同时保持了卓越的性能。这使得UniLION更适合实际自动驾驶系统的部署,特别是在计算资源受限的环境中。
结论
通过上述实验结果和分析,我们证明了UniLION作为一种统一的自动驾驶框架的有效性、鲁棒性和灵活性。它不仅能够在多种自动驾驶任务上达到具有竞争力甚至最先进的性能,而且具有良好的计算效率和对传感器错位的鲁棒性。这些特性使UniLION成为一个有前途的自动驾驶基础模型,为未来的研究和应用提供了新的可能性。
📈 主要贡献
- 统一的多模态处理:基于线性组 RNN 的卓越长程建模能力和线性计算复杂度,UniLION 能够将多视角图像、LiDAR 点云和时间信息整合到统一的 3D 骨干网络中,消除了通常需要的手工设计融合模块。
- 紧凑统一的特征表示:UniLION 有效地将异构多模态信息和时间序列压缩成紧凑、统一的鸟瞰图特征表示,作为无缝处理多种感知、预测和规划任务的通用基础。
- 卓越的多任务性能:UniLION 在 3D 感知(3D 物体检测、3D 物体跟踪、占用预测、地图分割)、预测(运动预测)和规划(端到端规划)任务上达到了具有竞争力甚至最先进的性能,突显了我们方法在应对自动驾驶挑战方面的通用性和有效性。
- 计算效率优势:UniLION 通过线性组 RNN 的线性计算复杂度,显著降低了计算资源需求和推理时间,使其更适合实际自动驾驶系统的部署。
🔮 未来展望
作为一种统一的自动驾驶框架,UniLION 为自动驾驶领域的 3D 基础模型开发提供了全新视角。我们期待这种统一框架能够简化多模态和多任务自动驾驶系统的设计,同时保持卓越的性能,为未来的研究和应用带来新的可能性。
在未来的工作中,我们计划进一步探索:
- 扩展支持更多传感器模态:将 UniLION 扩展到支持更多传感器类型,如毫米波雷达、超声波等,进一步增强其感知能力。
- 实际系统应用验证:将 UniLION 应用于实际自动驾驶系统,验证其在真实世界中的有效性和鲁棒性。
- 大规模预训练:探索在更大规模数据上进行预训练,进一步提升 UniLION 的泛化能力和表现。
....
#MindGPT-4ov
理想MindGPT-4o-Vision技术报告压缩版
2025年12月2日理想发布MindGPT-4ov技术报告
链接:https://arxiv.org/abs/2512.02895
通用能力与垂直领域适配的权衡冲突。
将通用多模态大模型(MLLM)迁移至垂直应用面临两个主要矛盾:
灾难性遗忘 (Catastrophic Forgetting):注入领域特定知识往往导致模型原有的通用理解能力(General Capabilities)退化。
缺乏系统的后训练方法论:现有方法要么忽视数据质量与成本控制,要么在优化领域能力时牺牲了基础能力和用户体验,缺乏涵盖数据生产、训练到部署的全链路工程方案。
当前多模态模型训练中存在的三个关键低效与偏差现象:
资源分配粗放:传统数据合成方法通常对所有数据进行均等处理,忽视了数据本身信息密度的差异,导致高价值数据挖掘不足,低价值数据浪费算力 。
奖励机制导致的单一化(Diversity Collapse):在强化学习阶段,传统的 Pass@1(单次通过即奖励)机制会导致模型为了最大化奖励而收敛到少数安全回复模式,牺牲了输出的多样性和探索性,进而削弱泛化能力。
单模态虚假相关(Unimodal Spurious Correlations):幻觉往往源于模型过度依赖语言模型的先验知识,而非视觉证据。例如,在移除图片输入后,模型仍能根据文本问题编造出视觉细节,这在工业应用中构成了事实性错误风险。
MindGPT-4ov通用后训练范式包含四个核心模块:
数据构建:基于信息密度(IDS)的数据合成与双维标签系统。
监督微调(SFT):协同课程监督微调(Collaborative Curriculum SFT)。
强化学习(RL):混合奖励的多阶段强化学习(Hybrid-Reward RL) 。
基础设施:5D 并行训练与推理过程中在模型适配、流式推理和高并发场景优化。(在3D并行框架上引入序列并行和专家并行)
基于信息密度评分(Information Density Score, IDS)
IDS评估维度:利用 MLLM 对图像数据进行四维量化评分:(1) 主体多样性、(2) 场景空间关系、(3) OCR 文本丰富度、(4) 世界知识相关性。
动态合成策略:依据 IDS 分数动态调整生成问答对(QA Pairs)的数量。高密度图像生成更多QA,低密度图像生成较少QA,以实现资源的高效配置。
双维标签系统: 构建领域+能力的树状标签体系,确保合成数据既覆盖垂直领域知识,又兼顾通用视觉能力(如计数、推理)。
SFT 机制:三阶段协同课程学习 (Collaborative Curriculum SFT)
采用分阶段训练策略,解决知识注入与能力保持的冲突:
阶段一:跨域知识学习:重点注入垂直领域知识,建立解决特定领域问题的基础。
阶段二:能力修复:针对第一阶段可能导致的通用能力下降,使用通用数据集(SFT-Ability)进行针对性恢复训练 16161616。
阶段三:偏好对齐:使用高质量偏好数据(SFT-Preference),优化响应格式、减少幻觉,并处理长上下文逻辑。
强化学习:混合奖励机制
在 RL 阶段引入多种奖励信号,平衡准确性、多样性与简洁性:
Pass@k 奖励:不同于仅奖励完全匹配的Pass@1,该机制在模型生成的k个回答中,只要有正确答案即计算期望奖励。这鼓励模型探索不同的推理路径,而非陷入单一模式。
多样性奖励:计算候选回答之间的语义距离。如果回答在语义上过于相似,即便是正确的也会受到惩罚;反之,语义差异大且正确的回答会获得更高奖励。
长度奖励:引入软性冗余约束。如果回答长度超过设定的阈值(即使内容正确),也会给予负向惩罚,强制模型输出简洁的响应。
对抗性幻觉数据:构造移除图像的文本样本。如果模型在无图情况下仍生成描述性细节,则视为知识泄漏并予以惩罚,强制模型基于视觉证据推理。
标签构建:专家定义一级标签,利用 MLLM 扩展生成二级标签及三级细粒度 Topic,形成覆盖广泛的知识树。
数据合成:对图像进行粗粒度(Top-3)和细粒度(Top-5)Topic 匹配,结合 IDS 分数生成 QA 对,并通过多模型投票机制过滤低质数据。
SFT 训练:执行上述三阶段课程学习,期间穿插数据准入(Data Admission)与拒绝采样机制,动态调整数据配比。
阶段一在线RL:使用 GSPO 算法,结合 Pass@k 和多样性奖励,重点提升多模态逻辑推理和 STEM 能力。
阶段二离线RL:使用 DPO 算法,利用人类偏好数据和对抗性幻觉数据,进行领域能力对齐和幻觉抑制。
推理部署:采用分块预填充 (Chunked Prefill) 和视觉编码缓存策略,在用户输入阶段并行处理图像,降低首字延迟。
垂直领域知识掌握: 在涉及理想汽车特定车型的问答中,MindGPT-4ov 能准确识别车型设计特征及定位,而基座模型(Qwen3-VL)出现知识缺失或幻觉。
响应简洁性 (Conciseness):在 MathVista 等基准测试中,MindGPT-4ov 的平均响应长度显著短于对比模型,同时保持了更高的准确率(83.3% vs 80.1%),验证了长度奖励机制的有效性。
....
#广义端到端的统一视角
上交AutoLab发布最新自动驾驶端到端/VLA综述
上海交通大学 AutoLab 团队联合滴滴提出 广义端到端(GE2E)自动驾驶统一框架:从端到端、VLA 到世界模型,用同一视角重新梳理自动驾驶的核心技术路线。该综述系统对比了传统 E2E、VLM-centric 与混合范式的能力边界与工程权衡,揭示了当前自动驾驶在长尾场景、实时性与可解释性上的关键挑战与未来方向。
论文标题:Survey of General End-to-End Autonomous Driving: A Unified Perspective
论文链接:https://doi.org/10.36227/techrxiv.176523315.56439138/v1
项目主页:https://github.com/AutoLab-SAI-SJTU/GE2EAD
前言
从端到端到VLA,再到世界模型,近几年自动驾驶领域的技术路线可谓百家争鸣,各大厂商都在大力宣传自己独特的技术路线。
事实上,无论是所谓的“一段式端到端”,“VLA”还是“WA(World Model - Action)”,他们都有一个共同的核心:实现“传感器信息输入,动作输出”的数据驱动范式。
然而,目前主流关于自动驾驶的综述中,大部分将端到端和VLA看成两种割裂的范式,缺乏统一的对比视角,导致研究者难以系统地了解端到端范式和VLA范式的区别和联系。
为了弥补这一空白,上海交通大学 AutoLab 团队联合滴滴,参考200多篇文献后发布的最新综述 《广义端到端自动驾驶的综述:统一视角》。
作者将通用端到端(GE2E)定义为任何一种通过整体模型将原始传感器输入处理为规划轨迹或控制动作的模式(无论架构中是否包含视觉语言基础大模型)。并基于此将传统端到端(Conventional E2E)、VLM为中心的端到端(VLM-centric E2E)和混合端到端(Hybrid E2E)三大范式统一起来,构建了完整的技术图谱。
01 引言:从分裂到统一
传统模块化智驾将任务拆解为感知、预测、规划,每个任务对应一个子模块并单独训练,这种割裂的训练导致了严重的信息丢失和误差累积,难以应对复杂场景。学术界逐步转向数据驱动的端到端(E2E)架构,并演化出三大流派:传统端到端、以大模型为中心的端到端、以及混合端到端。
图 1 端到端自动驾驶范式对比。(a)(b)传统端到端、(c)以大模型为中心的端到端、(d)(e)混合端到端。
1.传统端到端
传统端到端范式基于3D场景表征(BEV或者Occupancy),利用对场景的结构化理解来进行精确的轨迹规划。如图1(a)(b)所示,该范式主要分为纯规划端到端和多任务端到端。纯规划端到端直接输出规划或控制结果,不做感知预测等传统任务,而多任务端到端采用经典的分解方法,并为感知、预测、规划等任务分别构建了专用的模块。
不同于传统的模块化设计,多任务端到端将三个任务子模块统一训练,均面向最终的规划目标。其优势在于,统一的训练目标能够有效减少模块间的信息丢失和误差累积;较高的系统集成度高提高了执行效率。
然而,由于依赖预定义的几何先验并且缺乏通用世界知识,传统端到端模型在面对未见过的长尾场景(Corner Case)时泛化能力相对受限。
2. 以 VLM 为中心的端到端
为了解决上述问题,VLM-centric端到端范式利用在大规模互联网数据上预训练的视觉-语言模型(VLM)作为核心,将驾驶任务转化为多模态理解与推理问题。如图1(c)所示,VLM通过语言直接输出,或者利用动作解码器,将模型内部的抽象推理转化为可执行的物理轨迹。
得益于模型内部丰富的世界知识和强大的推理能力,它在开放世界场景中展现出卓越的泛化性与逻辑可解释性,成为解决自动驾驶长尾场景的一条可能的技术路径。
尽管如此,相比于基于纯视觉的传统端到端模型,擅长语言空间推理的VLM往往在生成轨迹的物理精度上存在局限。且VLM的巨量参数导致了高额推理延迟,这使得模型无法部署到高实时要求的真实驾驶场景。
3. 混合端到端范式
基于上述分析,传统端到端和VLM-centric端到端事实上是优势互补的:前者是快速且精确的智能体,但缺乏通用认知和推理能力;后者作为深思熟虑的认知大脑,但存在推理延迟,轨迹规划精度的短板。
如图1(d)(e)所示,混合范式旨在结合前两者的优势,通过“在线协同”(VLM 作为高层推理引擎指导 E2E 模型)或“离线蒸馏”(VLM 作为教师模型在训练阶段注入知识)的方式运作。
这种策略有效平衡了对复杂场景的高层语义理解能力与底层车辆控制的物理执行精度,是当前平衡性能与效率的有效路径。
4. GE2E
为了更好地统一三种范式,作者定义了广义端到端(GE2E),即任何一种通过整体模型将原始传感器输入处理为规划轨迹或控制动作的模式(无论架构中是否包含VLM)。
作者认为,以上三种范式并非割裂的技术路线,而是解决“从原始传感器输入到最终驾驶决策”这一共同问题的不同表现形式,其核心差异仅在于对场景表征方式、推理深度以及计算效率权衡的侧重不同。
全文脉络 为了方便读者阅读,作者绘制了以下思维导图,展示了全文的脉络。
图 2 GE2E全文脉络
02 传统端到端:基石与进化
传统E2E方法侧重于通过显式或隐式的场景表征,直接输出轨迹,其优势在于系统集成度高、执行效率快且在结构化场景下稳定性强,能够有效减少模块间的信息丢失和错误累积,是目前车企落地最广泛的实战派。
1. 纯规划端到端 (Planning-Only)
最简化的架构,直接从图像/LiDAR映射到规划控制信号(图1a)。近期主要研究点可以分为以下三个:
- 多模态融合:通过 Transformer 等机制融合图像与 LiDAR 数据,解决单一传感器无法获取足够 3D 场景信息的问题。
- 生成式建模:利用扩散模型等生成式方法来模拟轨迹分布,解决驾驶行为本身具有多模态(即同一场景有多种合理开法)的不确定性问题。
- 高效性优化:针对车载芯片资源受限的痛点,通过轻量化网络设计(如 EfficientViT)或 Mamba 架构来降低计算量。
代表作:ALVINN, TransFuser, DiffusionDrive
2. 多任务端到端(Multi-task)
纯规划端到端往往只有轨迹监督,这使得模型难以理解复杂的驾驶逻辑,泛化性能较差。因此,多任务端到端引入感知和预测的中间任务,为模型提供更加丰富的监督信号,强化模型对场景动态的理解,促使更加安全和鲁棒的规划性能。该范式的主要研究点有以下三个:
2.1 场景建模与理解 (Scene Modeling)
在多任务框架中,高效地表征和建模3D动态环境是核心。
- 高效场景表征:从早期的稠密 BEV 网格逐渐转向稀疏的实例级(Object-centric instance query)表征,旨在减少计算冗余并聚焦关键交通要素。
- 空间理解与推理:引入图模型或不确定性建模,显式地描述交通参与者与地图之间的交互关系,增强模型对复杂路况的理解。
- 时序融合与推理:通过记忆模块或时序对齐机制,捕捉场景的动态演变过程,解决单帧感知无法判断速度和意图的问题。
代表作:UniAD, SparseDrive, VAD
2.2 多任务协同 (Multi-task Coordination)
感知、预测、规划如何“打配合”,避免负迁移。
- 人工设计协同:根据任务特性手动设计依赖关系(如先预测后规划),或解耦特征学习,防止不同任务的梯度冲突导致性能下降。
- 统一多任务架构:将所有子任务的 Query 放入同一个 Decoder 中进行深度交互,让模型自动学习任务间的协作,而非依赖人工规则。
代表作:DriveTransformer, ST-P3, DriveAdapter
2.3 轨迹规划策略 (Trajectory Policy)
如何生成安全、合规且拟人的轨迹。
- 可训练轨迹评估器:不直接回归轨迹,而是从预定义的候选库中选择最优解,并通过可学习的评分模块来不断优化选择策略。
- 概率轨迹规划:针对直接回归方法的局限性,预测轨迹的概率分布并进行采样,从而覆盖更多样化的驾驶可能性。
- 分层规划:模仿人类认知,先生成粗粒度的驾驶意图(如换道),再生成细粒度的具体轨迹点,提高长时规划的稳定性。
代表作:Hydra-MDP, VADv2, ARTEMIS
03 VLM-Centric:驾驶认知大脑
尽管传统端到端范式展现出了显著的性能优势,但由于依赖预定义的几何先验和缺乏通用的世界知识,导致模型在面对未见过的长尾场景(Corner Case)时泛化能力相对受限。
因此,VLM-centric端到端范式通过构建认知驱动的代理,充分利用预训练VLM/LLM的强泛化能力和逻辑推理能力,在理解复杂的开放世界情况以及关键地在阐述其决策背后的理由方面表现出更出色的能力,成为解决长尾问题(Corner Cases)的一大可能的技术路径。VLM-centric范式主要有以下研究点:
1. VL对齐与时空理解 (VL Alignment & Spatial and Temporal Understanding)
LLM 天生只能理解文本,而自动驾驶面对的是复杂的视觉流。如何打破模态壁垒,让模型既能“看懂”像素,又能理解时空演变?
- VL对齐:利用 Q-Former 或 MLP 投影层,将高维的视觉特征压缩并映射为 LLM 可理解的 Token,打通视觉与语言的模态壁垒。
- 3D 空间增强:针对 VLM 空间感知弱的问题,引入点云输入或显式的 3D 位置编码,帮助模型理解3D空间关系。
- 时序信息增强:通过处理长视频流或引入追踪模块,使 VLM 能够理解交通流的动态变化,而非仅仅看图说话。
代表作:LMDrive, DriveMLM, S4-Driver
2. 推理能力 (Reasoning)
这是 VLM-Centric 范式最核心的优势。它要求模型不仅像老司机一样知道“怎么开”,更要能思考和解释“为什么这么开”。
- 记忆机制:构建长期或短期记忆库,存储历史驾驶经验或用户指令,使模型具备持续学习和长程任务处理能力。
- 思维链 (CoT) 推理:通过分步骤的逻辑推导(如先观察、再分析、后决策),将复杂的驾驶任务拆解,提高决策的可解释性。
- RAG 与知识集成:通过检索增强生成技术,实时调用外部的交通规则库或类似案例库,弥补模型参数知识的不足。
代表作:DriveLM, Agent-Driver, Drive Like a Human
3. 规划与动作策略 (Planning & Action)
有了高层的语义理解只是第一步,如何将这些“纸面上的策略”转化为底层车辆实实在在的规划控制信号?
- 动作头设计:设计专门的接口,将 VLM 的输出连接到 PID/MPC 控制器或轨迹规划器,实现从语义决策到物理执行的落地。
- 安全检查机制:针对大模型可能产生的“幻觉”,引入后处理验证或训练时的反馈机制,确保输出的指令符合物理安全约束。
- 推理与规划对齐:通过约束损失函数,强制模型的语言解释(Why)与实际动作(How)保持一致,避免“言行不一”。
代表作:DriveVLM, LanguageMPC, DriveMoE
4. 学习策略与效率 (Learning & Efficiency)
VLM 虽然强大,但参数量巨大且训练昂贵。如何在有限的资源下,让模型训练得更好、推理得更快?
- 知识蒸馏:利用拥有特权的教师模型(如掌握全局信息的 Agent)来指导学生模型,解决模仿学习中监督信号稀疏的问题。
- **强化学习 (RL)**:在仿真环境中通过试错学习,利用奖励函数优化策略,使模型能够探索出超越训练数据的驾驶技巧。
- 数据高效学习:利用自监督预训练或主动学习策略,从海量未标注数据中提取有用信息,降低对昂贵标注数据的依赖。
代表作:FastDrive, CoT-Drive, AutoPrune
04 混合范式:快思考与慢思考
事实上,以上所述的传统端到端模型和VLM-centric端到端具有显著的互补性:前者作为快速且精确的智能体,却缺乏通用认知和推理能力;后者作为深思熟虑的认知大脑,却受到存在轨迹规划精度的短板。
因此,混合端到端范式结合传统 E2E 的“快直觉”与 VLM 的“慢推理”,构建双系统智驾框架,有效平衡了对复杂场景的高层语义理解能力与底层车辆控制的物理执行精度,是实现驾驶性能进一步提升的有效路径。混合范式主要有以下两种主流框架:
1. 在线分层协同 (Online Coordination)
在推理阶段,VLM 与传统 E2E 模型同时运行。VLM 扮演“大脑”角色负责高层决策与长尾理解,E2E 扮演“小脑”角色负责实时控制与轨迹生成,两者优势互补。
- 感知级融合:VLM 利用语义理解能力生成提示词或特征,增强传统 E2E 模型对场景中长尾物体的识别能力。
- 规划级融合:VLM 输出高层的驾驶建议、路点或元动作,作为约束条件指导 E2E 模型生成具体的平滑轨迹。
- 全栈协同:在感知和规划多个层级进行双向信息交互,实现 VLM 的认知能力与 E2E 的执行能力的深度绑定。
代表作:DriveVLM, Senna, SOLVE
2. 离线知识迁移 (VLM-aided Training)
考虑到车端算力的限制,将庞大的 VLM 直接部署上车往往面临巨大的工程挑战。这一路线另辟蹊径:在训练阶段请 VLM 当“老师”,部署阶段只用轻量级的 E2E “学生”模型,从而实现零推理成本增量。
- 规划与动作对齐:通过蒸馏技术,将 VLM 对复杂场景的决策逻辑转移给轻量级 E2E 模型,使其具备类似的高层规划能力。
- 感知、规划与推理全对齐:不仅蒸馏最终动作,还强制 E2E 模型的中间特征与 VLM 的认知过程对齐,实现全链路的知识注入。
代表作:VLM-AD, ALN-P3, DistillDrive
05 数据集:从感知到认知
数据是驱动端到端自动驾驶进化的核心燃料。随着技术范式从“感知驱动”向“认知驱动”跃迁,传统仅包含几何标注(如 3D 框、车道线)的数据集,已难以满足 VLM 对逻辑推理能力的训练需求。
1. 语义化革命
新一代自动驾驶数据集不再局限于回答“这是什么”,而是开始包含大量的自然语言描述(Language Annotation)和问答对(QA Pairs)。这些数据旨在教会模型理解复杂的交通语境、因果逻辑以及人类的驾驶意图。
2. 思维链 (CoT) 的引入
为了支持更高级的推理任务,数据集开始从简单的“输入-输出”映射,转向包含思维链(Chain of Thought)的详细标注。这要求数据不仅给出驾驶动作,还要给出做出该动作的完整逻辑推导过程。
3. 基于 nuScenes 的生态爆发
目前,基于经典的 nuScenes 数据集进行二次开发的图文对数据占据了主流地位。研究社区正在爆发式地构建各类带有推理标注的 Benchmark,以支持多模态大模型的训练与评估。
为了帮助研究者快速上手,我们在综述原文(Table 2)中系统梳理了现有 VL 数据集的规模、任务类型、数据来源及标注方式,如图3所示。
图 3 VL数据集总结
规划性能对比: 为了帮助读者更好地了解当前不同范式的规划性能,作者基于 nuScenes(开环)、CARLA/B2D(闭环)及 NAVSIM 等主流基准测试,对不同范式的性能进行了横向对比分析,如下图所示:
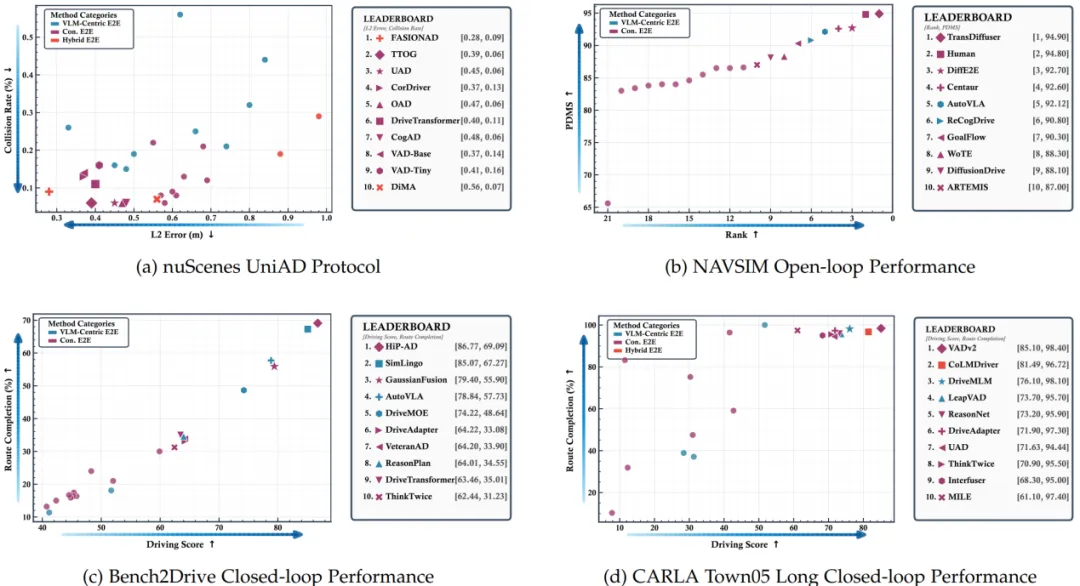
3.1 开环性能 (Open-loop):混合范式的胜利
开环测试主要评估模型在给定时刻的预测准确度(如 nuScenes的L2 误差、碰撞率,以及 NAVSIM的PDMS 综合评分)。
- 混合范式登顶: 榜单数据显示,表现最好的方法属于混合端到端范式。这证明了 VLM 带来的世界知识不仅是锦上添花,更是处理长尾的关键,能显著提升模型的规划上限。
- 传统端到端的数值优势: 尽管混合范式夺魁,但在 nuScenes 前十名中,传统端到端算法依然占据了绝大多数席位。这说明在数值轨迹预测的精确度上,传统方法依然具有统治力。
- VLA 的潜力与超越人类: 在 NAVSIM 榜单上,顶尖算法的评分甚至超过了人类驾驶员,展现了当前系统的强大能力。同时,VLA方法正在迎头赶上,部分指标已开始超越传统方法,展现出强大的鲁棒规划潜力。
3.2 闭环性能:传统范式的护城河
闭环测试(如 Bench2Drive, CARLA Town05 Long)更接近真实驾驶,重点考核路线完成率 (Route Completion) 和驾驶评分 (Driving Score)。
- 长程驾驶仍是瓶颈:即便SOTA方法在遵守交规方面表现尚可,但在Bench2Drive 中,最高的路线完成率仍未突破 70%。这表明,面对多样化、长时程的驾驶任务,当前的系统仍显得力不从心。
- 传统范式主导实战:在闭环榜单(尤其是高难度的Town05 Long)中,传统端到端方法占据了绝对的主导地位。相比之下,VLA 方法在这一领域的表现仍有较大提升空间。
VLA 的短板:
为何 VLA 在开环很强,闭环却稍逊一筹?原因在于它缺乏对细粒度轨迹控制的能力。VLA 往往难以精确理解其生成的轨迹对环境产生的连续影响。要想在实战中落地,VLA必须学会更精细的“微操”,而不仅仅是宏观的决策。
06 代表模型架构细节
为了更直观地理解各流派的异同,作者整理了主流模型的输入、骨干网络、中间任务及输出形式,欢迎查阅。
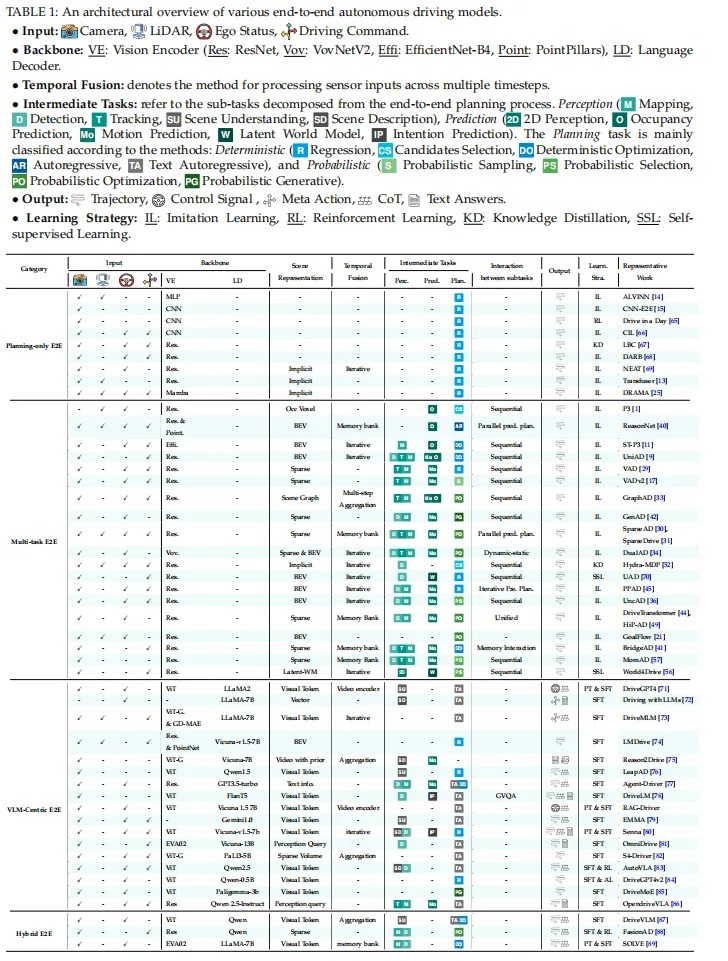
07 核心挑战
尽管端到端(E2E)架构和视觉语言模型(VLM)为自动驾驶带来了范式转移,但要真正实现大规模落地,我们仍需跨越四道这一阶段最棘手的难关。
1. 长尾数据的「无底洞」 (Long-tailed Data Distribution)
现实世界的驾驶场景呈现极端的长尾分布。
现状: 99% 的数据是平庸的日常驾驶,而那 1% 的稀缺 Corner Case(如极端天气、异形车辆)才是决定生死的关键。
痛点: 现有的生成式 AI 模拟存在“虚实鸿沟”,生成的数据质量有待提升。而 VLM 在微调驾驶任务时容易出现“灾难性遗忘”,导致通用认知能力下降,解决长尾场景仍然有所局限。如何高效获取并消化这些长尾数据,是目前最大的拦路虎。
2. 黑盒子的「信任危机」 (Explainability)
如果车辆突然急刹,是因为看到了危险,还是系统出了 Bug?
现状: 传统 E2E 模型是典型的“黑盒”,缺乏中间的可解释性。
痛点: 引入 VLM 虽然带来了思维链(CoT)推理,但往往出现言行不一的问题,模型嘴上说的推理逻辑和手下做的规划动作可能完全脱节。如何让模型不仅“开得好”,还能“说得对”,且两者具备因果关系,是建立用户信任的前提。
3. 安全与效率的「走钢丝」 (Safety Guarantee)
在绝对安全和通行效率之间,系统往往难以取舍。
现状: 为了兜底安全,现有方案通常会外挂一套基于规则的后处理(Post-processing)模块。
痛点: 这种“打补丁”的方式破坏了端到端的纯粹性,往往导致车辆行为过度保守,像个“新手司机”。如何在不牺牲 E2E 简洁性的前提下,将安全约束内化到模型中,是一个巨大的挑战。
4. 实时性的「速度焦虑」 (Real-time Efficiency)
大模型虽好,但让它上车“跑”得动又是另一回事。
现状: VLM 庞大的参数量和自回归生成机制,带来了巨大的推理延迟。
痛点: 尽管有蒸馏、剪枝等优化手段,但往往以牺牲模型的鲁棒性为代价。如何在车载芯片有限的算力下,实现低延迟与高智能的平衡,是工程落地的必答题。
08 未来展望
面对上述挑战,学术界和工业界正在酝酿新的技术风暴。论文指出了六个最具潜力的破局方向,这可能就是下一代自动驾驶的雏形。
1. 从模仿到超越:强化学习的进阶 (Reinforcement Learning)
单纯的“模仿学习”(Imitation Learning)只能让 AI 成为人类的影子,无法超越人类。
趋势: IL 预训练 + RL 后训练将成为主流。利用模仿学习快速上手,再通过强化学习在虚拟环境中主动试错探索。这能让AI在没有专家演示的陌生场景中,也能学会如何做出最优决策。
2. 通识即力量:基础模型的降维打击 (Foundation Models)
与其专门训练一个“老司机”,不如先训练一个“博学家”。
趋势: 基于海量通用数据预训练的 VLM 基础模型,将赋予车辆世界知识。
场景: 即使从未见过“小孩追球”的训练数据,具备常识的 VLM 也能推断出“球后面可能会跑出个孩子”,从而提前减速。这种常识推理能力是处理长尾场景的终极武器。
3. 分层系统:Agent 智能体架构 (Agent Systems)
模仿人类的认知结构,构建分层系统。
趋势: LLM/VLM 作为大脑,负责慢思考、复杂逻辑推理和任务分解;专用小模型或者“工具库”作为身体,负责专门任务的快直觉、毫秒级控制执行,如主动感知、运动规划等等。这种类人的分层架构,兼顾了可解释性、泛化能力与实时性。
4. 预见未来:世界模型 (World Models)
让 AI 在脑海中“预演”未来。
趋势: 世界模型能够基于当前状态,想象出未来环境的演变。这不仅能用于零成本的虚拟试错,还能利用海量无标签视频进行自监督学习,彻底摆脱对昂贵标注数据的依赖。
5. 全知视角:跨模态深度融合 (Cross-Modal Fusion)
不仅要看懂语义,还要看准距离。
趋势: 现有的 VLA 模型多基于视觉,缺乏精确的 3D 几何感知。下一代模型将深度融合 LiDAR/Depth与RGB,让模型既有“诗人的理解力”,又有“工程师的精准度”。
6. 永动机:数据引擎 (Data Engine)
从“堆量”转向“提质”。
趋势: 构建自动化的数据闭环引擎。不再盲目收集数据,而是问题驱动(Problem-driven),自动挖掘模型失败的 Corner Case,自动生成场景,自动训练迭代。谁拥有了最高效的数据引擎,谁就掌握了模型进化的钥匙。
结语
自动驾驶的技术栈正在经历前所未有的重构。无论是追求极致效率的 Conventional E2E,还是探索认知上限的 VLM-centric,亦或是博采众长的 Hybrid 架构,每一条技术路线都在为最终的“类人驾驶”贡献拼图。
本文所构建的 GE2E(广义端到端) 统一视角,旨在为研究者们提供一个清晰的坐标系。我们不再纠结于单一范式的优劣,而是透过现象看本质——如何用数据驱动的方式,实现从传感器输入到驾驶决策的最优解。
无论是解决长尾难题,还是实现闭环仿真,都需要社区的共同努力。欢迎各位同行点击阅读原文下载论文,或访问 GitHub 项目主页,与我们共同探讨自动驾驶的未来。
....
#业内首个RL+VLA汇总
强化学习如何推动 VLA 走向真实世界?
最近有几位同学咨询柱哥自驾方向VLA+RL的工作推荐,一直没来得及整理。今天带大家从近期十一篇VLA + RL工作上,一览该领域的历程......
去年大部分自驾VLM/VLA方向的工作都在基于SFT微调,数据量大的全参微调,数据量小的基于LoRA微调。效果是有的,但幻觉问题也比较严重。本质上还是监督学习,为了进一步提升模型的泛化能力和推理能力,学术界和工业界把目光转向了RL。本文汇总的工业涵盖新国立、斯坦福、清北复交、华科中科大等高校、小米、英伟达、阿里、博世、理想、华为诺亚等公司,基本上可以指明业界头部的研究方向。
MindDrive
- 论文标题:MindDrive: A Vision-Language-Action Model for Autonomous Driving via Online Reinforcement Learning
- 论文链接:https://arxiv.org/abs/2512.13636
- 项目主页:https://xiaomi-mlab.github.io/MindDrive/
- 提出机构:华中科技大学、小米汽车
- 一句话总结:为解决VLA模型在线强化学习中连续动作空间探索低效的问题,提出MindDrive框架,通过双专家(决策专家+动作专家)架构将动作空间转化为离散语言决策空间,实现高效在线RL训练。
- 核心贡献:
- 设计双LoRA适配器架构,决策专家负责场景推理与语言决策,动作专家将决策映射为可行轨迹,建立语言-动作动态映射。
- 构建基于CARLA模拟器的在线闭环RL框架,采用稀疏奖励与PPO算法,结合KL正则化避免灾难性遗忘。
- 在Bench2Drive基准上以轻量Qwen-0.5B模型实现78.04的驾驶分数与55.09%的成功率,超越同规模SOTA模型。
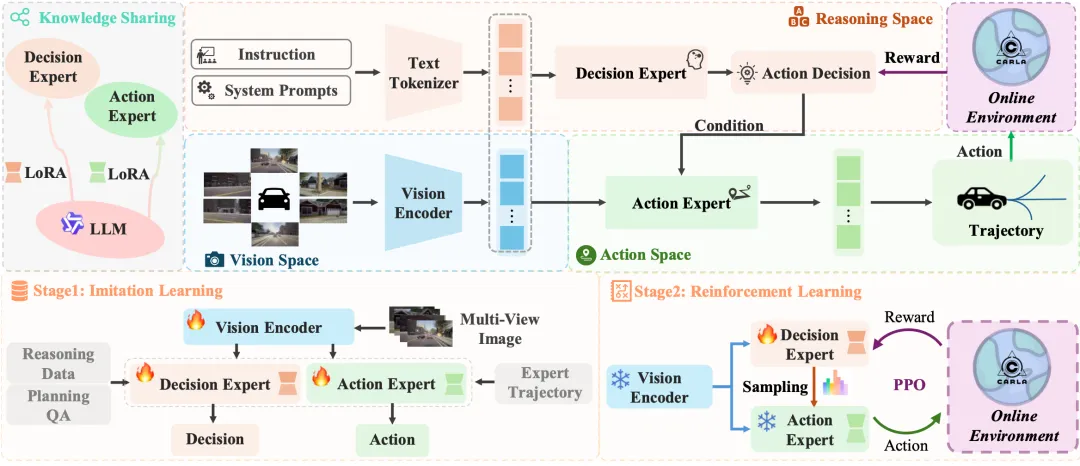
WAM-Diff
- 论文标题:WAM-Diff: A Masked Diffusion VLA Framework with MoE and Online Reinforcement Learning for Autonomous Driving
- 论文链接:https://arxiv.org/abs/2512.11872
- 项目主页:https://github.com/fudan-generativevision/WAM-Diff
- 提出机构:复旦大学、银王智能科技有限公司
- 一句话总结:提出WAM-Diff端到端自动驾驶VLA框架,采用离散掩码扩散迭代优化未来轨迹序列,结合稀疏MoE架构和GSPO在线强化学习,在NAVSIM基准上实现优异性能。
- 核心贡献:
- 系统适配掩码扩散用于自动驾驶,支持因果、逆因果等灵活解码顺序,适配不同驾驶场景。
- 引入稀疏MoE架构并联合训练运动预测与驾驶导向VQA任务,提升模型扩展能力与场景理解能力。
- 集成GSPO在线强化学习优化序列级驾驶奖励,在安全、舒适性等多维度提升驾驶性能。
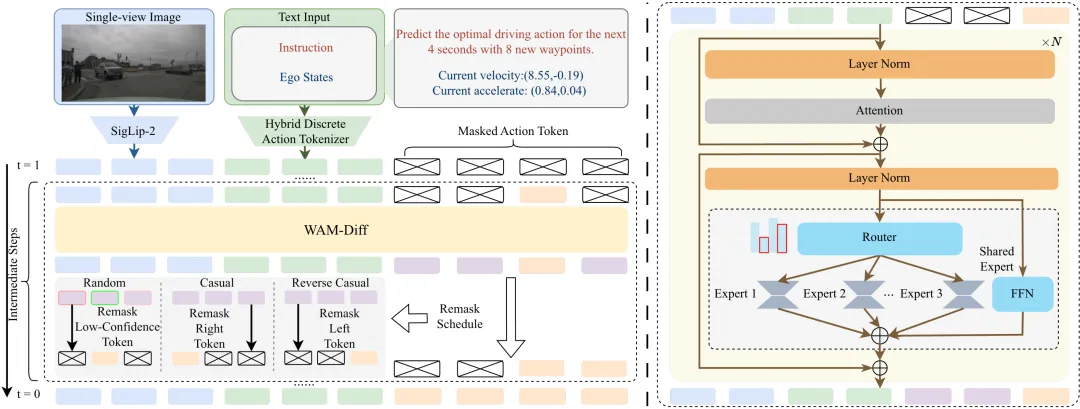
LCDrive
- 论文标题:Latent Chain-of-Thought World Modeling for End-to-End Autonomous Driving
- 论文链接:https://arxiv.org/abs/2512.10226
- 提出机构:得克萨斯大学奥斯汀分校、NVIDIA、斯坦福大学
- 一句话总结:针对文本链推理在自动驾驶中时空表达不足、 latency高的问题,提出LCDrive模型,采用动作对齐的 latent 语言进行推理,通过三阶段训练实现高效推理与决策一体化。
- 核心贡献:
- 设计 latent 链推理机制,交替使用动作提议令牌与 latent 世界模型令牌,在向量空间模拟反事实未来,提升推理效率与精度。
- 提出三阶段训练 pipeline(非推理预训练、 latent 链冷启动、闭环强化学习),强化推理与动作的对齐。
- 在PhysicalAI-AV数据集上验证,相比文本链推理基线,实现更快推理、更优轨迹质量与更强的RL提升效果。
Reasoning-VLA
- 论文标题:Reasoning-VLA: A Fast and General Vision-Language-Action Reasoning Model for Autonomous Driving
- 论文链接:https://arxiv.org/abs/2511.19912
- 项目主页:https://github.com/xipi702/Reasoning-VLA
- 提出机构:兰州大学、新加坡国立大学、中国科学技术大学、清华大学、新南威尔士大学
- 一句话总结:提出Reasoning-VLA高效VLA框架,通过可学习动作查询与推理增强型VLM交互实现并行轨迹生成,融合8个公开数据集构建统一训练数据,经SFT与RL微调实现高性能与强泛化。
- 核心贡献:
- 设计可学习动作查询(基于真实轨迹高斯采样初始化),与VLM跨注意力交互,支持一步并行生成连续轨迹。
- 构建统一的思维链推理数据集,融合8个自动驾驶数据集,提升模型跨场景与车辆配置的泛化能力。
- 采用SFT+RL两阶段训练策略,结合物理轨迹与车辆动力学奖励,强化模型推理与规划能力。
Alpamayo-R1
- 论文标题:Alpamayo-R1: Bridging Reasoning and Action Prediction for Generalizable Autonomous Driving in the Long Tail
- 论文链接:https://arxiv.org/abs/2511.00088
- 项目主页:https://github.com/NVlabs/alpasim(关联仿真工具开源,模型后续计划开源)
- 提出机构:NVIDIA
- 一句话总结:提出Alpamayo-R1 VLA模型,通过因果链(CoC)数据集、模块化架构(Cosmos-Reason骨干+扩散轨迹解码器)和多阶段训练(动作模态注入+SFT+RL),桥接推理与动作预测,提升长尾场景泛化能力与实时部署性能。
- 核心贡献:
- 构建CoC数据集,通过人机结合标注 pipeline 生成决策接地的因果推理轨迹,解决现有数据因果混淆、描述模糊的问题,为推理训练提供高质量监督。
- 设计模块化架构,融合物理AI预训练的VLM骨干与流匹配轨迹解码器,兼顾复杂场景推理能力与动力学可行的轨迹生成,实现99ms实时推理延迟。
- 采用RL后训练优化推理质量、推理-动作一致性和轨迹安全性, closed-loop 仿真中off-road率降低35%,close encounter率降低25%,实车测试验证城市道路部署能力。
AdaThinkDrive
- 论文标题:AdaThinkDrive: Adaptive Thinking via Reinforcement Learning for Autonomous Driving
- 论文链接:https://arxiv.org/abs/2509.13769
- 提出机构:清华大学、小米汽车、澳门大学、南洋理工大学、北京大学
- 一句话总结:提出AdaThinkDrive VLA框架,基于“快速响应/慢速思考”双模式机制,通过预训练、双模式SFT和GRPO强化学习(含自适应思考奖励),解决CoT在简单场景过度推理的问题,平衡自动驾驶的决策准确性与推理效率。
- 核心贡献:
- 揭示现有CoT方法的场景适配缺陷,设计自适应推理策略,让模型根据场景复杂度动态选择直接预测或CoT推理,避免冗余计算。
- 构建双模式SFT数据集(含推理型和直接响应型数据),搭配融合PDMS、端点奖励的自适应思考奖励,引导模型智能选择推理时机。
- 在Navsim基准测试中取得90.3的PDMS分数,较最优视觉基线提升1.7点,同时较“始终推理”基线减少14%推理时间,实现性能与效率双赢。
AutoDrive-R²
- 论文标题:AutoDrive-R²: Incentivizing Reasoning and Self-Reflection Capacity for VLA Model in Autonomous Driving
- 论文链接:https://arxiv.org/abs/2509.01944
- 提出机构:阿里巴巴集团、昆士兰大学、兰州大学、凯斯西储大学
- 一句话总结:提出AutoDrive-R²这一VLA框架,通过“监督微调+强化学习”两阶段训练,结合含自我反思的CoT数据集与物理基奖励机制,解决现有VLA模型推理不足和轨迹物理不可行的问题,实现精准轨迹规划。
- 核心贡献:
- 构建nuScenesR²-6K数据集,创新采用“观察-计算-逻辑推理-反思验证”四步逻辑链,为监督微调提供高质量因果推理数据,夯实模型基础认知能力。
- 设计融合空间对齐、车辆动力学和时间平滑性的物理基奖励框架,结合GRPO算法优化,确保轨迹满足真实驾驶的物理约束与舒适性要求。
- 在nuScenes和Waymo数据集上实现SOTA性能,7B版本平均L2误差低至0.20m,零样本迁移能力突出,较EMMA+等模型降低33.3%误差。
IRL-VLA
- 论文标题:IRL-VLA: Training an Vision-Language-Action Policy via Reward World Model for End-to-End Autonomous Driving
- 论文链接:https://arxiv.org/abs/2508.06571
- 项目主页:https://github.com/IRLVLA/IRL-VLA
- 提出机构:博世(中国)投资有限公司、上海大学、上海交通大学、博世汽车部件(苏州)有限公司、清华大学
- 一句话总结:为解决VLA模型依赖开环模仿学习、闭环训练受限于仿真器的问题,提出IRL-VLA框架,通过模仿学习预训练、逆强化学习构建奖励世界模型、PPO强化学习微调三阶段,实现高效闭环训练。
- 核心贡献:
- 提出轻量级奖励世界模型(RWM),基于逆强化学习从多模态数据中学习奖励结构,规避仿真器依赖与域迁移问题。
- 设计融合语义推理、3D推理与扩散规划器的VLA架构,兼顾场景理解与多模态轨迹生成。
- 在NAVSIM v2基准上取得SOTA性能,获CVPR2025自动驾驶挑战赛亚军,是首个不依赖仿真器的传感器输入闭环VLA方法。
DriveAgent-R1
- 论文标题:DriveAgent-R1: Advancing VLM-based Autonomous Driving with Active Perception and Hybrid Thinking
- 论文链接:https://arxiv.org/abs/2507.20879
- 提出机构:上海启智研究院、理想汽车、同济大学、清华大学
- 一句话总结:提出DriveAgent-R1自动驾驶智能体,创新融合主动感知与混合思维框架,通过三阶段渐进式训练(SFT+级联RL),实现简单场景高效文本推理与复杂场景工具增强视觉推理的自适应切换,兼顾性能与部署效率。
- 核心贡献:
- 首次将主动感知应用于高级行为规划,设计含Retrieve View、RoI Inspection等工具的视觉 toolkit,主动获取关键视觉证据,提升决策可靠性与可解释性。
- 提出混合思维框架,结合文本推理与工具增强推理,搭配MP-GRPO算法的级联RL训练,让模型能根据场景复杂度自适应选择最优推理模式。
- 仅3B参数就达到与GPT-5和人类驾驶相当的性能,Drive-Internal测试集工具使用后准确率提升6.07%,推理延迟较被动感知方法降低20%以上。
Drive-R1
- 论文标题:Drive-R1: Bridging Reasoning and Planning in VLMs for Autonomous Driving with Reinforcement Learning
- 论文链接:https://arxiv.org/abs/2506.18234
- 提出机构:中国科学技术大学、华为诺亚方舟实验室
- 一句话总结:针对VLMs在自动驾驶运动规划中过度依赖历史输入、推理与规划结果错位的问题,提出Drive-R1模型,通过包含长短链推理数据的监督微调与强化学习框架,实现场景推理与运动规划的衔接。
- 核心贡献:
- 构建了涵盖交通知识理解等五大领域的RP-COT数据集,提供长短链推理标注,使模型学习视觉关联的结构化推理路径。
- 设计基于GRPO的强化学习机制,结合轨迹准确性、元动作正确性等多维度奖励,对齐推理过程与规划结果。
- 在nuScenes和DriveLM-nuScenes基准上实现SOTA性能,为VLMs在自动驾驶中融合推理与规划提供了有效方法。
ReCogDrive
- 论文标题:ReCogDrive: A Reinforced Cognitive Framework for End-to-End Autonomous Driving
- 论文链接:https://arxiv.org/abs/2506.08052
- 项目主页:https://github.com/xiaomi-research/recogdrive
- 提出机构:华中科技大学、小米汽车
- 一句话总结:提出ReCogDrive框架,融合VLM认知推理与扩散规划器,通过分层数据管道注入驾驶先验,结合DiffGRPO强化学习优化,在NAVSIM等基准实现SOTA性能。
- 核心贡献:
- 设计生成、精炼、质控三阶段分层数据管道,构建大规模VQA数据集,为VLM注入类人驾驶认知先验。
- 提出认知引导扩散规划器,将VLM潜在语义表示转化为连续稳定轨迹,解决语言-动作模态不匹配问题。
- 提出DiffGRPO强化学习算法,基于模拟器奖励优化规划器,提升驾驶安全性与舒适性,突破模仿学习局限。
....
#GenieDrive
物理一致的自动驾驶世界模型(港大&华为诺亚)
来自香港大学、华为以及华中科技大学的最新工作 GenieDrive,提出了一种以 4D Occupancy 作为中间表示的自动驾驶世界模型框架,在 4D 占据预测、轨迹可控性以及长时序视频生成能力等方面均显著优于现有自动驾驶世界模型,为该领域提供了一条“先生成 4D 占据、再生成视频”的全新研究路径。
摘要
具备物理感知能力的自动驾驶世界模型,是实现路径规划、分布外数据合成以及闭环评测的关键基础。然而,现有方法往往依赖单一的视频扩散模型,直接将驾驶控制映射到视频结果,这种像素级端到端建模方式不仅学习难度大,也容易产生与真实物理规律不一致的生成结果。为此,本文提出 GenieDrive,一种面向物理一致性的自动驾驶视频生成框架,其核心思想是先预测 4D Occupancy 作为世界状态,再在此基础上生成多视角驾驶视频。4D Occupancy 蕴含了高分辨率的三维空间结构与动态演化信息,为视频生成提供了可靠的物理约束。针对高维占据表示的建模挑战,GenieDrive 设计了基于 Tri-plane 表示的变分自编码器,在仅使用现有方法 58% 潜在表示的情况下实现高质量占据重建,并引入 Mutual Control Attention 显式建模驾驶控制对占据演化的影响,通过端到端联合训练进一步提升预测精度。
得益于上述设计,GenieDrive 在仅使用 3.47M 参数的情况下实现了 41 FPS 的推理速度,并在 4D 占据预测任务上取得了 7.2% 的 mIoU 提升;同时,通过在视频生成阶段引入归一化多视角注意力机制,在 4D Occupancy 的引导下显著提升了多视角视频生成质量,将 FVD 指标降低了 20.7%。实验结果表明,GenieDrive 能够实现高度可控、多视角一致且符合物理规律的自动驾驶视频生成。
- 论文链接:https://arxiv.org/abs/2512.12751
- 项目链接:https://huster-yzy.github.io/geniedrive_project_page/
- 代码链接:https://github.com/Huster-YZY/GenieDrive
📝 项目简介
GenieDrive 是一种新型的以 4D Occupancy 作为中间表示的自动驾驶世界模型框架,能够实现高度可控、多视角一致且符合物理规律的自动驾驶视频生成。得益于上述设计,GenieDrive 在仅使用 3.47M 参数的情况下实现了 41 FPS 的推理速度,并在 4D 占据预测任务上取得了 7.2% 的 mIoU 提升;同时,通过在视频生成阶段引入归一化多视角注意力机制,在 4D Occupancy 的引导下显著提升了多视角视频生成质量,将 FVD 指标降低了 20.7%。
🔍 研究背景与挑战
当前自动驾驶世界模型主要面临两大挑战:
- 物理一致性不足:仅依赖视频生成模型来建模自动驾驶场景,本质上是在学习像素分布,从而间接的捕捉世界状态。这种建模范式一方面使得学习任务本身非常困难,需要大量计算资源才能获得可接受的生成效果;另一方面,纯数据驱动的方法也使模型训练极易受到数据分布偏置的影响,从而在面对控制指令(如转向、加速)时,难以产生符合真实物理规律的响应。
- 高维表示建模:4D Occupancy 表示能够显式刻画场景中的空间占据关系、物体的运动状态以及场景随时间的动态演化过程,但其高维特性给有效建模带来了巨大挑战。
💡 GenieDrive的创新点
GenieDrive 展现出四个显著特点:
- 以 4D Occupancy 作为中间世界状态:将显式物理信息注入自动驾驶视频生成的世界模型框架,为视频生成提供可靠的物理约束。
- Tri-plane VAE 高效压缩:仅使用现有方法 58% 的潜在表示数量,即可实现 SOTA 的占据重建性能,显著降低计算与存储开销。
- 控制感知注意力机制 & 端到端训练:通过 Mutual Control Attention 显式建模驾驶控制对占据演化的影响,并通过端到端联合训练进一步提升预测精度。
- 多视角一致的视频生成:引入归一化多视角注意力机制,在 4D Occupancy 的引导下显著提升了多视角视频生成质量与一致性。
🛠️ 技术架构
GenieDrive 采用一种两阶段的世界建模与生成框架:
- 4D Occupancy 世界模型:
- Tri-plane VAE:将占据表示分别投影到 XY、XZ 和 YZ 三个平面上,并通过变分自编码器学习紧凑的隐空间表示
- Mutual Control Attention:显式建模驾驶控制对占据演化的影响
- 端到端联合训练:在分别训练 VAE 与预测模块后,进一步对整个模型进行端到端联合训练
- Occupancy 引导的视频生成:
- 归一化多视角注意力机制:在不同视角之间执行交叉注意力,以建模视角间的一致性
- 轻量级设计:仅在不同视角的对应高度位置执行注意力计算,显著降低计算成本
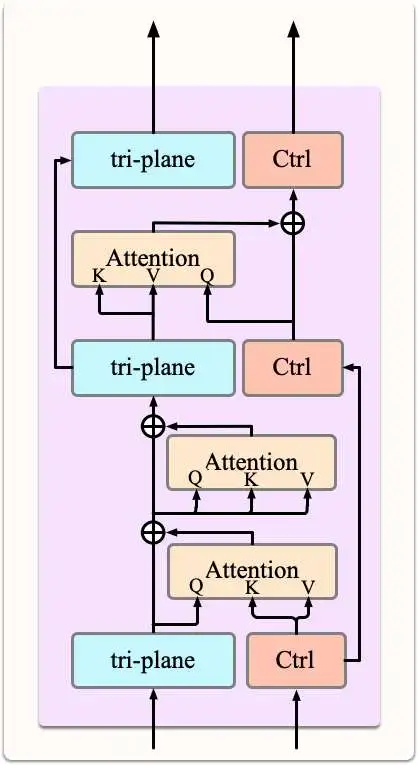
🔬 实验结果与分析
4D 占据预测性能
与此前的最新方法 I²-World 相比,GenieDrive 在预测性能上取得了显著提升,其中 mIoU 提高了 7.2%,IoU 提高了 4%。得益于紧凑高效的表示方式,模型在推理阶段可实现 41 FPS 的运行速度,并且整体参数量仅为 3.47M。
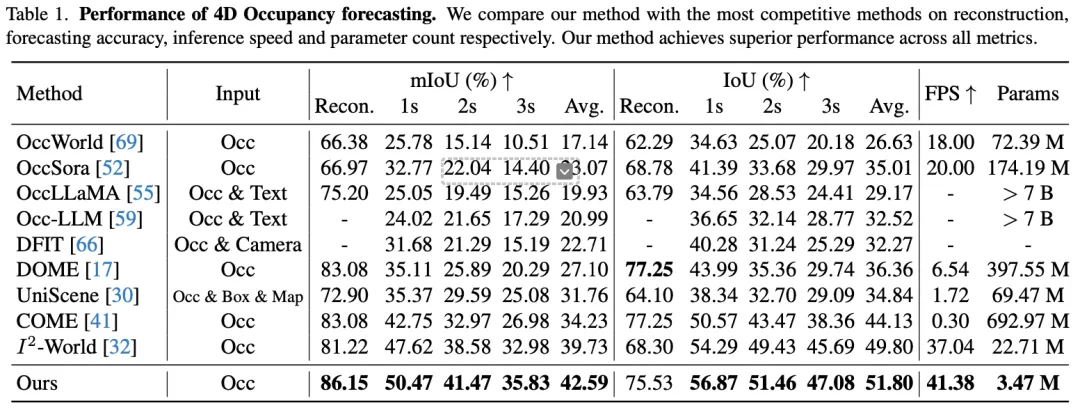
视频生成性能
GenieDrive 分别训练了三种仅在视频长度上不同的模型规模:S 模型可生成 8 帧(约 0.7 秒)视频,M 模型可生成 37 帧(约 3 秒)视频,L 模型可生成 81 帧(约 7 秒)视频,并通过逐步滚动预测进一步扩展,实现了最长 241 帧(约 20 秒)的多视角自动驾驶视频生成。在生成质量方面,GenieDrive 在各项评估指标上均显著优于现有基于 Occupancy 的方法,将 FVD 指标降低了 20.7%。
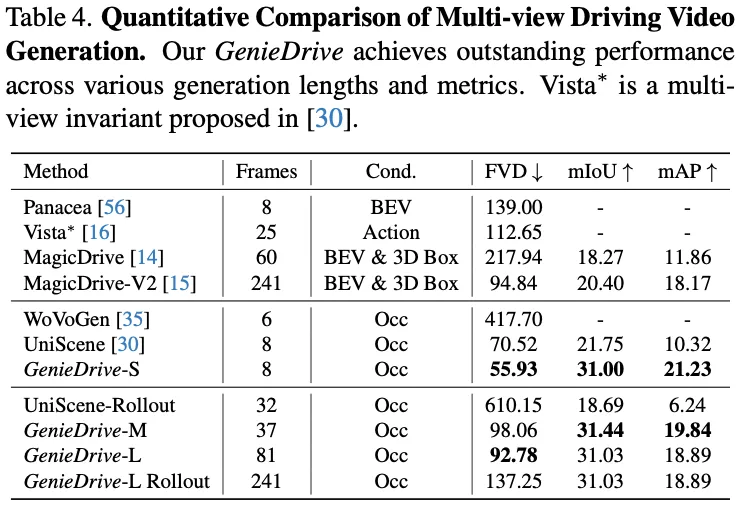
可视化结果
我们将 GenieDrive 与当前代表性的自动驾驶世界模型 Vista 和 Epona 进行了对比。在实验中,分别输入左转、直行和右转三条轨迹。结果显示,GenieDrive 能够严格遵循输入轨迹,生成物理一致且前后连贯的自动驾驶视频。
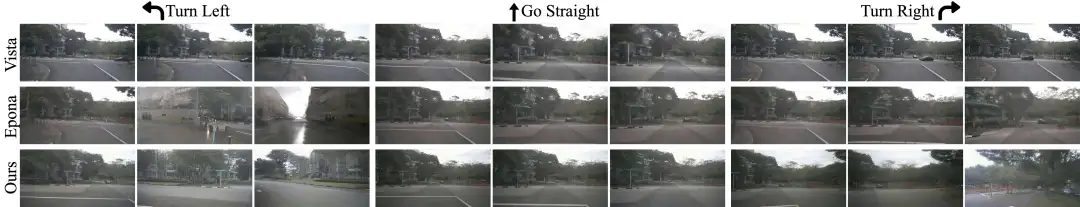
为更直观地展示 GenieDrive 的工作机制,我们对两阶段生成结果进行了可视化。可以看到,占据预测结果不仅包含完整的 3D 场景结构,还能准确反映由驾驶控制引起的动态变化,为后续视频生成提供了丰富且可靠的物理信息。
此外,得益于以 4D 占据作为中间表征,GenieDrive 还支持通过直接编辑占据信息(如插入或删除场景元素)来高效实现对最终生成视频的编辑,这在自动驾驶难例数据生成中具有重要价值。
📈 主要贡献
- 提出了以 4D Occupancy 作为中间表示的自动驾驶世界模型框架,为该领域提供了一条"先生成 4D 占据、再生成视频"的全新研究路径。
- 设计了基于 Tri-plane 表示的变分自编码器,在仅使用现有方法 58% 潜在表示的情况下实现高质量占据重建,并引入 Mutual Control Attention 显式建模驾驶控制对占据演化的影响。
- 在仅使用 3.47M 参数的情况下实现了 41 FPS 的推理速度,并在 4D 占据预测任务上取得了 7.2% 的 mIoU 提升;同时,通过在视频生成阶段引入归一化多视角注意力机制,将 FVD 指标降低了 20.7%。
🔮 未来展望
通过引入 4D Occupancy 作为中间表示,GenieDrive 实现了高度可控且具备物理感知能力的自动驾驶视频生成。我们期待 GenieDrive 作为一种强大的物理感知的自动驾驶世界模型,能够进一步推动闭环评测与仿真技术的发展,为自动驾驶领域带来新的研究方向和应用可能。
....
#走向融合统一的VLA和世界模型......
最近自动驾驶的两大前沿方向:VLA和世界模型,已经有明显的融合趋势。这一想法是十月份看到中科院的DriveVLA-W0,因此笔者借这个机会分别调研了 VLA 和 World Model 相关的工作,并且思考一下这二者结合的可能性。太长不看版:
VLA和世界模型并不冲突,终极目标是一致的。世界模型可以作为数据引擎、闭环引擎,甚至可以参与到VLA的模型训练过程中,融合是大趋势,落地是我全都要。
经过几周的调研、分析,有了些成果和自己的心得,所以也想理一理,分享给xx的小伙伴们,主要分为以下几个部分:
- 简单介绍 VLA
- 简单介绍 World Model
- 两者到底各有什么优缺点
- 二者融合的可能性
自动驾驶技术诞生到发展至今,已经有十多年了,随着技术的不断迭代,以及大模型技术的蓬勃发展,如今的自动驾驶仿佛进入了一个“百家争鸣”的时代。如果说早期的模块化设计像是手工打造的传统汽车,那么如今以大模型为代表的技术路线,更像是试图直接给车装上“会思考的大脑”。
在这股浪潮中,两条路径尤为引人瞩目:一条是“能听会说还会开”的 VLA,另一条是擅长“在脑海中预演未来”的 World Model。它们就像两位风格截然不同的车手:一位善于沟通,能听懂指令、解释行为,像一位经验丰富的“老司机”;另一位则沉默专注,善于推演和预判,像一位精于计算的“战术大师”。
那么,这两个看似不同的技术路线,究竟哪条路线更胜一筹?它们是对手,还是最终会携手并进的伙伴?本文将给大家深度解析。首先,咱们聊一聊二者分别是什么。因为xx平台有发过这两个路线的详解,这里笔者就 high level 的概括一下,感兴趣地小伙伴可以翻翻之前的文章,讲地更为详细。
什么是 VLA?
VLA,全称 Vision-Language-Action,即“视觉-语言-行动”模型。 是一个多模态大脑,它能看得懂画面(Vision),听得懂语言(Language),并且能直接做出行动决策(Action)。换句话说,它的输入是摄像头画面(Vision)和人类语言指令(Language),输出则是直接的驾驶动作(Action),比如方向盘转角、油门刹车信号,或是一条未来行驶轨迹。
想象一下,你坐在一辆自动驾驶车里,对它说:“前面路口右转,注意那辆自行车。” 它不仅能准确执行,还能回答你:“好的,已识别到右侧有自行车,我会减速让行。”——这就是 VLA 试图实现的场景。
从系统的角度出发,主要分为:输出-中间层-输出的 “三明治架构”:
输入端:融合多模态感知VLA的输入整合了视觉、传感器与语言等多模态的信息。核心视觉输入通过多摄像头图像生成BEV或体素表征,以理解空间结构;传感器(如激光雷达、毫米波雷达)提供几何与动态补充;语言输入则是关键创新,支持导航指令、交互问答与规则描述,使系统能理解人类意图与常识,构建出超越传统纯视觉感知的环境理解。
中间层:统一推理与决策生成中间层是VLA的“大脑”,由视觉编码器、语言处理器与动作解码器构成。视觉编码器(如DINOv2)提取特征;语言处理器(基于LLM)进行语义推理与链式思维分解;动作解码器则通过序列预测、扩散模型或分层控制,将推理结果转化为具体驾驶动作,实现感知、理解到行动生成的端到端映射。
输出端:直接驱动车辆输出端直接对应车辆控制,分为低层指令与轨迹规划两类。低层指令(如油门、方向盘转角)适用于需快速响应的场景;轨迹规划则输出未来数秒的连续路径,更注重平顺性与前瞻性,便于与控制系统集成。两类输出均旨在实现安全、流畅且可解释的驾驶行为。目前学术界和工业界的Action都定义在轨迹这一层面,因为轨迹是相对通用的,可以较容易转换为低层指令(不同车型之间有差异)。
总的来说, VLA 把视觉、语言和动作整合到一个统一框架里,既能理解人类的自然语言指令,比如“在路口礼让救护车”,也能基于视觉感知做出推理,并且直接生成具体的驾驶行为。换句话说,VLA 把“看、想、做”这三件事打通了,真正实现了从感知到推理再到控制的一体化。
什么是 World Model?
World Model,即世界模型,是一种生成式时空神经网络系统。它能将多传感器的高维观测数据压缩成一个紧凑的、包含几何与语义信息的内部状态,并在这个潜在空间中推演未来场景的演化。简单来说,它让自动驾驶车辆具备“在脑海中预演未来”的能力,通过内部仿真来评估不同决策的后果,从而做出更安全、更前瞻的规划。
想象一下,自动驾驶系统在左转前,会先在内部模型中快速模拟:如果现在转向,对向车辆是否会减速?行人是否会突然闯入车道?未来3秒的路口会呈现怎样的交通状态?——这就是 World Model 所实现的核心机制。
从系统架构出发,同样也可以划分为输入、核心模型与输出的 “三明治架构”:
输入端:多模态时序观测与状态
World Model的输入侧重于时序的多模态传感器数据(如图像、激光雷达点云)以及自车状态。这些数据被编码为统一的表征,用于捕捉场景的几何结构、语义信息和动态变化。与上述VLA不同,其输入通常不直接包含语言指令,而是专注于对物理世界状态的建模与预测。
核心层:状态编码、记忆与生成式推演
核心层是World Model的“虚拟引擎”,通常由编码器、记忆模块和生成式预测模块构成。编码器将观测压缩为低维潜在状态;记忆模块(如RNN、Transformer)维持时间上下文;生成模块(如扩散模型、自回归模型)则根据当前状态与 World Model的输出是对未来场景的丰富表征,如生成图像序列、BEV地图、4D占据栅格或未来点云。这些输出并不直接控制车辆,而是为下游规划模块提供前瞻信息,用于轨迹评分、风险估计与策略优化。本质上,World Model充当了规划器的“内部仿真器”,提供可快速试错的决策支持。
总的来说,World Model通过构建一个可微分、可推演的虚拟世界,使自动驾驶系统能够进行基于“想象”的决策。它将“观测-压缩-预测”整合进一个统一的生成框架,旨在实现更安全、更鲁棒、具备物理常识的自动驾驶能力。
二者的区别与联系
在解释完二者大概的技术路线之后,为了更好的展示(也为了笔者自己记些笔记),我将两者的主要区别,从不同维度整理在下表中,与大家分享:
| 不同维度 | VLA | World Model |
| 目标不同 | 主要为了实现人车交互与可解释的端到端的自动驾驶。重点在于将人类语言融入到系统当中,与驾驶行为对齐,让系统“能听懂、会解释、直接开”。 | 构建内一个预测&仿真的系统。重点在于推演未来世界状态,为规划提供一个可以试错的仿真 world。 |
| 输入不同 | 传感器数据(可能是单帧 / 多帧) + 显式语言指令 or 交互。 | 传感器时序数据 + 自车假设动作。 |
| 输出不同 | 直接的动作控制信号 or 短轨迹。 | 未来的场景状态(如图像、占据栅格),而非直接驾驶动作。 |
| 核心技术不同 | 利用大模型的推理能力。关键在于将视觉特征与语言语义在统一空间中对齐,并利用LLM的推理能力分解任务。 | 状态编码与生成式预测。关键在于学习环境动态的压缩表示,并用扩散、自回归等模型生成物理合理的未来。 |
| 优势不同 | 交互自然、可解释性强、能利用语言常识处理复杂语义场景。(更人性化) | 预测和仿真未来、方便量化风险,并且可以通过仿真生成大量 corner case 数据。 |
| 当前应对的挑战不同 | “说做不一”,L 和 A 的对齐难题、并且算力需求大。 | 缺乏高级语义理解、实时高保真推演的计算成本高、本身不直接产出驾驶策略。 |
在总结完这么多的相异点之后,VLA 和 World Model 真的不存在一些相似的点吗?其实也是有的:
- 技术起源的 Background 是一致的
两项技术都源于对传统模块化 pipeline(感知-预测-规划-控制)以及早期传统端到端模型(“黑箱”)的深刻反思,为了缓解“系统碎片化导致的信息损失” 以及“缺乏常识推理与长尾场景处理能力”这两大痛点。 - 终极目标是一致的
两者都是让自动驾驶系统具备 “human-like”的认知与决策能力。无论是通过语言理解常识,还是通过内部仿真预见未来,其内核都是为了赋予机器主动理解环境、进行推理、并做出稳健规划的高级 Agent。 - 关键挑战是一致的
都需要直面二八定律中的下半场难点:如何解决剩下的 20% 的 corner cases。虽然方法是不同的:VLA 试图利用大语言模型中嵌入的人类常识与语义知识来理解和应对;World Model 则试图通过物理仿真生成海量罕见场景数据来覆盖和准备,提升系统的鲁棒性。 - 技术底层是一致的
两者都重度依赖“预训练+微调” 的现代深度学习范式,并建立在 Transformer 等核心架构之上。它们都需要从海量的多模态数据(图像、视频、文本、点云)中学习世界的通用表征,作为自身能力的基础。
纵观技术发展,VLA 和 World Model 是适应当下技术发展潮流中两个弄潮儿,共同承担着将原始感知提升至高层次认知,并为最终决策提供关键支持的战略性角色。而且也并非是水火不容的关系,而是高度的互补。 未来的趋势可以是两者的深度融合,塑造一个“既会思考,又会沟通”的终极驾驶大脑。
笔者自己整理了些可能的融合路径如下:
- 架构级融合:以 World Model 作为核心的“预测与仿真”,负责生成高保真的未来场景和风险评估;同时,将 VLA 作为“交互与决策解释层”,负责理解指令、进行高级语义推理,并基于 World Model 的推演结果做出最终决策并解释。
- 训练数据互补:可以用 World Model 生成的大量、多样、逼真(尤其是一些高风险)场景,来训练和增强 VLA 的决策鲁棒性。同时,VLA 产生的带有语言标注的交互数据,也可以反过来用于提升 World Model 对语义意图的理解。
- 形成闭环智能:VLA 根据指令和当前状态做出初步决策,World Model 对该决策进行快速“脑内推演”,预测结果并评估风险,再将信息反馈给 VLA 进行决策调整或生成解释。形成一个“感知-推理-仿真-决策-解释”的增强闭环。
其实,将 VLA 和 World Model 融合的工作也是有不少的,当然,为了总结的完备性,笔者也会列一些机器人领域的 paper, 提供一些思路。接下来,我们按时间顺序来看一些例子。 PS:这里也提一下,早期的一些二者融合都是在机器人领域的尝试,近期,自动驾驶领域越来越多相关的工作了。
相辅相成的例子
我们从xx领域的相关工作盘起,再延伸到自驾领域。
3D-VLA
论文标题:3D-VLA: A 3D Vision-Language-Action Generative World Model
提出时间:2024.03
提出机构:东北大学、加州大学洛杉矶分校、麻省理工学院等
论文链接: https://arxiv.org/pdf/2403.09631
研究背景:现在的视觉-语言-动作模型大多还在“二次元”里打转——只处理2D图像,但咱们活在一个真实的三维世界。人类可是靠3D感知来理解环境、做决策的。虽然最近也有一些3D基础模型出现,但它们往往是“看到啥就动啥”,缺少对世界动态变化的想象能力,更不会像人一样先在大脑里模拟一下“如果我这么做,接下来会怎样”。这种“世界模型”能力对于机器人完成复杂任务至关重要。所以,这篇论文就想填上这个坑:搞一个能真正理解、想象并规划3D行动的xx模型。
论文内容:这篇论文的核心是提出了 3D-VLA,一个能打通3D感知、推理和动作生成的“世界模型”。它可不是简单地把2D模型升级成3D,而是从头设计了一套融合架构:
模型骨架以 3D-LLM 为基础,加入了各种交互token(比如物体、位置、场景、动作token),让模型能更自然地理解和表达3D环境中的元素和关系。
关键创新在于让模型学会“想象未来”:作者专门训练了一组扩散模型,用来生成执行指令后的目标图像、深度图和点云。然后通过一个投影器,把这些视觉生成能力和语言模型的推理能力对齐,让模型能根据指令“脑补”出目标状态。
数据方面,作者发现现有机器人数据集严重缺乏3D信息,于是自己动手整了一个超大规模的3Dxx指令数据集(约200万个样本),方法是从现有数据中提取或估算深度、点云、3D边界框等信息,再用ChatGPT增强语言描述。
实际效果上,3D-VLA在3D推理定位、多模态目标生成(图片和点云)和机器人动作规划等任务上,表现都远超之前的2D模型。比如,生成的目标图像更符合指令,动作预测也更准确,证明了这种“先想象再行动”的建模方式确实更接近人类的思维方式,更适合复杂的真实世界任务。
WorldVLA
论文标题:WorldVLA: Towards Autoregressive Action World Model
提出时间:2025.06
提出机构:阿里巴巴集团达摩院、浙江大学等
论文链接: https://arxiv.org/pdf/2506.21539
研究背景:视觉-语言-动作(VLA)模型与世界模型,也是机器人领域的两大热点。VLA模型利用预训练的多模态大语言模型作为主干,能生成动作,但通常也只是输出动作,缺乏对动作输入进行深度理解。而世界模型能够基于当前状态与动作预测未来状态,理解环境物理规律,但无法直接生成动作指令,限制了其在需明确动作规划的场景中的应用。这二者功能互补却相互割裂,导致机器人系统在动作生成与环境理解之间存在语义与功能鸿沟,难以实现真正统一的理解与决策闭环。
论文内容:标题就叫 WorldVLA,顾名思义,一个自回归动作世界模型,将VLA模型与世界模型统一于单一框架,实现动作与图像的联合理解与生成。模型采用三个独立的标记器(图像、文本、动作)将不同模态信息转换为共享词汇表中的离散标记,并在同一LLM架构中以自回归方式进行训练与推理。其中,世界模型基于当前图像与动作预测下一帧,学习环境物理规律;动作模型基于当前观测与指令生成动作,增强对视觉内容的理解。二者通过联合训练相互促进:世界模型为动作生成提供物理先验与结果模拟能力,动作模型则提升世界模型的视觉理解与生成质量。
针对自回归生成多步动作序列时错误累积导致性能下降的问题,论文还提出一种动作注意力掩码策略,在生成当前动作时屏蔽之前已生成的动作,使每个动作仅依赖于视觉与文本输入,从而减少错误传播,显著提升动作块生成的性能。
实验在LIBERO机器人操作基准上进行,结果表明WorldVLA在未使用大规模预训练数据的情况下,其动作生成成功率超过同类离散动作模型(如OpenVLA)约4%;同时,其视频生成质量(FVD指标)优于单纯世界模型约10%,验证了动作模型与世界模型相互增强的有效性。注意力掩码策略也在长序列动作生成任务中带来了4%至23%的性能提升。
IRL-VLA
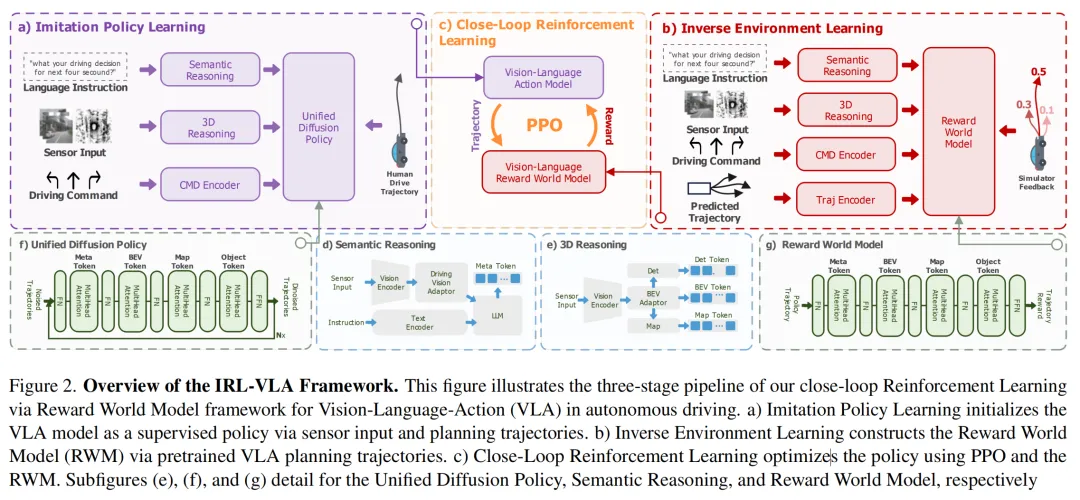
论文标题:IRL-VLA: Training an Vision-Language-Action Policy via Reward World Model for End-to-End Autonomous Driving
提出时间:2025.08
提出机构:清华大学AIR研究院、上海交通大学、博世企业研究所、上海大学等
论文链接: https://arxiv.org/pdf/2508.06571
研究背景:当前基于视觉-语言-动作(VLA)的端到端自动驾驶模型大多采用开环模仿学习,虽能复现数据中的驾驶行为,但易受数据分布限制,难以应对多目标(安全、效率、舒适等)与多模态(多种合理驾驶策略)的真实驾驶场景。闭环强化学习虽能通过环境交互提升策略,却严重依赖高保真传感器仿真,面临仿真-现实域差异大、计算开销高昂的瓶颈。因此,如何在不依赖重型仿真的前提下,实现VLA模型在闭环环境中的高效、稳定训练,成为推动其走向实际应用的关键难题。
论文内容:本文提出 IRL-VLA,一种基于逆强化学习奖励世界模型的闭环强化学习框架,用于训练端到端自动驾驶VLA策略。该框架采用三阶段训练范式:
Step 1: 模仿策略学习:设计一个包含语义理解、三维几何推理与统一扩散规划器的VLA模型,并通过模仿学习进行预训练,建立基础驾驶行为理解。
Step 2: 逆环境学习:构建轻量级奖励世界模型(RWM),通过逆强化学习从多样化的策略轨迹中学习多目标奖励函数(如碰撞避免、道路合规、舒适性等),替代传统仿真器进行高效奖励计算。
Step 3: 闭环强化学习:利用RWM提供实时奖励信号,基于近端策略优化(PPO)对VLA策略进行微调,使其在安全、效率与舒适性等多目标间取得平衡,同时通过保留部分模仿损失避免策略退化。
实验表明,IRL-VLA在NAVSIM v2闭环驾驶基准上取得领先性能(EPDMS 74.9),并在CVPR 2025自动驾驶大挑战中获得亚军。该框架首次实现了不依赖仿真器的、包含传感器输入的闭环VLA强化学习,为自动驾驶VLA模型的实用化训练提供了可扩展、高效的解决方案。
DriveVLA-W0
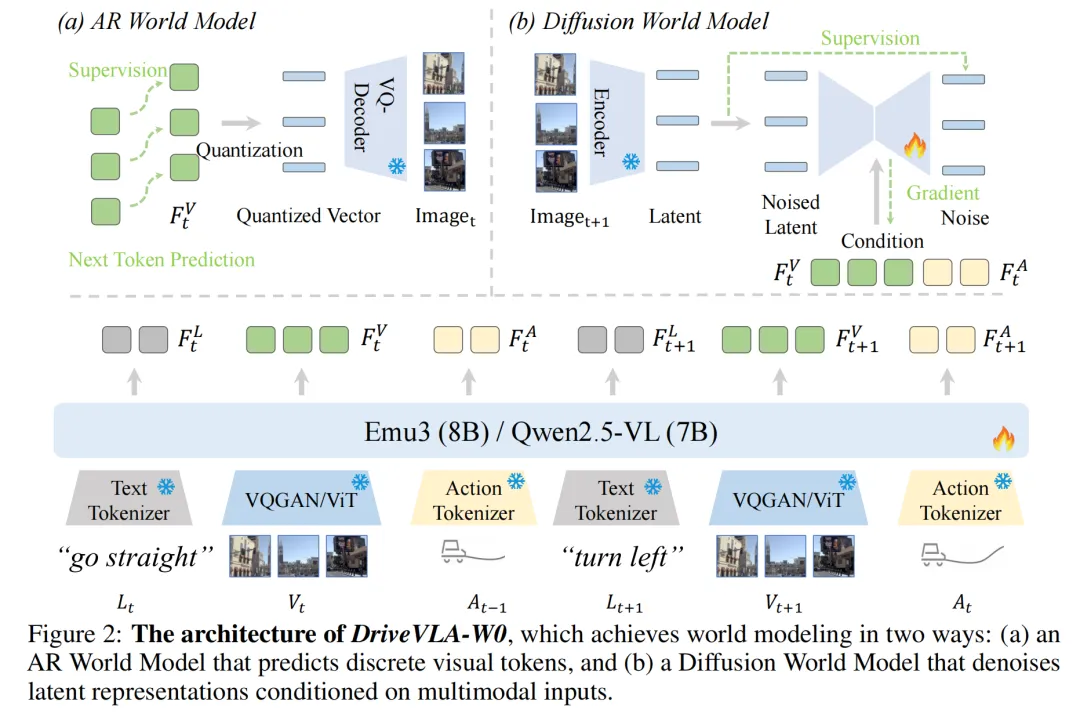
论文标题:DriveVLA-W0: WORLD MODELS AMPLIFY DATA SCALING LAW IN AUTONOMOUS DRIVING
提出时间:2025.10
提出机构:中国科学院自动化研究所等
论文链接: https://arxiv.org/pdf/2510.12796
研究背景:自动驾驶领域长期依赖基于鸟瞰图(BEV)的专用模型,这类模型虽在特定任务上有效,但其依赖几何先验、架构紧凑的特点限制了从非驾驶数据中学习与大规模扩展的能力。近年来,视觉-语言-动作(VLA)模型凭借其庞大的参数量与从互联网规模数据中预训练获得的基础能力,被视为实现更通用驾驶智能的有望路径。然而,VLA模型面临一个根本性瓶颈:其巨大的模型容量仅由极其稀疏、低维的专家动作信号进行监督,形成严重的“监督不足”。这导致模型无法充分学习丰富的世界表征,其扩展潜力远未发挥,甚至在有限数据下可能表现不如更小的BEV模型。
论文内容:本论文提出 DriveVLA-W0,一个通过世界建模来解决VLA模型“监督不足”问题的创新训练范式。核心思想是将未来图像预测作为一项密集的自监督任务,迫使模型学习驾驶环境的动态与因果规律。论文针对两类主流VLA架构设计了对应的世界模型:对于使用离散视觉令牌(如Emu3)的模型,提出了自回归世界模型,以预测未来图像的视觉令牌序列;对于使用连续视觉特征(如Qwen2.5-VL)的模型,则提出了扩散世界模型,在隐空间内生成未来帧。这种密集的视觉监督与原始的动作监督联合优化,显著提升了模型的表征能力。
大量实验验证了该范式的优越性。在NAVSIM v1/v2基准测试上,DriveVLA-W0仅使用单目前置摄像头,即超越了依赖多摄像头和激光雷达的BEV与VLA基线模型,刷新了最优性能。更重要的是,在一个包含7000万帧的大规模内部数据集上的实验表明,该方法能放大数据扩展定律——即随着训练数据量增长,模型性能的提升速度加快,这是单纯增加动作监督数据无法实现的。此外,为满足实时部署需求,论文引入了一个基于混合专家(MoE)的轻量级动作专家,将推理延迟降低至基线VLA的63.1%。利用此框架作为测试平台,论文揭示了一个“性能逆转”现象:在小规模数据上表现优异的复杂流匹配解码器,在超大规模数据下,其性能会被更简单的自回归解码器反超,这为大规模驾驶模型的动作解码器设计提供了关键洞见。
WM-MoE
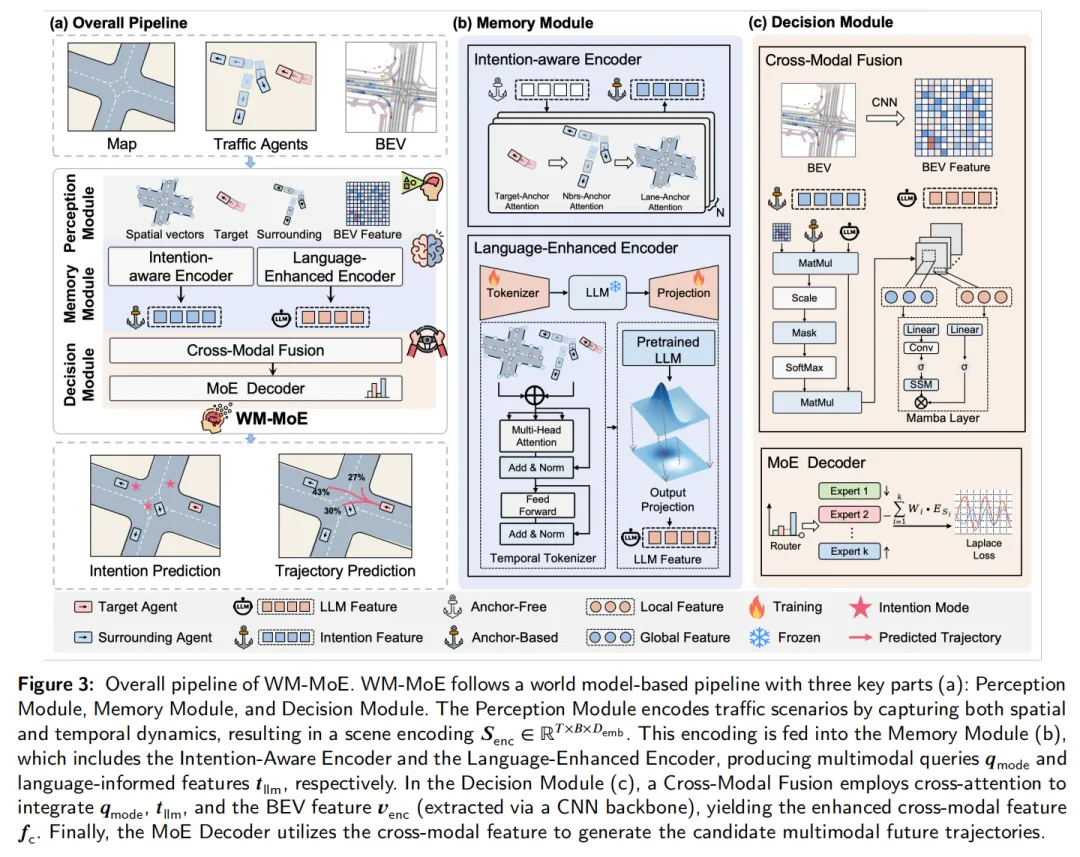
论文标题:Addressing Corner Cases in Autonomous Driving: A World Model-based Approach with Mixture of Experts and LLMs
提出时间:2025.10
提出机构:麻省理工、夏威夷大学、澳门大学等
论文链接: https://arxiv.org/pdf/2510.21867
研究背景:自动驾驶车辆的运动预测模型在常规场景下已取得显著进展,但其安全部署的核心瓶颈在于对罕见但高风险的“极端案例”的处理能力。这类场景(如紧急避让、复杂路口交互、突然制动)在现实数据中呈长尾分布,导致模型训练严重不均衡。现有解决方案,如数据重采样、代价敏感损失函数或对比学习,往往陷入“顾此失彼”的困境:提升极端案例性能的同时,常伴随常见场景预测精度的下降。此外,模仿学习等方法易受分布偏移影响,缺乏真正的因果推理能力。因此,如何构建一个能够像人类驾驶员一样,通过内部世界模型理解和推理复杂、罕见场景,并能同时兼顾常见与罕见场景性能的预测框架,成为提升自动驾驶系统安全性与可靠性的关键挑战。
论文内容:本文提出了首个基于世界模型,并融合专家混合网络与大型语言模型的运动预测框架——WM-MoE,目的是在系统性解决自动驾驶中的极端案例难题。该框架仿照人类认知机制,构建了由感知、记忆、决策三大模块组成的结构化世界模型。感知模块整合车辆历史轨迹、高清地图及鸟瞰图信息,编码为紧凑的时空场景表示。记忆模块是其核心创新之一,它通过一个轻量级时序分词器将轨迹数据映射到冻结的LLM(如GPT-2)特征空间,无需微调即可注入交通规则、社会常识等先验知识,从而增强了模型的长期推理与上下文理解能力。决策模块则引入了MoE架构,通过路由器将不同复杂度的场景动态分配给专门化的专家网络进行处理,实现了对常见模式的高效处理与对极端案例的专项优化。
作者还构建并发布了专注于极端案例的nuScenes-corner基准数据集。实验部分在nuScenes、NGSIM、HighD和MoCAD四个公开数据集上进行了全面验证。结果表明,WM-MoE不仅在整体预测精度上超越了现有先进方法,更在极端案例(如转弯、拥堵、急刹)和数据缺失的严苛条件下,展现出卓越的鲁棒性和泛化能力。消融研究进一步证实了LLM先验、时序分词器以及MoE架构各自的关键贡献。该工作为开发更安全、更适应真实世界复杂性的自动驾驶预测系统提供了新的有效范式。
FutureSightDrive
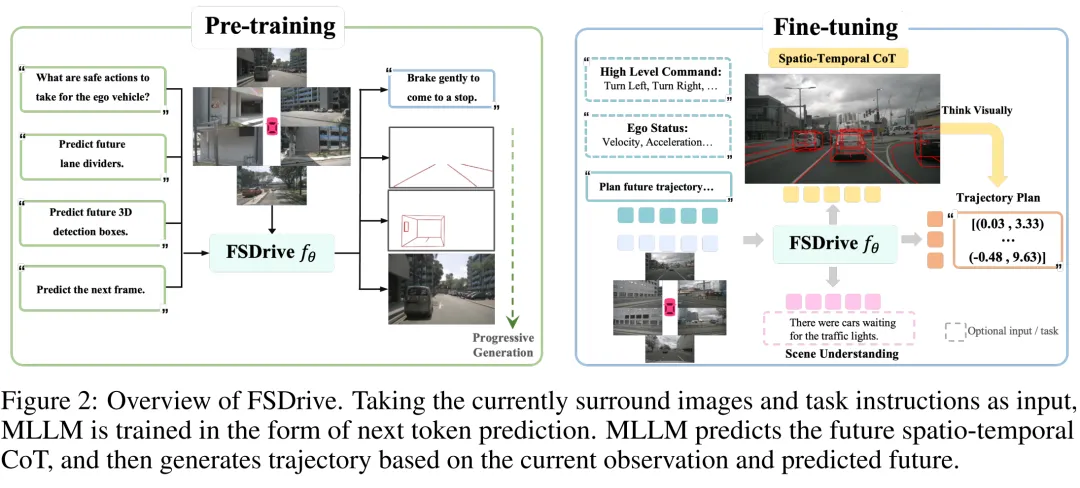
论文标题:FutureSightDrive: Thinking Visually with Spatio-Temporal CoT for Autonomous Driving
提出时间:2025.11
提出机构:西安交通大学、阿里巴巴集团达摩院等
论文链接: https://arxiv.org/pdf/2505.17685
研究背景:当前基于视觉-语言-动作(VLA)的端到端自动驾驶模型普遍采用文本链式思考(CoT)进行推理,但这将丰富的连续视觉信息压缩为离散的文本符号,导致空间-时间关系模糊、细粒度视觉细节丢失,造成感知与规划之间的“模态鸿沟”。这种符号化的推理方式难以支持对复杂动态驾驶环境的深度物理交互与前瞻性理解。人类驾驶员在规划时更倾向于在脑海中构建未来场景的视觉化表征,而非依赖语言描述进行推理。因此,如何让VLA模型像人一样进行“视觉化思考”,直接利用视觉表征进行时空推理,成为提升自动驾驶系统安全性、泛化性与可解释性的关键挑战。
论文内容:本文提出FSDrive,一个让VLA模型能够进行 “视觉思考” 的自动驾驶框架。核心创新是引入视觉时空链式思考(Spatio-Temporal CoT)作为中间推理步骤。具体而言,FSDrive首先充当世界模型,生成一个统一的未来帧,该帧不仅包含预测的背景,还叠加了具有物理合理性的先验信息(如未来车道线和3D物体框),从而在单一图像中同时编码时空关系。该生成的未来场景作为视觉CoT,为后续规划提供丰富的视觉推理依据。随后,同一VLA模型作为逆动力学模型,基于当前观测和此视觉CoT进行轨迹规划。
为实现上述能力,论文提出一种统一的预训练范式,通过扩展现有MLLM的词表融入视觉令牌,并联合优化语义理解(VQA)与未来帧预测任务。此外,设计了一种渐进式生成方法:先生成结构化先验(车道线、3D框)以强加物理约束,再在此基础上渲染完整场景,确保生成内容符合物理规律。
实验部分在nuScenes和NAVSIM数据集上验证了FSDrive在轨迹精度、碰撞率、未来帧生成质量(FID)以及场景理解(DriveLM)等方面的显著优势,表明其能够有效弥合感知与规划之间的模态鸿沟,推动自动驾驶向真正的视觉推理演进。
总结
内容大概就总结这么多,经过这阵子的调研,笔者觉得可能下一代自动驾驶的方向会沿着 VLA 和 World Model 融合的思路走下去,前者根据指令和当前状态做出初步决策 action,后者对该决策进行快速“推演”,预测结果并评估风险,再将信息反馈给 VLA 进行决策调整或生成解释。完整地形成一个“感知-推理-仿真-决策-解释”的增强闭环。工业界,华为鼓吹自己的 World Model 很牛,小鹏已经开始做所谓的 VLA2.0,前些日子,大家都在争论到底哪个方案才是终局,但其实两者并非水火不容,其实理想前一阵子的发布会也已经展示了这部分的理解,之后还会有多少玩家会陆陆续续入局呢?让我们拭目以待。
....
#Survey of General End-to-End Autonomous Driving
200多篇论文深度梳理!首个通用端到端自动驾驶(GE2E)综述发布,揭秘三大范式演进之路
自动驾驶的终极目标是构建一个能够无缝将原始传感器输入映射为驾驶决策的集成系统。为了克服传统模块化管道信息丢失和误差累积的局限性,也是为了追求更接近人类的驾驶智能,学术界和工业界正经历一场从模块化向数据驱动的端到端(End-to-End, E2E)范式的转变。
今天介绍的这篇综述论文来自上海交通大学AutoLab和滴滴出行Voyager研究团队。这篇论文通过对200多篇相关论文的全面梳理,首次提出了“通用端到端自动驾驶”(General End-to-End, GE2E)的概念,并系统性地将现有方法划分为三大范式:传统端到端(Conventional E2E)、以VLM为中心(VLM-centric E2E)以及混合端到端(Hybrid E2E)。
这篇综述不仅深入剖析了这三大范式的架构设计、学习策略和核心差异,还通过在nuScenes、CARLA、NAVSIM等主流基准上的横向对比,揭示了各范式的优劣势及未来潜力。如果你正深陷于自动驾驶技术路线的选择困难症中,这篇综述绝对是你的破局指南。
- 论文标题: Survey of General End-to-End Autonomous Driving: A Unified Perspective
- 机构: 上海交通大学, 滴滴出行
- 论文地址: https://www.techrxiv.org/doi/full/10.36227/techrxiv.176523315.56439138/v1
- 项目主页/代码仓库: https://github.com/AutoLab-SAI-SJTU/GE2EAD
什么是GE2E?三大范式一图看懂
论文首先定义了“通用端到端”(GE2E)的概念:无论架构中是否包含大语言模型(VLM),只要是通过单一整体模型将原始传感器输入处理为规划轨迹或控制动作的范式,都属于GE2E。
基于此,作者将现有技术路线清晰地划分为三类:
- 传统端到端(Conventional E2E AD):通过联合优化专门的模块(如感知、预测、规划)来直接映射输入到输出。它可以进一步细分为“纯规划(Planning-only)”和“多任务(Multi-task)”两类。
- 以VLM为中心(VLM-centric E2E AD):利用预训练大模型(VLM/LLM)的世界知识和推理能力,将多模态数据投影到语言空间进行决策,强调泛化性和可解释性。
- 混合端到端(Hybrid E2E AD):结合前两者的优势,既利用VLM的高层推理指导,又保留传统E2E的低层执行能力,形成“慢思考、快行动”的系统。
传统端到端:从黑盒拟合到多任务协同
传统E2E方法早期多采用简单的CNN网络直接回归控制指令(如ALVINN, P3),虽然缓解了误差传播,但往往缺乏可解释性且难以处理复杂场景中的多模态不确定性。为了解决这些问题,研究者们引入了多任务学习架构。
场景建模与理解
除了基本的感知任务,现代E2E模型更注重构建高效的场景表征:
- 稠密表征:如UniAD利用BEVFormer构建稠密BEV表征,但计算量大。
- 稀疏表征:SparseAD和SparseDrive直接对对象实例进行建模,显著降低了计算负担。
- 时空推理:GraphAD利用图模型描述交互,ReasonNet利用记忆库存储历史信息,增强对动态环境的理解。
轨迹生成策略
为了避免简单模仿学习带来的“因果混淆”和安全隐患,研究者提出了多种策略:
- 后处理优化:利用预测的占用网格(Occupancy)或成本函数优化轨迹。
- 概率规划:VADv2从概率分布中采样动作,DiffusionDrive利用扩散模型生成多模态轨迹,在NVIDIA 4090上实现了45 FPS的实时推理。
- 分层规划:CogAD模仿人类的“粗到细”认知机制,先进行意图规划再生成具体轨迹。
学习策略的进化
为了突破数据瓶颈,除了模仿学习(Imitation Learning),还涌现了多种高级策略:
- 知识蒸馏:LBC和Roach利用特权专家(Privileged Agent)指导学生模型。
- 强化学习:Drive in a Day引入RL进行探索,ReconDreamer-RL利用世界模型构建数字孪生进行大规模试错。
- 自监督学习:PPGeo和UAD利用大规模无标签数据进行预训练,UAD甚至实现了零3D标注下的SOTA性能。
VLM-centric:让自动驾驶拥有“认知大脑”
传统E2E模型因缺乏世界知识,在长尾场景(Corner Case)面前往往束手无策。VLM-centric范式试图通过引入大模型的推理能力来填补这一“认知鸿沟”。
视觉-语言对齐
核心挑战在于如何将驾驶场景的视觉特征映射到LLM的语义空间:
- 直接投影:使用MLP等轻量级投影器(如LMDrive)。
- 查询压缩:使用Q-Former等结构提取关键信息(如DriveMLM)。
- 任务驱动对齐:GPVL和Driving with LLMs设计了专门的预训练任务,将BEV特征或数值信息转化为LLM可理解的语言token。
推理与思维链(Chain-of-Thought)
VLM赋予了系统深度的因果推理能力:
- 结构化逻辑CoT:DriveLM和SimpleLLM4AD将驾驶任务分解为感知、预测、规划的问答链(Graph VQA),使决策过程透明化。
- 工具增强CoT:Agent-Driver让LLM作为调度器调用外部工具(如专门的规划器),结合了各种模型的长处。
- 动态CoT:AutoVLA根据场景复杂度动态调整推理深度,平衡效率与性能。
效率优化
针对VLM推理延迟高的问题,研究者提出了多种方案:
- 模型蒸馏:CoT-Drive将大模型的推理知识蒸馏到轻量级边端模型中。
- 结构优化:FastDrive通过结构化数据输入消除了冗余信息,实现了10倍的推理加速。
Hybrid E2E:强强联合的终极形态?
混合范式旨在融合VLM的“慢思考”与传统E2E的“快直觉”。
在线分层融合
- 规划层融合:VLM作为高层决策者生成“元动作”(如“向左变道”),指导传统E2E模型生成具体轨迹。DriveVLM实现了感知输出的双向验证和轨迹提示。
- 感知层融合:VLM-E2E利用VLM生成的注意力提示来增强BEV特征。
离线知识迁移(VLM辅助训练)
这种方式利用VLM作为“教师”在训练阶段指导E2E模型,推理时则仅使用E2E模型,实现了零推理成本的性能提升。
- 对齐与蒸馏:ALN-P3提出了全栈对齐框架,强制E2E模型的中间特征与VLM的语言表征一致,确保决策逻辑的合理性。
谁是王者?主流基准性能大比拼
论文在nuScenes、Bench2Drive、CARLA和NAVSIM等基准上进行了详尽的横向对比。
- nuScenes (Open-loop):传统端到端方法(如TTOG, UAD) 虽然占据了榜单前列的大部分位置,证明了其在数值轨迹预测方面的优势 ;但目前性能最佳的方法(Top 1)实际上属于混合端到端(Hybrid E2E)范式 。
- NAVSIM (Open-loop simulation):令人惊讶的是,传统端到端方法(如TransDiffuser) 在PDMS评分上甚至超过了人类驾驶员,展现了强大的潜力 。
- Bench2Drive (Closed-loop):尽管SOTA方法表现出了一定的鲁棒性,但Bench2Drive中最好的方法路网完成率仍未超过70% ,处理多样化和长程路线仍然是一个关键瓶颈。
- CARLA (Closed-loop):传统E2E方法在Town05 Long基准上仍占据主导地位,说明在需要精细操作控制的任务中,传统方法依然具有优势。
值得注意的是,ActiveAD仅利用30%的nuScenes数据就达到了全数据集的性能,凸显了在自动驾驶领域数据质量优于数量的重要性。
展望未来:通往AGI之路
论文最后指出了GE2E面临的四大挑战:长尾分布、可解释性、安全保证和实时效率,并提出了未来的四个关键研究方向:
- 强化学习(RL):从模仿学习转向RL,利用世界模型进行大规模低成本试错。
- 基础模型(Foundation Models):在海量通用数据上预训练,解决Long-tail问题。
- Agent系统:模仿人类大脑皮层和小脑的协作,构建分层的Agent体系。
- 世界模型(World Models):作为自监督学习的引擎,利用海量无标签视频数据驱动模型进化。
从传统E2E的精准控制,到VLM-centric的认知推理,再到Hybrid的融合之道,通用端到端自动驾驶正朝着更类人、更安全的方向加速演进。
....

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献28条内容

所有评论(0)