智能体间的“信任”难题——当 Agent A 需要评估 Agent B 的工作结果时,系统该如何设计?
一、问题本质:为什么“信任”在智能体之间如此困难?
当 Agent A 需要评估 Agent B 的结果时,困难并不在于“能不能看懂”,而在于:
-
目标不完全一致
-
B 可能在“表面完成任务”,但未满足隐含目标
-
B 可能在优化自己的奖励函数,而非系统整体目标
-
-
信息不对称
-
A 无法完整观察 B 的推理过程
-
B 可能使用了不可解释或私有模型
-
-
能力差异
-
B 可能比 A 更强(A 无法判断是否被“骗”)
-
或 B 更弱(但结果看起来“合理”)
-
-
评估本身也是一项任务
-
“判断是否正确”常常比“生成答案”更难
-
结论:智能体之间的“信任”不能依赖主观判断,而必须被“系统化、结构化、可验证”。
二、系统设计目标:我们希望“信任”具备什么特性?
一个良好的 Agent 信任机制,应满足:
-
可验证性(Verifiable)
-
可解释性(Explainable)
-
可追责性(Accountable)
-
抗投机性(Robust to Gaming)
-
可扩展性(Scalable)
三、核心设计思路(从“相信”转向“验证”)
✅ 关键转变:不是“Agent A 是否信任 Agent B”,而是“系统是否能验证 B 的结果”
下面是几种核心机制。
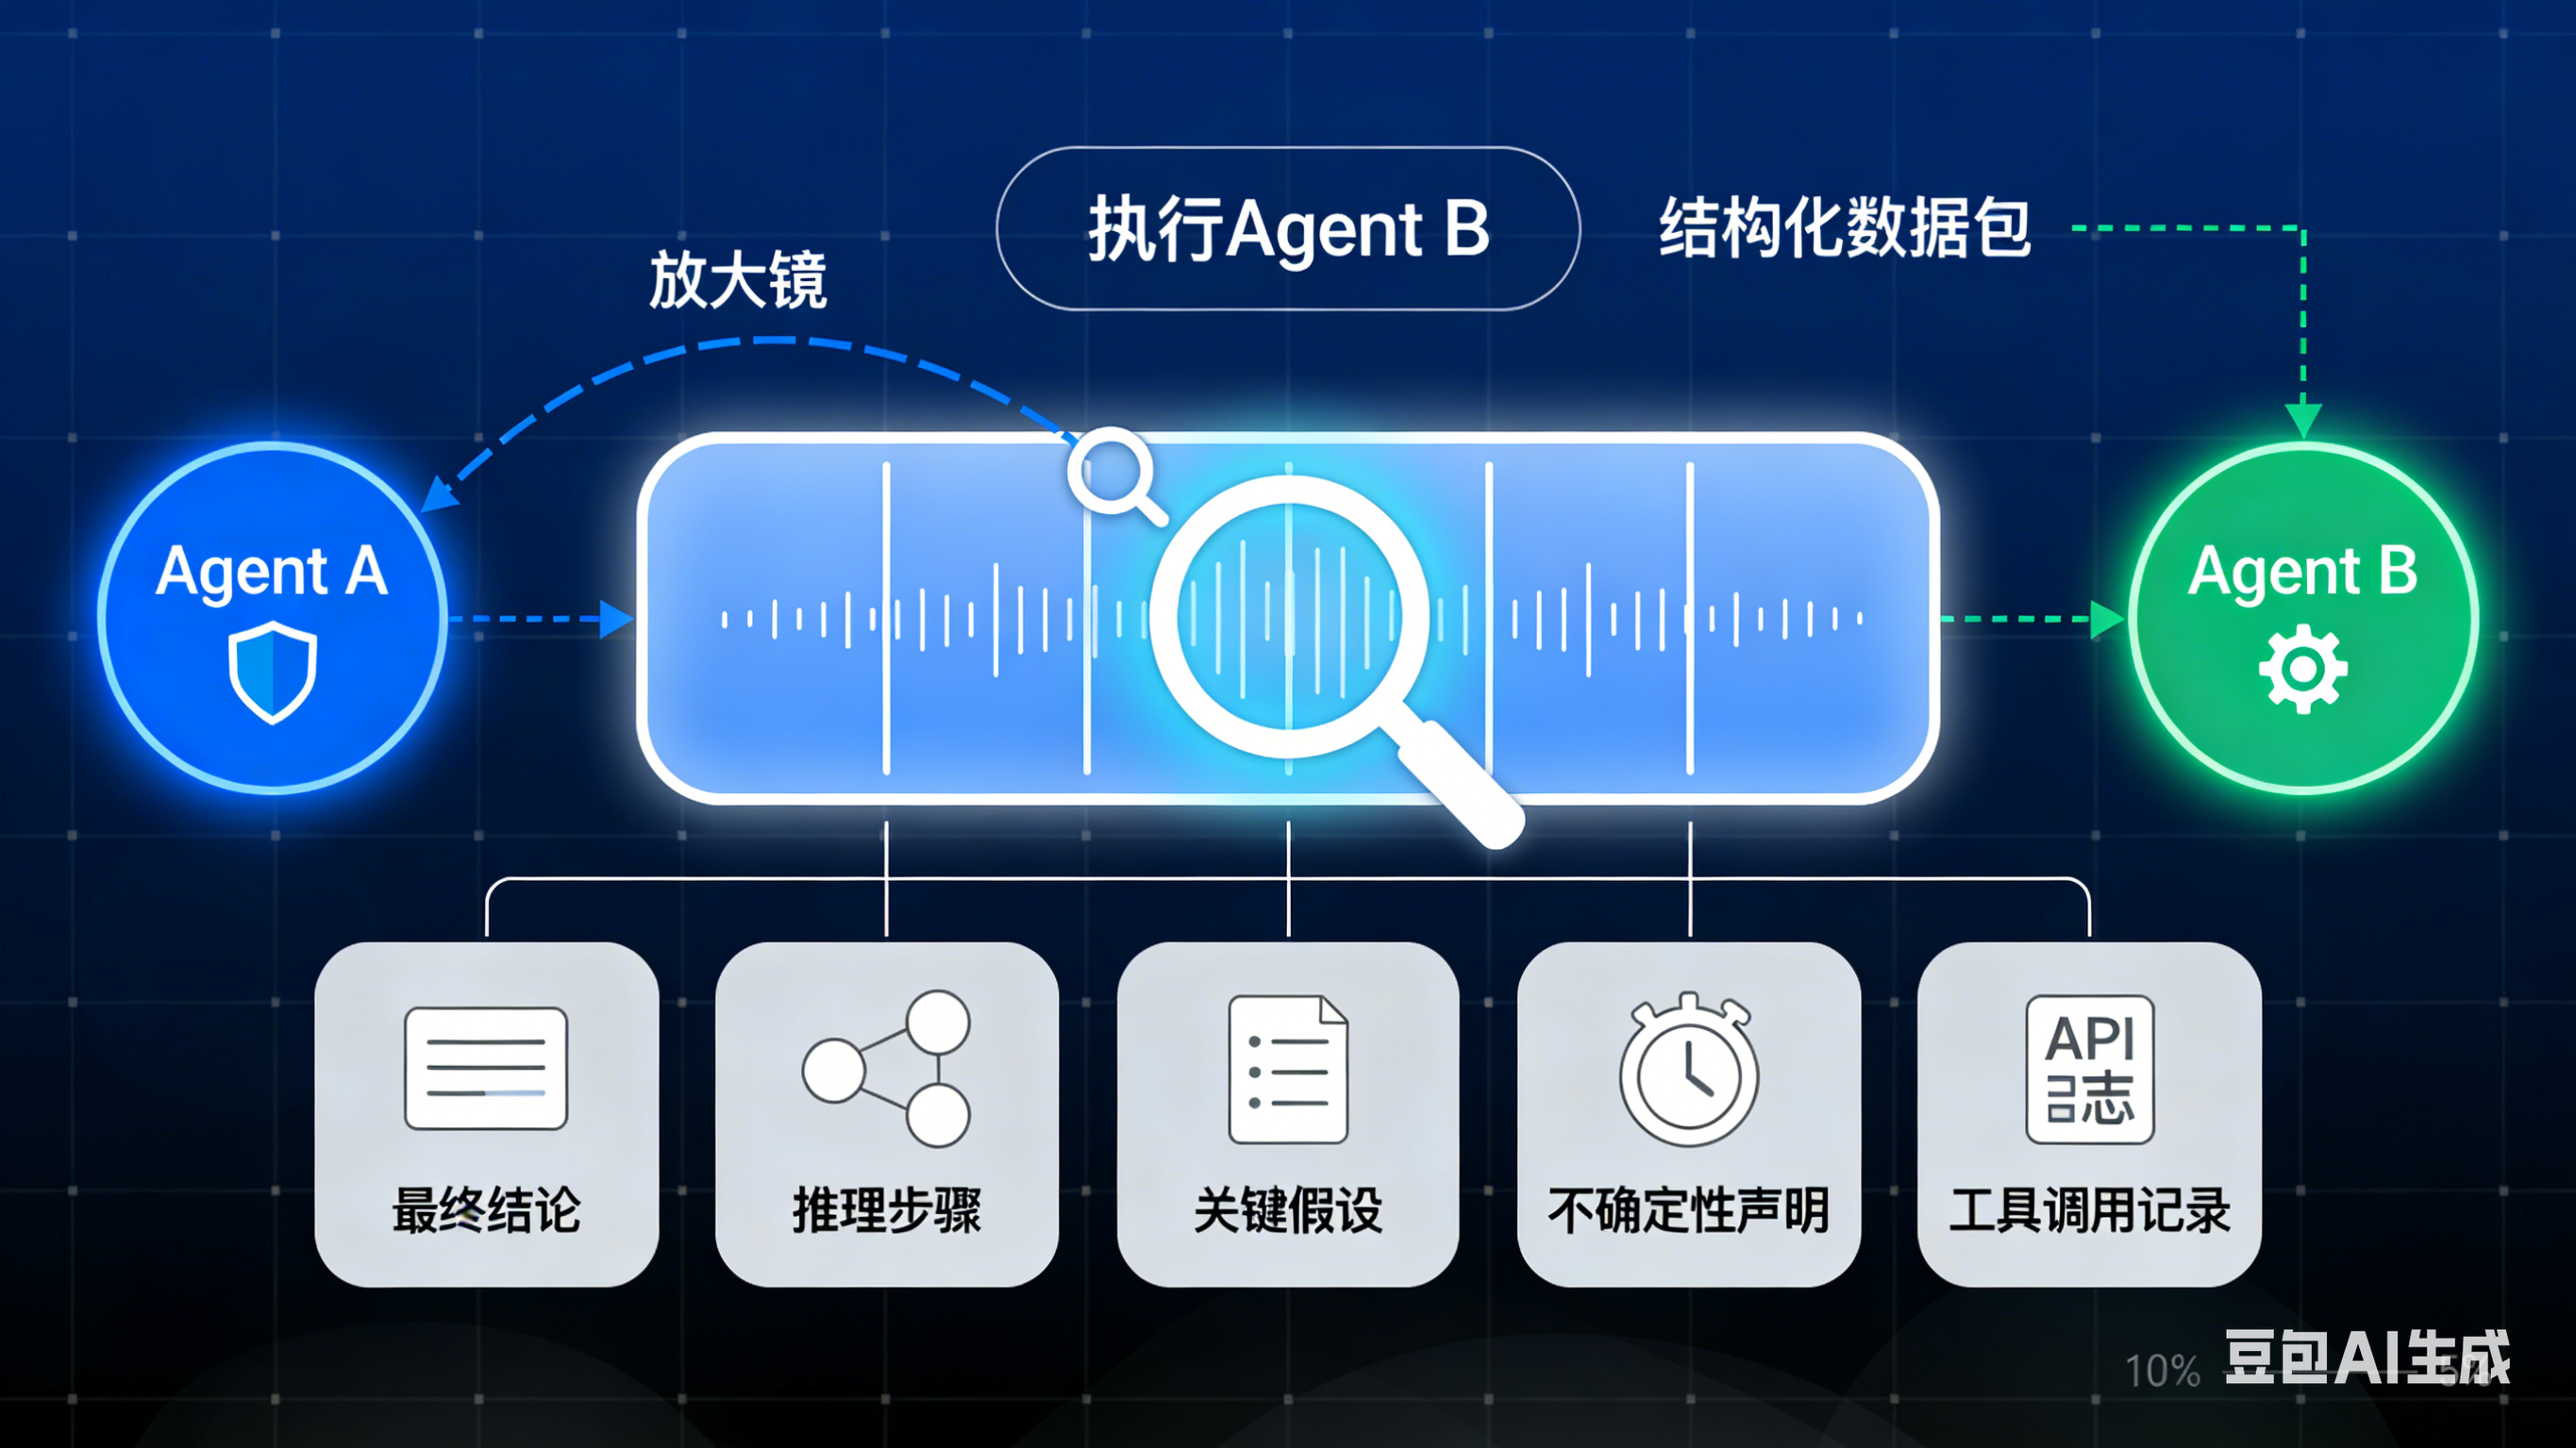
关键机制一:结果 ≠ 结论,而是「结构化产物」
1️⃣ 强制输出结构化结果
Agent B 的输出不只是答案,而包括:
-
✅ 最终结论
-
✅ 中间推理步骤(或可验证摘要)
-
✅ 使用的假设
-
✅ 不确定性声明
-
✅ 可复现的工具调用记录
📌 这使得 Agent A 可以:
-
检查逻辑一致性
-
验证假设是否合理
-
定位错误来源
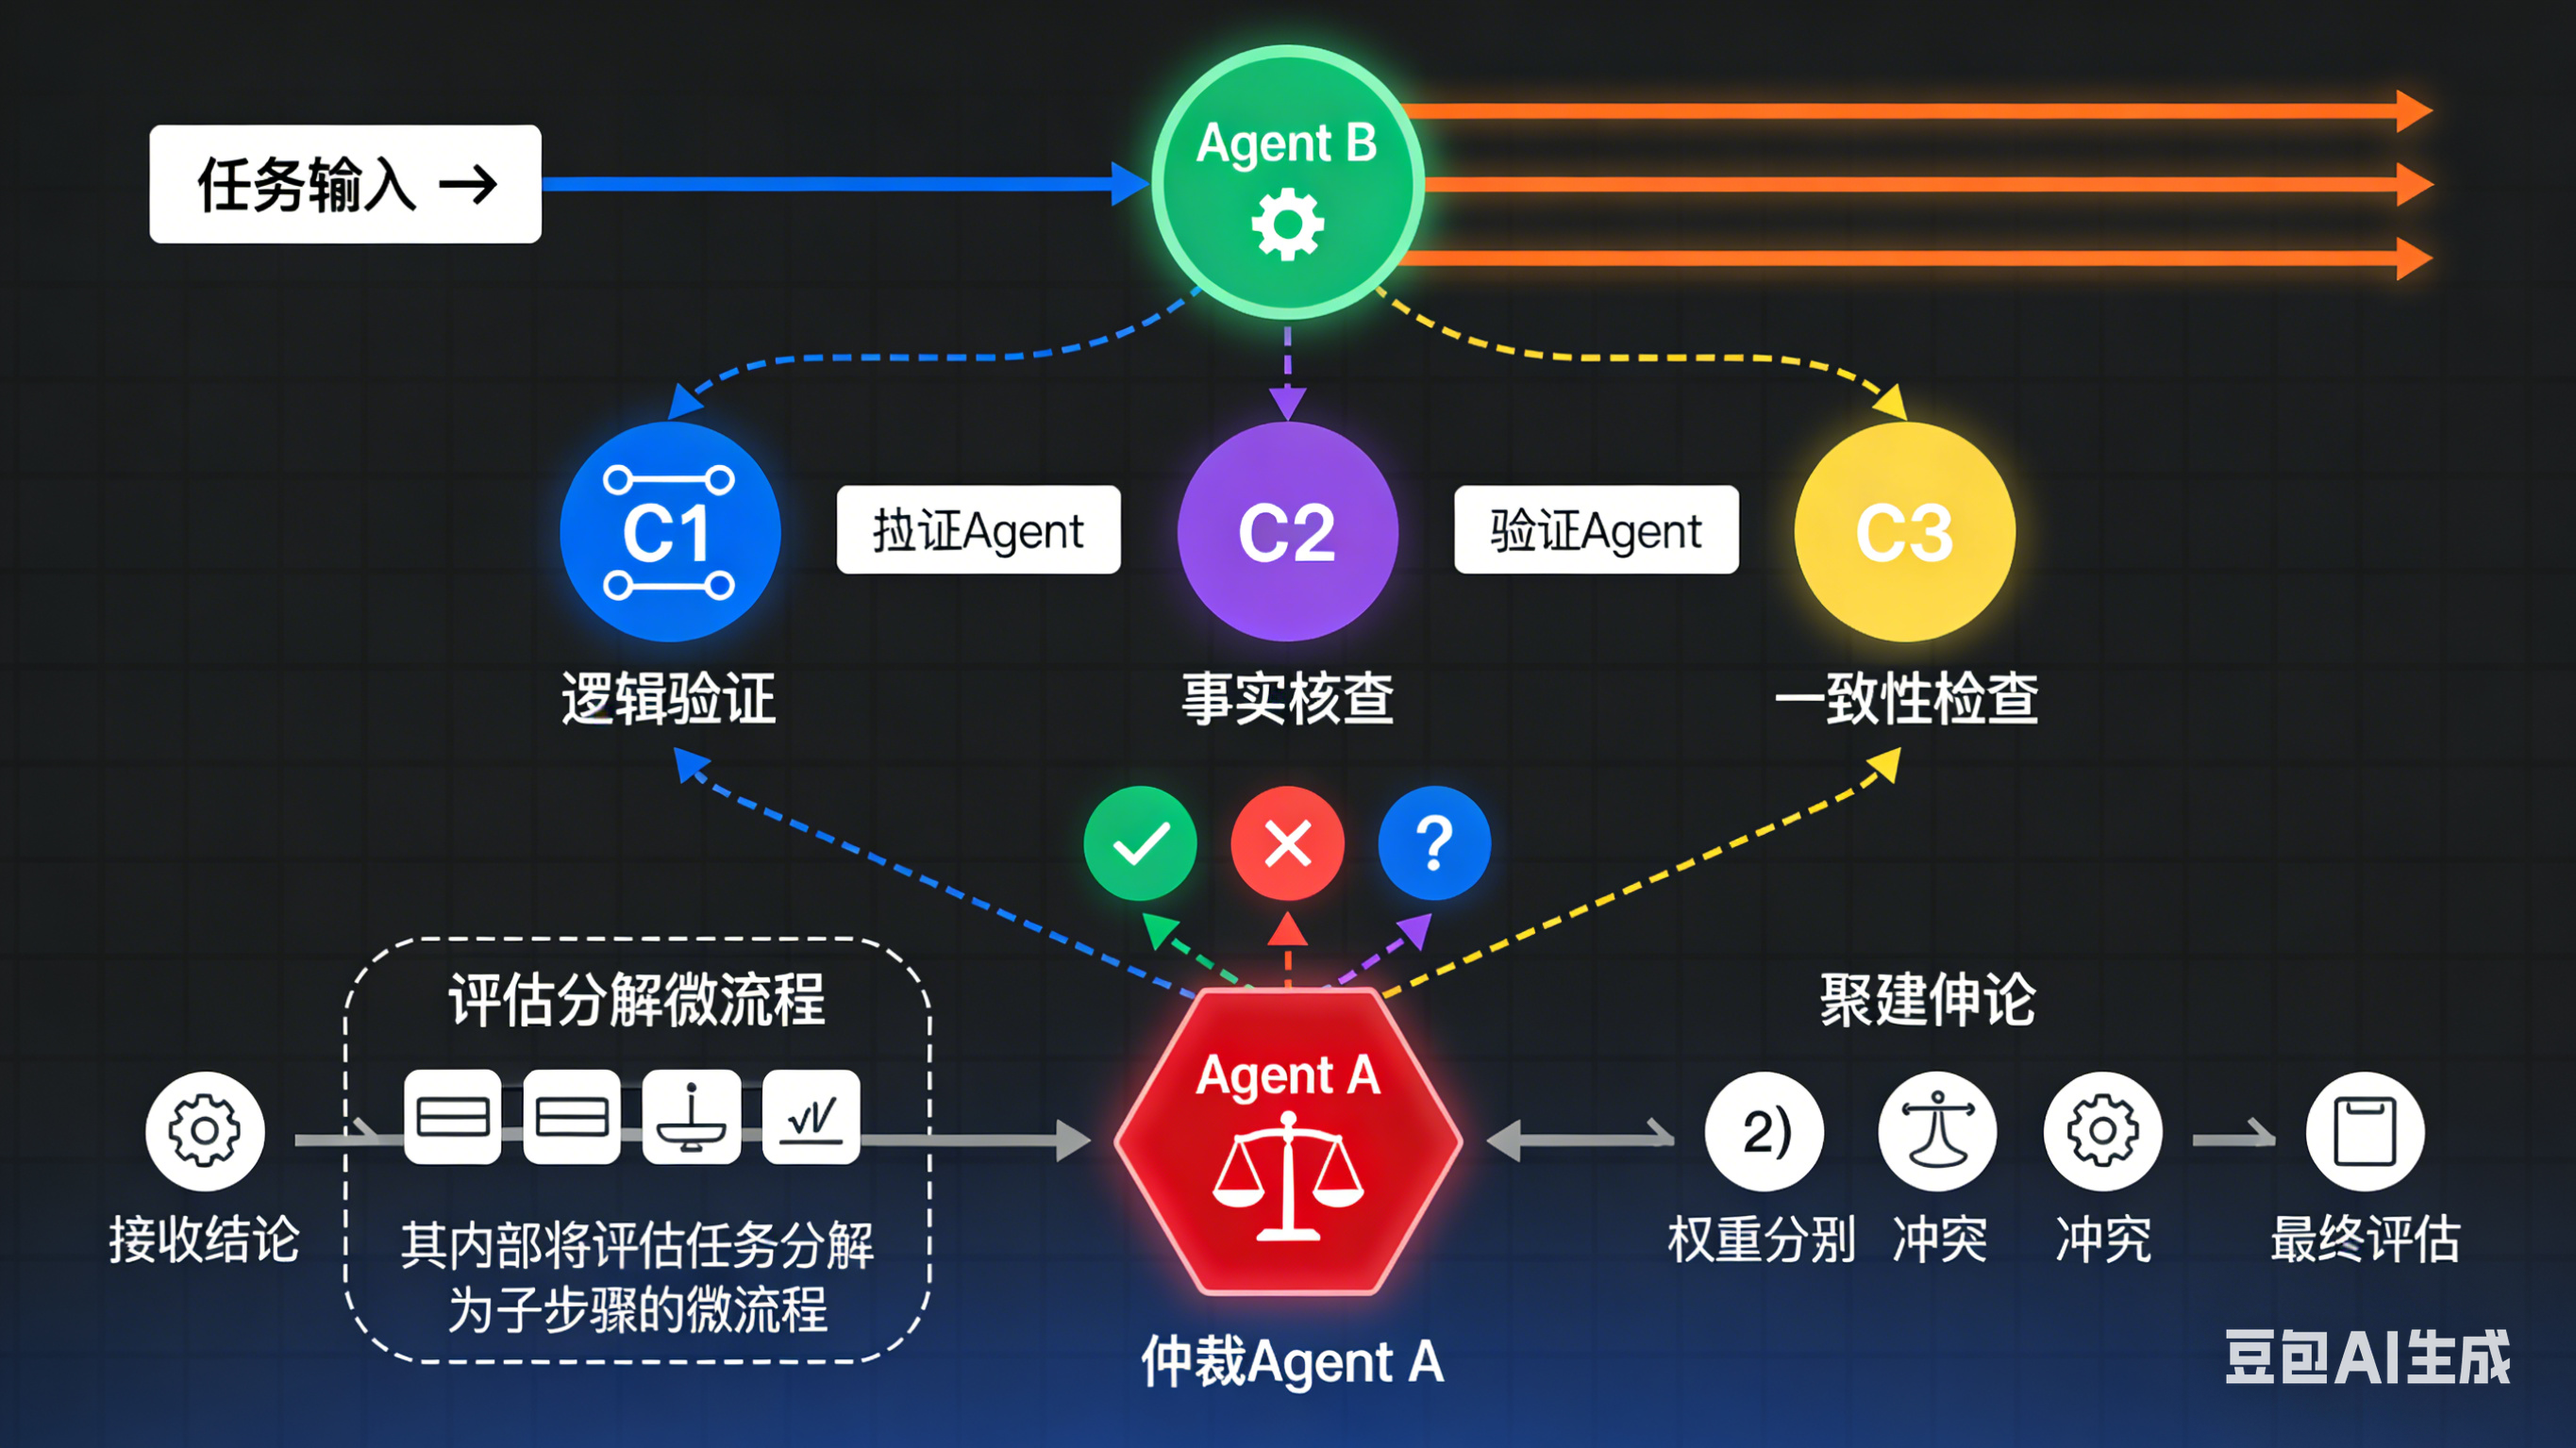
关键机制二:多智能体交叉验证(Agent Redundancy)
2️⃣ 不让 A 只信任 B,而是多智能体验证
B1 → 结果1
B2 → 结果2
B3 → 结果3
    ↓ A(或仲裁 Agent)
-
若多个独立 Agent 给出一致结论 → 信任度提升
-
若分歧显著 → 触发深入审查
类似于:学术同行评审,分布式共识
关键机制三:将“评估”拆成多个子任务
3️⃣ 不让 Agent A “整体判断对错”,而是:
表格 还在加载中,请等待加载完成后再尝试复制
评估本身是一个多 Agent 协作过程,目标分解后,由专业的Agent单独进行评估,增加准确率。
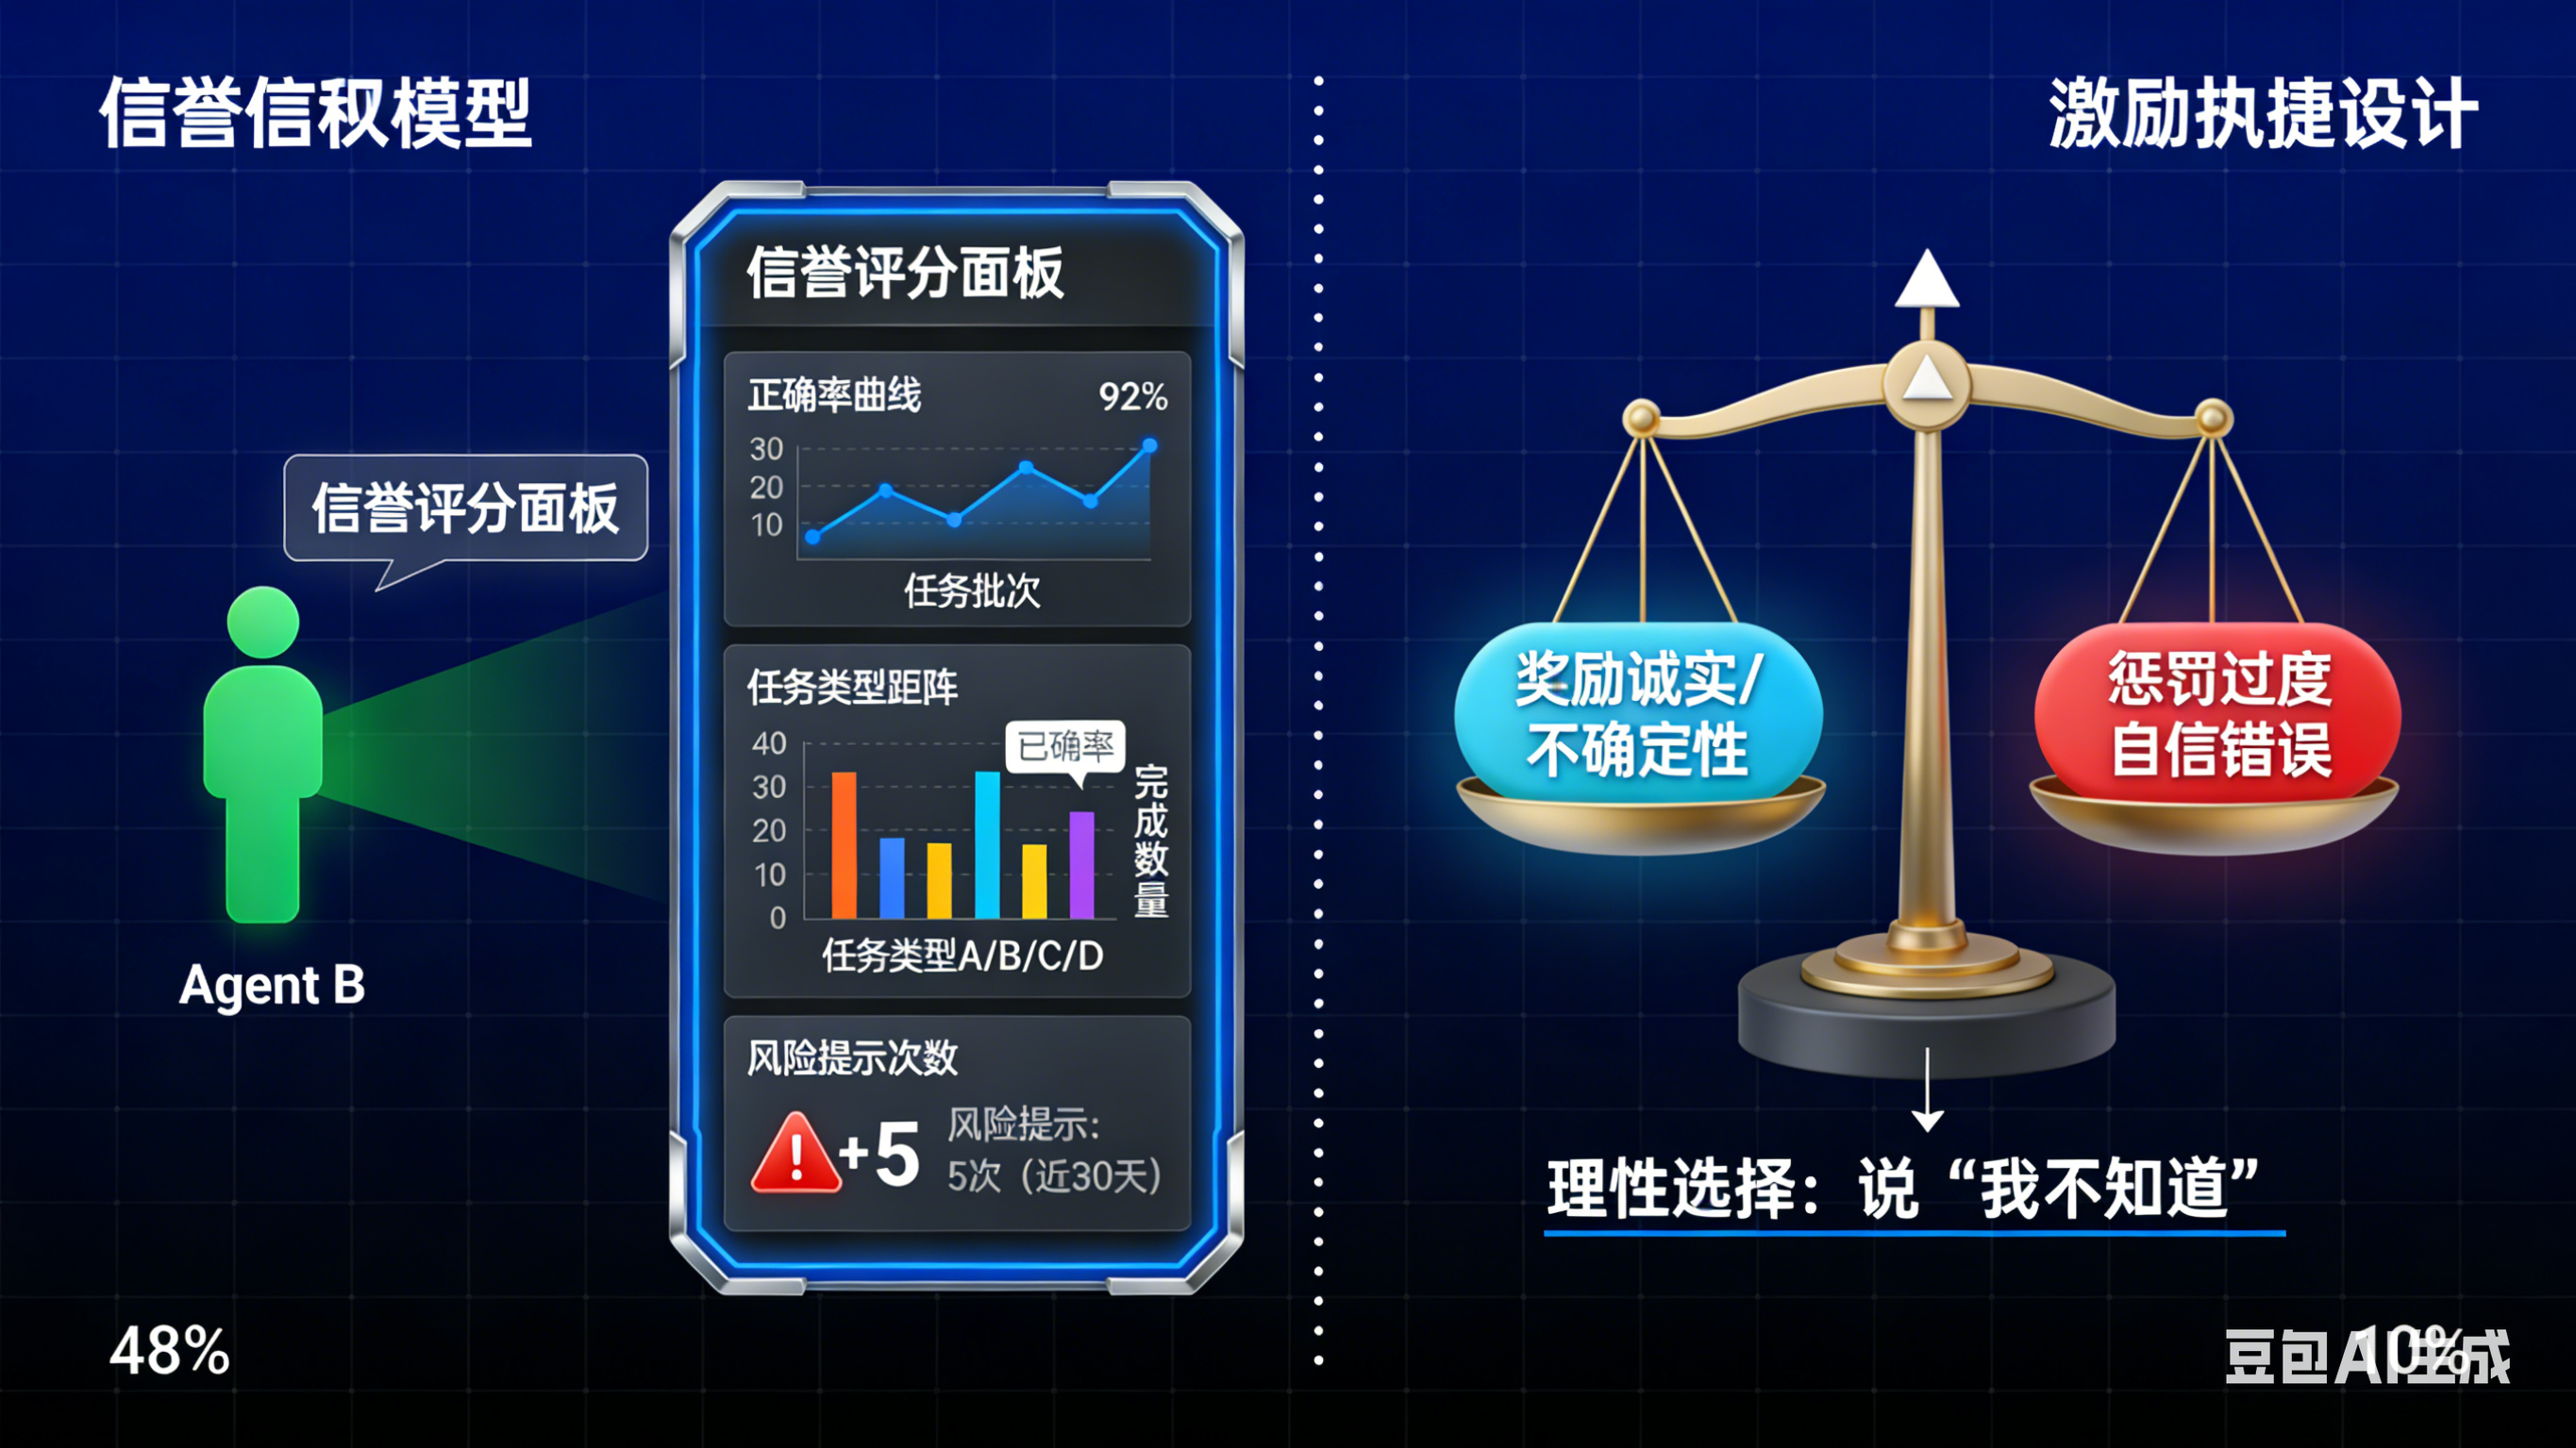
关键机制四:基于历史的“信誉系统”
4️⃣ 为 Agent B 建立动态信誉模型
-
正确率
-
被推翻次数
-
在不同任务类型下的表现
-
对失败的自我校正能力
示例:
Trust(B) = f(历史表现 × 任务相似度 × 不确定性声明质量)
信任不是二元(信 / 不信),而是概率分布
关键机制五:激励与约束设计
5️⃣ 防止 Agent B “投机取巧”
-
奖励 诚实表达不确定性
-
惩罚 过度自信但错误
-
鼓励 自我反驳与风险提示
✅ 让“说我不知道”在系统中是理性选择
四、一个典型的系统架构示例
任务输入
↓ Agent B(执行者)
↓ 结构化输出 + 证据
↓ 多个验证 Agent(C/D/E)
↓ 仲裁 Agent A(综合判断)
↓ 信任评分 + 决策
人类社会早已这样做,智能体信任机制,本质上是在“自动化”人类已有的制度:
表格 还在加载中,请等待加载完成后再尝试复制
在多智能体系统中,信任不是情感,而是架构;不是判断,而是机制。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)