51c自动驾驶~合集61
我自己的原文哦~ https://blog.51cto.com/whaosoft143/13993588
#谁杀死了毫.末智.行?
毫x末曾是长城智驾自研的排头兵,魏建军亲自背书、资本热捧、订单不断。但当跳票、内耗与路线失误不断累积,这家含着「金汤匙」出生的公司,最终走到了落幕的时刻。
2024年6月的一天,保定的天气已经开始闷热,长城汽车纪委办公室收到了一封来自北京的举报信。
举报人是长城旗下子公司毫x末智x行的一名员工,信中举报一名年薪近百万的销售简历造假,并揭露毫x末存在违规招聘行为。
这封举报信很快传到了长城汽车董事长魏建军的手里。让魏建军震怒的,并不只是毫x末x智行内部管理的混乱,更在于一个他难以接受的事实——毫x末北京、上海的研发团队,长期未向保定团队共享软件源代码,此事成为毫x末失去长城信任的导火索。
此后,长城将目光转向元戎、卓驭、Momenta等公司。2024年11月,搭载端到端方案的魏牌蓝山上市,后续这一方案又接连上车坦克、欧拉品牌等多款车型。
2024年广州车展上,长城汽车展台只展出一款车型——23台首次搭载端到端智驾的魏牌蓝山,魏建军希望通过此举让外界看到长城对智驾的重视。他曾说:“我们既然能做好动力、底盘和车身,就同样能做好智能。”
2025年12月22日,长城汽车量产VLA大模型,首搭魏牌蓝山智能进阶版,长城成为国内唯二有能力量产VLA的车企,另一家是理想。
一份证券报告显示,2025年前三季度,长城汽车L2++(城市NOA)渗透率达19.9%,位居传统车企第一。作为比较,同期比亚迪为6.1%,吉利则为11.6%。
长城智驾能力突飞猛进的背后,毫末x智行的处境却愈发尴尬和艰难。
PART 1
含着金汤匙的毫x末x智行
毫末智x行成立于2019年11月29日,是保定长城控股集团成员。根据股权穿透,长城汽车董事长魏建军是毫末智x行实际控制人,受益股份约37%。
毫x末智x行的前身是长城汽车技术中心的智能驾驶前瞻部,大约从2019年开始,国内大集团上市公司掀起拆分业务潮流,目的是让上市公司的主业更清晰。
当时,魏建军的思路是借鉴全球汽车巨头的模式——丰田、通用、现代等公司专注整车,而零部件业务独立运作。他希望毫x末智行也能独立成长为全球化零部件公司,而长城汽车则专注整车业务。
毫x末x智行成立之初,正是长城汽车的发展向上阶段。
2020年,长城汽车全年销量达到111.16万辆,同比增长4.8%,连续第五年突破百万辆,不仅稳住基本盘,还以109%的完成率超额兑现年度目标。
业绩向上的同时,长城汽车在智能化层面频频抛出高举高打的战略规划。2020年底,长城发布智能驾驶“331”战略,提出用三年时间实现用户规模行业第一、用户体验评价最好、场景功能覆盖最多的三个领先,目标成为智能时代自动驾驶的领导者。
长城汽车董事长魏建军
按照规划,长城汽车将在2021年实现中国首个全车冗余的L3级能力自动驾驶、中国首个配置激光雷达的自动驾驶、具有NOH能力的自动驾驶。
进入2021年中期,长城汽车又进一步加码,发布“2025战略”,提出到2025年实现全球年销量400万辆,其中新能源汽车占比达到80%,营业收入突破6000亿元,
业绩兑现与宏大战略持续叠加,迅速点燃资本市场情绪。自2020年起,长城汽车股价进入快速上行通道,A股股价由不足10元/股一路攀升,在2021年10月前后触及约68元/股,成为当年中国资本市场最具代表性的汽车板块超级牛股之一。
股价飙升点燃了魏建军想要在资本市场上大展拳脚的热情。
雷峰网《新智驾》了解到,在那一阶段,魏建军的思路颇为激进——几乎所有关键能力都希望掌握在自己手中。长城汽车不仅拆分成立了很多Tier 1,甚至连更上游的碳化硅生产炉子都要自己造。
与之配套的,是一场自上而下的“内部创业运动”。彼时,长城汽车鼓励内部高管走向台前创业,由集团在从0到1的早期阶段提供启动资金,先让项目跑起来;与此同时,通过高薪方式从外部市场集中引入大量专业人才,加速团队搭建。
在这一背景下,那时候内部一度并行推进20多个创业项目,项目以融资为目标。
投资人王强告诉《新智驾》,和比亚迪创始人王传福偏保守风格不同(多数独立子公司不开放融资),魏建军在资本运作上较为激进。“彼时吉利在资本运作层面走在前列,长城汽车内部有团队专门研究吉利的各种商业模式。”
往后发展,长城汽车内部孵化的创业项目开始明显“走偏”。只有少数项目在产业逻辑上相对成立,尚能引起投资人兴趣,例如线控制动、线控转向等方向;但更多项目则难以获得资本认可,如空调压缩机、音响等,既缺乏技术壁垒,也难以讲清楚独立成长的故事。
长城汽车的逻辑是,既然连汽车整车都能制造,那其他零部件、环节也自然没有做不到的。
但这些内部孵化的项目一个个都需要资源投入,也都需要时间发展。由于尚未形成规模化效应,它们普遍处于亏损状态。
据王强透露,这些项目同时争夺有限资源,而长城汽车又无法全部满足,内部随之出现抢占资源的现象。最终,不可避免地需要取舍:重要项目继续获得资源支持,不重要的项目资源则逐步收紧。结果是,一部分项目被边缘化甚至放弃。
最后,只有少数几个项目在融资层面取得突破,包括蜂巢能源、毫末智行、极电光能、未势能源。
毫末智行正是在长城汽车大扩张的背景下迎来短暂的蜜月期。
除了长城汽车之外,比亚迪拆出了弗迪电池和比亚迪半导体,后来还成立了光伏公司;吉利旧部张林在稍早几年前成立了智能驾驶解决方案公司福瑞泰克,获吉利的资本以及业务支持;后来奇瑞汽车也乘着这股东风成立了大卓智能。
当时还有两个行业背景。
一是始于2016年的自动驾驶投资热潮到2019年出现降温,自动驾驶烧钱多而短时间内又看不到成果,是很多大公司的共识。
二是汽车行业的竞争从2018年之后转向智能化的下半场,具备智能驾驶能力被普遍视为赢得市场竞争的关键。
一位知情人士透露,长城汽车当初选择将毫末智行独立发展,主要基于两方面考虑:其一,自动驾驶研发投入巨大、周期漫长,短期内难以看到回报,可能会影响其作为上市公司的财务报表;其二,在汽车产业竞争加速向智能化演进的背景下,长城汽车认为自身必须掌握智能驾驶能力。
内部员工李伟告诉《新智驾》,魏建军向投资人表示,今后大家共同管理毫末智行,长城汽车出人、出技术,也管业务方向给订单。
毫末智行高管合影(由左至右):CIO甄龙豹、CEO顾维灏、董事长张凯、COO侯军
魏建军还表示:“如果大家认我、认长城这块招牌,请相信我会把毫末智行经营好;经营好,大家一起发财;如果没有经营好,长城汽车也会兜底。”
2021年12月,毫末智行宣布获得A轮融资近10亿元,投资方为美团、高瓴创投、高通创投、首程控股、九智资本等。
多位投资人表示,大家投资毫末智行与投资Momenta、元戎启行等公司的逻辑完全不同。
不同于Momenta创始人曹旭东和元戎启行创始人周光对公司有着绝对控制权。据公开报道,以张凯和顾维灏为首的毫末智行管理层持股比例较低,合计不超过12%,而管理层的持股比例对公司决策和发展有着决定性作用。
投资人张磊表示,“一个持股比例仅有10%出头的管理层,很难对一个公司起决定性作用。这是毫末智行的症结所在。”
天眼查显示,毫末智行董事会成员中,除CEO顾维灏及另外两位投资人外,其余均为长城系高管,包括魏建军、张凯、穆峰和吴会肖;监事付诚及财务负责人楚浩然也来自长城汽车。
魏建军本人加上长城汽车持股比例超过50%,董事会由长城汽车控制,公司核心决策、经营审批及财务均由长城系高管掌握。
张磊无奈地表示:“这个时候长城汽车对外说毫末与自己无关,我觉得很可笑。”
据多位投资人反映,机构投资毫末智行的逻辑,就是奔着魏建军本人去的。2019年开始长城汽车拆分了很多公司,当时魏建军给出的承诺是:第一,这是长城汽车的身家;第二,长城汽车还要在这个市场上干几十上百年,这些公司长城都会兜住底线。
毫末智行成立后,长城汽车如承诺一样给予了毫无保留的支持。
当时,长城汽车的智能驾驶负责人是张凯。魏建军将张凯及长城体系中负责智能驾驶的团队,以及所有相关知识产权都划入了毫末智行。同时,长城汽车表示,将不再自行研发智能驾驶,相关工作全权交由毫末智行负责。
彼时,毫末智行可谓是长城汽车名副其实的“亲儿子”。
此外,为了增添毫末智行的科技元素,魏建军又从百度邀请当时百度智能汽车事业部负责人顾维灏加盟,出任毫末智行CEO。
由此,毫末智行的管理架构形成“双领导制”,张凯和顾维灏都参与决策,而且制度上未设CTO。这一不同寻常的管理架构,为毫末智行此后的发展埋下隐患。(为什么要设置双领导制,又为什么没有CTO,其中内幕欢迎添加作者微信 jinyuan-0428 交流)
PART 2
毫末的屡次跳票
在获得魏建军关于毫末智行可独立发展的承诺后,顾维灏将自己在百度任职时期的思考,投入到毫末智行的发展实践中。
顾维灏上任后,为毫末智行规划了至今仍相当前瞻的战略路线,业务主要覆盖三大方向:乘用车辅助驾驶、末端物流配送以及智能硬件。
内部员工刘洋告诉《新智驾》,毫末智行的战略路线主要借鉴了通用汽车旗下自动驾驶公司Cruise的经验。
此外,毫末智行是首家提出轻图和无图路线的自动驾驶公司,并赶在同行之前布局了数据闭环,同时推进大模型研发。
高速载人对应L2+方向,低速载物对应L4方向,这两条路线都是当前热门的自动驾驶领域,而毫末智行早在2020年就已开始布局,前瞻性十足,业务发展迎来一段短暂的高速期。
低速物流方面,毫末智行在2020年11月就发布了第一代无人配送车“小魔驼”,此后接连获得美团和阿里订单。
一位前员工告诉《新智驾》,“毫末智行是国内较早涉足低速无人车的公司,美团和菜鸟最早使用的无人物流车正是由其研发。”
乘用车辅助驾驶方面,毫末智行在2021年5月发布辅助驾驶系统HPilot 1.0,搭载在魏牌摩卡等多款车型上;2022年3月,毫末智行又量产了HPilot 2.0,并搭载在坦克500等多款车型上。
截至2022年底,毫末智行HPilot搭载的车型数量超过2500万公里,用户辅助驾驶行驶里程突破2500万公里。当时,毫末智行是国内量产自动驾驶的领跑者。
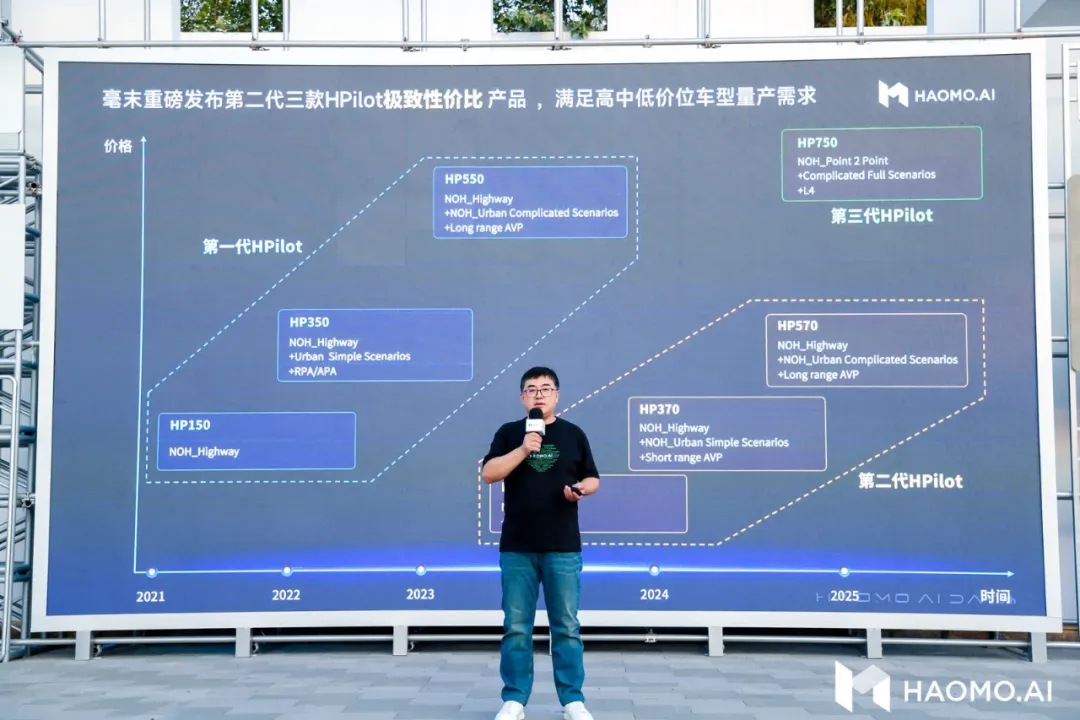
《新智驾》了解到,这些量产成绩主要来自长城汽车的托举,毫末智行自研技术在这些量产车型中尚未得到充分体现。
首发于魏牌摩卡的HPilot 1.0高速NOA项目,本为长城汽车原智驾团队的项目,后移交给毫末智行,以支撑其业务流水。
HPilot 1.0基于Mobileye EyeQ4芯片开发,其中核心的感知算法已提前由Mobileye封装在芯片中,规控由此前的保定团队完成。
知情人士透露,“HPilot 1.0项目本质上只是走账,通过license结算给毫末,目的仅在于让账面显示有项目、有收入。”
HPilot 2.0原本计划要加入毫末智行的自研感知算法。相较1.0,2.0方案要在此前的行车功能外增加泊车功能,实现行泊一体。这本应是毫末智行首次展示自研能力的机会,毫末选择了TI的TDA4芯片,自行研发泊车功能。
刘洋告诉《新智驾》,首发于坦克500的HPilot 2.0,宣称有行泊一体,但事实上没有泊车功能。
这是毫末智行第一次让魏建军失望。魏建军对毫末智行的期望是自主研发L2+及L3技术,即实现城市NOA,感知和规控算法是关键,但HPilot 2.0却暴露了“感知能力薄弱”的事实。
此事之后,毫末智行又向长城汽车承诺2022年底实现城市NOA小批量量产,2023年第一季度实现大规模量产。然而最终结果是,别说正式上车,连DEMO都是临时拼凑出来的。《新智驾》了解到,当时内部一个团队用J3+TDA4临时组装出一套方案,但未能通过长城汽车的验收。
接连未能兑现承诺后,长城汽车在2023年底转而寻求与元戎启行的合作。
多位内部员工透露,毫末智行量产城市NOA一再跳票,主要原因在于内部管理混乱以及技术路线选择失误。
毫末智行的管理架构为“双领导制”,董事长张凯与CEO顾维灏共同决策,未设CTO,两人各自直接管理业务。
一位内部员工表示,“CTO本应在技术体系中扮演关键角色,既要对整体技术成熟度有清晰判断,也要在面临技术风险时给出专业决策路径。但毫末智行始终未设立这一角色,最终只能依赖顾维灏拍板。
一个典型例子是,公司任何决策都必须经张凯与顾维灏签字方可执行。内部员工赵峰向《新智驾》透露,许多项目既不被否决也未获批准,悬而未决,最终往往自然流产。
刚开始,不少员工不清楚究竟该听顾维灏还是张凯的指示。按照常理,CEO应该向董事长汇报,但在毫末智行,顾潍灏和张凯之间没有汇报关系。
长此以往,“双领导制”致使毫末智行内部逐渐形成两股山头,公司内部几乎形成两大阵营:百度派和保定派,前者以技术副总裁艾锐为代表,后者以CIO甄龙豹为代表。
接近长城汽车的知情人士指出,长城汽车有一个老问题,老板魏建军常年驻扎保定,与其直接汇报的人也多在当地。这种管理方式在本地团队尚可运转,但一旦研发团队设在北京、上海等外地,矛盾便容易滋生,保定体系对外地团队的信任会逐渐下降。
“大家在内部通常会称北京团队和保定团队,从语言上就已经形成了分界。”
赵峰回忆称,自己应聘毫末智行时,并不知道公司与长城汽车存在如此深度的关联,HR在招聘过程中也从未明确告知。
直到2024年下半年,随着长城汽车对毫末智行的信任开始动摇,内部态度才出现明显转变——毫末智行这才意识到长城汽车的重要性,员工被告知“长城的事情要高度重视,需求要尽量满足”。
多位员工回忆称,北京和保定两个团队的分歧,从理念层面不断激化至公开冲突。
一位曾多次参与跨团队会议的员工直言:“一次涉及核心技术路线的远程会议上,双方情绪失控,争吵几乎升级为人身攻击,幸亏是线上会议,要是线下,真有可能打起来。”
当时,会议的一端是以技术副总裁艾锐为代表的算法团队,另一端则是以甄龙豹为核心的工程团队。双方围绕感知与工程实现问题互相指责,算法团队认为工程能力拖后腿,工程团队则直指算法“不落地、不好用”,你来我往,火药味十足。(艾锐在会议上的关键表态,以及这次冲突最终如何影响后续技术路线,欢迎添加作者微信 jinyuan-0428 交流)
类似的场面并非个例。多名员工透露,曾有不止一次在线会议中,保定团队成员当场怒斥感知方案,“这做的是什么东西?”
有一次争吵过程中,负责感知工程化的一名负责人当场退出会议。
除此之外,毫末智行管理风格上的不透明以及管理PR化,也让诸多员工无法适应。
毫末智行巅峰期员工也未超800人,但多位员工感觉距离公司高层很远,有的中层干部甚至在整个毫末生涯中只和高层开过一次会议。
毫末员工陈浩认为,作为一家创业公司,信息本应上下贯通,尤其在团队迷茫时,管理层更应站出来引领方向、提振信心。
在陈浩的记忆中,公司几乎从未对内发布过正式的内部信。唯一的一次发生在2024年底公司成立五周年之际,但那封信更像是写给外界的,内部员工还未收到公司就已对外发布。
还有一次是在2024年春节前后,北京现代向毫末智行管理层发来一封邮件。管理层对内部的转述是:北京现代对毫末的工作“很满意、很肯定”。但事实上,多位知情员工透露,邮件中传递出的情绪并非赞许,而是焦虑——该项目对北京现代至关重要,对方希望毫末智行加快节奏、全力保障交付。
由于公司长期信息不透明,内部不少员工始终搞不清楚真实情况。直到毫末智行临近停摆,内部仍有200-300人。一方面,部分人寄希望于长城汽车兜底;另一方面,很多员工对公司的真实处境缺乏清晰认知,甚至并未意识到风险已经来临。
PART 3
为什么要选高通智驾芯片?
2020年底,长城汽车与高通签署战略合作协议,决定在智能驾驶芯片上采用高通方案。这一选择为毫末智行后续量产的多次延期埋下了隐患。
长城汽车选择高通是多方面因素促成的结果。相较英伟达,高通的价格更为便宜。而且,高通当时提出了极具诚意的方案,包括提供客户资源、投资关系等。长城汽车当时是高通在国内的第一个客户。
此外,现代起亚、通用汽车、宝马集团等多家跨国车企也选择了高通方案,借助这层关系,毫末智行的出海门槛就会降低许多。
据知情人士透露,鉴于“出身原因”,毫末智行在国内市场很难获得吉利、比亚迪等其他自主车企的订单,因此很早便将出海确立为重要战略方向。与高通合作,是为了后续的海外市场进行提前布局。
事实上,毫末智行后来也成功拿下现代起亚的全球大订单。
这步看似具有前瞻眼光的战略选择,却将毫末智行拖入了技术路线进退两难的泥潭。
毫末智行NOH 3.0在2022年之前开始研发,基于高通8540(2021年推出的第一代智驾芯片)和9000芯片开发,算力水平达360TOPS,这在当时算是高配置。
当时,国内主流方案商普遍选择英伟达Orin平台,原因在于其开发门槛低、效果成熟、算法与工程移植效率高。
相比之下,高通在算法层面的支持相对不足,生态也不如英伟达完善,其推进节奏更偏向“先跑通、再迭代”,改进过程相对缓慢。
一位内部员工告诉《新智驾》,相比英伟达,高通在工具链、售后支持和整体技术支撑体系上都不够完善,实际使用过程中问题和bug明显更多。
更关键的是,这款芯片当时尚属首次大规模上车,高通自身也缺乏成熟的量产经验,对潜在问题并没有充分预期。结果是,在项目推进过程中,毫末智行实际上承担了大量“填坑”工作,为高通补齐量产与工程化经验。
因此,原计划于2022年底发布并量产的NOH 3.0一再延期,直至2023年底仍未能实现量产,这也促使长城汽车开始接触并评估其他辅助驾驶方案。
高通芯片的问题之外,毫末智行自身的技术短板尤其是感知算法更加显著,
另一位内部员工周涛向《新智驾》表示:“我们内部在分析绝大多数 P0 级问题时,都能追溯到感知模块。”他补充道,“这导致障碍物识别、车道线、车位识别以及接地线等,整体效果都不理想。”
周涛举例称,毫末智行交付到澳洲的车型搭载的是地平线芯片,由于该芯片自带行车感知,效果会明显提升,而同样的行车逻辑换成毫末自研的行车感知算法就表现不佳。
毫末智行的内部协作与工作方法也存在明显短板。
周涛回忆称,早期数据部门在接到采集需求后,由采集员轮班完成数据采集和送标工作,整个流程持续了半年,投入成本超过上千万元,但最终感知部门却告知采集员:“场景没沟通好,你们采集的数据用不了。”
毫末智行的感知负责人经历多次更迭:最初由许金涛负责,随后换成邓路,但感知效果始终不理想,直到2024年上半年从Momenta引入的谢国富接手后,情况才有所改善。
谢国富主要调整了工作方法:他先不直接动员采集员,而是让算法和工程团队先进行几天小规模数据采集,然后进行数据处理和算法验证,确保数据可用后,再安排技术人员跟随采集员进行实际采集,当采集员熟悉流程后,才让他们独立完成数据采集。
但此时的毫末智行已积重难返。
自动驾驶行业在2023年就已跟随特斯拉全面转向端到端,而毫末智行仍深陷此前的技术路线。
《新智驾》了解到,2023年底的内部复盘会议上,张凯和顾维灏承认在技术上遇到了障碍,并表态已经发现问题并正在解决。
然而,作为长城汽车的子公司,毫末智行若要纠正此前错误的技术路线,须报请长城汽车批准。
内部员工吴斌向《新智驾》表示,如果认为路线错误而想停下并换赛道,在长城汽车体系内很难法执行——前期已经投入数亿元,现在要转向,需要有人担责。
即便有人站出来,换新路线也需要数月时间的技术论证和向上汇报。“内部必须先把话术和逻辑梳理清楚,确保向上汇报时能够说服高层后,才能开展实际工作。”
吴斌透露,长城汽车强调亏损责任清晰化,任何亏损都要给出充分解释,这使得技术团队在面对路线偏差时,即便意识到问题,也难以迅速修正
PART 4
从托举到放手
2023年底,长城汽车开始接触元戎启行,并在保定组织了一场毫末智行与元戎启行的智驾方案试驾对比,结果毫末智行不出意外地输掉了此次PK。
随后,长城汽车将高阶辅助驾驶项目城市NOA的开发交由元戎启行负责。元戎启行的方案很快赢得了魏建军的认可,他在2024年4月的直播中亲自体验了搭载元戎启行方案的无图城市NOA,并在2024年11月独家向元戎启行投资1亿美元。
同时,长城汽车还将中阶辅助驾驶项目高速NOA的开发交由卓驭负责,后来还引进了Momenta。
自此之后,毫末智行几乎全面失去了长城汽车的项目。
实际上,毫末智行在2023年曾有机会推进IPO。当时,毫末内部已经开始股权改革、签署协议、走审计流程,券商也已进场。
但这次上市,最终在2024年初被叫停。
接近该项目的周婷向《新智驾》透露,长城当时确实同意,只是外部股东认为当时市场不景气,估值达不到预期,不愿意在2024年IPO,同时要求长城汽车提供更多订单以及兜底支持。
“当时内部按照100亿元的估值推进IPO,但外部股东希望能达到150至200亿元。”
到2024年4月时,毫末智行的账上还有4亿元,同时拿到了现代汽车5年50万辆的辅助驾驶订单,据悉该项目价值25亿元。
同时,外部股东也希望长城汽车能拿出一些资源,支持毫末智行的低速无人小车项目。周婷表示:“当初毫末的小魔驼依托长城供应链,价格具有竞争优势。如果项目一直坚持到现在,不敢说能击败九识、新石器等头部玩家,但进入行业前五绝对没有问题。”
据一位内部员工透露,毫末智行曾考虑将低速无人小车项目拆分出来进行独立融资,并接洽过一地方政府。对方表示可投资数亿元,但前提是将该业务独立成公司并落户到当地,最终这笔交易未能促成。
在长城汽车将中高阶辅助驾驶项目全部交由其他自动驾驶公司负责后,所有股东已经清楚认识到毫末智行难以扭转局面,股东们的主要诉求是尽快退出,希望与魏建军召开一次董事会,协商毫末智行的妥善处理方案,但双方迟迟未能见面。
2024年10月,长城派出总裁办高管刘向上(时任长城汽车副总裁)接管毫末智行。随后在11月,刘向上主导了一轮内部裁员,一些技术部门的核心骨干也相继选择离开。2025年11月,毫末智行的银行账户被股东申请冻结,公司运行停滞,近300名在职员工的去留与安置问题悬而未决。
员工们将全部希望都寄托于长城汽车。然而,在11月24日公司正式陷入停摆后,各方陷入了沉默。
有投资人向《新智驾》坦言,“有一种声音说,毫末智行并非长城的子公司。”
截至目前,毫末智行员工已在北京奥北科技园3号楼的北京总部至少组织过两次维权活动。与此同时,员工还向长城汽车保定总部发送了一封联名信,信中附有员工签名及对应工号,试图以此推动问题解决。
林远舟向《新智驾》表示,员工的核心诉求并不复杂,“我们希望拿回应得的社保、公积金、工资、经济赔偿金以及离职证明,仅此而已。”他进一步强调,“大家希望长城作为最大股东,能够负起应有的责任,协助员工妥善解决这些问题。”
在林远舟看来,长城汽车采取冷处理的方式,就是有意与毫末智行保持距离,试图撇清双方关系。
直到2025年11月,一位外部股东申请冻结毫末智行资产,迫使长城汽车出面解决。但到目前为止,长城汽车仍未有书面形式的解决方案。
一位投资人向《新智驾》表示,目前的局面,说白了是长城汽车对毫末智行这个“干儿子”很失望。站在长城汽车的视角,造成如今局面,完全是“干儿子”自己的问题,与长城汽车这个“干爸”无关,因为在这其中,毫末智行只是一个供应商。
《新智驾》了解到,在毫末智行未能满足长城汽车对自研的期望后,长城已在内部组建了一支数千人的智能化自研团队,由高管姜海鹏负责,并向CTO吴会肖汇报。
长城汽车对自研智能驾驶和智能座舱始终坚持战略执念。尽管目前已引入元戎启行,但在对外宣传中,长城依旧强调全栈自研,且元戎启行的对外宣传中不允许出现长城汽车的名字。
一位自动驾驶公司高管向《新智驾》表示,像毫末智行这样的主机厂孵化的公司,缺乏市场化锻炼和独立竞争能力,注定难以长期在市场中站稳脚跟。
他的理由是,孵化公司在内部得到资源和庇护,相当于“温室里的孩子”,缺乏在真实市场环境中锤炼的经历,其技术和产品竞争力往往不如经过市场洗礼的外部供应商。
而外部供应商经过充分竞争存活下来,能提供真实的竞争力,而孵化公司由于依赖母体支持,很难与之平等竞争。
如果不允许孵化公司独立去市场上闯,它无法形成自我验证和优化的机制,一旦缺少母体支持,就难以长期生存。
毫末智行当前的局面,正是这一逻辑的真实写照。
*林远舟、王强、李伟、刘洋、陈浩、吴斌、赵峰、周婷、张磊、周涛,均为化名。
....
#华.为为什么在自.驾VLA模型上悄无声息?
VLA不是唯一解,只是未来路线中的一种。
关于华为对VLA路线的看法,我的解释基本对应的上。
VLA的优点在于,在架构中增加了大模型,具备一定现实理解能力,是当下端到端技术探索的新路线
关于VLA,得先从原理说起。
VLA是把摄像头、激光雷达、毫米波雷达,甚至车外麦克风等信息和自车信息持续输入,问一个大模型如何开车。
如果你截一张行车记录仪的图,问DeepSeek应该如何开车,并让它只输出怎么开车,恭喜你,你获得了VLA的雏形。
有了这个雏形,再去做工程上的优化,终归是会大力出奇迹的。
端到端模式,依然存在数据的边际效应递减问题,以及Corner Case覆盖不够的问题。
当然,端到端模型最大的问题不是这些,而是模型的AI只知道相关性,而非因果性。此外,还有个灾难性遗忘的问题。
相较于目前的端到端,VLA架构中增加了LLM——也就是大模型,因此具备了对于现实世界更好的理解能力。
虽然大模型是否具备真正的理解能力还有争议,但相较于上面的端到端仅有相关性没有因果性的理解,大模型起码知道,红灯应该停。
大模型,特别是中小参数模型性能的飞速增长,意味着在VLA中的这个“L”的能力,也可以飞速增长。
但VLA的缺点在于,对于硬件的要求,模型能力的上限,都受到了约束。
以理想为例,VLA大体可以看做四步:
- 1)识别图像;
- 2)把图像信息和自车信息输入大模型(也就是Prefill)
- 3)大模型输出驾驶建议(也就是Decode)
- 4)将输出建议画成自车轨迹+环境,提供真正的驾驶建议。
所有内容,先变成语言对环境的描述,然后输入到一个(尺寸不算大)的大模型中,让这个大模型判断怎么开车,然后画出来行车轨迹。
为了泛化,多了一道转化,也会导致信息量的损失。
当然,对算力、内存带宽的需求也极大增长。
为了降低延迟,理想和小鹏都做了巨量的工程上的优化,
智驾的前沿模型还有世界模型和视频生成模型
——这不是我说的,这是王兴兴说的。
毕竟本来VLA也是之前xx智能领域拿过来的。
世界模型是直接通过环境信息,生成虚拟世界中对于未来的预测。
相较于VLA,世界模型少了两个步骤,即
2)把图像信息和自车信息输入大模型(也就是Prefill)
3)大模型输出驾驶建议(也就是Decode)
这样,理论上不仅具备对世界环境的理解能力,也可以实现更低的延迟。
华为ADS 4.0的车端世界行为模型大体是这个意思。
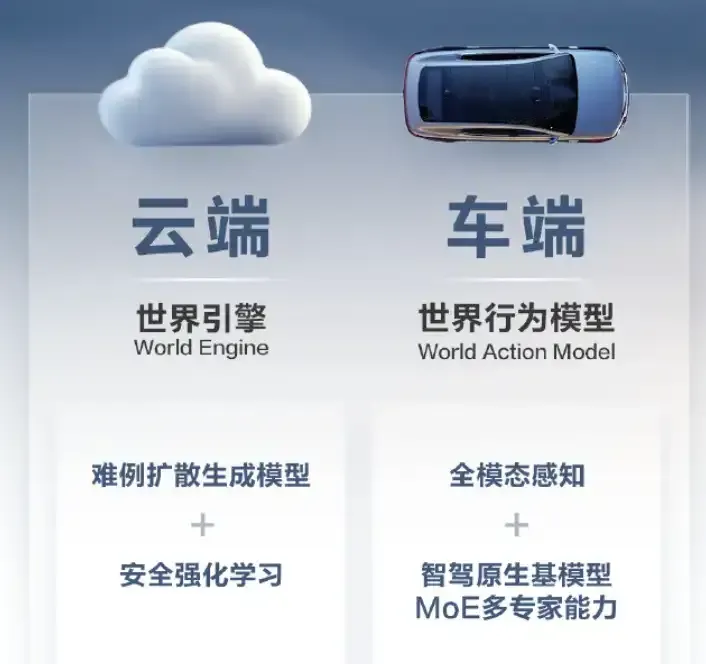
大体如此吧。
....
#没想到,Momenta单月智.驾搭载量近9.万了.....
这两天看到了中国汽车工业协会发布的《2025城市NOA汽车辅助驾驶研究报告》,核心信息给大家提炼一下:
- 2025年1—11月,搭载城市NOA的乘用车累计销量达312.9万辆;
- 双强主导,Momenta和华为HI模式的市场份额显著领先,合计占第三方供应商比例约八成。
- Momenta 占比达 61.06%,处于领衔地位;
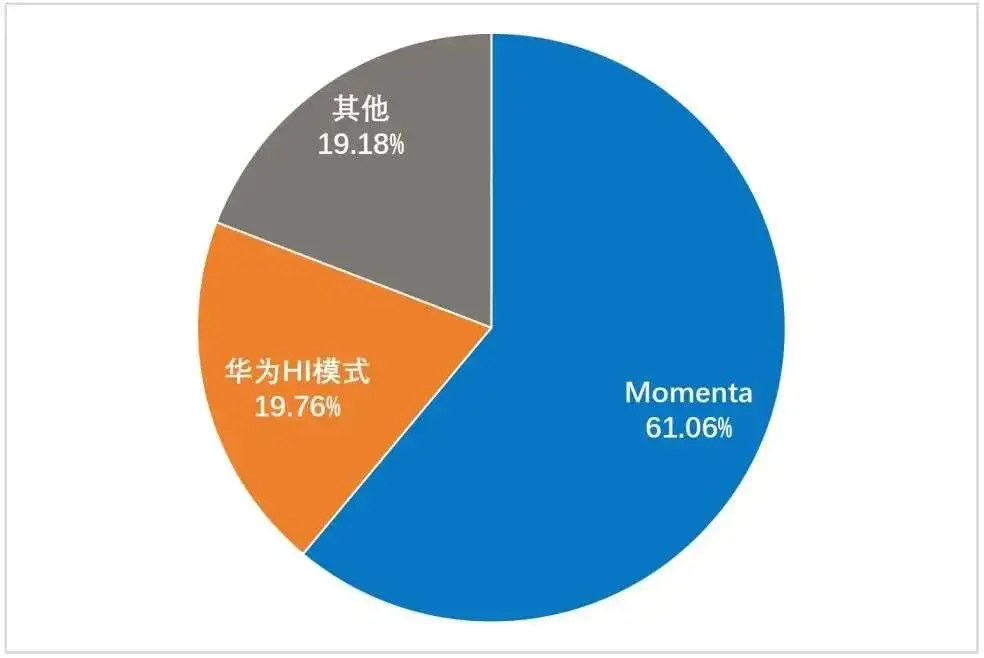
数据来源:《2025城市NOA汽车辅助驾驶研究报告》
这两家单月智驾搭载量已经达8-10万规模。 预估25年11月华为乾崑智驾(鸿蒙智行+HI模式)的搭载量已达到10万辆,Momenta搭载量约9万辆。
今天不打算聊这么泛,主要是想借这个机会聊下Momenta为什么可以做到这个Level。据xx了解,Momenta公开的方案是R6强化学习大模型。Momenta的强化学习公认做的比较好,也已于2025 Q3正式量产上车。
有的文章说:强化学习不应该是一个花太长时间去重点搞的东西,它对系统的提升或许只能贡献5%甚至更低。不会带来质变。
这一点,柱哥不是很认同:正是由于剩下5%的场景,模仿学习Cover不了,才需要其他方法。而强化学习是一个有效的途径,当下各种叠Reward的方式是现状,也会造成冲突的情况,但我认为强化学习是通往L3/L4智驾最正确的道路。
或者换句话说,强化学习做得好,量产的效果才能拉开明显的差距,这一点Momenta已经验证过了。
强化学习会提供一个反馈的机制让模型反思自己的结果是否合理,这是模仿学习提供不了的,柱哥更倾向于强化学习会有一条更普世的路径。这在Momenta R6 强化学习大模型中也有体现:
- 通过对不安全轨迹给予负反馈,显著提升对鬼探头等危险场景的应对能力;
- 第二是丝滑流畅的拟人体验,在多目标博弈场景(如无保护左转)中,需要综合优化安全、舒适与效率;
- 第三是高效通行,通过奖励机制,激励模型在通行效率上超越人类司机,例如在拥堵路段智能选择车道,精准下匝道等。
xx接触过业内试乘搭载Momenta R6 强化学习大模型量产车的算法工程师反馈,像雨天反光、窄道会车、积水无车道线都表现得很不错。交付能力,Momenta是业内公认的强,也是可以做到市占率的一个非常重要的原因。当然还有以下两点:
- “全球上车”的能力:Momenta针对法规场景做了很多的优化,交付前一把搞定欧标/美标/中标三份标定,一套OTA,这不仅能大幅提升交付周期,也能省去研发很多的精力,这一点和很多缝缝补补的小公司差距很大;
- 一个飞轮两条腿:这是最正确的一条道路,很多做一段式端到端顺利的公司,底子都是数据闭环做的好,才能在短时间堆积起来千万clips的训练数据。在26年L4爆发的起点,Momenta应该会吃到更多的红利。
借用知乎@February文章中的一句话:不是 Momenta 多完美。 在“既要又要还要”的整车车企眼里,它刚好是那个“全能乙方”。
截至 2025 年 10 月,其累计量产车辆达 50 万台,定点车型超过 160 款。
当然除Momenta、华为外,其他第三方供应商也积极布局NOA辅助驾驶领域,凭借差异化技术路线与合作模式,占据一定市场份额。
....
#上交自动驾驶3D重建综述
从NeRF到3DGS的全面调研
导读:3D重建是自动驾驶“上帝视角”的基石。从之前大火的NeRF,再到最近刷爆学术圈的3D Gaussian Splatting (3DGS),学习型方法正在重塑自动驾驶的感知与仿真。最近,上海交大张颂安老师团队在IEEE T-ITS上发表的最新综述全面盘点了自动驾驶场景下的学习型3D重建技术。本文带你一文看懂自动驾驶重建的“前世今生”!
综述全文请见:https://ieeexplore.ieee.org/document/11296945
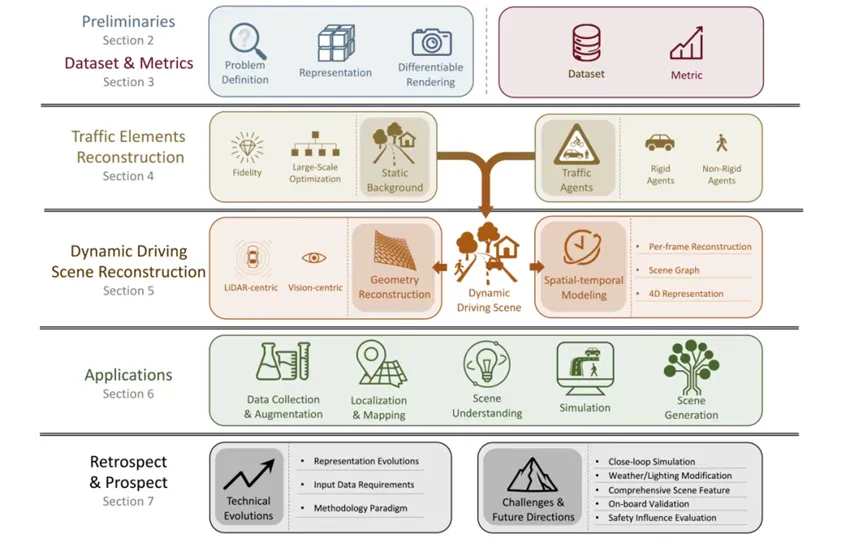
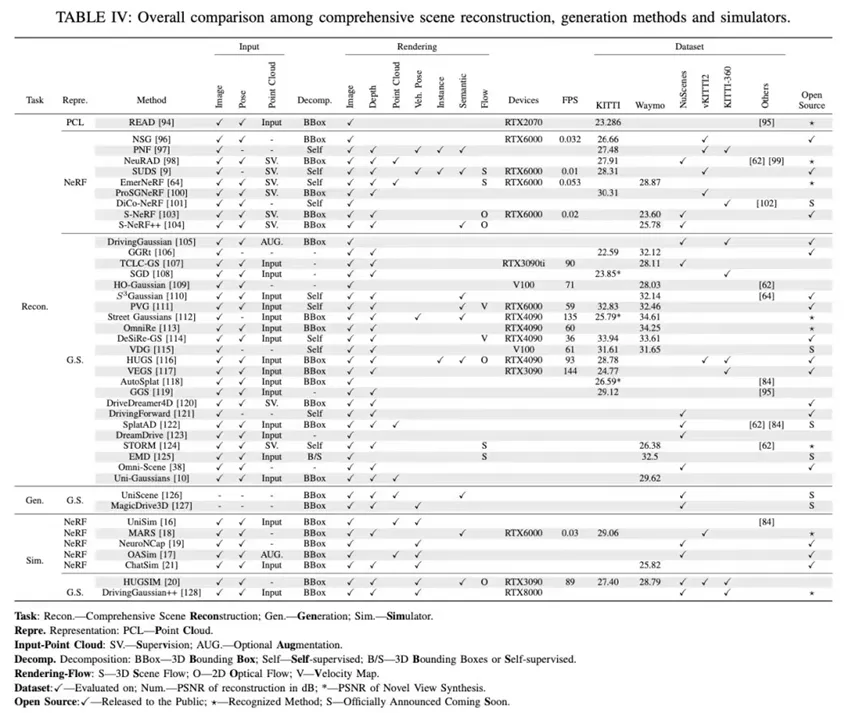
本文从3D重建的基础知识,到自动驾驶应用相关的重建任务,再到应用落地前景,对学习式3D重建任务在自动驾驶领域相关的论文进行了系统的梳理。
一、 研究背景:数据瓶颈与数字孪生
随着自动驾驶技术向L4/L5级别迈进,系统对环境感知的精度与鲁棒性要求日益严苛。实现可靠的自动驾驶,根本上取决于对三维环境的精准感知与整体理解。然而,当前行业面临着严峻的“数据长尾效应”:
- 高昂成本:获取海量、覆盖各种极端工况(如恶劣天气、事故场景)的高质量多模态数据成本极高。
- 安全风险:在真实世界中采集边缘场景(Corner Cases)往往伴随着不可控的安全风险。
为了突破这一瓶颈,“数字孪生”与仿真技术成为关键路径。通过构建物理世界的高保真数字化副本,可在虚拟环境中以低成本、零风险的方式生成大量训练数据,并进行算法的闭环测试。
传统重建方法(如摄影测量、SfM)在应对弱纹理区域、复杂光照以及高动态交通流时往往力不从心。而基于学习的三维重建技术(Learning-based 3D Reconstruction),凭借其强大的隐式或显式场景建模能力,为创建兼具照片级真实感(Photorealism)与几何精确性(Geometric Accuracy)的驾驶场景提供了突破性解决方案。
二、 技术演进:从隐式到显式的范式转移
在过去几年的时间里,3D重建技术在不停的突破,已经在短短的三年内经历了深刻的范式转移:
- NeRF时代 (2020起):神经辐射场的提出证明了隐式神经表示(Implicit Representation)能够实现前所未有的新视角合成质量,解决了传统建模在连续性和细节表现上的不足。
- 3DGS时代 (2023起):3D Gaussian Splatting技术的兴起引入了显式的高斯原语表示。它在保持高保真度的同时,借助高效的光栅化技术弥补了NeRF推理缓慢的缺陷,使实时渲染(Real-time Rendering)成为可能,极大地推动了重建技术在自动驾驶车端的落地。
然而,现有综述工作要么局限于特定方法(如 NeRF、Gaussian Splatting),要么缺乏在自动驾驶场景下的系统性分析。为了填补这一部分的研究空白,本文将对自动驾驶场景下3D重建技术的应用进行系统性回顾。
三、 核心内容:面向自动驾驶的重建分类学
本综述针对自动驾驶场景的独特性(如大规模无界场景、稀疏传感器视角、高动态交互),建立了一套完整的技术分类体系:
1. 静态场景表示 (Scene Representation)
论文详细对比了基于体素(Voxel)、点云(Point Cloud)、神经隐式表面(SDF)以及混合表示的方法,分析了它们在存储效率、渲染速度和几何质量之间的权衡(Trade-off)。
体素表示通过规则的三维网格对空间进行离散建模,每个体素可存储占据状态、语义或学习特征,因此在空间推理和语义建模中具有天然优势。然而,体素分辨率的提升会导致存储和计算复杂度呈立方级增长,使其在大规模、长距离自动驾驶场景中难以维持高精度重建。
相比之下,点云表示以稀疏方式直接采样物体表面,具有较高的几何精度和良好的存储效率,并且与 LiDAR 传感器数据天然对齐,但由于缺乏显式拓扑结构,其在连续表面建模、光照表达和高质量渲染方面能力受限。
神经隐式表示(如 SDF 和 NeRF)通过连续函数对几何和外观进行建模,在视觉真实感和连续性方面表现突出,但其几何结构隐含在网络参数中,难以直接用于下游感知与规划任务,同时体渲染机制带来的高计算成本严重制约了实时性。
基于上述不足,本文指出混合表示逐渐成为主流趋势,即通过将显式表示的几何可控性与隐式表示的连续建模能力相结合,在几何精度、渲染质量与系统效率之间取得更合理的折中。这一趋势反映了自动驾驶场景中“可用几何”和“可实时系统”优先于单纯视觉效果的工程导向
2. 动态目标重建 (Dynamic Object Reconstruction)
这是自动驾驶重建的难点所在。论文将交通参与者分为两类进行深入剖析:
- 刚性物体(Rigid Objects):对于以车辆为代表的刚性物体,由于其形状在运动过程中保持不变,主流方法通常通过引入长方体包围盒或规范化坐标系,将物体的运动与外观建模解耦。具体而言,车辆首先被映射到局部 canonical frame 中,在该坐标系下学习稳定的几何和外观表示,而其在全局场景中的运动则通过刚体变换进行建模。此外,车辆天然具有较强的几何先验,如左右对称性和标准结构比例,这些先验被广泛用于补全遮挡区域和缓解稀疏视角带来的信息缺失,从而显著降低了重建难度。
- 非刚性物体(Non-rigid Objects):行人和骑行者等非刚性物体由于存在复杂的关节运动和连续形变,其重建问题本质上转化为“形变建模 + 外观建模”的联合优化问题。论文指出,当前主流解决方案是将 SMPL 等参数化人体模型引入重建流程,通过线性混合蒙皮(LBS)将人体在不同姿态下的形变统一映射到 canonical space 中,再结合神经表示对细节外观进行补充。这一方法在受控的人体重建数据集上取得了较好效果,但在真实自动驾驶场景中仍面临两大瓶颈:一是远距离行人像素分辨率低,导致姿态估计和相机相对位姿不稳定;二是复杂交通环境中频繁发生遮挡,使得完整人体几何难以从局部观测中恢复。因此,本文认为,非刚性目标的高鲁棒性重建仍是当前研究中的薄弱环节。
3. 关键挑战与解决方案
综述还重点讨论了当前技术面临的核心挑战:
- 大规模一致性:主要体现在公里级长距离场景重建中误差的持续累积,表现为几何漂移和场景断裂。为缓解这一问题,现有方法普遍采用场景解耦策略,通过空间分块、距离分层或语义分区的方式,将整体场景拆分为若干局部子问题,从而降低单一模型的时空跨度。此外,静态背景与动态目标的分离建模,以及引入 4D 表示对时间维度进行统一建模,也被证明有助于提升长期一致性。
- 传感器融合方面:LiDAR 与 Camera 在信息层面具有高度互补性,前者提供精确但稀疏的几何约束,后者提供高密度但缺乏尺度的外观信息。主流方法并非简单拼接多模态数据,而是通过 LiDAR 深度监督、几何初始化或联合成像建模的方式,在统一的重建框架中实现跨模态对齐,从而同时提升几何可靠性与视觉质量。
- 极端环境适应性:在夜间、雨雪和雾霾条件下,关于重建鲁棒性的研究仍处于初级阶段。现有方法主要依赖 LiDAR 的几何稳定性或引入简化的成像退化模型,但尚无法真实模拟复杂天气条件下的物理光学效应。因此,极端环境下的高可信重建被认为是未来自动驾驶三维重建中最具挑战性且最具研究价值的方向之一。
四、 应用前景:赋能自动驾驶全栈
重建并非终点,而是赋能自动驾驶的新起点。论文总结了该技术的四大核心应用场景:
- 数据增强 (Data Augmentation):生成高质量的Corner Case合成数据,提升感知模型的泛化能力。
- 闭环仿真 (Closed-loop Simulation):构建World Model,让规控算法在高度真实的虚拟世界中进行“图灵测试”。
- 自动标注 (Auto-labeling):利用重建后的稠密几何信息,实现3D真值标签的自动化生成与迁移。
- 感知与理解 (Perception & Understanding):辅助提升3D目标检测、语义分割等下游任务的性能。
五、 总结与展望
本文为自动驾驶领域的很多研究人员提供了一份详实的参考指南。尽管3DGS等技术已取得显著进展,但在可编辑性(Editability)(如基于文本的场景编辑)和端到端生成方面仍有广阔的探索空间。随着生成式AI(Generative AI)的发展,未来的三维重建将不仅仅是复刻世界,更是创造世界。
....
#通用仿真模型——WeRide GENESIS
文.远WeRide GENESIS世界模拟器方案解析
28号前天,文.远WeRide发布了自研的通用仿真模型——WeRide GENESIS。柱哥今天有时间和大家一起分析一下,看看有哪些算法应用。先看下面这张图:
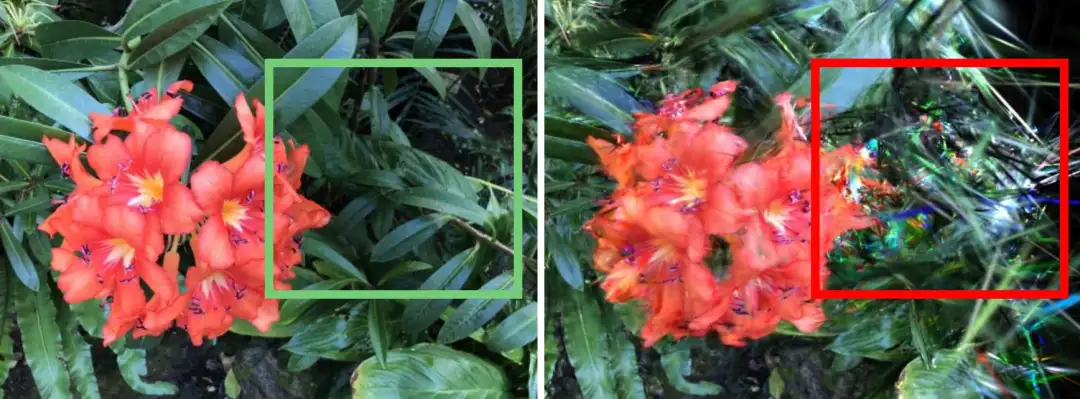
可以确定,文远的这套通用仿真模型是基于3DGS+生成的方案。在自车左右平移的过程中,以及他车经过自车的时候,可以比较明显的看出3D Gaussian的“伪影”。
这是3DGS算法所独有的,这是因为高斯椭球会尽可能的拟合见过的场景,而在平移之后就没办法较好的拟合新场景的真实表征。可以看下面这张图,稀疏视角/新视角下会出现GS特有的针状伪影,你可以理解为一个长细型的高斯椭球。也是学术界和工业界一直在尝试解决的一个问题,即新视角的重建。
稍微给没接触过的小伙伴解释下为什么需要新视角,或者说新视角的场景才是闭环仿真的核心。
闭环仿真一个最重要目的是用来验证新模型在问题场景上是否有改善。
假设正前方车道有一个侧翻的车辆或者障碍物,老模型无法正确做出变道的决策选择向前开,那么这个场景就成为了一个问题场景。现在新模型可以判断出前方有异常障碍物,需要向左/向右做出变道的行为,沿着新轨迹继续行驶。
问题在于,离线回传的场景已经固定,实车测试又没办法完全复刻当时的问题场景(车祸/行人碰撞等极端安全场景),所以就需要依赖3DGS的编辑能力,沿着自车的新轨迹继续前行,也就是新视角的重建。
这样能极大的减轻极端场景的测试成本、压力和周期。
但3DGS的新视角能力又比较差,严重失真的视觉重建便失去了仿真测试的意义,所以学术界和工业界希望用生成的能力来优化3DGS的短版。
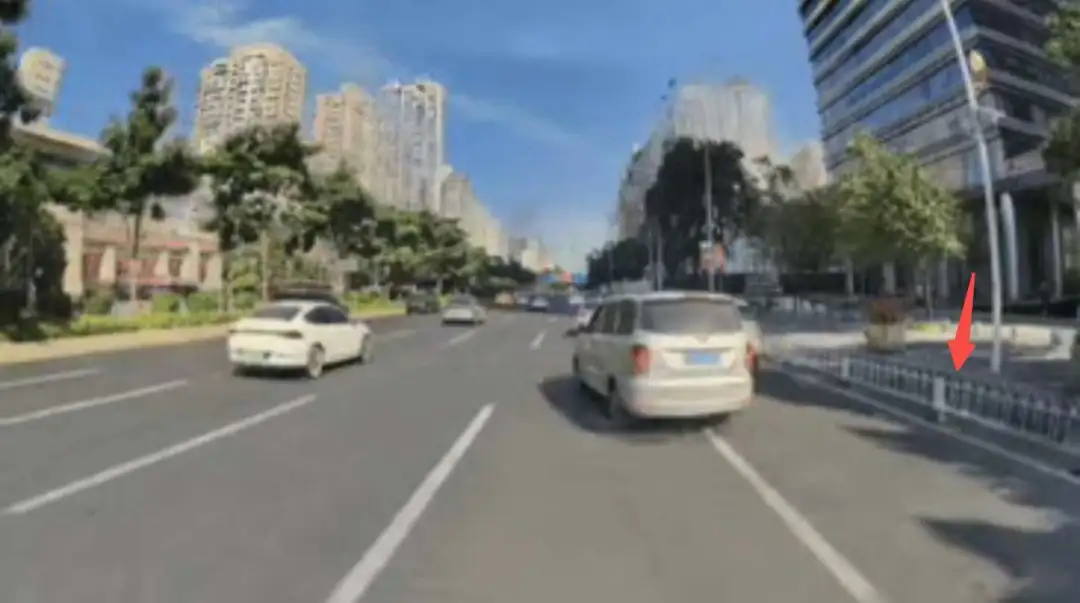
至少从文远展示出来的demo效果,还可以。车道线基本清晰、车辆整体完整,但车辆本身重建的质量还需要进一步优化(可以优化下位姿?)。还有一个不错的点,下图的栅栏的效果(手动狗头)。
当然,本次demo没有展示行人、骑行人和红绿灯的效果,期待未来进一步和xxx流。下图是WeRide GENESIS的整体框架,围绕AI的全场景、全要素评测和闭环仿真。
借用知乎@孙海洋老师的一句话:未来是一个巨大的世界模型。再补充一点,得是前馈的。
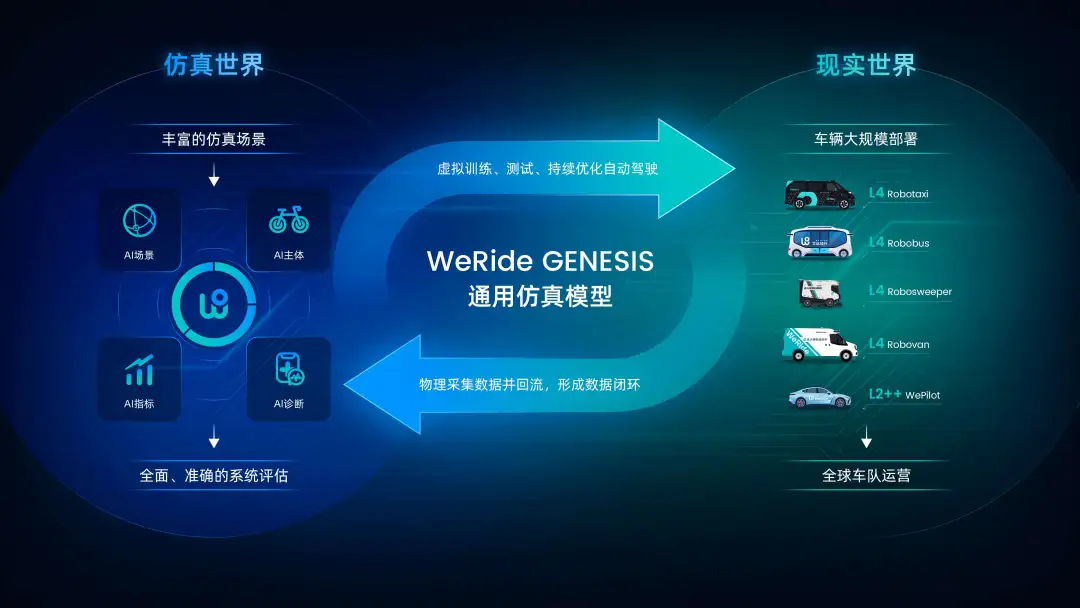
文.远知行联合创.始人兼.CT.O李.岩博士表示:“WeRide GENESIS为我们构建了一个能够随时生成、扩展与进化的‘数字宇宙’。借助WeRide GENESIS,我们的‘AI司机’可以在几分钟内熟悉全球任意城市的驾驶环境,为自动驾驶的全球商业化部署奠定了坚实的技术基础,这对行业来说是一次真正的能力飞跃。”
其他demo如下:
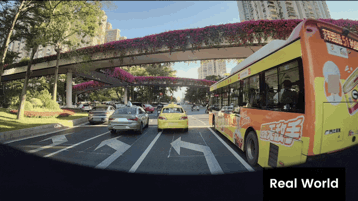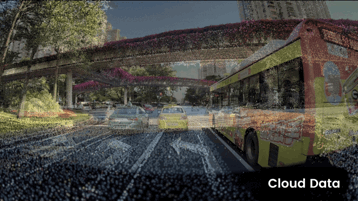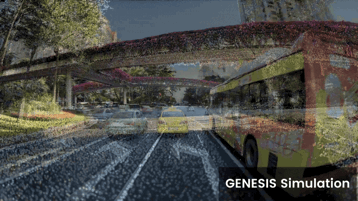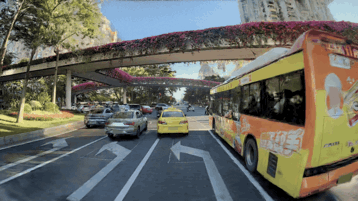
....
#EVolSplat4D
浙大&华为一篇前馈式GS算法,比特斯拉快了近20倍...
浙大&华为的一篇前馈式GS算法 - EVolSplat4D,主要解决自动驾驶动静态场景重建的一篇工作。性能算不上很惊艳,主要优势在推理速度,80+ FPS的渲染效率。这个推理速度要比特斯拉ICCV上 220ms的生成式GS快很多,当然EVolSplat4D没加生成算法,严格意义上不是一个维度的对比。
在自动驾驶技术飞速迭代的今天,数字孪生已成为算法训练与场景验证的核心基础设施。想象一下:一辆自动驾驶汽车在虚拟城市中完成上万次极端场景测试,无需耗费真实道路资源;或者通过精准还原交通流变化,优化城市道路规划——这一切的实现,都依赖于对静态建筑、动态车辆等元素的4D场景重建技术(3D空间+时间维度)。
然而,长期以来4D城市场景重建始终面临一个“不可能三角”:重建速度快、画面质量高、几何一致性强三者难以兼得。传统基于神经辐射场(NeRF)或3D高斯溅射(3DGS)的方法虽能实现照片级渲染,但需逐场景优化,重建一个场景动辄耗时数十分钟,完全无法满足大规模仿真需求;而新兴的前馈式方法虽能实现快速推理,却因采用逐像素高斯表示,在多视角融合时易出现多层伪影,动态场景中更是漏洞百出。
最近,浙江大学、华为、图宾根大学联合团队提出的EVolSplat4D,一举打破了这一技术僵局。这款专为静态与动态城市场景设计的前馈式框架,仅需1.3秒即可完成场景重建,渲染速度达到82.46 FPS,在四个数据集上验证了效果。今天笔者就来带大家详细分析这项技术突破。
- 论文链接:https://arxiv.org/pdf/2601.15951
- 项目地址:https://xdimlab.github.io/EVolSplat4D/
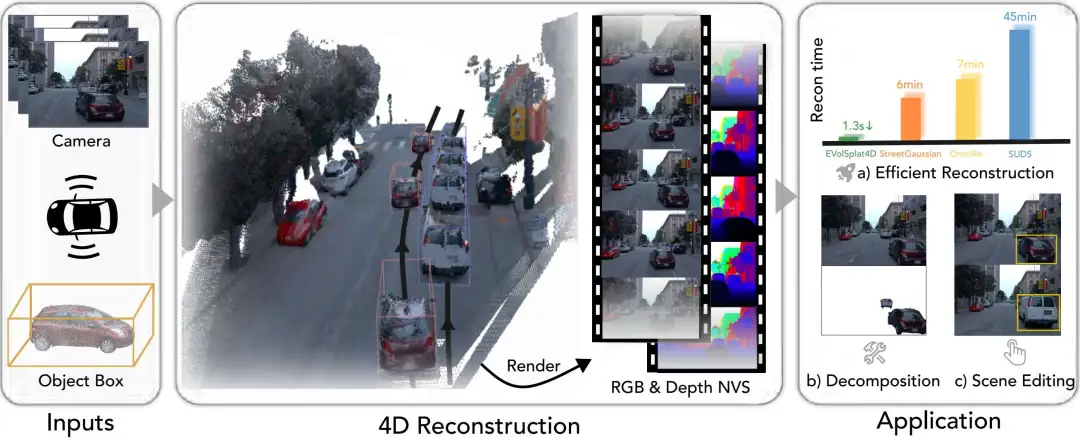
EVolSplat4D 整体框架
研究背景与动机
为何自动驾驶场景重建中难以兼顾“快”与“准”?首先要搞懂当前技术的核心痛点。
在自动驾驶仿真中,场景重建需要满足三个核心诉求:大规模泛化能力(适配不同城市、天气、交通场景)、实时交互性能(支持算法快速迭代测试)、毫米级几何精度(确保虚拟与真实场景的一致性)。
但现有方案始终存在致命短板:
1. 逐场景优化方法——精度够,速度慢
以NeRF和3D高斯溅射(3DGS)为代表的传统方法,是目前画面质量的“天花板”。它们通过对每个场景单独优化,能精准还原建筑物纹理、车辆轮廓等细节,实现照片级渲染。但问题在于,这种“量身定制”的模式效率极低——重建一个中等规模的城市街区,需要45分钟到数小时不等。
对于需要海量场景的自动驾驶仿真而言,这种速度完全不具备实用性。想象一下,若要覆盖1000个不同交通场景,仅重建环节就需要数月时间,根本无法跟上算法迭代的节奏。此外,这类方法的内存占用极高,往往需要专业服务器级GPU支持,进一步抬高了应用门槛。
2. 前馈式方法——速度快,精度低
为解决速度问题,研究者们提出了前馈式方法——通过在大规模数据集上预训练模型,实现“输入图像→直接输出场景表示”的端到端推理,重建时间压缩至秒级。但新的问题随之而来:
这类方法普遍采用逐像素高斯表示,即每个像素对应一个3D高斯元。当从多视角融合预测结果时,极易出现几何不一致性——比如远处的建筑物在不同视角下出现“分层”,动态车辆的运动轨迹出现断裂,也就是行业常说的“多层伪影”。更严重的是,逐像素表示的高斯元数量与像素数线性相关,不仅内存开销大,重叠区域还会产生大量冗余,进一步降低渲染质量。
3. 动态场景——难以保障稳定多视角一致性
城市场景中,车辆、行人等动态元素的存在,让重建难度呈指数级上升。现有动态重建方法要么依赖精准的3D运动估计(现实中易受遮挡、噪声影响),要么采用自监督方式分解静态与动态成分,但始终无法实现稳定的多视角一致性。比如STORM、DrivingRecon等前沿方法,在动态车辆区域仍会出现模糊、拖影等问题,难以满足自动驾驶仿真对场景真实性的要求。
正是在这样的技术背景下,EVolSplat4D横空出世,通过“分而治之”的创新架构,同时攻克了速度、精度、一致性三大难题。
EVolSplat4D核心创新
EVolSplat4D的核心思路是:不再用单一表示方法适配所有场景,而是将城市场景拆解为三大组件,为每个组件设计专属的重建模块。这种量身定制的架构,既保留了前馈式方法的速度优势,又通过体积式高斯表示解决了几何一致性问题。
整体框架
EVolSplat4D的输入极为简洁:稀疏相机图像+LiDAR预测的3D边界框。通过三大前馈分支分别处理不同场景组件,最终融合输出统一的3D高斯集合,再通过α混合实现全场景渲染。整个过程无需逐场景优化,端到端推理仅需1.3秒,渲染分辨率达到376×1408时仍能保持82.46 FPS的实时速度,内存占用仅10.98GB,普通消费级GPU即可支撑。
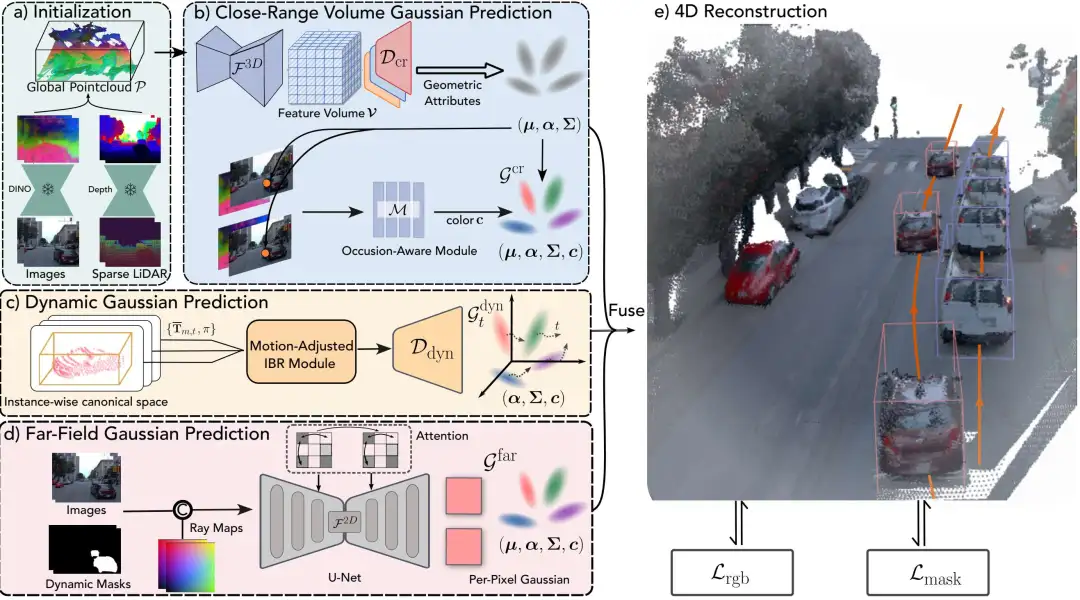
方法整体框架。包含近距体积区域、动态目标和远处景物三个重建部分
分支一:近距静态区域
城市场景中,道路、建筑物等近距静态区域是几何一致性的核心诉求点。EVolSplat4D放弃了传统的逐像素表示,采用体积式3D高斯预测,从根源上解决多视角融合的一致性问题。
具体来说,该分支分为三步:
- 全局点云初始化:利用深度估计模型生成的深度图,将多帧图像的2D语义特征(通过DINOv2提取)提升到3D欧氏空间,构建全局语义点云。这里的关键是,通过PCA降维将特征压缩至16通道,既保证信息完整性,又控制内存开销;
- 3D卷积解码几何:将全局点云体素化后,输入稀疏3D CNN网络,生成3D特征体积。通过三个独立的MLP头,分别预测高斯元的位置偏移、透明度和协方差矩阵。特别设计的递归更新规则,能让高斯元逐步收敛到物体表面,即使初始深度存在噪声,也能精准还原几何结构;
- occlusion-aware外观建模:几何一致后,如何保证纹理细节不丢失?该分支采用语义增强的图像基渲染(IBR)模块,将每个高斯元的3D中心投影到多个参考帧,通过3×3窗口采样局部颜色。更重要的是,引入DINO特征引导的遮挡检测——通过计算3D特征与2D投影特征的余弦相似度,自动过滤被遮挡区域的无效颜色信息,避免模糊伪影。
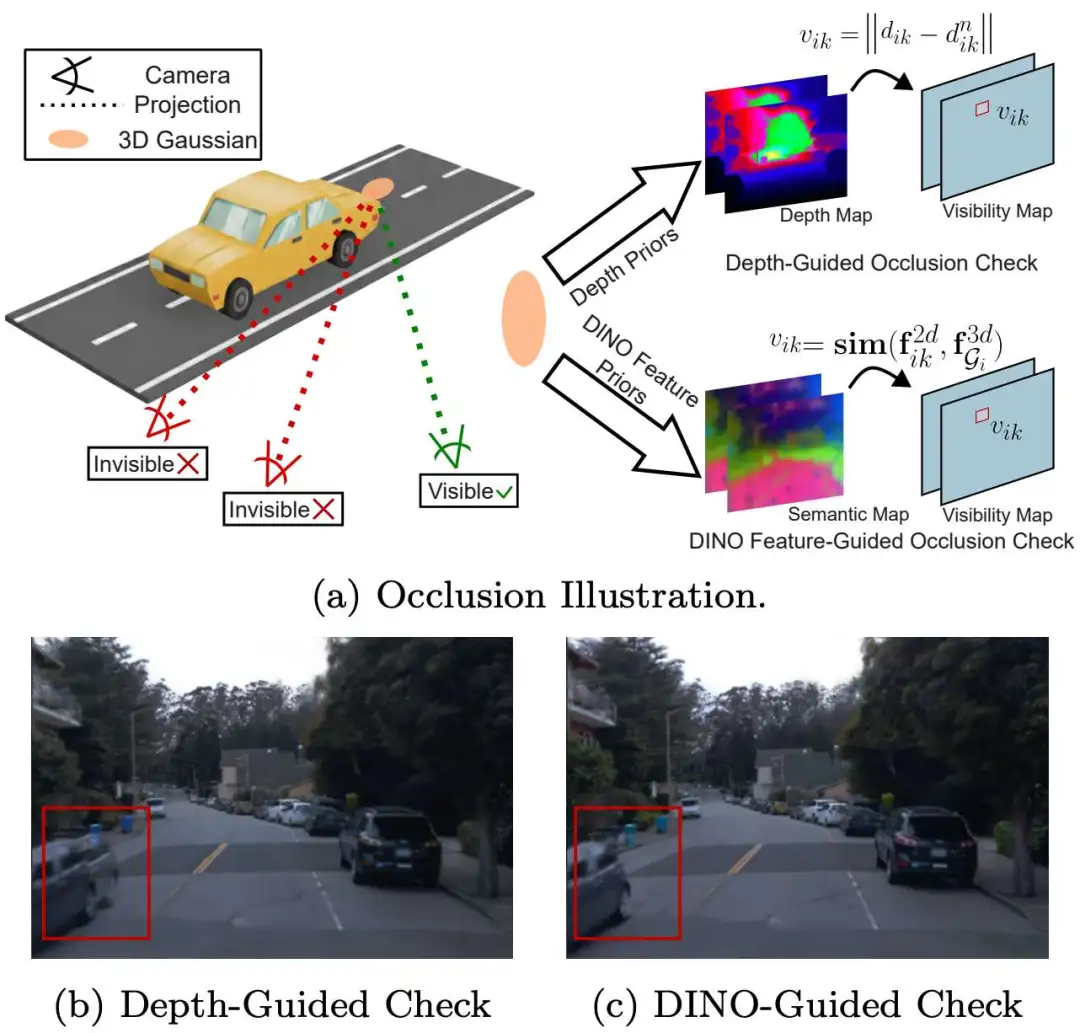
遮挡示意图
这种“几何与外观解耦”的设计,让近距静态区域的重建既保证了多视角一致性,又还原了纹理细节,PSNR(峰值信噪比)达到23.36 dB,远超同类前馈式方法。
分支二:动态车辆
动态车辆的重建是4D场景的核心难点:既要跟踪车辆的运动轨迹,又要保证不同时间戳下的外观一致性。EVolSplat4D通过目标中心规范空间+运动调整IBR模块,完美解决了这一问题。
其核心逻辑是“分离与统一”:
- 动态实例分离:利用LiDAR预测的3D边界框,将每个车辆从静态场景中分离出来,映射到独立的规范空间(即车辆自身的局部坐标系)。这样一来,无论车辆如何运动,其自身的几何结构(如车身轮廓、车窗位置)在规范空间中是固定的,便于跨帧信息聚合;
- 运动调整投影:针对不同时间戳的参考帧,通过刚性变换将规范空间中的点云映射到世界空间,再投影到2D图像平面采样颜色。这种“时间对齐”的投影方式,能有效补偿3D边界框的跟踪噪声,即使边界框存在微小偏差,也能通过局部窗口采样修正;
- 共享解码器预测属性:所有动态车辆共享一个三层MLP解码器,输入采样的颜色和可见性信息,直接预测高斯元的透明度、协方差和颜色。这种设计既保证了动态重建的效率,又通过多帧特征聚合提升了鲁棒性。
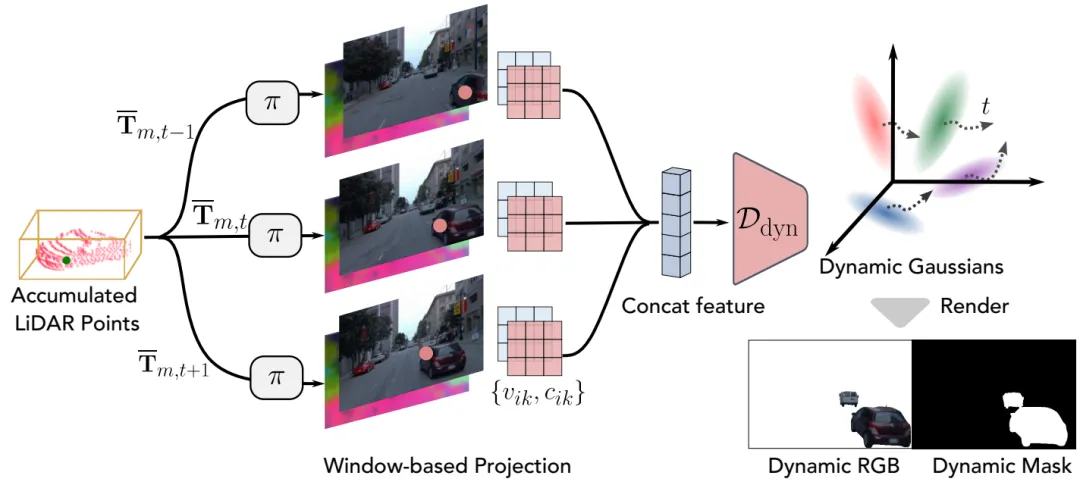
运动调整图像基渲染(IBR)
实验证明,该分支能精准还原车辆的运动轨迹,即使在80%图像缺失的稀疏输入下,仍能避免运动模糊和轮廓扭曲,在Waymo数据集上的LPIPS(感知相似度)仅0.121,远优于STORM的0.182。
分支三:远处场景
城市场景中的天空、远山等远处区域,虽对几何精度要求较低,但直接影响画面的完整性和真实感。EVolSplat4D针对远处特点,设计了基于跨视角注意力的逐像素高斯分支,在保证效率的同时提升背景 fidelity。
该分支的创新点在于:
- 10通道特征输入:将RGB颜色、动态掩码(过滤动态车辆干扰)和普吕克射线嵌入(编码相机光线的位置和方向)拼接成10通道特征图,为远处建模提供丰富信息;
- 跨视角注意力聚合:在2D U-Net的深层引入跨视角自注意力机制,能有效聚合多个参考帧的远处信息,避免单一视角的纹理缺失;
- 轻量级高斯预测:每个像素直接预测一个3D高斯元,包含颜色、尺度、旋转、透明度和射线距离,通过μ计算高斯中心,兼顾效率与精度。
值得注意的是,该分支仅负责远处建模,近距区域仍由体积式分支处理,这种“各司其职”的设计,既避免了逐像素表示的一致性问题,又保证了远处场景的渲染效率。
融合渲染:α混合+掩码损失
三大分支的输出如何融合成完整场景?EVolSplat4D采用两步融合策略:
- 先对近距静态高斯和动态高斯进行α混合,积累颜色和透明度;
- 将远处高斯作为背景层,与前景融合得到最终图像:。
为避免不同分支的建模区域重叠,特别引入分解损失():通过全局点云投影生成二进制掩码,强制近距分支仅建模指定区域,远处分支不涉足前景,从监督层面保证场景分解的清晰度。
主要实验结果
EVolSplat4D在KITTI-360、KITTI、Waymo、PandaSet四大权威数据集上进行了全面测试,无论是静态场景、动态场景,还是零样本泛化,都展现出压倒性优势。
1. 静态场景:精度与效率双第一
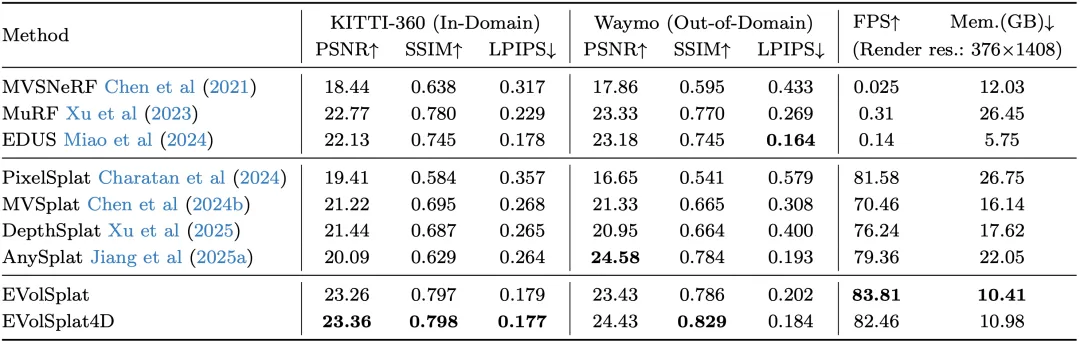
KITTI-360 和 Waymo 开放数据集上静态场景的定量结果(与其他前馈式基线方法对比)
在KITTI-360数据集(50%图像缺失的稀疏输入)上,EVolSplat4D的PSNR达到23.36 dB,SSIM为0.798,LPIPS仅0.177——不仅超越了所有前馈式方法,甚至逼近需要逐场景优化的3DGS方法。更关键的是,其渲染速度达到82.46 FPS,是EDUS(0.14 FPS)的589倍,内存占用仅10.98GB,远低于PixelSplat的26.75GB。
在Waymo数据集的零样本测试中(仅在KITTI-360上训练,直接迁移到Waymo),EVolSplat4D的SSIM和LPIPS仍领先所有基线,证明其强大的泛化能力——这意味着模型无需针对不同城市重新训练,极大降低了大规模应用的成本。
2. 动态场景:碾压同类前馈式方法
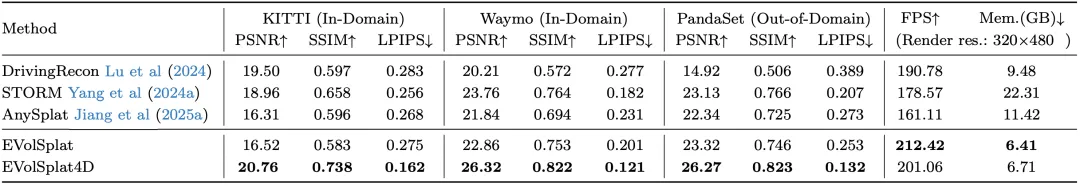
动态场景的定量结果(与前馈式基线方法对比)
在80%图像缺失的动态场景测试中,EVolSplat4D的优势更为明显:
- KITTI数据集:PSNR 20.76 dB,比第二名DrivingRecon高1.26 dB,LPIPS 0.162,仅为DrivingRecon的57%;
- Waymo数据集:PSNR达到26.32 dB,SSIM 0.822,远超STORM的23.76 dB和0.764;
- PandaSet零样本测试:PSNR 26.27 dB,LPIPS 0.132,比STORM低36%,彻底解决了动态场景的模糊和伪影问题。
更令人惊叹的是视图外推能力——在1米车道偏移的极端场景下,EVolSplat4D的KID(核 inception距离)仅0.062,远低于STORM的0.104,意味着即使是未见过的视角,也能生成真实可信的渲染结果。
3. 对比逐场景优化方法:3分40秒达到同等精度
与需要逐场景优化的方法相比,EVolSplat4D的速度优势更是“降维打击”:
- SUDS:45分钟重建,PSNR 25.03 dB;
- StreetGaussian:7分钟重建,PSNR 27.27 dB;
- EVolSplat4D(1000次微调):3分40秒重建,PSNR 28.29 dB,LPIPS 0.048,全面超越所有逐场景优化方法。
这意味着,原本需要一天才能完成的10个场景重建,现在仅需30多分钟即可完成,且精度更高——自动驾驶仿真的效率将提升数十倍。
4.可视化比较
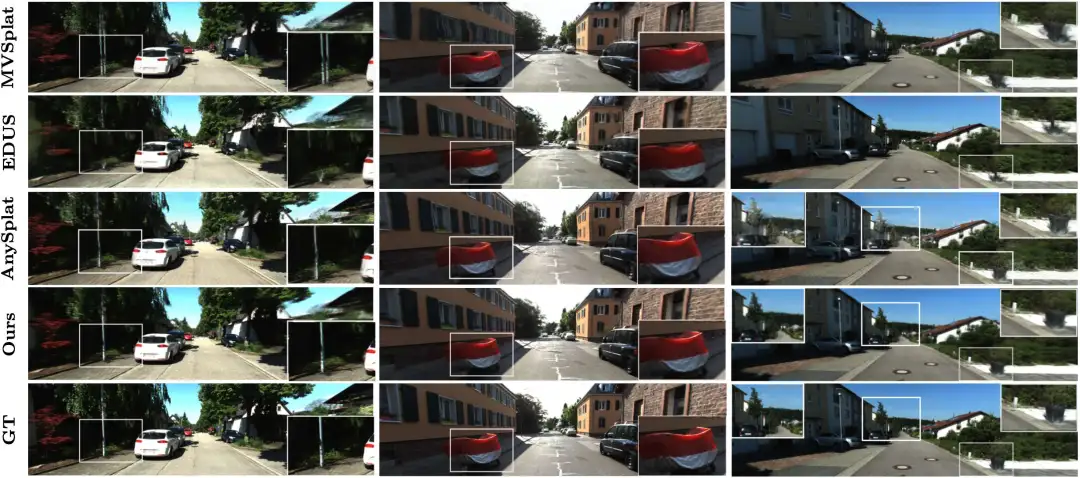
KITTI-360 数据集上与前馈式基线方法的定性对比
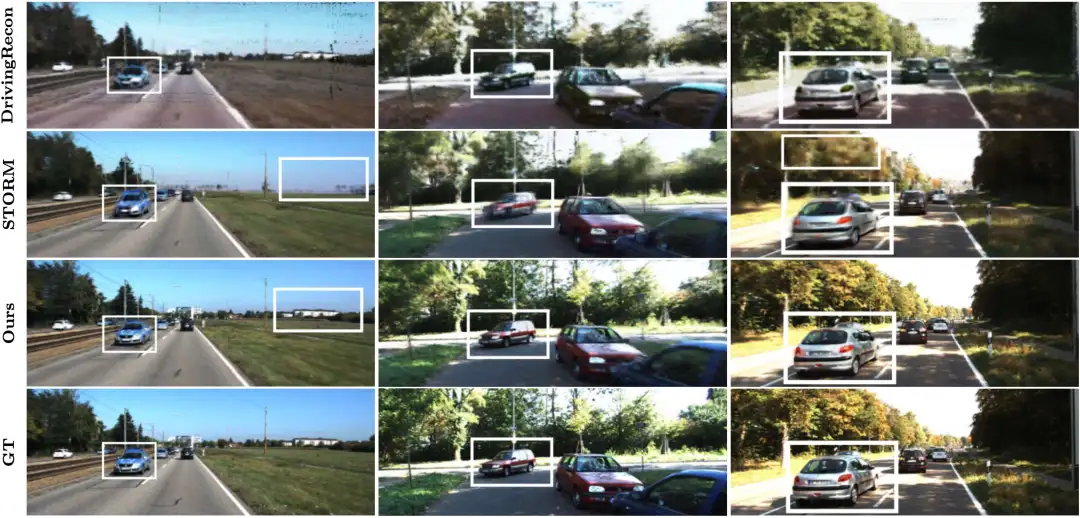
KITTI 数据集上前馈式推理的基线方法定性对比
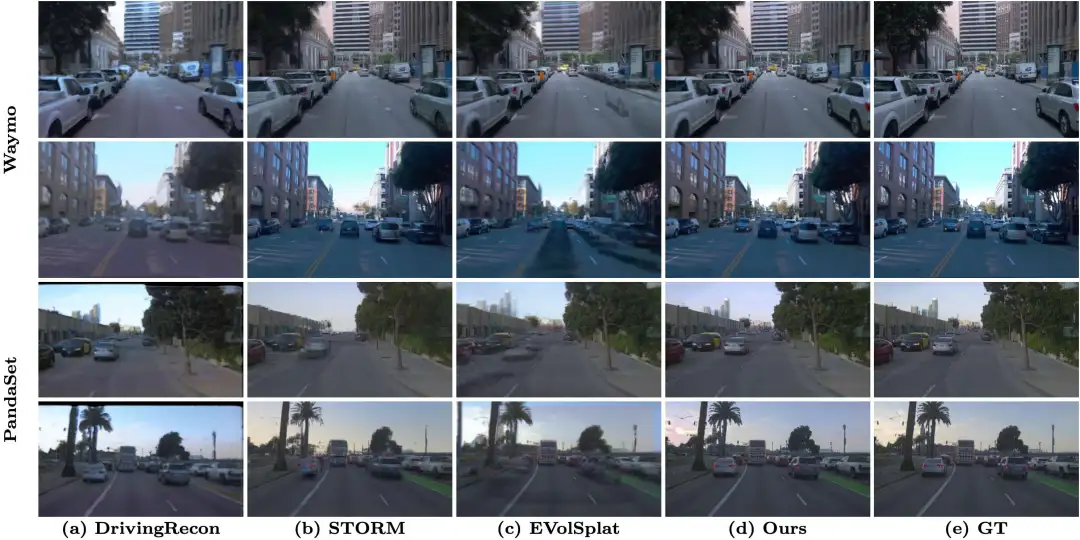
Waymo Open 数据集和 PandaSet 上前馈式推理的基线方法定性对比
应用场景
EVolSplat4D的突破,不仅解决了自动驾驶仿真的核心痛点,还能延伸到多个领域:
1. 场景编辑(Scene Editing)
提出的实例感知场景表示支持多种场景级编辑操作。借助解耦的 3D 高斯元,可以无缝替换特定车辆、将目标平移至新位置,或从环境中完全移除所有动态物体(具体见下图)。这些功能充分体现了面向目标的规范空间建模在仿真场景定制中的灵活性。
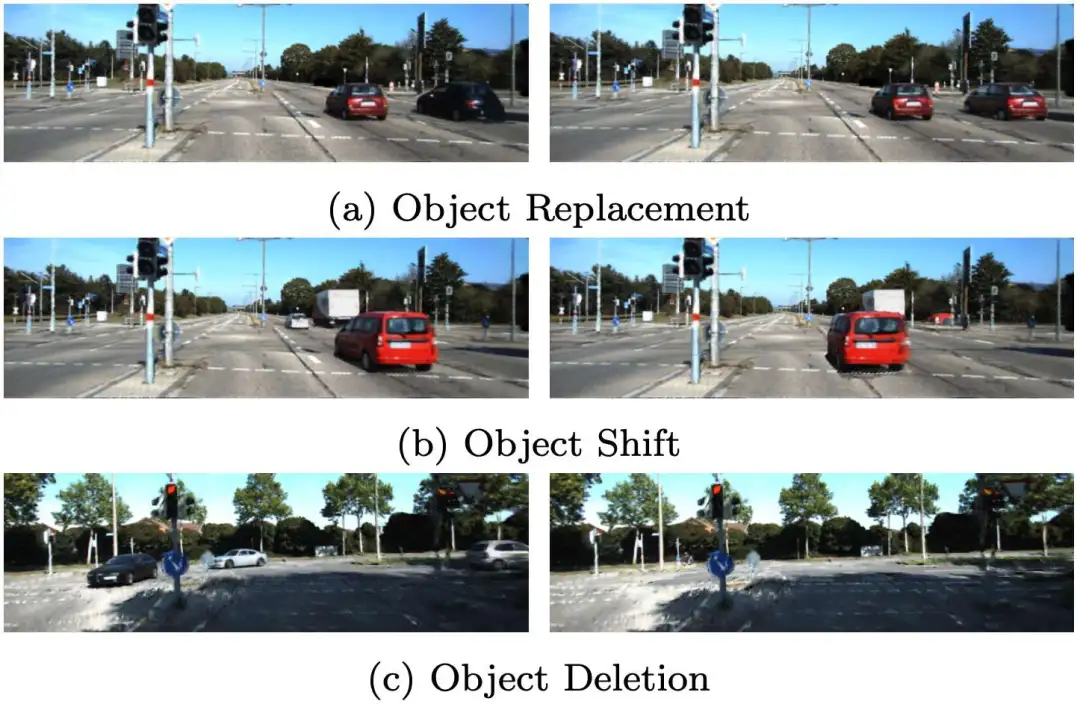
KITTI 数据集上的场景编辑结果。第一列和第二列的图像分别表示编辑前和编辑后的效果
2. 场景分解(Scene Decomposition)
所提出的混合重建框架通过将环境分解为三大组成部分(近距体积区域、动态目标及远处景物),实现了对 4D 几何结构的全面捕捉。如下图所示,成功将这些元素解耦为独立表示,生成清晰的分层结果,可直接应用于自动驾驶下游任务。
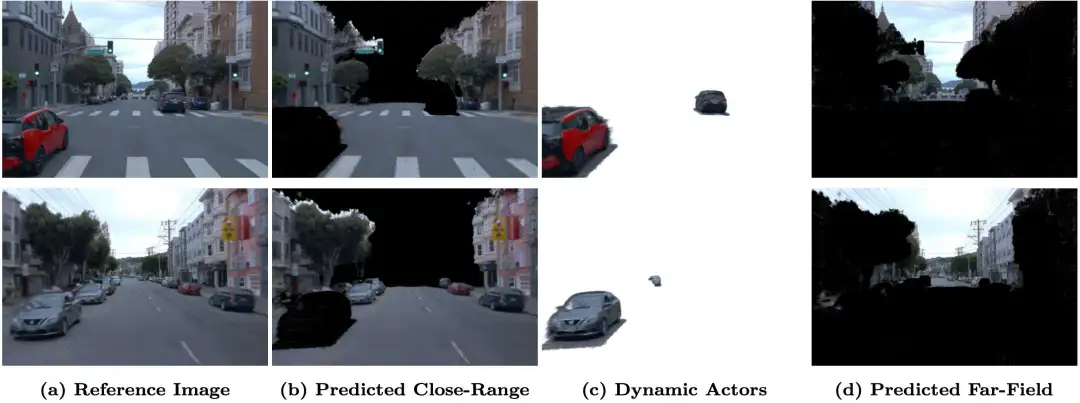
Waymo 数据集上的场景分解结果。能够清晰分解近距体积区域、动态目标及远处景物
总结
尽管EVolSplat4D表现惊艳,但仍存在一些值得优化的方向:
- 依赖LiDAR边界框:目前模型需依赖LiDAR预测的3D边界框来分离动态车辆,虽支持单目深度替代,但边界框精度仍影响动态重建效果。未来可集成端到端的视觉3D检测,实现纯相机输入的4D重建;
- 大基线外推性能衰减:当相机平移超过3米时,远处区域的渲染质量会下降。这是因为远处分支缺乏明确的深度先验,未来可引入更强的深度估计模型提升泛化能力;
- 非刚性物体支持不足:当前模型假设动态物体为刚性运动,无法精准还原行人、自行车等非刚性物体的运动。未来可融合非刚性动态重建方法,进一步拓展应用场景。
不过总的来说,EVolSplat4D的成功,不仅打破了4D重建的“不可能三角”,更为自动驾驶仿真提供了一套高效、精准、可扩展的解决方案。
....
#智驾行业的话语权,掌握在这三家公司手中......
以“华.元.魔”为代表的头部玩家,形成了三足鼎立格局。
《中.国.智能驾驶行业趋势白皮书(2025)》认为,能够穿越周期的幸存者,并非最早出发的,也非口号最响亮的,而是无一例外地在技术理想与商业现实间找到了那条狭窄的平衡带,它们普遍具备五大特征。
曾经,智能驾驶的故事由资本狂热书写,L4的技术梦想吸引无数玩家涌入赛道。但当行业从浪漫期行至商业化攻坚期,活下去成为所有参与者面对的最大难题。
2025年,累计交付超20万套城区NOA辅助驾驶系统的元戎启行,以一份逼近40%的月度市场份额成绩单,揭示出行业现阶段真正的生存法则:数据是未来燃料,装车量即话语权。
从高举高打的技术公司,到深度绑定长城、吉利等主流车企的规模化供应商,元戎启行的蜕变之路,是智能驾驶行业从技术竞赛转向数据竞争、从实验室 Demo 走向规模化交付的一个缩影。
根据《中国智能驾驶行业趋势白皮书(2025)》,并以元戎启行为例,外界能够看到当下行业竞争的本质:如何在技术、数据、商业与生态之间找到平衡,成为穿越周期的最终幸存者。
活下去,需要多少车?
2019年后,智能驾驶行业的共识逐渐被重塑。资本不再为遥远的L4故事买单,投资人只问两个问题:你拿到了多少量产订单?你的收入从哪里来?
《中国智能驾驶行业趋势白皮书(2025)》揭示,行业已从技术验证的浪漫期,硬着陆进入规模化与商业化并重的攻坚期。技术是基石,但装车量才是关键。没有车,就没有数据;没有数据,算法便是困在实验室的盆景,无法在真实世界的风雨中生长。
对于元戎启行这类从L4赛道转型的公司而言,活下去的路径变得异常清晰:服务足够多的车,越快越好。
这个“足够多”的阈值正在被市场迅速推高。白皮书指出,城区NOA(城市导航辅助驾驶)的前装渗透率预计在2025年底突破10%,进入规模化拐点。这片从高端车型快速下沉至10万至20万元主流价位的市场,已成为决定行业排位的核心战场。
截至2025年,元戎启行城市NOA系统累计超20万辆的交付量,其中,仅2025年10月单月,元戎启行在第三方城区NOA供应商市场中的份额就逼近40%。这背后,是元戎启行战略性的“车海战术”:深度绑定长城、吉利等主流品牌的畅销车型。
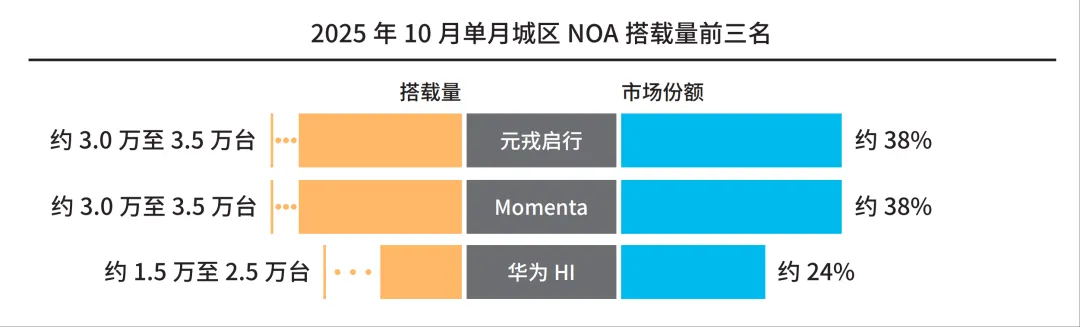
在新的竞争中,规模化数据积累比短期品牌溢价更具长期战略价值。装车量带来的,远不止是当下的收入。更多车辆上路,产生更多、更丰富的场景数据;这些数据喂养和迭代算法,提升系统体验;更好的体验又能助力获取更多订单。
对于元戎启行而言,将技术路线与商业路径进行高强度协同,坚持“纯视觉”和“无图化”路线,本质上是为了适配主流市场对性能与成本的严苛要求,从而实现方案的大规模上车。
此外,通往真正无人驾驶的道路无法仅靠封闭测试完成,必须通过大规模量产车辆在真实道路上积累的数据洪流来驱动。这份行业共识,也让每一份辅助驾驶系统的量产订单都变成了通往未来的门票。
数据决定智驾的未来
《中国智能驾驶行业趋势白皮书(2025)》明确指出,智能驾驶行业已进入“AI大模型驱动阶段”,技术范式发生了根本性变革。
这场变革的核心驱动力,并非仅仅是更精巧的模型架构,而是喂养这些模型的海量、高质量数据。无法构建这一能力(数据闭环)的公司,将迅速落后。数据闭环的效率,已超越算法模型本身,成为更核心的竞争力。
通往真正无人驾驶的道路,被行业共识验证为必须穿越数据洪流。而获取这洪流的路径,在2025年的中国市场主要裂变为两条清晰且竞争激烈的赛道。
第一条路:前装量产车的“群众路线”。这是以元戎启行、Momenta为代表的公司选择与车企合作获得海量合规数据。将L2+级辅助驾驶系统搭载于长城、吉利等品牌的走量车型上,收集覆盖全国数百城、数以亿计公里的长尾场景。
第二条路:特定场景运营的“精英主义”。以Robotaxi(自动驾驶出租车)为代表,小马智行、文远知行等公司在深圳、北京等政策先行区划定区域,进行高精度、全维度的示范运营。这种模式能在相对受控的环境下,收集深度结构化数据,专注于打磨极端场景下的处理能力,为最终的无安全员运营做准备。
两条路径并非泾渭分明,而是共同指向同一个目标:构建一个高效、低成本、自动化的数据闭环系统。这个系统需要完成从真实场景数据采集、自动化标注、仿真测试、模型训练到OTA部署的完整循环。白皮书强调,其速度与成本,直接决定了算法迭代的节奏和商业化的步伐。
对于元戎启行而言,押注前装量产路线,意味着其技术选择必须彻底服务于数据获取的效率,“纯视觉”与“无图化”技术路线,一方面是为了降低单车硬件成本以适配主流车型,另一方面也源于一个深刻认知:依赖昂贵的高精地图会限制数据收集的广度与鲜度。只有摆脱对预制地图的依赖,系统才能在最广阔、最真实的场景中学习进化。
装车量等于话语权
《中国智能驾驶行业趋势白皮书(2025)》显示,城区NOA的竞争已演化为第三方供应商与车企自研体系之间,在技术、量产、成本与数据闭环能力上的全方位较量。
在这场较量中,以“华元魔”(华为、元戎启行、Momenta)为代表的头部玩家,凭借从技术研发到大规模量产交付的完整闭环,形成了三足鼎立格局。而打破均势、定义自身地位的核心筹码,正是装车量。
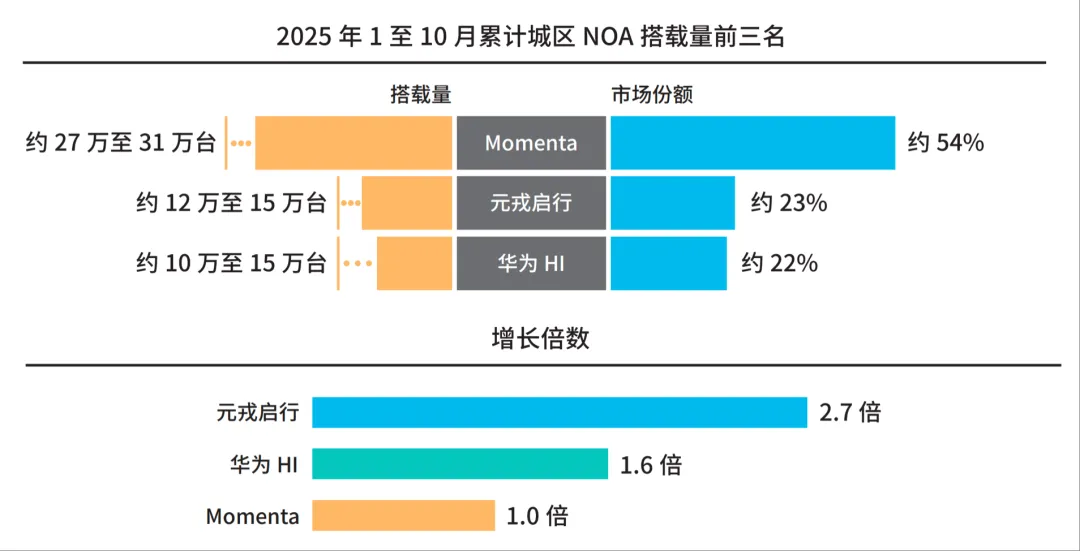
话语权,首先体现在与客户的谈判桌上。
当一家智能驾驶供应商的解决方案已搭载于超过数十万辆主流品牌汽车上,并获得市场验证时,它所带来的便不再只是一套技术方案,而是经过规模化检验的可靠性、用户接受度以及宝贵的数据反哺能力。
元戎启行选择与长城、吉利等销量庞大的主流品牌深度绑定,其逻辑正在于此。报告分析认为,这种“走量优先”的策略,比短期服务于高端品牌的溢价更具长期战略价值。
因为车企在选择合作伙伴时,不再仅仅评估技术参数,更会权衡其方案能否快速、稳定地铺开到自己的主力车型上,从而在市场竞争中抢占先机。装车量,成为了供应商技术实力与商业能力的双重信用背书。
更深层的话语权,关乎商业模式的生死转型。
白皮书强调,行业已跨越技术验证,进入从1到N的规模化交付阶段,而可持续的盈利模式仍是普遍挑战。共识在于必须从“一次性硬件销售”转向“软件+服务”订阅制。
然而,订阅模式的前提是规模。没有足够庞大的用户基盘,就无从摊薄高昂的研发与芯片成本,更无法形成可持续的软件迭代收入和用户付费习惯。
只有当装车量达到一定阈值,供应商才有底气与车企共同设计“硬件预埋、软件激活”的销售策略,或推动按服务收费的分成模式,从而真正掌握价值链中更具持续性和高利润的环节。
对于元戎启行这类第三方供应商而言,装车量直接带来了稳定的量产订单收入,这能帮助他们穿越资本寒冬。同时,基于海量装车量所构建的数据闭环和算法迭代能力,又使其能够不断升级产品,形成“更多车→更好用→更多订单”的增长飞轮,从而向资本市场和合作伙伴展示出清晰的、可预期的未来盈利能力。
从卖硬件到卖服务
2026年,特斯拉宣布取消自动驾驶FSD套件的一次性买断选项,仅提供订阅选项。这虽然是一家公司的商业策略调整,却也给全行业提了一个醒——依赖“一次性硬件销售”也许并非长久之计。
《中国智能驾驶行业趋势白皮书(2025)》提出,可持续的盈利模式仍是普遍挑战,行业共识在于必须从“一次性硬件销售”转向“软件+服务”订阅,并探索未来基于自动驾驶的出行服务运营。
“卖硬件”的陷阱在于,它永远在追逐成本与售价之间脆弱的平衡。白皮书提及,“100万台车才能摊薄7纳米芯片上亿美金的流片成本”。这意味着,如果仅靠一次性出售硬件,供应商要么陷入无利可图的消耗战,要么因定价过高被车企拒之门外。
“卖服务”的订阅模式,试图描绘一个不同的未来。它的逻辑是:供应商以前期合理的硬件价格(甚至微利)确保方案大规模上车,之后通过持续提供的软件算法升级、功能激活等订阅服务,获得长期、可持续的收入。
只不过,这个美好蓝图有一个极其坚硬的前提:必须要有足够庞大的装车量作为底座。
首先,是成本的摊薄。海量的订单能将芯片、研发等天文数字般的固定成本,分摊到每一辆车上,使前期硬件定价具备市场竞争力。
其次,是数据的积累与迭代飞轮。订阅制服务的核心价值在于持续优化体验,而优化的燃料是数据。白皮书将“数据闭环的效率”视为比算法模型更核心的竞争力。只有当这个闭环基于足够大的数据池高速运转,软件更新才能带来用户可感知的显著提升,订阅服务才有持续收费的理由。
最后,是用户习惯与商业生态的培育。当几十万用户每天都在使用某个系统,持续的OTA升级教育了市场:智能驾驶并非一锤子买卖的硬件功能,而是一种需要持续运营、可以不断进化的服务。
元戎启行等头部供应商的规模化交付,正是在为整个行业跑通订阅服务进行压力测试。
幸存者五大特征
2022年后,智能驾驶行业的融资窗口骤然收紧。曾动辄估值数十亿美元的明星初创公司,有的黯然退场,有的被并购吸收,行业从百花齐放的拓荒期,进入残酷的淘汰赛。
《中国智能驾驶行业趋势白皮书(2025)》认为,能够穿越周期的幸存者,并非最早出发的,也非口号最响亮的,而是无一例外地在技术理想与商业现实间找到了那条狭窄的平衡带,它们普遍具备五大特征。
特征一,是拥有可闭环的数据流与迭代能力。
“数据闭环的效率已成为比算法模型本身更核心的竞争力。”白皮书断言。这意味着,公司的价值不再取决于其算法论文的优劣,而在于能否构建一个从真实世界采集数据,到自动化处理、训练模型、再部署上车的“飞轮”,并让这个飞轮以最低成本和最快速度转动。
元戎启行选择了两条腿走路中的一条:通过前装量产车获取数据洪流,其与长城、吉利等主流品牌的绑定,目标明确——让系统在最常见、最复杂的中国城市道路场景中持续学习。正如白皮书所指出,无法构建这种能力的公司,其算法将沦为无源之水,迅速落后。
特征二,是技术路线与商业路径协同。
智能驾驶公司的技术选择必须为其商业模式服务,并能在市场中验证。这是一条务实的铁律。早期不少公司执着于炫技式的多传感器融合和高精地图依赖,导致方案成本高昂,无法落地。
元戎启行押注纯视觉、无图化路线。这并非纯粹的技术偏好,而是与其“为车企提供低成本、可量产解决方案”的供应商定位高度协同。这条路线显著降低了单车硬件成本和对基础设施的依赖,使其方案能够快速适配10万至20万元的主流价位车型,从而赢得了走量的订单。
特征三,是具备健康的现金流或明确的盈利路径。
单纯依赖融资输血的模式已被彻底摒弃。2022年后的资本寒冬让行业清醒,幸存者必须证明自己能赚钱,或至少能看到清晰的赚钱路径。
报告指出,只有足够装车量,才能摊薄高昂的芯片与研发成本,并积累起支撑付费订阅的用户基数。对于元戎启行来说,稳定的现金流来自前装量产订单。每交付一套系统,都带来直接收入。更重要的是,规模化装车量为其探索“软件+服务”的订阅制盈利模式铺平了道路。
特征四,是在产业生态中找到不可替代的生态位。
在华为、特斯拉等巨头环伺的战场,幸存者避免了正面硬刚,而是找到了属于自己的生态位。白皮书指出,这种生态位可能是在价值链的特定环节建立深度优势。
作为一家独立的第三方全栈解决方案供应商,元戎启行既不像华为那样提供从芯片到云端的全栈捆绑,也不像车企自研团队那样封闭。它专注于算法与软件系统的迭代,并以开放姿态与主流车企合作。
这种定位,使元戎启行成为那些希望掌握产品定义主导权,同时又需要顶尖智能驾驶技术外援的车企的“善意伙伴”,其与多家主流品牌形成的深度绑定,正是这一生态位价值的体现。
特征五,是具备产品规模化交付能力。
这是将一切蓝图变为现实的最后,也是最关键的一环。从Demo演示到实验室原型,再到稳定交付给成千上万用户的质量一致的产品,其间隔着巨大的工程化鸿沟。
元戎启行在2025年实现单月城区NOA搭载量跻身行业第一,证明了其不仅有能力研发,更有能力进行大规模、高质量、按时交付的工程化管理。
....
#在地.平.线搞自动驾驶的这三年
从自动驾驶转到xx智能已经有一年的时间了,之前在自动驾驶上一系列工作和一些个人思考还一直没有好好的做个总结。(Ps: 虽然广义来说,自动驾驶属于xx智能的子领域,但是现阶段二者所面临的问题和解决问题的具体方式还是存在较大差异,所以还是算是进入了一个转向了一个新的方向。)
可预期的短时间内,主要精力投入应该不会放在自动驾驶上了,但总觉得该给自动驾驶的这段经历留个记录。倒不是说这些工作多“惊天动地”,反而有些是“关注度不高但挺实在”的探索,它们可能没上过热搜,但个人认为其确确实实解决过实际问题,希望可以给做相关方向的朋友提供点参考。
在做自动驾驶期间,我主导过研究方向主要包括3D融合感知(Sparse4D系列)、轨迹预测(EDA)、端到端运动规划(SparseDrive)、传感器仿真(DriveCamSim)、交通流仿真(UniMM)以及智驾基础模型(LATR),这些研究之间的相互关系如下:
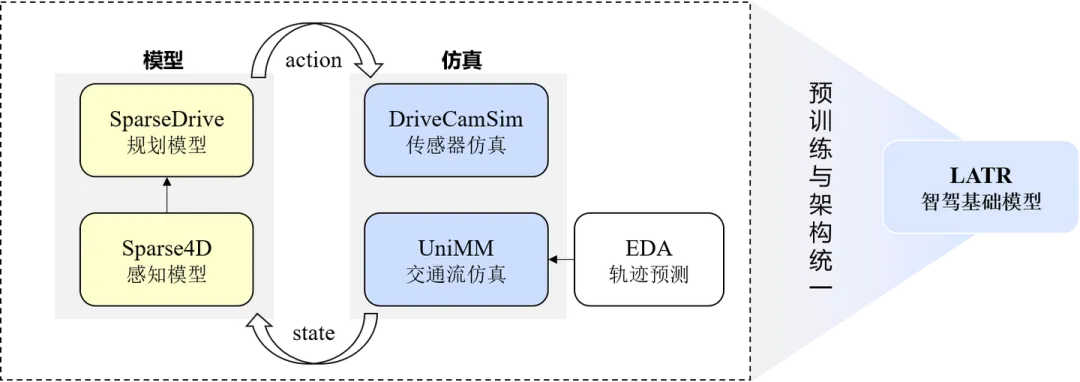
这些工作的递进关系可概括为:
- 从目标检测开始逐步往端到端planning拓展,构建一个强有力的端侧policy;
- 针对端到端模型的闭环评测和训练,构建传感器和交通流的仿真模型;
- 通过大数据量和大参数量构建一个智驾领域的基础模型,一方面可以为所有下游任务做预训练,另一方面想通过多任务统一的方式激发模型潜能。
所有研究点合在一起,目标是构建一个完备的自动驾驶算法系统。下面针对上述的7个研究点展开进行说明。
1. Sparse4D系列:极致性能的多传感器融合感知框架
当时受Tesla的影响,掀起了一波BEV浪潮,大家都涌入BEV方案的怀抱,但是我们认为BEV并不是一个那么合理的方案。首先是从图像特征构建BEV特征,并没有带来信息量的提升,但是却需要消耗大量的计算成本(特别是对于端侧芯片);其次BEV特征限制了模型的感知范围,感知范围、感知精度和计算效率三者难以平衡,面临着不同驾驶场景需要训练不同的BEV分辨率的模型,迭代起来很麻烦。
所以我们尝试利用稀疏query加内外参投影采样的方式,直接从多视角图像特征得到融合感知结果,最终做出了Sparse4D系列。
Sparse4D v1是最基础的版本,核心就是下图的deformable aggregation算子,它实现了纯稀疏范式的融合感知,query是稀疏的,query和image feature的交互也是稀疏的,理论计算复杂度远小于BEV方案或者其他dense方案。
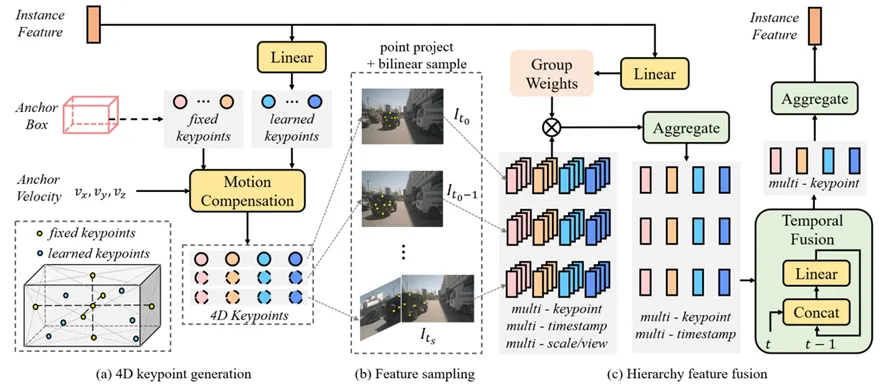
Sparse4D v1 - deformable aggregation
但是v1留下了一个坑,就是它的时序融合计算复杂度是O(T),计算量随着融合的帧数线性增长,对训练和推理都不太友好,所以在Sparse4D v2中我们将时序融合方式从多帧并行采样改为了recurrent的形式,每一帧的instance feature都会往后传递,时序复杂度降低至O(1),并且原理上可以融合历史所有帧的信息。
除此之外,为了让模型在GPU上推理速度更快,我们对核心算子deformable aggregation进行了高效的实现,实现了并行的最大化。 Sparse4D v2不仅获得了更快的训练和推理速度,还大幅提升了模型的性能。
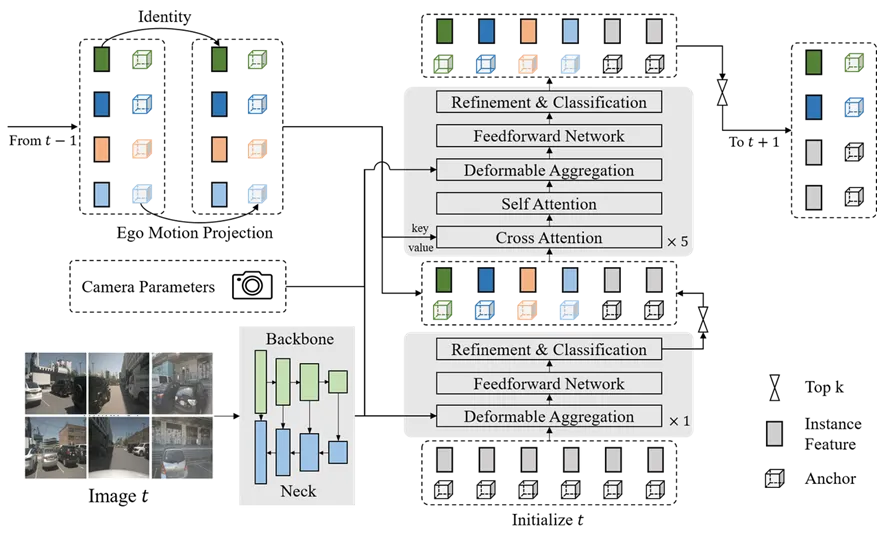
Sparse4D v2
到了Sparse4D v3,有两个方面的提升,一个是对感知性能更加极致的追求,另一个是向下游任务拓展。性能方面,我们通过temporal denoising、decouple attention、quality estimation让模型的检测能力和收敛速度都有显著提升。
不过这些改动还只能算一些小tricks,Sparse4D v3的核心贡献是它用最为简洁的方式实现了联合检测与跟踪,无需对detector做任何修改,无需任何tracking label,就能实现稳定跟踪。Sparse4D v3获得了非常好的感知性能,无论是在公开数据集还是在内部的业务数据集上,而且从2023年10月提交到nuScenes leaderboard至今,它仍然位居camera-only detection和tracking两个榜单的第一名。
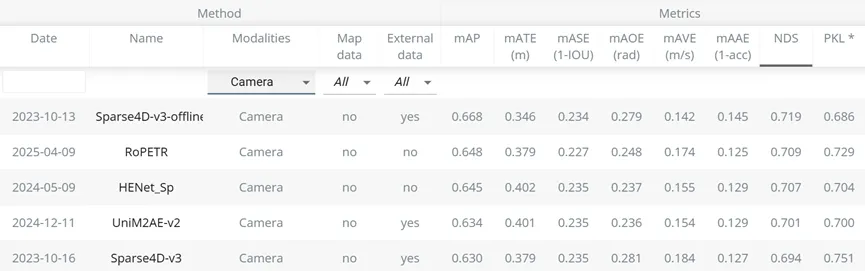
nuscenes camera-only 3d detection leaderboard
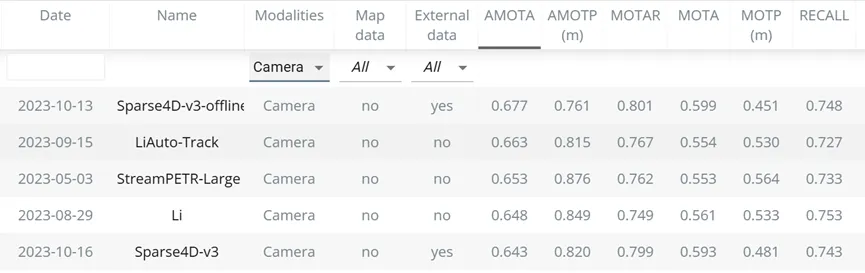
nuscenes camera-only 3d tracking leaderboard
2. SparseDrive:从感知迈向端到端规划的一次尝试
当我们有了Sparse4D这样一个动态目标检测模型之后,我们希望它能进一步往其他任务上拓展,于是就有了SparseDrive。SparseDrive的主要工作包括两个方面,一个是将online mapping任务加进来,另一个是设计了一个简单的motion planner,实现了端到端的他车轨迹预测和自车轨迹规划。SparseDrive实现了5个任务,检测、跟踪、建图、预测和规划,并在nuScenes上进行了大量的实验,这五个任务在当时都获得了不错的效果。
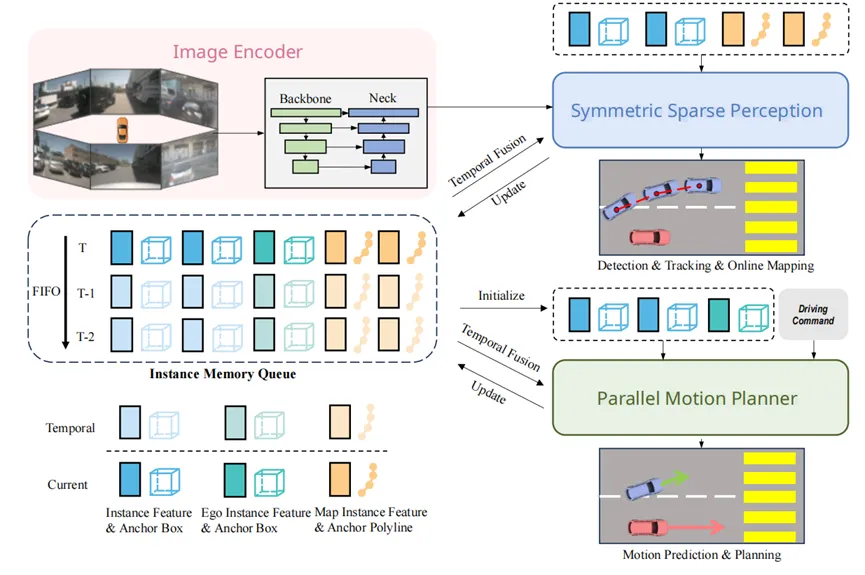
SparseDrive framework
有人可能会提出疑问,以稀疏feature作为planner的输入,是不是会丢失很多信息,比如非白名单物体的避障是不是就实现不了?我认为是完全不会的,稀疏feature虽然进行了检测loss进行了约束,让它们尽可能对白名单有目标更高的响应,但有个query的数量非常多,远超待检测目标数量,其他负样本的query会覆盖到所有的可视范围,这些query会受到planning loss的影响,关注到每个对规划有影响的区域。
SparseDrive存在的问题也很明显,它的planning decoder结构比较简单,而且端到端任务只在nuScenes上进行了开环评测,开环的指标只能说明它具备拟合能力,说明不了闭环性能。因此目前我们还在尝试通过仿真器进一步设计decoder的模型结构和训练方式,以达到更好的闭环性能。
3. EDA & UniMM:轨迹预测与交通流仿真的协同研究
轨迹预测是一个非常经典的任务,接入learning之后轨迹预测的算法爆炸式增长,效果也确实得到了显著的提升。但是这些算法大多集中在研究网络结构怎么设计,并没有触及轨迹预测的核心问题。
众所周知,目标检测算法的核心问题就是正负样本分配,无论是YOLO、FasterRCNN还是DETR,网络结构的不同并不是影响检测性能的关键,于如何设计一个让模型最容易学习的正负样本分配策略才是关键。其实在轨迹预测任务中,依旧如此,无论是Dense(HOME、DenseTNT)还是Sparse(TNT、MTR)方案,它们都是定义了某种形式的anchor,并给这些anchor分配正负样本的标签。我们发现轨迹预测中的anchor及其正负样本分配会严重影响预测性能,不正确的分配策略会使得预测结果模态坍缩或者精度不足。
因此我们提出了EDA(Evolving and Distinct Anchors),一种动态更新的anchor,并在匹配时采用NMS策略,让模型能更容易收敛。EDA可以很好的建模轨迹预测的多峰分布,并且具备良好的预测精度。EDA的另一大优势在于它可以和大多数轨迹预测模型完美契合,即插即用。
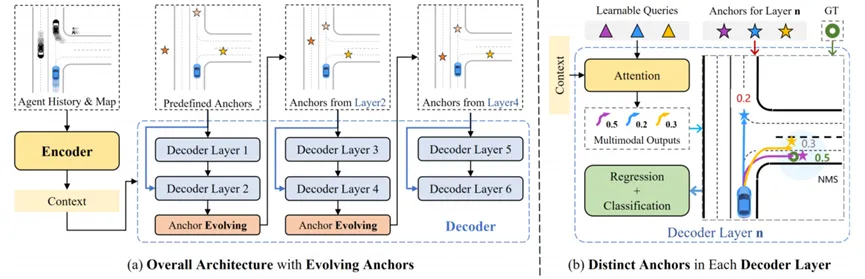
EDA framework
回到轨迹预测这个任务本身,它其实是连接感知和决策的中间件,一方面受感知噪声的影响,使得预测性能受限,另一方面由于输出的未来分布非常复杂,下游想用起来也是一大难点,有的规控团队可能只使用了一条预测置信度最高的轨迹,这也限制了预测带来的收益。多重因素叠加,使得轨迹预测算法的应用处于一个非常尴尬的状态。但是轨迹预测算法本身的研究还是有很必要的。这里就需要谈到另外一个任务,交通流仿真(agent simulation)。
轨迹预测和交通流仿真在输入输出形式上极其相似,都是输入历史帧的结构化信息,输出未来一段时间内所有交通参与者的轨迹。二者的区别在于轨迹预测是开环的,交通流仿真需要闭环进行rollout。
这里开环和闭环本质区别在于建模多个交通参与者之间的相互关系,熟悉轨迹预测任务的朋友可能知道,轨迹预测包含边缘轨迹预测和联合轨迹预测两个子类,边缘轨迹预测建模每个交通参与者的独立分布,而联合轨迹预测建模的是两个或多个交通参与者的联合分布。联合轨迹预测其实是一个伪问题,而交通流仿真通过每一个step都重新采样的方式绕开了直接建模多车联合概率,其更能反映算法的性能。
我们提出了UniMM,这篇文章研究了现有的主流交通量仿真方案,解释了那些设计是影响算法性能的关键因素。UniMM将主流的两大类模型Continuous Mixture Models和GPT-Like Discrete Models进行了统一,并提出了通用的算法框架。UniMM是以问答的形式展开的,回答了这个任务的一些关键问题。有兴趣的可以去翻阅一下这篇论文。
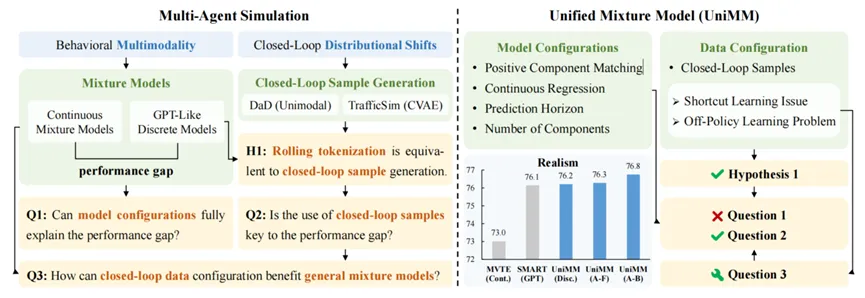
UniMM
4. DriveCamSim:高度可控的自动驾驶传感器仿真
当我们有了端到端模型之后,下一步我们需要思考的不仅仅是如何优化端到端模型本身,还需要思考如何高效的评测。实车评测当然是最为直接的方式,短期内用实车评测没有任何问题,但是当我们的端到端模型提升到某个阈值之后,发现不同时刻的小规模实车评测结果难以正确的反映模型性能。例如,当模型MPI达到50以后,需要至少实车跑多少公里才能准确的测出不同模型之间的差异呢?每次都需要多辆车同时开几百升至几千公里才能较为准确的反映模型性能。
很显然,到这个时候模型的迭代已经很困难了。那在可以预见的未来,当模型MPI达到几百或者几千之后,再想通过实车测试反映模型性能几乎就不可能了。所以,我们必须在云端去构建一套精准的评测系统,最为直接的实现方式就是构建仿真系统。这里说的仿真不是基于物理引擎构建的仿真,而是能对真实数据回放的、足够拟真的仿真系统。
仿真的关键在于如何做到拟真性和可控性。基于3DGS的仿真方案在可控性和拟真性上都有一定的优势,但是它本质还只是一个重建方案,新视角合成质量无法保证,仿真rollout过程中会涉及到大量的未观测信息的脑补,这是重建方案无法实现的。而且动态场景的重建pipeline比较复杂,存在各种corner case,也会导致最后仿真效果并不理想。所以我们希望以生成算法为中心来构建仿真系统。
我们将仿真系统解耦成交通流仿真和传感器仿真两部分,利用UniMM基本解决了交通流仿真问题,剩下的就是传感器仿真了,因此我们做了DriveCamSim。传感器仿真的核心是用尽可能多的确定性信息作为condition,生成传感器信号,并且保证condition和生成结果之间的一致性要足够好。现有的大部分生成算法,直接把各种feature全部塞进一个DiT里面,这种是完全不行的,模型没有办法去感知整个3D空间,没有办法建立3D condition和2D image之间的相关性,想通过硬堆数据大力出奇迹的方式来实现传感器仿真不是明知之举,在后续需要多车型、多传感器配置泛化的时候,会暴露出更多问题。
在DriveCamSim中,我们通过显式投影的方式,来约束3D-2D和时序的一致性。对于DriveCamSim模型本身来说,完全解耦了时间和空间的概念,可以生成任意帧率、任意相机内外参、任意相机数量下的图像。相比于那些完全基于attention硬拟合图像patch之间的相关性的方案来说,DriveCamSim是有非常显著的优势的。DriveCamSim可以适应的condition也很充分,包括3D bounding box、地图、自车pose、相机内外参以及任意数量的参考图像。这是我个人非常喜欢的项目,但因时间精力限制,其落地潜力尚未充分挖掘,期待后续有人能将其推向实用。
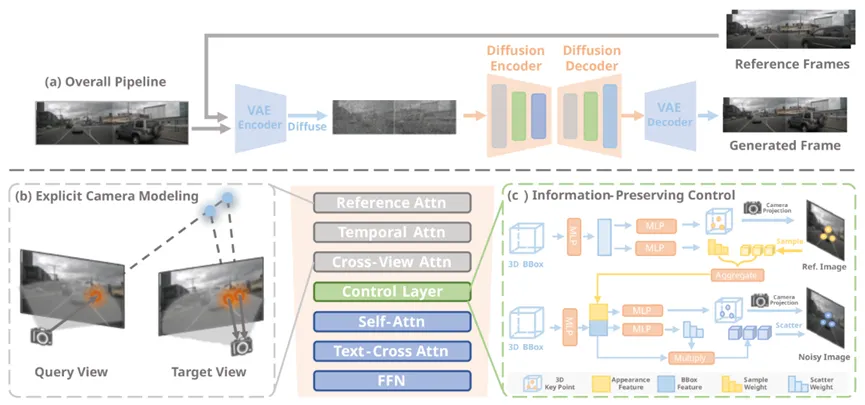
DriveCamSim Network Structure
5. LATR:智驾基础大模型初探
受大语言模型的启发,我们想在智驾场景下也通过大数据量和大参数量去构建一个性能强劲的基础大模型。我们初期规划智驾基础模型应当满足以下两点:一个是需要利用海量数据进行无监督训练,让它能够基本理解智驾场景的语义、空间和时空;其二是在接入下游任务做监督训练时,要尽可能复用预训练中的参数,减少新增参数,所以在模型架构上要能实现多任务的统一。
我们首先利用Mask Image Modeling的方式在海量数据上进行无监督训练,通过masking策略的设计,让模型需要通过相邻视角和时序帧的特征来估计mask部分的图像,使得模型能够理解空间和时间的关系。这部分工作注意就集中在masking策略上,做到尽可能让模型补全的难度加大,才能达到更好的训练效果。
接着,我们设计一个可以统一自动驾驶所有任务的decoder-only的模型结构,新增一个task只需要新增一个query到task output的MLP,最大程度发挥预训练参数的作用。我们将3d detection & tracking、online mapping、ego pose estimation、motion prediction、planning、depth estimation和novel-view synthesis这7个任务融合到了这个统一框架中,在效果上达到了和SparseDrive相当的水平,初步证明了所设计的模型结构及其训练方式是切实有效的。
(注:该项目未以论文/技术报告形式公开,略有遗憾。)
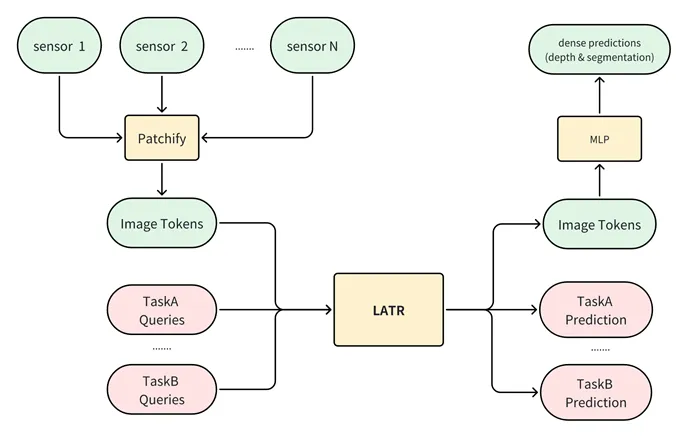
LATR: Look Around TRansformer, 多任务统一架构
总结与展望
上述7个模块共同构成了自动驾驶系统的核心链路。从现在这个回顾过去的角度来看这些工作依旧是正确的,它们形成了一条正确的技术路径。首先,我们做了融合感知Sparse4D和端到端规划SparseDrive,让自动驾驶汽车从看得懂到开得稳;其次,考虑到后续端到端模型长期迭代对评测的需求,我们通过将仿真系统解耦成交通流仿真和传感器仿真两个部分,提出了UniMM和DriveCamSim;最后,我们通过大数据量、大参数量以及合适的模型结构设计,搭建了智驾基础模型LATR。
目前由端到端模型主导的端侧方案逐步趋向于成熟,选择拥抱端到端的自动驾驶厂商都获得了非常显著的性能提升。大家在进一步优化端到端模型的同时,需要将目光放得更加长远。端到端模型的性能可不可以得到进一步提升,很大一部分都是由评测方式决定的。如何高效地、准确地完成模型评测是核心问题,如果完全依赖实车测试,大概率在进度是会被甩开的。构建评测系统,有两条路径可以并行尝试:
- 直接训练评测模型(类似RL中的Critic Network),以观测与动作为输入输出动作质量(安全性/舒适性等),简单直接易落地;
- 通过仿真系统评测(基于UniMM与DriveCamSim),可解释性更强且更利于迭代。
再往后展望的话,若是端侧模型和评测系统都得到充分发展,下一步就是如何利用RL提升模型性能了。当前阶段RL在自动驾驶上的作用还无法被完全发挥出来,很大一部分就是因为评测系统的不成熟。此外,智驾基础模型的研究同样关键——它既是所有任务的终极载体,也可能是十年后自动驾驶厂商的核心竞争力。
....
#Tesl,a FS,D就是一个端到端大模型
BigBite解析~
上周柱哥转载知乎文章的那篇《有消息称FSD不是端到端One Model》,引起了大家很广泛的讨论。批评和支持的声音都很多,当时分享这篇文章主要是提供一个角度看端到端:一个VA的端到端不是万能的,One Model可以承担95%的主要功能(甚至更高),但也会增加一些小模型辅助做优化。
今天给大家分享一篇业内工程师BigBite视角下的FSD解析,观点主要如下:
- Tesla FSD就是一个大模型;
- 大量的模型参数文件其实是一些小任务Head的模型参数,而不是独立的单模型;
- HW4的显存带宽高达384GB/s,理论上可以在36Hz支持约100亿参数的端到端模型。
以下是原文:
最近几天有人根据快一年前(2025年4月)著名Tesla黑客green爆料的Tesla FSD芯片上有上百个神经网络文件的信息,断言Tesla FSD其实是数百个小场景组合,然后还说马斯克的特长是把“落后”的东西组合起来形成非常好的工程化效果,原链接贴在这了。本来我对此感觉比较搞笑,没想到一早上起来好几个朋友问我意见,索性就把我回答他们的内容稍微整理下发出来。
先说结论:Tesla FSD就是一个大模型,这点Ashok在今年ICCV上已经给过一个端到端模型的简单示意图,确认了Tesla端到端自动驾驶使用的是一个巨大的神经网络来完成Photon In到Control Out的计算。
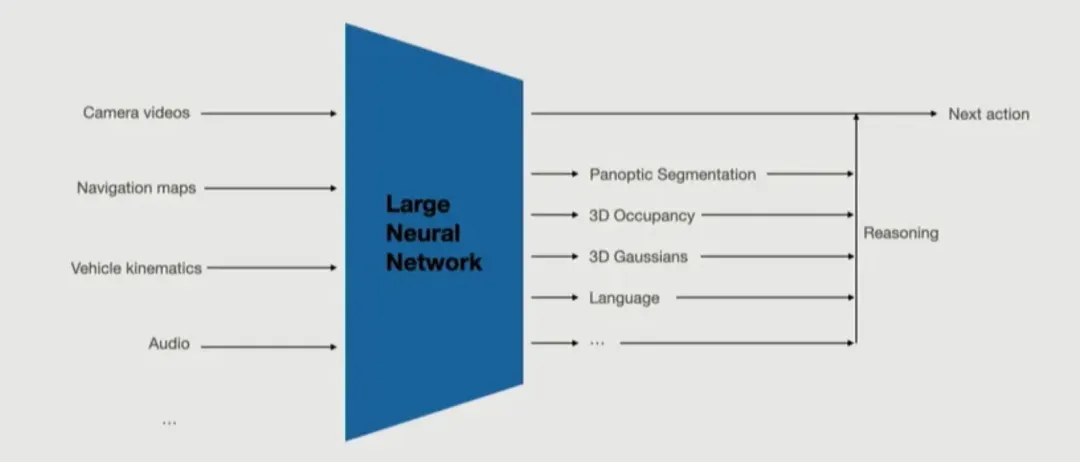
ICCV Ashok分享的TeslaFSD是一个大模型的架构
质疑FSD不是一个大型网络的主要观点在于green发现FSD有数百个神经网络参数相关的文件,并且其总规模相当大,HW3上的v12.6上A核1.2GB,B核2.3GB,HW4上的v13则达到A核2.3GB,B核7.5GB,其中A核包含189个参数文件,B核110个,其中61个共享。
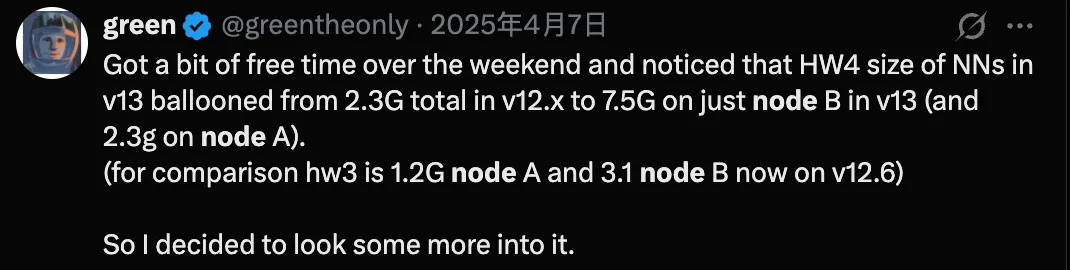
green发现的FSD模型参数文件信息
这里可以发现B核神经网络参数远多于A核,同时A,B共用的只有61个参数文件,也就是说早年AI Day上分享的A,B核互成冗余的设计实际上在Tesla V12端到端化之后神经网络规模急速膨胀之后已经很难实现完全的A,B核冗余(其实传说中V11阶段就很难实现完全的冗余备份了)。
而B核参数文件数量虽少,总文件大小却更大,其实原因在于后期端到端的模型规模远超从前,而这部分模型参数主要集中在B核。也就是说在green挖掘出来的模型参数文件中,有数量众多但规模不大的参数文件可能不属于端到端网络。这比较合情合理,因为Tesla是一个不使用雨量传感器的公司,其自动雨刷甚至都是有一个饱受诟病的视觉神经网络控制,再加上大量进行数据采集trigger相关的小的感知任务依旧大部分从V11以前继承下来,因此这里边大量的模型参数文件其实是一些小的任务Head的模型参数。
另外green的发现其实提到这里边很多模型参数其实是一个大模型的部分参数,有着FSD_E2E_FACTORY_PART_X这样的命名规则。AI Day上Tesla曾介绍其模型是通过分布式部署的,因此将模型参数分片存储或者进行切分存储在不同芯片上实际上是大模型时代里比较常见的现象。
而让人们怀疑Tesla并非是一个大模型的更重要的原因来自于Tesla有限的显存带宽很难支持使用规模巨大的端到端模型并保持其号称的36Hz高频Control输出。确实HW3使用的LPDDR4-4266带宽只有68GB/s,要支持36Hz输出,模型参数规模理论上不超过1.8GB,Tesla HW3仅对INT8支持良好,因此这也就是说FSD 12稠密计算的理论上限大概就是18亿参数,而考虑到理论实际的差异,这个数字更难达到。刚才说过,green发现HW3上承载大部分端到端参数的NodeB上参数文件大小2.3GB,大致上与此匹配。而HW4上Tesla使用了成本高昂的GDDR6显存,显存带宽高达384GB/s,有消息称HW4上Tesla使用FP8的参数类型,而这样的模型理论上可以在36Hz支持约100亿参数的端到端模型。参考HW3与HW4 NodeB的参数文件大小,基本上与Tesla FSD Release Note之前说的参数量增加3.5倍左右可以对应起来,因此我认为这个3.5倍模型参数增长我认为是可信的。
而Elon曾说后续还会以10倍的增量提升FSD参数,这个被很多人质疑,原因就是目前看来无论HW3还是HW4上,显存带宽留给参数scaling的空间已经不足了。关于这个问题其实在财报会议上Elon和Ashok都给出了比较明确的回答,之所以Tesla在19年的HW3和23年的HW4这样相对比较老的芯片上能够以非常高的频率运行令行业比较震惊的端到端大模型规模(某国内头部端到端方案传闻0.7B模型参数量),其原因就在于Tesla使用了类似MOE的架构。通过MOE架构,FSD可以在显存容量可以容纳的基础上,通过部分激活专家网络,节省显存带宽开销,最大程度提升模型等效参数量。考虑到HW4上16G显存容量以及可能的模型并行部署策略,HW4上FSD V14模型参数再大幅增加,我觉得也不是不可能。并且通过Elon的评论我们还知道,Tesla可能确实会在某些场景,如厂区自动出场使用一些Localized参数,我的理解这些是通过类似MOE的方式增加的额外专家参数,各种场景主要参数都是公用,这也符合无论什么场景,大部分驾驶是有共同性的这样一个第一性基本原理。而那种原文所谓的根据人工设计的规则完全切换一套独立的小模型的方式不仅不端到端,甚至实际很难实现,因为在场景切换的过程中很难保证前后模型输出的轨迹可以平滑连接,必然会造成很不舒适甚至危险的情况。
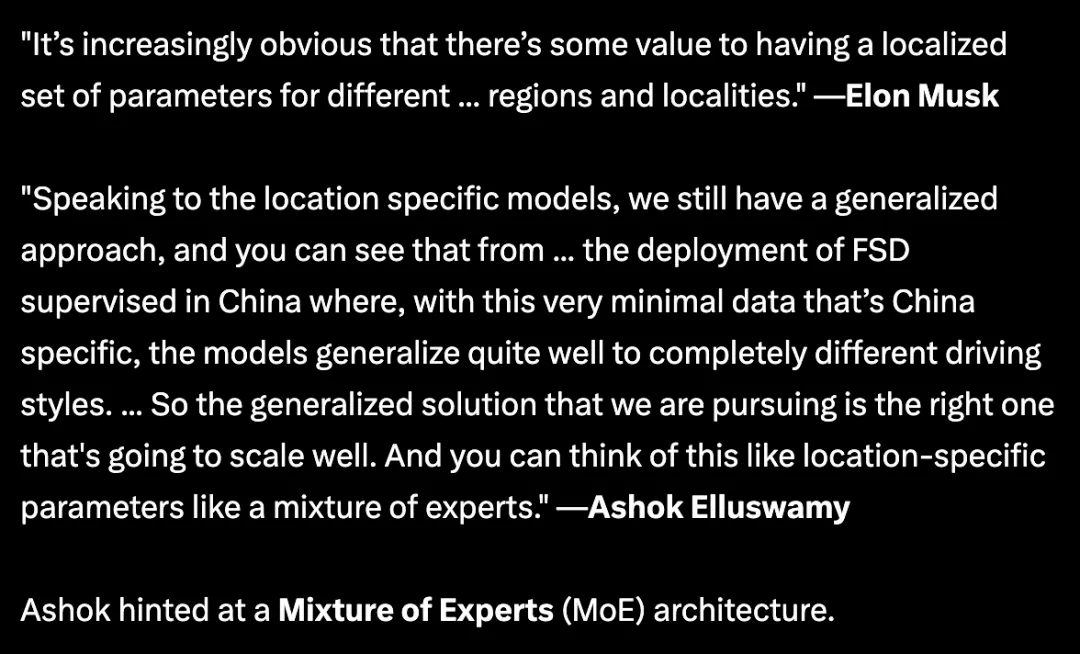
Elon和Ashok对于FSD使用MOE架构的评论
总而言之,Tesla FSD是一个端到端的大模型方案。根据ICCV上的分享,其端到端的程度甚至可能超出此前的普遍估计。至于说FSD其实是落后的技术方案更是无稽之谈,作者感觉对技术先进性有一定的误区,不是只有科学家的发现才代表先进性,许多人类伟大科技进步都是技术进步。就好像可回收火箭是先进的科技进步,利用猛禽发动机组合阵列的方式获得巨大推力推动星舰也是先进的科技进步,火箭相关研发人员经常被称作火箭科学家,但是火箭技术成熟落地依靠的其实更多是工程创新。另外马斯克是美国工程院院士。如果这样人以及Tesla,SpaceX这样的公司都是落后的,伪装的科技公司,那么请告诉我哪家是先进的科技公司。
....
#一段式、VLA和世界模型
轻.舟智.航L2/L4智驾方案解析~
21号,轻舟首个基于单征程6M的城市NOA方案,已正式上车理想L系列智能焕新版。23号轻舟开了一场发布会,里面技术的部分,给大家分享一下。
单J6M实现一段式端到端+强化学习,说实话是有点东西的。和大家一起拆解下整体的网络架构:
- 输入部分是时序图像、Lidar、SD导航和自车位姿;
- 经过多传感器时序BEV融合后,得到全局的BEV表征;
- 后续接多任务的解码head,输出道路拓扑、OCC特征、交通元素特征和Agent特征;
- 这些特征用于得到动静态、OCC和交通信号等相关信息;
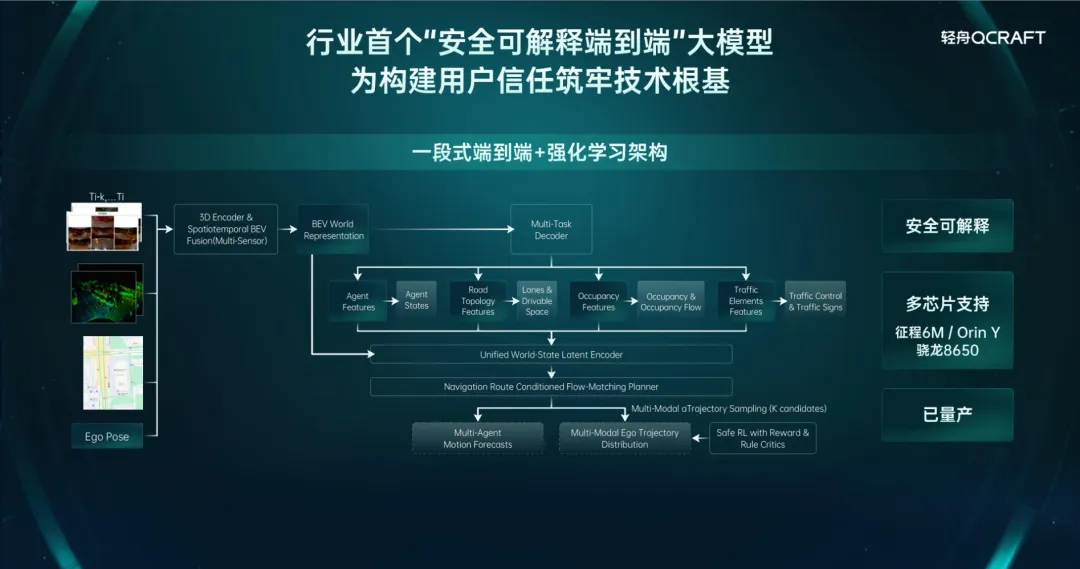
以上的部分是一个常见的OneModel架构,下面是不一样的地方:
- BEV表征和上述Agent/OCC/静态/交通元素的特征共同输入到统一的世界-状态隐编码器(Unified World-State Latent Encoder);
- 进一步接一个Flow-Matching Planner解码出他车的运动预测和多模态的自车轨迹。
后续利用Safe RL(增加规则的判断)进一步优化自车轨迹。这一套架构整体上来说,其实不复杂,难的是在J6M 128TOPS的算力上实现。第一时间就有人问柱哥这是不是真的。
DiffusionDrive和Flow Matching已经是多家公司验证过可量产的算法了。有两个算法也推荐一下,Diffusion Planner和Flow Planner,Flow Planner是Diffusion Planner的改进版本,是清华AIR詹仙园老师团队下面的工作。
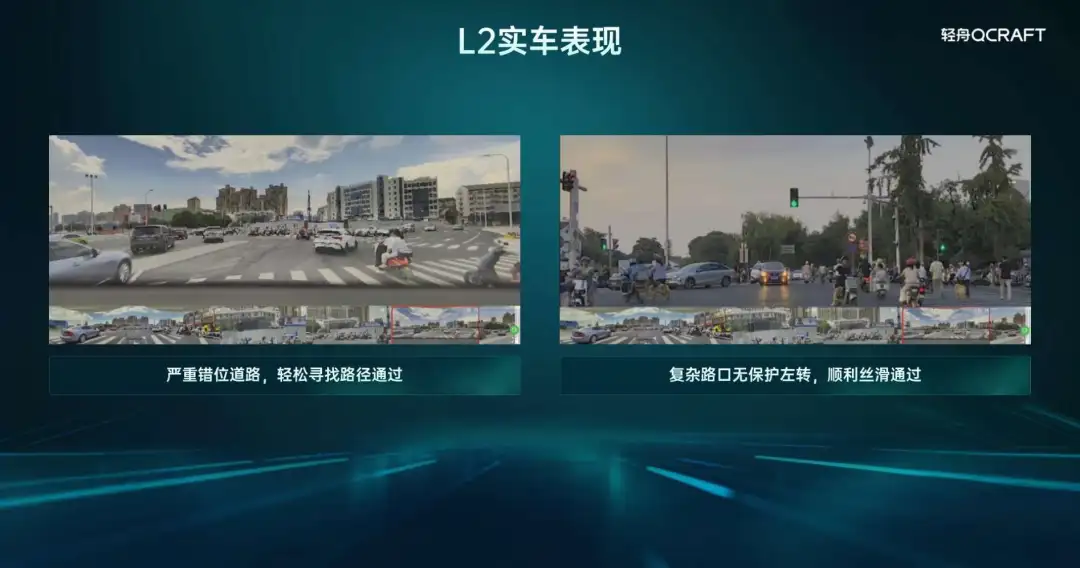
轻舟也放了几个困难场景的demo。下图是L2实车的表现,严重错位道路和复杂路口的无保护左转,效果都很不错。严重错位的道路很考验静态的基本功,不止是道路/车道线这些信息,也考验SD接入模型中的表现。
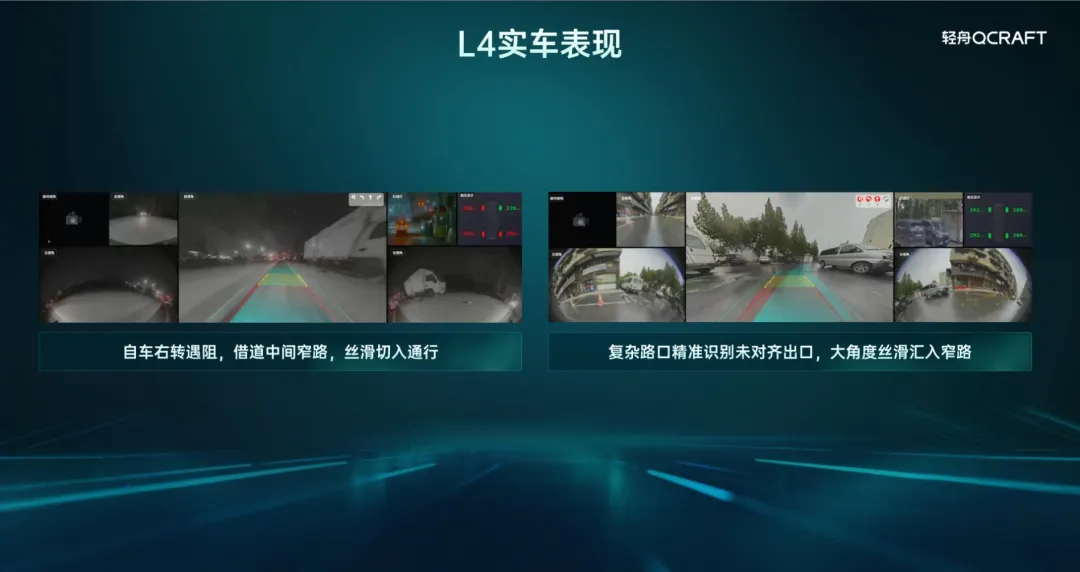
下图是L4实车的表现,大家可以看一下。
同时,轻舟也放出了下一代自动驾驶模型架构。核心理念是将 VLA与 World Model融合到一个端到端系统中。
如果把Transformer Decoder和Reasoning in Language的模块去掉,还是可以理解为一段式端到端的,整体看起来有些像小鹏的VLA 2.0。
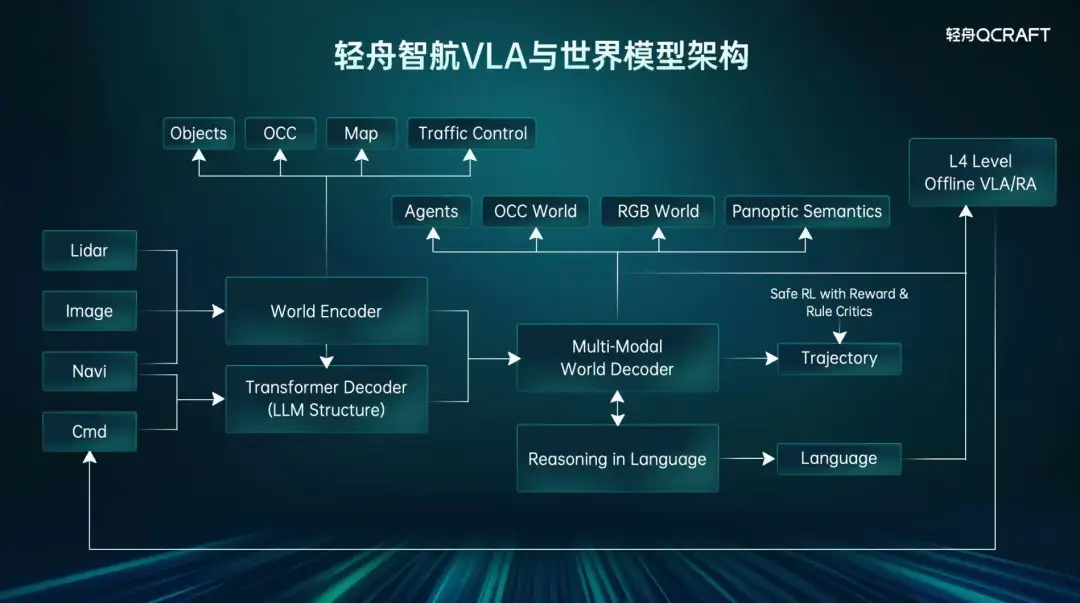
根据上图,可以分为五个部分:
- 输入增加cmd,判断是用于交互的语音指令;
- World Encoder,判断应该还是BEV特征,可以直接解码得到动静态/OCC/交通控制信息;
- 增加Transformer Decoder,用于处理环境中复杂文本信息、困难场景描述和车端语言指令,用于CoT的中间表示;
- 增加Multi-Modal World Decoder,作为世界预测模型的一个生成式模型,包含了对未来世界的动态演化能力;
- 多模态的世界解码器和语言推理互相交互,要能够强对齐,这一点也是VLA的核心,否则幻觉很严重
最后是强化学习微调自车轨迹,和上面一段式一样,判断是给端到端兜底的模块。
右上角,轻舟针对L4级自动驾驶提出了RA机制,保障系统级安全。在这个意义上,VLA 并不只是一个“展示能力”的系统,而是 L4 系统规模化运行的基础设施。这个有些意思,后续等待更进一步的信息展开解读。
轻舟智航联合创始人、CEO于骞下了一个判断:VLA或者世界模型,都不会是自动驾驶技术的终极答案。
以上。
....
#对.话复.旦.贾.萧.松教.授
从端到端、RL再到仿真,做有用的研究比刷SOTA更难但更有趣
作为端到端自动驾驶研究浪潮中的一名前沿探索者,他的研究之路始终围绕行业痛点并领先热点一步。从 2021 年开始以端到端自动驾驶作为博士研究课题,到2023年将基于世界模型的强化学习(Model-based RL)应用于自动驾驶,再到2024年开发闭环评测基准与生成式仿真,他的每一步选择都体现着他和合作者们对行业技术趋势的敏锐洞察和稳步布局。
他就是贾萧松,目前在复旦大学可信xx智能研究院担任助理教授。他本博毕业于上海交通大学,深耕自动驾驶领域多年,已在顶级学术会议期刊发表论文20余篇,引用3000余次,代表性工作包括:DriveAdapter、Think2Drive、Bench2Drive、DriveTransformer、Bench2Drive-R、DriveVGGT等,相关工作已成为端到端自动驾驶经典基线。
以下来源于xxx与他的圆桌访谈。
1、开局即拿下一个里程碑:在还没有行业共识的情况下开启研究,是一个有准备的美好巧合
xxx:2022-2023 年,您和您的合作者发表了“Think twice before driving: Towards scalable decoders for end-to-end autonomous driving[1]”。这篇文章中稿了2023年的CVPR。这一年恰好被誉为端到端开山之作的UniAD 也获得了 CVPR 最佳论文,端到端自动驾驶开始成为行业焦点并自此进入量产“兵家必争”之地。从现在往回看似乎是顺理成章的,但是回到那个时间点之前,大多数人其实是质疑“端到端”的。想问一下为什么您和您的团队在这么早的时间就敏锐而勇敢地入局这一领域?
贾萧松:其实团队还有两篇更早的端到端自动驾驶论文,ST-P3 – ECCV22、TCP – NeurIPS 22。我在自动驾驶全栈中的老本行是轨迹预测,从2019年开始研究。在研究中发现,轨迹预测作为一个中间模块,经常受制于上下游:面对上游感知模块,常用数据集的设定下能拿到的只有框的坐标、速度以及车道线。然而车和人的轨迹,其实受到很多因素影响,比如,行人招手代表他要横穿马路,那么对于看不到行人姿态的轨迹预测模型来说,预测难度极大。面对下游规控模块,一个经常发生的现象就是我们模块输出的6种模态,规控实际只用 top1——这意味着,即便我们在数据指标上不断突破,但对下游应用的实际帮助并未达到预期。
恰好2021年时我要选定博士课题,我的博士导师是严骏驰老师,合作导师是OpenDriveLab的李弘扬老师。严老师在应用机器学习去端到端解决行业问题有着丰富的经验,李老师在视觉与自动驾驶问题上有着深厚的积累,他们提出希望我的研究能更具学术深度和长远价值。彼时,端到端自动驾驶在行业内还被很多人看作 “玩具”,大家普遍认为通过优化人工规则仍有很大空间,但两位老师一致看好大规模神经网络的发展潜力,认为端到端大一统的自动驾驶才是未来的趋势。
当时,我面临了一个重要的选择:是继续深耕本科期间已经有多篇发表的轨迹预测方向,还是转向端到端自动驾驶。轨迹预测方向虽然可以确保稳定的论文产出,但它历史悠久、较为成熟,要在这一领域实现根本性突破并不容易;而端到端自动驾驶在行业内还被很多人看作 “玩具”,鲜有研究,需要自己定义问题、解决问题。经过深思熟虑,我选择了后者,哪怕这意味着做很多 “吃力不讨好”的苦活,而且论文数目上可能吃亏:相比基于已有代码刷点快速出成果,从头搭新范式的代码库需要大量的前期工作;但我始终觉得做从零到一的、解决实际痛点的研究,比刷sota,长远来看更有用、期望收益更高。当然确实也发现,这种当时来看的“苦活”,现在也都收获了应有的认可。
总而言之, 从 2021 年 年底开始,在严骏驰老师和李弘扬老师的指导下,我与陈立、司马崇昊、吴鹏浩、吴胜超等同学们一起组成小组,正式投身端到端自动驾驶研究。
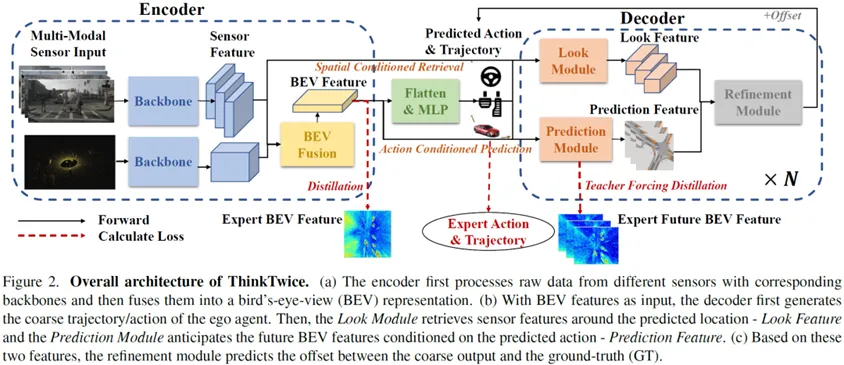
图1 Think Twice before Driving: Towards Scalable Decoders for End-to-End Autonomous Driving
当时全球范围内专注这一方向的团队并不多,除了我们,知名的大组包括图宾根大学的Andreas Geiger,英国的Wayve,多伦多大学&Waabi的Raquel Urtasun等。开始时我们是以很学术、很前沿探索的心态去做的,没想到越做效果越好,最后就成了业界的主流。这也让我很感慨于神经网络的范式威力。感觉是一个有准备的美好的巧合。也感谢两位老师的高瞻远瞩,替我博士期间定好了一个非常有潜力的课题。
xxx:现在都已经上车了。
贾萧松:对,所以说两位老师明见万里。我还记得微信上打了一个电话,我还说:“这方向没啥人做过,会不会有点难。”但一想到做轨迹预测时遇到种种根本性问题,就毅然决定范式级别的换方向,哪怕是从零到一,最后有幸做成了。但在当时其实不确定性还是很高的。很多人都觉得端到端都是闹着玩的。
2、“将基于世界模型的强化学习技术引入自动驾驶”拿下第二个“里程碑”
1)海量数据的加入并不能提高模仿学习的能力
xxx:回到2023,您和合作者们开发了Think2Drive[2],利用基于世界模型的强化学习算法,首次解决了CARLA Leader 2.0,这一步的“布局”是出于什么考虑?或者说是研究过程中你们发现了什么新的痛点?
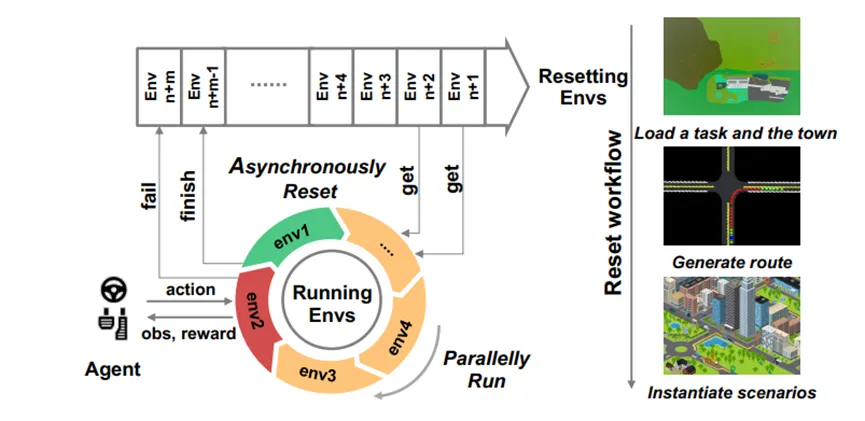
图2 Think2Drive:端对端自动驾驶评测框架的横向比较
贾萧松:团队从 2021 年开始研究端到端领域,最初我们认为,端到端自动驾驶只要通过暴力堆砌数据,就能攻克所有场景。做到23年初逐渐发现模仿学习的瓶颈:即便在仿真中数据无限的理想情况下,它也无法达到100分,对于真正困难的场景,可能60分都难。这一点,在26年的今天,不少业内车企在现实世界数据中也再次确认了这一现象。当下热门的大模型领域也有类似趋势:大模型的 pretraining 和 SFT 本质上都是模仿学习,通过 Next Token Prediction 学习人类的 Token 规律,但大模型领域现在也大力转向了强化学习。这一趋势背后的逻辑在自驾、xx、大模型都相同:模仿学习就像鹦鹉学舌,智能上限有限——它没有明确的对错判断标准,只是机械模仿人类行为,输出与人类不一致而就会被惩罚(Loss)。但是,与人类不一致并不代表是错的,而且人类数据也无法覆盖所有的分布。
2)“要攻克就要攻克最难的基准”!
贾萧松:正是基于这样的认知,2023年初我与严骏驰老师汇报了我的想法,想开始强化学习应用于自动驾驶的研究,不再在原有架构上做开环研究,修修补补。记得是23年初一个寒冷的春天,我向严老师、当时来实习的师弟李奇峰(他有丰富的强化学习经验),介绍了将刚刚挂在arXiv上的DreamerV3强化学习算法由原本的《我的世界》拓展到自动驾驶的整体方案构想。在23年时,Sora还没有出现,世界模型这个词暂时也没有被广义化,世界模型还是一个只有做强化学习的人才会使用的词 – Model-based RL里的Model,所以自己再次很幸运的走到了浪潮前面一步。
在选择具体应用场景时,考虑到CARLA Leaderboard 1.0版本场景简单,仅包含跟车、红绿灯识别等基础功能,相关研究的性能已经很高,趋于饱和;而更具挑战性的CARLA Leaderboard 2.0版本包含大量长尾场景,当时行业内的平均分数不足 1 分(满分 100 分),竞争停留在 1.2 分对 0.8 分的微小差距层面。因此,我们目标就是解决CARLA Leaderboard 2.0,要攻克就要攻克最难的基准。
经过与严老师、李奇峰学弟联手攻关,历经一年的攻坚克难,最终打造出首个能完整解决CARLA Leaderboard V2复杂场景的Think2Drive,也是目前唯一一套基于学习的方案(另有一套基于人工规则的方案,逐个场景写定制化代码解决)。这一套模型,有力推动了社区由CARLA Leaderboard 1.0的简单场景测试到CARLA Leaderboard 2.0的复杂场景测试,让端到端驾驶的测试进一步贴近现实难度。
3、如何定义有生命力的框架?让越来越多人用起来和提问题
xxx:在2024年,您和合作者们开源了端到端自动驾驶测评框架 Bench2Drive[3],整理了 44 种挑战性场景构建评测,动机是什么?这套框架目前还有迭代么?目前我们看到其实是有的。
图3 Bench2Drive:端对端自动驾驶评测框架的横向比较
贾萧松:在开发Think2Drive之后,考虑到当时 Carla Leaderboard V2 的闭环评测虽有丰富的素材但缺乏完善的评测基准,我当时的想法就是用Think2Drive作为专家模型去采集CARLA Leaderboard 2.0的模仿学习数据,让端到端社区不再沉迷于简单的测试,能够在真正困难的场景下进行测试。并且去适配当时比较流行的nuScenes数据集的格式,能够测试最前沿的基线模型,比如UniAD、VAD,将nuScenes和CARLA两个社区连接起来。此外,还希望解决当时UniAD依赖的mmcv版本过旧不支持4090/A800训练的问题,实现在A800上训练UniAD,并且在这个基础上,后续实现了一套基于国产深度学习框架计图(Jittor)的自动驾驶算法库JAD以及性能评测库Bench2Drive-Jittor。
基于上述动机,我和严老师讨论出了Think2Drive之后规划的下一个Project – Bench2Drive,记得当时拉的微信群名是“CARLA V2-nuScenes”,然后和杨振杰、李奇峰、张致远(大三本科生)三位学弟,在电院3-519开始了几个月的高强度开发,虽然工程量很大,但大家都知道自己在做的是一个能够改变整个社区的大项目,所以干劲十足,从立项的2月份到最终赶上了NeurIPS dataset track在6月的截稿。开源一年多来,我们收到了社区的广泛认可,也收集到大量宝贵建议。在此也向大家宣布,近期我们将推出 V0.4 版本的重大拓展,包括新增 occupancy 等功能、修复已知 bug、补充更多基线模型等。端到端自动驾驶的未来,必然要跳出简单的 benchmark 竞争,敢于挑战 nuScenes 之外的复杂场景,这也是行业发展的必然趋势。
xxx:有在自己后续工作中用到么?我们看到DriveTransformer[4]和DriveMOE[5]有用到Bench2Drive测评,同时还推出了针对自动驾驶大模型的基准Bench2Drive-VL[6]
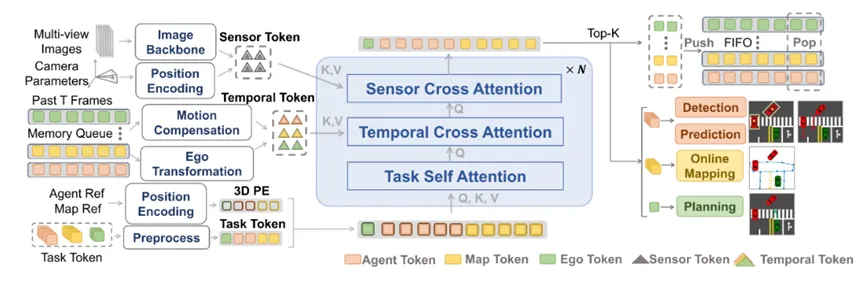
图4 DriveTransformer架构
图5 Bench2Drive-VL
贾萧松:在后续工作中,Bench2Drive 已得到充分应用,比如团队的多任务大一统的DriveTransformer模型和首个自动驾驶结合MoE的DriveMoE模型就采用该框架进行测评。同时,针对自动驾驶视觉语言大模型的闭环评测的发展需求,我们推出了 Bench2Drive-VL[6]框架。
xxx:有没有开发针对自动驾驶世界模型的测评框架?我看到最近有一篇重磅工作刚开源,也有多个知名实验室参与,是WorldLens
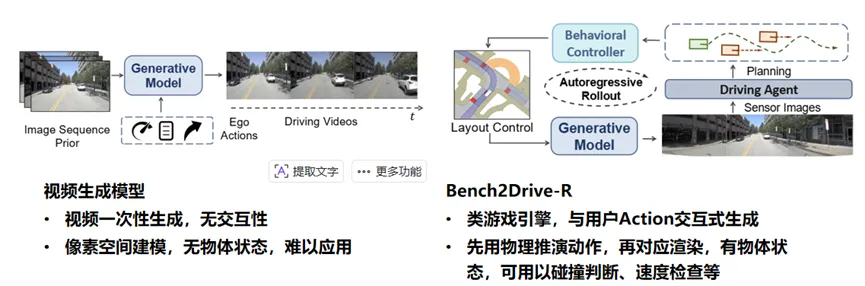
图6 交互式仿真模型Bench2Drive-R[7]
贾萧松:有的。其实在24年6月开发完Bench2Drive之后,一个马上的想法就是,既然Bench2Drive不够真,那么可不可以利用生成式模型来让仿真真实起来。有一个高保真的仿真环境,那么不管是Bench2Drive的闭环评测,还是Think2Drive的强化学习,都可以用真实世界数据去进行。
当时,在自动驾驶领域,做视频生成的工作已经有一些,但是他们都是一口气输出多帧,这样实际上并不符合仿真的需求:输出一帧-用户做动作-对应的再输出一帧。因此,我和游浚琦(大三本科生,DriveTransformer是和在他大二期间一起开发出来的)等合作者合作完成了一个交互式自回归视频生成模型 + nuPlan行为规划器的一个生成式闭环仿真器 Bench2Drive-R。在24年时候,这个概念是较为新颖的;在25年我们很高兴看到在通用视频生成领域和自动驾驶视频生成领域,都有大量的工作去研究自回归的交互式视频生成 – 因为大家都发现无法交互的视频,其实对于用户来说可用性会有一个巨大的缺失。
您提到的WorldLens [8]就是在自动驾驶视频生成浪潮下,一篇解决领域痛点需求的、非常出色的工作,它突破了当前自动驾驶视频评测依赖 FID、FVD 等基础指标的局限,提出了多项进阶评价标准,更加全面的衡量自动驾驶生成模型的性能。
4、比中稿和SOTA更好的也许是做一篇有影响力的工作
xxx:近几年贾老师的围绕端到端算法、评测、数据集等方面做了很多工作,这些工作我看下来都有个共同点,就是尽可能覆盖多的场景、任务、或者是兼容尽可能多的框架、输入尽可能多模态的信息。从这个角度看,每项工作的周期应该不会短,而且任务相当艰巨,除了论文发表的角度,有没有其他一些核心支撑您做这样一系列庞大的工作?
贾萧松:其实这也是我这段时间和师长们、同行们、合作者们交流后的共识。大家现在都有类似的想法或观点:发一篇论文当然是很好的,但更好的或许是做一些有影响力的、有用的工作——让工作能被大家用到,真正产生实际价值,实际推动这个领域的进展。如果说刷SOTA是精益求精从1到100的过程,那么攻克行业内的硬骨头,解决实际存在的痛点这样从0到1的过程也是很重要的。比如在我们最新的一篇工作空间召回自动驾驶(Spatial Retrieval Augmented Autonomous Driving)中,就提出了一个自动驾驶的新“玩法”:对于车端或云端的感知、决策、仿真模型们,能不能不仅仅依赖于当前时刻的图片,能不能赋予他们使用以往存下来的图片的能力(例如,百度街景、高德街景、谷歌街景等),这样他们就被赋予了长期的记忆。我们发现这样额外的信息,对于感知和决策,确实都带来了巨大的收益。
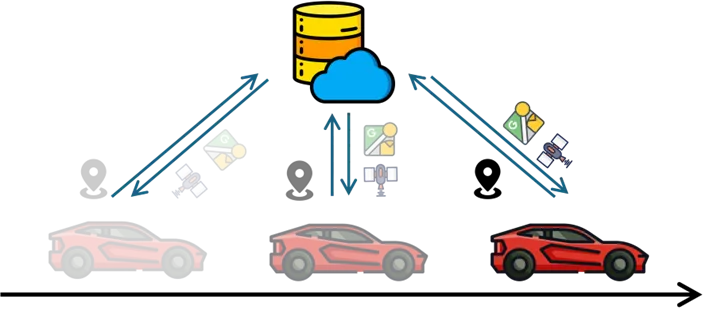
图7 Spatial Retrieval Augmented Autonomous Driving带记忆召回的自动驾驶系统 [9]
在这里也要特别感谢师长们信任我、支持我以及合作者们愿意去投入进来,去做这种从0到1的、工作量比较大的Project,尤其是考虑到做这种Project风险其实很大,大家大量的时间投入进来,仅仅为了发一篇论文,如果没取得很好的收益(比如高引用、高关注度、工业界的认可),压力其实都蛮大的。幸运的是目前做完的几个工作量较大的Project,现在看都还算有一定的认可度。我始终觉得一篇具有代表性的有影响力工作,长远看比单纯几篇普普通通的论文价值要高,后面希望自己也能够努力输出好的工作吧。
5、开启新方向:对机器如何更好理解物理世界的进一步探索
xxx:贾老师团队也有涉猎一些xx相关的工作,比如Interleave-VLA,后续有没有进一步进军xx的计划?
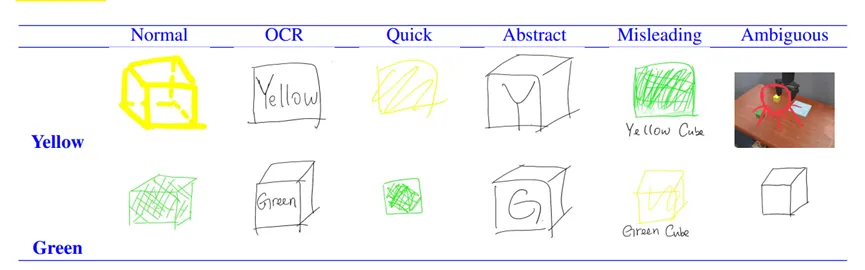

图8 Interleave-VLA零样本识别手绘指令,甚至OCR图片的指令
其实自动驾驶与xx智能存在诸多共通之处,两者都需要模型理解物理世界、做出精准决策并执行动作。团队此前已涉足部分xx相关工作,比如和范存心(当时是大三本科生)等合作者完成的Interleave-VLA[8],这项研究有一个有趣的发现:当我们将 VLA 的 输入prompt 从纯文字形式改为图文交错形式——例如把文字 “西瓜” 替换为西瓜图片后去训练,模型突然具备了极强的 zero-shot 能力。
我们做过很多有趣的测试:用互联网上的西瓜图片训练后,模型能准确识别并抓取真实场景中的西瓜;在平板上手绘一个物体,模型能看懂手绘图案并完成抓取任务;甚至手绘物体后标注 “blue”,模型能结合 OCR 功能,精准抓取蓝色的目标物体。这项工作让我看到了释放 VLM(Vision-Language Model)全部潜力的可能。
关于未来的规划,我和团队计划从精细化操作切入,去研究不局限于简单的夹爪抓放的、高难度的操作,从而进一步推动人工智能技术的在现实世界的实际应用。就像很多前辈学者所说,技术的边界正在不断融合,自动驾驶领域的研究经验的积累,将为我探索xx智能提供宝贵的借鉴。在人工智能这场伟大的革命中,期待能持续探索未知,为行业发展贡献自己的力量。
[1]Jia X, Wu P, Chen L, et al. Think twice before driving: Towards scalable decoders for end-to-end autonomous driving[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2023: 21983-21994.
[2] Li, Q., Jia, X., Wang, S. and Yan, J., 2024, September. Think2drive: Efficient reinforcement learning by thinking with latent world model for autonomous driving (in carla-v2). In European Conference on Computer Vision (pp. 142-158). Cham: Springer Nature Switzerland.
[3] Jia, X., Yang, Z., Li, Q., Zhang, Z. and Yan, J., 2024. Bench2drive: Towards multi-ability benchmarking of closed-loop end-to-end autonomous driving. Advances in Neural Information Processing Systems, 37, pp.819-844.
[4] Jia, X., You, J., Zhang, Z. and Yan, J., 2025. Drivetransformer: Unified transformer for scalable end-to-end autonomous driving. ICLR25.
[5] Yang, Z., Chai, Y., Jia, X., Li, Q., Shao, Y., Zhu, X., Su, H. and Yan, J., 2025. DriveMoE: Mixture-of-Experts for Vision-Language-Action Model in End-to-End Autonomous Driving. arXiv preprint arXiv:2505.16278.
[6] https://github.com/Thinklab-SJTU/Bench2Drive-VL
[7] You, J., Jia, X., Zhang, Z., Zhu, Y. and Yan, J., 2024. Bench2Drive-R: Turning real world data into reactive closed-loop autonomous driving benchmark by generative model. arXiv preprint arXiv:2412.09647.
[8] Liang, A., Kong, L., Yan, T., Liu, H., Yang, W., Huang, Z., Yin, W., Zuo, J., Hu, Y., Zhu, D. and Lu, D., 2025. WorldLens: Full-spectrum evaluations of driving world models in real world. arXiv preprint arXiv:2512.10958.
[9] Jia, X., Zhang, C., Jiang, Y., Wong, S., Zhang, Z., Chen, C., Zhang, S., Zhou, X., Yang, X., Yan, J. and Jiang, Y.G., 2025. Spatial retrieval augmented autonomous driving. arXiv preprint arXiv:2512.06865.
[10] Fan, C., Jia, X., Sun, Y., Wang, Y., Wei, J., Gong, Z., Zhao, X., Tomizuka, M., Yang, X., Yan, J. and Ding, M., 2025. Interleave-vla: Enhancing robot manipulation with interleaved image-text instructions. arXiv preprint arXiv:2505.02152.
....
#汽车工程师在焦虑中释怀的2025年
今年是2025年的最后一天,偌大的办公室空空荡荡,大多中国同事都已经返程陪伴家人,很多外国的同事也都前往东南亚旅行。
组内只有我和老W俩人了,一个紧张的早晨,老W安排好节后和各个部门的对齐会议,我调整好昨天开会确认的技术方案,下午算是比较轻松的一段时光,应该没有太多的工作,可以在座位上静静等待假期的到来。
中午得知,前同事小C从上海某外资车企研发中心领了大礼包后,找了一两个月工作,最后却去了令我们闻风丧胆的“极光湾”也就是所谓的杭州湾吉利动力研究院。实际上,在这里是看不到激光的,与其说它是激光湾,我更愿意成为它为“鸡血湾”,PUA打鸡血太厉害了,淘汰赛、赛马文化还没开始搞,当收到猎头推荐电话的那一刻,很多汽车工程师朋友就吓得不由自主地后退两步。
2025年,整个国家的经济形势很差。很大的原因就是汽车工业没有承担起来经济转型火车头的重任,这个宏观的话题实际上在微观层面很好理解,就是汽车行业如今是中国最大的经济支柱,汽车工程师特别是汽车研发工程师工资收入很高,理论上这些人应该疯狂消费去刺激其他行业,正如曾经的煤老板、房地产经理、IT精英一样的社会角色。
然而从2022年开始,汽车行业对汽车工程师的压榨和抽血却日益严重,加班加点都是小CASE,背锅挨骂也是家常便饭,稍有不慎就要吃低绩效,得罪了领导层或者项目出现问题后,领盒饭被开除也是常有的事情,面对上级和客户陪笑脸受羞辱自然让人难受但是很多技术项目经理也不得不去面对,更为艰难地是无论是新势力还是传统巨头,要么是经营不善,要么是融资不力,要么就是乘着市场波动来把大换血改善人才队伍,弄得失业汽车工程师到处都是。
就在这种没有保障,人人自危的环境中,本应该成为消费主力的汽车工程师的口袋自然而然被收紧了。大家在职场中就一个目的,以不被裁为导向的应对式干活,以熬过失业过空档期为目的进行消极式储蓄。更何况,面临着复杂的技术挑战和繁琐的项目沟通,他们已经疲惫不堪,还要面临上级或者客户的PUA,还要应对失业奉献和经济压力,本来一个月能消费2万的或者消费1万的,实际上最多敢拿出来四五千来消费。这种状态下,其他行业怎么可能被刺激呢,经济的源头被卡住了,后面的渠道怎么疏通它就是不出水你有什么办法呢?
回到我们汽车工程师个人,就必须做到在保障储蓄的前提下进行消费,能不升级或者购买大件比如汽车坚决不买,能不升级或者购买的中件比如笔记本电脑、手机等也要酌情考虑,至于衣服等等这些消耗品也要看之前的是不是确实不能用了,还有一些户外运动的自行车等等看看能不能直接咸鱼二手算了。也正是这种保证基本较好的生存状态下,才能够让汽车工程师的内心达到平衡,尽可能减少焦虑和内耗,应对不确定的失业奉献。
经济大环境不好,并不是刺激个人消费就能解决的,而是说要从根本上去解决个人的担忧,个人消费是果而不是因,一个人的生活有了保证,事业有了持续发展,他自然相信他会越来越好,自然而然他就会去花钱消费,而不是说用消费券降价去刺激,其实没有太大用。实际上,泉水都是自发性地受到内部压力而喷涌出来的,而不是去强行去吸出来的,消费也是一样。当然了,如今的反内卷确实开了个好头,但是我认为这远远不够,真正的落实要切切实实把中国汽车工程师当成最宝贵的人供起来,给他们较高的社会地位,给他们充实的保障,让他们真实感受自己被重视,是这个国家这个时代最宝贵的人。
作为个人,我们在这种经济不确定增大的过程中要用一种积极的态度去面对风险,用一种消极的太对去面对诱惑,前面的坑太多了,到处都想着割韭菜下套,但是你又不能完全躺平,这个社会的机制是逼着你往前走的,这就意味这我们要把主要的精力拿来面对危机和挑战,而非去谋求发展和承担责任,历史和实践告诉我们:责任是担不起的,担了责任的人都被开除了,奉献也是奉献不起的,奉献厉害的人都被抽空了。
正如在长跑中感悟到的一个道理,我们要保持配速平衡,不要急着完成跑步,而是说调整到身体达到一种自己不会太累也不会完全松懈下来的状态,持续的去适应这种慢跑的状态,别人催你就催,你超过我你就超,别人躺平或者慢走我也不会受到影响,而是持续的关注自己的脚下和全身平衡,为自己而跑。这正是对抗内耗和焦虑最好的办法。
由于前几年汽车行业过分激进的转型和发展,做了大量寅吃卯粮和重复投资的项目,很多投资毫无意义甚至铺张浪费,如今整个产业都陷入了内耗和焦虑,而我们也必须清楚地认识到,这些浪费实际上浪费的是整个社会的财富,对于我们个体而言在这些投资和试错中反而锻炼的了本领,这种损害集体有益个人的事情并非我们主动发起但是是被动承受的。
2025结束,中国汽车工业在震荡和内耗中彻底完成了转型,大批量的汽车公司和零部件公司倒下后,虽然大量的老板的高管卷钱跑路,当然也有多笨的锒铛入狱;但是利好的是,中国汽车工业研发的各个链路都被打通,实际上也没有什么壁垒了,在这些年的反内卷和反压迫的斗争中,以跳槽和摆烂为主题的工人运动依然在延续,打工人的主人翁意识也开始逐渐觉醒。我们可以遇见的是,一个崭新的、属于中国汽车打工人的汽车时代正在到来。
2026年即将到来,毫无疑问,中国汽车人应该继续启程,继续慢跑,让自己平衡地稳步推进。这次历史必将证明,胜利和受益必定属于中国汽车工业变革的主人翁——中国汽车打工人。
....
#MMDrive
纯图像理解的时代该翻篇了!MMDrive:给自动驾驶装上「多模态大脑」
只看图说话”的自动驾驶视觉模型,在真实路况中够用吗?遮挡、恶劣天气、复杂空间关系……这些挑战让传统模型捉襟见肘。今天要介绍的这项研究,正是要为自动驾驶系统打造一个更懂“场景”、更会“思考”的视觉语言模型——MMDrive。
- 论文标题:MMDrive: Interactive Scene Understanding Beyond Vision with Multi-representational Fusion
- 论文链接:https://arxiv.org/abs/2512.13177
- 作者单位:吉林大学,香港科技大学(广州),佐治亚理工学院,密歇根大学安娜堡分校
一、为什么传统方法不够用了?
目前主流的自动驾驶视觉语言模型(VLM),大多沿用“图像+文本”的双分支架构:视觉编码器提取图像特征,文本编码器理解问题,两者拼接后输入大语言模型生成答案。这种模式在简单场景中表现尚可,但面临三大瓶颈:
- 缺乏三维感知能力:二维图像难以表达深度、空间布局等关键信息;
- 语义融合能力有限:不同模态之间往往是“硬拼接”,未能实现语义对齐;
- 关键信息提取效率低:在复杂动态环境中,模型难以快速聚焦于重要区域。
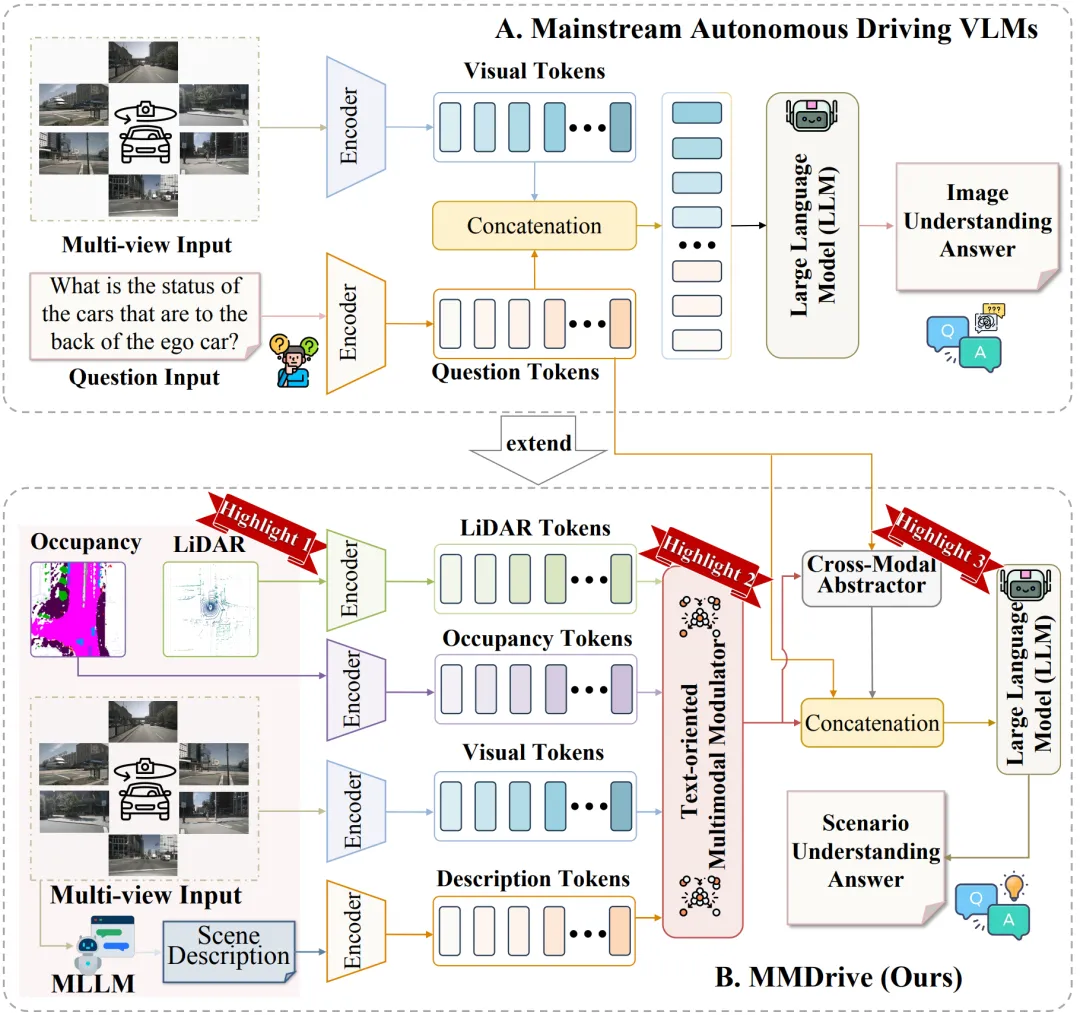
图1. 自动驾驶的主流VLMs与所提出的MMDrive的比较。
(A)主流的图像理解范式:通过编码器提取图像和文本特征,并通过投影进行组合,限制了跨模态交互。
(B) MMDrive:该框架包含占用、激光雷达和场景描述模态,将传统的图像理解范式扩展到整体场景理解。它还融合了TMM和CMA,以实现多模态信息融合,从而增强在复杂驾驶场景中的表征能力和适应性。
正如下图所示:前向摄像头被遮挡,仅凭图像无法准确判断后方车辆状态。这提醒我们:驾驶场景的理解,必须超越“平面视觉”,走向“立体感知”。
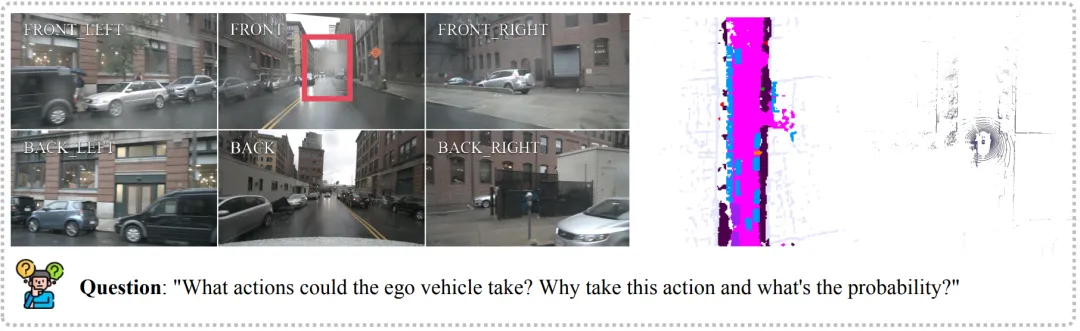
图2. 在复杂的自动驾驶场景中,单纯的图像感知给物体识别带来了困难。
二、MMDrive 的三大核心突破
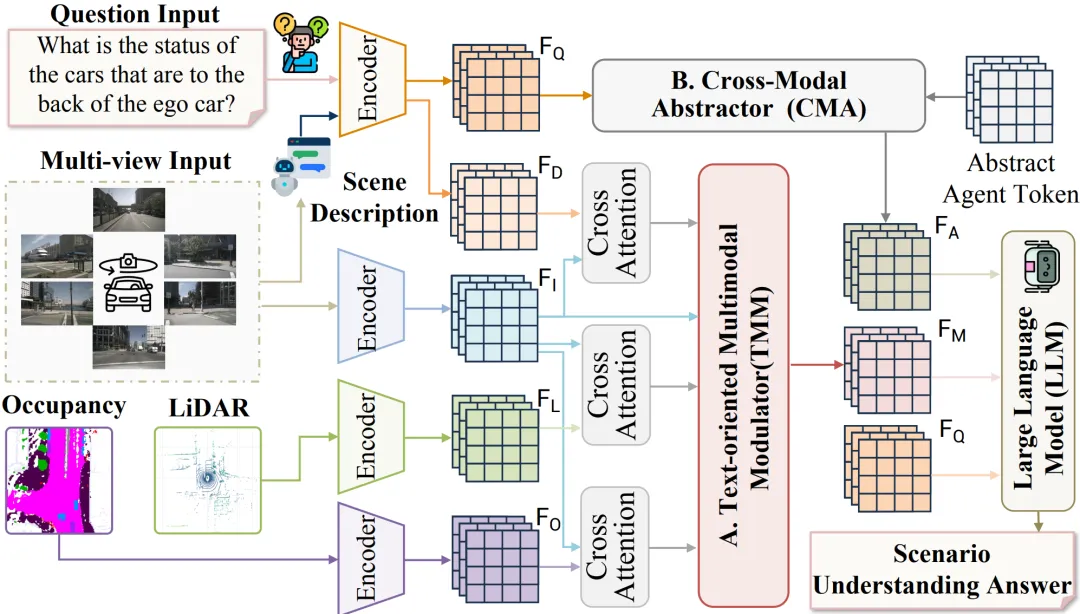
图3. MMDrive架构概述。
(1)该模型将多视角图像、文本问题、占用情况、激光雷达和场景描述作为输入。
(2)首先利用冻结编码器提取特定模态的特征。
(3)面向文本的多模态调制器(text -oriented Multimodal Modulator, TMM)根据文本问题的语义内容动态调整多模态信息的贡献,实现自适应的多模态融合。
(4)跨模态抽象器(Cross-Modal abstrator, CMA)通过提取关键信息进一步细化融合后的多模态表示。
(5)最后,将融合后的表示输入LLM以生成最终答案。
1. 多模态信息融合:从“图像理解”到“场景理解”
MMDrive 引入了三类互补信息源:
- 占据栅格地图(Occupancy):提供稠密的三维空间结构信息;
- 激光雷达点云(LiDAR):提供精确的几何与深度信息;
- 文本场景描述(Scene Description):通过两阶段生成策略,提炼出高层语义信息。
这三种模态分别对应 空间结构、几何细节、语义关系,共同构建出一个立体的场景表征。
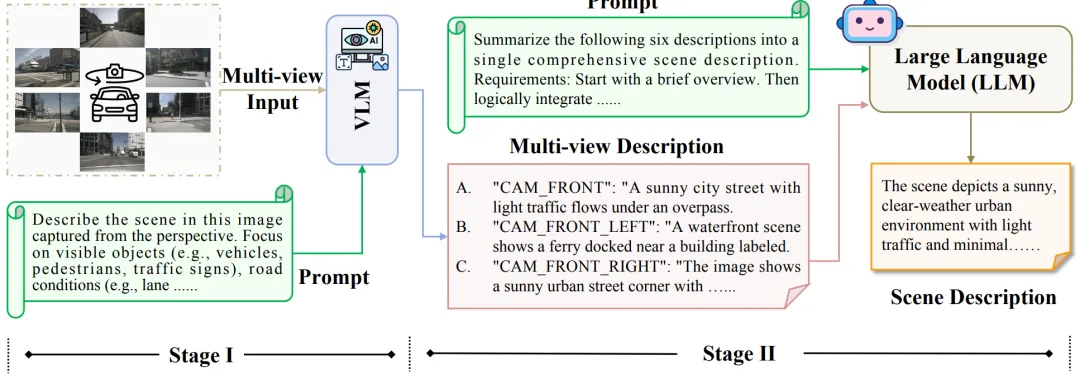
图4. 通过两阶段分层策略生成场景描述的实例。
在第一阶段,将多视角图像和文本提示输入视觉-语言模型(Vision-Language Model, VLM)以生成相应的多视角描述;在第二阶段,将这些多视图描述与摘要提示一起输入到大型语言模型(LLM),以产生最终的场景描述。
2. 文本导向的多模态调制器(TMM)
不同问题关注的模态不同:
- “后方车辆距离多远?” → 需要 LiDAR
- “左侧是否有障碍物?” → 需要 Occupancy
- “前方施工区域在做什么?” → 需要场景描述
TMM 能根据问题的语义,动态调整各模态的权重,实现问题感知的特征融合,避免信息稀释。
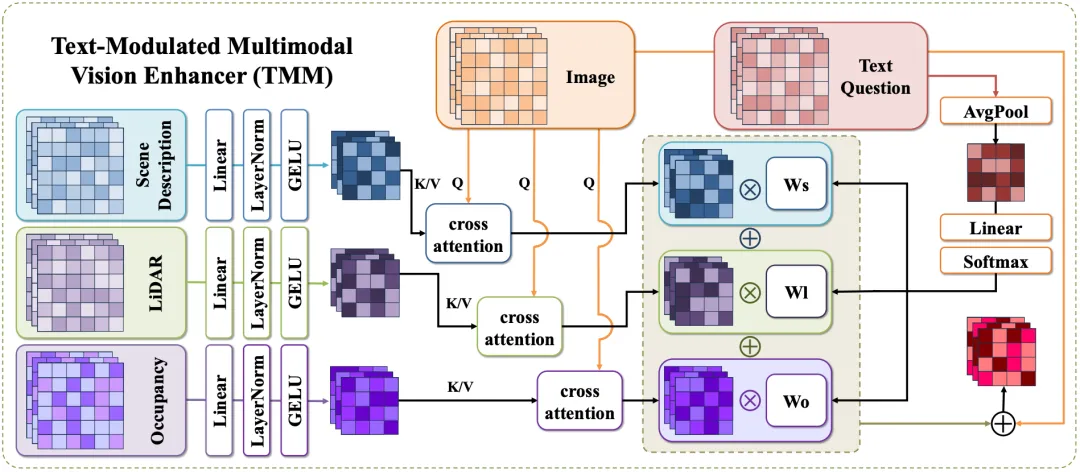
图5. 面向文本的多模态调制器(TMM)的架构图。
TMM通过将多模态特征投影到潜在空间,生成文本问题驱动的自适应融合权值,通过加权求和进行跨模态交叉注意,增强多模态场景表示能力,实现多模态融合。
3. 跨模态抽象器(CMA)
在复杂场景中,信息量巨大。CMA 通过学习一组“抽象令牌”,提取跨模态的关键信息,形成一个紧凑的语义摘要,让大语言模型能更高效地聚焦于核心内容。实验表明,16个抽象令牌是性能最佳配置,太少表达能力不足,太多则引入冗余。
三、实验结果:性能领先,鲁棒性强
在 DriveLM 和 NuScenes-QA 两个权威基准测试中,MMDrive 均表现优异:
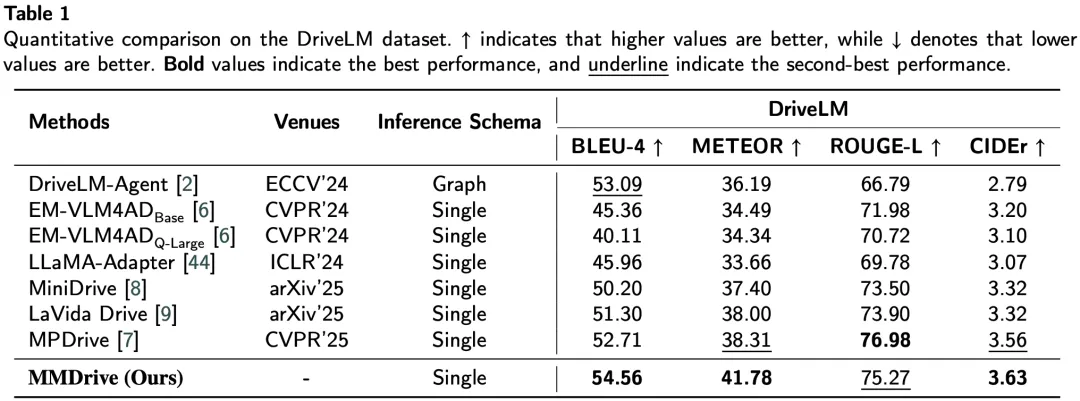
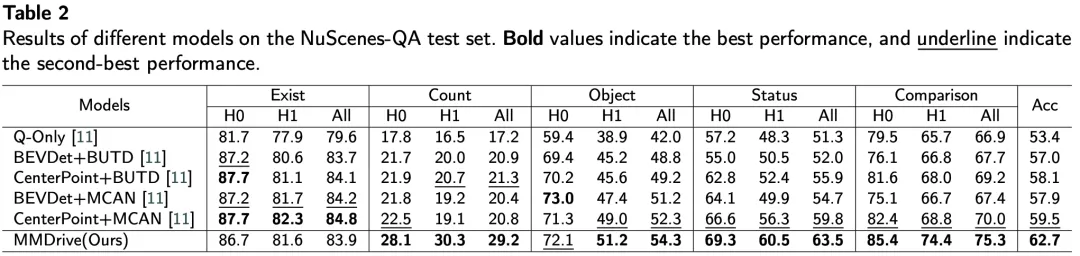
尤其在 计数、状态查询、比较类问题 上,MMDrive 优势明显,说明其在空间推理与语义理解方面更具优势。
定性实验 也显示:
- 在夜间、雨天等低能见度场景中,MMDrive 仍能保持较高判断准确率;
- 能识别出传统方法易忽略的细节(如与背景颜色相近的标志牌、远处的小型物体)。
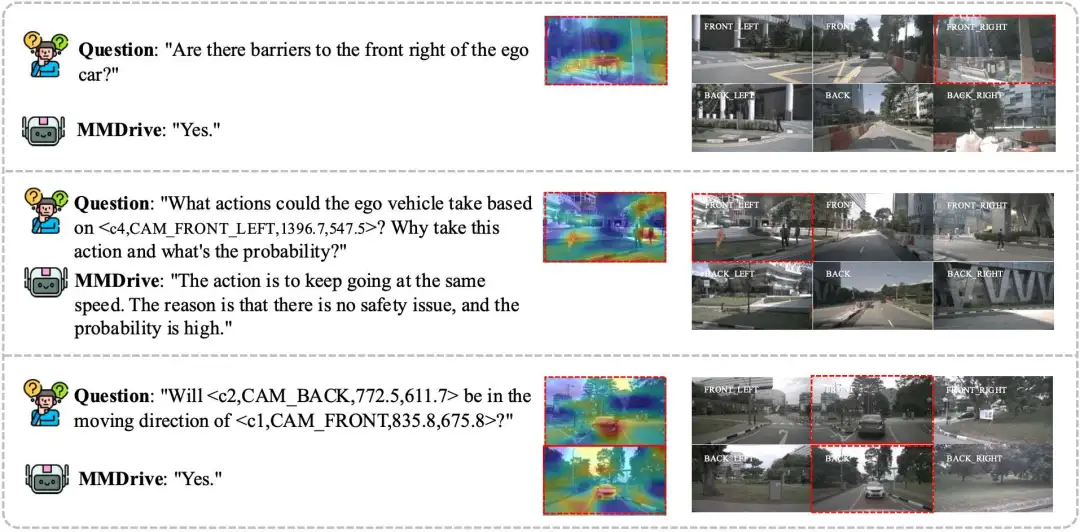
图6. MMDrive在多模式场景理解上的定性结果。
左边的面板显示问题和相应的预测,而右边的面板显示六张环绕视图图像。MMDrive可以准确地检测物体,推荐安全行为,并预测不同视点的物体细节。
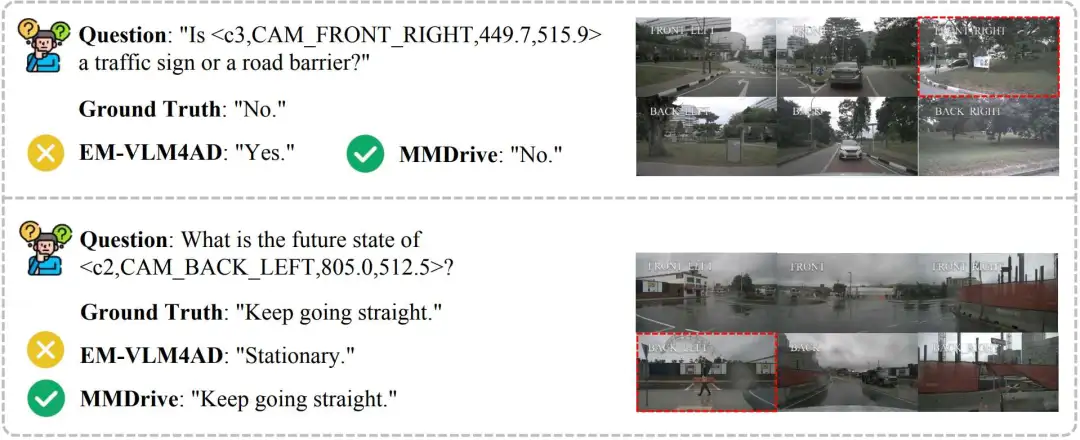
图7. MMDrive与EM-VLM4AD的定性比较。MMDrive在预测精度和可靠性方面优于EM-VLM4AD。
四、MMDrive 能用在哪些地方?
1. 自动驾驶系统的高阶感知模块
- 复杂路口理解、施工区识别、异常事件判断;
- 为预测与规划模块提供丰富的语义场景表示。
2. 驾驶仿真与测试平台
- 生成高质量的场景描述,用于测试系统的语义理解能力;
- 支持多模态问答,用于驾驶员行为分析与系统评估。
3. 智能交通与车路协同
- 通过车辆与路侧设备的多模态信息融合,提升全域交通态势感知;
- 支持自然语言交互的交通指挥与调度系统。
4. 驾驶教育与辅助系统
- 为驾考模拟、危险场景教学提供可解释的问答支持;
- 增强ADAS系统的交互能力,实现“语音问答+场景理解”的双重辅助。
五、未来展望:更轻、更强、更可解释
作者在文末也指出,后续研究将围绕:
- 长时序预测与协同规划:在时间维度上拓展多模态推理;
- 轻量化部署:让模型更适合车载嵌入式平台;
- 可解释决策生成:不仅给出答案,还能提供推理链条。
写在最后
MMDrive 不仅仅是一个技术框架的改进,更是一种范式转换:从“图像理解”迈向“场景理解”。它告诉我们,真正的自动驾驶系统,需要的不仅是“眼睛”,还要有“空间感”和“语义脑”。
或许在不远的将来,你的车子不仅能“看见”路,还能“理解”路上发生的一切,并像老司机一样,用自然语言告诉你:“前面施工,咱们慢慢走,右边那台车可能要变道。”
....
#DGGT
清华&小米DGGT:0.4秒完成4D高斯重建,性能提升50%!
清华大学与小米汽车联合推出 DGGT(Driving Gaussian Grounded Transformer):一个pose-free、feed-forward的4D动态驾驶场景重建框架。
,时长04:27
DGGT 只需未标定的稀疏图像,单次前向即可同时输出相机位姿、深度、动态实例与基于 3D Gaussian 的可编辑场景表示。模型在 Waymo 上训练,却能在 nuScenes 与 Argoverse2 上实现强劲的零样本泛化——在关键感知指标上相比STORM提升超过 50%。此外,系统通过lifespan head建模场景随时间的外观演变,并配合单步扩散精修,有效抑制运动插值伪影,提升时空一致性与渲染自然度。
- 论文标题:DGGT: Feedforward 4D Reconstruction of Dynamic Driving Scenes using Unposed Images
- 开源链接:https://github.com/xiaomi-research/dggt
- 项目主页:https://xiaomi-research.github.io/dggt/
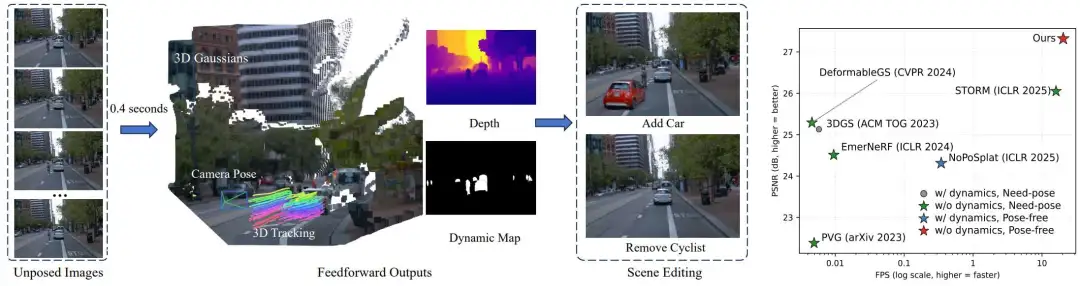
图1.左:从未标定稀疏图像在0.4 s内重建动态场景,并输出相机姿态、深度、动态图、3D Gaussian追踪等可编辑资产;右:在速度与精度上相较前向/优化方法处于更优位置
亮点速览
- 无需外参(Pose-Free): 将相机位姿从输入转为模型输出,端到端预测内外参并融入场景表示,打破跨数据集部署的校准壁垒。
- Feed-forward 4D表示: 采用多头联合预测结构(相机、4D Gaussian、lifespan、动态/运动、天空等),一次前向即可得到时空一致的可编辑表示。
- 跨数据集零样本泛化: 仅在 Waymo 训练,无需在目标数据集上微调即可在 nuScenes 与 Argoverse2 上获得优于SOTA的定量与定性结果(LPIPS 降幅 52%–61%)。
- 可编辑性强: 支持直接在 Gaussian 层面添加/删除/移动车辆、行人等实例,扩散精修自动补洞,输出可用于仿真与数据合成。
- 速度与质量兼顾:在Waymo上20 帧/视角,单场景约 0.39 s;PSNR 27.41 / SSIM 0.846,与优化类方法相比显著加速,与前向方法相比更高保真。
DGGT详解
DGGT 的核心思想是:一次前向就预测出“完整的4D场景状态”,并把相机位姿从前提变成结果。这使得系统无需外参标定即可从稀疏、未标定图像里恢复动态场景,而且能自然跨数据集部署。图1展示了DGGT 的整体能力与速度-精度位置:在0.4 秒量级完成重建的同时,DGGT 在重建质量上超越一系列前向与优化方法,并将相机姿态、深度、动态分割、3D Gaussian、追踪等输出一并给出,便于后续实例级场景编辑。
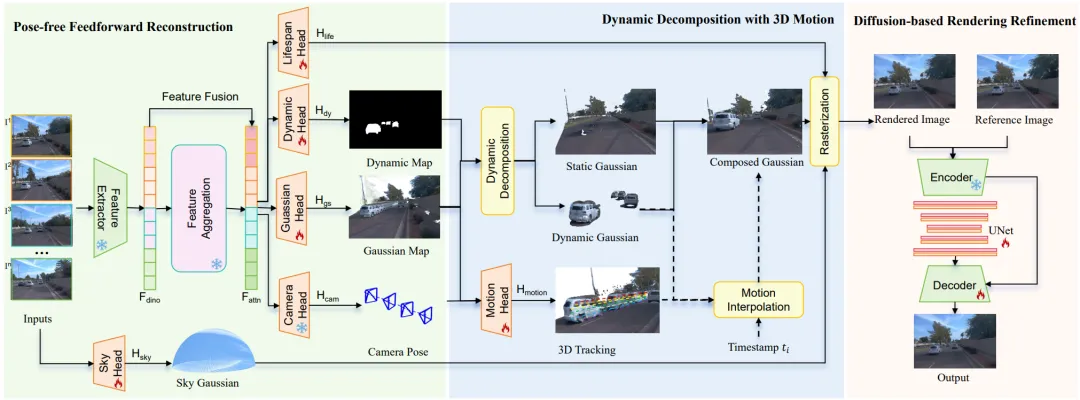
图2.DGGT 框架结构图 ViT 编码融合DINO先验,联合相机/高斯/寿命/动态/运动/天空六个预测头;渲染后接单步扩散精修,一次前向完成时空一致重建。
在系统结构上(图2),DGGT 采用 ViT 编码器融合 DINO 先验,通过交替注意力得到共享特征,再由多个预测头并行输出:
- (1)相机头估计各帧内外参;
- (2)Gaussian 头给出逐像素 Gaussian 参数(颜色/位置/旋转/尺度/不透明度);
- (3)lifespan 头用寿命参数调制时间维度可见性,精确刻画静态区域在不同时间的外观变化;
- (4)动态头+运动头显式估计动态区域与 3D 运动轨迹,支持任意时间点的运动插值;
- (5)天空头稳定建模远景背景。渲染后,再通过单步扩散精修抑制遮挡/插值产生的伪影与细节缺失。
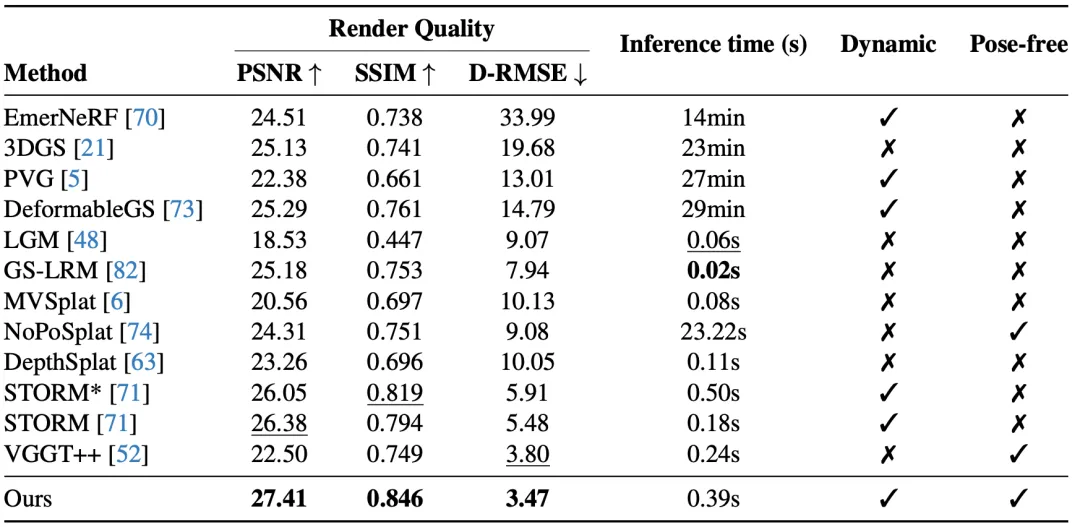
表1. Waymo定量结果 DGGT无需相机位姿输入的同时,对场景中动静态进行判断,在Waymo数据集上获得更高PSNR/SSIM与更低深度误差,单场景推理仅约0.4s
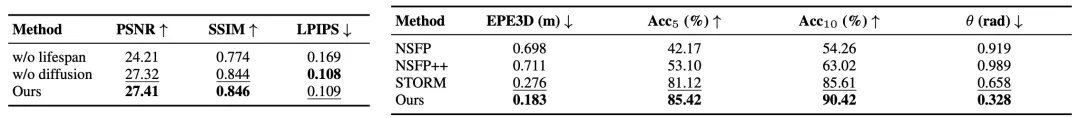
表2. 其他消融实验和指标测试 扩散模型虽然在性能上提升较小,但是生成的结果视觉效果更好,更适配于下游任务;同时DGGT在Waymo上EPE3D达0.183 m
在Waymo数据集上的定性与定量评估(见表1)表明:以往的前馈式静态重建方法(如 MVSplat、NoPoSplat、DepthSplat)在存在大范围运动目标的场景中难以维持时间一致性,且会产生明显的错配与伪影;而STORM虽然通过前馈式建模缓解了对逐场景优化的依赖,但在处理更长的时序跨度或更复杂的动态行为时仍可能出现性能退化。相比之下,DGGT能够在渲染级别上实现对静态与动态成分的有效分离,保持帧间外观与几何的一致性,从而显著提升整体视觉质量与重建稳定性。在定量指标上(表2),DGGT 在场景流估计上的EPE_3D为0.183 m,明显优于多种既有方法,证明了通过渲染监督学得的稠密三维对应具有良好的可靠性与精度。
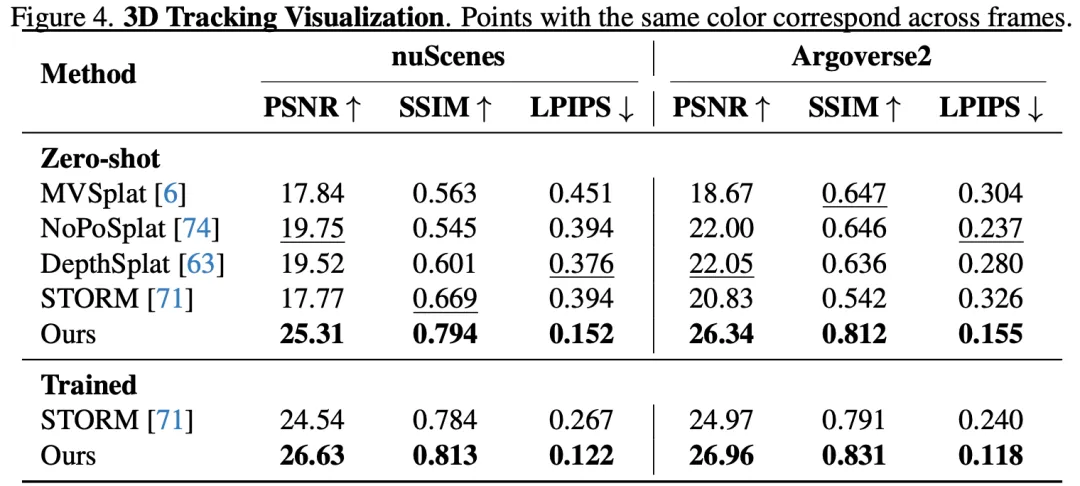
表3. 零样本跨库泛化 仅用Waymo训练,DGGT在nuScenes/Argoverse2上无需微调即显著优于STORM:LPIPS分别下降 61.4% 与 52.5%
跨数据集的零样本泛化能力是 DGGT 的另一项核心优势。模型仅在Waymo上训练,但在未做任何微调的情况下,在nuScenes与Argoverse2上均取得超越现有SOTA的结果(见表3):如在nuScenes上 LPIPS从0.394 降至0.152(下降 61.4%);在 Argoverse2上从0.326降至 0.155(下降52.5%)。这种跨域鲁棒性主要得益于DGGT 的pose-free 设计:将位姿从输入转为模型输出,减少了对固定拍摄轨迹与相机配置的依赖,从而降低了对特定数据采集设置的过拟合风险,使模型在不同传感器布置与行驶路径下仍能维持良好性能。
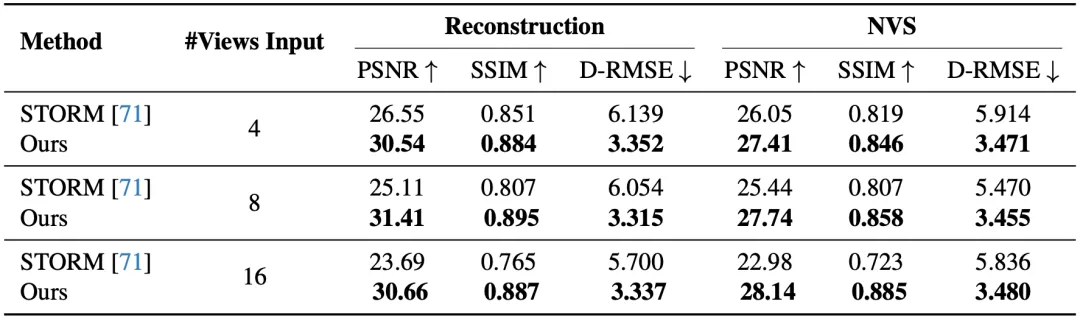
表4. 输入视角数消融 当视角数从 4→8→16 增加时,DGGT的重建/NVS指标保持稳定;STORM出现明显下滑,DGGT更适合大规模日志处理
在可扩展性方面,DGGT 能自然支持任意数量的输入视角与长序列。从表4可以看到,当输入视角从 4 → 8 → 16 扩增时,DGGT 的重建与新视角插值(NVS)指标基本不变,而对比方法会明显下滑。这意味着 DGGT 不仅适合研究场景,更适合在大规模输入中做工程级预处理与批量重建,视角变多时不需要额外改模型或调参数。
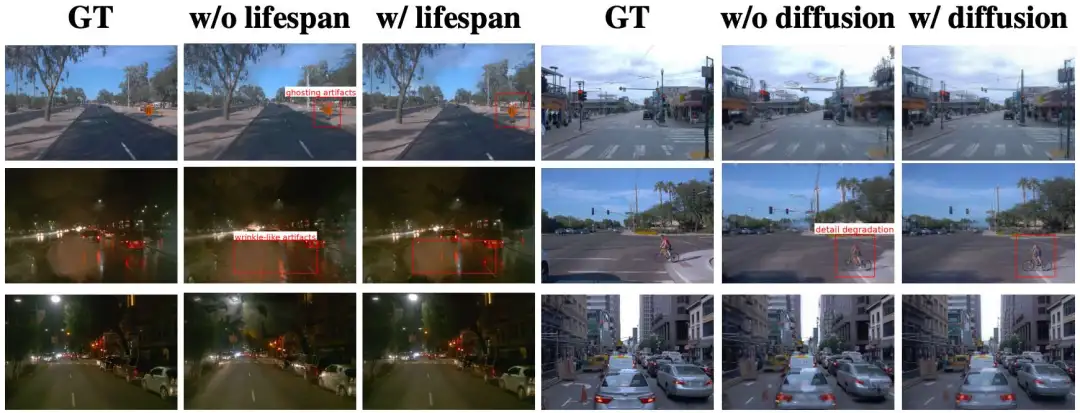
图3. Lifespan head 价值 去除lifespan后PSNR下降3.2 dB,静态区域的光照/反射时间变化难以刻画,时空一致性受损
Lifespan head 的作用在图3中的消融对比非常直接:去掉 lifespan 后,PSNR 从 27.41 降至 24.21,原因在于系统失去了对静态区域在时间维度上的细微变化(如亮度、反射、阴影过渡等)的建模能力。世界坐标静态的地方一旦无法随时间正确更新,就会破坏渲染的时空一致性与真实感,从而显著拉低最终画面质量。
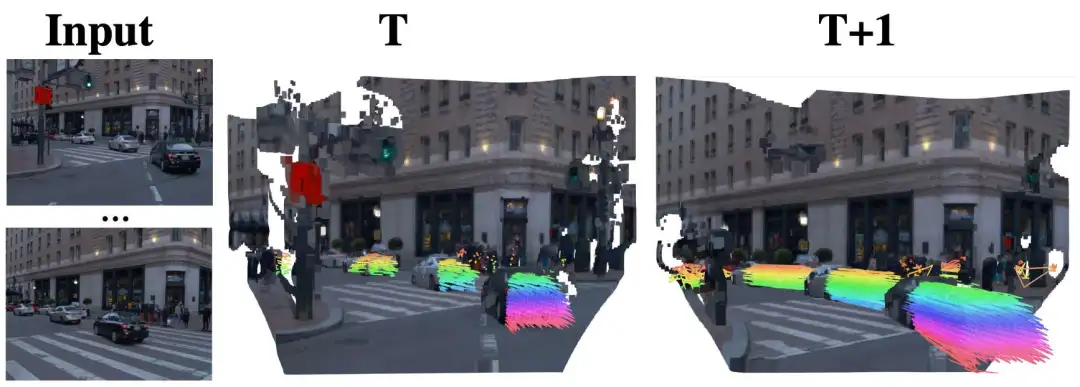
图4. 3D追踪可视化 相邻时刻等色点一一对应,展现可靠的稠密时空关联
Motion head负责把动态像素在时间上对齐(图4):它直接预测像素级的 3D 位移,用于将同一物体在相邻帧中对齐并做插值。也就是说,模型不只是预测静态形状,而是学会了像素到像素的时序对应,从而在生成中间帧或执行编辑时显著减少错配与拖影,保证运动物体在时间上的连续性与视觉自然度。
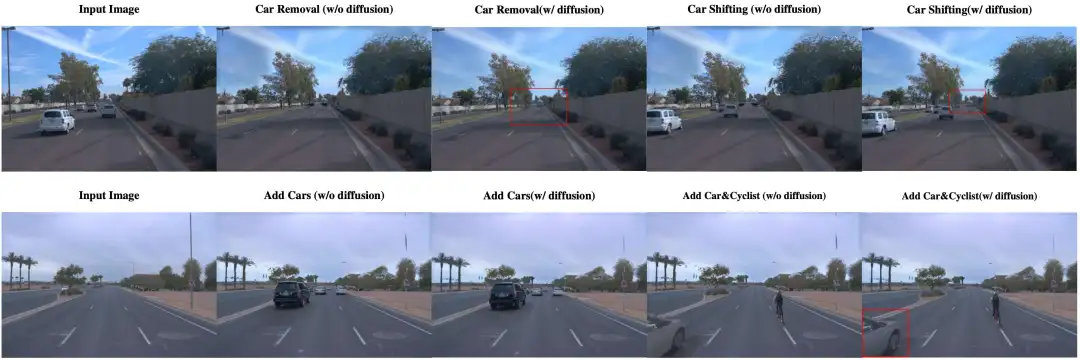
图5. 实例级编辑:加/删/移动车辆、跨场景插入新车与骑行者 在Gaussian层面对目标进行加、删、平移操作;扩散精修自动补洞与平滑边界,合成结果自然可信,提升可用性与观感。
在场景编辑与扩散精修方面(图5),DGGT 直接在 3D Gaussian 表示层面支持实例级操作——可以对单个高斯体执行“新增/删除/平移/替换”等编辑;随后引入的扩散精修模块会自动填补因遮挡产生的空洞、弱化边缘锯齿并修复纹理缝隙。经过这两步处理,合成结果在几何与外观上都保持高度一致且自然可信。
这意味着 DGGT 不只是“重建器”,更是“可编辑的 4D 场景资产生成器”,非常契合自动驾驶仿真、评测与数据合成等下游需求。
....
#从xxx到自驾,VLA和世界模型的融合趋势已经形成......
最近自动驾驶的两大前沿方向:VLA和世界模型,已经有明显的融合趋势。这一想法是十月份看到中科院的DriveVLA-W0,因此笔者借这个机会分别调研了 VLA 和 World Model 相关的工作,并且思考一下这二者结合的可能性。经过几周的调研、分析,有了些成果和自己的心得,所以也想理一理,分享给xxx的小伙伴们,主要分为以下几个部分:
- 简单介绍 VLA
- 简单介绍 World Model
- 两者到底各有什么优缺点
- 二者融合的可能性
自动驾驶技术诞生到发展至今,已经有十多年了,随着技术的不断迭代,以及大模型技术的蓬勃发展,如今的自动驾驶仿佛进入了一个“百家争鸣”的时代。如果说早期的模块化设计像是手工打造的传统汽车,那么如今以大模型为代表的技术路线,更像是试图直接给车装上“会思考的大脑”。
在这股浪潮中,两条路径尤为引人瞩目:一条是“能听会说还会开”的 VLA,另一条是擅长“在脑海中预演未来”的 World Model。它们就像两位风格截然不同的车手:一位善于沟通,能听懂指令、解释行为,像一位经验丰富的“老司机”;另一位则沉默专注,善于推演和预判,像一位精于计算的“战术大师”。
那么,这两个看似不同的技术路线,究竟哪条路线更胜一筹?它们是对手,还是最终会携手并进的伙伴?本文将给大家深度解析。首先,咱们聊一聊二者分别是什么。因为xxx平台有发过这两个路线的详解,这里笔者就 high level 的概括一下,感兴趣地小伙伴可以翻翻之前的文章,讲地更为详细。
什么是 VLA?
VLA,全称 Vision-Language-Action,即“视觉-语言-行动”模型。 是一个多模态大脑,它能看得懂画面(Vision),听得懂语言(Language),并且能直接做出行动决策(Action)。换句话说,它的输入是摄像头画面(Vision)和人类语言指令(Language),输出则是直接的驾驶动作(Action),比如方向盘转角、油门刹车信号,或是一条未来行驶轨迹。
想象一下,你坐在一辆自动驾驶车里,对它说:“前面路口右转,注意那辆自行车。” 它不仅能准确执行,还能回答你:“好的,已识别到右侧有自行车,我会减速让行。”——这就是 VLA 试图实现的场景。
从系统的角度出发,主要分为:输出-中间层-输出的 “三明治架构”:
输入端:融合多模态感知VLA的输入整合了视觉、传感器与语言等多模态的信息。核心视觉输入通过多摄像头图像生成BEV或体素表征,以理解空间结构;传感器(如激光雷达、毫米波雷达)提供几何与动态补充;语言输入则是关键创新,支持导航指令、交互问答与规则描述,使系统能理解人类意图与常识,构建出超越传统纯视觉感知的环境理解。
中间层:统一推理与决策生成中间层是VLA的“大脑”,由视觉编码器、语言处理器与动作解码器构成。视觉编码器(如DINOv2)提取特征;语言处理器(基于LLM)进行语义推理与链式思维分解;动作解码器则通过序列预测、扩散模型或分层控制,将推理结果转化为具体驾驶动作,实现感知、理解到行动生成的端到端映射。
输出端:直接驱动车辆输出端直接对应车辆控制,分为低层指令与轨迹规划两类。低层指令(如油门、方向盘转角)适用于需快速响应的场景;轨迹规划则输出未来数秒的连续路径,更注重平顺性与前瞻性,便于与控制系统集成。两类输出均旨在实现安全、流畅且可解释的驾驶行为。目前学术界和工业界的Action都定义在轨迹这一层面,因为轨迹是相对通用的,可以较容易转换为低层指令(不同车型之间有差异)。
总的来说, VLA 把视觉、语言和动作整合到一个统一框架里,既能理解人类的自然语言指令,比如“在路口礼让救护车”,也能基于视觉感知做出推理,并且直接生成具体的驾驶行为。换句话说,VLA 把“看、想、做”这三件事打通了,真正实现了从感知到推理再到控制的一体化。
什么是 World Model?
World Model,即世界模型,是一种生成式时空神经网络系统。它能将多传感器的高维观测数据压缩成一个紧凑的、包含几何与语义信息的内部状态,并在这个潜在空间中推演未来场景的演化。简单来说,它让自动驾驶车辆具备“在脑海中预演未来”的能力,通过内部仿真来评估不同决策的后果,从而做出更安全、更前瞻的规划。
想象一下,自动驾驶系统在左转前,会先在内部模型中快速模拟:如果现在转向,对向车辆是否会减速?行人是否会突然闯入车道?未来3秒的路口会呈现怎样的交通状态?——这就是 World Model 所实现的核心机制。
从系统架构出发,同样也可以划分为输入、核心模型与输出的 “三明治架构”:
输入端:多模态时序观测与状态
World Model的输入侧重于时序的多模态传感器数据(如图像、激光雷达点云)以及自车状态。这些数据被编码为统一的表征,用于捕捉场景的几何结构、语义信息和动态变化。与上述VLA不同,其输入通常不直接包含语言指令,而是专注于对物理世界状态的建模与预测。
核心层:状态编码、记忆与生成式推演
核心层是World Model的“虚拟引擎”,通常由编码器、记忆模块和生成式预测模块构成。编码器将观测压缩为低维潜在状态;记忆模块(如RNN、Transformer)维持时间上下文;生成模块(如扩散模型、自回归模型)则根据当前状态与 World Model的输出是对未来场景的丰富表征,如生成图像序列、BEV地图、4D占据栅格或未来点云。这些输出并不直接控制车辆,而是为下游规划模块提供前瞻信息,用于轨迹评分、风险估计与策略优化。本质上,World Model充当了规划器的“内部仿真器”,提供可快速试错的决策支持。
总的来说,World Model通过构建一个可微分、可推演的虚拟世界,使自动驾驶系统能够进行基于“想象”的决策。它将“观测-压缩-预测”整合进一个统一的生成框架,旨在实现更安全、更鲁棒、具备物理常识的自动驾驶能力。
二者的区别与联系
在解释完二者大概的技术路线之后,为了更好的展示(也为了笔者自己记些笔记),我将两者的主要区别,从不同维度整理在下表中,与大家分享:
| 不同维度 | VLA | World Model |
| 目标不同 | 主要为了实现人车交互与可解释的端到端的自动驾驶。重点在于将人类语言融入到系统当中,与驾驶行为对齐,让系统“能听懂、会解释、直接开”。 | 构建内一个预测&仿真的系统。重点在于推演未来世界状态,为规划提供一个可以试错的仿真 world。 |
| 输入不同 | 传感器数据(可能是单帧 / 多帧) + 显式语言指令 or 交互。 | 传感器时序数据 + 自车假设动作。 |
| 输出不同 | 直接的动作控制信号 or 短轨迹。 | 未来的场景状态(如图像、占据栅格),而非直接驾驶动作。 |
| 核心技术不同 | 利用大模型的推理能力。关键在于将视觉特征与语言语义在统一空间中对齐,并利用LLM的推理能力分解任务。 | 状态编码与生成式预测。关键在于学习环境动态的压缩表示,并用扩散、自回归等模型生成物理合理的未来。 |
| 优势不同 | 交互自然、可解释性强、能利用语言常识处理复杂语义场景。(更人性化) | 预测和仿真未来、方便量化风险,并且可以通过仿真生成大量 corner case 数据。 |
| 当前应对的挑战不同 | “说做不一”,L 和 A 的对齐难题、并且算力需求大。 | 缺乏高级语义理解、实时高保真推演的计算成本高、本身不直接产出驾驶策略。 |
在总结完这么多的相异点之后,VLA 和 World Model 真的不存在一些相似的点吗?其实也是有的:
- 技术起源的 Background 是一致的
两项技术都源于对传统模块化 pipeline(感知-预测-规划-控制)以及早期传统端到端模型(“黑箱”)的深刻反思,为了缓解“系统碎片化导致的信息损失” 以及“缺乏常识推理与长尾场景处理能力”这两大痛点。 - 终极目标是一致的
两者都是让自动驾驶系统具备 “human-like”的认知与决策能力。无论是通过语言理解常识,还是通过内部仿真预见未来,其内核都是为了赋予机器主动理解环境、进行推理、并做出稳健规划的高级 Agent。 - 关键挑战是一致的
都需要直面二八定律中的下半场难点:如何解决剩下的 20% 的 corner cases。虽然方法是不同的:VLA 试图利用大语言模型中嵌入的人类常识与语义知识来理解和应对;World Model 则试图通过物理仿真生成海量罕见场景数据来覆盖和准备,提升系统的鲁棒性。 - 技术底层是一致的
两者都重度依赖“预训练+微调” 的现代深度学习范式,并建立在 Transformer 等核心架构之上。它们都需要从海量的多模态数据(图像、视频、文本、点云)中学习世界的通用表征,作为自身能力的基础。
纵观技术发展,VLA 和 World Model 是适应当下技术发展潮流中两个弄潮儿,共同承担着将原始感知提升至高层次认知,并为最终决策提供关键支持的战略性角色。而且也并非是水火不容的关系,而是高度的互补。 未来的趋势可以是两者的深度融合,塑造一个“既会思考,又会沟通”的终极驾驶大脑。
笔者自己整理了些可能的融合路径如下:
- 架构级融合:以 World Model 作为核心的“预测与仿真”,负责生成高保真的未来场景和风险评估;同时,将 VLA 作为“交互与决策解释层”,负责理解指令、进行高级语义推理,并基于 World Model 的推演结果做出最终决策并解释。
- 训练数据互补:可以用 World Model 生成的大量、多样、逼真(尤其是一些高风险)场景,来训练和增强 VLA 的决策鲁棒性。同时,VLA 产生的带有语言标注的交互数据,也可以反过来用于提升 World Model 对语义意图的理解。
- 形成闭环智能:VLA 根据指令和当前状态做出初步决策,World Model 对该决策进行快速“脑内推演”,预测结果并评估风险,再将信息反馈给 VLA 进行决策调整或生成解释。形成一个“感知-推理-仿真-决策-解释”的增强闭环。
其实,将 VLA 和 World Model 融合的工作也是有不少的,当然,为了总结的完备性,笔者也会列一些机器人领域的 paper, 提供一些思路。接下来,我们按时间顺序来看一些例子。 PS:这里也提一下,早期的一些二者融合都是在机器人领域的尝试,近期,自动驾驶领域越来越多相关的工作了。
相辅相成的例子
我们从xx领域的相关工作盘起,再延伸到自驾领域。
3D-VLA
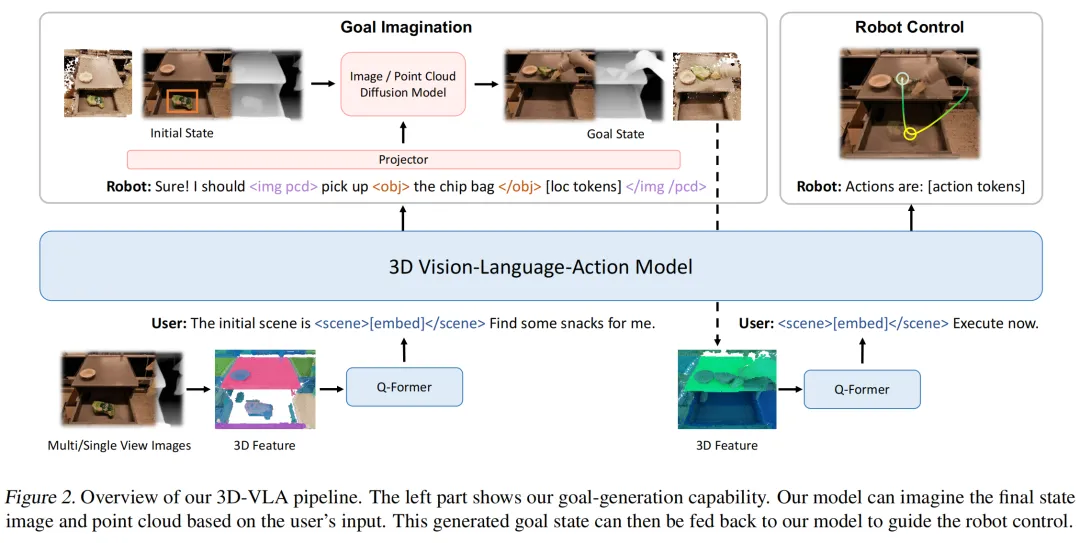
论文标题:3D-VLA: A 3D Vision-Language-Action Generative World Model
提出时间:2024.03
提出机构:东北大学、加州大学洛杉矶分校、麻省理工学院等
论文链接: https://arxiv.org/pdf/2403.09631
研究背景:现在的视觉-语言-动作模型大多还在“二次元”里打转——只处理2D图像,但咱们活在一个真实的三维世界。人类可是靠3D感知来理解环境、做决策的。虽然最近也有一些3D基础模型出现,但它们往往是“看到啥就动啥”,缺少对世界动态变化的想象能力,更不会像人一样先在大脑里模拟一下“如果我这么做,接下来会怎样”。这种“世界模型”能力对于机器人完成复杂任务至关重要。所以,这篇论文就想填上这个坑:搞一个能真正理解、想象并规划3D行动的xx模型。
论文内容:这篇论文的核心是提出了 3D-VLA,一个能打通3D感知、推理和动作生成的“世界模型”。它可不是简单地把2D模型升级成3D,而是从头设计了一套融合架构:
模型骨架以 3D-LLM 为基础,加入了各种交互token(比如物体、位置、场景、动作token),让模型能更自然地理解和表达3D环境中的元素和关系。
关键创新在于让模型学会“想象未来”:作者专门训练了一组扩散模型,用来生成执行指令后的目标图像、深度图和点云。然后通过一个投影器,把这些视觉生成能力和语言模型的推理能力对齐,让模型能根据指令“脑补”出目标状态。
数据方面,作者发现现有机器人数据集严重缺乏3D信息,于是自己动手整了一个超大规模的3Dxx指令数据集(约200万个样本),方法是从现有数据中提取或估算深度、点云、3D边界框等信息,再用ChatGPT增强语言描述。
实际效果上,3D-VLA在3D推理定位、多模态目标生成(图片和点云)和机器人动作规划等任务上,表现都远超之前的2D模型。比如,生成的目标图像更符合指令,动作预测也更准确,证明了这种“先想象再行动”的建模方式确实更接近人类的思维方式,更适合复杂的真实世界任务。
WorldVLA
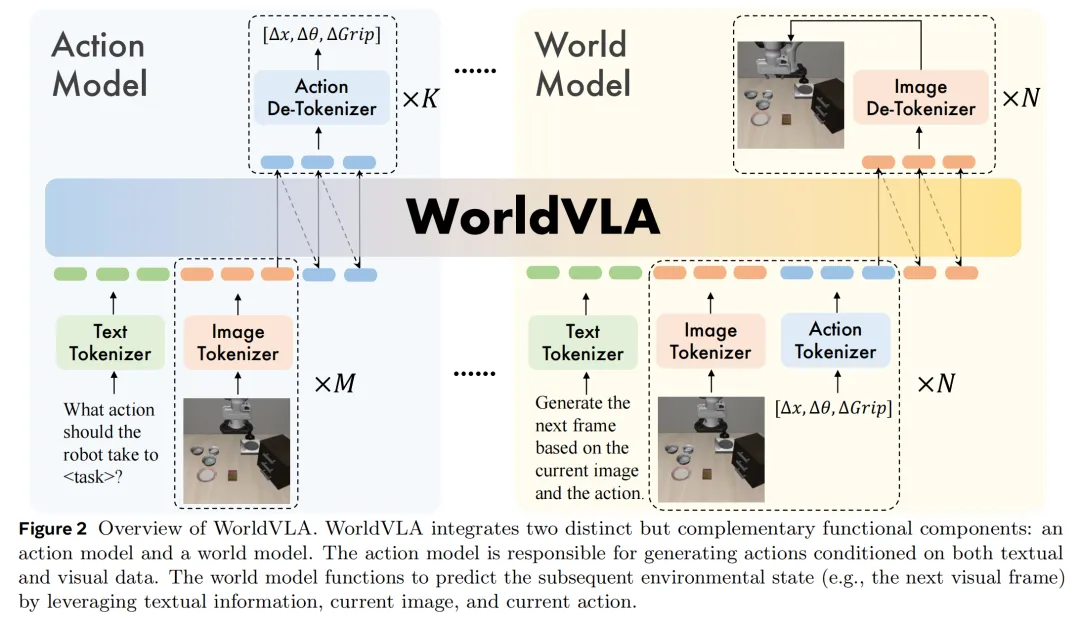
论文标题:WorldVLA: Towards Autoregressive Action World Model
提出时间:2025.06
提出机构:阿里巴巴集团达摩院、浙江大学等
论文链接: https://arxiv.org/pdf/2506.21539
研究背景:视觉-语言-动作(VLA)模型与世界模型,也是机器人领域的两大热点。VLA模型利用预训练的多模态大语言模型作为主干,能生成动作,但通常也只是输出动作,缺乏对动作输入进行深度理解。而世界模型能够基于当前状态与动作预测未来状态,理解环境物理规律,但无法直接生成动作指令,限制了其在需明确动作规划的场景中的应用。这二者功能互补却相互割裂,导致机器人系统在动作生成与环境理解之间存在语义与功能鸿沟,难以实现真正统一的理解与决策闭环。
论文内容:标题就叫 WorldVLA,顾名思义,一个自回归动作世界模型,将VLA模型与世界模型统一于单一框架,实现动作与图像的联合理解与生成。模型采用三个独立的标记器(图像、文本、动作)将不同模态信息转换为共享词汇表中的离散标记,并在同一LLM架构中以自回归方式进行训练与推理。其中,世界模型基于当前图像与动作预测下一帧,学习环境物理规律;动作模型基于当前观测与指令生成动作,增强对视觉内容的理解。二者通过联合训练相互促进:世界模型为动作生成提供物理先验与结果模拟能力,动作模型则提升世界模型的视觉理解与生成质量。
针对自回归生成多步动作序列时错误累积导致性能下降的问题,论文还提出一种动作注意力掩码策略,在生成当前动作时屏蔽之前已生成的动作,使每个动作仅依赖于视觉与文本输入,从而减少错误传播,显著提升动作块生成的性能。
实验在LIBERO机器人操作基准上进行,结果表明WorldVLA在未使用大规模预训练数据的情况下,其动作生成成功率超过同类离散动作模型(如OpenVLA)约4%;同时,其视频生成质量(FVD指标)优于单纯世界模型约10%,验证了动作模型与世界模型相互增强的有效性。注意力掩码策略也在长序列动作生成任务中带来了4%至23%的性能提升。
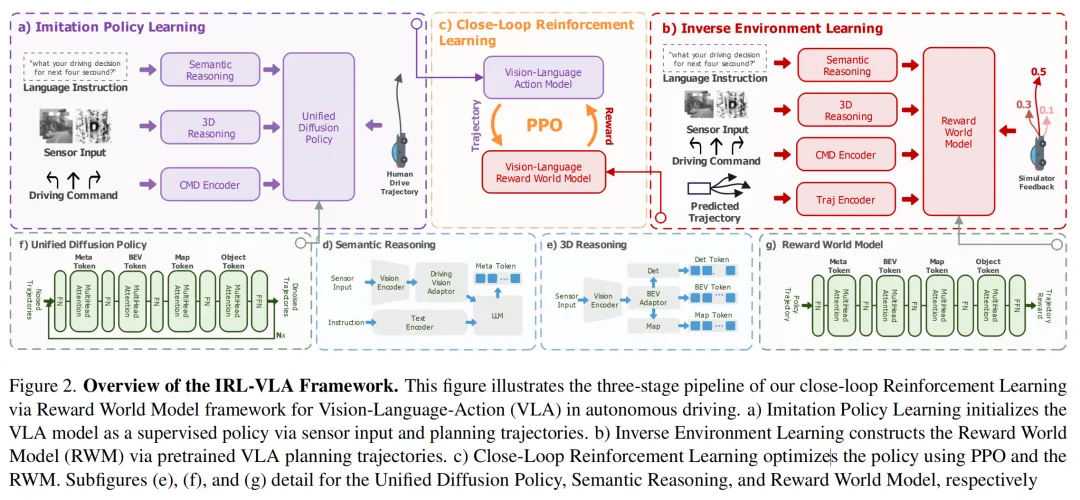
IRL-VLA
论文标题:IRL-VLA: Training an Vision-Language-Action Policy via Reward World Model for End-to-End Autonomous Driving
提出时间:2025.08
提出机构:清华大学AIR研究院、上海交通大学、博世企业研究所、上海大学等
论文链接: https://arxiv.org/pdf/2508.06571
研究背景:当前基于视觉-语言-动作(VLA)的端到端自动驾驶模型大多采用开环模仿学习,虽能复现数据中的驾驶行为,但易受数据分布限制,难以应对多目标(安全、效率、舒适等)与多模态(多种合理驾驶策略)的真实驾驶场景。闭环强化学习虽能通过环境交互提升策略,却严重依赖高保真传感器仿真,面临仿真-现实域差异大、计算开销高昂的瓶颈。因此,如何在不依赖重型仿真的前提下,实现VLA模型在闭环环境中的高效、稳定训练,成为推动其走向实际应用的关键难题。
论文内容:本文提出 IRL-VLA,一种基于逆强化学习奖励世界模型的闭环强化学习框架,用于训练端到端自动驾驶VLA策略。该框架采用三阶段训练范式:
Step 1: 模仿策略学习:设计一个包含语义理解、三维几何推理与统一扩散规划器的VLA模型,并通过模仿学习进行预训练,建立基础驾驶行为理解。
Step 2: 逆环境学习:构建轻量级奖励世界模型(RWM),通过逆强化学习从多样化的策略轨迹中学习多目标奖励函数(如碰撞避免、道路合规、舒适性等),替代传统仿真器进行高效奖励计算。
Step 3: 闭环强化学习:利用RWM提供实时奖励信号,基于近端策略优化(PPO)对VLA策略进行微调,使其在安全、效率与舒适性等多目标间取得平衡,同时通过保留部分模仿损失避免策略退化。
实验表明,IRL-VLA在NAVSIM v2闭环驾驶基准上取得领先性能(EPDMS 74.9),并在CVPR 2025自动驾驶大挑战中获得亚军。该框架首次实现了不依赖仿真器的、包含传感器输入的闭环VLA强化学习,为自动驾驶VLA模型的实用化训练提供了可扩展、高效的解决方案。
DriveVLA-W0
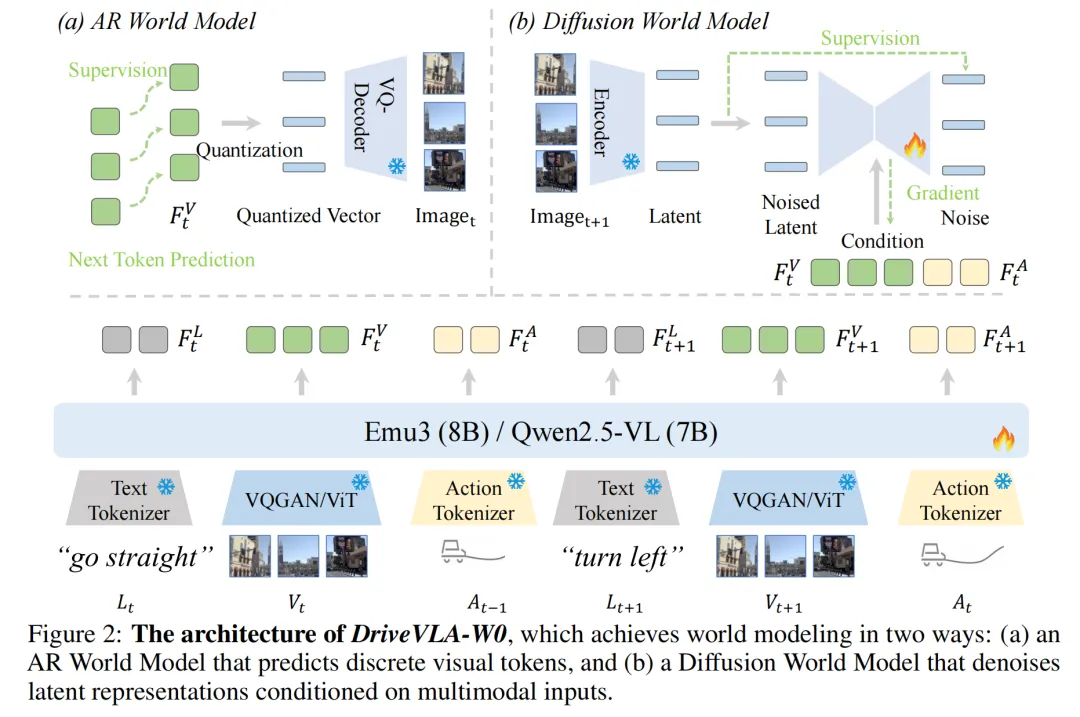
论文标题:DriveVLA-W0: WORLD MODELS AMPLIFY DATA SCALING LAW IN AUTONOMOUS DRIVING
提出时间:2025.10
提出机构:中国科学院自动化研究所等
论文链接: https://arxiv.org/pdf/2510.12796
研究背景:自动驾驶领域长期依赖基于鸟瞰图(BEV)的专用模型,这类模型虽在特定任务上有效,但其依赖几何先验、架构紧凑的特点限制了从非驾驶数据中学习与大规模扩展的能力。近年来,视觉-语言-动作(VLA)模型凭借其庞大的参数量与从互联网规模数据中预训练获得的基础能力,被视为实现更通用驾驶智能的有望路径。然而,VLA模型面临一个根本性瓶颈:其巨大的模型容量仅由极其稀疏、低维的专家动作信号进行监督,形成严重的“监督不足”。这导致模型无法充分学习丰富的世界表征,其扩展潜力远未发挥,甚至在有限数据下可能表现不如更小的BEV模型。
论文内容:本论文提出 DriveVLA-W0,一个通过世界建模来解决VLA模型“监督不足”问题的创新训练范式。核心思想是将未来图像预测作为一项密集的自监督任务,迫使模型学习驾驶环境的动态与因果规律。论文针对两类主流VLA架构设计了对应的世界模型:对于使用离散视觉令牌(如Emu3)的模型,提出了自回归世界模型,以预测未来图像的视觉令牌序列;对于使用连续视觉特征(如Qwen2.5-VL)的模型,则提出了扩散世界模型,在隐空间内生成未来帧。这种密集的视觉监督与原始的动作监督联合优化,显著提升了模型的表征能力。
大量实验验证了该范式的优越性。在NAVSIM v1/v2基准测试上,DriveVLA-W0仅使用单目前置摄像头,即超越了依赖多摄像头和激光雷达的BEV与VLA基线模型,刷新了最优性能。更重要的是,在一个包含7000万帧的大规模内部数据集上的实验表明,该方法能放大数据扩展定律——即随着训练数据量增长,模型性能的提升速度加快,这是单纯增加动作监督数据无法实现的。此外,为满足实时部署需求,论文引入了一个基于混合专家(MoE)的轻量级动作专家,将推理延迟降低至基线VLA的63.1%。利用此框架作为测试平台,论文揭示了一个“性能逆转”现象:在小规模数据上表现优异的复杂流匹配解码器,在超大规模数据下,其性能会被更简单的自回归解码器反超,这为大规模驾驶模型的动作解码器设计提供了关键洞见。
WM-MoE
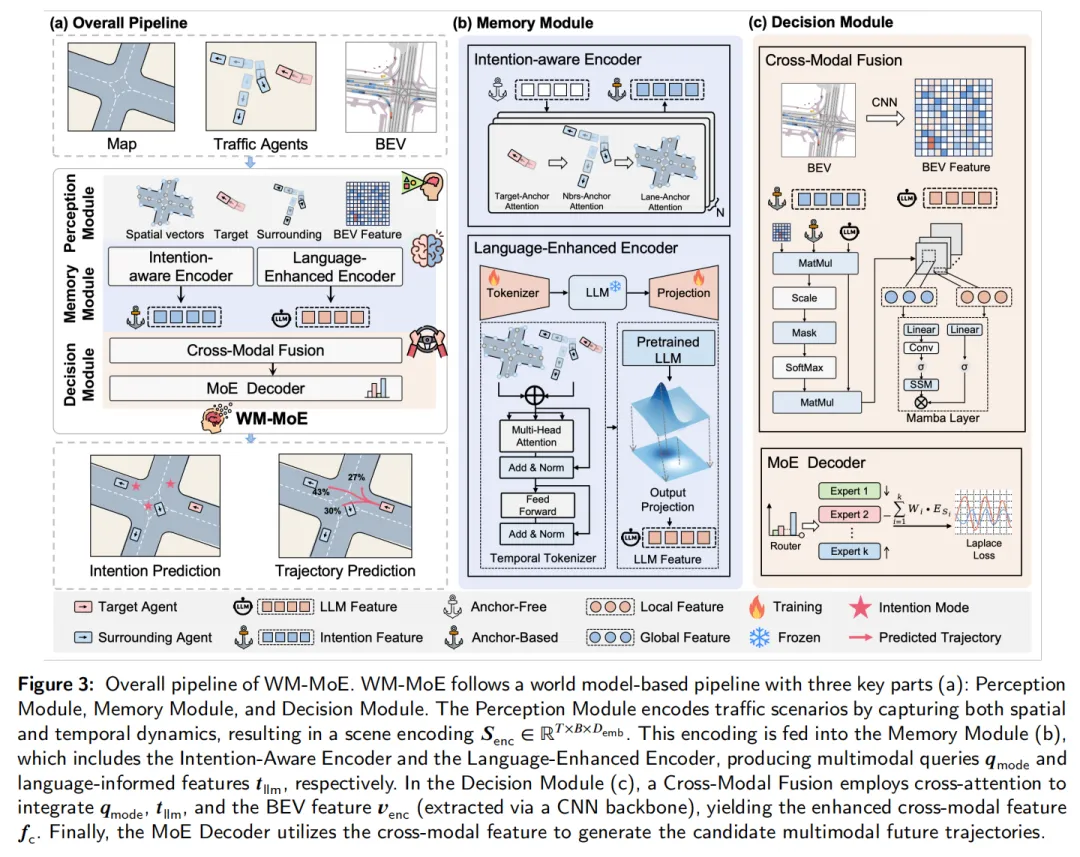
论文标题:Addressing Corner Cases in Autonomous Driving: A World Model-based Approach with Mixture of Experts and LLMs
提出时间:2025.10
提出机构:麻省理工、夏威夷大学、澳门大学等
论文链接: https://arxiv.org/pdf/2510.21867
研究背景:自动驾驶车辆的运动预测模型在常规场景下已取得显著进展,但其安全部署的核心瓶颈在于对罕见但高风险的“极端案例”的处理能力。这类场景(如紧急避让、复杂路口交互、突然制动)在现实数据中呈长尾分布,导致模型训练严重不均衡。现有解决方案,如数据重采样、代价敏感损失函数或对比学习,往往陷入“顾此失彼”的困境:提升极端案例性能的同时,常伴随常见场景预测精度的下降。此外,模仿学习等方法易受分布偏移影响,缺乏真正的因果推理能力。因此,如何构建一个能够像人类驾驶员一样,通过内部世界模型理解和推理复杂、罕见场景,并能同时兼顾常见与罕见场景性能的预测框架,成为提升自动驾驶系统安全性与可靠性的关键挑战。
论文内容:本文提出了首个基于世界模型,并融合专家混合网络与大型语言模型的运动预测框架——WM-MoE,目的是在系统性解决自动驾驶中的极端案例难题。该框架仿照人类认知机制,构建了由感知、记忆、决策三大模块组成的结构化世界模型。感知模块整合车辆历史轨迹、高清地图及鸟瞰图信息,编码为紧凑的时空场景表示。记忆模块是其核心创新之一,它通过一个轻量级时序分词器将轨迹数据映射到冻结的LLM(如GPT-2)特征空间,无需微调即可注入交通规则、社会常识等先验知识,从而增强了模型的长期推理与上下文理解能力。决策模块则引入了MoE架构,通过路由器将不同复杂度的场景动态分配给专门化的专家网络进行处理,实现了对常见模式的高效处理与对极端案例的专项优化。
作者还构建并发布了专注于极端案例的nuScenes-corner基准数据集。实验部分在nuScenes、NGSIM、HighD和MoCAD四个公开数据集上进行了全面验证。结果表明,WM-MoE不仅在整体预测精度上超越了现有先进方法,更在极端案例(如转弯、拥堵、急刹)和数据缺失的严苛条件下,展现出卓越的鲁棒性和泛化能力。消融研究进一步证实了LLM先验、时序分词器以及MoE架构各自的关键贡献。该工作为开发更安全、更适应真实世界复杂性的自动驾驶预测系统提供了新的有效范式。
FutureSightDrive
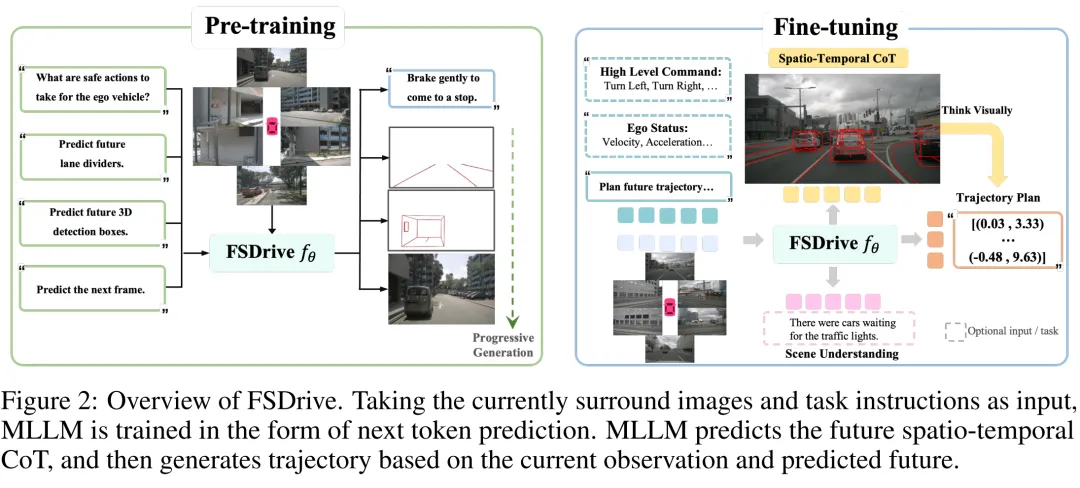
论文标题:FutureSightDrive: Thinking Visually with Spatio-Temporal CoT for Autonomous Driving
提出时间:2025.11
提出机构:西安交通大学、阿里巴巴集团达摩院等
论文链接: https://arxiv.org/pdf/2505.17685
研究背景:当前基于视觉-语言-动作(VLA)的端到端自动驾驶模型普遍采用文本链式思考(CoT)进行推理,但这将丰富的连续视觉信息压缩为离散的文本符号,导致空间-时间关系模糊、细粒度视觉细节丢失,造成感知与规划之间的“模态鸿沟”。这种符号化的推理方式难以支持对复杂动态驾驶环境的深度物理交互与前瞻性理解。人类驾驶员在规划时更倾向于在脑海中构建未来场景的视觉化表征,而非依赖语言描述进行推理。因此,如何让VLA模型像人一样进行“视觉化思考”,直接利用视觉表征进行时空推理,成为提升自动驾驶系统安全性、泛化性与可解释性的关键挑战。
论文内容:本文提出FSDrive,一个让VLA模型能够进行 “视觉思考” 的自动驾驶框架。核心创新是引入视觉时空链式思考(Spatio-Temporal CoT)作为中间推理步骤。具体而言,FSDrive首先充当世界模型,生成一个统一的未来帧,该帧不仅包含预测的背景,还叠加了具有物理合理性的先验信息(如未来车道线和3D物体框),从而在单一图像中同时编码时空关系。该生成的未来场景作为视觉CoT,为后续规划提供丰富的视觉推理依据。随后,同一VLA模型作为逆动力学模型,基于当前观测和此视觉CoT进行轨迹规划。
为实现上述能力,论文提出一种统一的预训练范式,通过扩展现有MLLM的词表融入视觉令牌,并联合优化语义理解(VQA)与未来帧预测任务。此外,设计了一种渐进式生成方法:先生成结构化先验(车道线、3D框)以强加物理约束,再在此基础上渲染完整场景,确保生成内容符合物理规律。
实验部分在nuScenes和NAVSIM数据集上验证了FSDrive在轨迹精度、碰撞率、未来帧生成质量(FID)以及场景理解(DriveLM)等方面的显著优势,表明其能够有效弥合感知与规划之间的模态鸿沟,推动自动驾驶向真正的视觉推理演进。
总结
内容大概就总结这么多,经过这阵子的调研,笔者觉得可能下一代自动驾驶的方向会沿着 VLA 和 World Model 融合的思路走下去,前者根据指令和当前状态做出初步决策 action,后者对该决策进行快速“推演”,预测结果并评估风险,再将信息反馈给 VLA 进行决策调整或生成解释。完整地形成一个“感知-推理-仿真-决策-解释”的增强闭环。工业界,华为鼓吹自己的 World Model 很牛,小鹏已经开始做所谓的 VLA2.0,前些日子,大家都在争论到底哪个方案才是终局,但其实两者并非水火不容,其实理想前一阵子的发布会也已经展示了这部分的理解,之后还会有多少玩家会陆陆续续入局呢?让我们拭目以待。
....
#DIVER
北交&地平线提出DIVER:扩散+强化的多模态规划新框架
当前主流自动驾驶系统正加速向端到端范式演进,通过统一的深度网络将感知、预测与规划整合在一起,从多视角传感器数据直接生成车辆未来轨迹或控制指令,在复杂城市场景中展现出良好的整体性能。
然而,现有端到端自动驾驶方法大多仍基于单一专家示范的模仿学习范式进行训练,模型被迫去拟合一条“唯一正确”的专家轨迹。即使引入多模态规划,生成的多条候选轨迹也往往高度聚集在 Ground Truth 附近,缺乏真正有意义的行为多样性。在复杂交互、转弯或不确定性较高的场景中,这种模式坍塌现象会限制系统对多种安全可行决策的探索能力。
近日,来自北京交通大学、地平线机器人、华中科技大学、清华大学、澳门大学、昆士兰大学等机构的研究团队提出了一种面向端到端自动驾驶的多模态规划框架 DIVER(Diffusion + Reinforcement for Diverse End-to-End Driving)。该方法将扩散模型的多模态生成能力与强化学习的目标约束机制相结合,将轨迹生成从“单一模仿回归问题”转化为“在安全与多样性约束下的策略生成问题”,从而能够在统一模型中生成多样、可行且符合驾驶语义的候选轨迹。
实验结果表明,DIVER 在 Bench2Drive、nuScenes 等多个公开基准上显著提升了端到端规划的轨迹多样性与安全性,在保持低碰撞率的同时有效拓展了行为覆盖范围,并在闭环评测中展现出更强的复杂场景适应能力,为构建更灵活、更接近人类驾驶决策模式的端到端自动驾驶系统提供了一条新的技术路径。
- 论文标题:DIVER: Reinforced Diffusion Breaks Imitation Bottlenecks in End-to-End Autonomous Driving
- 论文链接:https://arxiv.org/abs/2507.04049
- 项目主页:https://github.com/adept-thu/diver
研究背景
端到端自动驾驶正在快速演进,但在大量真实测试与闭环评测中,一个非常典型的问题始终存在:
车辆的规划行为过于保守、模式单一,难以应对复杂交通场景。
这是因为主流端到端方法大多依赖单一专家示范的模仿学习范式:
模型被迫去“复现一条唯一的 GT 轨迹”,即使引入多模态规划,生成的多条轨迹也会高度聚集在 GT 周围,最终仍然缺乏真正的行为多样性(图1a、图1b)。
具体来说:
- 单模态规划直接回归一条确定性轨迹,几乎不具备探索能力(图1a);
- 多模态规划虽然生成多条候选轨迹,但由于训练仍基于单一 GT 的模仿学习目标(通常以 L1 / L2 或 score matching 形式实现),模型在优化过程中会将概率质量集中到 GT 附近,导致多模态预测出现严重的 mode collapse(图1b)。
相比之下,人类驾驶并不会只“模仿一种动作”:
在同一个场景下,我们可能选择减速、并线、绕行或等待,而这种行为多样性与安全约束的平衡,正是当前端到端模型所缺失的能力。
基于此,论文提出了 DIVER(Diffusion + Reinforcement for Diverse E2E Driving):
一个将扩散模型的多模态生成能力与强化学习的目标约束能力相结合的端到端自动驾驶框架,使模型不仅能“生成多条轨迹”,更能生成多样、可行且安全的驾驶行为(图1c)。
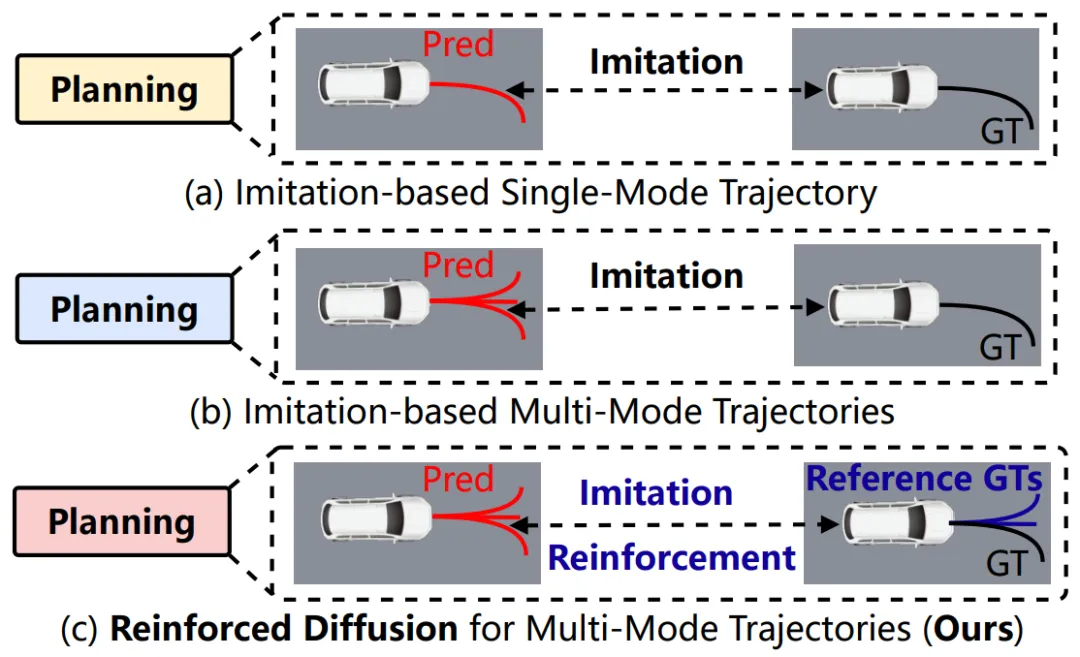
图1. 三种规划范式对比
核心技术
DIVER 的核心思想是:
- 不再把轨迹生成当作“拟合 GT 的回归问题”,
- 而是把它当作“在安全与多样性约束下的策略生成问题”。
为此,DIVER 在端到端规划中构建了一个完整的 “扩散生成 + 强化学习优化” 框架(图2),包括:
- Policy-Aware Diffusion Generator(PADG)
- Reference GT 引导的多模态扩散
- GRPO 强化学习优化
- 多样性 / 安全 / 时序一致性奖励设计
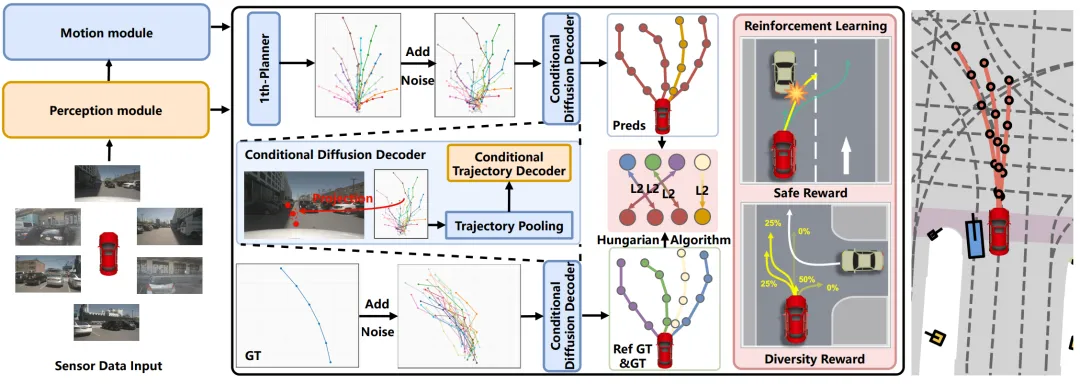
图2. DIVER 整体框架图
多模态扩散规划:打破模仿学习瓶颈
传统扩散规划方法虽然能生成多条轨迹,但仍然受单一 GT 监督,理论上必然收敛到 GT,作者对此给出了严格推导。
DIVER 的关键改进在于:
- 将扩散模型视为随机策略
- 不再只用 L1 / L2 回归监督
- 通过多 Reference GT + 强化学习奖励,显式鼓励多样性
Policy-Aware Diffusion Generator(PADG)
PADG (图3)是 DIVER 的核心模块,其作用是:
在扩散去噪过程中,引入地图、动态体、参考轨迹等条件信息,使生成的每条轨迹都具备清晰语义与可行性。
其结构包括:
- 轨迹编码(Trajectory Encoder)
- 条件扩散解码器(Conditional Diffusion Decoder)
- 地图 / Agent Cross-Attention
- Reference GT 引导机制
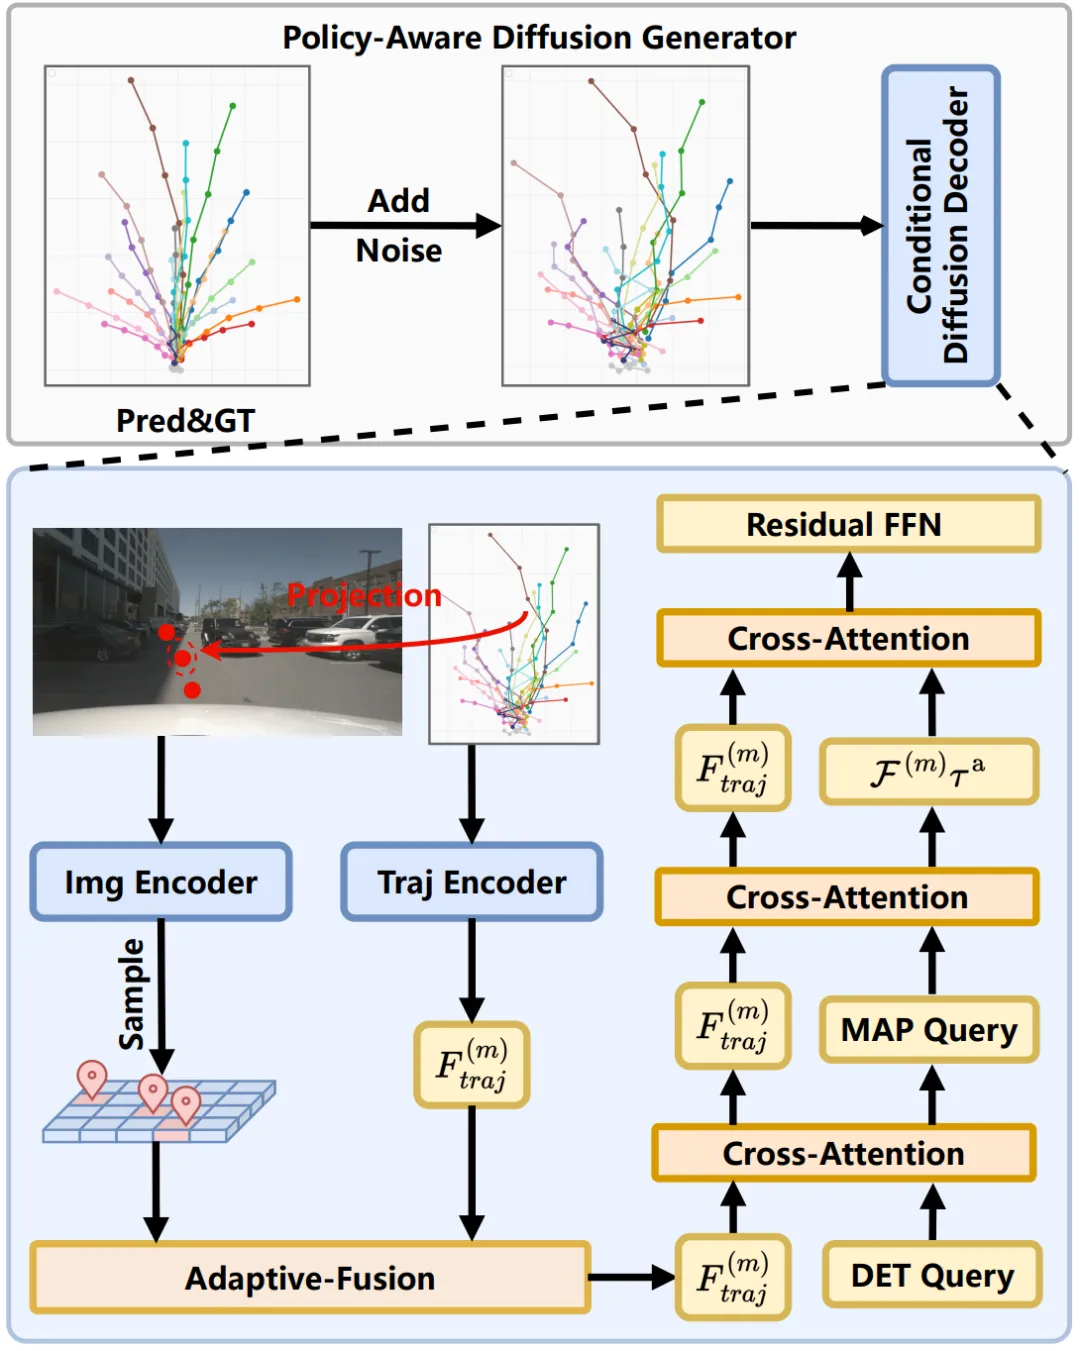
图3. PADG模块示意图
Reference GT:让每一条轨迹都有“意图”
为避免多模态轨迹全部收缩到同一模式,DIVER 不再只使用一个 GT,而是:
- 从专家轨迹中构建 多个 Reference GT
- 每个预测轨迹 mode 与一个 Reference GT 对齐
- 使用 Hungarian Matching 进行一对一匹配监督
这样,每个 mode 都被明确赋予一种驾驶意图(如转弯、让行、并线),从源头上避免 mode collapse。
强化学习(GRPO):把“好轨迹”定义清楚
仅有多样性还不够,真实驾驶还需要安全与稳定。
DIVER 采用 Group Relative Policy Optimization(GRPO),为扩散生成的轨迹引入多种轨迹级奖励,包括多样性、安全、轨迹一致性与车道保持等
这些奖励共同作用,使模型在“探索更多可能性”的同时,仍然保持驾驶质量。
多样性评估指标(Diversity Metric)
在多模态规划中,仅生成多条轨迹并不等价于“有效多样性”。
如果轨迹之间只是无约束发散,反而可能降低安全性与可执行性。
为此,DIVER 提出了一种新的 Diversity Metric,用于在可行性约束下评估多模态轨迹的真实多样性。
该指标不仅衡量不同轨迹在空间上的差异,还能够避免“无意义分散”的情况,更准确反映多模态规划在行为覆盖与驾驶质量之间的平衡。
在后续实验中,论文均基于该指标对不同方法的多模态规划能力进行对比分析。
性能亮点
在 Bench2Drive 闭环评测中,DIVER 在多项关键指标上显著优于 UniAD、VAD、SparseDrive、DiffusionDrive 等方法(表1)
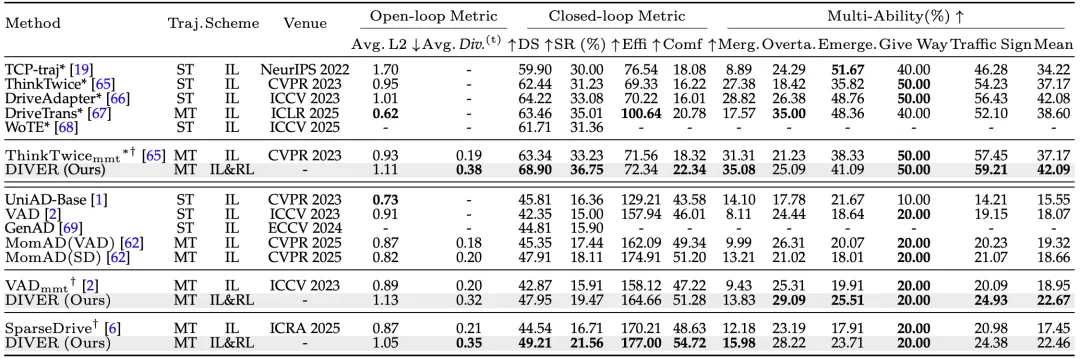
表1. Bench2Drive(V0.0.3)上的开环、闭环结果和多功能结果
针对“转弯最容易出问题”的场景,论文使用 Turning-nuScenes 数据集进行评测。
结果(表2)显示:
DIVER 的 轨迹多样性显著更高
同时 碰撞率最低
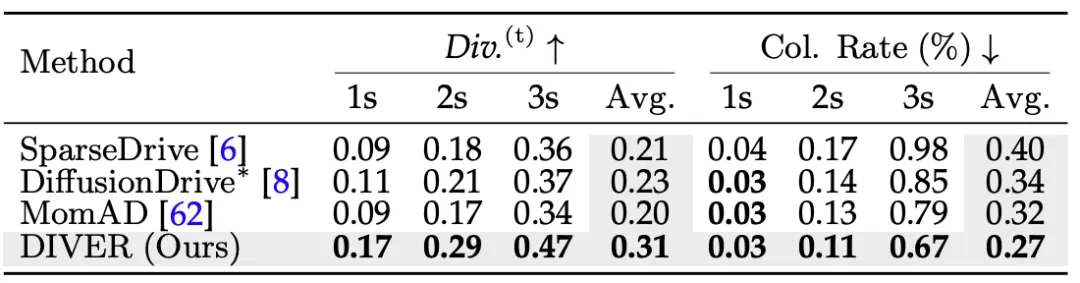
表2. Turning-nuScenes 规划结果
在 nuScenes 验证集的 6 秒长时预测任务中:
DIVER 在 多样性(Div.) 上大幅领先
同时保持 最低碰撞率
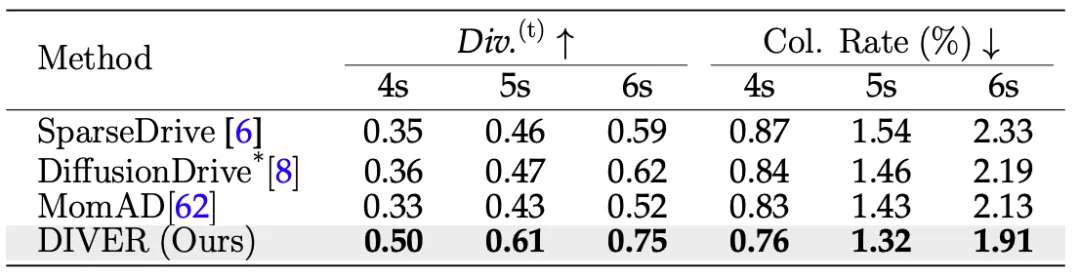
表3. NuScenes验证集上的长期规划结果
总结
DIVER 通过 “扩散模型 + 强化学习” 的统一框架,系统性解决了端到端自动驾驶中长期存在的 模仿学习模式坍塌问题。
在多个权威基准中,DIVER 展示了:
- 显著更高的轨迹多样性
- 更低的碰撞率
- 更稳定的长时规划能力
- 更强的复杂场景泛化能力
这项工作表明:靠模仿学习已不足以支撑真实世界自动驾驶,将生成模型与强化学习结合,是通向“更像人”的自动驾驶的重要一步。
....
#MindDrive
华科&小米汽车联合发布,基于在线强化学习自动驾驶 VLA 模型,闭环仿真新SOTA!
当自动驾驶迈入 “端到端” 新时代,视觉 - 语言 - 动作(VLA)范式成为打破传统模块化瓶颈的关键,但模仿学习带来的分布偏移、因果混淆等问题,始终制约着闭环驾驶的安全性与鲁棒性。如今,华中科技大学与小米汽车团队联手,推出基于在线强化学习的自动驾驶 VLA 框架 ——MindDrive,成功将语言推理与动态环境交互深度融合,在 Bench2Drive 基准测试中刷新同参数模型性能纪录,为自动驾驶领域的VLA模型自主学习能力开辟了全新路径。
- 论文标题:MindDrive: A Vision-Language-Action Model for Autonomous Driving via Online Reinforcement Learning
- 论文地址:https://arxiv.org/abs/2512.13636v1
- 项目地址:https://xiaomi-mlab.github.io/MindDrive/
- 代码地址:https://github.com/xiaomi-mlab/MindDrive
- 单位:华中科技大学,小米汽车
摘要
MindDrive 是专为自动驾驶设计的 VLA 模型,核心创新在于通过 “语言 - 动作动态映射”,将连续的轨迹动作空间转化为离散的语言决策空间,解决了在线强化学习在自动驾驶中探索效率低下的痛点。模型采用双专家架构:共享基础大语言模型(LLM)但搭载独立 LoRA 参数的决策专家与动作专家,通过轨迹级奖励反馈优化推理能力,实现了复杂场景最优决策、类人驾驶行为与高效探索的三者平衡。在 Bench2Drive 闭环基准测试中,搭载轻量化 Qwen2-0.5B的 LLM 的 MindDrive,取得了 78.04 的驾驶评分(DS)和 55.09% 的成功率(SR),分别超越同参数 IL 基线模型 5.15 分和 9.26%,是首个通过与环境实时交互进行在线强化学习训练的自动驾驶VLA模型。
动机
图一:不同VLA用于强化学习范式的比较
传统端到端自动驾驶框架依赖感知、预测、规划的模块化设计,缺乏常识推理能力,而现有 VLA 模型虽引入视觉语言模型(VLM)的强推理能力,但大多数基于模仿学习,这种仅通过专家数据拟合行为,易出现因果混淆和分布偏移,在闭环驾驶中导致不可逆的错误累积。
为解决模仿学习的缺陷,研究者尝试引入强化学习。然而,与视觉语言模型中离散语言空间的强化学习不同,自动驾驶领域的动作空间是一个连续轨迹空间。当前自动驾驶领域应用强化学习的方案可以分为两大范式:
- 离线强化学习:如图 1(a)所示,依赖固定的专家数据集训练,无法与动态环境交互。模型只能在已经收集好的数据内优化轨迹,无法探索新场景。
- 在线强化学习:一些方法通过在语言空间中引入在线强化学习,如图 1(b)所示,这些方法将驾驶决策视为动作,通过在线强化学习促进对因果推理的更深入理解,但难以将驾驶决策有效映射为具体且类人的驾驶轨迹并与环境进行交互。
为了解决上述问题,作者提出MindDrive ,如图1(c)所示,通过动态映射将动作空间从连续的轨迹转化为基于语言的离散决策,大幅提升强化学习的探索效率,同时在在线环境中利用轨迹动作奖励强化模型的推理能力。
方法
作者提出的MindDrive 架构包含两个核心组件:决策专家和动作专家。二者共享相同的视觉编码器和文本分词器,仅在各自的 LoRA 参数上存在差异。决策专家基于导航指令和多视角视觉输入进行高层推理,以元动作的形式生成驾驶决策;动作专家则基于场景信息和导航指令,将这些元动作转化为具体的动作轨迹。
图2:MindDrive整体架构图
训练流程包含两个阶段。第一阶段为模仿学习,作者结合大语言模型生成与人工筛选,构建了元动作与轨迹严格对应的规划QA,以此建立稳定的语言-动作映射,为强化学习提供高质量的初始策略与轨迹候选。
第二阶段则在 CARLA 模拟器的闭环交互环境中进行在线强化学习,如图3所示。在线强化学习过程中,作者利用视觉编码器提取并存储场景令牌以融合时空信息、降低计算成本,并设计了一套稀疏奖励机制:抵达目的地奖励为+1分,发生碰撞、闯红灯等四类事件为奖励为-1分,以此驱动智能体学习目标导向的安全驾驶行为。
图3:在线强化学习框架图
实验
作者在Bench2Drive数据进行闭环评估测试,如表1所示,对比传统端到端模型,超越最新模仿学习基线 DiffAD 10.12 DS 和 16.45% SR,领先了离线强化学习方法 Raw2Drive 6.68 DS 和 4.85% SR。对比 VLA 范式模型,以 0.5B 轻量化 LLM,实现与 7B 级 ORION 模型相当的性能,同时超越 Paligemma-3B 驱动的 DriveMoE 3.82 DS 和 6.45% SR。
表1:Bench2Drive上闭环评估和开环评估的性能对比
可视化结果
,时长01:23
总结
作者提出了自动驾驶领域的新框架MindDrive,其核心在于将语言指令映射为驾驶动作,从而将强化学习的探索空间从连续的轨迹空间转变为离散的语言空间,以显著降低训练成本。该框架还能够通过闭环仿真环境中的动作反馈,持续优化VLA模型的推理能力。作者基于所提出的在线强化学习训练框架开展的实验表明,MindDrive 凭借轻量化的模型结构,实现了最先进的性能。这项研究是首次在交互式模拟器进行在线强化学习的自动驾驶VLA模型。
#2# ~ 华科&小米联合提出MindDrive:首个证实在线强化学习有效性的VLA框架......
华科&小米的一篇新工作MindDrive,提出了一种基于在线强化学习的VLA框架。相比RecogDrive、ORION提升了不少,在Qwen2-0.5B的基座上效果挺不错的。
,时长01:23
当前自动驾驶领域VLA的相关工作主要依赖模仿学习,这会带来分布偏移和因果混淆等固有挑战。在线强化学习通过试错学习为解决这些问题提供了一条极具潜力的途径。然而,将在线强化学习应用于自动驾驶视觉-语言-动作模型时,面临着连续动作空间中探索效率低下的难题。为克服这一限制,华科和小米的团队提出了MindDrive——一种包含大语言模型(LLM)的视觉-语言-动作框架,该模型配备两组不同的LoRA参数。其中一组大语言模型充当决策专家,负责场景推理和驾驶决策;另一组则作为动作专家,将语言决策动态映射为可行驶轨迹。通过将轨迹级奖励反馈至推理空间,MindDrive能够在有限的离散语言驾驶决策集合上进行试错学习,而非直接在连续动作空间中操作。该方法有效平衡了复杂场景下的最优决策、类人驾驶行为与在线强化学习中的高效探索。在具有挑战性的Bench2Drive基准测试中,MindDrive取得了优异的闭环性能,驾驶得分(DS)达78.04分,成功率(SR)为55.09%。据我们所知,这是首个证实在线强化学习对自动驾驶视觉-语言-动作模型有效性的研究。
- 论文标题:MindDrive: A Vision-Language-Action Model for Autonomous Driving via Online Reinforcement Learning
- 论文链接:https://arxiv.org/abs/2512.13636
- 项目主页:https://xiaomi-mlab.github.io/MindDrive/
自动驾驶空间检索新范式来了
一、背景回顾
自动驾驶依赖模型在动态复杂环境中的感知、决策与动作执行的能力。传统端到端自动驾驶框架整合了感知、预测和规划模块,但缺乏常识和因果推理能力。随着视觉语言模型(VLM)在视觉理解和推理能力上的提升,众多研究尝试将视觉-语言-动作(VLA)范式应用于端到端自动驾驶领域。自动驾驶中的视觉-语言-动作范式旨在将复杂交通场景的理解转化为自车的行驶轨迹。
当前的视觉-语言-动作模型主要采用模仿学习(IL)进行训练,其目标是拟合从收集到的驾驶数据中提取的专家行为。然而,单纯依赖模仿学习范式会导致模型易受因果混淆和分布偏移的影响,进而在闭环驾驶场景中产生不可逆的误差累积。强化学习通过试错学习为解决这些挑战提供了新思路,并在提升视觉语言模型的因果推理能力方面取得了显著成效。
与视觉语言模型离散语言空间中的强化学习不同,自动驾驶的动作空间是连续的轨迹空间。当前强化学习在自动驾驶视觉-语言-动作领域的应用主要分为两类范式:动作空间的离线强化学习和语言空间的在线强化学习。离线强化学习通常基于专家演示构建的固定数据集进行训练,如图1(a)所示。这些方法采用带有不同奖励函数的离线强化学习,在动作空间中生成更可行的轨迹。尽管取得了一定进展,但离线强化学习限制了视觉-语言-动作模型通过与环境交互进行探索的能力。此外,强化学习中对轨迹的优化无法有效提升视觉语言模型的推理能力。为克服这些限制,部分方法尝试在语言空间中应用在线强化学习,如图1(b)所示。这些方法将驾驶决策视为动作,通过在线强化学习加深对因果推理的理解,但难以将驾驶决策有效映射为具体且类人的驾驶轨迹。因此,利用在线强化学习提升自动驾驶视觉-语言-动作模型的性能仍需进一步探索。
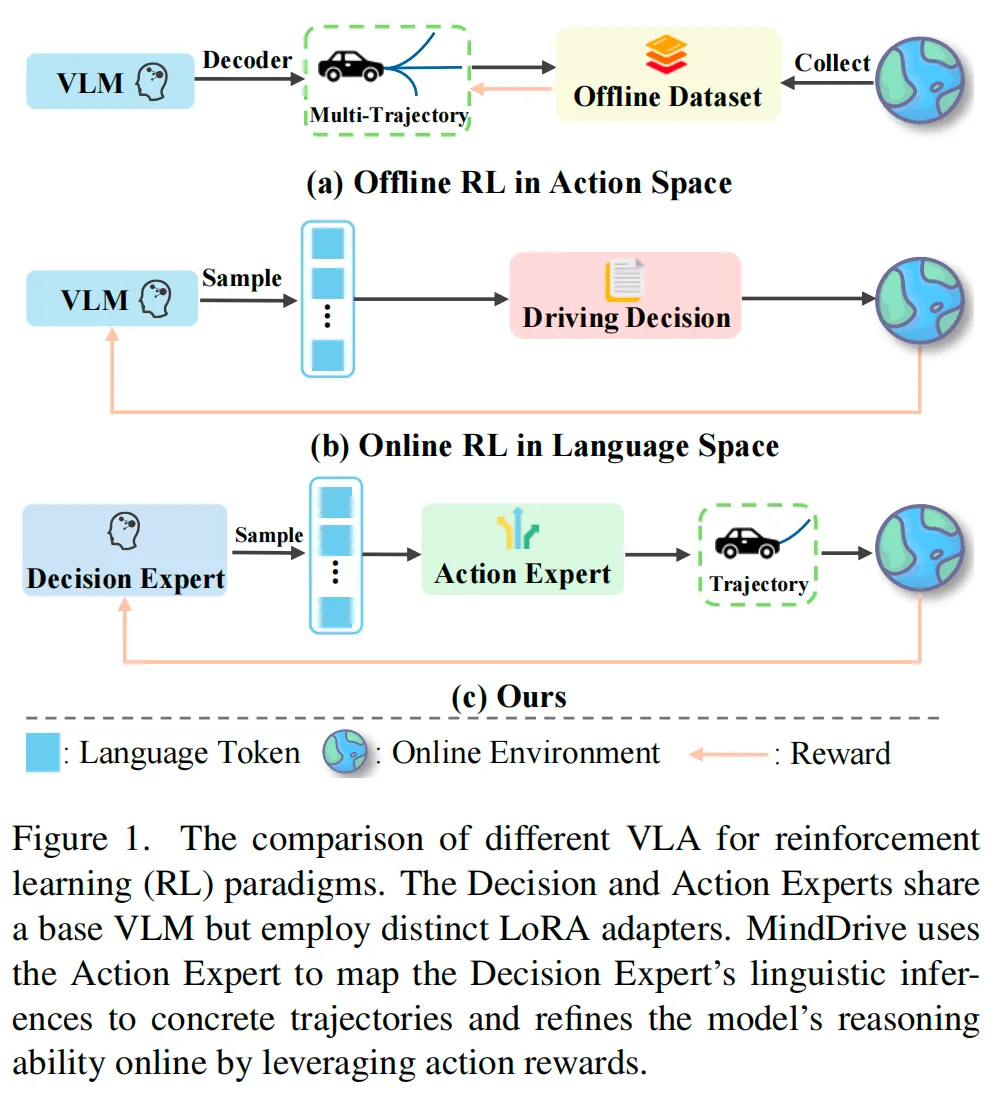
为应对上述挑战,我们提出了一种新型架构MindDrive——一种基于在线强化学习的自动驾驶视觉-语言-动作模型,如图1(c)所示。MindDrive通过动态映射将动作空间从轨迹转化为基于语言的决策,在利用轨迹奖励强化模型在线推理的同时,显著提升了探索效率。具体而言,MindDrive包含两个同质的大语言模型,仅在各自的低秩适配(LoRA)适配器上存在差异。其中一个大语言模型作为决策专家,负责根据当前场景做出合理决策;另一个作为动作专家,建立推理结果到连续轨迹的动态映射。MindDrive首先通过模仿学习在决策专家推断的元动作与动作专家输出的多模态轨迹之间建立一一对应关系。动作专家输出的高质量驾驶轨迹为在线强化学习提供了合理且类人的候选轨迹。随后,我们利用在线强化学习对决策专家进行优化,使其能够通过采样不同轨迹并从在线交互环境中接收相应的奖励信号,学习如何做出正确决策。同时,为实现模型在动态交互环境中的探索与训练,我们基于CARLA仿真器构建了一个面向自动驾驶视觉-语言-动作模型的在线闭环强化学习框架。我们定义了明确的任务成败信号,并将在线强化学习过程划分为数据收集和训练两个阶段。在数据收集阶段,我们计算并缓存每帧的场景令牌,作为紧凑的状态表示。这一预计算步骤降低了内存缓冲开销,支持大批量训练,并使整个过程可表述为标准的马尔可夫决策过程。
我们在全面且具有挑战性的闭环基准测试Bench2Drive上评估了MindDrive的驾驶能力。大量实验表明,我们的框架在复杂驾驶场景中实现了更有效的驾驶行为。值得注意的是,即使采用轻量级的0.5B参数大语言模型,MindDrive仍取得了78.04分的驾驶得分(DS)和55.09%的成功率(SR),分别比相同参数规模的强基线模型高出5.15分和9.26%。
本文的主要贡献如下:
- 提出了MindDrive——一种面向视觉-语言-动作自动驾驶模型的在线强化学习框架。通过引入动态的语言-动作映射,MindDrive显著提升了探索效率,并利用轨迹级动作奖励促进推理优化。
- 提出了一种计算高效的在线强化学习方案。据我们所知,MindDrive是首个在仿真器中通过在线强化学习训练的基于视觉-语言-动作的自动驾驶模型,旨在为自动驾驶领域带来新的启发。
- 大量实验验证了MindDrive的有效性,其在Bench2Drive基准测试中取得了78.04分的驾驶得分和55.09%的成功率,显著优于相同模型规模下最先进的模仿学习基线。
二、MindDrive算法详解
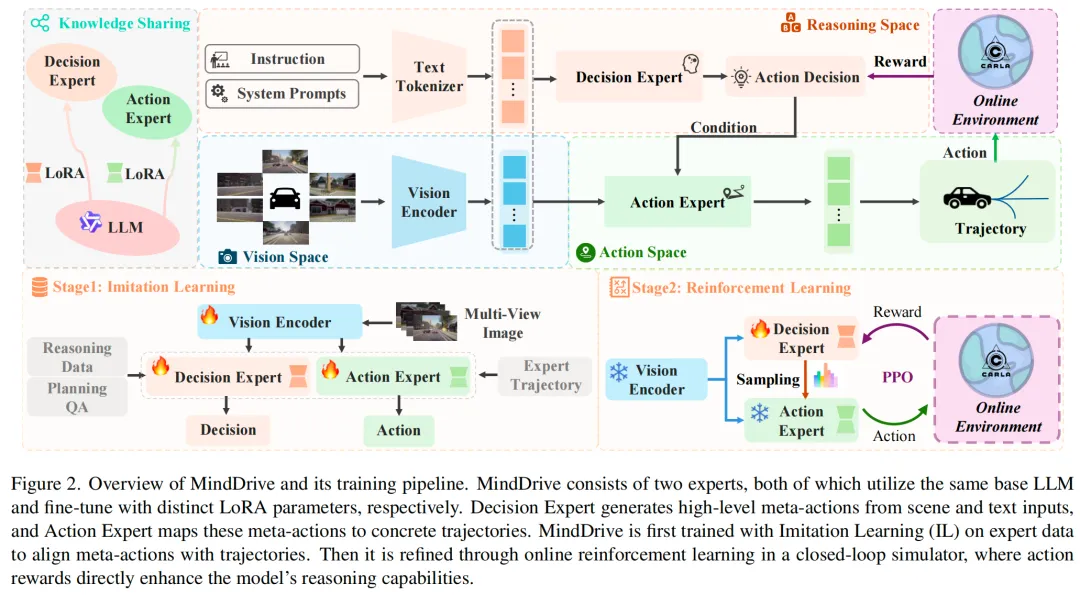
本节将详细介绍所提出的MindDrive。如图2所示,MindDrive的架构包含两个核心组件:决策专家(Decision Expert)和动作专家(Action Expert)。两者共享相同的视觉编码器(Vision Encoder)和文本分词器(Text Tokenizer),仅在各自的低秩适配(LoRA)参数上存在差异。决策专家基于导航指令和多视角视觉输入进行高层推理,以元动作(meta-actions)的形式生成抽象驾驶决策;动作专家则结合场景信息和指令,将这些元动作转化为具体的动作轨迹。该设计实现了灵活且可解释的动作生成,衔接了高层推理与低层控制。我们的训练过程分为两个阶段:1)模仿学习(IL)建立语言与动作空间的映射,为在线强化学习(RL)提供高质量候选轨迹,有效缩小其探索空间;2)在线强化学习通过在线环境中的动作奖励进一步提升模型的理解能力。
问题表述
在端到端自动驾驶任务中,我们旨在基于周围视觉信息和语言指令,生成多样化轨迹集合并确定最优轨迹:
,
其中,表示多模态轨迹集合中的轨迹,为轨迹生成策略函数。现有方法通常基于得分选择策略挑选最优轨迹:
为充分发挥视觉-语言-动作(VLA)模型的潜力,我们将选择任务建模为动作决策过程,并引入作为选择策略函数:
选择生成
由式(3)可知,最优轨迹的生成依赖两个核心策略函数:(选择策略)和(生成策略)。现有方法未能在在线强化学习中建立这两个策略空间的关联。为解决该问题,我们建立了从语言元动作到轨迹的映射关系,再通过在线强化学习利用轨迹反馈优化的推理过程。在线强化学习使模型能通过与动态环境的交互持续学习和优化策略,这对提升模型的因果关系理解至关重要。
我们将轨迹决策过程建模为马尔可夫决策过程(MDP)以适配在线强化学习。该MDP可表示为元组:状态包含智能体在第步决策所需的所有必要信息;模型根据策略从动作空间中选择动作;执行动作后,系统将根据闭环仿真环境隐含定义的动态特性转移至新状态;奖励是评估在状态下执行动作质量的标量反馈信号。我们的目标是学习决策策略,在折扣因子的引导下,最大化收集数据中的期望累积折扣奖励,目标函数定义为:
语言-动作映射
为增强决策策略与轨迹生成策略之间的协同性,我们将单个大语言模型(LLM)解耦为两个配备不同LoRA参数的专用专家。其中一个大语言模型作为决策专家,实现策略;另一个作为动作专家,负责策略。该架构确保两者在共享世界知识基础的同时,各司其职。
我们首先利用模仿学习在决策专家与动作专家之间建立映射,构建语言与动作的关联,以提升后续强化学习过程的探索效率。受其他工作启发,我们将控制解耦为纵向控制和横向控制,以提高规划灵活性,并在规划问答(QA)中设计相应的元动作。我们利用大语言模型生成规划问答对,并通过人工筛选进行优化,确保语言与动作的一一对应。随后,模型在推理数据和规划问答对上进行训练,学习从语言到动作的映射,损失函数表示为:
接着,在动作专家中,我们将元动作映射为纵向控制的时间速度轨迹和横向控制的几何路径轨迹。具体而言,我们利用动作专家的自回归特性,将视觉和语言信息编码为隐藏状态,并引入两个特殊令牌<speed waypoints>(速度航点)和<path waypoints>(路径航点),从动作专家的输出中提取对数概率:
最后,我们采用带有门控循环单元(GRU)解码器的变分自编码器(VAE)对齐语言和动作空间,直接将视觉-语言表示转化为最终的动作轨迹:
其中,是 latent 空间中的高斯变量。我们采用常用的检测损失进行辅助监督;变分自编码器在专家轨迹的监督下,通过KL散度损失进行训练;对于速度和路径航点回归,我们采用L1损失作为行为克隆损失。总损失为:
面向动作推理的在线强化学习
模仿学习能生成类人轨迹,但常受因果混淆问题困扰。为解决这一问题,我们在CARLA仿真器中引入在线强化学习。如图3所示,这种在线方式使智能体能通过试错探索环境,从直接交互及其后果中学习,进而提升模型在复杂场景下的驾驶性能。
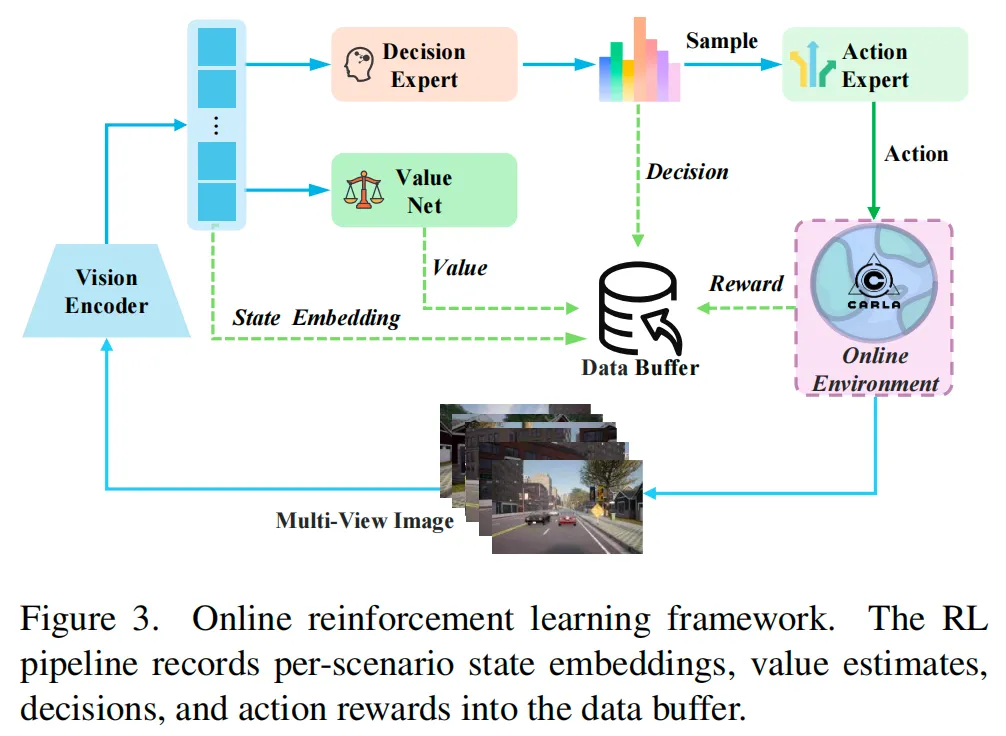
为充分利用模仿学习获得的先验知识,价值网络与大语言模型共享相同权重,仅将最后一层替换为多层感知机(MLP)以预测状态价值。为实现高效的滚动(rollout)过程,我们部署了个并行的CARLA数据采集器,重点关注模仿学习后模型未能完成的不同场景路线。每一步中,我们利用视觉编码器处理场景中的视觉信息并转化为状态嵌入;以提问形式查询决策专家,并从其输出的元动作令牌对数概率中采样;采样得到的元动作通过动作专家进一步映射为动作空间中的精确轨迹。同时,价值网络用于估计每个决策步骤下当前状态的价值。
由于MindDrive已通过模仿学习预训练掌握了基本驾驶技能,我们采用稀疏奖励函数引导其高层推理空间的优化:车辆成功到达目的地时奖励为+1;触发预定义惩罚事件时奖励为-1;其他正常驾驶场景下奖励为0。奖励函数定义如下:
若到达目的地若触发惩罚事件其他情况
我们采用CARLA官方排行榜指标作为惩罚事件,包括与其他车辆碰撞、闯红灯等严重违规行为。一旦触发任何惩罚事件,滚动过程立即终止。收集完完整路线后,通过时序差分法计算值:
其中,是价值网络函数,是折扣因子,用于合理权衡未来奖励在决策过程中的权重。随后计算广义优势估计(GAE):
其中,是迹衰减参数,用于控制优势估计中的偏差-方差权衡。
我们未直接使用多帧图像进行强化学习训练,而是采用视觉编码器提取的状态嵌入表示当前状态。该方法可同时整合时序和视觉信息,并通过避免重复计算提升计算效率。我们将每一步的价值、决策-动作及奖励存储至数据缓冲区;收集完所有路线后,利用近端策略优化(PPO)算法优化策略:
其中,是PPO中的裁剪参数。得益于所提出的强化学习训练框架,MindDrive能够支持大批量训练,实现稳定优化。
同时,为缓解强化学习微调阶段的灾难性遗忘问题,我们引入KL散度损失作为正则化项,用于约束决策专家元动作的输出分布,公式表示为:
训练过程中,仅更新价值网络中多层感知机头部的参数,通过最小化均方误差(MSE)损失实现优化:
最终,在线强化策略学习损失为:
其中,是控制KL正则化强度的系数。
实验结果分析
主要结果
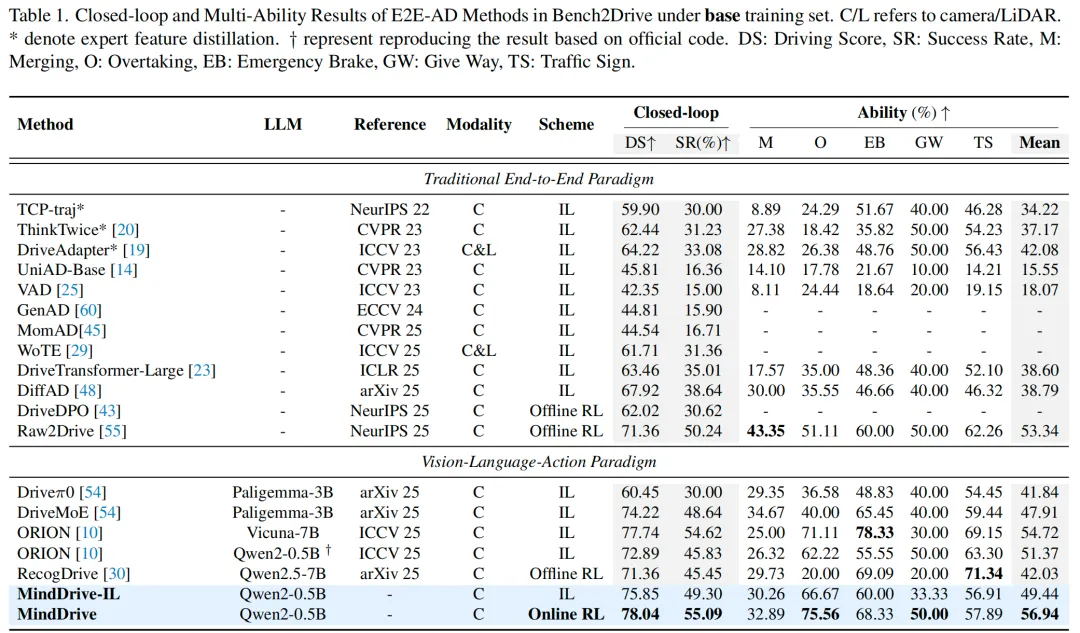
我们在Bench2Drive基准测试集上,将MindDrive与传统端到端(E2E)和视觉-语言-动作(VLA)范式的代表性方法进行了全面对比。表1列出了详细结果,主要发现如下:
- 轻量级模型实现优异性能:与传统端到端方法相比,MindDrive超越了最新的最先进(SOTA)模仿学习模型DiffAD,驾驶得分提升10.12分,成功率提升16.45%;超越离线强化学习方法Raw2Drive,驾驶得分提升6.68分,成功率提升4.85%。在视觉-语言-动作范式中,MindDrive与最先进的模仿学习模型ORION性能相当,且比DriveMoE的驾驶得分高3.82分,成功率高6.45%。值得注意的是,MindDrive采用轻量级Qwen2-0.5B模型,而ORION和DriveMoE分别使用更大规模的Vicuna1.5-7B和Paligemma-3B模型,凸显了我们方法的高效性。
- 在线强化学习增强复杂动态交互能力:如表1所示,MindDrive相较于其他方法展现出明显优势。它超越离线强化学习方法RecogDrive,驾驶得分提升6.68分,成功率提升9.64%;相较于MindDrive-IL(仅模仿学习版本),驾驶得分提升2.19分,成功率提升5.79%,充分验证了所提在线强化学习范式的优越性。多能力评估结果进一步支持这一发现:MindDrive的平均能力比RecogDrive提升14.91%,比采用相同轻量级大语言模型的模仿学习方法ORION提升5.57%。特别是在与元动作选择密切相关的能力上,超车(Overtaking)能力提升55.56%,让行(Give Way)能力提升30%。尽管MindDrive在紧急制动(Emergency Brake)和交通标志识别(Traffic Sign)能力上略低于最先进的视觉-语言-动作方法,但相较于MindDrive-IL仍有显著提升,分别提高8.33%和0.98%。这些结果证实,在线强化学习显著增强了模型在复杂交互环境中的因果推理能力和决策鲁棒性。
消融实验
消融实验中,除非另有说明,每条路线执行两次在线强化学习rollout。
惩罚事件消融:在线强化学习阶段,我们引入四类惩罚事件:与行人或车辆碰撞、闯红灯、驶离道路或偏离路线超过30米、不遵守停车标志(分别记为碰撞、交通灯、路线偏离、停车),并为触发这些事件的模型分配-1的稀疏奖励。如表2所示,随着这些惩罚事件的逐步加入,模型的成功率和平均驾驶能力相较于模仿学习基准(ID-1)持续提升。具体而言,引入碰撞惩罚(ID-2)后,成功率较基准提升1.4%,平均能力提升3.76%,且驾驶得分保持相当水平;在超车场景中,MindDrive表现尤为突出,较基准提升4.44%,这得益于模型学会了在连续交互的交通流中采取更主动的避撞策略,但这种策略转变也导致并道(Merging)性能有所下降。引入交通灯惩罚(ID-3)后,交通标志识别能力提升1.52%,紧急制动能力提升8.97%,但惩罚中的冲突奖励信号导致超车性能明显下降。引入路线偏离惩罚(ID-4)有助于在果断性和谨慎性之间取得更好平衡,但对探索的严格约束限制了进一步的性能提升。值得注意的是,添加停车标志惩罚后,模型整体性能显著提升——这与停车元动作高度相关,能促进更有效的策略学习,尤其在含停车标志的并道场景中,相较于ID-4,并道能力提升5.26%,成功率提升3.24%。无需复杂的奖励工程,MindDrive即可通过在线试错发现有效的驾驶策略,从失败中自主学习以逐步确定最优动作。
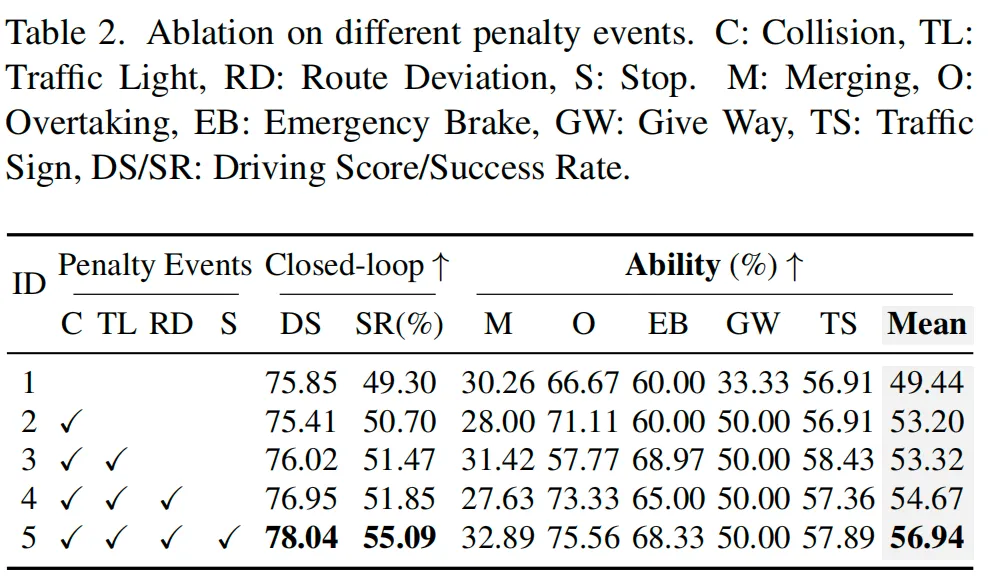
rollout次数消融:我们进一步分析了在线强化学习过程中滚动次数对MindDrive的影响。如图4所示,仅执行一次滚动时,价值网络的估计不准确导致动作优势估计出现偏差,性能较基准下降;执行两次滚动后,模型显著超越基准,驾驶得分提升2.19分,成功率提升5.79%;但继续增加滚动次数会导致性能大幅下降,驾驶得分从78.04降至73.69,成功率从55.09%降至45.12%。这一退化源于灾难性遗忘——过多滚动导致策略过拟合近期经验,忘记之前学到的场景理解能力。因此,我们将默认滚动次数设为2,以平衡探索效率和训练稳定性。
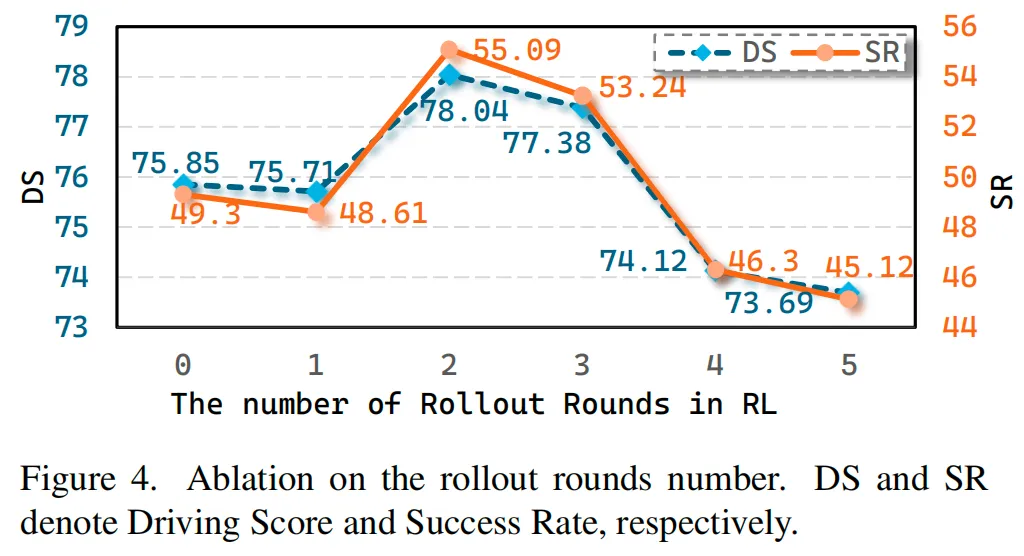
策略正则化消融:我们在PPO框架内评估了不同的策略正则化方法,结果如表3所示。我们的方法(PPO-KL)相较于基础PPO(PPO-Vanilla),驾驶得分提升3.31分,成功率提升8.36%,表明KL散度损失能有效稳定强化学习训练过程中的策略更新,缓解灾难性遗忘;相较于基于熵的正则化(PPO-Entropy),驾驶得分提升2.33分,成功率提升5.85%,说明尽管熵正则化能促进探索,但过多的策略随机性对于目标导向的驾驶任务并非最优。总体而言,我们的KL正则化方法实现了更高效的学习,策略优化过程更快,样本效率高于基准方法。
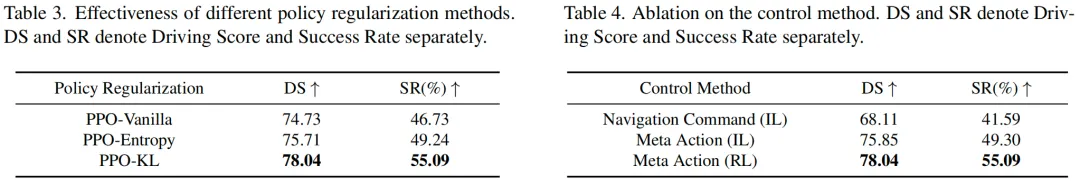
控制方法消融:我们通过对比两种高层指令方式,研究了不同控制方法的效果:导航指令和大语言模型生成的元动作。如表4所示,基于视觉语言模型引导的元动作模仿学习模型,相较于导航指令基准,驾驶得分提升7.74分,成功率提升7.71%,表明视觉语言模型衍生的元动作能支持复杂交通场景下更有效的推理;引入在线强化学习后,元动作选择进一步优化,驾驶得分额外提升2.19分,成功率额外提升5.79%。
定性结果
图5展示了MindDrive的模仿学习版本与强化学习版本的定性对比。模仿学习范式在特定任务上表现出较强能力(如及时发出停车指令以实现早期制动),但仅通过模仿学习训练的MindDrive在动态交互场景中表现不佳,尤其在需要复杂决策的场景(如确定最优变道时机)中。经过强化学习训练后,MindDrive在具有挑战性的场景中能选择更稳健的元动作,实现更安全、更果断的变道行为。这些定性结果表明,强化学习阶段显著提升了视觉语言模型的高层推理和决策能力,使其能更好地应对复杂且不确定的交通环境。
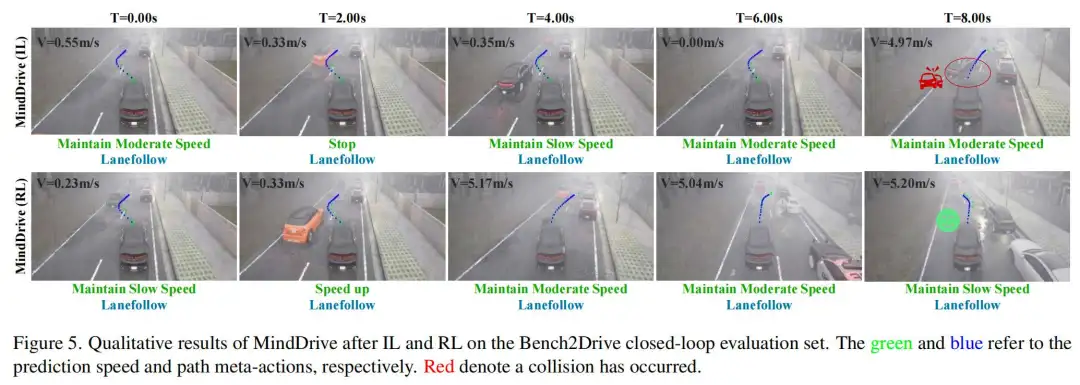
四、结论
在本文中,我们提出了MindDrive——一种新型自动驾驶框架,该框架以语言为接口实现在线强化学习(RL)。MindDrive将语言指令映射为动作,把探索空间转化为离散的语言空间,从而降低强化学习的成本。它还能让大语言模型通过闭环仿真器中的动作反馈,优化自身的推理能力。
我们在提出的在线强化学习训练框架中开展了实验。结果表明,MindDrive凭借轻量级模型实现了最先进的性能。据我们所知,这是首个在交互式仿真器中成功训练用于自动驾驶的视觉-语言-动作模型的研究。我们期望这项工作能为自动驾驶领域带来宝贵的启发。
局限性
由于缺乏真实世界的交互仿真器,我们的评估仅限于CARLA仿真器。此外,同步多个CARLA仿真器存在技术挑战,这使得我们无法评估相同初始状态下的备选动作,进而限制了GRPO算法的应用。
....
#WorldLens
十余所机构联合提出:评测了所有开源自驾世界模型(中科院&新国立等)
现有世界模型在视觉生成上已经相当逼真,但在几何一致性、时序稳定性和行为合理性上仍存在明显缺陷,而这些问题往往难以通过传统的视频质量指标被发现。针对这个问题WorldBech团队提出了WorldLens。
这一全方位基准用于评估模型构建、理解其生成世界并在其中行为的能力。它涵盖五个核心维度:生成质量、重建性能、指令跟随、下游任务适配性和人类偏好,全面覆盖视觉真实性、几何一致性、物理合理性和功能可靠性。评估结果显示,现有世界模型均无法实现全维度最优:部分模型纹理表现出色但违背物理规律,而几何稳定的模型则缺乏行为可信度。为使客观指标与人类对齐,WorldLens进一步构建了WorldLens-26K数据集——包含大规模人类标注视频,附带量化评分和文本说明,并开发了WorldLens-Agent评估模型,通过蒸馏这些标注数据实现可扩展、可解释的评分。基准、数据集与智能评估代理共同构成统一生态系统,用于衡量世界模型的保真度,为未来模型的评估提供标准化依据——不仅关注视觉真实感,更重视行为合理性。
- 论文标题:WorldLens: Full-Spectrum Evaluations of Driving World Models in Real World
- 项目主页:https://worldbench.github.io/worldlens
- 论文链接:https://arxiv.org/abs/2512.10958
- 汇总链接:https://github.com/worldbench/WorldLens
- 数据集:https://huggingface.co/datasets/worldbench/videogen
- 参与机构:新国立、中科院、澳门大学、中科大、浙大、地平线、南洋理工、华科、慕尼黑工大、复旦、上海人工智能实验室
一、背景回顾
生成式世界模型已彻底改变人工智能与仿真领域。从文本驱动的4D合成到可控驾驶环境生成,现代系统能够生成类似行车记录仪视角的序列,视觉真实感令人瞩目。然而,评估方法的发展却未能同步跟进:目前缺乏标准化手段来衡量生成世界是否保持几何结构、遵循物理规律,以及支持可靠的决策制定。
现有广泛使用的指标多侧重于帧质量和美学表现,但难以反映物理因果关系、多视角几何一致性或控制场景下的功能可靠性。近期多个综述已明确指出这一缺口,导致领域进展分散,研究结果缺乏可比性。尽管结构化成熟度量表(如SAE自动驾驶分级标准)已为自动驾驶基准测试提供清晰指引,但适用于驾驶世界模型评估、可直接落地的类似协议仍尚未出现。
为填补这一空白,我们构建了WorldLens——全方位基准,用于评估世界模型构建、理解其生成世界并在其中行为的能力。如图1所示,现有模型均无法实现全维度最优:部分模型实现了出色的纹理真实感但违背物理规律,而另一些模型虽能保持几何一致性,却在行为表现上存在缺陷。
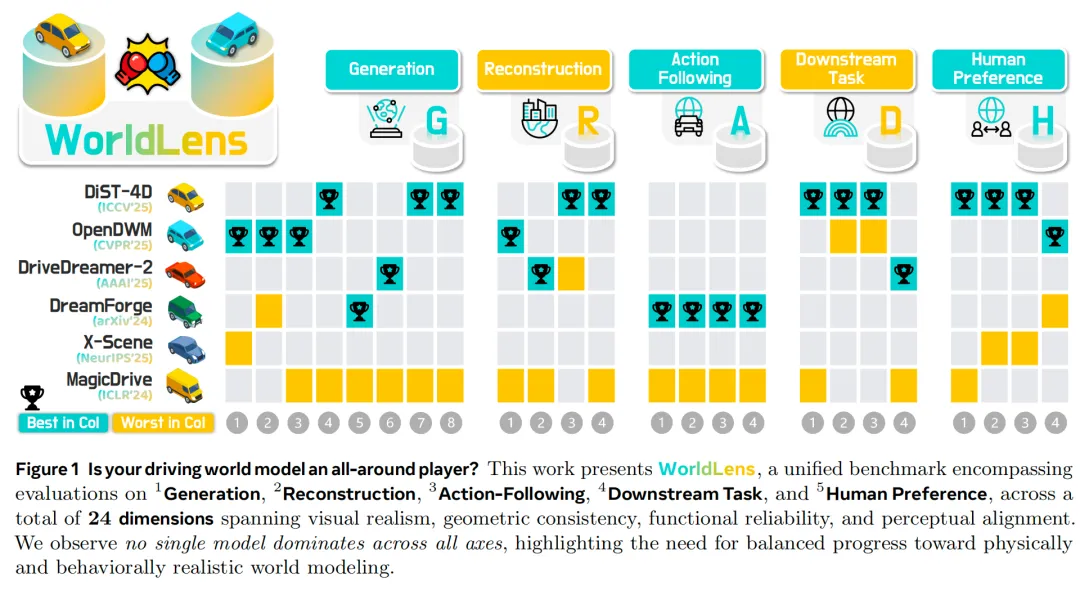
为揭示世界建模中的权衡关系,我们将评估拆解为五个互补维度:
- 生成质量:衡量模型能否合成视觉真实、时间稳定且语义一致的场景。即使是感知误差较低的最先进模型(如基于LPIPS、FVD指标),也常存在视角闪烁或运动不稳定问题,凸显当前扩散模型架构的局限性。
- 重建性能:考察生成视频能否通过可微分渲染重建成连贯的4D场景。许多在2D视角下表现清晰的模型,在重建过程中会出现几何“漂浮物”,表明多数模型的时间一致性与空间结构耦合较弱。
- 指令跟随:测试预训练动作规划器能否在生成世界中安全运行。高开环真实感并不意味着闭环控制的安全性,几乎所有现有世界模型都会导致碰撞或偏离车道等问题,说明仅靠 photometric真实感无法实现功能可靠性。
- 下游任务适配性:评估合成数据能否支持基于真实数据集训练的下游感知模型。即使视觉效果出色的生成世界,也可能导致检测或分割精度下降30%-50%,这表明与任务分布的对齐度(而非单纯图像质量)对实际应用至关重要。
- 人类偏好:通过大规模人类标注捕捉世界真实感、物理合理性和行为安全性等主观评分。研究发现,几何一致性强的模型通常被评为更“真实”,证实感知保真度与结构一致性密不可分。
为衔接算法指标与人类感知,我们构建了WorldLens-26K数据集——包含大规模人类标注视频,覆盖感知质量、物理规律和安全性等多个维度。每个样本均包含量化评分和文本说明,捕捉评估者对真实感、物理合理性和行为安全性的判断逻辑。通过将人类判断与结构化说明相结合,我们旨在将主观评估转化为可学习的监督信号,实现对生成式世界模型的感知对齐与可解释评估。
基于上述资源,我们开发了WorldLens-Agent——从人类偏好中蒸馏得到的反馈对齐自动评估器。该智能体能够预测感知和物理相关评分,同时生成与人类推理逻辑一致的自然语言说明。它对未见过的模型具有良好的泛化能力,无需重复人工标注即可实现生成世界的可扩展自动评估。
综上,我们的基准、数据集和评估代理共同构成统一生态系统,衔接客观测量与人类解读。我们将开源工具包、数据集和模型,推动标准化、可解释且与人类对齐的评估方法发展,引导未来世界模型不仅“看起来”真实,更能“表现”得合理。
二、WorldLens:全方位基准
生成式世界模型需超越视觉真实感,实现几何一致性、物理合理性与功能可靠性。我们提出WorldLens这一统一基准,从低层次外观保真度到高层次行为真实感,通过五个互补维度评估这些核心能力。如图2所示,每个维度均拆解为细粒度、可解释的子维度,形成衔接人类感知、物理推理与下游实用性的综合框架。
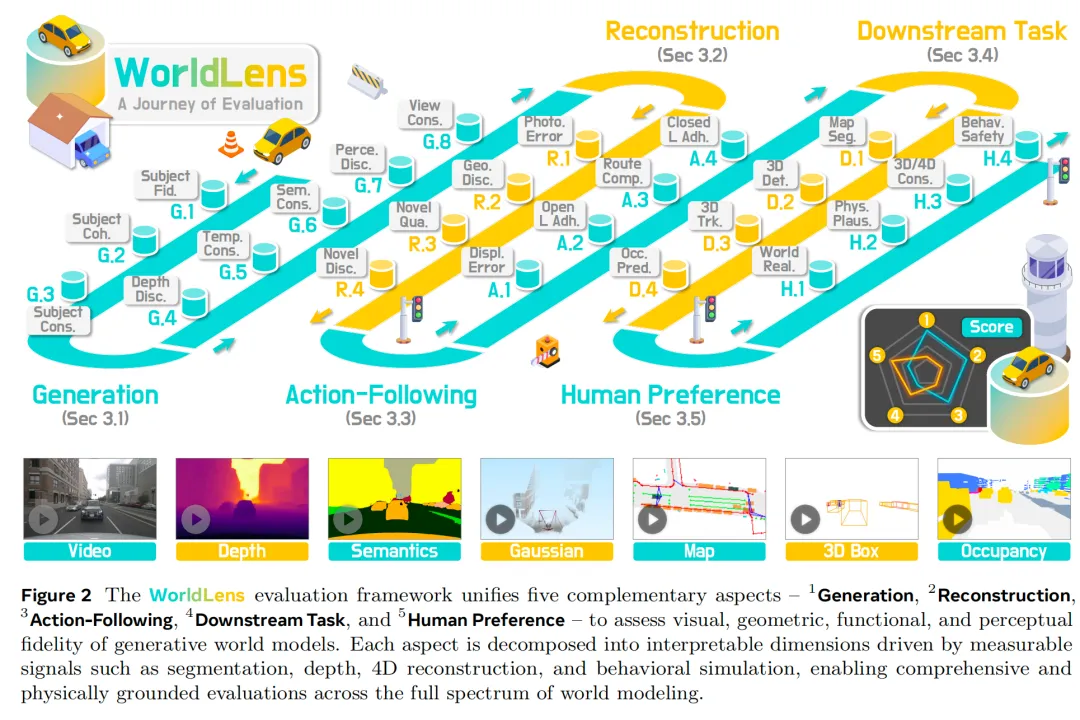
生成质量
该维度将整体生成质量拆解为八个互补子维度,评估外观保真度、时间稳定性、几何正确性与语义流畅性,量化模型在不同时间与视角下构建视觉及感知一致驾驶场景的“忠实度”。
- 目标保真度(Subject Fidelity):衡量车辆、行人等单个目标实例的感知真实感与语义正确性。对生成帧中的目标区域进行边界框裁剪,采用基于真实数据训练的类别专用二分类器评估,高置信度表明生成目标在视觉上与真实世界类别对齐,聚焦实例级保真度,补充全局指标的不足。
- 目标连贯性(Subject Coherence):评估目标在生成序列中的时间稳定性。通过已知跟踪ID,利用预训练ReID模型提取视觉嵌入并计算帧间相似度,高连贯性分数意味着目标在运动过程中保持形状、颜色和纹理一致,反映外观稳定性与身份持续性。
- 目标一致性(Subject Consistency):借助DINO特征捕捉目标的纹理与空间细节,评估目标级语义与几何的细粒度时间稳定性,确保目标在运动中结构与语义不变形、无闪烁,体现目标时间演化的可靠性与外观平滑变化特性。
- 深度差异度(Depth Discrepancy):通过Depth Anything V2估计单目深度并编码为彩色图,利用DINO v2提取嵌入,计算连续帧间特征平均距离,量化深度感知的连续性,数值越低表明场景运动的几何稳定性与物理合理性越强。
- 时间一致性(Temporal Consistency):在CLIP视觉编码器学习的外观空间中,量化帧间全局平滑度。通过相邻帧相似度、抖动抑制及与真实视频的运动速率对齐,评估动态过程的时间稳定性,高分数对应无突变、自然的动态演化。
- 语义一致性(Semantic Consistency):采用预训练SegFormer预测帧级掩码,计算标签、区域及类别分布的稳定性,确保生成视频的目标语义与场景结构无边界闪烁或标签不一致,维持语义布局的时间流畅性。
- 感知差异度(Perceptual Discrepancy):利用预训练I3D提取时空嵌入,计算真实与生成视频分布间的弗雷歇视频距离(FVD),量化两者的整体感知差距,数值越低表明外观与运动统计特性越相近,感知真实感与时间连贯性越强。
- 跨视角一致性(Cross-View Consistency):通过LoFTR检测同步相机对的特征对应关系并聚合置信度,评估相邻相机重叠区域的几何与光度对齐程度,高一致性确保多视角驾驶系统的3D一致生成,体现多视角下的结构对齐与视觉连续性。
重建性能
该维度聚焦生成视频恢复连贯4D场景的能力。将每个序列映射为高斯场,在原始与新视角轨迹下重新渲染,测试空间插值、视差效果及新视角路径的泛化能力。
- 光度误差(Photometric Error):衡量重建场景还原输入帧的准确性。将生成视频重建为可微分4D表示,在原始相机姿态下重新渲染,计算LPIPS、PSNR、SSIM等像素级相似度,反映外观与光照的时间稳定性,数值越低越利于实现忠实的4D重建。
- 几何差异度(Geometric Discrepancy):评估重建几何与真实世界结构的对齐程度。在相同相机姿态下,分别从生成序列与真实序列重建4D场景,对比渲染深度图,在Grounded-SAM 2筛选的区域内计算绝对相对误差(AbsRel),数值越低表明深度与表面几何越贴近真实场景。
- 新视角质量(Novel-View Quality):采用MUSIQ模型评估新视角轨迹下重建渲染帧的感知真实感。新视角轨迹包括前向中心插值、S形轨迹、横向偏移三种,高分数意味着新视角下的渲染帧清晰、无伪影、视觉连贯,体现模型在训练视角外的外观与光照一致性保持能力。
- 新视角差异度(Novel-View Discrepancy):在相同新视角轨迹下,计算生成重建与真实重建渲染视频的FVD,量化两者的感知差距,数值越低表明模型在未见过的视角下,仍能维持4D空间中几何、外观与时间动态的连贯性。
指令跟随
该维度评估生成世界支持预训练规划器做出合理驾驶决策的能力,检验合成场景是否提供与真实世界一致的视觉及运动线索。所有评估在生成式模拟器中进行,采用基于真实世界地图设计的自定义路线,对标标准基准。
- 位移误差(Displacement Error):评估生成视频在运动规划下游任务中的功能一致性。利用预训练端到端规划器(UniAD或VAD)分别从生成视频与真实视频预测未来路径点,计算平均L2距离,数值越低表明生成场景保留了准确轨迹预测所需的运动线索,功能保真度越高。
- 开环适配度(Open-Loop Adherence):在非反应式仿真环境中,采用预测驾驶模型分数(PDMS)评估预训练策略的性能。PDMS聚合安全性、进度、舒适度等子分数,高分数意味着仅基于生成视觉输入,策略仍能展现真实、稳定、安全的驾驶行为,反映短期功能真实感。
- 路线完成率(Route Completion):在闭环仿真中,计算车辆在碰撞、偏离车道或超时终止前完成预定义路线的百分比,高完成率表明生成环境支持长期、物理一致的控制,保障目标导向运动的持续性。
- 闭环适配度(Closed-Loop Adherence):通过场地驾驶分数(ADS)整合运动质量与任务完成度,由PDMS与路线完成率相乘得到。高ADS分数表明规划器在闭环仿真中既能安全驾驶,又能有效完成路线,证实生成世界不仅“看起来真实”,且在自主控制闭环中“驾驶起来真实”。
下游任务适配性
该维度通过评估预训练3D感知模型在合成数据上的性能,衡量生成视频的下游实用性。任务性能下降程度反映生成场景的真实感、保真度与迁移能力,具体涵盖四个代表性下游任务:
- 地图分割(Map Segmentation):评估生成数据是否包含足够的空间与语义线索,支持鸟瞰图(BEV)映射。采用预训练BEV地图分割网络预测语义地图,以平均交并比(mIoU)衡量性能,高mIoU表明场景结构布局与语义利于准确BEV重建。
- 3D目标检测(3D Object Detection):测试生成数据是否保留感知交通参与者所需的几何线索。将预训练BEVFusion应用于生成帧,采用nuScenes检测分数(NDS)评估,高分数意味着生成场景支持更精准的3D目标定位。
- 3D目标跟踪(3D Object Tracking):评估生成视频中目标运动一致性与身份信息保留能力。利用预训练3D跟踪器预测3D轨迹,以nuScenes协议下的平均多目标跟踪精度(AMOTA)衡量,高AMOTA反映3D场景中运动目标的时间动态稳定性与数据关联准确性。
- 占用预测(Occupancy Prediction):采用RayIoU指标,对比相机光线上的语义一致性(而非体素重叠),评估生成场景支持3D几何与语义重建的准确性。高RayIoU表明生成视频保留了下游场景理解所需的3D结构完整性,实现深度一致的占用估计。
人类偏好
该维度通过大规模人类标注,评估生成视频在视觉真实性、物理连贯性与行为安全性上与人类判断的对齐程度,各子维度采用1-10分评分制,分数越高表明人类感知保真度越强。
- 世界真实感(World Realism):从整体场景连贯性、车辆几何与运动稳定性、行人身体比例与行走一致性三个子维度,评估纹理、光照、运动与真实驾驶画面的贴近程度,高分数意味着场景在视觉上与真实录制难以区分。
- 物理合理性(Physical Plausibility):聚焦运动连续性、遮挡顺序正确性、目标接触稳定性与光照时间一致性,评估场景是否遵循直观物理定律与因果关系。存在瞬移、穿透、反射不一致等现象的场景得分较低,而动态过程平滑、物理连贯的场景得分更高。
- 3D与4D一致性(3D & 4D Consistency):评估重建3D结构的时间稳定性,以及目标相对位置、姿态与轨迹的持续性,高一致性表明生成视频形成符合真实世界动态的合理4D场景,维持空间-时间维度的几何与外观连贯性。
- 行为安全性(Behavioral Safety):评估交通参与者行为的可预测性与安全性,聚焦车辆、行人与环境线索的短期交互,如交通信号遵守、碰撞规避、车道保持等。突发碰撞、违规穿越等不安全行为会降低分数,平滑、合法、可控的运动对应更高分数,体现行为的可信度与合规性。
人类标注与评估代理
标注流程
为给基准建立可靠的人类监督,我们设计了结构化多阶段标注流程。10名标注员分为两组,独立对3.5节定义的四个维度进行全视频评分;当两组评分存在分歧时,重新评估样本以确保一致性。标注界面同步展示四个视图:生成视频、语义掩码、深度图与3D边界框(如图3所示)。所有标注员均获得含评分等级示例的详细文档,以提升一致性与领域理解。平均每条标注耗时约2分8秒,总耗时超930小时。更多实现细节、文档与示例见附录。
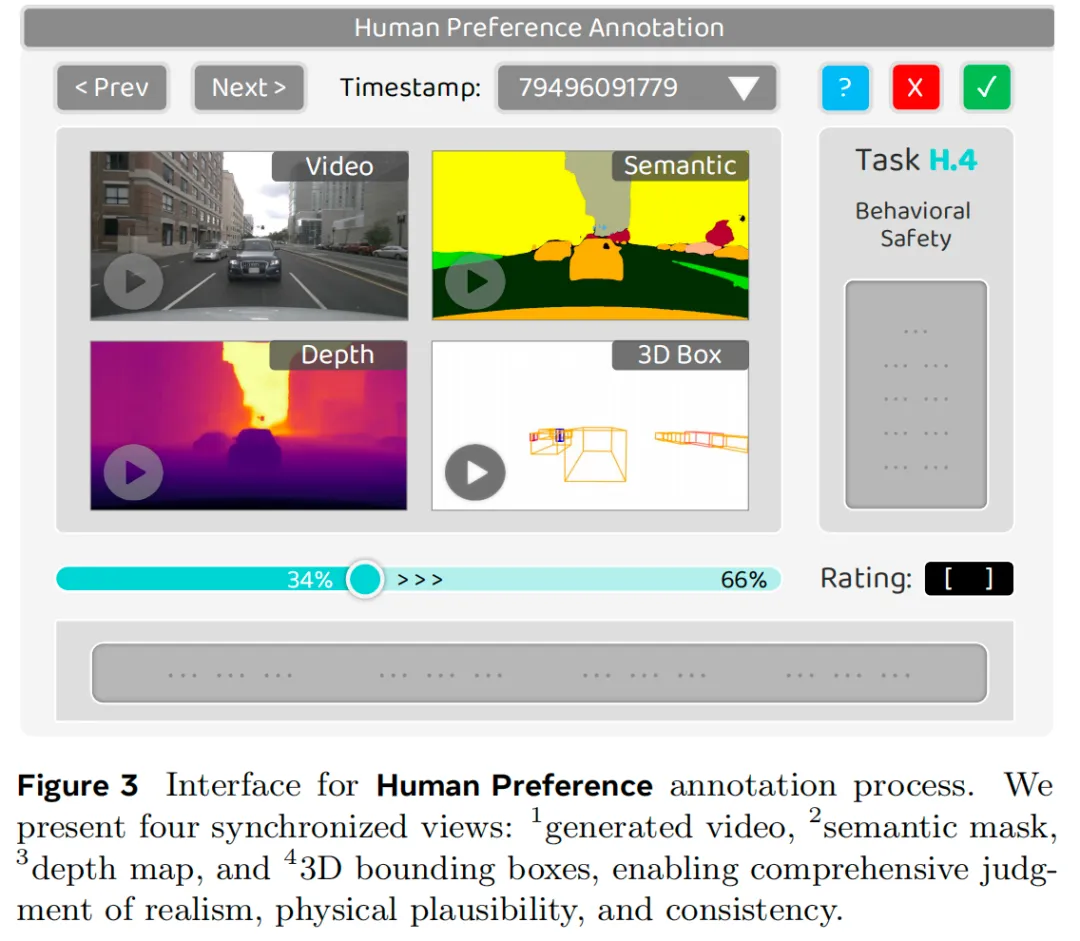
WorldLens-26K:多样化偏好数据集
为衔接人类判断与自动化评估,我们构建了包含26,808条生成视频评分记录的大规模人类标注数据集。每条记录均含离散分数与标注员撰写的简洁文本说明,同时涵盖感知质量的多个互补维度,均衡覆盖世界模型真实感的空间、时间与行为层面。如图4所示,文本说明的词云与对应目标维度高度契合,证实标注标签的有效性与可解释性。我们期望WorldLens-26K成为训练评估代理、构建人类对齐奖励函数或优势函数的基础资源,助力生成式世界模型的强化微调。
WorldLens-Agent:基于人类反馈的监督微调评估器
生成世界的评估依赖物理合理性等人类中心准则与感知真实感等主观偏好,这些是量化指标难以捕捉的,因此亟需人类对齐的评估工具。为此,我们提出WorldLens-Agent,一种基于WorldLens-26K训练的视觉-语言评论代理。通过LoRA-based监督微调,将人类的感知与物理判断蒸馏到Qwen3-VL-8B模型中,使其内化真实感、合理性、行为安全性等评估准则,提供一致、人类对齐的评估结果,为未来世界模型基准测试提供可扩展的偏好基准。更多分布外视频的自动评分与说明生成示例,见图8及附录。
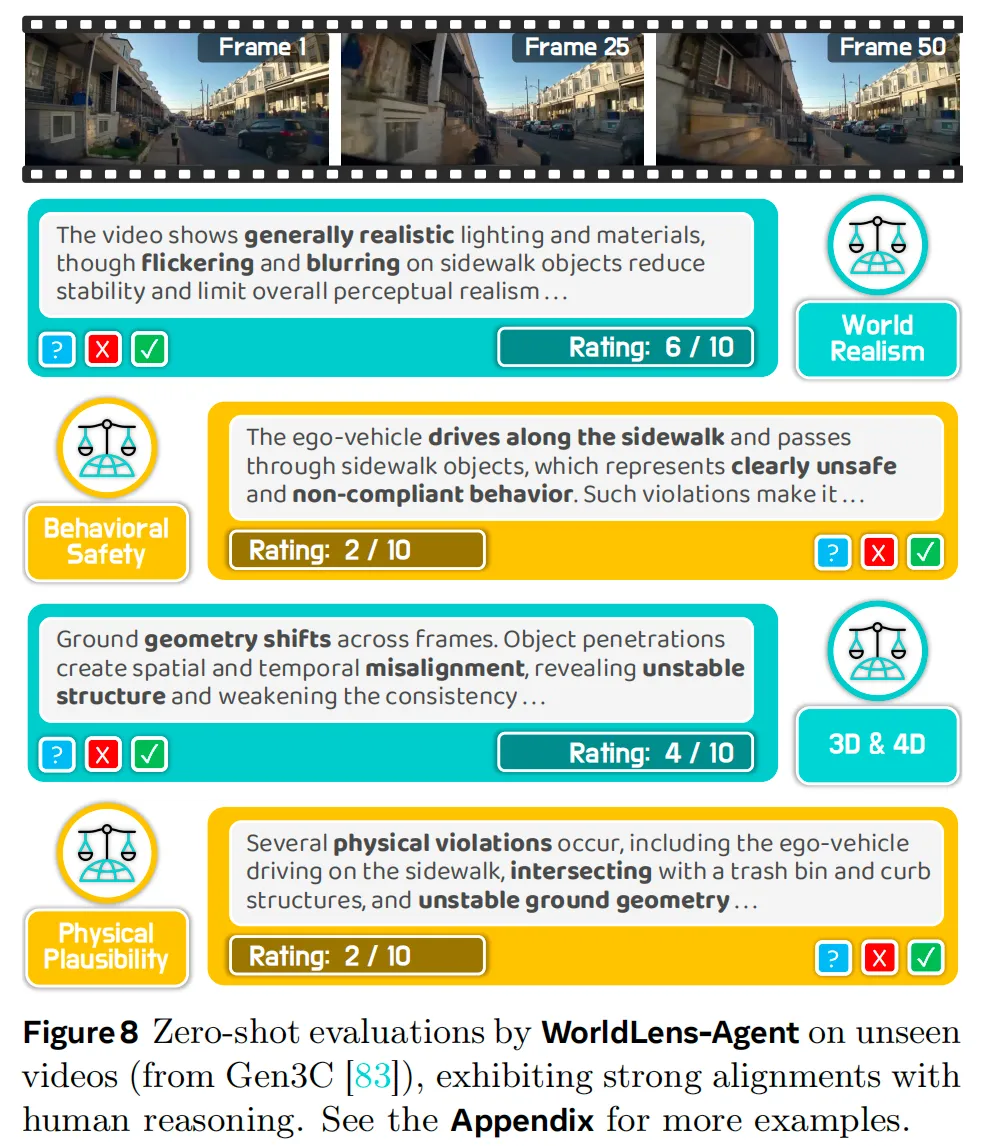
四、实验结果分析
我们在WorldLens定义的所有五个维度上,对代表性驾驶世界模型进行了全面评估,涵盖定量评估与人类参与评估。
各维度评估
生成质量:如表1所示,所有现有模型的表现均显著低于“经验最大值”,表明驾驶世界模型的视觉与时间真实感仍有巨大提升空间。尽管DiST-4D实现了最低的感知差异度,但在目标保真度和跨视角一致性上不如OpenDWM,这表明仅靠感知指标不足以评估物理连贯的场景生成能力。OpenDWM的整体表现最为均衡,这很大程度上得益于大规模多数据集训练;而MagicDrive、X-Scene等单数据集模型在所有指标上的泛化能力有限。值得注意的是,DiST-4D、DriveDreamer-2等基于条件输入的方法通过利用真实帧,将深度一致性和跨视角一致性提升了20%-30%,部分克服了上述局限性。这些结果表明,对于实现可靠、时间一致的世界建模,数据集多样性和条件输入策略比感知保真度更为关键。
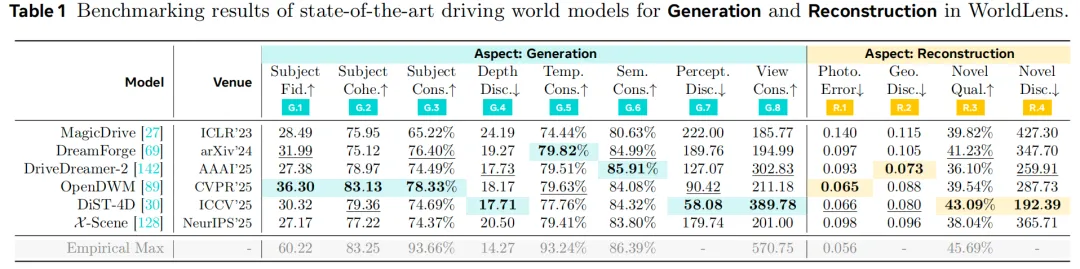
重建性能:我们通过将生成视频重建为4D高斯场来评估时空3D连贯性,其中“漂浮物”和几何不稳定性直接反映时间不一致性。如表1所示,MagicDrive的重建性能最差,其光度误差和几何差异度均比OpenDWM高出两倍以上。DreamForge也存在类似缺陷,表明其3D一致性有限。相比之下,OpenDWM和DiST-4D的重建效果显著更优,将光度误差和几何误差降低了约55%,生成的序列结构更连贯。DiST-4D的新视角质量表现最佳,这可能得益于其RGB-D生成设计,能更好地长期保留深度信息。如图5所示,MagicDrive和DreamForge在侧视视角下会产生大量漂浮物和畸变,而OpenDWM和DiST-4D则能保持清晰、稳定的几何结构。综上,时间稳定性和几何一致性是生成物理真实、可重建世界模型的关键要素。
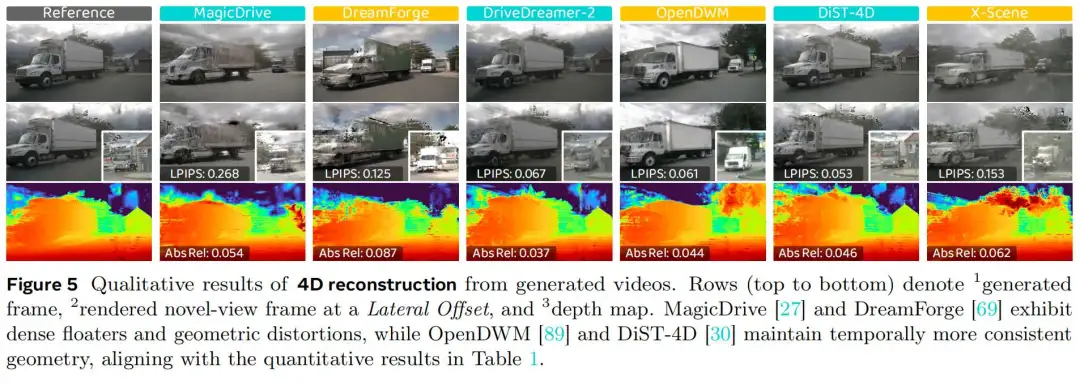
指令跟随:如表2所示,我们通过闭环仿真评估合成环境的功能可行性——预训练规划器在各模型生成的“世界”中运行。时间连贯性被证明至关重要:规划代理依赖多帧历史和自车状态线索,时间稳定性较弱的模型路线完成率最低。一个显著发现是开环与闭环性能存在巨大差距:尽管所有方法在位移误差和PDMS上的开环表现良好,但在闭环条件下均表现不佳,路线完成率极低。频繁的失败(如碰撞、偏离车道)表明,当前合成数据仍无法在高级控制任务中替代真实世界数据。这一结果凸显核心洞见:提升生成式世界模型的物理真实性和因果真实性,对于有效部署闭环系统不可或缺。
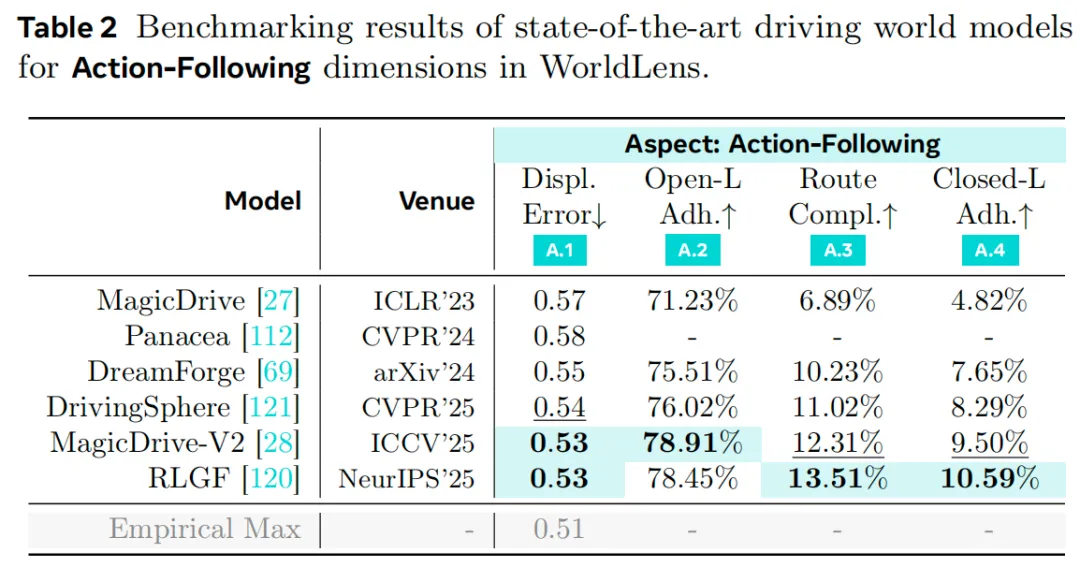
下游任务适配性:该维度直接反映世界模型超越视觉真实感的实际效用。如表3和图1所示,DiST-4D在所有任务(地图分割、3D检测、跟踪)中均大幅领先,平均比第二名模型高出30%-40%。DriveDreamer-2排名第二,尤其在占用预测任务中表现突出,彰显了时间条件输入对连贯视频生成的优势。相比之下,MagicDrive在所有任务中表现最差,证实其时空连贯性有限。有趣的是,尽管OpenDWM的感知质量出色,但在检测(21.9%)和跟踪(6.9%)任务中表现不佳,这表明大规模多域训练可能会阻碍模型对特定数据集分布的适配。图6的定性评估进一步验证了上述观察。综上,时间条件输入和数据集对齐对于提升实际应用中的任务特异性效果至关重要。
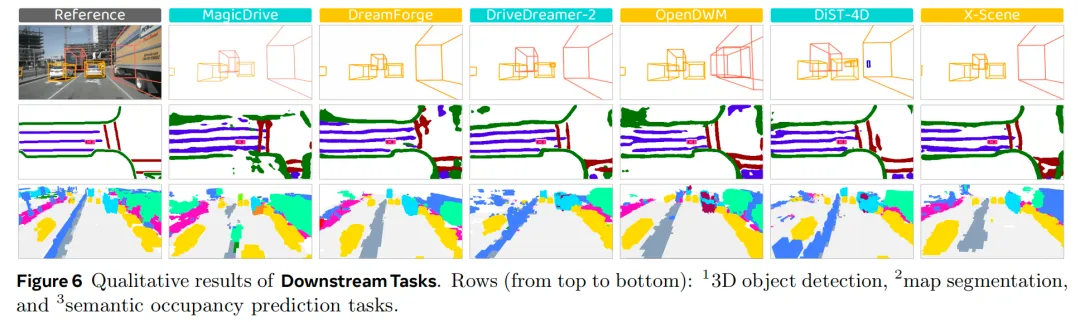
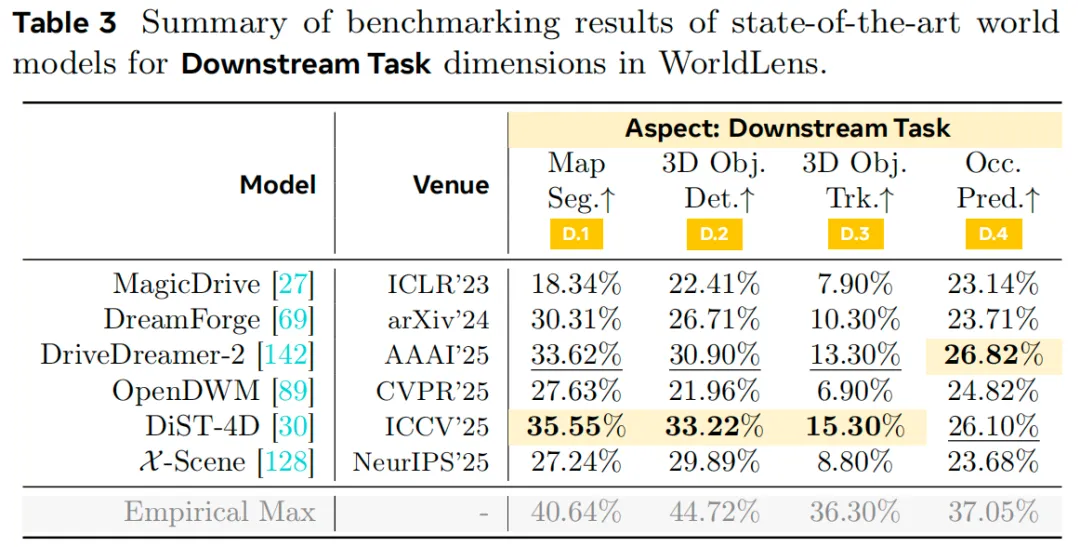
人类偏好对齐
主观评估:由于定量指标无法捕捉世界建模的所有方面,我们针对世界真实感、物理合理性、3D与4D一致性及行为安全性开展了人类评估。如图7所示,所有模型的整体得分均较为温和(10分制中的2到3分),表明当前世界模型与人类级真实感仍有较大差距。DiST-4D在所有维度上的得分最为均衡,在物理合理性(2.58分)和行为安全性(2.59分)上领先;OpenDWM的真实感得分最高(2.76分),但物理一致性略低;MagicDrive的整体排名最低,反映其连贯性较差。值得注意的是,世界真实感与一致性得分高度相关,表明人类感知的真实感与几何及时间稳定性紧密耦合。综上,这些结果凸显了人类参与评估的必要性——它能补充定量基准的不足,为世界模型质量提供全面评估。
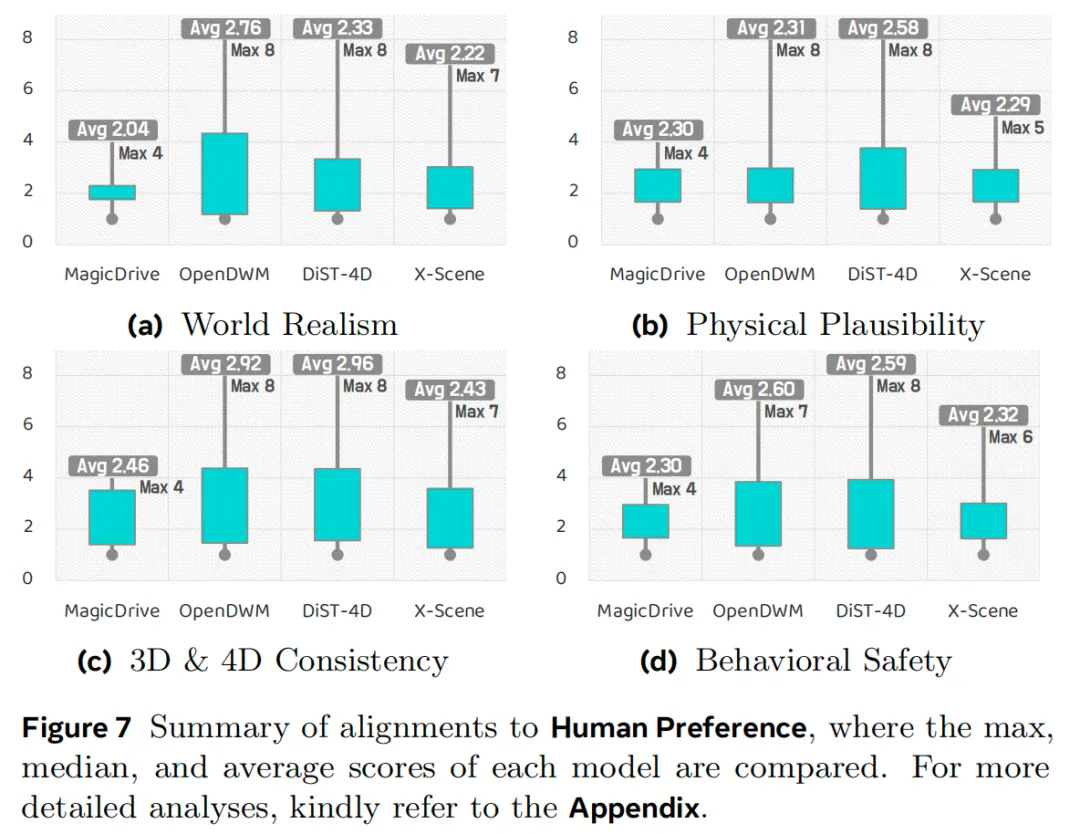
人机代理对齐:为评估自动评估器WorldLens-Agent的泛化能力,我们在Gen3C生成的视频上进行了零样本测试(如图8所示)。该代理的预测得分与人类标注在所有评估维度上均表现出强对齐性,证实其能够捕捉细微的主观偏好。除数值一致性外,代理生成的文本说明与人类标注者的表述高度相似,既实现了得分层面的一致性,又保证了解释层面的连贯性。这些结果表明,利用人类标注的感知数据训练评估代理,能够为未来世界模型基准测试提供可扩展、可解释且可复现的评估工具。
Insight与讨论
全面评估至关重要:没有任何单一世界模型能在所有方面表现最优(图1):DiST-4D在几何和新视角指标上表现最佳,OpenDWM在光度保真度上领先,DriveDreamer-2的深度准确性最高。这种差异表明,视觉真实感、几何一致性和下游可用性是互补而非可替代的,凸显了多维度基准测试的必要性。
感知质量不代表可用性:感知得分优异的模型(如OpenDWM)可能在下游任务中表现不佳。尽管OpenDWM的视觉保真度出色,但其3D检测得分比DiST-4D低30%,这表明大规模多域训练可能阻碍模型对任务特异性分布的适配。因此,对于有效下游应用而言,生成数据与目标域的对齐比感知真实感更为关键。
几何感知赋能物理连贯性:DiST-4D在重建和新视角任务中的优异表现,源于其RGB-D生成设计和解耦时空扩散架构——两者共同建模时间预测和空间合成。这表明,几何感知监督能显著提升生成场景的物理真实性和可重建性。
外观与几何的联合优化:光度指标(LPIPS/PSNR)与几何指标(AbsRel)之间的差异表明,当前模型常将纹理和结构视为独立优化目标:几何感知监督能稳定深度但会模糊细节,而外观驱动训练能锐化纹理却会破坏空间一致性。通过时空正则化联合优化外观与几何的统一框架,才能实现连贯的重建效果。
未来世界模型设计指南:基于实验结果,我们提炼出物理接地世界模型的核心设计原则:1)将几何作为核心优化目标:显式深度预测或监督能同时提升重建保真度和下游感知性能;2)稳定前景动态:一致的几何结构是可靠运动解纠缠的关键;3)确保自回归鲁棒性:强化跨视角和时间一致性以减少漂移和结构伪影,同时通过自强制训练或流式扩散提升闭环生成中对累积误差的鲁棒性——这对长时程稳定性至关重要。综上,稳健的世界模型源于外观、几何与任务适配性的联合优化,需从视觉真实感向物理可靠性进阶。
五、结论
我们提出了WorldLens——一款全方位基准,从感知、几何、功能和人类对齐四个视角评估生成式世界模型。通过五个互补评估维度和二十余项标准化指标,该基准提供了衡量物理真实感与感知真实感的统一协议。结合WorldLens-26K数据集和WorldLens-Agent智能评估器,我们的框架为未来世界模型基准测试建立了可扩展、可解释的基础——引导研究向“不仅看起来真实,更能表现得合理”的系统迈进。
....
#SparseWorld-TC
理想一篇OCC世界模型:全新轨迹条件稀疏占用世界模型
端到端自动驾驶预测技术正迎来革命性突破!传统方法依赖鸟瞰图(BEV)表示或离散令牌化,这些技术虽然在一定程度上推动了行业发展,但本质上限制了模型对复杂时空依赖的捕捉能力。特别是在长时预测和动态场景中,如何平衡精度与效率成为制约技术落地的核心挑战。如果仅靠VAE编码或BEV先验,往往难以兼顾细粒度细节和实时性需求。近年来,基于注意力的Transformer架构在语言和视觉领域的成功,为自动驾驶世界模型提供了全新思路——能否直接利用稀疏表示绕过中间表示,实现更灵活的时空建模?这是一个值得深入探索的方向。
现有4D占用预测方法大多面临两大本质局限:一是过度依赖VAE等离散令牌化技术,导致表征容量受限,细节信息丢失;二是BEV表示引入的显式几何先验,虽然简化了问题形式化,但严重限制了特征交互的灵活性。例如,OccWorld和RenderWorld采用VQ-VAE编码场景,虽然简化了生成过程,却牺牲了连续空间的细节表达能力;而基于BEV的方法如TPVFormer虽然在某些任务上有效,但难以处理长时预测中的多模态演化问题。针对这些行业痛点,同济大学与理想汽车联合团队经过深入研究,提出了SparseWorld-TC——一种全新的轨迹条件稀疏占用世界模型。该模型创新性地摒弃了传统BEV和离散令牌,直接通过稀疏查询和注意力机制实现端到端的4D占用预测,在nuScenes基准上实现了多项技术突破!
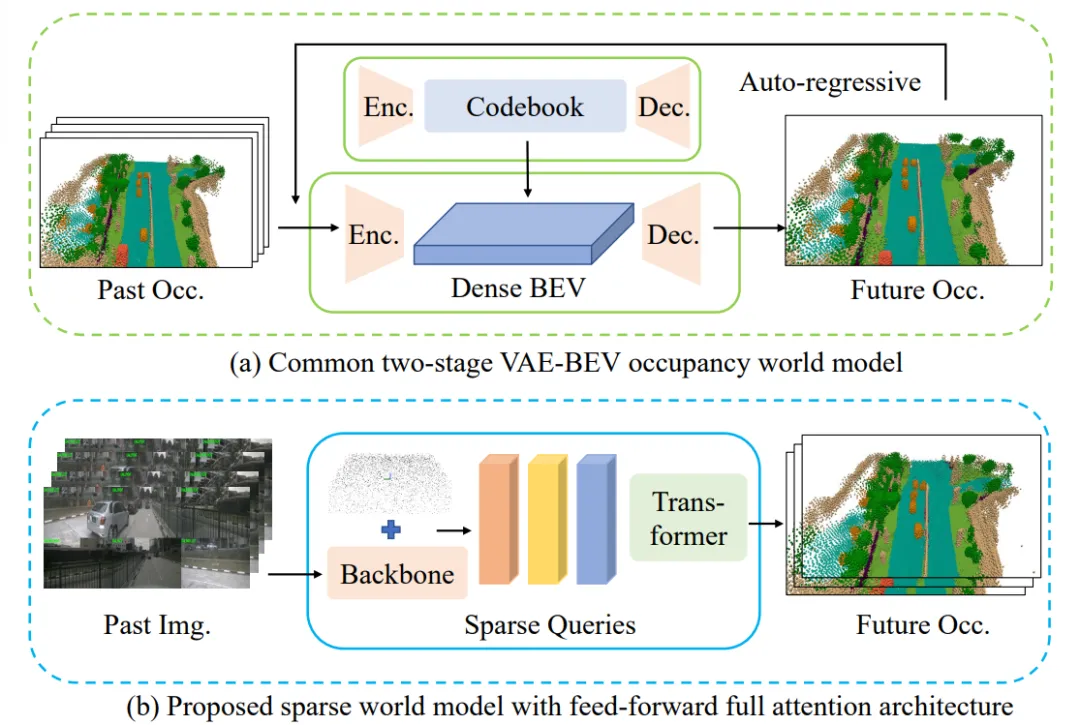
- 论文链接:https://arxiv.org/pdf/2511.22039
- Github链接:https://github.com/MrPicklesGG/SparseWorld-TC
一、自动驾驶世界模型的技术演进与核心挑战
1.1 世界模型的基本概念与发展历程
世界模型是理解环境动态的核心框架,对于在物理世界中运行的AI系统至关重要。从控制理论中的状态空间模型到现代深度学习方法,世界模型经历了漫长的发展历程。在自动驾驶领域,世界模型需要具备预测物理环境演化的能力,这被认为是实现真正智能驾驶的核心技术之一。
早期的方法主要基于物理规则和简单传感器模型,随着深度学习的发展,数据驱动的方法逐渐成为主流。近年来,基于占用的世界模型因其在自动驾驶和机器人领域的直接适用性而备受关注。这类模型能够生成时间一致的传感器观测,为后续的决策规划提供重要支持。
1.2 当前技术路线的局限性分析
现有的世界模型方法主要存在三个层次的局限性。在表示层面,离散化表示(如VQ-VAE)虽然降低了建模复杂度,但不可避免地导致信息损失。在结构层面,BEV表示引入了过强的几何先验,限制了模型对复杂场景的适应能力。在生成范式层面,自回归方法虽然能捕获时序依赖,但存在误差累积问题,而扩散方法虽然生成质量高,但计算成本较大。
具体到4D占用预测任务,这些局限性表现得更为明显。由于驾驶场景的复杂性和安全性要求,模型需要在有限的计算资源下实现准确的长期预测。传统方法在平衡这一矛盾时往往捉襟见肘,亟需新的技术路线突破。
1.3 稀疏表示的技术优势与可行性
稀疏表示作为一种新兴的技术路线,为解决上述问题提供了新的思路。与密集的体素网格不同,稀疏表示只对场景中实际存在的区域进行建模,这显著降低了计算复杂度。同时,稀疏表示避免了离散化带来的信息损失,能够更好地保持场景的连续特性。
从理论角度看,驾驶场景本质上是稀疏的——大部分空间是空闲的,只有少部分区域存在物体。这一特性为稀疏表示的应用提供了天然优势。近年来,随着3D稀疏感知模型的发展,稀疏表示在目标检测、分割等任务中已展现出强大潜力,为其在世界模型中的应用奠定了技术基础。
二、SparseWorld-TC的核心创新:架构设计与技术细节
2.1 整体架构设计理念
SparseWorld-TC的创新之处在于其纯注意力驱动的架构设计。与依赖手工设计令牌化器或中间表示的传统方法不同,该模型采用端到端的方式直接对占用世界进行建模。场景被表示为一组可学习的特征嵌入,它们之间的交互通过注意力机制进行中介。
这种设计理念的突破性在于:首先,它避免了离散令牌化带来的表示能力限制;其次,它绕过了BEV表示的几何约束,使模型能够更灵活地捕获时空特征;最后,采用类似VGGT的前馈架构,能够在单次前向传播中预测未来占用,显著提升了推理效率。
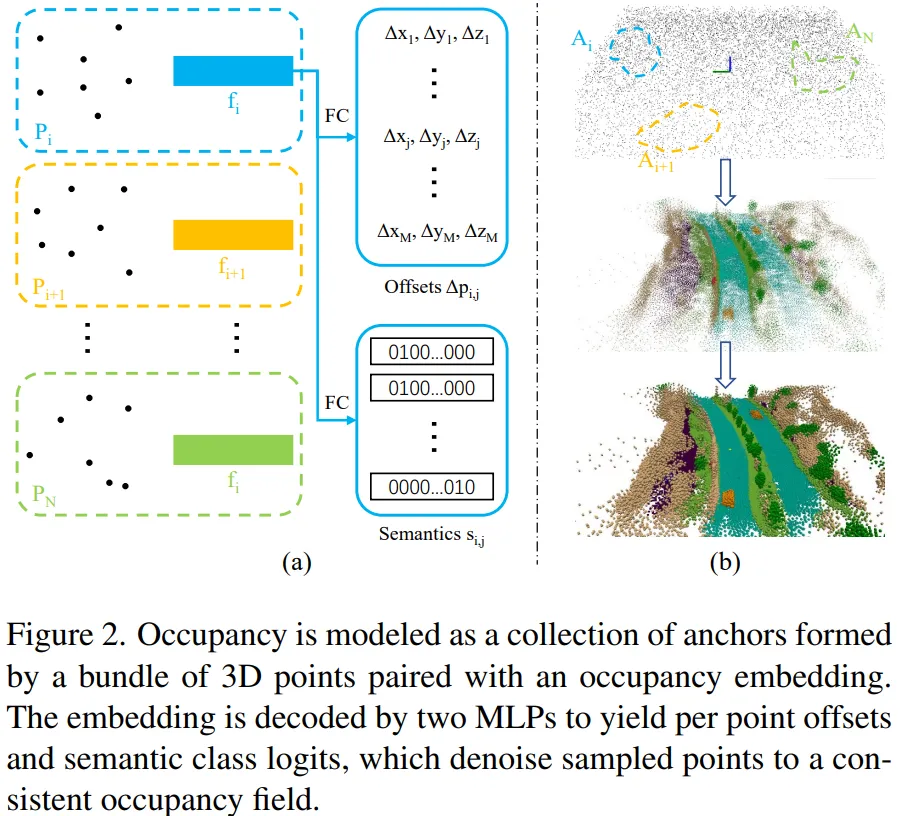
2.2 稀疏占用表示的具体实现
在技术实现层面,SparseWorld-TC采用了一种基于锚点的稀疏占用表示方法。每个锚点由一组随机初始化的3D点和相关的特征向量组成。具体而言,对于单帧占用表示,我们定义:
其中表示锚点的个点,是对应的特征向量。特征向量为每个点预测偏移量和语义标签(C维类别概率向量)。
这种表示的初始化过程经过精心设计:中心点在空间内均匀分布,每个点集在中心点周围随机初始化,特征向量初始化为零。这种设计确保了表示的全面性和灵活性。
2.3 轨迹表示与条件机制
轨迹条件机制是SparseWorld-TC的另一大创新。在自动驾驶中,自车的规划轨迹为预测世界模型提供了重要的条件信号。我们将未来轨迹τ参数化为离散状态序列:
每个状态封装了在时间t的ego运动状态。在我们的实现中,每个状态包含车辆的平面位置(x,y)、航向角θ和时间戳t本身,为条件世界模型提供了紧凑而富有表现力的表示。
世界模型F的数学形式化表示为:
其中表示所有未来帧的初始状态表示,代表过去个时间步的传感器观测历史,τ是给定的轨迹。这一公式化使模型能够集成过去上下文和未来意图,以生成物理一致的未来场景。
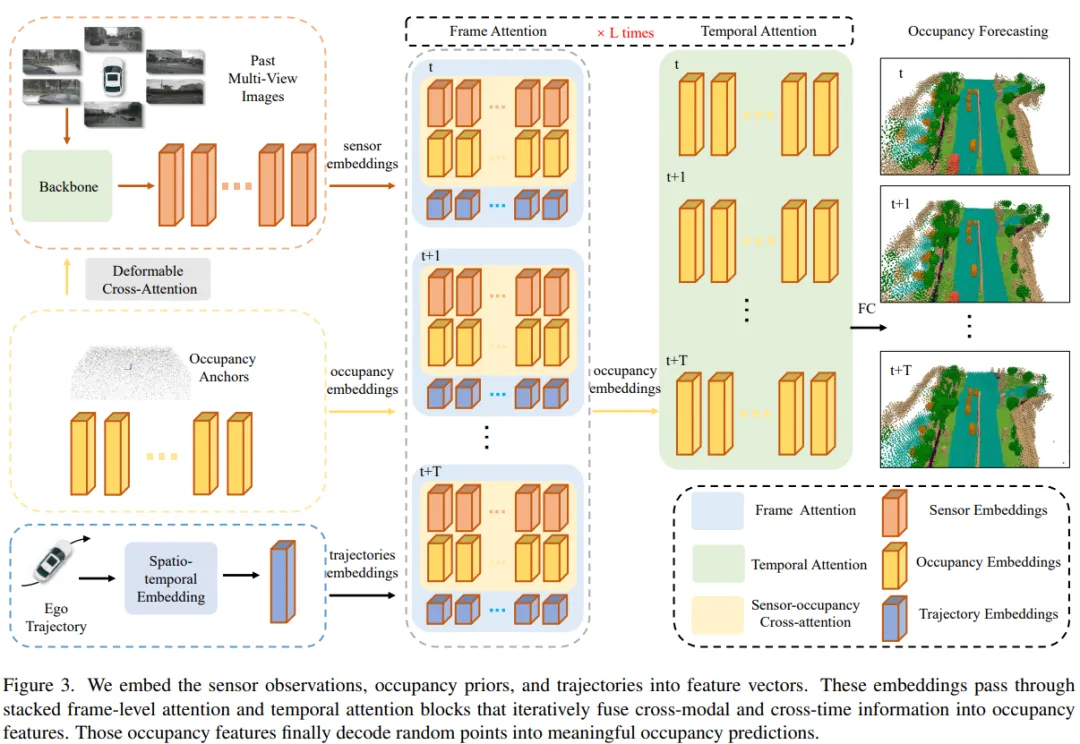
2.4 时空融合架构的详细设计
时空融合架构是SparseWorld-TC的核心技术组成部分,其设计充分考虑了多模态数据的有效整合。整个架构基于纯注意力机制,实现了传感器观测、占用先验和轨迹信息的高效融合。
2.4.1 轨迹时空嵌入
轨迹表示包含每个路径点的位置和时间戳。为了保持灵活性,我们不假设路径点之间的均匀时间采样,而是直接嵌入每个路径点的独立位置和时间戳,以适应各种可能的规划输出。
位置嵌入通过相对姿态变换捕获轨迹的空间特征。路径点的3D坐标首先进行相对姿态变换以进行后续融合,然后通过多层感知机(MLP)映射到目标特征维度。相对姿态变换的齐次矩阵也使用MLP映射到特征维度,最终为特征配备空间属性和ego轨迹信息。
时间嵌入使用经典的sin-cosine编码来捕获轨迹的相对时间位置关系。时空嵌入受运动感知层归一化(MLN)的启发,在位置嵌入和时间嵌入的基础上实现时空信息融合。具体设计两个线性层来隐式学习相邻帧之间的仿射变换,这一学习过程依赖于位置嵌入提供的空间属性线索和时间嵌入捕获的相对时间关系信息。
2.4.2 传感器嵌入与可变形注意力
可变形注意力在3D稀疏感知中得到广泛应用。在我们的架构中,每个锚点集的中心作为可变形注意力操作中的查询点。我们计算锚点集沿x、y、z方向的均值和标准差作为采样偏移的基础。
每个中心使用相机内参、外参和ego姿态投影到骨干网络(如ResNet或ViT)的多尺度图像特征图中。如果一个查询由于视野重叠投影到多个视图,我们通过对所有m个视图的采样特征进行平均来聚合。每个锚点中心从过去的T'帧收集特征。为了编码时间上下文,我们添加一个由全连接层处理的正弦时间嵌入以提供运动线索。
2.4.3 完全注意力融合机制
完全注意力融合机制是SparseWorld-TC的最核心创新。如公式4所示,世界模型可以重新表述为:
这一公式提供了我们世界模型的紧凑表述:所有相关特征通过标准注意力直接交互。我们采用前馈、纯基于注意力的Transformer架构,如图3所示。
对于每个未来帧t,占用嵌入通过交叉注意力参与过去传感器嵌入。更新后的占用特征然后通过帧级自注意力与轨迹嵌入融合。最后,时态注意力块在所有未来帧上应用自注意力,联合优化占用嵌入集合以捕获长距离时空依赖。我们堆叠帧和时态注意力模块并多次应用,逐步将随机初始化的3D锚点优化为未来T帧的准确占用预测。
2.5 训练策略与优化算法
2.5.1 随机集成策略
虽然nuScenes占用世界模型基准评估1-3秒的预测范围,但一些研究考虑更长的未来(例如长达10秒)。这促使我们设计一个灵活的模型,以适应不同的预测需求,支持在任意时间范围内甚至不同时间间隔的未来占用预测。我们通过随机集成策略实现这一目标,该策略在不改变网络架构的情况下增强了训练模型的泛化能力。
随机集成策略的具体实现如下:我们假设最大预测范围T。在训练期间,我们随机选择目标序列长度L,其中L∈{2,…,T},并使用相应的L个未来占用帧监督模型。由于没有规定固定的时间步长,场景演化完全由编码时间和位置上下文的轨迹嵌入控制。这种灵活的监督方案使模型能够适应不同的预测需求,并提高了整体性能。
2.5.2 损失函数设计
损失函数的设计直接影响了模型的性能。我们提取每个真实占用体素的中心作为目标点,并优化Chamfer距离损失 以使预测点分布与目标点对齐。该损失函数在点云处理和占用建模中被广泛采用,因为它有效测量预测点云和目标点云之间的相似性。
Chamfer距离的数学定义为:
其中。 遵循[38]的方法,匹配的目标点还提供语义标签。因此,我们使用标准焦点分类损失监督语义预测,产生整体目标函数:
这种损失设计确保了模型在几何准确性和语义一致性方面的平衡优化。
三、实验设计与评估体系
3.1 性能评估与对比分析
在自动驾驶4D占用预测领域,SparseWorld-TC通过创新的稀疏表示方法实现了突破性进展。对于评估,我们采用标准几何交并比(IoU)和语义平均交并比(mIoU)指标,评估指标的设计充分考虑了自动驾驶任务的需求。几何IoU关注占用预测的几何准确性,而语义mIoU评估类别预测的准确性。这两个指标的结合全面反映了模型在几何和语义层面的性能。
方法分类与对比分析
我们将对比方法分为两大类别进行深入分析:
基于真值占用的方法包括OccWorld-O、OccLLaMA-O等,这些方法虽然性能较高,但需要预先计算的占用真值作为输入,在实际部署中存在局限性。例如,I2-World在使用真值占用输入时达到39.73%的mIoU,但其实际应用价值受到限制。
基于摄像头输入的方法更贴近实际应用场景。在这一类别中,我们的SparseWorld-TC表现出色。特别是SparseWorld-TC-Large*版本(集成DINOv3骨干网络),在mIoU指标上达到29.89%,超越了许多基于真值占用的方法,这充分证明了我们方法的实用性和先进性。
3.2 实验设置与实现细节
3.2.1 数据集与评估协议
实验基于广泛采用的Occ3D-nuScenes基准,该数据集包含1000个驾驶场景,每个场景时长20秒,包含多传感器数据(摄像头、激光雷达等)。我们严格遵循文献[7,22,31,47,51,53]的评估协议:
- 训练/验证/测试分割:700个场景用于训练,150个用于验证,150个用于测试,确保评估的统计显著性。
- 评估指标:主要采用几何交并比(IoU)和语义平均交并比(mIoU)。
- 预测范围:短期预测(1-3秒)和长期预测(扩展至8秒),以验证模型在时序上的鲁棒性。
3.2.2 模型配置与训练策略
SparseWorld-TC的实现涵盖以下关键细节:
- 时序设置:历史观测使用过去2秒的数据(T'=2),未来预测范围T设置为3秒(短期)和8秒(长期),与现有基准[7,53]保持一致。
- 稀疏锚点配置:
- Small版本:每帧N=600个锚点,每个锚点包含M=128个3D点,计算效率优先。
- Large版本:N=4800,M=16,通过增加锚点密度提升精度。
- 骨干网络:基础版使用ResNet-50,增强版集成DINOv3-Base,以验证大规模预训练模型的可迁移性。
- 训练参数:在8个NVIDIA H20 GPU上训练70个epoch,总批次大小8,使用AdamW优化器(初始学习率2×10^{-4},余弦退火调度)。
- 损失函数:结合Chamfer距离损失()和焦点分类损失(),确保几何和语义预测的平衡优化。
四、实验结果与深度分析
4.1 主要结果与性能对比
在nuScenes基准上的评估结果显示了SparseWorld-TC的显著优势。如表1所示,我们的方法在多项指标上实现了突破性性能。
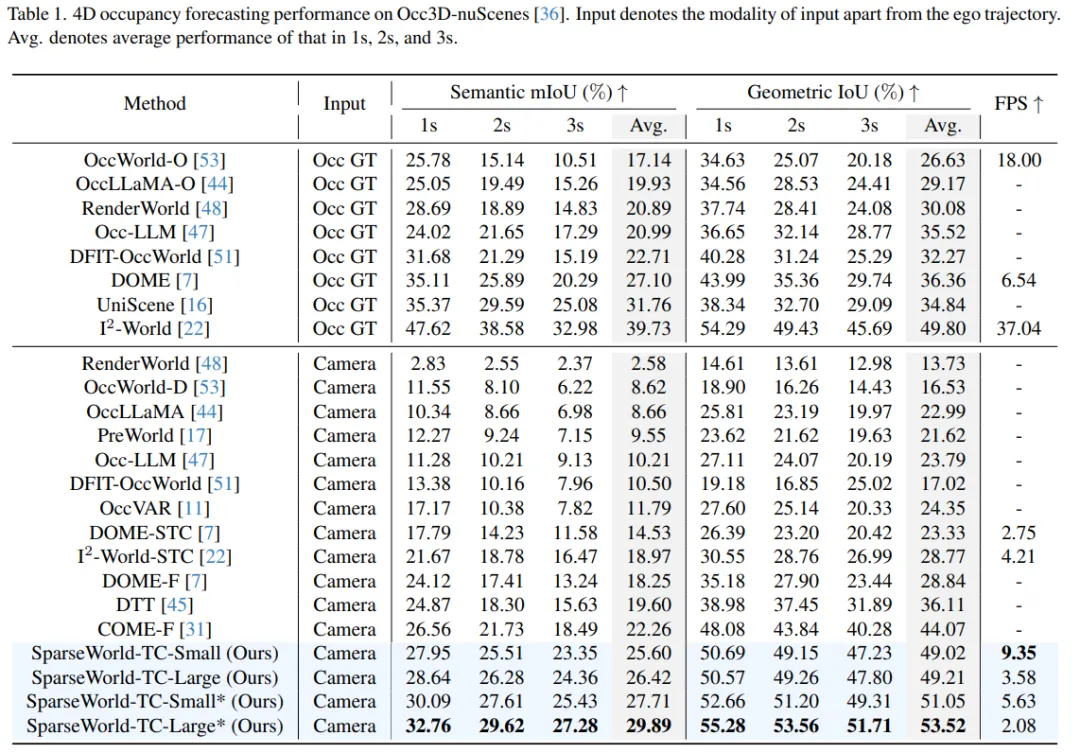
具体而言,SparseWorld-TC-Large在平均mIoU上达到26.42%,比先前最优方法COME提升18.7%;平均IoU达49.21%,提升11.7%。小规模版本在效率与性能间取得良好平衡,推理速度达9.35 FPS,适合实时应用。
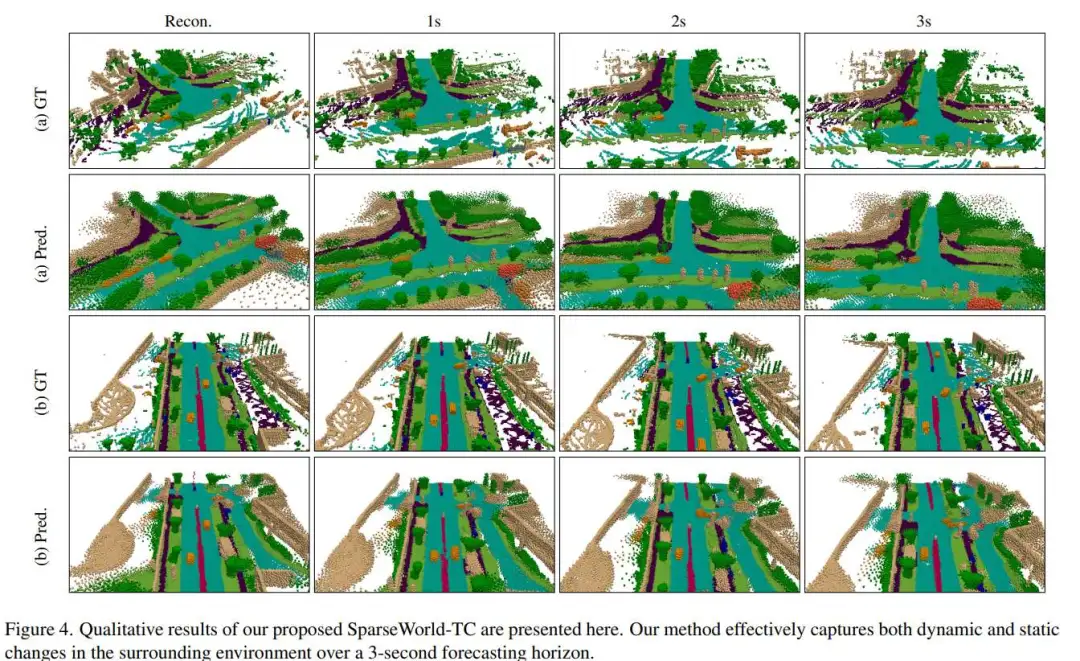
4.2 长时预测能力分析
长时预测是评估世界模型性能的关键指标。我们将预测期从3秒延长到8秒,结果如表2所示,我们的方法在长时预测任务中表现出色。
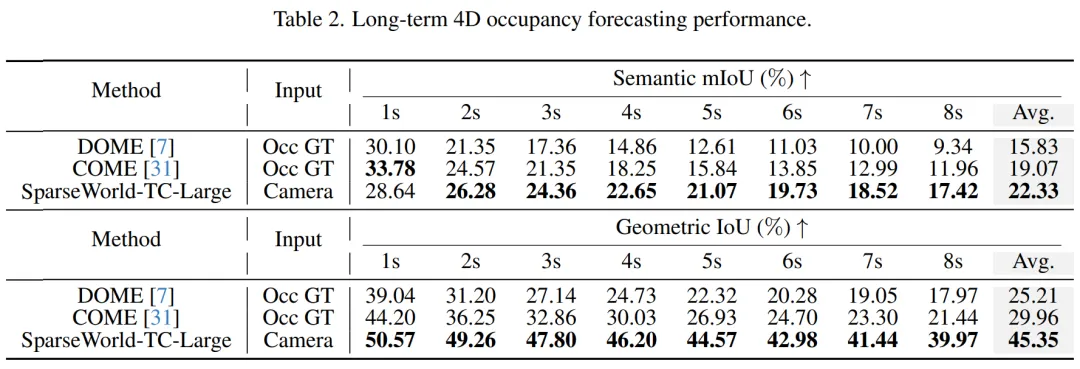
SparseWorld-TC-Large在8秒预测任务中,平均mIoU和IoU分别达到22.33%和45.35%,显著优于对比方法。特别是在4秒后的预测中,性能衰减明显慢于其他方法,这证明了我们方法在长时预测中的稳定性。
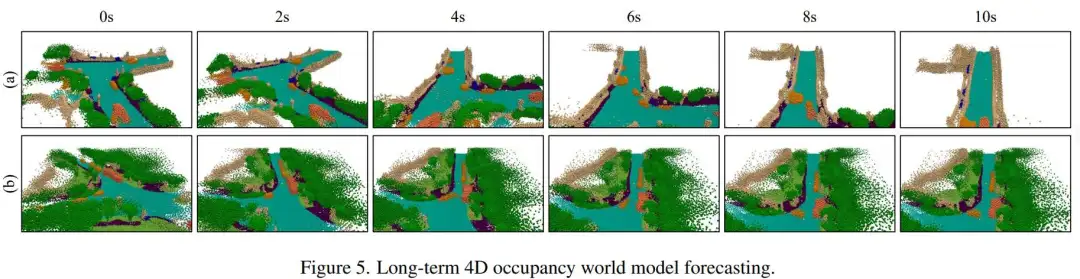
4.3 基于轨迹条件的预测
在基于轨迹条件的未来占据预测方面,我们提出的SparseWorld-TC同样具有出色的表现。
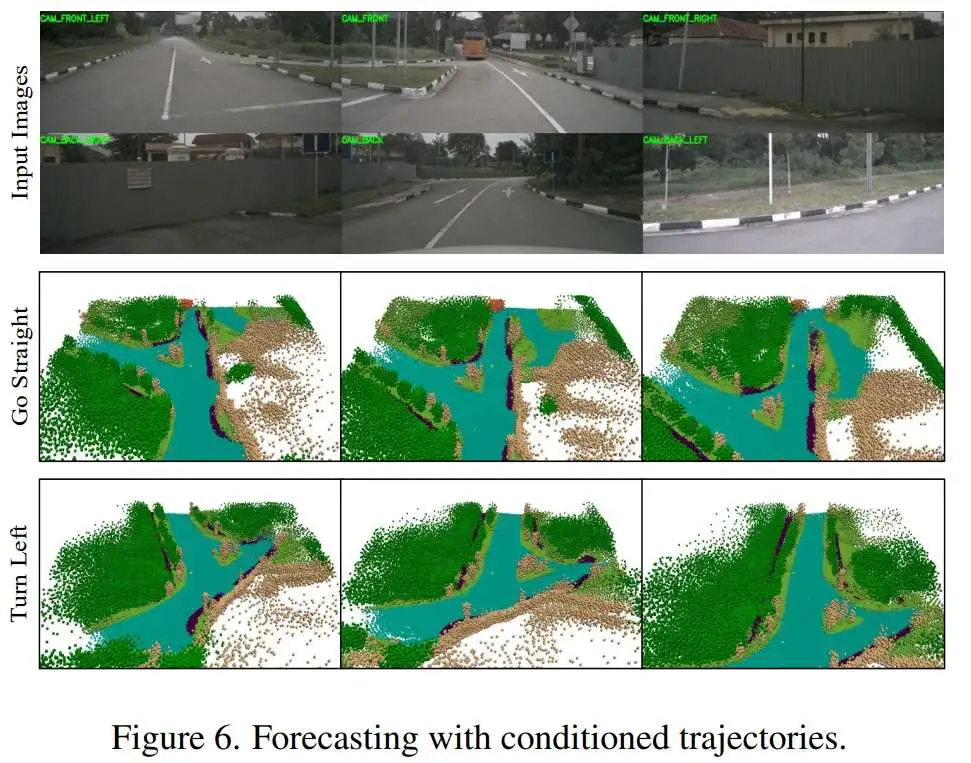
如图6所示的分岔路口,我们可视化了直行和左转两种不同轨迹条件下的占据预测结果,SparseWorld-TC在保持场景几何信息的时空一致性的同时,精确预测场景沿给定轨迹的演化。
五、结论
SparseWorld-TC的研究工作通过引入轨迹条件稀疏占用世界模型,为端到端自动驾驶预测任务提供了创新性解决方案。本论文的核心贡献在于成功设计了一种纯注意力驱动的架构,彻底摒弃了传统BEV表示和离散令牌化的限制,实现了更灵活高效的时空建模。实验结果表明,该方法在nuScenes基准测试中取得了突破性性能,特别是在长时预测任务中展现出了卓越的稳定性与准确性。
六、扩展应用:前馈高斯预测与传感器级生成
SparseWorld-TC的架构设计不仅限于占用预测,还具备扩展到传感器级观测生成的潜力。我们进一步探索了模型在前馈高斯预测方面的应用,这一扩展为自监督训练和场景重建提供了新的可能性。
前馈高斯预测的技术实现
受前馈高斯方法[29,30,35]的启发,我们在原始模型基础上集成了额外的MLP解码器,用于从潜在特征直接生成高斯参数。具体实现包括以下几个关键组件:
高斯参数解码网络:在原有的占用解码基础上,我们增加了专门的MLP分支,用于预测3D高斯分布的参数。 这些参数包括:
- 中心位置偏移量(Δx,Δy,Δz)
- 协方差矩阵参数(旋转和缩放因子)
- 颜色特征和透明度值
微分渲染机制:利用3D高斯溅射(3DGS)技术的可微分渲染器,将预测的高斯参数转换为前视图图像。这一过程支持端到端的梯度传播,使得模型能够通过比较渲染结果与真实图像来优化参数预测。
训练过程中,我们计算渲染图像与真实图像之间的L1损失:
其中H和W分别表示图像的高度和宽度。
重建与预测结果可视化
在训练阶段,模型展现了出色的重建能力。如图7所示,通过高斯溅射技术,SparseWorld-TC能够从稀疏图像特征生成高质量的前视图重建结果。这一能力不仅验证了高斯表示的有效性,也为自监督训练奠定了基础。
更重要的是,模型在未来的传感器观测预测方面表现出强大潜力。如图8所示,在验证集上的未来观测预测结果显示了良好的时间一致性和视觉质量。
技术优势与应用前景
这一扩展工作带来了几个重要优势:
- 自监督学习能力:通过可微分渲染,模型可以实现自监督训练,减少对大量标注数据的依赖。这在实际应用场景中具有重要意义,因为获取精确的3D标注通常成本高昂。
- 多模态输出支持:高斯表示天然支持多种输出模态,包括深度图、语义分割图等。这为下游任务提供了丰富的环境理解信息。
- 实时性能潜力:3D高斯溅射技术以其高效的渲染速度著称,结合SparseWorld-TC的前馈架构,整个系统具备实现实时预测的潜力。
在实际应用方面,这一技术可以用于:
- 自动驾驶仿真:生成逼真的驾驶场景用于算法测试和验证
- 预测性规划:为规划模块提供未来场景的视觉预览,支持更安全的决策制定
- 数据增强:在训练过程中生成额外的训练样本,提升模型的泛化能力
与其他扩展的协同效应
前馈高斯预测与轨迹条件生成形成了良好的互补关系。通过结合轨迹条件机制,模型能够根据不同的未来路径生成对应的传感器观测,为"what-if"分析提供了强大工具。例如,在分叉路口场景中,模型可以分别生成直行和转弯对应的未来观测,帮助系统评估不同决策的后果。
此外,这一扩展还与长期预测能力紧密结合。在8-10秒的预测范围内,高斯表示能够更好地保持场景的视觉一致性,避免传统体素方法中常见的模糊或失真问题。
局限性与未来方向
尽管前馈高斯预测展现了良好潜力,但仍存在一些挑战需要进一步研究:
- 计算复杂度:虽然3DGS渲染效率较高,但高斯参数预测和优化过程仍需要相当的计算资源。未来工作需要探索更高效的参数化方法。
- 动态建模:当前方法对高度动态场景的建模能力仍有提升空间,特别是在处理快速移动物体或复杂交互时。
- 多传感器融合:如何有效融合摄像头、激光雷达等多种传感器数据,进一步提升预测的准确性和鲁棒性,是未来的重要研究方向。
总体而言,前馈高斯预测的引入显著扩展了SparseWorld-TC的应用范围,为自动驾驶环境理解提供了更加全面和实用的解决方案。这一技术路线的发展有望推动世界模型从传统的几何预测向更加综合的场景理解和生成方向发展。
....
#中国真正L4只有3家......
文远知行韩旭:~
时隔六年再次来到量子位MEET智能未来大会,韩旭已不再是那个需要向投资人证明“自动驾驶不是骗局”的创业者。
他的治下,文远知行现在是美股港股双料上市的“Robotaxi第一股”。
但与量子位总编辑李根的对话中,韩旭对创业8年的评价却出人意料:
我现在没空看成绩单。
他在忙什么?在忙500万年薪广招英才、在忙Robotaxi海外跑马圈地、在忙一段式端到端量产的“搏二兔”:
时过境迁,今天有能力的玩家,确实可以搏二兔了。
但对同样“搏二兔”大搞Robotaxi的特斯拉,他却给出了近乎“打脸”的预言;
相似的,行业内“L4公司”遍地开花的现状,韩旭又毫不迟疑划出了不容模糊的技术壁垒,并直言:
“国内真正能纯无人运营的只有三家”。
从L4到L2++,这位亲历行业从“骗局论”走到规模化落地的自动驾驶一线“老兵”,在独家对话中给出了当下自动驾驶的一线洞察,以及未来竞争的生死线判断。
从“骗子公司”到无人化规模落地
时至今日,文远知行在全球已经部署了超过1600辆自动驾驶车辆,其中Robotaxi的数量超过750辆。
这个数字相比一年前文远美股IPO时,增长至少30%左右,这还仅仅是文远视角的“加速度”。
放眼整个L4赛道,萝卜快跑11月公布的所有Robotaxi的最新周订单数是25万单,小马智行Q3财报显示,其Robotaxi车队数为961台,广州单台车日均订单量达到23单。
北美“一哥”Waymo,刚刚“被”披露的数据是车队2500辆、每分钟就能完成45单。
至于落地广度,文远知行则是整个L4赛道最早敏锐意识到海外需求和机遇的玩家,并且迅速付诸行动,率先在11个国家、30多座城市部署Robotaxi,也是行业首个拿下8个不同国家自动驾驶牌照的科技企业。
截止目前,文远知行既是中国Robotaxi出海No.1,同时还是整个自动驾驶行业落地Robotaxi场景最丰富的玩家。
而这一切在韩旭如今看来,“恍如隔世”,因为上一次来同样的大会分享,刚刚好2019年——自动驾驶资本寒冬。
甚至韩旭如今也承认了当时的“私心”:
当时账上的钱只够6、7个月的时间,创新工场的李开复老师也来量子位了,他那时已经是文远的投资人,我的策略是跟投资人汇报一下,因为技术进展真的很不错,看看投资人能不能再加码。
韩旭回忆,当年路演甚至还要想方设法说服投资人自动驾驶不是“骗子公司”,即使心中笃定2025年Robotaxi一定会“满大街跑”。
融资难一方面,另一方面是对未来的判断,无论技术还是模式,当时行业内远未达成共识。
韩旭当时抛出的观点,引用了围棋大师吴清源的一句话“搏二兔,而不得一兔”,意思是不适合L2和L3、L4都做。
而文远专注的L4赛道,也给出了至关重要的转折点:去安全员、前装量产。
一方面,文远知行合一,2021年首次实现Robotaxi去安全员运营,紧随其后有和吉利远程合作了前装量产Robotaxi GXR……这些成了奠定“第一股”的技术、产品基础。
但另一方面,韩旭又“背叛”了当年的认知:文远知行不但L4红红火火,另一条业务线L2+也没闲着,2025年还有了“风生水起”的迹象——
一段式端到端方案率先发布且量产就绪,其进度与地平线、Momenta并称“文地魔”第一梯队。
韩旭如何解释回应?
L2、L4的关系,文远知行怎么划分定义的?
“L2/L4壁垒我最有发言权,马斯克干不过Waymo”
这句话同样也是韩旭说的:
文远既做ADAS也做L4,我自然有资格评判两边的难度。
评判分成两个维度,首先是“L2和L4之间的壁垒根本没有被打破”,所谓大量L4公司,都是“伪Robotaxi”。
是不是真L4,至少要两个标准。第一点是至少要有一个20、30辆车的车队,纯无人跑半年之后才可以说自己是L4的公司。
第二点,是要有纯无人的商业运营。
以这两条标准评判,韩旭认为中国真正的L4公司只有三家:文远知行、百度Apollo、小马智行。
至于其他有安全员在车内的、后端随时接管的,或者拿L2++车冒充的,或者买辆L4车重新刷漆的……在韩旭看来要么是伪L4公司,要么就是一个纯运营平台。
由此也引出了韩旭的第二个观点,那就是“L2和L4之间的壁垒根本没有被打破”。
从文远知行的实践出发,韩旭认为L2++做好的确不容易,但难度跟纯L4比起来是天壤之别:“类似做江里面的一艘船和做跨洋大船,难度差别太大了”。
这也是为什么L4的公司比L2++值钱得多,就比如有百万量产搭载的Mobileye,其市值和几乎没有运营的Aurora差不多,这就是市场给出的评判。
韩旭的观点其实在L4阵营大佬那里经常听到,今年争论尤其激烈。究其原因,也是那个“地球最强男人”马斯克,今年开始大张旗鼓做Robotaxi了,并且押注的还是与传统L4针锋相对的L2+同源同架构、模型大力出奇迹的路线——自然老马也没少调侃嘲讽Waymo。
韩旭的态度、观点掷地有声,直接又给出一个信心十足的预测:
如果马斯克还是用Model 3或者Model Y这样的L2量产车,且3年之内坚持不装激光雷达,那么肯定无法在旧金山做到今天Waymo的水平。
预言很危险,但是我愿意做,3年之后大家可以看看我是不是被打脸。
勇气可嘉,智能车参考也在这里插个眼,3年后再与韩旭当面应证。
一段式端到端“文地魔”,韩旭如何回应?
话说回来,韩旭毫不迟疑给L4、L2划清界限,至少又在估值这个层面更认可文远的“L4”标签,不免在L2+量产业务上给人一种割裂感。
先看看文远知行“江里的船”,造得怎么样?
首先是2023年,文远首次合作博世,帮助这家百年Tier 1追赶高阶智能辅助驾驶方案。
落地量产奇瑞旗下的星途星纪元车型。
前不久,文远又发布了量产一段式端到端方案,同样是帮助博世一夜间追赶上L2+最先进技术范式。
从这个层面看,文远首先是整个L4赛道唯一有稳定量产智能辅助驾驶项目的玩家;另一个角度,文远也是整个自动驾驶行业内,唯一一家L4、L2技术栈全覆盖,且都有成熟落地案例的公司。
从一段式量产节奏来看,文远知行同样是现在行业内的T0梯队。
也就是说,文远知行现在明明白白在“搏二兔”,而且搏成了行业领先!
韩旭自知避不开追问,于是主动“坦白”:
当时只有Xavier,大约70TOPS,今天有Thor,单卡1000TOPS+,L4的算力大约是在3000tops左右,所以双Thor已经到了L4的级别,这样一来L4和L3或ADAS所需要的硬件门槛迅速降低。
这就相当于两个兔子腿绑在一起了,两只兔子只能往一个方向跑。时过境迁,此一时彼一时,今天有能力的确实可以搏二兔了。
一句话总结,量产L2+的需求,推动底层计算硬件快速发展,在2025年这个节点,L4和L2+首先在算力这个层面交汇重合。
如此一来,L4方法论的“降维”,有了可量产的现实途径。
具体到文远知行来看,迅速迭代一段式端到端体系,其实是贯彻端到端技术范式的“第一性”原理:
让模型直接学习输入数据与输出轨迹之间的映射关系。
系统性能的迭代提升,主要利用强化学习手段进行训练,而针对性的场景数据,可以来自文远去年已经量产搭载的奇瑞星纪元车型,也可以来自文远的Robotaxi车队。
毕竟文远早就构建起通用AI司机体系,在感知识别、决策规划等等环节复用算法,无论L2L4、无论乘用货运,基础模型使用相同的数据来训练迭代,后续的仿真测试等等环节,也可以用统一的工具。
所以一段式端到端,是文远探索更进一步的规则+模型的多元技术体系,自证L2+的泛化性、L4的安全性可以共存的落地第一步。
眼下,中国市场标配高阶智能辅助驾驶的车型,算全价位全品类,占比还不到20%。
所以文远+博世的一段式端到端,目标不是追赶某一单点技术突破,而是真正把高阶能力普及到各个价位车型,用L4同源技术尽快推动L2+越过“价值拐点”。
如果文远知行能统一融合L4、L2架构,Robotaxi“地理围栏”范围就有希望逐渐扩大到普通乘用车一样的程度,到这一步实际上地理围栏就已经不存在了,升维降维之争也会彻底终结。
更进一步,通用AI司机的基座“大脑”,启发的不只是自动驾驶…
这其实也是韩旭在这次MEET大会上给出自动驾驶终极预测的根源:
8年之内,自动驾驶有可能会出现AlphaGO时刻。
这会是一个SuperDriver,比人类99.99%的司机都开得好,开得安全。
One more thing
双重上市达成后,韩旭还提到了AI对人才的放大作用。
八年前招聘一个AI人才是30—50万左右年薪,而文远知行刚刚给优秀AI人才开出的最新条件是:300万起,500万封顶。甚至,“对于真正好的英才,500万可能还远远不够。”
Boss韩承诺:文远知行不画饼,上市前说给股票是在空中飘着,如今就是真金白银地给。
以及最后,韩旭还给AI行业创业者一句忠告:善待自己的身体健康,尤其现在融资环境比2019年前后好得多。
....
#FutureX
小鹏最新一篇基于潜在思维链世界模型的FutureX,车端可以借鉴...
港中文联合小鹏最新的一篇工作,很有意思。基于潜在思维链世界模型增强端到端的能力,有一些值得业内尝试的改进点:
- 自动思考开关:判断当前场景是否需要Reasoning以生成更高质量的轨迹,适合复杂场景优化;
- 思考模式:基于潜在世界模型生成未来场景表征,进一步利用总结网络(Summarizer Network)优化生成轨迹;
- 即时模式:适合简单场景,直接利用总结网络输出自车轨迹;
这和前一段时间港中文提出的AdaDrive有异曲同工之处。这折射出一个观点:思维链是必须的,但何时使用思维链推理需要仔细设计。
在自动驾驶领域,端到端规划器从原始传感器数据中学习场景表征,并利用这些表征生成运动规划或控制指令。然而,仅依赖当前场景进行运动规划,在高度动态的交通环境中可能导致次优响应——在这类环境中,自车行为会进一步改变未来场景。为了建模未来场景的演变过程,我们借助世界模型(World Model)来表征自车与其环境随时间的相互作用及变化,这一过程涉及复杂的推理。思维链通过预测一系列未来思考,进而指导轨迹优化,为解决该问题提供了一种极具潜力的方案。本文提出FutureX,一种思维链驱动的流水线框架,通过未来场景潜在推理与轨迹优化,增强端到端规划器的复杂运动规划能力。具体而言,自动思考开关会分析当前场景,判断是否需要额外推理以生成更高质量的运动规划。当FutureX进入思考模式时,潜在世界模型会执行思维链引导的滚动预测,生成未来场景表征,进而让总结网络对运动规划进行优化;否则,FutureX将以即时模式(Instant mode)运行,通过前向传播快速生成运动规划,适用于相对简单的场景。大量实验表明,FutureX在不影响效率的前提下,能增强现有方法的性能,生成更合理的运动规划,减少碰撞事故,实现整体性能的显著提升——例如,在NAVSIM数据集上,FutureX使TransFuser的预测驾驶员模型得分(PDMS)提升了6.2。
一、背景回顾
端到端(E2E)自动驾驶指的是通过完全可微分的映射,直接将多模态原始传感器数据流转换为运动规划或底层驱动指令的技术流水线。该领域在算法方案和基准测试两方面均取得了快速发展。尽管面临固有挑战,现有方法仍实现了显著进步。
在这些成功背后,现有端到端自动驾驶系统通过单一神经网络直接将传感器输入映射为控制输出,执行高效的一次性前向预测,而无需进一步“思考”。这导致它们在复杂环境中缺乏适应性和可解释性(图1第二行)。在人类认知中,驾驶员在执行任何操作前,都会在脑海中模拟可能的未来场景:预测周围车辆的运动趋势、场景的演变方向,以及每种可能行为的潜在结果(图1第一行)。这种内在推理能力使人类能够做出安全且贴合场景的决策。因此,对于端到端系统而言,在高度动态的交通环境中推断未来场景至关重要。
ChatGPT5、Qwen3等先进大型语言模型通过思维链(CoT)机制展现出强大的推理能力。受此启发,近期自动驾驶领域的相关研究尝试将思维链风格的推理融入规划与决策过程。然而,这些方法主要在文本领域运作,生成的语言解释或高层逻辑依据与实际控制过程脱节——它们的“思考”仅以文字形式存在,并未转化为实际动作。因此,这类思维链更多起到描述性注释的作用,而非提升规划质量或安全性的功能性推理机制。这一差距引发了一个新问题:如何使思维链推理具备可执行性,并嵌入决策过程本身?为解决该问题,我们从状态演变与动作选择的视角重新诠释思维链。我们认为,思维链的核心并非文本形式,而在于其逐步展开未来、推理后续事件及对应行动的能力。为此,我们提出潜在思维链推理(latent CoT reasoning):每个推理步骤对应潜在世界模型的一次前向滚动预测,随后进行内部策略评估。这一设计在推理(思考)与规划(动作)之间建立了可微分、可学习的接口。
基于上述洞察,我们提出FutureX——一种将思维链推理融入潜在世界模型的新型端到端驾驶框架。具体而言,FutureX执行迭代的“思考-模拟-行动”(think-simulate-act)循环,使模型在执行运动规划前能对假设的未来场景进行推理。FutureX首先引入自动思考开关(Auto-think Switch),灵感源自ChatGPT5的自动推理触发机制,该开关通过评估当前场景的规划难度,决定是否激活世界模型,进而输出“思考”或“即时”信号。随后,基于潜在世界模型,在潜在场景特征空间内直接执行潜在思维链推理,实现对捕捉环境动态的丰富时空表征的推理。最终,总结器网络(Summarizer Network)结合未来表征与初始运动规划预测偏移量,使策略网络能够基于额外的未来信息进行规划,而非仅依赖当前场景。在具有挑战性的自动驾驶基准测试(如NAVSIM)上的实验表明,FutureX相较于强大的端到端基线模型,显著提升了性能。
本文的贡献主要体现在三个方面:
- 1)概念层面:将端到端自动驾驶中的思维链重新定义为潜在未来推理——即可学习的世界模型-策略循环内的显式状态演变与动作选择;
- 2)方法层面:提出FutureX,首个配备自动思考开关的思维链驱动潜在世界模型,能在不确定性场景下选择性激活推理,实现性能与效率的平衡,满足实时部署需求;
- 3)实证层面:即使基于传统骨干网络(如LTF和TransFuser),FutureX在纯视觉和视觉-激光雷达(camera-LiDAR)两种设置下均达到当前最优性能,验证了所提方法的有效性与广泛适用性。
二、预备知识潜在世界模型
世界模型(World Model)旨在从原始感官输入中学习环境动态的紧凑预测模型,捕捉不同动作作用下世界随时间的演变规律。借助世界模型,智能体在执行实际动作前可模拟更多可能的未来状态,从而实现基于想象的规划。本文中,我们将潜在世界模型定义为一个可微分的转移函数,其在抽象现实世界的潜在特征空间内,对环境的时间演变过程进行建模。该模型并非在原始观测空间中运作,而是通过结构化的潜在状态来表征复杂的场景动态,能够高效、可微分地模拟基于自车动作的未来状态。
思维链
给定初始输入和期望输出,思维链(CoT)推理通过引入一系列中间步骤(即“思考”,thoughts)来提升复杂问题的求解能力。思维链通常以自然语言解释的形式实现,可视为连接输入与最终答案的逐步过程。然而,若构建一系列能将当前状态逐步转化为期望结果的操作或路径点,这些“思考”也可在动作空间中实例化。例如,底层控制指令可根据动态环境和自车意图生成,如“为行人减速→保持车道直至通过人行横道→左转变道”。这正是我们为自动驾驶引入潜在思维链推理的核心原因——每个推理步骤均通过潜在世界模型的前向滚动预测(forward rollout)模拟动态环境,并通过内部策略评估实现自车在预测未来中的意图。
三、思维链驱动的端到端自动驾驶
初始轨迹生成
不失一般性,我们定义流水线,其包含一个场景编码器,用于从输入中提取场景潜在特征。随后,策略网络基于当前潜在特征预测完整的自车轨迹:
其中,每个路径点定义于时刻的自车坐标系,和表示空间坐标,表示航向角。整个轨迹描述了自车在步时域内的预期运动规划。
潜在思维链推理(Latent Chain-of-Thought Reasoning)
如图2底部所示,潜在世界模型执行思维链引导的滚动预测,基于当前潜在特征和初始轨迹推理未来场景的潜在特征。
思维链段构建
为实现结构化推理,将轨迹均匀划分为个子轨迹:
其中,的固定长度为,每个段代表一个用于单步推理的短期局部规划。
思维链引导的潜在世界模型rollout预测
从当前潜在状态出发,潜在世界模型执行段级“假设分析”(what-if)模拟,建模执行该子轨迹时场景在潜在空间中的演变过程。其形式化定义为:
其中,输出更新后的潜在特征,表征执行该子轨迹后的想象潜在状态。此过程生成一系列具备未来感知的潜在状态:
这些状态共同构成潜在推理链——即自车规划作用下环境演变的逐步内部模拟。因此,每个推理步骤对应对未来某一段场景的“思考”。
在实现中,由堆叠的Transformer层构成。首先将和融合形成输入序列:轨迹编码器将编码为与特征维度匹配的紧凑嵌入,随后将与沿序列维度拼接,得到Transformer层的最终输入序列。通过多头自注意力机制,模型融合轨迹条件动态信息和时空上下文,生成更新后的潜在状态。
基于思考的轨迹优化
生成内部推理链与初始轨迹后,FutureX执行推理总结步骤,这与大型语言模型(LLMs)将中间思考整合为最终答案的过程类似。
如图2所示,总结器网络以和为输入,预测优化后的轨迹:
其中,为优化后的轨迹,作为最终动作输出。
具体而言,基于预测的内部推理链,预测初始轨迹的偏移量,使策略网络能够基于额外的未来潜在特征进行规划,而非仅依赖当前潜在特征。例如,在两侧停放车辆的车道上,思维链风格的推理可帮助模型预判未来可能从车辆间隙冲出的行人,从而保持更保守的行驶速度。
该总结过程生成最终的思维链感知规划,确保所有内部“思考”被连贯地提炼为统一、与未来场景一致的驾驶轨迹。
自动思考开关
自动思考开关对原始传感器输入提取的当前场景潜在特征进行评估,通过估计场景难度决定是否激活潜在世界模型,并输出“思考”或“即时”信号(如图2顶部所示)。
具体来说,场景编码器将原始传感器输入映射为统一表征。基于,自动思考开关在时刻输出标量的运动规划难度分数:
对于的标签,首先计算初始轨迹和优化轨迹相对于真实轨迹的损失:
随后,通过误差的相对降低量衡量优化增益,并推导开关的二元监督信号。定义改进率和思考标志的计算方式为:
其中,确保数值稳定性,表示指示函数,为预定义阈值,用于调节思考模式的灵敏度。
思维链中的监督机制
为实现FutureX的端到端训练,我们同时对外部轨迹预测和内部推理过程进行监督。具体定义三个损失项:1)轨迹规划损失,使优化后的轨迹与人类专家轨迹对齐;2)潜在一致性损失,监督思维链潜在世界模型;3)开关监督损失,指导自动思考开关何时调用潜在推理。
Latent一致性损失
为优化,我们尝试将预测的未来潜在特征与场景编码器从对应传感器输入中提取的真实未来潜在特征对齐。因此,潜在一致性损失计算如下:
轨迹损失
由于FutureX的轨迹输出依赖自动思考开关通过式(8)得到的思考标志,最终轨迹损失计算为:
该损失使FutureX能够通过额外的潜在推理处理复杂规划任务,同时在相对简单的场景中保持快速响应。
自动思考损失
基于式(6)的规划难度分数和式(8)的思考标志,采用交叉熵计算思考损失:
综上,FutureX的训练目标函数为:
其中,和为超参数。训练过程的伪代码总结于算法1。
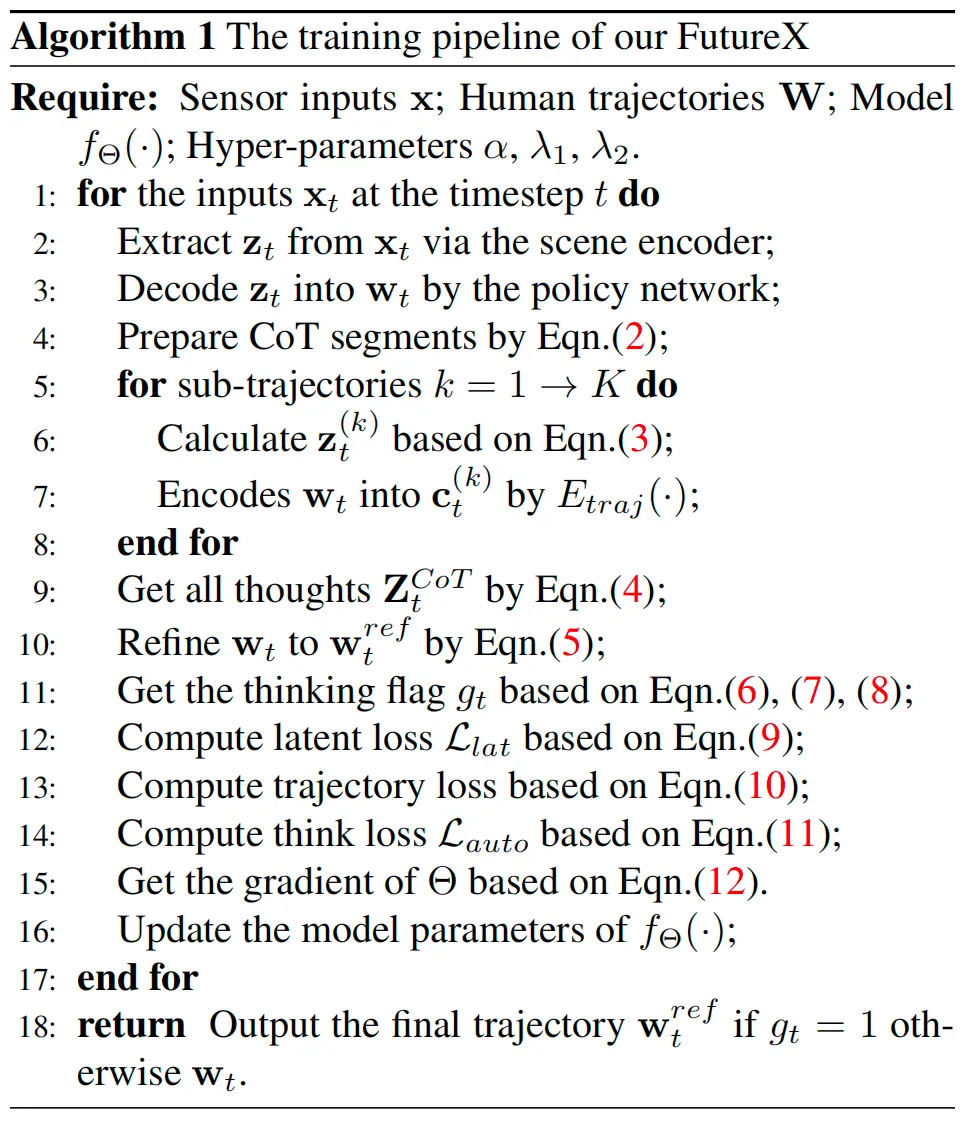
实验结果
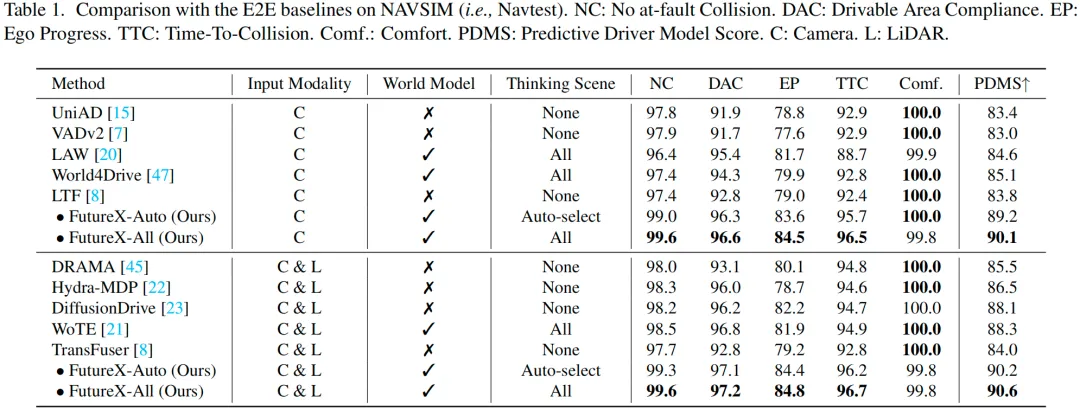
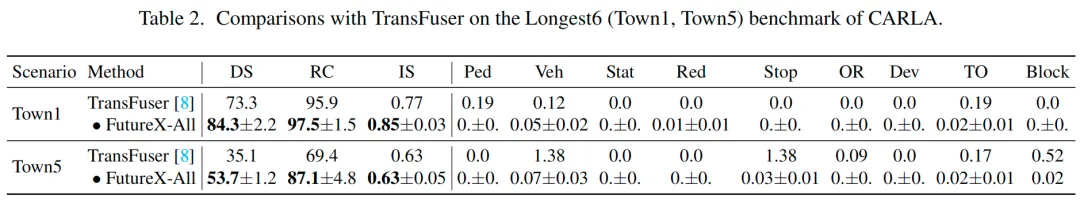
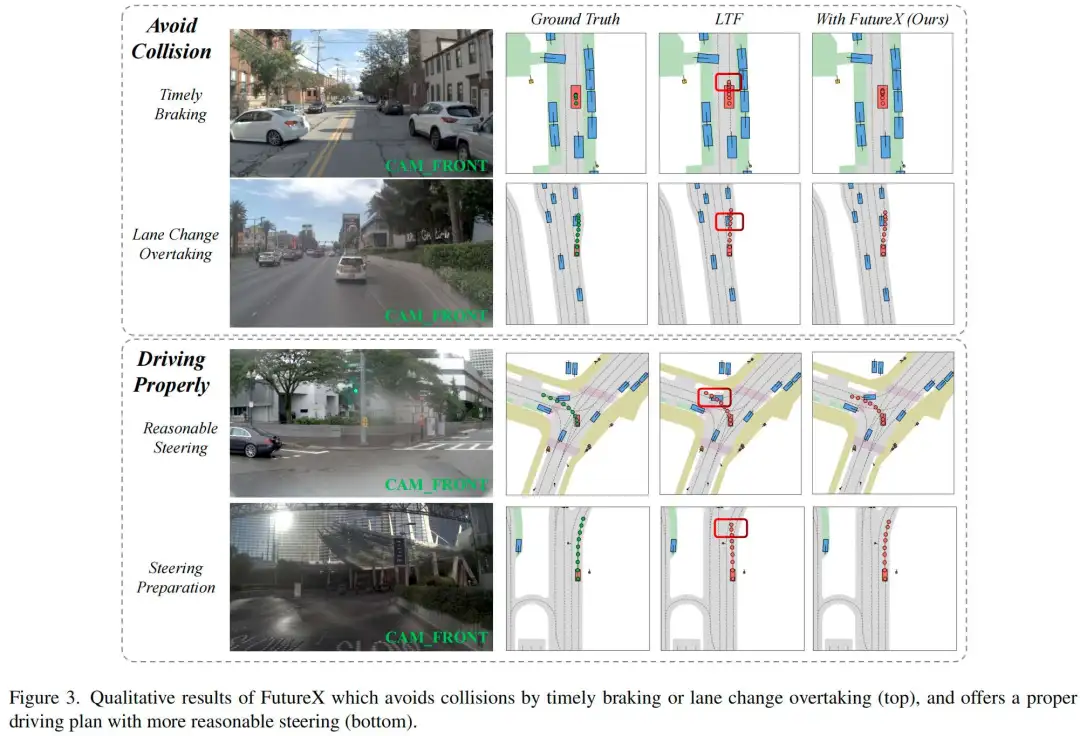
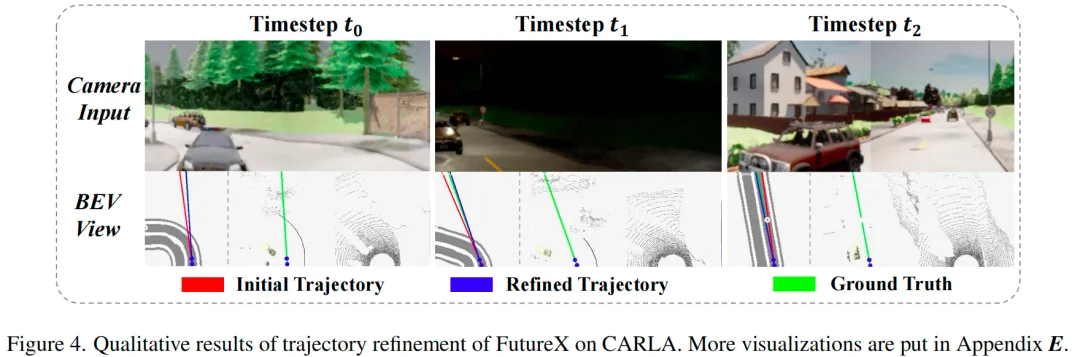
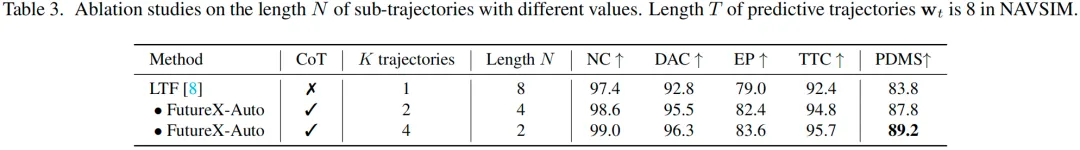
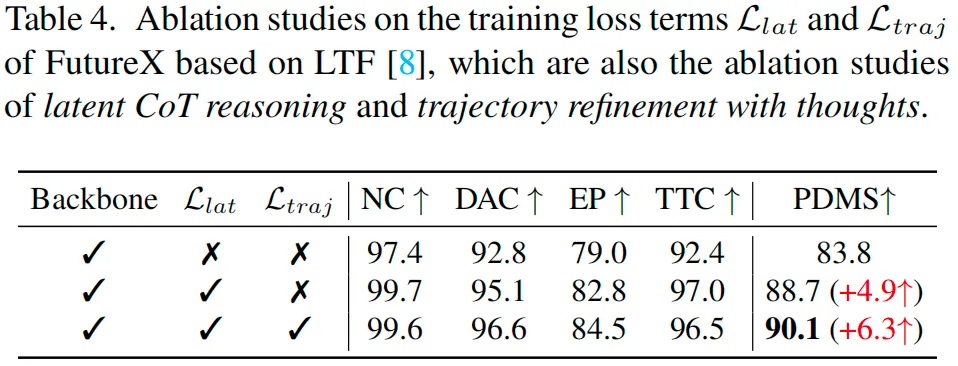
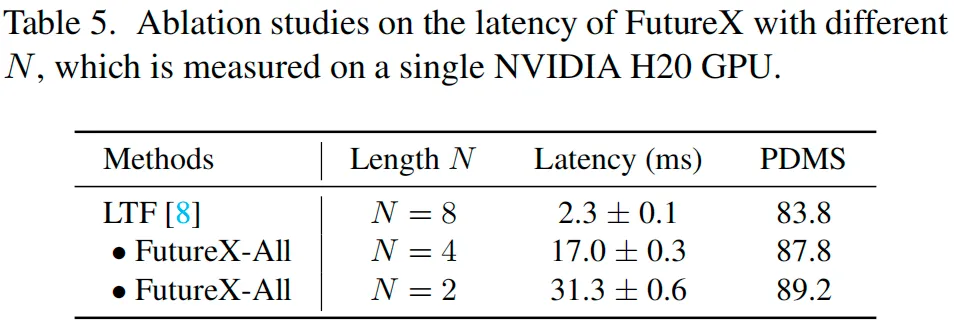
五、结论
本文提出一种将思维链推理融入潜在世界模型的端到端驾驶框架FutureX。该方法通过执行迭代的“思考-模拟-行动”循环,在执行动作前对假设未来场景进行推理。具体而言,潜在世界模型基于丰富的场景表征进行潜在思维链推理,捕捉环境动态;随后,FutureX执行推理总结步骤——类似大型语言模型将中间思考整合为最终答案的过程,生成最终的思维链感知规划。为满足实际部署需求,自动思考开关决定是否激活潜在世界模型,实现性能与时间开销的平衡。在NAVSIM和CARLA数据集上的实验表明,FutureX在增强纯视觉和多模态端到端自动驾驶系统的性能方面具有有效性和适用性。
....
#45万亿!中国智驾的新风口来了
L4级智能驾驶商业化进程显著提速,呈现政策、技术、场景三轮驱动格局。
政策层面,国家级规划与五城全域开放试点明确事故责任划分,破除制度障碍;
技术层面,系统成本持续下探,车路云协同能力增强,提升复杂环境可靠性;
场景层面,Robotaxi、无人配送、干线物流等多场景试点加速从低速封闭向中高速开放场景跨越。
在政策红利释放、核心技术进步与应用场景拓展的共同作用下,2025年五城L4车辆保有量预计突破10万辆,带动相关产业链规模超200亿元,标志着“全民智驾”元年正式开启。
L4智驾的发展背景概览
L4级智驾已成为跨越式技术路线的主战场,产业生态庞大、格局趋明。
资本集中注入头部企业,政策逐步开放多类场景的L4智驾试点,商业化按“中低速封闭场景→高速开放场景”路径逐级拓展;
技术端以“车-云”与“车-路-云”协同为标配,感知-决策-控制专利持续攀升,推动研发测试迅速转入试运营和规模化落地。
L4智驾的商业化应用现状分析
低速半开放和封闭场景L4智驾基本已进入商业模式探索阶段和全面推广应用阶段,中高速开放/半开放场景当前多处于早期阶段。
L4智驾技术的商业化应用需要场景提供方、技术公司、车企及供应商、金融机构与政府部门的共同协作。
当前商业模式主要包括产品销售与代运营两类,并以产品销售为主要方向。
园区服务场景,L4智驾车辆根据工业和商业文创等不同类型园区的需求提供差异化服务。
工业园区多采用牵引车、叉车等车型,由智驾企业提供产品与技术支持;商业园区则更多使用小型车辆进行零售配送或巡防,运营方式包括园区自营和第三方代运营。
应用L4技术后,工业园区智能重叉车年均单车节省成本18万元,商业园区智能巡防车年节省成本约7万元。
环卫场景覆盖园区与城区,涵盖清扫和垃圾清运等环节,车型包括扫路车、洒水车和垃圾车。
合作模式分为自建车队的重资产模式与提供技术服务的轻资产模式,并可进一步细分为四种类型。
园区场景中,L4智驾可替代人工清扫,年节约成本11%;城区场景中预计电动智驾环卫车可比传统柴油车节省21%的年均成本。
城区配送聚焦3-5公里范围内的社区服务,客户包括商超、餐饮和快递公司。
主流商业模式为“直接销售+订阅服务”,车辆价格已低于10万元,订阅费每月约2000–3000元。
同时也可采用租赁模式,由厂商负责运营。该模式通过“中转直发”提升物流效率,预计每年可为快递驿站降低超过4万元成本,降幅达19%。
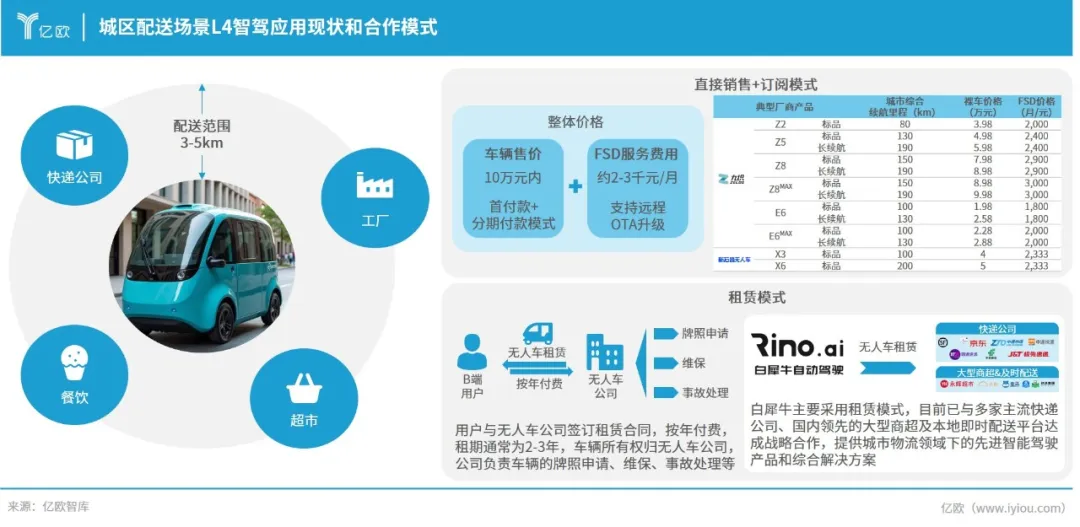
Robotaxi已形成以智驾公司、主机厂和出行平台为核心,政府、通信与安全机构辅助的成熟“金三角”模式,特斯拉等企业还在探索包括车主在内的四方协作模式。
在客单价25元、日接单17笔的假设下,单车年营收可超15万元,年均成本约12万元,毛利润约3万元,毛利率21%,接近传统出租车水平。
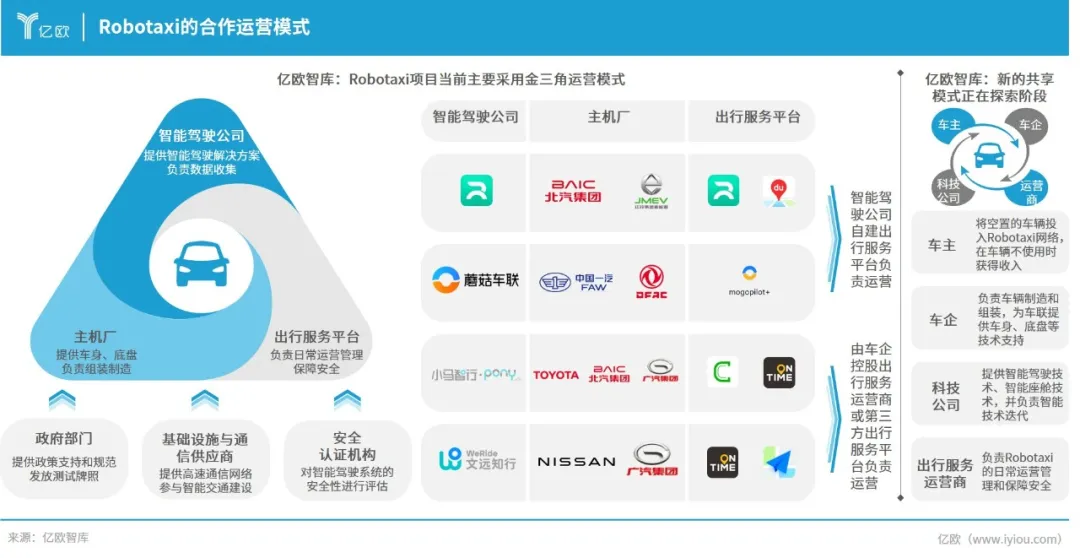
Robobus应用于城市微循环、地铁接驳及园区景区内部线路,城市公交多采用公交公司主导、多方协同的运营机制,园区景区则常见技术方直接参与运营。
一辆49座Robobus在60%满座率下,年营收预计近70万元,年成本约51.3万元,毛利润超17万元,毛利率可达25%。
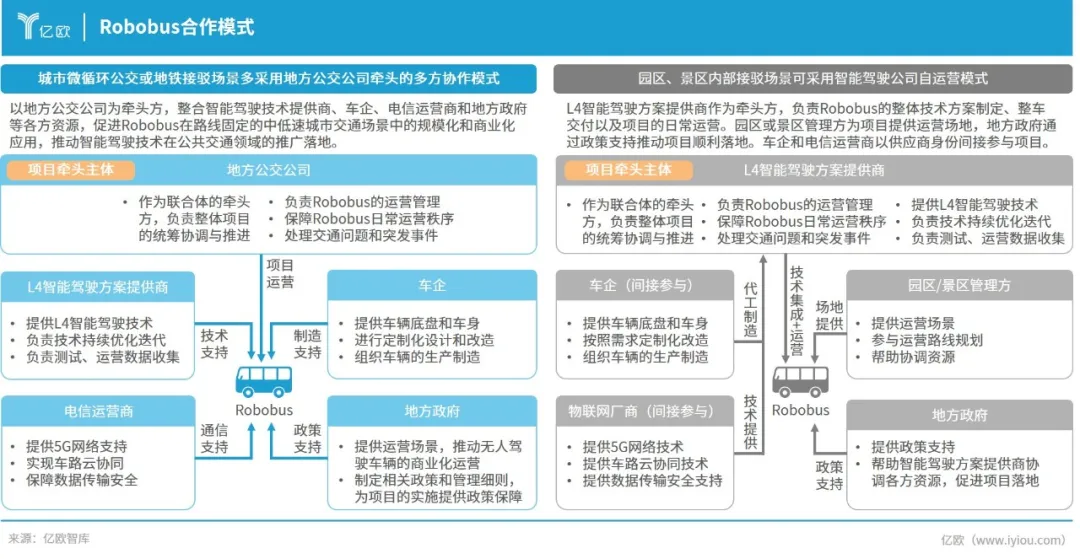
干线物流存在轻资产、重资产和混合三类合作模式,目前以L2辅助驾驶为主,正逐步向高阶智驾发展。
预计进入小规模运营阶段后,年均成本将降至55万元,与传统燃油车持平甚至略低;大规模运营后成本将进一步降至44万元,相比传统车辆节省17万元。
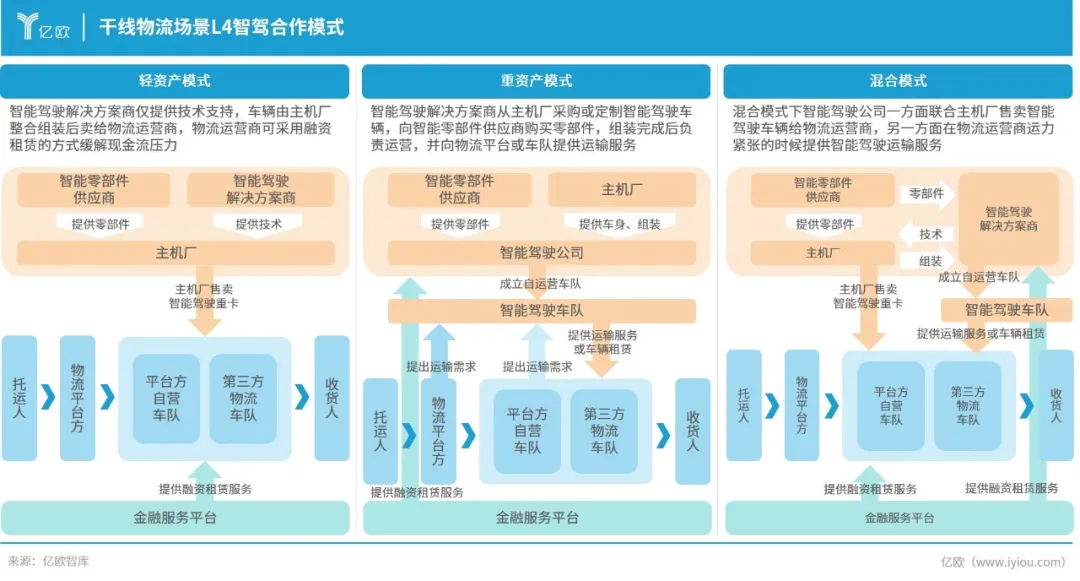
港口场景以销售与代运营为主要商业模式,销售包括解决方案和整车两种形式。
DCV无人集卡已实现成本优势,年省约6万元;IGV、AGV和ASC车型随着规模扩大和技术成熟,未来成本还将进一步下降。
航空港场景目前仅采用“整车销售+软件服务”模式,由地服公司运营,不涉及代运营。
因作业强度大、容错率低,L4技术对提升安全与效率具有关键作用,已应用于摆渡车、行李牵引车等车型,并在国内外多个机场进行测试与落地。
矿山场景中L4车辆主要用于矿石与人员运输,合作模式包括向矿企提供解决方案或按运输量收费。
智驾矿卡可显著降低人工成本,单车年均节省超过40万元司机费用,同时安全性更高,但车辆购置与运维成本仍较高。
仓储场景以“硬件+软件”结合服务为主,提供AGV/AMR设备及调度管理系统。
主流模式包括销售、租赁和代运营,早期以销售为主,如今合作形式日趋多元。
应用L4技术后,仓储可实现数字化运营,年均单车节省约2万元人工成本。
L4智驾的发展趋势洞察
L4级智能驾驶正从技术验证阶段迈向商业化爬坡阶段,面临技术瓶颈、法规缺失、数据伦理与商业模式四重挑战,需依靠政策支持、基建协同、技术突破、生态开放与公众参与共同推动其安全、高效、经济和可信的规模化应用。
在技术上,硬件趋向冗余与容错设计,软件依托端到端架构与多模态模型实现感知和伦理决策,车路云融合实现全局优化。
商业上正从单点工具发展为跨场景运力平台,融入共享经济与多业态联动,逐步从低速封闭场景向中高速开放场景推进,预计2035年中国L4及以上智驾市场规模将超过45万亿元,渗透率达13%以上。
....
#SpatialRetrievalAD
复旦&上交最新!一篇长达40页的自动驾驶空间检索范式SpatialRetrievalAD
现有自动驾驶系统非常依赖车载传感器进行实时精确的环境感知。然而,这种模式受行驶过程中的感知范围限制,在视野受限、遮挡或黑暗、降雨等极端条件下常出现性能失效。相比之下,人类驾驶员即使在能见度不佳的情况下,仍能回忆起道路结构。为了让模型具备这种“回忆”能力,针对这个特点,复旦可信xx智能和上交等合作,将离线检索的地理图像作为额外输入引入系统。这些图像可从离线缓存(如谷歌地图或已存储的自动驾驶数据集)中轻松获取,无需额外传感器,是现有自动驾驶任务的即插即用型扩展方案。
在实验中,首先通过谷歌地图API检索地理图像,扩展了nuScenes数据集,并将新数据与自车轨迹对齐。并在五个核心自动驾驶任务上建立了基准:目标检测、在线建图、占用预测、端到端规划和生成式世界模型。其中在线建图mAP提升13.4%,占用预测静态类mIoU +2.57%,夜间规划碰撞率从0.55%降至0.48%,为复杂场景自动驾驶提供低成本、高鲁棒的感知增强方案。大量实验表明,该扩展模态能够提升部分任务的性能。我们将开源数据集构建代码、数据及基准测试,为这一新自动驾驶范式的后续研究提供支持。
- 论文标题:Spatial Retrieval Augmented Autonomous Driving
- 论文链接:https://arxiv.org/abs/2512.06865
- 项目主页:https://spatialretrievalad.github.io/
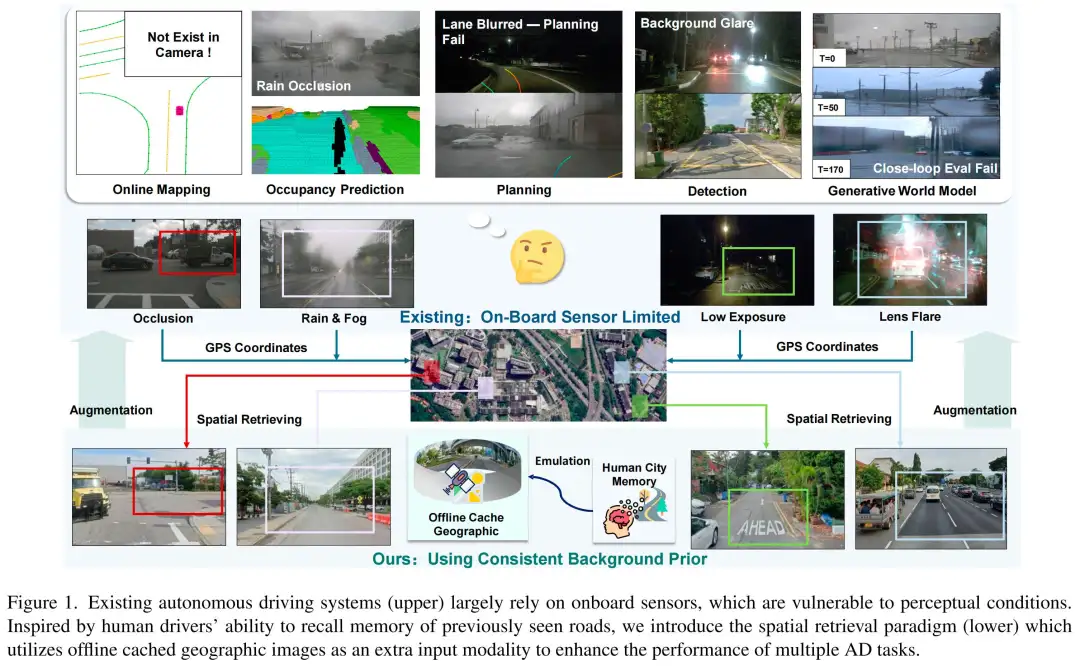
一、背景回顾
最新的自动驾驶方法依赖车载传感器捕获环境信息。尽管这种模式已取得良好性能,但其输入本质上受限于在线传感的有限范围和视线传播特性。因此,在视野受限、遮挡、曝光异常或雨雪雾等恶劣天气等视觉挑战场景下,系统性能会显著下降,如图1所示。例如,在线建图和占用预测等任务旨在估计场景结构,而有限能见度或遮挡会降低其环境识别能力,进而影响规划决策。同样,近年来的自动驾驶世界模型在自车偏离记录日志较大时,难以生成新颖场景,这一局限源于车载视野的狭小范围,限制了其作为闭环评估和强化学习模拟器的应用能力。
相比之下,当当前视觉输入不足时,人类驾驶员会回忆近期的场景记忆。在本研究中,我们旨在通过空间检索为自动驾驶系统增添车载传感器即时范围之外的更广泛上下文信息。空间地理数据可来自谷歌地图,该平台提供包含经纬度信息的街景和卫星图像。对于自动驾驶企业而言,也可使用其离线缓存的数据集。与车载传感器不同,这些地理数据是离线的、全球可访问的,且不受行驶过程中干扰因素的影响。它们从自车之外的视角提供丰富的上下文线索,无需额外传感器或人工标注,是一种经济高效的空间上下文增强方式。
为系统研究这一新范式,我们首先构建了一个将地理数据整合到现有自动驾驶数据集的框架。该框架通过谷歌地图API和自车姿态信息实现数据收集和空间对齐的自动化,以获取并对齐坐标系。利用这一框架,我们随后为nuScenes数据集扩展了相应的地理图像和基于坐标的空间检索API。最后,为探究这一新模态的效果,我们在五个关键自动驾驶任务上建立了基准:目标检测、在线建图、占用预测、端到端规划和生成式世界模型。我们设计了一个即插即用的适配器,将地理图像无缝整合到现有模型中。大量实验表明,该模态能够提升多个任务的性能。
我们的主要贡献总结如下:
- 提出自动驾驶空间检索范式,减轻车载感知对环境的敏感性,并提供广泛的远距离上下文信息。
- 构建扩展nuScenes数据集——nuScenes-Geography,包含地理图像和空间检索API,为新范式的系统研究提供支持。
- 设计模型无关的适配器,并在五个自动驾驶任务上建立基准,验证新模态的广泛适用性。
- 开源数据构建流程、扩展数据集及所有基准模型,以促进后续研究。
算法详解
空间检索范式与任务定义
假设一段自动驾驶数据由个时序化的传感器和姿态数据组成,其中每个时间步包含车载传感器数据(例如带有相机内参和外参的多视角图像)和自车姿态。
引入离线地理数据库,该数据库由地理图像及其对应的元数据(全球坐标和相机参数)构成。
我们在五个自动驾驶任务上评估空间检索范式的有效性(表1)。对于车载任务(3D目标检测、在线建图、占用预测和运动规划),每个时间步都会应用检索函数,该函数以当前图像和自车姿态为输入,从中检索最相关的地理数据:
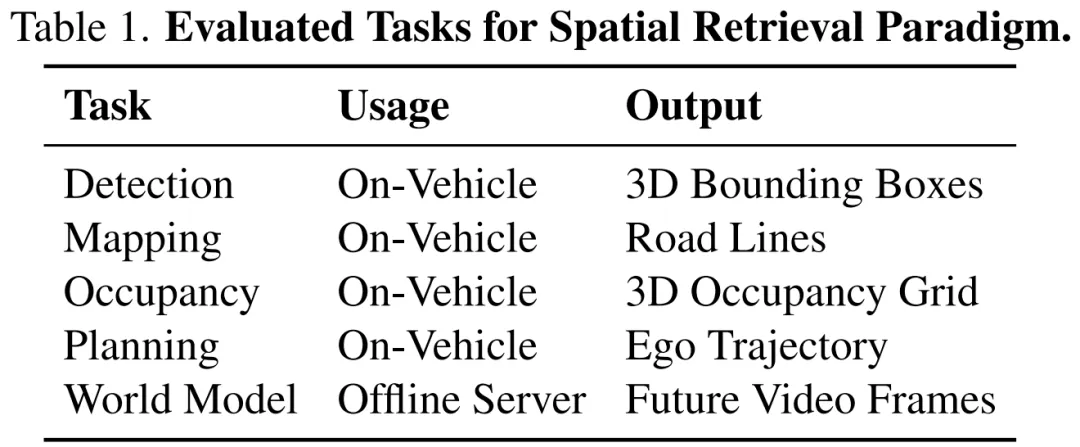
为简化起见,本研究中我们为每个相机在每个时间步检索最近的地理图像。若3D距离大于阈值,API返回“无(NONE)”。未来可探索更先进的检索方式,例如检索更多邻域图像作为全局上下文。
对于离线任务(生成式世界模型),会沿生成目标行驶轨迹检索多张地理图像,为长时域、全局一致的场景生成提供空间支架,减少幻觉现象。
空间检索适配器
本节介绍一种通用的即插即用模块(图2左),用于将检索到的地理数据融入基于鸟瞰图(BEV)的车载任务,作为直观基准。结合各任务先验知识的更先进模块将留待未来研究。
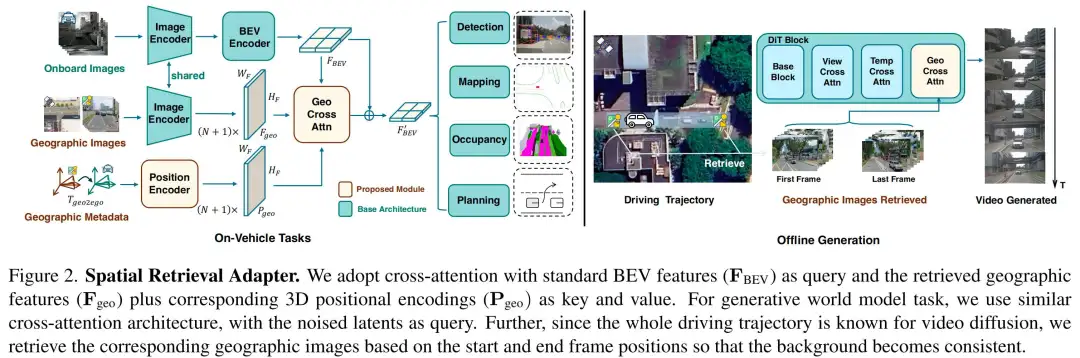
地理图像与位置编码:检索到的地理图像通过与车载相机相同的骨干网络编码得到。为编码检索地理图像与当前自车位置的相对空间关系,我们采用PETR对地理图像块进行3D位置编码,得到。
地理交叉注意力:地理特征通过带位置编码的交叉注意力融入BEV表示,由可靠性分数调制以处理检索缺失或错误的情:
增强后的BEV特征随后输入原始下游任务头。这种即插即用设计保持所有训练目标和网络架构不变。
生成式世界模型的空间检索
自动驾驶生成式世界模型可作为数据生成器、闭环评估器或强化学习(RL)环境,通常运行在集群和服务器上而非车载设备。因此,这些模型可获取未来自车轨迹,能够沿即将行驶的路径预检索地理图像,类似Bench2Drive-R。通过在生成过程中注入未来位置的地理图像,提供持续的空间线索,维持场景一致性。
地理扩展DiT:参考Bench2Drive-R,为将地理数据融入生成过程,我们在广泛使用的DiT模块的原始注意力层后,额外注入一个地理交叉注意力层:
其中表示带噪声的 latent 特征,表示生成片段起始帧和结束帧的检索地理特征。该设计使模型能获取对应未来位置的地理上下文。
基于可靠性估计的自适应融合
利用地理数据的核心挑战是处理缺失或错位的街景图像(图7)。为减少这类情况的影响并提升模型对不可靠检索的鲁棒性,我们引入自适应融合机制(图3),基于以下两点动态调整地理特征的贡献权重:(i)检索位置与自车姿态的距离;(ii)检索图像与当前车载图像的相似度。
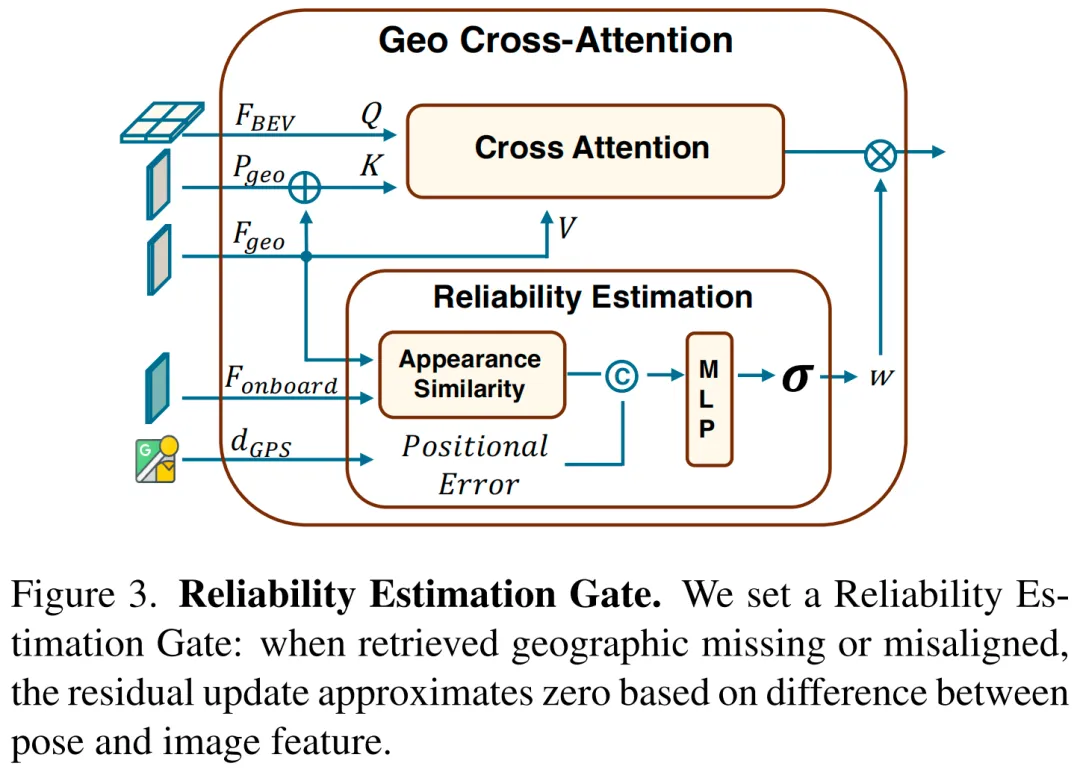
具体而言,我们设置可靠性估计门控模块输出可靠性分数,其中ZNCC计算车载特征与地理特征的零归一化互相关,是街景位置与自车位置的距离,是sigmoid函数。训练过程中,我们用二元标签(0表示无效/缺失,1表示有效)监督的学习。测试时,该学习到的估计器可对不可靠地理特征进行降权。
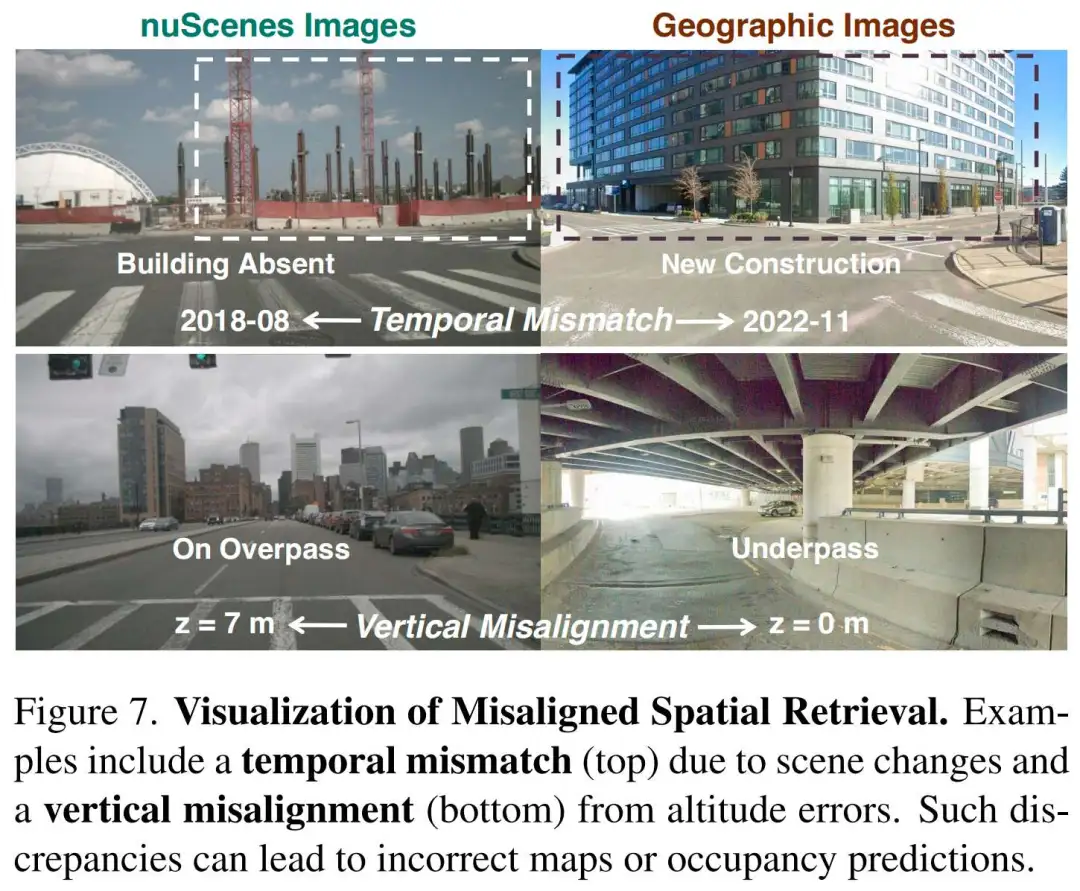
三、nuScenes-Geography:基于谷歌地图的扩展地理数据
为系统验证空间检索范式的有效性,我们引入nuScenes-Geography数据集——通过谷歌地图API收集地理数据,对广泛使用的nuScenes数据集进行扩展(图4)。
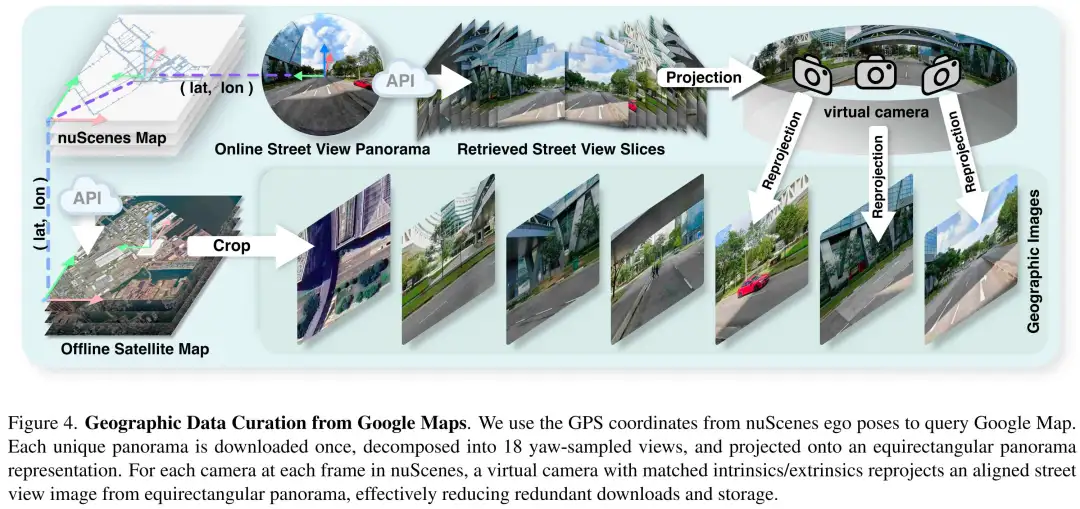
坐标计算
为建立地理数据与nuScenes帧的关联,我们结合nuScenes地图的全球原点和自车姿态,计算每个帧的经纬度坐标。利用这些坐标查询谷歌地图API,获取街景图像和卫星地图切片。
面向高效存储与检索的等矩形全景图表示
由于街景图像的空间采样频率显著低于nuScenes的关键帧速率,同一条道路上的多个nuScenes帧可能对应相同的街景位置(图5)。为最小化存储开销,每个独特的地理数据仅检索一次,并存储该地理数据与其所有最近nuScenes帧的映射关系。
然而,nuScenes中不同帧对同一街景位置需要不同视角。为在保证几何正确视角的同时维持存储效率,我们采用等矩形全景图表示:
- 数据获取:对于每个街景位置,从API检索18张视角图像,这些图像具有分布式偏航角(覆盖360°)和固定俯仰角0°。
- 等矩形全景图格式:将这些图像投影到球面表示,并存储为等矩形全景图格式。
- 虚拟相机对齐:对于nuScenes的每个帧和每个车载相机,在对应街景位置实例化一个虚拟相机,其内参与nuScenes相机模型一致。外参变换由自车姿态和街景拍摄点推导:旋转遵循原始nuScenes相机朝向,平移由街景与自车的经纬度偏移计算得出,z轴平移设为固定常数。
- 重投影检索:利用虚拟相机配置,从等矩形全景图进行透视投影,合成与nuScenes帧几何对齐的街景图像。
该过程确保每个车载帧与其合成街景视角的空间一致性和一一对应关系,同时使整个收集流程具备存储高效性——与直接下载每帧街景裁剪图相比,存储量减少超过70%。
缺失与错位地理数据的处理
如图7所示,谷歌地图API可能返回空响应或错位地理数据。如前文所述,我们设计自适应融合机制,通过残差门控让模型选择性融合可靠的地理信息。在nuScenes-Geography的构建过程中,我们手动检查所有下载的地理图像,识别出1800个错位案例,作为可靠性估计模块的负样本标签。图6展示了nuScenes地理数据的覆盖情况,整体覆盖率较高。
四、实验结果分析
本节在扩展后的nuScenes-Geography数据集上,针对五个任务评估所提出的空间检索范式。我们探究了空间检索的三大潜在优势:提升静态场景理解能力、增强规划鲁棒性以及改善生成式世界模型的空间一致性。
场景理解
空间检索提供了稳定的背景视图,弥补了车载传感器在极端视觉条件下的脆弱性和有限感知范围。
- 在线建图:如表2所示,将地理先验融入MapTR和MapTRv2后,在线建图性能显著提升。额外的背景信息有助于恢复被遮挡的车道(见图10)。
- 占用预测:如表3所示,扩展FBOCC和FlashOCC后,模型的平均交并比(mIoU)持续提升,静态类别尤为明显。该先验为背景几何结构提供了抗传感器噪声的锚定(见图10)。
- 目标检测:如表4所示,BEVDet和BEVFormer在融入地理数据后提升微乎其微。这一结果符合预期,因为空间检索主要提供背景信息。不过,利用地理数据区分前景与背景进而辅助目标检测,是一个值得探索的未来方向。
规划鲁棒性
我们基于VAD评估空间检索对安全规划的促进作用。地理先验提供了一致的道路布局信息,弥补了遮挡或光照不足导致的传感不稳定性。如表6所示,在保持轨迹精度相当的前提下,我们的方法提升了安全裕度。具体而言,在具有挑战性的夜间场景中,平均碰撞率从0.55%降至0.48%,证明了地理先验作为安全规划可靠指导的价值(见图9的可视化示例)。
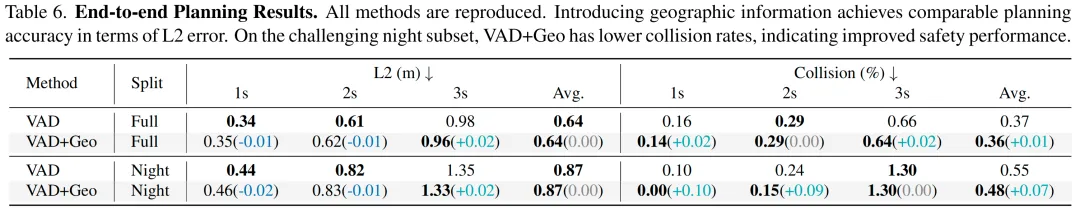
生成式世界模型一致性
我们进一步评估地理先验对生成式世界模型的辅助作用。将UniMLVG和MagicDriveDit (针对MagicDriveDit,我们将测试集采样步长调整为13,以避免重复采样近重复片段)与地理图像进行条件关联后,模型的视频弗雷歇距离(FVD)和inception距离(FID)均降低,有效防止了场景漂移,在滚动生成过程中保持了几何一致性(如表5所示)。这证实了空间检索可作为结构化支架,支撑连贯的世界建模。
错位空间检索的可视化
新范式面临检索缺失或错位的挑战——当离线地理图像与相机图像不一致时会出现此类问题(见图7)。其原因主要包括:(1)地图过时:道路布局因施工发生变化,但缓存的地图影像未准确反映,可能误导模型;(2)GPS/定位误差:自车姿态不准确可能导致检索图像与车载传感器图像错位,谷歌地图API偶尔会出现此类情况。
消融实验
我们在占用预测任务(FlashOcc)和生成式世界模型任务(Unimlvg)上进行消融实验。如表7所示,引入地理先验始终能带来显著性能提升,而位置编码和可靠性估计门控则进一步优化了性能。
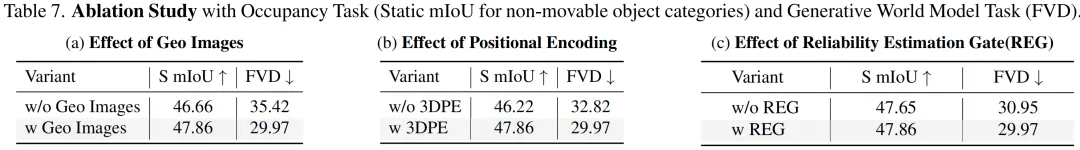
定性分析
- 在线建图:图10显示,当车载相机的视觉线索退化或缺失时,地理先验有助于重建地图元素。
- 占用预测:图10显示,地理先验提供了清晰稳定的几何参考,能够恢复被遮挡的背景结构。
- 规划:图9显示,地理先验提供的稳定道路几何信息,使模型在复杂路口和恶劣天气下能生成更平滑、更安全的轨迹。
- 生成式世界建模:图8显示,地理先验防止了长时域滚动生成过程中的生成崩溃,维持了场景一致性。
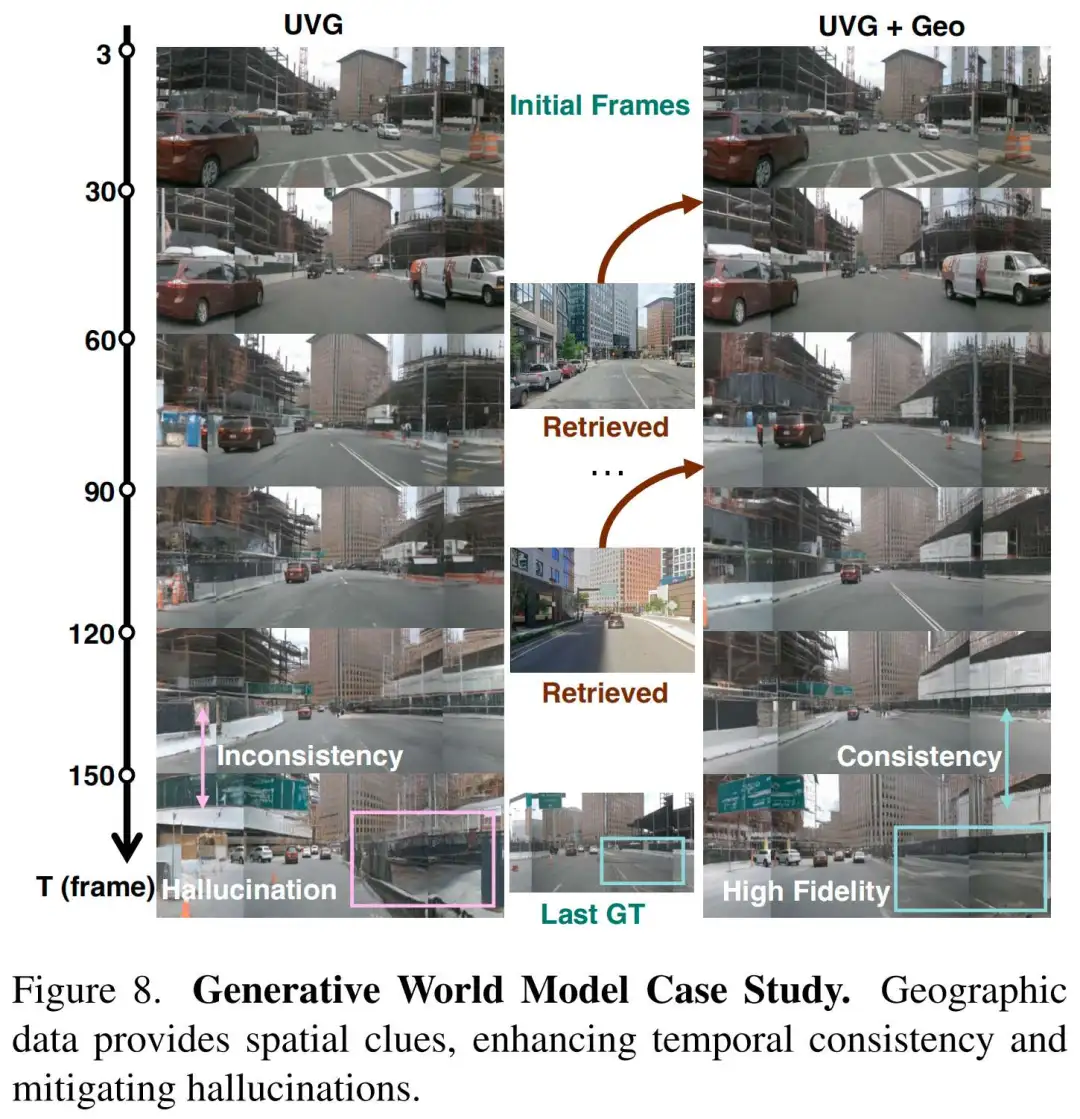
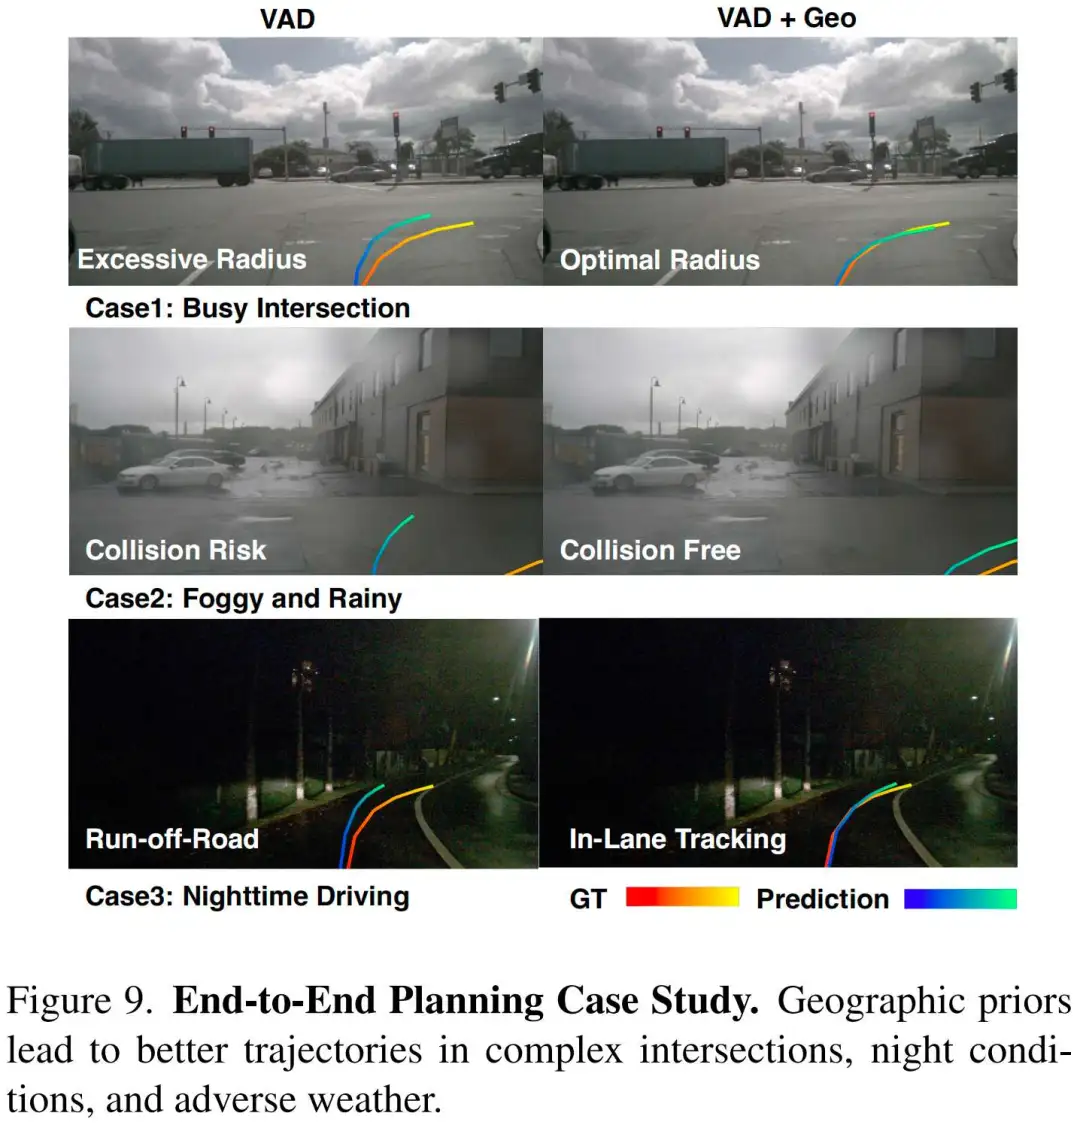
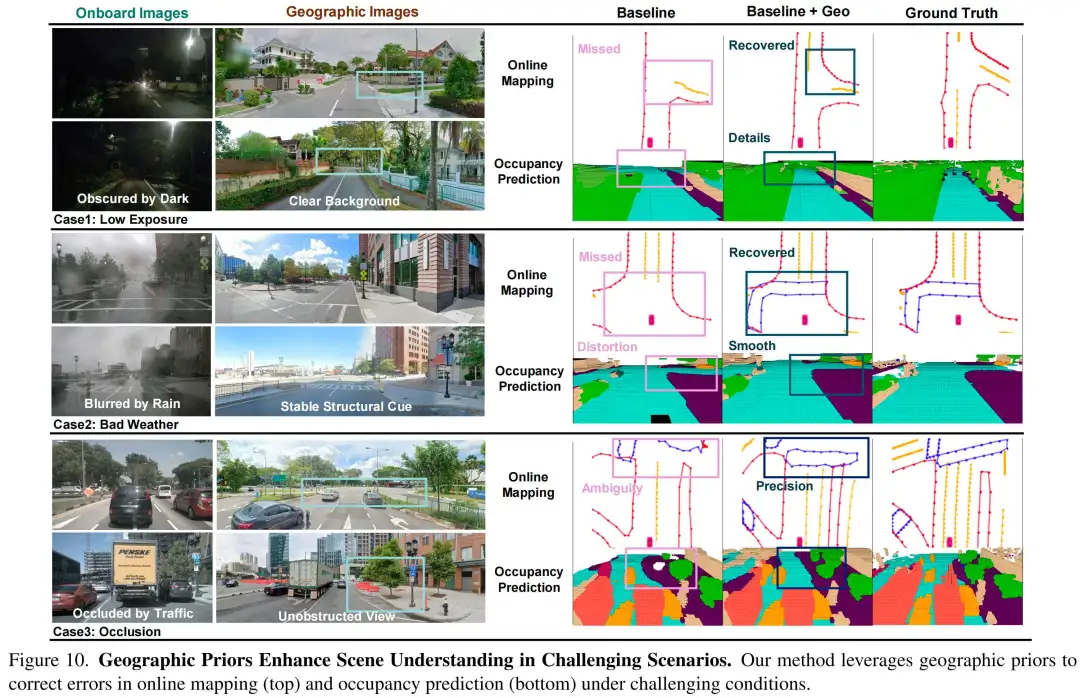
对不准确检索的鲁棒性
为进一步评估所提出的可靠性估计门控的有效性,我们测试了在线建图方法MapTRv2在不准确检索下的鲁棒性。我们随机丢弃地理图像,或在一定比例的帧中用随机错误图像替换它们。图11显示,随着先验可用性的降低,模型性能平稳下降。即使50%的先验缺失或错位,模型仍保留了相对于基准的大部分性能提升。这表明,所提出的可靠性估计门控使模型能够在有可用先验时加以利用,而在无先验时不会出现灾难性失效,体现了良好的实际应用鲁棒性。
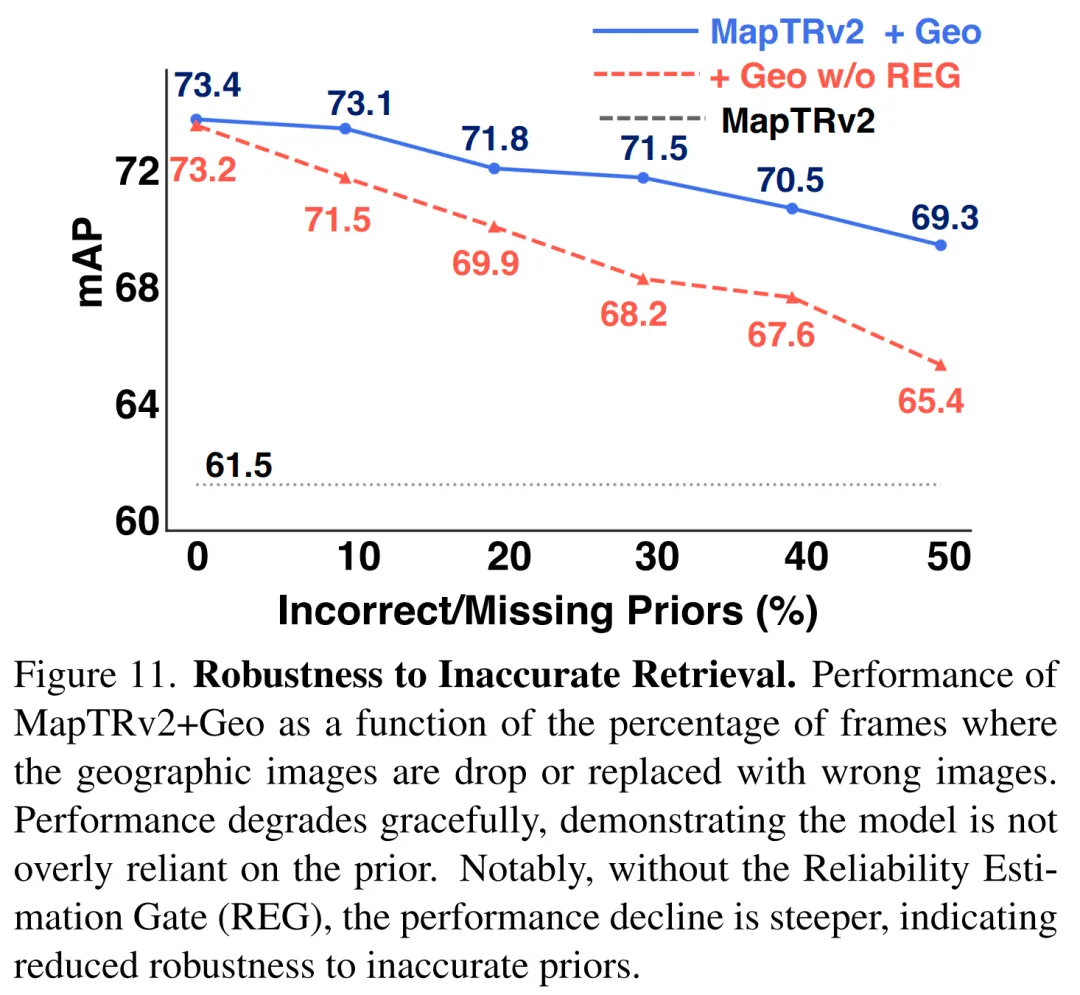
五、结论
本研究提出了自动驾驶空间检索范式,将地理数据作为额外输入引入系统。我们通过谷歌地图API获取地理数据,扩展了nuScenes数据集,并在扩展后的nuScenes-Geography数据集上对五个关键自动驾驶任务进行了评估。我们设计了通用的即插即用型空间检索适配器,作为融入地理数据的直观基准;同时提出可靠性估计机制,基于检索数据的可靠性自适应融合地理信息。大量实验表明,所提出的范式能够提升多个自动驾驶任务的性能,彰显了这一新范式的巨大潜力。
....
#理想下一步的重点
理想汽在ICCV'25期间也分享了些新东西!目前还没有视频对外。
VLA团队负责人詹锟老师做了一场世界模型的presentation,名为World Model: Evolving from Data Closed-loop to Training Closed-loop。xxx第一时间做了解读分享给大家~
首先是介绍下理想VLA司机大模型:
回顾了理想汽车智能驾驶的发展路线,从规则时代的轻图和无图,再到基于AI的E2E+VLM快慢双系统和VLA,这四个方案中Nav(导航)是重点突出的模块。
下面介绍的是数据闭环的价值。左上角这张图是一个完整的数据闭环流程:影子模式验证→经由数据触发回传到云端进行数据挖掘→有效样本进行自动标注→生成训练集训练模型→模型下发验证性能。
这个过程已经可以做到一分钟的数据回传。
目前已经有15亿公里的驾驶数据,200+的Trigger来生产15-45s的Clip数据。
目前理想的端到端量产版本MPI已经到了220+,相比于24年7月底的版本,MPI翻了19倍左右。
数据闭环虽然有效,但仅靠数据闭环解决不了所有问题。主要还是长尾场景的收敛问题,交通管制、烟花燃放、突然的变道等等。
所以抛出来一个观点:自动驾驶进入下半场
自动驾驶的下半场换个新玩法:从数据闭环到训练闭环。
L4的训练循环的核心是:VLA+RL+WM。
- 轨迹由VLA的Diffusion和基于世界模型的强化学习共同优化;
- 强化学习不仅仅是RLHF,还有RLVR和RLAIF
- 右侧的世界模型主要指场景重建和新视角复原;
闭环自动驾驶训练关键技术栈:区域级别的仿真、合成数据和强化学习。
- 仿真靠场景重建:视觉/Lidar重建、区域重建、多趟重建、场景编辑和风格迁移;
- 合成数据靠多模态生成:视频/点云生成、神经渲染;
- 强化学习靠Agent、3D资产和评测&奖励
詹锟老师本人出镜的重建和生成效果图。
理想汽车近期从重建到生成的方案发展,确实Feedforward 3DGS今年提的很多,无需点云初始化,直接由视觉输入得到最终结果。
理想这两年重建方面的工作,两篇顶会。
联合重建&生成方面的工作,一篇顶会。
生成方面的工作,三篇顶会。
生成的应用:从场景编辑,到场景迁移再到场景生成。
新的数据配比,看起来数据上下了不少功夫。
系统能力是增强引擎的关键,世界模型提供的仿真环境、3D资产构建多样化的场景、SimAgents做交互式行为建模、奖励模型准确的反馈泛化能力、GPU工程加速推理。
重点强调了可交互的Agent是训练闭环的关键挑战。
总结一下取得的成果和奖励。
....
#2025年还存活的自动驾驶公司......
近期一个比较明显的信号,L2渗透率狂奔,L3落地在即,L4规模破局。智能驾驶学术界和工业界关注一直都很多,像端到端、VLA、世界模型、强化学习等等技术方向都还在快速发展。秋招期间也有很多小伙伴咨询我们业内都有哪些公司,秋招打算看一看。
相比于前两年,有一些公司已经谢幕,有一些公司在合并/收购的路上,当然也有一些新势力异军突起。自动驾驶行业正在经历新一轮的洗牌和资源整合。今天xxx就为大家全面梳理下2025年智能驾驶相关的公司,有新势力、主机厂、重卡、Robotaxi、Tier1等等,为大家带来行业的全景图,助力大家选择。
1 新势力
蔚来、小鹏、理想、小米、零跑、滴滴、威马、牛创、极氪、阿维塔、岚图、千里科技、极越等
2 Tier1
华为、百度、大疆、中兴、腾讯(智能座舱/高精地图/仿真工具链)、上汽零速、鉴智机器人、momenta、博世中国、麦格纳、佑驾创新minieye等
3 Robotaxi
百度、小马智行、上海造父智能科技(哈啰Robotaxi)、文远知行、元戎启行、滴滴、momenta、轻舟智航、驭势科技等
4 Robotruck
卡尔动力、智加科技、赢彻科技、小马智行、主线科技、斯年智驾、西井科技、飞步科技、牧月科技(文远知行)、挚途科技、畅行智能、环宇智行、希迪智驾、千挂、行猩、友道智途、卡睿智行、前晨、纬度、吉利远程、恒润、宏景、希迪、擎天智卡
5 物流配送
美团、九识智能、京东、苏宁、阿里菜鸟、中国邮政、百度Apollo、威盛电子、新石器、白犀牛、智行者、驭势科技、行深智能、伽智科技、小狮科技、易成等等
6 老牌主机厂
上汽、长安、广汽(埃安)、北汽(极狐)、一汽、长城、比亚迪、吉利(福瑞泰克)、东风、奇瑞、吉利(极氪等)
7 农用自动驾驶
丰疆智能、中联重科、中国一拖、悟牛智能、中科原动力、雷沃重工、超星智能、博创联动、皓行科技等
8 矿区自动驾驶
易控智驾、踏歌智行、慧拓智能、路凯智行、伯镭科技、盟识科技、清智科技
9 环卫自动驾驶
智行者、酷哇、仙途、高仙机器人、深兰科技、浩睿智能、于万智驾、云创智行
10 泊车
百度、追势、德赛西威、东软睿驰、禾多科技、纽励科技、恒润科技、领世科技、魔视智能、欧特明、智行者、驭势科技
11 高精地图
百度、高德、四维图新、腾讯、华为、滴滴、京东、美团、宽凳、深动、中海庭、亿咖通
12 车路协同
蘑菇车联、觉非科技、百度、华为、大唐高鸿、华砺智行、阿里、海康、星云互联、云骥智行
....
#OpenREAD
南洋理工&哈佛提出OpenREAD:端到端RL统一认知与轨迹规划
在自动驾驶研究中,利用大语言视觉语言模型(LLMNLM)学习开放式驾驶知识,进而提升轨迹规划与决策能力,正逐渐成为新的趋势。
然而,传统的监督微调(SFT)范式难以充分挖掘模型的推理潜力,对知识的学习效率也存在不足。DeepSeek-R1的出现向我们展示了强化学习在提升模型推理与思考能力方面的巨大潜力,使模型具备更强的泛化表现。
因此,一个关键问题随之而来:如何通过强化学习增强视觉语言模型的推理能力,让模型“学会思考”,并在同一框架下同时掌握开放式驾驶知识与轨迹规划?这正是基于视觉语言大模型实现端到端自动驾驶所面临的全新挑战。
南洋理工大学与哈佛大学联合推出OpenREAD--一个通过强化学习(RL)全面提升视觉语言大模型(VLM)推理能力的全新框架。
1 方法
该方法引入 Qwen3-LLM作为“评判专家”,将强化学习从传统只适用于可验证的下游任务(如决策、规划),成功拓展到“驾驶建议”“场景分析"等开放式任务,实现从高层语义推理到低层轨迹规划的端到端强化微调。在LingoQA知识评测和NuScenes开环评测中,OpenREAD均取得了SOTA表现。
1.大语言模型作为开放式知识学习的打分器
在自动驾驶领域,现有强化学习多应用于轨迹预测或决策规划等“可验证”的下游任务,因为这些任务可以直接根据真值计算误差。但基于语言的驾驶知识学习属于开放式问题:同一个参考答案可能有多种不同表达方式,这给RL的奖励函数设计带来了很大挑战。
为解决这一问题,我们做了以下两步准备:
(1) 构建带显式思维链(CoT)的知识数据。
我们在LingoQA数据集上使用GPT-4标注了一批包含详细推理过程的驾驶知识数据,覆盖“感知类”与“决策类”两大任务,让模型能够学习到可解释的推理链条。
(2) 将OmniDrive数据集转换为RL可用格式。
我们将其统一转换为“思考+回答”的形式,使其能用于强化学习训练,包含两类任务:轨迹规划与伪轨迹分析。
两个数据集上的示例标注如图所示:
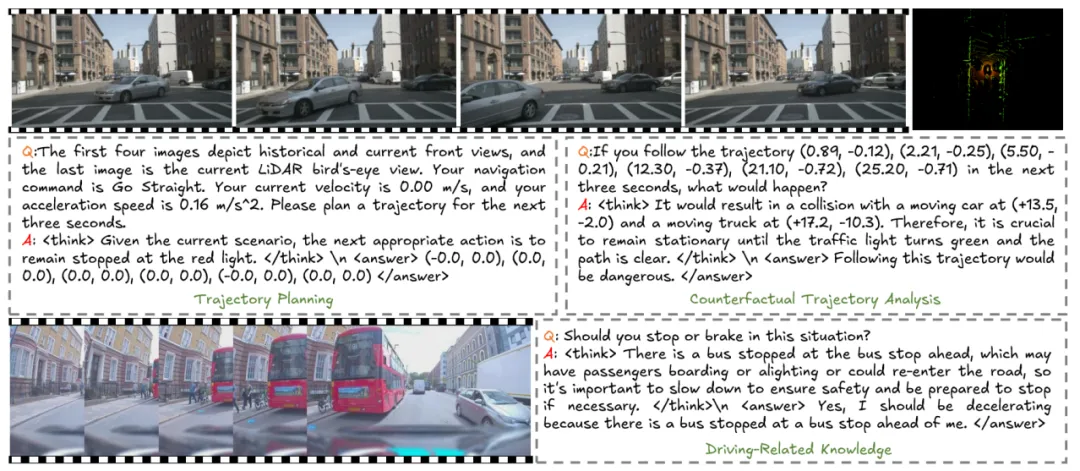
在数据准备完成后,我们先利用CoT标注进行冷启动(cold start),让模型快速获得基础的思考与推理能力。随后进入基于GRPO的强化微调阶段,进一步提升推理能力。在这个阶段,我们引入Qwen3LLM被用作评判专家,将问题、参考答案和模型生成的回答一起作为Owen3-LLM的输入,让其判断模型的预测与参考答案是否一致,如果一致则设置奖励值1,反之为0。
为了让模型的回答不仅正确,还要简洁、不啰嗦,我们进一步计算生成答案与参考答案的embedding余弦相似度,将其作为额外奖励,与Owen3的评判结果共同作用,使模型在语言表达上更加贴近高质量输出。通过这种“专家判断+语义相似度”双重奖励机制,模型得以在开放式驾驶知识学习中获得更稳定且更可靠的推理能力。
2.驾驶知识与轨迹规划的协同强化学习
在解决了开放式知识学习的奖励函数难题后,我们进一步将强化学习同时应用于驾驶知识推理与轨迹规划,实现两类任务的协同训练,模型在学习“如何思考驾驶知识”的同时,也学习“如何利用这些知识进行更合理、更安全的轨迹规划”。
对于轨迹规划任务,我们设计了基于轨迹误差的奖励数。县体来说,我们将轨迹误差作为指数函数的变量,对较远时间点的轨迹误差给予更宽松的容忍度,因为此类误差对即时安全性影响较小;对近距离时间点的轨迹误差设置更严格的要求,以确保模型在关键位置的规划更加精准可靠。
在联合强化学习过程中,一个训练批次内可能包含不同类型的任务(如驾驶决策问答、轨迹规划等),我们为每类任务分别计算其对应的奖励函数,最后综合得到当前批次的整体奖励,用于更新模型参数,使模型能够在知识推理与路径规划之间建立自然的联系,从而提升其整体的驾驶智能。
OpenREAD的整体训练框架如下图所示:
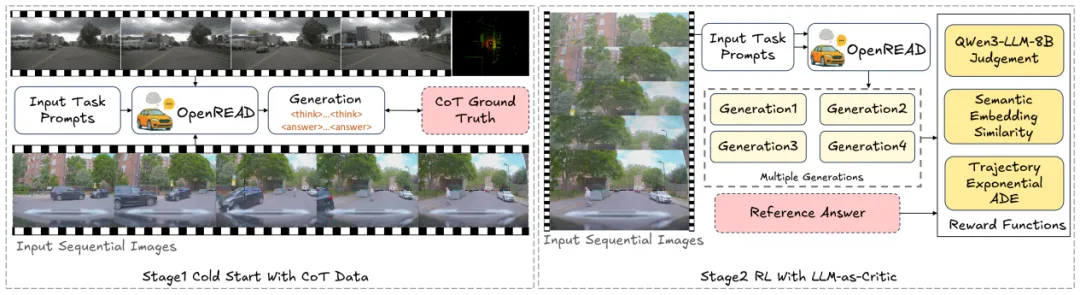
2 实验结果
为了验证强化学习对知识学习和轨迹规划协同微调带来的提升,我们分别在LingoQA和NuScenes数据集上对OpenREAD进行评测。
RFT VS. SFT
从上图可以看到,在仅使用轨迹规划任务的情况下,即使引入强化学习进行微调,轨迹误差和碰撞率的提升都非常有限。随着相关驾驶知识数据的引入,强化学习微调的效果逐渐显现,最终在轨迹误差、碰撞率和相关驾驶知识的评测中,都超过了SFT,证明了引入强化学习同步学习驾驶知识和轨迹规划的必要性。
路径规划评测对比
在与其他现有方法的轨迹规划对比中,OpenREAD取得了更为出色的碰撞控制能力,保证了驾驶的安全性。与同样使用GRPO进行强化学习微调的AutoVLA相比,OpenREAD均取得了更为出色的轨迹误差和碰撞率控制,这一差异也进一步说明引入驾驶知识对下游任务的重要意义。
驾驶知识评测对比
在LingoQA数据集的驾驶知识评测中,OpenREAD超过了先前的WiseAD、RecogDrive等一系列工作,取得了最高的Lingo-Judge准确率:
3 更多可视化结果
RFT与SFT的轨迹规划结果对比。
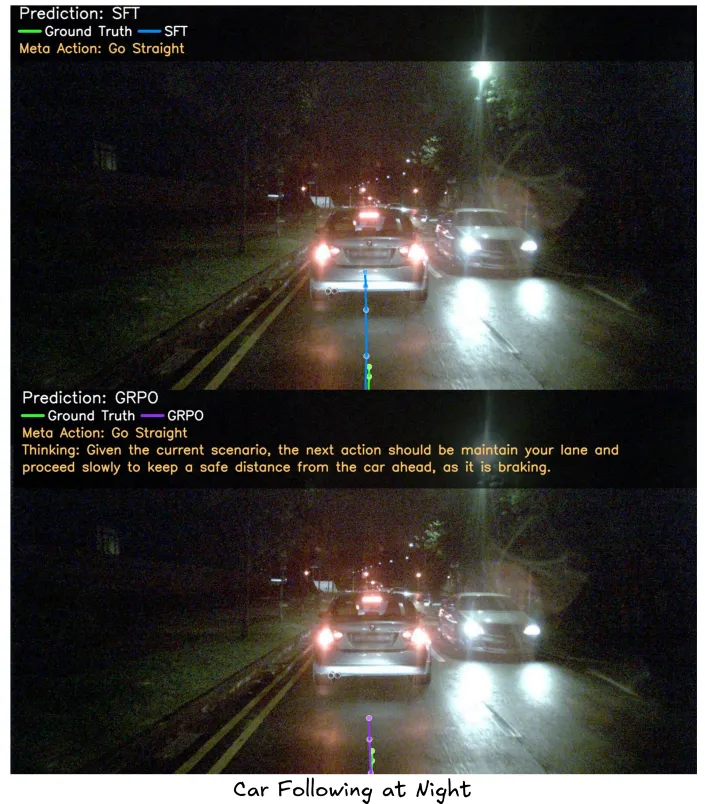
OpenREAD与Owen3-VL和WiseAD在LingoQA上的对比。
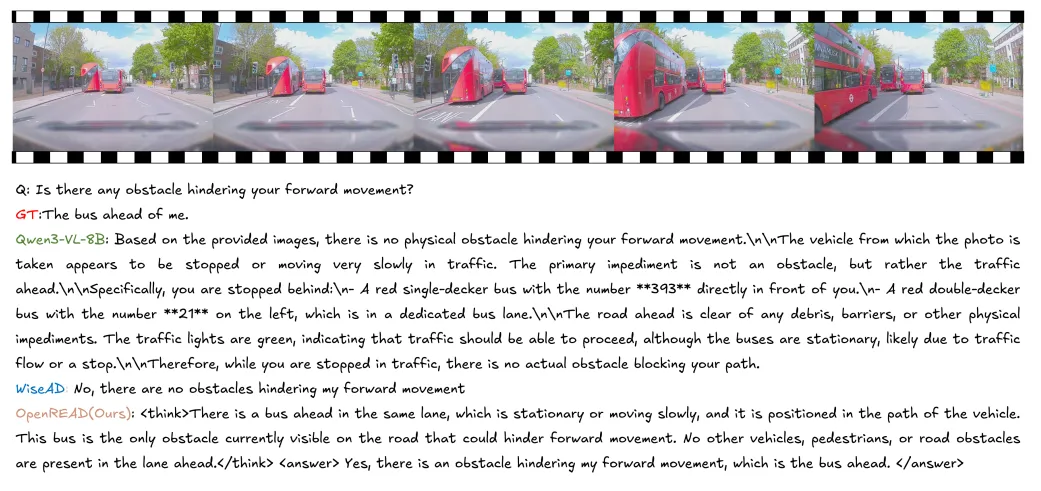
4 总结
OpenREAD通过引入Qwen3-LLM作为“评判专家”,实现了对驾驶知识与轨迹规划的协同强化学习微调,进一步拓展了强化学习在端到端自动驾驶中的应用边界。该框架不仅提升了模型的整体推理与规划能力,也为深入挖掘驾驶知识对下游任务性能的促进作用提供了重要参考。
论文链接:https://arxiv.org/abs/2512.01830
代码链接:https://github.com/wyddmw/OpenREAD
数据连接:https://huggingface.co/datasets/wyddmw/OpenREAD
....
#可能是第一家年销百万的新势力!?
在过去几个月里,零跑的销量节节攀升。
今年三季度零跑共卖出了17.4万辆新车,同比增长101.77%,环比也增长了29.63%,月销量接连突破5万辆、6万辆,四季度首月更是突破了7万辆大关。
在大规模的销量支撑下,零跑汽车也率先跑通了新能源车企的盈利模型。
11月17日发布的三季报显示,零跑汽车三季度净利润1.5亿元,继半年度盈利之后,再度实现单季盈利。而在流动性方面,零跑也保持着正向的经营现金流与自由现金流,在手资金339.2亿元。
这意味着,这家曾经不被看好的造车新势力,已经成功穿越生存考验,其“全域自研”的供应链模式、极强的成本控制能力以及“技术普惠”的产品定价理念,已经赢得了市场的规模化认可。
11月15日,零跑汽车今年的累计销量突破了50万辆。这是一个令人振奋的成绩,原本零跑要用全年去冲刺这个目标,但提前一个半月零跑便越过了这个阶段性的终点线。
零跑汽车创始人、董事长朱江明第一时间在朋友圈转发了这个消息,并自信地立了一个新的目标:明年将冲击100万辆,争取更上一层楼。
以今年50-60万辆的年销量来看,明年100万辆的销量目标几近翻番,这不可谓不激进。但到今天,对于已经连续半年蝉联新势力销量榜首的零跑,这已经不是天方夜谭。
在过去几个月里,零跑的销量还在节节攀升,今年三季度零跑共卖出了17.4万辆新车,同比增长101.77%,环比也增长了29.63%,月销量接连突破5万辆、6万辆,四季度首月更是突破了7万辆大关。
在大规模的销量支撑下,零跑汽车也率先跑通了新能源车企的盈利模型。
11月17日发布的三季报显示,零跑汽车三季度净利润1.5亿元,继半年度盈利之后,再度实现单季盈利。而在流动性方面,零跑也保持着正向的经营现金流与自由现金流,在手资金339.2亿元。
这意味着,这家曾经不被看好的造车新势力,已经成功穿越生存考验,其“全域自研”的供应链模式、极强的成本控制能力以及“技术普惠”的产品定价理念,已经赢得了市场的规模化认可。
零跑拿到了“通行证”
与很多互联网背景的造车新势力不同,零跑自诞生起就有着非常务实的基因——它没有要颠覆行业,也没有想着冲击豪华,而是要做一个年销数百万级的世界级电动车企,类似于燃油车时代的大众、丰田。
基于此,零跑的策略也非常清晰,朱江明曾经做过阐释:“希望零跑的每一款车都能有销量。
在初步踏入汽车领域后,零跑汽车很快规划了A、B、C、D四大产品系列,价格从低到高,覆盖了轿车、SUV、MPV等全面的产品矩阵。
最早推出和上量的是C系列产品,几款中型及中大型SUV凭借着“水桶”的产品配置和实惠价格,在新能源汽车逐渐成为市场主流选择的背景下,成功切入市场腹地。
今年3月,零跑交付了3.7万辆,首次登顶新势力销量榜首。此后,随着B系列等更多新产品的上市及交付,零跑的月销量更是节节攀升,稳居首位。
朱江明的理念正是汽车行业运行百年的朴素规律:可持续盈利的关键就是规模,而规模是车企长期经营的“通行证”。
在连续数月的销量登顶之余,零跑汽车也顺势解决了生存问题,已经连续实现季度盈利。
在刚过去不久的第三季度,零跑汽车在斩获17.4万辆的销量新高时,收入水平也创下新高达到194.5亿元,并且同比也增长了97.3%。
这样的表现超出了市场预期。
今年年中,零跑主推的新车型是更年轻的B系列——比如7月下旬上市的B系列首款轿车B01,自上市次月起月销量便突破了万辆,成为零跑产品矩阵中不容忽视的主力,但它起售价不到9万元。
不过,在车型增加的情况下,零跑汽车还是稳住了财务表现,第三季度零跑的单车售价和毛利率水平均有所回升——相较于第二季度,零跑的单车收入从10.6万元提升至11.2万元,而毛利率则从13.6%回升到14.5%。
单车收入的稳定来源于C系列的车型的持续放量。数据显示,在过去几个月里,零跑之前的销量担当C10、C11、C16等销量仍在持续提升,以终端数据计算的话,这三款车在零跑总销量中的占比仍达到七成左右。
而即便增加了定价相对更低的B系列车型,零跑汽车的毛利率水平还有了显著提升,去年同期,零跑汽车的毛利率还仅有8.2%,也就是说,今年三季度足足提升了4.3个百分点。
这便是规模释放出的强大势能,尤其是对于零跑这样高度平台化的车企而言。零跑的平台化水平可以做到什么程度?朱江明曾经介绍,B系列的零部件通用率高达88%。
如此的平台化率,可以让零跑的销量表现高效反哺到财务数据上:今年三季度,零跑汽车毛利达到28.2亿元,同比增长45%,环比增长248%,增长幅度均优于收入水平。
夯实的毛利为零跑的业务扩展赢得了从容的空间。
当下,零跑仍处于投入扩张期——三季度其研发费用和管理费用也都创下新高,分别为12.1亿元、6.3亿元,比上一季度分别增加了1.2亿元、2.2亿元——但这并未影响零跑的盈利表现,当季还是稳扎稳打地收获了1.5亿净利润,与上一季度相当。
与去年同期相比,零跑汽车已经完成了“由亏转盈”的蜕变,也在理想之后,破除了“造车新势力难以盈利”的魔咒。
如果说2024年是零跑汽车的起势之年,那么今年便是它彻底翻身的转折点。而明年其销量目标已经瞄准百万量级,零跑也将进入高质量盈利的全新阶段。
销量的飞轮转动起来
今年8月,基于超预期的市场表现,零跑汽车将2025全年销量目标从年初定的50-60万辆上调至58-65万辆。
从零跑10月份突破7万辆的表现来看,要实现这样的目标并不难,这也将为零跑实现年度盈利做好业务保障。
而在此基础上,零跑要实现明年100万辆的销量目标,似乎也并不遥远。
以同样主打大众市场的比亚迪为参考,其第100万辆新能源车在2021年5月下线,一年后便迎来了第200万辆车型的下线,第300万辆则只花了半年。
零跑汽车在新势力里也展现了类似的节奏:今年9月25日,零跑第100万台整车下线——从第50万辆到第100万辆,仅用了不到一年的时间。这不仅展现了零跑规模化发展的超快速度,更标志着零跑的体系能力迈向了全新高度。
体系能力最直观的体现就是产品矩阵。
明年,零跑即将完成A、B、C、D四大产品线的全面布局——在C系列、B系列稳固基盘的同时,零跑D系列、A系列也将有新产品上市。
朱江明此前曾介绍,明年还将推出2-3款D系列新品及2款A系列新品。其中,D系列首款车型——旗舰SUV D19已经于10月中旬首秀,而A系列首款车型A10也将在11月21日广州车展亮相。此外,专为年轻人打造的Lafa5也将在11月27日正式上市。
“2026年将是零跑产品投放力度最大的一年,销量增长具备可预期性。”朱江明自信满满地表示。
无论是D系列、A系列还是Lafa,零跑的产品都将遵循一贯的风格——好而不贵。
朱江明曾在D19的首秀发布会后表示,即便是D系列这样的高端产品,也会延续零跑“产品很豪华,价格不豪华”的理念,以成本为核心定价,不会刻意追求高毛利。
这意味着,零跑会以被验证过的成熟打法——领先的配置及优势的价格——将会被复用至更多细分市场,这是零跑的舒适区,也是支撑明年百万级销量的保障。
这对于零跑来说,是其简单直接的经营理念在细分市场和目标用户的扩圈。
在过去一年里,零跑C系列及B系列的主要用户画像为年轻群体,相当一部分是家庭用户,而随着D19、Lafa5等新系列车型的上市,零跑将辐射更多的家庭用户及年轻群体——“向上够一够”,也“向下探一探”。
而已经累积了100万用户的零跑汽车,在如何定义产品层面,也有了比过去更多的心得。
以专为年轻人打造的全球车型Lafa5为例,它既有扎实的操控与加速表现,也有个性化的设计表达,是零跑在布局了多款实用型、走量型产品的基础上补充的“既满足个性化表达、又兼顾实用性”的车型。
零跑高级副总裁曹力坦言,早年零跑曾推出小车S01,更多是觉得轿跑造型很酷,对“用户是否真的喜欢、核心需求是什么”没有做太多深入考量,但今天的零跑已经非常清楚用户的刚需是什么,补充性需求、个性化需求又是什么。
在技术与配置之外,零跑汽车也在进一步磨炼用户需求与产品定义,这无疑为零跑进入更多市场提供了更加坚实的后盾。
站在新阶段的零跑,甚至还尝试为新用户提供情绪价值。比如,Lafa5亮相时发布会的主色调从往日的绿色改成了一抹亮眼的黄色,而D19首秀时,一向“抠搜”的零跑还请了一位代言人——老戏骨费翔。
零跑副总裁周颖表示,过去的产品沟通中,零跑确实更侧重传递产品硬核的一面,把其擅长的技术实力、产品硬实力讲透,但现在,零跑希望在保持这些核心优势的基础上,多传递一些感性理念,让大家看到零跑不一样的特质。
随着产品布局的完善与用户洞察的深化,零跑以“技术创新”驱动的产品经营体系已经臻于成熟,这家新势力也正在从少量爆款的成功,迈向全系列、多车型的规模化胜利。
实现年销百万,对零跑而言并不只是一句空谈,而是响亮的口号,更是其步入高质量发展新阶段、成为主流汽车市场重要一极的里程碑。
....
#Progressive Robustness-Aware World Models in Autonomous Driving
近200文献深度综述!北交大等全景解读驾驶世界模型:生成、规划与增强
自动驾驶(Autonomous Driving, AD)技术正试图让车辆像人类一样思考和驾驶,而驾驶世界模型(Driving World Models, DWM)作为通往通用人工智能(AGI)的核心框架,正成为连接感知、决策与控制的关键桥梁。与传统的端到端模型不同,DWM 不仅关注从传感器到控制的映射,更致力于构建对物理世界的内部表征,预测环境的未来演变。
- 论文标题:Progressive Robustness-Aware World Models in Autonomous Driving: A Review and Outlook
- 作者列表:Feiyang Jia, Caiyan Jia, Ziying Song, Zhicheng Bao, Lin Liu, Shaoqing Xu, Yan Gong, Lei Yang, Xinyu Zhang, Bin Sun, Xiaoshuai Hao, Long Chen, Yadan Luo
- 机构列表:北京交通大学;澳门大学;哈尔滨工业大学;南洋理工大学;清华大学;北京航空航天大学;小米汽车;澳大利亚昆士兰大学
- 论文地址: https://doi.org/10.36227/techrxiv.176523308.84756413/v1
- 项目主页: https://github.com/MoyangSensei/AwesomeRobustDWM
近期,来自北京交通大学、小米汽车、澳门大学、哈尔滨工业大学、清华大学等机构的研究团队,在 TechRxiv 上发布了一篇关于自动驾驶世界模型的重磅综述。该文不仅全面梳理了 DWM 的技术流派,更首创性地提出了“渐进式鲁棒性”(Progressive Robustness)分析范式,将 DWM 的发展划分为 Robustness 1.0(自评测)、Robustness 2.0(系统贡献)和 Robustness 3.0(开放世界)三个阶段,为该领域的未来演进提供了清晰的路线图。
如图 1 所示,DWM 的鲁棒性演进路径揭示了从关注模型自身指标,到强调对 AD 系统的实际贡献,再到解决开放世界挑战的跨越。
什么是驾驶世界模型(DWM)?
世界模型(World Model)的概念最早可追溯到心理学中的“心智模型”,即人类在头脑中构建外部世界的简化抽象。在自动驾驶中,DWM 旨在学习数据空间中的动态模式,具备“理解过去”和“预测未来”的双重能力。
图 2 展示了本综述的整体架构。研究团队将 DWM 的核心任务归纳为三大类:生成(Generation)、规划(Planning)和增强(Enhancement)。
DWM 摄入历史观测数据,通过生成未来场景、辅助运动规划或增强下游任务,从根本上提升自动驾驶系统的安全性和鲁棒性。
图 4 展示了 DWM 领域代表性工作的时间线与贡献分布,清晰地反映了从 Robustness 1.0 到 3.0 的技术演进趋势。
Robustness 1.0:如何通过自评测判断 DWM?
在 Robustness 1.0 阶段,研究焦点在于模型本身的任务定义、架构设计及量化评估。DWM 需要在图像、点云、占据栅格(Occupancy)等多种模态下证明其“预测未来”的能力。
生成任务的量化评估
生成高质量的未来场景是 DWM 的基础能力。针对不同的数据模态,DWM 展现了各自的优势:
- 图像/视频生成:这是目前最普遍的任务。如 Vista 在早期就展现了高分辨率(576×1024)和低 FID(6.9)的生成优势。新近的方法如 MiLA、EOT-WM 和 UniMLVG 则通过引入额外条件(如深度、多视角)进一步提升了空间一致性。
- 点云预测:利用点云的深度信息优势,DWM 如 BEVWorld 和 HERMES 在无额外监督的情况下,实现了 SOTA 的点云预测效果。
- 4D Occupancy 预测:DOME 在 4D Occupancy 预测上取得了显著突破,大幅超越了基准方法 OccWorld。相比纯视觉输入,基于 Occupancy 的方法(如 RenderWorld)通常能提供更鲁棒的环境理解。
表 VI 展示了 DWM 在驾驶场景图像/视频生成上的性能对比。
表 VII 展示了点云重建/预测的性能。
表 VIII 展示了 4D Occupancy 重建/预测的性能。
规划任务的量化评估
规划能力是检验 DWM 是否理解驾驶逻辑的试金石,分为开环和闭环两类:
- 开环规划(Open-loop):在给定历史数据下预测未来轨迹。DriveWorld 通过 4D 预训练显著提升了规划性能;Epona 和 WoTE 在 NAVSIM 评测中展现了极高的 PDMS 分数,证明了 DWM 在开环设置下的优越性。
- 闭环规划(Closed-loop):将 DWM 集成到 Agent 中进行模拟驾驶。Raw2Drive 在 Bench2Drive 榜单上取得了 71.36 的高驾驶分(DS),仅次于使用特权信息的专家方法。这表明 DWM 在长尾场景处理上具有巨大潜力。
表 IX 展示了 nuScenes 验证集上的运动规划性能。
表 XI 展示了 CARLA 平台上的规划性能。
表 XII 展示了 Bench2Drive 基准上的性能。
Robustness 2.0:DWM 是否真正造福了 AD 系统?
Robustness 2.0 关注 DWM 如何反哺自动驾驶系统,主要体现在可控生成、零样本泛化和跨任务增强三个方面。
可控生成(Controllable Generation)
DWM 的核心价值之一是生成多样化、高价值的虚拟数据,特别是针对 Corner Case 的数据补全。
- 静态控制:修改天气、光照或背景。如 UniMLVG 和 DrivingDiffusion 可通过文本调整天气。
- 动态控制:控制车辆行为、轨迹。InfinityDrive 和 GenAD 利用文本指令引导车辆减速或遵守交通规则;Drive-WM 甚至能生成“冲入绿化带”等反事实安全测试场景。
表 XIII 列举了支持可控生成的 DWM 方法。
零样本泛化(Zero-Shot Generalization)
具备 Zero-Shot 能力的 DWM 可以在未见过的场景中进行推理,这是迈向“数据引擎”的关键。Vista 通过协同训练策略,在不依赖动作条件的数据集上实现了动作可控性;Dreamland 则在 MetaUrban 模拟器上展示了针对新型交通工具的零样本生成能力。
表 XIV 总结了具备 Zero-Shot 能力的 DWM。
跨任务增强与人类偏好对齐
DWM 通过预训练范式(如 UniWorld、ViDAR)为下游检测、跟踪、分割任务提供强大的初始化参数和先验知识。同时,Aligning with human preference(与人类偏好对齐)成为提升安全性的关键,ReSim 和 GAIA-2 等工作开始尝试通过用户研究(User Study)来验证生成内容与人类直觉的一致性。
Robustness 3.0:DWM 的下一站是哪里?
展望未来,DWM 需要迈向 Robustness 3.0,应对开放世界的终极挑战。
迈向可信驾驶模拟器
目前的 DWM 虽能生成逼真图像,但离“可信驾驶模拟器”(Trusted Driving Simulator)仍有距离。
- 挑战:缺乏闭环场景下的真实影响评估,且难以对特定语义元素进行精细化干预。
- 方向:开发模块化的 DWM 架构,支持显式语义分解和可控扰动注入,建立开环与闭环相结合的分级评测协议。
统一任务与分层架构
现有的 DWM 任务定义割裂。未来的方向是构建分层世界模型(Hierarchical WM):
- 物理层:表征环境几何。
- 意图层:分析物理规律和决策动机。
- 行为层:建模交通参与者的交互。 这种分层设计将有助于统一感知、预测和规划任务,并提升模型的可解释性。
效率与可解释性
- 效率:如表 XV 所示,DWM 的训练极其消耗资源(如 Vista 使用了 128 张 A100,训练时长达 24576 GPU Hours)。未来的重点是模型轻量化、知识蒸馏及端侧部署优化。
- 可解释性:打破“黑盒”,利用 LLM 和 VLA(视觉-语言-动作)架构,让 DWM 能够解释“为什么生成这条轨迹”或“为什么做这个决策”,建立人类信任。
表 XV 展示了 DWM 的 GPU 资源消耗情况,高昂的算力成本是落地的一大阻碍。
写在最后
从 Robustness 1.0 的自证其名,到 Robustness 2.0 的赋能系统,再到 Robustness 3.0 的开放世界征途,自动驾驶世界模型正处于爆发的前夜。感兴趣的朋友继续跟进github上的项目,获取后续进展。
....
#基于Qwen3-VL的自动驾驶场景实测......
近年来,多模态大模型在自动驾驶领域的潜力逐渐显现。它们能否真正“看懂”路况、理解交通行为、甚至预测风险,成为行业内外关注的焦点。
笔者对近期阿里通义最新的Qwen3-VL模型进行了一系列自动驾驶场景的实测,涵盖场景理解、空间推理、行为判断、风险预测等多个维度。
个人认为,Qwen3-VL不仅在基础感知任务上表现稳健,更在开放式推理与动态场景理解中展现出令人惊喜的“老司机”潜质。
更重要的是,它并未经过专门的自动驾驶指令微调(SFT),却能对复杂交通场景做出合理、连贯、甚至带有“安全意识”的判断——这让我们看到了通用视觉语言模型在垂直领域中落地的更多可能。
本次测试选取了CoVLA基准中的部分图像,以及基准中的一些中翻后的问题。此外笔者也自拟了一些开放式问题。
场景理解和空间推理
示例1
👨🎓:简单描述一下这张图片。
👨🎓:图片中的天气如何?
👨🎓:车辆正行驶在哪种道路?
👨🎓:你可以在图片中看到行人或车辆吗?
示例2
👨🎓:简单描述一下这张图片。
👨🎓:图片中的天气如何?
👨🎓:车辆正行驶在哪种道路?
👨🎓:你可以在图片中看到行人或车辆吗?
示例3
👨🎓:距离自车最近的车辆是什么?
👨🎓:前方那辆车是在移动还是静止的?
👨🎓:旁边车道的车有变道意图吗?
示例4
👨🎓:前方有多少辆车?在什么位置?
👨🎓:自车当前行驶在哪个车道上?前方有几条车道线?
👨🎓:图片中有交通信号灯吗?如果有,是什么颜色?
行为决策和因果推理
示例1
👨🎓:基于当前情况,自车应该加速、减速还是保持速度?
👨🎓:图中最大的潜在危险是什么?
👨🎓:图中的交通标志是什么?遇到这个标志,我们应该怎么做?
示例2
👨🎓:我们现在应该变道吗?为什么?
👨🎓:请按危险程度对图像中的交通参与者进行排序。
👨🎓:为什么旁边的车在闪灯?
👨🎓:为了安全超车,我们应该怎么做?
时序(多帧图像输入)与动态变化理解
示例1
👨🎓:前方车辆的相对速度是在增加还是减少?
👨🎓:请解释交通流从畅通到拥堵的演变过程。最初是什么事件引发了拥堵?
👨🎓:基于前方车辆的连续运动,现在超车是否安全?
示例2
👨🎓:左边的两辆车为什么在闪灯?
👨🎓:在这个动态场景中,哪个交通参与者的行为最危险?为什么?
👨🎓:请模拟一下,如果旁边停靠的车辆突然爆胎,整个场景会如何演变?
(这里太长了就不放思考过程了)
测试亮点回顾
在本次实测中,Qwen3-VL展现了以下几大能力:
- 精准的场景理解:能准确描述道路结构、交通参与者、天气状况、交通标志等;
- 深度的空间推理:能判断车辆相对位置、运动状态、车道关系等;
- 动态行为预测:能分析车辆意图(如变道、闪灯原因)、评估风险等级;
- 安全意识突出:在判断是否超车、是否变道等问题时,多次强调“安全第一”,体现出良好的驾驶伦理观;
- 多帧时序理解:能基于连续图像推断速度变化、交通流演变过程,展现出对动态场景的连贯认知。
💡 总结与展望
Qwen3-VL在这次自动驾驶场景测试中表现出了强大的通用视觉语言基础能力。它不仅能“看到”图像中的内容,更能“理解”场景背后的逻辑与风险,甚至在未经过专门训练的情况下,展现出接近人类驾驶员的常识判断与安全意识。
这让我们有理由相信:未来,基于通用大模型的自动驾驶系统,或许不再需要海量场景数据的反复打磨,而是通过“常识推理+多模态理解”的方式,实现更高效、更泛化、更可信的驾驶决策。
当然,模型仍有一些细节需要优化——例如在极端复杂场景下的反应一致性、对罕见交通标志的识别等。但总体而言,Qwen3-VL已经为我们描绘出一个更加智能、更具理解力的自动驾驶未来。
....
#2025年的博世,正在脱胎换骨......
作为国际Tier1巨头的博世,今年也被国内智驾的飞速发展卷到了。根据最新的信息,博世汽车电子猛抓预研和量产两条线。量产方面博世投入更多的资源落地一段式端到端,近期也招聘到不少技术专家加入。xx也期待博世后续的量产车型,并会在第一时间跟进。
预研方面,我们看到了很多优秀的算法工作,其中不少xx都首发报道过。在这些已经公开的工作中,有几位值得大家留意:Ren Liu,Yao Yuhan,Sun Hao,Zhang frank,Jiang Anqing,Zhang Youjian等等。整体上来看,博世在自驾以下几个方向投入较大:
- 端到端和VLA:打榜的DiffVLA、Diffuson改进AnchDrive、FlowDrive、闭环强化学习框架IRL-VLA、纯血Impromptu VLA等等;
- 静态感知:中稿IROS的SparseMeXT和在线地图工作DiffSemanticFusion;
此外还有一些闭环仿真方面的工作DGS(NeurIPS 2025)和视觉基础模型DINO-R1等。作为一家近140年的老牌企业,博世的工程师文化非常浓厚。柱哥有幸和博世的几位技术专家交流过,更能切身感受到他们务实的精神。相比去年,博世可谓成果颇丰,大方向上博世跟上了前沿的脚步并开始打造自己的特色。本文精选了博世汽车业务近期的优秀工作,为大家一窥其最新的研究图景。
PS. 推荐阅读
DGS(NeurIPS 2025)
- 论文标题:DGS: Dense Depth Regularization for LiDAR-free Urban Scene Reconstruction
- 论文链接:https://arxiv.org/abs/2510.25173
- 提出机构:武汉大学, 上海交通大学, 同济大学, 博世, 南洋理工大学
- 一句话总结:D²GS是一种仅依赖相机输入的动态城市街景重建框架,通过多视角深度估计初始化、渐进式剪枝策略、扩散增强的深度优化模块以及道路几何强先验建模,在无需LiDAR的情况下实现了与LiDAR监督方法相媲美甚至更优的几何重建与深度估计质量。
- 核心贡献:
- 提出了一种完全LiDAR-free的动态城市街景重建流水线,避免了实际应用中LiDAR与相机之间的标定误差、时空不同步和数据稀疏性问题,显著降低了数据采集与系统部署的复杂度与成本。
- 设计了渐进式剪枝策略,从密集的多视角深度点云中高效筛选出具有全局几何一致性的高斯点集,实现了从冗余初始化到紧凑、高质量几何表示的平稳过渡,兼顾了计算效率与重建精度。
- 创新性地引入了基于扩散先验的深度增强模块,通过参考损失、多视角扭曲损失与平滑损失的联合优化,迭代地利用当前高斯几何引导深度扩散过程,生成密集、准确且多视角一致的度量深度图,为高斯训练提供了强有力的几何监督。
- 在场景图表示中集成了专用道路节点,通过对高斯的位置、法向和平坦性施加强几何约束,显式建模地平面先验,显著提升了道路区域的几何重建与深度估计精度。
- 在Waymo Dynamic32数据集上的大量实验表明,D²GS在图像重建(PSNR/SSIM/LPIPS)和深度估计(L1/RMSE/Abs Rel)指标上均超越现有LiDAR监督及LiDAR-free方法,验证了其有效性与先进性。
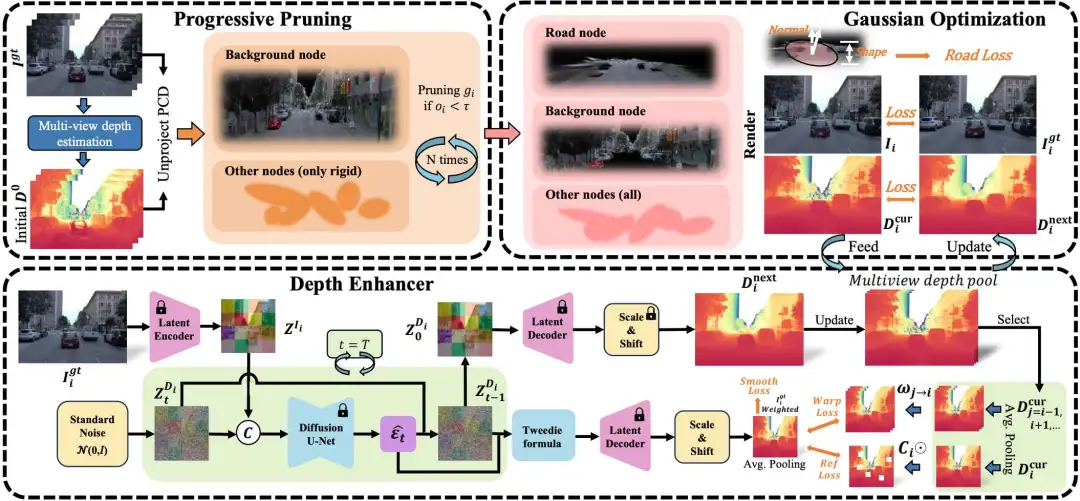
FlowDrive
- 论文标题:FlowDrive: Energy Flow Field for End-to-End Autonomous Driving
- 论文链接:https://arxiv.org/abs/2509.14303
- 项目主页:https://astrixdrive.github.io/FlowDrive.github.io/
- 提出机构:上海交通大学,博世,清华大学(AIR),上海大学
- 一句话总结:针对现有端到端自动驾驶规划方法在BEV特征中缺乏显式、可解释的安全与语义先验建模,以及运动意图预测与轨迹生成任务耦合导致的梯度冲突问题,FlowDrive 提出了一种融合能量流场表示、流感知锚点细化与任务解耦扩散规划的创新框架,通过物理可解释的流场显式编码风险与车道先验,实现更安全、可解释且符合交规的轨迹生成。
- 核心贡献:
- 提出了基于能量的流场表示法,在BEV空间中显式建模风险势能场与车道吸引场,将几何约束与规则语义编码为连续的空间能量分布,为规划提供结构化、可解释的安全与引导先验。
- 设计了流感知锚点细化模块,利用流场梯度动态调整初始轨迹锚点,使其与能量最低(即最安全、最符合车道引导)的区域对齐,从而提升轨迹初始化的空间合理性与意图一致性。
- 提出了任务解耦的运动生成规划器,通过特征级门控机制将高层运动意图预测与底层轨迹去噪生成分离,缓解了多任务学习的梯度干扰,并利用条件扩散模型生成多样且目标一致的轨迹分布。
- 在NAVSIM v2基准测试上取得了最先进的性能(EPDMS: 86.3),在安全性、轨迹质量、交通规则遵守等多个指标上超越现有基线,验证了流场引导与任务解耦设计对提升自动驾驶规划安全性、可解释性与鲁棒性的有效性。
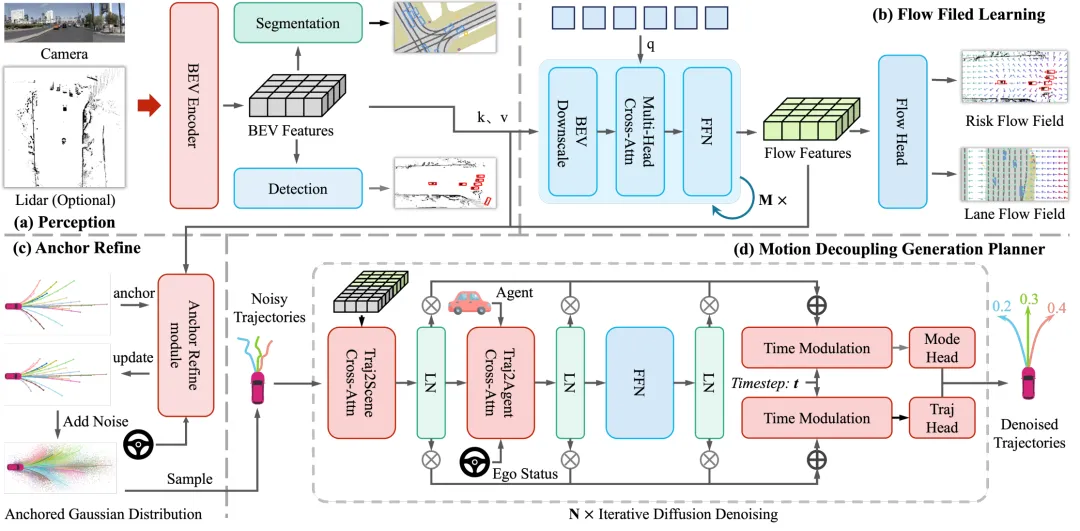
AnchDrive
- 论文标题:AnchDrive: Bootstrapping Diffusion Policies with Hybrid Trajectory Anchors for End-to-End Driving
- 论文链接:https://arxiv.org/abs/2509.20253
- 提出机构:上海大学、博世、上海交通大学、西交利物浦大学
- 一句话总结:AnchDrive提出一种基于混合轨迹锚点初始化的截断扩散策略,通过动态生成与静态先验相结合的锚点集合,显著提升了扩散模型在端到端自动驾驶轨迹生成中的效率与性能,实现了在少量去噪步骤下生成高质量、多样化的安全轨迹。
- 核心贡献:
- 提出混合轨迹锚点机制,首次将动态锚点(由实时感知特征生成)与静态锚点(从大规模人类驾驶数据中预采样)融合,为扩散过程提供高质量初始化,既保留场景适应性,又具备跨场景泛化能力。
- 设计双分支感知架构,结合密集BEV特征与稀疏实例级特征(如障碍物、车道线等),为规划模块提供兼具全局语境与局部结构信息的丰富表征,增强了对复杂交通场景的理解能力。
- 引入锚点引导的截断扩散策略,将扩散过程从纯噪声初始化改为从锚点开始,大幅减少去噪步数(仅需2步),在保持生成质量的同时显著降低推理延迟,满足实时规划需求。
- 在NAVSIM v2闭环仿真基准上取得SOTA性能(EPDMS: 85.5),显著超越基于固定轨迹词表的方法(如VADv2、Hydra-MDP)及其他扩散基线(如DiffusionDrive),验证了方法在多样化、长尾场景下的鲁棒性与泛化能力。
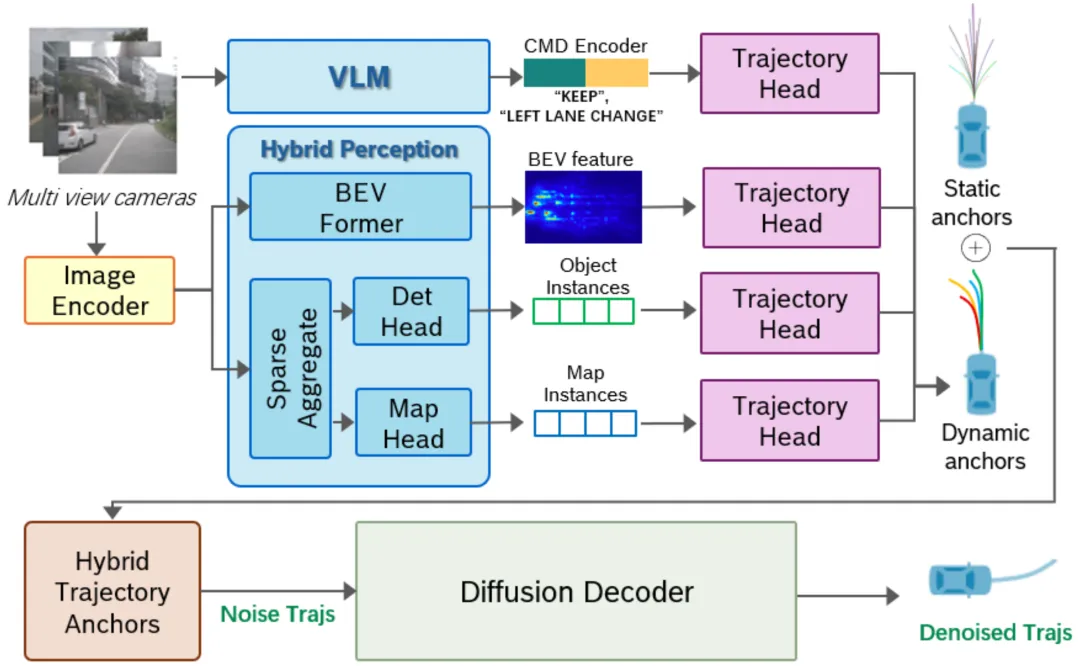
DiffSemanticFusion
- 论文标题:DiffSemanticFusion: Semantic Raster BEV Fusion for Autonomous Driving via Online HD Map Diffusion
- 论文链接:https://arxiv.org/abs/2508.01778
- 项目主页:https://github.com/SunZhigang7/DiffSemanticFusion
- 提出机构:博世、上海大学、上海交通大学、清华大学AIR等
- 一句话总结:针对在线高精地图在噪声、不完整场景下的不稳定问题,提出DiffSemanticFusion框架,通过地图扩散模块增强地图表达的稳定性与语义丰富性,并结合栅格、图结构与BEV特征的多模态融合,显著提升轨迹预测与规划任务的鲁棒性与性能。
- 核心贡献:
- 在线HD地图扩散模块:首次在轨迹预测与规划任务中引入地图扩散机制,通过可学习的去噪过程提升在线地图在噪声、缺失情况下的可靠性与一致性,增强下游任务的鲁棒性。
- 语义栅格BEV融合架构:设计了一种统一的BEV空间融合方法,有效整合栅格图像、图结构表示与密集BEV特征,充分发挥各模态在几何结构、语义关系与空间连续性方面的互补优势。
- 多任务SOTA性能验证:在nuScenes轨迹预测任务中,将QCNet性能提升5.1%;在NAVSIM端到端自动驾驶规划任务中,尤其在NavHard复杂场景下取得15%的性能提升,展现了方法的强泛化能力与场景适应性。
- 模块兼容性与可扩展性:地图扩散模块与多种矢量式方法(如VectorNet、QCNet)兼容,可灵活集成于现有预测与规划流程,具备良好的工程落地潜力。
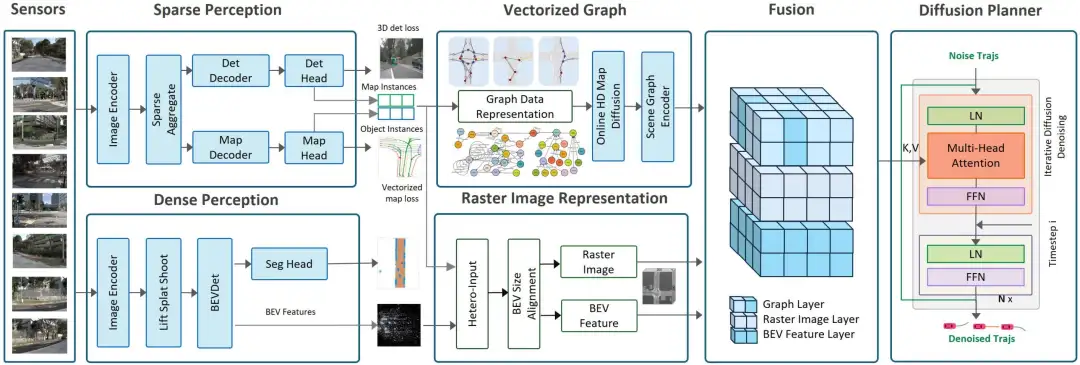
IRL-VLA
- 论文标题:IRL-VLA: Training an Vision-Language-Action Policy via Reward World Model
- 论文链接:https://arxiv.org/abs/2508.06571
- 项目主页:https://github.com/IRL-VLA/IRL-VLA
- 提出机构:博世、上海大学、上海交通大学、清华大学等
- 一句话总结:针对当前视觉-语言-动作模型在自动驾驶中存在的开环模仿学习性能受限、闭环训练依赖高仿真模拟器且计算效率低两大挑战,IRL-VLA提出一种基于奖励世界模型的闭环强化学习框架,通过三阶段训练(模仿预训练→逆环境学习奖励模型→奖励引导的强化学习微调),在不依赖高保真仿真的情况下实现安全、舒适与效率均衡的端到端驾驶策略优化,在NAVSIM v2基准上取得领先性能。
- 核心贡献:
- 提出IRL-VLA框架,首次实现了不依赖仿真器的、基于传感器输入的闭环VLA强化学习,通过逆强化学习构建轻量级奖励世界模型,替代传统高计算成本的仿真器奖励计算,实现了可扩展、高效的闭环训练。
- 设计了分层推理的VLA模型架构,融合语义推理、三维几何推理与扩散规划器,在模仿学习阶段即表现出优秀的性能基础,为后续强化学习微调奠定坚实基础。
- 构建了基于EPDMS的奖励世界模型,利用多目标驾驶指标(如无责碰撞、可行驶区域合规、交通灯合规、舒适度等)进行逆强化学习,实现了对驾驶行为多维度、细粒度的奖励建模。
- 在NAVSIM v2端到端驾驶基准上取得先进性能,EPDMS得分达74.9,在CVPR2025自动驾驶大奖赛中获得亚军,验证了框架在安全、舒适和效率方面的综合优势,为闭环自动驾驶VLA研究提供了新范式。
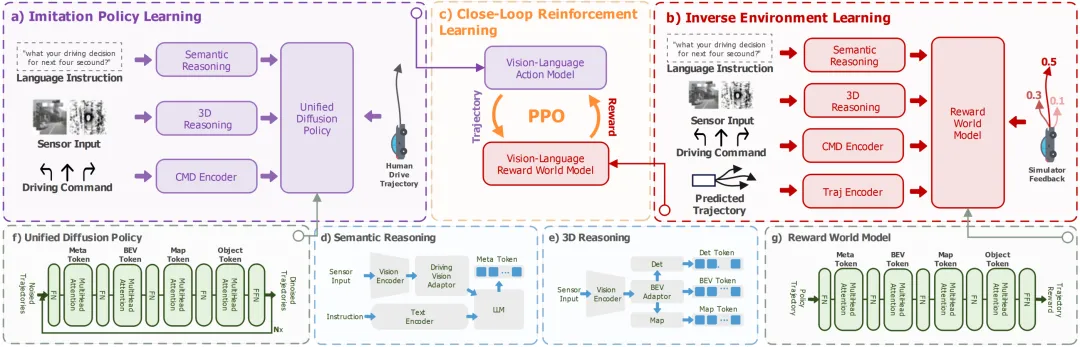
SparseMeXT(IROS 2025)
- 论文标题:SparseMeXT Unlocking the Potential of Sparse Representations for HD Map Construction
- 论文链接:https://arxiv.org/abs/2505.08808
- 提出机构:博世、上海大学、清华大学AIR、西交利物浦大学
- 一句话总结:本文系统性地重新设计并优化了基于稀疏表示的在线高精地图构建方法SparseMeXT,首次在nuScenes数据集上使稀疏方法的精度和效率全面超越现有密集BEV方法,实现了稀疏表示在HD地图构建任务中的突破性进展。
- 核心贡献:
- 针对地图任务优化的稀疏网络架构:提出专门为地图特征提取设计的网络结构,通过优化特征聚合与表示学习,解决现有基于3D检测的稀疏架构在地图任务中覆盖范围大、空间一致性要求高的不适应问题,显著提升了特征提取效率与表达能力。
- 稀疏-密集辅助分割监督机制:设计了一种基于查询的稀疏-密集实例到分割辅助任务,弥补了稀疏范式中缺少显式BEV特征网格的不足,使模型能够有效利用全局语义与几何信息,增强了地图重建的完整性与准确性。
- 基于物理先验的查询去噪策略(PPDN):针对地图元素的曲线结构特点,设计了包含旋转、平移、缩放和曲率调整四种物理噪声模式的去噪训练模块,通过引入符合真实几何约束的噪声扰动,显著提升了模型训练的稳定性与预测鲁棒性。
- 全面的性能优势验证:在nuScenes数据集上,SparseMeXT系列模型在保持高效率(最高32.9 FPS)的同时,mAP显著领先于现有稀疏与密集方法,其中SparseMeXT-Large达到68.9% mAP,长距离感知(90m范围)任务上亦大幅领先,证明了稀疏方法在高精地图构建中的强大竞争力与实用潜力。
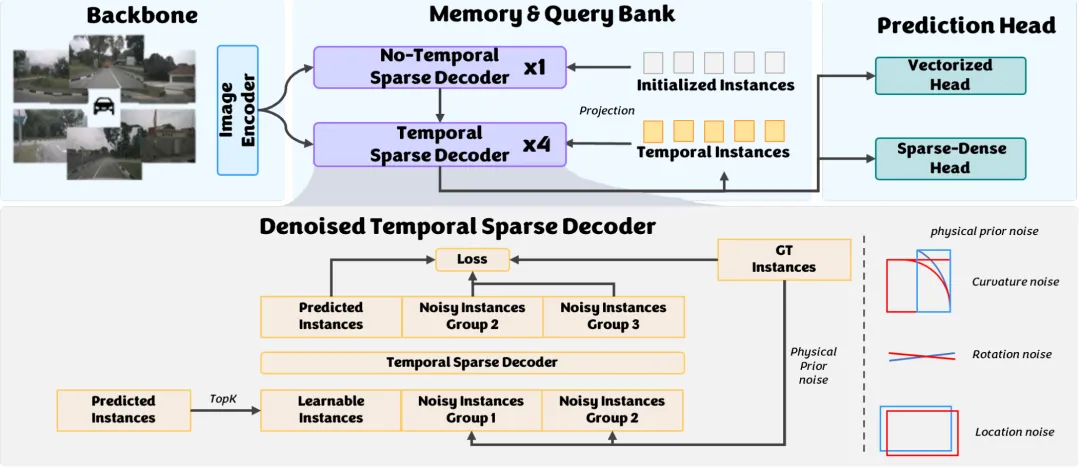
Impromptu VLA
- 论文标题:Impromptu VLA: Open Weights and Open Data for Driving Vision-Language-Action Models
- 论文链接:https://arxiv.org/abs/2505.23757
- 项目主页:http://impromptu-vla.c7w.tech/
- 提出机构:清华大学 AIR,博世
- 一句话总结:为解决自动驾驶模型在“长尾”非结构化道路场景(如模糊路界、临时交通规则、非常规障碍物等)中性能不足的问题,本研究提出并构建了大规模、高质量、多任务标注的Impromptu VLA 数据集,该数据集从超 200 万原始片段中精选约 8 万段,并系统定义了四类非结构化场景分类体系;实验表明,基于该数据集训练的 VLA 模型在闭环安全评估与开环轨迹预测任务上均取得显著性能提升,同时其规划导向的问答体系可作为诊断工具,精准评估模型在感知、预测与规划等维度的能力演进。
- 核心贡献:
- Impromptu VLA 数据集:首个大规模、公开可访问、专注于多样化非结构化驾驶场景的数据集,包含约 8 万段视频片段,覆盖“边界不清道路”“临时交通规则变化”“非常规动态障碍物”“恶劣道路条件”四大挑战类别,并提供了丰富的多任务问答注释及动作轨迹,有效填补了现有自动驾驶数据在非结构化场景上的空白。
- 系统化非结构化场景分类学与自动化数据构建流水线:提出了一套数据驱动的非结构化道路场景分类体系,并设计了一个以视觉语言模型(VLM)为核心的自动化数据筛选、分类与标注流程,结合链式思维(CoT)推理与人工验证,实现了高质量、可扩展的多任务标注生成。
- 全面的实验验证与诊断能力证明:通过闭环(NeuroNCAP)与开环(nuScenes 轨迹预测)基准测试,实证了使用 Impromptu VLA 数据集训练的 VLA 模型在安全评分、碰撞率及轨迹精度上均有显著提升;同时,数据集自带的规划导向问答验证集被证明是一个有效的诊断工具,能够清晰量化模型在感知、预测与规划等关键能力上的进步。
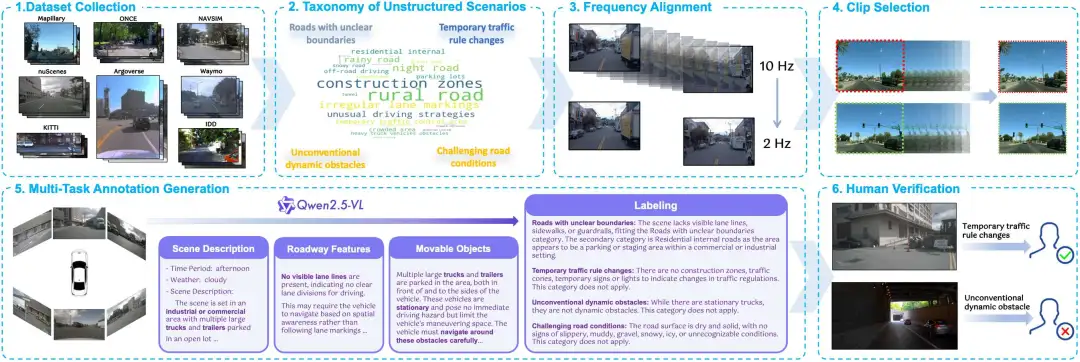
DiffVLA
- 论文标题:DiffVLA: Vision-Language Guided Diffusion Planning for Autonomous Driving
- 论文链接:https://arxiv.org/abs/2505.19381
- 提出机构:博世(RIX),清华大学(AIR),上海大学,上海交通大学,东南大学
- 一句话总结:本文提出DiffVLA,一种面向自动驾驶的视觉-语言引导扩散规划框架,通过结合视觉语言模型的语义引导、混合稀疏-稠密感知以及高效的扩散轨迹生成,在复杂闭环场景中实现安全、多样且拟人的驾驶行为生成,显著提升端到端自动驾驶系统的决策鲁棒性与泛化性能。
- 核心贡献:
- 提出一种新颖的混合稀疏-稠密扩散策略,将稠密BEV特征与稀疏实例级感知(如障碍物、车道线)相结合,增强对动态场景的结构化理解与碰撞规避能力。
- 引入VLM命令引导模块,基于Senna-VLM架构实现多视角图像与导航指令的融合理解,输出高层驾驶决策(横向/纵向控制),为扩散规划提供语义层面的行为引导。
- 设计基于轨迹词汇的离散化扩散规划器,通过构建轨迹词汇表并结合截断扩散策略与层次化信息编码,实现高效、多模态的轨迹生成与优化。
- 在NAVSIM v2闭环评测基准上取得领先性能,综合指标EPDMS达到45.0,并在碰撞率、可行驶区域合规性、交通信号遵守等多个子任务上表现优异,验证了框架在真实与合成复杂场景中的有效性与鲁棒性。
- 提出两阶段训练策略,分阶段优化VLM、稀疏感知、稠密感知与规划模块,并在训练中冻结部分模块以提升稳定性和收敛效率,为大规模端到端自动驾驶系统训练提供了可行方案。
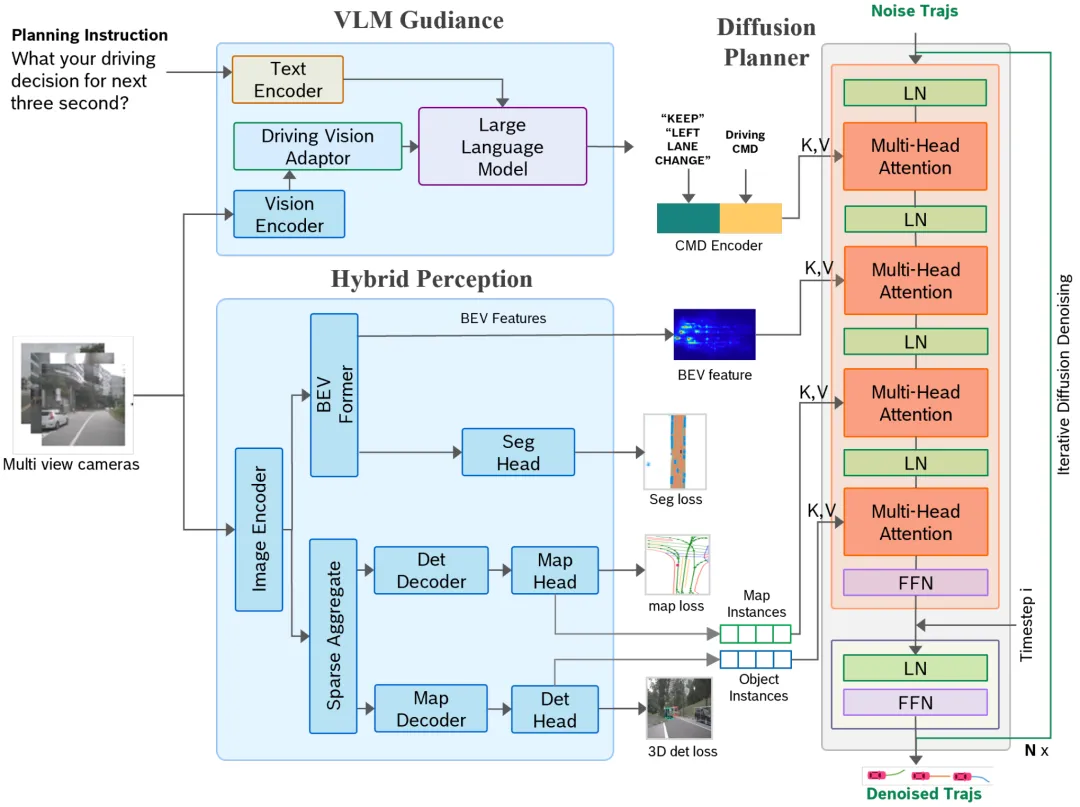
DINO-R1
- 论文标题:DINO-R1: Incentivizing Reasoning Capability in Vision Foundation Models
- 论文链接:https://arxiv.org/abs/2505.24025
- 项目主页:https://christinepan881.github.io/DINO-R1
- 提出机构:博世北美研究中心,博世人工智能中心,得克萨斯农工大学
- 一句话总结:受语言模型中强化学习推动推理能力进步的启发,本研究首次将类似思想引入视觉基础模型,提出Group Relative Query Optimization训练策略,通过查询级相对奖励与KL正则化,显著提升了视觉提示检测中的泛化与推理能力,为视觉模型的“思考式”训练开辟了新路径。
- 核心贡献:
- 提出Group Relative Query Optimization,首个面向视觉提示检测的强化式训练范式,通过组内查询的相对奖励机制,实现对高方差视觉样例的鲁棒对齐与泛化。
- 设计了查询级相对奖励模块与KL散度正则化策略,前者通过组归一化优势信号增强查询表达与监督密度,后者通过约束目标分布稳定性防止训练漂移与灾难性遗忘。
- 构建了VIS-G-DINO视觉提示检测框架及其强化训练版本DINO-R1,实现了从文本提示到视觉提示的无缝扩展,并在训练中融入了视觉引导的查询选择机制。
- 在COCO、LVIS和ODinW等多个数据集上系统验证了DINO-R1的优越性,其在零样本与微调设置下均显著优于传统监督微调基线,展现出更强的跨域泛化与视觉上下文推理能力。
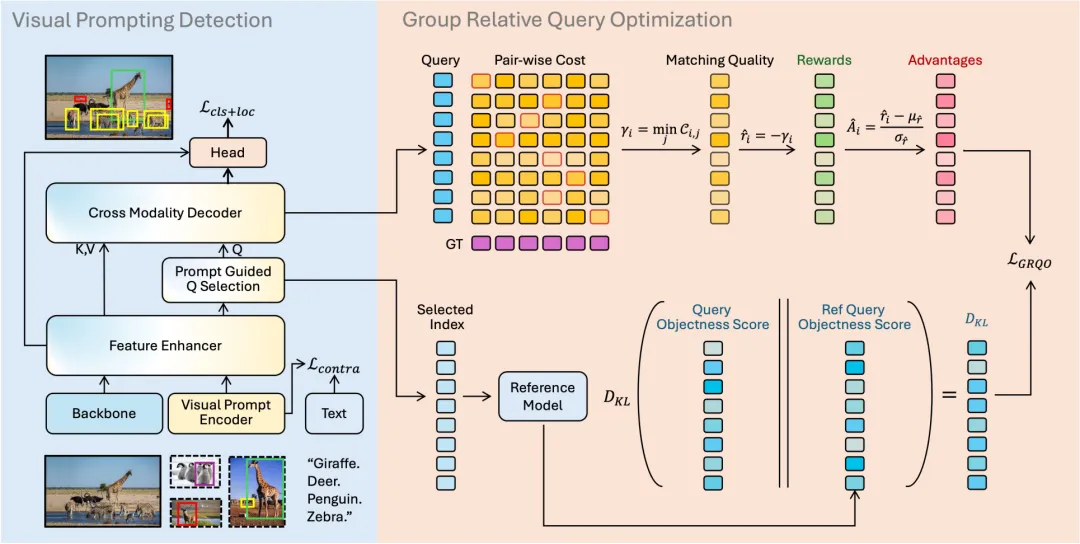
....

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献28条内容

所有评论(0)