51c自动驾驶~合集60
我自己的原文哦~ https://blog.51cto.com/whaosoft143/13987792
#Waymo World Model
Waymo联手DeepMind打造世界模型:基于Genie 3,让自动驾驶「脑补」罕见场景
刚刚,Alphabet 旗下的自动驾驶汽车公司 Waymo,推出了最新世界模型 Waymo World Model,其基于 DeepMind 的 Genie 3 构建,在大规模、超真实自动驾驶仿真方面树立了全新的行业标杆。

DeepMind CEO、诺奖得主 Demis Hassabis 也转推分享说这个基于 Genie 3 模拟的用例「超酷」。

Waymo World Model 建立在 Google DeepMind 的通用世界模型 Genie 3 之上,能够生成高度逼真且可交互的 3D 环境,并针对自动驾驶的严格需求进行了专业化适配。凭借 Genie 丰富的世界知识,它可以模拟极为罕见的事件 —— 从龙卷风到偶遇大象 —— 这些在现实中几乎无法大规模复现。
同时,模型架构高度可控,工程师可通过简单的语言提示、驾驶输入或场景布局快速调整仿真内容。更重要的是,Waymo World Model 支持生成高保真、多传感器数据,包括摄像头图像和激光雷达点云,为自动驾驶系统提供全面、逼真的训练与测试环境。
Waymo 表示,Waymo Driver 已累计完成近 2 亿英里的完全自动驾驶行驶,成为美国多个主要城市运行体系中的一部分,并持续提升道路安全性。但公众往往看不到的是,在真正驶上公共道路之前,这套系统早已在虚拟世界中行驶了数十亿英里,反复演练各种复杂、罕见甚至极端的交通场景。Waymo World Model 正是支撑这一能力的核心基础设施,使自动驾驶系统能够在现实世界之外,提前掌握应对真实世界的能力。
,时长00:14
Waymo Driver 避开逆向行驶车辆的仿真演示。该仿真首先重现了真实事件,然后平滑过渡,使用 Waymo World Model 实时高效生成的摄像头图像和激光雷达点云进行模拟。
接下来我们看看 Waymo 世界模型在实际运行中的表现,包括 Waymo Driver 在各种罕见、极端边缘场景中的仿真驾驶过程。
涌现的多模态世界知识
自动驾驶行业中的大多数仿真模型,都是仅基于自身采集的道路数据从零开始训练的。这种方式意味着系统只能从有限的真实经验中学习。相比之下,Genie 3 在极其庞大且多样化的视频数据上进行预训练,由此获得了强大的世界知识,从而可以探索车队从未直接经历过的场景。
通过专门设计的后训练流程,Waymo 将这些庞大的 2D 视频世界知识迁移到了 Waymo 硬件套独有的 3D 激光雷达输出中。摄像头擅长呈现丰富的视觉细节,而激光雷达则提供了提供了宝贵的互补信号,如精确的深度信息。Waymo 世界模型可以跨多种传感器模态生成几乎任何场景 —— 从日常驾驶到极为罕见的「长尾」场景。
极端天气与自然灾害示例
车辆行驶在覆盖着薄雪的金门大桥上,前置摄像头画面中还能看到 Waymo 的影子;
,时长00:03
在极端天气中,车辆遭遇龙卷风的情况:
,时长00:03
罕见且对安全至关重要的事件
在车辆行驶过程中,鲁莽的驾驶员操作不当,驾着车驶离公路:
,时长00:03
行走在道路上,一辆故障卡车逆向行驶,堵塞了道路:
,时长00:03
遇到诸如大象、长角牛等动物或事物时的罕见情况
车辆行驶在道路上,迎面遇到一只大象:
,时长00:03
车辆行驶在道路上,与一只德克萨斯长角牛相遇:
,时长00:03
强大的模拟可控性
Waymo 世界模型提供了强大的模拟可控性。而这仰赖三种主要机制:驾驶行为控制、场景布局控制和语言控制。
驾驶行为控制能够创造一个响应迅速的仿真器,遵循特定的驾驶输入。这使得我们能够模拟「如果…… 会怎样」的反事实事件,例如在特定情况下,Waymo 驾驶系统是否可以更自信地安全驾驶,而不是让行。
反事实驾驶。下面 Waymo 展示了在过往记录驾驶的原始路径或全新路径下的仿真结果。虽然纯重建式仿真方法(例如 3D 高斯溅射,或 3DGS)在模拟路径与原驾驶路径差异过大时,由于缺少观测数据而容易出现视觉失真,但完全基于学习的 Waymo 世界模型凭借其强大的生成能力,仍能保持良好的真实感和一致性。

场景布局控制允许自定义道路布局、交通信号灯状态以及其他道路使用者的行为。通过这种方式,可以通过选择性放置其他道路使用者,或对道路布局应用自定义变异,来创建定制场景。
场景布局条件控制遵从

语言控制是 Waymo 世界模型最灵活的工具,可以用来调节一天中的时间、天气状况,甚至生成完全合成的场景(例如前文展示的长尾场景)。
世界变异:时间

世界变异:天气

行车记录视频的转换
在一次风景优美的行程中,人们常会用手机或行车记录仪记录沿途视频,可能拍到堆积的雪墙,或是夕阳下的高速公路。Waymo 世界模型可以将这类视频,以及任何普通相机拍摄的视频,转换为多模态仿真,呈现 Waymo Driver 在同一场景下的「所见」。Waymo 表示,由于仿真直接来源于真实影像,这一过程在真实感和事实准确性上达到了最高水平。

可扩展推理
一些需要模拟的场景可能需要较长时间才能完整呈现,例如在狭窄车道中通行的情况。长时间仿真通常更具挑战性,因为随着仿真时长增加,计算负担加重,同时保持稳定高质量也更困难。不过,通过 Waymo World Model 的高效变体,可以在显著降低计算量的同时模拟更长的场景,并保持高真实感与高保真度,从而支持大规模仿真。
在高效变体上进行的长时段仿真(4 倍速):

在高速公路上,需要在车道内的障碍物和快速行驶的车辆之间穿梭行驶。
,时长00:07
在繁忙的街区穿行
通过模拟这些极为罕见的情况,Waymo Driver 可以提前为复杂、长尾的驾驶场景做好准备。这一能力为自动驾驶系统设立了更严格的安全基准,确保其在现实道路上遇到类似挑战之前,已具备应对能力。
参考链接:
https://x.com/demishassabis/status/2019827916385972517
....
#Waymo刚刚的世界模型分享
自动驾驶仿真的新进展...
Waymo上周五晚些更新了一些新的技术进展,本着周末让大家好好休息的原则,所以柱哥周末没卷大家(不是)。本次更新主要是Waymo世界模型的一些的内容,核心是利用Google DeepMind Genie3的生成能力做闭环仿真(Camera + Lidar)。今天给大家分享一下~
- 原文:https://waymo.com/blog/2026/02/the-waymo-world-model-a-new-frontier-for-autonomous-driving-simulation
概览
Waymo自动驾驶系统的完全自动驾驶里程已近2亿英里,成为美国主要城市交通脉络的重要组成部分,持续提升道路安全水平。而乘客与当地社区未曾看到的是,这套系统早已在虚拟世界完成了数十亿英里的仿真行驶,在现实道路遭遇复杂场景前,就已将其悉数掌握。今日,我们欣喜地推出Waymo世界模型——一款前沿生成式模型,为大规模、超写实的自动驾驶仿真树立了全新标杆。
,时长00:14
仿真是Waymo人工智能生态系统的核心组成部分,也是我们打造可验证安全人工智能体系的三大关键支柱之一。下文将详细介绍的Waymo世界模型,正是负责生成超写实仿真环境的核心模块。
更多信息见:Waymo的基座模型分享:快慢双系统端到端 & 世界模型仿真
Waymo世界模型基于谷歌深度思维研发的新一代通用世界模型“Genie3”打造,该基础模型可生成真实的交互式三维环境,我们针对自动驾驶领域的严苛需求完成了专属适配。借助Genie3积淀的海量世界认知能力,Waymo世界模型能够仿真各类极罕见场景——从龙卷风天气到偶遇大象,这些场景在现实中几乎无法大规模捕捉。模型架构具备高度可控性,工程师仅通过简单的文本指令、驾驶操作参数和场景布局设置,即可对仿真内容进行调整。值得一提的是,Waymo世界模型可生成高保真多传感器输出数据,涵盖摄像头视觉数据与激光雷达点云数据。
视觉&激光仿真更贴合Waymo实际的仿真需要,对于纯视觉方案来说,点云重建不是必须。国内主要做的是视觉重建,像理想(StreetGaussian)、小米(WroldSplat)、英伟达(OmniRe),Lidar重建工作不是很多,也推荐几个世界模型的汇总仓库仓库一:https://github.com/worldbench/awesome-3d-4d-world-models仓库一:https://github.com/LMD0311/Awesome-World-Model
海量的世界认知、精细化的可控能力与多模态的真实感相结合,大幅提升了Waymo在更多地区、全新驾驶环境中安全落地服务的能力。在下文内容中,我们将展示Waymo世界模型的实际应用效果,呈现系统应对各类罕见边缘场景的仿真行驶案例。
🌎 涌现式多模态世界认知能力
自动驾驶行业的多数仿真模型均仅依托采集的道路实测数据从零开始训练,这就导致系统的学习经验存在局限性。Genie3通过在海量多元视频数据上完成预训练,积淀了强大的世界认知能力,让我们得以探索车队从未直接观测到的各类场景。
通过专属的后训练环节,我们将这种海量的世界认知能力从二维视频数据,转化为适配Waymo专属硬件套件的三维激光雷达输出数据。摄像头擅长还原视觉细节,而激光雷达传感器能提供精准深度信息等高价值互补信号。Waymo世界模型可针对任意场景生成多模态传感器数据,无论是日常常规驾驶,还是各类罕见的长尾场景,均能实现全覆盖。
🌪️ 极端天气与自然灾害场景仿真
仿真场景1:行驶在薄雪覆盖的金门大桥,前视摄像头画面中可清晰看到车辆投影。
,时长00:03
仿真场景2:遭遇龙卷风天气。
,时长00:03
仿真场景3:郊区死胡同被积涝完全淹没,水面漂浮着各类家具。
,时长00:03
💥 罕见且安全关键的场景仿真
仿真场景1:遭遇道路上的鲁莽驾驶车辆。
,时长00:03
还提供了一些其他的例子:
- 前车径直撞上树枝。
- 跟车行驶时,前车车顶摆放着固定不稳的家具。
- 故障卡车逆向停驻,阻断道路通行。
🐘 长尾特殊物体及场景仿真
仿真场景1:偶遇温顺的大象。
,时长00:03
还提供了一些其他的例子:
- 偶遇德克萨斯长角牛。
- 偶遇狮子。
- 行人身着霸王龙造型服饰。
- 遭遇汽车大小的巨型风滚草。
🕹️ 强大的仿真可控性
Waymo世界模型主要通过三种机制实现强大的仿真可控性:驾驶行为控制、场景布局控制与文本指令控制。
驾驶行为控制可让仿真系统响应精准,严格遵循设定的驾驶操作参数。借助这一功能,我们能够仿真各类“假设性”反事实场景,例如在某一特定场景下,Waymo自动驾驶系统若选择更果断的行驶策略而非避让,是否仍能保障安全。
反事实驾驶仿真:我们可基于历史实测行驶的原始路线,或完全全新的路线开展仿真。传统重构式仿真方法(如3DGS)存在明显短板——当仿真路线与原始行驶路线偏差过大时,会因观测数据缺失出现视觉失真;而全自学习的Waymo世界模型凭借强大的生成能力,可在该类场景下保持良好的真实度与一致性。
场景布局控制支持对道路布局、交通信号灯状态及其他道路参与者的行为进行自定义设置。通过这一功能,我们可通过精准布置道路参与者、对道路布局进行自定义改造,打造专属仿真场景。
场景布局适配效果

文本指令控制是灵活性最高的工具,通过该功能,我们可调整仿真的时段、天气条件,甚至生成全新的合成场景(如前文展示的各类长尾场景)。
场景属性改造——时间调整
,时长00:03
场景属性改造——天气调整
,时长00:03
🎞️ 行车记录仪视频的仿真转化
人们在风景优美的路段行驶时,常会用手机或行车记录仪记录沿途画面,可能拍下积雪堆、日落时分的高速公路等场景。Waymo世界模型可将这类行车记录仪视频,或普通相机拍摄的任意视频,转化为多模态仿真场景,还原Waymo自动驾驶系统对该真实场景的感知效果。由于这类仿真场景源自实际影像素材,其真实度与还原度达到了最高水平。
,时长00:03
⚙️ 可扩展的推理能力
部分待仿真的场景需要更长的行驶时长才能完成,例如在窄车道中小心避让通行。这类仿真的实现难度更高,因为仿真时长越长,计算量需求越大,保持画质稳定的难度也越高。不过,基于Waymo世界模型的轻量化优化版本,我们能够在大幅降低计算量的同时,实现长时程场景仿真,且保持高真实度与高保真度,为大规模仿真提供技术支撑。
🚀 Waymo世界模型轻量化版本的长时程仿真(4倍速播放)
,时长00:05
通过对这些“现实中极难遇见”的场景开展仿真训练,我们让Waymo自动驾驶系统提前对各类罕见复杂场景做好应对准备。这一方式构建了更严格的安全基准,确保系统在现实道路遭遇各类长尾挑战前,就已具备成熟的应对能力。
结语
Waymo的世界模型强调的是生成式方法,看似和国内生成+重建的路子不一样。但从文中一些有限的信息来看,柱哥猜测也用了3DGS,下图红色箭头是3DGS特有的新视角伪影。

还可以看出一些端倪,下图红色箭头围栏的效果还可以,近处的围栏的点云效果就比较差了。这也是生成式方法固有的弊端,虽然给了很多layout和条件,生成的质量其实不太可控,猜测Waymo应该也是加了Depth的监督,这种镂空状的栏杆/栅栏其实很难做。但整体点云效果还是可以的。

柱哥个人观点:Waymo这两个月的技术分享频率挺高,希望大家看到自己技术能力的迭代,但还没有敞开心扉把一些硬菜呈现给大家。本文算是前一阵Waymo基座模型的世界模型仿真模块,整体上和国内的方向一致。
....
#FSD 背后的技术哲学
特斯.拉AI 负责人新分享
特斯拉 AI 负责人 Ashok Elluswamy 在最近2026 ScaledML Conference 的演讲中又一次深入剖析了 FSD(完全自动驾驶)背后的技术哲学,为什么要彻底抛弃传统的规则代码?端到端(End-to-End)架构到底难在哪里?特斯拉又是如何用“世界模型”和“高斯泼溅”等黑科技逐一击破的?也分享了特斯拉对VLA语音控车的一些想法。
大家阅读下文的时候看到ppt图片肯定觉得眼熟,之前不少博主都科普了很多遍,但我看之前的解读都没有特别深度,所以这两天花时间像素级的看了一遍又一遍,按照如下章节解读:
- 为什么要破除规则采用端到端算法?
- 端到端的难点?特斯拉的解法!
- FSD的解法,适用于Physical AI的机器人
- 特斯拉有没有使用类似VLA的语音控车,未来会不会用?
希望给大家带来一些有用的信息。
在解读之前,先铺垫下特斯拉的系统优势,我们之前文章《特斯拉FSD算法技术解读 - 国内FSD测试特斯拉真输了么?》老早也就是指出了特斯拉FSD的基本优势 - 行云流水老司机。
Ashok Elluswamy也在演讲中开头就讲到,特斯拉使用端到端(End-to-End)的驾驶系统来构建自动驾驶软件。他单一的端到端大模型,运行频率是36hz,这个36hz的意思是1s钟产生36个车辆运动输出,也就是27.8ms就有一个运动动作输出,而很多竞品基本还在10hz左右。你可以类比特斯拉的FSD犹如你看的手机和电视屏幕是高刷,动作会更流畅和丝滑。
它接收原始传感器输入——主要是来自车上 8 个摄像头的视频,但也包括导航指令、运动学状态(如车速、转向角度等)、音频等——然后直接输出车辆应该如何表现,即下一步的动作,比如转向、加加速度(jerk)等。

这就是特斯拉FSD的大模型一个高阶的概述。
为什么要破除规则采用端到端算法?
Ashok Elluswamy总结了三个原因,分别是人类价值观编码极其困难,感知、预测和规划之间的接口定义不清,驾驶行为所有行为紧密耦合。这些导致规则化的方法没有未来。

1. Codifying human values is incredibly difficult
(将人类价值观编码极其困难)
现实当中的驾驶不是非黑即白的逻辑题,而是充满了无数微小的“电车难题”和价值权衡。程序员无法通过写 if-else 代码来穷尽所有人类在驾驶时的判断逻辑。
Ashok Elluswamy在演讲中举了一个水坑 vs. 对向来车的例子:
场景:你的车道前方有一个水坑,想要绕过去就必须压线,甚至借用一点对向车道。
规则冲突:你有两条规则。规则A是“避开障碍物(水坑)”,规则B是“严禁逆行”。
人类的直觉: 如果对向没车,或者对向车很远,或者水坑很深,我们会选择压线绕行;如果对向车很快,或者水坑只是浅水,我们会选择直接压过水坑。
编码的困境: 如果要写代码,你需要定义水坑多深才算深?对向车多远才算远?这就陷入了“抽象泄漏(Leaky Abstractions)”。你想写死规则,但现实总有例外。

端到端的解法: 不写规则,让 AI 看成千上万个人类司机在这种情况是怎么做的。AI 会学习到一种隐性的“价值观概率分布”,而不是僵化的代码。
2. Interface between perception, prediction and planning is ill-defined
(感知、预测和规划之间的接口定义不清)
在传统的模块化架构中,模块之间需要传递信息。上游(感知)必须决定“抛弃什么信息”和“保留什么信息”传给下游(规划)。这个“接口”怎么定义,往往会丢失关键的细节信息。
Ashok Elluswamy在演讲中举了一个“小鸡与鹅的腿部动作”的例子:
传统困境: 假设感知模块识别出前方有“一只鸟”。它传给规划模块的信息可能只是 Object: Bird, Location: (x,y)。规划模块收到这个信息,不知道该停还是该走。因为规划模块“看”不到鸟的动作细节。
接口定义的荒谬: 为了解决这个问题,你可能需要修改接口,增加一个字段 Leg_Moving: True/False。这就变成了一个笑话——难道要专门写一个“鸡腿探测器”吗?世界上有无数种物体,你不可能为每种物体定义专属的接口字段。

端到端的解法: 消除接口。原始的视频像素(包含了鸡腿在动的信息)直接流向控制端。AI 不需要被告知“这是一只鸡”,它只需要学会“看到这种像素模式(腿动),我就得停下来”,信息在系统中是无损流动的。
3. All behaviors tightly coupled
(所有行为紧密耦合)
一般传统的软件工程喜欢“解耦”(Decoupling),即把大问题拆成独立的小问题。但在机器人和自动驾驶领域,感知及控制是分不开的,拆分会导致延迟和误判。
Ashok Elluswamy在演讲中举了一个“高速避险与延迟”的例子:
紧密耦合的现实: 你的车速决定了你需要看多远(感知服务于控制);你看到的危险程度决定了你刹车的力度(控制依赖于感知)。
传统困境: 如果分为三个模块,感知处理完 -> 传给预测 -> 传给规划。每一步都有延迟(Latency)。当规划模块决定刹车时,世界已经变了(几十毫秒在高速下就是好几米)。
三阶智能案例: 演讲中提到前车失控的案例。AI 观察到前车微小的横摆角速度异常(Perception),瞬间预判它会弹回来(Prediction),并立刻决定猛踩刹车(Planning)。在端到端网络中,这三个步骤是在同一个神经网络的前向传播中瞬间、整体完成的。
总结下来就是,试图用人类的逻辑语言(代码规则)去描述复杂的物理世界是行不通的。
- 因为人类价值观太复杂(难以编码);
- 因为世界细节太丰富(接口无法定义);
- 因为反应要求太快且环环相扣(模块化导致割裂)。
所以特斯拉选择了端到端:让数据说话,用神经网络的复杂性去匹配物理世界的复杂性。
端到端的解法,将所有行为视为一个整体任务。网络根据环境直接输出动作,确保了确定性的低延迟(演讲中提到的 36Hz 控制频率),并且能利用整体上下文做出反应,而不是基于过时的、被切割的信息片段。
端到端的难点?特斯拉的解法!
特斯拉意思是端到端是目前的最优解,但是要落地端到端并不是一句话的事情,他至少有以下几个难点:
1. 维度的诅咒 (Curse of dimensionality)
这个挑战指的是输入数据的极度庞大与输出动作的极度精简之间的巨大鸿沟。
输入端的数据爆炸:特斯拉车辆拥有 8 个高分辨率摄像头(500万像素),运行在高帧率下。为了做出正确的驾驶决策(例如在停车标志处判断谁先到),系统需要理解过去一段时间的历史上下文(比如 30 秒)。将这些视频流和历史数据加在一起,神经网络每时每刻需要处理大约 20 亿个 Token(信息单元)。
输出端的极度压缩:尽管输入了海量信息,最终的输出却非常简单,只有 2 个动作:转向角度和加速/刹车力度。

核心难点:因果关系的提取将 20 亿个 Token 压缩为 2 个动作,难点在于区分“真正的因果”与“虚假的关联”。
例子: 车辆停下来,是因为前面的车亮了刹车灯(真因果),还是因为路边的一棵树刚好晃动了一下(虚假关联)?
在海量的数据中,如果只给模型看平庸的驾驶视频(比如一直在高速上直行),模型很容易学到错误的关联。因此,特斯拉必须从车队每天产生的 500 年驾驶数据中,挖掘出极少数的“有趣数据”(如校车、事故、罕见交通状况)来训练模型,让它学会正确的因果逻辑。
这里特斯拉算是告诉大家他有一个独门绝技就是海量数据里面淘金的能力。特斯拉不会收集所有数据,而是通过“触发器”筛选有价值的信息:
- 极小神经网络(Tiny NNs):在车端运行微型模型,专门捕捉特定场景(如紧急车辆、特殊障碍物)。
- 事后验证:评估系统的预测与实际发生的情况是否一致。
- 人工干预:任何人类驾驶员接管或干预 FSD 的时刻,都是极佳的学习样本。
- 状态空间剧变:当环境发生剧烈变化或出现罕见状况时触发采集。
2. 可解释性与安全保证 (Interpretability and safety guarantees)
端到端神经网络常被视为“黑盒”,这带来了安全隐患:如果车撞了,我们怎么知道它是没看见障碍物,还是判断错了?特斯拉表示他们能够打破“黑盒”,他的神经网络不仅仅是在做简单的像素匹配,而是真正理解了物理世界。

这次特斯拉倒是告诉大家他的解法:采用思维链CoT与过程验证。大家是不是一听端到端大模型就是,从光子到电机信号?错!特斯拉的基础模型有多重输出 (Foundation model predictions)。
虽然这是一个端到端的模型(输入像素 -> 输出控制),但它被设计为同时预测许多“人类可理解的中间结果” (interpretable outputs)。这些输出就像是插入模型内部的“探针”,用来监测模型是否真正理解了世界。
具体包括以下几个维度:
- 物理世界的理解 (3D occupancy and flow):模型会输出它眼中的 3D 空间占用情况(哪里有东西,哪里是空的)以及物体的流动(速度、方向)。如果车撞了障碍物,可以检查这一层:是模型没看见障碍物(感知错误),还是看见了却没刹车(控制错误)?
- 物体识别 :模型会明确标出这是车、那是人、那是自行车。证明模型具备语义理解能力,而不仅仅是处理像素颜色。
- 交通规则与环境 :识别红绿灯、路标、车道线、道路边界、限速牌等。验证模型是否遵守了人类社会的交通规则。
- 交互预测:预测其他交通参与者是否会与自己发生交互(例如:那个行人会不会突然冲出来?那辆车会不会加塞?)。 展示模型的预判能力和风险评估逻辑。
最后,这些东西会形成自然语言解释 (Decisions expressed as plain language):这是最直观的一层。模型可以直接用英语输出它的决策理由。 模型可能会输出:“我正在减速,因为前方检测到一名行人准备横穿马路。”这让调试变得像对话一样简单,极大地增强了人类对系统的信任。

如上图一样,大模型输出动作,但同时会输出环境理解的一些特征,然后形成思维链推理形成逻辑闭环。当然特斯拉并没有像国内厂商一样,把这个思维链秀出来,估计特斯拉如果秀出来,大家也就可以蒸馏特斯拉的模型了。
对于物理世界的理解,特斯拉有一个独门绝技就是,特斯拉自研的生成式高斯泼溅(Generative Gaussian Splatting)技术。
特斯拉的神经网络不仅输出驾驶动作,还能在220毫秒内实时重建车辆周围的 3D 世界。这可以证明端到端大模型确实识别出了车辆、行人及其位置和形状,而不仅仅是处理二维像素。

现在自驾行业,3D高斯已经很火了,但是特斯拉表示大家用的传统3D高斯,需要30分钟才能生成场景,同时失真很难用在动态物体上面。
对于推理,特斯拉采用的独门绝技是“系统 2 思维”(System 2 Thinking),这个词很熟悉,理想之前讲过的快慢系统,特斯拉应该也采用了,特斯拉的端到端神经网络不仅能“看见”像素,还能像人类一样阅读、思考和解释复杂的交通逻辑。

这个可以看我们之前视频。
复杂的路障与绕行,图片左侧是车辆的前视摄像头画面。前方道路被橙白相间的施工护栏堵死,并立有“ROAD CLOSED THRU TRAFFIC”(道路关闭,禁止通行)和绿色的“DETOUR”(绕行)标志。
AI 成功检测并标记了“detour sign”(绕行标志)和“construction barrier”(施工护栏)。然后采用自然语言逻辑推理产生动作结论。
3. 评估,如何验证你确实行。
特斯拉表示在实现自动驾驶过程中面临的第三个、也是被 Ashok Elluswamy 称为“最难”的挑战是评估,如何验证你确实行。
特斯拉指出了传统机器学习评估方法在自动驾驶领域的局限性:
- 损失函数(Loss)并非万能: 在常规 AI 训练中,我们会看“损失函数”是否下降。但在驾驶中,即便损失值非常低,模型也可能在某个关键的“长尾”场景(如突然冲出的行人)中犯下致命错误。
- 现在大家的虚拟仿真测试一般都是开环(Open-loop)的,AI 只是在看视频预测人类会怎么开,它并不实际控制车辆,而闭环的环境中,自动驾驶的每一个动作都会改变接下来的视觉输入。所以在开环仿真测试下表现良好的模型,在闭环实际行驶时,微小的误差可能会不断累积,最终导致车辆偏离航道或发生碰撞。

所以特斯拉采用的是多模态与行动后果预测
特斯拉认为避免事故的方法不止一种。面对障碍物,你可以刹车,也可以向左或向右绕行。评估指标必须能够捕捉并认可这些不同的、但同样安全的路径,而不是强制要求 AI 只做唯一的“标准动作”。
特斯拉提出了一种更高级的评估方案“行动后果预测(Consequence-of-action)”,不仅仅看 AI 做了什么,还要看它是否预见到了动作的后果。

这就引出了特斯拉的神经网络闭环模拟器(Neural Network closed-loop simulator),也被称为“世界模型”。这是特斯拉为了在不依赖真实道路测试的情况下,实现对自动驾驶系统的闭环评估而构建的一个虚拟世界生成器。

采用这个神经网络闭环模拟器,就能解决提到的“开环 vs 闭环”评估难题。他构建了一个虚拟考场: 有了这个模型,特斯拉就可以把自动驾驶策略模型(Policy Network)放进去。

然后进行闭环测试:策略模型看到 t 时刻的画面 -> 决定做一个动作 -> 世界模拟器根据动作生成 t+1 时刻的新画面 -> 策略模型再看新画面 -> 再做动作……
这样 AI 就可以在一个完全由神经网络生成的虚拟世界里“练车”。哪怕 AI 在这里撞车了(比如生成了碰撞的视频画面),现实中也没有任何损失。这让特斯拉能够安全地测试各种极端危险的边缘场景。
里面的World Sim NN就是一个世界模型,他采用特斯拉“廉价”收集的‘状态-动作’数据进行训练”。这些数据都是特斯拉车队回传回来的真实海量数据case,而且无需人工标注: 训练这个模型不需要人类去画框或打标签。

特斯拉通过开发“生成式世界模拟器”,让 AI 在虚拟但真实的闭环环境中进行数百万次的极端测试,从而解决了这一难题。
FSD的解法,适用于Physical AI的机器人
特斯拉表示,这一整套系统——端到端驾驶网络和世界模拟器——不仅适用于自动驾驶,也是机器人技术的基础模型(Foundation model)。 同样的视频生成网络可以泛化到生成 Optimus 机器人行走的室内场景。这也是可控的,你可以输入“直行”或“左转”的动作,视频生成会正确反映这些动作。同样,它也适用于机械臂的操作(如打开抽屉)。

特斯拉有没有使用语音控车?
根据Ashok的现场问答,目前特斯拉车辆确实有 Grok,你可以和它聊天。另外,FSD确实有自己的音频模型,但对于FSD来讲,目前不是用于自然语言交互,更多是用于理解汽车周围的噪音(如警笛和紧急车辆)。
在未来,特斯拉会拥有完全集成的语音控制命令来控制车辆。但他们认为现在还为时过早。这开启了一个全新的测试领域。例如,你不应该能告诉汽车去撞车,然后它就真的撞了。为了防止使用语音的对抗性攻击,需要进行大量的安全工作。目前这还不值得这么麻烦。
这个和我们之前文章《特斯拉 Grok + FSD = VLA?》推断是一致的。
最后
希望,解释得比较清楚。不过大概FSD的原理比较简单,相信国内各家主机厂真正搞算法的人都懂这个方法论,毕竟华人不少在特斯拉,湾区碰一碰party一下,交换信息都熟了。但是各家投入的资源个核心落地能力确不一样,所以一般都是照虎画猫了。
....
#首次,蔚.来真盈利了......
冰箱彩电大沙发垃圾桶挣钱啦.....
首次!蔚.来实现单季度盈利了。
就在昨晚,蔚.来集团发布2025年第四季度的盈利预告。
预计蔚.来于2025年第四季度录得经调整经营利润(非公认会计准则)约人民币7亿元(约1亿美元)至人民币12亿元(约1.72亿美元)之间,这是蔚.来首次录得单季度经调整经营利润(非公认会计准则)。

2025年,蔚.来打了一个漂亮的翻身仗。
25年12月,蔚.来交付新车48135台,同比增长54.6%,创历史新高。
- 其中,蔚.来品牌交付31897台,同比增长54.8%;
- 乐道品牌交付9154台;
- firefly萤火虫品牌交付7084台,环比增长16.4%。
2025年全年,蔚.来共交付新车326028台,同比增长46.9%,创历史新高。
- 其中,蔚.来品牌交付178806台;
- 乐道品牌交付107808台;
- firefly萤火虫品牌交付39414台。
从成立至今,蔚.来累计交付新车997592台。
- 其中蔚.来品牌累计交付829609台;
- 乐道品牌累计交付128569台;
- firefly萤火虫品牌累计交付39414台。
2026年1月也实现了开门红,交付新车27182台,同比增长96.1%。
- 蔚.来品牌1月交付新车20894台;
- 乐道品牌交付3481台;
- firefly萤火虫品牌交付2807台。
截至目前,蔚.来公司已累计交付新车1024774台。值得注意的是,蔚.来全新ES8也在广州完成第6万台新车交付,历时134天。
- 41 天交付到 1 万
- 29 天交付到 2 万
- 19 天交付到 3 万
- 11 天交付到 4 万
- 20 天交付到 5 万
- 14 天交付到 6 万
昨晚,蔚.来美股盘中一度涨超10%。

在技术层面,蔚.来NWM2.0在2026年1月底也已正式推送,主要技术点聚焦在"世界模型+闭环强化学习"上。
柱哥大胆猜测一下,NWM2.0的技术提升主要在闭环RL上。和开环RL相比,闭环RL对算力的要求更高,技术难度也更大。直接带来的提升就是拥堵绕行更丝滑、左转会车绕行、右转不会一直卡着等待行人。
强化学习真值得业内有资源的公司多花些精力,无论是是开环还是闭环。
世界模型大概率是用在云端,应该不是直接用于车端输出轨迹。
从目前网上看到了一些驾驶体验,导航SD应该是接在模型端,而不是规控端。
但是一段式还是两段式端到端,从实车效果来看目前还拿不准。
蔚.来智驾今年的目标是通过三个版本回到行业头部(数一数二)的位置。

....
#FastDriveCoT
英伟达最新FastDriveCoT!CoT思维链推理加速3-4倍...
英伟达团队的一篇新工作 — FastDriveCoT,把思维链的过程加速了3-4倍。做VLA部署的公司和同学可以重点关注下,主要实现方式如下:
- 将思维链轨迹格式化为结构化模板;
- 把推理过程分解为多个子任务;
- 并行解码,加速结构化的思维链推理;
- 构建了依赖图和动态规划的算法,以适应不同字段长度的变化。
这篇工作不仅局限于自驾领域,可以将思维链的过程模板化,都可以借鉴本文的思路进行加速。
思维链(CoT)推理提升了自动驾驶中视觉-语言-动作(VLA)模型的决策能力,但其自回归特性带来了显著的推理耗时,使其难以应用于实时场景。为解决这一问题,本文提出了FastDriveCoT——一种新的并行解码方法,用于加速模板结构化的思维链推理。该方法将推理过程分解为包含多个独立子任务的依赖图,例如识别关键目标和总结交通规则等,其中部分子任务可并行生成。通过在单次前向传播中同时生成多个独立的推理步骤,本文大幅减少了串行计算量。实验表明,在多种模型架构下,该方法实现了3-4倍的思维链生成加速比,且端到端耗时显著降低,同时保留了思维链推理带来的原始下游任务性能提升。
- 论文标题:Accelerating Structured Chain-of-Thought in Autonomous Vehicles
- 论文链接:https://arxiv.org/abs/2602.02864
一、背景回顾
近年来,语言已成为机器人系统中的关键模态,推动了xx操作和自动驾驶等领域的发展。随着大语言模型(LLMs)和视觉-语言模型(VLMs)的快速进步,语言已越来越多地融入感知和决策流程,将视觉-动作(VA)模型转变为视觉-语言-动作(VLA)模型。与传统VA模型相比,VLA模型受益于语言接地能力,能够更好地解读用户意图、分解任务,并运用常识推理实现更类人的行为。
这一方向的代表性技术是思维链(CoT)提示法,该方法以牺牲部分推理效率为代价换取推理准确性的提升。通过鼓励VLA模型将复杂问题分解为一系列简单子问题,思维链利用推理时的缩放特性改善策略性能。除提示法外,思维链还被整合到训练流程中,例如在监督微调(SFT)中使用精心构建的思维链数据集。随着DeepSeek v3的发布,基于扩展结构化思维链轨迹的推理在机器人领域获得了广泛关注,并自然延伸至自动驾驶车辆(AVs)领域。

自动驾驶与纯语言任务或操作任务的核心区别在于其对推理速度的严格要求。在典型的自动驾驶策略中,决策必须以高频率(通常为10Hz或更高)更新,以安全响应快速变化的环境,这对每个规划周期内可生成的token数量施加了严格限制。然而标准的思维链轨迹通常包含多个模板(例如环境描述、关键目标识别、元动作预测等),这些阶段会额外产生数百个token,导致显著的推理开销,使其在自动驾驶中的应用面临挑战。
尽管自回归解码的串行特性使得思维链推理成为推理过程中的瓶颈,但自动驾驶中的推理包含多个高度独立的组件,因此适合并行化处理。与人类驾驶员类似,自动驾驶智能体可以并行评估道路条件、交通标志和关键目标等环境因素。自动驾驶场景的这一特性使其具备高度并行化的潜力,这与近年来专注于通用推理任务(如数学运算)的研究形成鲜明对比——这些通用任务中可分解的独立子任务数量通常有限且具有任务特异性。此外,自动驾驶智能体为确保安全驾驶,通常遵循基于固定观测因素集的结构化推理模式。这种规律性无需其他领域所需的临时任务分解,从而能够采用更复杂的算法协调思维链轨迹的并行生成。
本文的主要贡献:基于上述思路,英伟达的团队提出了FastDriveCoT——一种用于加速自动驾驶任务中思维链推理的方法。
- 该方法引入了一种系统化的方式,将思维链轨迹格式化为结构化模板。为最大化并行化程度,本文采用一种优化算法,基于通用依赖图动态识别可并行生成的字段;
- 此外针对并行解码策略优化了大语言模型的推理过程,尤其关注字段的排列和合并方式。实验表明,FastDriveCoT显著加速了思维链生成,与自回归解码相比实现了3.1至4.1倍的加速比,同时保留了思维链推理带来的下游任务性能提升;
- 进一步验证了这些发现适用于多种场景,包括自回归框架和Transfusion框架下的元动作预测和轨迹生成任务。
二、FastDriveCoT详解
大语言模型(LLMs)中的标准自回归生成在现代GPU上受内存限制(源于KV缓存操作),因此单次前向传播仅生成一个token的方式无法充分利用硬件的计算能力。这种GPU利用率不足为并行解码创造了机会——并行解码技术可同时生成多个token以提升效率。
尽管已有研究探索了通过任务分解实现并行解码,但这些工作主要集中在数学、编程等通用推理领域。这些领域通常需要复杂的、特定于任务的分解策略,且本身可并行化的程度有限,导致加速效果不佳。相比之下,自动驾驶(AV)任务通常遵循标准化的思维链(CoT)模式,从环境描述逐步过渡到关键目标识别,最终实现元动作预测。这种结构化的推理过程天然适合细粒度的任务分解,从而使思维链生成具备高度并行化的潜力。
为提升自动驾驶任务的推理效率,提出了FastDriveCoT — 一种利用上述结构化推理过程的并行解码方法。首先,本文设计了适用于自动驾驶任务标准化思维链模式的模板化思维链;其次,为管理并最大化并行化程度,本文构建了依赖图和动态规划算法,以适应不同字段长度的变化;最后,本文详细阐述了注意力掩码、位置ID、填充和KV缓存的处理方案,该实现充分考虑了大语言模型推理中的关键瓶颈,以确保最优性能。FastDriveCoT的整体框架如图2所示。

模板化思维链(Template CoT)
本文的思维链模板将自动驾驶推理任务分解为一系列特定字段。初始字段用于捕捉驾驶环境及其中的关键实体,包括光照、道路条件、天气、路口类型、道路类型、车道、关键目标、交通灯、交通标志和其他交通规则。其中,“关键目标”字段专门涵盖车辆、行人、骑行者、障碍物或其他与驾驶安全相关的物体,且每个关键目标需额外标注相对位置、物体类型和相关说明。后续字段用于对场景进行结构化总结,包括交通规则摘要、非交互元素和交互元素摘要。模板最终以自车(ego vehicle)的预期行收尾。每个字段均支持填充不同长度的自由格式自然语言文本。本文提出的思维链模板仅为示例,实际应用中可根据具体场景和系统配置进行调整。
部分字段(如车道和关键目标)可能包含数量可变的实例。例如,车道配置会随车辆行驶而变化,关键目标的数量也因场景而异。若采用简单的单字段自由格式描述所有实例,会导致生成过程缓慢且串行化。为实现并行化,本文为这些多实例字段设计了两阶段生成流程:
- 阶段1(枚举):模型首先生成高层概览。对于车道字段,需确定不同的分析时间范围;对于关键目标字段,则需枚举每个待描述的独立目标。
- 阶段2(细化):模型随后对阶段1中枚举的每个实例进行详细描述。
该结构支持对多个车道时间范围或多个关键目标的详细描述进行并行生成,显著提升了推理效率。为简化实现,本文为多实例字段设定了固定数量的“插槽”:模板中为车道分配了3个时间范围插槽,为关键目标分配了4个插槽,这些数量对应于训练数据中观察到的各类别最大实例数。若实际实例数少于分配的插槽数,剩余插槽将填充“N/A”占位符。更具适应性的方案可根据阶段1的枚举结果动态调整模板,这一方向将留待未来研究。
所有字段均采用“字段名称:字段内容”的格式逐行排列,各行拼接后形成完整的思维链文本,其长度通常为300-500个token。
依赖图(Dependency Graph)
思维链模板中的字段存在多种依赖关系:部分字段(如天气和道路条件)相互独立,可并行解码;另一些字段则存在依赖关系,需遵循特定的生成顺序。例如,交通规则摘要需在交通标志和交通灯字段生成完成后才能生成;对于车道、关键目标等多实例字段,枚举阶段必须先于细化阶段执行。这种生成顺序在推理过程中需严格遵守。
管理这些依赖关系需要一种能够适应多种关系结构的通用方法,而字段长度的可变性(不同字段长度不同,同一字段在不同场景下长度也可能变化)进一步增加了难度,使得固定解码调度方案不可行。为解决这些挑战并优化性能,本文引入了依赖图这一数据结构,其能够动态跟踪生成过程,并在每一步识别出所有满足前置条件、可并行解码的字段。

依赖图是一种有向无环图(DAG),其中每个节点代表模板中的一个字段。从字段A对应的节点指向字段B对应的节点的有向边,表示字段B的生成直接依赖于字段A的完成。图3展示了简化的依赖图示例。该依赖图设计直观且灵活,仅需基于直接依赖关系构建,可迁移至任意可分解的推理任务。

本文采用动态规划(DP)算法基于依赖图全自动调度并行解码过程:
- 初始化:就绪集包含所有源节点(即无入边的节点);
- 迭代生成:直至所有字段生成完成,每轮迭代执行以下操作:
- 对就绪集中的所有字段,在大语言模型的单次前向传播中并行生成一个token;
- 当某个字段生成完成时,其对应节点向所有依赖它的节点发送信号;
- 当一个节点收到所有前置节点的信号后,立即加入就绪集。
算法1给出了该过程的伪代码。本文的调度算法在前置传播次数方面具有最优性——能够以最少的前置传播次数完成所有字段的生成,该最小值等于关键路径的长度(即依赖图中任意依赖链上token累积数量的最大值)。后续实验将证明,这种最小化前置传播次数的最优性直接转化为调度算法的最大化加速比。
语言模型推理
并行生成多个字段需要高效的输出管理与合并方法。以往将推理分解为子任务的研究通常独立生成每个部分,再拼接自然语言文本。但这种方法计算效率低下,因为不同字段的并行生成过程无法共享或复用KV缓存,导致冗余的内存操作和计算开销。
为解决这一问题,本文提出将整个模板化思维链格式化为单一连续序列:并行解码多个字段的token时,将这些token沿序列长度维度打包。该方案允许模型在单次前向传播中同时计算所有并行字段的下一个token对数概率(logits),同时保持原始批次大小不变,从而实现KV缓存在所有字段间的完全共享和复用,最大化计算效率。
为在单一序列中实现该并行解码策略,本文设计了自定义注意力掩码以确保正确的因果依赖关系。该掩码可防止某个字段的生成token关注其他未确保完成的字段的token,且能基于依赖图自动计算。形式化地,字段B中的token仅当字段A是字段B的祖先节点时(即依赖图G中存在路径),即:
才可关注字段A中的token。特别地,初始模板中的固定token对序列中所有后续token可见(因其从一开始就是已知的)。图3展示了该注意力掩码的示例。由于生成字段的长度可变,本文将其输出填充或截断至预定义的固定长度,以确保序列中所有后续token的位置编码可正确计算。每个字段的最大长度根据训练数据中至少99%的输出长度确定。
需要注意的是,朴素实现会对填充token进行无效处理,造成计算资源浪费。为避免这一开销,本文修改了注意力掩码,使所有填充token对序列中其他所有token(包括后续元动作和轨迹生成的token)不可见。该策略允许填充token预留空间并定义token位置,同时无需在推理前向传播过程中处理填充token本身。
总体而言,FastDriveCoT在效率和实现方面具有以下关键优势:
- 零计算开销:与标准自回归解码相比,该方法不增加额外的浮点运算次数(FLOPs)。通过在单一序列中管理所有生成过程,自定义注意力掩码确保KV缓存在所有前向传播中完全复用,无需重新计算已有的key-value pairs;
- 缓解内存瓶颈:沿序列长度维度打包token,使得共享KV缓存可在单个CUDA注意力内核中被多个查询token(每个并行字段对应一个)访问。该策略显著减少了GPU内存总访问量——而内存访问是现代GPU上大语言模型推理的主要瓶颈;
- 实现简洁:该方法无需复杂的架构修改,仅通过精心设计标准Transformer组件(即注意力掩码和位置ID)即可实现效率提升,易于集成和部署。
三、实验结果分析
实验设置
模型:本文在三种不同架构和规模的基础模型上评估FastDriveCoT:Qwen2-0.5B、Qwen3-1.7B和Qwen2.5-VL-3B。对于本身不支持视觉输入的Qwen2-0.5B和Qwen3-1.7B,本文使用DINOv2从输入帧中提取特征,并将其作为连续输入提供给语言模型;同时,通过小型MLP将1.6秒的轨迹历史编码为单个嵌入,作为大语言模型的额外输入。
在思维链输出后,本文进一步生成元动作和未来轨迹以评估模型的驾驶性能,并探索了两种架构:
- 纯自回归Transformer(VLA-AR):将思维链、元动作和未来轨迹token化为离散序列,采用下一个token预测损失进行训练,并通过自回归方式解码;
- Transfusion:思维链和元动作的处理方式与VLA-AR一致,但未来轨迹通过流匹配(flow matching)建模,且共享相同的Transformer骨干网络。
对于架构1的轨迹表示,本文采用自编码预训练分词器将每个6.4秒的未来轨迹压缩为6个离散token;对于架构2的轨迹表示,首先将未来轨迹转换为64个10Hz的(∆x, ∆y, ∆yaw)动作,通过正弦位置编码和MLP进行嵌入,生成64个连续嵌入,最后通过轻量级MLP将嵌入解码回(∆x, ∆y, ∆yaw)动作空间。
为评估该方法的有效性,本文设置了两个基线:
- 无思维链(No CoT):端到端训练的模型,不生成中间思维链,用于衡量引入思维链对整体性能的贡献;
- 自回归思维链(Autoregressive CoT):使用完整的思维链模板,但通过标准自回归解码串行生成字段,用于单独量化并行解码带来的效率提升。
数据:为评估FastDriveCoT的效率和任务性能,本文使用了大型内部数据集,包含来自25个国家、2500多个城市的多辆自动驾驶车辆的20,000小时驾驶数据¹。该数据集涵盖多种道路条件、天气状况、昼夜场景和交通流量,本文使用轨迹数据和前后视摄像头的同步记录(下采样至320×512分辨率)进行训练和测试。本文采用包含Qwen2.5-VL-72B的自动标注流水线生成结构化思维链数据:对每个数据点,随机采样一个时间戳,向模型输入对应的2Hz前视视频和轨迹历史,通过约束解码确保输出严格遵循预定义模板。该流水线最终生成717,344个高质量训练样本和950个测试样本。
评估指标:为验证FastDriveCoT在提升计算效率的同时保持高任务性能的能力,本文采用以下评估指标:
- 思维链生成时间(CoT Time):从模型接收输入到思维链生成完成的延迟,直接衡量FastDriveCoT针对核心推理组件的加速效果;
- 总时间(Overall Time):从模型输入到最终轨迹输出的总延迟,衡量实际应用中的端到端效率提升;
- 元动作交并比(Meta-Action IOU):模型预测6.4秒时间范围内的元动作序列,通过计算每个0.1秒时间间隔内预测动作与真实动作的交并比(IOU)评估,反映模型的场景理解能力和高层决策质量;
- 轨迹平均位移误差(Trajectory ADE):通过计算预测轨迹与真实轨迹的平均位移误差(ADE),评估最终运动规划的准确性。
训练与推理配置:模型从预训练 checkpoint 初始化,根据需要添加随机初始化的嵌入层和网络层;在717,344个样本的数据集上训练50,000步,采用批次大小64、AdamW优化器,学习率设置为3×10⁻⁵,采用余弦衰减调度。
所有推理实验均在单块NVIDIA A100 80GB SXM GPU上进行,大部分计算采用BFloat16精度,输入轨迹历史处理和最终输出对数概率(logits)计算采用Float32精度。实现基于PyTorch的缩放点积注意力(SPDA):基线模型的标准因果掩码使用FlashAttention-2,并行解码所需的自定义掩码使用xFormers。为确保延迟测量的准确性,采用CUDA事件计时器,并丢弃每次运行的前10次迭代以消除内核预热效应。
主要结果
效率:如表1所示,与标准自回归基线相比,FastDriveCoT实现了3.1-4.1倍的思维链生成加速比,端到端推理总时间的加速比为1.9-3.1倍(具体取决于后续元动作和轨迹生成所占的时间比例)。
这种显著的加速效果通过缓解自回归推理的高昂延迟,使思维链在实际应用中具备可行性。此外,该性能提升在所有测试的模型架构和规模中均保持一致,证明了FastDriveCoT在多种视觉-语言模型(VLMs)和大语言模型(LLMs)中的通用性。

任务性能:表1进一步表明,引入思维链对元动作和轨迹生成均带来显著收益:在Qwen2.5-VL 3B模型的3秒轨迹预测任务中,性能提升最为明显——平均位移误差(ADE)从无思维链基线的0.617降至自回归思维链的0.511,FastDriveCoT的并行解码思维链进一步降至0.482;在Qwen2 0.5B、Qwen3 1.7B等其他模型的长时(6.4秒)轨迹预测任务中,平均位移误差(ADE)也实现了显著降低,证实了思维链在自动驾驶任务中的普遍有效性。
将并行解码方法与自回归思维链基线对比发现,FastDriveCoT保持了极具竞争力的性能:在VLA-AR架构实验中,并行方法的性能略优于自回归基线(本文推测这是由于结构化解码过程天然促进了对模板格式的严格遵循);在Transfusion架构实验中,尽管轨迹平均位移误差(ADE)较自回归思维链略有下降,但FastDriveCoT仍显著优于无思维链基线。综上,FastDriveCoT在所有实验中均实现了计算效率的显著提升,同时持续保留了思维链带来的任务准确性改善。
Inference分析
为深入理解FastDriveCoT的加速来源,本文基于Qwen2 0.5B + VLA-AR配置对推理过程进行了详细分析。

分析聚焦于依赖图中的关键路径——即必须串行生成的最长依赖token链。如图4a所示,思维链生成时间与关键路径上的token数量呈强线性关系。这一结果证实,延迟的主要决定因素是串行前向传播次数,而非单次前向传播生成的token数或所有字段的总token数。该发现为未来研究指明了两个有前景的方向:
- 通过显式设计思维链模板以最小化关键依赖路径长度,可进一步提升推理速度;
- 由于并行生成更多token不会增加延迟,FastDriveCoT可支持智能体在生成“全面推理”思维链的同时,并行生成“快速响应”轨迹(仅含少量或不含思维链),且无额外时间成本。这种双响应系统的应用将留待未来研究。
另一关键发现来自加速比与并行度的关系(如图4b所示):相对加速比定义为自回归基线的思维链生成时间与FastDriveCoT的比值,平均并行度定义为单次前向传播处理的平均token数。图中显示二者呈强线性关系,证实加速比与并行度直接成正比;同时观察到加速比始终略低于平均并行度(该规模下平均并行度近似等于FastDriveCoT的加速比),本文推测这一微小差异源于FastDriveCoT使用的自定义注意力掩码对应的注意力内核效率较低。这一优化方向将留待未来研究。
四、结论
本文提出了FastDriveCoT——一种基于并行解码的方法,用于加速自动驾驶任务中模板结构化思维链(CoT)的推理过程。该方法采用直观且具有通用性的依赖图,结合全自动优化动态规划算法,能够动态识别可并行生成的字段。实验结果表明,FastDriveCoT在多种视觉-语言模型(VLM)和大语言模型(LLM)架构及规模下,均实现了显著的思维链推理速度提升(3-4倍),同时保留了思维链带来的下游任务性能改善,包括元动作预测准确性和轨迹生成质量的提升。
....
#吉.利反超.比.亚.迪
车市告别“先抑后扬”的2025年后,受市场订单提前“透支”、促销费政策调整、传统淡季等叠加因素影响,多家传统车企和造车新品牌于2月初发布的销量数据表明,今年1月汽车市场整体呈现销量环比下滑、同比上扬的局面。
在极氪销量同比超100%带动下,虽然吉利品牌、领克品牌录得小幅下滑,但吉利汽车于2月1日晚间披露的1月销量数据显示,其当月乘用车销量达27.02万辆,同比增长1.29%,环比增长14.08%,成为目前唯一实现同环比正增长的企业,并借此反超比亚迪,登顶当月“销冠”。
在新能源领域,吉利汽车1月新能源销量(含吉利银河、领克、极氪三大品牌)达12.4万辆,同比增长2.63%。其中,极氪品牌1月销量达23,852辆,同比翻倍增长,抵消了银河、领克品牌的销量波动。海外市场方面,吉利汽车1月出口销量6.05万辆,同比大幅增长121.2%。其中,新能源海外销量达3.2万辆,占海外出口总销量比重为53%。
“2026年是吉利汽车产品大年,吉利汽车将在每个季度都推出1-2款全新产品,涵盖多款全新混动车型及全新一代醇氢能源车型,全力冲击全年345万辆的销量目标。”吉利汽车方面表示,公司将2026年的出口销量目标锚定64万辆,同比增幅超50%以上。
“痛失”销冠的比亚迪,1月呈现“国内下滑、海外增长”的分化态势。产销快报显示,比亚迪当月实现销售21万辆,同比下降30.11%,环比下降50.04%。其中,国内市场销量10.5万辆,同比下降54.35%;海外市场销量10万辆,同比增长51.47%。
受此消息影响,2月2日比亚迪股价低开约3%,至午间收盘跌3.15%,报88.03元/股。
在国内车市普遍承压背景下,海外市场的快速拓展正成为比亚迪重要的增长引擎。比亚迪品牌及公关部门总经理李云飞于年初透露,公司计划在2026年向中国以外地区销售130万辆汽车。这一目标较2025年约105万辆的海外交付量,预计增长约24%。
同为多品牌运营的汽车集团,奇瑞汽车1月五大品牌总销量为19.1万辆,同比下降10.7%。广汽集团1月销量11.66万辆,同比增长18.47%,昊铂埃安BU和传祺BU完成组建后,昊铂埃安BU销量同比增长171.63%,传祺BU销量同比增长51.06%。长城汽车1月销量9万辆,同比增长11.59%,其中WEY品牌7873辆,同比增长57.24%,在旗下五大品牌中涨幅最高。
新造车品牌中,小米汽车于2月1日率先公布2026年1月成绩单——交付量超39000辆,环比下滑22%但同比增幅接近翻倍。“SU7马上改款,目前主要交付的是YU7。”小米创办人、董事长兼CEO雷军解释称。
目前小米汽车在售SU7、YU7两款车型,其中SU7正处于新老交替过渡期,新一代SU7预计于今年4月上市。有知情人士向财联社记者透露,现款小米SU7停产为小米汽车上月销量波动的主因。“相比2025年12月(销量)有明显的下滑,主要原因是第一代SU7已经停产,现在在交付的主要是YU7,工厂也在全力准备新一代SU7。”
“新一代SU7上市前的研发测试工作已完成。预计从2月13号开始,新一代SU7展车会陆续在北京、上海、深圳、广州等7个城市展出。”雷军在最新一期直播中表示。
位列“新品牌”头部位置的鸿蒙智行开年首月交付57,915辆,同比增长65.6%的同时,未能延续连续四个月创交付历史新高的势头。其中,问界交付超4万辆,同比增长83%,在鸿蒙智行整体销量中占比近七成。2月2日,华为常务董事、终端BG董事长余承东在社交媒体上表示,“问界M6即将登场,‘56789’凑齐,春天见。”
华为乾崑合作品牌中,岚图汽车今年1月交付10,515辆,同比增长31.29%;刚刚宣布全面接入“华为全家桶”(华为乾崑智驾、鸿蒙座舱、华为乾崑车控、华为乾崑车云)、同为东风汽车旗下的奕派披露,1月销量21,269辆,同比大增145%。
根据规划,岚图2026年计划推出四款全新车型,包括岚图泰山Ultra、岚图泰山X8、岚图FE(代号)及岚图珠峰(代号)。奕派科技旗下奕派品牌,则计划于今年下半年交付搭载半固态电池的“满血华为”高性能轿跑。
传统车企集团和“新品牌”的开年走势,成为国内乘用车市场的缩影。乘联分会认为,1月车市环比大幅下滑几成定局——初步推算1月狭义乘用车零售总市场预计为180万辆左右,环比下降20.4%,同比持平微增,其中新能源零售预计为80万辆左右,渗透率44.4%。
“尽管春节前1-2周或涌现刚需及返乡群体购车小高峰,但春节长假导致有效销售时间较短。”展望恰逢马年春节的2月车市,中国汽车流通协会表示,返乡潮对大中城市客流影响较大,2月车市面临较大下行压力。
....
#Drive-JEPA
小.鹏Drive-JEPA:结合JEPA的世界模型端到端框架
小鹏汽车最新的工作Drive-JEPA,看名字就知道结合了世界模型V-JEPA,最终效果很不错。推荐大家仔细看一下~
端到端自动驾驶正日益借助自监督视频预训练来学习可迁移的规划表示。然而,迄今为止,为场景理解预训练视频世界模型仅带来了有限的性能提升。这一局限性因驾驶本身的固有模糊性而加剧:每个场景通常仅提供单一的人类轨迹,使得学习多模态行为变得困难。在本文中,我们提出Drive-JEPA,这是一个将视频联合嵌入预测架构(V-JEPA)与多模态轨迹蒸馏相结合的端到端驾驶框架。首先将V-JEPA适配于端到端驾驶任务,在大规模驾驶视频上预训练视觉Transformer(ViT)编码器,以生成与轨迹规划对齐的预测表示。其次入了一种proposal-centric规划器,该规划器在人类轨迹之外还蒸馏了仿真器生成的多样化轨迹,并采用动量感知选择机制以促进稳定且安全的驾驶行为。
在NAVSIM基准测试中,结合简单Transformer解码器的V-JEPA表示在perception-free比现有方法高出3个PDMS。完整的Drive-JEPA框架在v1上达到93.3 PDMS,在v2上达到87.8 EPDMS(扩展预测驾驶模型分数),创下了新的SOTA。
- 论文名称:Drive-JEPA: Video JEPA Meets Multimodal Trajectory Distillation for End-to-End Driving
- 论文链接:https://arxiv.org/abs/2601.22032
- 开源链接:https://github.com/linhanwang/Drive-JEPA
一、背景回顾
端到端自动驾驶已成为一种极具前景的范式,其通过统一的神经模型直接将原始传感器观测映射到驾驶动作。与传统模块化流水线中使用手工设计的中间表示不同,端到端方法旨在通过直接从大量人类驾驶数据中学习,减少信息损失并提高可扩展性。

近年来,端到端自动驾驶愈发倾向于利用自监督视频预训练来学习可迁移的规划表示。然而迄今为止,为场景理解预训练视频世界模型仅带来了有限的性能提升。该方向上的现有方法大致可分为两类。第一类是视频生成类方法,例如VaVAM和Epona,它们通过重建或生成视频来学习表示,然后将其迁移到规划任务中,但这种像素级目标会带来巨大的计算开销,且可能过度强调与决策无关的视觉细节。第二类为降低成本,latent世界模型会预测紧凑的特征动态(例如,LAW通过特征T预测特征T+1,而World4Drive进一步引入预训练基础模型以丰富 latent target)。然而,这些隐方法通常仅用作辅助目标,且尚未展现出通过扩大预训练规模所带来的显著优势。
另一方面,端到端驾驶面临着监督瓶颈:尽管驾驶的未来轨迹本质上具有多模态特性,但每个场景通常仅能提供单一的人类轨迹。现有研究通过离散或连续的表述方式生成多模态轨迹来解决这一问题。离散方法(如VAD v2和Hydra-MDP)将轨迹聚类为固定词汇表,并预测反映安全性和舒适性的分数;然而,其表达能力从根本上受到锚点轨迹的覆盖范围和质量的限制,导致在未覆盖的场景中泛化性能较差。此外,基于扩散的方法(包括DiffusionDrive和GoalFlow)通过迭代采样对多模态轨迹分布进行建模,展现出了强大的生成能力。尽管如此,这些方法仍然受到每个场景单一人类轨迹监督的限制,本质上制约了所学习行为的多样性。
本文提出了Drive-JEPA,这是一种端到端自动驾驶框架,能够以统一的方式解决上述两个瓶颈。首先将V-JEPA适配到自动驾驶领域,从大规模原始视频中学习与规划对齐的预测表示,其迁移性能优于现有的世界模型预训练方法。其次,我们引入多模态轨迹蒸馏技术,将模拟器中的知识蒸馏到proposal-centric规划器中,提供超越单一人类轨迹的多样化监督,从而实现更安全的多模态决策。
Drive-JEPA的框架包含三个组件:驾驶视频预训练、多模态轨迹蒸馏和动量感知轨迹选择。在第一个模块中,我们构建了大规模驾驶视频数据集,并利用V-JEPA预训练基于ViT的视觉编码器,该编码器通过预测未来 latent并有效防止模式崩溃来学习预测表示。在第二个模块中,基于航点锚定的proposal生成利用可变形注意力聚合轨迹航点处的鸟瞰图(BEV)特征,并迭代优化proposal。为了提高多样性,我们同时利用人类轨迹和满足安全性与舒适性约束的模拟器生成多模态轨迹对proposal进行监督,从而实现从模拟器中有效蒸馏知识。最后,选择模块通过预测碰撞风险、交通规则合规性和舒适性为所有候选轨迹分配分数,并进一步引入动量感知惩罚项以减少帧间轨迹畸变。
我们在NAVSIM v1、NAVSIM v2和Bench2Drive上对Drive-JEPA进行了验证。Drive-JEPA在NAVSIM v1上达到93.3 PDMS,在NAVSIM v2上达到87.8 EPDMS,创下了新的SOTA。值得注意的是,仅使用单目前视摄像头和轻量级Transformer规划器,本文的V-JEPA预训练模型在perception-free设置下比现有工作高出3个PDMS,突显了V-JEPA预训练在规划任务中的有效性。在Bench2Drive上,多模态轨迹蒸馏持续提升驾驶质量,证明了多样化监督在生成安全、多模态轨迹方面的优势。
本文的贡献可总结如下:
- 将V-JEPA预训练引入端到端自动驾驶,同时提升了有感知和无感知设置下的性能;
- 提出了一种新颖的多模态轨迹监督方法,将模拟器知识蒸馏到proposal-centric框架中,生成多样化的多模态轨迹;
- 设计了动量感知轨迹选择模块,提升了驾驶舒适性;
- 在NAVSIM v1和NAVSIM v2上达到了新的SOTA。此外即使不依赖感知标注,Drive-JEPA在NAVSIM上仍取得了优异的性能。
二、算法详解

预备知识
端到端自动驾驶:在端到端自动驾驶任务中,目标是以航点形式估计自车的未来轨迹。形式上,设表示时间步捕获的张环视多视角图像。模型需预测一系列航点,其中每个航点代表自车在时间戳的预测鸟瞰图(BEV)位置和航向角。此处表示待预测的未来位置数量。此外,模型还需输入自车状态,包括驾驶指令(如左转、直行、右转)、速度和加速度。
V-JEPA:V-JEPA通过从掩码视图(随机丢弃部分时空patch)估计目标视图的潜在表示,来学习预测性视频表示。该方法采用元架构,包含提取视频特征的编码器和预测掩码位置表示的预测器。编码器和预测器通过以下公式联合优化:
其中是指示丢弃补丁位置的可学习掩码令牌。目标分支使用停止梯度算子和指数移动平均编码器(参数为)来稳定训练并避免表示崩溃。损失仅在掩码位置计算。和均实例化为视觉Transformer(ViT)。
驾驶视频预训练:
为通过自监督视频预训练增强规划表示能力,现有研究探索了像素空间驾驶世界模型和潜在世界模型。前者面临计算开销大的问题,后者则难以扩展,因此我们提出在大规模驾驶视频预训练中采用V-JEPA。
驾驶视频数据集构建与扩展:本文使用V-JEPA 2发布的参数初始化ViT编码器。为缩小domain gap,Drive-JEPA从三个公开数据集构建大规模驾驶视频数据集:CoVLA、DrivingDojo和OpenScene。所有视频均由前视相机拍摄,处理为分辨率512×256、帧率2Hz的8帧片段。
我们在该构建数据集上以自监督方式采用V-JEPA目标训练ViT编码器。如表1所示,得益于潜在预测任务的高效性和有效的模式崩溃预防,我们成功将预训练规模扩展至208小时,且计算成本低于现有方法。

perception-free端到端自动驾驶:借鉴现有基于世界模型的端到端驾驶研究,我们采用perception-free评估设置,模型仅通过人类轨迹监督,不依赖感知标注。基于ViT编码器从前视图像提取的时空特征,使用带可学习查询的Transformer解码器预测未来航点。给定前视输入和,通过预训练ViT编码器提取时空特征并记为。引入个可学习查询嵌入,每个对应一个未来航点。基于Transformer的解码器通过交叉注意力关注,生成:
随后映射为预测航点:
其中,每个代表时间步的BEV位置和航向。网络通过与真实轨迹之间的均方误差(MSE)损失进行端到端训练。尽管结构简单,该设置仍显著优于现有方法(表1),突显了基于V-JEPA的驾驶视频预训练的有效性。
Waypoint-anchored proposal生成
基于驾驶视频预训练得到的强表示,我们设计了遵循proposal选择范式的规划器。如前所述,固定词汇表可视为proposal,但存在离散误差。受iPad启发,进一步改为在线生成proposal。
给定时间步(t)的视觉特征和自车状态,通过线性层将自车状态投影为自车特征。proposal查询通过将添加到可学习位置嵌入中初始化为,其中是航点轨迹proposal数量,是未来航点数量。我们对proposal查询进行次迭代优化。在第次迭代中,MLP将解码为航点轨迹proposal,其中,每个航点包含。以这些显式航点位置为锚点,通过提升-平铺BEV特征采样聚合每个预测航点周围的(F_{t})特征,并在proposal间交换信息以优化查询,随后通过轻量级MLP更新查询:
其中WADA表示航点锚定可变形注意力。
由于规划的最终轨迹从中选择,其分布至关重要。给定人类轨迹和中间proposal,引导的朴素方法是使用跨迭代折扣监督的最小N损失:
其中对早期迭代进行权重衰减,以鼓励由粗到细的优化。
然而,在自动驾驶中,除单一人类轨迹外,一个场景通常存在多种有效选择。这种朴素引导方法限制了proposal的多模态性。我们将在下一节给出解决方案。
多模态轨迹蒸馏
为缓解每个场景单一人类轨迹带来的稀疏监督问题,我们从基于规则的模拟器中蒸馏知识。HydraMDP通过学习固定词汇表上的分数进行Hydra蒸馏,而我们让模拟器提供多模态轨迹目标以引导proposal分布。
即借鉴VADv2和HydraMDP构建轨迹词汇表,但用途不同。收集训练数据集中的所有轨迹(超过10万条),使用K均值聚类选择轨迹中心。选取8192个中心作为轨迹词汇表,平衡覆盖范围和计算成本。对于训练数据集中的每个场景,通过基于规则的模拟器从词汇表中选择高质量多模态轨迹。遵循NAVSIM v2,计算所有轨迹的EPDM分数(详细定义见附录A)。
具体来说,首先运行PID控制器将8个航点转换为更密集的41点轨迹,然后在每个时间步重放其他道路参与者、交通灯等,计算碰撞及其他指标。NAVSIM v2中的基于规则模拟器仅用于评估,我们进一步提升了向量化计算效率以满足大规模离线评分需求。在获得词汇表中所有轨迹在训练数据集所有场景下的分数后,通过排序和阈值筛选为每个场景选择一组多模态轨迹。训练时,使用这些多模态轨迹作为伪教师引导proposal,而非单一人类轨迹。最终轨迹损失定义为:
其中min算子在第次迭代时对proposal索引取最小值。
如图3所示,无多模态轨迹蒸馏(MTD)时,proposal存在明显的mode collapse;加入MTD后,proposal呈现多模态分布。

动量感知轨迹选择
为从proposal集中选择最优规划轨迹,我们训练神经评分器评估最终proposal。具体而言,对proposal查询在航点维度上进行最大池化,得到池化特征,随后输入多层感知机(MLP)生成proposal分数。评分器通过二元交叉熵(BCE)损失训练:
其中。监督信号来自基于模拟器的EPDMS评估,同时用于定义候选伪目标。
尽管多模态轨迹蒸馏提升了proposal多样性,但可能加剧时序的不一致性,导致相邻时间帧间变异过大,降低舒适性。为缓解这一问题,我们通过引入舒适项使分数具备动量感知能力。设为前一时间帧选择的轨迹,通过比较与当前所有proposal计算基于畸变的舒适分数,并通过以下公式重新校准学习分数:
其中权重设置遵循NAVSIM v2。最终选择的轨迹形式化为:
其中表示proposal的重新校准分数。
损失函数
在端到端驾驶任务中,添加辅助任务以增强模型的环境理解能力至关重要,例如BEV地图分割、3D目标检测和跟踪。然而,这些传统密集型理解任务计算开销大,因此我们采用轻量级辅助任务,其包含丰富的时空信号且与proposal-centric设计兼容。
我们采用两个辅助任务:proposal-centric映射和碰撞预测。对于第一个任务,模型预测proposal航点的在路概率和在路线概率,记为,proposal-centric映射损失为。
对于proposal-centric碰撞预测,通过日志重放模拟估计中航点的碰撞概率。该任务不仅要求模型检测周围目标,还需理解其运动模式。proposal-centric碰撞损失为。
Drive-JEPA是端到端可微分的,训练损失定义为:
其中、、。
三、实验结果分析
主要结果
NAVSIM v1上的结果:如表2所示,与现有方法相比,Drive-JEPA使用ResNet34主干网络时取得了最佳PDMS。使用ViT/L时,Drive-JEPA仅次于采用先进数据增强的DriveSuprim。值得注意的是,在保持高安全指标(如NC、DAC和TTC)的同时,Drive-JEPA实现了最佳自车进度(EP),呈现出果断的驾驶风格。
perception-free端到端自动驾驶:Drive-JEPA在perception-free设置下评估了方法,使用简单解码器和预训练ViT编码器。如表2所示,无论主干网络规模如何,我们的方法均大幅超越现有方法,PDMS甚至接近依赖感知标注的最先进方法,突显了V-JEPA预训练的优势。

NAVSIM v2上的结果:NAVSIM v2的指标比v1更复杂,但我们的方法仍优于所有现有方法。现有方法在扩展舒适性(EC)上表现不佳,而我们的方法在该指标上表现出色,同时在安全指标、交通规则合规性和自车进度上也取得了良好结果。
Bench2Drive上的结果:Bench2Drive在闭环仿真中评估自主智能体。Drive-JEPA取得了最佳驾驶分数(DS),且效率极具竞争力。与另一种proposal-centric方法iPad相比,Drive-JEPA的驾驶分数高出4分,验证了多模态轨迹蒸馏的有效性。


消融实验
所提模块的消融实验:我们首先对所提模块进行消融实验::V-JEPA 2预训练权重;:驾驶视频预训练;:多模态轨迹蒸馏;:动量感知轨迹选择。如表5所示,将ResNet34替换为V-JEPA 2发布的ViT()提升了EPDMS;驾驶视频预训练通过缩小领域差距进一步提升性能();加入后,框架实现了更优的多样性(D和整体指标(图5的验证分数曲线也支持这一结论),但多样性增加导致EC下降;最终加入不仅将EC大幅提升至84.8,还创下了EPDMS的新纪录。


伪教师轨迹数量的消融实验:如表6所示,我们尝试了个伪教师轨迹。尽管与EPDMS的相关性不强,但使用伪教师轨迹始终比不使用()表现更优。

驾驶视频预训练的消融实验:使用相同的简单解码器,搭配主流预训练方法训练的编码器。如表7所示,V-JEPA 2在这些方法中表现最佳,MAE和DepthAnything无法收敛。这突显了V-JEPA目标在视频预训练中的优势。本文中,我们构建了大规模驾驶视频数据集,基于该数据集和V-JEPA目标训练的ViT/L编码器进一步提升了性能,比最先进的Epona高出3个PDMS。

四、结论
Drive-JEPA是一种新的端到端驾驶框架,它将V-JEPA视频预训练与多模态轨迹蒸馏相结合,以缓解模仿学习中的模式崩溃问题。在大规模驾驶视频上预训练视觉Transformer(ViT)编码器,能够得到强大的规划表示,使简单解码器在perception-free设置下也能实现具有竞争力的性能。通过蒸馏模拟器引导的伪教师轨迹,proposal的多样性得到提升,而动量感知选择机制进一步增强了时间稳定性和驾驶舒适性。Drive-JEPA在NAVSIM v1/v2基准测试中取得了最先进的结果,并在Bench2Drive上提升了闭环性能。
....
#DiffusionDriveV2
时隔一年DiffusionDrive升级到v2,创下了新纪录!
时隔一年,DiffusionDrive终于升级到v2了。华科王兴刚教授团队近年来产出了很多大家耳熟能详的工作,比如MapTR、VAD系列、ReCogDrive、首个闭环3DGS训练框架-RAD、DiffusionDrive等等工作,而廖本成博士也是这些工作的核心开发者。
在端到端自动驾驶的轨迹规划任务中,扩散模型常面临mode collapse的问题,倾向于生成保守且单一的行为。尽管DiffusionDrive通过预定义的锚点(代表不同驾驶意图)对动作空间进行划分,从而生成多样化轨迹,但该方法依赖模仿学习,缺乏足够约束,导致在多样性与持续高质量之间陷入两难困境。本文提出DiffusionDriveV2,利用强化学习既约束低质量模式,又探索更优轨迹。
该方法在保留核心高斯混合模型固有多模态特性的同时,显著提升了整体输出质量。首先,引入适用于轨迹规划的尺度自适应乘法噪声,以促进更广泛的探索;其次,采用锚点内GRPO管理单个锚点生成样本间的优势估计,并通过锚点间截断GRPO整合不同锚点的全局视角,避免不同意图(如转弯与直行)间不当的优势比较(此类比较可能进一步导致mode collapse)。在NAVSIM v1数据集的闭环评估中,DiffusionDriveV2结合对齐的ResNet34网络实现了91.2的PDMS,在NAVSIM v2数据集上实现了85.5的EPDMS,创下新纪录。进一步实验验证,该方法解决了截断扩散模型在多样性与持续高质量之间的矛盾,实现了最优权衡。
- 论文链接:https://arxiv.org/abs/2512.07745
- 论文标题:DiffusionDriveV2: Reinforcement Learning-Constrained Truncated Diffusion Modeling in End-to-End Autonomous Driving
- 开源链接:https://github.com/hustvl/DiffusionDriveV2
一、背景回顾
近年来,随着3D目标检测、多目标跟踪、预训练、在线建图和运动预测等传统任务的日益成熟,自动驾驶系统的发展浪潮已转向端到端自动驾驶(E2E-AD)——该方法直接从原始传感器输入中学习驾驶策略。
该领域的早期方法在建模方面存在局限性:传统端到端单模态规划器仅回归单一轨迹,无法在高不确定性的复杂驾驶场景中提供备选方案;基于选择的方法采用大型静态候选轨迹词汇库,但这种离散化方式灵活性有限。
近年来,已有多项研究将扩散模型应用于轨迹生成,该模型可根据周围场景动态生成少量候选轨迹。然而,将原始扩散模型直接应用于多模态轨迹生成时,会面临模式崩溃的挑战——模型会收敛到单一高概率模式,无法捕捉未来的多样性可能,如图1(a)所示。为解决这一问题,DiffusionDrive提出利用多个预定义轨迹锚点定义的高斯混合模型(GMM)构建初始噪声的先验分布。这种结构化先验将整个生成空间划分为多个子空间,每个子空间对应特定驾驶意图(例如,一个模式用于变道,另一个用于直行),从而有效促进多样化行为模式的生成。

然而,DiffusionDrive受限于模仿学习(IL)范式,在生成轨迹的多样性与持续高质量之间陷入根本性两难。尽管高斯混合模型先验确保了模式生成的多样性,但其训练目标旨在最大化整个混合模型中专家轨迹的似然性,而在实际应用中被简化为仅优化单一正模式(即与专家轨迹最接近的模式)的参数。因此,该方法忽略了对来自负模式(占样本绝大多数)的采样轨迹施加任何显式约束,导致模型在生成高质量轨迹的同时,也会产生大量无约束、低质量且常发生碰撞的轨迹,无法保证持续的高质量,如图1(b)所示。
这种危险的混合轨迹迫使系统依赖下游选择器,但由于选择器的参数通常远少于生成器,其鲁棒性更弱。这种过度依赖存在显著风险:当筛选大量低质量轨迹时,尤其是在分布外场景中,选择器容易失效。
强化学习(RL)为这一困境提供了强有力的解决方案。与局限于单一正模式的模仿学习不同,强化学习采用“探索-约束”范式:一方面,通过对所有模式施加目标对齐约束来提高模型的下限——奖励期望行为,同时惩罚负模式的不安全动作;另一方面,通过推动模型探索更广泛的动作空间来提高模型的上限,寻求在质量和效率上可能超越专家的策略。
受DeepSeek-R1成功的启发,已有多项研究将GRPO引入端到端自动驾驶领域,但这些应用仅限于原始扩散模型。与这些方法不同,在基于锚点的截断扩散模型中,每个预定义轨迹锚点代表不同的驾驶意图。若直接对不同驾驶意图对应的轨迹进行优势估计,会加剧模式崩溃。例如,左转轨迹和直行轨迹应共存,而非进行优劣比较。这一见解促使我们提出锚点内GRPO:通过仅在每个锚点内进行组优势估计,阻止不同意图间的比较,从而防止模式崩溃;同时引入锚点间截断GRPO,以提供全局视角并稳定训练。
借助这些创新,本文提出一种新型框架DiffusionDriveV2,利用强化学习解决DiffusionDrive因依赖模仿学习而面临的多样性与持续高质量之间的两难问题。我们在面向规划的NAVSIM v1和NAVSIM v2数据集上通过闭环评估对该方法进行基准测试。DiffusionDriveV2在两个基准测试中均达到当前最优水平:结合ResNet-34主干网络,在NAVSIM v1上实现91.2的PDMS,在NAVSIM v2上实现85.5的EPDMS,相比现有方法有显著提升。此外,与其他基于扩散的生成模型相比,DiffusionDriveV2在轨迹多样性与持续高质量之间实现了最优权衡。
本文的贡献可总结如下:
- 提出DiffusionDriveV2——一种引入强化学习的新型方法,用于解决DiffusionDrive因模仿学习中多模态监督不完整而导致的多样性与持续高质量两难问题。据我们所知,DiffusionDriveV2是首个直接面对并解决这一困境的工作。
- 引入锚点内GRPO和锚点间截断GRPO,解决了将原始GRPO直接适配到DiffusionDrive时,在高斯混合模型框架下无法跨不同模式进行组优势估计的问题。DiffusionDriveV2是首个成功将GRPO迁移到截断扩散模型的工作。
- 采用尺度自适应乘法噪声作为探索噪声,而非加法噪声,有助于保留探索轨迹的平滑性和连贯性。
- 在NAVSIM v1和NAVSIM v2基准测试中的大量评估表明,DiffusionDriveV2在保留底层高斯混合模型生成多模态轨迹能力的同时,显著提升了整体输出质量,实现了当前最优性能。
二、预备知识
端到端自动驾驶
端到端自动驾驶(E2E-AD)系统通过模仿学习习得专家驾驶策略,将原始传感器数据映射为未来自车轨迹预测结果。轨迹由一系列未来路径点表示,记为,其中为第时刻路径点的位置,代表规划时域。
截断扩散模型
扩散策略模型通过学习反向马尔可夫噪声过程,对随机高斯噪声进行迭代优化,从而生成轨迹。然而实验表明,原始扩散模型易出现模式崩溃问题,无法生成多样化驾驶行为。这使其难以应对复杂驾驶场景,无法提供丰富的备选轨迹(例如跟车与超车、路口直行与左转等场景)。
为解决原始扩散模型的模式崩溃问题,DiffusionDrive提出将轨迹分布建模为高斯混合模型(Gaussian Mixture Model, GMM)分布。该方法通过K-Means算法对专家驾驶行为进行聚类,得到个锚点轨迹,用这组离散轨迹表示不同的驾驶意图。每个锚点对应轨迹空间中的特定区域,进而代表一种具体驾驶意图(如超车、左转或直行)。锚点对应的轨迹分布可表示为:
值得注意的是,与直接从随机噪声中预测轨迹的原始扩散模型不同,DiffusionDrive的训练目标是预测轨迹与其对应锚点之间的偏移量。其中表示基于场景上下文的、相对于锚点状态的场景特定偏移量。整个轨迹分布可表示为:
该分布即为高斯混合模型,其中为混合权重,表示在给定场景上下文时,选择锚点所对应驾驶意图的概率。
DiffusionDrive采用截断扩散过程,通过缩短标准噪声调度表,将每个锚点轨迹扩散为对应的锚定高斯分布:
其中,且(为标准扩散模型的噪声步数),为截断扩散步数。训练阶段,DiffusionDrive以锚定高斯分布中采样的带噪轨迹为输入,预测去噪后的轨迹及概率得分(其中是公式(2)中的简写)。
然而,DiffusionDrive仍受限于模仿学习(IL)的固有缺陷。尽管其基于锚点的设计缓解了模式崩溃问题并提供了多样化轨迹选择,但训练过程本质上受限于每个场景仅存在一条真实轨迹(GT trajectory)。因此,模型在训练时仍需选择一个锚点作为正模式进行优化:将与真实轨迹最接近的锚点指定为正样本(),其余锚点则为负样本()。训练目标函数为:
受模仿学习的约束,每个场景中仅有一个模式能获得监督。这导致模型虽能生成多样化轨迹,但也会产生大量可能引发碰撞的低质量轨迹,对系统安全性构成重大威胁。
DiffusionDriveV2算法详解
截断扩散生成器
本文提出的DiffusionDriveV2整体架构如图2所示。为生成多模态轨迹,我们直接采用DiffusionDrive作为轨迹生成器,并利用其在真实轨迹上通过模仿学习预训练得到的权重实现冷启动,使模型初步具备多模态轨迹生成能力。基于感知网络提取的特征,截断扩散解码器以锚定高斯分布中采样的带噪轨迹为输入,经过步迭代优化后,生成最终的去噪轨迹。

面向扩散生成器的强化学习
尽管DiffusionDrive在多模态轨迹生成方面表现出较强能力,但它继承了模仿学习的核心缺陷——对负模式缺乏监督。这往往导致低质量轨迹的生成,对系统构成严重威胁。为解决该问题,我们引入轨迹级强化学习目标,对所有模式施加约束,同时推动模型探索更优驾驶策略。受DPPO启发,我们将去噪过程视为马尔可夫决策过程(MDP)。从锚点出发的扩散链中,每个条件去噪步骤均可视为一个高斯策略:
其中为模型预测的均值,由预定义的噪声调度表确定。
该式表示高斯似然,可通过解析方式求解,且适用于基于REINFORCE的策略梯度更新:
,其 中表示优势函数。 ### 尺度自适应乘法探索噪声 DiffusionDrive采用DDIM更新规则,将去噪步数大幅减少。该更新规则通常通过设置作为确定性采样器使用。为实现更广泛的探索并避免狄拉克分布下的似然计算问题,我们在训练阶段设置以引入探索噪声(等价于采用DDPM),而在验证阶段保持以实现确定性推理。 然而,由于轨迹的近端段与远端段存在固有尺度不一致性,直接在每个点施加加法高斯噪声会破坏轨迹的结构完整性,降低探索质量。如图3(a)所示,对标准化轨迹施加加法高斯噪声后,生成的探索路径通常呈锯齿状(类似折线),丧失了原始轨迹的平滑性。为保留轨迹连贯性,我们提出仅添加两个乘法高斯噪声(一个纵向噪声、一个横向噪声),其表达式为,其中。这种尺度自适应乘法噪声确保生成的探索路径保持平滑,如图3(b)所示。 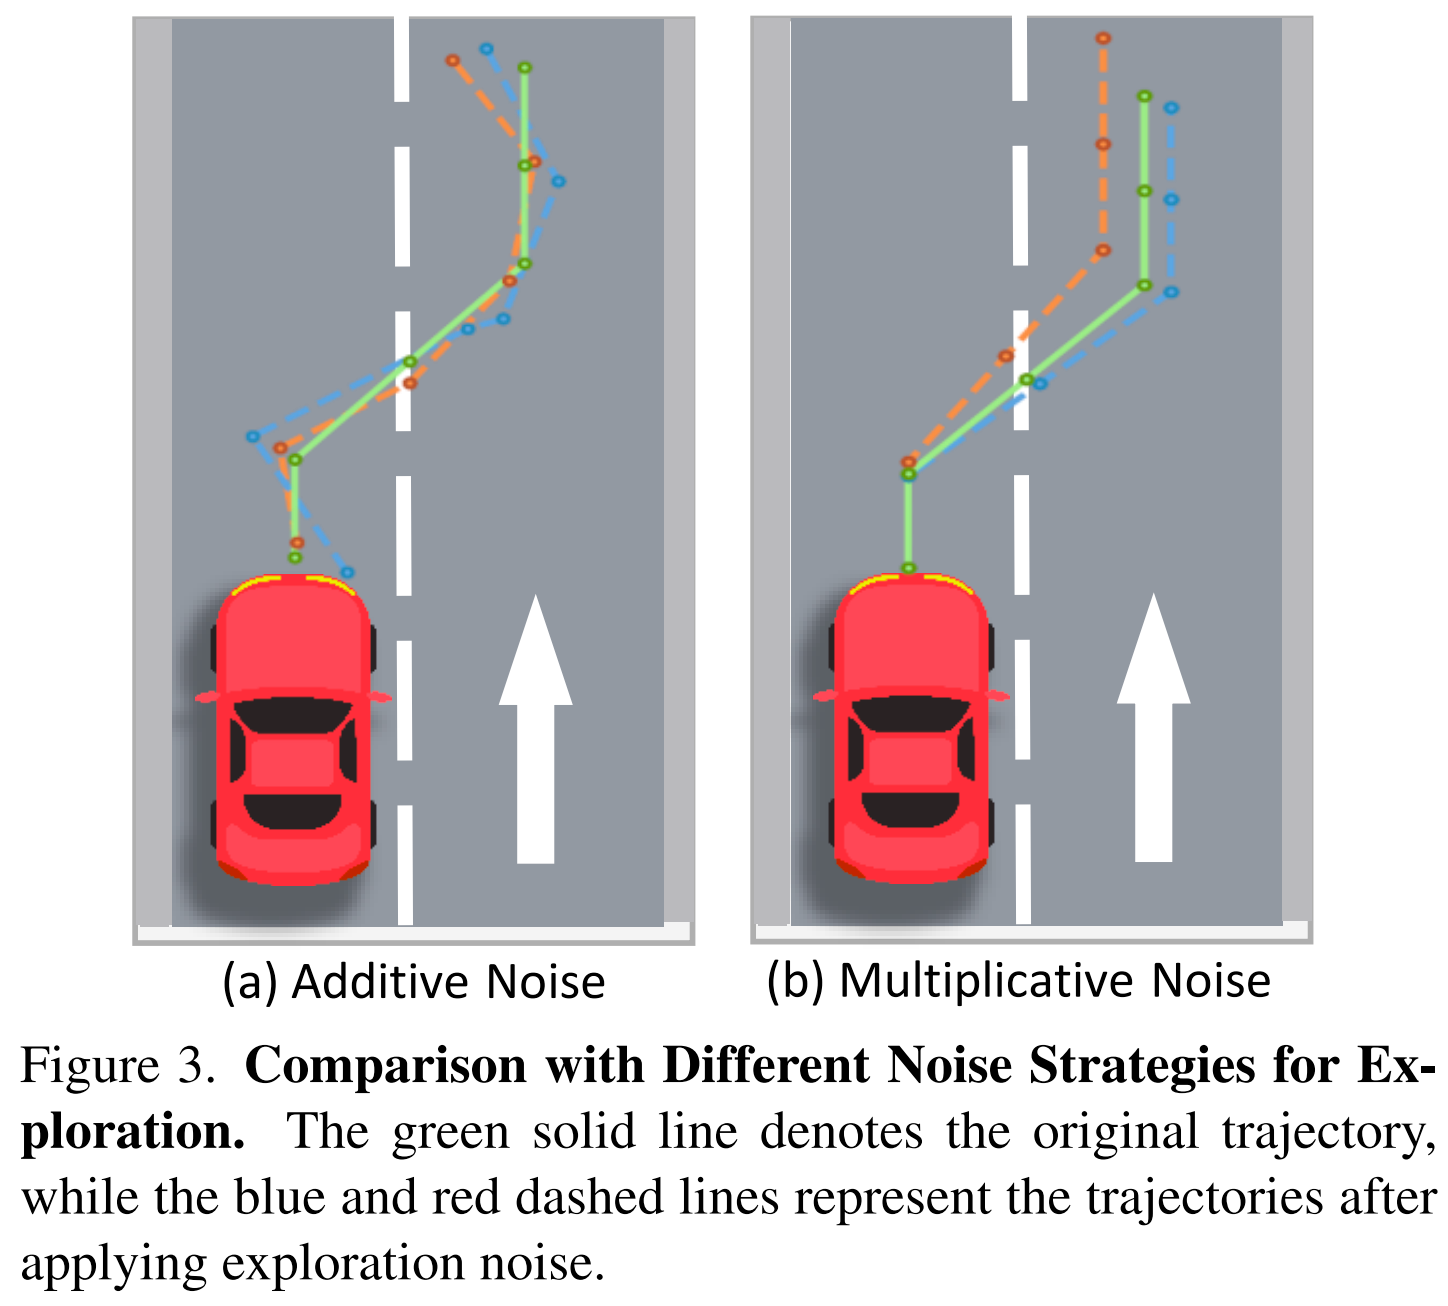 ### 面向轨迹生成的锚点内GRPO GRPO是一种适用于多智能体或多模式场景的强化学习方法,其通过共享的组级基线更新每个智能体的策略。与传统PPO不同,该方法通过基于组条件期望归一化的优势函数定义策略梯度。通过利用轨迹级奖励优化非可微目标,GRPO对标准模仿学习进行了增强,可引导扩散模型生成多样化、面向目标的轨迹,且性能有望超越人类驾驶员。 然而,若直接将不同锚点采样的轨迹作为GRPO策略更新的“组”,则会适得其反。这种做法与我们利用锚点将轨迹空间划分为不同驾驶意图对应区域的核心动机相冲突,甚至会导致模式崩溃。例如,若将代表“右转”和“直行”的锚点采样轨迹(如图2中红色和绿色轨迹)进行相对优化,策略可能会崩溃为更常见的“直行”单一模式。这些锚点代表本质不同的意图,不应在同一优化组内直接比较。 基于这一洞察,我们提出锚点内GRPO(Intra-Anchor GRPO)。对于每个锚点,首先通过随机高斯噪声和探索噪声对其进行扩散,生成个轨迹变体组成的组;随后在该组内执行GRPO更新,而非跨不同锚点的组进行更新。该方法将策略优化约束在每个特定行为意图的状态空间内,引导模型生成更安全、更面向目标的轨迹,同时不损害其多模态能力。强化学习损失函数可表示为:
其中为折扣系数,用于缓解早期去噪步骤中的不稳定性;为优势函数,GRPO通过计算组相对优势进行估计,无需价值模型:
为基于最终去噪轨迹计算的单一奖励估计值,该奖励被应用于扩散链中的所有去噪步骤,且每个步骤的影响通过去噪折扣进行缩放。
此外,与原始GRPO通过添加策略模型与参考模型之间的KL散度实现正则化类似,我们引入额外的模仿学习损失,以防止模型过拟合并保障其通用驾驶能力。组合损失函数为,其中为权重系数。
面向轨迹生成的锚点间截断GRPO
锚点内GRPO虽能防止模式崩溃,但完全隔离不同模式会引发新问题:优势估计丧失全局可比性。例如,某一模式中次优但安全的轨迹可能获得负优势,而另一模式中危险且存在碰撞的轨迹若为其组内“最优”样本,则可能获得正优势。这种依赖局部组内比较的方式会向模型传递误导性学习信号。
为解决该问题,我们提出锚点间截断GRPO(Inter-Anchor Truncated GRPO),其核心原则简洁而有效:奖励相对改进,但仅惩罚绝对失败。具体实现方式为修改锚点内GRPO的优势估计:将所有负优势截断为0,并对存在碰撞的轨迹分配-1的强惩罚:
这一设计为模型提供了清晰且一致的学习信号。随后,该截断优势将替代公式(7)中的用于强化学习损失计算。
模式选择器
我们在模型末尾添加了一个模式选择器,负责从代表不同意图的多模态预测结果中选择最优、与目标最对齐的轨迹。得分越高表示与整体目标的对齐程度越强。具体而言,轨迹坐标首先作为查询向量,通过可变形空间交叉注意力与BEV特征交互,随后通过与智能体查询和地图查询的交叉注意力层进行优化;最后,富含上下文的特征表示被输入多层感知机(MLP)以预测得分。受DriveSuprim启发,我们采用两阶段“粗到细”评分器:首先由粗评分器筛选出排名前的候选轨迹,再由细粒度评分器进行更细致的选择。得分学习采用二元交叉熵(BCE)损失。
针对连续指标,我们引入额外的Margin-Rank损失:,其中为真实得分,为预测得分,为正超参数。该损失引导模型比较轨迹的相对质量,避免直接回归绝对连续值的难题,进而增强模型对细微差异的区分能力。
四、实验结果分析
基准测试数据集
我们在NAVSIM v1和NAVSIM v2数据集上对DiffusionDriveV2进行评估。NAVSIM基于OpenScene构建,包含一系列真实世界、以规划为核心的驾驶场景,是大规模nuPlan数据集的精简版本。该数据集的传感器套件包括8台摄像头(提供360°视野)和5台激光雷达(生成融合点云),并分为训练集(navtrain,1192个场景)和测试集(navtest,136个场景)。
实现细节
为保证公平对比,我们的模型采用与Transfuser和DiffusionDrive相同的ResNet-34主干网络,并匹配DiffusionDrive的扩散解码器尺寸。DiffusionDriveV2的输入包括3张裁剪并下采样的前向摄像头图像(拼接为1024×256尺寸),以及激光雷达点云的栅格化鸟瞰图(BEV)表示。我们以DiffusionDrive在模仿学习中预训练的权重作为冷启动,随后在navtrain训练集上通过强化学习训练10个epoch。优化器采用AdamW,学习率为,总批次大小为512,分布式训练于8台NVIDIA L20 GPU。模式选择器采用相同配置训练20个epoch。推理阶段与DiffusionDrive一致,仅需2步去噪即可生成预测结果。
主要结果
NAVSIM v1数据集结果:如表1所示,DiffusionDriveV2在NAVSIM v1测试集上实现当前最优性能,PDMS(规划决策度量分数)达到91.2。该模型相较于DiffusionDrive提升了3.1个PDMS,且EP(自车进度)分数显著提升5.3,证明其能提供更高质量、更高效的驾驶策略——这一改进归功于精心设计的强化学习方法。与同样基于强化学习的DIVER相比,DiffusionDriveV2的PDMS高出2.9,验证了锚点内GRPO和锚点间截断GRPO训练框架的卓越有效性。此外,仅配备ResNet-34主干网络(2180万参数)的DiffusionDriveV2,性能仍优于基于更大V2-99 主干网络(9690万参数)的GoalFlow和Hydra-MDP。


多样性与质量:受DIVER启发,我们引入多样性指标(Div.)定量评估模型生成多模态轨迹的能力。该指标定义路径点处的未归一化 pairwise 多样性为:
为保证不同场景下轨迹的尺度一致性,通过平均轨迹尺度对其进行归一化:
最终多样性得分为所有路径点的平均值。为评估生成轨迹的整体质量,我们进一步报告Top-K PDMS(前K个排名轨迹的PDMS分数)。由于基于回归和基于选择的端到端自动驾驶方法仅能生成确定性轨迹,我们仅在测试集中将本文方法与其他基于扩散的方法进行对比。参考DiffusionDrive的设置,每个模型生成20条轨迹用于评估,结果如表3所示。

结果验证了我们的理论:原始扩散方法生成质量稳定但缺乏多样性,陷入单一“保守”轨迹;DiffusionDrive生成多样性极高,但无法保证持续高质量;而DiffusionDriveV2通过精心设计的强化学习算法实现“探索-约束”效果——对所有模式施加约束以提高模型下限(Top-10 PDMS),同时推动模型探索更优策略以提高模型上限(Top-1 PDMS)。该方法解决了截断扩散模型在多样性与持续高质量之间的矛盾,实现了最优权衡。
消融实验
我们通过一系列消融实验验证DiffusionDriveV2各设计模块的有效性。为保证公平对比,所有实验采用相同超参数配置,并通过减少训练轮数实现快速验证。
探索噪声类型:表4展示了不同探索噪声的对比结果。实验证实,尺度自适应乘法噪声优于加法噪声,能有效解决轨迹近端与远端的尺度不一致问题。



更多可视化结果



五、结论
本文提出DiffusionDriveV2框架,通过结合锚点内GRPO、锚点间截断GRPO与尺度自适应乘法探索噪声,解决了DiffusionDrive因模仿学习多模态监督不完整而面临的多样性与持续高质量两难问题。大量实验和定性对比验证,DiffusionDriveV2在保证规划质量持续优异与模式多样性之间实现了最优权衡,并取得了当前最优的闭环性能。
...
#Percept-WAM
真正「看懂世界」的自动驾驶大脑,感知到行动的一体化模型
在过去几年,自动驾驶圈流行一句话:「大模型会说话,但不会开车。」
一方面,大规模视觉语言模型(VLM)在文本理解和逻辑推理上突飞猛进;另一方面,一旦把它们放到真实道路上,让它们处理长尾场景、远距离目标和复杂博弈时,这些 “聪明大脑” 却常常犯低级错误:看不清、定位不准、反应不稳定。深层原因在于 —— 现有 VLM 在空间感知和几何理解上的能力,远远跟不上它们在语义层面的 “表达能力”。
为了让大模型真的能 “看懂世界”,在很多现有方案中,研究者会在训练中加入一些 “感知类 QA” 问题,比如问 “左前方有没有车”“两车距离有多远”。但这类监督更多停留在语义标签和粗略相对关系层面,并没有让模型真正学会可用于控制决策的强 2D/3D 感知能力 —— 例如精确、稳定的检测框、分割结果和 BEV 感知信息。换句话说,今天很多 VLA 仍然停留在「会回答关于世界的问题」,而不是「真的看清这个世界」。这种 “弱感知的大模型”,显然不足以支撑自动驾驶和广义xx智能对空间理解的高要求。
近日,来自引望智能与复旦大学的研究团队联合提出了一个面向自动驾驶的新一代大模型 ——Percept-WAM(Perception-Enhanced World–Awareness–Action Model)。该模型旨在在一个统一的大模型中,将「看见世界(Perception)」「理解世界(World–Awareness)」和「驱动车辆行动(Action)」真正打通,形成一条从感知到决策的完整链路。
- 论文标题:Percept-WAM: Perception-Enhanced World-Awareness-Action Model for Robust End-to-End Autonomous Driving
- 论文链接:https://arxiv.org/abs/2511.19221
整体架构 / 任务介绍
在架构设计上,如图 1 所示,Percept-WAM 基于具备通用推理能力的 VLM 主干构建,在保留其原有语言与推理优势的同时,引入 World-PV / World-BEV 世界 Token,统一 PV / BEV 视角下的 2D/3D 感知表示:通过可学习的 BEV 级栅格 Token 将多视角 PV 特征隐式映射到 BEV 空间,并采用栅格条件(grid-conditioned)预测机制;在解码侧,则结合 IoU-aware 置信度输出与并行自回归解码等关键技术来提升输出的精度及效率,同时配备轻量级动作解码头,用于高效预测未来行车轨迹。
在训练任务上,Percept-WAM 接收多视角流式视频、LiDAR 点云 (可选) 以及文本查询作为输入,在同一模型上联合优化 PV 下的 2D 检测、实例分割、语义分割、单目 3D 检测任务等, BEV 下的 3D 检测与 BEV map 分割任务等,以及基于多帧输入的轨迹预测任务。

图 1:Percept-WAM 模型整体架构图
核心设计:World-PV / World-BEV
把世界压成一组 Token
Percept-WAM 围绕 World–Awareness–Action 构建统一的世界 token 空间:多视角图像和 3D 场景被压缩为一小组结构化 World tokens。每个 token 显式携带语义特征、空间位置以及置信度,用作 2D/3D 感知、轨迹预测等下游任务的共享世界表征。
在图像平面,World-PV tokens 将每帧图像划分为规则栅格,每个栅格对应输出一组 token,联合编码局部外观与 2D/3D 几何信息(如像素坐标、归一化尺寸、视线方向等)。基于同一组 PV tokens,模型可以统一建模 2D 检测、实例 / 语义分割、单目 3D 检测等任务,后续再叠加栅格条件预测与 IoU-aware 评分机制,提升密集 2D 感知的稳定性和排序质量。
在鸟瞰 (BEV) 视角,World-BEV tokens (根据是否存在 Lidar 点云特征,可选的从 LiDAR 特征初始化或随机初始化) 对应覆盖前方场景的固定分辨率 BEV 网格单元。每个 BEV token 通过与多视角 PV 特征的交互,隐式建模 PV 到 BEV 上的映射,聚合该网格区域的占据状态、语义类别和运动属性(如速度、朝向等),在世界 token 空间中显式刻画道路结构与交通参与者的空间关系。
栅格条件预测 + IoU-aware:
稳定密集场景感知
为支撑城市场景中的高密度目标预测及对应物体预测置信度的矫正,Percept-WAM 在解码端引入 栅格条件预测(Grid-Conditioned Prediction) 和 IoU-aware 置信度回归 两项关键设计。
栅格条件预测借鉴了 UFO [1] 的思想,将整个特征空间按 PV/BEV 栅格划分为多个子区域,并围绕每个栅格构造局部自回归序列,其中 (i) 每个栅格对应一条局部自回归子序列,只回归该区域内对应的候选目标;(ii) 不同栅格之间通过注意力 mask 做隔离,限制跨区域的无关交互,进行并行训练及预测,显著缩短了单序列长度,减轻了超长序列导致的训练不稳定和目标间干扰,提升了高密度场景下的收敛性与训推效率。
IoU-aware 置信度预测则显式建模候选框的定位质量。在训练阶段监督置信度微调数据集(Confidence-tuning Dataset)的分值 token,在推理阶段输出预测框与真实框的 IoU 预测结果,并将该 IoU 置信度分数与分类分数联合用于整体置信度排序。相比仅依赖分类得分的传统方案,这一设计在小目标、远距离目标以及长尾类别上能够提供更一致的候选排序,减少 NMS 阶段的误删与误保留,从而整体提升密集检测的可靠性。

图 2:利用 IoU-aware 置信度来显式建模候选框的定位质量,(a) 不同产生 IoU score 训练数据集的方式对比;(b) 原有训练数据以及带 IoU Score 训练数据的不同 loss mask 方式对比
从感知到轨迹:
World–Action 打通决策链路
Percept-WAM 模型在感知类 world tokens 之上进一步引入 World–Action tokens,用于动作与轨迹预测的查询(queries)。这些 tokens 从 World-PV / World-BEV 等感知 tokens 中聚合多视角图像与 BEV 表征(以及可选 LiDAR)的信息,并与历史轨迹、车速、转向等车辆状态融合,在统一坐标系下直接生成未来规划轨迹或控制信号;相比 “先产出 BEV 特征、再交由独立规划网络 (Diffusion)” 的两阶段方案,World–Action 在同一 token 空间内完成从世界建模到决策输出,使感知与规划在表示空间和时空对齐上天然一致。
在解码方式上,Percept-WAM 将未来轨迹离散为一系列关键点或片段,结合并行化策略进行加速,避免传统自回归 “一点一点推” 的 AR 推理的效率瓶颈。具体来说,在轨迹解码方式上,Percept-WAM 采用轻量级 MLP 解码头驱动的 query-based 轨迹预测:World–Action 由一组功能不同的查询组成,其中一部分查询仅关注自车状态特征(只与 Ego-state 交互),一部分查询仅关注 PV 侧特征(只与 World-PV 交互),一部分查询仅关注 BEV 侧特征(只与 World-BEV 交互),还有一部分同时汇聚所有输入特征的信息,在融合视角下输出最终轨迹。这种多组查询并行工作的方式,一方面保留了 PV / BEV 各自对局部几何与全局结构的优势,另一方面通过共享的 World tokens 建立统一的世界状态,避免轨迹预测任务过度依赖部分输出特征。

图 3:轨迹解码 head 结构可视化,不同组 query 关注不同的特征 (如自车,PV,BEV 特征),Qfull 关注所有的特征并输出最终轨迹
面向连续驾驶场景,Percept-WAM 引入 streaming inference:在时间维度上采用 streaming KV cache strategy 复用历史帧的注意力缓存,仅对新到达的帧做增量计算;同时通过 longer-clip training scheme 和 dual-recomputation KV cache mechanism 缓解训练–推理范式不一致带来的 distribution drift 与误差累积,从而在几乎不牺牲规划精度的前提下,显著降低多帧多视角端到端推理的时延与计算开销。
实验结果:
高水平感知 + 强力轨迹规划一体化模型
在公开基准上,Percept-WAM 在 PV 视角感知、BEV 视角感知以及端到端轨迹规划 三个层面相较于现有模型均展现出强竞争力。
1)PV 视角:统一 PV 场景下感知的 World-PV
在图像平面上,Percept-WAM 基于 World-PV tokens 统一建模 2D 检测、实例 / 语义分割与单目 3D 感知任务,具体表现为:
- 与专用感知模型的对比
如表 1 所示,在 nuImages /nuScenes 的 PV 任务上,Percept-WAM 在 2D 与 Mono 3D 上整体匹配或超过专用模型 —— 在 2D detection 上达到 49.9 mAP,相比 Mask R-CNN 的 47.8 mAP 有明显提升;在 2D instance segmentation 上取得 41.7 mAP,高于 Mask R-CNN 的 38.6 mAP;在 mono 3D detection 上达到 33.0 mAP,同样优于 FCOS3D 的 32.1 mAP。
- 2D–3D 协同与多任务联合训练增益
实验观察到明显的 2D–3D 协同效应:在统一 World-PV 表征下联合建模 2D 与 3D 检测,可带来约 +3.2 mAP 的 2D 检测增益。进一步在自动驾驶 PV 数据集上对所有 PV 任务进行联合训练,各基准上基本维持一致或提升,说明统一的 World-PV token 空间有利于在多任务之间共享有用的几何与语义信息。

表 1: PV 场景下 Percept-WAM 的效果与其他主流模型的对比
- 置信度分数矫正的影响
该文章同时可视化了预测的置信度分数(x 轴)与对应框真实 IoU(y 轴)之间的关系。如下图所示,引入 IoU-based confidence prediction 后,散点分布整体向 y = x 附近收敛,而在基于 model-prediction 数据集进行训练的设置下,曲线与对角线的贴合度最高,说明预测分数与真实定位质量更加一致,更适合作为后续筛选与排序的依据。

图 4: PV 任务上置信度分数矫正前后分数分布对比,不同图像代表不同的置信度分数构建方式或者不同的带 IoU score 的训练数据生产方式
2)BEV 视角:World-BEV 承载 3D 场景理解
在 BEV 空间中,Percept-WAM 通过 World-BEV tokens 统一建模路面占据、动态目标与地图语义。如表 2 所示,即便在不使用时序信息、且采用相对较低图像分辨率(448×796)的设置下,仍在 nuScenes 上展现出强竞争力的 BEV 感知能力:
- BEV 3D 检测性能
在 nuScenes BEV 3D detection 上,Percept-WAM 在无时序、低分辨率输入的条件下依然取得 58.9 mAP,整体表现优于经典 BEV 检测方法,如 PointPillars 与 SECOND 等 specialist 检测器。
- BEV map segmentation 与静态语义建模
在 BEV map segmentation 任务上,基于 World-BEV tokens 的分割头可以同时刻画车道线、可行驶区域、行人横穿区等静态语义要素;在部分关键类别(如 drivable area、pedestrian crossing)上,Percept-WAM 的分割结果可以超过 BEVFusion 等专用 BEV 模型。

表 2: BEV 场景下 Percept-WAM 的效果与其他主流模型的对比
3)端到端轨迹规划:World–Action 连接世界与控制
在端到端轨迹规划上,如表 3 所示,搭载 World–Action 轨迹解码头的 Percept-WAM 在 nuScenes 与 NAVSIM 上都取得了有竞争力的表现,并优于多种现有 BEV-based 与 VLM-based 方案。具体来看:
- nuScenes 开环轨迹评估
在 nuScenes 的 open-loop 轨迹指标上,Percept-WAM 的平均轨迹 L2 误差约为 0.36 m,在同等设置下优于多数 BEV-based 方法(如 UniAD)以及 VLM-based 方法(如 DriveVLM)。
- NAVSIM 闭环驾驶性能
直接轨迹模仿学习难以兼顾开环与闭环指标,因此在 NAVSIM 的 closed-loop 评测中,Percept-WAM 采用对聚类轨迹打分的方式,获得约 90.2 的综合得分,同样优于大部分现有端到端方法。实验同时表明,两阶段训练策略(先在感知与中间任务上预训练,再在规划任务上进一步微调)可以进一步提升端到端驾驶性能。

表 3: 轨迹预测场景下 Percept-WAM 的效果与其他主流模型的对比
在定量结果之外,我们还给出三类代表性可视化示例:(i)PV 视角下的 2D 检测 / 实例分割与 mono 3D 检测结果,(ii)BEV 视角下的 3D 检测与 map 分割,(iii)NAVSIM /nuScenes 场景中的端到端规划轨迹。

图 5: PV 感知上 Percept-WAM 预测结果可视化,图中展现了不同任务的可视化结果以及对道路上非白名单障碍物的检测情况

图 6: BEV 感知上 Percept-WAM 的 3D 检测及 Map Segmentation 结果

图 7: 轨迹预测任务上针对于路面难例 case,Percept-WAM 具有较强的预测鲁棒性
总结来看,Percept-WAM 指出了一条面向未来的演进路径:在统一大模型中做强世界感知,用 World tokens 一体化打通世界表征与行为决策,逐步沉淀可持续演进的自动驾驶世界模型。它的价值不在于 “又多了一个更大的模型”,而在于给出了一个更完整、工程上可落地的范式 —— 自动驾驶的大模型不应该只是会聊天、会问答的 “语文老师”,而应该是一个真正能构建世界、理解世界并在其中安全行动的 “世界大脑”。
参考文献:
[1] UFO: A Unified Approach to Fine-grained Visual Perception via Open-ended Language Interface
...
#Think Before You Drive
澳门大学首个世界模型驱动的视觉定位框架!
在自动驾驶的交互场景中,最尴尬的时刻莫过于此:
乘客指着前方复杂的路口说:“跟着那辆SUV”。自动驾驶系统看着眼前三辆长得差不多的车,内心OS:“哪辆?是左边那辆?还是正在变道那辆?”
现有的自动驾驶视觉定位(Visual Grounding)模型,大多像是一个“只会看图说话”的愣头青。它们盯着当前的这一帧画面,试图从像素里找答案。一旦指令模糊,或者目标被遮挡,它们就很容易“指鹿为马”,甚至引发错误推理。
- 论文题目: Think Before You Drive: World Model-Inspired Multimodal Grounding for Autonomous Vehicles
- 论文链接:https://arxiv.org/abs/2512.03454
人类司机为什么不会弄错?因为我们会“预判”。
当我们听到指令时,大脑里会瞬间推演未来的画面:左边那辆车马上要转弯了,不符合“跟着”的语境;只有中间那辆车在加速直行,才是最可能的意图。
“在行动之前,先思考未来”。
受此启发,来自[澳门大学]的研究团队提出了全新的框架 ThinkDeeper。这是首个将世界模型(World Model)引入自动驾驶视觉定位的研究。这项工作不仅刷新多项榜单的SOTA,还构建了一个大规模的视觉接地数据集DrivePilot。
01. 困局:自动驾驶视角的“盲区”

ThinkDeeper与传统VLM的对比
尽管视觉定位(VG)和多模态大模型(VLM)在学术界风生水起,但一旦把它们应用到现实复杂的自动驾驶场景中,往往会暴露出的三大致命软肋:
空间上的“近视眼”: 普通模型看世界是2D的,严重缺乏3D深度感知。在它们眼里,路边广告牌上的汽车和马路上的真车可能没啥区别。这种“近视眼”让它们根本分不清谁是无关紧要的“背景板”,谁是近在咫尺的“交互对象”。

基于深度的空间先验示意
时间上的“短视症”:驾驶是动态的博弈,指令往往指向未来(如“等前车转弯后,跟上去”)。但现有模型只能盯着当前的一帧画面“看图说话”,缺乏对未来状态的推演能力。这种“走一步看一步”的策略,根本无法从根源上消除指令的歧义。
落地上的“虚胖”: 这也是最现实的阻碍。像GPT或Qwen-VL这样的通用大模型虽然聪明,但参数量动辄百亿,推理延迟极高。把它们搬上算力受限的车载芯片,根本跑不动。而在毫秒必争的自动驾驶中,慢,就意味着危险。
如果自动驾驶汽车不能像人类司机一样拥有“时空前瞻性”,那么所谓的人机共驾就永远停留在“听口令做动作”的低级阶段。

ThinkDeeper总体架构
02. 破局:拒绝“走一步看一步”,让AV学会“脑补”未来
ThinkDeeper的核心思想非常直观:Think Before You Drive(三思而后行)。
它引入了一个空间感知世界模型(Spatial-Aware World Model, SA-WM)。这个模型不只是简单地处理当前的图像,它更像是给自动驾驶系统装上了一个会思考的“大脑”, 让它在做决策前,先完成两件极具“人类智慧”的事情:
第一步:去粗取精(Distill), 给视野“降噪”:ThinkDeeper会结合乘客的语音指令,从当前纷繁复杂的街景中提取出关键的“潜变量状态(Latent State)”。比如当你提到“公交车”时,它会自动过滤掉路边的树木、行人和小轿车,只保留与指令相关的核心要素。它提取的不再是死板的像素,而是与任务强相关的关键潜变量,就像人类司机在开车时,眼中只有路况,而自动忽略路边广告牌一样。
第二步:推演未来(Rollout),在脑中“放电影” 。基于提取出的关键信息,SA-WM会快速在潜意识里快速“播放”未来的画面:预测这些关键物体下一秒会在哪里、会怎么动。
通过这种“未来状态链”(Chain of Future States)的推演,ThinkDeeper获得了一个上帝视角般的前瞻性线索。
最后,再配合一个超图解码器(Hypergraph Decoder),将这些时空线索与视觉、深度信息融合,ThinkDeeper就能在极度模糊的指令下,精准锁定乘客的想去的地方。
03. 数据增强:用大模型“重塑”数据,打造DrivePilot

DrivePilot数据集总览
除了模型创新,该团队还发布了DrivePilot数据集。在自动驾驶领域,数据就是燃料。但传统的公开数据集往往面临“营养不良”的窘境:场景单一、标注只有冷冰冰的物体框,缺乏深层的语意理解。为了给AI提供最优质的“教材”,团队利用Qwen2-VL大模型的强大场景理解能力,配合RAG(检索增强生成)和CoT(思维链)技术,构建了一套自动化的高质量数据生产流水线,发布了DrivePilot数据集。

利用思维链(CoT)引导大模型生成高维语义标注的提示词设计示意
这不仅仅是数据量的堆砌,更是维度的升维。DrivePilot包含了数万个复杂场景,提供了多达14个维度的详尽语义标注,从天气变化到情绪上下文,从交通规则到驾驶意图。它让数据从枯燥的“看图画框”,进化为了一本本图文并茂、逻辑严密的“驾驶教科书”。
04. 实验结果
在Talk2Car等六大主流基准测试中,ThinkDeeper展现了令人印象深刻的表现:
- 登顶Talk2Car榜首:在这一最具挑战性的自动驾驶指令定位基准上,超越了所有现有方案。
- 专治“疑难杂症”:在DrivePilot的长文本(Long-text)、多智能体(Multi-agent)和模糊指令(Ambiguity)等Corner Case场景中,ThinkDeeper的优势尤为明显,大幅领先MiniGPT-v2/Qwen2.5-VL等通用大模型。
- 准确且高效:ThinkDeeper在保持高性能的同时,推理速度达到了39ms (A40 GPU),完全满足车载芯片的实时性要求:既跑得过SOTA,也跑得动实车。

SA-WM当前/未来潜在状态可视化及模型性能在DrivePilot数据集上的定性结果
05.结语
ThinkDeeper的出现,证明了世界模型在自动驾驶感知和人机交互理解层面的巨大潜力。它让自动驾驶汽车不再是被动接收指令的机器,而变成了一个懂得观察环境、懂得推演未来、懂得理解意图的智能体。
当自动驾驶汽车学会了“Think Before Drive”,我们离真正放心地把方向盘交给它的那天,又近了一步。
...
#Waymo Foundation Model
Waymo刚刚的基座模型分享:快慢双系统端到端 & 世界模型仿真
早上看到waymo最新的基座模型分享,柱哥抓紧解读了下,核心信息:基本上可以断定waymo在follow国内的快慢双系统端到端方案,和理想的E2E+VLM以及小鹏VLA2.0有相似之处。
在Waymo,我们正通过将“可验证安全的人工智能”置于核心优先级来攻克这一挑战——安全是我们从底层设计模型与人工智能生态系统的核心准则。由此,我们打造出了一套极其先进的人工智能系统,已实现大规模安全落地于物理世界。截至目前,我们的完全自动驾驶里程已远超1亿英里,在运营区域持续提升道路安全性——与人类驾驶员相比,严重事故发生率降低了十倍以上。
现在,我们邀请你走进这一技术核心。本文将详细解析Waymo的人工智能战略,以及该战略如何为我们注入发展动力,让安全的自动驾驶服务以史无前例的速度惠及更多用户。我们将拆解这套以Waymo基础模型(Waymo Foundation Model)为核心的整体人工智能方案,该模型支撑起统一的可验证安全人工智能生态系统,进而实现加速、持续的学习与迭代优化。
Waymo的整体人工智能方案
与其他先优化性能、再叠加安全功能的人工智能应用不同,在自动驾驶领域,安全绝不能是事后补充的考量。在Waymo,安全是我们构建人工智能生态系统不可或缺的核心基础。
实现“可验证安全的人工智能”——即安全是可被证明的,而非单纯承诺——需要一套整体方案。除了智能高效的自动驾驶系统(驾驶员),还需要一个闭环、逼真的仿真器,在各类复杂挑战场景中对“驾驶员”进行训练和严格测试;同时需要一个精准的评估系统(评论家),用于评估“驾驶员”的性能并识别改进空间。
核心优势在于统一性。我们的驾驶员、仿真器和评估器均以安全为核心联合开发,且由同一底层人工智能——Waymo基础模型——提供动力,形成持续的良性循环。

Waymo基础模型:Waymo人工智能的核心支柱
Waymo基础模型是一款多功能、顶尖的“世界模型”,为整个人工智能生态系统提供动力。其创新架构相比纯粹的端到端方案或模块化方案,具备显著优势。
具体而言,该模型充分利用习得嵌入(learned embeddings)的强大表达能力,作为模型各组件间的丰富交互接口,并在训练过程中支持完整的端到端信号反向传播。同时,其额外的紧凑、具象化的结构化表示(如目标物体、语义属性和道路图元素)可实现以下功能:
- 在“驾驶员”的推理阶段,进行有效的正确性与安全性验证;
- 实现大规模、物理层面准确且逼真的闭环仿真;
- 为评估器的评估过程和训练阶段的强化学习提供强有力的可验证反馈信号。

Waymo基础模型采用“快速反应与深度思考”(又称系统1与系统2)的架构,包含两个不同的模型组件:
- 用于快速反应的传感器融合编码器:作为基础模型的感知组件,它能实时融合摄像头、激光雷达和雷达的输入数据,生成目标物体、语义信息及丰富的嵌入特征,为下游任务提供支持。这些输入数据帮助我们的系统做出快速、安全的驾驶决策。
- 用于复杂语义推理的驾驶视觉语言模型(Driving VLM):该组件利用丰富的摄像头数据,通过Waymo的驾驶数据和任务进行微调。它基于Gemini大模型训练而成,借助Gemini的海量世界知识,更好地理解道路上罕见、新颖且复杂的语义场景。例如,在极罕见的前方道路有车辆起火的场景中,尽管物理空间和可行驶车道可能允许通行,但该视觉语言模型(VLM)能提供语义信号,促使Waymo自动驾驶系统选择其他路线或掉头避让。
这两个编码器的输出均接入Waymo的世界解码器(world decoder),该解码器利用这些输入数据预测其他道路使用者的行为、生成高清地图、规划车辆行驶轨迹,并为轨迹验证提供信号。
Waymo的人工智能生态系统:知识从教师模型到学生模型的蒸馏传递
基于整体方案,Waymo基础模型为“驾驶员”、仿真器和评估器(评论家)提供动力。我们首先将基础模型适配这三大任务,训练出大型、高质量的教师模型,使其在各自特定角色中表现卓越。然而,这些教师模型体积过大,无法在车辆上实时运行以支持决策,也无法在云端高效处理数亿英里的仿真和评估任务。因此,我们通过安全的模型蒸馏技术,将其转化为更小的学生模型。模型蒸馏是关键环节,它能在保留大型模型卓越性能的同时,得到更紧凑、高效的版本。因此(与人工智能其他领域的类似趋势一致),通过先训练性能强大、容量充足的教师模型,再利用高效的蒸馏技术,我们能够让最终的学生模型实现更优的缩放定律(scaling laws)。

- “驾驶员”:我们的教师驾驶模型经过训练,能够生成安全、舒适且合规的动作序列。通过蒸馏技术,我们将其丰富的世界理解能力和推理能力迁移至更高效的学生模型,优化后用于车载实时部署。为最大化蒸馏的效益,我们的车载架构设计与Waymo基础模型的结构保持一致。重要的是,Waymo自动驾驶系统(驾驶员)配备了独立且严格的车载验证层,用于验证其生成式机器学习模型所规划的行驶轨迹。
,时长01:33
- 仿真器:仿真器是自动驾驶系统(驾驶员)闭环训练和测试的核心工具,可覆盖各类多样化、高难度场景,包括潜在碰撞风险、恶劣天气、复杂路口和道路上的异常行为等。仿真器教师模型能够创建高保真、多模态的动态虚拟世界,用于评估我们的“驾驶员”。学生模型则是这些大型模型的计算高效版本,专为满足自动驾驶系统稳健评估所需的大规模仿真任务而设计。Waymo基础模型的架构支持将紧凑的具象化世界状态表示与传感器仿真无缝结合,打造出大规模、超逼真、物理层面准确且计算高效的虚拟环境。

通过对全局场景元素(如天气条件和时间)使用文本提示,同时对场景中的动态元素(如其他道路使用者和交通信号灯)进行语义条件约束,我们能够将真实世界场景(左侧)转化为高度逼真的仿真场景(中间为摄像头仿真画面,右侧为激光雷达仿真画面)。值得注意的是,在该示例中,传感器数据完全是合成的,由我们的生成式传感器仿真模型基于底层紧凑的结构化世界表示生成。
- 评估器:我们的顶尖评估系统旨在对Waymo自动驾驶系统(驾驶员)进行压力测试,主动识别细微的边缘场景,并支持快速、有针对性的改进。评估器教师模型能够分析驾驶行为并生成高质量的反馈信号,用于训练学生模型和自动构建丰富的评估数据集。随后,评估器学生模型会分析驾驶日志,识别有趣或有问题的场景,并对驾驶质量提供细致的反馈。
在Waymo基础模型的支撑下,所有这些组件共同构成了一个无缝衔接的人工智能生态系统,形成了持续学习与优化的飞轮效应。
构建持续优化的飞轮效应
一个优秀的自动驾驶系统(驾驶员)并非一成不变——它是持续学习与进化的产物。Waymo自动驾驶系统的演进得益于多种机制的协同作用。我们的内部学习循环由仿真器和评估器(评论家)提供动力,利用强化学习对“驾驶员”进行训练。在这个安全可控的仿真环境中,“驾驶员”不断积累经验,根据自身行为获得奖励或惩罚,实现大规模学习。
我们的外部学习循环则基于Waymo的真实道路驾驶数据,形成了更强大的学习飞轮。该循环始于评估器(评论家)从我们海量的完全自动驾驶经验中,自动标记出任何次优驾驶行为;随后,我们基于这些事件生成改进后的替代行为,作为“驾驶员”的训练数据;这些改进会在仿真器中进行严格测试,由评估器(评论家)验证修复效果;最后,只有当我们的安全框架确认不存在不合理风险时,经过优化的“驾驶员”才会被部署到真实道路。

这一飞轮效应的实现,得益于我们多年来积累的海量完全自动驾驶数据,且这些数据仍在以指数级速度持续增长。过去,我们严重依赖高质量的人工驾驶数据来训练和优化Waymo自动驾驶系统;如今,我们的完全自动驾驶里程已远超人工驾驶数据量。如此庞大的真实世界完全自动驾驶经验是无可替代的——无论多少仿真训练、人工驾驶数据采集或有测试驾驶员参与的运营,都无法复制Waymo自动驾驶系统在完全自主运行时所遇到的各类场景及应对反应。将这些丰富的真实世界完全自动驾驶数据直接融入我们独特的飞轮体系,使Waymo自动驾驶系统能够从自身海量经验中学习,实现持续优化。
通过采用这套整体人工智能方案并构建学习飞轮,我们不仅在推动Waymo自动驾驶系统的进步,更在树立大规模安全自动驾驶的行业标准。我们持续创新,不断突破可能性的边界,未来在人工智能领域还有许多令人期待的工作即将展开。
...
#曾一度看不到自动驾驶太多希望...
演讲者:苏箐 | 地平线副总裁&首席架构师
演讲时间:2025.12.9
演讲场合:2025地平线技术生态大会
全文提炼如下:
今年,我们确实能看到自动驾驶的技术路径是比较清晰的,但也会看到有更难的问题在前面。你知道这些问题能解掉,但应该怎么解今天还不知道。
绝大多数行业外的人,可能并不理解自动驾驶团队面临的困难和压力。这种智力和体力的双重压榨极度痛苦,因为有SOP的时间压在那儿,然后又有方法论的变化,还有各种corner case需要去解。
在稠密的世界里连续运行的时候,所有的case都需要解决,这就是这个行业非常痛苦的地方。
曙光:重大分水岭的出现
我刚准备加入地平线的时候,和余凯博士聊过几次,我当时很坚决地表示,不想再做自动驾驶了:我觉得做自动驾驶第一太痛苦,第二我看不到太多的希望。因为如果以人类司机的标准来衡量的话,它的差距是非常大的。
因此,在2023-2024年以前,我是看不到太多希望的,也是非常不确定的。
分水岭事件发生在2024年——FSD的v12发布了,它打开了一个内核的新范式,这具有非常重要的意义。
这类似于在原子时代首次发现核裂变是可能的,而且是能释放能量的。当时这个实验结果出来以后,全世界所有从事量子物理的科学家们都认为是不可能的,但是实验逐渐证明这是这是对的,之后又用N年造出了第一颗原子弹。

大家会发现深度学习的神经网络,就像当初的核裂变实验一样,它告诉你这个范式是可能的。FSD V12让大家看到了希望,它把「原子弹」造好了,证明这件事情是对的。
在2023年到2024年之间的自动驾驶,背后有两个问题:
- 深度学习只重构了感知部分,感知之后的部分几乎还是规则主导的,相当于「革命革到一半」。「无图」只解决了动态的问题,而没有解决静态认知的问题。
- 当一个方法论重构到一半的时候,它的效果却并不能达到一半,可能只是20-30%,必须把后面那一半革命完成,才能迎来新的时代。这就是端到端的意义所在。但这件事情非常难。

因为感知技术也是发展了很多年,才被数据驱动完全搞定的,而规控的理论(至今)都还是不成熟的,且每尝试一轮都需要数亿元,还有可能无果,这对于精神还是资金都是考验:当时的系统是非常不收敛的,任何一个噪声都会导致整个系统废掉,所以这件事情非常困难。
在此背景下,新范式体现出了巨大的意义。
浇一点冷水
人类是很奇怪的一种动物——当事件还未发生时,人类往往完全不相信它会发生;但在事情发生以后,人类又会觉得它会持续发生。你不要以为革命会是一波一波的,它也有可能是最后一波。
自动驾驶的重构会不会是一种常态?我们认为大概率其实不会。

2023-2024年发生的这一次变革,它有两个前提条件:
- 人工智能大概每20-30年会有一个轮回,然后大家再干20-30年,干出一个很新的范式来把它兑现掉,兑现了以后却发现它还是有天花板的。
目前我们多多少少能看到这一代的深度学习技术,有一点碰到天花板的可能性。因为从大语言模型和其他领域的进展来看,有这种可能性。
- 目前AD的前一段已经革新了,如果我们希望再发生巨大的内核重构,那就不是把深度学习从系统的50%平推到100%,而是要改变内核理论了。
因为物理世界的演进都是先有理论突破,然后到应用突破,如此不断循环。但现在很不幸的是,我们还没有看到下一个理论突破的前置信号出现。即使这种信号出现了,可能还需要5年到20年才能变成应用的突破。
所以我个人判断,很大的概率是未来三年行业都还是会在现有的系统上做极致优化,而不是一种理论内核的重构。所以大家别太嗨,又进入苦日子的阶段了。

- FSD V12这类系统的出现,对整个AD产业的路线意味着什么?
首先还是回到三年以前,我跟余凯博士聊天时,终于又看到希望了,我们终于能用新技术把城市的L2做到好用类人了。我可以负责任地说,在未来一年内,AD会有巨大的提升,因为新范式打通以后,它会有一个红利期,会有巨大的提升。
L2和L4的方法论统一了
当系统越来越类人,我们终于有机会把吹了这么多年的牛放到车上,它是新时代的自动挡。
我们认为城市L2会迎来巨大的发展红利期,它的搭载车型会从几十万、20万的车降到10万元的车,就像自动挡一样,而且它都会变得很好用。
这就是计算机工业的好处——突破成本极其高,但复制成本极其低。你今天看到的再复杂的计算机,只要给它几年的时间,就会变得跟白菜一样。所以让10万元甚至更低成本的车都变得一样好用,这件事是一定会到来的。
另外,过去我们认为L2跟L4是两个完全不一样的世界,但是新范式到来以后,我们能看到方法论终于统一了,当前的方法论再做最多2-3年的工作,就有极大的机会把MPI干到5万- 10万公里的水平,同时它还能保持类人,并可以在所有城市、所有区域里,做到自动泛化。

我们发现,新的方法论上去以后,系统在绝大多数城市的测试,都是天然没有问题的,只有极少数的非常奇怪的、离散在系统分布之外的细小场景需要处理一下,过程省了很多时间。
这对L4是个极大的好消息——在搞定一个复杂城市的时候,大概率就搞定了整个国家的复杂城市。
Robotaxi的本质是要和人类司机比成本,这是一切商业本质的源头,所以高成本的复制就不能达到数量级的降本,而是一种线性推进的方法,这在商业上的很薄弱的。
而新方法导致的结果就是,在未来的短短几年内,用同样的开发方式,不但在L2上能带来新的体验,同时还以极低的部署成本和几乎无限制的部署区域,去带来一个L4系统,而且它会以乘用车和Robotaxi的双模式来部署。
我一直不同意Robotaxi只能是Robotaxi,我也很想买一辆车L4的车开。因为车作为一个大玩具也好,第二空间也好,它有它自己独特的价值。而且我自己是比较社恐的,我是不愿意坐出租车的,还要跟司机讲两句话。
另一个复杂性的变化是什么呢?
2023-2024年之前,大家开始在系统空间里去做各种碎片功能的拼凑。
这就像一棵只能长这么高了,那就再种一棵树,然后再种一棵树……把它拼起来,拼各种奇奇怪怪的东西;而在2024年之后,我们就种植一棵树,把这棵树种得越来越粗越来越高,让其网络的主干越来越大,数据量越来越大,然后你会很欣喜地发现它长出了新的能力,而且还是在你不知道的时候。

这就是新的方法论和数据驱动的魅力,它从人类的稠密数据里面,会学到一切能力,无论是好的还是坏的,但是我们需要把坏的处理,这就是跟过去不一样的地方。
下一步怎么做?
我们认为AGI的基础理论在未来3-5年可能不会有全新的突破,而是进入一个演进和优化的阶段。在此前提下,有几件事情仍然是可以做的:
- 在大语言模型领域,大家隐约感到了天花板。但是我很高兴的是这件事在AD领域还完全没有发生,Scaling law 在AD行业才刚刚开始。
因为无论是成本问题、功耗问题还是芯片工艺的精度问题,都还没有显现天花板,应该说才刚刚开始。我们后面会每一代芯片和每一代产品都会坚持10倍算力的提升,以及10倍模型容量的提升。
- 我们会开始重投L4,但不是以割裂的形式去做,而是以统一的开发范式、统一的传感器配置,统一的ODD区域去打通L2到L4。大家有一天可能不会在意这个概念了,你三年以后买到的车,它就会是准L4系统了,这件事情是高概率会发生的。
- 不要应激,要将工程能力和组织能力不断地强化再强化,只有一个稳定的能承载这个工程的公司组织,才能应对一切变化——有新技术的时候,你能快速导入。而新技术导入后碰到一堆爆发的问题,只有集团军的作战能力才能去把它消灭,并且持续打磨这些难题。

今天我们没有非常清晰的答案,但是这件事情是需要我们做的。我之所以仍然焦虑,是因为风险仍然非常高:做一轮实验可能要花10亿,还不一定成功,这种事情是很恐怖的,但是必须要做。
HSD的SOP可以达到我的基本预期,但我们本质的目的是做一个能替代人类司机的机器,否则它就没有意义。从这个维度来讲的话,我觉得还有很多工作需要去做。
未来我们的研发的方式会以L4为核心,希望在未来的2-3年,让HSD这套系统体验的有一个巨大的飞跃,这件事情是一定会发生的。
另外,我很希望在未来的几年,我们能把L4的车以同样的价格,在用户无感的情况下送到你的手上,这是我们希望行业能做到的一个目标,虽然很难,但这是我们所有人辛苦了这20年的意义所在。
...
#CorrectAD
理想端到端自进化智能体系统CorrectAD导读
破解“端到端模型长尾故障”痛点!现有端到端自动驾驶模型受限于训练数据中的罕见安全关键场景(长尾问题),手动收集此类数据成本高、风险大。西湖大学+理想汽车+天津大学联合提出CorrectAD自校正智能体系统,实现四重突破:
- PM-Agent模拟产品经理,多轮推理分析故障原因并制定多模态数据需求;
- DriveSora可控视频生成模型,生成与3D标注对齐的高保真多视图视频;
- 端到端模型无关,适配UniAD、VAD等主流规划器;
- 迭代自校正循环,持续缩小生成数据与故障分布的差距。
实验验证:在nuScenes和内部挑战性数据集上,分别修复62.5%和49.8%的故障案例,碰撞率降低39%和27%,为自动驾驶模型的持续优化提供自动化、低成本解决方案。
推荐理由
- 核心价值:首个实现E2E自动驾驶故障自校正的智能体系统,PM-Agent精准析因+DriveSora定向生成,故障修正率62.5%、碰撞率降39%,支持多E2E模型,无需手工收集标注;
- 落地意义:将故障修正周期从数周缩短至数天,大幅降低数据迭代成本,可直接集成到车企现有模型优化流程;
- 学术价值:提出“智能体析因→定向生成→迭代微调”的自校正范式,解决生成模型与故障修正的衔接问题,DriveSora生成质量超SOTA(FVD 94.51、NDS 36.58)。
1 核心概念:关键定义与术语解析
1.1 当前痛点
- 手工数据收集成本极高
长尾故障(Long-tail Failure,如低能见度碰撞、密集车流绕行失效)罕见且危险,手工收集标注需数周时间和数千美元成本,扩展性差。
- 现有方法数据多样性不足
检索式方法(如AIDE)仅从现有数据集筛选相似场景,无法覆盖未见过的长尾故障,难以从根源修正模型缺陷。
- 生成模型缺乏定向可控性
现有驾驶场景生成模型(如MagicDrive)可控性差,无法精准匹配故障修正所需的场景特征,生成数据与故障关联性弱。
- 故障与生成模型存在衔接鸿沟
缺乏有效机制将E2E模型的故障案例转化为生成模型可理解的需求,导致生成数据无法针对性解决故障。
1.2 核心术语
| 术语 | 细节描述 |
| CorrectAD | 自校正智能体系,通过PM-Agent分析故障、DriveSora生成数据,实现端到端模型故障自修复 |
| PM-Agent | 模拟产品经理的智能体,基于VLM多轮推理,分析故障原因并生成多模态数据需求(BEV布局+场景描述) |
| DriveSora | 可控多视图视频生成模型,基于STDiT架构,生成与3D标注对齐的高保真自动驾驶场景视频 |
| 自校正循环 | 故障分析→多模态需求→数据生成→模型微调→评估迭代的自动化流程,持续缩小生成数据与故障分布差距 |
| 故障案例 | 端到端模型规划轨迹在未来T步内与其他交通参与者或道路边界发生碰撞的场景 |
1.3 关键公式与指标
- 故障案例定义:
其中为车辆位置,(安全阈值),(规划时域)。
- 多条件无分类器引导:
其中(文本约束权重),(背景约束权重),(前景约束权重)。
- 生成数据质量指标:帧内一致性(FID)、帧间一致性(FVD)、检测适配性(NDS)、语义对齐度(CLIP分数);
- 模型性能指标:轨迹误差(L2)、碰撞率(Collision Rate)、故障修复率(Failure Correction Rate)。
2 核心方法:CorrectAD系统详解(深度展开)
📷图1:(a):一个模型迭代的工作流程包括4个步骤:找出失败案例、准备训练数据、模型更新,然后进行评估并再次迭代。关键问题在于如何准备特定的训练数据来纠正这些失败案例。(b):以往的范式是基于检索的,即从现有数据中检索相似数据并自动标记,这严重限制了训练数据的多样性。(c):我们提出的智能体系统CorrectAD是定制生成的。我们首先提出PM-Agent,其作用类似于产品经理,通过分析失败案例来制定数据需求。然后,提出生成模型DriveSora,其作用类似于数据部门,用于生成符合PM-Agent所提出的数据需求的高保真训练数据。在端到端规划模型的L2和碰撞率(Col.)方面,本文的方法优于以往的方法。
2.1 整体框架
逻辑整体框架如图1所示,流程图如下:
2.2 核心模块1:PM-Agent(故障分析与需求制定)
2.2.1 故障分类:从聚类到多轮推理
- 步骤1:故障原因标注与聚类。
- 抽取27个故障案例,由领域专家标注10条/案例的故障原因;
- 用GPT-4o提取关键词(如“雨天”“路面湿滑”“低能见度”),设置欧氏距离阈值0.8进行模糊聚类;
- 层次聚类+K-Means(K=3),最终得到“前景”“背景”“天气”三大故障类别。
📷图2: 规划失败案例的聚类结果。
- 步骤2:多轮问询分类。
- 第一轮:输入6视图视频+规划轨迹,VLM输出“是否属于某类别+置信度”(阈值0.8);
- 第二轮:针对高置信度类别,进一步细化原因(如“天气类→雨天导致路面湿滑+低能见度”)。
📷图3:分析故障原因的prompt。
2.2.2 多模态需求构建:BEV布局+场景描述
- 场景描述生成:
基于故障原因,用LLM生成结构化场景描述(如“雨天、低能见度、城市道路跟车场景,路面湿滑,前车突然减速”);
📷图4:生成需求的prompt。
- BEV布局提取:
- 从训练集中检索与场景描述语义相似的场景—— LLM 将数据需求与所有场景字幕进行初步筛选比较(caption)。接下来VLM 将数据需求与初步筛选后剩余场景中的图像进行比对,进一步筛选以识别匹配场景。(BLIP-2计算图像-文本相似度,阈值0.9)如图5
- 提取检索场景的BEV布局,包含两部分:
- 背景布局():道路边界、车道线的彩色线图();
- 前景布局():3D边界框坐标()、航向角()、实例ID()、密集描述();
需求组合:将场景描述(文本)与BEV布局()组合为多模态需求。
📷 图5:多模态需求制定的prompt。
2.2.3 关键优化:多轮推理提升准确性
- 单步推理缺陷:语义距离4.66,原因描述片面(如仅提及“路面湿滑”,忽略“低能见度”);
- 多轮推理优势:语义距离降至3.49,通过“分类→细化→补充”三步,覆盖故障全部关键因素。
📷图6:PM-Agent的框架。给定一个失败案例,PM-Agent首先将失败原因分类为,随后详细分析失败描述。基于,PM-Agent生成具体需求。之后,PM-Agent构建与该失败案例相似的多模态需求(包括鸟瞰布局和场景描述),以与后续的生成模型进行交互。
2.3 核心模块2:DriveSora(高保真数据生成)
2.3.1 基础架构:时空扩散Transformer(STDiT)
- 整体结构:28层Transformer块,分为encoder(前13层)和decoder(后15层),输入为噪声latent(维度,B=批次、V=视图数、T=帧数、S=嵌入分辨率、C=通道数);
- 预训练初始化:基于OpenSora 1.1 checkpoint,单视图模型先训练30k迭代,再扩展为多视图模型训练25k迭代。
2.3.2 关键技术1:ControlNet-Transformer集成(3D布局约束)
- 核心目标:让生成视频严格对齐BEV布局中的道路草图和边界框;
- 实现逻辑:
- 为STDiT的前13层encoder各添加一个可训练的“复制块”(Base Block_1~13);
- 复制块输出经Zero初始化的线性层,与原encoder块输出相加,作为下一层输入;
- 道路草图()经VAE编码为,注入ControlNet-Transformer,实现精准控制;
优势:不破坏原STDiT的生成能力,仅通过增量训练实现布局约束。
2.3.3 关键技术2:参数无关多视图空间注意力(空间一致性)
- 传统方案缺陷:需额外跨视图注意力层,增加参数且一致性差;
- 创新操作:
- 重塑输入特征:将转为;
- 直接应用自注意力:让不同视图的特征在同一注意力窗口中交互,无需额外参数;
效果:多视图生成的车辆位置、航向角一致性提升15%,FVD降低2.8%。
2.3.4 关键技术3:多条件无分类器引导(语义对齐)
- 训练阶段:
- 每个条件(文本、前景、背景)独立以5%概率设为(空),同时全部设为空的概率也为5%;
- 损失函数:标准扩散损失,联合优化多条件对齐;
推理阶段:
- 采用整流流采样(30步),提升生成速度;
- 按公式叠加各条件的引导信号,强化文本与布局的协同约束——交替屏蔽文本、前景、背景条件,强化单个约束的引导作用,公式如下:
其中 。
2.3.5 自动标注流程
- 3D边界框:用预训练3D检测器(NDS=34.56)对生成视频进行帧级标注;
- 轨迹生成:基于边界框序列,用卡尔曼滤波平滑得到连续轨迹;
- 输出格式:与nuScenes数据集一致,支持直接用于模型微调。
📷 图7:DriveSora框架和ControlNet-Transformer,执行数据生成任务,旨在产生高质量、多样化的新型数据。
2.4 核心模块3:自校正循环(迭代优化机制)
2.4.1 分布对齐量化
- 指标:Hellinger距离(D-D),衡量生成数据与故障案例的分布差异,值越小对齐度越高;
- 计算流程:
- 用LLM提取故障案例和生成数据的场景关键词(Top 100高频词);
- 计算关键词频率分布的Hellinger距离:
📷图8:关键词提取的prompt。
2.4.2 迭代微调策略
- 数据混合:原始训练数据与生成数据按4:1比例混合;
- 超参数:学习率2e-5,优化器HybridAdam,批次大小16,微调迭代10k;
- 迭代终止条件:连续2轮D-D<0.1或碰撞率<0.2%。
2.4.3 多轮迭代效果
- 迭代1:D-D=0.15,L2=1.06m,碰撞率=0.26%;
- 迭代2:D-D=0.11,L2=1.04m,碰撞率=0.22%;
- 迭代3:D-D=0.09,L2=0.98m,碰撞率=0.19%;
- 关键结论:生成数据分布逐步向故障场景收敛,模型故障修复率持续提升。
3 实验结果:性能验证与关键发现
3.1 实验设置
- 数据集:①nuScenes(700训练/150验证场景,6视图、12Hz,单场景20s);②内部挑战性数据集(3M训练/0.6M验证场景,6视图、10Hz,含36%变道、15.8%转弯场景);
- 对比方法:AIDE(检索式数据扩充,重构适配端到端规划任务);
- 评估模型:UniAD、VAD、内部自研端到端模型(基于STDiT架构);
- 硬件:训练(8×A800 GPU),推理(L40S GPU)。
📷图9: 内部数据集驾驶动作统计数据
📷图10: GT的因果示例,以及PM-Agent和基线(单步GPT4o)对响应的影响。
3.2 核心性能结果
(1)故障修复与安全指标提升
| 数据集 | 方法 | 故障修复率 | L2误差(m)↓ | 碰撞率(%)↓ |
| nuScenes | 基线(UniAD) | - | 1.25 | 0.35 |
| nuScenes | AIDE | 31.2% | 1.06 | 0.29 |
| nuScenes | CorrectAD | 62.5% | 0.98 | 0.19 |
| 内部数据集 | 基线(自研) | - | 1.06 | 0.26 |
| 内部数据集 | AIDE | 28.5% | 0.79 | 0.22 |
| 内部数据集 | CorrectAD | 49.8% | 0.62 | 0.19 |
(2)DriveSora生成质量对比
| 生成模型 | FID↓ | CLIP↑ | FVD↓ | NDS↑ |
| MagicDrive-v2 | 20.91 | 85.25 | 94.84 | 35.79 |
| Panacea | 16.96 | 84.23 | 139.0 | 32.10 |
| DriveSora | 15.08 | 86.73 | 94.51 | 36.58 |
(3)多轮迭代效果
📷图11:多轮迭代中增强数据与验证集上失败案例之间的分布差距。
3.3 消融实验验证
(1)模块贡献
| 配置 | L2误差(m)↓ | 碰撞率(%)↓ |
| 随机复制训练数据 | 1.25 | 0.35 |
| 仅DriveSora(无PM-Agent) | 1.12 | 0.29 |
| 仅PM-Agent(无DriveSora) | 1.09 | 0.27 |
| CorrectAD(完整配置) | 0.98 | 0.19 |
(2)关键技术贡献
| 配置 | FID↓ | NDS↑ |
| 无多模态约束+无多视图注意力 | 25.65 | 25.23 |
| 有多模态约束+无多视图注意力 | 17.23 | 36.37 |
| 有多模态约束+有多视图注意力 | 15.08 | 36.58 |
3.4 定性结果
- 故障修复示例:低能见度夜间场景中,基线模型偏离车道碰撞,CorrectAD生成对应数据微调后,模型能提前减速避让;
- 生成数据一致性:DriveSora生成的6视图视频中,车辆位置、航向角跨帧跨视图一致,无MagicDrive的“航向错误”“物体突变”问题;
- 可控性验证:支持实例编辑(车辆颜色切换)和场景编辑(晴天→雨天),生成结果与约束完全对齐。
📷图12:在内部验证集上进行自校正前后的两个示例可视化结果:通过基于高斯泼溅的专有闭环模拟器渲染。
📷图13: 跨帧一致性比较。
📷图14:实例与场景编辑的可视化效果。图(a)展示了实例层面的控制结果,如所有车辆的呈现属性;图(b)展示了场景层面的控制结果,包括天气和时间因素。
4 挑战与未来方向
4.1 当前局限
- 故障类型单一:仅将碰撞视为故障,未涵盖车道违规、交通规则违反等场景;
- 生成效率较低:DriveSora(1.1B参数)需8×A800 GPU训练72小时,推理单样本需4秒(L40S);
- 复杂交互场景生成不足:对多智能体复杂博弈场景的生成能力有待提升。
4.2 未来方向
- 扩展故障类型:结合多维度基准,纳入车道保持、交通规则遵守等评估维度;
- 提升生成效率:集成快速扩散模型(如SANA),优化推理速度;
- 增强复杂场景生成:引入博弈论建模多智能体交互,提升长尾场景覆盖;
- 闭环部署适配:与真实车辆部署流程结合,实现线上故障实时反馈与模型迭代。
5❓ 核心QA(基于论文内容)
Q1:PM-Agent如何保证故障原因分析的准确性?
A1:采用多轮问询策略,先分类(前景/背景/天气)再细化描述,结合ICL(上下文学习)注入故障案例示例,语义距离从单步问询的4.72降至3.49,前景/背景/天气析因准确率分别达92.59%、87.41%、91.85%。
Q2:DriveSora相比其他生成模型的核心优势是什么?
A2:① 可控性强:通过BEV布局+文本双条件,精准匹配故障修正需求;② 多视图一致性好:参数无关多视图空间注意力解决跨视图错位;③ 生成质量高:FID 15.08、FVD 94.51,NDS 36.58,超现有SOTA模型。
Q3:CorrectAD为何支持多E2E模型?
A3:采用模型无关设计,核心是通过生成“通用高保真训练数据”补充模型的长尾场景覆盖,而非针对特定模型定制,因此可直接应用于UniAD、VAD、内部E2E等不同架构。
Q4:与检索式方法(如AIDE)的区别是什么?
A4:AIDE从现有数据集检索相似数据,数据多样性不足,无法覆盖未见过的故障;CorrectAD通过定向生成,可创造全新场景,生成数据与故障分布更贴合,故障修正率比AIDE高30%+。
Q5:迭代自校正的意义是什么?
A5:每轮迭代后,生成数据会更贴近故障分布,模型微调后新的故障会减少,同时暴露未修正的旧故障,持续迭代使故障修正率逐步提升,3轮迭代后nuScenes故障数从22降至14。
6 总结
核心价值
- 架构创新:首个“故障分析→定向生成→迭代优化”的自动化自校正框架,打破人工数据收集依赖;
- 数据质量卓越:DriveSora在保真度、一致性、适配性上超越现有生成模型,sim-to-real差距显著缩小;
- 模型无关兼容:适配主流端到端规划器,无需重构模型,落地成本低;
- 持续优化能力:迭代循环使生成数据与故障分布逐步对齐,模型性能持续提升。
总结金句
👉 “CorrectAD的核心突破,在于用‘PM-Agent精准锚定故障需求+DriveSora生成高保真数据+迭代循环持续优化’,将自动驾驶模型的故障修复从‘人工依赖’推向‘自动化闭环’,既解决了长尾场景数据稀缺的痛点,又大幅降低了模型迭代成本,为端到端自动驾驶的安全部署提供了可持续的优化方案。”
7 原论文信息
- 论文题目:CorrectAD: A Self-Correcting Agentic System to Improve End-to-end Planning in Autonomous Driving
- 作者:Enhui Ma等(西湖大学Autolab+理想汽车+天津大学)
- 发表状态:arXiv preprint(2025年11月)
- 核心价值:提出自校正智能体系统,通过定向数据生成实现端到端模型故障自修复,大幅提升长尾场景鲁棒性
- 关键链接:arXiv链接:https://arxiv.org/pdf/2511.13297v1.pdf
- 核心数据:
- 故障修复率:nuScenes 62.5%,内部数据集49.8%;
- 碰撞率降低:nuScenes 39%,内部数据集27%;
- 生成模型性能:FID=15.08,FVD=94.51,NDS=36.58(SOTA水平)。
...
#DGGT
清华&小米最新DGGT:0.4秒完成4D自驾高斯重建,性能提升50%!
清华大学与小米汽车联合推出 DGGT(Driving Gaussian Grounded Transformer):一个pose-free、feed-forward的4D动态驾驶场景重建框架。
,时长04:27
DGGT 只需未标定的稀疏图像,单次前向即可同时输出相机位姿、深度、动态实例与基于 3D Gaussian 的可编辑场景表示。模型在 Waymo 上训练,却能在 nuScenes 与 Argoverse2 上实现强劲的零样本泛化——在关键感知指标上相比STORM提升超过 50%。此外,系统通过lifespan head建模场景随时间的外观演变,并配合单步扩散精修,有效抑制运动插值伪影,提升时空一致性与渲染自然度。
- 论文标题:DGGT: Feedforward 4D Reconstruction of Dynamic Driving Scenes using Unposed Images
- 开源链接:https://github.com/xiaomi-research/dggt
- 项目主页:https://xiaomi-research.github.io/dggt/

图1.左:从未标定稀疏图像在0.4 s内重建动态场景,并输出相机姿态、深度、动态图、3D Gaussian追踪等可编辑资产;右:在速度与精度上相较前向/优化方法处于更优位置
亮点速览
- 无需外参(Pose-Free): 将相机位姿从输入转为模型输出,端到端预测内外参并融入场景表示,打破跨数据集部署的校准壁垒。
- Feed-forward 4D表示: 采用多头联合预测结构(相机、4D Gaussian、lifespan、动态/运动、天空等),一次前向即可得到时空一致的可编辑表示。
- 跨数据集零样本泛化: 仅在 Waymo 训练,无需在目标数据集上微调即可在 nuScenes 与 Argoverse2 上获得优于SOTA的定量与定性结果(LPIPS 降幅 52%–61%)。
- 可编辑性强: 支持直接在 Gaussian 层面添加/删除/移动车辆、行人等实例,扩散精修自动补洞,输出可用于仿真与数据合成。
- 速度与质量兼顾:在Waymo上20 帧/视角,单场景约 0.39 s;PSNR 27.41 / SSIM 0.846,与优化类方法相比显著加速,与前向方法相比更高保真。
DGGT详解
DGGT 的核心思想是:一次前向就预测出“完整的4D场景状态”,并把相机位姿从前提变成结果。这使得系统无需外参标定即可从稀疏、未标定图像里恢复动态场景,而且能自然跨数据集部署。图1展示了DGGT 的整体能力与速度-精度位置:在0.4 秒量级完成重建的同时,DGGT 在重建质量上超越一系列前向与优化方法,并将相机姿态、深度、动态分割、3D Gaussian、追踪等输出一并给出,便于后续实例级场景编辑。

图2.DGGT 框架结构图 ViT 编码融合DINO先验,联合相机/高斯/寿命/动态/运动/天空六个预测头;渲染后接单步扩散精修,一次前向完成时空一致重建。
在系统结构上(图2),DGGT 采用 ViT 编码器融合 DINO 先验,通过交替注意力得到共享特征,再由多个预测头并行输出:
- (1)相机头估计各帧内外参;
- (2)Gaussian 头给出逐像素 Gaussian 参数(颜色/位置/旋转/尺度/不透明度);
- (3)lifespan 头用寿命参数调制时间维度可见性,精确刻画静态区域在不同时间的外观变化;
- (4)动态头+运动头显式估计动态区域与 3D 运动轨迹,支持任意时间点的运动插值;
- (5)天空头稳定建模远景背景。渲染后,再通过单步扩散精修抑制遮挡/插值产生的伪影与细节缺失。

表1. Waymo定量结果 DGGT无需相机位姿输入的同时,对场景中动静态进行判断,在Waymo数据集上获得更高PSNR/SSIM与更低深度误差,单场景推理仅约0.4s

表2. 其他消融实验和指标测试 扩散模型虽然在性能上提升较小,但是生成的结果视觉效果更好,更适配于下游任务;同时DGGT在Waymo上EPE3D达0.183 m
在Waymo数据集上的定性与定量评估(见表1)表明:以往的前馈式静态重建方法(如 MVSplat、NoPoSplat、DepthSplat)在存在大范围运动目标的场景中难以维持时间一致性,且会产生明显的错配与伪影;而STORM虽然通过前馈式建模缓解了对逐场景优化的依赖,但在处理更长的时序跨度或更复杂的动态行为时仍可能出现性能退化。相比之下,DGGT能够在渲染级别上实现对静态与动态成分的有效分离,保持帧间外观与几何的一致性,从而显著提升整体视觉质量与重建稳定性。在定量指标上(表2),DGGT 在场景流估计上的EPE_3D为0.183 m,明显优于多种既有方法,证明了通过渲染监督学得的稠密三维对应具有良好的可靠性与精度。

表3. 零样本跨库泛化 仅用Waymo训练,DGGT在nuScenes/Argoverse2上无需微调即显著优于STORM:LPIPS分别下降 61.4% 与 52.5%
跨数据集的零样本泛化能力是 DGGT 的另一项核心优势。模型仅在Waymo上训练,但在未做任何微调的情况下,在nuScenes与Argoverse2上均取得超越现有SOTA的结果(见表3):如在nuScenes上 LPIPS从0.394 降至0.152(下降 61.4%);在 Argoverse2上从0.326降至 0.155(下降52.5%)。这种跨域鲁棒性主要得益于DGGT 的pose-free 设计:将位姿从输入转为模型输出,减少了对固定拍摄轨迹与相机配置的依赖,从而降低了对特定数据采集设置的过拟合风险,使模型在不同传感器布置与行驶路径下仍能维持良好性能。

表4. 输入视角数消融 当视角数从 4→8→16 增加时,DGGT的重建/NVS指标保持稳定;STORM出现明显下滑,DGGT更适合大规模日志处理
在可扩展性方面,DGGT 能自然支持任意数量的输入视角与长序列。从表4可以看到,当输入视角从 4 → 8 → 16 扩增时,DGGT 的重建与新视角插值(NVS)指标基本不变,而对比方法会明显下滑。这意味着 DGGT 不仅适合研究场景,更适合在大规模输入中做工程级预处理与批量重建,视角变多时不需要额外改模型或调参数。

图3. Lifespan head 价值 去除lifespan后PSNR下降3.2 dB,静态区域的光照/反射时间变化难以刻画,时空一致性受损
Lifespan head 的作用在图3中的消融对比非常直接:去掉 lifespan 后,PSNR 从 27.41 降至 24.21,原因在于系统失去了对静态区域在时间维度上的细微变化(如亮度、反射、阴影过渡等)的建模能力。世界坐标静态的地方一旦无法随时间正确更新,就会破坏渲染的时空一致性与真实感,从而显著拉低最终画面质量。

图4. 3D追踪可视化 相邻时刻等色点一一对应,展现可靠的稠密时空关联
Motion head负责把动态像素在时间上对齐(图4):它直接预测像素级的 3D 位移,用于将同一物体在相邻帧中对齐并做插值。也就是说,模型不只是预测静态形状,而是学会了像素到像素的时序对应,从而在生成中间帧或执行编辑时显著减少错配与拖影,保证运动物体在时间上的连续性与视觉自然度。

图5. 实例级编辑:加/删/移动车辆、跨场景插入新车与骑行者 在Gaussian层面对目标进行加、删、平移操作;扩散精修自动补洞与平滑边界,合成结果自然可信,提升可用性与观感。
在场景编辑与扩散精修方面(图5),DGGT 直接在 3D Gaussian 表示层面支持实例级操作——可以对单个高斯体执行“新增/删除/平移/替换”等编辑;随后引入的扩散精修模块会自动填补因遮挡产生的空洞、弱化边缘锯齿并修复纹理缝隙。经过这两步处理,合成结果在几何与外观上都保持高度一致且自然可信。
这意味着 DGGT 不只是“重建器”,更是“可编辑的 4D 场景资产生成器”,非常契合自动驾驶仿真、评测与数据合成等下游需求。
...
#智源&清华带来自驾重建新SOTA!

「多尺度双边网格框架
实现几何与视觉渲染质量的双重突破」
在自动驾驶领域,准确、高效的三维场景重建对于确保安全、避障和可靠导航至关重要。然而,传统方法常常面临由于光照条件、动态物体等因素引起的光度不一致和几何不准确问题。
在自动驾驶技术飞速发展的今天,如何在复杂的动态环境中进行高精度的三维场景重建,依然是自动驾驶系统面临的一大挑战。传统的场景重建方法常常因为光照变化、视角差异和动态物体的影响,导致光度不一致和几何误差。
为此,北京智源人工智能研究院(BAAI), 清华大学智能产业研究院(AIR) 提出了一种多尺度双边网格框架,能够在不同尺度上对3D场景表征进行局部和全局调整,从而有效解决了光度不一致性问题,并提升了几何重建的精度。
通过在多个标准数据集(如Waymo、NuScenes、Argoverse和PandaSet)上的实验验证,该方法在几何精度和视觉质量上均超越了现有技术,尤其在复杂的动态场景中表现优异。
《Unifying Appearance Codes and Bilateral Grids for Driving Scene Gaussian Splatting》已被人工智能和机器学习领域的顶级国际学术会议NeurIPS 2025接收。

左:本文的方法,右:OmniRe,极端光照变化导致OmniRe出现严重的光度不一致和几何失真。我们的方法则有效解决了光照变化带来的问题,呈现出更加清晰、稳定的几何结构。
1 主要方法
当前的自动驾驶场景重建面临着来自光照、相机视角差异和动态物体等多重因素的挑战,这些因素会导致图像之间的色彩不一致,从而影响重建的真实感和几何精度。
传统的解决方案,如外观编码(Appearance Codes)和双边网格(Bilateral Grids),各自有一定的优势,但仍然存在局限性。外观编码虽然能够调整全局光照,但无法处理局部光影变化;而双边网格则能够进行像素级的调整,但优化难度较大。
因此,如何结合两者的优点,实现更高效、更准确的自动驾驶场景重建,成为本研究的核心目标。

(a)外观编码进行全局变换,但建模能力有限。 (b)双边网格支持像素级变换,能提升色彩一致性,但优化难度大。 (c)本文提出的多尺度双边网格统一了前两者,实现了高效且强大的区块级变换。
1.1 多尺度双边网格架构
我们采用高斯溅射(Gaussian Splatting)技术来建模复杂的驾驶场景。首先,场景被分解为一个混合场景图,包括独立建模的天空、静态背景和动态物体(如车辆、行人)。从该场景图渲染得到初步图像,尽管几何重建准确,但由于光照和视角变化,渲染图像通常存在明显的光度不一致性。
渲染图像接下来会送入我们设计的多尺度双边网格进行处理,最终输出色彩一致且观感真实的高质量图像。此过程分为三层次:
- 粗层级(Coarse Level):该层通过一个小型网格(2×2×1×12)捕捉并校正场景级别的全局光照和色调偏差,相当于外观编码的作用。
- 中层级(Intermediate Level):使用中等尺寸的网格(4×4×2×12),进一步调整区域性光影变化,例如大块阴影或光斑。
- 精细层级(Fine Level):使用更高分辨率的网格(8×8×4×12),进行像素级的精细微调,精确恢复物体的局部细节和材质。

多尺度双边网格架构示意图
1.2 层次化光度优化
每个网格层采用不同的学习策略,通过一个基于亮度引导的“切片”(Slicing)操作,结合三线性插值来确保平滑过渡。
粗层网格首先对全局光照进行调整,中层进一步处理区域性差异,而精细层则专注于局部像素级的微调。最终,所有层级的输出通过递进的方式进行融合,确保从全局到局部的逐级优化。
为了确保训练的稳定性和在真实环境中的应用效果,我们采用了从粗到细的优化策略。粗层使用较高的学习率进行全局光照校正,而精细层则以较低学习率微调细节。此外,我们还引入了正则化项,确保学习到的变换平滑且合理,从而避免了伪影和纹理失真。 循环正则化损失() 鼓励学到的色彩变换是可逆的,从而有效约束了变换空间,防止产生伪影,保证了高质量的视觉效果:
而自适应总变分正则化()惩罚网格内部特征的剧烈变化, 使我们多尺度网格学习到的颜色变换更加平滑,并减少噪声伪影:
为了有效地训练整个框架,我们定义了一个复合损失函数,结合了重建损失、几何损失以及正则化项。主要的优化目标是最小化渲染图像与真实图像之间的差异,同时保持几何形状的准确性。损失函数可以表示为:
λλλ
2 实验结果
为了验证我们提出的多尺度双边网格框架在自动驾驶场景重建中的有效性,我们在Waymo、NuScenes、Argoverse和PandaSet这四个大规模自动驾驶数据集上进行了广泛的实验。
这些数据集涵盖了不同的传感器配置(如LiDAR、摄像头规格)、环境条件(光照、季节变化)和地理位置,确保了实验结果的广泛适用性。 我们比较了不同方法在几何精度、外观一致性、渲染质量等方面的表现,并对比了现有的最先进模型。
2.1 几何精度与外观一致性
在几何精度方面,我们的方法显著优于所有基准模型。
在Waymo数据集上,倒角距离(CD)从OmniRe的1.378降低至我们方法的0.989,提升了28.2%。
在NuScenes数据集上,我们的方法将CD降低至1.161,相较于OmniRe的1.458也有显著改善。
在外观一致性方面,我们的方法在PSNR和SSIM指标上也表现出色。例如,在NuScenes数据集上,我们的方法PSNR达到了27.69,比OmniRe的26.37有明显提升,SSIM也从OmniRe的0.837提升到了0.847。

2.2 对现有SOTA模型的增强能力
为了验证方法的通用性,本文将其核心模块集成到了两种先进的基线方法ChatSim和StreetGS中。
结果显示,本文的方法能作为即插即用的增强模块,带来巨大提升。例如,它将ChatSim的重建PSNR从25.10提升至27.04;同时将StreetGS的重建PSNR从25.74提升至27.90,并将其几何误差(CD)从1.604降低到1.272。

2.3极端场景对比
我们进一步测试了极端场景(如夜间场景、极端光照、反射、雨天等),证明我们的模型在这些困难条件下表现更加稳健。
2.4 定性评估
以下视频展示了我们方法在处理车表面反射时的表现。
与 OmniRe 对比,视频中可以看到我们的方法在反射区域的处理上更加精准,避免了反射物体的畸变和浮动现象。

另一个视频展示了 我们的多尺度双边格栅 与 OmniRe 方法在阴影和阳光变化下的对比。

我们的方法在这种光照剧烈变化的场景中表现得尤为出色,能够更好地恢复物体细节,并减少因光照变化引起的几何误差与色偏。
下图通过视觉对比,展示了本文的方法在处理真实世界复杂情况时的鲁棒性。通过对比真实图像(Ground Truth)、我们的结果(Baseline + Ours)和基线结果(Baseline),可以观察到:
- (a)高光区域:基线方法在车身反光处出现过曝和细节丢失,而本文的方法能有效抑制高光,还原出下方纹理。
- (b)运动模糊:本文的方法能生成比基线更清晰的动态物体边缘,有效减轻运动模糊带来的影响。
- (c)和(d)不完整几何与伪影:基线方法在重建远处或被遮挡的物体时,容易产生不完整的、破碎的几何结构,而本文的方法能生成更连贯、更完整的场景。
- (e)低光照:在光线不足的场景下,本文的方法能更好地提亮暗部细节,同时避免噪点,还原出更真实的夜间场景。





下图则深入剖析了本文的方法为何有效。它通过直方图的形式,可视化了不同方法所“学习”到的色彩校正策略。
1.下排(Bilateral Grid):代表传统的单尺度双边网格。可以观察到,其学习到的变换分布通常呈现出两个尖锐的峰值(即“双峰分布”)。这表明它只学会了少数几种固定的、缺乏弹性的校正模式,难以适应真实世界中多样化的光照变化。
2.上三排(Multi-scale Bilateral Grid):代表本文的多尺度方法。其最终聚合后的变换分布直方图(最右侧叠加图)显得平滑和分散。这证明本文的方法学习到了一个极其丰富和多样化的色彩变换集合,能够从全局、区域到像素级别进行平滑过渡和精细调整。正是这种强大的适应性和表示能力,使其能够在各种复杂场景中取得鲁棒的、高质量的渲染结果。

3 总结
通过广泛的实验评估,我们验证了多尺度双边网格框架在自动驾驶场景重建中的有效性。与现有方法相比,我们的方法在几何精度、外观一致性和动态场景重建方面均取得了显著提升。特别是在处理动态变化和复杂光照条件下,我们的方法展现了更强的鲁棒性和更高的重建质量。
这一技术突破为自动驾驶和3D场景重建带来了新的可能。通过提高场景的几何精度和视觉真实感,本研究的方法不仅为自动驾驶系统的避障和路径规划提供了更加可靠的数据支持,还为未来的智能交通系统提供了更加稳定和安全的导航基础。
未来,研究团队计划进一步优化该框架,扩展其应用范围,处理更大规模和更复杂的场景,并探索更高效的计算方法,使该技术能够在更多实际应用中落地。
论文题目:Unifying Appearance Codes and Bilateral Grids for Driving Scene Gaussian Splatting
论文作者:Nan Wang, Yuantao Chen, Lixing Xiao, Weiqing Xiao, Bohan Li, Zhaoxi Chen, Chongjie Ye, Shaocong Xu, Saining Zhang, Ziyang Yan, Pierre Merriaux, Lei Lei, Tianfan Xue and Hao Zhao
论文链接:https://arxiv.org/abs/2506.05280
代码地址:https://github.com/BigCiLeng/bilateral-driving
项目主页:https://bigcileng.github.io/bilateral-driving/
...
#探寻自动驾驶的「大脑」进化史
VLA 架构解析 - 以理想汽车为例
在自动驾驶这个飞速迭代的领域,技术范式的更迭快得令人目不暇接。前年,行业言必称BEV(鸟瞰图视角);去年,“端到端”(End-to-End)又成了新的技术高地。然而,每一种范式在解决旧问题的同时,似乎都在催生新的挑战。
传统的“端到端”自动驾驶,即VA(Vision-Action,视觉-行动)模型,就暴露出一个深刻的矛盾:它就像一个车技高超但沉默寡言的“老司机”。它能凭借海量数据训练出的“直觉”,在复杂的路况中做出令人惊叹的丝滑操作。但当您坐在副驾,心脏漏跳一拍后问它:“刚才为什么突然减速?”——它答不上来。
这就是“黑箱”问题:系统能“做对”,但我们不知道它“为何做对”。这种无法解释、无法沟通的特性,带来了巨大的信任危机。
自动驾驶的三大范式演进。(a) 传统的端到端 (VA) 是一个黑箱,缺乏可解释性;(b) 视觉语言模型 (VLM) 只能理解和解释,存在“行动鸿沟”;(c) 视觉-语言-行动 (VLA) 模型打通了感知、推理与行动的闭环
为了撬开这个“黑箱”,行业转向了VLM(Vision-Language Models,视觉语言模型)。VLM就像一个坐在副驾、懂车的“评论员”。它能看懂摄像头拍到的一切,能精准地告诉你“前方有施工”或者“那个指示牌是可变车道”(见图(b))。但问题是,它只会说,不会开。VLM的产出停留在语言和理解层面,与车辆的实际控制之间存在一条难以逾越的“行动鸿沟”(Action Gap)。
显然,我们需要的不是一个“直觉型老司机”和一个“评论员”的生硬组合,而是一位既能掌勺、又能著书立说的“教练型司机”——他不仅能做出完美的驾驶动作,更能用语言解释他为何这么做。
这就是2025年的技术焦点——VLA(Vision-Language-Action,视觉-语言-行动)模型。
VLA不再是VA或VLM的简单修补,而是一场彻底的范式革命(见图 (c))。它的目标是打造一个“可解释的大脑”,将计算机视觉(Computer Vision)、自然语言处理(Natural Language Processing)和强化学习(Reinforcement Learning)这三大AI领域的顶尖技术最终融合在一起,试图创造一个既能感知世界、又能理解规则、更能执行动作的统一智能体。
VLA的诞生并非偶然,它是人工智能三大分支(计算机视觉、自然语言处理、强化学习)发展至今的必然融合点
一、“真假”E2E之辨:VLA为何是自动驾驶的“真”端到端?
在自动驾驶的讨论中,“端到端”(End-to-End, E2E)是一个被频繁使用,但定义却常常模糊的术语。要理解VLA为何被视为一场革命,我们必须首先严格地辨析:在驾驶场景下,到底什么才是“真”端到端?
一个“真”的端到端驾驶系统,必须是一个统一的、完整的神经网络。它接收最原始的传感器输入(如摄像头图像 - Vision),并直接输出最终可执行的控制信号(如转向和加减速 - Action)。
这个架构最关键的特性,在于它是“全程可求导”的(Fully Differentiable)。这意味着,当车辆在现实中犯了一个错误(比如刹车晚了),这个“错误”的信号可以像电流一样,从最终的动作输出端,一路反向传播(Backpropagation)回溯到最开始的视觉输入端,从而修正和优化网络中的每一个参数。
只有这样,系统才能通过驾驶本身“学会”驾驶。
图1.1:VLA(左)被视为“全程可求导”的统一架构,而传统的E2E+VLM(右)则被视为“非全程可求导”的双系统拼凑
1.1 VLM的“非”端到端本质
基于上述严格的定义,我们再来看行业早期为了让E2E模型“变聪明”而引入的VLM(视觉语言模型),会发现一个根本性的问题。
VLM的引入,非但没有实现“真”端到端,反而从架构上“打断”了端到端的闭环。
其核心问题在于:VLM的输出端是文本(Text),而非轨迹(Trajectory)。
图1.2:不同端到端范式的对比。(a) 是经典的VA黑箱。(b) VLM-Based E2E方法,其输出是“Text”,而不是可执行的轨迹(c)红色的被打叉的反向传播虚线也表明,学习信号无法直接从车辆动作回传到VLM
正如上图(b)所示,VLM(视觉语言模型)在自动驾驶中扮演的角色,是我们序言中提到的“评论员”。它接收图像输入(Image),然后输出它对场景的“理解”,即文本(Text)。例如,它会输出:“前方有行人,应减速”或“这是一个可变车道,当前可通行”。
这个“文本”输出,与车辆最终执行的物理动作——即一系列精确的转向、油门、刹车数值(例如 [x, y, yaw, velocity, ...])——之间,存在着一条巨大的“语义鸿沟”和“行动鸿沟”。
这种架构上的断裂,带来了一个灾难性的后果:VLM模型无法受益于自动化的数据闭环(Data Loop)驱动。
试想一下:当车辆因为“刹车晚了”而产生了一个错误,这个“刹车”的错误信号是一个物理数值。我们如何用这个物理数值,去反向训练一个只输出“文本”的VLM,让它下次生成“更正确”的句子呢?答案是几乎不可能。
由于VLM并不直接输出轨迹,它的学习和优化(即反向传播)与车辆的最终驾驶行为是“解耦”的。因此,VLM本质上“并非端到端神经网络”(在驾驶的语境下)。它是一个强大的“外挂”大脑,但它不是“驾驶员”本身。
1.2 “快慢双核”的“半”端到端
既然VLM本身无法成为端到端的“驾驶员”,一个看似聪明的“折中”方案便应运而生:将VLM(“评论员”)与传统的VA(“老司机”)组合在一起,形成一个“L+VA”的拼凑架构。
这就是行业早期的“快慢双核”系统。
- “快系统”(System 1): 传统的VA端到端模型,负责处理95%的常规驾驶场景。它就像大脑的“直觉与本能”,运行速度快、自动化。
- “慢系统”(System 2): VLM大模型,负责处理5%的复杂长尾场景(如理解异形路标、处理复杂博弈)。它就像大脑的“理性思考”,费力、缓慢但逻辑性强。
图1.3:理想汽车早期的IM智驾系统(Li E2E + VLM Dual System Framework)。该架构明确地将驾驶分为“系统1-动作”(E2E模型)和“系统2-决策”(VLM模型),对应了丹尼尔·卡尼曼的“思考,快与慢”理论
以理想汽车早期的IM系统为例,这套“快慢双核”架构的运行机制非常典型:
它的“快系统”(System 1)运行在一块Orin X芯片上,可能以15-20Hz的频率高速处理本能驾驶。而它的“慢系统”(System 2,基于阿里的千问大模型)则运行在另一块芯片上,受限于算力和VLM的复杂性,可能仅以5Hz的频率缓慢地进行“理性思考”。
这种“半”端到端的拼凑架构,虽然在一定程度上解决了VA“老司机”不认识字的问题,但也带来了三个致命的缺陷:
- 异步与冲突: 两个系统、两块芯片、两种频率(15-20Hz vs 5Hz),这本身就是一场灾难。当“快系统”凭直觉要超车时,“慢系统”在200毫秒后才反应过来并发出指令:“不要超车,那是可变车道”。此时,两个系统的决策发生冲突,车辆到底该听谁的?
- 臃肿与信息损失: “慢系统”VLM如何“指导”“快系统”E2E?它无法直接传递“直觉”,只能通过低效的“符号”。比如,VLM输出一段文本,或者输出一条粗糙的“参考轨迹”,然后“快系统”再进行所谓的“轨迹优化”(Trajectory Refinement)。这就像一个“翻译”过程(见图1.2 (c)),不仅架构臃肿,而且在“翻译”过程中会丢失大量有价值的原始信息。
- 优化困难: 这两个系统是独立训练的。你无法将一个“慢系统”的VLM和一个“快系统”的E2E放在一起进行端到端的联合优化。如图1.1所示,这是一个“非全程可求导”的架构。驾驶失误的信号无法同时回传给两个系统,导致整个架构的迭代效率低下。
我们看一下图1.2 :(c) VLM-Assisted Classic E2E methods。这张图清晰地展示了“快慢双核”的拼凑架构,VLM通过一个低效的接口(Interfaces)与经典的E2E方法相连,反向传播(红色虚线)被阻断(X)。
因此,这种“快慢双核”系统,本质上只是一个“半”端到端的过渡形态。它虽然短暂地解决了有无问题,但其架构上的根本性缺陷,决定了它必然会被“真”端到端所取代。
1.3 VLA的“真”端到端
“快慢双核”的拼凑暴露了根本性的架构缺陷,而VLA(视觉-语言-行动)模型,正是为了彻底解决这些问题而生的。它不是对旧架构的修补,而是一次彻底的“颠覆性”重构。
VLA的“真”,首先体现在它在算法形式上,回归并坚守了从(传感输入)到(轨迹输出)的端到端神经网络形式。
图1.4:从“E2E + VLM”(上图)到“VLA”(下图)的进化。VLA将两个并行的、解耦的系统(3D编码器->动作解码器 和 2D编码器->LLM),重构为一个统一的、串行的“V -> L -> A”单一模型(空间智能 -> 语言智能 -> 行动策略)
如上图所示,VLA不再是两个分裂的系统,而是一个统一的、单一的大模型。在这个模型中,视觉感知(V)、语言推理(L)和动作执行(A)被“融合”在了一起。
这种架构上的统一,带来了一个至关重要的特性,也是“真”端到端的核心标志:“全程可求导”(Fully Differentiable)。
“全程可求导”意味着,当车辆在现实中犯了一个错误(比如刹车晚了),这个“错误”的信号可以从最终的“轨迹”(Trajectories)输出端,一路无阻碍地反向传播(Backpropagation),穿过“行动策略”(A模块)、穿过“语言智能”(L模块),一直回溯到最开始的“空间智能”(V模块)。
这解决了“快慢双核”最大的痛点。它意味着VLA终于可以像最初的VA“老司机”模型一样,高效率、低成本地通过自动化的数据闭环(Data Loop)来实现驾驶数据的自我驱动和迭代。
那么,VLA是如何解决“快慢双核”之间低效的“符号”交流问题的呢?
答案是,VLA通过一个统一的内部表征,取代了L和V+A之间低效的“外部翻译”。在“快慢双核”系统中,语言模型(L)和行动模型(VA)是通过“符号”(如文本指令)来交流的,这个过程效率极低且损失了大量信息。
而在VLA这个统一模型中,V、L、A模块之间传递的不再是人类能理解的“文本符号”,而是一种模型内部的“软符号系统”(soft-symbol system)。大语言模型(LLM)在VLA中的工作方式,也不是真正进行人类意义上的“符号逻辑推理”,而是如GPT自己所说,它在底层是token prediction(令牌预测),但能“涌现”出“合理的思维链条”,这是一种“类推理能力”。
换言之,VLA内部的“思考”和“行动”是同一种“语言”(即Token)。L模块(语言智能)的输出——即“思考”的结果,直接就是A模块(行动策略)的输入——即“行动”的指令。这种内部的“类推理”token预测,远比“快慢双核”之间通过文本符号来回“翻译”要高效和保真得多。
这就是VLA的真正强大之处。它不是简单地把V、L、A三个积木粘在一起,而是把它们熔铸成了一个全新的合金。它既拥有了传统E2E模型的“全程可求导”的数据驱动能力,又在模型内部融合了大语言模型的“思维链”和“类推理能力”。
VLA=端到端的神经网络形式 + 大语言模型的推理能力
它终于成为了我们想要的那个,既能开、又能(在内部)“思考”的“真”端到端驾驶员。
二、VLA要解决的“VLM顽疾”:从“长尾场景”到“语义鸿沟”
VLA的出现,并不仅仅是为了追求更优雅的“全程可求导”架构。它的诞生,更是出于一种迫切的“必要性”——即为了解决上一代“快慢双核”(L+VA)架构暴露出的四大核心痛点。这些痛点,是VLM和E2E模型“强行拼凑”时必然产生的顽疾。
2.1 长尾场景的挑战:当“老司机”不认识字
自动驾驶面临的最大挑战,并非日常的直行和转弯,而是那些“出乎意料”的“长尾场景”(Corner Cases)。
对于传统的VA“老司机”模型(即基于找规律的数据驱动系统)而言,学习“左转右转”或“绕开一个坑”是容易的,因为这些驾驶行为在全世界的规律都相似。但当它面对一个写着“前方施工,请绕行”的临时手写木板时,它就束手无策了。
这就是“长尾场景”的核心:它们是高度语义化、非标准化、且极其多样化的。
图2.1:中国自动驾驶面临的“长尾”挑战——“不仅仅是公交车道”。这张图集中展示了大量复杂的、非标准的、甚至临时的交通标识,这些是传统E2E模型难以处理的
上图仅仅揭开了冰山一角。中国的实际路况远比这更复杂:
- 复杂的龙门架: 一块指示牌上可能挤满了十几个箭头和地名。
- 可变车道: 需要根据不同时段的LED灯或指示牌来判断能否通行。
- 临时指示: 各种临时的、不规则摆放的锥桶和手写指示牌。
- 动态LED文本: 如“在安全原则下,红灯允许直行” 或“ETC故障,请走人工通道”。
对于VA“老司机”来说,这些充满了“文字”和“逻辑”的场景是它的知识盲区。它无法通过“找规律”的方式去学习这上百万种“如果”。
正是为了解决这个“老司机不认识字”的根本性问题,VLM(语言模型)才被引入到自动驾驶系统中。VLM的核心任务,就是去“阅读”和“理解”这些VA模型无法处理的复杂语义信息。然而,VLM的引入,虽然解决了“长尾”问题,却也带来了下面三个更为棘手的架构顽疾。
2.2 语义鸿沟(The Gap):当“大脑”的语言,“车轮”听不懂
VLM的引入虽然解决了“长尾场景”的“看懂”问题,但它也立即催生了一个更棘手的架构难题:“语义鸿沟”(Semantic Gap)。
VLM(无论是理想IM 还是其他VLM-Assisted方法)本质上是生活在一个“语义推理空间”(Semantic Reasoning Space)。它的输出是文本(Text),是逻辑和描述。例如,它会输出:“前方有行人,应减速”。
图1.2 中的 (b) VLM-Based E2E 和 (c) VLM-Assisted E2E 揭示了“鸿沟”所在。VLM的输出是“Text”(文本)或“Interfaces”(接口),而不是车辆能直接执行的动作,反向传播(红色虚线)因此被阻断。
然而,车辆的控制器(如方向盘、油门、刹车)并不生活在“语义空间”,而是生活在一个纯粹的、冷冰冰的“轨迹行动空间”(Action Space)。它需要的是一系列精确的、可执行的纯数值,例如:[转向角: -5.2°, 加速度: -2.1m/s², ...]。
“应减速”(一个文本字符串)和 [加速度: -2.1m/s²](一个物理数值向量)之间,存在着一条几乎无法跨越的“语义鸿沟”。
“快慢双核”系统 试图用一种笨拙的方式来“翻译”:让VLM(慢系统)输出一个粗略的指令(如文本或一条大致的轨迹),然后让E2E(快系统)去执行所谓的“轨迹优化”(Trajectory Refinement)。这就像一个“评论员”在电话里告诉“老司机”该如何打方向盘,这个过程不仅效率低下,而且充满了信息的损失和误解。这就是VLM架构下难以弥补的“行动鸿沟”。
2.3 空间精度不高:当“评论员”被强行要求“画图”
一个自然的想法是:既然“翻译”这么麻烦,我们能不能强行“教会”VLM,让它不输出文本,而是直接输出那串[x, y, z, ...]的轨迹数值呢?
答案是:可以,但效果很差。
VLM(尤其是那些基于LLM的VLM)的核心是“语言”和“逻辑”。它的整个世界是由“Token”(令牌)构建的。让一个以“Token”为基础的模型去生成高精度的、物理上连续的、空间几何上正确的驾驶轨迹,就像是强迫一个诗人去绘制一张CAD工程蓝图。
结果就是“空间精度不高”,“输出轨迹点是基于语言生成的,易产生偏差”。VLM或许能“理解”它应该向左转,但它“画”出来的这条左转轨迹可能是歪歪扭扭的、会切到马路牙子的、或者在加减速上是反物理的。
这种与生俱来的“偏差”意味着VLM(慢系统)永远无法被信任去直接操控车辆。它最多只能提供一个“大概的参考意见”,最后还是需要“快系统”E2E模型来收拾残局,进行实时的、高精度的轨迹生成。这进一步证明了“快慢双核”架构的臃肿和低效。
2.4 时序建模的瓶颈:当“大脑”只有三秒钟记忆
最后一个顽疾,是VLM在处理“时间”上的瓶颈。
驾驶决策不是一个静态的“看图说话”,而是一个动态的“时序分析”。你不仅要看到“现在”有一辆车,你还要知道它“5秒前”在哪里,“3秒前”是否在加速,以此来“预测”它“2秒后”会做什么。
传统的VLM(如LLaVA)在处理视频或时序任务时,采用的是一种简单粗暴的方法:叠加多帧的图像信息(Stacking Frames)。
这种方法在自动驾驶的复杂场景下,会立即导致两个灾难性的后果:
1. Token长度限制(Context Window Limit):
VLM“通过叠加多帧的图像信息完成时序建模,会受到 VLM 的 Token 长度限制”。一个LLM的上下文窗口(Context Window)是有限的。如果一帧图像需要消耗500个Token,那么一个8K的上下文窗口最多也就能装下16帧。如果以10Hz的频率计算,这连2秒钟的驾驶历史都存不下。这种“短暂的记忆”让VLM无法进行任何长时程的规划和博弈。
2. 巨大的计算开销(Computational Cost):
VLM(慢系统)本就运行缓慢。如果每一次“思考”都需要它去处理这叠加的十几帧图像,无疑是雪上加霜。这“会增加额外的计算开N销”,并进一步拉大了它与“快系统”(E2E)之间的频率差距,使得“快慢双核”的同步几乎成为不可能的任务。
综上所述,VLM的引入虽然解决了VA“老司机”不认识字的“长尾”问题,但它带来的“语义鸿沟”、“空间精度低”和“时序瓶颈”这三大顽疾,使得“快慢双核”的拼凑架构注定只是一个过渡。
自动驾驶需要一场彻底的革命,一个能同时解决这所有问题的“统一大脑”。这就是VLA诞生的使命。
三、VLA的通用技术栈:积木是如何搭建的?
VLA的“统一大脑”并非凭空产生的魔法,它更像是将过去十年中AI领域最顶尖的“乐高积木”——即那些在各自领域被验证为最强(SOTA)的模型组件以一种全新的方式拼装在了一起。
要真正理解VLA,我们就必须拆解它的“积木”。一个VLA模型(无论是用于自动驾驶还是机器人) 通常由三个核心技术组件构成:视觉编码器(V)、语言编码器(L)和动作解码器(A)。
本章,我们就来详细拆解这三大组件的“黄金标准”。
图 3.1:一个VLA系统的典型架构。它清晰地展示了VLA的三大核心组件:视觉编码器(Visual Encoder)、大型语言模型(Large Language Model,即L模块)和动作解码器(Action Decoder)
3.1 视觉编码器 (V):VLA的“眼睛”
VLA的“眼睛”,即视觉编码器(Visual Encoder),是整个系统的感知基石。它的核心任务是接收最原始的传感器输入(如摄像头图像),并将其“翻译”成“大脑”(L模块,即LLM)能够理解的“视觉令牌”(Visual Token) 或特征。
在当今的技术栈中,这个角色的最佳选择,几乎被ViT(Vision Transformer)及其变体所垄断。而ViT的强大,又来自于其特定的“预训练”方式。
目前,VLA领域最受青睐的ViT主要有两种:CLIP/SigLIP 和 DINOv2。它们各自为VLA提供了不可或缺的独特能力。
1. CLIP / SigLIP:提供“内容识别”能力 (“What is it?”)
- 核心功能:
CLIP(及其优化版SigLIP)的核心是 强大的视觉-文本对齐(visual-text alignment)能力。它擅长将图像中的像素与描述这些像素的自然语言单词联系起来。 - 训练方式: 它们通过海量的“图像-文本”配对数据进行“对比学习”(Contrastive Learning)。简单来说,它们学习到了“这段文字描述的就是这张图片”。
-
SigLIP的优势:SigLIP是CLIP的直接升级版。它用更简单、扩展性更好的Sigmoid损失函数,取代了CLIP复杂的Softmax损失函数,训练过程更高效,且在更大规模数据集上表现更好,从而实现了“更简单,效果更好”。 - VLA中的角色:
SigLIP主要为VLA提供了“识别和描述图像内容” 的能力。它负责告诉“大脑”:“我看到了一个红色的瓶子”或“这是一条狗,脖子上有牵引绳”。
2. DINOv2:提供“空间理解”能力 (“Where is it? How is it positioned?”)
核心功能:DINOv2 的核心是强大的空间理解和高级视觉语义能力。训练方式: 它是一种自监督学习(Self-Supervised Learning)模型。它不需要文本标签,而是通过一种名为“自蒸馏”(self-distillation) 的方式进行训练。这种方式强迫模型去理解图像的内在空间结构(例如,一张猫的左耳和右耳在空间上的关系,即使没有任何文字告诉它这是“猫”或“耳朵”)。VLA中的角色:DINOv2主要为VLA提供了“空间推理能力”。它负责告诉“大脑”:“那个红色的瓶子在碗的左边,并且是竖立着的”,或者“那只狗正坐着,它的牵引绳延伸到了草地上”。
3. 顶尖方案:SigLIP + DINOv2 双编码器
既然SigLIP擅长“识别内容”(What),而DINOv2擅长“理解空间”(Where/How),那么最强大的VLA视觉系统,自然是将两者互补的优势结合起来。
图3.2:OpenVLA的视觉编码器架构。它同时并联使用了DinoV2和SigLIP,将两者的特征(features)融合后,再送入MLP Projector(MLP投影器)
这正是OpenVLA、Prismatic-7B 等顶尖VLA模型所采用的“双编码器”策略:
- 并行编码: 原始图像被同时输入到SigLIP和DinoV2两个独立的视觉编码器中。
- 特征提取:SigLIP输出包含丰富“内容”信息的特征向量,DinoV2输出包含精确“空间”信息的特征向量。
- 特征融合: 这两种不同类型的特征向量在通道维度上被“连接”(Concatenated)在一起,形成一个同时包含“是什么”和“在哪里/怎么样”的“综合性的视觉表示”(comprehensive visual representation)。
- 模态对齐-关键步骤: 最后,这个“综合视觉特征”必须被“翻译”成“大脑”(L模块,即LLM)能够理解的“语言”。这个关键的“翻译”步骤由一个MLP Projector(多层感知机投影器) 完成。该投影器负责将高维的视觉特征向量,投影(映射)到与LLM处理文本时使用的相同的“令牌”(Token)嵌入空间中。
通过这种“双编码器 + MLP投影器” 的精密设计,VLA的“眼睛”就为“大脑”提供了最完美的输入:一个既知道“是什么”(来自SigLIP),也知道“在哪里/怎么样”(来自DinoV2)的、且“大脑”能够直接理解的视觉信息流。
理想汽车MindVLA的实现方式:拥抱3D高斯建模 (3DGS)
值得注意的是,SigLIP + DINOv2 虽然是通用VLA中的顶尖方案,但并非唯一选择。
理想汽车的MindVLA在其V-Spatial Intelligence(空间智能)模块 上,采取了另一条更侧重于高保真3D重建的技术路线。
图3.3:MindVLA的V模块核心是“高斯中心”(Gaussian-Centric)的自监督3D编码器预训练
MindVLA的V模块核心是:
- 3D高斯建模-3D Gaussian Splatting, 3DGS:它没有使用SigLIP或DINOv2,而是直接采用了基于3D高斯球的场景表示方法。这种方法旨在从多视图2D图像中,重建出更精细、更连续的3D场景。
- 自监督3D编码器预训练-Self-Supervised 3D Encoder Pretraining:其V模块通过自监督的方式,直接从传感器数据(包括摄像头Cameras, 激光雷达Lidar等)通过3D Encoder 生成统一的Scene Representation(场景表示)。
- 3D Tokenizer / 3D Projector:最终,这个基于3DGS的场景表示,通过3D Projector(3D投影器) 或3D Tokenizer 被转换为MindGPT(L模块) 可以理解的Token。
对比总结:
- 通用方案-SigLIP + DINOv2: 更侧重于从2D图像中提取内容和空间语义,并通过MLP投影器与LLM对齐。
- MindVLA方案-3DGS: 更侧重于直接进行高保真的3D场景重建,为“从零预训练”的L模块提供更原生、更丰富的3D空间输入。
这两种不同的V模块实现路径,也反映了VLA架构仍在快速发展,不同的团队在根据自身的技术积累和目标进行着不同的探索。
3.2 语言编码器 (L):VLA的“大脑”
如果说V模块(视觉编码器)是VLA的“眼睛”,那么L模块(语言编码器,即LLM)就是VLA的“大脑”。
这个“大脑”是整个系统的“决策中枢”。它的核心任务不再是像ChatGPT一样“聊天”,而是接收来自“眼睛”(V模块)的视觉令牌(Visual Token) 和来自用户的文本令牌(Text Token),在模型内部将这两者“融合”(Fuse),并进行复杂的跨模态推理(Cross-modal Reasoning)。
3.2.1 “大脑”的主流选择:LLaMA家族与Qwen等
正如V模块被ViT及其变体所统治,L模块(语言领域)目前的主流选择也相对集中。
- LLaMA家族(核心主导): 这是目前VLA领域的绝对主流。
- LLaMA-2:被广泛认为是开源VLA模型的“标配”。例如,OpenVLA 和 Prismatic-7B 都明确使用了Llama 2 7B 作为其语言主干(backbone)。
- Vicuna:作为LLaMA最著名的微调变体之一,Vicuna因其强大的对话和推理能力而被广泛采用。ORION 架构的LLM就是Vicuna v1.5。
- Qwen系列(重要力量): 阿里巴巴的Qwen系列也在VLA领域扮演着重要角色。
- OpenDriveVLA使用了Qwen-2.5。
- SimLingo使用了Qwen-2。
- Impromptu VLA和AutoVLA则都采用了Qwen-2.5VL。理想汽车早期IM系统也使用了基于Qwen(千问)的VLM。
- 其他家族(展现多样性): 当然,GPT系列和Gemma等也在VLA模型中占有一席之地,验证了VLA架构的灵活性。
- EMMA使用了Gemini。
- LangCoop使用了GPT-4o。
- VaVIM使用了GPT-2。
- Pi-0和FAST模型使用了Gemma-2B。
3.2.2 “大脑”是如何工作的?—— 融合与推理
L模块的工作流程(以OpenVLA 和 ORION 为例)非常精妙:
图注:OpenVLA的L模块(Llama 2 7B) 接收两路输入:一路是来自Llama Tokenizer的“文本指令”,另一路是来自MLP Projector的“视觉特征”。
- 融合(Fusion): L模块(LLM)的输入是一个组合序列。这个序列的前半部分是来自“眼睛”(V模块)的视觉Token(即被MLP Projector“翻译”过的视觉特征),后半部分是来自“用户”的文本Token(例如“Put eggplant in bowl”,即“把茄子放进碗里”)。
- 推理(Reasoning): 一旦输入融合,LLM就会像处理普通文本一样,在“视觉”和“文本”Token之间进行复杂的“自注意力”(Self-Attention)计算。
- 在ORION 这样的高级架构中,L模块的输入甚至还包括了来自QT-Former 的“历史Token”。
- 此时,LLM会执行后续的高级推理任务,如“场景分析”(Scene Analysis)、“动作推理”(Action Reasoning)和“历史回顾”(History Review)。
3.2.3 “大脑”的输出:从“思考”到“指令”
VLA“大脑”的革命性在于它的输出。
它输出的不是用于聊天的文本,而是一个(或一系列)高度浓缩的、机器可读的“动作令牌”(Action Token) 或“规划令牌”(Planning Token)。
这个“Token”就是L模块(大脑)“思考”的最终结晶。它代表了一个明确的“意图”或“决策”(例如“抓取红色物体”或“执行减速让行策略”)。这个“意图”将被传递给A模块(“手脚”),由A模块去解码和执行。
3.2.4 “大脑”的优化:LoRA与MoE
在车端或机器人上部署一个70亿(7B)参数的LLM 是一个巨大的工程挑战。为了让“大脑”既聪明又高效,业界采用了两种主流的优化策略:
- LoRA-Low-Rank Adaptation: 这是ORION(小米的实现) 采取的策略 。即冻结(Frozen) 庞大的Vicuna 主体参数,只在旁边“外挂”一个极小的、可训练的LoRA适配器。这使得VLA的微调成本和部署灵活性大大降低,是一种“轻量化”的改装方案 。
这里面理想汽车MindVLA的与ORION 等模型采用开源LLM(如Vicuna )+ LoRA 轻量化微调的“改装”路线不同,理想汽车的MindVLA 选择了更彻底的“从零开始打造LLM” 的“自研”路线,其L模块被称为MindGPT。
图 3.6 :MindGPT核心架构,专为“实时边缘推理”设计
MindGPT 的核心特点在于其针对3D驾驶场景的原生设计:
- 原生3D输入:MindGPT的输入不是经过MLP Projector “翻译”的2D图像特征,而是来自V模块 的、通过3D Projector 或3D Tokenizer 处理的“3D高斯特征”(3D Gaussian Features)。它的“母语”就是3D空间。
- 面向驾驶的预训练:MindGPT在预训练阶段就学习驾驶相关的物理因果律,例如通过“未来帧预测”(Next Frame Prediction) 和“CoT(条件输出)” 等任务进行训练。
- 为车端优化的架构: 为了在车端芯片上实现实时推理,MindGPT内部采用了MoE(混合专家)+ 稀疏注意力(Sparse Attention) 架构,通过Router(路由器) 实现稀疏激活,大幅降低了计算量。
- 高效动作输出: 在输出“Action Tokens”(动作令牌) 时,MindGPT采用了“并行解码”(Parallel Decoding) 技术,在一个步骤内同时生成所有动作指令(如转向、油门等),满足了实时性要求。
对比总结:
- 通用方案-如ORION: 通常采用开源LLM + LoRA微调。优点是开发速度快,可利用社区成果;缺点是LLM底层可能缺乏对3D物理世界的原生理解。
- MindVLA方案-MindGPT: 采用从零预训练。优点是模型天生为3D驾驶设计,与V模块(3DGS) 结合更紧密,性能潜力可能更高;缺点是研发投入巨大。
3.3 动作解码器 (A):VLA的“手脚”
当“眼睛”(V模块)完成了高保真的3D感知,“大脑”(L模块)也完成了复杂的跨模态推理 并输出了一个抽象的“指令”——即“动作令牌”(Action Token)或“规划令牌”(Planning Token)之后,VLA就进入了最后,也是最关键的一步:执行。
“动作解码器”(Action Decoder, A模块) 就是VLA的“手脚”。
它的核心任务,就是接收来自“大脑”(L模块)的那个高度浓缩的“意图”Token,并将其“解码”(Decode) 成一系列真实、物理、可执行的控制信号,例如机器人的[Δx, Δθ, ΔGrip](7D动作) 或自动驾驶的“Trajectories”(轨迹)。
图3.7:一个VLA系统的标准流程。LLM(大脑)输出“Action Token”(指令),这个Token随后被送入“Action Decoder”(手脚),解码为最终的“Robot Action”(机器人动作)
在VLA的技术栈中,实现这个“解码器”有多种路径,但其中一种因其卓越的性能而成为当今的“黄金标准”。
3.3.1 “黄金标准”:基于扩散的Transformer(Diffusion Transformer)
在所有技术中,“基于扩散的Transformer”(Diffusion-based Transformer)是目前VLA模型中“最受青睐”(most favored)的动作解码器方案。
- 代表模型:Octo、理想汽车的MindVLA(其A-Action Policy核心就是一个“Diffusion Decoder”) 以及小米/华科的ORION(它也将Diffusion作为一个核心的“Generative Planner”选项) 都采用了这一思路。
- 为何是它? 因为Diffusion模型(AIGC绘画的核心技术)极其擅长“建模复杂多模态动作分布”。
- 解释: 驾驶或机器人操作往往不是一个“唯一解”。面对一个障碍物,你可以“向左绕一点”、“向左绕很多”或者“减速等待”。Diffusion模型天生就能理解并生成这种“多模态”的概率分布,而不是只给出一个僵硬的单一答案。
- 如何工作? 它通过一种名为“迭代去噪”(Iterative Denoising) 的方式工作。
- 流程: 从一堆随机的“噪声”(Noise) 出发,在“大脑”(L模块)输出的“Action Token”或“Planning Token”的约束和引导下,逐步将噪声“还原”成一条(或多条)符合意图的、最优的轨迹。
- 核心优势: 这种“生成式”的轨迹,具有无与伦比的“细粒度”和“平滑控制”(fine-grained, smooth control)能力。
- “拟人化”轨迹: 这完美地呼应了MindVLA的目标——生成“拟人化”的、“如丝般顺滑”的“黄金轨迹”。正如理想工程师所比喻的“旋轮线”,Diffusion寻找的是物理上最优、最舒适的“变分函数”解,而不是简单的代数曲线。
- 工程挑战: Diffusion虽然强大,但“迭代去噪”天生就很慢。为了解决这个问题,MindVLA等架构采用了ODE Sampler(常微分方程采样器) 等技术,将“去噪”步骤从几百步压缩到“2到3步”,从而满足了实时控制的需求。
- 解决方案 (以MindVLA为例): 为了解决这个速度瓶颈,MindVLA等架构采用了ODE Sampler(常微分方程采样器) 等先进的采样技术。
- 效果: 这些技术极大地加速了Diffusion的生成过程。它们不再需要“成百上千步”,而是可以将轨迹的“收敛”压缩到“大概2到3步内完成”。这个工程上的突破,才使得Diffusion这个强大的生成模型,终于得以被应用于需要实时控制的自动驾驶和机器人领域。
3.3.2 其他主流方案
虽然Diffusion是“顶配”,但在不同的VLA模型中,也存在其他更简洁、更高效的解码器方案:
- 自回归Transformer头(Autoregressive Transformer Head):
- 代表模型:Gato。
- 工作方式:这种解码器就像LLM“写作文”一样,一个Token一个Token地“逐步生成动作序列”。例如,它会先生成“转向Token”,再生成“油门Token”……
- 核心优势:这种方式非常适合“优化实时响应”。
- MLP预测器头(MLP Predictor Head):
- 代表模型:OpenVLA。
- 工作方式:这是最简单直接的方案。L模块输出的“Action Token”,被直接送入一个简单的MLP(多层感知机,即Action De-Tokenizer),由这个MLP直接“映射”出最终的[Δx, Δθ, ΔGrip] 等控制数值。
- 核心优势:“实现高效低级控制”。它极其轻量,计算速度飞快。ORION的消融实验也将“MLP with Planning Token”作为了一个重要的对比基线。
- 嵌入式MPC/规划头(Embedded MPC / Planning Head):
- 代表模型:VoxPoser。
- 工作方式: VLA的L模块(大脑)不输出具体动作,而是输出一个“目标状态”,然后由一个经典的“模型预测控制”(MPC)或“规划头”来解算这个目标。
- 核心优势:“支持动态决策”,能很好地与传统的、经过安全验证的控制理论相结合。
从简单的MLP,到实时的自回归,再到最强大、最受青睐的Diffusion Transformer,“动作解码器”(A模块)是VLA的最终执行者,负责将“大脑”的意图转化为物理世界的精确动作。理想汽车MindVLA 通过采用先进的Diffusion Transformer 并结合ODE Sampler 加速技术,力求在生成质量和实时性之间达到最佳平衡。
至此,VLA的“积木”已全部分解完毕:它用强大的视觉编码器(如3DGS 或SigLIP+DINOv2)作为“眼睛”,用LLaMA 或自研模型(如MindGPT)作为“大脑”,用先进的动作解码器(如Diffusion Transformer)作为“手脚”。这些最强组件的融合,构建出了这个革命性的“统一大脑”。
四、VLA的四个进化阶段:从“驾驶解释器”到“决策核心”
VLA架构的演进并非一蹴而就,而是经历了一个清晰的、逐步“赋权”的过程。语言(Language)在自动驾驶系统中的角色,经历了从一个被动的“旁观者”,到主动的“规划者”,最终演变为具备推理能力的“决策核心”。
根据麦吉尔大学和清华大学等机构的权威综述,我们可以将VLA的发展划分为四个清晰的阶段。
图4.1:VLA模型在自动驾驶(AD)领域的演进历程。清晰地展示了从“VLM作为驾驶解释器”到“推理增强型VLA”的四个阶段,语言的角色和输出内容发生了根本性转变
阶段一:语言模型作为“解释器” (Pre-VLA: Language Model as Explainer)
在最初的探索阶段(Pre-VLA),语言模型被用作一个被动的、用于描述的工具,其核心目标只有一个:增强自动驾驶系统的可解释性。
这一阶段的系统,就是我们前文提到的“评论员”。
- 典型架构: 这一阶段的系统通常采用一个冻结的视觉模型(如 CLIP)和一个LLM解码器(如 LLaMA-2)。
- 工作流程: 如图4.1中的第一副图所示,系统感知到驾驶场景(Vision)后,将图像特征喂给视觉语言模型(VLMs),模型并不参与任何车辆控制。
- 核心输出: 其输出是纯粹的文本,如“解释”(Explain)、“问答”(Q&A)或“场景描述”(Description)。
DriveGPT-4 是这个阶段的典型代表。它可以接收来自前置摄像头的单张图像,然后生成一个高阶的操纵标签(如“减速”、“左转”)或一段场景描述。
这些文本输出,极大地帮助了人类工程师去理解感知系统“看到”了什么,或者E2E“黑箱”模型“打算”做什么,从而提升了系统的透明度。
然而,这个阶段的局限性也是显而易见的:一个根本性的“语义鸿沟”(或者说“行动鸿沟”)依然存在。正如之前所说的:“描述场景不等于生成精确的驾驶指令”。这个“评论员”的角色,使其在驾驶任务上更像是一个“局外人”,对解决实际的驾驶问题帮助有限。
阶段二:模块化VLA模型 (Modular VLA Models for AD)
随着研究的深入,语言的角色开始发生关键转变。它不再仅仅是一个被动的场景“评论员”,而是演变为模块化架构中一个主动的规划组件。
在这一阶段,语言的输入和输出开始直接为规划决策提供信息。其核心思想是,语言成为了连接“高级指令”与“车辆执行”之间的一个可解释的中间环节。
- 典型架构: 如图4.1中的第二幅图所示,系统接收多模态视觉输入(Multimodal Vision),VLM(视觉语言模型)不再只是对外输出文本,而是生成一个“中间表示”(Intermediate Representation)。这个中间表示随后被送入一个独立的“动作头”(Action Head),最终由动作头输出“轨迹”(Trajectory)或“控制”(Control)信号。
- 工作流程: 感知 -> 语言规划 -> 动作执行。
这一阶段涌现了许多创新的代表作:
- OpenDriveVLA:它能融合摄像头、激光雷达和文本路径指令(例如“在教堂右转”),然后VLM会生成人类可读的中间路径点(例如“20米后右转,然后直行”),这些路径点最后被下游的控制器转换为连续的轨迹。
- DriveMoE:它采用混合专家(Mixture-of-Experts)架构。VLM会利用语言线索(例如分析场景是“高速超车”还是“拥堵跟车”),来动态地选择最合适的子规划器(例如“超车专家”或“启停专家”)。
- RAG-Driver:它提出了一种检索增强(RAG)的规划机制。当遇到模糊或长尾场景时,系统会从记忆库中“检索”相似的历史驾驶案例,用以指导当前的决策。
尽管这些模块化方法显著缩小了语言指令和车辆动作之间的“语义差距”,但它们的根本缺陷也暴露无遗:它们严重依赖于多阶段的处理流程。
这种“感知 -> 语言规划 -> 动作执行”的串联管道,不仅会引入显著的计算延迟(这在高速驾驶中是致命的),而且在每个模块的交界处都带来了“级联错误”(Cascading Errors)的风险。
换句话说,如果第一阶段的VLM对场景的理解(中间表示)出了哪怕一点小错,这个错误也会被传递并放大到第二阶段的“动作头”,导致最终输出一个灾难性的驾驶轨迹——即使“动作头”本身的功能是完美的。这个“翻译”过程中的信息损失和错误累积,是模块化VLA无法克服的硬伤。
阶段三:统一的端到端VLA模型 (Unified End-to-End VLA Models for AD)
模块化VLA暴露出的“延迟”和“级联错误”问题,促使研究者们寻求一个更彻底的解决方案。受益于(如Gemini)等大型多模态基础模型的出现,自动驾驶的范式演进到了第三阶段——构建完全统一的端到端网络。
这一阶段的核心思想是:在一个单一的、可微分的系统中,无缝整合感知、语言理解和动作生成。
- 典型架构: 如图4.1中的第三幅图所示,阶段二的“VLM”和“动作头”这两个分离的模块被合并成了一个单一的“VLMs”大模型。
- 工作流程: 不再有“中间表示”或“多阶段”处理。模型在一个单一的前向传播(single forward pass)中,就能将多模态的传感器输入(以及可选的文本指令)直接映射到最终的轨迹(Trajectory)或控制信号(Action)。
这个架构的代表作包括 EMMA、LMDrive、CarLLaVA 和 SimLingo。
其中,LMDrive 和 CarLLaVA 等模型为了实现这种直接映射,甚至在CARLA模拟器中进行微调,并引入了一种名为“行动构想”(Action Dreaming)的创新训练技术:
在训练时,模型会通过“想象”来学习。例如,在同一个驾驶场景下,研究者会给模型两个相反的指令,如“保持车道”和“向左变道”。模型被要求在这两个不同指令下“构想”出两条截然不同的未来轨迹。
这种“行动构想”技术,强制性地在模型的语言理解(“向左变道”)和其最终的轨迹输出(一条向左的曲线)之间建立了紧密的因果耦合。这使得模型真正学会了“听懂人话”并将其转化为精确的驾驶动作,而不是像阶段二那样仅仅是“翻译”指令。
核心局限性:
统一的端到端VLA模型虽然反应灵敏,在“感觉运动映射”(sensorimotor mapping)——即“所见即所动”的反应能力上表现出色,但一个新的瓶颈也随之出现。
这些模型擅长执行明确的、即时的指令,但它们在长时程规划(例如,需要提前几百米就规划好如何通过一个复杂的施工区)和提供细粒度的决策解释(例如,详细说明为什么它选择等待而不是抢行)方面,仍然存在明显困难。
它们就像是反应很快的“士兵”,但还不是能够深谋远虑的“指挥官”。这一局限性,直接催生了VLA的第四个、也是目前最前沿的进化阶段。
阶段四:推理增强的VLA模型 (Reasoning-Augmented VLA Models for AD)
这是VLA发展至今最新、最前沿的浪潮。它将VLM/LLM从一个“执行组件”彻底提升为整个自动驾驶系统的“决策核心”。
在这一阶段,系统不再仅仅是对传感器输入的“被动反应”,而是被赋予了“思考”的能力。模型在输出任何一个驾驶动作之前,都能够进行解释、预测和长时程的推理。
- 核心思想: 将“思维链”(Chain-of-Thought, CoT)与“行动”(Action)进行端到端的对齐。VLA必须在行动之前,先用语言(或内部Token)表达其决策路径,即“先想明白,再行动”。
- 典型架构: 如图4.1中的第四幅图所示,这一阶段的架构演变为“推理VLM与工具使用代理”(Reasoning VLMs & Tool-use Agents)。VLM不再只是一个模型,而是一个可以调用“工具”(如记忆库、规划器)的“智能代理”(Agent)。
这一阶段的代表作,如 ORION、Impromptu VLA 和 AutoVLA,真正展现了“可解释的大脑”是如何工作的:
- ORION:它引入了一个名为 QT-Former 的Transformer记忆模块,可以存储并聚合长达数分钟的观察和动作历史。它的LLM核心会负责“总结”这段历史,并同时输出下一段轨迹和一个相应的自然语言解释(例如:“因为我刚才在历史中看到了那辆车一直在变道,所以我现在选择拉开距离”)。
- ORION 的关键创新在于,它使用VLM生成一个抽象的“规划Token”来弥合“语义鸿沟”。这个“规划Token”既是VLM推理(CoT)的结果,又是下游生成模型(A模块)生成轨迹的“条件”(Condition),从而将推理和动作完美地对齐。
- Impromptu VLA:这个模型将“CoT与行动对齐”做到了极致。它的训练集不再是简单的(视频+动作),而是专门收集了8万个带有“专家驾驶推理步骤”标注的“犄角旮旯”(corner-case)场景。
- 例如,一份训练数据可能是:“(CoT:前方有救护车在闪灯,虽然是红灯,但交规允许避让)->(Action:缓慢压线绕行)”。
- 通过学习这种“先思考、后行动”的专家范例,Impromptu VLA 在零样本(Zero-shot)的车辆任务中达到了业界顶尖水平(SOTA)。
- AutoVLA:它则在一个单一的自回归Transformer中,天才般地融合了CoT推理和轨迹规划。
- AutoVLA 的创新之处在于将连续的路径点“令牌化”(Tokenize),变成了离散的“驾驶令牌”(Driving Tokens)。
- 这使得LLM可以在同一个输出序列中,既生成“文本令牌”(CoT推理),又生成“驾驶令牌”(轨迹规划)。例如,一个输出序列可能是:“[
CoT: 前方车辆刹车灯亮了,我需要减速][DrivingToken: 加速度-2.5][DrivingToken: 转向0.0] ...”。
第四阶段的VLA系统,预示了未来“可对话的自动驾驶汽车”的到来。你可以实时地质问它“你为什么要变道?”,它会立即用自然语言口头解释自己的行为,然而,这种强大的推理能力也带来了全新的挑战:
- 我们如何高效地索引和查询城市规模的记忆库(如 ORION 的 QT-Former)?
- 我们如何将LLM复杂的“思维链”推理(CoT)压缩在30Hz(约33毫秒)的实时控制循环内完成?
- 以及最关键的:我们如何对这种由“自然语言”调节的驾驶策略进行形式化的安全验证?
这些都是我们后续需要解决的问题,下一篇的会给大家介绍一下理想的VLA的具体实现方式。
...
#端到端时代下的自动驾驶感知

「端到端感知的AlexNet时刻」
不得不感叹的是,自动驾驶行业的技术的发展日新月异,技术热点已经从BEV迅速地转移到了端到端上。
不管如何看待端到端,最近一年端到端的火热已经切实影响到了这个行业的每一个人。
相比于在紧锣密鼓恶补各种模型知识的传统规划的工程师而言,大家似乎往往默认感知算法工程师在端到端时代是有优势的。
然而实际上,和很多朋友交流下来,我发现很多人还是做着和以前类似的工作,专注于某个感知task来提升端到端性能,忽略了端到端时代下真正的感知红利。
因此想在这里结合我们ICLR 2025的工作SSR,分享一些从感知角度出发的思考。
1 端到端的复兴
端到端并不是一项新的技术,甚至在自动驾驶技术方兴未艾时,很多人都寄希望于能用神经网络输入前视相机图像直接输出轨迹或是控制量。
然而,当时的方案不管是用CNN或是强化学习,都很难达到稳定安全的实车效果。最终通过不断的实车测试迭代,主流的方案才逐渐收敛到定位-感知-规划-控制这套系统架构下。
这套系统架构很好地分解了自动驾驶任务——感知模块将障碍物,车道线,红绿灯等等元素通过固定的接口传输到规划模块,再由规划模块根据上游信息输出轨迹给控制模块。
而随着BEV感知的快速发展和Transformer架构的不断成熟,端到端终于又带着全新的架构卷土重来,尤其以UniAD为代表,把这项经典技术又重新带回了大众视野内。各家纷纷掏出自己的一段式、两段式方案,只要是能把规划模块NN化,就可以说自己已经端了(端到端风评被害:D)。
2 端到端的感知红利
在传统的感知-规划框架里,感知的目的是全量化尽可能多的获取精确的场景感知信息,让规划模块能有完备的输入以得出好的规划结果。这是由于传统框架模块化的设计使得感知无法获得规划的需求,所以只能尽可能多的提取有效信息给下游模块使用。
目前主流的端到端方案也大都延续了这一思路,无非是把BBox,Map这些信息换成query来表征,把原来的各种感知任务当成auxiliary loss加进来做监督。当然还有那种把感知网络decode出来的感知信息,再重新encode又输入到规划网络的两段式方案。
但一个一直被忽略的问题是,端到端时代下依然还需要这么多人为定义的感知任务吗?或者说,真的还需要全量的感知信息吗?
对于感知而言,端到端最大的意义在于"Planning-Oriented",也就是从全知全量的感知到可以学习的的按需感知。我们以传统的检测任务打个比方,感知任务就相当于特征提取,轨迹生成则相当于特征处理。目前定义的各类感知任务就类似于SIFT这种手工特征,是人为定义的而非学习的。而端到端架构打通了从轨迹生成任务到感知模块之间的反向传播通路,为一种可学习而非人为设计的感知模块提供了可能。这正是端到端时代下感知最大的红利,也是目前主流端到端方法因循守旧所忽略掉的。扪心自问,这些人为定义的感知任务不恰恰就是感知模块自己的手工特征算子吗?
在端到端时代,不仅规划模块要革自己的命,感知模块也要有勇气革自己的命。也许端到端模型对于场景的理解方式和我们人类并不相同,基于人类先验知识定义的感知任务反而约束了端到端模型的上限。
很多最新的用大模型来做自动驾驶场景理解的工作,同样也能不依赖于这些感知任务来实现很好的场景理解。更何况,感知任务同样层出不穷,从2D检测3D检测再到Occ,我们也无法定义和穷举所有的有效任务。相反地,如果我们通过learning的方式在端到端模型中去除了这些人为定义的感知任务,得到的好处也是显而易见的。
一方面,这将极大减少模型对于标注资源和训练资源的需求,提高端到端模型的Scalability;另一方面,按需感知的高效推理速度能使得端到端模型更快地走向大规模量产部署,真正让端到端模型在数据闭环下乘上Scaling Law的东风。
3 Navigation-Guided Perception
在主流的端到端方案中,感知任务的结果不仅仅显式地作为上下游的中继,更为整体的模型性能起着重要作用。若要不依赖于这些感知任务,仍然能隐式地实现对于场景的有效理解,便成了一个非常有挑战的任务。
在一次讨论中,我们聊到为什么感知一定要做全量感知而非根据下游的需求来做局部感知。沿着这一思路,受人类驾驶员的注意力机制启发,我们提出了一种Navigation-Guided Perception的方案,也就是根据导航信息来引导感知注意力——人类驾驶员在开车的时候也不会做全量的感知,而是根据不同的驾驶意图去关注场景中的不同部分。但是如果模型直接用behavior来引导感知,就会陷入先有鸡还是先有蛋的怪圈。
而导航信息无论是以引导线或者command来表示,都可以看成是一种简化的behavior。在传统方案中,导航信息往往只被用作在规划模块中辅助最终轨迹的生成,但我们认为它同样可以引导感知信息的提取,类似于人类驾驶员会根据导航指引关注场景中的不同信息。

为了实现这一构想,我们设计了一个基于BEV特征的Scene TokenLearner(STL)模块,来实现对于场景特征的高效提取。我一直是一个BEV特征的支持者,这一点从我们之前的工作(DualBEV)可以看出,这是由于BEV特征集成了语义信息和几何信息以包含完备的场景信息。虽然task-specific query直接和图像交互可以在各个感知task上实现很好的效果,但是BEV特征仍然是我认为的感知乃至端到端的基石模块。
既然BEV特征包含着所有的场景信息,那么理论上我们就可以直接根据BEV特征来输出规划轨迹。然而,这种类似于BEV-Planner的做法无论在效率还是性能上都不能够满足我们的要求。因此我们继续沿用了我们在做DualBEV时候的思路,希望在BEV层面引入注意力机制,但与直接预测占据概率不同的是,我们的STL模块首先使用一个SE模块将导航信息引入到BEV特征中,再通过TokenLearner预测BEV注意力来将场景表征压缩为16个scene query。
而Planning Decoder只需要和这16个scene query做交互就可得到最后的规划轨迹。也就是说,我们发现在Navigation-Guided Perception模式下,仅仅只使用16个query就可以有效表征当前规划任务所需要的感知信息,这在原来的全量感知方案下是难以想象的——哪怕是号称Sparse的各种端到端方案,实际上也需要上百个query来表征感知到的场景信息。
通过这种对感知模块的极致压缩和高效利用,我们的端到端方案SSR不仅在训练效率和推理速度上都成倍地提高了,在性能上同样也大幅超越了各种SOTA的方案。

4 世界模型——隐式特征监督的新方向
为了使模型进一步摆脱对于人为定义的感知任务的依赖,我们诉诸自监督的方式,通过时序上的信息来增强对场景的理解能力。具体来说,我们引入了一个基于BEV特征的世界模型,在训练过程中通过预测未来帧的BEV特征和实际的未来帧特征做自监督,来增强scene query对于场景的理解能力。
这种方法在之前BEV检测的HoP,端到端任务的LAW中都是有出现的。但由于我们Navigation-Guided Perception的方案在每一帧上关注的区域是在不断变化的,就无法按照这些策略mask掉某一帧然后进行一一对应的scene query监督。
在经历了很多种失败的尝试后,我们最终提出了一种在sparse query上做轨迹规划,而在dense BEV上做世界模型的方案。由于世界模型只在训练时作为一种增强方式来提升性能,这种设计既能保证轨迹规划任务在推理时的高效,同样也能使得世界模型在自监督时具备一致性来实现模型的收敛。
我们目前的设计还仍然比较简单,并不像广泛定义下的世界模型那样直接囊括掉原始数据如图片、点云等的生成。但随着世界模型的研究越来越成熟,我们认为它终将会完全替代掉目前人定任务在感知模块的作用,成为隐式场景表征最可靠的监督方式。

5 端到端感知的AlexNet时刻
我们设计的SSR框架,最终仅用16个自监督可学习的query来作为场景的高效稀疏表征,代替了传统端到端方案里成百上千个人为定义并标注监督的query,使得感知模块终于从handcrafted perception task解脱出来。
在nuScenes和Carla上我们分别进行了开环和闭环实验, 对比了大量SOTA方案甚至包括arxiv上还未正式发表的工作,都实现了效率和性能上的大幅超越。


为了探寻导航信息如何指引scene query自适应的感知场景中与驾驶意图相关的区域,我们通过特征图的方式,对这些scene query进行了可视化。可以看出,在不同的导航指令下,左图中红色星号代表的scene query最高亮特征位置会关注到对应的场景中最可能跟自车发生交互的区域。
同样地,如果在右图中对同一个路口场景输入不同的导航指令,scene query同样会自适应的调整自己的注意力来关注到不同的感知目标。而对比左右图中居中的图像,我们也可以发现对于相同的导航指令,在不同场景下,这种可学习的感知模块依然能够很好的做出调整。更多的实验细节和讨论分析可以直接翻阅我们的论文,这里就不再赘述。

尽管我们的方案摒弃掉了过去往往用作可视化的显式感知结果,但并没有放弃端到端模型的可解释性。就如同传统检测任务放弃了角点、特征点的提取显示,但仍然可以用特征图等方式可视化出CNN的热力图。
我们今天给出的方案显然并不是端到端技术的终局,但我们希望它能够像AlexNet那样,成为可学习感知模块首次大幅超越人定感知模块的分界线,引导后续端到端任务的感知模块能够朝着可学习按需感知的方向大步地前进。
我们也同样认为,一个可学习的而非人为定义的感知模块,才是在端到端时代下感知工程师真正应该发力的方向。而沉迷于某个具体感知任务的指标得失,则迟早会像手工设计的特征提取算子一样被时代淘汰。
来源:https://zhuanlan.zhihu.com/p/14173403896
arxiv: Navigation-Guided Sparse Scene Representation for End-to-End Autonomous Driving
github: https://github.com/PeidongLi/SSR (开源啦)
...
#博世最新自动驾驶轨迹规划综述
博世一篇很重量级的轨迹规划综述,分享给大家。全面调研了自动驾驶中的轨迹规划基础模型,涵盖了37种近期的、基于基础模型的轨迹规划方法。本综述通过统一的分类法对这类方法进行全面梳理,批判性地评估其架构设计选择、方法学优势以及内在能力与局限性。
作为Tier 1一哥,博世今年明显在智驾上投入了更多资源。国内团队有做研究和量产的,近期也在全力冲击一段式端到端量产。
- 汇总仓库:https://github.com/fiveai/FMs-for-driving-trajectories
- 论文名称:Foundation Models for Trajectory Planning in Autonomous Driving: A Review of Progress and Open Challenges
- 论文链接:https://arxiv.org/abs/2512.00021
一、背景回顾
基础模型(FMs)是一类大规模模型,它们利用海量数据学习表征,这些表征可有效适配多种下游任务。根据处理的数据类型,这类模型通常有不同的称谓。仅处理语言数据的基础模型被称为大型语言模型(LLMs),例如BERT、GPT-2、ChatGPT和Qwen。而同时处理语言和视觉数据的模型则被视为视觉语言模型(VLMs),典型示例包括CLIP、Flamingo、LLaVA、GPT-4o、Intern-VL和Gemini。与通常输出语言数据的LLMs和VLMs不同,另有一类基础模型旨在根据语言输入生成图像,或根据语言与视觉联合输入生成图像。
这些模型通常作为backbone,通过微调构建适用于不同领域的专用模型,自动驾驶(AD)领域也不例外。本研究的核心是探究基础模型在自动驾驶中的实用性。但在深入探讨自动驾驶专用方法之前,一个自然会产生的问题是:“现成的基础模型(尤其是视觉语言模型)在未经过自动驾驶相关的显式训练或微调的情况下,能否理解驾驶场景?”为解答这一问题,我们向GPT-4o输入了三个复杂驾驶场景及相关问题,交互结果如图1所示。前两个示例涉及罕见驾驶场景,而GPT-4o的回答既准确又具洞察力。例如在第一个案例中,它不仅理解了场景,还就为何以及如何在该场景下谨慎驾驶提供了实用指导。同样,在最后一个示例中,模型识别出了具有误导性的提示,并给出了倡导安全驾驶的合理解释。因此,得益于其庞大的架构规模、训练流程以及海量的训练数据,这些模型已学到能够令人惊讶地良好理解驾驶场景的表征,使其成为构建自动驾驶专用解决方案的极具潜力的基础——这也是当前自动驾驶行业范式转变的关键驱动力。尽管如此,要在自动驾驶的边缘设备上高效、可靠地部署基础模型,仍需解决这类模型定制过程中的多个问题(例如思维链推理成本、模型规模、开放权重的可获取性、训练/推理效率、获取适用于微调的数据集等),这些都是该领域当前研究和设计选择的核心部分。通过本综述,我们将从整体视角阐述这些方面,重点突出研究进展、局限性以及开放研究方向。

范围与贡献
基础模型在自动驾驶中的应用方式多种多样。部分方法利用合成数据进行训练和评估,而生成自动驾驶数据的模型(如自动驾驶世界模型)可为此提供支持。一些方法通过视觉问答(VQA)任务增强基础模型在自动驾驶中的场景理解和推理能力。还有部分方法利用基础模型提升自动驾驶模型的特定能力,例如感知、预测或控制。在这一背景下,有一类方法利用基础模型生成文本化动作,通常是将场景分类为预定义的元动作(如“直行”和“减速”)。最后但同样重要的是,部分模型借助基础模型直接操控车辆,通常是通过轨迹规划实现。尽管上述各项能力对于开发稳健、准确的自动驾驶模型都至关重要,但轨迹规划可以说是驾驶过程中最核心的任务,其他能力均为这一主要目标提供辅助功能。因此,考虑到基础模型对这一关键任务的深远影响,本论文将重点聚焦于基础模型如何助力自动驾驶的轨迹规划模型。
实际上,基础模型可通过多种方式增强轨迹规划能力,如图2所示。一种常见方法是对现有基础模型进行少量架构修改,然后在任务特定数据集上对其进行微调。这种微调可简化为训练模型直接从传感器数据中输出轨迹(见图2(a))。此外,部分模型还利用思维链(CoT)推理技术——该技术可帮助大型语言模型将问题分解为多个步骤,从而提升推理能力。图2(b)展示了其常见应用:基础模型首先以关键目标和元动作的形式利用思维链,随后再生成最终轨迹。视觉语言模型具备语言模态这一特性,也启发了多种方法利用该能力实现与轨迹规划模型的语言和/或动作交互。如图2(c)所示,语言交互能力可解释模型行为的背后逻辑,增强用户的信任感。与之不同,动作交互能力通过执行用户的驾驶指令提供驾驶辅助(参见图2(d)),这与现有的视觉-语言-动作模型(VLA)类似。此外,还有一类方法通过在训练和/或推理过程中转移知识,让基础模型为现有的轨迹规划系统提供指导。图2(e)通过一个示例展示了这类方法:视觉语言模型(本案例中为GPT-4o)输出场景描述、自动驾驶车辆需关注的关键目标以及元动作。

尽管如前所述,已有大量研究利用基础模型优化自动驾驶中的轨迹规划,但该领域仍缺乏对已取得进展的整体理解。现有方法种类繁杂、异质性强,且其底层架构、数据集和训练流程差异显著,对性能产生极大影响,这使得区分不同方法的核心差异变得愈发困难。本研究旨在通过系统分析和比较当前技术,为这一分散的研究领域建立秩序,重点突出影响方法有效性的架构设计选择和能力,并提供统一视角以指导基础模型在自动驾驶轨迹规划中应用的进一步发展。因此,本研究的主要贡献如下:
- 我们提出了一套利用基础模型进行自动驾驶轨迹规划的方法分类体系,并基于该分类法对37种现有方法进行了系统分析²。本研究是对这一快速发展领域进行整理、解读和统一的综合性尝试——该领域已涌现出多种异质性方法,但缺乏明确的基准测试和对其差异的深入理解。我们相信,本研究将为该领域的系统性发展奠定结构化基础。
- 除了为如何定制和微调基础模型以适应轨迹规划,以及如何为不同用例整理数据集提供实用指导外,我们还评估了这些方法在代码和数据开放性方面的表现,为从业者和研究人员提供有关可复现性和复用性的实用参考。我们还从效率、稳健性、评估基准和仿真到现实迁移等多个角度,概述了未来的关键挑战和开放研究问题。
与先前综述的比较
考虑到已有多篇聚焦自动驾驶的综述类文献,我们在此说明本研究与现有综述的主要差异。部分现有综述聚焦于自动驾驶领域,通常旨在呈现和讨论发表时的技术前沿。其中一些综述的研究范围更窄,例如聚焦于端到端(E2E)可训练模型、基于强化学习的模型、基于模仿学习的方法或现有的自动驾驶数据集。此外,部分综述并未聚焦于轨迹规划,而是关注自动驾驶的单一辅助任务,例如感知、占用预测或运动规划。这些综述虽各有其价值,但并未特别关注基础模型在轨迹规划中的应用方式。因此,本综述与这类综述形成互补。
由于基础模型在包括自动驾驶在内的多个领域得到广泛应用,已有少数综述探讨了这些模型如何助力自动驾驶。尽管这些研究涉及基础模型在自动驾驶中的应用,但它们的研究范围比本研究更广泛。具体而言,这些研究旨在从感知、数据生成、场景理解以及轨迹规划等多个角度全面覆盖基础模型的应用价值。因此,它们对轨迹规划的讨论较为有限,而本研究则专门聚焦于轨迹规划,能够提供更深入、全面的分析。此外本研究还将利用基础模型进行知识转移的方法纳入研究范围,针对这一更广泛的模型集合提出了分层分类法,深入探讨了视觉语言模型适配轨迹规划的设计选择,并详细阐述了对研究人员和从业者具有实用价值的方法开放性问题。

二、分层分类体系
本章将提出一套分类体系,用于系统性地研究利用基础模型(FMs)的轨迹规划方法。从整体上看,这些方法可分为两大主类别:为轨迹规划定制的基础模型与指导轨迹规划的基础模型。但这两大主类别下还包含多个子类别,最终形成如图4所示的分层分类体系。具体而言,分类树中的8个叶节点分别对应图5中的数学表述形式。下文将对各类别展开详细论述。


为轨迹规划定制的基础模型
此类方法的核心特征是:通过部分或完全利用现有的预训练基础模型,并对其进行定制与微调,以适配自动驾驶(AD)的轨迹规划任务。因此,这类方法本质上是构建了直接用于自动驾驶场景的基础模型。考虑到基础模型的自回归生成特性,以及“通常先输出文本、再预测轨迹”的惯例,此类方法的数学表述可写为:
其中,代表微调后的基础模型。从设计逻辑来看,这类方法的优势在于能直接利用基础模型的海量通用知识,并通过微调将其适配到自动驾驶任务中——这是传统轨迹规划方法无法比拟的。此外,基础模型的选择还能为这类方法赋予新能力:例如,若选用基于语言的基础模型,在推理阶段除完成轨迹规划核心任务外,还可实现“语言交互”“动作交互”等人机交互功能。
本文从现有文献中筛选出22种属于此类的方法,并根据其功能特征进一步划分为两个亚类:
仅专注于轨迹规划的模型:这类模型要么无文本提示(),要么使用固定文本提示。在后一种情况下,文本提示的唯一作用是触发模型输出预期结果(例如固定提示“规划轨迹”)。由于语言输入无变异性,轨迹的生成主要依赖于输入观测。此外,推理阶段仅通过思维链(CoT)推理提升轨迹精度的方法,也归为此类。类似地,这类方法可能使用“单一固定提示”或“预定义顺序的多轮固定提示”,以利用基础模型的推理能力。不过,这些提示的设计方式对理解模型决策的影响因素至关重要,因此本文根据“是否使用及如何使用思维链”,将此类方法进一步细分为三个子类:
- 无思维链(No CoT):即无文本输出(),轨迹直接由观测生成,公式为(见图5(a))。图2(a)即为这类方法的示例。
- 文本输出作为思维链(Text as CoT):文本输出由观测生成(),轨迹则基于观测与文本共同生成()(见图5(b))。图2(b)可作为这类方法的示例。
- 初始轨迹预测作为思维链(Initial Trajectory as CoT):即先预测初始轨迹,再结合观测、文本与初始轨迹生成最终轨迹,公式为(参见图5(c))。这类模型会先输出初始轨迹,再对其进行优化以得到最终轨迹;在生成或的过程中,仍可利用实现思维链推理。
具备额外能力的模型:除轨迹规划核心功能外,这类模型还利用基础模型的语言理解能力,新增了“语言交互”和/或“动作交互”功能。下文将其进一步细分为三个子类:
- 语言交互能力(Language Interaction Capability):文本输出由观测与文本提示共同生成()(见图5(d))。这类语言能力主要包括“问答任务”或“场景描述任务”,目的通常是向用户告知周围环境信息或模型拟执行的动作(如图2(c)所示);同时,该能力也可作为理解模型决策过程的工具——帮助研究者解释模型行为、调试模型输出,或增强用户对模型的信任。这类模型的轨迹规划,可根据是否使用思维链推理,对应图5(a)-(c)中的任意一种形式。
- 动作交互能力(Action Interaction Capability):文本提示可直接触发模型对规划轨迹的调整(见图5(e))。例如,输入提示“在下一个路口左转”,模型会据此重新规划轨迹。这类“指令型提示”要求模型做出特定行为,且形式具有多样性(例如“超越前方车辆”“在咖啡店前靠边停车”“减速”等)。需要注意的是,这类提示与“导航指令”(如“右转”“直行”等预定义基础指令)不同——导航指令仅包含有限的固定命令,因此仅支持导航交互的模型不归属此类。此外,除直接影响动作的指令外,其他类型的指令也可能产生间接影响:例如,提示“注意横穿马路的行人”属于“警示型指令”,而“撞向前方车辆”则属于“误导性指令”(模型需拒绝此类指令并规划安全轨迹)。
- 语言与动作交互能力(Language & Action Interaction Capabilities):部分模型可同时具备上述两种交互能力,如图5(f)所示。
指导轨迹规划的基础模型
这类方法的设计灵感源于经典的知识蒸馏研究:它们不构建驾驶专用的基础模型,而是大多利用“现成基础模型”(off-the-shelf FMs),对现有的自动驾驶轨迹规划模型进行性能提升。从整体视角来看,此类方法的数学表述可写为:
其中,代表从基础模型转移到对应自动驾驶模型的知识。需要注意的是,此处的既可以是模块化方法(见图3(a),基础模型可在任意层级助力轨迹规划),也可以是端到端自动驾驶模型(E2E-AD model)(见图3(b))。
本文从现有文献中筛选出15种属于此类的方法,并根据“推理阶段是否需要”(即是否需要基础模型参与推理),将其进一步划分为两个亚类(如图5(g)所示):
仅在训练阶段进行知识蒸馏的模型:这类方法仅在自动驾驶模型的训练阶段,利用基础模型进行知识蒸馏。例如,可通过向视觉语言模型(VLM)输入文本与传感器数据,获取“元动作”等结构化输出,再通过为自动驾驶模型附加“元动作预测模块”,将基础模型的知识蒸馏到自动驾驶模型中(类似VLM-AD的设计)。在这类方法中,推理阶段无需基础模型参与,对应公式(2)中的情况。因此,推理阶段模型的预测仅依赖于观测,即。这种设计的优势在于:既能利用基础模型的知识提升性能,又能保持自动驾驶模型的推理效率(无需在推理时调用基础模型)。
在推理阶段进行知识转移的模型:这类方法不仅在训练阶段利用基础模型,还在推理阶段调用基础模型,以更充分地利用基础模型的知识。这种情况对应公式(2)中的情况:通常是“场景描述”(如场景中的目标物体等感知类知识)或“规划决策”(如基础模型输出的轨迹、元动作等)。无论是哪种情况,既可以是基础模型的内部表征,也可以是基础模型的直接输出(若为纯文本输出,则通常需额外的文本编码器对其进行编码,再传递给自动驾驶模型)。不过,由于推理阶段需调用基础模型,这类方法的推理计算量通常大于前一类方法。
三、为轨迹规划定制的基础模型
本章将深入探讨为自动驾驶轨迹规划定制的基础模型(FMs)的设计与开发细节。首先阐述“为轨迹规划微调基础模型前需关注的核心要素”;随后,分别针对前文分类体系下的两个亚类方法(仅专注于轨迹规划的模型、具备额外能力的模型)展开具体论述。
如何为轨迹规划微调基础模型
数据整理(Data Curation):为基础模型适配轨迹规划任务时,所需整理的数据结构主要取决于模型的预期用例,如图6(a)所示。仅用于轨迹规划的数据集,其核心构成是“观测-轨迹”数据对,即。如前所述,观测通常包含传感器数据、自车状态(ego status)和路线指示(route indicator)的子集。

在需依赖推理能力的复杂场景中,可利用基础模型的思维链(CoT)推理能力提升场景理解效果。为此,需在驾驶数据集的每个数据元组中加入“用于触发思维链推理的文本”,使数据集结构变为。不过,若思维链以“初始轨迹”形式存在,则无需提前整理并存储包含的数据集——该初始轨迹可由模型实时生成。
上述驾驶数据集还可包含固定的输入提示(例如图2(b)中的提示“规划轨迹”)。尽管这类数据集可满足基础轨迹规划需求,但若模型需具备“语言交互”或“动作交互”能力,则需根据具体用例补充额外数据元组:
- 语言交互能力:数据集需新增元组,其中与是基于观测的“问答对”。若模型需在回答问题的同时生成轨迹,则数据元组需扩展为,此时可作为思维链推理依据。
- 动作交互能力:模型需根据用户指令规划轨迹,因此数据元组通常为——其中是用户指令,是与该指令对应的轨迹。此外,也可选择性加入,用于在执行指令时辅助思维链推理。
模型设计(Model Design):在设计模型架构时,两类主流思路如下:
- 直接使用现成视觉语言模型(VLMs):部分方法采用现成VLMs,其优势在于可直接利用预训练于海量数据的模型参数,实现参数的联合初始化。
- 组合视觉编码器与大型语言模型(LLMs):另一类方法选择将偏好的视觉编码器(如ViT)与LLM结合,并通过随机初始化的视觉适配器(vision adapter) 连接两者。
上述两种思路均遵循典型的VLM架构(见图3(c)),核心差异在于是否需自定义视觉适配器。对于“组合视觉编码器与LLM”的思路,视觉适配器的设计至关重要,如图6(b)所示,主要有三种设计方案:
- 文本接口(Text Interface):视觉编码器直接输出感知和/或预测信息(如场景中目标物体的位置、地图元素等),该信息以文本形式传递给LLM。此类设计的模型无法进行端到端训练。
- 线性层或多层感知机(MLP):将视觉编码器输出的所有视觉token投影到LLM的输入空间。
- Queryformer:与线性层或MLP不同,Queryformer通过“随机初始化的 latent 表征”与视觉编码器输出token之间的交叉注意力,选择性地投影最具价值的表征集合。Omni-Q采用了这种方案。
此外,引入自定义模块可赋予模型“现成基础模型所不具备的归纳偏置”。例如,现成VLMs通常未在3D感知任务或视频数据上进行预训练,因此部分方法设计了自定义模块,以让模型捕捉VLMs中缺失的3D或时序线索。
轨迹表征(Trajectory Representation):为自动驾驶定制基础模型时,轨迹的表征方式是另一关键问题——这一选择可能直接影响模型设计。图6(c)展示了常见的轨迹表征方式,具体如下:
- 轨迹作为文本(Trajectory as Text):通过LLM的标准自回归(AR)文本生成功能实现。例如,假设模型每次生成一个字符,且某2D轨迹点为“1.54, 0.21”,则该点需通过自回归方式依次生成字符“1”“.”“5”“4”“,”“0”“.”“2”“1”,如图6(c)(左)所示。此类方法无需修改tokenizer或模型架构,但生成单个轨迹点需多次通过LLM,会增加推理时间。
- 轨迹作为动作token(Trajectory as Action Tokens):不通过多轮生成单个2D点,而是将动作空间离散化,并将这些离散动作作为“动作token”纳入LLM的词汇表。例如,可通过网格离散化2D鸟瞰图(BEV)空间,将网格点作为动作token——具体可通过“将词汇表中低频token映射为2D点”实现
- 轨迹作为数值集合(Trajectory as a Set of Numbers):通常通过附加“规划头(planning head)”单次生成。具体有两种变体:其一,部分方法先通过“可学习嵌入(learned embeddings)”对观测(及可选文本输入)进行注意力建模,再由规划头解码为轨迹;其二,另一类方法不引入可学习嵌入,直接利用LLM最后一层的表征通过规划头生成轨迹。无论哪种变体,均需为LLM附加规划头——文献中已探索的规划头类型包括MLP、变分自编码器、扩散模型(等。
模型训练(Model Training):基础模型的微调通常通过“单阶段”或“多阶段”完成,每个阶段通常针对特定模块子集。例如,参考LLaVA风格的训练流程(如图6(d)所示),可先冻结视觉编码器与LLM,仅训练视觉适配器(尤其当视觉适配器为随机初始化参数时);待适配器训练完成后,再对所有模型参数或部分参数进行微调,以适配目标任务。
为清晰呈现现有方法的微调策略,本文定义以下符号,用于表示“训练过程中(多阶段训练则涵盖所有阶段)模块参数的变化情况”:
- ⊗:训练期间模块参数完全冻结。
- △:对模块进行类似LoRA的方法微调——假设新任务所需的适配可通过低秩更新实现,该方法效率高但会限制模型的适配能力。
- □:对模块所有参数进行标准微调——可充分利用模块的适配能力,但所需资源多于LoRA。
- ○:训练模块时,要么随机初始化参数(如引入自定义模块时),要么从“仅在领域特定数据上预训练的模型”初始化(如仅在nuScenes上预训练的视觉编码器)。
基于上述符号,表1汇总了本节所涵盖的22种方法的核心设计选择。

仅专注于轨迹规划的模型
根据图4所示的分类体系,本节将分亚类讨论此类模型。表2为每个亚类提供了代表性方法示例。

无思维链推理的模型:CarLLaVA是较早采用VLM实现轨迹规划的方法之一,其基于LLaVA-NeXT构建,将ViT视觉编码器与Tiny-LlamaLLM结合。该模型以“前视图像、当前自车速度、两个GPS目标点(作为路线指示)”为输入,输出两类结果:(1)20个等距路径点(间距1米,与时间无关,用于控制转向);(2)10个等时间间隔的速度点(间隔0.25秒,用于控制油门与刹车)。这些输出通过MLP规划头单次生成,符合图6(c)(右)的设计。需注意的是,与其他方法不同,CarLLaVA中的Tiny-Llama是从头开始训练的。2024年,该模型在约300万张图像上训练后,赢得了CARLA 2.0挑战赛——这是一项基于闭环模拟器的驾驶竞赛。
DriveGPT4-v2与CarLLaVA类似,以“前视、前左、前右三个摄像头视图”为输入,将Siglip-ViT与Qwen结合,直接预测目标速度与转向角控制信号。此外,该模型还受监督预测轨迹与等距路线点(类似CarLLaVA的路径点)。与CarLLaVA不同的是,DriveGPT4-v2利用“具备特权信息(如场景中目标物体、潜在危险信息)的专家模型”扩充训练数据集,这种数据扩充对驾驶性能有显著提升。
上述两种方法均无系统提示,而V2X-VLM则使用固定提示“请预测未来45个时间步的自车位置”。该模型基于Florence-2(构建,核心特点是专门利用“环境中基础设施的外部摄像头”提升性能。
文本输出作为思维链推理的模型:思维链(CoT)推理通常是基础模型的一种提示策略,可帮助模型将问题分解为多步推理——具体可通过在输入提示前附加“类似问题的分步解决方案”(作为推理演示)实现;此外,研究发现仅在提示后追加“让我们逐步思考(Let’s think step by step)”也能有效提升推理效果,即“零样本思维链(zero-shot CoT)”。这些优化的提示策略可让基础模型分步输出结果,从而提升算术推理等任务的性能。
类似地,为轨迹规划定制的基础模型也会利用思维链推理提升驾驶性能,但方式略有不同:这类方法会通过微调让基础模型分步输出结果,而非在推理时修改输入提示;且此时的提示通常是固定的(例如表2中S4-Driver使用的“我的未来轨迹是什么?”),并可能包含多步指令。通过微调,文本输出会包含“预定义的解释内容”,以提升轨迹规划的精度——的范围差异显著,既可以是单一元动作,也可以是“场景描述+智能体行为分析”的综合内容(详见图2(b)的综合示例)。
初始轨迹预测作为思维链推理的模型:与“仅用作为思维链”不同,少数方法会利用评估或优化“模型先预测的初始轨迹”;这类方法也可进一步利用提升或最终轨迹的精度。
Agent-driver是较早的此类方法,本质上是在GPT-Driver的基础上,扩展了“多步思维链”——包含“关键物体(及其潜在影响)、元动作()、初始轨迹”。该方法还利用感知模块预测的“占用图(occupancy map)”,检查是否存在碰撞:若存在碰撞,则将修正为;否则直接将作为最终轨迹。与GPT-Driver类似,Agent-driver基于GPT-3.5构建,采用“文本接口”作为视觉适配器,因此无法进行端到端训练。
Solve-VLM则设计为“始终通过两步生成最终轨迹(轨迹型思维链)”:首先从“预定义轨迹集合”中预测一条粗粒度初始轨迹,再将其优化为更精细的最终轨迹。与FeD不同的是,该模型不明确输出“碰撞或违规”等解释性内容。Solve-VLM采用“自定义VLM”架构:将EVA-02与基于LLaVA的LLM通过“自研的SQ-Former”结合,在将视觉特征传递给LLM前,先融入3D表征。此外,由于Solve还涉及向其他自动驾驶模型转移知识。
具备额外能力的模型
本节将讨论“除轨迹规划外,还具备语言或动作交互能力”的模型³。
具备语言交互能力的模型:显然,“通过语言交互”是LLM的语言接口所赋予的显著特性。表3汇总了具备语言交互能力的方法,包括其训练数据集、训练方式及语言评估相关特征。下文将重点总结此类方法在“训练数据集构建”与“评估”方面的关键发现。
语言交互能力数据集:具备语言交互能力的模型通常需要“视觉问答(VQA)数据对”用于训练——这类数据并非nuScenes等标准驾驶数据集的组成部分。因此,在设计必要的问题模板后,需根据数据集类型,采用以下三种主要方式进行标注:
- 仿真数据集:通常基于CARLA构建,可利用“仿真状态(包含智能体速度与位置、天气、路口、交通灯等信息)”填充预定义的答案模板。DriveLM-CARLA与SimLingo数据集均采用这种方式,其优势是实现简单且语言标注精度高。
- 真实世界数据集:通常无法获取场景的详细信息,因此部分方法依赖人工标注,例如DriveLM-nuScenes。这种方式标注精度高,但标注大规模数据集需耗费大量资源。
- 基础模型辅助标注:GPT-4等基础模型常被用于生成语言标签。具体而言,将“问题模板”与“系统提示、传感器数据”一同输入基础模型,即可获取答案。这种方式可同时用于仿真数据集(Fu et al., 2025a)与真实世界数据集的标注,效率高,但需人工检查以确保标注质量。
构建VQA数据集后,部分方法会利用LLM扩充问题或答案,以提升语言多样性。此外,不同方法的训练数据集规模差异显著:例如,DriveGPT4的训练数据包含5.6万个VQA样本,而Orion的训练数据则包含211万个VQA样本。
这些VQA样本通常聚焦于“感知、预测、规划”等子任务——这些子任务是模型实现良好驾驶性能的基础。DriveLM与OmniDrive是目前主流的VQA基准测试数据集:
- DriveLM数据集包含针对这些子任务的VQA对,例如“自车到达下一个可能位置时,应首先关注哪个物体?(What object should the ego vehicle notice first when the ego vehicle is getting to the next possible location?)”;
- OmniDrive的特色是“反事实VQA”,例如“若我决定加速并左转,可能会产生什么后果?(If I decide to accelerate and make a left turn, what could be the consequences?)”——这类反事实问题通过“基于元动作(如加速、左转)的模板”设计,答案则通过“规则化检查清单+GPT-4”联合生成。
语言交互能力评估:为评估生成文本的质量,此类方法通常采用自然语言处理(NLP)领域的经典指标——通过对比“机器生成文本”与“参考文本”进行评估。这些指标包括:
- BLEU、ROUGE、METEOR;
- 专为图像描述设计的指标:CIDEr、SPICE。
现有方法讨论:下文将重点阐述“具备语言交互能力的轨迹规划方法”的核心特征,其模型设计细节与语言交互能力细节可分别参考表1与表3。

DriveGPT4的目标是“在训练轨迹规划模型的同时,保留LLM的原有能力”。为实现这一目标,研究发现“在5.6万个驾驶相关VQA样本之外,保留非自动驾驶相关VQA样本”对训练至关重要。该模型基于“自定义VLM”构建(将视频编码器与Llama2结合),训练流程分为“视觉-语言对齐”与“模型微调”两阶段,符合图6(d)(右)的设计。
DriveLM-Agent是DriveLM基准测试的基线模型,通过“单阶段微调BLIP-2”适配基准测试的VQA任务。
Emma基于Gemini VLM构建,其预训练阶段使用“20.3万小时驾驶场景数据”;预训练完成后,再在特定领域(如nuScenes数据集)上微调以实现适配。与其他方法不同,Emma的语言能力仅限于“预定义感知任务相关的问题”(包括目标检测、道路图估计、道路堵塞检测),而非对话式问答。
OpenDriveVLA与DiMA-MLLM的独特之处在于:采用BevFormer作为视觉编码器,以有效提取场景的3D表征——这一设计旨在解决CLIP或EVA等“基于基础模型的视觉编码器”的局限性。但需注意的是,BevFormer未在海量数据上预训练,因此与上述视觉编码器相比可能存在劣势。
具备动作交互能力的模型:本节将综述“可根据用户指令规划轨迹”的模型。表4汇总了这类方法的核心特征,包括训练数据集、训练方式及评估指标。
动作交互能力数据集:分类体系(图4)中此类别的三种方法(DriveMLM、LMDrive、SimLingo)均在“基于CARLA模拟器构建的合成数据集”上进行训练与测试。这一选择的原因在于:对合成数据而言,“指令-动作”对的标注更简单(可直接利用模拟器状态获取场景的全面信息)。
与本文讨论的其他方法不同,DriveMLM与LMDrive均同时依赖激光雷达(lidar)与摄像头数据。此外,LMDrive的特色功能是“支持警示型指令(notice instructions)”(如“注意前方隧道(watch the tunnel coming up)”)。
此类模型还需具备“规避误导性指令”的机制——误导性指令可能导致不安全后果。理想情况下,模型应在识别出误导性指令后拒绝执行,并规划安全轨迹。LMDrive与SimLingo均已集成这一关键功能。
现有方法讨论:表4汇总了具备动作交互能力的方法,下文将展开具体说明:

DriveMLM将EVA与GDMAE分别作为视觉编码器与激光雷达编码器,通过Q-Former模块与Llama LLM结合。该模型受监督输出“四类预定义油门控制指令({保持、加速、减速、停车})”与“五类转向动作({跟随、左转、右转、左借道、右借道})”。
LMDrive的输入包含“多摄像头与激光雷达数据”,通过“多模态视觉编码器(包含ResNet与PointPillars)”处理;该编码器首先在“仅前视图像的感知任务”上预训练,随后与Llama结合,通过端到端训练适配轨迹规划任务。与其他方法不同,LMDrive在训练期间保持LLM参数冻结;此外,该模型还会预测“指令完成标志”——用于判断用户指令是否已执行,是目前唯一具备该功能的方法。
SimLingo基于Mini-InternVL VLM构建,是CarLLaVA的扩展模型。与其他方法不同,SimLingo同时具备“语言交互”与“动作交互”能力,且支持“思维链推理”(关于思维链推理的推理时间-精度权衡)。该模型通过“单阶段训练”适配这些功能,训练数据集包含各类功能对应的样本。其“指令遵循功能”(称为“动作模拟(action dreaming)”)旨在让预测轨迹与自然语言指令对齐;研究表明,“动作模拟”对驾驶性能的提升效果,优于纯语言任务(VQA与思维链推理)。此外,SimLingo还关注“数据集重采样”——通过为“预定义驾驶特征”构建数据桶(data buckets),并为每个数据桶分配不同采样比例,优化数据分布。
四、指导轨迹规划的基础模型
利用基础模型(FMs)实现轨迹规划的另一种方式是:采用自动驾驶(AD)领域的现有方法(如模块化方法或端到端方法,见图3(a,b)),并将选定基础模型的知识转移到该方法中——转移过程既可仅发生在训练阶段,也可同时发生在训练与推理阶段。这类方法的核心差异在于“是否在推理阶段使用基础模型”:若需在推理阶段使用,则必然会增加计算成本与内存需求。基于此,结合本文分类体系(参见图4)讨论“仅在训练阶段进行知识蒸馏的模型”和“需在推理阶段也调用基础模型的方法”。
仅在训练阶段进行知识蒸馏的模型
这类方法仅在训练阶段利用基础模型进行知识蒸馏,推理阶段无需调用基础模型。图7汇总了此类方法的现有方案。
作为早期代表性方法之一,VLP的目标是“将端到端自动驾驶模型(E2E-AD model)的表征与现成的CLIP表征对齐”。为获取CLIP表征,该方法仅使用CLIP的文本编码器:具体而言,向文本编码器输入两类提示:(1)“智能体与地图元素描述”(如语义类别、位置等);(2)“规划提示”(如“自动驾驶车辆在城区行驶,当前保持直行,规划轨迹为”)。随后,如图7(上)所示,通过对比学习将这些表征分两层蒸馏到端到端自动驾驶模型中:“智能体与地图元素表征”被蒸馏到模型的视觉特征中,而“规划提示表征”则作为规划模块的输入,融入到模型的自车查询(ego query)中。

与VLP类似,VLM-AD同样保持基础模型参数冻结,但采用的是向视觉语言模型(VLM)——GPT-4o——输入提示的方式:(1)“含特权信息的前视图像”(图像中用红线标注自车未来轨迹,见图7(右));(2)“6个不同问题”(用于从VLM获取元动作及其推理过程)。随后,通过独热编码(one-hot encoding)与CLIP文本编码器对这些响应进行结构化处理,并在端到端自动驾驶模型后附加一个适配层(adapter layer),使其能够预测该结构化输出;最终,采用交叉熵损失(cross-entropy loss)实现知识蒸馏。
与上述方法不同,DiMA与Solve通过“联合训练端到端自动驾驶模型与大型语言模型(LLM)”实现知识蒸馏。具体而言,如图7(下)所示,两种方法均将端到端自动驾驶模型的表征传递给LLaVA-v1.5的LLM,使LLM能够基于这些表征预测轨迹与文本输出。其中,Solve仅传递“感知后的表征”,而DiMA则追求更全面的蒸馏:(1)将鸟瞰图(BEV)特征、智能体/地图表征、自车查询均传递给LLM(图7(下)中从LLM指向蓝色接口的红色箭头);(2)引入蒸馏损失,使LLM表征与端到端自动驾驶模型规划模块的表征对齐(图7(下)中从LLM指向规划模块的红色箭头)。此外,DiMA还加入了“掩码BEV token重建”等辅助任务,以实现更有效的表征学习。两种方法均采用LoRA微调LLM,以适配轨迹规划任务。
在推理阶段进行知识转移的模型
与前一节的方法不同,本节讨论的方法不仅在训练阶段利用基础模型,还在推理阶段调用基础模型,以更充分地转移基础模型的知识。表5汇总了这类方法的核心特征,包括“输入基础模型的传感器数据”“所用基础模型类型”“推理阶段从基础模型转移的知识(Z)”“Z的编码方式”及“Z在自动驾驶模型中的融入位置”。下文将根据“转移知识的类型”(即场景描述、规划决策,或两者兼具),对这类方法展开详细阐述。
转移场景描述的方法:这类方法旨在转移基础模型输出的“场景描述”(例如“本车道内有一辆黑色货车,正远离自车行驶”,引自VLM-E2E。DME-Driver采用类似思路,但转移的知识除“场景描述”外,还包括“驾驶员视线关注方向”与“驾驶员动作逻辑”(例如“因存在行人而减速”)。
转移规划决策的方法:这类方法向自动驾驶模型转移基础模型输出的“规划决策”(通常以元动作或轨迹形式存在)。例如,Senna-E2E通过“专门微调视觉语言模型”实现元动作转移:模型采用多阶段微调策略,逐步使视觉语言模型适配规划任务——首先在“驾驶场景视觉问答(VQA)”任务上微调视觉语言模型,随后在“元动作分类”任务上进行规划微调;视觉语言模型训练完成后保持参数冻结,其输出的元动作通过“可学习嵌入层”转换为嵌入向量;为利用视觉语言模型的知识,自动驾驶模型(VADv2)的规划查询(planning query)会关注该元动作嵌入向量。
Diff-VLA同样依赖Senna-VLM,但存在两处关键差异:第一,元动作不再通过“可学习嵌入层”编码,而是采用独热编码(one-hot encoding)后直接输入规划模块;第二,将VADv2的规划器替换为“扩散规划器(diffusion planner)”,该规划器会依次基于“元动作编码、BEV特征、地图、目标查询”生成轨迹。
同时转移场景描述与规划决策的方法:部分方法会同时转移“场景描述”与“规划决策”两类知识。VDT-Auto通过“在驾驶相关VQA任务上微调Qwen2-VL”,使其输出“目标物体描述”“元动作”与“轨迹”;视觉语言模型参数冻结后,将其对应的表征转移到自动驾驶模型中;具体而言,这些嵌入向量会输入到“基于扩散模型的规划器”,该规划器会基于“嵌入向量与视觉特征”优化轨迹。
FasionAD++则引导视觉语言模型输出两类信息:(1)“规划状态”(包含“是否存在交通灯、障碍物、路口”等二进制变量);(2)“元动作”。其中,“规划状态”通过适配层更新BEV特征、智能体查询、地图查询与自车查询,而“元动作”仅融入到自车特征中——这一设计实现了“多层级知识转移”。此外,FasionAD++还考虑了视觉语言模型的低效性:仅当自动驾驶模型的不确定性超过阈值时,才调用视觉语言模型。
与本节讨论的其他方法不同,AsyncDriver将LLM知识转移到“模块化方法的规划模块”中(见图3(a))。具体而言,该方法通过“附加辅助对齐模块”微调LLM,使其输出自动驾驶相关的有用信息;基于LLM的输出,辅助对齐模块会预测“交通灯状态、相邻车道占用情况”等感知特征,以及“车道变更、速度决策”等影响轨迹规划的特征;LLM的 latent 编码(作为辅助对齐模块的输入)会通过“特征适配层”传递到模块化规划器中。为实现LLM与模块化规划器的对齐,两者会在nuPlan数据集上联合训练。推理阶段,LLM的 latent 编码会“异步传递”到模块化规划器中以优化规划决策,且在间隔期间会保留“上一次的高层指令特征”——这种“实时规划器与LLM规划器的异步连接”,在决策质量与推理速度之间实现了平衡。
五、现有方法的数据集与代码开放性如何?
开放的模型与数据集对推动研究进展、加速实际部署至关重要。它们能让研究人员在现有成果的基础上快速突破技术前沿,也能让从业者无需花费大量时间复现现有工作即可构建高性能实际系统;同时,透明度可揭示方法的优势与不足,从而增强用户信任;此外,开源资源还能降低经济门槛,促进低收入地区的技术应用。鉴于开放性的重要性,本文将对所研究的37种自动驾驶轨迹规划方法的开放性水平进行阐述。
我们将模型构建划分为训练、评估、部署三个阶段,并据此对“数据”与“代码”两类资产的开放性进行评分。资产评分越高,代表开放性越强。由于本文研究的是“利用基础模型的轨迹规划方法”,此类方法的资产构成需额外补充关键要素,如图8(a)所示:具体而言,我们在训练阶段新增“预训练基础模型权重”作为数据资产;同时,将“驾驶数据集”与“语言/动作数据集”分开考量——这是因为语言标注通常源于现有驾驶数据集,且同一驾驶数据集可能对应多种语言标注(例如nuScenes数据集衍生出nuCaption、nuX、nuScenes-QA、DriveLM-nuScenes等多种语言数据集)。

对于开放性水平,我们将每种资产的评分设定为1-3分,以针对性地为研究与商业应用提供参考信息(见图8(b)),具体定义如下:
- 1分:资产(代码或数据)未公开发布,或虽公开但许可证禁止非商业与商业用途(包括研究用途)。
- 2分:资产公开可用,可用于非商业用途(包括研究),但禁止商业使用。
- 3分:资产公开可用,且可同时用于研究与商业用途。
表6对所有方法的代码与数据开放性进行了分类。研究发现,无任何一种方法的所有资产均支持研究与商业双用途;仅有5种方法(Omni-Q、Orion、LMDrive、SimLingo、AgentDriver)公开了所有资产,但部分资产仍限制商业使用——其中4种属于“为轨迹规划定制的基础模型”,1种属于“指导模块化自动驾驶模型轨迹规划的基础模型”。由此可见,“指导端到端自动驾驶模型轨迹规划的基础模型”(表6中第23-36行)尚无开源实现。此外,训练代码与模型权重是限制最严格的资产,这使得在缺乏这些资产的情况下,复现与复用相关方法的难度显著增加。

六、开放问题
本节将明确并讨论本文研究范围内的关键开放问题。
高推理成本导致部署困难
这类模型的部署面临挑战,核心问题在于推理成本过高——尤其是当使用思维链(CoT)推理时。除少数“仅在训练阶段进行知识蒸馏的模型”外,本文研究的其他所有方法均需在推理阶段调用基础模型;而由于基础模型参数规模庞大且输出采用自回归(AR)生成方式,其延迟通常超过实际需求——为实现对动态环境的有效响应并匹配传感器数据(摄像头、激光雷达)的延迟要求,推理帧率通常需达到10-30帧/秒(fps)。例如,Orion的参数规模超过70亿(见表1),即便不使用思维链,在NVIDIA A800 GPU上的推理帧率也仅为0.8帧/秒;此外,SimLingo是参数规模相对较小的模型(仅处理前视图像),其在NVIDIA A4500 GPU上“无思维链”与“有思维链”的推理帧率分别为3.6帧/秒与0.8帧/秒。因此,要实现这类模型的实际部署,亟需更高效的技术方案。
微调后的视觉语言模型对世界的理解能力下降
尽管“为轨迹规划定制的基础模型”在基准测试中表现优异,证明其能通过微调预训练模型有效利用迁移学习,但微调过程可能导致视觉语言模型(VLM)丧失对轨迹规划潜在有用的能力。这种“能力削弱”可能源于微调的负面影响——即“概念遗忘(concept forgetting)”,这是微调基础模型时“灾难性遗忘”的延伸现象。

我们在图9中展示了这种效应:对SimLingo所用的视觉语言模型“微调前后”分别输入相同的图像与文本提示。为便于对比,我们采用了前文中用于提示GPT-4o的输入之一(GPT-4o的响应全面且准确)。尽管SimLingo的初始模型——Mini-InternVL(参数规模相对较小)的响应不如GPT-4o全面,但仍较为准确:它识别出“奶牛正在横穿马路”,并建议“让奶牛先通过或寻找更安全的行驶区域”。然而,微调后的SimLingo却给出了自相矛盾的响应:先是称“不适合驾驶”,随后又解释“当前路线不拥堵”(暗示路线安全);此外,SimLingo完全未提及环境中的关键信息(如奶牛的存在)。因此,亟需进一步研究与深入分析,以确保视觉语言模型在自动驾驶专用数据集上微调后,仍能保留必要的能力。
7.3 迈向Agentic VLAs
现有具备语言交互能力的方法,其核心聚焦于“解读当前场景以向用户提供可解释性”;但如果能针对性地设计问答对,此类方法有望拓展更多实用场景。例如,用户可询问与驾驶无关的问题(如“自车行驶途中经过的小镇有哪些历史地标”,见图10示例);又如,模型可帮助视障人士理解周围环境(如“交通为何停滞”)。

当前具备动作交互能力的模型存在一大局限:仅能处理“短时域内可执行的指令”。例如,DriveMLM与SimLingo仅支持“调整速度”“变道”等指令——这类指令可在单次轨迹输出的时域内完成,因此模型无需“记忆指令”或“检查指令是否完成”,但这种设计在实际场景中实用性有限。尽管LMDrive支持的指令类型更丰富(包含56种不同指令),但仍无法像“请启动车辆并继续前往牛津的酒店”(见图10示例)这类人类化复杂指令那样,将指令拆解为多步执行。机器人领域中更先进的规划模型,或可为自动驾驶模型实现类似能力提供参考。
尚无实车场景下具备动作交互能力的模型
本文研究的所有“具备动作交互能力的模型”,均在CARLA模拟器的合成场景中进行训练与测试。由于“domain shift”会导致模型性能显著下降,若不解决“仿真到现实(sim-to-real)的差距”,现有模型无法实际部署。因此,亟需设计“解决域转移问题的方法”并“构建实车训练数据集”,才能推动具备动作交互能力的模型从研发走向部署。
需进一步分析“哪些因素对提升驾驶性能至关重要”
不同方法在模型设计与实验设置上差异显著,这使得难以判断“某一方法性能优异的核心原因”。例如,Orion在B2D-Base数据集上训练(包含约7小时视频片段),采用“现成视觉编码器+带视频记忆块的自定义Q-Former”架构,分三阶段训练,参数规模超过70亿,采用“变分自编码器作为轨迹规划头”,并结合“场景描述、场景分析、动作推理、历史回顾”的综合思维链——该模型在闭环B2D基准测试中取得77.74的驾驶分数,显著优于端到端自动驾驶方法(如VAD的驾驶分数为42.35)。
与之相对,SimLingo采用“Mini-InternVL(10亿参数)”作为现成视觉语言模型,在“超过200小时视频数据”上通过单阶段训练适配任务(依赖“数据桶(bucketing)”重采样策略),采用不同的语言标注与思维链设计——最终驾驶分数超过85。这些模型在“训练方式、训练数据集、模型架构”等方面的巨大差异,使得难以厘清“究竟哪些因素导致性能差异”。因此,亟需深入分析这些因素对模型性能的影响机制。
需建立“推理能力评估基准”
与基础模型的通用评估基准类似,“为轨迹规划定制的基础模型”也需要标准基准来评估其推理能力。例如,基础模型领域的ARC-AGI基准(Chollet et al., 2025)设计了“人类易解决但基础模型难处理的视觉推理问题”,并在有限资源预算下衡量基础模型的准确率。自动驾驶领域也需设计类似基准,以评估模型在“复杂语言输入、语言-视觉接地(grounding)”场景下的推理能力——这类基准的设计具有挑战性,需要学术界共同关注与投入。
七、结论
本文对“利用基础模型的自动驾驶轨迹规划方法”进行了全面综述。为提供完整且连贯的研究视角,我们基于“基础模型的使用方式”提出了一套分类体系;并借助该分类体系,对各类方法进行了详细且具对比性的论述,形成了统一且批判性的观点。此外,我们还评估了这些方法的开放性,为从业者与研究人员选择合适模型提供参考。最后,我们指出了“开发具备目标功能的实用模型”所面临的关键开放问题。通过本综述,学术界可更好地理解该领域的研究现状,明确未来方向,从而开发出更强大的“利用基础模型的自动驾驶解决方案”。
...
#SimScale
李弘扬团队最新!SimScale:显著提升困难场景的端到端仿真框架,NavSim新SOTA
李弘扬老师团队的新工作 - SimScale,中科院、港大OpenDriveLab和小米汽车联合完成。近年来,大模型领域背靠 Data Scaling 取得了前所未有的突破,但到了自动驾驶,这套方法却突然失灵了。不是因为模型不够大,而是现实世界根本给不了足够多的关键场景。
现实道路中的绝大多数驾驶片段都是重复而安全的“常态行为”,真正决定策略能力上限的高风险、长尾、极端场景却往往难以遇见,更难以大规模收集。因此即使训练数据越来越多,模型的真实表现却没有得到相应的增加。因此,自动驾驶不是缺数据,而是缺“对的”数据,行业亟需一种能系统性生成大量关键场景、并规模化训练的新路径。
针对这个问题SimScale应运而生,SimScale探索了在scalable的3DGS交互式仿真下,通过真实世界仿真生成关键场景,以及真实仿真协同训练策略,首次揭示了自动驾驶仿真数据的规模效应:无需更多真实数据,只靠扩大仿真数量,就能持续突破任何端到端驾驶模型的性能上限!

该框架利用先进的神经渲染技术和交互式环境,生成由扰动后的自车轨迹控制的高真多视角观测数据。此外本文还为这些新仿真状态开发了伪专家轨迹生成机制,以提供动作监督。基于合成数据的实验表明,在真实世界数据和仿真数据上采用简单的协同训练策略,能显著提升多种规划方法在挑战性真实世界基准测试中的鲁棒性和泛化能力——在navhard数据集上EPDMS指标最高提升6.8,在navtest数据集上最高提升2.9。更重要的是,即使没有额外的真实世界数据输入,仅通过增加仿真数据量,就能实现策略性能的平稳提升。
- 论文标题:SIMSCALE: Learning to Drive via Real-World Simulation at Scale
- 论文链接:https://arxiv.org/abs/2511.23369
- 项目主页:https://opendrivelab.com/SimScale
代码、仿真数据、模型权重即将全面开源!
总结来说,SimScale有以下特点:
- 🏗️一个能“无限扩张世界”的仿真生成框架:通过高保真神经渲染,自动制造多样化反应式交通场景与伪专家示范。
- 🚀一套让仿真与真实“相互增益”的训练策略,使各种端到端模型都能越训越强,鲁棒性与泛化性全面提升。
- 🔬一份首次系统揭示自动驾驶仿真规模效益的“实践手册”,通过实验深度分析把仿真推向规模化的关键因素。
一、背景回顾
Data Scaling被视为现代深度学习在多个领域(包括语言、视觉和多模态建模)的基本原理,随着数据量增加,它为性能的稳步提升提供了支撑。在自动驾驶领域,端到端规划通过学习将原始观测数据映射为动作,为利用大规模驾驶数据实现完全自动驾驶系统提供了一种极具潜力的途径。
然而,来自人类专家演示的真实世界驾驶数据中,常见场景占主导地位,而诸如安全关键场景等复杂情况则代表性不足。此外,基于这类数据训练的规划器会受限于人类驾驶的分布范围,难以泛化到罕见或未见过的场景,导致部署时出现分布偏移和因果混淆问题。因此,仅依靠扩展真实世界数据,对于实现可部署的自动驾驶而言效率低下。
基于神经渲染的仿真技术能够生成高保真的驾驶场景,因此有望大规模产生偏离人类演示的分布外状态,这对于闭环规划至关重要。因此,扩展仿真数据成为替代单纯依赖真实世界数据的一种有吸引力的方案。但规划器需要相应的可行演示来学习如何处理分布外状态,而现有仿真方法无法有效生成这类演示。此外,关于仿真数据扩展带来的影响,目前尚缺乏深入分析。本研究旨在为端到端规划中,基于有限真实世界场景扩展仿真数据提供一套系统化方案。
为开展全面的实验和分析,本研究围绕三个核心问题展开:
- (1)有效的仿真数据应具备哪些特征;
- (2)规划器能从仿真数据中获得多大收益;
- (3)在固定真实世界数据集的情况下,该系统是否能实现可预测的规模扩展。
为此,本文设计了一套可扩展的仿真数据生成框架,能够将现有真实世界训练数据中的专家分布进行扩展,从而为端到端自动驾驶系统提供支撑。本文开发了基于3DGS的仿真数据引擎,该引擎支持控制时间维度上的自车和其他智能体状态,并从自车视角渲染多视角视频。
具体而言,本文首先对自车轨迹进行多样化且合理的扰动采样,以最大化状态空间的覆盖范围(例如车道偏离中心、近距离交互等场景)。随后,本文将每个扰动轨迹的最终状态作为扰动状态,并通过两种不同形式的伪专家生成相应的演示轨迹进行对比。第一种是基于恢复的专家,它会检索能将策略引导回人类轨迹分布的轨迹,从而产生类人且谨慎的行为;第二种是基于特权规划器的专家,它会生成最优轨迹,代表一种探索性策略,但真实感相对较低。为提升可扩展性和合理性,整个流程在交互式环境中执行,其中周围智能体会对自车做出响应式交互。
为全面评估仿真数据的效果,本文考虑了三种不同模型规模的端到端规划器,即回归类方法的LTF、扩散模型类规划器的DiffusionDrive,以及词汇评分类的GTRSDense。本文采用一种简单有效的虚实协同训练策略,在保留人类驾驶分布的同时,减轻视觉领域退化问题。此外,通过固定真实数据量,并通过非重叠样本逐步增加仿真数据,本文研究了不同规划器从仿真数据中获益的情况以及整体的规模扩展特性。
本文采用两个真实世界闭环基准测试,从多个角度对规划器进行评估:navhard专注于未见过的挑战性场景,用于评估分布外状态对规划器的影响;而navtest则包含大量多样化场景,用于测试规划器处理不同情况的能力。

如图1所示,这套完整的虚实结合学习系统(包括可扩展的仿真数据构建流程和有效的虚实协同训练策略),名为SimScale。严谨的实验揭示了SimScale带来的若干关键发现,包括但不限于:
- 结合伪专家的可扩展仿真,能够释放现有真实世界驾驶数据的内在潜力;
- 虚实协同训练能协同提升不同端到端规划器的鲁棒性和泛化能力;
- 探索性专家和交互式环境能提升仿真数据的有效性;
- 具备多模态建模能力的规划器,展现出更令人满意的数据规模扩展特性。
二、相关方法
本文将SimScale的核心框架概述如下:第一部分简要介绍支持可控多视角视频渲染的3D高斯Splatting(3DGS)仿真数据引擎;然后提出伪专家场景仿真流水线,生成包含分布外(OOD)状态及可行演示样本的多样化仿真数据;最终展示适用于不同端到端规划器的可扩展虚实协同训练方法。
预备知识
端到端规划模型以历史时序帧内的观测数据为输入,输出预测的未来轨迹。每个训练场景从选定时间步开始,包含长度为T的历史时间域和长度为H的规划时间域。模型处理过去T帧数据以预测未来H帧轨迹,最终形成一个覆盖个时间步的完整训练样本。
3DGS仿真数据引擎
为减小真实世界数据与仿真场景中新视角生成观测数据之间的域差异,需要一个照片级真实感的数据引擎。基于从真实世界数据集重建的3DGS资产,本文的数据引擎以时间步t的相机内参、外参,以及同一时间步非自车的位置和偏航角为输入,渲染出对应的RGB观测图像。相机外参可通过自车位置和航向结合自车到相机的变换关系直接获取,其他相机参数则直接沿用原始数据集的配置。
预处理:参考相关工作,本文以时间步t的投影激光雷达点为指导,对多视角相机同时捕获的图像进行曝光对齐。此外,借助NAVSIM标注提供的3D边界框,将带颜色的激光雷达点划分为静态背景和多个车辆等不同组,进一步将其作为高斯初始化的输入,以提升重建性能。
分块重建:场景重建过程中,图像数量的增加会显著提升计算成本和运行时间。因此,本文采用分块重建的方式,每个块对应一个时空范围。参考现有工作,利用每一时间步的3D边界框位置和姿态,将背景和前景分别重建为独立模型,得到静态背景资产和多个可移动车辆资产。这些资产可根据输入指定的位置和航向进行放置,从而渲染出新视角下的传感器数据。为保证生成仿真数据的质量,本文会剔除新颖视角合成中平均峰值信噪比(PSNR)较低的块。
伪专家场景仿真
基于上述数据引擎,本文设计了伪专家场景仿真流水线,从现有真实世界数据中生成多样化的仿真数据,流程如算法1所示。该流水线旨在通过扰动状态与专家轨迹配对,生成可行的演示样本,具体如图2所示。

反应式场景重建:对于每个训练片段d,本文执行两次时长为H的仿真:一次用于在t=T时探索扰动状态,另一次用于在t=T+H时生成专家轨迹。
在每次仿真中,自车轨迹通过线性二次调节器(LQR)进行仿真,而其他智能体则采用智能驾驶员模型(IDM)建模,以实现与自车的交互,进而生成对应的未来状态。为得到有效的专家轨迹,本文将模拟的自车-智能体轨迹分为两个阶段,再通过数据引擎Φ将其渲染为多视角视频。这种将行为仿真与传感器渲染解耦的设计,实现了其他智能体对自车行为做出合理响应的反应式环境,从而提升了仿真数据的真实性和多样性。
轨迹扰动:在第一次仿真步骤(t=T)中,本文对自车轨迹进行扰动,使自车在t=T+H时达到新的终端状态,该状态随后将作为下一次滚动的起始状态(图2(a))。本文的目标是采样多样化且合理的状态:为保证多样性,扰动从密集覆盖动作空间的聚类人类轨迹词汇库中选取;为保证合理性,本文通过对纵向/横向偏移和航向变化设置阈值,并剔除物理上无效的轨迹(如碰撞、偏离道路、渲染不稳定等),将扰动限制在人类行为附近。
此外,本文采用步长为的交错网格对轨迹端点进行空间稀疏采样,以促进状态空间的均匀覆盖。由于反应式仿真成本较高,本文先通过非反应式方式筛选不可行轨迹,仅对稀疏后的轨迹集进行反应式验证,最终得到一组动态和物理上均可行的扰动。
伪专家轨迹生成:在第二次仿真(t=T+H)中,针对每个扰动状态,本文采用非人类专家(即伪专家)生成对应的可行轨迹。由于伪专家并非完美,且将用于监督训练,因此在第二阶段仿真中本文采用了更严格的筛选条件。除物理约束外,还强制执行交通规则和车辆运动学限制。为探究哪种策略最适合作为端到端规划器的监督信号,本文对比了两种伪专家策略:保守型恢复式专家和探索型规划器式专家,具体如下:
(1)恢复式专家:在轨迹扰动后,将策略引导至人类行为分布范围内。为保证鲁棒性,本文的恢复式专家从大型词汇库中检索与自车在t=T+2H时记录状态最匹配的人类轨迹(图2(b1))。对于每个长度为H的候选轨迹,本文用一个紧凑的匹配向量总结其初始和最终姿态:
给定带有目标向量的自车扰动状态,恢复式专家通过以下方式检索最接近的人类机动动作:
这一策略能产生类人且保守的 fallback 行为,在分布偏移情况下保持稳定性。
(2)规划器式专家:参考现有工作,本文采用特权规划器P,该规划器利用真实状态在仿真中生成反应式且优化后的轨迹滚动(图2(b2))。规划器式专家定义为:。与恢复式策略相比,规划器式专家依赖规则或成本启发式,偶尔会牺牲行为的类人性和真实性,但能提供强优化性和多样化的探索性滚动,丰富超越人类数据的专家监督信息。
可扩展虚实协同训练
协同训练策略:虚实协同训练是一种简单有效的策略,能够将真实数据和仿真数据整合用于规划任务。在本文的方法中,训练过程中从真实世界数据集D和仿真数据集的混合集中随机采样,旨在保留人类驾驶分布的同时,减轻由潜在仿真伪影(如细微渲染不一致、时间抖动或不真实的光照和阴影)导致的视觉域退化。本文的全自动可扩展仿真数据生成框架,能够在固定真实数据量的前提下,通过逐步添加非重叠的仿真样本,实现训练数据总量的扩展。
协同训练所用规划器:为全面评估仿真数据对端到端规划器的有效性,本文选取了三种具有代表性的现代端到端规划范式:基于回归的规划器、基于扩散模型的规划器和基于词汇评分的规划器,并在协同训练实验中分别选用各范式的代表性模型。
(1)基于伪专家轨迹的协同训练:
基于回归和扩散模型的规划器依赖专家演示样本,因此协同训练过程可表示为:
其中,表示模仿损失;D和分别代表真实世界数据集和生成的仿真数据集;A表示专家轨迹,即D中的人类专家轨迹和中的伪专家轨迹。对于基于词汇评分的规划器,其学习目标还需额外预测提炼了评价指标(如式6中的EPDMS)的奖励信号r:
其中,表示奖励损失,λ为权重因子。
(2)仅基于奖励的协同训练:
对于基于词汇评分的规划器,如式4所示,当奖励信号对齐良好时,理论上无需专家轨迹。该规划器可在不受单一专家轨迹限制的情况下,探索能提升奖励的方向。协同训练过程可表示为:
因此,本文在基于规划器的仿真数据中,针对评分式规划器开展了纯奖励驱动的优化实验,以评估其充分利用仿真数据的潜力。
三、实验结果分析
排行榜结果
表1和表2分别展示了SimScale虚实协同训练在navhard和navtest基准测试集上针对三种规划器范式的排行榜结果。

navhard排行榜:所有模型在第一阶段和第二阶段均表现出显著的性能提升。值得注意的是,GTRS-Dense(V2-99)取得了47.2的得分,创下navhard的最新最优性能(SOTA)。这些结果表明,融入具有扩展分布的仿真数据,能显著提升模型在具有挑战性和未见过场景中的鲁棒性,且不会因仿真数据而遭受潜在的视觉退化影响。值得一提的是,性能较弱的基线模型(如LTF和DiffusionDrive)获益最为明显,性能提升超过20%,这表明结合本文仿真数据的虚实协同训练,能有效帮助模型更好地挖掘数据集信息,释放其潜在的学习能力。

navtest排行榜:所有模型均实现了高达2.9个百分点的持续性能提升,表明模型在大规模多样化场景下的性能更强。上述定量结果凸显了本文的仿真数据具有模型通用性,且通用的虚实协同训练实现了鲁棒性和泛化性的协同优化,这对于真实世界中可靠的闭环部署至关重要。
消融实验与数据缩放分析
不同规划器的数据缩放曲线:由于现有工作缺乏对固定真实世界数据量下仿真数据缩放行为的研究,本文采用对数二次函数建模性能与总数据量(仿真数据+真实数据)之间的关系:
其中,表示总数据量为N时的规划器性能,a、b、c为通过非线性最小二乘法拟合的参数:

其中,表示总数据量为时的观测性能,M为数据点数量。若存在数据缩放趋势,则二次项系数a趋近于0,模型退化为对数线性关系;否则,曲线呈抛物线形状,存在明显的饱和点。本文在图3所示的仿真数据缩放设置下,评估了四种规划器在两种伪专家策略下的性能,并选取navhard中的EPDMS作为。图4展示了缩放曲线和拟合的对数二次函数,误差带表示残差标准差。此外,本文还针对GTRS-Dense,在基于规划器的仿真数据中提出了仅奖励评分的额外实验。从图4中可观察到一些典型趋势,例如对比图4(c)和(d)中规划器式专家与仅奖励评分的设置,在相同数据量下,更大规模的模型表现出更显著的数据缩放趋势。其他有趣且有意义的发现如下:

伪专家应具备探索性:对于所有规划器,恢复式策略下的缩放曲线收敛更早,且性能低于规划器式策略。恢复式专家始终引导轨迹向人类驾驶日志靠拢,当从相同真实场景中扩展仿真数据时,会限制数据多样性。相比之下,规划器式专家能探索更广泛的可能性,甚至在具有挑战性的场景中提供可行解决方案。因此,与规划器式策略相比,恢复式专家仅在小数据量场景下表现出优势(图4(d)),这可能是因为其轨迹分布与真实世界数据更契合,更易于学习。在大多数情况下,随着数据缩放,恢复式策略的性能提升边际效益递减。这些观察结果凸显了伪专家探索性行为的重要性,它能提升缩放场景下仿真数据的价值。
多模态建模激发缩放潜力:尽管基于回归的LTF和基于扩散模型的DiffusionDrive模型规模相当(5600万参数 vs 6100万参数),但在规划器式策略下,两者的缩放特性存在显著差异(图4(a)和(b))。对于LTF,当仿真数据与真实数据比例达到1:1时,性能达到饱和并开始下降;而DiffusionDrive则表现出近似线性的性能提升。这是因为来自相同真实场景的演示样本多样性逐渐增加,带来了有效的多模态监督问题。单模态回归模型难以建模多峰分布,导致模态混淆和性能下降,而扩散模型能够捕捉多模态特征,因此更适合在多样化监督下进行优化。由于真实世界自动驾驶本质上是一个多峰问题,本文的仿真缩放结果强调了多模态建模对于可扩展真实世界端到端自动驾驶的重要性。
奖励信号足矣:在图4(c)和(d)中,对于基于评分的GTRS-Dense规划器,仅使用仿真数据中的奖励信号(无需专家轨迹)就能实现更优的性能。为进一步分析这一现象,本文在仅使用真实世界数据的情况下进行了仅奖励驱动的训练,结果如表3所示,性能反而下降。这些结果表明,在足够的专家监督以稳定优化方向的前提下,奖励引导能发挥更好的效果。模型在环境探索和交互过程中,能从奖励反馈中获益。
反应式仿真的影响:为分离反应式交通的影响,本文对比了基于奖励评分的GTRS-Dense在navhard上使用非反应式和反应式仿真数据的性能(表4)。两轮非反应式采样生成了14.1万条轨迹(由于碰撞率更低,比反应式多5.4万条有效样本),但EPDMS未得到任何提升;当反应式仿真进行到第三轮时,生成了12.4万条样本(比非反应式少1.8万条),但在两种模型规模下均实现了持续且显著的EPDMS提升。这些结果表明,反应式智能体动态提升了交通交互的真实性和多样性,进而增强了仿真数据的有效性。

仿真场景的定性结果
图5展示了仿真数据的定性可视化结果,呈现了四种用于训练策略的代表性OOD场景。这些场景模拟了学习到的策略容易出错的典型真实世界驾驶挑战,包括(a)车道偏离中心、(b)近碰撞、(c)驶离可行驶区域和(d)车辆加塞。每个场景均通过俯视图展示作为监督信号的伪专家轨迹和作为历史动作的偏离扰动轨迹,并附上作为策略感官输入的合成前视图图像。例如,场景(b)要求策略在短时间域内自适应避免碰撞。


四、结论
本文提出了SimScale,最新的仿真学习系统,揭示了大规模仿真如何放大真实世界数据集在端到端自主驾驶中的价值。在仿真数据生成流程方面,本文首先通过在交互环境中对自车轨迹进行扰动,从潜在的分布外状态中生成伪专家演示数据。为实现贴近真实世界的仿真效果,本文利用3DGS引擎渲染出高保真的多视角观测数据。基于这些仿真数据,虚实协同训练在具有挑战性的真实世界基准测试中,显著提升了各类规划器的鲁棒性和泛化性——在navhard基准上EPDMS评分最高提升6.8分,在navtest基准上最高提升2.9分。
值得注意的是,在固定真实世界数据集的情况下,该虚实系统随着仿真数据量的增加,呈现出清晰且可预测的性能扩展趋势。本文进一步发现,探索性的伪专家设计和交互环境能够提升仿真数据的有效性,而具备多模态建模能力的规划器则会展现出更优的数据扩展特性。本文希望SimScale能够启发学术界进一步探索真实世界仿真在数据扩展方面的应用。
...
#LAP
哈工大提出LAP:潜在空间上的规划让自动驾驶决策更高效、更强大!
本文的核心设计哲学在于:去除掉冗余的动力学细节,让模型专注于规划的高层语义。LAP 通过将规划放到去除掉动力学细节的语义空间上进行,从而提高了模型对复杂、多模态的驾驶策略的建模能力,并大大提升了推理速度。
本文首先设计了针对轨迹数据的 VAE 模型,将原始轨迹压缩到语义化的潜在空间,随后在潜在空间上作规划,让模型专注于高层驾驶策略。其次,针对潜在空间规划带来的挑战,本文进一步引入初始状态注入、无分类器引导、细粒度特征蒸馏等技术进一步提升模型性能。在大规模自动驾驶规划数据集 nuPlan 上的实验证实了方法的有效性。尤其在最具挑战性的 Test14-hard 数据集上,模型以十倍的推理加速,取得大幅领先当前 SOTA 方法(提高约 3.1 score)的性能,闭环评测分数达到 78.52。
- 论文标题:LAP: Fast LAtent Diffusion Planner with Fine-Grained Feature Distillation for Autonomous Driving
- 论文链接:https://arxiv.org/abs/2512.00470
背景回顾 (Background Review)
自动驾驶系统的核心在于能够处理复杂交互环境的鲁棒运动规划。该领域的发展经历了以下几个阶段和挑战:
- 传统方法的局限性: 早期的基于规则的系统(如有限状态机)虽然具有可解释性,但其手工设计的逻辑难以扩展,无法应对开放世界中的长尾场景。
- 模仿学习 (Imitation Learning, IL) 的瓶颈: 数据驱动的 IL 方法容易受到“模式平均”(mode-averaging)的影响,即模型将多个有效的专家轨迹坍缩成单一的、物理上不可行的路径,无法捕捉人类决策的多模态特性。
- 扩散模型的引入与带来的问题: 去噪扩散概率模型(DDPMs)虽然能够建模复杂的多模态分布,但现有方法直接在原始轨迹的路点(waypoints)上进行操作。这种做法存在两个核心缺陷:
- 计算效率低: 迭代采样过程导致显著的延迟。
- 容量浪费: 模型将大量能力消耗在模拟底层的运动学细节(如连续性、速度限制)上,而不是关注高层的驾驶策略语义。
为了解决这些问题,我们提出了 LAP (LAtent Planner),旨在将高层意图与轨迹的底层运动学解耦,在解耦得到的潜在空间中进行规划。
预备知识 (Preliminaries)
扩散模型基础
扩散模型通过反转一个前向加噪过程来生成样本。
- 前向过程: 在时间 内向数据 添加噪声,其分布可表示为:
其中 和 是噪声参数。
- 反向过程: 通过求解扩散常微分方程(ODE)从噪声中恢复数据:
模型使用神经网络 来估计分数函数 。
无分类器引导 (Classifier-free Guidance)
为了增强生成样本与输入条件的一致性,同时学习无条件模型 和有条件模型 ,推理时使用参数 控制条件对齐度与样本多样性之间的权衡:
在 LAP 中,这一技术主要用于增强导航信息的引导作用。
LatentPlanner 算法详解 (Methodology)
如图1所示,LAP 框架将轨迹生成分解为两个阶段:在高层语义化的潜在空间作规划,随后再以高保真度重建对应轨迹。

图 1:Latent Planner整体框架示意图
轨迹的潜在表示 (Trajectory Representation in Latents)
我们设计了一个基于 Transformer 的 轨迹变分自编码器 (Trajectory VAE)。
- 编码器 (Encoder): 使用可学习的查询(Queries)和自注意力机制聚合轨迹的结构信息,将轨迹 压缩为低维潜在向量 。
- 解码器 (Decoder): 通过路点查询(Way-point queries)利用交叉注意力机制从潜在表示中重建轨迹 。
- 训练目标: 包含重建损失(MSE)、KL 散度以及为了提高平滑度引入的 差分损失 (Differential Loss) :
其中 为差分项权重(实验中设为 0.01)。
潜在空间上的规划 (Planning on Latents)
在 VAE 训练完成后,再训练一个潜在扩散模型(DiT 结构)来预测轨迹对应的潜在向量 。模型具体结构如下:
- 场景编码: 使用 MLP-Mixers 编码周车历史和车道信息,使用 MLP 编码静态障碍物,并通过一个 Transformer Encoder 融合得到最终的场景表示 。
- 初始状态注入 (Initial State Injection, ISI): 由于周车的起点并不固定,我们发现不添加额外信息会导致模型对周车的预测无法收敛。因此,我们将周车的初始状态 注入到 DiT 的输入和输出层,为预测周车轨迹提供一个明确的先验“锚点”。

图 2:初始状态注入模块
- 导航引导增强: 我们观察到模型在闭环规划中会出现“因果混淆”现象:自车完全根据周围车辆当前状态来作决策而完全不按导航路线行进。因此,我们在训练中随机丢弃导航信息,并在推理时使用 Classifier-free Guidance 强化导航约束来缓解这一问题。
弥合语义–感知鸿沟 (Bridging the Semantic–Perception Gap)
在压缩的语义空间规划虽然高效,但也带来新的问题:压缩得到的潜在空间是一个高度抽象化的语义空间,而条件输入(周车历史、车道线等)仍为低层的、细粒度的向量化表示,这导致两者的信息交互与融合变得困难。针对此,我们引入一个细粒度特征蒸馏 (Fine-grained Feature Distillation) 模块来引导规划空间与条件输入空间的信息交互过程:

图 3:细粒度特征蒸馏模块
- 特征教师: 首先获取一个能够将场景信息与规划信息作良好对齐与融合的教师模型。
- 特征蒸馏: 将教师模型中间层的特征 作为目标,指导 LAP(学生)的中间层特征 的学习。
- 蒸馏损失:
总损失为 。这可以为学生模型的中间层特征提供一个已经编码完美(良好的规划–场景交互与对齐)的“模板”,从而降低学生模型中规划空间与向量化输入空间的交互“难度”,引导更好的特征融合。由于已经有工作证实:像素扩散模型自身就是很好的 image-condition 对齐编码器,因此我们直接使用像素空间规划器 Diffusion Planner 作为教师模型。
实验结果及分析 (Experiments)
实验设置
- 数据集: nuPlan 大规模基准测试(1300 小时真实驾驶记录)。
- 评价指标: 闭环评分(Closed-loop Score),包括非反应性(NR)和反应性(R)场景。指标综合考虑了碰撞、舒适度、进度和交通规则遵守情况。
主要结果
LAP 在 nuPlan 基准上取得了优异的成绩。
- 性能对比: 如表1所示,LAP 在所有基于学习的方法中实现了 SOTA 性能,并且在加上后处理(refine)后,甚至超过了部分规则–学习的混合方法。值得注意的是,在最具挑战性的 Test14-hard 数据集上,LAP 大幅超越了先前的 SOTA 方法(约 3.1 的提升),说明潜在空间规划可以让模型更好地建模复杂的驾驶策略,提升困难场景下的性能。

- 推理速度: 如表2所示,相比于之前的 SOTA 方法 Diffusion Planner(需迭代 10 步),LAP 受益于潜在空间的紧凑性,仅需 2 步 采样即可生成高质量轨迹,实现了最高 10 倍 的推理加速。

定性结果与多模态分析
- 多模态能力: 相比于像素级规划器,潜在空间规划能更好地捕捉多样化的高级驾驶策略(如不同的转弯半径和速度),而不是坍缩到单一模式。参见下图。

图 4:多模态轨迹解码,左图为Latent Planner,右图为Diffusion Planner,Latent Planner表现出更高的多模态驾驶策略
- 潜在空间可视化(附录分析):
- 插值: 潜在空间的线性插值能产生平滑的轨迹过渡,证明了潜在空间的光滑性(参见下图)。

图 5:潜在空间插值
- 聚类: 潜在向量聚类后对应明显的驾驶意图(如直行、转弯、静止),证明其学到的语义空间是高度结构化的(参见下图)。

图 6:潜在空间聚类
- 降维可视化: 在原始轨迹空间聚类得到“意图”标签,随后用 UMAP 对潜在空间降维并用对应意图染色,结果显示不同区域基本分离开,说明潜在空间结构与意图对齐良好(参见下图)。

图 7:潜在空降降维可视化
消融实验
如下表所示,我们对各个模块进行了详细的消融分析:

- 设计模块的影响:
- 初始状态注入 (ISI): 提升了非反应性环境下的性能,但由于“因果混淆”问题,反应性环境中性能反倒有所降低。
- 特征蒸馏 (Dist): 显著提升了模型在两种环境下的表现,证明了其有效性。
- 导航增强 (CFG): 大幅缓解了反应性环境中的“因果混淆”问题。
- 采样步数的影响: 1 步或 2 步采样效果最佳。增加步数(如 3 步以上)反而导致性能下降,原因可能是精度过高的解码严格生成了训练集中的某条轨迹,无法应对闭环规划中的 OOD 场景 。
- 蒸馏策略的影响: 使用教师模型最后一层的特征作为目标,并将权重 设为 0.5–1 之间效果最好。
结论 (Conclusion)
本文提出了 LAP,这是一种潜在扩散框架,通过在由 VAE 学习到的解耦语义空间中进行操作,显著提高了自动驾驶规划的性能和效率。
- 核心贡献:
- 利用变分自编码器实现了高层语义与底层运动学的解耦。
- 引入细粒度特征蒸馏,弥合了潜在规划空间与向量化场景上下文之间交互与融合的鸿沟。
- 在 nuPlan 基准上实现了 SOTA 的闭环性能,同时推理速度提升了 10 倍。
...
#Alpamayo-R1
英伟达拿出推理版VLA:Alpamayo-R1让自动驾驶AI更会动脑子
一、自动驾驶的瓶颈:「看」得见,却「想」不明白
当今自动驾驶模型越来越强大,摄像头、雷达、Transformer 网络一齐上阵,似乎什么都「看得见」。但真正的挑战在于:模型能否像人一样「想明白」为什么要这么开?
传统的端到端(E2E)系统虽然能从感知到控制一气呵成,却常在「长尾场景」翻车 —— 比如:
- 迎面来车违规左转;
- 行人突然闯入;
- 临时施工、交通标志被遮挡。
这些「极少数但容易发生事故」的场景正是当前系统的盲点。
二、Alpamayo-R1:给模型装上「推理链条」
NVIDIA Research 推出的 Alpamayo-R1(AR1),是一种全新的带有推理能力的视觉 - 语言 - 行动模型(Reasoning VLA),让车辆不只是「执行指令」,而是能在决策前「推理出因果关系」。

图 1:Alpamayo-R1 模型架构(示意)
AR1 的核心创新有三个方面:👇
1. Chain of Causation(因果链)数据集
AR1 引入了一套全新的数据标注体系:每一段驾驶数据不仅有「做了什么」,还有 「为什么这样做」。例如:「减速并左变道,是因为前方有助动车等红灯,且左侧车道空闲。」

图 2:因果链(CoC)标注示例
2. Diffusion-based Trajectory Decoder(扩散式轨迹解码器)
AR1 引入了一种基于扩散模型的轨迹解码器,它能在实时约束下生成连续、动态可行的驾驶轨迹。该模块结合语言推理输出与物理约束,实现从推理到控制的无缝衔接。
3. Multi-Stage Training(多阶段训练策略)
AR1 是基于 NVIDIA 的 Cosmos Reason 模型,这是一种专为物理 AI(Physical AI)设计的推理视觉语言模型;并采用多阶段训练策略:首先在大规模驾驶数据上做模态注入,学习从视觉到动作的基本映射;第二阶段在 CoC 因果链数据上做监督微调,显式教会模型「先想清楚再开」;最后通过强化学习(RL)进一步优化推理质量、推理 - 行动一致性和轨迹安全性。
这种分阶段、分目标的训练流程,使得模型在开放场景、长尾危险场景中都表现的更加稳健。
三、性能飞跃:更稳、更准、更懂你
在实验中,AR1 为以下性能带来了显著提升:
- 🚀 规划精度提升 12%
- 🌲 越界率降低 35%
- 🚗 近碰率降低 25%
- 🤖 推理 - 行动一致性提升 37%
- ⚡ 实时性能:99 ms 端到端延迟
更重要的是,这些提升主要体现在以往最容易出错的「长尾场景」中 —— 也就是说,它更接近「真正会判断的司机」。
四、Vision Encoding:高效多相机时序感知
AR1 的输入由多相机、多时序观测帧组成,同时可以选配高层语言输入(如导航指令或驾驶目标)。所有输入(包括历史自车运动)会被统一编码成多模态 token 序列,按时序和传感器顺序排列,再送入主干模型 Cosmos-Reason 进行推理与预测。
在这一过程中:
- 每个相机视角先经过轻量级 CNN 与时间注意力模块做特征压缩与时序建模;
- 多相机特征随后融合为 BEV(鸟瞰图)表征;
- 所有模态(图像、导航文本、自车状态)被 token 化后统一输入 Transformer;
- 模型的输出包含三类 token:推理链(reasoning traces)、中层动作(meta-actions)与未来轨迹预测(trajectories)。
这种统一编码方式让模型具备了多模态语义理解与运动状态感知的「一体化」能力。
五、数据的灵魂:结构化标注的革命
AR1 的 CoC 数据集采用「人机协同标注」机制:
- 人工部分:标注关键帧、核心因果因素(如红灯、行人、障碍物),并撰写推理链。
- 自动部分:通过 GPT-5 等大模型自动生成初版推理,再由人类审查。
- 质量审核:每条样本通过因果覆盖、因果正确性、近因优先等四项规则严格把关。
最终形成数十万条高质量推理 - 行动样本,使 VLA 模型能真正「理解因果,而非记忆现象」。

图 3:CoC 数据标注流程示意图
六、Multi-Stage Training:从常识推理到行为控制
Alpamayo-R1 的训练分为三个阶段,旨在让模型从「看懂」到「会想」再到「能开」。

图 4: AR1 训练流程示意图
1. 监督微调(Supervised Fine-Tuning, SFT)
基于 Cosmos-Reason 的预训练权重进行微调。该主干模型原本在 370 万条 VQA 数据上后训练(post-training),其中包括 2.47 万条专为驾驶设计的视频样本,带有场景描述、驾驶难度和推理轨迹标注,帮助模型建立「物理常识」和 「因果直觉」。
此外还构建了额外的 10 万条驾驶样本,标注关键目标、交通信号、因果行为解释等信息,用于领域自适应微调。
2. 因果链监督阶段(CoC Supervision)
引入 CoC 因果链数据集,显式监督模型的推理输出,使其能回答「为什么要减速」、「为什么左转」。这一阶段通过人工 + 教师模型(如 GPT-5)生成高质量推理样本,使模型在策略学习前先获得强大的语言 - 推理能力。
3. 强化学习后训练优化(Reinforcement Learning based Post-Training)。
在最终阶段,英伟达通过强化学习对模型进行策略微调,以进一步提升其在推理精准性、推理–行动一致性、轨迹平滑性以及闭环控制稳定性等方面的表现。
Alpamayo-R1 引入了多维度奖励机制:包括由专家级推理模型提供的反馈信号,用于评估并引导模型生成更具因果逻辑的推理;「推理–行动一致性(Reasoning–Action Consistency)」奖励,用于鼓励模型依据自身推理合理执行动作;以及底层安全奖励,用以促进模型生成更加安全、平滑且可执行的运动轨迹。
七、未来展望:迈向可解释的 L4 自动驾驶
AR1 的设计理念可以看作是自动驾驶从「黑箱」到「白箱」的转折点。
它不再只是一个会开车的 AI,而是一个能告诉你「为什么这样开」的驾驶员。
✨ 小结:让自动驾驶「有理可讲」
Alpamayo-R1 的意义不止在性能提升,更在于:它让 AI 的「推理链」与物理世界的「行动链」形成真正的闭环。
当车辆能解释自己的每一个决策时,才能确保更加安全,信任与普及才会得以实现。
一句话总结:AR1 = 会开车 + 会思考 + 会解释的自动驾驶模型。
详细内容请查看:https://research.nvidia.com/publication/2025-10_alpamayo-r1
...
#CoT4AD
超越ORION!CoT4AD:显式思维链推理VLA模型(北大最新)
北大一篇新的VLA工作 - CoT4AD。这篇文章重点解决的是下面这个问题:现有VLA模型通常存在数值推理能力有限和输入-输出映射过于简化的问题,所以在需要逐步因果推理的复杂驾驶场景中的性能表现一般。
所以本文提出了CoT4AD——一种新的VLA框架,其将思维链推理引入自动驾驶领域,以增强VLM的逻辑推理和因果推理能力。CoT4AD整合视觉观测和语言指令,实现语义推理、场景理解与轨迹规划。训练阶段,该模型明确构建了“感知-提问-预测-动作”的思维链,使推理空间与多个驾驶任务的动作空间对齐;推理阶段,其通过隐式思维链推理,在动态环境中实现一致的数值推理和稳健的决策制定。在真实世界数据集(nuScenes)和仿真数据集(Bench2Drive)上的大量实验表明,CoT4AD在开环和闭环评估中均取得了最先进的性能。
- 论文标题:CoT4AD: A Vision-Language-Action Model with Explicit Chain-of-Thought Reasoning for Autonomous Driving
- 论文链接:https://arxiv.org/abs/2511.22532
背景回顾
自动驾驶作为人工智能与机器人领域的核心研究方向,近年来受到了广泛关注。它不仅有望提升交通安全性和出行效率,还在智慧城市与智能交通系统的发展中发挥关键作用。传统自动驾驶系统通常采用模块化流水线架构,将感知、预测和规划分解为独立模块。然而,此类方法在实际应用中常面临误差累积、跨模块优化困难以及泛化能力有限等问题,制约了自动驾驶系统在复杂环境中的性能表现。
为应对这些挑战,端到端自动驾驶范式应运而生。这类方法旨在利用统一的学习框架,直接从原始传感器输入预测驾驶控制信号或规划轨迹,从而避免多阶段信息传播带来的不确定性。与此同时,随着大规模视觉-语言模型(VLMs)的快速发展,研究人员开始探索视觉-语言-动作(VLA)模型在端到端自动驾驶中的潜力。VLA模型能够处理多模态输入,并通过语言指令执行语义推理,与传统端到端方法相比,展现出更强的可解释性和泛化能力。
通过在多样化数据集上进行模仿学习,VLA模型继承了VLMs对异质场景、物体和语言的理解能力,实现了稳健的跨任务泛化。然而,它们也继承了VLMs的固有缺陷——尤其是在复杂环境中的数值推理能力较弱。因此,将VLMs应用于自动驾驶面临两大核心挑战:(1)有限的数值推理能力导致不可靠或幻觉的结果;(2)现有方法将大语言模型(LLMs)视为从感知到数值输出的单一映射器,忽视了其多步推理能力。
思维链(CoT)推理通过将复杂任务分解为中间步骤,显著增强了LLM的推理能力。尽管已有研究通过语言描述、关键点或边界框等方式引入CoT,但这些工作主要聚焦于环境受限的xx智能或机器人场景。然而,自动驾驶面临着本质上不同的挑战——它要求在动态、大规模且安全关键的环境中实现精准的数值推理、长时域规划和稳健的泛化能力。如图1(b)所示,直接将所有提示输入VLM会导致输出不稳定,而融入CoT则能够实现结构化的中间推理,获得更可靠的结果。本研究试图解决一个关键问题:如何为自动驾驶量身定制思维链推理,以提升效率和性能?
为此,我们提出了CoT4AD——一种新的VLA模型,其将思维链推理整合到端到端自动驾驶中。如图1所示,CoT4AD与现有方法的不同之处在于:通过针对自动驾驶场景设计的一系列下游任务,对开源预训练语言模型进行微调,使其能够显式或隐式地执行思维链推理。这一设计使模型能够从多模态输入生成可靠且稳定的驾驶轨迹。

我们的统一框架整合了环境感知、语言推理、未来预测和轨迹规划,使模型能够生成显式的思维链推理步骤。在感知推理阶段,模型通过专家数据训练感知任务,获取场景理解能力;在未来预测阶段,模型从专家数据中学习预测未来场景,实现场景重建;在视觉问答(VQA)推理阶段,模型通过基于提示的监督在视觉问答任务上进行微调;在轨迹规划阶段,模型通过模仿学习生成高质量的驾驶轨迹。通过多阶段训练过程,CoT4AD培养了适用于自动驾驶场景的思维链推理能力。推理阶段,CoT4AD无需显式生成中间推理步骤,即可通过单次前向传播直接输出驾驶轨迹,在规划性能与计算效率之间实现了平衡。
我们在真实世界数据集nuScenes和仿真数据集Bench2Drive上对CoT4AD进行了全面评估。实验结果表明,在开环和闭环测试中,CoT4AD在各类端到端自动驾驶基准测试中均表现出卓越性能。
主要贡献总结如下:
- 提出了CoT4AD——一种端到端自动驾驶框架,其利用经过多步微调的预训练VLM,能够基于原始视觉观测和语言指令实现思维链推理和多任务处理能力。
- 为驾驶场景的未来预测和轨迹规划引入了创新方法。该基于扩散模型的框架整合了现有的视频生成和规划方法,并与思维链推理流水线无缝衔接。
- 在NuScenes和Bench2Drive数据集上的大量实验表明,CoT4AD在开环和闭环驾驶中均建立了新的最先进结果,持续优于现有的基于LLM的方法和端到端自动驾驶方法。
CoT4AD算法详解3D环境感知
在现有VLA模型中,视觉特征通常通过2D编码器提取,这类编码器在平面任务中表现良好,但在建模3D结构和空间关系方面存在不足。由于缺乏多视图深度信息和几何一致性,这些模型无法准确感知3D环境。为解决这一局限,CoT4AD采用了以特征为中心的感知训练方式,通过学习多个3D感知任务生成3D视觉token。

如图2(a)所示,CoT4AD以多视图图像作为输入。首先,2D backbone网络提取多尺度特征,随后利用相机参数将这些特征投影到鸟瞰图(BEV)空间,得到BEV特征。模型采用PB-SSM框架实现高效的多视图融合,之后通过两个视觉模块对结构化3D语义进行编码:用于静态元素(车道、可行驶区域)的地图tokenizer()和用于动态目标(车辆、行人)的目标tokenizer()。其中,从BEV patches中生成地图token ,而则在上应用ROI对齐(ROI Align),得到目标token 。
为补充基于标注学习的局限性,本文进一步引入BEVTokenizer:该模块直接将BEV特征划分为个patch,生成全面的BEV token 。最终的环境表示为,该表示将作为思维链(CoT)推理的感知阶段输入。
视觉-语言提示微调
现有VLA模型的视觉-语言微调通常局限于图像token和语言token的调整,缺乏对感知token与其他多模态表示的联合优化。为解决感知模型提取的多特征token在环境表示能力上的不足,以及自然语言离散化嵌入的问题,本文提出一种基于视觉问答(VQA)的多模态视觉-语言微调框架。
在微调阶段,模型从VQA数据集中学习高级感知能力和驾驶知识,实现从多模态token到数值推理空间的迁移。受软提示微调的启发,本文引入跨阶段无关token(记为):这类可学习的离散化token在训练过程中用于编码视觉细节,并作为输入贯穿思维链推理的不同阶段。软提示微调的有效性已在图像分类、数值推理等多种基于Transformer的任务中得到验证,后续实验将证明,该方法在端到端自动驾驶任务中同样有效,能够提升多模态感知与语言推理的融合效果。
如图2(b)所示,本文将VQA数据集构建为提示-响应对,其中,用于编码自车状态(如速度、加速度、偏航角)。在指令微调过程中,视觉tokenizer保持冻结状态,而大型语言模型(LLM)设置为可训练。视觉-语言提示微调的数学表达式如下:
VLM-Conditioned Latent Diffusion
现有VLA系统常受限于文本级推理,忽略了现实世界丰富的多模态特性。受自动驾驶领域“世界模型”(通过生成未来帧学习物理规律)的启发,本文利用VLM条件扩散模型生成未来帧,使模型能够更深入地理解世界丰富的语义信息和物理规律,而非仅依赖文本或单帧信息。如图2(b)所示,本文提出的VLM条件扩散模型工作流程如下:
借鉴Latent扩散模型(LDM),本文训练编码器将图像压缩为更小的空间表示,同时训练解码器通过恢复未来帧。通过在latent空间中进行扩散建模,避免了在高维像素空间中直接扩散,从而显著加快扩散模型的训练速度。
LDM的前向过程定义为向latent空间逐步添加噪声,其数学表达式为:其中,为干净的latent变量,为时刻的带噪声帧,为超参数。
在反向过程中,本文训练扩散Transformer ,使其根据带噪声帧和条件嵌入重建(其中)。与从高斯分布中采样噪声不同,本文从当前帧构造带噪声帧,具体公式为:其中,。
训练阶段,扩散Transformer 以带噪声帧和条件嵌入为输入,预测去噪后的latent变量。训练目标结合了latent变量重建损失和噪声预测损失,公式如下:
推理阶段,本文采用截断去噪过程:首先从基于当前帧的高斯分布中采样带噪声latent表示,然后在VLM生成的条件嵌入的约束下逐步对其去噪,最终得到预测的。在每个去噪步骤中,采用DDIM更新规则迭代优化latent状态,以过渡到下一时刻。最后,通过解码器对进行解码,得到预测的未来帧。
通过这种基于latent空间的VLM条件扩散生成方法,VLA模型能够学习未来场景预测,从而形成对场景变化的视觉推理能力,进一步提升对环境语义和物理规律的理解。
思维链轨迹规划
在该阶段,CoT4AD基于思维链对未来驾驶动作进行规划,驾驶动作以路径点序列表示。本文采用3.3节中提出的VLM条件扩散规划方法,但与latent空间扩散不同(如图2(b)所示),本文直接在动作空间进行扩散。
首先,通过对数据集进行K均值聚类,得到动作锚点,并从中初始化采样噪声。扩散Transformer 以带噪声动作和条件嵌入为输入,预测去噪后的轨迹和分类分数,数学表达式如下:其中,为条件嵌入,为时间戳。
训练过程中,对视觉编码器、视觉扩散Transformer、规划扩散Transformer以及LLM进行联合优化。为加快推理阶段的前向传播速度,模型无需显式生成中间步骤和图像,而是直接从环境token和提示中生成作为条件嵌入。在每个去噪步骤中,扩散Transformer将前一步预测的轨迹作为输入,并采用DDIM更新规则优化下一时刻的预测结果。
实验结果分析
本节首先介绍两个广泛使用的数据集:nuScenes数据集与Bench2Drive数据集;随后在这两个数据集上对所提方法进行评估,并与当前SOTA的VLA模型展开对比;此外,通过可视化分析阐释所提方法的有效性;最后在Bench2Drive数据集上开展消融研究,验证各模块的作用。
数据集
nuScenes数据集:nuScenes是自动驾驶领域用于感知任务与开环规划任务的多模态基准数据集,包含1000个时长20秒的场景(数据采集于波士顿与新加坡),标注频率为2Hz;数据集按700/150/150的比例划分为训练集、验证集与测试集。在此基础上,nuScenes-QA将其扩展为视觉问答(Visual Question Answering, VQA)基准数据集:通过生成场景图与多种问题类型(如目标存在性、数量统计、属性描述、特征对比),考察模型在多模态推理任务中的性能。
Bench2Drive数据集:Bench2Drive是用于闭环端到端自动驾驶的基准数据集,由上海交通大学Thinklab团队提出。该数据集基于CARLA V2仿真环境构建,可在交互式动态场景下全面评估自动驾驶系统的性能。为保证基线对比的公平性,Bench2Drive定义了包含1000个片段的基础数据集,通常按950/50的比例划分为训练集与开环验证集;每个片段对应特定交通场景下的连续驾驶路段(长度约150米)。Chat-B2D是在Bench2Drive基础上扩展的VQA数据集(由ORION提出),为Bench2Drive数据集中的每个驾驶场景自动生成“问题-答案”对,可在闭环仿真环境中评估模型的语义推理能力。
评估指标
- 在nuScenes数据集上开展开环评估,采用L2距离误差(衡量轨迹预测精度)与平均碰撞率(衡量驾驶安全性)作为评估指标。
- 在Bench2Drive数据集上同时开展开环与闭环评估,采用的评估指标包括:驾驶得分(Driving Score, DS)、成功率(Success Rate, SR)、效率(Efficiency)、舒适性(Comfortness) 及综合能力(Multi-Ability)。
与SOTA对比
nuScenes数据集对比:表1展示了当前主流端到端自动驾驶方法在nuScenes数据集上的性能(采用UniAD定义的评估指标)。CoT4AD取得了极具竞争力的结果:在1秒、2秒、3秒时域下的L2距离误差分别为0.12米、0.24米、0.53米(平均值为0.29米),显著优于OpenDriveVLA、EMMA等最新基于VLM的方法。安全性方面,CoT4AD的平均碰撞率低至0.10%,证明其轨迹预测的稳健性与可靠性。
值得注意的是,与需结合规划器轨迹的方法不同,CoT4AD仅以自车BEV(鸟瞰图)状态和相机图像为输入,却能持续实现比OmniDrive++更低的预测误差与碰撞率——这体现了所提“思维链(CoT)推理”的强大能力:可增强模型在复杂场景下的驾驶轨迹预测性能。

Bench2Drive数据集对比:表2展示了各类端到端自动驾驶方法在Bench2Drive基准数据集上的闭环评估结果。其中,“CoT4AD”代表模型直接端到端输出轨迹,“CoT4AD-CoT”代表模型通过分步思维链推理生成轨迹。
所提的CoT4AD与CoT4AD-CoT模型均取得了最优综合性能:具体而言,CoT4AD-CoT的驾驶得分(DS)高达81.22,成功率(SR)达55.78%,超过ORION、DriveTransformer-Large等强基线方法。在效率与舒适性方面,本文方法实现了性能平衡——与易产生“突发操控”的Transformer-based方法相比,CoT4AD的操控行为更平滑、更接近人类驾驶。
需特别说明的是,两种版本的CoT4AD均仅依赖相机输入和导航指令,却优于需额外结合激光雷达(LiDAR)或专家蒸馏信号的模型。这些结果充分证明:所提的思维链推理框架可增强决策一致性,提升模型在多样化场景下的驾驶可靠性。

定性结果
为进一步验证所提方法在复杂场景下的规划能力,本文将CoT4AD与UniAD进行定性对比。如图3所示,选取两个具有代表性的驾驶场景,每个场景包含3帧连续图像,以展示模型的决策过程:
- 场景1(避障变道):任务要求模型通过变道避开前方障碍物。两种方法均生成了合理的变道轨迹,但CoT4AD的轨迹更平滑、更连续,在第3帧中与障碍物保持了更大的安全距离。
- 场景2(超车机动):任务要求模型完成超车动作。UniAD未能提前识别超车意图,导致加速度不足、超车距离有限,无法安全完成超车;而CoT4AD可更早识别超车意图并主动规划,在保持较近跟车距离的同时平稳加速、变道,最终成功完成超车。

这一对比表明,CoT4AD具备更强的时序推理能力和高层语义理解能力,可实现更接近人类的“场景感知型”驾驶行为。综上,定性结果验证了所提“思维链推理”的优势:不仅提升了轨迹的平滑性和安全性,还增强了模型在复杂交通交互场景下的稳健性和决策可解释性。更多定性可视化结果及视频请参见附录。
消融研究
(1)感知Tokenizer的有效性:表3展示了各Tokenizer(令牌生成器)的详细消融结果。实验发现,基于感知标签的Tokenizer(ID 1和ID 2)可带来较强性能:例如,仅使用(地图Tokenizer)或(目标Tokenizer)即可显著提升成功率(SR),说明感知标签能为规划任务提供有价值的指导。
直接基于视觉特征的Tokenizer(ID 3 vs ID 4)也能取得较好性能,但效果弱于基于感知标签的Tokenizer(成功率50.88% vs 39.64%)。而将感知特征与视觉特征结合后,模型性能进一步提升,取得了最优闭环指标——这表明:尽管有限的感知标签可提供部分环境信息,但图像特征能保留更完整的语义信息,二者结合可增强模型的整体性能。

(2)思维链(CoT)设计的有效性:表4展示了思维链预训练各步骤的详细消融结果。移除基础感知模块(ID 1 vs ID 2)会导致驾驶得分(DS)和成功率(SR)显著下降(DS:66.44→59.89;SR:36.86%→27.95%),说明视觉感知特征对安全、有效的驾驶至关重要。类似地,移除VQA模块(ID 1 vs ID 3)也会导致性能下降(但降幅较小:DS 64.38→59.89;SR 33.22%→27.95%),表明视觉问答推理能为驾驶决策提供有用的上下文信息。
而“未来扩散模块”对性能的影响最大:仅启用该模块时(ID 4),模型的DS和SR均大幅提升(DS:72.38;SR:45.22%),这凸显了“预测未来状态”在闭环控制中的重要性。其原因可能是:与有限的标注标签相比,模型通过自监督学习从未来预测中获取了更丰富的感知表示。最终,结合所有模块的模型(ID 5)取得了最优性能(DS:80.24;SR:55.22%),证明感知、VQA推理、未来预测三者相辅相成,可共同提升驾驶性能。
(3)未来场景预测数量的有效性:图4展示了“预测未来场景数量”对模型性能的详细消融结果。当预测未来场景数量从0增加到8时,模型性能逐步提升,在“预测4个未来场景”时达到峰值(成功率55.78%);但当预测数量超过这一最优阈值后,模型性能开始下降——这是因为过多的未来信息会导致模型负载过重、引入混淆,进而降低成功率。该结果表明:“未来场景预测”的引入需兼顾“信息量”与“模型负担”,找到平衡至关重要。

结论
在本文中,我们提出了CoT4AD模型,该模型可在自动驾驶场景中实现显式思维链推理。通过采用“感知-视觉问答-扩散-规划”构成的多步推理流程,该模型在视觉空间、推理空间与动作空间间实现了更好的对齐,能够为驾驶任务提供更平滑、更精准的规划。在两个数据集上开展的实验表明,CoT4AD性能优于现有最先进方法,验证了所提方法的有效性。
尽管CoT4AD在显式推理下表现优异,但仍受限于多步思维链推理的计算复杂度以及扩散模型的训练不稳定性。在未来工作中,我们计划探索更高效的思维链推理机制,以实现实时自动驾驶。
...
#特斯拉为什么现在不选择VLA?
通往罗马道路千万条,但极简、极短的就那么一条
这次ICCV tesla分享了最新FSD技术,从技术架构看其实还是个大号端到端。VLA现在在机器人领域这么火,代表前沿、代表潮流,为什么tesla不选择VLA架构?FSD架构是不是已经落后了呢?
VLA源于早期google机器人使用VLM做为Backbone控制机器人操作,相当于是在VLM基础上增加了Action,缩写为VLA,这也形成了当今机器人领域的主流技术。
对比机器人和自动驾驶
1.任务目标:机器人可以定义为可以完成人类任意指令的机器,自动驾驶则是其中完成起点到终点任务的汽车。产品定义上不同则决定机器人不可能像自动驾驶端到端类似技术方案,它最重要的是要理解人类的语言指令并完成指令目标,对于通用的指令没有比Language更好的表征方式了。但自动驾驶不同,其指令目标就是导航,直接获取高德或是百度导航地图底层数据就可以快速知道怎么完成目标了,比用语言表征更加精确。
2.作业环境:自动驾驶只需要在确定的道路上按照规则行驶,场景相对单一,需要进行复杂拆解的任务少之又少。对于绝大部分司机来说,路怎么走、是加速还是减速,只是个本能反应,绝逼不会每次操作都用语言去分析和解释。需要分析的地方少之又少,即使不确定需要分析时候,车也是会停下来或是低速行驶的。这也是tesla提到只是特殊场景下调用vm模型类似人类的大小脑协作机制。如果一直是大脑工作,没有累死,一日三餐也是满足不了的。
3.硬件限制: 现有端侧硬件基本都没有超过1000 TOPS的,本身算力是捉襟见肘,一个是几B的语言模型基本不可用,连对话都是幻觉,更何况放到车端,对自动驾驶的安全绝对是挑战。从视觉转化到语言,再从语言转化到动作,纯粹浪费算力,拉长耗时。对于高速场景,百公里速度0.1s就已经跑出车道。
而Tesla则选择了快慢思考逻辑,端到端和VLM协同工作,绝大部分场景使用端到端完成,只是很少场景比如交规、非结构化道路场景,才会减速下来调用VLM 。兼顾了当前产品目标、运行环境和硬件限制。
...
#MPA
英伟达又一新作!MPA:基于模型的闭环端到端自适应策略新框架(CMU&斯坦福等)
英伟达最近工作很多啊,而且做的都挺扎实。前一段时间的自驾VLA框架 - Alpamayo-R1,昨天新的一篇闭环仿真测试框架 - MPA。
自动驾驶中的开环评测已经相对完善,但在闭环评测中仍然面临着级联误差和泛化能力不足的问题。针对这个问题,CMU、斯坦福和英伟达的团队提出一种基于模型的策略自适应通用框架 - Model-based Policy Adaptation。旨在提升预训练E2E驾驶智能体在部署阶段的鲁棒性与安全性。MPA首先利用几何一致的仿真引擎生成多样化反事实轨迹,让智能体接触到原始数据集之外的场景;基于生成的数据,MPA训练一个基于扩散模型的策略适配器以优化基础策略的预测结果,并训练一个多步Q值模型来评估长期收益。推理阶段,适配器生成多个轨迹候选,Q值模型则选择期望效用最高的轨迹。在nuScenes基准数据集上,通过重建出的真实闭环仿真器的实验表明,MPA在域内场景、域外场景及安全关键场景中均显著提升了性能。MPA进一步探究了反事实数据规模和推理阶段引导策略对整体效果的影响。
- 论文标题:Model-Based Policy Adaptation for Closed-Loop End-to-End Autonomous Driving
- 论文链接:https://arxiv.org/abs/2511.21584
- 项目主页:https://mpa-drive.github.io/
背景回顾
端到端(E2E)自动驾驶模型通过将感知、预测和规划集成到统一的学习框架中,取得了令人瞩目的进展。借助大规模离线驾驶数据集,E2E模型在开环评估协议下表现出色——在此类评估中,智能体仅需从离线记录的观测序列中被动预测未来行为。然而,些模型在闭环环境中性能会下降:微小偏差随时间累积,导致误差叠加、分布偏移,并难以泛化到长时域场景。这种性能差距揭示了一个核心挑战:基于经验风险最小化的离线训练,与最大化累积奖励的在线目标并不一致(如图1所示)。

为弥合这一差距,近期研究开始关注E2E智能体的闭环性能评估。部分开环方法(如NavSim)通过在开环评估中引入预测驾驶模型评分(Predictive Driver Model Score),实现了近似闭环评估。其他研究则为闭环评估引入了传感器仿真技术,基于扩散模型、神经辐射场(NeRF)或3D高斯溅射(3DGS)生成相机视图,支持对新视角的照片级真实感渲染。这些工具能对智能体干预和视觉真实性进行细粒度控制,成为研究失效模式和恢复策略的理想测试平台。现有工作(如VAD、VAD-v2和Hydra-MDP)设计了不同的评分机制来选择用于闭环控制的预测运动,但这些工作要么缺乏闭环评估结果,要么仅在非照片级真实感仿真器(如CARLA)中进行评估。最新的RAD结合了强化学习,并利用3DGS进行在线轨迹推演和评估,但近端策略优化(PPO)智能体的训练成本较高,且价值评判器在推理阶段未被充分利用。在所有现有尝试中,尚无任何工作在训练阶段纳入经过筛选的反事实数据。
本文的目标是借助基于3DGS的驾驶仿真数据引擎,将真实场景下预训练的开环E2E驾驶智能体,适配为安全且具有泛化能力的闭环智能体。我们发现,闭环与开环评估之间的性能下降源于两个根本原因:(1)观测不匹配——训练阶段的传感器输入,与部署阶段不同数据引擎产生的扰动行为下的闭环观测之间存在差异;(2)目标不匹配——离线模仿学习过程中缺乏有意义的奖励反馈,限制了智能体的长时域推理能力。
我们通过初步实验证明,开环评估中第一种不匹配的影响实际上较小。为此,我们提出一种统一解决方案——基于模型的策略自适应(MPA),该通用框架通过分离并针对两类不匹配的根本原因,直接解决上述问题。首先,我们将预训练策略作为行为策略的初始化,利用高保真3DGS仿真引擎生成反事实数据集。为缓解观测不匹配,我们设计了一种基于扩散模型的残差策略适配器,以多样化的反事实轨迹为条件进行训练,使策略能够接触到离线数据集之外的广泛行为和视觉场景。为解决目标不匹配,我们从相同的反事实数据中学习Q值模型,该模型能够捕捉长时域结果,并支持超越规则化指标的基于价值的评估。MPA在推理阶段同时利用这两个组件:策略适配器基于当前观测生成残差动作建议,价值模型通过推理阶段的缩放选择期望效用最高的动作。
本文的贡献主要体现在三个方面:
- 分析了E2E智能体闭环性能下降的根本原因,并评估了基于3DGS的仿真在建模观测和行为偏移方面的保真度;
- 提出了一种基于3DGS轨迹推演的系统性反事实数据筛选流程,并训练了包含基于扩散模型的策略适配器和奖励模型的MPA,分别解决观测不匹配和奖励不匹配问题;
- 在nuScenes基准上验证,利用所学奖励模型进行推理阶段scaling,显著提升了闭环性能,尤其在安全关键场景和域外场景中效果突出。
预备知识
端到端自动驾驶的问题建模
我们将闭环端到端(E2E)驾驶建模为部分可观测马尔可夫决策过程,其形式化定义为,其中各参数含义如下:为潜在状态空间,为动作空间,为转移动力学,为奖励函数,为观测空间,为折扣因子,为规划时域。在每个时间步,智能体接收观测并输出轨迹动作;环境根据转移概率演化,并通过观测模型生成观测结果。
在实际场景中,状态包含自车的惯性测量单元(IMU)状态以及周围道路实体的历史位姿和运动意图,但这些信息通常仅能部分观测。动作表示未来的一系列路径点,需通过线性二次调节器(LQR)控制器转换为底层油门和转向控制序列,该过程遵循现有基准方法的设计。观测可由真实传感器采集,或在闭环评估中由仿真引擎渲染生成。
值得注意的是,当前开环E2E智能体的训练依赖于参考行为策略的专家轨迹,由此产生状态分布并得到有监督模型。与之不同,闭环智能体的目标是最大化长期累积奖励,即: (注:原文此处公式未完整显示,核心逻辑为闭环目标函数与开环模仿误差最小化的对比)
这一差异导致了固有目标不匹配:开环训练通过专家监督最小化模仿误差,而闭环部署则需在动态演化和部分可观测条件下优化长时域奖励(如图1所示)。弥合这一差距需对式(1)中的三个组件进行精细对齐:
- 转移模型:可通过车辆动力学进行一致性近似;
- 观测模型:可能与仿真传感器的观测模型存在偏差;
- 奖励函数:需通过学习到的价值模型从部分观测中推断。
为解决上述不匹配问题,我们利用基于3D高斯溅射(3DGS)的观测模型生成反事实数据,进而设计策略适配器,将预训练模型转换为在学习到的Q值模型引导下与奖励对齐的策略,具体框架如图1所示。
闭环仿真中的端到端驾驶智能体
近年来,一类研究方向利用视觉生成模型或重建模型,基于状态参数化渲染照片级真实感驾驶场景,其技术基础包括图像扩散建模、神经场渲染和3D高斯溅射(3DGS)等。这类方法本质上是在POMDP框架中学习观测模型的估计。但关键在于,需验证这些模型输出的视觉质量是否接近真实场景——只有满足这一条件,它们才能作为闭环评估的有效代理。
我们通过初步实验分析了闭环仿真器的保真度,并验证了开环与闭环评估之间的性能差距。在图2中,我们系统对比了两种评估设置下运动预测的L2误差:利用3DGS从nuScenes数据集重建场景,并结合真实轨迹(Ground Truth)数据进行性能比较。结果显示,三种E2E策略在开环运动预测中的性能极为接近,这证明了基于3DGS的仿真在场景重建质量上的高保真度。同时,我们还展示了基于UniAD的闭环轨迹推演(rollout)轨迹的L2误差:随着预测时域延长,闭环预测误差较开环预测显著增大。短预测时域内不可忽略的L2误差会导致分布偏移问题,进而引发误差累积;而单纯提高规划频率或缩短规划时域,并不能弥合开环与闭环的性能差距——除非为E2E智能体提供有效的反馈引导。

所提方法:基于模型的策略自适应(MPA)
为解决2.1节所述的观测不匹配和目标不匹配问题,我们提出基于模型的策略自适应(Model-Based Policy Adaptation, MPA)——一种用于端到端(E2E)自动驾驶从开环到闭环适配的统一框架,其整体结构如图3所示。

基于世界模型的反事实数据生成
我们利用几何一致的3D高斯溅射(3DGS)仿真器生成反事实样本,该仿真器可根据自车和周围智能体的位姿渲染照片级真实感观测,从而建模观测分布。如前文所示,只要轨迹推演策略所诱导的状态分布与参考分布接近,该仿真器的渲染结果就能保持高保真度。
为在保证观测可靠性的同时引入行为多样性,我们对预训练E2E策略的预测动作进行随机增强(包括旋转、扭曲和随机噪声),得到噪声策略。增强后行为的分布如图4所示,具体轨迹增强参数设置如下:旋转角度范围为[-10, 10](单位:度),扭曲比例范围为[0.1, 1.0],随机高斯噪声的标准差为0.05。根据旋转角度和扭曲比例的不同,这些增强轨迹会被划分为不同模态,以适配多模态策略适配器。

在教师强制(teacher-forcing) 设置下,我们从每个驾驶场景的原始参考状态初始化轨迹推演,并执行反事实轨迹推演。为缓解随推演时域延长而呈指数级增长的搜索空间,我们借鉴波束搜索算法(beam search algorithm),仅保留仿真器通过规则化启发式计算得到的累积奖励最高的候选轨迹(奖励的具体定义见附录A)。这种“提议-评分-选择”流程在现有研究中也被用于缓解运动规划器的“预测-规划失配”问题。
为避免渲染伪影,我们丢弃两类轨迹:一是偏离参考轨迹距离超过阈值的轨迹,二是奖励低于最小值的轨迹。轨迹推演时域决定了反事实行为的未来延伸长度——实验表明,更长的时域能为下游学习提供更丰富的监督信号,但也会增加轨迹偏离参考数据的风险。
完整的反事实数据生成流程总结于算法1(Algorithm 1)。在获得生成的反事实数据集后,我们将在后续小节中开展策略学习和价值学习。

基于扩散模型的策略自适应
如图4所示,生成的反事实动作呈多模态分布。为捕捉这类动作特征,我们提出基于扩散模型的策略适配器:通过预测残差轨迹,对冻结的端到端(E2E)驾驶模型的输出进行优化。其中,是预训练策略(如UniAD)输出的轨迹,是从反事实轨迹推演数据集中筛选出的奖励最高的轨迹样本。
训练过程:为建模残差轨迹的分布,我们采用潜扩散过程(latent diffusion process)。前向过程通过步添加高斯噪声实现:设(初始残差轨迹),为累积噪声调度因子,则第步的带噪残差轨迹为:
其中是标准高斯噪声。
去噪网络采用1D U-Net结构,以带噪残差轨迹为输入,输出多模态的初始残差轨迹,其条件输入包括:场景编码(为观测,为自车状态)、自车历史,以及基础预测轨迹。去噪网络的输出包含个模态,第个模态表示为。网络训练采用以下损失函数(基于前向过程的噪声预测): (注:原文未完整列出损失函数公式,核心为最小化预测噪声与真实噪声的均方误差,即)
推理过程:推理阶段采用DDIM(Denoising Diffusion Implicit Models)方法采样初始残差轨迹,并恢复适配后的最终轨迹:
该设计通过将预训练基础策略的场景上下文和基础动作作为条件输入,实现了对预训练知识的适配,从而使策略能够泛化到反事实数据域之外的场景。
Q值引导推理时间采样原理
训练过程:尽管在可完整获取状态的情况下可计算单步奖励,但在部分可观测条件下估计长时域收益仍具挑战性。为此,我们利用生成的反事实数据集,训练多步动作价值模型(即Q值模型),其设计基于四个可解释原则:
- :路径跟随(衡量自车沿规划路径的推进程度);
- :车道距离(衡量自车与车道边界的距离合规性);
- :避撞(衡量自车与周围实体的碰撞风险);
- :速度合规(衡量自车速度与限速的匹配程度)。
每个Q函数均独立训练,输入为,输出为对应原则下的累积收益。最终综合Q值为各单原则Q值的加权和:
其中权重的设计参考现有研究。
推理过程:推理阶段,首先按照前文的策略适配器推理流程采样残差动作,再通过以下方式选择最优动作提议: (注:原文未完整列出选择公式,核心逻辑为选择综合Q值最高的动作,即)
与基于分类器的奖励引导相比,我们的Q值引导具有两大优势:一是能纳入更长规划时域的反馈信息,二是避免了奖励模型的梯度不稳定性。
实验结果分析
本章通过实验解答以下研究问题(RQ):
- RQ1:与基线模型相比,MPA能否为E2E驾驶智能体在闭环评估中带来具备泛化性的性能提升?
- RQ2:MPA在闭环评估的安全关键场景中性能表现如何?
- RQ3:MPA中的不同适配器与价值引导模块对整体性能的贡献分别是什么?
- RQ4:在数据生成阶段,反事实规划步数的规模如何影响MPA的性能?
实验设置
数据集与仿真引擎:我们采用nuScenes数据集,该数据集包含波士顿和新加坡地区共5.5小时的驾驶数据,每个场景均有20秒的参考轨迹。仿真与评估基准采用HUGSIM,训练过程使用nuScenes训练-验证集中的290个场景,评估分为三类设置:
- 域内评估:测试集为70个场景,场景中动态实体(车辆、行人)的运动轨迹按离线数据集中参考轨迹的固定比例回放;
- 未见过的常规场景评估:测试集为70个训练阶段未接触过的场景,动态实体运动轨迹同样按参考轨迹固定比例回放;
- 安全关键场景评估:测试集为10个场景,场景中包含一个(或少量)干扰性非原生智能体,用于对自车智能体形成对抗性挑战。
仿真频率设为4Hz,闭环仿真终止条件包含以下五种:(1)完成全部路线;(2)驶离道路;(3)发生碰撞;(4)偏离参考轨迹过远;(5)达到最大推演时间限制(50秒,为参考轨迹时长的2.5倍)。
基线模型:我们将MPA与两类E2E驾驶算法基线进行对比:
- 开环训练的预训练基础策略:对比UniAD、VAD、LTF在HUGSIM数据集上的性能,并基于这些策略构建MPA模型;
- 基于筛选后反事实数据集训练的E2E智能体:
- AD-MLP:以自车速度、加速度、历史轨迹和高层指令为输入,是闭环驾驶任务的基础基线;
- BC-Safe:利用反事实数据集中的安全片段训练E2E策略;
- Diffusion:参考的场景编码方式,推理阶段采用基于DDIM的采样器(而非截断去噪)。
为保证公平对比,所有方法均采用预训练ResNet作为感知backbone,用于编码6个视角相机的RGB输入;自车状态包含速度、加速度及历史帧中的导航路标信息。
评估指标:评估协议遵循HUGSIM[13](参考NAVSIM[22]的指标设计),具体指标如下(所有指标取值范围为[0.0, 100],数值越高性能越好,表格中均已乘以100):
- RC(Route Completion,路线完成率):衡量自车在发生严重失效(碰撞、驶离道路等)前沿规划路线的推进程度;
- NC(Non-Collision,无碰撞率):评估自车与周围静态/动态实体无责任碰撞的概率(注:HUGSIM中3DGS模型可能因点云不一致对车辆包围盒进行侵蚀处理,导致部分“近距避让”被误判为碰撞,因此NC值可能被低估);
- DAC(Driveable Area Compliance,可行驶区域合规率):若自车位姿落在地面点云内的面积占比<0.3,判定为违规(DAC=0);占比在0.3~0.5之间时DAC=50;占比>0.5时DAC=100;
- TTC(Time-To-Collision,碰撞时间合规率):若未来0.5秒内(不同于NAVSIM的0.9秒)自车将发生碰撞,TTC=0;否则TTC=100;
- COM(Comfort,舒适性):若纵向/横向加速度、横摆率、横摆加速度及纵向加加速度均低于阈值,COM=100;否则为0;
- HDScore(HUGSIM驾驶评分):基于上述指标的加权和,与NAVSIM不同,HDScore采用RC(而非Ego Progress,自车进度)作为核心权重项,具体计算方式见附录B.1。
主要结果与分析(RQ1、RQ2)
域内与域外场景性能:为解答RQ1,我们首先评估MPA在域内和域外场景的闭环性能(所有MPA模型推理时均采用20个动作样本)。域内场景指新加坡地区用于生成反事实训练数据的场景,定量结果如表1所示。基于MPA的E2E驾驶智能体相较于其预训练版本(如UniAD、VAD、LTF)以及三种基于筛选后反事实数据集训练的基线方法(AD-MLP、BC-Safe、Diffusion),均取得了更优的结果,尤其在关键指标RC和HDScore上提升显著。
其中,基线模型AD-MLP的行驶策略极为保守,虽能维持较低的碰撞风险(NC和TTC指标尚可),但路线完成率极低(RC仅13.4),难以完成复杂E2E场景的导航任务。此外,HUGSIM中的NC值相较于NAVSIM偏低,原因如前所述(3DGS对车辆包围盒的侵蚀导致误判),但多数“误判碰撞”并不会导致闭环仿真episode终止,因此部分模型虽NC值中等,仍能通过合理规避碰撞和驶离道路行为完成路线导航,最终获得较高的HDScore。

我们进一步在域外场景(波士顿地区未纳入反事实数据集的70个场景)中评估性能,定性结果如图6(左)所示。与表1的域内结果相比,AD-MLP和Diffusion的性能显著下降,而预训练E2E策略在域内与域外场景中的性能表现相近;值得注意的是,基于预训练E2E策略构建的MPA智能体在域外场景中仍保持最优性能,且三类MPA变体(MPA(UniAD)、MPA(VAD)、MPA(LTF))的HDScore与域内评估结果相当,这证明了所提适配器和价值模型在未知场景下的泛化能力。

安全关键场景性能:为解答RQ2,我们在包含对抗性干扰智能体的安全关键场景中进行评估,定量结果如表2所示。MPA模型在该场景下的性能提升尤为显著:以MPA(VAD)为例,其RC达到96.6,HDScore高达74.7,远超预训练VAD的RC(25.4)和HDScore(16.0);即使是性能最差的MPA(LTF),其HDScore(56.3)也约为预训练LTF(24.2)的2.3倍。

定性结果如图5所示:在“右侧车辆切入”的安全关键场景中,预训练VAD策略无法有效应对,而MPA适配后的策略在Q值模型引导下,能够成功制动并避让切入车辆,验证了MPA在安全关键场景中的有效性。

消融研究(RQ3、RQ4)
我们通过消融实验分析MPA三大核心模块的贡献:(1)反事实数据集生成;(2)策略适配器;(3)Q值引导。
反事实数据集的影响(RQ4:我们通过消融反事实数据生成过程中的轨迹推演步数(即算法1中的),分析其对MPA性能的影响。实验在波士顿域外场景中进行,结果如图6所示:随着反事实推演步数的增加,MPA的各项评估指标(尤其是RC和HDScore)均呈上升趋势。这是因为更长的推演步数能为价值函数训练提供更丰富的未来步监督信号,帮助Q值模型更准确地评估长时域收益。
策略适配器的影响(RQ3):表3展示了基于UniAD基础策略的MPA变体消融结果(VAD和LTF的消融结果见附录B)。对比ID-5(无适配器)与ID-6(有适配器)的结果:在安全关键场景中,适配器使RC提升约20%,HDScore显著提高,证明适配器能有效优化基础策略的动作输出;在域外常规场景中,适配器同样提升了路线完成率(RC从91.1升至93.7)。

此外,我们还分析了策略适配器的模态数量对安全关键场景性能的影响(图7):模态数量从1增加到8时,RC、DAC和HDScore均显著提升;当模态数量超过8后,性能提升趋于平缓。这表明适当增加模态数量能覆盖更多反事实行为模式,但过量模态并不会带来额外增益。

Q值引导的影响(RQ3):表3中通过移除Q值模型的不同组件(、、、),分析各组件的作用:
- 移除(ID-1):RC急剧下降(域外场景从91.1降至6.9,安全关键场景从75.6降至4.6),HDScore近乎归零,证明路径跟随是Q值模型的核心组件;
- 移除(ID-2):DAC和NC显著下降(域外场景DAC从94.1降至81.0),说明车道距离约束对保证行驶区域合规性至关重要;
- 移除(ID-3):安全关键场景中RC下降明显(从75.6降至57.7),原因是智能体易因碰撞提前终止episode;尽管NC值看似较高,但这是由于碰撞前的有效帧长度缩短(分母变小)导致的统计偏差;
- 移除(ID-4):COM略有下降,TTC轻微受损,HDScore随之降低,表明速度合规性对驾驶舒适性和安全性有一定影响。
上述结果验证了Q值模型各组件的必要性,且路径跟随和避撞是保障闭环安全与性能的关键原则。
结论
工作总结
本文提出基于模型的策略自适应(MPA) 框架,旨在提升端到端(E2E)自动驾驶智能体的闭环可靠性。MPA的核心流程如下:
- 反事实数据生成:利用几何一致的3D高斯溅射(3DGS)仿真环境,生成高质量反事实轨迹,在保证视觉保真度的同时扩大数据覆盖范围;
- 策略与价值模型训练:基于反事实数据集,训练两种核心模块——(1)基于扩散模型的策略适配器,用于优化基础策略的预测结果;(2)多原则价值模型(Q值模型),用于引导推理阶段的决策;
- 闭环推理:适配器生成多个轨迹候选,价值模型选择长时域收益最优的动作,使预训练智能体能应对复杂闭环场景。
在nuScenes数据集和HUGSIM基准上的实验表明,MPA在域内场景、域外场景及安全关键场景中均显著提升了E2E智能体的性能,验证了其安全性与泛化性。
局限性与未来工作
尽管MPA取得了较好的效果,仍存在以下局限性:
- 3DGS渲染依赖:MPA假设3DGS在受限轨迹偏差下能提供可靠渲染,但当轨迹严重偏离参考分布时,渲染质量可能下降;
- 价值与策略分离:当前MPA将价值建模与策略优化解耦,未实现两者的联合优化;
- 场景覆盖范围:实验仅基于nuScenes数据集,未扩展至更多驾驶场景(如极端天气、复杂路口)。
未来工作将围绕以下方向展开:
- 数据集扩展:将MPA应用于更多多样化驾驶数据集,验证其跨场景适应性;
- 在线强化学习集成:探索在3DGS仿真器中引入在线强化学习(RL),实现价值模型与策略适配器的联合训练;
- 多模态基础模型融合:将MPA部署到多模态基础模型中,增强其对严重分布偏移场景的推理能力,进一步提升闭环鲁棒性。
...
#GuideFlow
轻舟智航最新GuideFlow:端到端轨迹规划新方案
今年学术界和工业界很大的精力都投入在Action的建模上,也就是自车轨迹的输出。先前的MLP只能输出单模的轨迹,实际使用中无法满足下游不确定性的需求。所以从去年开始,我们看到了生成式的很多算法问世。
经过这一年的发展,生成式的算法进一步收敛到Diffusion和Flow matching两个方向上。xxx了解到上半年有不少公司都在尝试将这两种方法落地量产,期间坎坷无需多言。
今天为大家分享的是一篇北交&轻舟智航等团队最新的工作,提出一种基于Constrained Flow Matching的新型规划框架GuideFlow,整体效果还不错。
具体而言,GuideFlow显式建模流匹配过程,该过程本质上可缓解模态坍塌的问题,并能灵活融合多种条件信号的引导。本文的核心贡献在于,将显式约束直接嵌入流匹配生成过程,而非依赖隐式约束编码。关键创新点在于,GuideFlow将流匹配与Energy-Based模型的训练相统一,增强模型自主优化能力,以满足物理约束。其次,GuideFlow将驾驶激进度参数化为生成过程中的控制信号,实现对轨迹风格的精准调控。在主流驾驶基准数据集(Bench2Drive、NuScenes、NavSim和ADV-NuScenes)上的大量实验验证了GuideFlow的有效性。值得注意的是,在NavSim测试集的高难度子集(Navhard)上,GuideFlow取得了当前最优(SOTA)性能,其扩展PMD分数(EPDMS)达到43.0。
- 论文标题:GuideFlow: Constraint-Guided Flow Matching for Planning in End-to-End Autonomous Driving
- 论文链接: https://arxiv.org/abs/2511.18729
一、背景回顾

近年来,端到端自动驾驶(E2E-AD)已成为传统模块化流水线的一种极具吸引力的替代方案。与单独优化感知、预测和规划模块不同,端到端自动驾驶将整个驾驶过程构建为一个可微分的统一系统,能够通过数据进行整体训练。以UniAD为代表的框架便是该方向的典型范例,其将空间感知、在线建图、运动预测和控制决策等功能耦合在一个连贯的架构中。这种联合范式支持跨任务推理,有效减轻了分阶段设计中常见的级联误差问题。其中,规划模块的核心作用是预测可行的、面向目标的轨迹,最终决定车辆的行驶行为。
近年来,端到端自动驾驶规划技术已从单模态轨迹生成向多模态轨迹生成演进,以更好地反映真实驾驶场景中的固有不确定性。在许多场景中,往往存在多种合理的驾驶意图,但单模态端到端自动驾驶规划器仅能输出一条确定性路径,限制了系统的鲁棒性。相比之下,多模态端到端自动驾驶规划方法会预测多条候选轨迹,提供更丰富的意图表达。然而,如图1所示,这些方法大多仍基于模仿学习(IL)进行训练。由于每个驾驶场景仅提供一条真实轨迹(GT),模型学习到的多模态输出往往会向单一主导模式收敛——尽管名义上具备多样性,但最终预测结果高度相似。这种现象被称为模式崩溃。为缓解模式崩溃问题,近期研究探索将生成式建模用于轨迹规划。生成式方法(流匹配和扩散模型)旨在表征可行未来轨迹的完整分布,通过迭代采样自然实现多样化的轨迹假设。尽管生成式方法提升了多模态轨迹预测性能,但采样过程中固有的随机性和高方差,给保证生成轨迹满足严格安全约束带来了根本性挑战。当前方法极少探索在生成过程中融入显式的风格引导和安全引导以确保约束满足,这给系统的可靠部署带来了难题。
为解决上述问题,本文提出GuideFlow框架——一种基于流匹配架构、生成过程受显式监督的规划模型。GuideFlow从随机采样出发,通过多样化的条件信号引导生成过程,从而缓解模式崩溃问题。其核心创新在于将安全约束直接嵌入生成过程的策略:(1)速度场约束(CVF):采用预定义的、满足约束的速度场,主动修正模型预测的速度场,引导结果满足约束;(2)流状态约束(CF):对偏离约束的流路径进行修正,使流路径朝向满足约束的生成终点演进;(3)EBM流优化(RFE):通过统一流匹配架构与能量基模型(EBM),赋予模型在数据流形内自主探索的能力,使其能够“发现”满足约束的结果。本文的贡献如下:
- 提出一种基于流匹配的多模态轨迹规划器GuideFlow,有效缓解模式崩溃问题。其核心创新在于在流匹配过程中施加显式硬约束,并结合EBM提升轨迹的可行性;
- GuideFlow将环境奖励作为条件信号,在推理阶段支持激进驾驶与保守驾驶风格的灵活切换;
- 在自动驾驶数据集(NuScenes、ADV-NuScenes、NavSim和Bench2Drive)上的大量实验验证了其优异性能。值得注意的是,在NavSim测试集的高难度子集(Navhard)上,GuideFlow取得当前最优结果,EPDMS分数达43.0。
二、预备知识
Flow Policy and Rectified Flow:本文首先将规划问题建模为基于流的轨迹生成问题,该方法通过学习一个向量场,将简单的高斯先验分布映射到目标轨迹分布。设沿概率路径遵循如下常微分方程(ODE)演化:
其中是可学习的向量场。该模型的一种常见实现形式是修正流(Rectified Flow, RF)。修正流在先验分布与目标分布之间构建线性概率路径,即样本满足。在此设定下,流匹配的学习目标定义为:
该目标函数能高效学习朝向数据流形的直线映射。在推理阶段,通过数值积分生成轨迹,且需满足:
这种形式可实现快速稳定的采样,但直线映射路径本质上具有“模式趋同”特性,往往会收敛到主导性的驾驶模式。
能量匹配:近期提出的“能量匹配”(Energy Matching)方法引入能量函数,使流模型能够恢复多个可行模式。其动力学公式的最优条件满足:在数据流形附近,映射项消失(因),此时式(4)可简化为终端分布满足玻尔兹曼形式:
其中,能量权重调度函数控制系统从纯流映射过渡到能量引导的流形优化,具体定义为:
由此,将数据流形塑造为多个低能量“盆地”,每个盆地对应一种独特的可行模式(如“让行”“合流”)。在采样阶段,离散化更新需引入离散调度器:实际上,在$0<t<1$阶段,流项将样本高效映射至轨迹流形;而当$t ≥\tau^{*}$时,能量项激活,引导样本进入不同的低能量模式。这为guideflow优化过程中确保多模态多样性提供了理论基础。<="" p="">
三、GuideFlow算法详解
本文提出的GuideFlow框架如图2所示,其本质是一种基于流的轨迹生成器,可生成可行且安全的未来运动规划。该模型包含三个核心模块:(i) 感知条件速度场生成器;(ii) 无分类器引导(在采样阶段注入驾驶意图与风格);(iii) 安全约束采样过程(通过截断与基于能量的动力学在数据流形附近运行,具体包括“速度场约束(CVF)”“流状态约束(CF)”和“EBM流优化(RFE)”三种策略)。

感知条件流生成器
如图2所示,GuideFlow首先解码理想速度场,并采样可行的未来轨迹,具体流程如下:
感知到场景令牌的映射:给定多视角图像,先提取图像特征,并将其提升为鸟瞰图(BEV)表示。感知模块通过查询该BEV特征,生成两组结构化令牌:(1) 智能体令牌(编码动态智能体间的交互关系);(2) 地图令牌(嵌入道路与车道拓扑结构)。
流状态与条件建模:将时刻的轨迹表示为流状态(见式(2)),其中为预测时域。为使速度场适应场景条件,需将映射为latent表示(为正弦时序嵌入),随后执行序列交叉注意力操作:

最终,通过解码速度场采样未来驾驶轨迹:
Classifier-free Intent与奖励引导
GuideFlow通过将轨迹生成过程与多个表达意图和风格的动态元素关联,实现高层驾驶行为建模。具体而言,模型考虑四种动态条件信号:(1) 规划锚点;(2) 目标点;(3) 驾驶指令;(4) 塑造轨迹偏好的奖励(详见4.4节)。需注意:驾驶引导信号、、在语义上存在重叠,因此不会同时使用。
实现细节:
- 规划锚点构建:通过对训练集执行最远点采样,构建规模为的轨迹词汇表。训练阶段,选择与真实轨迹(GT)最接近的规划锚点作为;采样阶段,GuideFlow通过对中每个锚点施加条件,生成条轨迹,从而获得多样化的候选运动。
- 目标点生成:目标点由选定的规划锚点推导得出,训练与推理阶段均采用与规划锚点一致的处理策略。
- 驾驶指令编码:将驾驶指令编码为独热向量(one-hot vector)以进行后续处理。
Classifier-free Intent引导训练:采用无分类器引导训练框架,对条件输入以概率进行掩码(记为):
其中表示交叉注意力融合模块。随后预测条件速度场:。在采样阶段,通过引入引导尺度,控制条件信号对运动的影响强度。
约束生成
尽管感知条件与意图引导共同实现了多样化且目标一致的运动假设,但二者本身无法保证轨迹的物理可行性与安全性。结合式(3)和式(8)的采样过程可知,每条轨迹的更新同时依赖于:(1) 速度场;(2) 前一流状态;(3) 优化阶段()的能量项。基于这一洞察,本文提出以下三种互补约束机制(如图3所示)。

速度场约束(CVF):首先,引导预测运动方向与满足约束的参考方向对齐。根据物理或安全约束,从轨迹锚点集中手动选择可行轨迹,或采用预训练评分器(如GTRS)选择约束满足概率最高的轨迹。该轨迹对应的速度场为(即与间的线性速度场)。尽管这种方向设定可能并非最优,但能确保流终点满足约束。为平衡约束合规性与运动合理性,构建修正后速度场:
其中设置为0.1,(为简化表述)。式(14)的核心目标是在最小化对速度大小影响的前提下,调整的方向。相关证明详见附录。
流状态约束(CF):速度场修正虽能对齐整体运动方向,但在积分过程中,流轨迹仍可能偏离约束流形。设从到的连续流为,根据离散时序将其离散化为序列:
其中设置为100。若生成轨迹无法满足约束,可认为偏离了理想流。一种直接的修正方式是在每个时序步手动调整以满足约束,但这种方法会严重干扰采样过程且效率低下。为此,GuideFlow采用类截断策略:直接用满足约束的锚点替换接近目标真实轨迹的离散变量,并从该点继续采样,即(实际中设置为50)。与DiffusionDrive在训练阶段使用截断策略不同,GuideFlow仅在推理阶段激活该机制,以保留模型在测试时的适应性。这种后期修正可确保轨迹终止于可行区域,同时不破坏已学习的映射动力学。
EBM流优化(RFE):为进一步将约束执行融入生成过程,本文将其直接嵌入能量图景。基于式(8),将时的流匹配模型解释为能量基模型(EBM),该模型既鼓励样本收敛到低能量区域,又确保其满足约束。据此,定义能量代理函数:
其中表示式(3)中的采样算子,参考的方法评估约束满足度(如道路合规性、碰撞惩罚)。上述为可行轨迹分配较低能量,为违反约束的轨迹分配较高能量,从而使速度场在训练过程中隐式学习约束感知能力。
遵循EBM训练范式,定义训练目标(表示模型在时生成的终点,为目标真实轨迹):该目标函数的核心作用是提升违反约束样本的能量,同时降低满足约束样本的能量,从而引导速度场向约束满足概率更高的区域优化。
奖励作为风格条件
为在推理阶段动态调整轨迹激进度,本文基于NavSim数据集引入激进度评分(EP)——定义为单位时间内沿车道中心线行驶的距离,取值范围为[0,1]。该评分针对每条真实轨迹(GT)在线计算,并作为条件输入融入模型。通过调节EP值,可直接控制生成轨迹的激进度:实际中,当推理阶段将EP设置为接近1时,模型会生成更具激进性的驾驶行为。
实验结果分析实验设置
数据集与评价指标:
- 开环测试:在NuScenes(简称NuS)和ADV-NuScenes(简称ADV-NuS)两个数据集上对GuideFlow进行评估。其中,NuScenes数据集包含1000个驾驶序列,每个数据样本涵盖6张图像和点云数据,可提供360°视野;本研究仅将图像数据作为模型输入。ADV-NuScenes数据集包含150个物理可行的对抗性驾驶场景,共6115个样本,涵盖多种激进驾驶行为。对于NuS和ADV-NuScenes数据集,研究用碰撞率(Collision Rate) 替代L2距离作为唯一评价指标。
- 闭环测试:在NavSim和Bench2Drive两个数据集上评估GuideFlow。Bench2Drive是基于CARLA排行榜2.0的端到端自动驾驶闭环评估协议,提供官方训练集(本研究使用基础集的1000个片段,以确保与其他基线模型的公平对比),评估采用官方提供的220条路线。NavSim是基于OpenScene构建的规划基准数据集,整合了多视角相机和激光雷达(LiDAR)数据以实现360°感知,标注频率为2Hz,包含高清地图(HD maps)和目标边界框;该数据集采用无反应仿真(non-reactive simulation)和闭环评估方式,可对规划性能进行全面评估。对于Bench2Drive,研究遵循其数据集设置,采用驾驶分数(Driving Score, DS) 和成功率(Success Rate, SR,单位:%) 作为评价指标;对于NavSim,采用其提出的扩展PMD分数(Extended PMD Scores, EPDMS) ——一种加权组合型指标——作为评价标准。
实现细节:研究在四个不同基准数据集上验证了GuideFlow的性能,通过统一训练协议和基线模型确保对比公平性,具体设置如下:
- NavSim数据集:以TransFuser为基线模型,在NavTrain子集上训练100轮(学习率LR:);采用GTRS-Dense(基于v2-99 backbone)评分模型选择多模态轨迹。
- NuScenes数据集:基于SparseDrive(700个训练场景)实现,遵循其两阶段训练协议;GuideFlow以第一阶段的感知模型为初始模型,微调8轮(学习率LR:)。需特别说明:ADV-NuScenes数据集仅用于域外(OOD)评估,不参与任何训练过程。
- Bench2Drive数据集:以Hydra-Next为基线模型,将其轨迹生成模块替换为GuideFlow后,对整合后的模型训练20轮(学习率LR:)。更多实现细节详见附录。
主要结果
闭环结果:如表1所示,在NavSim数据集的Navhard高难度子集上:
- 未使用评分器(No Scorer)时,GuideFlow的EPDMS得分为27.1,在多数指标上优于无评分器的基线模型(如LTF、GTRS-DP),体现了其在无辅助评分情况下的稳健规划能力。
- 集成评分器(Scorer)后,GuideFlow创下当前最优(SOTA)性能,Navhard子集的EPDMS得分达43.0,较此前最佳结果提升1.3分。

如表2所示,在Bench2Drive数据集上:
- GuideFlow的驾驶分数(DS)达75.21,成功率(SR)达51.36%,优于多数端到端自动驾驶基线模型。相比基于专家知识蒸馏的方法(如ThinkTwice、DriveAdapter)及Hydra-Next基线模型,GuideFlow在闭环稳健性和决策稳定性上展现出显著优势。

Bench2Drive和NavSim数据集上的性能提升,证实了将约束机制融入生成过程的有效性——该设计可直接转化为规划与驾驶关键指标的提升。这些跨数据集的一致性能增益,源于GuideFlow将安全约束直接嵌入轨迹生成过程的核心能力,进而系统性地改善了EPDMS等关键规划与驾驶指标。
开环结果:在开环数据集(NuScenes、ADV-NuScenes)上,由于传统L2距离无法合理评估非模仿类方法,研究仅以碰撞率作为评价指标。如表3所示:
- GuideFlow在所有预测时域下均实现最低碰撞率,在正常与对抗性场景中均表现出持续的安全性能。在NuScenes数据集上,其平均碰撞率为0.07%;在ADV-NuScenes数据集上,平均碰撞率为0.73%。
- 与SparseDrive相比,GuideFlow在NuScenes和ADV-NuScenes上的碰撞率分别降低0.08%和1.02%,且在NuScenes上显著优于UniAD和VAD。
- 值得注意的是,GuideFlow在1秒预测时域内几乎无碰撞(碰撞率0.00%),2秒预测时域内碰撞率仅为0.02%,体现了其在短时域预测中的高可靠性。
这些安全性能的提升,直接源于GuideFlow将安全约束融入生成过程的能力——生成的轨迹本质上具备碰撞感知能力,且在不同场景中均表现稳健。

消融实验
不同动态条件的影响:研究针对不同动态条件信号开展消融实验,结果如表4所示。与基线模型相比,所有模型变体均实现性能提升,验证了“无分类器意图与奖励引导”方法的有效性。其中,基于规划锚点(Plan Anchor, PA)引导的模型变体表现最优:EPDMS得分为29.0,驾驶分数达75.21,优于采用简单驾驶指令(Driving Command, CM)或目标点(Goal Point, GP)引导的变体。这一优势源于规划锚点能够封装更丰富的决策信息,同时解决“行驶目标(where to drive)”与“行驶方式(how to drive)”两大核心问题。消融实验结果表明:在“无分类器意图与奖励引导”框架下,尽管每种引导信号均能提升模型整体性能,但设计更具信息性和有效性的引导信号,仍是大幅提升模型生成能力的关键。

约束生成模块的影响:研究探究了三种约束生成方法对模型性能的影响,结果如表5所示。单独使用任意一种约束模块均能提升模型性能,充分证明了GuideFlow中“约束生成”设计的有效性。具体来看:
- 流状态约束(CF)模块的性能增益更为显著(EPDMS提升1.6分,成功率提升0.45%),优于速度场约束(CVF)模块。二者的核心差异在于:CVF在每一步生成过程中均进行修正,可能干扰概率路径的平滑性并降低生成质量;而CF仅在生成过程中进行一次修正,这种“单次干预”既能最小化对概率路径的干扰,又能确保约束满足,同时为模型预留充足时间以根据场景调整轨迹。
- EBM流优化(RFE)模块对EPDMS的提升最为显著,尤其在域外(OOD)场景评分(第二阶段EPDMS)中表现突出。这一结果凸显了RFE的核心作用:感知约束规则并引导模型修正结果。由于约束规则具有本质上的泛化性,且RFE模块能有效感知这些规则,GuideFlow在域外场景中实现了最优性能。
- CF与RFE模块组合使用时,模型性能达到最佳:EPDMS得分为27.1,驾驶分数达75.21,成功率达51.36%。这表明约束生成中的三种方法并非相互对立,而是具有互补性——CVF与CF负责在生成过程中执行约束,RFE则确保生成结果进一步优化以符合约束规则。更多消融实验细节详见附录。
奖励作为风格条件(RAS)的影响:本消融实验旨在探究RAS模块对模型性能的影响。实验中,将激进度评分(EP)设置为1,以专门鼓励生成更激进的轨迹。结果显示:
- 当模型集成RAS模块时,EP评分从79.6显著提升至82.3,证实了通过奖励条件调节轨迹激进度的可行性。
- 但与此同时,EPDMS评分下降0.8分。这表明:无差别鼓励激进轨迹会损害安全约束,进而导致性能下降。

GuideFlow的超参数敏感性:研究对三个关键超参数进行了消融实验,结果如表6所示:
- 超参数λ的影响:当λ从0.1增至0.5时,EPDMS评分持续下降。性能下降并非源于约束策略本身,而是由于对预测速度场的过度干扰,破坏了流的平滑性并降低了轨迹质量。
- 超参数的影响:当从10增至50时,EPDMS评分先升后降。这一趋势表明:CF模块能有效修正累积偏差,但过晚启动约束会导致模型缺乏充足步骤适应动态场景,从而限制生成质量。
- 超参数K的影响:尽管修正流理论上允许采用较大的采样步长,但实际中,与理想模型的偏差会限制过大步长的使用。步长过大将破坏采样稳定性,导致轨迹异常并引发性能下降(如表6所示)。
定性结果
如图4所示,在多种驾驶场景下的视觉对比表明,本文提出的GuideFlow方法相比DiffusionDrive具有显著优势:GuideFlow能生成满足约束的轨迹,在大幅降低碰撞风险的同时,严格遵守车道行驶规则。具体而言:
- 在图4(c)和(d)的避障场景中,与DiffusionDrive相比,GuideFlow生成的轨迹能明确响应周围车辆,执行避撞操作;
- 在图4(b)的刹车场景中,GuideFlow能维持静止状态,避免与前方车辆发生潜在碰撞;
- 在转弯、变道等更复杂的驾驶任务中,GuideFlow同样表现更优。

结论
本文提出了一种基于流匹配的规划框架GuideFlow。该方法的核心在于:通过融入驾驶指令、目标点、规划锚点等多种条件信号,引导生成过程向场景感知型行为演进;此外,本文创新性地提出三种策略,在生成过程中执行显式约束。
在NavSim、NuScenes、Bench2Drive等数据集上的大量实验证实了GuideFlow的有效性。尤其在具有挑战性的域外场景中,GuideFlow展现出卓越的稳健性。尽管GuideFlow性能优异,但加速采样会导致其性能下降。未来的研究方向将是整合重流(reflow)与均值流(meanflow),以提升模型的采样速度。
...
#被遗忘的商汤绝影
商汤智驾也不是没有高光时刻,毕竟它曾拥有过曹旭东。
商汤绝影正寻求外部大额融资。
此番寻求融资,可以视作绝影正式接受市场的考验,更可能是其独立发展后最重要的时刻。毕竟,随着智驾战场终局玩家的逐渐清晰,融资环境收窄明显,市场上可获的钱屈指可数。
随着卓驭正式官宣36亿天价融资,毫末宣布“周一全员停工”等标志性事件,智驾战场,正式进入“伤停补时”,留给剩余玩家的时间不多了。
商汤绝影,是决赛圈外最有意思的一家公司,值得细说。(干货在第三部分)
依托于商汤的绝影,挣扎在智驾决战的水面
中国的智驾版图,除去车企自研,大体上存在三类公司。其一,科技大厂事业部孵化,其典型为引望(华为)、卓驭(大疆)、阿波罗(百度)、绝影(商汤);其二,汽车大厂孵化或整合,其典型为毫末(长城孵化)、大卓(奇瑞扶持)、千里(吉利整合);其三,大厂明星融资创业,其典型为地平线(余凯NEC+百度)、Momenta(曹旭东微软+商汤)。
无需论证,大厂派(科技or汽车大厂)在品牌、技术、资金、人才、订单角度,均有天生的优势。具体而言,科技大厂拥有更多的技术底蕴,无论百度还是商汤,总是能用各种论文刷榜;汽车大厂则拥有更多的工程师和量产订单做依托,毫末或大卓,都是含着订单出生的宠儿。命运馈赠,总有价码。
创业派则相对“苦逼”一些,要从大厂把团队连哄带骗出来(人的角度),要经受各种投资人的刁难获取融资(钱的角度),要让车企相信一家“成立三五年”的公司不会死且能交付(事的角度),关关难过。虽说现在许多公司够到了曙光,在接连IPO的路上。但过程中实际死伤无数,活下来的都是幸存者,满是偏差。关关难过,但过了就是护城河。
开个玩笑,同是“创业公司”,当“独立派”Momenta还在为第一款智己下线熬夜刷Bug时,“车企派”毫末则在为每个季度的AI Day熬夜画PPT,“生态化反”。前者希望取悦客户,后者则取悦媒体,再让媒体帮着构筑信息茧房给魏老板。AI Day连办九届,CEO表示“我们在技术创新的赛道上加速狂奔”,然后公司奔没了。
当然,“基因论”只适合酒后扯淡,上不了商业教材。你可以说科技光环携C端影响力反哺B端订单,但是华为接近一统江湖,百度已经退出了乘用车智驾的竞争;也可以说大厂缺乏股权变现路径不适合留住顶尖人才,但是“不上市”的大疆(卓驭)杀出了血路,拆分主体“分封诸侯”的商汤(绝影)却四处碰壁。
从统计学角度,样本失真,我们无法计算哪条路径成功率更高,这样的计算也没有意义。但是,拥有类似起点的公司,结果却差别很大,值得聊聊。
在这之中,绝影是一家比较“有意思”的公司,有意思在“比较”。
同为“AI四小龙”的旷视,通过车企扶持和资本运作,成功组局千里科技,至少从纸面上,进入了决赛圈。而绝影还在挣扎,寻求车企或Tier 1融资;
同为“视觉科技大厂”孕育的卓驭,把TDA 4这个“不太理想”的平台做成性价比之选,并逐步延伸至高通+TI(+地平线)的全栈算法商。而绝影的2* TDA 4方案做了又弃,地平线3* J5方案做了又弃,J6M做了却不是业内首选,英伟达方案则遥遥待定;
同为“舱驾并举”的华为,鸿蒙座舱+乾崑智驾已经成为车企营销的绝对封面。而绝影宣传的“30家车企、130款车型、交付突破360万辆”,绝大多数其实是单价百元的DMS和OMS系统;
同为“AI人才黄埔军校”,百度走出了地平线,商汤走出了Momenta,长江后浪推前浪,后浪们成为智驾的两位新王,项目做不过来;而前浪们却正愁项目收不回来,毕竟百度标志性量产在极越,倒闭了,商汤标志性量产在哪吒,也倒闭了。
如果写一篇“智驾十年”的商业案例分析,商汤绝影可以作为Comparative Study的支点,用来对比大多数玩家的成败得失。
如今,这个支点,摇摆在智驾正负面案例的水平线上。
科学家的理想国,技术理想主义
了解商汤的人,有个共同的评价,“商汤是个研究型组织、科学家乐园。”
每个公司,都会不可避免地烙上创始人对组织的思考。已故的汤晓鸥教授,是“中国AI领域的宗师人物”,相较于创业者、AI推动者的身份,汤教授更看重的也许是“老师”的身份。这也使得商汤是中国企业中“科学家”氛围最浓的公司之一。
往好了说,这是一种独立研究、允许为长远技术布局承受短期亏损的气质;往差了说,这是重科研成就,轻商业落地。
这种基因深刻地影响了绝影。绝影负责人王晓刚作为汤教授的学生、联创和妹夫,在很多层面继承了商汤的这种理想国氛围。因此,绝影的许多项目,其出发点有时并非是经过严密商业论证后,主动寻找α客户分摊研发成本,实现商业闭环;相反,更常见的情形是,客户提出了某个前沿或挑战性的诉求,而绝影团队认为这个问题在技术上“有意思”、“有挑战”,便欣然承接,将其视为一个值得攻克的科研课题。
王晓刚自己也坦言,早期与本田的合作,正是2017年对方提出的“仅用摄像头,无高精地图实现智能驾驶”这一挑战性课题,开启了商汤在端到端智能驾驶上的探索之路。
这种技术驱动、挑战导向的模式,使得绝影的业务线一度非常庞杂。
从智能座舱(DMS/OMS、多模态交互、甚至车载医疗应用)到智能驾驶(既尝试V2X也深耕单车智能,在TI、地平线、英伟达多个平台均有布局),再到AI云服务。
然而,绝影在资源层面远无法与华为这类真正的大厂相比——华为能够实现芯片、传感器、算法的全栈自研闭环,因为华为是华为。
从资源和技术路线的专注度来看,同样源自视觉大厂的卓驭或许是更合适的参照系。卓驭早期专注于性价比路线的极致优化与量产落地,虽说有点过于“轴”,但也以“宝骏”小车打响了工程化名声。别拿卓驭不当大疆。
相比之下,绝影的布局则显得更为发散,更像一个在汽车产业里进行广泛技术验证的实验室。是绝影,更是商汤。
这种带着浓厚学术色彩的“科学家理想国”,必然也会面对创新人才因“产业落地前景”和“商业回报”考量而流失的现实。
汤晓鸥教授曾以其开放心态表示,“MMLab不介意大家做跳板,但希望能做出成果”。某种意义上,商汤在一定程度上也扮演了类似角色。财报数据显示,从上市的2021年到2024年,商汤科技每年年末的员工数分别为6114、5098、4531,3756人。
这背后,既有公司因连年亏损而进行的结构性调整,也有顶尖技术人才在产业界寻求更大应用舞台和更高回报的主动选择。
“AI黄埔军校”,对于产业和个人,是褒义词;对于公司,则不然。
这样的组织氛围,对绝影这类需要重度工程化、紧贴量产节奏和成本控制的智驾业务而言,其影响是直接且深远的:
- 科研实力卓著,算法论文引领风骚。这无疑是绝影最亮眼的标签。其在学术上的前瞻性毋庸置疑,例如,2022年底提出的感知决策一体化自动驾驶通用模型UniAD,确实是领域内里程碑式的工作,堪称“孤篇压全唐”。近期发布的“开悟”世界模型,也展现了其在底层技术上的创新“野心”。
- 内部协同存在“高墙”,工程化落地能力屡受考验。据悉,绝影内部曾存在比较明显的“墙”,学生嫡系派与外部社招派、算法团队与工程团队之间,会因视角和目标差异而产生摩擦。尤其是工程团队,面临将算法转化为稳定可控的量产产品的巨大压力。王晓刚也曾坦诚,绝影“经历了一个痛苦的过程”,在首批量产项目交付中,“工程化能力是不足的,缺少量产意识、交付意识”。基于地平线J5的方案未能量产,虽有市场节奏变更的因素,但也暴露了工程化交付的短板。
- 商业驱动意识相对薄弱,盈利模式面临挑战。不同于学校的知识探索,公司的本质是可持续的“商业模式”。商汤上市以来,已经累计亏损超过500亿。尽管绝影已经收入小数亿元,但其中绝大部分收入来源仍集中于单价百元左右的DMS/OMS等,而非高附加值的中高阶智驾方案。
所幸,在商汤的战略调整下,绝影开始独立运营、激励和融资,这或许是其拥抱市场、强化商业思维的一个重要契机。
但是,长期形成的组织基因,绝非一朝一夕所能扭转。
大叙事做惯了,智驾的脏活累活,就做不惯了。
智驾落地多方遇挫,量产,是个难题
近几年,绝影在智驾业务的业务、人才、客户三大层面均出现明显动荡。
一、业务层面:被动收敛战线,未能成为核心平台首选方案商
绝影一度试图覆盖全场景智驾方案,早期从TI、地平线、英伟达平台均有布局,甚至一度想做华为MDC。TI方面,推出过“双TDA4域控平台”的行泊一体方案,因成本与性能平衡不佳被边缘化,量产无果;地平线方面,推出过“3J5平台”方案尝试突围,因交付延迟被客户弃用。
2024年以来,其产品线大幅收缩,逐步聚焦于地平线征程系列和英伟达高阶平台,在2024年AI DAY上高调发布AD Pro(J6E)、AD Max(J6M)和AD Ultra(Orin/Thor)三款方案。
英伟达方面,大家都在用,但是Momenta一骑绝尘,自不必说。
地平线方面,有不少值得说的故事。早期,地平线曾主动寻求合作,但绝影因“算法优越感”态度冷淡;后来地平线J6系列发布,地平线就没带绝影玩,J6E/M首发算法伙伴除了轻舟鉴智等传统小弟外,甚至选了小马和STRADVISION;待到J6E/M成为“智驾公约数”,绝影开始扭头拥抱地平线,但地平线已经实现自研+算法生态商的完整矩阵。
此外,UniAD“孤篇压全唐”,获得了CVPR2023年的最佳论文奖,但是地平线、商汤、上海人工智能实验室为了该文章的著作权争破头。“二桃杀三士”,目前仍没有定论。
这种技术理想主义与商业现实的错位,导致绝影在关键窗口期未能卡位主流供应链。
二、人才层面:频繁换帅与核心流失,量产能力遭质疑
绝影智驾的VP层,在过去两年经历了几次剧烈的人事地震。
2024年,原智驾副总裁石建萍(学术背景主导)被调岗至大模型团队,由王伟宝接任。王伟宝拥有苹果、极越等公司的经验(甚至不能在经验两字前加成功的定语),但其空降引发内部抵触。后逐渐被边缘化,现已离职。
2025年,原哪吒智驾负责人王俊平(百度系背景)高调加入绝影,接手交付。但其目前唯一的东风项目迟迟没有落地。据内部人士透露,王俊平已经在内部申请了调往L4方向,连带着一部分研发人员分流。
频繁的中高层动荡,使得绝影难以适配高强度、长周期的量产需求。有离职员工曾表示:“算法团队追求论文指标,但工程团队抱怨‘模型在仿真环境跑分高,一上车就崩’。换了一套人,又重新开始分析问题。”
基于此,绝影的算法和工程团队一直在“对外输血”。
三、客户层面:战略客户流失,陷入边缘化危机
业务和人才方面的动荡,也在影响着客户层面的稳定。
绝影智驾的客户虽多,但是大都处于“二供”甚至“三供”的角色。
唯一的“一供”客户是哪吒汽车,也是绝影智驾板块最大的客户,但因经营危机进入重组,后续订单难料;一汽已经战略入股卓驭,绝影很难拿到后续的车型;广汽方面,曾推“绝影感知+自研规控”的J6E方案,后因绝影感知不达标,交给另一家算法供应商整体接盘;东风项目前文提过,迟迟没有落地;奇瑞曾让“绝影感知+大卓规控”的组合跑了一年,试图跟上全民智驾的浪潮,最后大卓跑解散了。
承压之下,绝影虽试图以“白盒交付”模式+炫酷DEMO吸引车企,但随着车企纷纷已有重注合作的智驾厂商,绝影在智驾版图上接连退守,恐被彻底边缘化。
“一切都会归于量产”。
融资决定存亡,但破局筹码不足,转型或是出路
做不好智驾,不代表绝影没有价值。
商汤在视觉算法与大模型上的积累,使其在智能座舱等多模态交互领域、AI大平台等前沿战场,仍然保有竞争力。
但智驾,依旧是“汽车智能化的核心”,更是“xxx智能的前奏”。在这点看,绝影不想放弃,但目前来说,已经明显掉队了。
事实上,绝影曾经尝试向北方及南方两大主机厂融资,均以失败告终。
24年,业界曾传出绝影与北方某央企主机厂、深圳国资洽谈融资的消息。随着该北方央企主机厂正式天价战略入股某头部算法供应商,算是在两家公司中做出了选择;
25年,有媒体报道绝影与南方某国资主机厂洽谈融资。但融资条件“不同寻常”,具体为“投资后全额返投其旗下零部件公司”。后因绝影的估值过高、量产实力不强等原因再次不了了之。
当然,也许绝影有一天不会作为智驾算法商而存在。甚至,王晓刚自己对绝影的定位也不一定是算法商。
“就大趋势而言,(软件供应商们的)核心壁垒并不在算法本身,我们更多地要看重AI基础设施建设,而且技术还在不停地演进。”王晓刚曾对媒体公开表示,“只要AI不断演进,绝影对主机厂就是有价值的。”
如此,PPT多画两个发布会,也许绝影就“转型成功”了。
当然,转型并不意味着失败。百度退守“L4+大模型”后,重新获得市场认可;“大商汤”方面,2024年正式开启“1+X”架构,今年以来市值及营收均增幅明显,旗下业务单元均开启独立融资。值得一提的是,除绝影外,商汤医疗、零售、服务机器人等业务均已有公开融资信息,包括最新剥离的曦望(AI推理芯片),也于今年获得了10亿元量级的融资。
座舱基本盘的低附加值、智驾高地的量产遇阻,也许支撑不了绝影内外部高昂的估值预期。绝影也正在尝试L4业务(小巴、清扫车等)的突围和AI基座(大模型和卡)的全新叙事。
故事总有的讲,但也总有讲不下去的一天。
Fin
Fake it until make it?
Who's paying?
...
#RAD
地平线RAD:基于3DGS 大规模强化学习的端到端驾驶策略
原文信息:
https://hgao-cv.github.io/RAD/
TLDR
il:imitation learning ; rl:reinforcement learning
做了什么?
第一个提出基于 3dgs 来进行 rl 用来做 e2e policy。分以下三步走:
- 训练一个基础的 bev 和 perception model
- freeze感知,用 il 方式训练一个 planning head
- 基于上面的 planning head,用 3dgs 生成 sensor level 的 env,用 rl + il 混着训
有啥提升?
主要是碰撞率相比纯 il 少了 3 倍
有啥局限?
3dgs-env缺乏交互,只是log replay;3dgs 渲染非刚性行人、视野外信息、低光场景等效果不行
个人总结
总体来说,读起来不费劲,行文舒服、图文清楚、实验充分,有很实际的工程化改进。核心亮点是使用 3dgs 来构建 sensor-level 的 env,最后结果确实比 il 的方案要好一些。
工程化改进较多,比较务实,不那么纯 rl,比如辅助 task、il & rl mix training 等等。
其中对于辅助 task,rl 只贡献了 gae 作为 loss_weight,感觉像是 trajectory-level 的 loss,消融实验也显示没 ppo 那套loss也能改进指标。对于 il & rl mix + event reset,本质都是为了限制 rl 的探索,核心原因有 2 个:一个是缩小 rl的搜索空间,加速收敛;第二个是尽量保证和 expert traj 偏差不大,毕竟轨迹偏离太远 3dg-env就 G 了。不过最开始看 il 做 norm 以为是从 loss 角度,最后发现是 mix train,不知道在 loss 里面加入 kl_penalty 会不会没这么硬。最后文中说的 env-intersect 和 3dgs noisy sensor,很限制 rl 的探索上限了
论文细节
RAD:三阶段流程
整个流程如上。RAD接受多视角图像输入,输出动作的概率分布,最后从中采样动作控制车辆。
状态空间
bev encoder:常规操作,从 multi-veiwe image学一个 instance-level bev feature
map head:从 bev map 中学静态地图元素,包括centerline、lane divideer、boundary、arrows 这些
agent head:学习交通参与者的运动信息,包括location、orientation、size、speed 这些
image encoder:和上面并行,从图像中学习 planning 相关的特征
planning head: 用 作为场景表示(包括map \ agent \ image token), 是 planning 的 embedding,用 Transformer decoder 结构,其中 作 query, 作为 key 和 value。
动作空间
- 0.5s 一帧,在这个期间内假定车辆的线速度和角速度不变
- 动作分为横向动作 和纵向动作 ,解耦横纵向。具体定义如下:
其中 ,,。横向是 -7.5m 到 7.5m 之间,离散化 61 个动作,间隔 0.25m 为一个横向移动距离;纵向是 0 到 15m 之间,同样是 61 个动作,每 0.25 一个 gap。结合状态空间和动作空间,策略和值函数可以表示为
pi_net
v_net
奖励函数
设计目标:惩罚不安全的动作 + 鼓励对齐专家轨迹,所以有 4 个奖励:
- :dynamic_collision,动态碰撞,ego 和 动态物体的 bounding box 重合时给负。
- :static_collision,静态碰撞,类似同上
- :postional deviation ,位置偏差(横向偏差),计算当前位置和专家轨迹投影点的欧氏距离,大于阈值给负。论文里阈值是 2.0m
- :heading deviation ,同上,当前朝向和专家匹配点的朝向 diff,大于阈值给负。论文里阈值是 40°
注意:当这些事件发生时会直接 done 掉环境,因为触发这些事件时 3dgs-env通常会产生 noisy sensor data,对 rl训练有害。(简单说就是偏差太大或者碰撞,重建数据就乱了,环境会 G)
训练流程
- 感知预训练:训练 agent_head 和 map_head,隐式编码高级信息,这个阶段只更新 bev encoder \ map head \ agent head 的参数
- 规控预训练:il方式,从大规模的人类专家数据中学习动作概率分布,冻结感知参数,只训练 image encoder 和 planning head
- 强化后训练:rl + il,一起 fine-tune。rl 目的是引导策略对关键风险场景更敏感,适应分布外的情况。il 作为正则项保证策略行为和人类相近。如下图
具体而言,从收集的数据中选了大量危险的交通拥堵clip,每个 clip 独立训练 3dgs model 重建场景作为 env。剩下就是 rl 的常规操作了,并行 N个 worker,随机选择一个 3dgs-env 进行 rolllout,把 transition 存在 buffer 里,结束后随机选择下一个3dgs-env。
policy 和 env交互的动作,用简单的自行车模型来计算下一步的位置:
自行车模型来近似动作执行结果
策略优化环节,分别用 ppo 算法和 il 一起优化 policy,训练一定步数后,新 policy 替换掉老 policy.
第三阶段,il + rl
训练细节
整个训练里面都分成横向和纵向两个部分,完全两个解耦的并行任务设定。
其中 reward 也按照横纵向来分配归属,除了 dynamic_collision 是纵向的 reward,其他都属于横向 reward。
最后的优化目标也是 2 个部分,如下:
ppo-loss
辅助任务
为了稳定训练加速收敛,文章设置了一些辅助目标引导整个动作分布,结合特定的奖励来惩罚不好的行为。这里有分为“减速“ 、 “加速“、“左转“、“右转“这 4 个部分。
这里拿“减速“这个行为来举例,它在动作上和纵向有关,在奖励上和前面的“动态碰撞“[dc]有关。引入了如下的一个定义。
dec_event
定义为时序上纵向 比旧的纵向 小的概率之和。
比如一条轨迹上有 5 个 timestamp,旧的纵向输出是 ,新的纵向输出 。从第 3 帧开始,新的纵向移动要比老的小【也就是刹车减速更厉害了】。
同时,假设新策略每一步的决策概率分别是 【也就说越来越确定】。根据前面的定义,我们可以得到 。
同理,对于 “加速” 行为,上面的例子里面,只有第 2 帧时新的>老的,所以
那下一步,对于这些减速、加速行为怎么定义偏好或者 loss呢?答案就在前面的 reward 设计里。如果在第 t 时刻发现车辆前面要发生动态碰撞,那么在 t 时刻应该鼓励“减速“行为。相反,车辆后面要发生碰撞,则鼓励“加速“行为。文章用下面的公式形式化表达这个偏好:
符号系数
dynamic collision avoidance的辅助目标
其中 就是 对应的 gae.
按照上面的逻辑,纵向有 2 个分别是“减速”和“加速”,横向也有 2 个:、,分别用来计算“横向位置偏差的辅助目标”和“纵向朝向偏差的辅助目标”。
综上所述,辅助任务目标和所有的优化目标,分别如下:
auxiliary objective
optimization objective
以上基本上就是大部分的技术细节了,下面来看看数据和实验指标。
数据情况
- 第一阶段:收集 2000h 真实人类驾驶数据,用低成本的自动化标注获取 gt
- 第二阶段:用里程计数据作为第二阶段监督学习的 gt
- 第三阶段:选择4305个关键场景用 3dgs重建 env,3968个训练,337个评测
指标设计:
- 动态碰撞率 DCR + 静态碰撞率 SCR = 碰撞率 CR
- 位置偏离率 PDR + 朝向偏移率 HDR = 偏移率 DR
- 平均偏移距离 ADD:描述碰撞和偏差发生时,和专家轨迹最近点的距离
实验结论
- reward 设计:合适调参,所有的 reward 都有用;尤其 dc_reward 对减少碰撞有效
reward ablation
- 辅助任务设计:所有的都有用,结合 ppo后 cr可以更低。
auxiliary ablation
- 训练配比:rl 和 il 数据比是 4:1 时最优
rl-il ablation
- rl 必要性研究:和其他 il-based 算法比,指标都更好。说明了闭环训练的优势在于能更好处理动态环境
rl better il-based
其他细节
对于 planning 的预训练,设置了一些 anchors:,用最近邻匹配去匹配 gt:。最后优化 loss 就是 dual focal loss
normalized nearest-neighbor matching
dual focal loss for il
以上。
...

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 25
 0
- 0


 已为社区贡献28条内容

所有评论(0)