正则表达式(十一)自然语言处理:提取文本中的名词+分割文本为独立句子+提取文本中的地名
·
正则表达式语法介绍与自然语言处理类查询
正则表达式基础语法
常用元字符
.- 匹配任意单个字符(除换行符外)[]- 字符集,匹配其中任意一个字符[^]- 否定字符集,匹配不在其中的任意字符*- 匹配前一个元素0次或多次+- 匹配前一个元素1次或多次?- 匹配前一个元素0次或1次{n}- 匹配前一个元素恰好n次{n,}- 匹配前一个元素至少n次{n,m}- 匹配前一个元素n到m次|- 或操作,匹配左边或右边的模式()- 分组,捕获匹配的内容^- 匹配字符串开头$- 匹配字符串结尾\s- 匹配任何空白字符\S- 匹配任何非空白字符\d- 匹配数字\w- 匹配字母、数字、下划线
常见错误与注意事项
- 转义字符问题:在字符串中,
\需要转义为\\ - 贪婪匹配:默认是贪婪匹配,使用
?可改为非贪婪匹配 - 边界问题:注意
^和$的使用,确保匹配位置正确 - 字符集误解:
[^\\s]表示匹配任何非空白字符,不是"非s字符" - 分组引用:替换时使用
$&表示整个匹配,$1、$2等表示分组
自然语言处理类正则表达式查询表格
| ID | 类别 | 标题 | 正则表达式 | 替换模式 | 描述 | 示例 | 注意事项 |
|---|---|---|---|---|---|---|---|
| 95 | 自然语言处理类 | 提取文本中的名词(基础匹配) | [^\\s]+(公司|产品|地点|城市|省份|国家) | - | 基础匹配文本中的名词(以公司/产品/地点等结尾) | 腾讯公司的微信产品 → 提取结果:腾讯公司、微信产品 | 1. 可能匹配到不完整的词 2. 无法处理嵌套结构 3. 对英文支持有限 |
| 96 | 自然语言处理类 | 分割文本为独立句子 | [。!?;] | $&\n | 将文本按中文标点(。!?;)分割为独立句子 | 你好!今天天气不错。我们去公园吧;那里很美?→ 分割后:你好! 今天天气不错。 我们去公园吧; 那里很美? | 1. 英文标点不适用 2. 可能分割引号内的句子 3. 需要后续处理空行 |
| 97 | 自然语言处理类 | 提取文本中的地名 | [^\\s]+(省|市|区|县|镇|街道) | - | 提取文本中的地名(以省/市/区/县/镇/街道结尾) | 北京市朝阳区建国路 → 提取结果:北京市、朝阳区 | 1. 可能误匹配非地名 2. 无法处理复合地名 3. 对少数民族地区名称支持有限 |
改进建议
- 名词提取:考虑使用更精确的边界匹配,如添加单词边界
\b - 句子分割:可结合前后文规则,避免在引号内分割
- 地名提取:可建立地名词典辅助验证,提高准确性
这些正则表达式适合基础文本处理,但对于复杂的自然语言处理任务,建议结合专业的NLP工具库使用。
我用代码做了一个正则表达式查询库,可以查询100种典型应用,也可以验证和测试你的代码,可以点击直接下载:
正则表达式查询库 覆盖数据验证、文本提取/清洗、开发调试、日志分析、网络安全等数十个领域的100种正则表达式应用场景
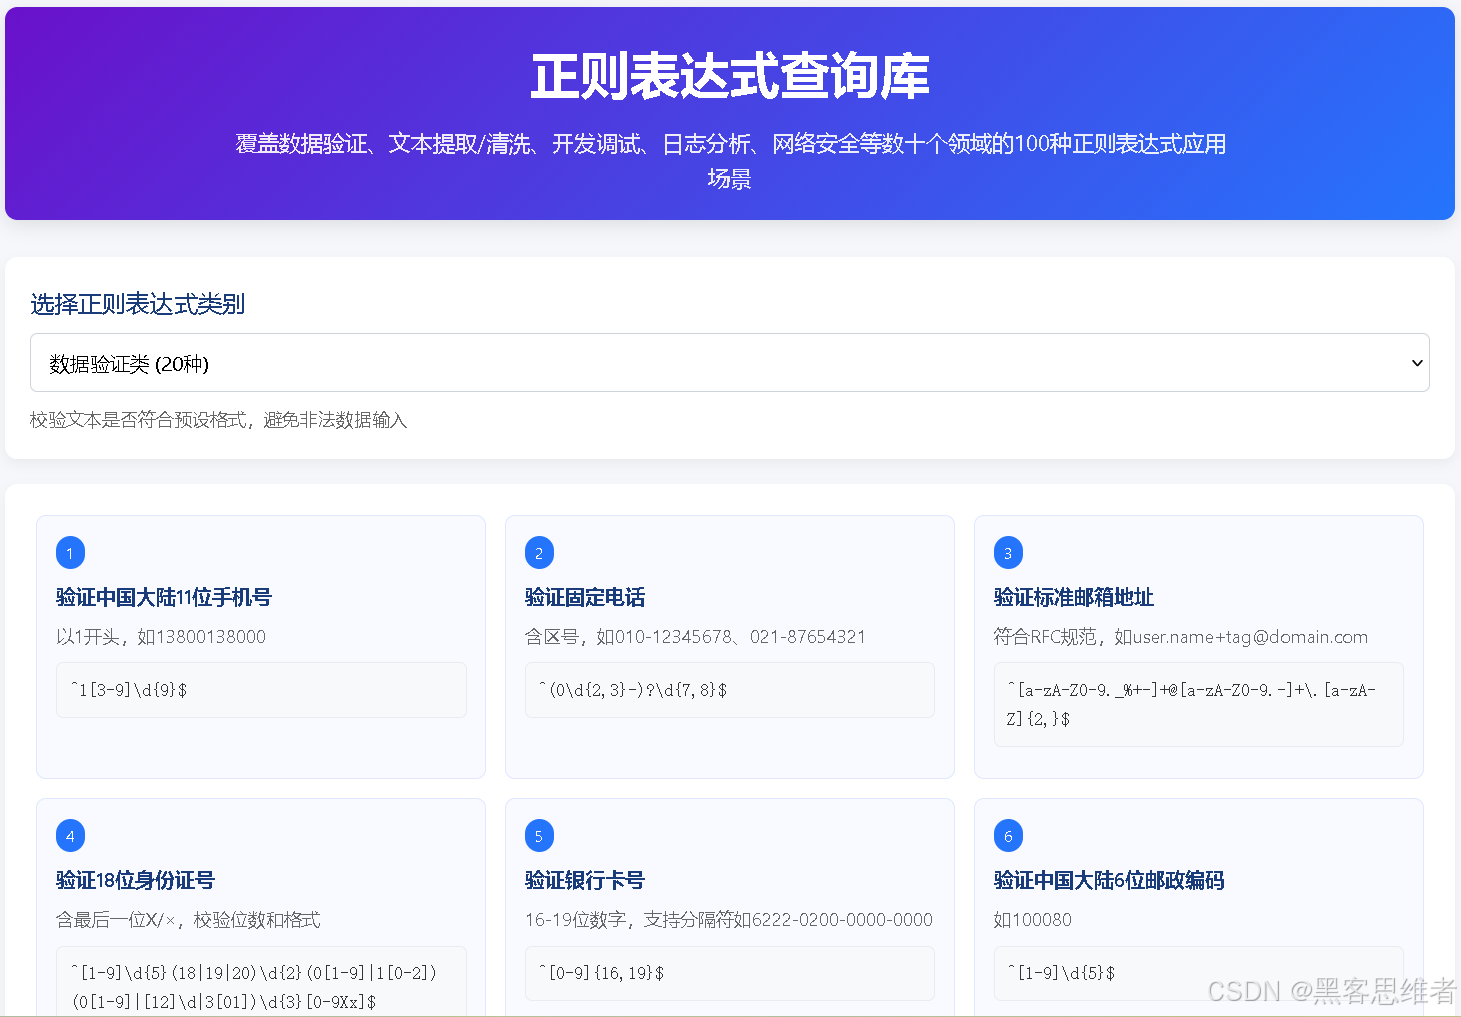
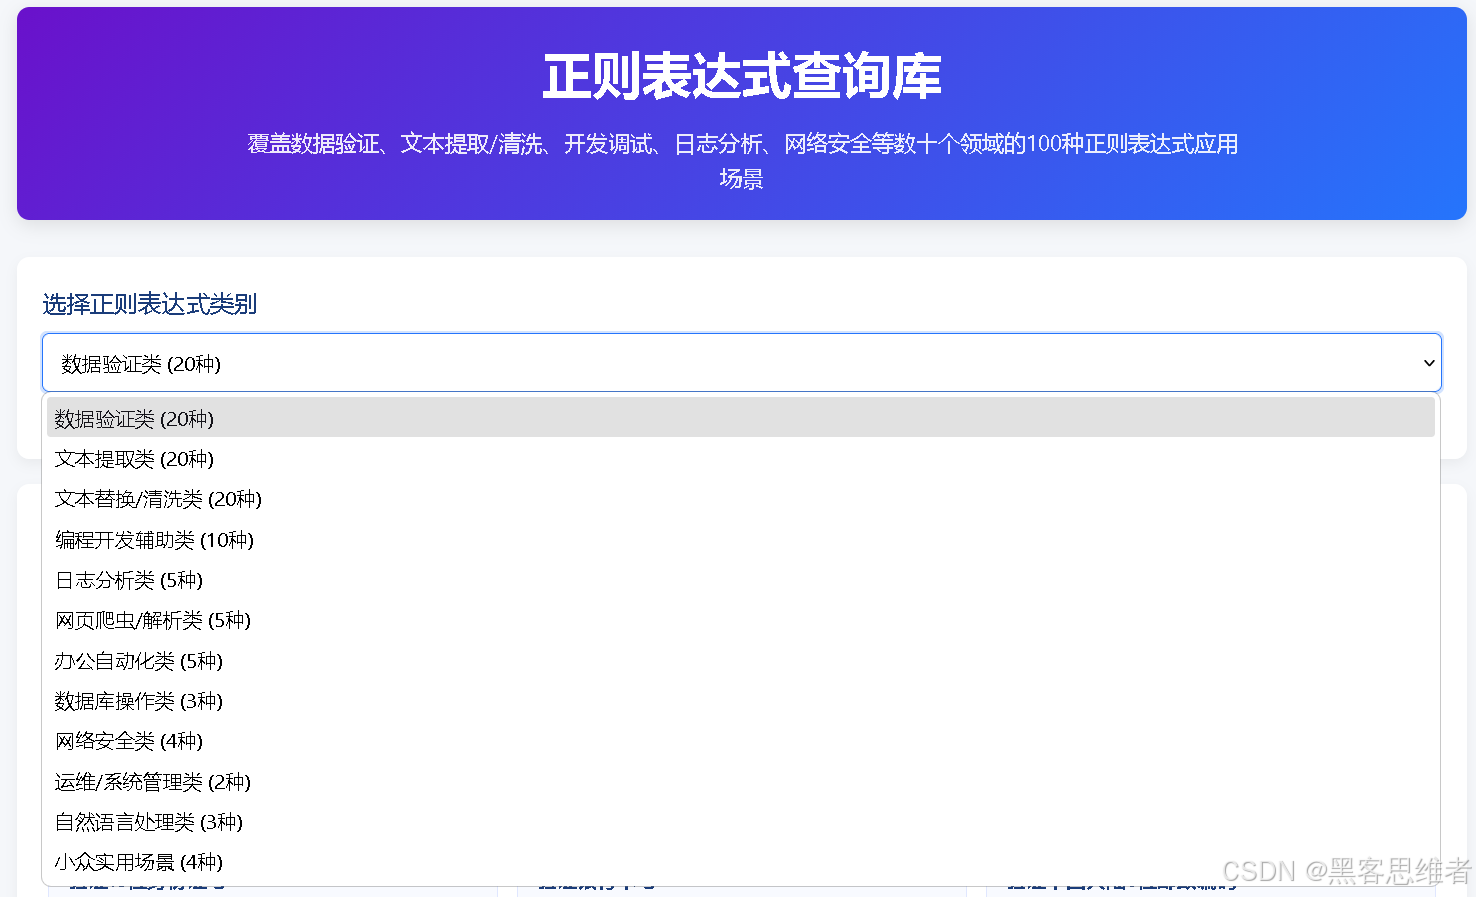
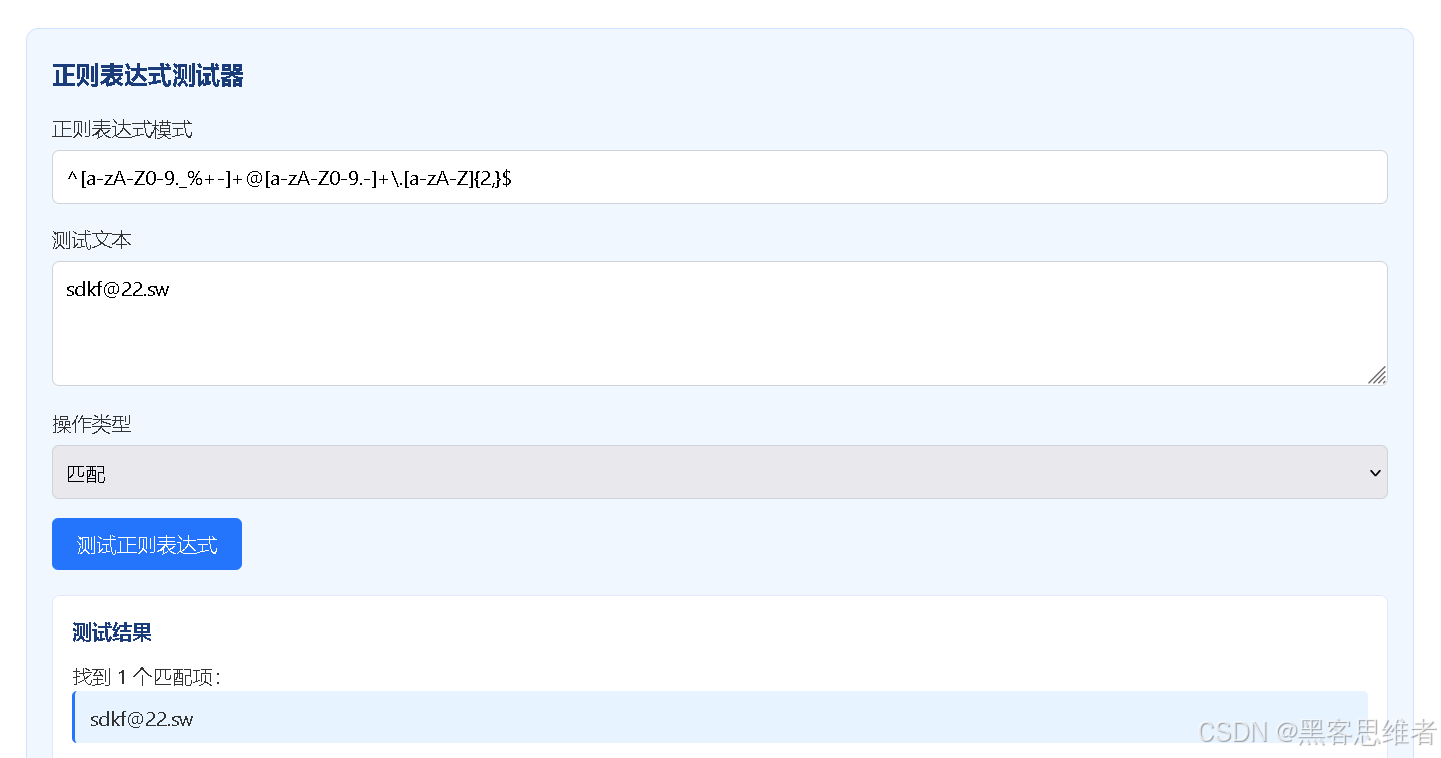
正则表达式查询库 覆盖数据验证、文本提取/清洗、开发调试、日志分析、网络安全等数十个领域的100种正则表达式应用场景

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献12条内容

所有评论(0)