基于Whistle实现手机App抓包爬虫的技术实践
一、Whistle 工具简介
Whistle 是一款基于 Node.js 开发的跨平台 Web 调试代理工具,核心定位是「可视化网络请求拦截与修改」,支持 HTTP/HTTPS/WS/WSS 等协议,兼具抓包、Mock、代理转发等多功能于一体。
核心功能与特点
- 可视化操作:无需复杂命令,通过 Web 界面即可完成请求筛选、修改、保存
- 多协议支持:全面覆盖移动端 App 常见的网络请求协议,包括 HTTPS 双向证书验证场景
- 灵活规则配置:支持按域名、URL、请求方法、响应状态等多维度匹配规则
- 插件生态丰富:可通过插件扩展加密破解、数据导出等高级功能
- 跨平台兼容:Windows/Mac/Linux 全支持,手机端无需安装额外 App
| 特性 | Whistle | Fiddler | Charles |
|---|---|---|---|
| 移动端证书安装 | 支持 WiFi 直连安装 | 需手动导入证书文件 | 支持 WiFi + 扫码安装 |
| 配置灵活性 | 高(支持正则 / 通配符) | 中(需熟悉脚本语法) | 中(图形化配置有限) |
| 抓包性能 | 优秀(Node.js 异步特性) | 一般(Windows 平台易卡顿 | 良好 |
移动端抓包的核心优势
- 证书安装更便捷:手机连接同一 WiFi 后,通过访问http://local.whistlejs.com:8899即可一键安装证书,无需电脑导出证书文件
- 无设备限制:支持 iOS/Android 全版本,无需越狱或 Root(部分 SSL Pinning 场景除外)
- 规则同步高效:修改规则后实时生效,无需重启代理或 App
- 数据导出灵活:支持 JSON/CSV/Har 等多种格式,便于后续爬虫开发的数据解析
二、环境配置与基础设置
- 依赖环境与安装步骤
前置条件:安装 Node.js(v12 + 版本,推荐 v16 LTS),可通过node -v验证安装成功。
安装 Whistle:
#全局安装Whistle
npm install -g whistle

# 启动Whistle(默认端口8899)
w2 start

# 验证启动:访问http://127.0.0.1:8899,出现管理界面即成功
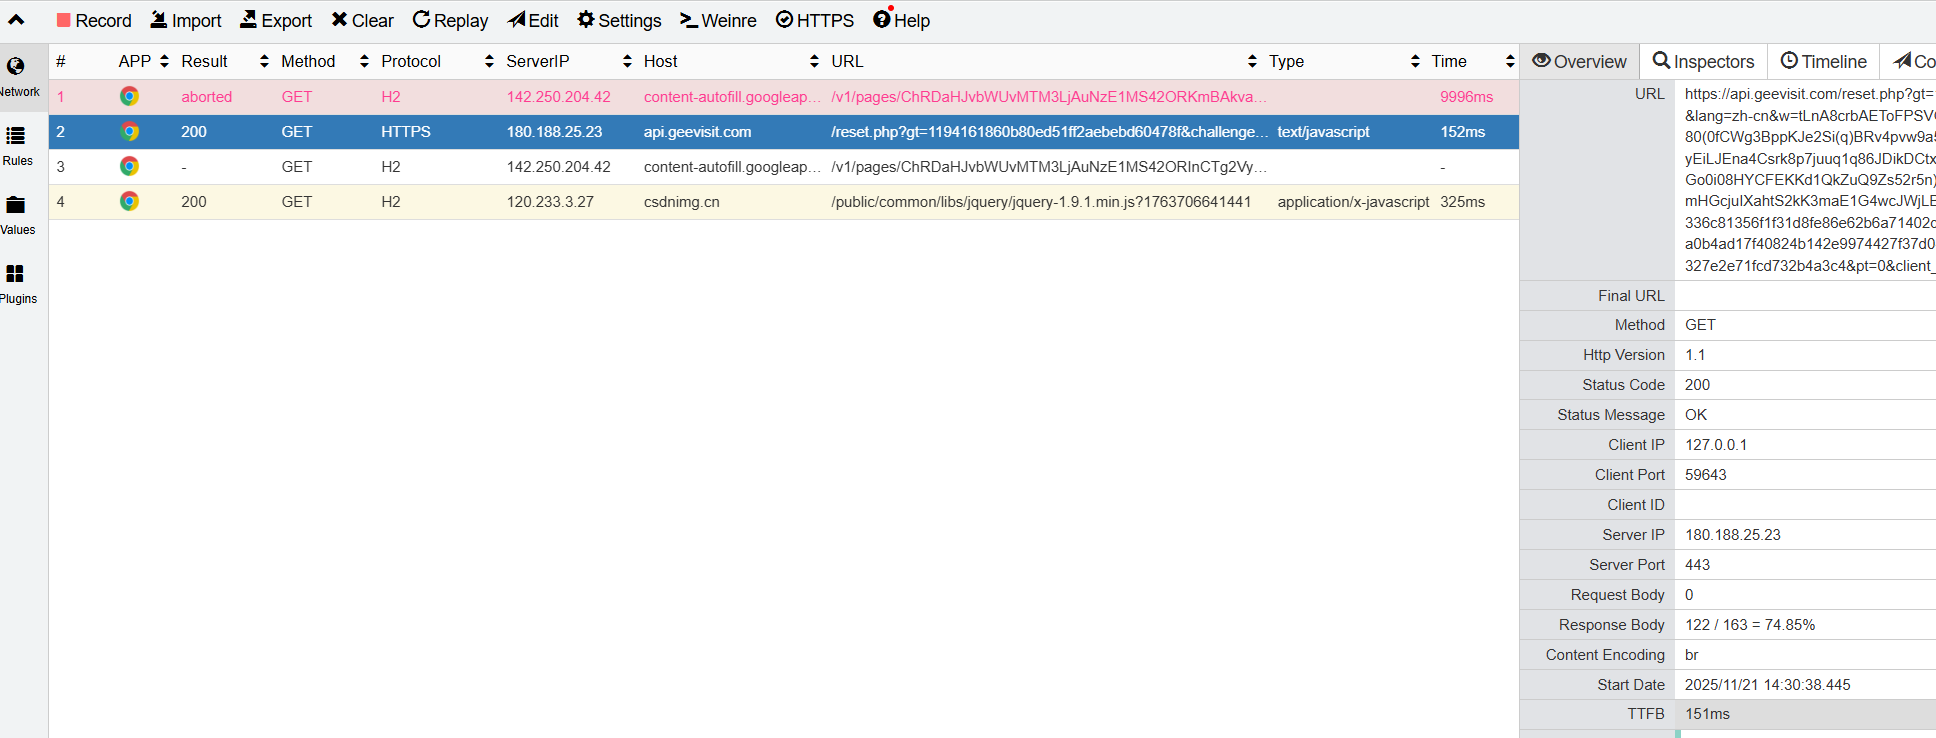
【图示 1:Whistle 启动命令行界面与 Web 管理界面】
-
配置 Whistle 代理服务器
打开 Web 管理界面(http://127.0.0.1:8899),进入「代理」标签页
确认默认代理端口(8899),如需修改可在「设置」-「端口」中调整(避免端口冲突)
勾选「允许局域网访问」(关键!确保手机能连接电脑代理) -
手机端代理设置
前提:电脑与手机连接同一 WiFi 网络,记录电脑的局域网 IP(如 192.168.3.105,可通过ipconfig/ifconfig查询)。
iOS 设置步骤:
打开「设置」-「无线局域网」,点击当前连接 WiFi 后的「i」图标
选择「配置代理」-「手动」
服务器填写电脑局域网 IP(如 192.168.3.105),端口填写 8899,保存
Android 设置步骤:
打开「设置」-「WLAN」,长按当前连接 WiFi,选择「修改网络」
勾选「显示高级选项」,代理选择「手动」
填写服务器 IP 和端口 8899,保存并重新连接 WiFi
【图示 2:iOS 与 Android 代理配置步骤,可参考】 -
安装并信任 Whistle CA 证书(解决 HTTPS 抓包)
HTTPS 抓包需手机信任 Whistle 的根证书,否则会出现「证书不受信任」导致抓包失败。
电脑端准备:
打开 Whistle 管理界面,进入「HTTPS」标签页
点击「下载根证书」,并安装到电脑(信任证书,避免后续调试警告)
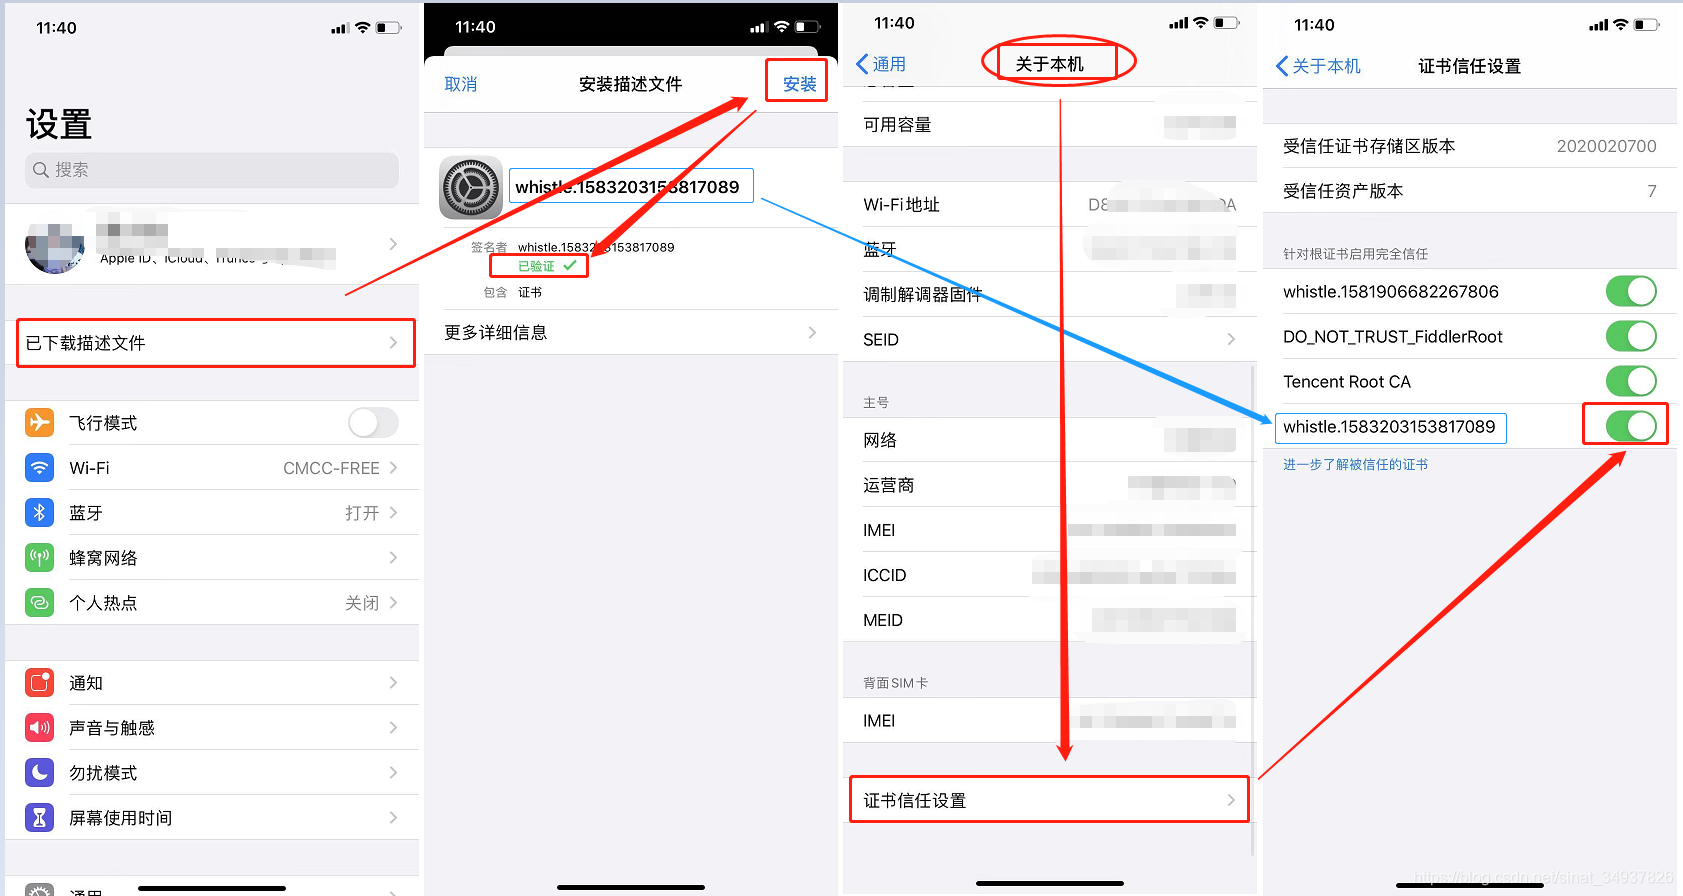
手机端 iOS 安装:
手机浏览器访问http://local.whistlejs.com:8899(或电脑 IP:8899)
点击「安装证书」,跟随系统提示完成安装(iOS 需在「设置」-「通用」-「VPN 与设备管理」中信任证书)
iOS 16 + 需额外开启「设置」-「通用」-「关于本机」-「证书信任设置」,找到 Whistle 证书并开启信任
Android 注意事项:
部分机型需在「设置」-「安全」-「凭据存储」-「安装从存储设备的证书」中手动选择下载的证书文件
Android 7 + 默认不信任用户证书,需通过 Whistle 插件(如whistle.certpin)绕过证书校验,或 Root 后将证书移动到系统证书目录
三、抓包流程实现
-
启动 Whistle 并监听请求
确保电脑 Whistle 已启动(w2 start),手机代理配置正确
打开 Whistle 管理界面,进入「网络」标签页,此时界面会实时显示所有经过代理的网络请求 -
手机 App 网络请求捕获与分析
打开目标 App(如某电商 App、社交 App),操作核心功能(如刷新列表、加载详情页)
Whistle 界面会同步显示 App 发起的所有请求,包括请求 URL、方法、状态码、响应时间等基础信息
点击任意请求,可查看「请求头」「请求体」「响应头」「响应体」等详细数据
【图示 3:Whistle 抓包界面】
- 过滤与筛选目标请求
当 App 请求量较大时,需通过筛选功能定位目标接口:
「筛选栏」快速匹配:输入域名(如api.targetapp.com)、URL 关键词(如/list/data)、状态码(如200)
「规则筛选」精准匹配:在「规则」标签页添加规则,例如:
# 只显示目标域名的请求
host://api.targetapp.com log://true
# 隐藏静态资源请求(图片、CSS、JS)
url://*.png|*.jpg|*.css|*.js log://false
「方法筛选」:勾选 GET/POST/PUT 等特定请求方法,过滤无效请求
- 解析请求与响应数据
对于 JSON 格式数据:Whistle 会自动格式化显示,支持折叠 / 展开字段,便于查看嵌套结构
对于 XML/HTML 格式:提供语法高亮,支持快速搜索关键词
关键数据提取:重点关注「请求参数」(如 page、size、token)和「响应数据结构」(如 data 列表、total 计数),为后续爬虫开发提供依据
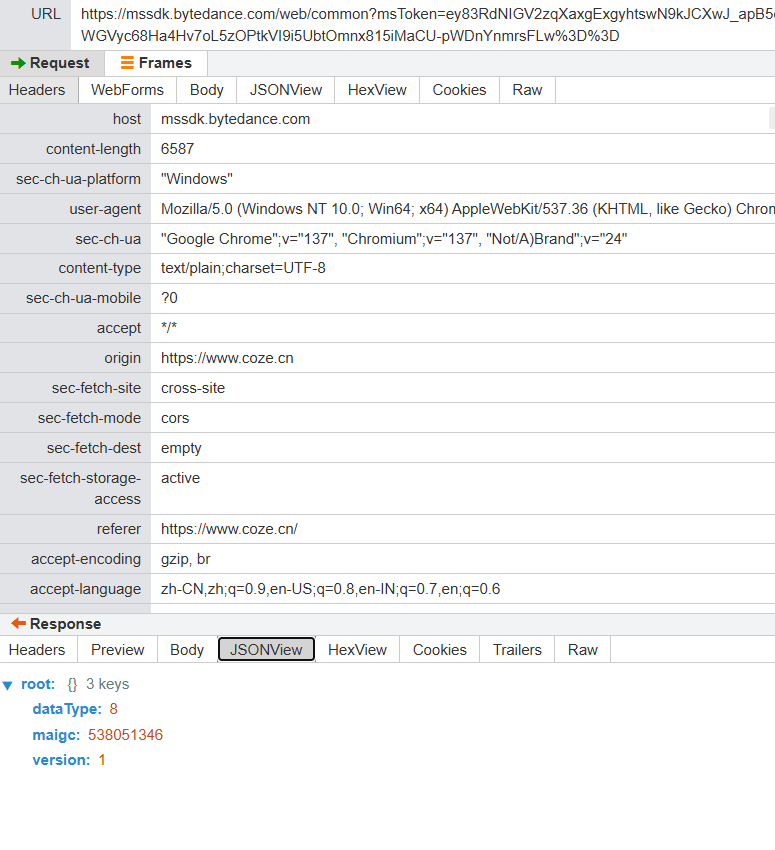
【图示 5:JSON 响应数据解析示例截图,标注关键字段(如数据列表、分页参数)】
四、数据存储与分析
- 抓包数据保存方式
单条请求保存:点击请求右侧「保存」按钮,选择保存格式(Har/JSON/ 文本),存储到本地
批量导出:在「网络」标签页勾选多个请求,点击「导出」选择批量保存格式
自动保存配置:在「规则」中添加保存规则,例如:
# 将目标域名的所有请求自动保存到本地Har文件
host://api.targetapp.com save://~/capture/targetapp/%Y%m%d.har
- 自动化处理抓包数据
以解析 Har 文件为例,提取所有接口的 URL、请求参数和响应数据:
import json
import haralyzer

def parse_har_file(har_path):
    # 读取Har文件
    with open(har_path, 'r', encoding='utf-8') as f:
        har_data = json.load(f)

    # 初始化Har解析器
    analyzer = haralyzer.HarParser(har_data)
    results = []

    # 遍历所有请求
    for entry in analyzer.har_data['log']['entries']:
        # 提取请求信息
        request = entry['request']
        url = request['url']
        method = request['method']

        # 提取GET参数
        get_params = {}
        if 'queryString' in request and request['queryString']:
            get_params = {param['name']: param['value'] for param in request['queryString']}

        # 提取POST参数(FormData格式)
        post_params = {}
        if method == 'POST' and 'postData' in request and request['postData']['params']:
            post_params = {param['name']: param['value'] for param in request['postData']['params']}

        # 提取响应数据(JSON格式)
        response = entry['response']
        response_data = {}
        if response['content']['mimeType'] == 'application/json':
            response_data = json.loads(response['content']['text'])

        results.append({
            'url': url,
            'method': method,
            'get_params': get_params,
            'post_params': post_params,
            'response': response_data
        })

    # 保存解析结果到JSON文件
    with open('parsed_data.json', 'w', encoding='utf-8') as f:
        json.dump(results, f, ensure_ascii=False, indent=2)

if __name__ == '__main__':
    parse_har_file('targetapp_202405.har')
- 数据分析与关键信息提取
API 接口整理:去重后整理出目标 App 的核心接口(如列表接口/api/v1/list、详情接口/api/v1/detail)
参数结构分析:识别必填参数(如 token、device_id)、可选参数(如 page、filter)
数据字段映射:明确响应数据中需要爬取的字段(如商品 ID、标题、价格、图片 URL)
接口依赖关系:分析接口间的关联(如列表接口返回的 ID 作为详情接口的参数)
五、爬虫开发与自动化
- 基于抓包结果的反向工程
接口 URL 固化:从抓包数据中提取目标接口的完整 URL(含域名和路径)
请求头复刻:复制 App 的真实请求头(包括 User-Agent、Referer、Cookie、Authorization 等),避免被服务器识别为爬虫
参数验证分析:判断参数是否需要加密(如 sign 字段)、是否有时间戳校验(如 timestamp) - 模拟请求构造与签名破解
无加密场景示例:
import requests

# 从抓包结果中复制的请求头
headers = {
    'User-Agent': 'TargetApp/5.2.1 (iPhone; iOS 16.5; Scale/3.00)',
    'Referer': 'https://app.targetapp.com/',
    'Cookie': 'uid=123456; token=abcdef123456',
    'Content-Type': 'application/x-www-form-urlencoded'
}

# 构造请求参数(从抓包中提取)
params = {
    'page': 1,
    'size': 20,
    'category': 'hot'
}

# 发送请求
response = requests.get(
    url='https://api.targetapp.com/api/v1/list',
    headers=headers,
    params=params,
    verify=False  # 忽略SSL证书验证(本地测试用)
)

# 解析响应数据
if response.status_code == 200:
    data = response.json()
    print(data['data']['list'])  # 打印商品列表
加密参数破解思路:
若请求中存在 sign 等加密字段,通过 Whistle 的「断点调试」功能拦截请求,查看参数加密前的原始数据
分析 App 的反编译代码(需借助 jadx-gui 等工具),找到加密算法(如 MD5、SHA256、AES)
用 Python 复现加密逻辑,例如:
import hashlib
import time

def generate_sign(params, secret_key):
    # 按参数名排序
    sorted_params = sorted(params.items(), key=lambda x: x[0])
    # 拼接参数字符串
    param_str = ''.join([f"{k}{v}" for k, v in sorted_params]) + secret_key
    # MD5加密
    sign = hashlib.md5(param_str.encode()).hexdigest().upper()
    return sign

# 使用示例
params = {
    'page': 1,
    'size': 20,
    'timestamp': int(time.time()),
    'device_id': '861234567890123'
}
secret_key = 'target_app_secret_2024'  # 从App反编译中获取
params['sign'] = generate_sign(params, secret_key)
- 自动化爬虫框架搭建
Scrapy 项目结构:
targetapp_crawler/
├── scrapy.cfg
├── targetapp_crawler/
│   ├── __init__.py
│   ├── items.py       # 定义爬取字段
│   ├── middlewares.py # 配置请求头、代理
│   ├── pipelines.py   # 数据存储(本地/数据库)
│   ├── settings.py    # 爬虫配置
│   └── spiders/
│       ├── __init__.py
│       └── app_spider.py # 核心爬虫逻辑
核心爬虫代码(app_spider.py):
import scrapy
from targetapp_crawler.items import TargetAppItem
import hashlib
import time

class AppSpider(scrapy.Spider):
    name = 'target_app'
    allowed_domains = ['api.targetapp.com']
    start_urls = ['https://api.targetapp.com/api/v1/list']

    # 加密密钥(从抓包和反编译中获取)
    SECRET_KEY = 'target_app_secret_2024'

    def generate_sign(self, params):
        sorted_params = sorted(params.items(), key=lambda x: x[0])
        param_str = ''.join([f"{k}{v}" for k, v in sorted_params]) + self.SECRET_KEY
        return hashlib.md5(param_str.encode()).hexdigest().upper()

    def start_requests(self):
        # 构造第一页请求
        for page in range(1, 10):  # 爬取1-9页
            params = {
                'page': page,
                'size': 20,
                'timestamp': int(time.time()),
                'device_id': '861234567890123'
            }
            params['sign'] = self.generate_sign(params)

            yield scrapy.Request(
                url=self.start_urls[0],
                method='GET',
                params=params,
                headers=self.settings.get('DEFAULT_REQUEST_HEADERS'),
                callback=self.parse_list
            )

    def parse_list(self, response):
        data = response.json()
        # 解析列表数据
        for item in data['data']['list']:
            app_item = TargetAppItem()
            app_item['id'] = item['id']
            app_item['title'] = item['title']
            app_item['price'] = item['price']
            app_item['image_url'] = item['image']
            app_item['detail_url'] = f"https://api.targetapp.com/api/v1/detail?id={item['id']}"

            #  yield详情页请求
            yield scrapy.Request(
                url=app_item['detail_url'],
                headers=self.settings.get('DEFAULT_REQUEST_HEADERS'),
                callback=self.parse_detail,
                meta={'item': app_item}
            )

    def parse_detail(self, response):
        app_item = response.meta['item']
        data = response.json()
        # 解析详情数据
        app_item['description'] = data['data']['description']
        app_item['sales_count'] = data['data']['sales_count']
        yield app_item
- 处理反爬机制
- User-Agent 随机化:在 Scrapy 的middlewares.py中配置多个真实 App 的 User-Agent,随机切换
- IP 轮换:使用代理 IP 池(如阿布云、快代理),避免单一 IP 被封禁
– 请求频率控制:在settings.py中设置DOWNLOAD_DELAY = 2(每秒最多发送 0.5 个请求) - Cookie 池维护:定期更新 Cookie,避免因 Cookie 过期导致爬取失败
- 应对 SSL Pinning:若 App 启用 SSL 证书锁定,可通过以下方式绕过:
– Android:Root 后替换系统证书,或使用 Xposed 框架 + JustTrustMe 模块
– iOS:越狱后安装 SSL Kill Switch 2 插件
– 无 Root/Jailbreak:使用 Frida 脚本注入,hook 证书校验函数
六、实际案例演示
案例背景
目标:爬取某电商 App 的「限时特惠」栏目商品数据,包括商品 ID、标题、价格、销量、详情描述。
全流程步骤
- 环境准备:启动 Whistle,配置手机代理,安装并信任证书
- 抓包分析:
打开 App「限时特惠」栏目,Whistle 捕获到列表接口https://api.shopapp.com/promotion/list
分析请求:GET 方法,参数包括page(分页)、timestamp(时间戳)、sign(加密签名)
分析响应:JSON 格式,data.list为商品列表,包含基础信息;详情接口为https://api.shopapp.com/goods/detail?id=xxx - 签名破解:
通过反编译 App,发现 sign 生成规则:MD5(page + timestamp + device_id + secret_key)
secret_key 为固定值:shop_app_2024_promotion - 爬虫开发:按上述 Scrapy 框架搭建爬虫,集成签名生成逻辑
- 数据存储:在pipelines.py中配置 MySQL 存储,将爬取数据存入数据库
- 运行测试:启动爬虫,成功爬取 10 页共 200 条商品数据,无反爬拦截
关键代码片段,签名生成函数:
def generate_sign(page, timestamp, device_id):
    secret = "shop_app_2024_promotion"
    raw_str = f"{page}{timestamp}{device_id}{secret}"
    return hashlib.md5(raw_str.encode()).hexdigest()
Scrapy 设置(settings.py):
DEFAULT_REQUEST_HEADERS = {
    'User-Agent': 'ShopApp/6.3.0 (Android 13; Xiaomi MI 13)',
    'Cookie': 'uid=789012; session=xyz123456',
    'Accept': 'application/json'
}

DOWNLOAD_DELAY = 1.5  # 控制请求频率
ROBOTSTXT_OBEY = False  # 忽略robots.txt
ITEM_PIPELINES = {
    'targetapp_crawler.pipelines.MysqlPipeline': 300,
}
常见问题与解决方案
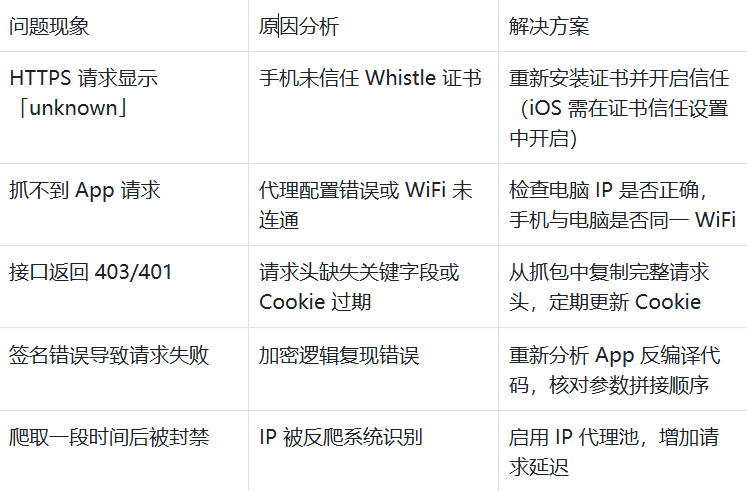
七、进阶技巧与优化
- Whistle 插件扩展功能
- 常用插件推荐:
whistle.certpin:绕过 App 的 SSL Pinning 证书校验
whistle.save:自定义抓包数据保存规则(如按接口分类保存)
whistle.decode:自动解码 Base64/URL 编码的请求 / 响应数据
插件安装方法:
w2 install whistle.certpin
-
性能优化与大规模抓包建议
关闭不必要的日志:在「设置」中取消「记录静态资源」「记录 OPTIONS 请求」,减少日志量
定期清理缓存:大规模抓包前,清理 Whistle 的历史数据(「设置」-「清除数据」)
分时段抓包:针对 App 高峰期请求量大的情况,分时段抓包并合并数据
使用过滤规则减少冗余:通过host://* !host://static.targetapp.com规则,只保留核心接口请求 -
结合 Mitmproxy 增强抓包能力
Mitmproxy 优势:支持 Python 脚本自动化处理请求(如实时破解加密参数)
协同方案:Whistle 作为基础抓包代理,Mitmproxy 作为二级代理处理复杂逻辑
Whistle中配置转发规则,将目标请求转发给Mitmproxy(默认端口8080)
host://api.targetapp.com proxy://127.0.0.1:8080
应用场景:需要实时修改请求参数、破解动态加密签名等高级需求
本文所介绍的技术仅用于个人学习、技术研究和合法的数据分析,严禁用于非法入侵、数据窃取、破坏他人权益等违法违规行为。使用者应自行承担因违规使用所产生的法律责任。
九、参考资料与延伸阅读
官方文档
Whistle 官方文档:https://wproxy.org/whistle/
Whistle GitHub 仓库:https://github.com/avwo/whistle
Scrapy 官方文档:https://docs.scrapy.org/
技术博客与开源项目
《Whistle 高级用法:移动端 HTTPS 抓包与 Mock 实战》
《App 爬虫加密签名破解实战》
开源项目:AppCrawler(App 自动化爬虫框架):https://github.com/seveniruby/AppCrawler
开源项目:Frida 脚本库(用于绕过 SSL Pinning):https://github.com/frida/frida
工具推荐
反编译工具:jadx-gui(Android)、Hopper Disassembler(iOS)
加密分析工具:IDA Pro、Ghidra
代理 IP 池:阿布云、快代理、芝麻代理
数据存储:MySQL、MongoDB(适合存储非结构化 JSON 数据)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 55
 0
- 0


 已为社区贡献2条内容

所有评论(0)