Python实战:图片混淆反爬虫技术解析
·
快速体验
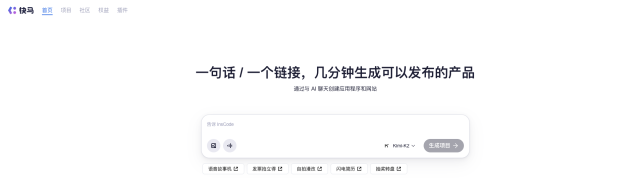
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个图片识别反爬虫系统,用于解析混淆图片中的文字内容。系统交互细节:1. 模拟浏览器请求目标网页 2. 提取页面中的混淆图片 3. 使用OCR技术识别图片文字 4. 输出识别结果。注意事项:需处理图片URL拼接,选择高精度OCR库。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
反爬虫技术解析
-
图片混淆原理:网站通过将关键信息嵌入图片而非文本中,阻止爬虫直接获取数据。这种技术常见于验证码、价格信息等场景,需要特殊处理才能获取真实内容。
-
核心实现步骤:
- 使用requests库模拟浏览器请求目标网页
- 通过XPath定位页面中的混淆图片元素
- 处理图片URL拼接,确保获取完整图片地址
-
调用OCR库识别图片中的文字内容
-
技术难点处理:
- 图片URL拼接时需考虑相对路径和绝对路径问题
- OCR识别准确率受图片质量影响较大
-
反爬虫策略可能需要定期更新OCR模型
-
优化方向建议:
- 尝试多种OCR引擎比较识别效果
- 对图片进行预处理提高识别率
-
设置合理的请求间隔避免被封禁
-
实际应用场景:
- 电商价格数据采集
- 验证码自动识别系统
- 网页关键信息提取
平台体验
在InsCode(快马)平台上实践这个反爬虫项目非常便捷,无需配置复杂环境,直接输入需求就能生成可运行的项目代码。
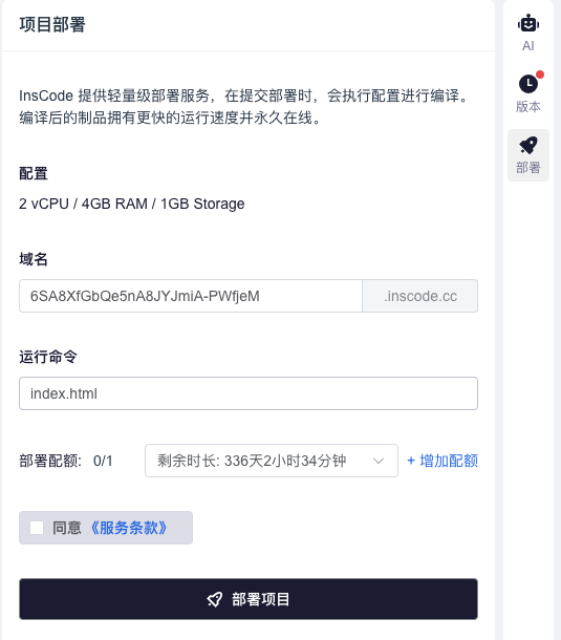
实际测试发现,平台内置的编辑器可以快速调试代码,一键部署功能让项目分享变得非常简单。对于需要持续运行的爬虫服务,部署后可以长期监控目标网站的变化。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献12条内容

所有评论(0)