知识图谱03——知识图谱的存储与查询
知识图谱的存储与查询
第1节 基于关系型数据库的知识图谱存储
关系型数据库(RDBMS)是知识图谱早期的存储载体,核心是将图结构(实体-关系-属性)转化为关系表结构,主要有4种经典方案:
1. 三元组表(Triple Store)
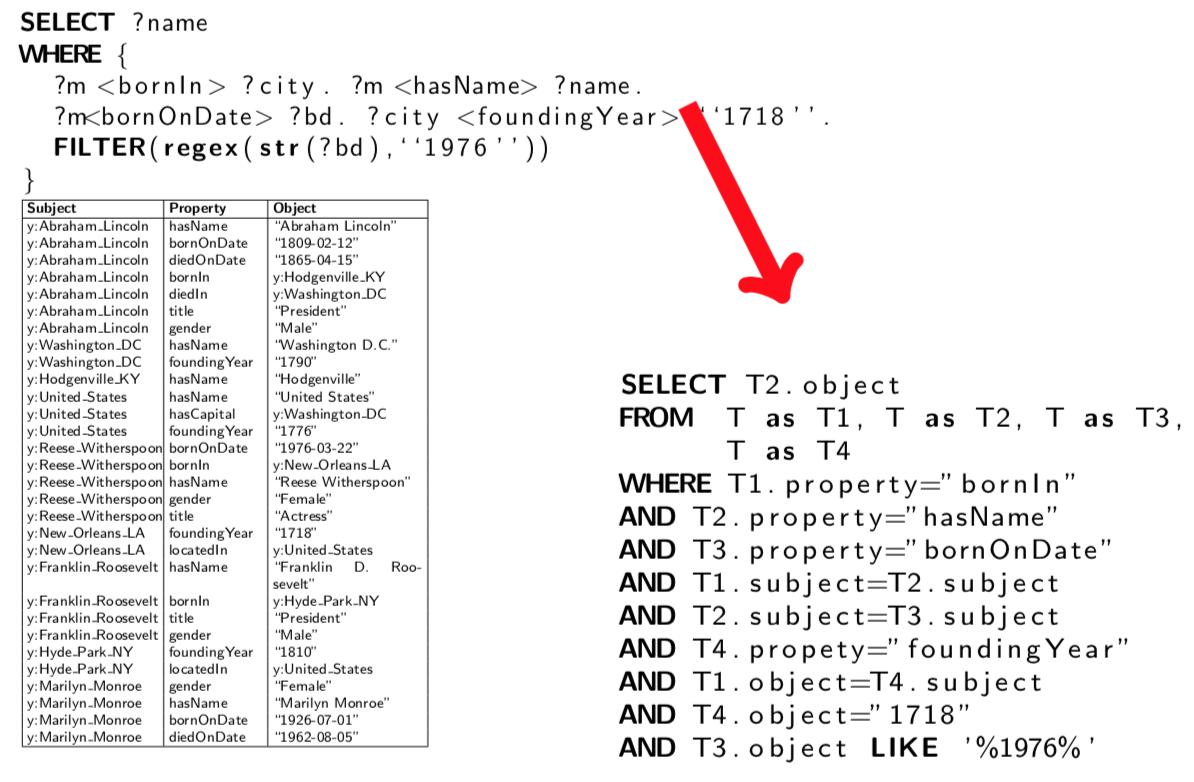
- 核心思想:用一张表存储所有三元组(Subject, Property, Object),是最简单的存储形式。
- 示例:将“Abraham Lincoln hasName ‘Abraham Lincoln’”“Abraham Lincoln bornOnDate ‘1809-02-12’”等均存入同一表中。
- 优点:结构极简,无需预先定义Schema。
- 缺点:查询时需大量自连接(Self Join),性能极差(例如查询“1976年出生、出生地为1718年建城的人”需关联4张表)。
- 代表系统:3store。
2. 属性表(Property Tables)
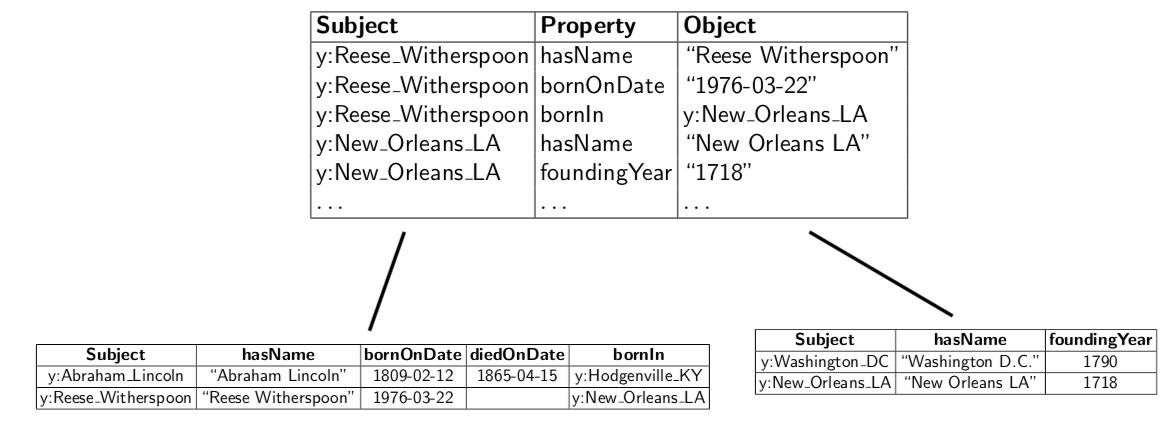
- 核心思想:按实体类型分组,同一类型实体的属性作为列,构建一张表(如“Person表”含hasName、bornOnDate、bornIn等列)。
- 优点:减少自连接Join操作,可直接复用RDBMS的成熟功能。
- 缺点:存在大量空值(如部分人无diedOnDate),难以处理多值属性(如一个人多个手机号),实体类型聚类复杂。
- 代表系统:Jena、DB2-RDF。
3. 二元表(Binary Tables/垂直划分表)
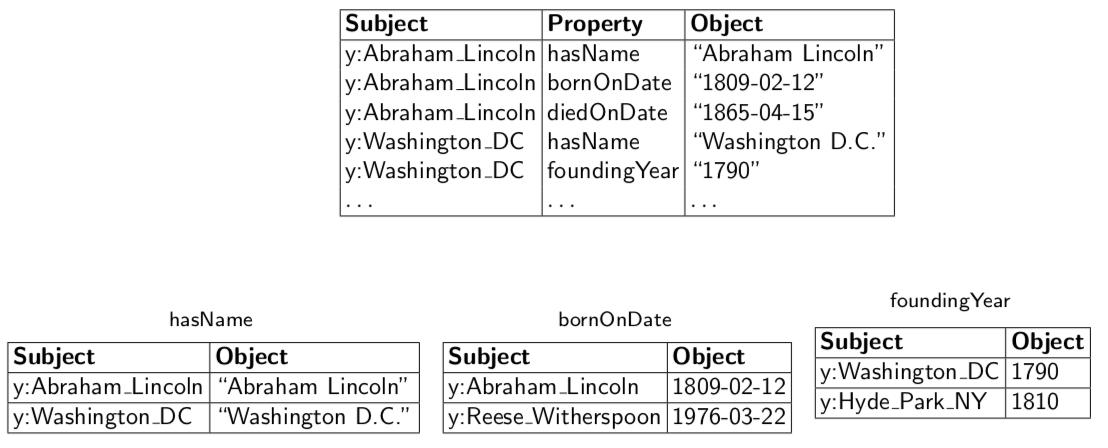
- 核心思想:按属性分组,每个属性单独建表,表结构为(Subject, Object)(如“hasName表”“bornOnDate表”)。
- 优点:无空值,支持多值属性,Subject-Subject Join性能好。
- 缺点:属性数量决定表数量,维护成本高;插入性能差,Subject-Object Join效率低。
- 代表系统:SW-Store。
4. 全索引结构(Exhaustive Indexing)
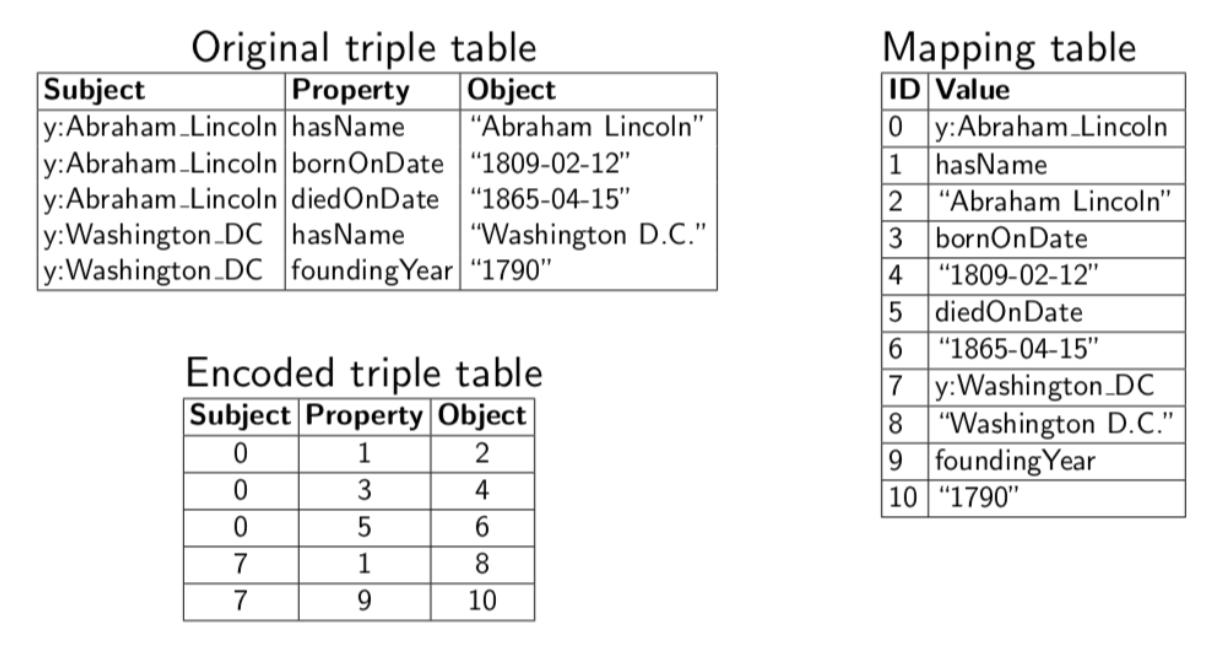
- 核心思想:基于三元组表优化,通过“字符串ID映射+六重索引”提升查询效率。
- 关键优化:
- 映射表(Mapping Table):将实体、属性的字符串转化为唯一数字ID,压缩存储空间。
- 六重索引:建立SPO、SOP、PSO、POS、OPS、OSP六种索引,覆盖所有查询维度。
- 优点:查询性能最优,任意三元组模式查询均可直接命中索引。
- 缺点:存储空间开销是原数据的6倍,数据更新维护成本极高。
- 代表系统:RDF-3X、Hexastore。
四种方案对比
| 存储方案 | 优点 | 缺点 | 代表系统 |
|---|---|---|---|
| 三元组表 | 结构简单,无需Schema | 大量自连接,查询低效 | 3store |
| 属性表 | 减少自连接,复用RDBMS功能 | 空值多,不支持多值属性 | Jena、DB2-RDF |
| 二元表 | 无空值,支持多值属性 | 表数量多,维护成本高 | SW-Store |
| 全索引结构 | 查询性能最优,覆盖所有查询维度 | 存储开销大,更新维护复杂 | RDF-3X、Hexastore |
第2节 基于原生图数据库的知识图谱存储
关系型数据库的本质是“表结构”,无法原生适配图的“关联结构”,因此原生图数据库应运而生——核心是“将关系作为一等公民(First-Class Citizen)”,直接存储图结构。
1. 关系型数据库的局限性
- 关系隐藏:语义关联被外键隐藏,多跳查询需频繁Join,性能随跳数指数下降(如5跳查询RDBMS无法完成,Neo4j仅需2.132秒)。
- 适配性差:无法高效处理自反关系(如“谁是Bob的朋友”需扫描全表)、传递关系(如“祖先”)、多跳关系(如“朋友的朋友”)。
- 灵活性不足:Schema固定,难以应对知识图谱的动态扩展(如新增“爱好”属性需修改表结构)。
- NoSQL也不适用:NoSQL(如MongoDB)同样不原生支持关系,多跳查询需暴力扫描,效率极低。
2. 原生图数据库的核心优势
- 关系显式存储:实体(节点)和关系(边)直接关联,无需Join,查询复杂度仅与相邻子图大小相关(与数据集整体大小无关)。
- 模型灵活:支持动态扩展(新增节点/边/属性无需修改Schema),适配知识图谱的开放世界假设。
- 支持复杂关系语义:天然支持自反、传递、对称、多跳等关系,查询逻辑更贴合自然语言。
3. 主流原生图数据库与查询语言
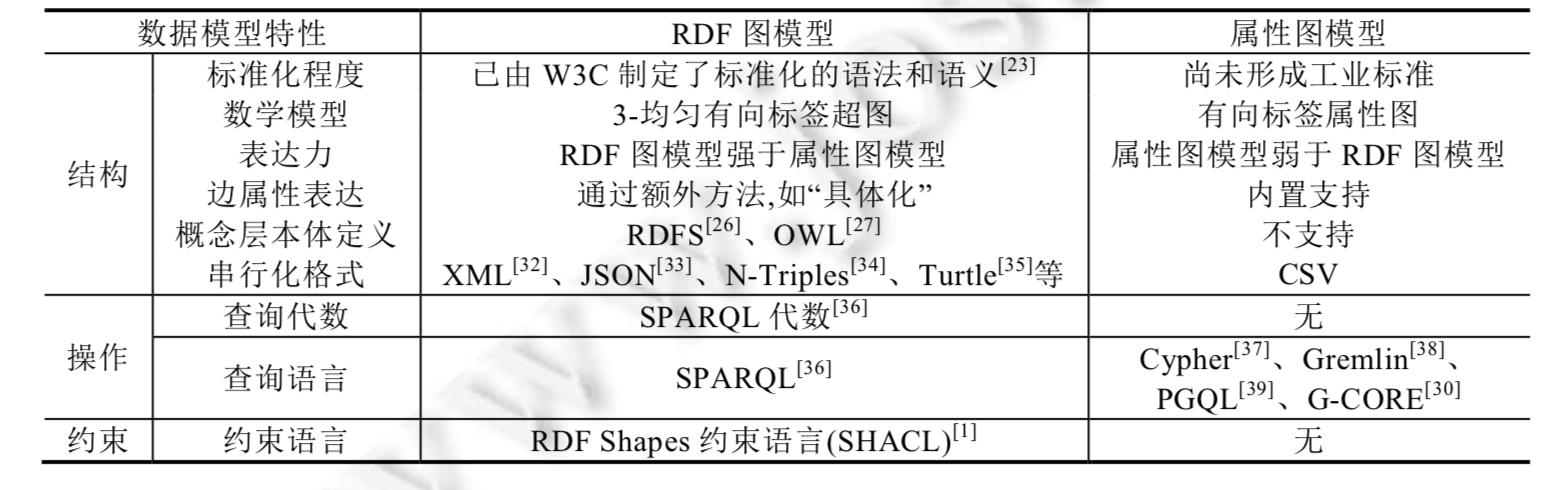
- 核心模型:属性图(工业界主流)和RDF图(语义网标准)。
- 代表性数据库:
- Neo4j:最流行的属性图数据库,支持Cypher查询语言,开源免费(社区版),商业版支持分布式。
- JanusGraph:分布式属性图数据库,支持Gremlin查询,可对接HBase/Cassandra存储。
- AllegroGraph:RDF图数据库,支持SPARQL和Prolog推理。
- Amazon Neptune:云原生图数据库,同时支持属性图和RDF。
- 主流查询语言:
- Cypher(Neo4j):语法简洁,贴合图结构(如
MATCH (a:Person)-[:KNOWS]->(b) RETURN a,b)。 - SPARQL(W3C标准):适配RDF图,支持复杂语义查询(如过滤、聚合)。
- Gremlin(Apache TinkerPop):通用图查询语言,支持多数据库适配。
- Cypher(Neo4j):语法简洁,贴合图结构(如
4. 应用示例:Cypher查询
- 场景:查询“纽卡斯尔皇家剧院上演的、莎士比亚1608年后创作的戏剧”。
- Cypher语句:
MATCH (theater:Venue {name:'Theatre Royal'}), (newcastle:City {name:'Newcastle'}), (bard:Author {lastname:'Shakespeare'}), (newcastle)<-[:STREET|CITY*1..2]-(theater)<-[:VENUE]-()-[:PERFORMANCE_OF]->()-[:PRODUCTION_OF]->(play)<-[w:WROTE_PLAY]-(bard) WHERE w.year > 1608 RETURN DISTINCT play.title AS play - 结果:直接返回《Julius Caesar》《The Tempest》,无需复杂Join,查询效率极高。
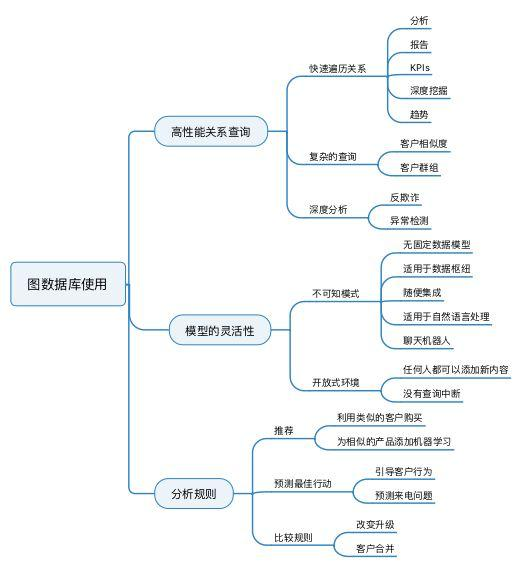
5. 图数据库的适用场景
- 高性能关系查询:如社交网络分析、欺诈检测、网络拓扑分析。
- 动态扩展需求:如知识图谱增量构建、多源数据融合。
- 复杂规则分析:如推荐系统(“喜欢A的人也喜欢B”)、客户相似度计算。
第3节 原生图数据库实现原理浅析
原生图数据库的高效核心是“免索引邻接(Index-free Adjacency)”,配合优化的物理存储设计,实现关联查询的极速响应。
1. 核心原理:免索引邻接
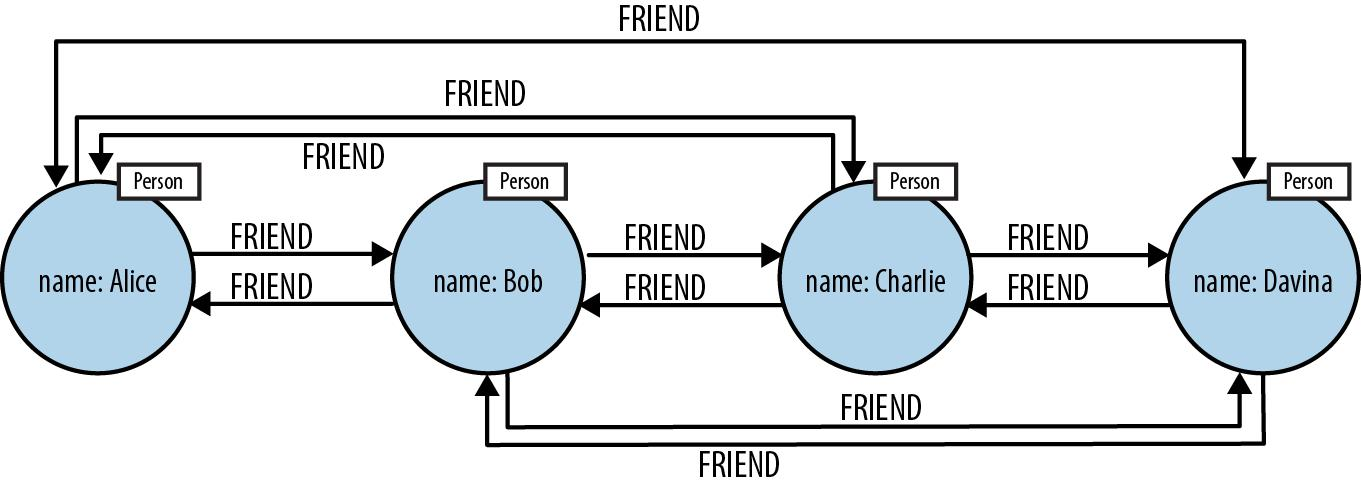
- 定义:每个节点直接维护指向其相邻节点的引用(微索引,Micro Index),无需全局索引即可快速遍历邻居。
- 优势:查询复杂度与数据集大小无关,仅与节点的邻居数量相关(如查询“Alice的朋友”仅需遍历Alice的相邻节点,复杂度O(k),k为邻居数)。
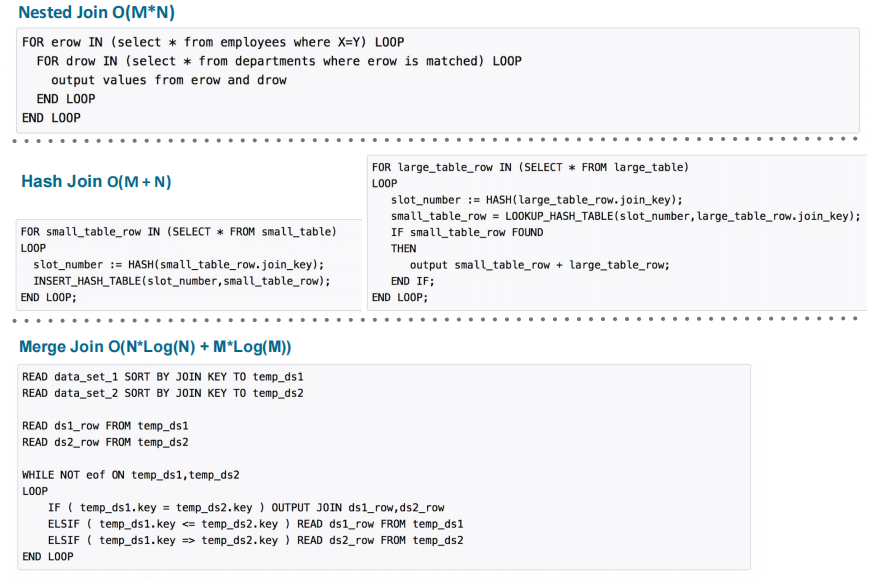
- 对比关系型数据库:传统Join的复杂度为O(M*N)(嵌套Join)或O(N log N)(合并Join),远高于免索引邻接。
2. 物理存储实现
原生图数据库的物理存储围绕“图遍历优化”设计,核心分为5类文件:
-
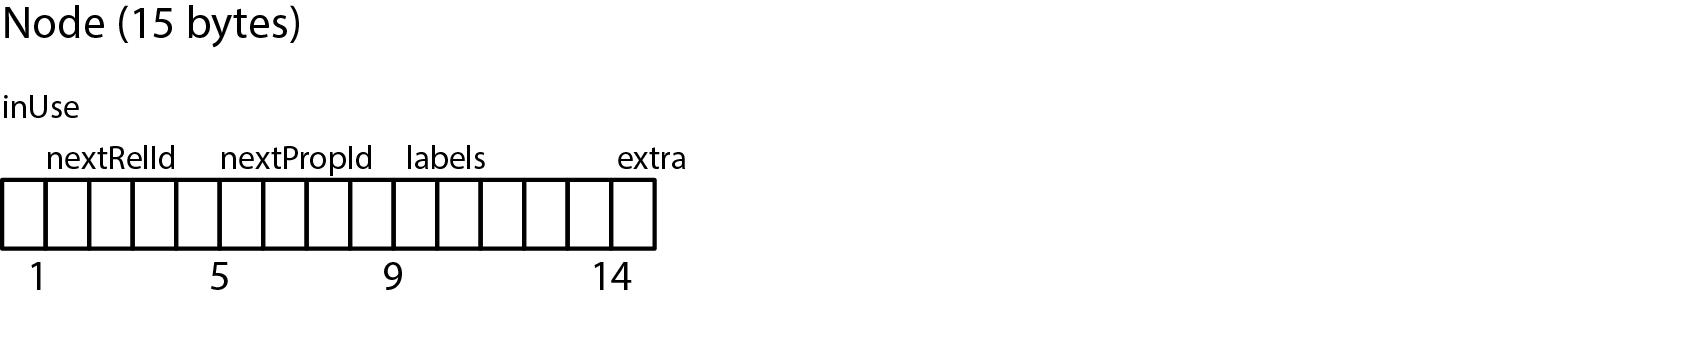
节点存储文件:存储节点元信息(固定14字节/节点),含“是否可用(inUse)”“第一个关系ID”“第一个属性ID”“标签ID”,支持O(1)快速定位节点。
-
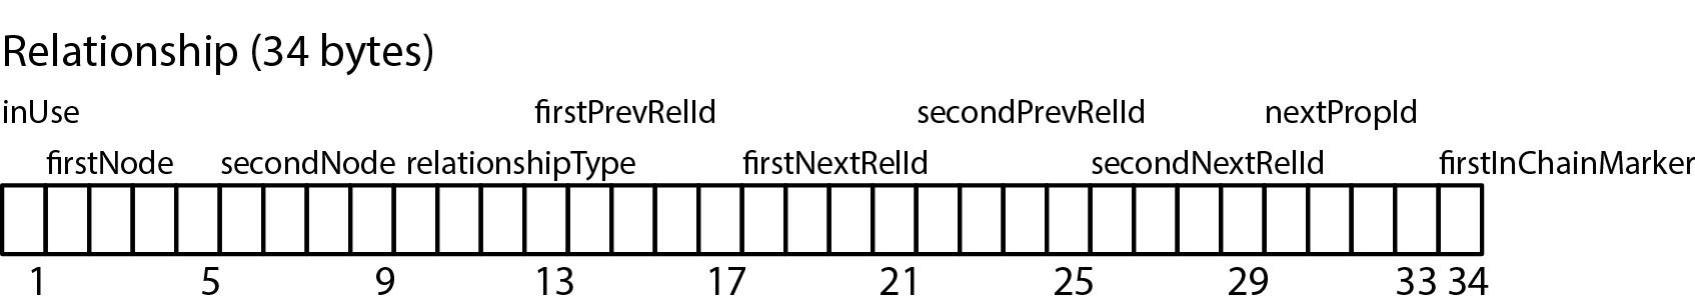
关系存储文件:存储关系元信息(固定34字节/关系),含“头尾节点ID”“关系类型ID”“前后关系ID”,支持快速遍历节点的出入边。
-
属性存储文件:单独存储节点/关系的属性(如name、age),节点/关系仅存储“第一个属性ID”,避免属性数据影响图遍历效率。
-
标签/关系类型存储文件:存储节点标签(如Person、Venue)和关系类型(如KNOWS、WROTE_PLAY)的元信息。
-
动态存储文件:存储大属性值(如长文本、数组),小属性值直接内联存储,平衡存储效率和查询速度。
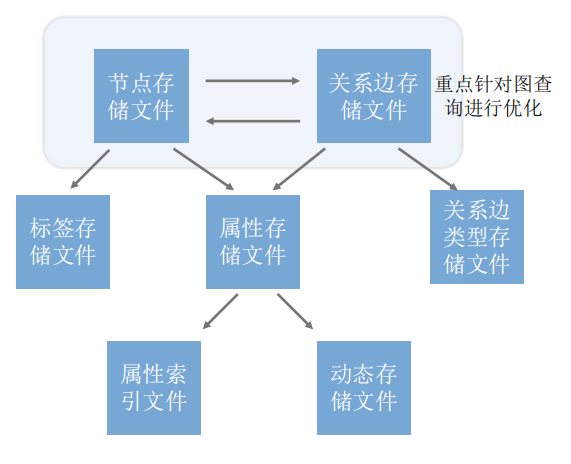
主要优化的点:
1.节点的查找,关系的查找
2. 从节点到关系,从关系到节点
3. 从关系到关系
4. 从节点到属性,从关系到属性
5. 从关系到关系类型。
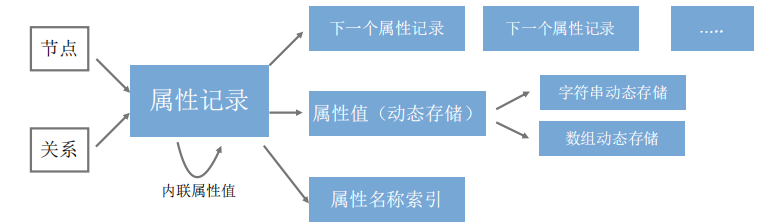
属性数据的存储处理:内联与动态存储
Ø 图数据库中存在大量属性,这些属性的检索与图遍历的计算是分开的,这是为了让节点之间的图遍历能不受大量属性数据的影响。
Ø 节点和关系的存储记录都包含指向它们的第一个属性ID的指针,属性记录也是固定大小,便于之间通过ID计算获得存储位置。
Ø 每个属性记录包含多个属性块,以及属性链中下一个属性的ID。
Ø 每个属性记录包含属性类型以及属性索引文件,属性索引文件存储属性名称。
Ø 对于每一个属性值,记录包含一个指向动态存储记录的指针(大属性值)或内联值(小属性值)。
3. 关键对比:RDF图 vs 属性图
4. 主流查询语言对比
| 查询语言 | 核心特性 | 适用场景 | 代表系统 |
|---|---|---|---|
| Cypher | 语法简洁,贴合属性图,支持模式匹配 | Neo4j生态,工业界快速开发 | Neo4j、AgensGraph |
| SPARQL | 适配RDF,支持语义推理、复杂过滤 | 语义网项目、学术研究 | Jena、Virtuoso |
| Gremlin | 通用型,支持多数据库适配,含图算法 | 多图数据库兼容场景 | JanusGraph、TinkerPop |
| PGQL | 支持子图同构查询,侧重分析型场景 | Oracle PGX生态 | Oracle PGX |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献6条内容

所有评论(0)