Python爬虫实战:轻松抓取网络小说内容
·
快速体验
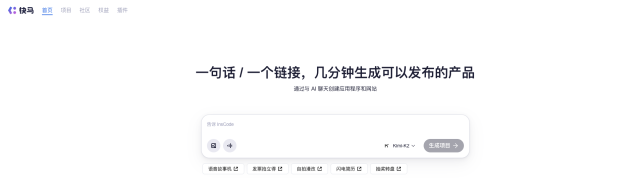
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个网页小说爬取系统,用于自动抓取指定网站的小说章节内容。系统交互细节:1.输入小说目录页URL 2.自动解析章节链接 3.逐个抓取正文内容 4.清洗并保存文本文件。注意事项:需设置请求间隔防止封IP。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
爬虫实现要点
-
环境准备 需要安装requests库用于发送HTTP请求,re模块用于正则匹配,json模块用于数据存储。这些基础库的组合能够满足大多数简单爬虫的需求。
-
目标分析 以三国演义小说网站为例,首先需要分析网页结构。通过浏览器开发者工具查看源代码,可以找到章节链接的HTML特征,这是编写正则表达式的基础。
-
目录抓取 使用requests发送GET请求获取网页内容后,通过精心设计的正则表达式提取所有章节标题和对应的URL。这里要注意设置合理的User-Agent模拟浏览器访问。
-
内容抓取 遍历每个章节链接,再次发送请求获取正文内容。使用re.DOTALL标志确保跨行匹配,获取完整的章节文本。为提高稳定性,建议添加随机延时模拟人工操作。
-
数据清洗 抓取的原始文本通常包含大量HTML标签和特殊字符。通过正则替换和字符串处理,去除无关内容,保留干净的文本。
-
结果存储 将清洗后的文本按章节保存到本地文件,建议使用UTF-8编码确保中文正常显示。可以同时保存JSON格式的目录结构便于后续管理。
-
反爬应对 合理设置请求间隔,使用随机延时。对于更复杂的网站,可能需要处理cookie、验证码等反爬机制。
-
扩展思考 可以考虑将抓取的文本自动生成电子书格式,或者开发成持续更新的小说订阅服务。也可以尝试使用更高效的异步请求库提高抓取速度。
平台体验
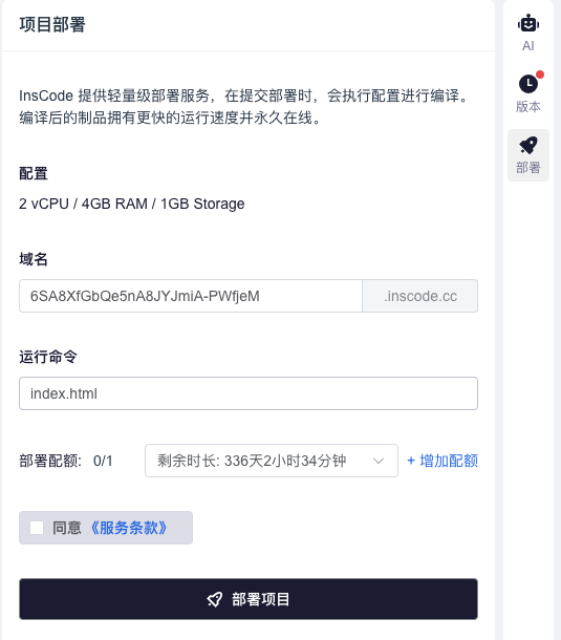
在InsCode(快马)平台上尝试这个项目非常便捷,无需配置环境就能直接运行。我发现它的AI辅助功能可以快速生成基础爬虫框架,特别适合新手快速上手。对于这个小说爬虫项目,平台的一键部署功能让结果展示变得很直观,抓取到的小说内容可以直接在线查看效果。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献12条内容

所有评论(0)