零代码玩转AutoScraper:智能爬虫实战全解析
·
快速体验
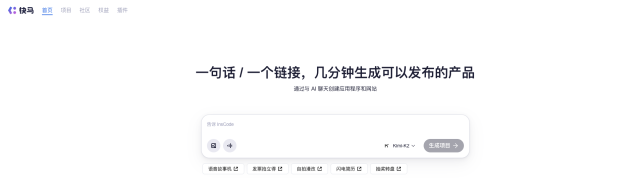
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个智能爬虫系统,用于自动提取网页中的产品信息。系统交互细节:1.输入目标网址和需要提取的数据样例 2.AI自动学习页面结构 3.输出所有匹配数据。注意事项:需提供3-5个准确样例数据。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
智能爬虫技术解析
- 传统爬虫的核心痛点
- 需要手动编写复杂的选择器表达式,对HTML结构理解要求高
- 网站结构变化会导致爬虫失效,维护成本居高不下
- 动态内容处理需要额外技术栈支持,如Selenium
-
数据清洗和格式化需要额外编写处理逻辑
-
AutoScraper的工作原理
- 基于示例学习的智能模式识别技术
- 自动构建DOM树并分析数据分布规律
- 生成多个候选选择器路径进行评估
- 选择最优匹配规则应用于全页面
-
支持规则保存和复用,降低重复开发成本
-
典型应用场景实践
- 电商平台价格监控:自动抓取竞品价格波动
- 新闻聚合:实时获取多家媒体热点内容
- 房产数据采集:批量获取房源信息
- 社交媒体分析:提取用户评论和互动数据
-
招聘信息收集:监控岗位需求变化
-
进阶使用技巧
- 分组提取:同时获取标题、价格等多类数据
- 规则优化:通过选择器栈筛选提高准确率
- 动态渲染:结合无头浏览器处理JS内容
- 分页处理:自动遍历多页数据
-
异常处理:应对反爬机制和网络波动
-
性能优化建议
- 合理设置请求间隔,避免被封禁
- 使用代理IP池应对高频访问限制
- 分布式部署提升采集效率
- 数据去重和校验机制
-
定时任务自动化运行
-
合规使用指南
- 严格遵守robots.txt协议
- 控制采集频率避免影响网站运营
- 仅采集公开可用数据
- 注意个人隐私保护
- 遵守数据使用相关法律法规
平台体验建议
在InsCode(快马)平台实际测试发现,其内置的AI代码生成功能可以快速构建爬虫原型,特别适合需要快速验证想法的情况。网站无需安装任何环境即可使用,对新手非常友好。
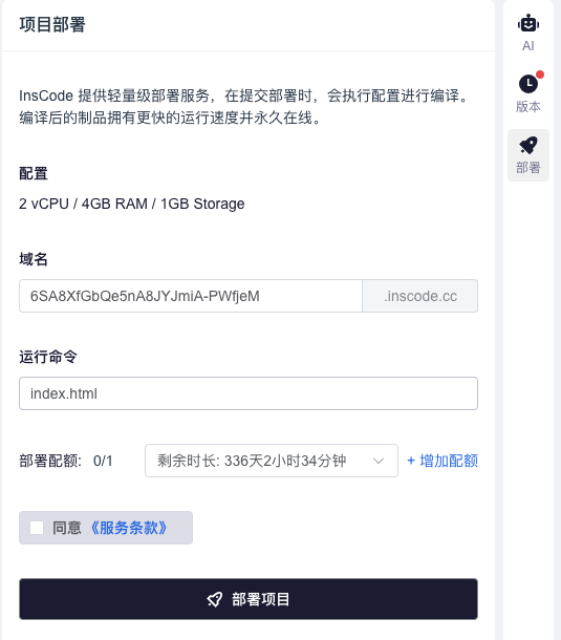
通过简单的描述就能生成可运行的爬虫代码,配合AutoScraper的智能提取能力,真正实现了零代码数据采集。对于需要长期运行的数据监控项目,平台的一键部署功能让项目上线变得异常简单。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献7条内容

所有评论(0)