向量数据库进阶必看!用一个医疗项目带你走完从数据到检索的完整链路
今天我将通过一个小的实战项目–基于ICD-10医疗编码的RAG检索系统,带大家走完从数据准备、向量存储到向量检索的完整流程。这样可以对之前的知识做一个简单的复盘。
项目背景
ICD-10 编码广泛用于医疗行业,是一套统一的疾病分类标准。从感冒到癌症,都有一个唯一的编码表示。它的作用是什么?因为你看病能不能顺利报销、医院怎么整理海量的病历、甚至国家如何跟踪和预防大规模的疾病,都离不开这套编码体系。
在实际医疗场景中,医生对于疾病的口语表述是不一样的。比如,“高血压”、“血压偏高”、“原发性高血压”……这些我们能听得懂,可系统机器不一定能识别出,并对应到标准的ICD-10编码中。
因此,我们的目标就是:
造一个足够聪明的“翻译官”,它不仅能听懂医生在说什么,更能理解他话里的真正含义,然后快速、准确地查出那个唯一、正确的ICD-10编码。
核心功能特性
为了解决上面场景中的问题,我设计了一套融合了命名实体识别(NER)与向量检索的RAG系统。
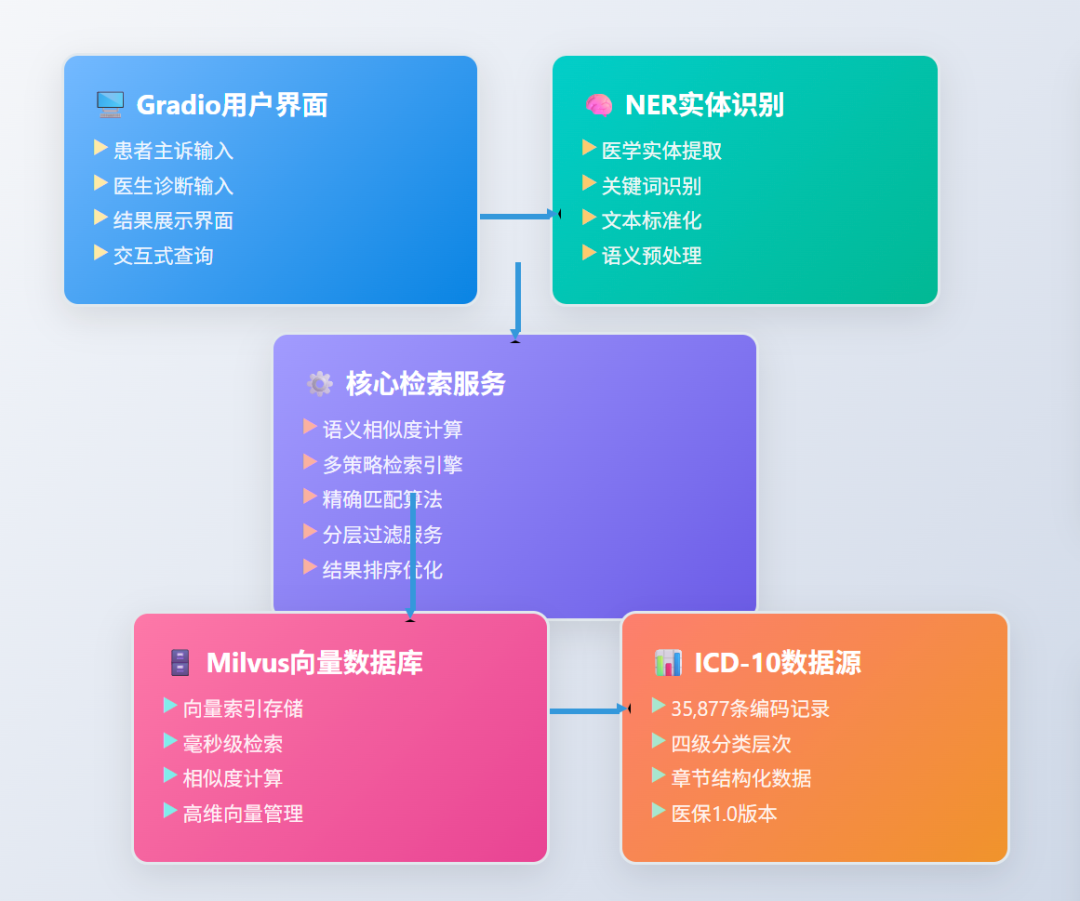
前端交互 (Gradio UI):作为UI操作页面,我选择了Gradio来快速搭建和使用。它有两个核心功能:“命名实体识别”和“诊断标准化”。
核心服务 (The Brain):两大关键能力:
- • 实体识别服务 (NER):它像一位初诊医生,能迅速从“患者主诉胸痛3天,伴有呼吸困难”这样的复杂描述中,提取出“胸痛”、“呼吸困难”等具有医学意义的关键实体。
- • 向量检索服务:这是本文的核心。它负责将用户输入的诊断信息“翻译”成高维向量,然后在数万个ICD-10编码构成的向量空间中,寻找语义上最接近的匹配项。
向量数据库 (Milvus):可以视作系统的长期记忆库。超过3.5万条ICD-10编码及其描述,都被转化成高维向量并存储于此。Milvus的价值在于,它能高效管理这些向量,并以毫秒级的延迟响应检索请求。
快速上手
1. 环境准备
# Python环境要求Python >= 3.10# 环境激活命令conda create -n embed_test python=3.10conda activate embed_test# 安装Milvus# 具体安装步骤可以参考官方文档:https://milvus.io/docs/zh/install_standalone-docker-compose.md# 启动Milvus服务docker-compose up -d milvus
2. 向量存储准备
这个流程在我的 build_database.py 脚本中实现:
# 构建向量数据库python build_database.py# 预期输出:# ✅ 数据加载完成: 35,877条记录# ✅ 向量化处理完成: 1024维向量# ✅ Milvus入库完成: icd10_diseases集合# ✅ 索引构建完成: IVF_FLAT索引
1. 数据加载与预处理
我们使用Pandas库加载 data目录下的ICD-10医保1.0版.csv 文件。这个文件包含了3万多条记录,每一条都由编码、疾病名称、别名等字段构成。
2. 文本向量化(Embedding)
这个流程我使用BAAI/bge-large-zh-v1.5嵌入模型。它用来将组合的文本内容转换成1024个浮点数的数组,也就是1024维的向量。
"急性心肌梗死" ---(BGE模型)--> [0.12, -0.45, 0.88, ..., 0.23] (一个1024维的向量)
3. 数据库索引与入库(Milvus)
在 build_database.py 流程中,我们连接Milvus服务,创建集合(Collection),并为其定义了数据结构(Schema),其中包含了主键、元数据字段,以及至关重要的向量字段。
接着我们将生成的向量批量存储到Milvus并构建索引。这里我采用了 IVF_FLAT 索引,其工作原理是:
先通过聚类算法将所有向量划分到不同的“桶”中,检索时系统先定位到与查询向量最相近的几个“桶”,然后只在这些小范围内进行精确的距离计算。这种方法在检索性能和结果准确率之间取得了出色的平衡,适用于当前的业务场景。
3. 向量检索机制
当用户在界面输入“急性心梗”并触发搜索时,系统的另一部分——向量检索服务 (search_service.py)便开始运作。
1. 查询向量化: 系统首先会调用与数据构建时完全相同的 BAAI/bge-large-zh-v1.5 模型,将用户的查询文本“急性心梗”也转换成一个1024维的向量。
2. 执行检索: 接着,它向Milvus发出检索请求,可以具象化为:Milvus向量数据库以这个新向量为参照,在 icd10_diseases 集合中,找出与它最相似的10个向量。
3. 相似度计算: Milvus内部利用预设的距离度量算法(例如L2距离或内积)来量化查询向量与数据库中所有向量的相似程度。距离越近,意味着语义关联性越强。
4. 结果返回: 最终,Milvus返回相似度最高的Top-K个结果的ID。服务层根据这些ID,从关系型数据库或缓存中提取出完整的ICD-10编码、疾病名称等详细信息,呈现给用户。
NER的辅助增强
为提升系统的准确性,我还集成了命名实体识别(NER)。
当面对“患者主诉胸痛3天,伴有呼吸困难和心悸”这类复杂描述时,NER模型 (lixin12345/chinese-medical-ner) 会率先启动,从中提取出核心的医学实体:[胸痛, 呼吸困难, 心悸]。
然后,系统才将这些识别出的实体作为查询主体,送入向量检索模块。
这一步骤,极大地提升了系统从混杂的诊断文本中提取有效信息并进行精确匹配的能力。
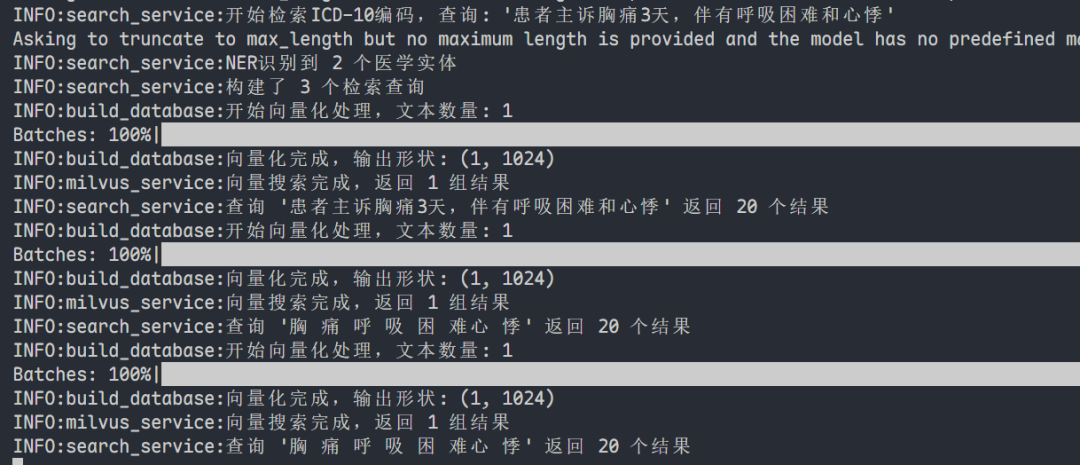
4. 操作界面展示
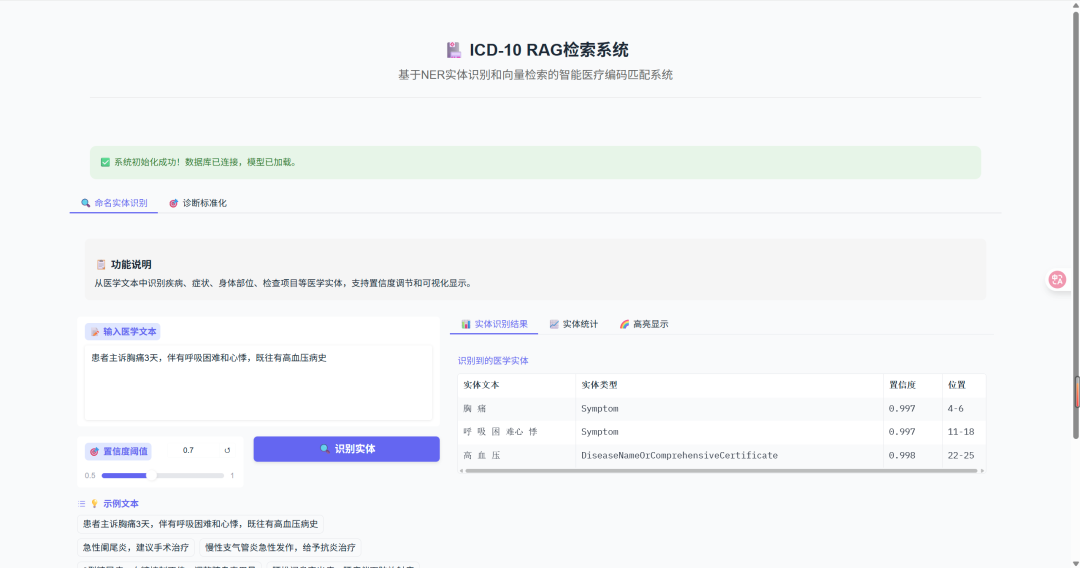
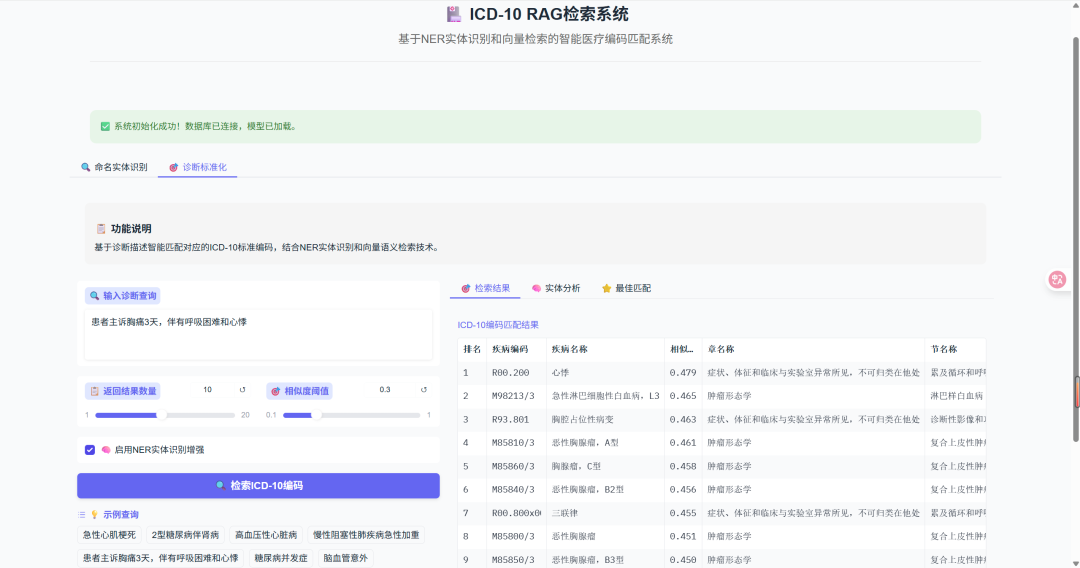
我使用Gradio快速搭建了UI界面,让这套RAG系统的功能可以更直观的操作。
# 启动Gradio Web界面python app.py
访问地址: http://localhost:7860
包含两个功能模块:
-
- 命名实体识别
-
- 诊断标准化检索
总结
通过这个ICD-10智能检索项目,我们亲手构建了一个具备实际应用价值的AI工具。我们走过的每一步,都验证了文章开篇所提及的核心概念:
- • 向量存储:它是将非结构化文本通过Embedding技术转化为结构化向量,并利用专业数据库进行高效索引和管理的过程。
- • 向量检索:它通过计算向量间的空间距离,实现了超越传统关键词匹配的、基于“语义”的智能查找。
这个项目只是一个小的起点。同样的技术范式,可以被广泛应用于法律文书检索、金融产品推荐、智能客服、企业内部知识库等众多领域。它就像一个强大的“语义理解引擎”,能让AI更深刻地理解人类知识,从而提供更精准的服务。
本文所有代码及项目详情均已开源,欢迎访问我的 🔗GitHub 查看、运行和 Star!
项目代码:https://github.com/yilane/rag-related/tree/main/src/04-rag-vector-storage/icd10-vectors-demo
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
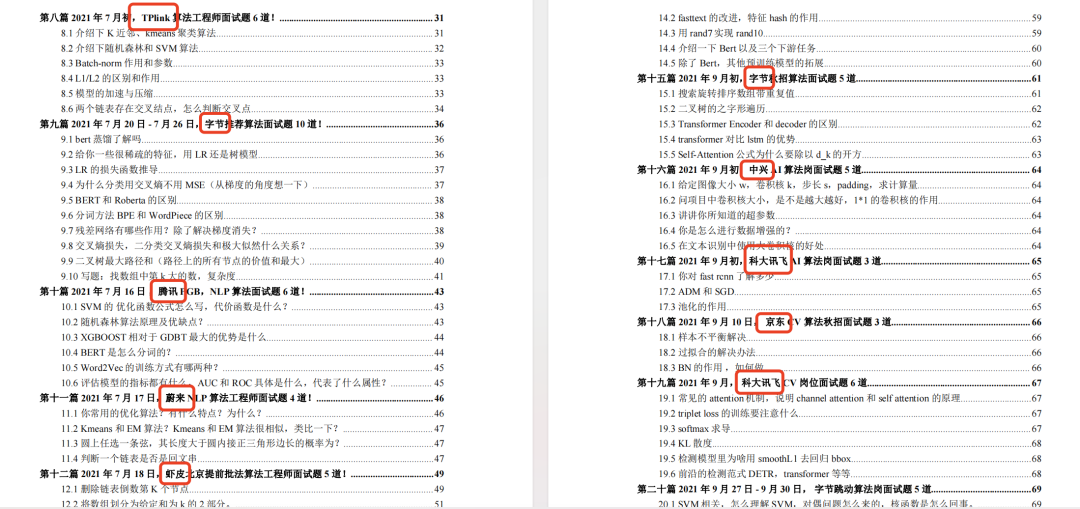
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
2. 102 道 AI 大模型真题:直击大模型核心考点
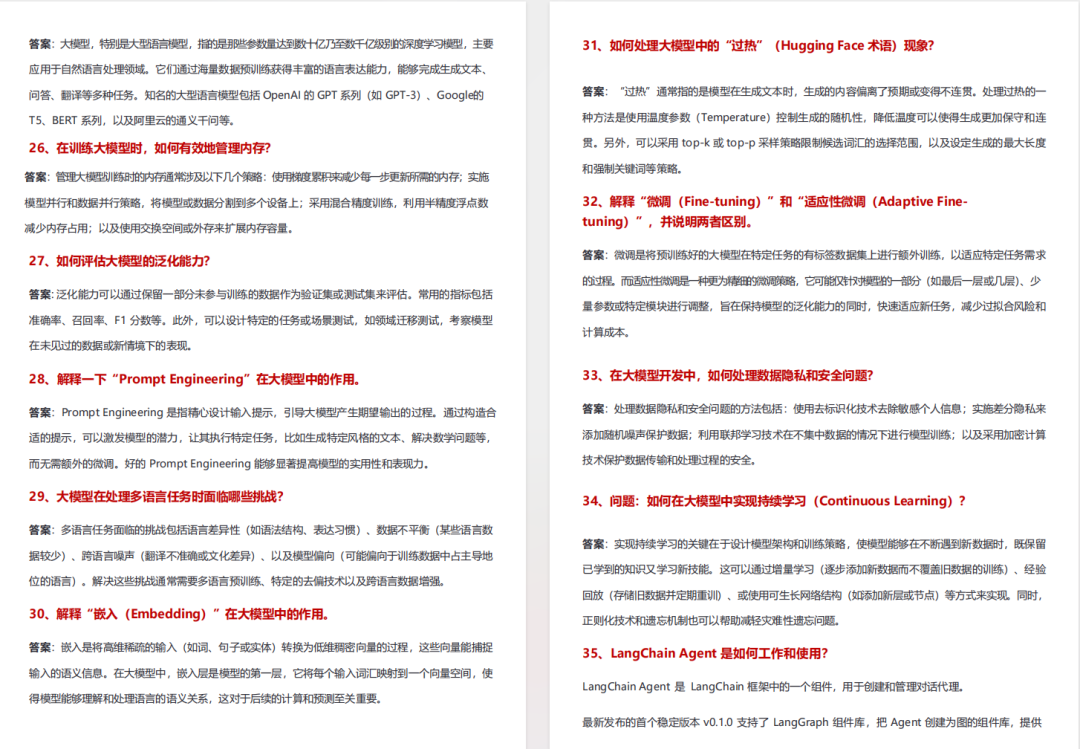
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
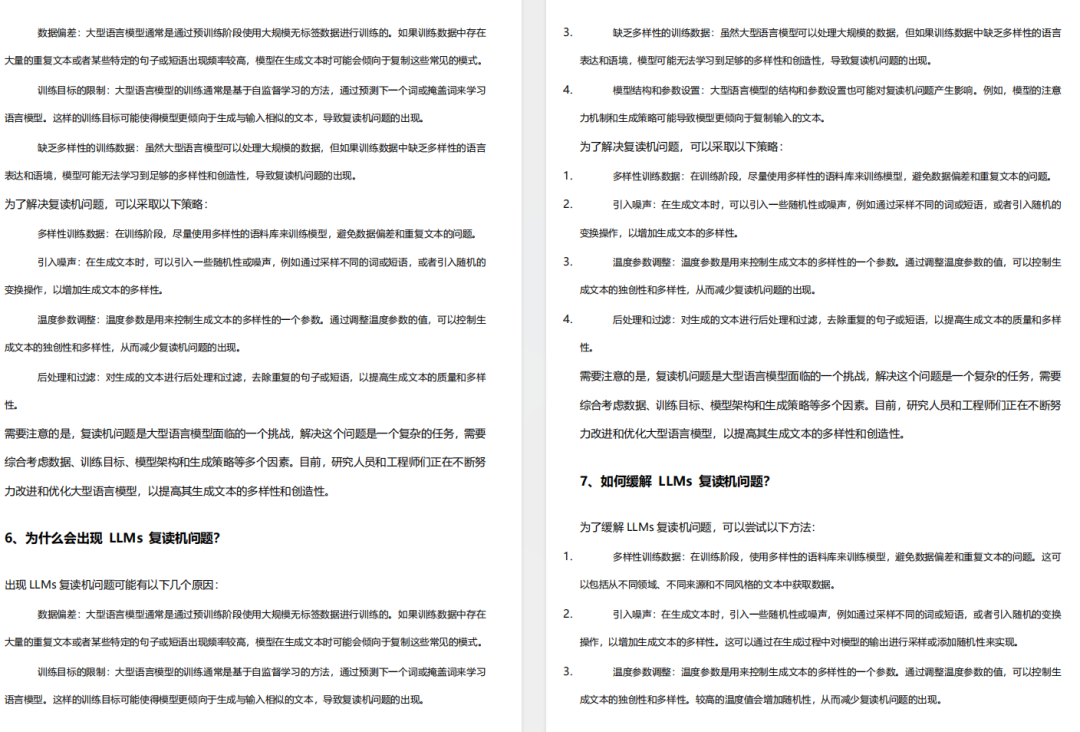
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
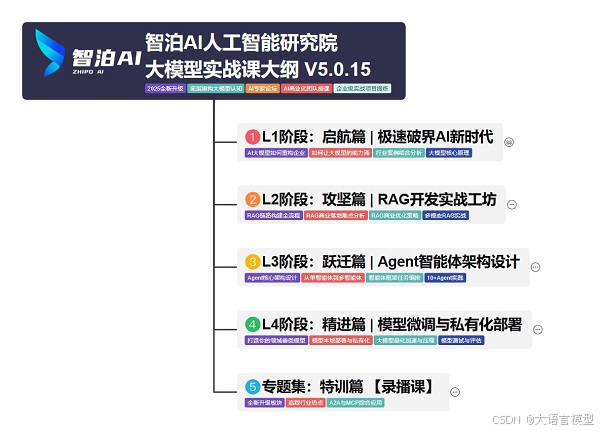
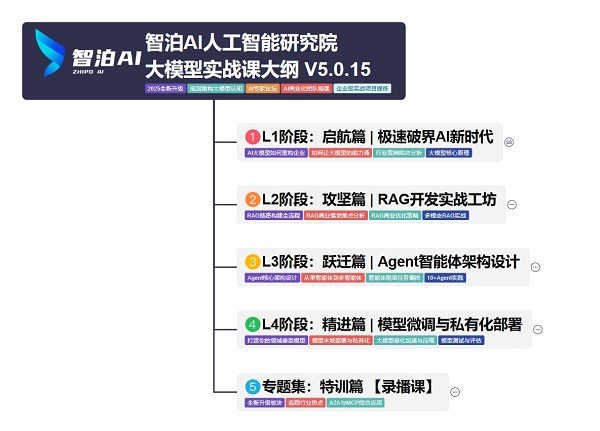
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
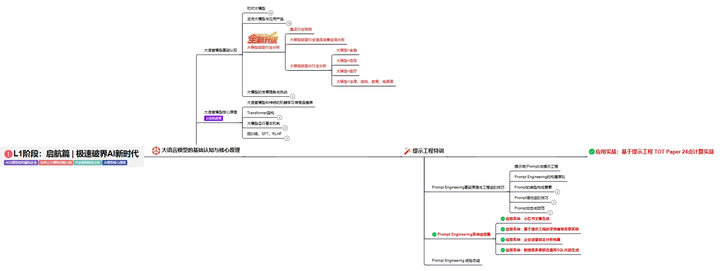
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
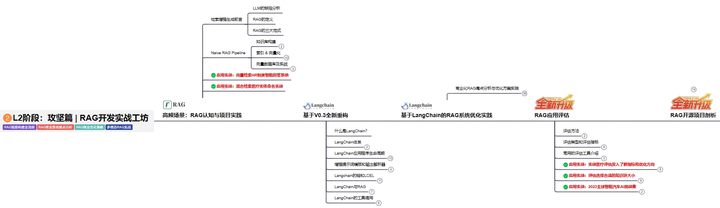
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
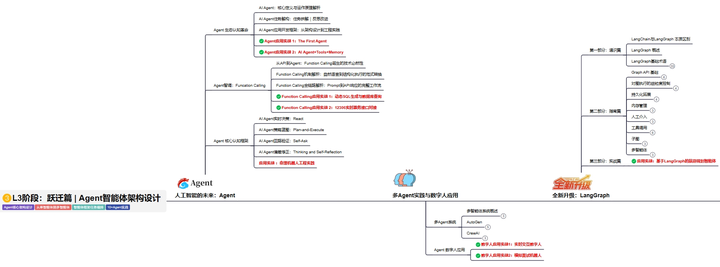
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
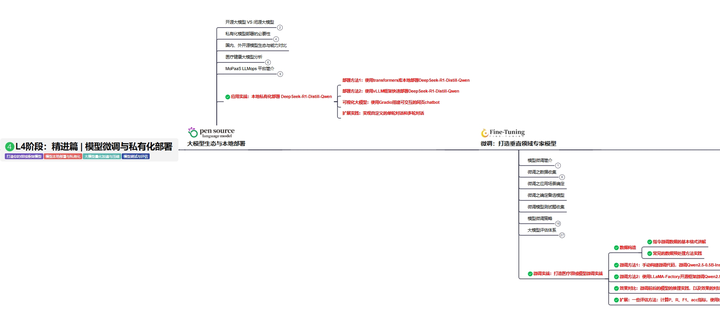
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
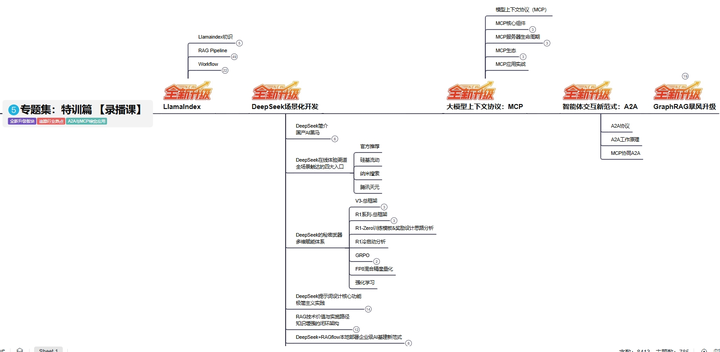
L5阶段:专题集丨特训篇 【录播课】
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献31条内容

所有评论(0)