Python爬虫实战:自动抓取影视资源网站数据
·
快速体验
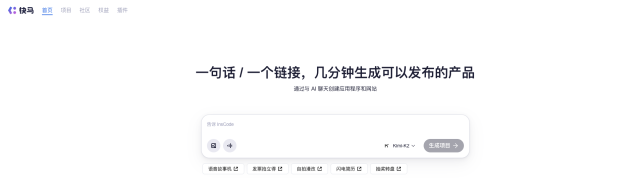
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个影视资源抓取系统,用于帮助影视爱好者自动获取最新影视更新信息。系统交互细节:1.自动爬取目标网站影视列表 2.解析影视名称/更新时间/下载链接 3.数据存储到数据库 4.提供网页展示界面。注意事项:需设置合理的请求间隔防止封禁 - 点击'项目生成'按钮,等待项目生成完整后预览效果
项目实现要点
-
目标网站分析 选择目标影视网站时需要重点关注页面结构特点,通常这类网站会采用列表页+详情页的方式组织内容。通过浏览器开发者工具可以查看网页DOM结构,找到影视信息所在的HTML标签和类名。要注意有些网站会采用动态加载或反爬机制。
-
请求处理技巧 使用requests库发送请求时,必须设置合理的User-Agent模拟浏览器访问。对于频繁访问的情况,建议添加随机延迟和代理IP池来避免被封禁。处理响应时要注意检查状态码,对异常情况做好错误处理。
-
数据解析方法 BeautifulSoup是解析HTML的利器,通过find和find_all方法可以精准定位目标元素。要注意处理可能出现的None值情况,为每个字段设置默认值。相对链接需要转换为绝对链接才能正常使用。
-
数据存储方案 MongoDB的文档型结构非常适合存储影视数据,每条记录包含标题、时间和下载链接等字段。插入数据前要检查是否已存在相同记录,避免数据重复。可以为常用查询字段建立索引提高查询效率。
-
前端展示实现 Flask作为轻量级Web框架,可以快速搭建展示界面。后端提供API接口返回JSON数据,前端通过fetch获取数据并动态渲染表格。表格样式可以使用CSS美化,添加悬停效果提升用户体验。
经验分享
- 在实际运行中会遇到各种异常情况,比如网络波动、页面改版等,需要完善错误处理和日志记录。
- 对于大型网站可以考虑使用Scrapy框架,它提供了更完善的重试机制和分布式爬取能力。
- 前端展示可以增加搜索和筛选功能,让用户能快速找到感兴趣的影视资源。
- 如果目标网站有验证码等反爬措施,可能需要引入OCR识别或人工打码服务。
平台体验
这个影视资源抓取系统非常适合在InsCode(快马)平台上一键部署。平台内置了Python环境和所需依赖库,省去了繁琐的环境配置过程。
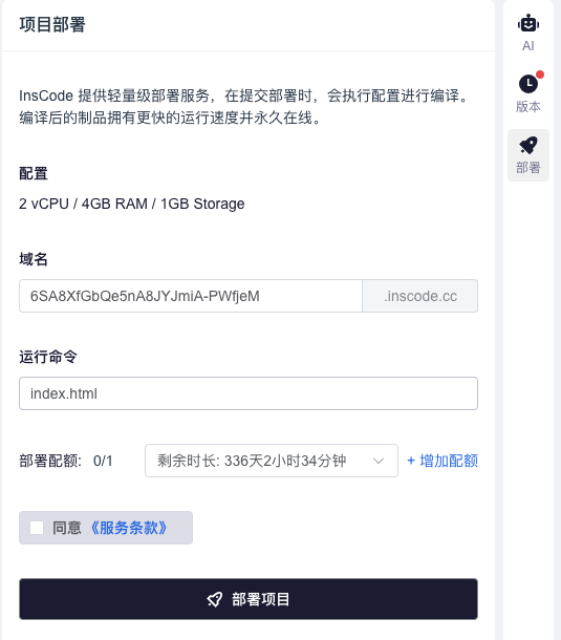
我实际测试发现,从代码生成到部署上线整个过程非常流畅,不需要操心服务器维护等复杂问题。对于想快速实现类似功能的开发者来说,这种一站式开发体验确实能节省大量时间。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献7条内容

所有评论(0)