Day15:Python实现实时天气爬虫
一、为什么要做这个小工具?
在过去的几天里,我们所有的原材料都来自我们自己的电脑(Excel, .txt文件)。我们已经可以处理本地文件了。
但是,这个世界上最大的数据源在哪里?在互联网上。
为什么我们每次查天气,都要手动打开浏览器、输入城市、然后用眼睛去看?
我们能不能让Python替我们去看,然后把数据抓回来?
今天,我们就来探索下入门版的网络爬虫。
我们将做一个自动的天气预报机器人。
二、requests库
要让Python上网,我们需要一个浏览器模块。
requests就是Python里最著名、最好用的网络请求库。
2.1. 安装
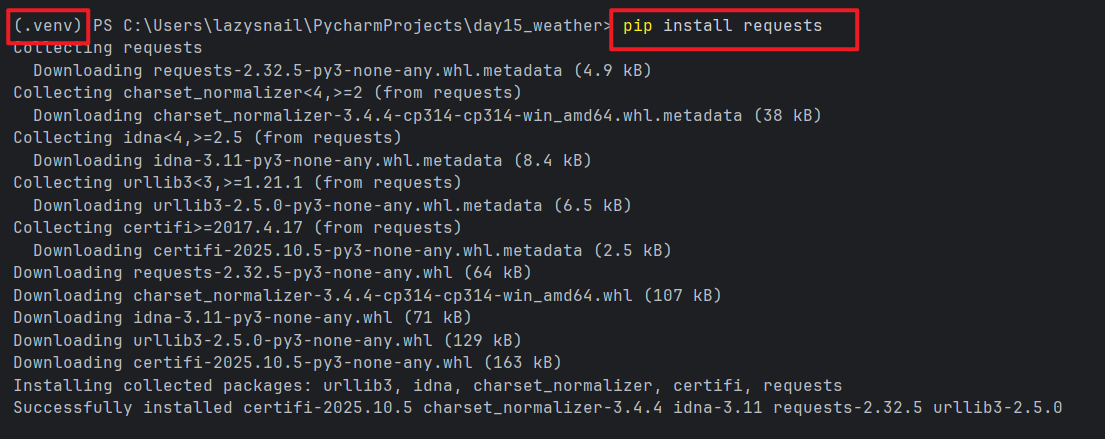
requests是第三方库,老规矩,打开PyCharm的Terminal:
pip install requests
2.2. 爬哪里?
新手爬虫最大的误区,就是去爬一个完整的网页。这种方式其实有点困难,网页的HTML代码都很复杂,很多零基础的是看不懂的。
再者就是网站一旦改版了,我们的爬虫就瞎了,就识别不了了,要调整代码,不然我们的代码就全部报废了。
我们可以不爬网页,直接去访问API。
我们可以把API理解成网站专门开的一个数据窗口,就是为了给程序(不是人)提供干净、整洁、格式化好的数据。
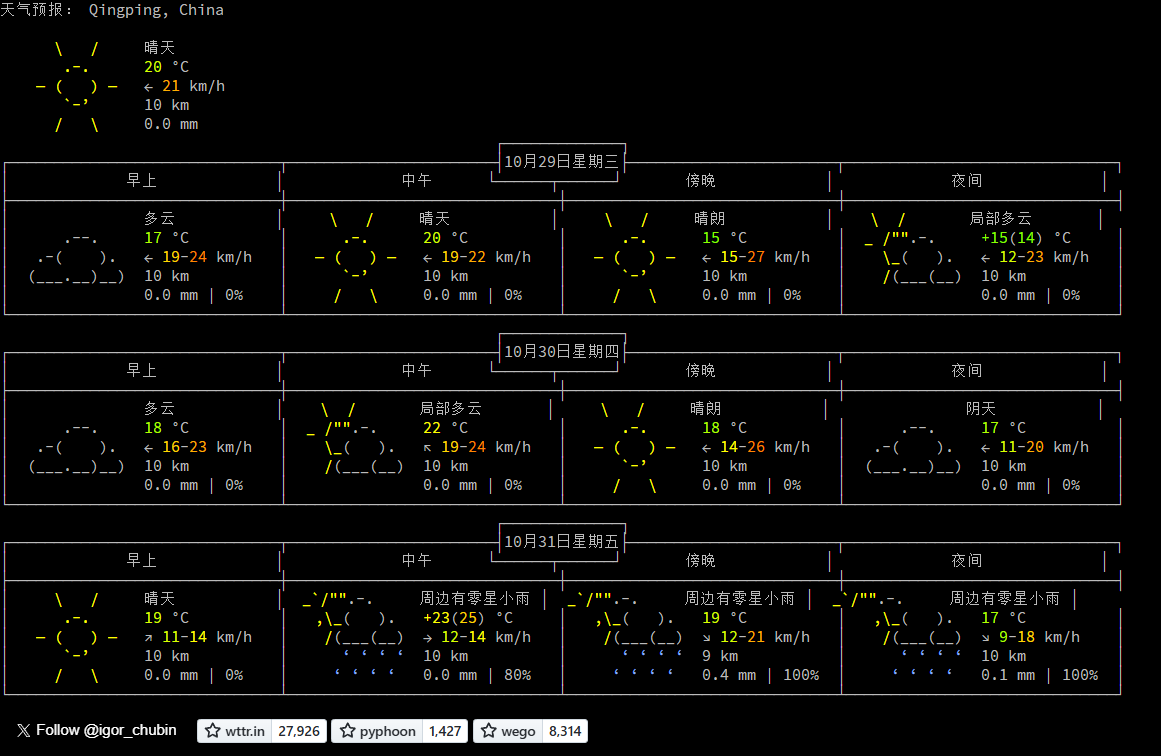
我们今天就选用一个比较友好的、免费、免注册的天气 API:wttr.in。
如果你直接在浏览器访问https://wttr.in/
三、连上网,把数据拿回来
这个版本我们先不管数据长什么样子,先试试能不能从网上抓到东西。
3.1. 敲代码
import requests

url = "https://wttr.in/China+Chongqing?format=j1"

print(f"正在连接到: {url}")

response = requests.get(url)

print(response.text)
3.2. 运行结果
终端会打印出一大堆密密麻麻、像字典一样的东西。
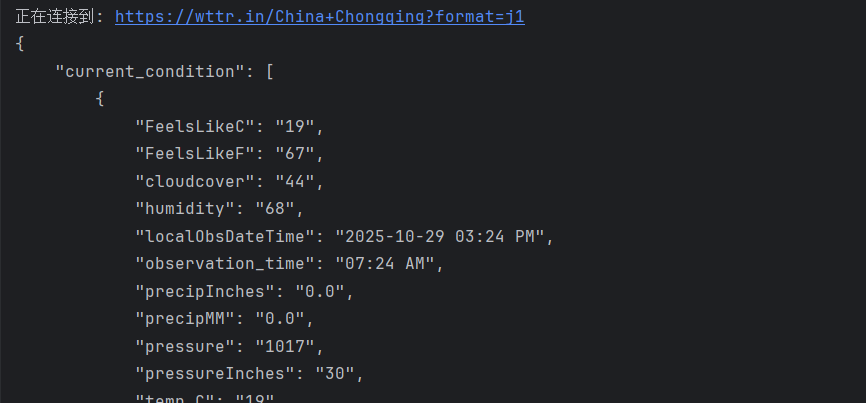
这些东西其实就是我们访问API,我们的脚本爬回来的东西。学名叫JSON。
3.3. 代码讲解
代码其实很简单,其实就是引入了一个requests库。
指定了一个我们需要访问的url地址。
直接通过get方法去访问地址,然后把访问到的数据打印到了控制台。
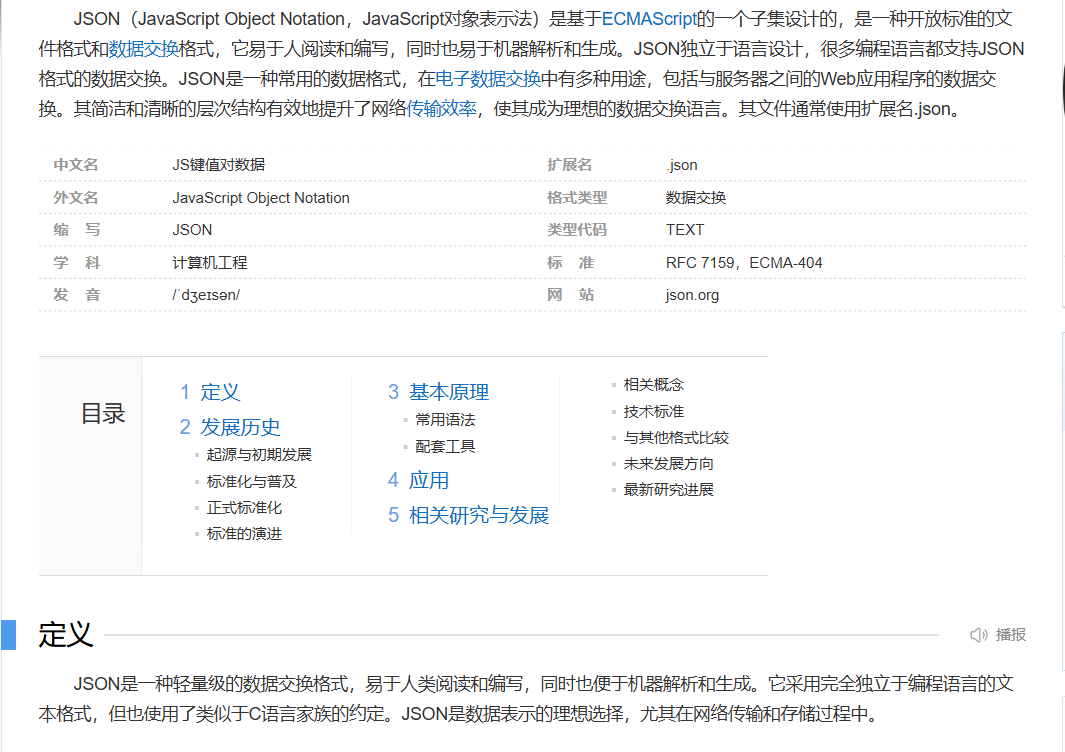
JSON是个什么东西?简单理解就是个键值对组成的数据格式。
四、看懂 JSON 数据
上一个版本我们把数据抓回来了,但是抓回来的那坨字符串有点乱。
但是JSON和Python的字典和列表几乎长得一模一样。
requests库已经内置了一个JSON解码器,能帮我们自动把他转成Python字典。
4.1. 敲代码
import requests

url = "https://wttr.in/China+Chongqing?format=j1"
print(f"正在连接到: {url} ...")

try:
    response = requests.get(url)

    data = response.json()

    current_condition = data["current_condition"][0]

    city = data["nearest_area"][0]["region"][0]["value"]
    temp_c = current_condition["temp_C"]
    feels_like_c = current_condition["FeelsLikeC"]
    weather_desc = current_condition["weatherDesc"][0]["value"]

    print("\n--- 实时天气 ---")
    print(f"城市: {city}")
    print(f"天气: {weather_desc}")
    print(f"温度: {temp_c}°C")
    print(f"体感: {feels_like_c}°C")

except Exception as e:
    print(f"出错了: {e}")
    print("无法获取天气,请检查城市名或网络连接。")
4.2. 运行结果
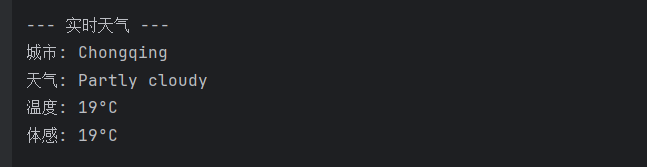
这就是解析出来的部分数据展示。
4.3. 代码讲解
data = response.json()
这是requests的功能之一,他会自动分析response.text里的JSON字符串,把他变成一个我们可以直接用[]来取值的Python字典。
datadata[“current_condition”][0][“temp_C”]就是挖数据的过程。
data[“current_condition”]拿到了一个列表[…]。
[0]表示取列表里的第0个元素,[“temp_C”]就是取出字典里temp_C对应的值。
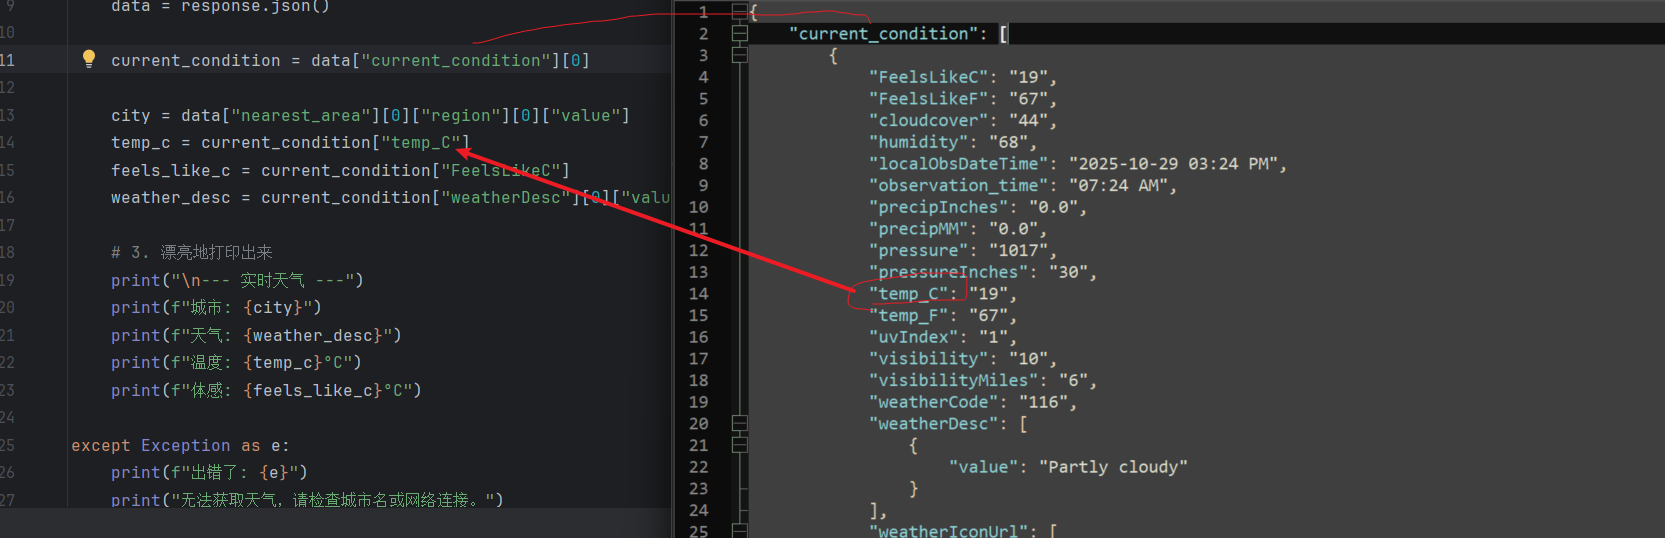
要取哪些数据,就慢慢对照着json数据一步步的找就行了。
五、终极版
我们这一步让用户可以自己输入想查的城市,然后把查询结果存下来。正好用一下之前文件操作的知识点。
5.1. 敲代码
import requests
import datetime

city = input("请输入你想查询的城市 (拼音或英文,例如 beijing): ").strip()
if not city:
    city = "Chongqing"

url = f"https://wttr.in/China+{city}?format=j1"

print(f"正在查询 {city} 的天气...")

try:
    response = requests.get(url)
    data = response.json()

    current_condition = data["current_condition"][0]
    real_city = data["nearest_area"][0]["region"][0]["value"]
    temp_c = current_condition["temp_C"]
    feels_like_c = current_condition["FeelsLikeC"]
    weather_desc = current_condition["weatherDesc"][0]["value"]

    # 4. 打印结果
    output_text = f"城市: {real_city}\n天气: {weather_desc}\n温度: {temp_c}°C\n体感: {feels_like_c}°C"
    print("\n--- 实时天气 ---")
    print(output_text)

    now = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    log_line = f"[{now}] {output_text.replace('\n', ' | ')}\n"

    with open("weather_log.txt", "a", encoding="utf-8") as f:
        f.write(log_line)

    print("\n(已保存到 weather_log.txt)")

except Exception as e:
    print(f"出错了: {e}")
    print("无法获取天气,请检查城市名或网络连接。")
5.2. 运行结果
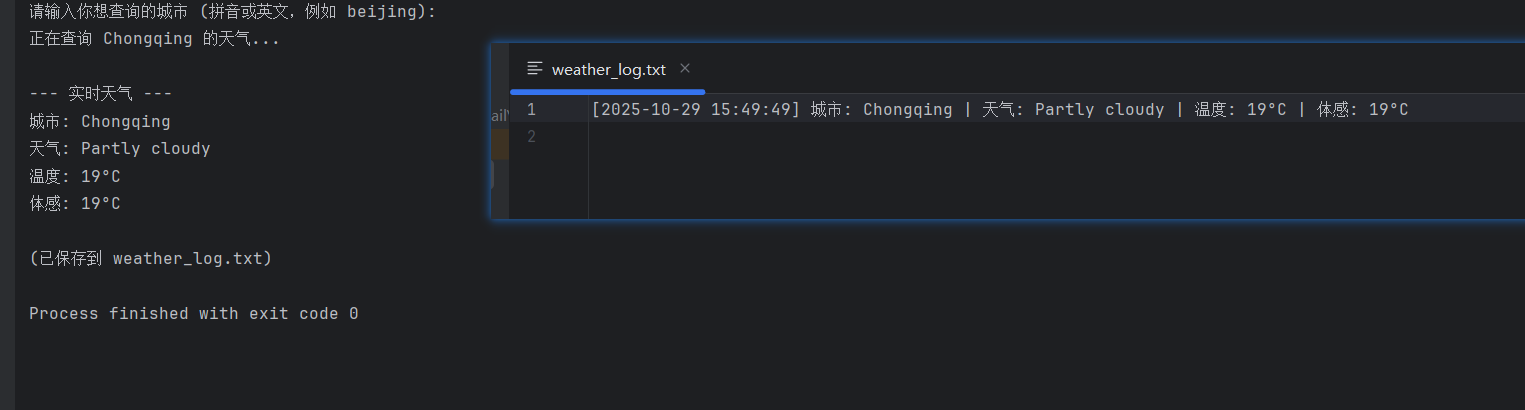
5.3. 代码讲解
这次的ulr我们没有写死了。留了一个用户输入的占位符口子,让用户可以自由的输入需要查询的城市。
如果用户没有输入,我们也有一个默认值。
除了把数据解析出来,还使用了之前操作文件的知识点,把我们的数据写到了本地的文件里面。
然后访问API或者解析数据时,都可能会出现异常,我们将主体代码都包在了try…except里面。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 10
 0
- 0


 已为社区贡献2条内容

所有评论(0)