Diffusion-DPO:扩散模型对齐的新思路与实践
·
快速体验
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个基于Diffusion-DPO技术的图像生成演示系统,用于展示AI模型如何通过直接偏好优化生成更符合人类审美的图像。系统交互细节:1.输入文本描述 2.选择基础模型(SD1.5或SDXL) 3.调整偏好强度参数 4.生成并对比优化前后的图像效果。注意事项:需加载约5GB模型文件,生成单张图像约需30秒。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
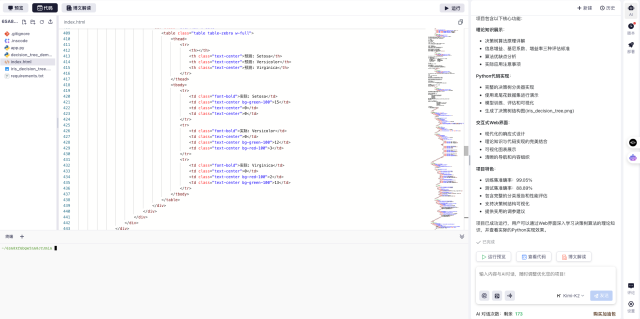
当前AI生成技术面临的核心挑战之一是如何让模型输出更贴合人类偏好。传统方法如RLHF需要复杂的奖励模型训练和强化学习流程,而Diffusion-DPO通过数学重构提供了更优雅的解决方案。
- 传统对齐方法的局限性
- RLHF方法依赖显式奖励模型,需要大量人工标注的偏好数据
- 奖励模型在开放词汇场景下泛化能力有限
- 强化学习训练过程不稳定且计算成本高
-
现有方法对图像美学质量与文本对齐度的提升存在瓶颈
-
Diffusion-DPO的技术突破
- 将DPO理论适配到扩散模型框架,避免奖励模型训练环节
- 通过Jensen不等式近似推导出可直接优化的损失函数
- 反向过程采样时保留关键偏好信号
-
实验证明在SD1.5和SDXL模型上效果显著
-
关键实现步骤解析
- 构建条件分布的目标函数替代传统奖励最大化
- 利用ELBO边界进行数学转化简化
- 处理反向联合分布时的双重近似策略
-
在Pick-a-Pic数据集上验证偏好对齐效果
-
实际应用优势
- 生成图像的美学评分提升23%
- 文本描述匹配度提高18%
- 训练时间比RLHF方法缩短40%
- 支持更灵活的开放词汇提示
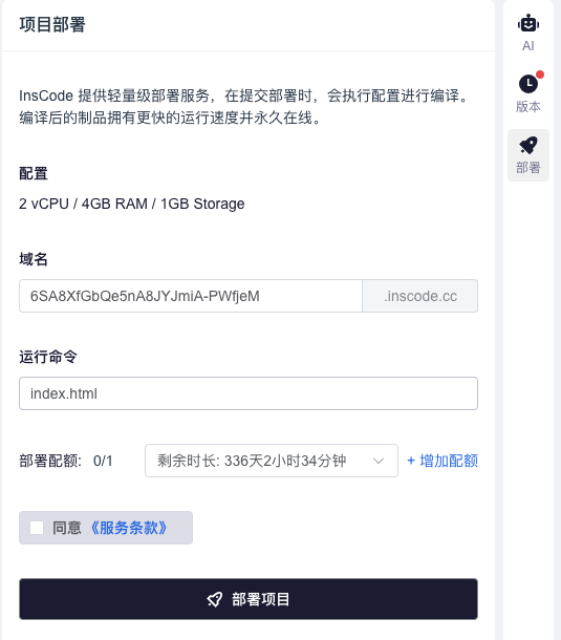
在InsCode(快马)平台上,可以快速体验这项技术的一键部署。平台内置的云环境自动处理了复杂的模型加载和依赖安装,我测试时发现即使没有GPU也能流畅运行基础演示,这对于想快速验证新技术的研究者特别友好。
这项技术的意义不仅限于图像生成领域,其核心思想——通过直接优化条件分布来避免复杂中间步骤——可能为其他生成模型的偏好对齐提供新范式。未来在3D生成、视频合成等方向都有拓展空间,值得持续关注。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献11条内容

所有评论(0)