计算机毕业设计Hadoop+Hive+PySpark小说推荐系统 小说可视化 小说爬虫(源码+文档+PPT+详细讲解)
·
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
温馨提示:文末有 CSDN 平台官方提供的学长联系方式的名片!
信息安全/网络安全 大模型、大数据、深度学习领域中科院硕士在读,所有源码均一手开发!
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助更多的人
介绍资料
以下是一篇关于《Hadoop+Hive+PySpark小说推荐系统》的开题报告框架及内容示例,供参考:
开题报告
题目:基于Hadoop+Hive+PySpark的小说推荐系统设计与实现
一、研究背景与意义
-
背景
随着互联网文学的快速发展,小说平台积累了海量用户行为数据(如阅读记录、评分、评论等)。如何从这些数据中挖掘用户偏好,提供个性化推荐,成为提升用户体验和平台竞争力的关键。传统的单机推荐算法(如协同过滤)在处理大规模数据时面临性能瓶颈,而分布式计算框架(如Hadoop、Spark)能够高效处理海量数据,为构建高精度推荐系统提供了技术支撑。 -
意义
- 理论意义:探索分布式计算框架在推荐系统中的应用,验证混合推荐算法(如基于内容的推荐+协同过滤)在大数据场景下的有效性。
- 实践意义:为小说平台提供可扩展的推荐解决方案,提升用户粘性和平台收益。
二、国内外研究现状
- 推荐系统研究
- 传统推荐算法(协同过滤、基于内容的推荐)在中小规模数据中表现良好,但存在冷启动、数据稀疏性问题。
- 深度学习推荐模型(如Wide & Deep、Neural Collaborative Filtering)在精度上有所提升,但计算复杂度高,难以直接应用于超大规模数据。
- 分布式推荐系统研究
- Hadoop/Spark等框架被广泛用于推荐系统的数据预处理和模型训练(如Mahout、Spark MLlib)。
- 现有研究多集中于电商、视频领域,针对小说平台的分布式推荐系统研究较少。
- 现有问题
- 小说数据具有长尾效应(少数热门作品占大部分流量),传统算法难以挖掘小众优质内容。
- 实时推荐需求(如用户即时行为反馈)对系统响应速度提出更高要求。
三、研究内容与目标
- 研究内容
- 数据层:基于Hadoop构建分布式存储系统,存储用户行为数据、小说元数据等。
- 数据处理层:利用Hive进行数据清洗、特征提取(如用户画像、小说标签)。
- 算法层:结合PySpark实现混合推荐算法:
- 基于内容的推荐(TF-IDF提取小说文本特征)。
- 协同过滤(ALS算法优化用户-小说评分矩阵)。
- 深度学习模型(可选:使用Spark NLP结合简单神经网络)。
- 评估层:通过离线实验(准确率、召回率)和在线A/B测试验证推荐效果。
- 研究目标
- 设计并实现一个基于Hadoop+Hive+PySpark的小说推荐系统。
- 解决传统推荐系统在大数据场景下的性能瓶颈。
- 提升长尾小说的曝光率,优化推荐多样性。
四、研究方法与技术路线
- 技术选型
- 存储与计算:Hadoop HDFS存储原始数据,Hive管理结构化数据仓库。
- 数据处理:PySpark进行分布式特征工程和模型训练。
- 推荐算法:
- 离线阶段:基于Spark MLlib实现ALS协同过滤。
- 在线阶段:结合用户实时行为(如点击、阅读时长)调整推荐结果。
- 技术路线图
1数据采集 → Hadoop存储 → Hive清洗 → PySpark特征工程 → 混合推荐模型 → 效果评估 → 部署优化
五、预期成果与创新点
- 预期成果
- 完成系统原型开发,支持千万级用户和百万级小说的推荐。
- 实验证明混合推荐算法在准确率和多样性上优于单一算法。
- 创新点
- 技术融合:首次将Hadoop+Hive+PySpark完整应用于小说推荐场景。
- 长尾优化:通过引入小说内容特征(如题材、风格)缓解冷启动问题。
- 实时性:结合Spark Streaming实现近似实时推荐。
六、进度安排
| 阶段 | 时间节点 | 任务 |
|---|---|---|
| 文献调研 | 第1-2周 | 收集推荐系统、分布式计算相关资料 |
| 系统设计 | 第3-4周 | 完成架构设计与数据模型设计 |
| 环境搭建 | 第5周 | 部署Hadoop/Hive/Spark集群 |
| 算法实现 | 第6-8周 | 开发PySpark推荐模块 |
| 实验与优化 | 第9-10周 | 离线测试、调参、A/B测试 |
| 论文撰写 | 第11-12周 | 完成论文并答辩 |
七、参考文献
- Apache Hadoop官方文档.
- Apache Hive官方文档.
- Zaharia M, et al. "Apache Spark: A Unified Engine for Big Data Processing." Communications of the ACM, 2016.
- Koren Y, et al. "Matrix Factorization Techniques for Recommender Systems." IEEE Computer, 2009.
- 李航. 《统计学习方法》(第2版). 清华大学出版社, 2019.
八、指导教师意见
(待填写)
备注:
- 可根据实际需求调整技术细节(如是否引入深度学习模块)。
- 需补充具体数据集来源(如公开小说数据集或合作平台数据)。
- 实验部分需明确评估指标(如RMSE、NDCG等)。
希望这篇框架能为您的开题报告提供参考!
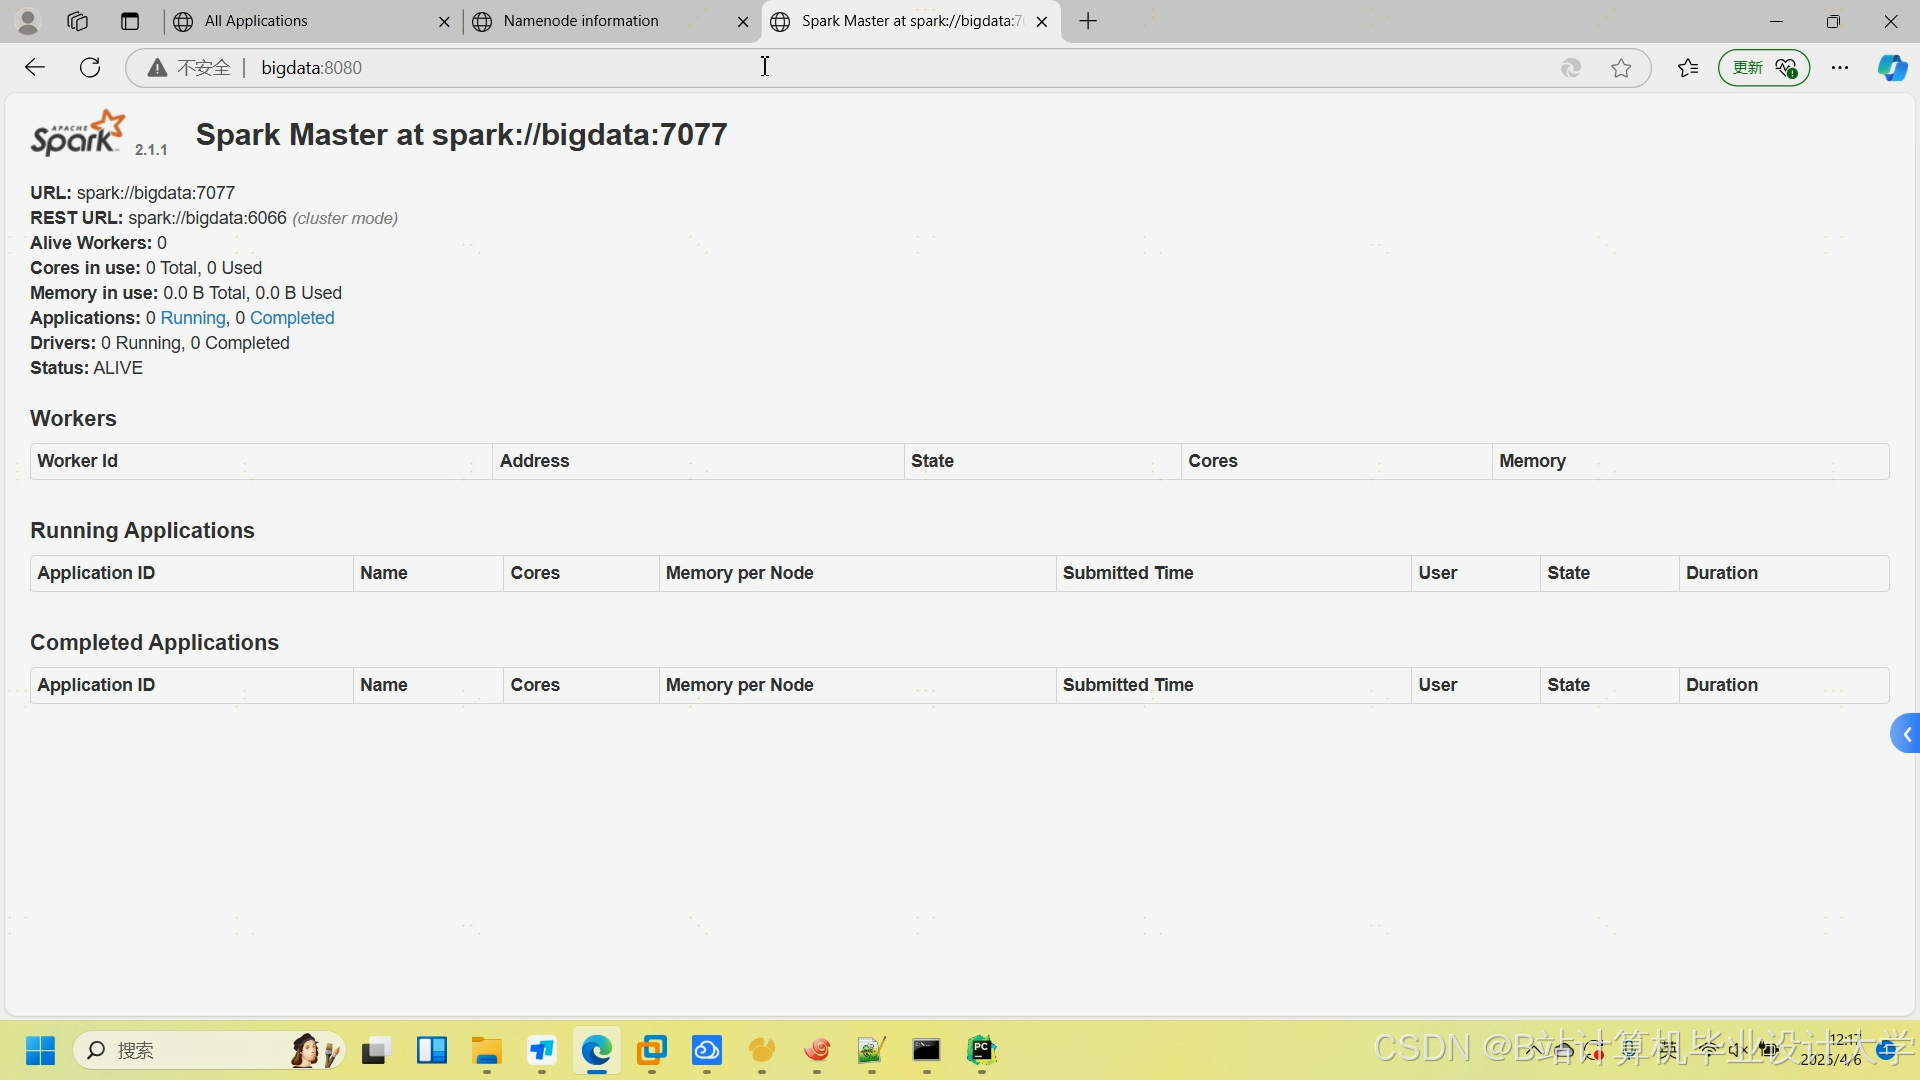
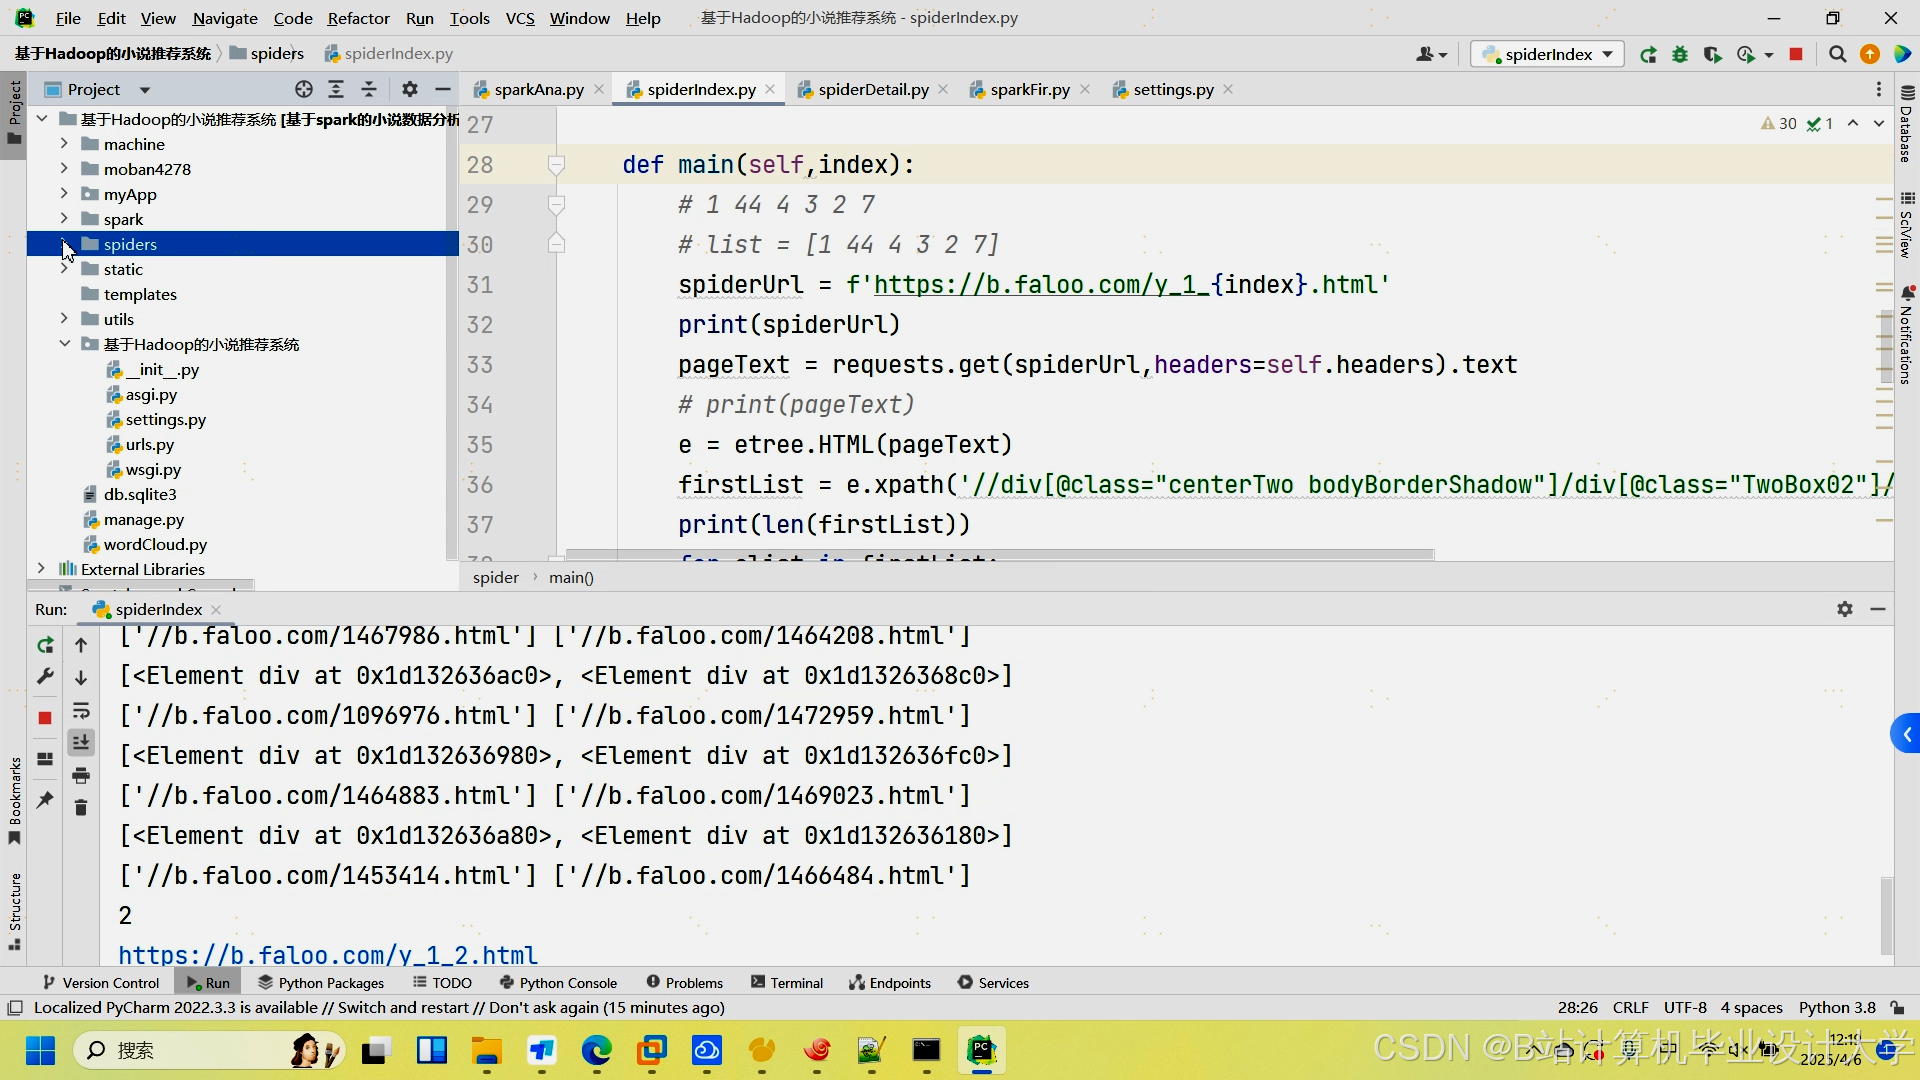
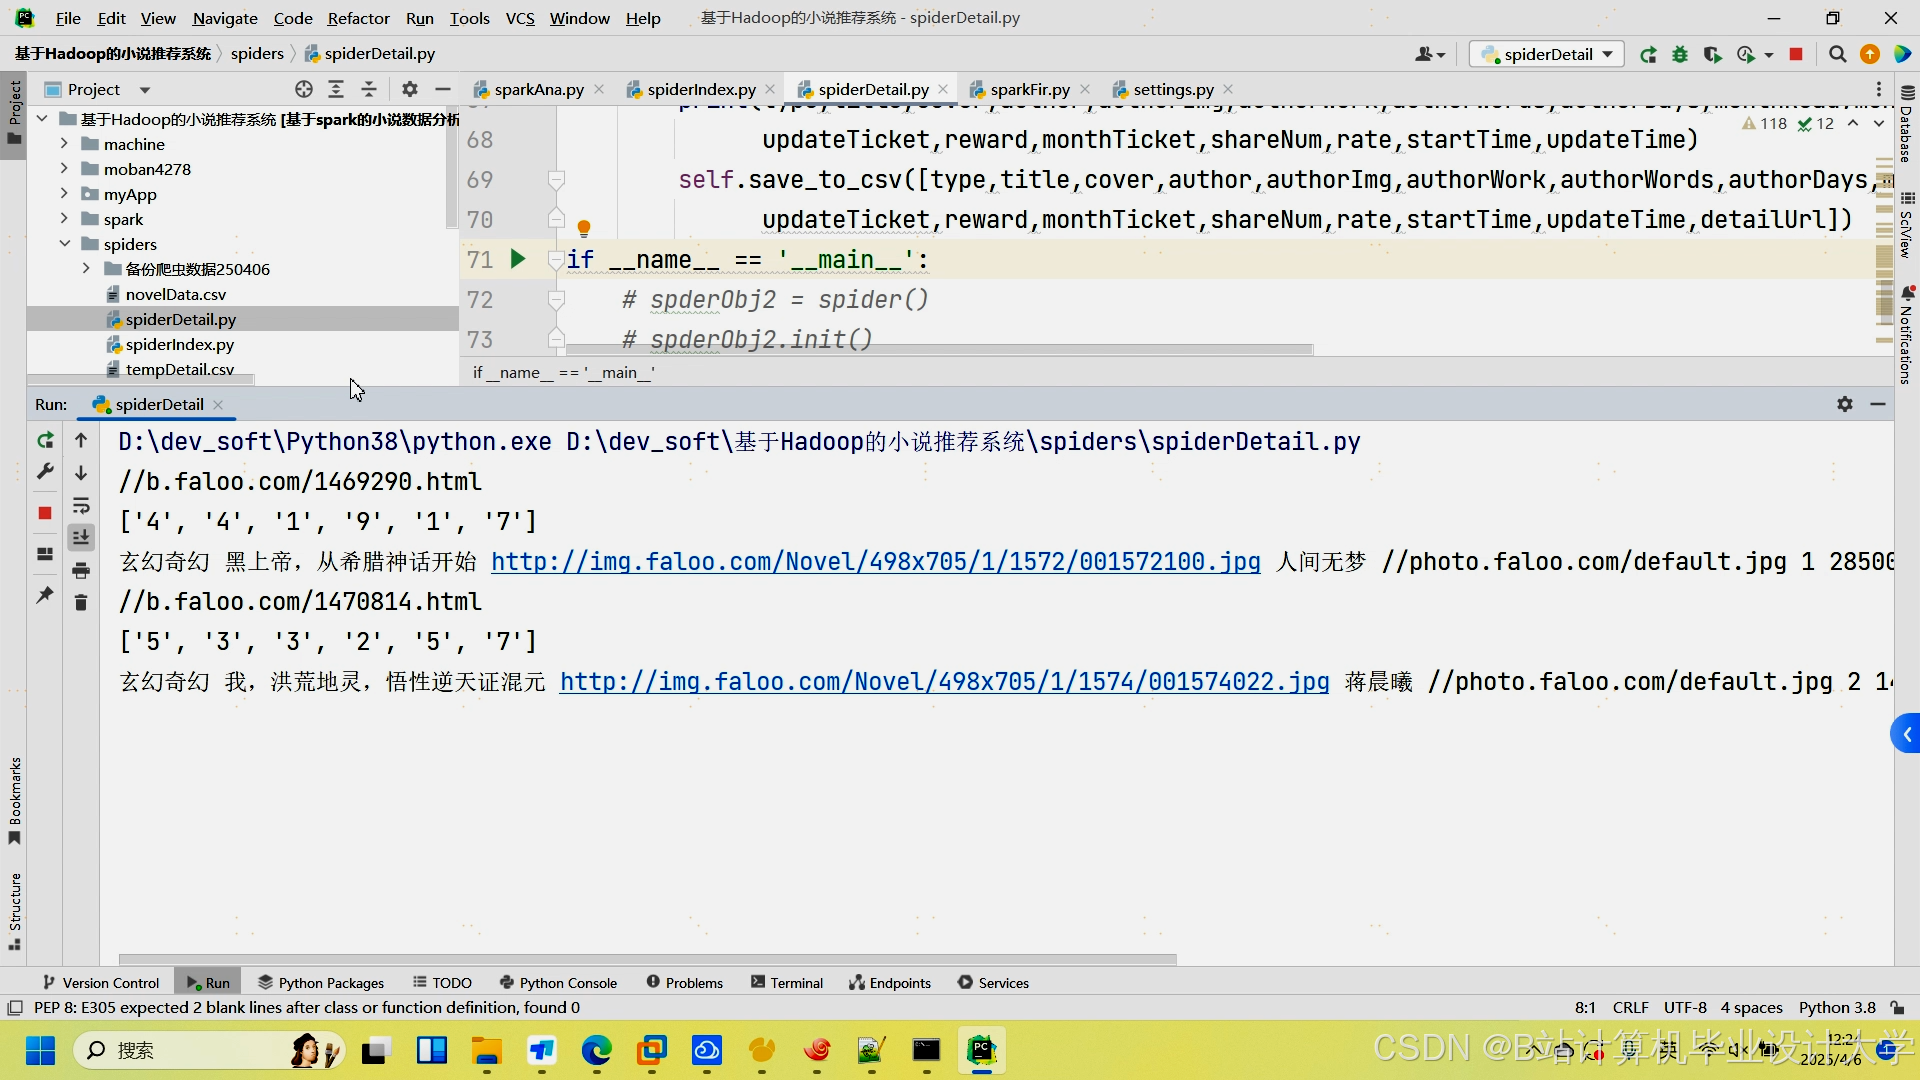
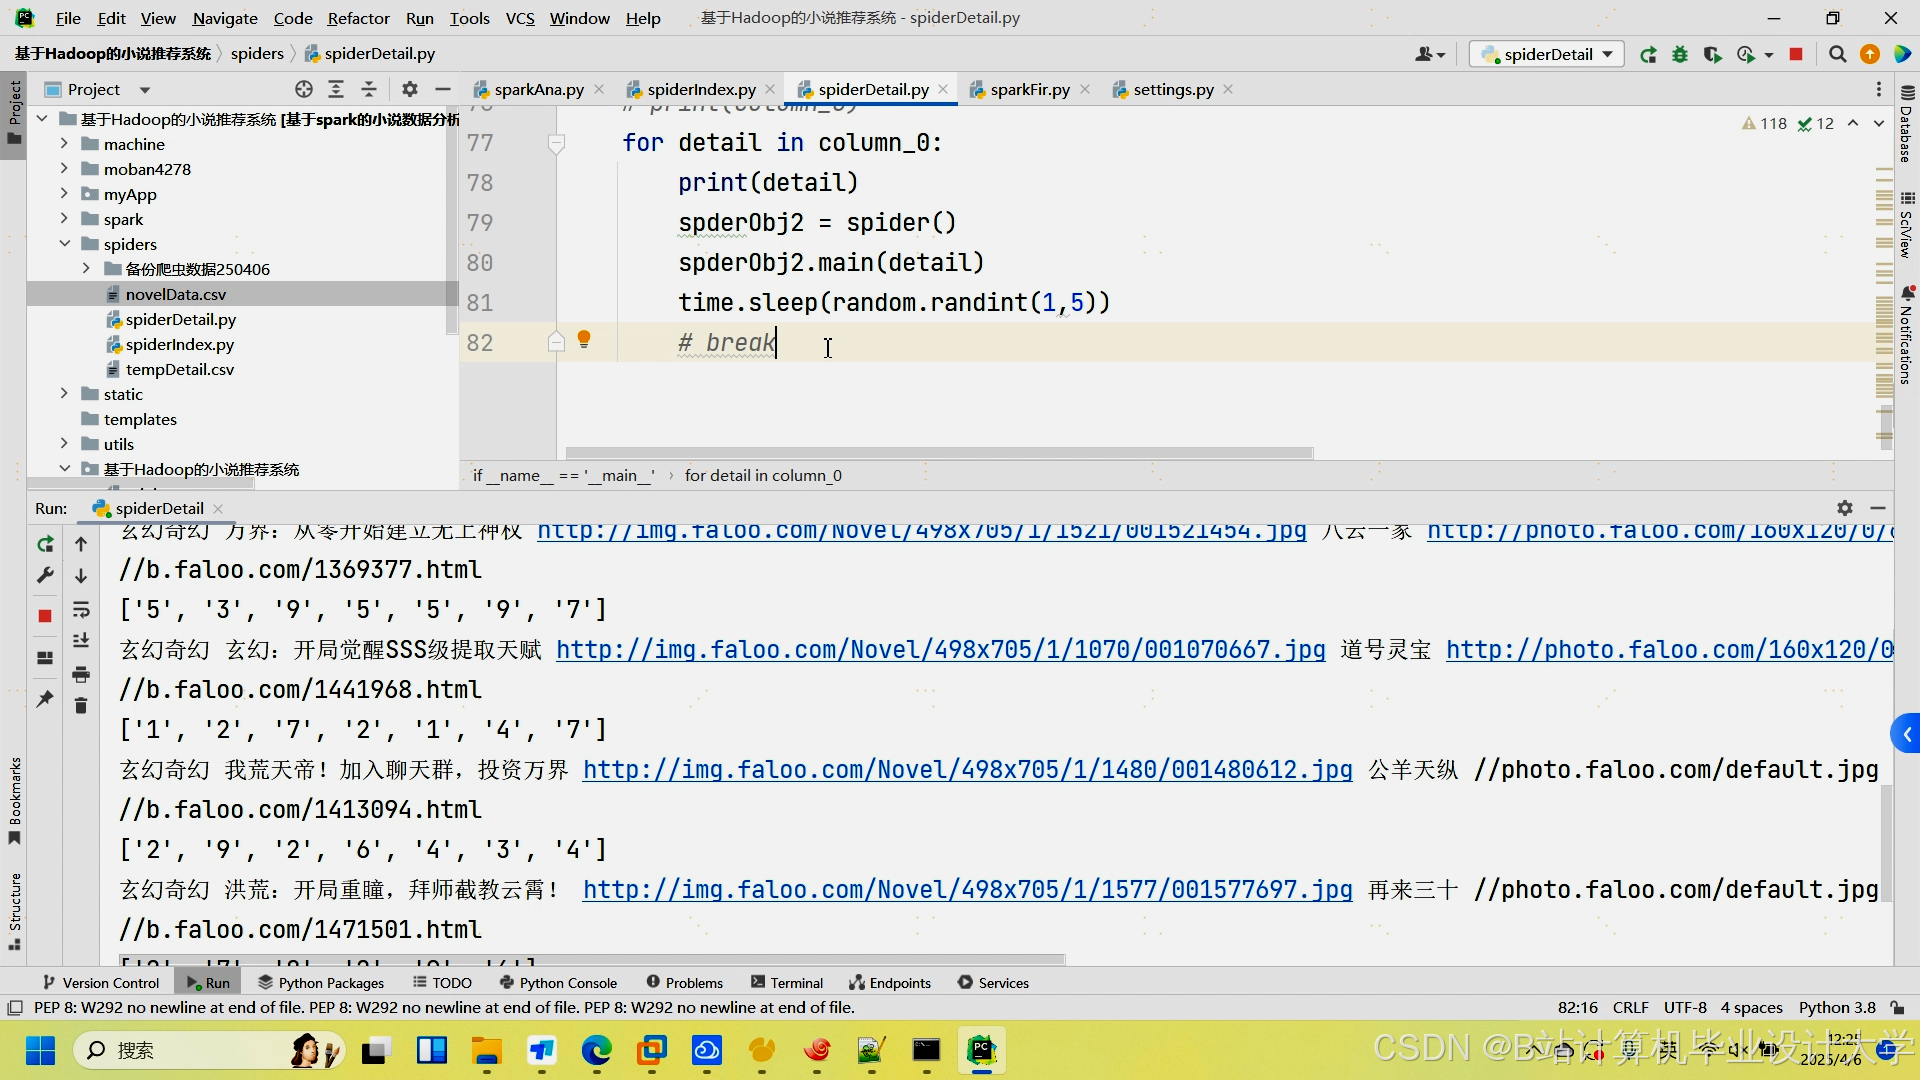
运行截图
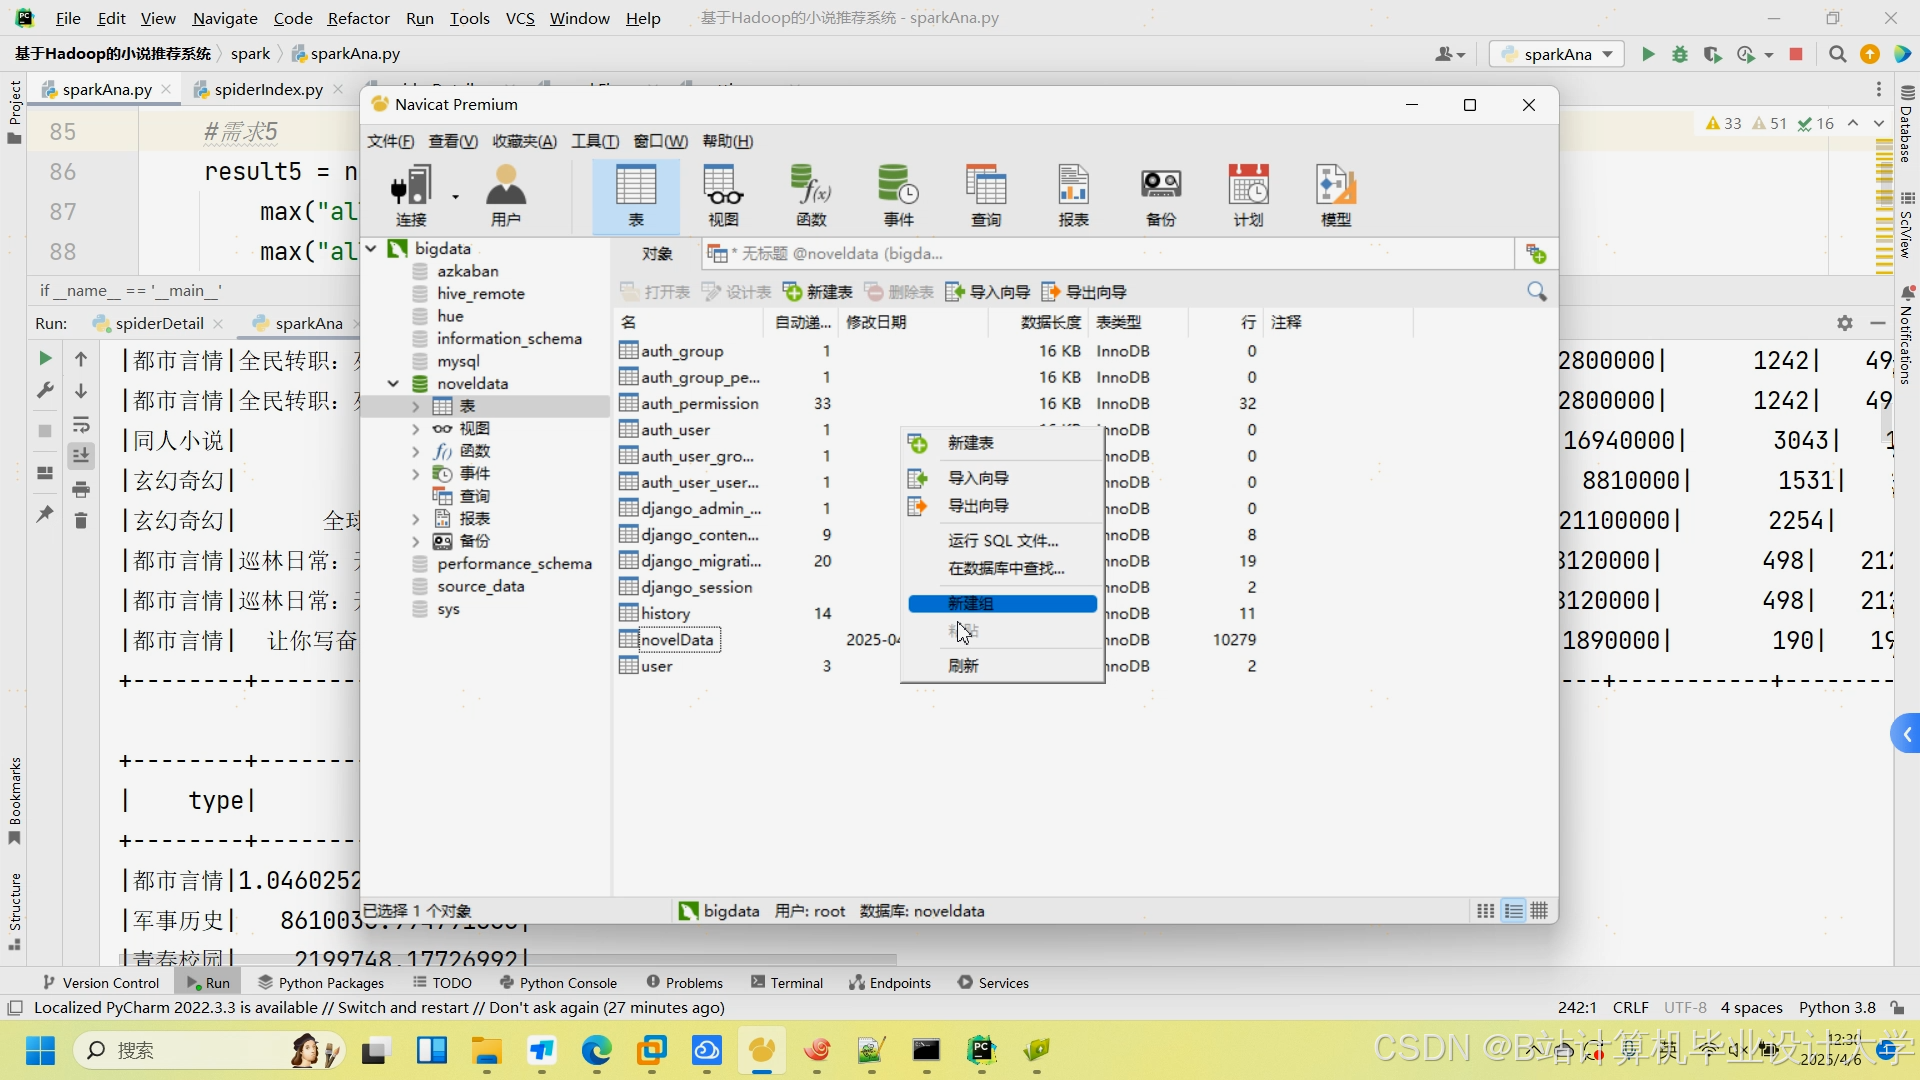
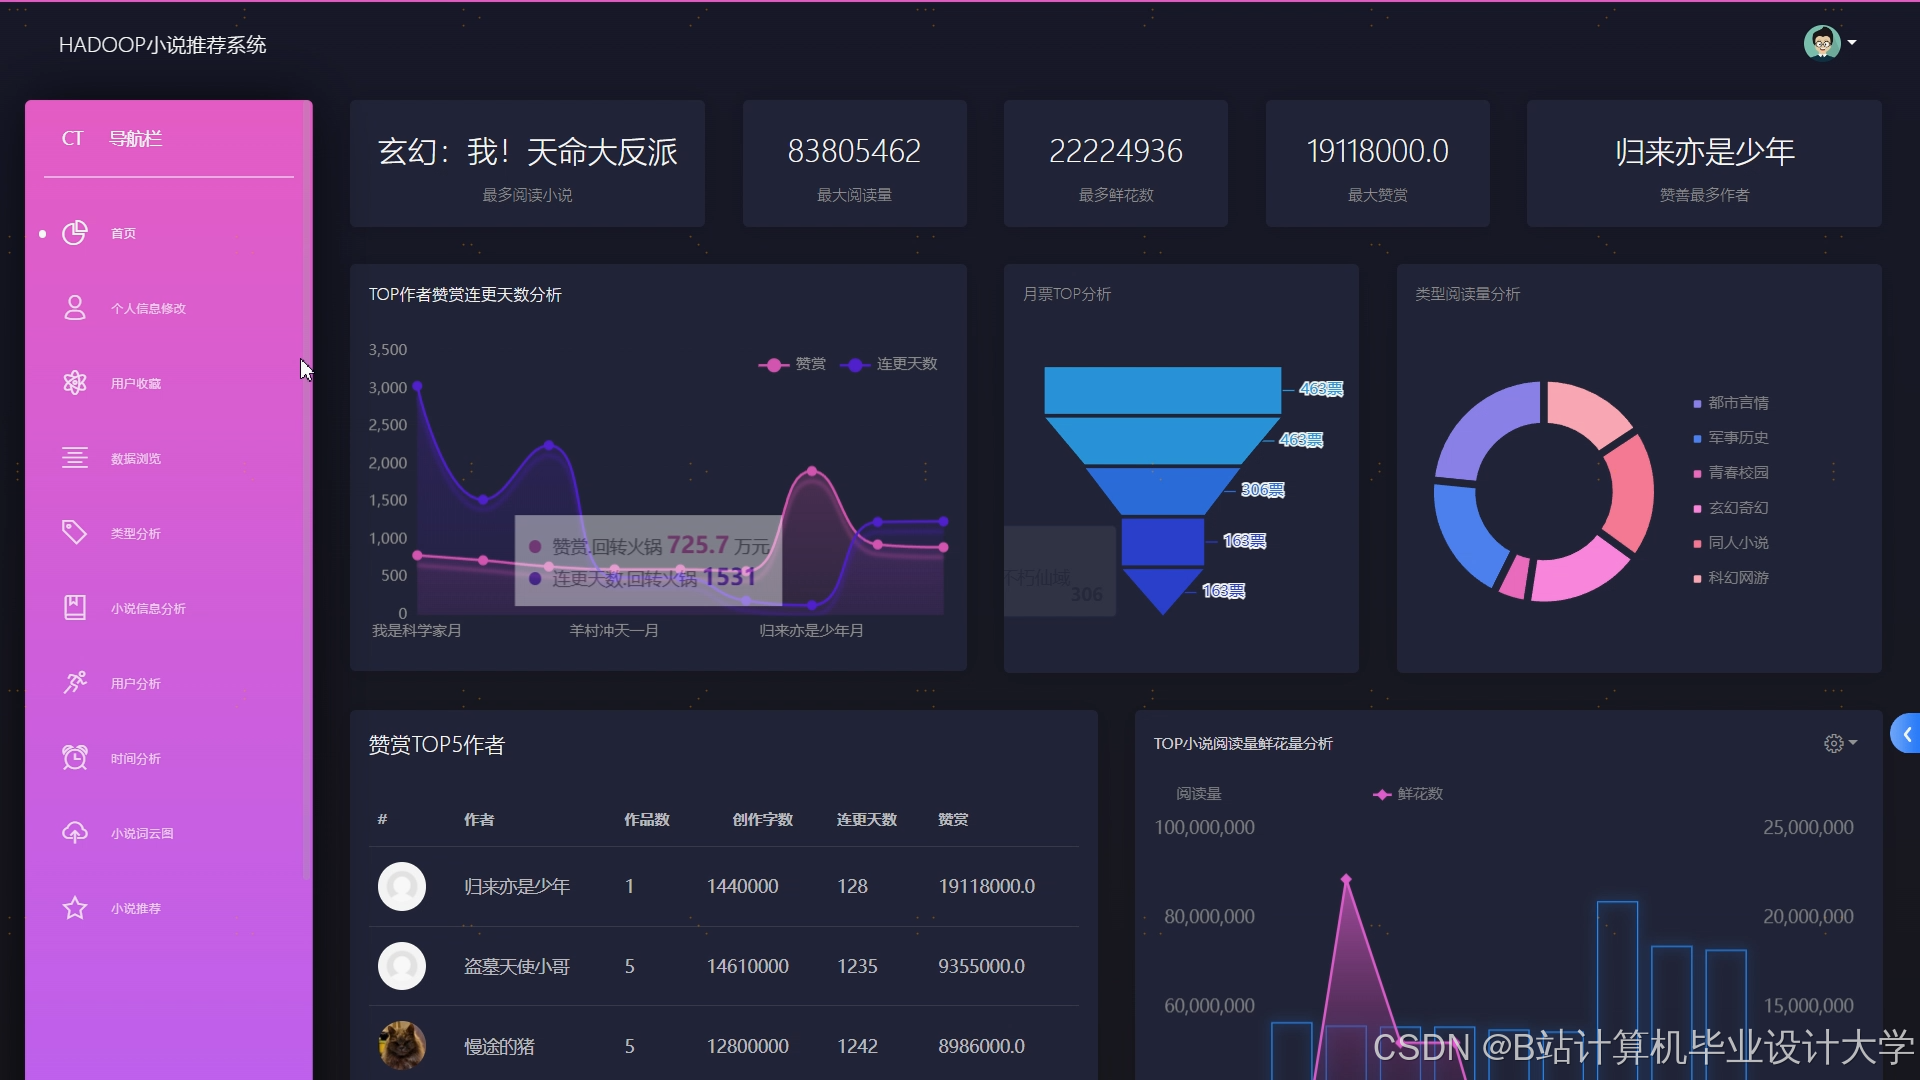
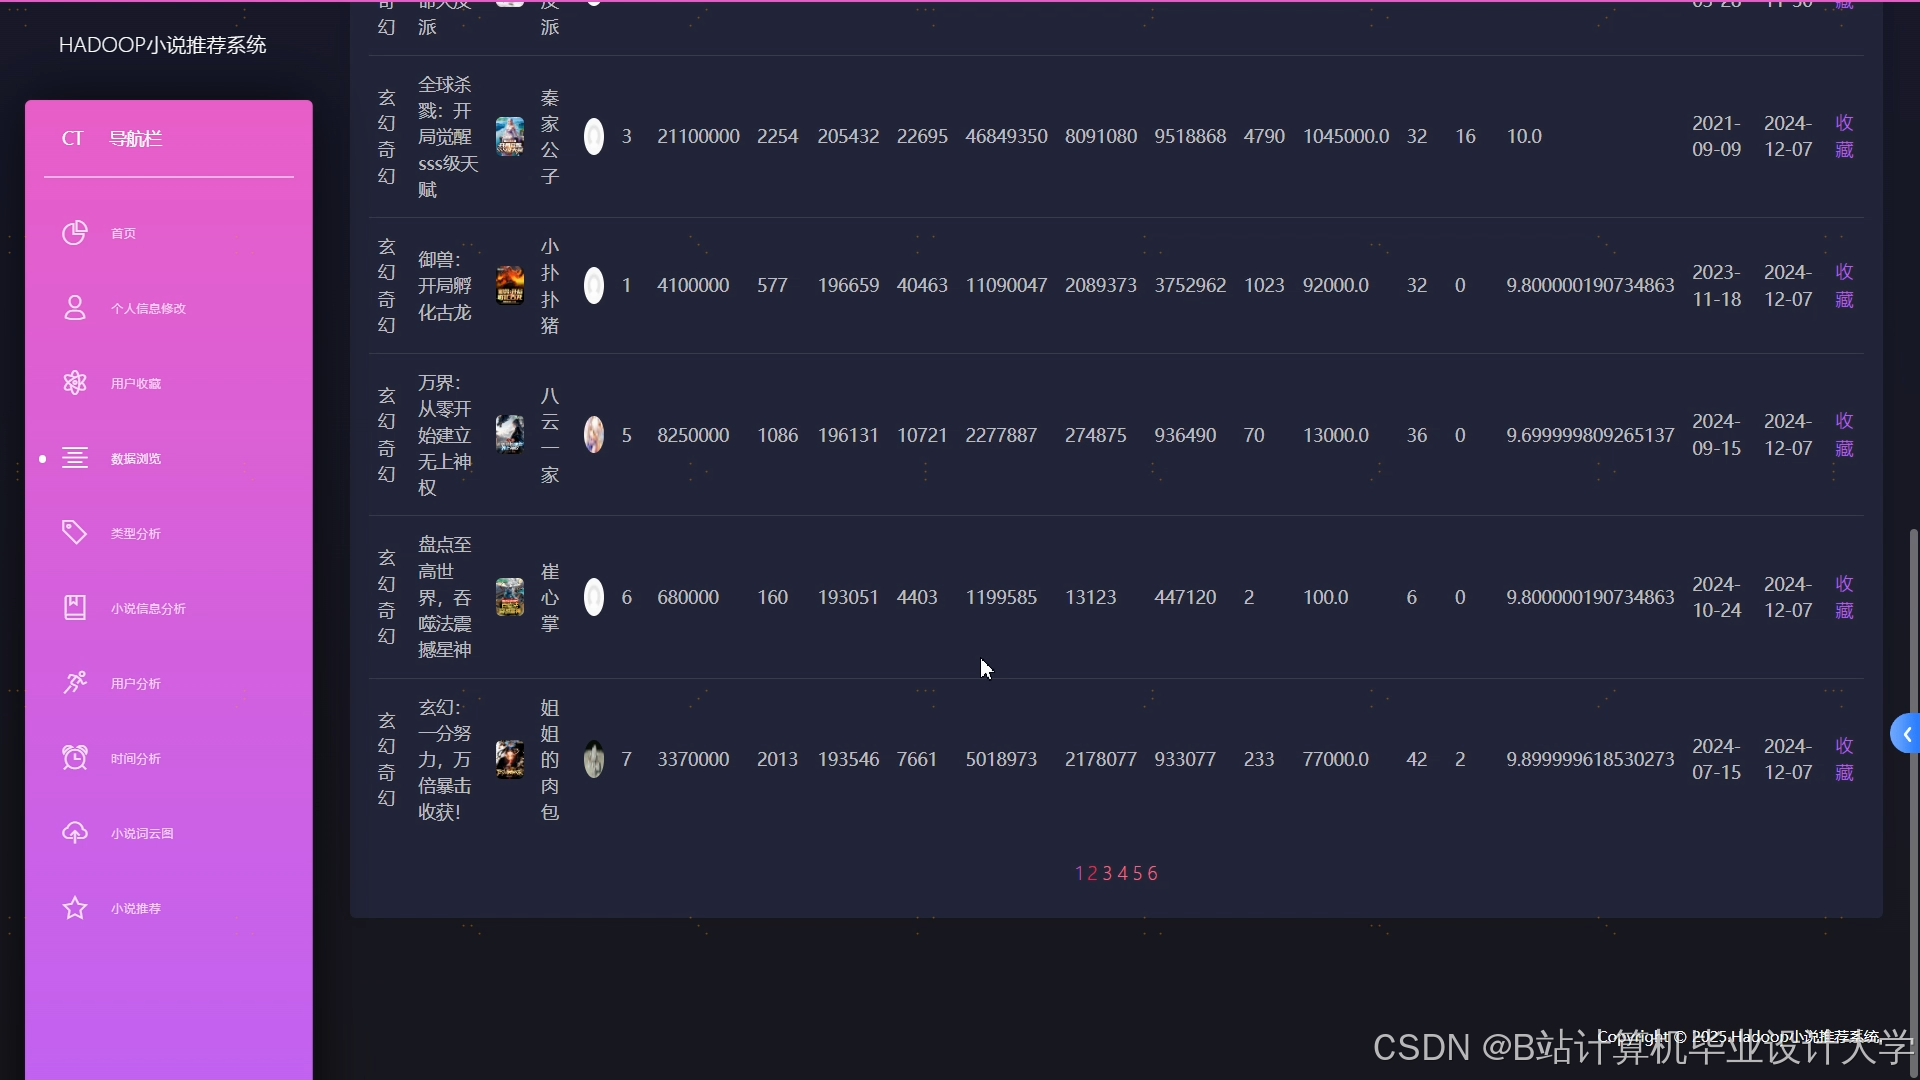
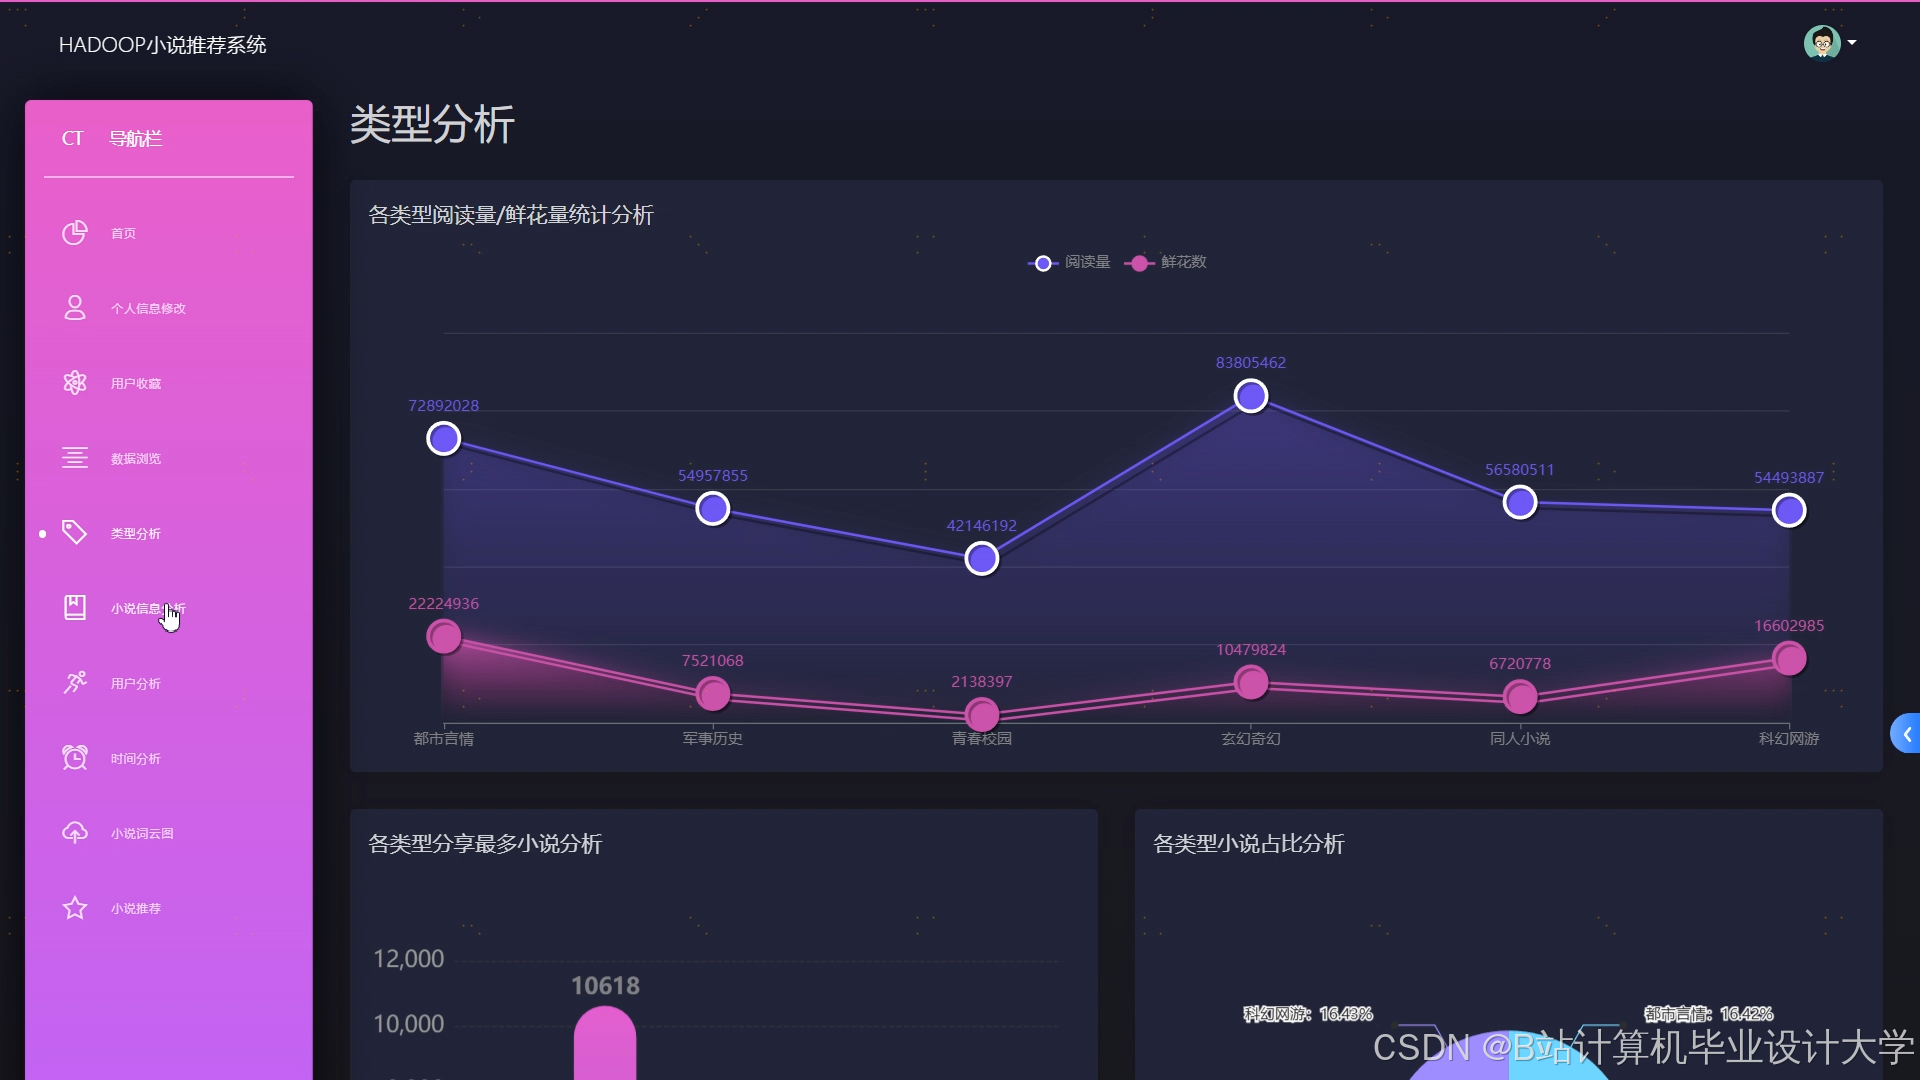
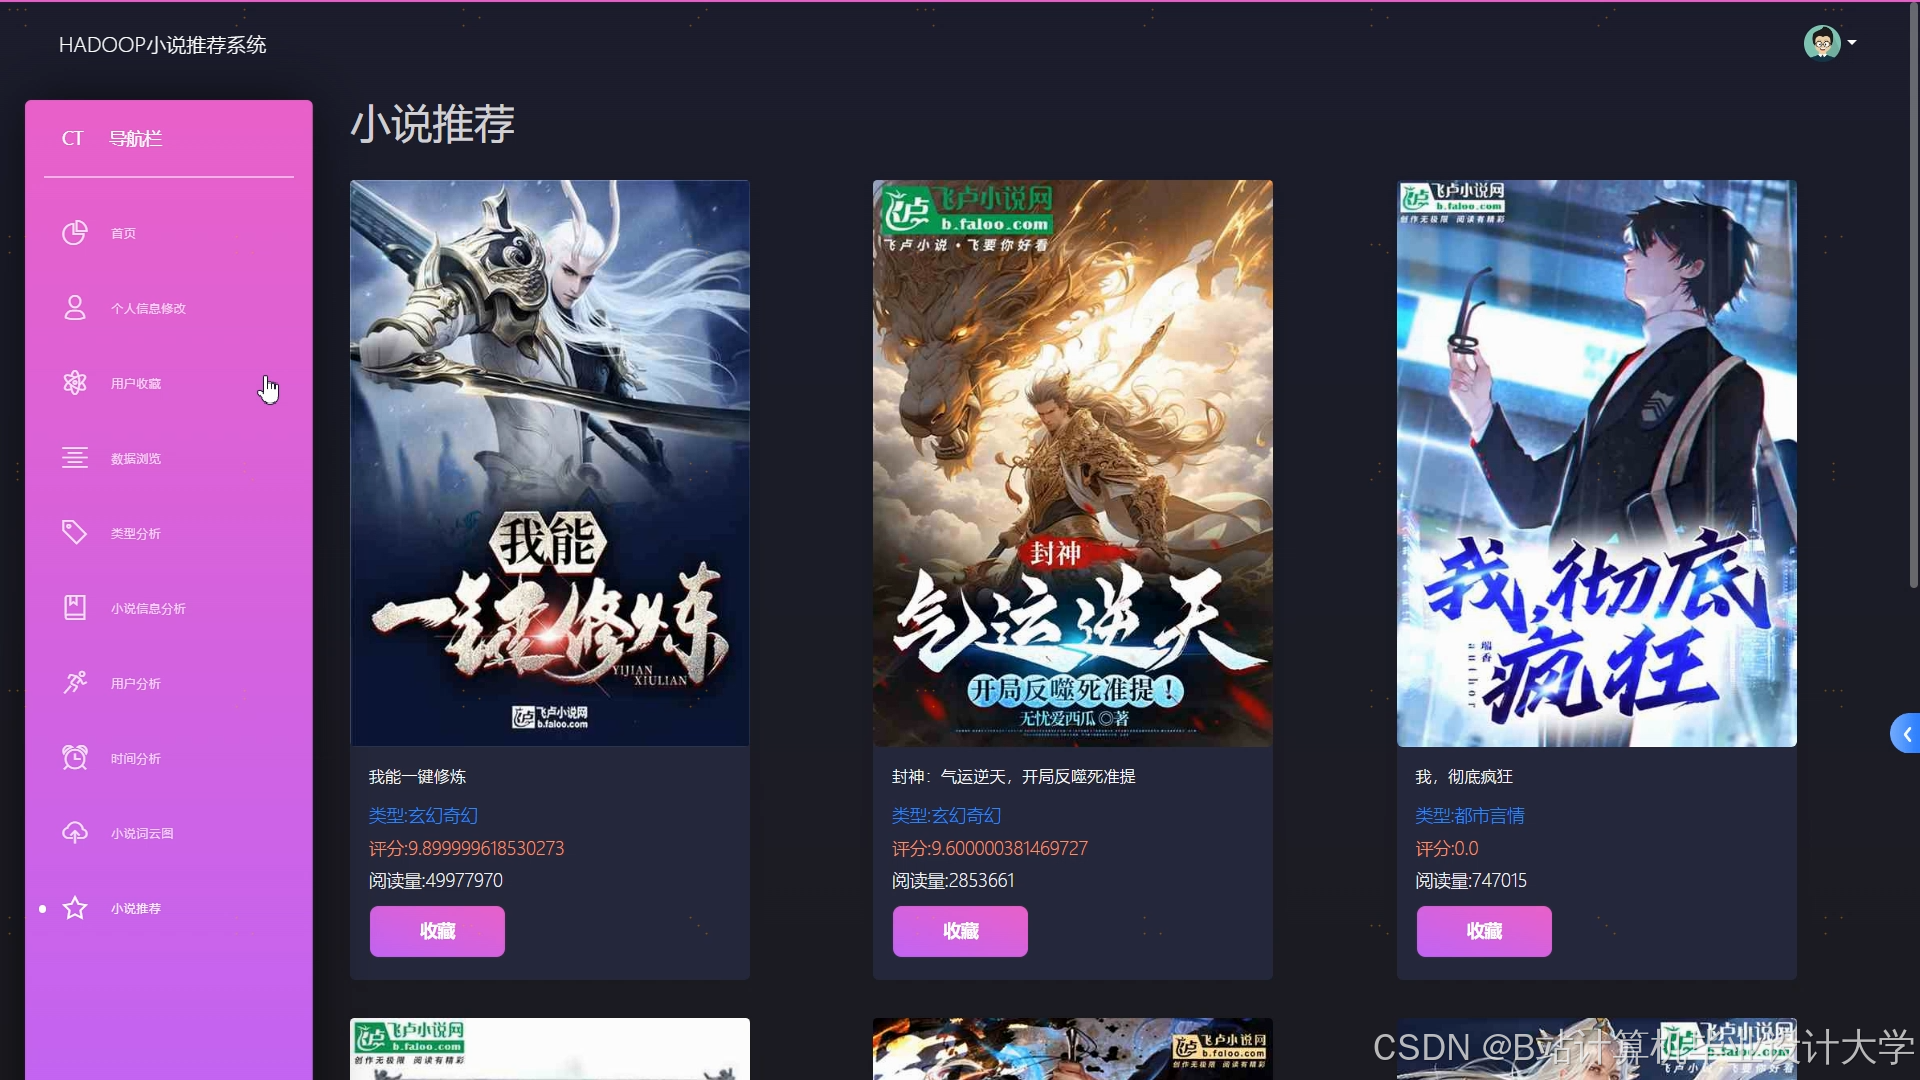
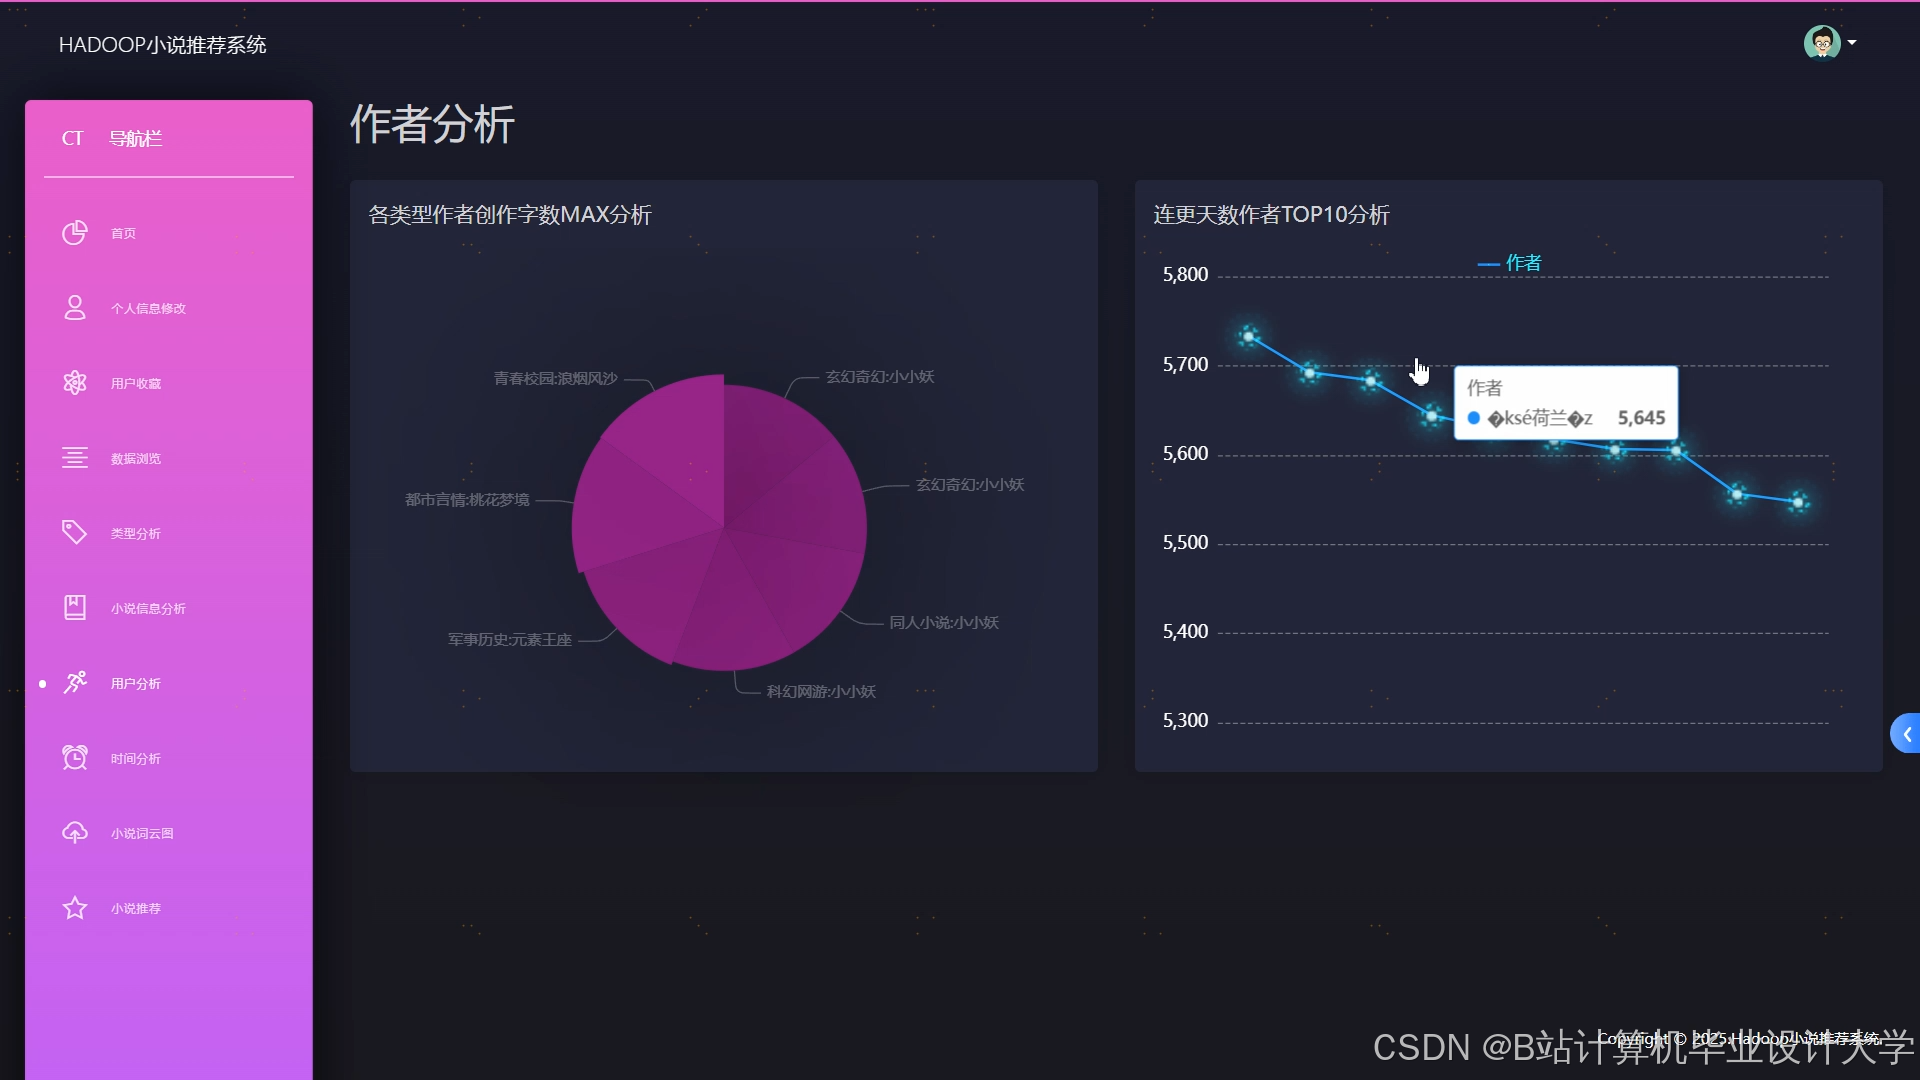
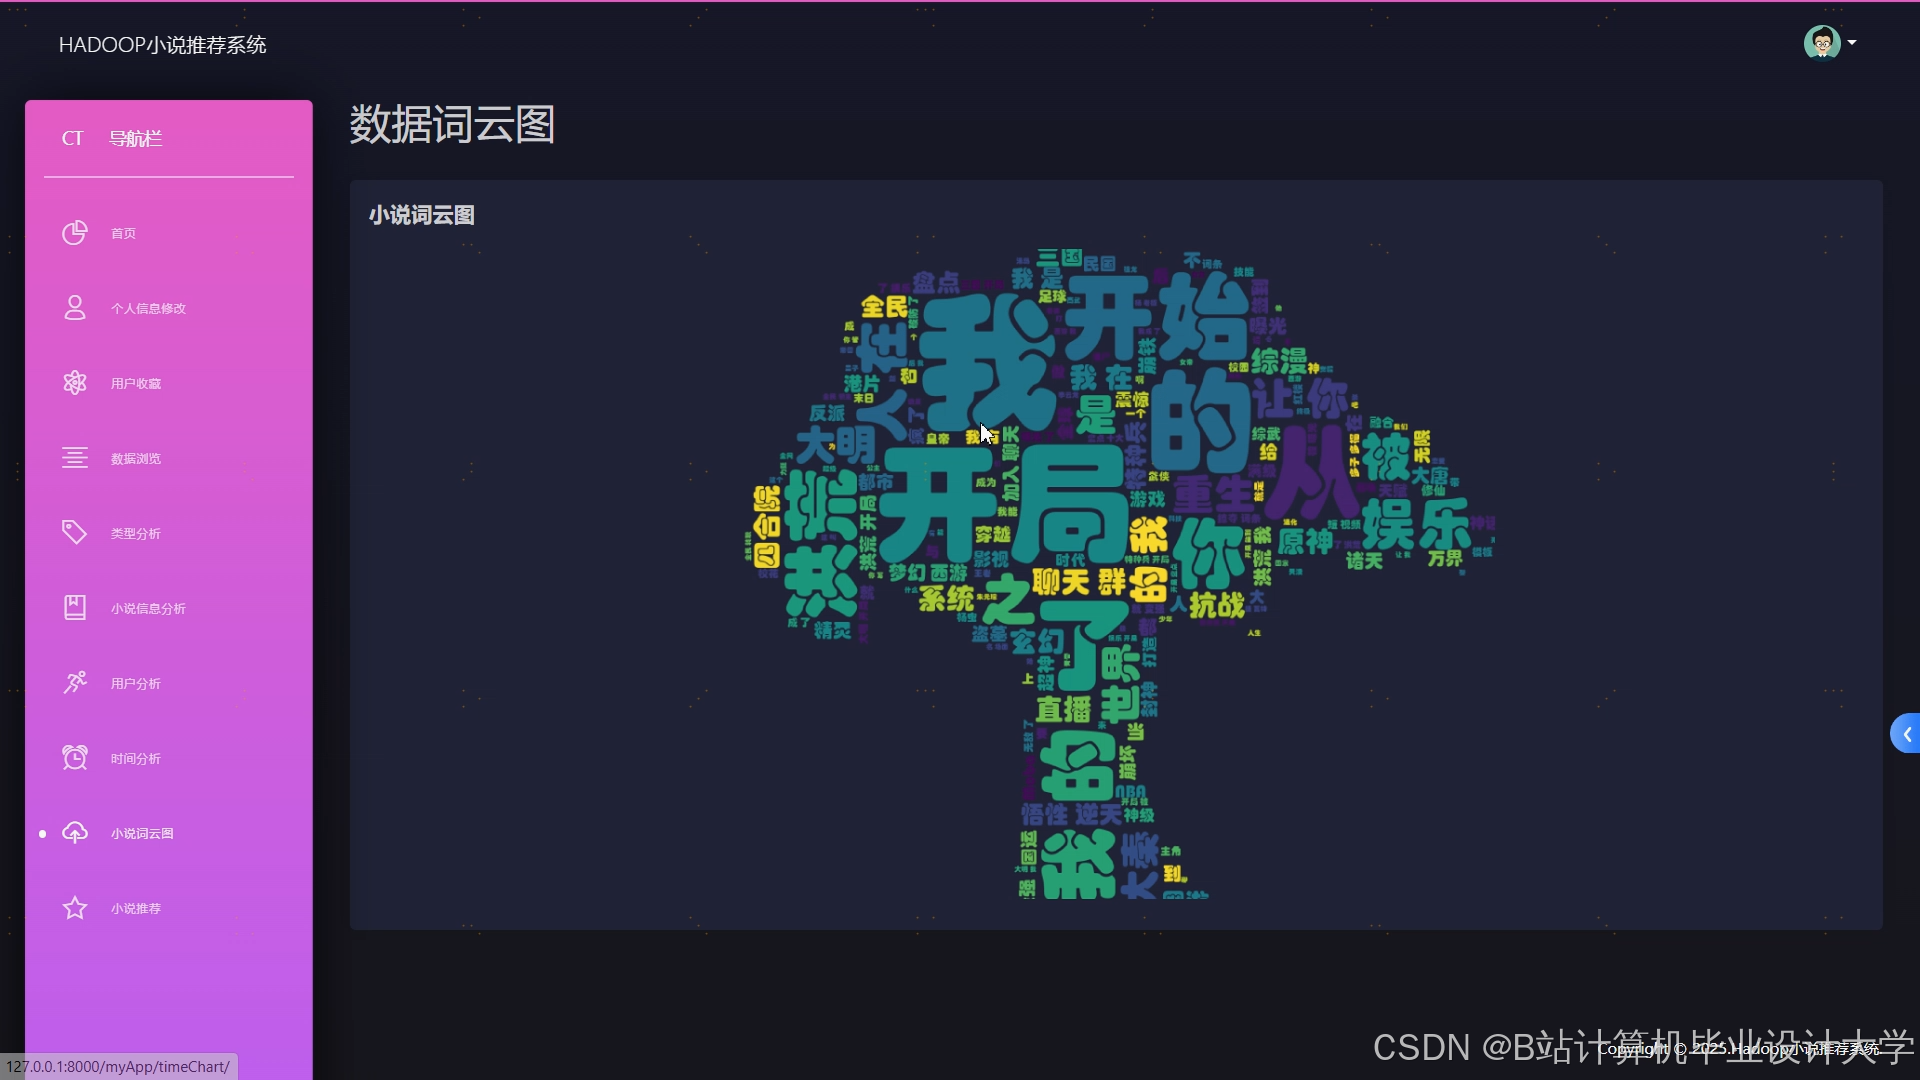
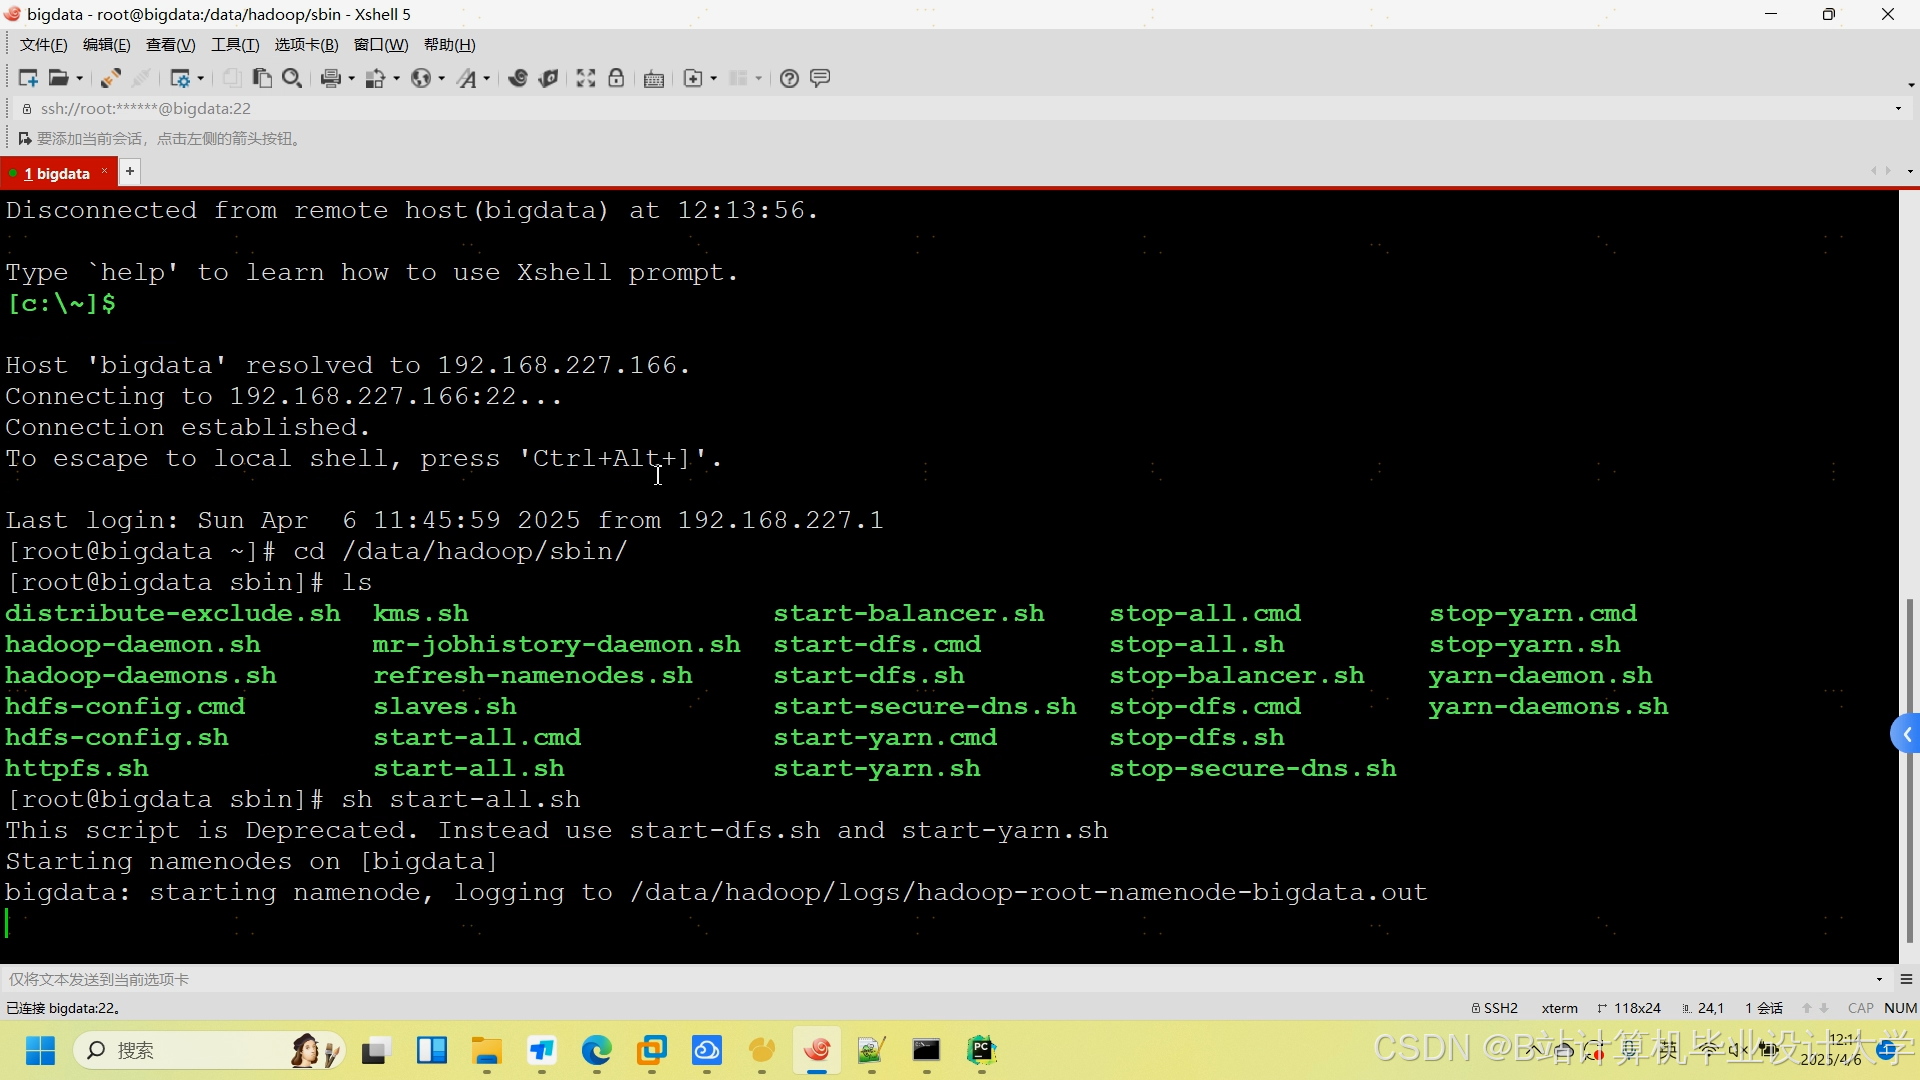
推荐项目
上万套Java、Python、大数据、机器学习、深度学习等高级选题(源码+lw+部署文档+讲解等)
项目案例


优势
1-项目均为博主学习开发自研,适合新手入门和学习使用
2-所有源码均一手开发,不是模版!不容易跟班里人重复!
🍅✌感兴趣的可以先收藏起来,点赞关注不迷路,想学习更多项目可以查看主页,大家在毕设选题,项目代码以及论文编写等相关问题都可以给我留言咨询,希望可以帮助同学们顺利毕业!🍅✌
源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,拉到文章底部即可看到个人联系方式。🍅
点赞、收藏、关注,不迷路,下方查看👇🏻获取联系方式👇🏻

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献183条内容

所有评论(0)