基于Python爬虫的网络小说热度分析
在数字化信息飞速发展的当下,网络文学市场规模不断扩大,网络小说热度分析对于了解读者喜好、优化平台运营具有重要意义。随着互联网技术的持续演进,海量的网络小说数据蕴含着丰富的读者行为和偏好信息,如何从中挖掘有价值的内容成为亟待解决的问题。基于Python爬虫技术,能够高效获取网络小说相关数据,为后续的热度分析提供坚实的数据基础。
本系统基于B/S开发模式,前端采用Vue框架进行页面构建,以实现用户交互的良好体验;后端运用Django框架,确保系统的稳定运行和数据的有效管理。同时,利用Echarts进行数据可视化展示,使分析结果更加直观清晰。在热度分析方面,引入随机森林回归算法,对网络小说的热度进行精准预测。系统具备丰富的管理功能,管理员可对用户信息进行管理,包括用户的注册、登录、权限设置等;对小说信息进行全面管理,涵盖小说的基本信息录入、更新等;针对言情小说这一特定类型进行精细化管理;还能够基于算法对小说的阅读情况进行预测,从而为平台的运营决策提供有力支持。该系统的开发和应用,有助于提升网络小说平台的运营效率,为作者、读者和平台管理者提供有价值的参考,促进网络文学行业的健康发展,具有重要的理论和实践意义。
关键字:网络小说热度分析;Python语言;
研究背景
近年来,随着互联网技术的迅猛发展,网络文学作为数字娱乐产业的重要组成部分,取得了令人瞩目的成就。网络小说以其丰富多样的题材、便捷的阅读方式和广泛的受众群体,在全球范围内掀起了阅读热潮。据相关数据显示,截至[具体年份],我国网络文学用户规模已达数亿人,市场规模也呈现逐年递增的态势[1]。众多网络文学平台如雨后春笋般涌现,海量的网络小说作品不断产出,构成了庞大而复杂的网络文学生态系统。在这一繁荣景象的背后,网络小说的热度分析变得愈发重要。对于网络文学平台而言,了解每部小说的热度情况,能够精准把握用户需求,合理推荐作品,提升用户留存率和活跃度,从而在激烈的市场竞争中占据优势。从作者的角度出发,热度分析结果有助于他们了解读者喜好趋势,调整创作方向,创作出更符合市场需求的作品。同时,对于文化研究领域,网络小说热度变化反映了一定时期内社会大众的文化心理和审美取向,具有较高的研究价值[2]。
然而,网络小说数据分散在各个平台,且数据量极为庞大,传统的数据收集和分析方法难以满足需求。Python爬虫技术的出现为解决这一难题提供了有力手段。它能够按照预定规则,自动从网页中抓取大量网络小说相关数据,包括小说的基本信息、章节内容、读者评论、点赞数、收藏数等。基于这些丰富的数据,结合先进的数据分析技术和算法,如随机森林回归算法,能够深入挖掘数据背后隐藏的规律,实现对网络小说热度的精准分析与预测,为网络文学行业的健康、可持续发展提供坚实的数据支持和决策依据[3]。
研究目的与意义
研究目的
本研究旨在借助Python爬虫技术以及多种前沿开发框架与算法,构建一个功能完备且高效的网络小说热度分析系统。通过该系统,实现对网络小说数据的全面采集与深度分析,精准把握网络小说热度变化规律[4]。从功能层面,赋予管理员对用户、小说信息以及特定类型小说(如言情小说)的精细化管理权限,确保平台数据有序且安全。同时,利用随机森林回归算法搭建阅读预测模型,为小说热度预测提供科学依据。在技术应用上,基于B/S开发模式,融合Vue、Django、Echarts等技术,打造出交互性强、稳定性高且数据可视化效果佳的系统。通过达成上述目标,期望能为网络文学平台提供优化运营的有力工具,辅助平台精准推荐小说,提升用户阅读体验,增强用户粘性;助力作者依据热度分析结果调整创作策略,产出更契合读者需求的作品;推动网络文学行业朝着数据驱动、高效发展的方向迈进,促进整个行业生态的良性循环[5]。
研究意义
网络文学市场竞争激烈,准确把握小说热度能助力平台优化资源配置。通过热度分析,平台可精准推荐热门小说,提高用户发现心仪作品的概率,提升平台流量与用户活跃度,推动网络文学平台运营模式向数据驱动型转变,促进整个行业的高效发展,增强行业在数字娱乐市场的竞争力。
对用户和创作者而言,为用户提供个性化阅读推荐服务,依据热度分析结果推送符合用户兴趣偏好的小说,节省用户筛选作品的时间,提升阅读体验。对于创作者,热度分析结果可作为创作方向的参考,帮助其洞察读者需求,创作出更具市场潜力的作品,实现创作价值与经济效益的双赢。从技术应用角度,综合运用Python爬虫、Vue、Django、Echarts以及随机森林回归算法等技术,为跨领域技术融合提供实践范例。拓展了Python爬虫在大规模文本数据采集方面的应用场景,验证多种技术协同实现复杂业务功能的可行性,为其他相关领域的数据挖掘与分析项目提供技术借鉴与思路启发[6]。
本文研究内容
本文聚焦于基于Python爬虫的网络小说热度分析,深入开展多方面研究。首先,利用Python爬虫技术,设计并实现高效的数据采集模块。精准定位各大网络文学平台,依据网页结构特征编写爬虫规则,获取海量网络小说数据,涵盖小说基本信息、章节内容、用户评论及各类热度指标数据等。基于B/S开发模式,采用Vue构建前端交互界面,确保用户操作流畅、界面友好;运用Django框架搭建后端服务,实现对数据的存储、管理与业务逻辑处理。构建管理员管理功能体系,实现对用户信息、小说信息以及言情小说等特定类型小说的全方位管理。引入随机森林回归算法,对采集到的数据进行特征工程处理,筛选出影响小说热度的关键因素,训练预测模型,实现对网络小说阅读热度的精准预测。并借助Echarts实现数据可视化,将热度分析结果以直观、易懂的图表形式呈现,为网络文学平台运营决策提供有力支持[7]。
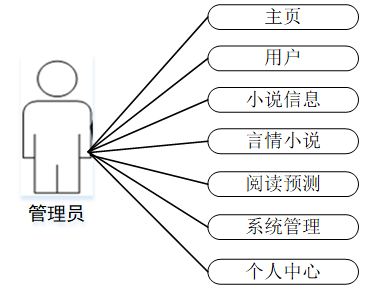
管理员需求分析
管理员端的功能主要是为系统管理人员设计的,使他们能够全面管理用户、小说信息、言情小说、阅读预测、系统管理、个人中心等操作。通过这些功能,管理员可以清晰地了解并掌控系统的整体运行情况。
管理员用例分析图,如图
用户需求分析
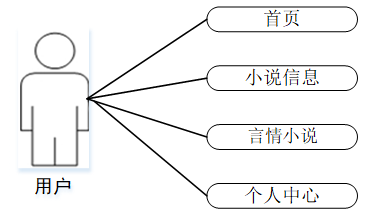
用户的功能主要集中在个人账号管理以及信息查询方面。具体而言,用户可以更新和管理自己的账号及密码,同时能够在首页、小说信息、言情小说、个人中心查询并获取相关详情。这些功能旨在为用户提供便捷的个人信息管理途径和丰富的信息查询服务。
用户用例分析图,如图
功能模块设计
网络小说热度分析系统的功能模块图,系统主要分为管理员和用户两大角色模块。这种划分有助于实现不同权限的功能隔离,保障系统有序运行。管理员功能模块主页系统操作入口,可快速访问常用功能。用户管理对系统用户信息进行增删改查,保障用户数据准确、安全。小说信息管理负责录入、更新、审核小说基础信息,确保数据及时、准确。言情小说管理聚焦言情类小说,进行专项管理与分析。阅读预测利用算法对小说阅读热度等进行预测,辅助决策。系统管理涵盖系统参数设置、权限分配等,保障系统稳定运行。个人中心用于管理员个人信息维护、密码修改等。用户功能模块主页展示热门小说等信息,方便用户快速浏览。小说信息查询用户可搜索、查看小说详情,获取阅读指引。言情小说浏览为喜爱言情类小说的用户提供专门浏览入口。个人中心:方便用户管理个人资料、收藏记录等,如图

前台用户功能模块
当访客浏览至系统的网址时,首先映入眼帘的便是首页界面。在这个页面上,访客可以清晰地看到网络小说热度分析的导航栏,其中包括首页、小说信息、言情小说、个人中心等多个板块。系统首页界面如图
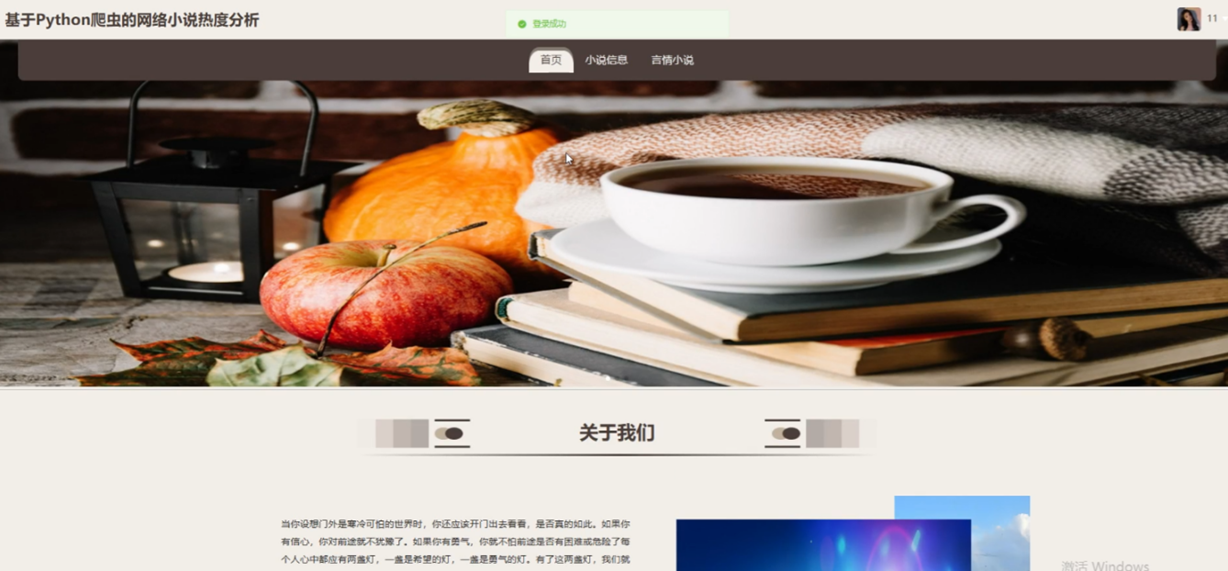
后台管理员功能模块
管理员成功登录网络小说热度分析后,可以访问用户、小说信息、言情小说、阅读预测、系统管理、个人中心等多个功能模块进行细致的操作与管理,如图
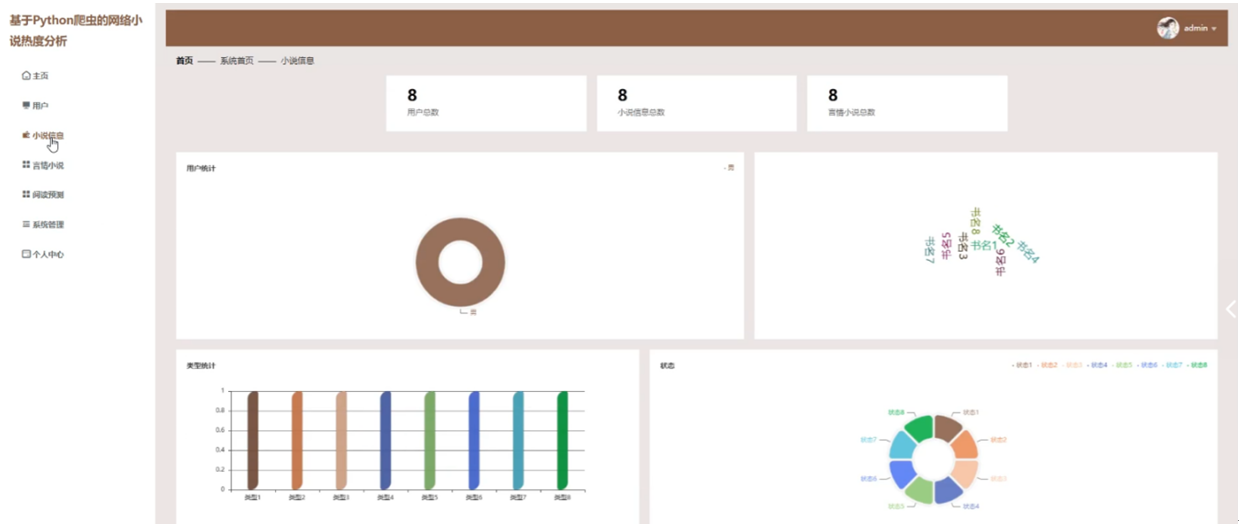
看板展示
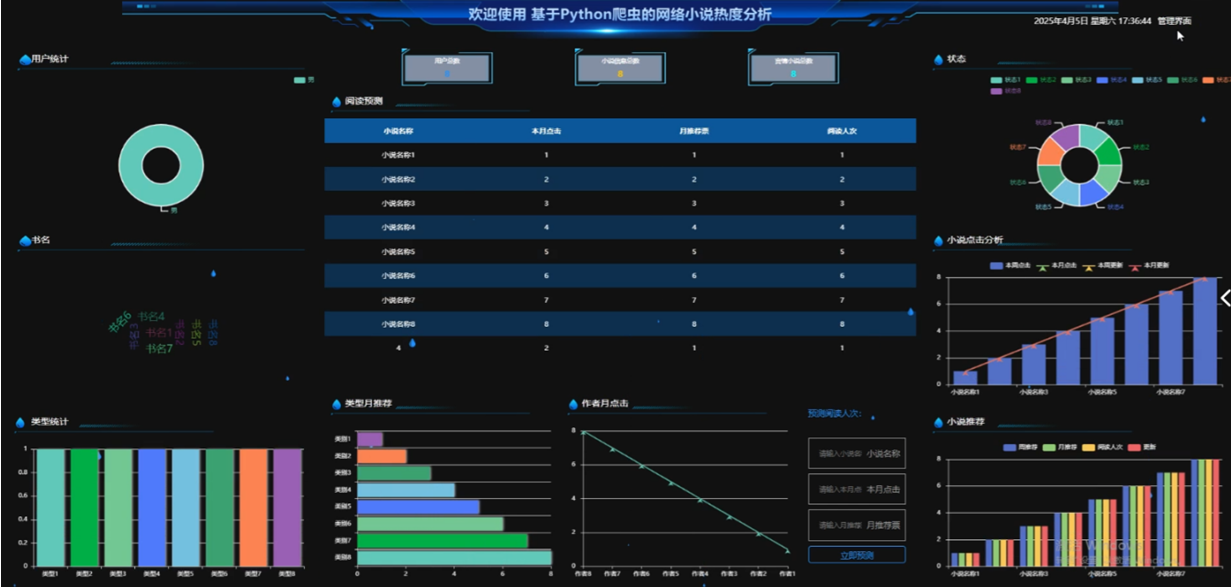
基于Python爬虫的网络小说热度分析看板展示明确系统功能。同时,还显示着当前时间,增强系统的实时性与交互性。环形图表,可能用于展示不同类型网络小说在整体热度中的占比情况,通过不同颜色区分类别,直观呈现各类型的热度份额。多组横向条形图,大概率是展示不同网络小说的热度排名。条形长度对应热度数值,读者可借此快速了解热门小说排序。饼状图表,或为分析网络小说热度来源构成,如来自不同平台、不同推广渠道的流量占比。柱状图表,也许是呈现网络小说热度随时间(如日、周、月)的变化趋势,帮助分析热度波动规律。堆叠柱状图,可用来展示不同维度下(如不同年龄、性别读者群体)的热度分布,分析不同群体对小说热度的贡献。折线图,可能用于体现网络小说的阅读量、评论量、收藏量等关键指标随时间的变化走向。或为热度预测相关图表,结合算法预测结果,辅助用户预判小说未来热度趋势。多色柱状图,可能是对比不同作者、不同系列网络小说的热度情况。如图
《基于Python爬虫的网络小说热度分析》该项目采用技术Python的django框架、mysql数据库 ,项目含有源码、文档、PPT、配套开发软件、软件安装教程、项目发布教程、核心代码介绍视频等
软件开发环境及开发工具:
开发语言:python
使用框架:Django
前端技术:JavaScript、VUE.js(2.X)、css3
开发工具:pycharm、Visual Studio Code、HbuildX
数据库:MySQL 5.7.26(版本号)
数据库管理工具:phpstudy/Navicat或者phpstudy/sqlyog

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献13条内容

所有评论(0)