python虚拟环境搭建与工程化实战
引言:
python属于动态类型的脚本语言,主要用于科学研究、数据分析、爬虫等领域,优势主要目的是短、频、快。语言本身并不适合开发大型系统(当然不适合,不代表不可以干)。由于python在数据分析和人工智能领域得到广泛应用,python相关依赖库、生态环境、语言本身都在迅速发展和丰富,使其运行环境和依赖管理变得非常复杂,也非常重要。pip,pyenv,pipenv,peotry是运行环境、依赖管理相关的一些工具,本文主要是介绍这些工具在windows下的安装使用(linux环境也支持),如果觉得有用可以点赞收藏,方便查看更新,这里建议先了解python。
Jupyter 是一款开源的交互式 Web 应用程序,被誉为数据科学领域的“实验笔记本”,它允许你在文档中同时编写代码、运行结果、数学公式和说明文字,特别适合数据分析、机器学习和教学演示。了解python核心语法的可以关注我其他文章。
本文也涉及了python工程化的一些探讨,我相信对很多初步想使用,或者想改变现状,有理想的技术人员应该会有不一样的收获,pyhon发展到今日,工程化还是存在很多问题:
第一 是语言本身设计不太适大规模工程化,主要是研究
- 语言是弱类型,优点是灵活,缺点是不好维护
- 语言有面向对象功能,但是设计为了兼顾灵活,语法,权限控制都存在缺陷,维护性和安全性差
- 语言本身存在很多语法陷阱(可以参看我的Python文章)
- 语法很多特殊功能全靠__xx__类似的魔法方法隐式处理,多如牛毛,不好掌握,后面可能还会增加
- 兼容性差,版本变迁可能很多历史代码都涉及调整
第二 目前还不适合做高并发服务
虽然通过一些手段比如多进程可以解决一些要求不太高场景,但是如果有更好的选择,就不要用,免得又迁移
第三 规范不统一或者没有规范
因为语言的目标是快速上手、灵活。真正像大规模使用的时候发现缺乏规范、或者是生态支持,不好做工程化。生产上已有很多烂摊子,不好处理,对于只看重结果项目,只好摆烂。
目录
1 pyenv
1.1 pyenv介绍
pyenv(官网)这款软件主要时用来安装python和切换python运行版本。实现多版本python环境管理。pyenv最先有linux版本,因为有大量用户诉求,所以后来也出了windows版本。如果Python是在linux版本上使用,建议在linux上安装,有些功能可能在windows上没有。
官方推荐的 Python 多版本管理工具也是是 pyenv,适用于 MacOS、Linux 等 Unix 系统,支持安装多个 Python 版本并快速切换。
pyenv有以下几个 特点:
轻量级:仅管理 Python 版本,不包含大数据分析库,适合普通开发需求。 1
版本切换:通过修改环境变量实现全局或局部版本切换,兼容 CPython、Anaconda 等发行版。
虚拟环境:结合 pyenv-virtualenv 插件可创建独立虚拟环境,避免依赖冲突。 (本人不建议用这个管理虚拟环境,虚拟环境直接使用poetry管理虚拟环境)
环境重现:这个是poetry最大的卖点,因为有lock文件锁定精确版本,所以才能方便重现一致依赖版本,方便排除问题。
目前使用发现的缺点:
pip能安装的一些软件换成pipenv安装不了,比如pytorch可能需要特殊处理。如果安装的时候跳过了检查验证,可能导致pipfile和lock文件不一致,手动处理容易搞错,部署时出现麻烦。网上有解决办法是下载pytorch whl文件安装,大家可以自行尝试以下。
lock卡容易卡住,耗时特长。网上建议得方法是安装时先跳过lock动作,投产前或者定期重新生成lock,这个方法不知道是不是万能的。npm也是类似管理方式,如果是像python一样卡,估计早没有人用了。
1.2 安装
在官网下载pyenv-win-master.zip.解压到合适的位置。如:D:\programs\pyenv-win-master。可以在绑定资源中下载,如果要下载最新的,就在官网下载。
目录结构 如下图:

当然可以使用也可以使用如下命令在线安装:
| Invoke-WebRequest -UseBasicParsing -Uri "https://raw.githubusercontent.com/pyenv-win/pyenv-win/master/pyenv-win/install-pyenv-win.ps1" -OutFile "./install-pyenv-win.ps1"; &"./install-pyenv-win.ps1" |
1.3 配置环境变量
在在线安装脚本install-pyenv-win.ps1中发现脚本设置了四个环境变量:PATH、PYENV、PYENV_ROOT、PYENV_HOME。其内容如下图,
$PyEnvDir = "${env:USERPROFILE}\.pyenv"
$PyEnvWinDir = "${PyEnvDir}\pyenv-win"
$BinPath = "${PyEnvWinDir}\bin"
$ShimsPath = "${PyEnvWinDir}\shims"

Function Remove-PyEnvVars() {
    $PathParts = [System.Environment]::GetEnvironmentVariable('PATH', "User") -Split ";"
    $NewPathParts = $PathParts.Where{ $_ -ne $BinPath }.Where{ $_ -ne $ShimsPath }
    $NewPath = $NewPathParts -Join ";"
    [System.Environment]::SetEnvironmentVariable('PATH', $NewPath, "User")

    [System.Environment]::SetEnvironmentVariable('PYENV', $null, "User")
    [System.Environment]::SetEnvironmentVariable('PYENV_ROOT', $null, "User")
    [System.Environment]::SetEnvironmentVariable('PYENV_HOME', $null, "User")
} |
PATH环境变量设置(桌面上右键->属性->高级->环境变量设置):需要把bin和shims添加进去,然后点击确定,如下图:

如果忘记加shims目录,会报关于脚本执行莫名奇妙的错误。PATH变量的设置是为了系统能找到命令所对应的文件。
PYENV环境变量设置:

python安装包的位置就是由该变量控制。
1.4 验证
执行powershell命令:pyenv version 如果命令不报错,则安装成功。
1.5 安装python
检查支持支持版本:pyenv install --list 该命令是检查pypenv支持的版本,如果在不在列表中,就没法安装。就是说可能没有最新版本的python。
然后执行命令安装对应版本的python:pyenv install 3.13.5 命令执行后会发现如下下载信息

使用pyenv global 3.13.5设置全局python,pyenv local <version>局部版本。设置版本后可能需要关闭窗口重新打开。输入pyenv versions能查看所有安装的python版本和当前使用的版本,当前版本是前面带*号标记的版本。但是一般项目不使用这个玩意来指定虚拟环境python版本,而是使用pipenv。这个可以看pipenv虚拟环境使用介绍。输入python即可进入解释器编写python代码。如果没有必要,学习与研究都不要安装python 2版本了。
因为在安装的python包下面会自带pip(D:\pyenv-win-master\pyenv-win\versions\3.13.5\Lib\site-packages),所以不需要再额外安装pip。通过命令配置镜像源。pip config set global.index-url https://mirrors.aliyun.com/pypi/simple/ 该命令会在用户目录下(F:\Users\admin2\AppData\Roaming\pip)产生pip.ini文件记录配置项。
在线安装可能下载比较慢或者卡住,可以直接下载需要的包放到install_cache目录下,然后再执行pyenv install 3.13.5安装命令。
1.6 pyenv常用命令与验证
commands List all available pyenv commands
local Set or show the local application-specific Python version
latest Print the latest installed or known version with the given prefix
global Set or show the global Python version
shell Set or show the shell-specific Python version
install Install 1 or more versions of Python
uninstall Uninstall 1 or more versions of Python
update Update the cached version DB
rehash Rehash pyenv shims (run this after switching Python versions)
vname Show the current Python version
version Show the current Python version and its origin
version-name Show the current Python version
versions List all Python versions available to pyenv
exec Runs an executable by first preparing PATH so that the selected
Python version's `bin' directory is at the front
which Display the full path to an executable
whence List all Python versions that contain the given executable
2 pipenv(不推荐)
Pipenv 是 Python 官方推荐的依赖管理和虚拟环境工具。它将 pip(包管理)和 virtualenv(虚拟环境)的功能合二为一,并通过 Pipfile 和 Pipfile.lock 文件来确保项目的可复现性。实际上不太好使,更新也慢。
win10上测试的时候发现没有pipenv scan命令,pipenv check提示安装安全组件,组件安装成功,但是命令还是报错,需要使用的可以在linux上试试看。
2.1 安装pipenv
使用命令: pip3 install pipenv -i https://mirrors.aliyun.com/pypi/simple 安装pipenv 官网
常用命令:


2.2 创建虚拟环境
在项目目录下执行:pipenv install 结果会产生两个依赖包管理文件(先手动创建.venv),如下图:

默认虚拟环境会在用户目录C:\Users\admin\.virtualenvs下面,这样如果觉得不方便,可以在项目目录下创建.venv然后执行pipenv install即可。有一种一劳永逸的设置办法,可以设置环境变变量 PIPENV_VENV_IN_PROJECT=1 可以达到同样的效果,推荐这样做。网上有中办法是设置WORKON_HOME,但是这个方式会生成一个奇怪的目录结构,爱整洁的我不喜欢这种目录结构。

2.3 deploy与sync区别
--deploy适用场景
生产服务器部署时确保环境一致性14
审计关键项目的依赖完整性(如安全敏感应用)
示例命令:pipenv install --deploy --ignore-pipfile
sync适用场景
开发团队新成员快速同步环境
修复因误操作导致的虚拟环境损坏
示例命令:pipenv sync --dev
速度:sync比--deploy快约30%-50%(因跳过依赖解析)
安全性:--deploy通过双重验证更安全,但可能因严格检查导致部署失败
灵活性:sync允许环境与Pipfile临时不一致,适合敏捷开发
建议结合用户历史问题中提到的依赖冲突解决方案(如--skip-lock)灵活选择命令。
对于需要严格复现的环境,优先使用--deploy;快速迭代场景下sync效率更高。
2.4 依赖管理
后续python项目都使用pipenv安装替换pip。pipenv同npm管理方式很接近,比pip要先进得多。注意命令是pipenv,有时候pipenv和pip容易搞混,这也是比较恶心的地方。pip3能安装的依赖,有时候用pipenv安装可能会报错,感觉不太稳定。有些情况可能是pipenv的校验机制比较pip严格,通过 不了校验,安装不成功,可以使用命令pipenv run pip3 install xxxx跳过校验机制,但这有可能导Pipfile和Pipfile.lock没有对应的依赖信息,可能影响最终版本的安装部署,这就有点坑了。pip3会改变Pipfle,但是没发现修改lock文件。
2.5 配置文件概览

各个选区具体意思请参看官网 配置文件说明 一般来说不需要人工修改配置文件,全靠pipenv命令维护,才能保证一致性。但是有些情况需要调整,比如下载的url地址需要换成更快镜像地址的情况。
2.6 Pipfile配置script
支持配置自定义命令,这个记得不要和系统的冲突,示例如下图:

3 poetry(推荐) 官网
3.1 poetry介绍
因为pipenv容易卡住,性能不太好,poetry有类似功能。这里做一些尝试对比,根据自己需要选择。
3.2 poetry安装
官网推荐用命令pipx install poetry 安装,所以需要先用pip install pipx 安装pipx
poetry安装后可能会提示poetry安装路径不在PATH环境变量中(默认是C:\Users\admin\.local路径下)需要运行提示的命令确保添加到PATH变量,或者自己手动加也行。然后再控制台输入poetry验证。
3.3 创建项目
命令:poetry new [文件夹名字] --python=[pyhon版本]
示例:poetry new my-project --python=3.10.11
结果如下图:

.python-version 是pyenv 执行pyenv local 3.10.11 生成的。如果先执行了这个命令,创建项目的时候就不用指定版本,如:poetry new my-project。
pyproject.toml是poetry管理配置文件。其他是默认创建的项目结构。这个结构不太符合我个人的风格,一般会把src和tests都归到py目录下,共享一个顶层包。
这里最好有一个顶层包和项目名字一样,就像上图中的src下有个包my_project。因为poetry build之后的模块名字是配置文件name。如果顶层包和顶层文件夹(也是配置文件中的name字段)不一致,如项目顶层文件夹叫xx。该目录下有个顶层包叫oo,那么poetry build之后,其他应用使用poetry add 之后显示的模块名字叫xx 但是导入的时候叫oo。这就有点怪怪的了。起初我看到新建的顶层目录文件夹和src下面有同名文件夹,感到非常不理解。估计应该就是这个原因导致这个奇怪的目录结构现象。
如果包需要发布到pypi,那么需要先去pypi检查一下项目名字,防止重名。pip会对名字做规范化处理,项目名字全部使用小写之母中间使用连字符。如 scikit-learn 但顶层包名却是sklearn就是开发者在代码中使用import语句导入的名字。项目名字更像程序的名字,包名字才是导入的名字。这里可能会引发问题,如果项目名字不一样,但是存在相同的包名字,可能会引起导入冲突,这里可以将项目名字连字符改成下划线变成包名,确保唯一性就像上面截图中的样子。
poetry new [项目名字] --flat 可以让包名字直接在根目录下。这样看起来更清晰
3.4 创建虚拟化环境
使用poetry config --list 查看配置,如果virtualenvs.in-project = null,则用命令 poetry config virtualenvs.in-project true 设置成true(如果不设置,那么虚拟环境目录就在配置对应目录下,不在项目目录下,设置后可能需要关闭窗口,重新打开窗口才生效)。
进入项目目录(如my-project),然后执行(可能需要管理员权限):poetry install 结果如下图:

3.5 安装依赖
先在配置文件pyproject.toml添加如下内容,预先配置好版本和安装源。
| [tool.poetry.dependencies] [[tool.poetry.source]] [[tool.poetry.source]] |
因为我安装的的CUDA是12.6版本,所以配置中指定了。pytorch的官网有相关版本匹配信息,这里pipy使用了阿里镜像源,可是使用其他或者默认镜像源。
然后执行 peotry lock 成功后再执行peotry install 安装配置的依赖。经过验证安装成功,项目.venv目录下也有对应安装包。

注意:
当你运行 poetry install 时,Poetry 实际上做了两件事:
- 安装依赖:安装你在
pyproject.toml中列出的所有第三方库(如requests,numpy等)。 - 安装项目本身(可编辑模式):它会将当前项目作为一个包安装到虚拟环境中。
3.6 常用配置说明
官网 pyproject.toml 。配置在像PEP靠拢,老大的配置方式要过时,但是PEP配置还没有poetry配置强大,这点需要注意
3.6.1 project 项目元数据
[project]
name = "my-awesome-project"
version = "0.1.0"
authors = [
  { name="Your Name", email="your.email@example.com" },
]
description = "一个功能强大的现代 Python 项目"
readme = "README.md"
license = { text = "MIT" }
# 指定项目兼容的 Python 版本
requires-python = ">=3.9"
# PyPI 上的分类标签
classifiers = [
    "Programming Language :: Python :: 3",
    "License :: OSI Approved :: MIT License",
]
3.6.2 依赖配置
有两种模式
| 特性 | [tool.poetry.dependencies] | [project.dependencies] |
|---|---|---|
| 归属标准 | Poetry 专用 (非标准) | PEP 621 官方标准 (通用) |
| 语法格式 | 字典/键值对 (requests = "^2.0") | 数组/列表 ("requests^2.0") |
| 兼容性 | 只有 Poetry 能读懂 | pip、build、hatch、poetry 都能读懂 |
| 主要用途 | 定义项目依赖,但格式由 Poetry 决定 | 定义项目依赖,符合 Python 社区规范 |
| 现状 | 旧版 Poetry 默认使用,正在逐渐被弃用 | 未来的主流,Poetry 新版本也推荐转向它 |
新模式有些缺陷,不支持更复杂的属性配置:
#poetry 特有
[tool.poetry.dependencies]
python = ">=3.10,<3.14.0"
torch = { version = "2.8.0", extras = ["cu126"], source = "torch" }
torchvision = { version = "0.23.0", extras = ["cu126"], source = "torch" }

#标准格式无法带source属性,如果不是poetry禁止使用,可以都用上面那种配置
[project]
dependencies = [
    "torch[cu126]==2.8.0"
]

# 定义源(Poetry 1.5+ 支持的标准风格源定义)
[[tool.poetry.source]]
name = "torch"
url = "https://download.pytorch.org/whl/cu126"
priority = "explicit" # 显式指定,只有包名匹配时才用这个源
3.6.3 配置源
poetry source show 可以显示下载源信息。
poetry source add --priority primary aliyun-pypi http://mirrors.aliyun.com/pypi/simple/ 可以将默认的pip源替换成阿里源。命令执行后会在pyproject,toml产生如下配置:
| [[tool.poetry.source]] name = "aliyun-pypi" url = "http://mirrors.aliyun.com/pypi/simple/" priority = "primary" |
和直接修改配置文件效果一样。
[[tool.poetry.source]]
name = "my-private-repo"          # 必填:源的唯一标识名称
url = "https://my-repo.example.com/simple/"  # 必填:源的 URL (必须以 /simple 结尾)
priority = "primary" # 选填:优先级 (默认为 primary)| 优先级 | 说明 | 行为逻辑 |
|---|---|---|
"primary" | 主源 | Poetry 会同时查询该源和 PyPI。如果同一个包在两个源中都存在,Poetry 可能会报错或根据版本策略选择。通常用于公司内部完全替代 PyPI 的场景。 |
"supplemental" | 补充源 | Poetry 会先查询 PyPI。只有在 PyPI 找不到该包时,才会去该源查找。通常用于存放公司内部私有包,而公共包仍走 PyPI。 |
"explicit" | 显式源 | Poetry 仅在明确指定从该源安装包时才使用它。默认情况下不会查询该源。 |
场景 A:混合模式(推荐)
大多数公司的使用场景:公共库(如 requests)走官方 PyPI,内部私有库(如 my-company-utils)走私有源。
[tool.poetry]
name = "my-project"
version = "0.1.0"

# 1. 配置补充源
[[tool.poetry.source]]
name = "company-nexus"
url = "https://nexus.mycompany.com/repository/pypi/simple/"
priority = "supplemental"  # 先找 PyPI,找不到再来这里找

[tool.poetry.dependencies]
python = "^3.9"
requests = "^2.28.0"  # 从 PyPI 下载
my-internal-lib = "^1.0.0"  # PyPI 没有,自动从 company-nexus 下载
场景 B:完全镜像模式
为了速度或安全,完全禁用 PyPI,所有包都从内部镜像源获取。
[[tool.poetry.source]]
name = "tsinghua"
url = "https://pypi.tuna.tsinghua.edu.cn/simple"
priority = "primary" # 设为 primary 会干扰 PyPI,建议配合 default 使用

# 注意:如果要完全替代,通常还需要禁用默认 PyPI
# 或者将私有源设为 default (Poetry 1.4.0+)
[[tool.poetry.source]]
name = "internal-mirror"
url = "https://pypi.internal/simple"
priority = "default"
认证方式
如果源是私有的,需要进行身份验证,Poetry 不会在 pyproject.toml 中明文存储密码,而是通过以下两种方式:
-
环境变量(推荐用于 CI/CD):
设置POETRY_HTTP_BASIC_<NAME>_USERNAME和POETRY_HTTP_BASIC_<NAME>_PASSWORD。- 注意:
<NAME>必须对应[[tool.poetry.source]]中的name字段,并将连字符-转换为下划线_。 - 例如
name = "my-repo",则变量名为POETRY_HTTP_BASIC_MY_REPO_USERNAME。
- 注意:
-
Poetry 配置命令:
在本地终端运行:
poetry config http-basic.my-repo myusername mypassword3.6.4 script配置
scripts标签可以配置一些命令
| 特性 | [project.scripts] | [tool.poetry.scripts] |
|---|---|---|
| 标准归属 | 官方标准 (PEP 621) | Poetry 特有 (非标准) |
| 适用范围 | 通用 (pip, setuptools, hatch, poetry 1.2+) | 仅限 Poetry |
| 语法格式 | 命令名 = "模块:函数" | 命令名 = "模块:函数" |
| 额外功能 | 仅支持标准的脚本入口点 | 支持额外参数 (如 extras) |
| 推荐程度 | ⭐⭐⭐⭐⭐ (现代项目首选) | ⭐⭐⭐ (旧项目或需特殊功能时使用) |
如下图是我配置的一个使用实例:
发现有两种project.scripts配置方式有缺陷,只能支持相同顶层包模块识别,比如pkg01下的test.py就不能导入tests模块下的包。tool.poetry.script就可以,所以我推荐项目使用一个顶层包。先使用poetry install 将配置的命令安装到虚拟环境,然后使用poetry run run_testxx。就会执行ptr_test4.pkg01包下test模块testxx函数。运行的时候会生成缓存文件,可以加-B 参数不生成缓存文件。python自身好像没有清理命令,这就有点恶心了,需要手动删除,可以找一些工具处理。代码更新了,保存会自动更新,只是看起有点恶心。
提示:
When a script is added or updated, run poetry install to make them available in the project’s virtualenv
[tool.poetry.scripts]
Deprecated: Use project.scripts instead for console and gui scripts. Use [tool.poetry.scripts] only for scripts of type file
#[project.scripts]
#开始测时候这个会报错,后面不报错了
#run_test1 = "test3_project.sub_pkg11.test1_in_pkg11:printName"

#[tool.poetry.scripts]
#poetry run run_test1 可行
#run_test1 = "test3_project.sub_pkg11.test1_in_pkg11:printName"
#不行
#run_test1 = { module = "test3_project.main", attr = "main" }
不install也可以执行,这个命令用处不大,本来像配置模块运行方式,但是要要报错,没啥用处。
3.6.5 build-system
它的作用是告诉工具(如 pip、poetry、build):“如果你想安装或打包这个项目,你需要先安装哪些依赖,以及使用哪个 Python 模块来执行构建操作。”这是 Python 打包标准化的重要组成部分(基于 PEP 517 和 PEP 518 标准)。
[build-system]
# 1. 构建依赖:构建这个项目所需的包
requires = ["poetry-core>=1.0.0"]

# 2. 构建后端:实际执行构建工作的 Python 模块
build-backend = "poetry.core.masonry.api"| 字段 | 说明 | 常见值示例 |
|---|---|---|
requires | 构建依赖列表。 这是一个字符串列表,指定了构建项目所需的所有包及其版本。 pip 会在构建前自动在隔离环境中安装这些包。 | ["setuptools>=45", "wheel", "setuptools_scm[toml]>=6.2"]["poetry-core>=1.0.0"]["flit_core>=3.2,<4"] |
build-backend | 构建后端入口。 指定一个 Python 对象(模块路径),该对象必须实现标准的构建钩子(如 get_requires_for_build_wheel, build_wheel 等)。 | "setuptools.build_meta""poetry.core.masonry.api""flit_core.buildapi" |
在 build-system 出现之前,Python 项目主要依赖 setup.py。这带来了一些问题:
- 黑盒执行:
pip在运行setup.py之前,不知道它需要什么依赖(除了install_requires,但构建本身的依赖如Cython往往不明确)。 - 强耦合:项目强依赖于
setuptools,难以切换到其他构建工具。
build-system 解决了这些问题:
- 构建隔离:
pip看到requires后,会创建一个临时的虚拟环境,只安装这里列出的包,构建完即销毁。这防止了构建过程污染你的全局环境。 - 工具无关性:你可以自由选择构建工具(Poetry, Flit, Setuptools, Hatchling 等),只要它们符合 PEP 517 标准
3.6.6 packages
[tool.poetry]
packages = [{include = "test4_project", from = "src"}]
配置的作用是显式地告诉 Poetry(以及你的 Python 环境)去哪里寻找你的项目源代码。
简单来说,它定义了你的项目包(比如 test4_project)的物理位置。
3.7 常用命令
参看官网 命令
poetry [--help|-h] [--quiet|-q] [--verbose|-v|vv|vvv] [--version|-V] [--ansi] [--no-ansi] [--no-interaction|-n] <command>-v,-vv,-vvv: 增加输出详细程度(正常 -> 详细 -> 调试)。-q: 静默模式,不输出非错误信息。-n: 非交互模式(不询问确认,直接使用默认值)。--ansi/--no-ansi: 强制开启或关闭彩色输出。
3.7.1 基础与初始化
| 命令 | 说明 | 示例 |
|---|---|---|
new | 创建一个全新的项目目录结构。 | poetry new my-project |
init | 在当前目录初始化 pyproject.toml(交互式问答)。 | poetry init |
about | 显示 Poetry 的基本信息和帮助链接。 | poetry about |
check | 验证 pyproject.toml 的有效性,检查锁文件是否过期。 | poetry check |
version | 显示或设置项目版本号。 | poetry versionpoetry version 1.2.0 |
self | 管理 Poetry 自身的安装(更新、添加插件等)。 | poetry self updatepoetry self show plugins |
3.7.2 依赖管理
| 命令 | 说明 | 示例 |
|---|---|---|
add | 添加包到 pyproject.toml 并安装。 |
|
remove | 从项目中移除包并卸载。 | poetry remove requests |
update | 更新依赖包到最新允许的版本,并更新锁文件。 | poetry updatepoetry update requests (只更新特定包) |
lock | 仅解析依赖并生成/更新 poetry.lock,不安装任何包。 | poetry lockpoetry lock --no-update (重新锁定当前版本) |
install | 根据 poetry.lock 安装所有依赖(生产环境部署常用)。 | poetry installpoetry install --only dev (只装开发依赖)poetry install --no-root (不安装项目本身,只装依赖) |
show | 列出已安装的包及其详细信息。 | poetry showpoetry show --tree (显示依赖树)poetry show --outdated (显示可更新的包) |
search | 在 PyPI 上搜索包。 | poetry search requests |
注意 poetry install --no-root 不安装项目本身,如果已经安装了,只能直接删除虚拟目录,再重新安装,poetry show不会列出项目本身。
3.7.3 虚拟环境管理
| 命令 | 说明 | 示例 |
|---|---|---|
env info | 显示当前激活的虚拟环境的详细信息(路径、Python版本等)。 | poetry env infopoetry env info --executable (仅打印解释器路径) |
env list | 列出该项目关联的所有虚拟环境。 | poetry env list |
env use | 切换或指定项目使用的 Python 解释器。 | poetry env use python3.9poetry env use /usr/bin/python3.11 |
env remove | 删除指定的虚拟环境。 | poetry env remove python3.9 |
env activate | 激活虚拟环境并启动一个新的 Shell (类似 source bin/activate)。 | poetry env activatepoetry env activate --fish (生成 fish shell 命令) |
3.7.4 运行与脚本
| 命令 | 说明 | 示例 |
|---|---|---|
run | 在虚拟环境中运行任意命令。 | poetry run python main.pypoetry run pytest |
shell | 启动一个新的 Shell 并自动激活虚拟环境。 | poetry shell (退出输入 exit) |
3.7.5 构建与发布
poetry build命令能构建项目,默认会在项目路径dist目录下生成.tar.gz 和wheel文件。该文件就可以作为发布包给其他应用本地安装使用,或者使用poetry publish推送到仓库。.tar.gz安装实际上是先编译成wheel文件
| 命令 | 说明 | 示例 |
|---|---|---|
build | 构建项目包(生成 .whl 和 .tar.gz 到 dist/ 目录)。 | poetry buildpoetry build --format wheel (只构建 wheel) |
publish | 将构建好的包发布到 PyPI 或私有仓库。 | poetry publishpoetry publish --repository testpypi (发布到测试源)poetry publish --username ... --password ... |
config | 配置 Poetry 的全局或局部设置(如仓库源、API Token)。 | poetry config pypi-token.pypi YOUR_TOKENpoetry config virtualenvs.in-project true (在项目内创建 .venv) |
3.7.6 缓存管理
| 命令 | 说明 | 示例 |
|---|---|---|
cache list | 列出缓存中的条目。 | poetry cache list |
cache clear | 清除指定包或整个缓存。 | poetry cache clear pypi requestspoetry cache clear --all pypi |
3.8 与pip混用问题
如果你在poetry项目中一不小心使用了pip安装包,而且你还没注意到问题,pip是不会修改依赖配置文件的,那么你的配置文件依赖信息和实际安装的包可能不一致。目前的终极解决办法是删除虚拟环境,重新poetry install一把。安全起见,可以把pip名字改一下,避免手滑。
4 pipx
pipx (官网) 是面向用户的的命令。这个看起来简单的说明,可能有点不太好理解。据我目前的理解来说,是给用户安装python应用程序的。比如别人发布了一个python程序a,你可以用pipx来安装这个应用程序(如 pipx install a),每个安装的程序都是独立的,也不会干扰系统,如果有可执行文件,还会把路径添加到用户环境变量中。看到这里应该就能明白其使用场景了。需要使用的时候,可以安装两个不同应用,检验一下是不是产生独立的虚拟环境。这个不要和poetry和pipenv使用场景搞混了。如果是用来安装python应用程序,pipx就够了,还是一个很好的选择。
5 依赖管理工具总结
通过pytorch环境的安装实践,做一些总结,供大家参考和交流。
pipenv命令要简洁和易用一些,配置文件也相对要简单一些。但是性能和稳定不好。cu126版本pytorch没有安装成功,报依赖有问题,但是用pip安装后打印出依赖图和树,没有看出冲突在哪里,pip下的的包也能通过程序检测:


poetry 命令和配置看起来要复杂一些,但是安装成功了。机制也是一样的,使用toml配置文件管理依赖,lock文件锁定精确版本,只是速度还是比pip慢很多。poetry 支持打包(poetry build)和发布包到pipy(poetry publish),这也是poetry的一个优点。
pip 时老牌包管理工具,没有依赖配置文件。安装很快,没有特殊需要求只有pyenv和也基本可以实现多版本python同时使用,如果需要使用虚拟环境,从对比来看建议使用poetry。如果遇到poetry解决不了的情况可以使用pip安装依赖。
一种较为这种的办法是使用pyenv管理python安装和版本切换,使用pipenv或者poetry创建虚拟环境,直接使用pip安装虚拟环境依赖。需要时可以用pip导出requirements.txt文件,pipreqs可以导出实际依赖项目。
安装python依赖过程中,会产生大量缓存在用户目录(默认是C盘),可能会影响系统运行,需要提前考虑空间是否足够大,可以提前改变用户数据存储盘。
6 Jupyter
1 安装
python3安装好后,就可以用python自带的pip安装Jupyter 了,安装命令:
pip3 install notebook
实时上直接使用pip install notebook 也行,pip 会连接到pip3
jupyter时候后会出问题,没有反应,遇到这种问题可以重启,如果还不生效,直接用pyhon解释执行python脚本。
2 启动
使用Jupyter之前,最好先建立一个工作目录,然后在工作目录打开powershell然后执行命令启动
jupyter notebook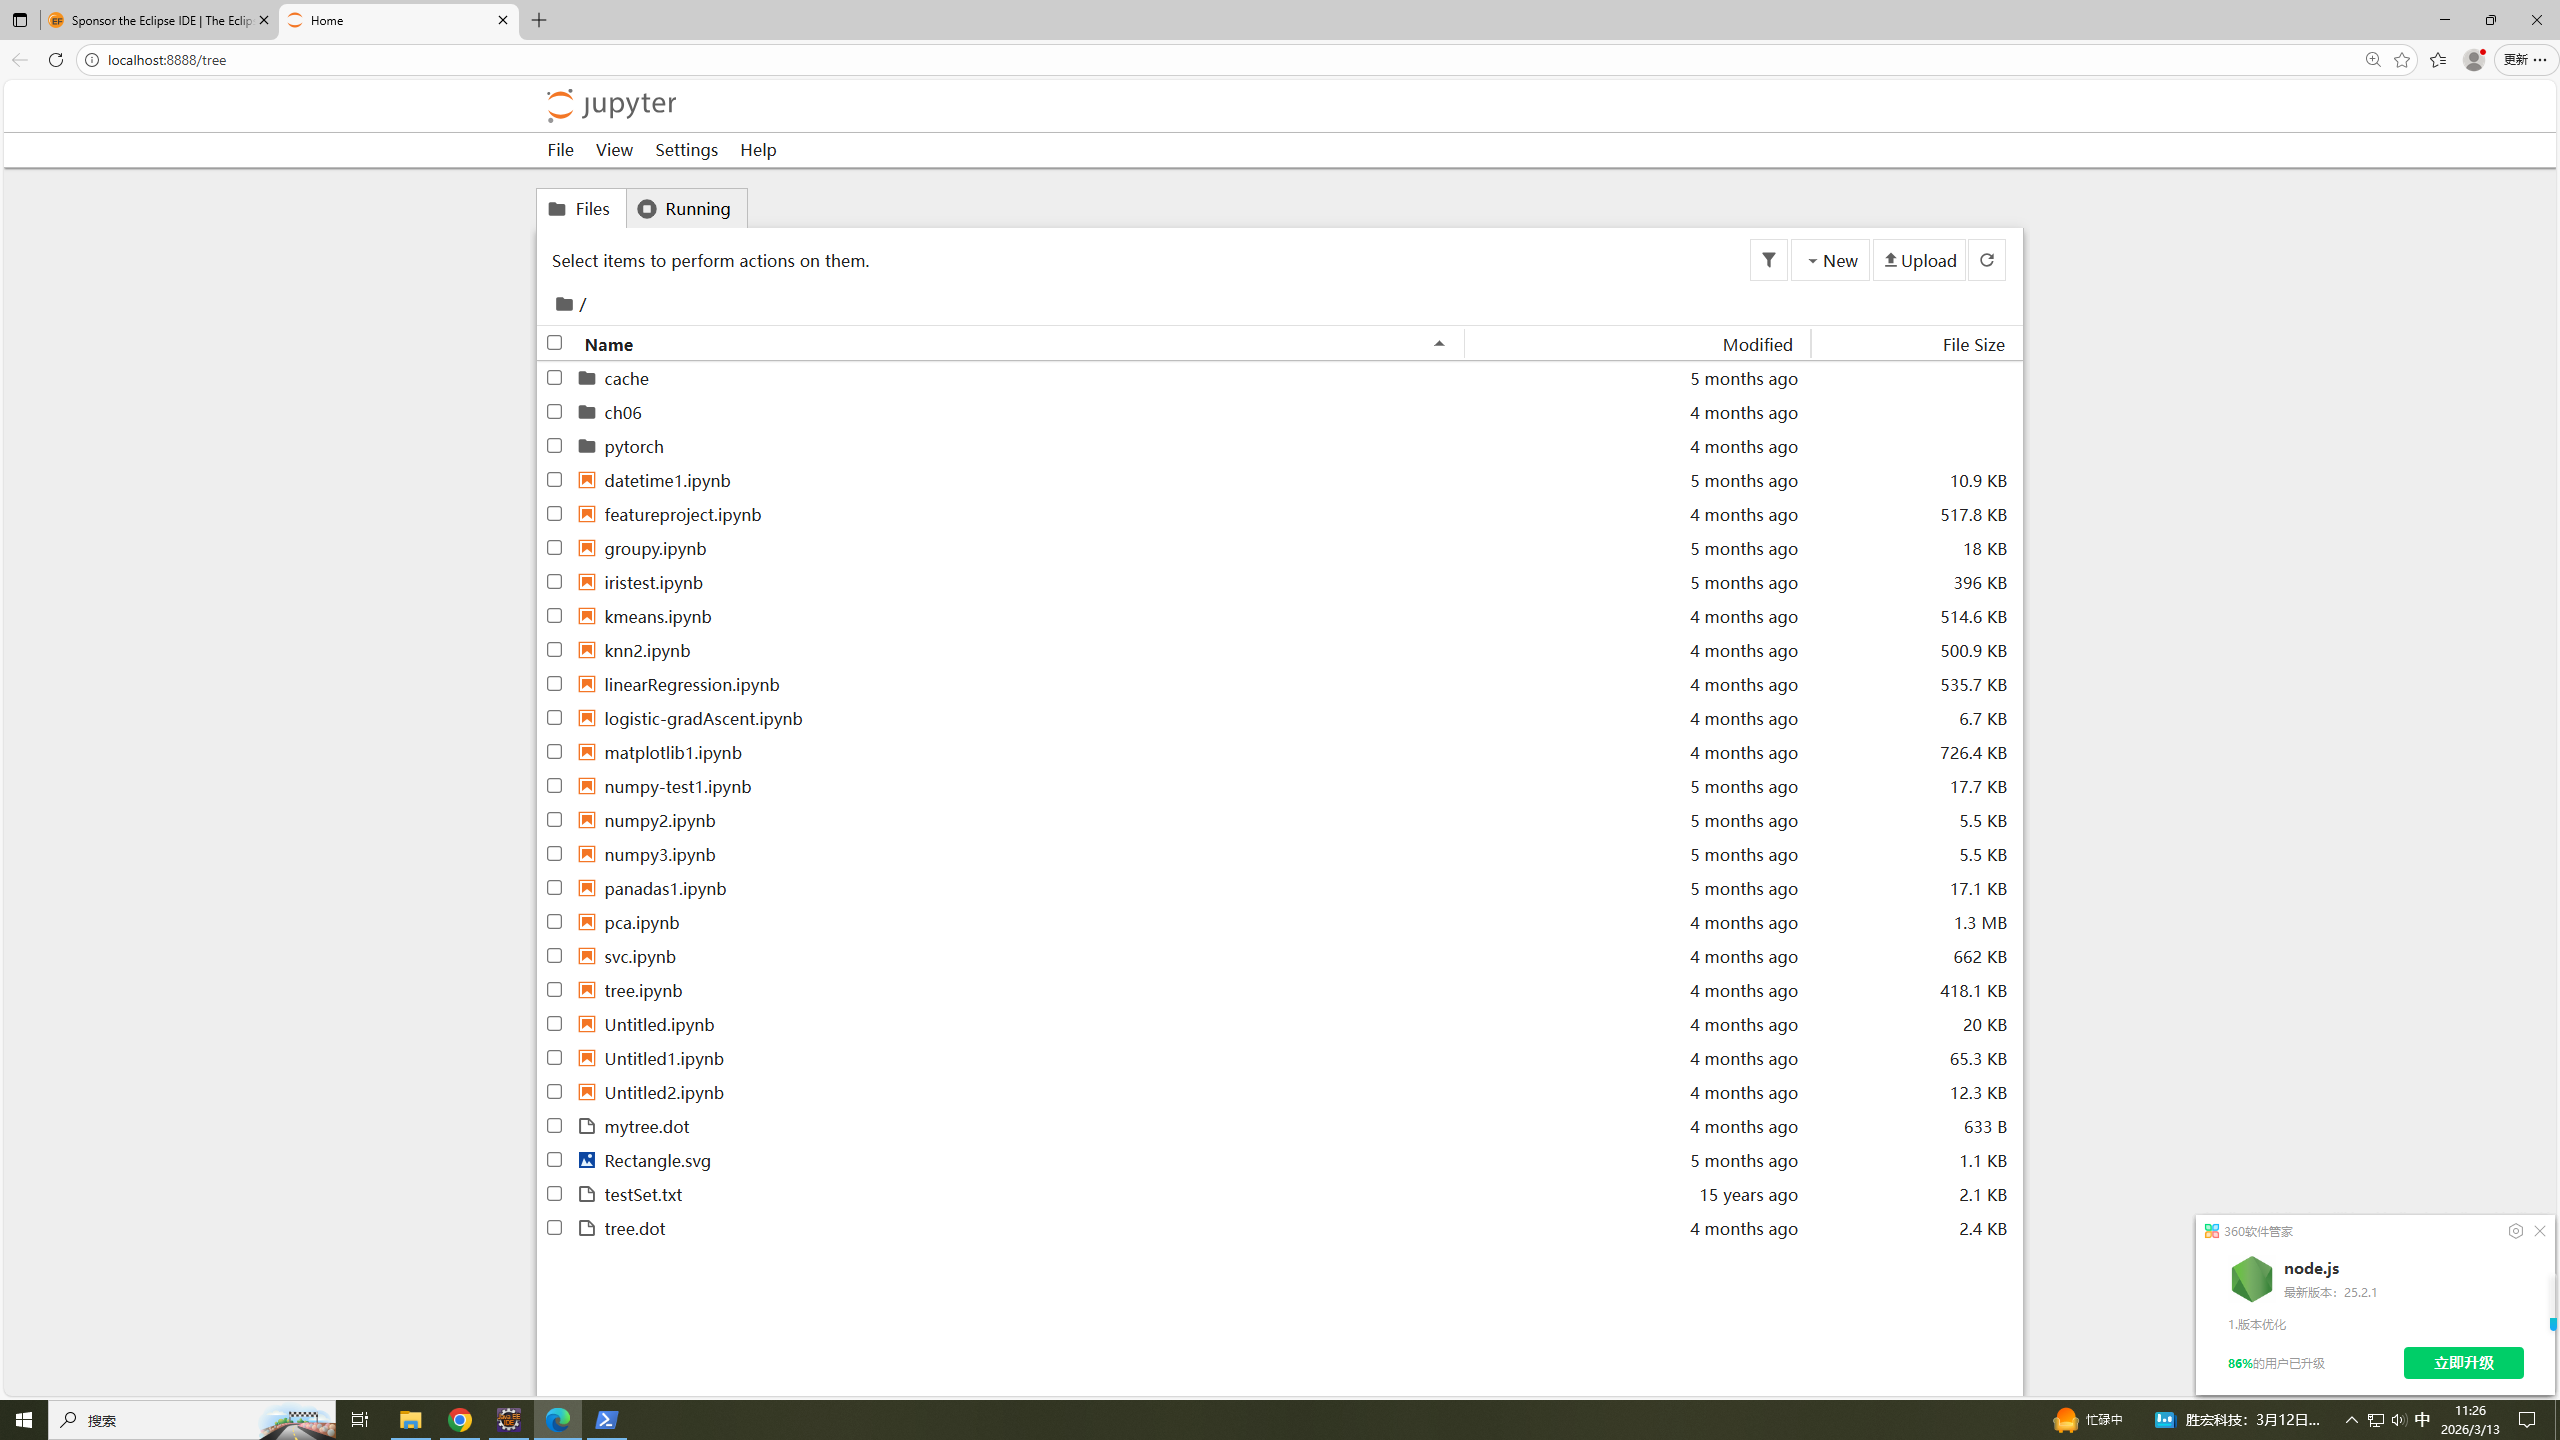
3 创建工作文件
这个就和写python文件差不多,只是更便捷一些,创建后的文件就会保存到工作目录下,后缀.ipynb,如下图
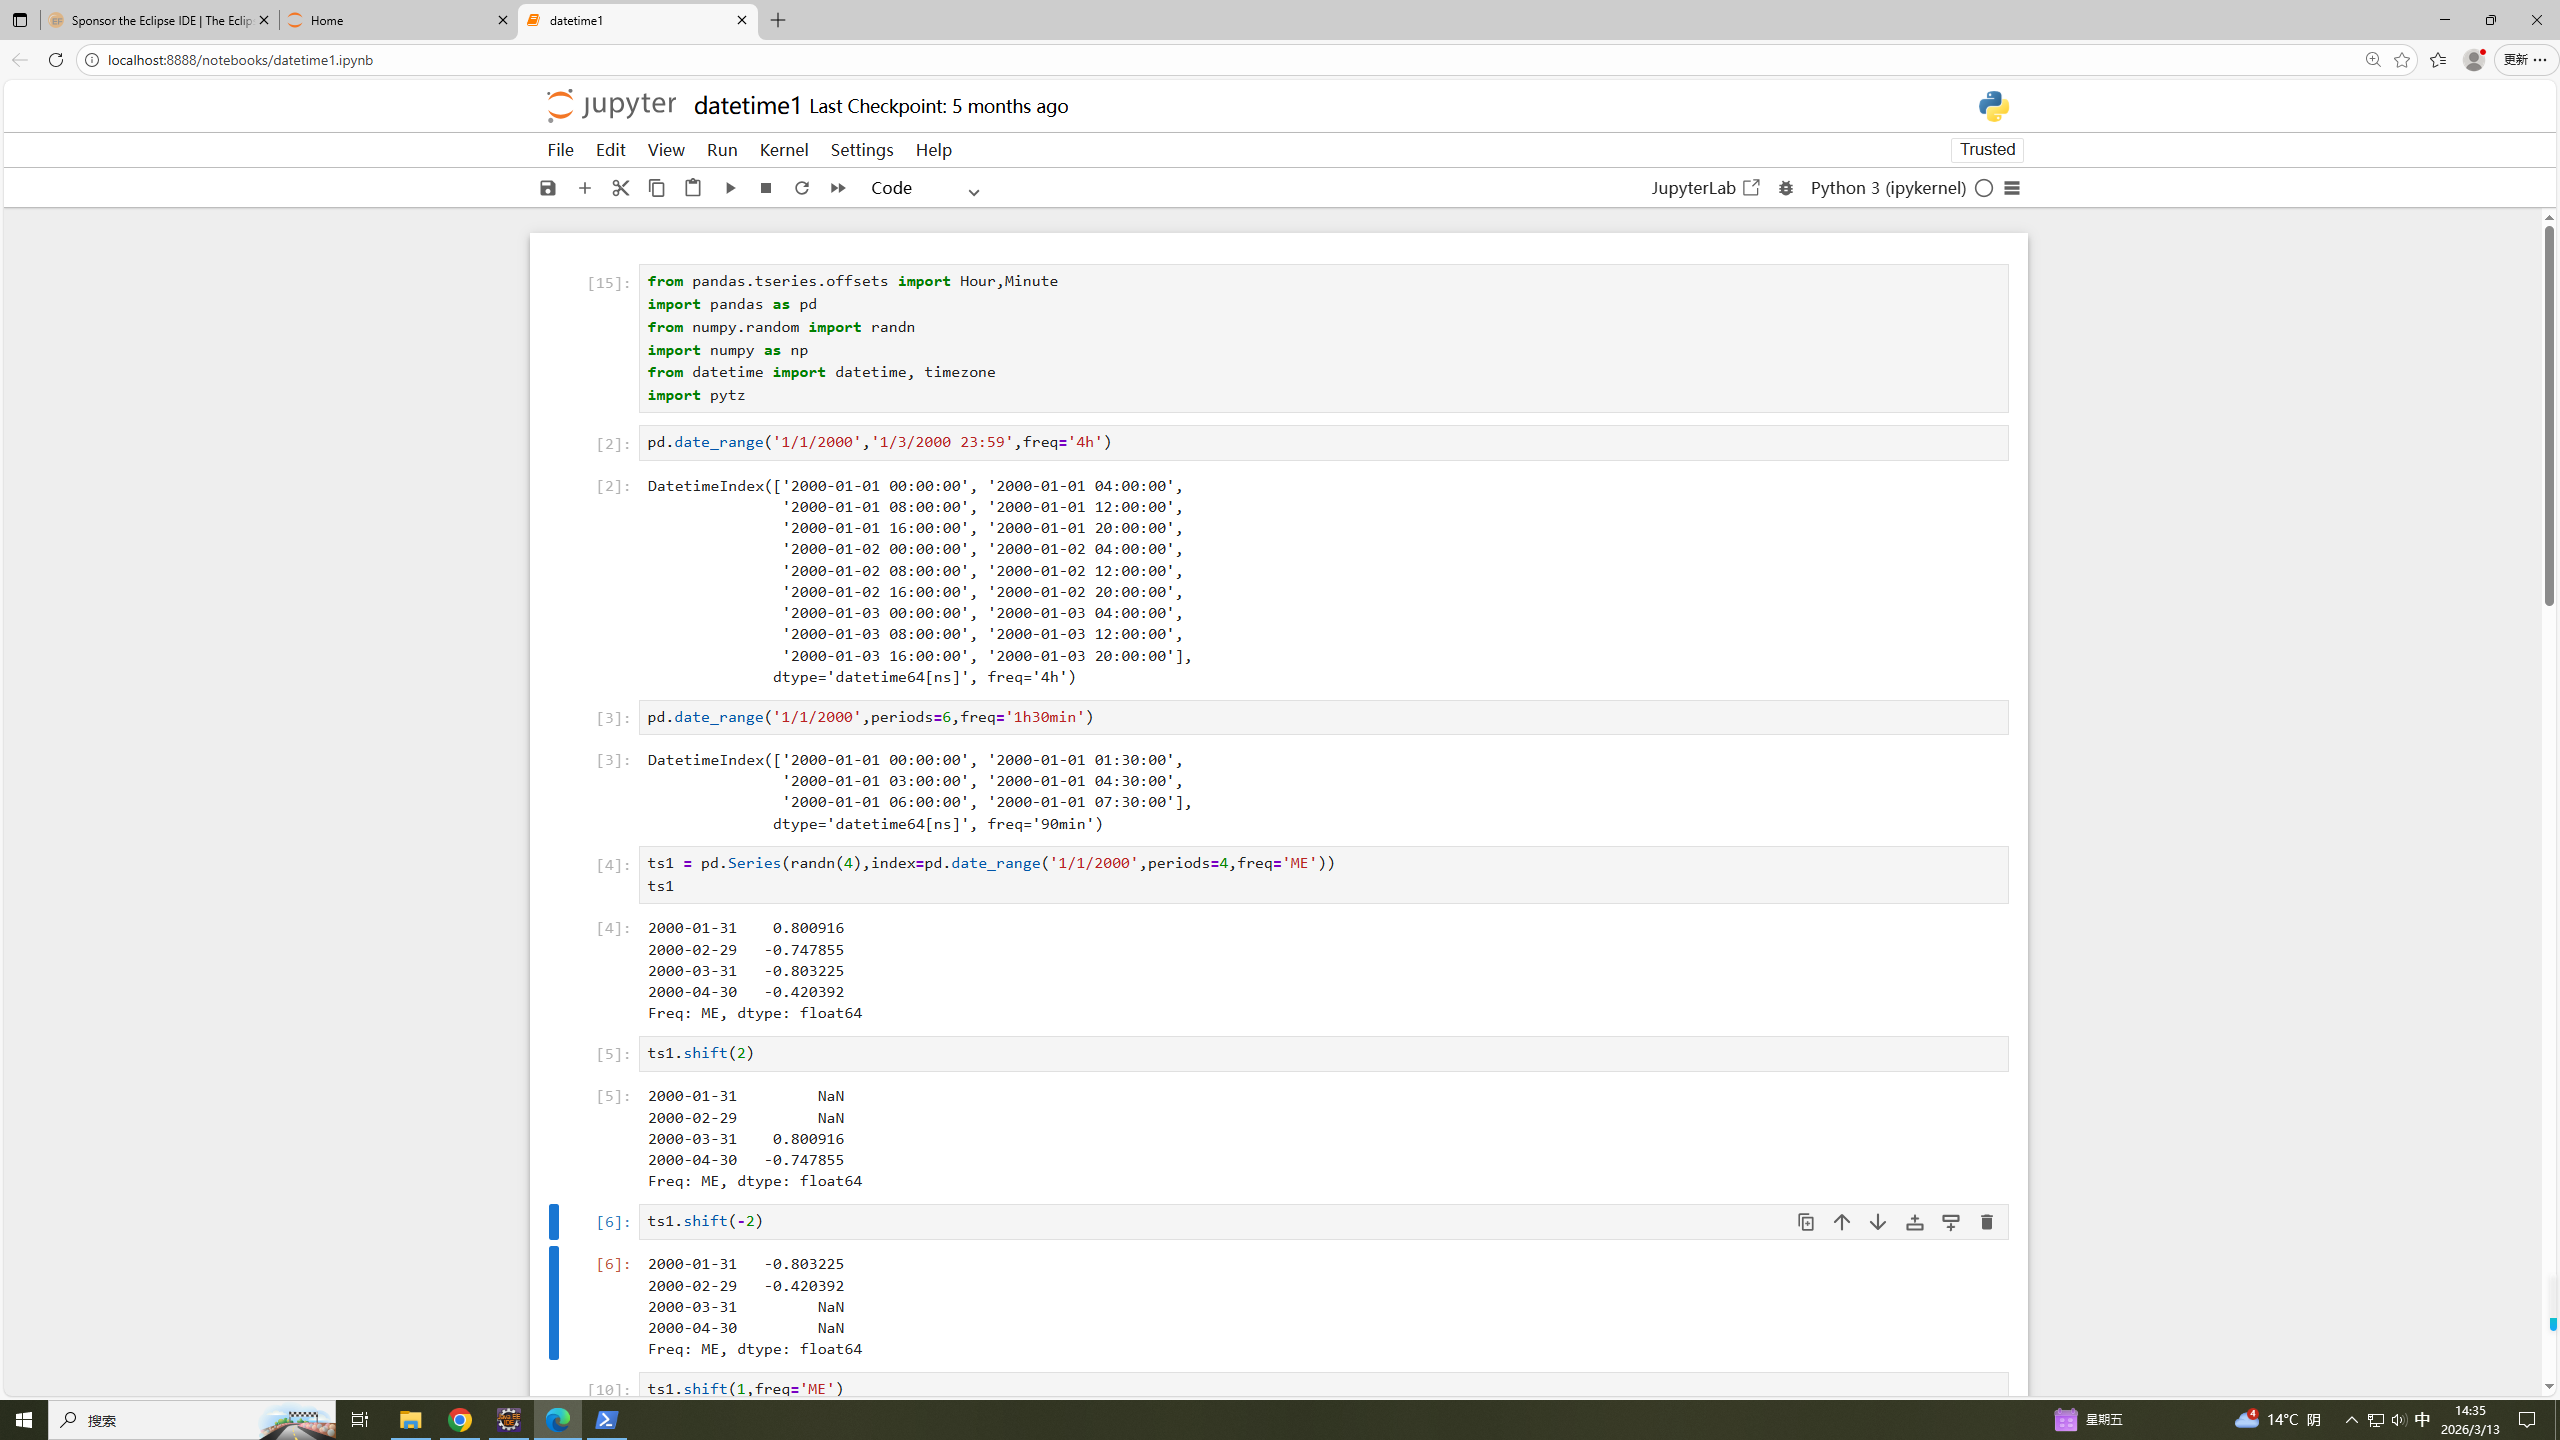
像上面这个就可以开始你的表演了
7 工程化
工程化对软件的可维护性可以说是重中之重,90%的人对这块都有要求,但实际对工程化有很好认识和实践的人很少。没有经过实践提炼是不可能做出真正可行的工程化框架。一个良好的工程化框架,可以极大加快可读性和开发速度,方便后期维护。有部分人是不管这玩意的,包括自己干的项目,有时候其实也是无奈的选择,干完了就没事做了😂。
首先我们来看看AI查出来的工程化解释:是一个将科学原理、技术或创意转化为可重复、高效率、高质量、可维护的系统性过程的方法论,简单来说,工程化就是把“手工作坊式”的、依赖个人经验和临时发挥的做法,转变为一套有标准、有流程、可协作、可预测的工业化生产模式。有以下一些基本特征
- 系统化 (Systematic): 采用自上而下的规划,将复杂问题分解为相互关联但职责清晰的模块,并考虑各部分之间的协同关系。
- 标准化 (Standardized): 建立并遵循统一的技术规范、流程和接口,确保不同团队、不同环节产出的一致性和兼容性,降低协作成本。
- 可重复性 (Repeatable): 整个过程和结果是稳定且可复现的。无论在何时何地,只要遵循相同的工程化流程,就能得到质量相近的产物。
- 自动化 (Automated): 尽可能利用工具和平台自动执行重复性、易出错的任务,如自动化测试、持续集成与部署(CI/CD),以提升效率并减少人为错误。
- 可维护性 (Maintainable): 设计时就考虑到未来的修改、扩展和问题修复,使得系统或产品在其生命周期内容易被理解和维护。
- 质量控制 (Quality Control): 在过程的各个阶段引入检查点和验证机制,如代码审查、单元测试、故障模式分析(FMEA)等,以确保最终成果符合预期标准。
所以遇到一些公司招人,你问他想招什么人,招来干什么,他说想找搞工程化的人。结果问题全是你对什么有没有升入研究?你知不知线程池有那些参数?你有没有研究过什么源码?所有的问题和工程化都不搭边。对工程化有一定认识的人,一般都是那种长期维护过项目,做过工程架构,系统稳定的少出幺蛾子的人。他们做得系统或者写的代码,都是容易发现套路和线索的,好用易入手,这种人一帮都有些代码洁癖。老板要是遇到懂这个的人,会隐形中个公司节约很多成本,但是容易被砍掉,因为系统稳定了,说明你不重要或者说你做的事情没有难度(这让我想起了扁鹊三兄弟的故事),要么让你去搞烂了七八年的系统。搞工程化不是研究算法,不要搞错目的。工程师其实是一个含金量很高的词,一般人是匹配不上这个词的。
7.1 要解决的问题
- 环境管理
- 依赖管理
- 工程结构
- 开发测试
- 打包发布
- 安装运行
- 运维监控
7.2 PIPY规范
Python 世界的“应用商店”或“图书馆”。开发者在这里发布他们编写的第三方库(Packages),而其他开发者可以通过工具轻松下载并安装这些库,以便在自己的项目中使用。也可以发布自己包到PIPY,让其他人可以下载使用
PyPI 项目名称允许(且推荐)使用连字符 -,而 Python 内部导入时必须使用下划线 _。
这是新手最容易混淆的地方。以下是基于 PEP 503 和 PEP 685 的官方规范详解:
1. 核心规则:标准化名称 (Normalized Name)
PyPI 遵循 PEP 503 标准,所有项目名称在存储和匹配时都会进行标准化处理。
- 允许的字符:
- 英文字母 (
A-Z,a-z) - 数字 (
0-9) - 连字符 (
-) - 下划线 (
_) - 点 (
.) —— 注:虽然允许,但通常用于版本号分隔,项目名本身尽量少用
- 英文字母 (
- 标准化规则 (Normalization):
- 全部转换为小写。
- 将所有的 连字符 (
-)、下划线 (_) 和 点 (.) 都视为等价,统一视为连字符-。 - 去除首尾空白。
💡 这意味着什么?
以下所有名称在 PyPI 上都被视为同一个项目:
My-Packagemy_packagemy.packageMY-PACKAGE
当你运行 pip install My-Package 时,pip 会自动将其标准化为 my-package 去搜索。
| 场景 | 推荐风格 | 示例 | 原因 |
|---|---|---|---|
| PyPI 项目名称 (在 pyproject.toml 或 setup.py 中) | kebab-case (全小写 + 连字符) | requests-oauthlibbeautiful-soup | 1. 符合 URL 友好习惯。 2. 避免与 Python 模块名混淆。 3. 社区主流惯例。 |
| Python 导入名称 (在代码中 import ...) | snake_case (全小写 + 下划线) | import requests_oauthlibimport bs4 | 1. - 在 Python 语法中是减号,不能用于导入。2. 必须符合 Python 标识符规范。 |
虽然 _ 和 - 在 PyPI 看来是一样的,但在发布和代码引用时有明确的分工:
7.3 分析与选择
问题是相同的,但是解决方案是多样的,这个可以根据具体情况选择,更具目前的研究和技术生态.
1 环境管理
主要管理python环境,用pyenv管理多版本python安装和切换即可
2 依赖管理和项目管理
pip只能安装包,但是没有配置文件,你不知道项目实际上需要那些包,不好分析和管理。不能像maven那样安装多个版本,只能是一个,所以出现了个虚拟环境
选择poetry工具,python多环境就选择pyenv即可。如果poetry遇到一些安装依赖处理不了,可能还需要结pip处理。
3 工程结构与开发测试
选择之前,我先提一下Django(5.2.12)这个框架(这个玩意可以作为http服务框架,如果有更好的选择,建议不要用,切记pyhon不是一个适合长期维护的语言),应该是用得比较多。
先看看Django生成的目录结构:
#创建命令 django-admin startproject test2_project .
py/ #这个目录并不是命令创建的,命令创建的只包含manage.py和test2_project目录以及下面的文件
├── manage.py
└── test2_project
    ├── asgi.py
    ├── __init__.py
    ├── settings.py
    ├── urls.py
    └── wsgi.py
早期的版本的可能是这样的结构
#创建命令 django-admin startproject test2_project .
test2_project/
├── manage.py
└── test2_project
    ├── asgi.py
    ├── __init__.py
    ├── settings.py
    ├── urls.py
    └── wsgi.py
poetry创建项目,有以下两种结构:
扁平化结构
#创建命令:poetry new test3-project --python=3.13.5 --flat
tree test3-project/
test3-project/
├── pyproject.toml
├── README.md
├── test3_project
│   └── __init__.py
└── tests
    └── __init__.py
这个结构tests下面的包是能引用test3_project下面的模块的,没有安装也能测试。
嵌套结构(官方推荐结构)
#创建命令:poetry new test4-project --python=3.13.5
test4-project/
├── pyproject.toml
├── README.md
├── src
│   └── test4_project
│       └── __init__.py
└── tests
    └── __init__.py
这个结构tests下面的包是能引用test4_project下面的模块的。开始的时候没有理解到为啥要这么干,认为上面的结构更合理,后面继续研究,发现推荐的结构就是带src,像PEP标准靠近,这玩意也在目录搞规范,越来越像java的风格靠近(可以去看看threading模块)。test不是让你测试src/test4_project下的源代码文件的,是让你测试执行poetry install后的代码(默认会安装到.venv/lib/site-packages下面),这让我很意外。
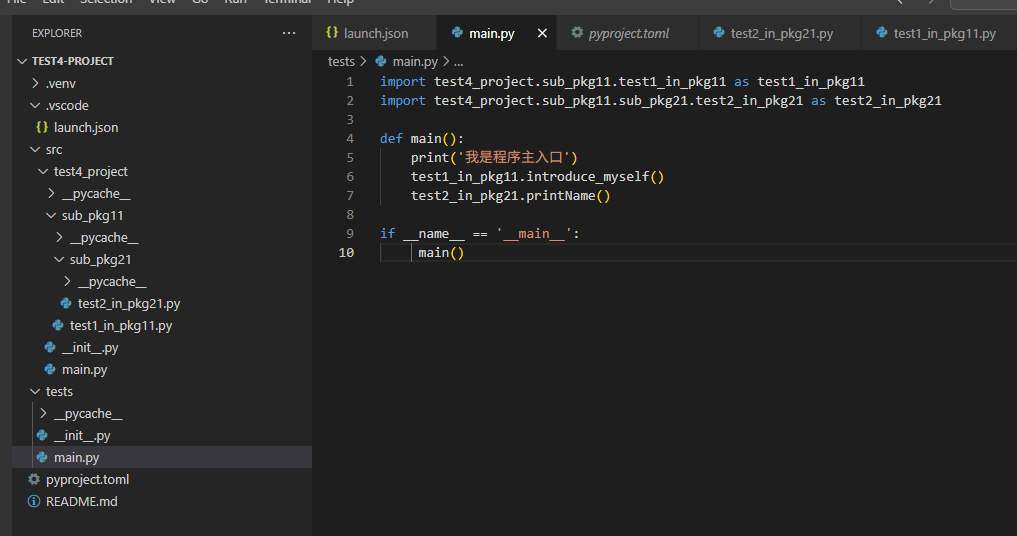
因为你要执行tests.main模块,你就必须在test4-project目录下,因为src不是包,所以tests/main.py导入的源文件根本就找不到,防止你测试源码,如果你执行poetry install后,会把项目安装到项目虚拟环境,你就能测了,目的是让你的测试更接近真实环境(这是你想要的吗?)。
这种模式目前来看,会带来一些麻烦,比如要切换执行目录(项目目录或者src目录下),还有其他的可能需要做香项目过程中才能发现了。
看起来上面两种结构,都能兼容Django,扁平结构可能更接近一些。
创建好后使用poetry install 自动产生依赖管理文件
最后总结:
poetry再像PEP标准靠近,导致配置不稳,有一定的维护代价。PEP的主要目的是要配置通用化,像pip这些也能识别,以后poetry会不会又被pip换回来也很难说。两种工程结构,扁平结构会相对简单一些。嵌套结构是推荐的方式,但是因为Python本身模块查找规则,可能会带来一些麻烦,根据具体需要选择。
到这里估计也看出了这玩意工程化、标准化方面都不成熟。不易用Python把项目做得过重,尽量只做必要部分,不然后期维护成本可能会很大。
两种目录结构最大的区别是你tests,目的是想测试你工程里面的代码,那么好的选择是不要src,如果要测试的是安装后的包,那么就要加src
7.4 开发与测试
pycharm是开发python最流行的ide,有社区版和专业版(付费)。我就直接用VsCode(安装pyhon支持插件即可),安装很多ide也麻烦。考虑到会使用到Django 项目以扁平结构为例子。
7.4.1 基础验证结构
将test3-project导入vscode并创建一些测试文件
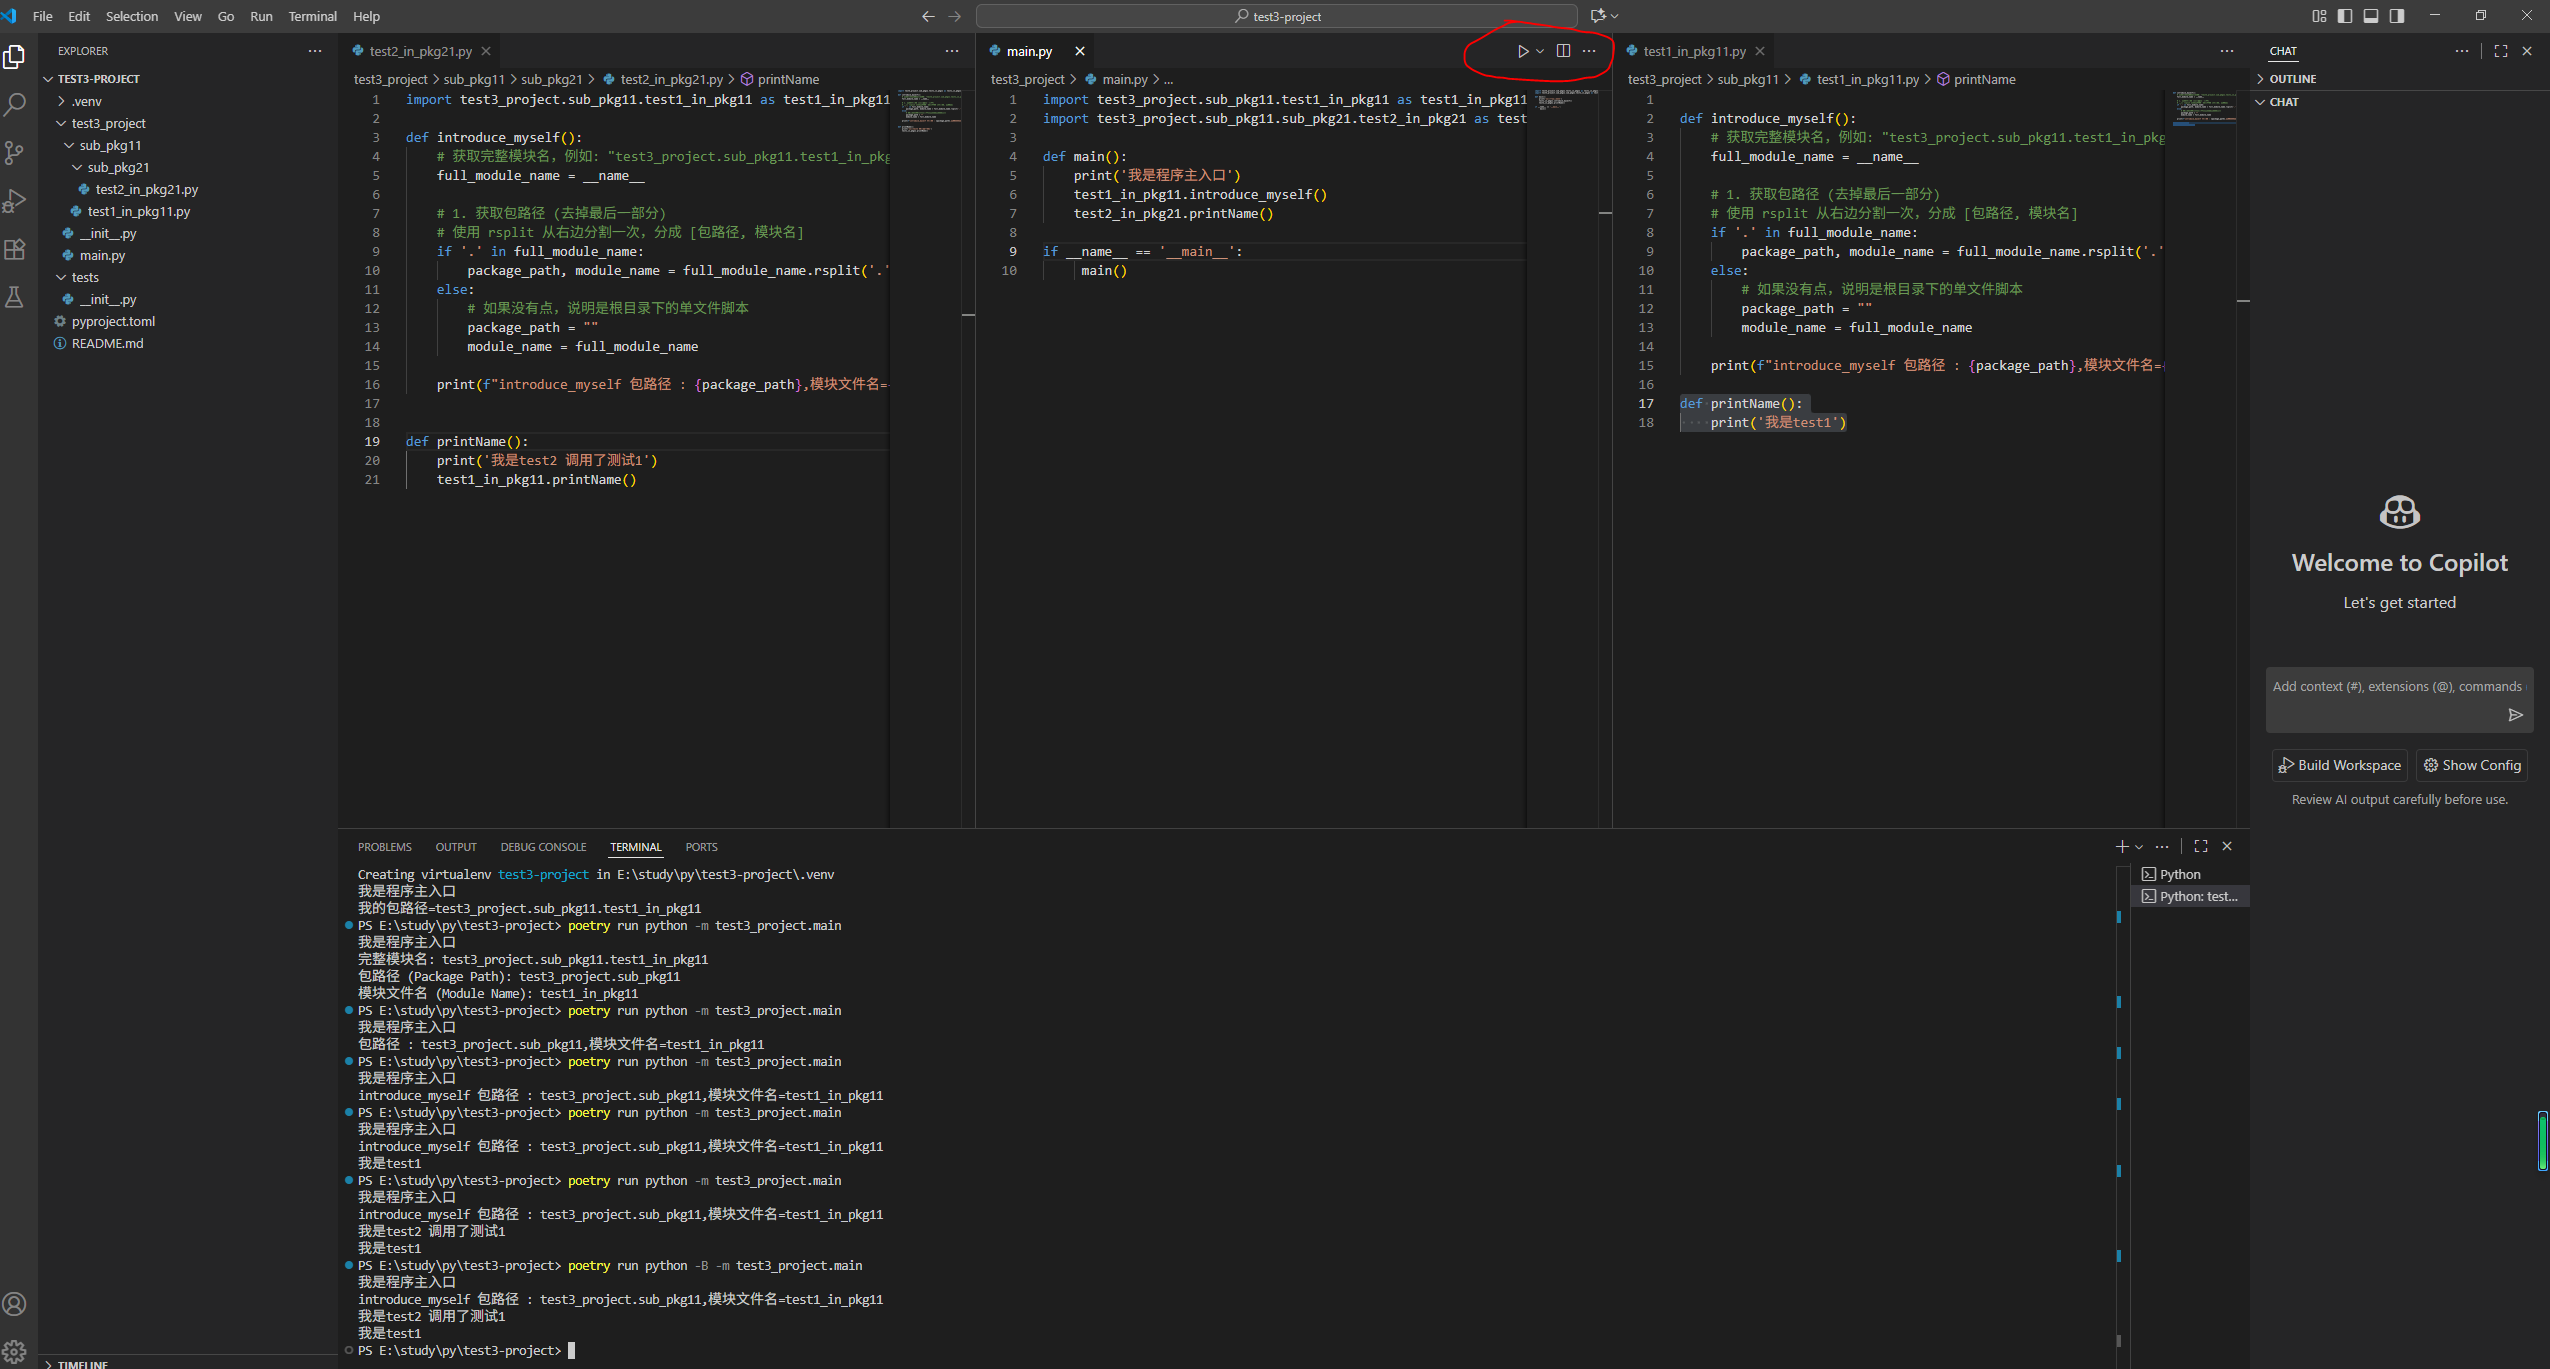
工程结构(正常情况如果,不嫌弃难看,每个文件夹下都要包含__init__)
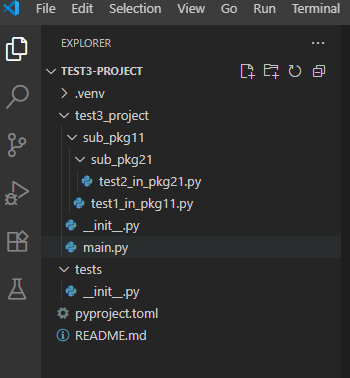
一个应用程序一般只有一个入口,Django外面单独搞出来一个管理脚本,是有些难看。所以这个python规范是做的差。
main.py
import test3_project.sub_pkg11.test1_in_pkg11 as test1_in_pkg11
import test3_project.sub_pkg11.sub_pkg21.test2_in_pkg21 as test2_in_pkg21

def main():
    print('我是程序主入口')
    #测试调用子包方法
    test1_in_pkg11.introduce_myself()
    #测试调用子包方法,子包方法又调用包方法
    test2_in_pkg21.printName()

if __name__ == '__main__':
     main()
test1_in_pkg11.py
def introduce_myself():
    # 获取完整模块名,例如: "test3_project.sub_pkg11.test1_in_pkg11"
    full_module_name = __name__

    # 1. 获取包路径 (去掉最后一部分)
    # 使用 rsplit 从右边分割一次,分成 [包路径, 模块名]
    if '.' in full_module_name:
        package_path, module_name = full_module_name.rsplit('.', 1)
    else:
        # 如果没有点,说明是根目录下的单文件脚本
        package_path = ""
        module_name = full_module_name

    print(f"introduce_myself 包路径 : {package_path},模块文件名={module_name}") # 输出: test3_project.sub_pkg11

def printName():
    print('我是test1')
test2_in_pkg21.py
import test3_project.sub_pkg11.test1_in_pkg11 as test1_in_pkg11

def introduce_myself():
    # 获取完整模块名,例如: "test3_project.sub_pkg11.test1_in_pkg11"
    full_module_name = __name__

    # 1. 获取包路径 (去掉最后一部分)
    # 使用 rsplit 从右边分割一次,分成 [包路径, 模块名]
    if '.' in full_module_name:
        package_path, module_name = full_module_name.rsplit('.', 1)
    else:
        # 如果没有点,说明是根目录下的单文件脚本
        package_path = ""
        module_name = full_module_name

    print(f"introduce_myself 包路径 : {package_path},模块文件名={module_name}") # 输出: test3_project.sub_pkg11


def printName():
    print('我是test2 调用了测试1')
    #调用上层包方法
    test1_in_pkg11.printName()
7.4.2 运行
在上一步介绍中,红线标注的下拉框可以运行python文件,是以脚本方式运行。所以并不满足需求,需要打开终端在项目test3-project目录想执行命令运行:
命令:poetry run python -B -m test3_project.main

输出:

我是程序主入口
introduce_myself 包路径 : test3_project.sub_pkg11,模块文件名=test1_in_pkg11
我是test2 调用了测试1
我是test1
和预期一致,必须加-m参数,pyhon才会把文件当模块处理。
7.4.3 调试
vscode支持调试,在下图中搞个调试配置即可
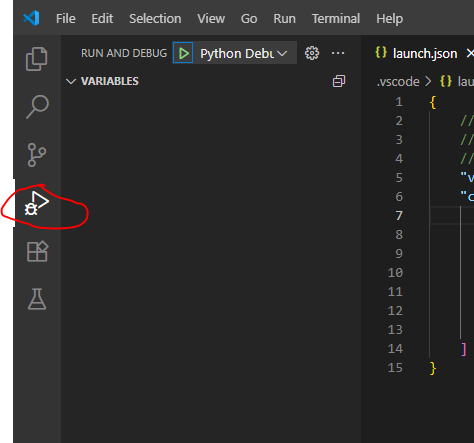
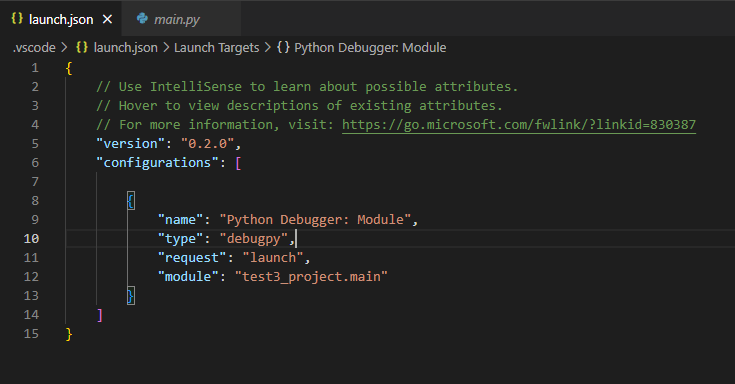
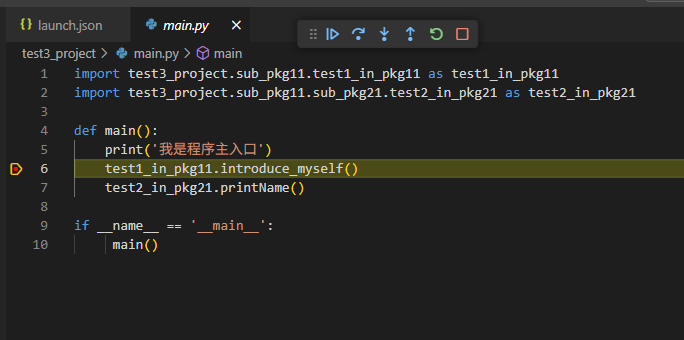
看这玩意就出来了,前期可以手动点击,后面还是需要设置快捷键,方便一些。如果是嵌套结构(有src),调试配置要加如下配置。不然就找不到模块,有点麻烦。
"cwd": "${workspaceFolder}",
"env": {
     "PYTHONPATH": "${workspaceFolder}/src${pathSeparator}${env:PYTHONPATH}"
}
7.4.4 单元测试
poetry add --group dev pytest 安装开发测试依赖
在tests创建测试文件,文件以test_开头或者_test结尾,测试方法以test_开头
然后执行poetry run pytest就会自动执行测试脚本。
嵌套结构需要先poetry install
7.5 打包与发布
7.5.1 python文件的运行
Python 采用的是 “先编译成字节码,再解释执行” 的流程
Python 代码的执行可以分为两个清晰的阶段:
编译阶段:源码 → 字节码
当你运行一个 Python 脚本(例如 python script.py)时,Python 解释器(以最常用的 CPython 为例)并不会直接执行你的源代码。首先,它会将人类可读的 .py 源代码文件,通过词法分析和语法分析,编译成一种平台无关的、低级的中间形式——字节码(Bytecode)。
字节码是一种 Python 虚拟机能够理解的指令集,它比源代码更接近机器码,但还不是 CPU 可以直接执行的二进制码。为了优化性能,编译生成的字节码通常会被缓存在 __pycache__ 目录下的 .pyc 文件中。下次再运行同一个模块时,如果源码没有改动,解释器就会直接加载这个 .pyc 文件,跳过编译步骤,从而加快启动速度。
解释执行阶段:字节码 → 机器码
编译完成后,Python 虚拟机(PVM)会介入。
PVM 是一个用 C 语言实现的循环解释器,它负责逐条读取并解释执行上一步生成的字节码指令。
在解释执行的过程中,字节码指令最终会被转换成当前计算机 CPU 能够理解的机器码并运行。
尽管存在编译步骤,但 Python 仍然被广泛归类为“解释型语言”,主要原因如下:
- 对用户透明:整个“编译成字节码”的过程是自动且隐式的,开发者通常无需像使用 C/C++ 那样手动执行编译命令。你只需要写代码,然后直接运行。
- 最终执行方式:程序的最终执行是由 PVM 解释字节码完成的,而不是提前编译成一个独立的可执行文件。
- 动态特性:Python 支持在运行时动态地执行代码(如
eval()和exec()函数),这是解释型语言的典型特征。
与 Java 的对比
| 特性 | Python (CPython) | Java |
|---|---|---|
| 编译时机 | 运行时按需自动编译 | 运行前手动编译 (javac) |
| 字节码文件 | .pyc (可选,用于缓存加速) | .class (必须,是交付物) |
| 执行方式 | 纯解释执行 | 解释 + 即时编译 (JIT) |
7.5.2 wheel格式文件
你可以把它通俗地理解为 Python 的 “安装包” 或 “压缩包”。它的核心目的是为了让 Python 库的安装变得更快、更简单,避免用户在安装时进行复杂的编译过程。在 Wheel 出现之前,Python 包通常以源码形式(.tar.gz)分发。当你安装这些源码包时,电脑需要先编译代码(特别是包含 C/C++ 扩展的库,如 NumPy、Pandas),这需要安装编译器(如 GCC)和相关依赖,过程慢且容易报错。Wheel 文件解决了这个问题:
🚀 极速安装:Wheel 文件包含了预编译好的二进制文件。安装时,pip 只需要把文件解压并复制到你的 Python 目录中,无需编译,速度极快。
✅ 避免环境报错:你不需要在电脑上安装 C 编译器或开发库,就能安装那些复杂的科学计算库。
📦 离线安装:你可以下载好 .whl 文件,拷贝到没有网络的服务器上进行安装。
🔒 一致性:保证了在不同机器上安装的结果是完全一致的。
. 文件名解读(
Wheel 文件的命名非常严格,包含了很多元数据。
格式: {包名}-{版本}-{Python版本}-{ABI}-{平台}.whl
举个例子:
numpy-1.24.3-cp310-cp310-win_amd64.whl
| 部分 | 含义 | 示例解读 |
|---|---|---|
| 包名 | 库的名字 | numpy |
| 版本 | 库的版本号 | 1.24.3 |
| Python 标签 | 支持的 Python 版本 | cp310 代表 CPython 3.10 |
| ABI 标签 | 应用二进制接口 | cp310 代表依赖特定 ABI |
| 平台标签 | 支持的操作系统 | win_amd64 代表 64位 Windows |
你看到的 .whl 文件是一个纯 Python 包,它的文件名中的 py3-none-any 已经揭示了这一点:
py3:表示它只兼容 Python 3。none:表示它不包含任何特定的 C/C++ 编译代码。any:表示它可以在任何操作系统上运行。
7.5.3 构建与发布
poetry build命令能构建项目,默认会在项目路径dist目录下生成.tar.gz 和wheel文件。该文件就可以作为发布包给其他应用本地安装使用,或者使用poetry publish推送到仓库。.tar.gz安装实际上是先编译成wheel文件
执行poetry build就会出现,打包。在dist目录下生成文件。
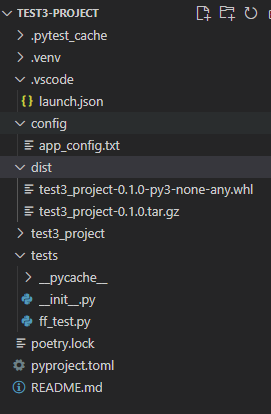
两个包都是python源码包,没有编译,也不带缓存的字节码。
config配置文件夹,可以调整一下放到test3_config目录下(注意空文件夹不会被打包),这里建议放在test3_project的原因是防止冲突。
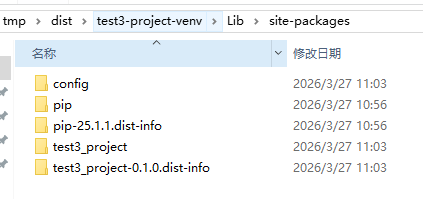
config在外面有可能会和pip安装时产生的文件夹冲突。也可以减少下面两项配置
#要包含的文件
[[tool.poetry.include]]
path = "config"
format = "wheel" # 明确指定包含在 wheel 中

[[tool.poetry.include]]
path = "config"
format = "sdist" # 明确指定包含在 sdist 中
也可以放一个独立的不可能重名文件夹在外面做隔离,防止动到python代码。
7.6 安装与运行
这个玩意不像java,只要安装了jdk,打一个完整的包上去就直接运行。这破玩意不行。你在不同系统上的依赖库和解释器不具有可移植性,所以你不要想把你的工程和虚拟环境复制过去,除非时完全一样的系统和版本。所以安装方法是重新安装依赖。
7.6.1 复制包
复制包(test3_project-0.1.0.tar.gz)到指定的安装目录,比如 E:/opt/app/python
7.6.2 创建虚拟环境
命令:python -m venv test3-project-venv
一次创建,后续发布可以继续使用,这里要
7.6.3 激活与检查
激活:test4-project-venv\Scripts\activate
验证(windows):
echo $env:VIRTUAL_ENV 或者cmd echo %VIRTUAL_ENV%
where.exe python 或者cmd echo where python
7.6.4 安装
pip install test4_project-0.1.0.tar.gz
删除test4_project-0.1.0.tar.gz
部署后项目结构类似如下
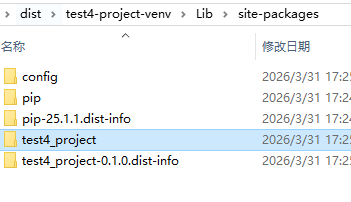
你看,config跑到test4_project外面去了,会和pip的一些东西混在一起,所以如果使用pip安装的东西最好都挡在test_project目录下。这个结构有点不太好维护。这种方式更像一种库,不像应用程序部署方式,应用程序部署不适合用这种目录结构。
pip重新安装的时候如果你把config目录改名字成了conf,以前的目录还是在,看起比较混乱,其他pip这些是不能删除的,不然pip要运行报错。所以你想粗暴的删除site-package不太可行。实在不行,你只有删除虚拟环境重新创建。至于重新安装不删除虚拟环境会不会引发一些其他问题,这个就需要自己验证了。如果每次发布都删除虚拟环境,重新下载安装是最可靠的,就是可能发布时间会变得很长。
7.6.5 检查与运行
如果没有报错,就会在test3-project-venv\Lib\site-packages\test3_project 目录下找到安装的项目。
运行:python -m test3_project.main
7.6.6 源码发布
pip把程序包也安装到sitepache下,这种方式更像发布依赖包。我觉得IDE里面的目录结构就不错。调整一下变成类似如下模板
  test4_project-0.1.0
    ├─config  配置
    └─test3_project 顶层包
	└─.venv 相当于lib
	└─bin  脚本一般用于控制程序启动停,检查状态等或者是启动的exe文件
	└─data 程序需要的一些本地数据
    └─tests 这个目录生产不需要,但是也没啥影响
	└─log  日志目录,这个一般放到其他磁盘分区
  test4_project-0.1.0
    ├─config  配置
    └─src/test3_project 顶层包
	└─.venv 相当于lib
	└─bin  脚本一般用于控制程序启动停,检查状态等或者是启动的exe文件
	└─data 程序需要的一些本地数据
    └─tests 这个目录生产不需要,但是也没啥影响
	└─log  日志目录,这个一般放到其他磁盘分区
上面这个目录结构基本就完美了,很多绿色安装软件基本都是这样,解压即可用(比如kafka,flink.eclipse)。应用程序发布直接使用源码发布就行。poetry安装依赖时只安装生产需要的就行,即使全部安装,其实也不会有啥问题,可能就是稍微慢点。
第一种结构pip安装目录不会发生变化,但是第二种如果使用pip安装会去掉src,这个要注意。如果使用pip安装,建议将文件都放在test3_project下,不然文件在IDE和打包后路径不一致,容易出错。
7.7 PyInstaller
是 Python 生态中最流行的打包工具之一,它的核心作用是将 Python 脚本及其依赖项(如第三方库、资源文件、甚至 Python 解释器本身)打包成一个独立的可执行文件(Windows 下是 .exe,macOS 下是 .app 或二进制文件)
7.7.1 安装
pip install pyinstaller7.7.2 打包命令
假设你有一个 main.py,在命令行进入该文件所在目录,执行
pyinstaller main.py打包完成后,你主要关注以下两个:
dist/:这是最终结果。里面包含你的.exe文件,发给别人就是发这个文件夹里的内容。build/:打包过程中的临时文件,打包成功后可以删除。.spec:配置文件。如果你需要非常复杂的打包设置(如包含多个数据文件、版本信息等),可以直接编辑这个文件,然后通过pyinstaller yourscript.spec来打包。
7.7.3 参数详解
| 参数 | 作用 | 示例/说明 |
|---|---|---|
-F 或 --onefile | 打包成单个 exe 文件 | 最常用的参数,方便分发,但启动速度稍慢(因为需要解压到临时目录)。 |
-w 或 --windowed | 隐藏控制台黑窗口 | 写 GUI 程序(如 Tkinter, PyQt)时必用,否则运行时会多出一个黑色的 cmd 窗口。 |
-i 或 --icon | 自定义图标 | 需准备 .ico (Windows) 或 .icns (Mac) 格式。例如:-i myicon.ico。 |
-n 或 --name | 指定生成的文件名 | 默认与脚本名一致,可用此参数重命名,如 -n MyTool。 |
--add-data | 包含外部数据文件 | 打包图片、配置文件等。Windows 用 ; 分隔路径,Mac/Linux 用 : 分隔。 |
一个标准的“黄金组合”命令:
# 打包成单文件、隐藏控制台、使用自定义图标
pyinstaller -F -w -i app.ico main.py
7.7.4 问题
1. 资源文件找不到?
相对导入出现文件找不到,使用写代码方式获取
2. 打包体积过大?
默认情况下,PyInstaller 会把所有依赖都打包进去,导致文件很大(比如一个简单的 Tkinter 程序可能也有几十 MB)。
虚拟环境打包: 建议创建一个干净的虚拟环境,只安装项目必需的库,然后在该环境中运行 PyInstaller。
排除模块: 使用 --exclude-module 参数剔除不需要的库(如 matplotlib 或 tkinter 如果你没用到)。
3. 缺少隐藏导入(Hidden Import)
有些库(如 pandas, numpy 的某些子模块)是动态加载的,PyInstaller 可能检测不到,导致运行时报错 ModuleNotFoundError。解决方案: 使用 --hidden-import 参数手动指定:
pyinstaller -F main.py --hidden-import=pandas._libs.tslibs.base
7.8 多环境
多环境支持也垃圾,在项目根目录下方式一个.env文件,然后还需要写一个动态配置类
# config.py
import os
from functools import lru_cache
from pydantic_settings import BaseSettings, SettingsConfigDict
from pydantic import Field, field_validator

class Settings(BaseSettings):
    app_name: str = "MyApp"
    debug: bool = False

    # 移除 alias,自动匹配 APP_DB_HOST
    db_host: str = "localhost"
    db_port: int = 5432
    redis_url: str | None = None
    time_out: str = "localhost"

    model_config = SettingsConfigDict(
        env_file=".env" if os.getenv("APP_ENV") != "prod" else None,
        env_prefix="APP_",
        case_sensitive=False,
        extra="allow",
    )

    @field_validator("db_port")
    @classmethod
    def validate_port(cls, v: int) -> int:
        if not (1 <= v <= 65535):
            raise ValueError(f"非法端口号: {v}")
        return v

@lru_cache
def get_settings() -> Settings:
    return Settings()
可以写多个配置文件,然后启动时设置环境变量,这种模式有点像springboot的多环境做法,最大的问题时成品包会存在多个配置文件。为了干净,使用一个最好。
7.9 总结
python目前研究来看,是很难工程化的,主要有以下几点:
1 python 兼容性差
python2 到python3 可以自己对比看看
2 语法诡异,自由放荡
喜欢用简单灵活做营销策略,一旦要上生产做服务,还有一大堆问题等着解决
3 工程结构难以统一
前面两种结构推荐的是src结构,实际上没有src的也很多。而且很多框架有自己创建项目的工具,搞出来五花八门。
4 依赖管理工具混乱
大多还是用pip安装依赖,除了poetry ,uv 等工具能安装依赖和管理项目。但是可能还是会遇到一些奇葩的场景,比喻qt商业版安装用qtpip,如果你的项目是用poetry 管理,这里估计会出现问题。
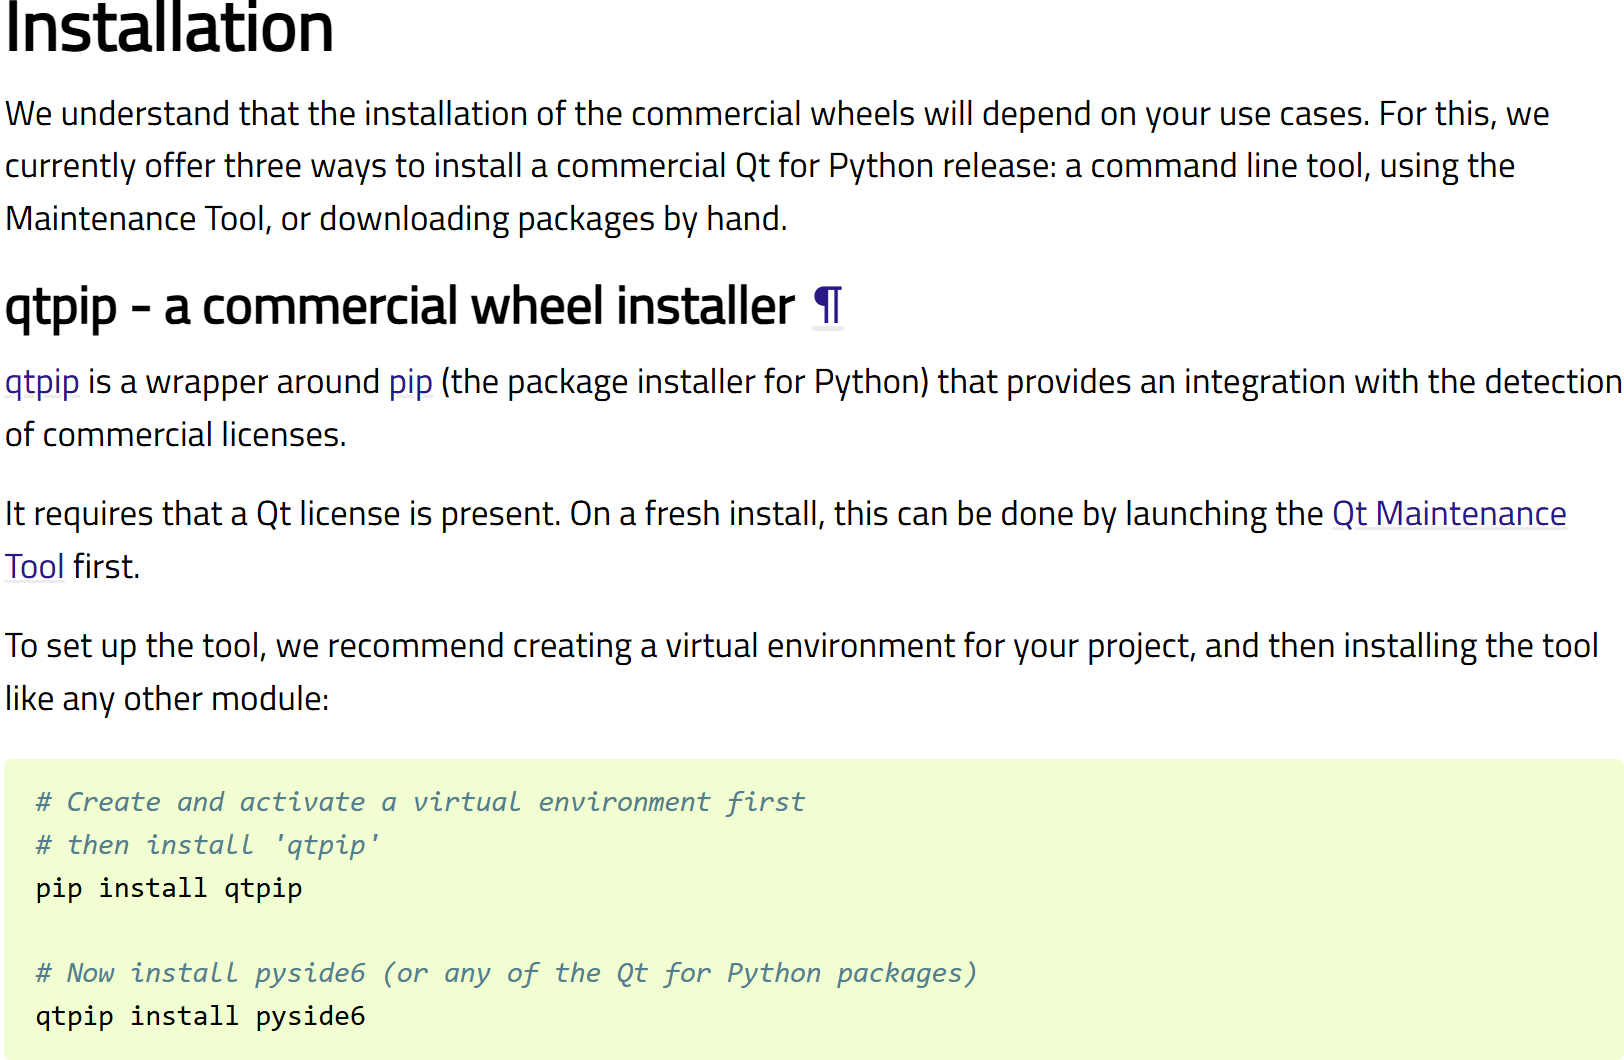
5 类型提示
并不是真正强类型
6 面向对象
权限控制、动态属性绑定等会破坏面向对象封装性和可维护性等
7 喜欢玩魔法
这点就是有点无耻玩法
8 仓库ssh认证
当连接的仓库需要不同的ssh认证是,就涉及多个ssh认证key的生成,比如gitee和github
8.1 生成认证文件
参考命令
ssh-keygen -t rsa -f ~/.ssh/gitee_xx -C "gitee_xx"
ssh-keygen -t rsa -f ~/.ssh/github_xx -C "github_xx"
8.2 配置
# 示例:~/.ssh/config 文件内容
Host gitee.com
    HostName gitee.com
    User git
    IdentityFile ~/.ssh/gitee_xx

Host github.com
    HostName github.com
    User git
    IdentityFile ~/.ssh/github_xx
8.3 在服务配置pub文件内容
复制到gitee或者github个人中心认证配置的地方即可
# config.py
import os
from functools import lru_cache
from pydantic_settings import BaseSettings, SettingsConfigDict
from pydantic import Field, field_validator

class Settings(BaseSettings):
    app_name: str = "MyApp"
    debug: bool = False

    # 移除 alias,自动匹配 APP_DB_HOST
    db_host: str = "localhost"
    db_port: int = 5432
    redis_url: str | None = None
    time_out: str = "localhost"

    model_config = SettingsConfigDict(
        env_file=".env" if os.getenv("APP_ENV") != "prod" else None,
        env_prefix="APP_",
        case_sensitive=False,
        extra="allow",
    )

    @field_validator("db_port")
    @classmethod
    def validate_port(cls, v: int) -> int:
        if not (1 <= v <= 65535):
            raise ValueError(f"非法端口号: {v}")
        return v

@lru_cache
def get_settings() -> Settings:
    return Settings()
8.4 克隆项目
选择ssh协议克隆就行
9 uv工具
uv 和 poetry 都是现代 Python 项目中用于依赖管理和项目构建的工具,但它们在性能、功能范围和设计理念上有着显著的差异。uv 底层是用 Rust 开发的,但作为用户,你只需要运行上述安装命令即可直接使用,完全无需关心 Rust 环境的配置。以下是两者的详细对比:
9.1 性能对比
uv 的核心优势在于极致的速度。
- 执行效率:
uv基于 Rust 编写,其依赖解析和包安装速度比poetry快 10-100 倍。例如,在安装包含 100 个依赖的大型项目时,uv可能仅需几秒,而poetry可能需要数十秒甚至更久。 - 解析算法:
uv采用了基于 PubGrub 的确定性解析算法,并配合并行下载与全局缓存优化,极大地减少了“依赖地狱”带来的等待时间。相比之下,poetry的依赖解析器(尤其是处理复杂冲突时)常被视为性能瓶颈,尽管可以通过配置镜像源或启用并行安装进行优化,但底层速度仍不及uv。
9.2 功能范围对比
uv 旨在成为一体化的工具链,而 poetry 更专注于依赖管理与打包分发。
表格
| 功能维度 | uv | poetry |
|---|---|---|
| 包管理 | ✅ 支持 (uv add/pip install) | ✅ 支持 (poetry add) |
| 虚拟环境 | ✅ 内置管理 (uv venv) | ✅ 内置管理 |
| Python 版本管理 | ✅ 内置 (uv python install),可自动下载和管理多版本 Python | ❌ 不支持,需配合 pyenv 等外部工具使用 |
| 依赖锁定 | ✅ 生成 uv.lock,确保跨平台一致性 | ✅ 生成 poetry.lock,确保环境复现 |
| 打包与发布 | ⚠️ 支持基础构建,但生态仍在成长 | ✅ 成熟,内置 poetry build/publish,适合库开发者 |
| 脚本运行 | ✅ 支持 PEP 723 内联依赖脚本 (uv run script.py) | ❌ 无原生支持 |
| 全局工具 | ✅ 替代 pipx (uv tool install) | ❌ 无原生支持 |
- 一体化 vs 专业化:
uv试图取代pip、venv、pyenv和pip-tools等多个工具,提供从 Python 安装到项目运行的全流程管理。poetry则主要解决setup.py+requirements.txt的混乱问题,专注于通过pyproject.toml统一管理元数据和依赖,并在库的打包发布方面更为成熟。
uv这个值得研究一下。python工程化体系到目前来看还是比较乱,工具不好选。
总结
这只是我个人的实践总结,仅供参考,技术在进步,后面可能还有更好的方法。就目前来讲,python工程化能力相当弱,上面只是一个可落地方案,不过于依赖,后期可能不太好维护。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)