基于Python+爬虫的网络小说热度可视化分析系统设计与实现
💗博主介绍:✌全网粉丝20W+,CSDN全栈领域优质创作者,博客之星、掘金/华为云/阿里云等平台优质作者,计算机毕设实战导师。目前专注于大学生项目实战开发,讲解,毕业答疑辅导,欢迎高校老师/同行前辈交流合作✌
💗主要服务内容:免费功能设计、选题定题、开题报告、任务书、程序开发、论文编写和辅导、论文降重、程序讲解、答辩辅导等,欢迎咨询~
👇🏻 精彩专栏 推荐订阅👇🏻
计算机毕业设计精品项目案例(持续更新,值得收藏!)✅
2025-2026年计算机毕业设计选题推荐:计算机专业毕业设计题目大全✅
全网最全计算机毕业设计选题推荐:计算机毕设选题指导及避坑指南✅
🌟文末获取源码+数据库+文档🌟
感兴趣的可以先收藏起来,还有大家在毕设选题,项目以及论文编写等相关问题都可以和学长沟通,希望帮助更多的人
一.前言
在数字化信息飞速发展的当下,网络文学市场规模不断扩大,网络小说热度分析对于了解读者喜好、优化平台运营具有重要意义。随着互联网技术的持续演进,海量的网络小说数据蕴含着丰富的读者行为和偏好信息,如何从中挖掘有价值的内容成为亟待解决的问题。基于Python爬虫技术,能够高效获取网络小说相关数据,为后续的热度分析提供坚实的数据基础。
本系统基于B/S开发模式,前端采用Vue框架进行页面构建,以实现用户交互的良好体验;后端运用Django框架,确保系统的稳定运行和数据的有效管理。同时,利用Echarts进行数据可视化展示,使分析结果更加直观清晰。在热度分析方面,引入随机森林回归算法,对网络小说的热度进行精准预测。系统具备丰富的管理功能,管理员可对用户信息进行管理,包括用户的注册、登录、权限设置等;对小说信息进行全面管理,涵盖小说的基本信息录入、更新等;针对言情小说这一特定类型进行精细化管理;还能够基于算法对小说的阅读情况进行预测,从而为平台的运营决策提供有力支持。该系统的开发和应用,有助于提升网络小说平台的运营效率,为作者、读者和平台管理者提供有价值的参考,促进网络文学行业的健康发展,具有重要的理论和实践意义。
二.技术环境
开发语言:Python
Python框架:Django
数据库:mysql 5.7或更高版本
数据库工具:Navicat11
爬虫框架:Scrapy
开发软件:Pycharm
前端框架:vue.js
可视化技术:Echarts
三.功能设计
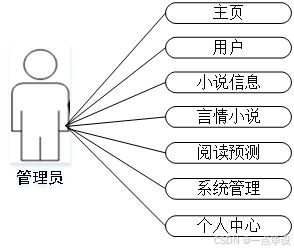
管理员端的功能主要是为系统管理人员设计的,使他们能够全面管理用户、小说信息、言情小说、阅读预测、系统管理、个人中心等操作。通过这些功能,管理员可以清晰地了解并掌控系统的整体运行情况。管理员用例分析图,如图所示。
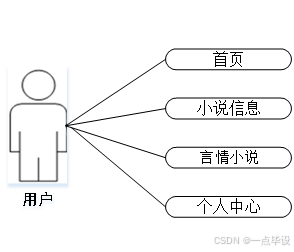
用户的功能主要集中在个人账号管理以及信息查询方面。具体而言,用户可以更新和管理自己的账号及密码,同时能够在首页、小说信息、言情小说、个人中心查询并获取相关详情。这些功能旨在为用户提供便捷的个人信息管理途径和丰富的信息查询服务。用户用例分析图,如图所示。
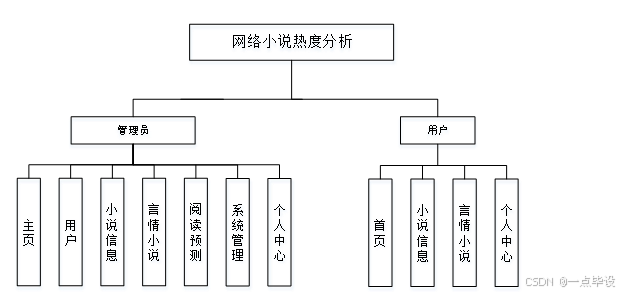
网络小说热度可视化分析系统的功能模块图,系统主要分为管理员和用户两大角色模块。这种划分有助于实现不同权限的功能隔离,保障系统有序运行。管理员功能模块主页系统操作入口,可快速访问常用功能。用户管理对系统用户信息进行增删改查,保障用户数据准确、安全。小说信息管理负责录入、更新、审核小说基础信息,确保数据及时、准确。言情小说管理聚焦言情类小说,进行专项管理与分析。阅读预测利用算法对小说阅读热度等进行预测,辅助决策。系统管理涵盖系统参数设置、权限分配等,保障系统稳定运行。个人中心用于管理员个人信息维护、密码修改等。用户功能模块主页展示热门小说等信息,方便用户快速浏览。小说信息查询用户可搜索、查看小说详情,获取阅读指引。言情小说浏览为喜爱言情类小说的用户提供专门浏览入口。个人中心:方便用户管理个人资料、收藏记录等,如图所示。
四.数据设计
系统需要数据库存储系统中的信息,MySQL数据库能够处理系统的信息,当考研信息爬虫与分析需要数据的时候,MySQL数据库能够取得数据交给服务端处理。MySQL数据库能够使用可视化软件操作,管理员可以在可视化软件对数据库的信息管理。
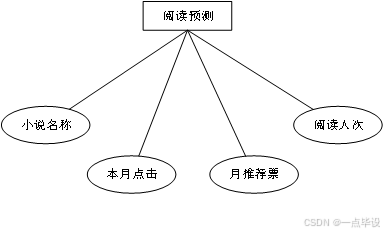
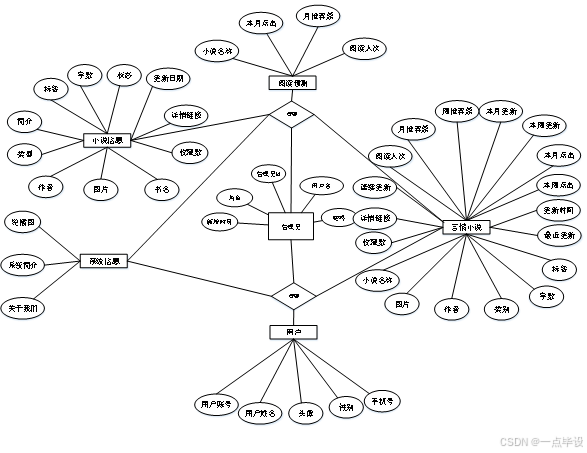
系统数据层设计包括了E-R设计,系统数据实体的设计依赖于E-R的分析和设计,通过E-R能够得到数据库表的设计,E-R能够描述系统所涉及到的实体,还能够描述系统中不同实体的联系和关系。系统部分实体E-R图如下所示:
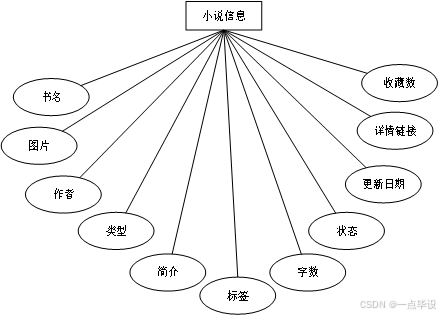
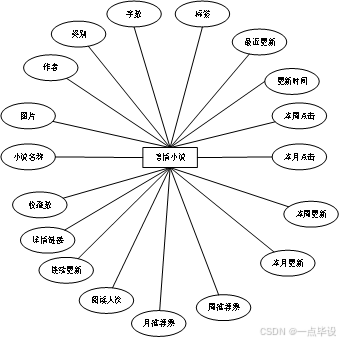
系统总体E-R图如下所示:
五.部分效果展示
5.1前台用户功能实现效果
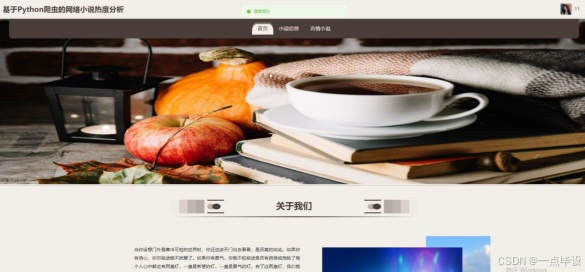
当访客浏览至系统的网址时,首先映入眼帘的便是首页界面。在这个页面上,访客可以清晰地看到网络小说热度分析的导航栏,其中包括首页、小说信息、言情小说、个人中心等多个板块。系统首页界面如图所示:
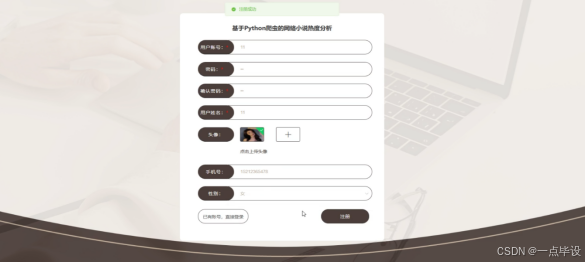
在注册流程中,用户在Vue前端填写必要信息(如用户名、密码等)并提交。前端将这些信息通过HTTP请求发送到Python后端。后端处理这些信息,检查用户名是否唯一,并将新用户数据存入MySQL数据库。完成后,后端向前端发送注册成功的确认,前端随后通知用户完成注册。这个过程实现了新用户的数据收集、验证和存储。如图所示。
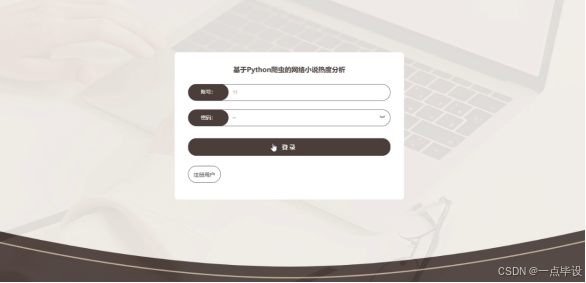
在登录流程中,用户首先在Vue前端界面输入用户名和密码。这些信息通过HTTP请求发送到Python后端。后端接收请求,通过与MySQL数据库交互验证用户凭证。如果认证成功,后端会返回给前端,允许用户访问系统。这个过程涵盖了从用户输入到系统验证和响应的全过程。如图所示。
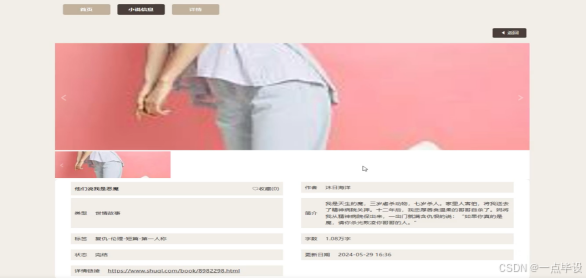
用户点击以小说信息页面,随后在该页面的搜索框中输入书名、图片、作者、类型等关键词进行查询,查询结果展示包括书名、图片、作者、类型、简介、标签、字数、状态、更新日期、详情链接等信息。还可以点击收藏等操作;如图所示。
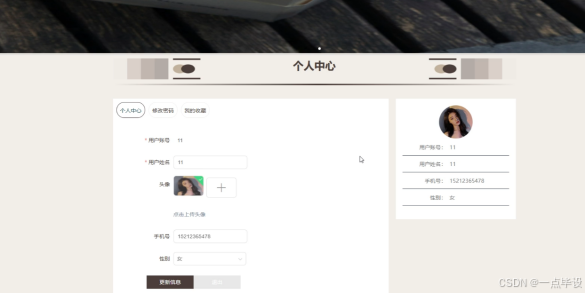
用户点击个人中心,在个人中心页面填写详细信息,进行更新信息操作,还可以对修改密码、我的收藏等进行详情操作,如图所示。
5.2后台管理员功能实现效果
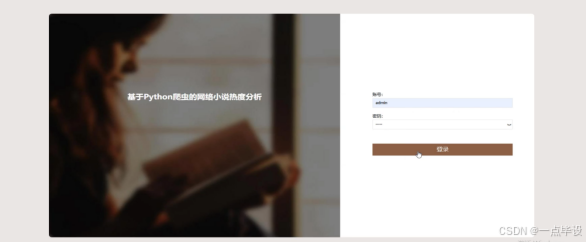
管理员需通过登录页面,输入其用户名和密码等认证信息,以完成登录操作,如图所示。
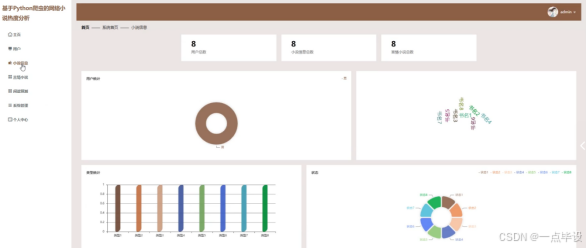
管理员成功登录网络小说热度分析后,可以访问用户、小说信息、言情小说、阅读预测、系统管理、个人中心等多个功能模块进行细致的操作与管理,如图所示。
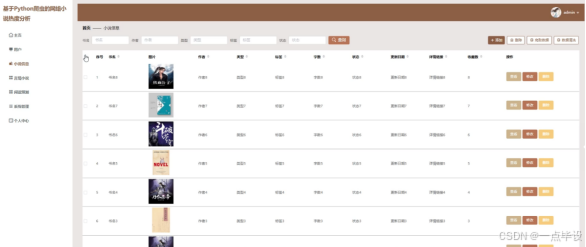
管理员点击小说信息功能后,会进入小说信息管理页面。在这个页面上,管理员可以根据书名、作者、类型、标签、状态等信息,进行查询、添加、爬虫数据、数据清洗或者删除等操作;如图所示。
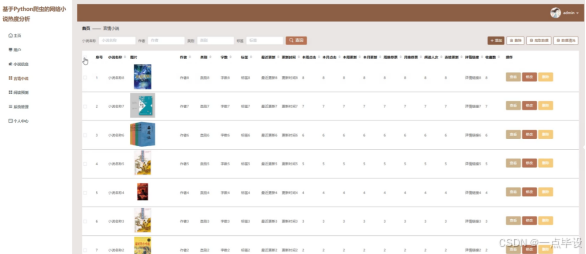
管理员点击言情小说功能后,会进入言情小说管理页面。在这个页面上,管理员可以根据小说名称、作者、类型、标签等信息,进行查询、添加、爬虫数据、数据清洗或者删除等操作;如图所示。
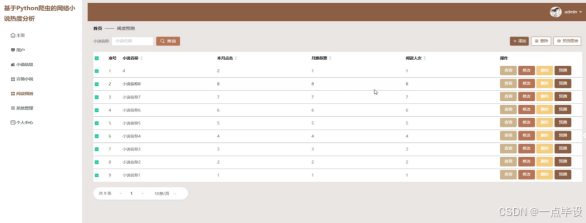
管理员点击阅读预测功能后,会进入阅读预测管理页面。在这个页面上,管理员可以根据小说名称等信息,进行查询、添加、预测图片或者删除等操作;如图所示。
5.3可视化大屏展示功能实现效果
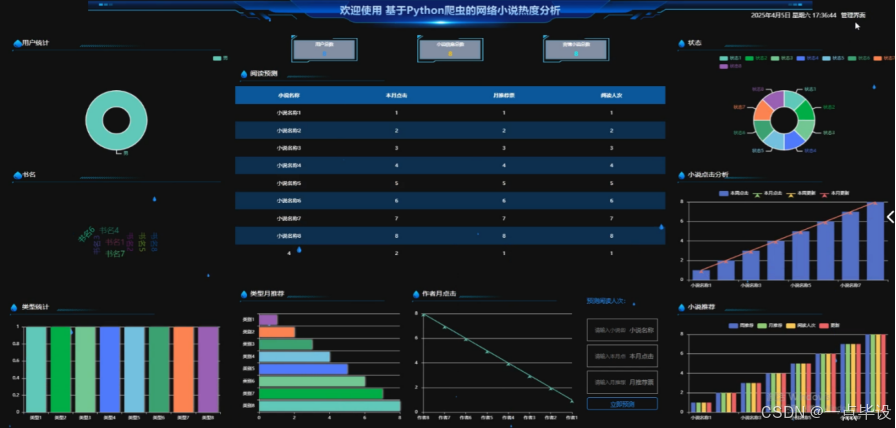
基于Python爬虫的网络小说热度分析看板展示明确系统功能。同时,还显示着当前时间,增强系统的实时性与交互性。环形图表,可能用于展示不同类型网络小说在整体热度中的占比情况,通过不同颜色区分类别,直观呈现各类型的热度份额。多组横向条形图,大概率是展示不同网络小说的热度排名。条形长度对应热度数值,读者可借此快速了解热门小说排序。饼状图表,或为分析网络小说热度来源构成,如来自不同平台、不同推广渠道的流量占比。柱状图表,也许是呈现网络小说热度随时间(如日、周、月)的变化趋势,帮助分析热度波动规律。堆叠柱状图,可用来展示不同维度下(如不同年龄、性别读者群体)的热度分布,分析不同群体对小说热度的贡献。折线图,可能用于体现网络小说的阅读量、评论量、收藏量等关键指标随时间的变化走向。或为热度预测相关图表,结合算法预测结果,辅助用户预判小说未来热度趋势。多色柱状图,可能是对比不同作者、不同系列网络小说的热度情况。如图所示。
六.部分功能代码
import scrapy
import pymysql
import pymssql
from ..items import xiangmuItem
import time
import re
import random
import platform
import json
import os
from urllib.parse import urlparse
import requests
import emoji
class xiangmuSpider(scrapy.Spider):
    name = 'xiangmuSpider'
    spiderUrl = 'https://url网址'
    start_urls = spiderUrl.split(";")
    protocol = ''
    hostname = ''

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)


    # 列表解析
    def parse(self, response):

        _url = urlparse(self.spiderUrl)
        self.protocol = _url.scheme
        self.hostname = _url.netloc
        plat = platform.system().lower()
        if plat == 'windows_bak':
            pass
        elif plat == 'linux' or plat == 'windows':
            connect = self.db_connect()
            cursor = connect.cursor()
            if self.table_exists(cursor, 'xiangmu') == 1:
                cursor.close()
                connect.close()
                self.temp_data()
                return

        list = response.css('ul.subject-list li.subject-item')

        for item in list:

            fields = xiangmuItem()


            fields["laiyuan"] = self.remove_html(item.css('div.pic a.nbg::attr(href)').extract_first())
            if fields["laiyuan"].startswith('//'):
                fields["laiyuan"] = self.protocol + ':' + fields["laiyuan"]
            elif fields["laiyuan"].startswith('/'):
                fields["laiyuan"] = self.protocol + '://' + self.hostname + fields["laiyuan"]
            fields["fengmian"] = self.remove_html(item.css('div.pic a.nbg img::attr(src)').extract_first())
            fields["xiaoshuoming"] = self.remove_html(item.css('div.info h2 a::attr(title)').extract_first())

            detailUrlRule = item.css('div.pic a.nbg::attr(href)').extract_first()
            if self.protocol in detailUrlRule:
                pass
            elif detailUrlRule.startswith('//'):
                detailUrlRule = self.protocol + ':' + detailUrlRule
            else:
                detailUrlRule = self.protocol + '://' + self.hostname + detailUrlRule
                fields["laiyuan"] = detailUrlRule

            yield scrapy.Request(url=detailUrlRule, meta={'fields': fields},  callback=self.detail_parse)


    # 详情解析
    def detail_parse(self, response):
        fields = response.meta['fields']

        try:
            if '(.*?)' in '''div#info span a::text''':
                fields["zuozhe"] = re.findall(r'''div#info span a::text''', response.text, re.S)[0].strip()
            else:
                if 'zuozhe' != 'xiangqing' and 'zuozhe' != 'detail' and 'zuozhe' != 'pinglun' and 'zuozhe' != 'zuofa':
                    fields["zuozhe"] = self.remove_html(response.css('''div#info span a::text''').extract_first())
                else:
                    fields["zuozhe"] = emoji.demojize(response.css('''div#info span a::text''').extract_first())
        except:
            pass
 # 去除多余html标签
    def remove_html(self, html):
        if html == None:
            return ''
        pattern = re.compile(r'<[^>]+>', re.S)
        return pattern.sub('', html).strip()

    # 数据库连接
    def db_connect(self):
        type = self.settings.get('TYPE', 'mysql')
        host = self.settings.get('HOST', 'localhost')
        port = int(self.settings.get('PORT', 3306))
        user = self.settings.get('USER', 'root')
        password = self.settings.get('PASSWORD', '123456')

        try:
            database = self.databaseName
        except:
            database = self.settings.get('DATABASE', '')

        if type == 'mysql':
            connect = pymysql.connect(host=host, port=port, db=database, user=user, passwd=password, charset='utf8')
        else:
            connect = pymssql.connect(host=host, user=user, password=password, database=database)

        return connect

    # 断表是否存在
    def table_exists(self, cursor, table_name):
        cursor.execute("show tables;")
        tables = [cursor.fetchall()]
        table_list = re.findall('(\'.*?\')',str(tables))
        table_list = [re.sub("'",'',each) for each in table_list]

        if table_name in table_list:
            return 1
        else:
            return 0
@main_bp.route("/python05c7298x/danchexinxi/save", methods=['POST'])
def python05c7298x_danchexinxi_save():
    '''
    '''
    if request.method == 'POST':
        msg = {"code": normal_code, "msg": "success", "data": {}}
        req_dict = session.get("req_dict")
        if danchexinxi.count(danchexinxi, danchexinxi, {"danchebianhao":req_dict["danchebianhao"]})>0:
            msg['code'] = crud_error_code
            msg['msg'] = "单车编号已存在"
            return jsonify(msg)
        for key in req_dict:
            if req_dict[key] == '':
                req_dict[key] = None
        error= danchexinxi.createbyreq(danchexinxi, danchexinxi, req_dict)
        if error!=None:
            msg['code'] = crud_error_code
            msg['msg'] = error
        return jsonify(msg)
为什么选择我们
大学毕业那年,曾经有幸协助指导老师做过毕业设计课题分类、论文初选(查看论文的格式)、代码刻录等打杂的事情,也帮助过同界N多同学完成过毕业设计工作,毕业后在一家互联网大厂工作8年,先后从事Java前后端开发、系统架构设计等方面的工作,有丰富的编程能力和水平,也在工作之余指导过别人完成过一些毕业设计的工作。2016年至今,团队已指导上万名学生顺利通过毕业答辩,目前是csdn特邀作者、CSDN全栈领域优质创作者,博客之星、掘金/华为云/B站/知乎等平台优质作者,计算机毕设实战导师,专注于大学生项目实战开发,讲解,毕业答疑辅导,欢迎咨询~✌
最后
💕💕
最新计算机毕业设计选题篇-选题推荐
小程序毕业设计精品项目案例-200套
Java毕业设计精品项目案例-200套
Python毕业设计精品项目案例-200套
大数据毕业设计精品项目案例-200套
💟💟如果大家有任何疑虑,欢迎在下方位置详细交流。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献70条内容

所有评论(0)