第4节:向量数据库Milvus实战
·
📚 课程目标
通过本课程的学习,学员将能够:
- 深入理解Milvus向量数据库的架构原理与核心特性
- 掌握向量索引策略与性能优化方法
- 学会向量数据的存储与检索机制
- 具备在生产环境中部署和优化Milvus的能力
🎯 课程大纲
- Milvus向量数据库概述
- 架构原理与核心特性
- 向量索引策略详解
- 数据存储与检索机制
- 性能优化实战
- 部署与运维实践
📖 课程内容
1. Milvus向量数据库概述
Milvus是一个开源的向量数据库,专门设计用于处理大规模向量数据的存储、索引和检索。它支持多种向量索引算法,能够高效处理数十亿级别的向量数据。
1.1 Milvus的核心优势
高性能检索
- 支持毫秒级向量检索
- 可扩展至数十亿向量
- 多种索引算法支持
云原生架构
- 微服务架构设计
- 水平扩展能力
- 容器化部署支持
丰富功能
- 多向量数据类型支持
- 混合检索能力
- 实时数据更新
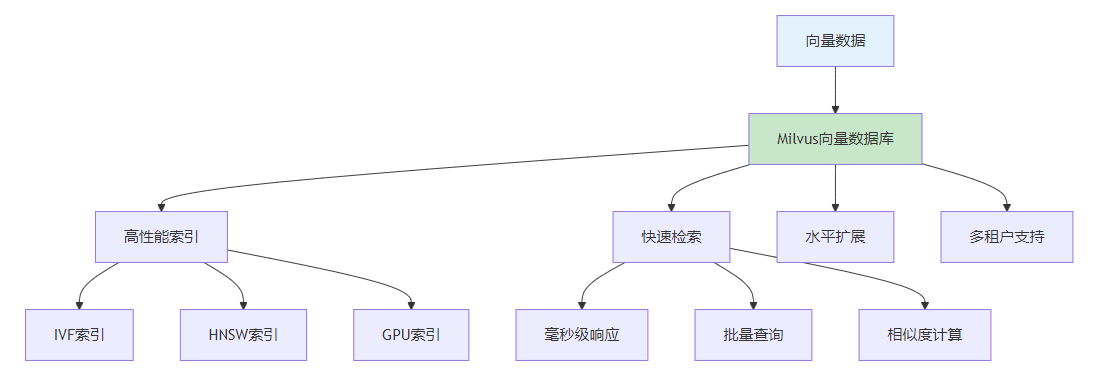
1.2 应用场景
推荐系统
- 用户行为向量化
- 商品相似度计算
- 个性化推荐
搜索引擎
- 语义搜索
- 图像搜索
- 音频搜索
知识库问答
- 文档向量存储
- 语义检索
- RAG系统支持
生物信息学
- 蛋白质序列分析
- 基因相似度计算
- 药物发现
2. 架构原理与核心特性
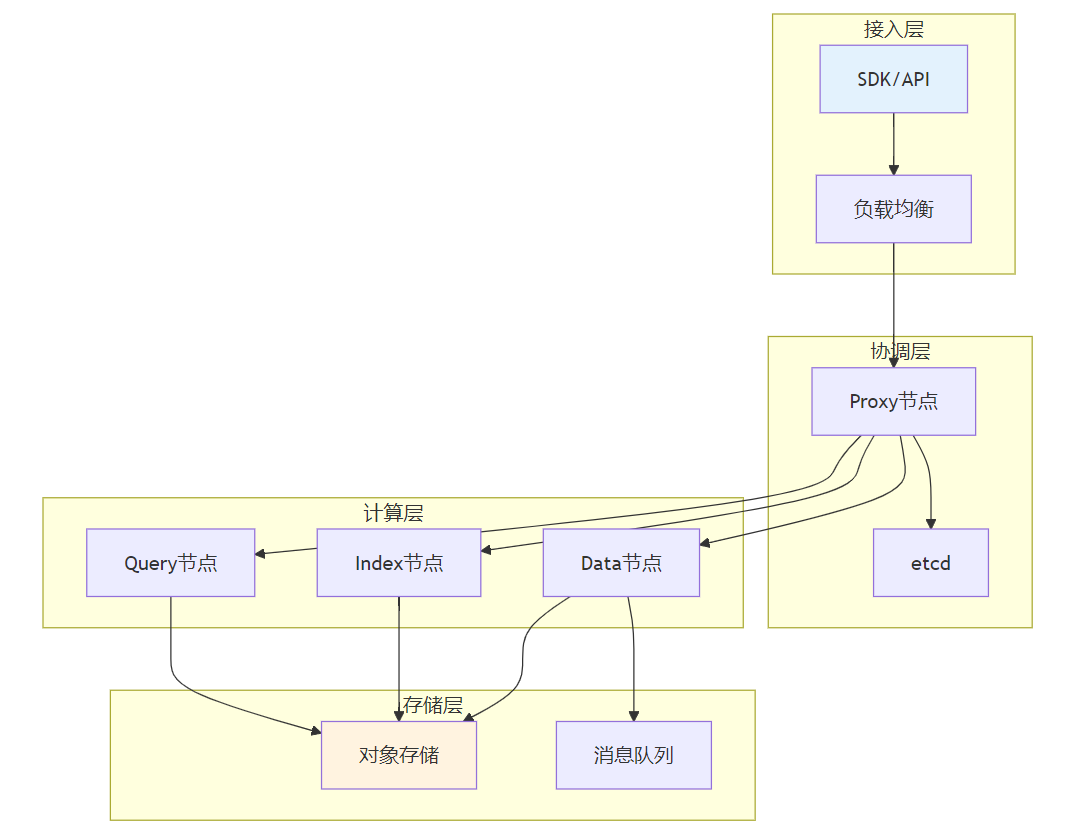
2.1 系统架构
2.2 核心组件
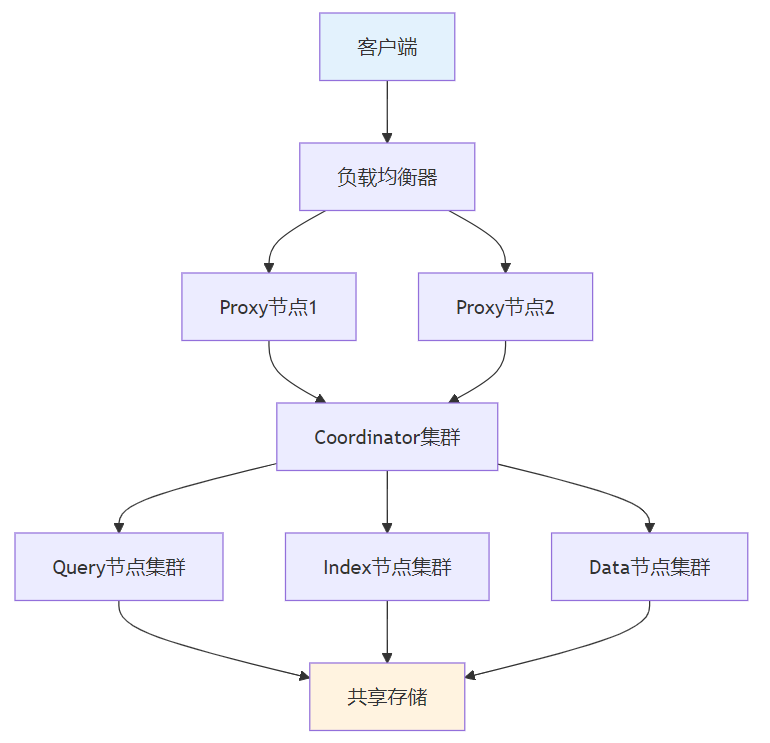
Coordinator(协调器)
- Root Coordinator:元数据管理
- Query Coordinator:查询调度
- Index Coordinator:索引管理
- Data Coordinator:数据管理
Worker节点
- Query Node:查询执行
- Index Node:索引构建
- Data Node:数据存储
存储组件
- MinIO/S3:对象存储
- etcd:元数据存储
- Pulsar/Kafka:消息队列
2.3 关键特性
分布式架构
- 无单点故障
- 水平扩展
- 负载均衡
多种索引支持
- IVF系列索引
- HNSW索引
- GPU加速索引
数据一致性
- 强一致性保证
- 事务支持
- 数据备份
3. 向量索引策略详解
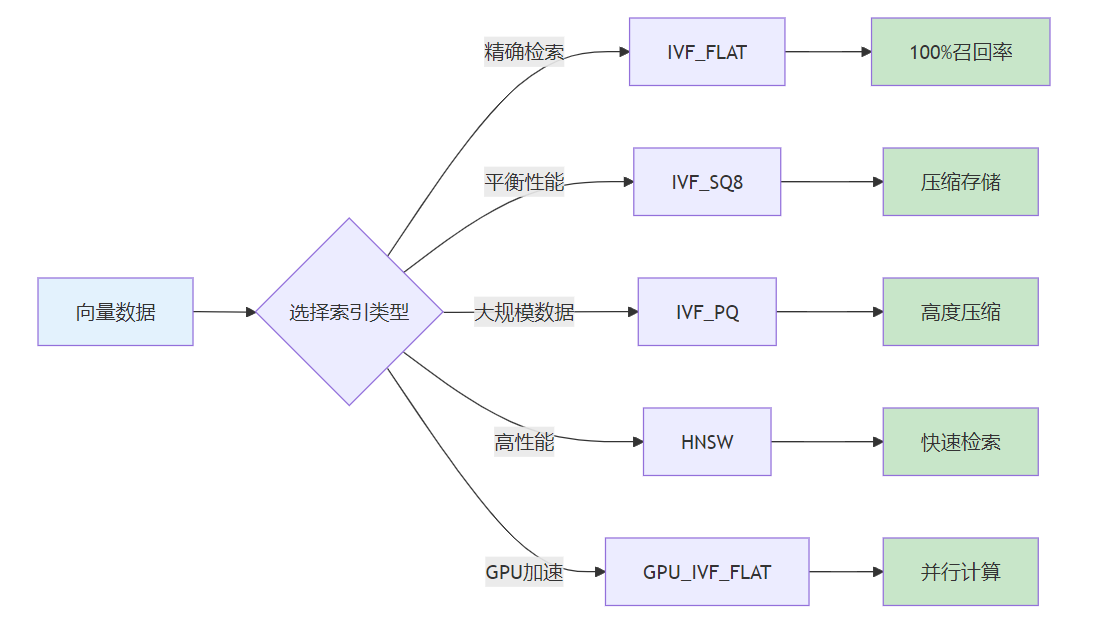
3.1 索引类型对比
| 索引类型 | 适用场景 | 优势 | 劣势 |
|---|---|---|---|
| IVF_FLAT | 精确检索 | 100%召回率 | 内存占用大 |
| IVF_SQ8 | 平衡检索 | 压缩存储 | 精度损失 |
| IVF_PQ | 大规模数据 | 高度压缩 | 精度损失大 |
| HNSW | 高性能检索 | 检索速度快 | 构建时间长 |
| GPU_IVF_FLAT | GPU加速 | GPU并行计算 | 需要GPU资源 |
3.2 IVF索引详解
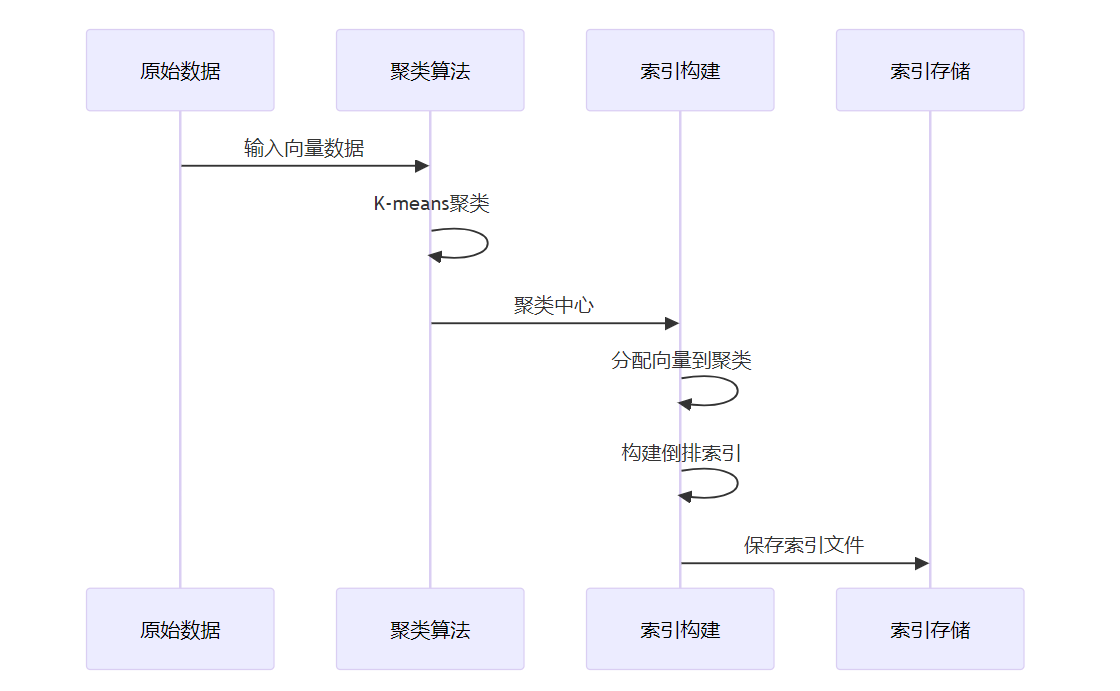
IVF(Inverted File)索引
- 基于聚类的索引方法
- 将向量空间划分为多个聚类
- 检索时只在相关聚类中搜索
索引构建过程:
参数调优:
- nlist:聚类数量,影响检索精度和速度
- nprobe:搜索聚类数量,影响召回率和性能
- m:PQ编码维度,影响压缩比和精度
3.3 HNSW索引详解
HNSW(Hierarchical Navigable Small World)索引
- 基于图的索引结构
- 多层级图结构
- 贪心搜索算法
索引结构:
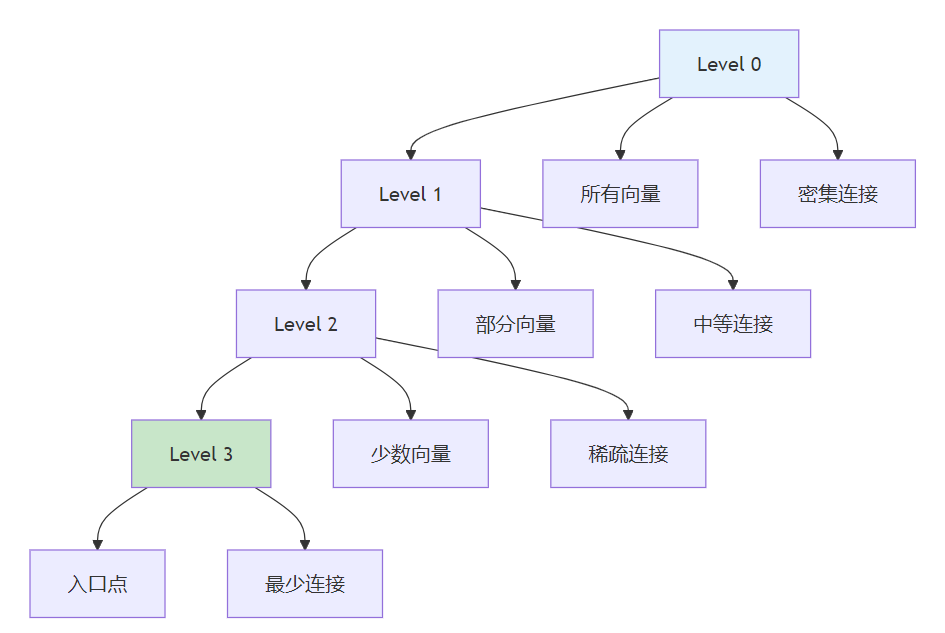
参数配置:
- M:每个节点的最大连接数
- efConstruction:构建时的搜索宽度
- ef:检索时的搜索宽度
4. 数据存储与检索机制
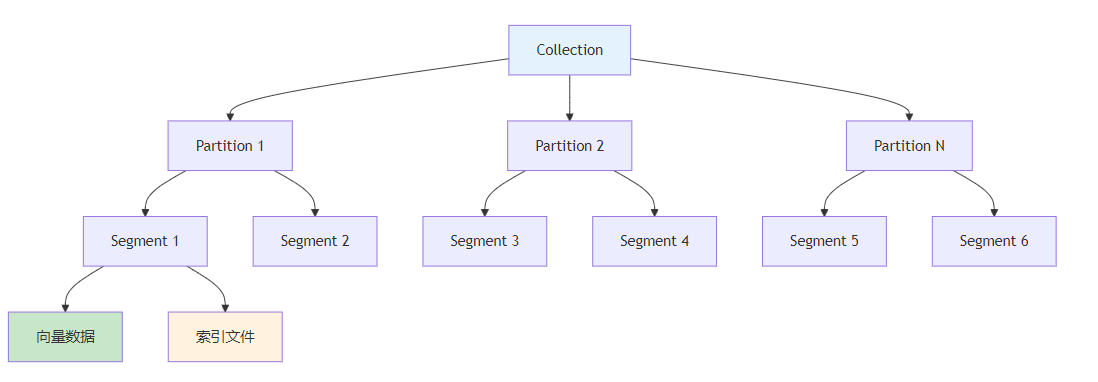
4.1 数据模型
Collection(集合)
- 类似关系数据库的表
- 定义向量维度和数据类型
- 包含Schema和索引配置
Partition(分区)
- Collection的逻辑分区
- 支持数据隔离
- 提高查询效率
Segment(段)
- 数据存储的基本单位
- 自动分片和合并
- 支持增量更新
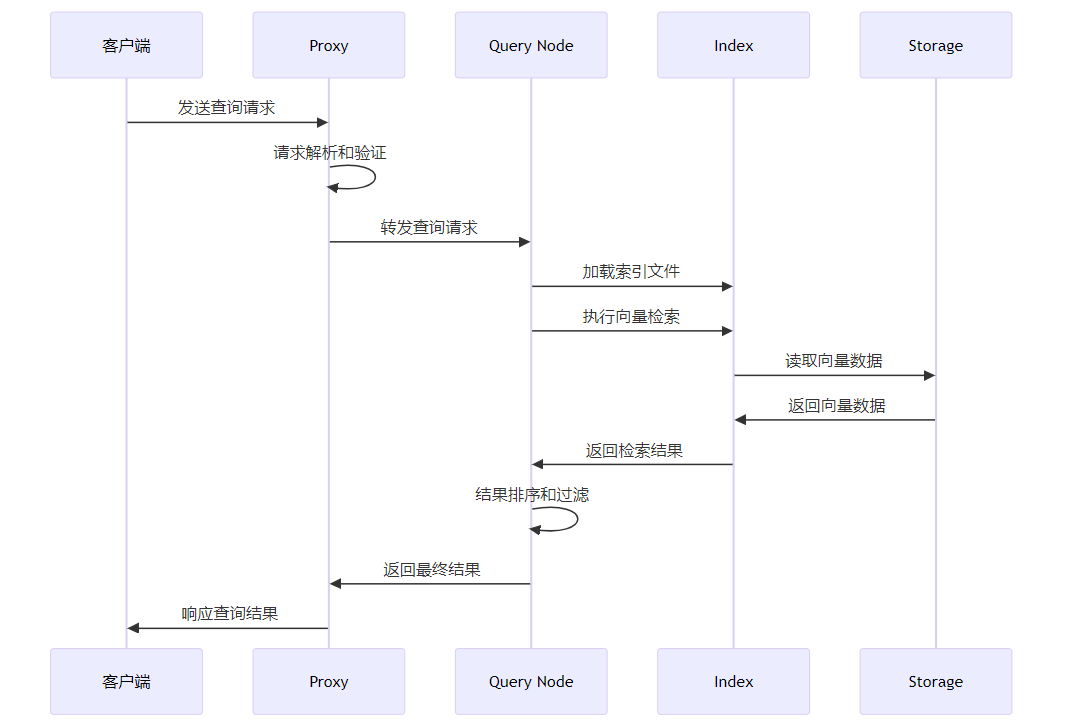
4.2 检索流程
4.3 批量操作优化
批量插入
- 减少网络开销
- 提高吞吐量
- 批量索引构建
批量查询
- 并行处理多个查询
- 减少延迟
- 提高并发性能
批量删除
- 标记删除机制
- 延迟物理删除
- 支持数据恢复
5. 性能优化实战
5.1 索引优化策略
索引选择原则
- 数据量大小
- 检索精度要求
- 硬件资源限制
- 查询延迟要求
参数调优方法
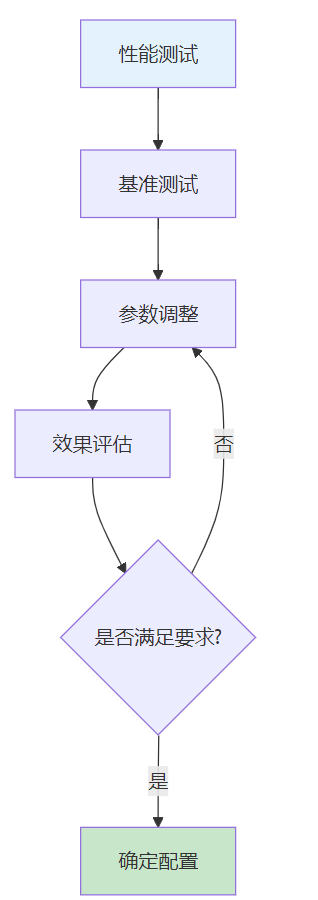
优化技巧:
- nlist调优:数据量/1000到数据量/100
- nprobe调优:平衡精度和性能
- 批量大小:根据内存情况调整
- 并发控制:避免资源竞争
5.2 系统优化
硬件优化
- CPU:多核处理器,支持并行计算
- 内存:充足内存,支持索引缓存
- 存储:SSD存储,提高I/O性能
- 网络:高速网络,减少延迟
配置优化
- 连接池配置:合理设置连接数
- 缓存配置:启用查询缓存
- 日志配置:调整日志级别
- 监控配置:启用性能监控
5.3 查询优化
查询语句优化
- 使用合适的过滤条件
- 避免全表扫描
- 合理设置topK值
- 使用批量查询
索引优化
- 定期重建索引
- 监控索引性能
- 调整索引参数
- 清理无用索引
6. 部署与运维实践
6.1 部署架构
单机部署
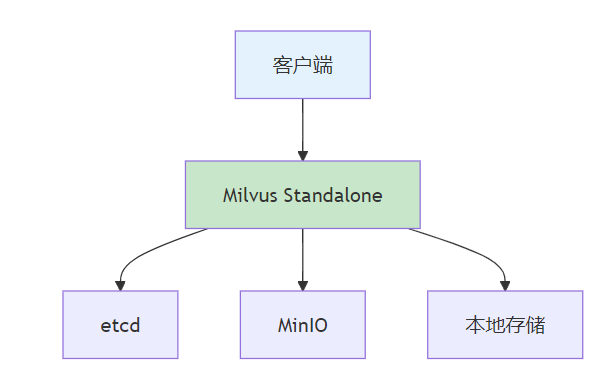
集群部署
6.2 监控与告警
关键指标监控
- 查询延迟:P50、P90、P99延迟
- 吞吐量:QPS、TPS
- 资源使用:CPU、内存、磁盘
- 错误率:查询错误率、连接错误率
告警配置
- 延迟超过阈值告警
- 资源使用率告警
- 服务可用性告警
- 数据一致性告警
6.3 备份与恢复
数据备份策略
- 定期全量备份
- 增量备份
- 跨地域备份
- 备份验证
故障恢复
- 节点故障恢复
- 数据损坏恢复
- 服务降级策略
- 灾难恢复预案
📝 课程总结
Milvus作为专业的向量数据库,为大规模向量数据的存储和检索提供了强大的支持。掌握其架构原理、索引策略和优化方法,是构建高性能RAG系统的重要基础。
关键要点回顾:
- Milvus采用分布式架构,支持水平扩展和高可用
- 多种索引算法适用于不同场景,需要根据需求选择
- 性能优化需要从硬件、配置、查询多个维度考虑
- 生产环境部署需要考虑监控、备份、恢复等运维问题

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)