小白学爬虫之豆瓣top250爬取与数据处理
前面写了两篇入门爬虫,后面断断续续学所以断更了。
今天展示一下学习的部分成果——新手小白的必修课之爬取豆瓣电影。
后续还会展示部分可视化成果,请持续关注哦。
一.分析网页结构
首先找到对应网站,右键进入“检查”页面。
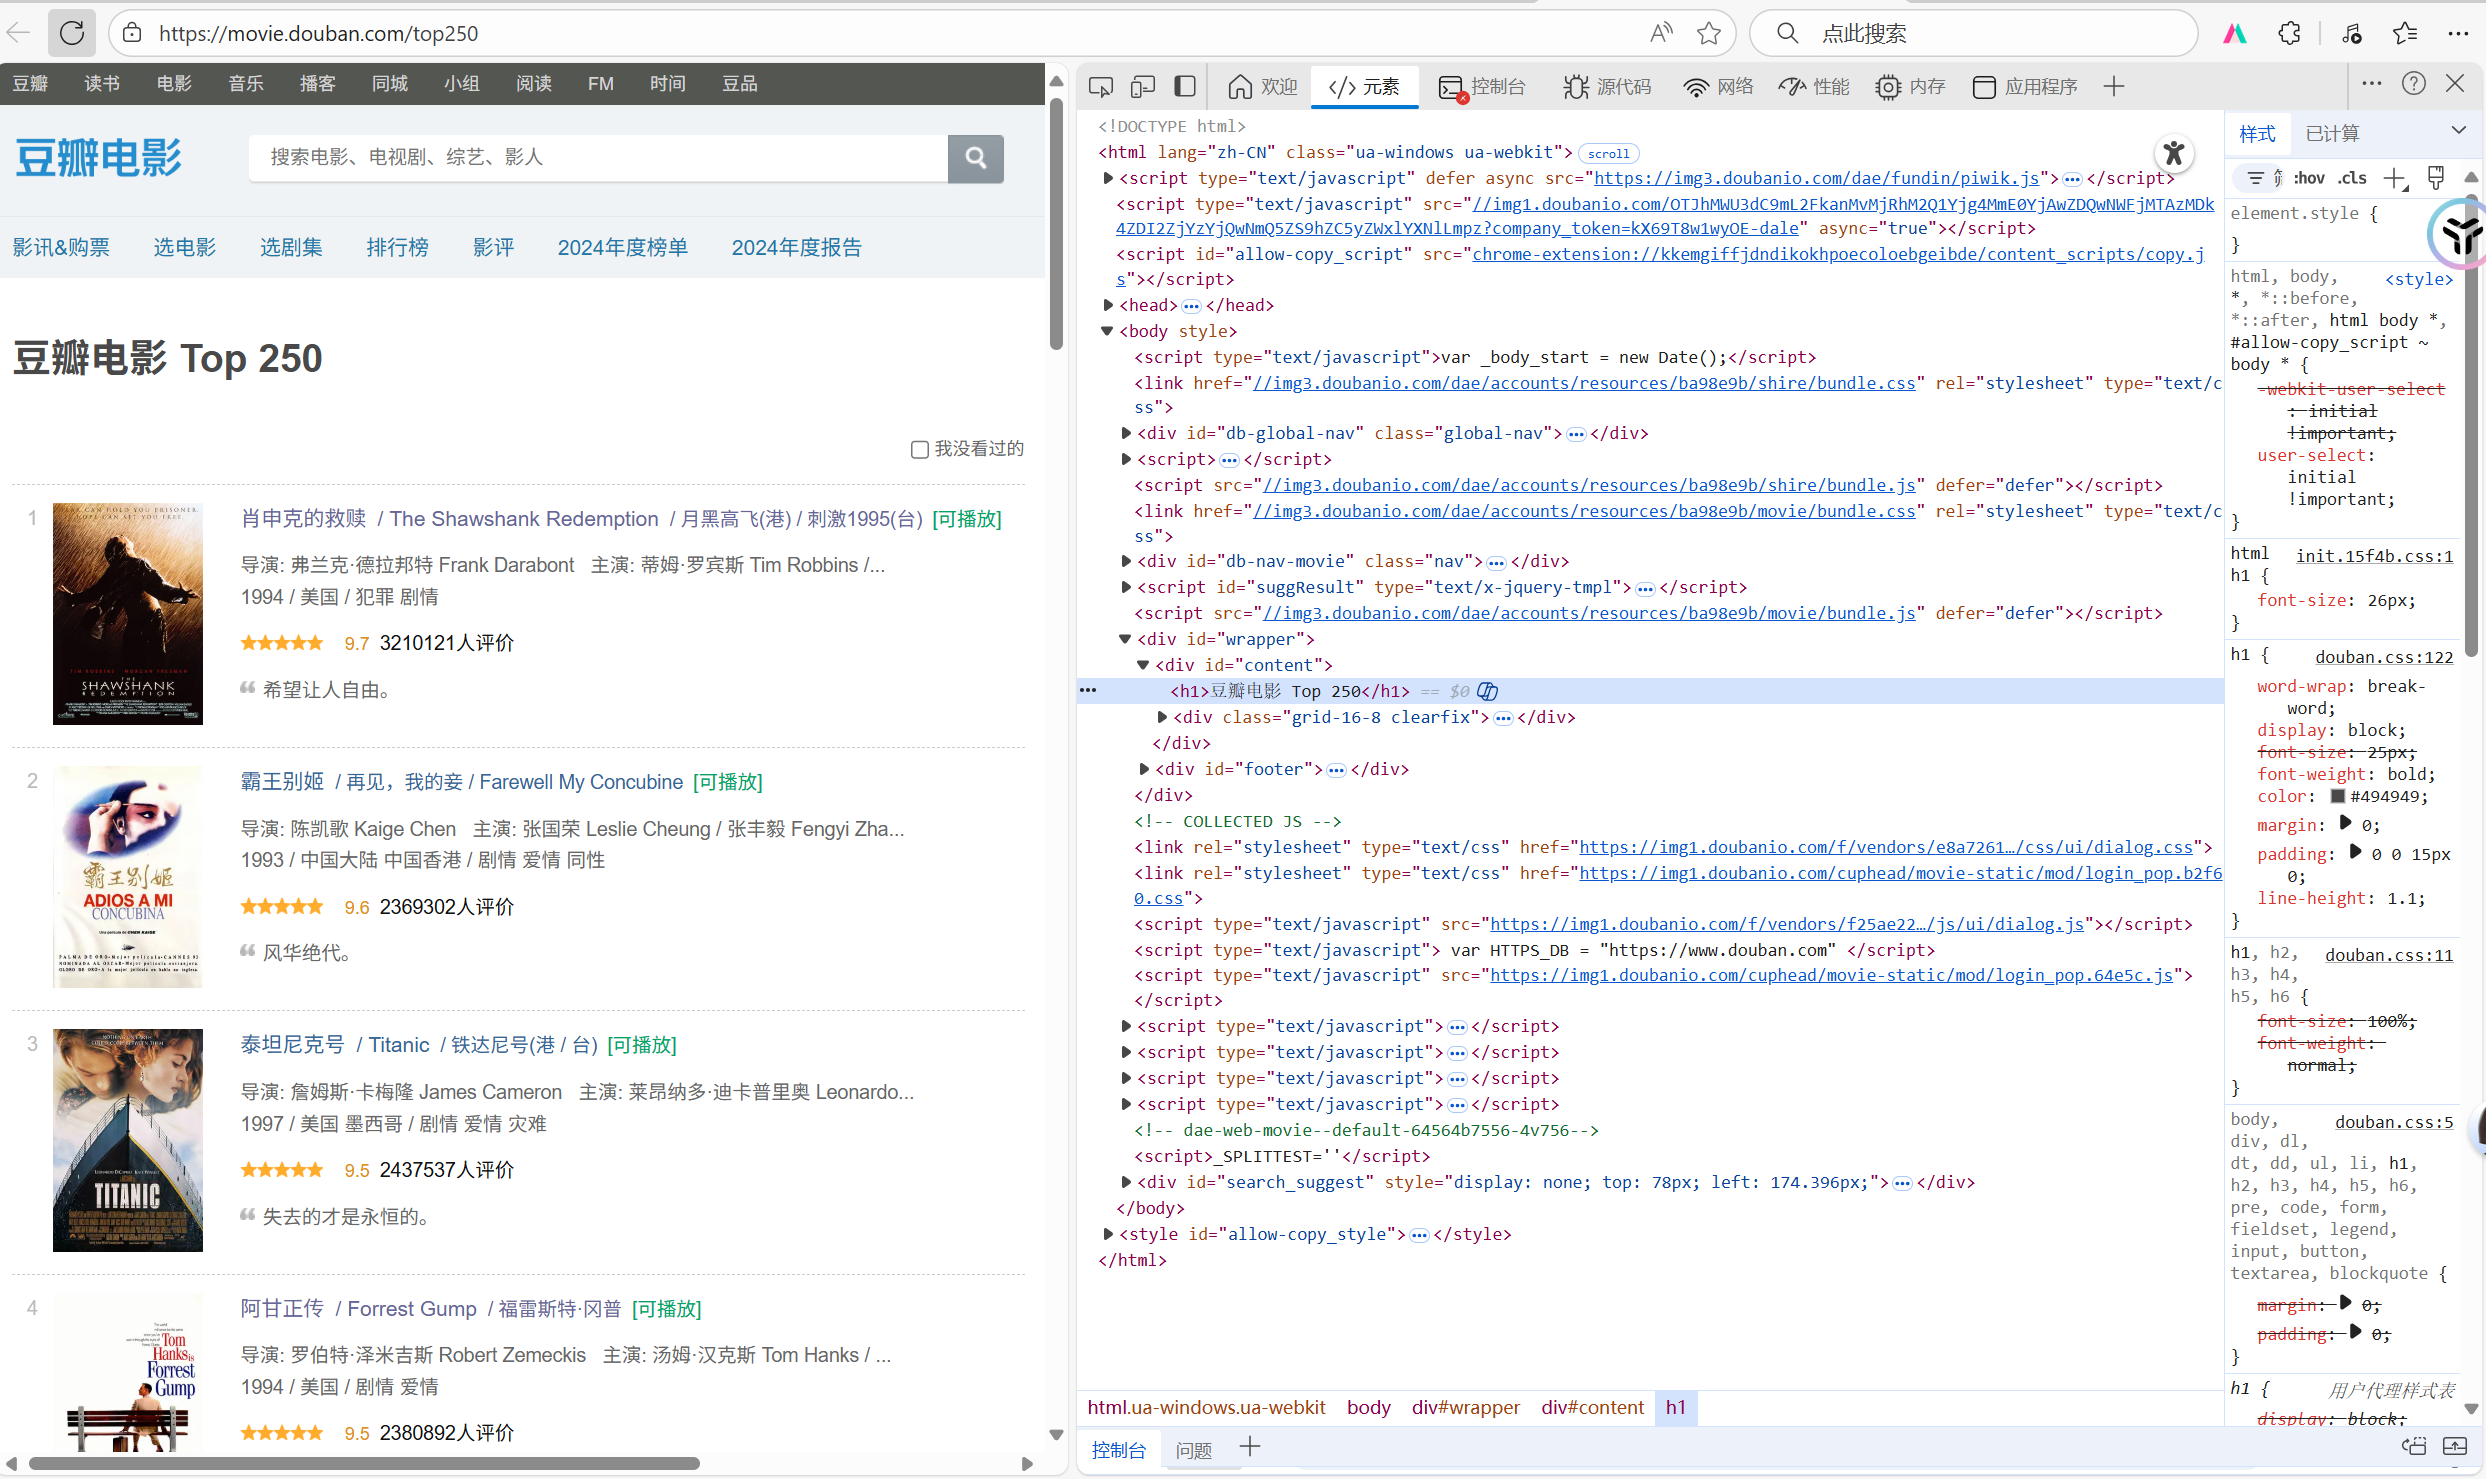
一部电影包含的文字信息有:
电影名称、导演、主演、上映年份、地区、类型、豆瓣评分、评价人数、电影简介
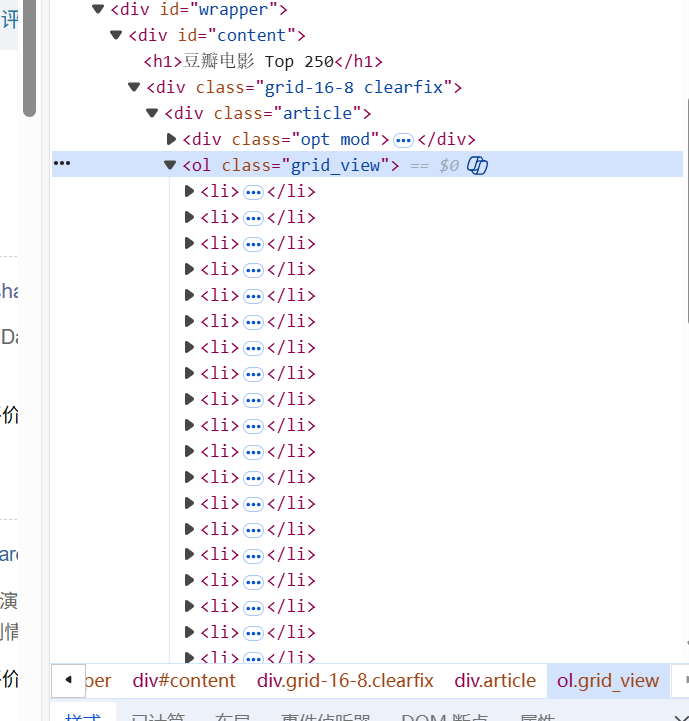
可以看出,在ol标签下有很多li标签,我们要寻找的信息就在这些li标签中。
打开几个查看后不难发现这些li标签的结构是类似的,所以我们可以利用循环先定位到这些li标签,然后通过xpath取出想要的信息。
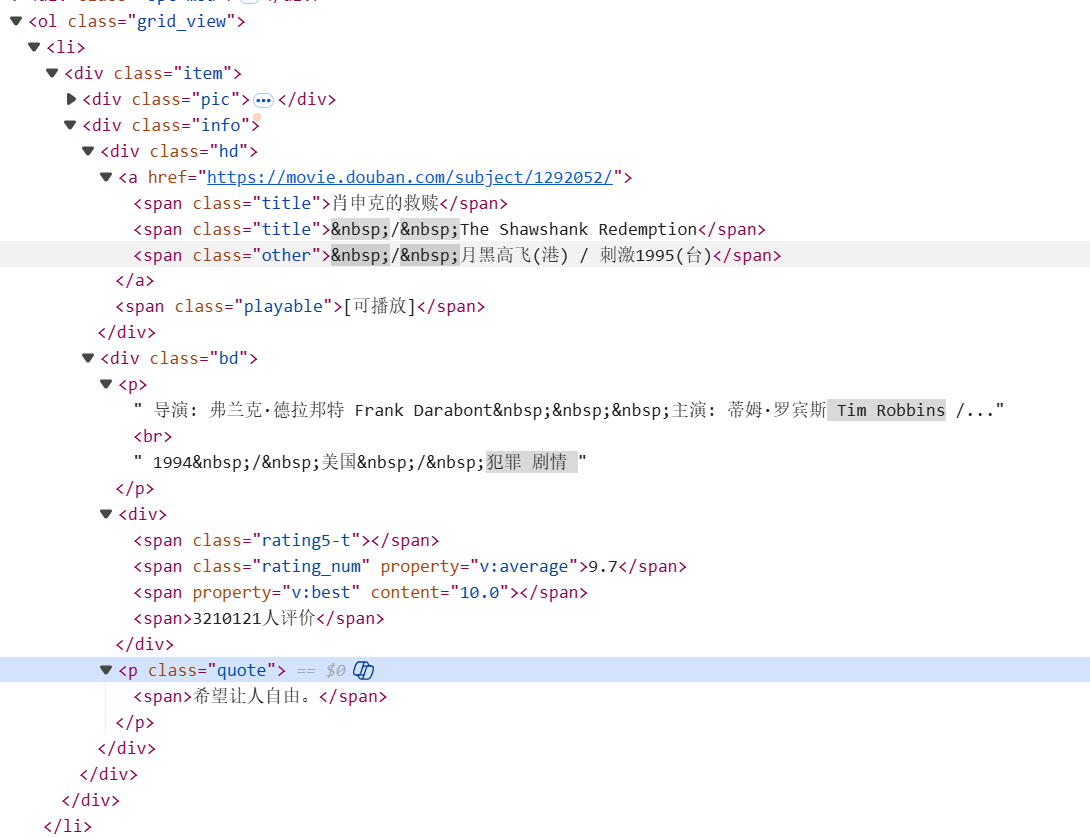
以《肖申克的救赎》为例
可直接用text()提取的有:
1.电影名称 定位是li/div/div[2]/div[1]/a/span[1]
2.豆瓣评分 定位是li/div/div[2]/div[2]/div/span[2]
3.评价人数 定位是li/div/div[2]/div[2]/div/span[4]
4.电影简介 定位是li/div/div[2]/div[2]/p[2]/span
其他信息同理,但是通过直接用text()获取的文本包含我们不需要的字符串,要过滤处理。
比如最为明显的 “ ” 功能是让文本之间不换行,挨着写。取出来的文本则可以使用replace('\xa0',' ')将它替换为空格,再使用strip()清理字符串首尾空白(包括普通空格、制表符、换行符等),但不会影响字符串中间的空白字符。
二.代码实现
import requests
from lxml import etree
import pandas as pd
import time
import random
import re


# 请求头信息
headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/108.0.0.0 Safari/537.36 Edg/108.0.1462.46',
    'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8',
    'Accept-Language': 'zh-CN,zh;q=0.8,zh-TW;q=0.7,zh-HK;q=0.5,en-US;q=0.3,en;q=0.2'
}


# 功能函数,获取列表的第一个元素
def get_first_text(element_list):
    """安全获取列表第一个元素并去除首尾空格"""
    try:
        return element_list[0].strip() if element_list else ""
    except (IndexError, TypeError):
        return ""


#解析单个电影各信息的函数
def parse_movie_info(li_element):


    # 基础信息提取
    title = get_first_text(li_element.xpath('./div/div[2]/div[1]/a/span[1]/text()'))
    src = get_first_text(li_element.xpath('./div/div[2]/div[1]/a/@href'))
    score = get_first_text(li_element.xpath('./div/div[2]/div[2]/div/span[2]/text()'))
    comment = get_first_text(li_element.xpath('./div/div[2]/div[2]/div/span[4]/text()'))[:-3]
    summary = get_first_text(li_element.xpath('./div/div[2]/div[2]/p[2]/span/text()'))


    # 导演信息提取
    director_part = get_first_text(li_element.xpath('./div/div[2]/div[2]/p[1]/text()'))
    director_part = director_part.replace('\xa0', ' ').strip()
    director = ""
    if '导演:' in director_part:
        director = director_part.split('导演:')[1].split('主演:')[0].strip()


    # 上映信息提取
    info_text = get_first_text(li_element.xpath('./div/div[2]/div[2]/p[1]/br/following-sibling::text()'))
    info_text = info_text.replace('\xa0', '').strip()
    parts = [part.strip() for part in info_text.split("/")]

    # 年份清洗:提取纯数字年份
    year = ""
    if parts:
        # 匹配4位数字年份(处理类似"1964(中国大陆)"格式)
        year_match = re.search(r'\b\d{4}\b', parts[0])
        if year_match:
            year = year_match.group()

    # 地区清洗:处理可能包含年份的情况
    region = ""
    if len(parts) > 1:
        # 移除地区中可能包含的年份信息
        region = re.sub(r'\b\d{4}\b', '', parts[1]).strip()
        # 移除可能的括号和空格
        region = re.sub(r'[()()\s]+', '', region)

    # 类型提取
    genre = parts[2] if len(parts) > 2 else ""

    return [title, src, director, year, region, genre, score, comment, summary]


#爬取数据的函数
def crawl_douban_top250():

    # 初始化数据框
    df = pd.DataFrame(columns=[
        "标题", "链接", "导演", "上映年份",
        "上映地区", "类型", "评分", "评价人数", "简介"
    ])

    # 生成10个页面的地址
    urls = [f'https://movie.douban.com/top250?start={i * 25}&filter=' for i in range(10)]

    for idx, url in enumerate(urls, 1):
        try:
            # 随机延迟避免请求过于频繁
            time.sleep(random.uniform(1, 3))

            # 发起请求
            res = requests.get(url=url, headers=headers, timeout=10)
            res.raise_for_status()  # 检查请求是否成功

            # 解析HTML
            html = etree.HTML(res.text)
            lis = html.xpath('//*[@id="content"]/div/div[1]/ol/li')

            if not lis:
                print(f"第{idx}页未找到电影数据,跳过...")
                continue

            # 解析并存储数据
            for li in lis:
                movie_info = parse_movie_info(li)
                df.loc[len(df)] = movie_info
                print(f"已爬取: {movie_info[0]}")  # 只打印标题,减少输出干扰

            print(f"第{idx}页爬取完成,累计爬取{len(df)}部电影")

        except Exception as e:
            print(f"第{idx}页爬取出错: {str(e)}")
            # 出错时稍作等待
            time.sleep(5)

    # 保存数据到Excel
    try:
        df.to_excel("豆瓣top250数据.xlsx", sheet_name="豆瓣电影top250数据",
                    na_rep="", index=False)  # 去掉索引列
        print(f"Excel文件已生成,共包含{len(df)}部电影数据")
    except Exception as e:
        print(f"保存Excel失败: {str(e)}")

    return df


if __name__ == "__main__":
    crawl_douban_top250()
三.各功能介绍
重点介绍三个功能函数。
get_first_text(element_list) #获取用text取出的文字列表的第一个元素
【注:text()取出的文本节点是以列表的形式组成,因为xpath的核心是准确返回所有匹配结果,text()返回形式为列表才能确保不会遗漏可能存在的多个结果。在只有一个结果的情况下就需要用[0]提取】
parse_movie_info(li_element) #针对单部电影进行信息提取
crawl_douban_top250() #实际爬取函数
def get_first_text(element_list):

#进行异常处理,增强代码可读性
    #提取到文本返回列表中第一个文本元素并清除首尾空白字符串
    try:
        return element_list[0].strip() if element_list else ""

    #如果没有提取到文本就返回空字符串
    except (IndexError, TypeError):
        return ""
def parse_movie_info(li_element):

    # 基础信息提取
    title = get_first_text(li_element.xpath('./div/div[2]/div[1]/a/span[1]/text()'))
    src = get_first_text(li_element.xpath('./div/div[2]/div[1]/a/@href'))
    score = get_first_text(li_element.xpath('./div/div[2]/div[2]/div/span[2]/text()'))
    #为了方便后面的可视化数据,这里直接去掉“人评价”
    comment = get_first_text(li_element.xpath('./div/div[2]/div[2]/div/span[4]/text()'))[:-3]
    summary = get_first_text(li_element.xpath('./div/div[2]/div[2]/p[2]/span/text()'))

    # 导演信息提取
    #先提取包含该信息的文本内容
    director_part = get_first_text(li_element.xpath('./div/div[2]/div[2]/p[1]/text()'))
    #'\xa0'在html中对应' ',这里把非断行空格替换为空格
    director_part = director_part.replace('\xa0', ' ').strip()
    director = ""
    if '导演:' in director_part:
        #把‘导演’以后的内容和‘主演以前的内容清理后提取出来’
        director = director_part.split('导演:')[1].split('主演:')[0].strip()

    # 上映信息提取
    info_text = get_first_text(li_element.xpath('./div/div[2]/div[2]/p[1]/br/following-sibling::text()'))
    info_text = info_text.replace('\xa0', '').strip()
    parts = [part.strip() for part in info_text.split("/")]
    # 年份清洗:提取纯数字年份
    year = ""
    if parts:
        # 匹配4位数字年份(处理类似"1964(中国大陆)"格式)
        year_match = re.search(r'\b\d{4}\b', parts[0])
        if year_match:
            year = year_match.group()

    # 地区清洗:处理可能包含年份的情况
    region = ""
    if len(parts) > 1:
        # 移除地区中可能包含的年份信息
        region = re.sub(r'\b\d{4}\b', '', parts[1]).strip()
        # 移除可能的括号和空格
        region = re.sub(r'[()()\s]+', '', region)

    # 类型提取
    genre = parts[2] if len(parts) > 2 else ""

    return [title, src, director, year, region, genre, score, comment, summary]
def crawl_douban_top250():

    # 初始化数据框
    df = pd.DataFrame(columns=[
        "标题", "链接", "导演", "上映年份",
        "上映地区", "类型", "评分", "评价人数", "简介"
    ])

    # 生成10个页面的地址
    urls = [f'https://movie.douban.com/top250?start={i * 25}&filter=' for i in range(10)]

    for idx, url in enumerate(urls, 1):
        try:
            # 随机延迟避免请求过于频繁
            time.sleep(random.uniform(1, 3))

            # 发起请求
            res = requests.get(url=url, headers=headers, timeout=10)
            res.raise_for_status()  # 检查请求是否成功

            # 解析HTML
            html = etree.HTML(res.text)
            lis = html.xpath('//*[@id="content"]/div/div[1]/ol/li')

            if not lis:
                print(f"第{idx}页未找到电影数据,跳过...")
                continue

            # 解析并存储数据
            for li in lis:
                movie_info = parse_movie_info(li)
                df.loc[len(df)] = movie_info
                print(f"已爬取: {movie_info[0]}")  # 只打印标题,减少输出干扰

            print(f"第{idx}页爬取完成,累计爬取{len(df)}部电影")

        except Exception as e:
            print(f"第{idx}页爬取出错: {str(e)}")
            # 出错时稍作等待
            time.sleep(5)

    # 保存数据到Excel
    try:
        df.to_excel("豆瓣top250数据.xlsx", sheet_name="豆瓣电影top250数据",
                    na_rep="", index=False)  # 去掉索引列
        print(f"Excel文件已生成,共包含{len(df)}部电影数据")
    except Exception as e:
        print(f"保存Excel失败: {str(e)}")

    return df
四.成果展示
最后保存的excel是这样的
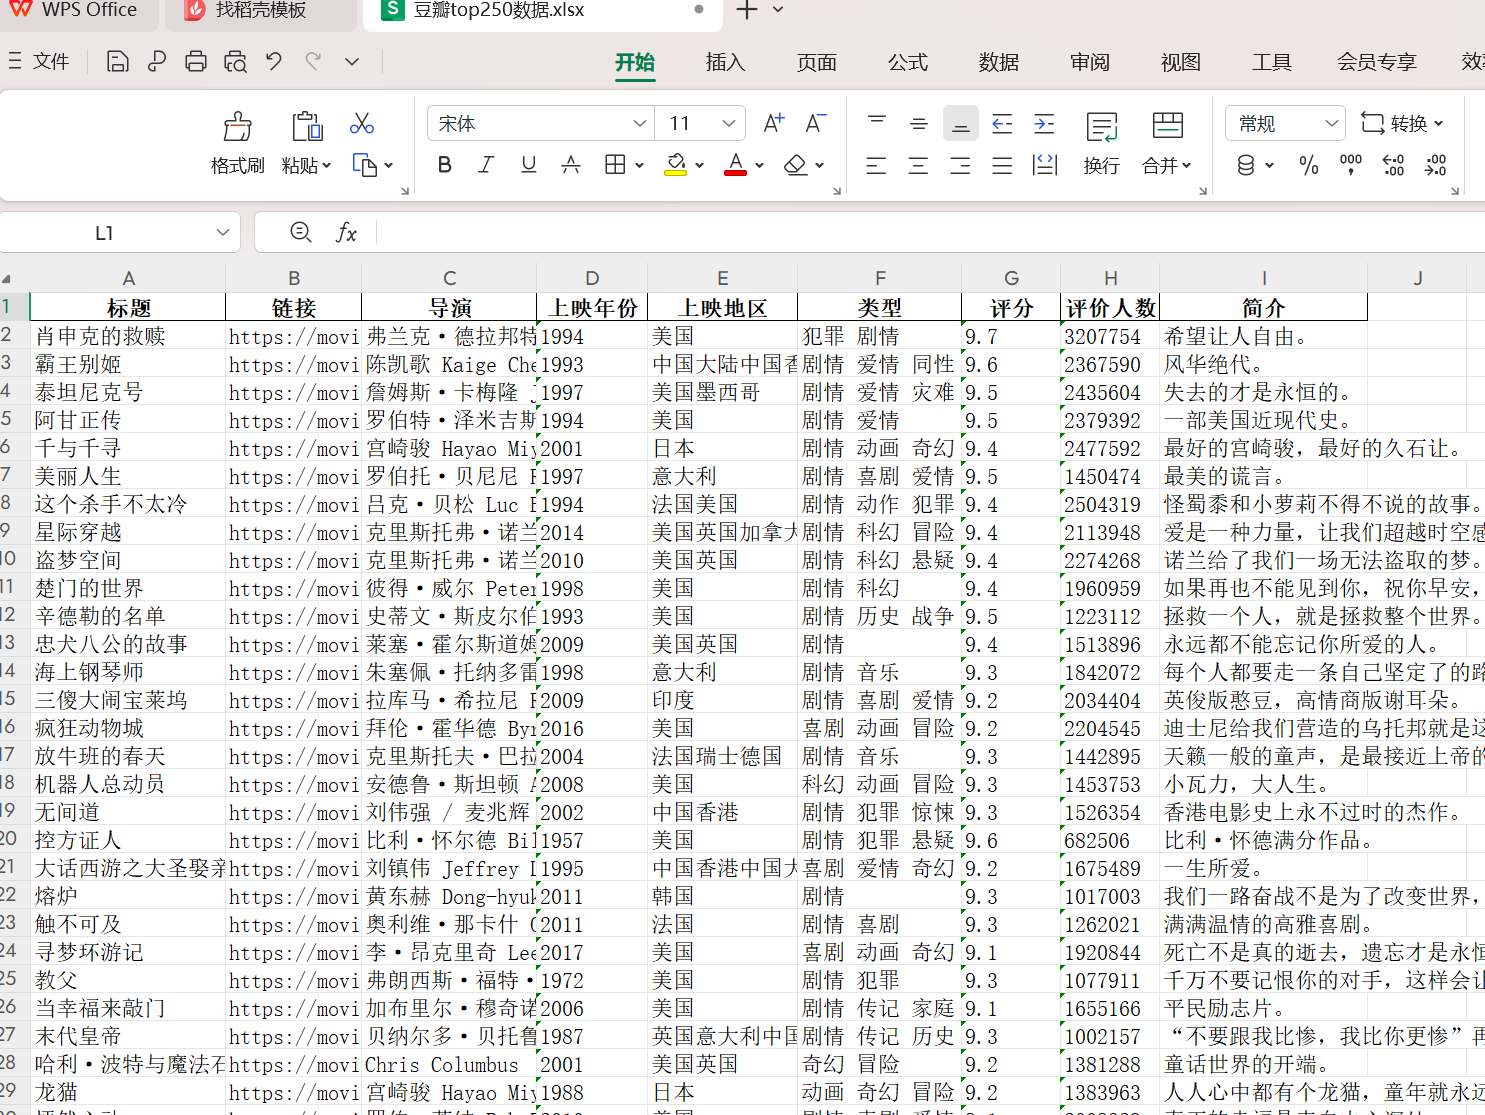
案例仅供参考,期待与大家共同学习共同进步,新手小白完成的第一个小项目还有颇多不足,请各位前辈多多指正!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献1条内容

所有评论(0)