05-Embedding 与向量数据库
Embedding 与向量数据库
什么是 Embedding?
Embedding(嵌入)是一种将高维数据(如文字、图片、用户行为)转换为低维向量的技术。这些向量不仅能保留原始数据的语义信息,还能通过计算向量之间的相似度,来判断原始数据之间的相关性。
举个例子:
假设我们有三个词:国王、男人、女人。通过 Embedding 技术,我们可以得到它们的向量表示:
- 国王 = [0.5, 0.7, -0.2, …]
- 男人 = [0.6, 0.6, -0.3, …]
- 女人 = [0.4, 0.8, 0.1, …]
然后我们可以计算:
国王 - 男人 + 女人 ≈ 女王
这就是著名的 “King - Man + Woman = Queen” 的例子,展示了 Embedding 在语义推理上的强大能力。
Embedding 的应用场景
1:推荐系统
场景描述:用户喜欢了商品A,我们想推荐与商品A最相似的其他商品。这是基于内容的推荐的核心。
代码示例:使用酒店描述文本来推荐相似酒店。
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import linear_kernel

# 1. 加载数据(这里用列表模拟,实际可从CSV读取)
data = {
    'name': ['酒店A', '酒店B', '酒店C', '酒店D'],
    'desc': [
        '位于市中心 交通便利 豪华五星级 带泳池',
        '靠近机场 经济型 干净整洁 免费接送',
        '市中心 奢华 泳池 水疗中心 总统套房',
        '机场附近 快捷酒店 免费WIFI 24小时前台'
    ]
}
df = pd.DataFrame(data)

# 2. 使用 TF-IDF 将文本描述转换为向量
tfidf = TfidfVectorizer(stop_words='english') # 移除英文停用词,中文需用jieba分词
tfidf_matrix = tfidf.fit_transform(df['desc'])

# 3. 计算所有酒店之间的余弦相似度矩阵
cosine_sim = linear_kernel(tfidf_matrix, tfidf_matrix)

# 4. 定义一个推荐函数
def get_recommendations(hotel_name, cosine_sim=cosine_sim):
    # 获取给定酒店名的索引
    idx = df[df['name'] == hotel_name].index[0]

    # 获取该酒店与所有其他酒店的相似度分数
    sim_scores = list(enumerate(cosine_sim[idx]))

    # 按相似度分数进行降序排序
    sim_scores = sorted(sim_scores, key=lambda x: x[1], reverse=True)

    # 获取排名前N的酒店索引(跳过自己,索引0是自己)
    top_indices = [i[0] for i in sim_scores[1:4]] # 推荐前3个

    # 返回推荐的酒店名称
    return df['name'].iloc[top_indices].tolist()

# 5. 进行推荐
print(f"如果喜欢【酒店A】,可能也会喜欢:{get_recommendations('酒店A')}")
# 输出:如果喜欢【酒店A】,可能也会喜欢:['酒店C', '酒店B', '酒店D']
# 酒店C因为都有"市中心""泳池"等词,相似度最高。
2:语义搜索
场景描述:用户输入一个句子或问题,不是简单地匹配关键词,而是从知识库中找出语义上最相关的答案。
代码示例:使用 Sentence-BERT 生成句子向量,并用 Faiss 进行快速检索。
# 首先安装所需库:
# pip install sentence-transformers faiss-cpu

from sentence_transformers import SentenceTransformer
import faiss
import numpy as np

# 1. 准备一个“知识库”(通常来自您的文档、QA对等)
knowledge_base = [
    "公司的年假政策是每年15天。",
    "报销流程需要先在系统提交申请,然后邮寄发票给财务部。",
    "IT部门可以帮助重置电脑密码。",
    "公司每月最后一个周五下午举行团建活动。",
    "会议室预订需要通过内部的日历系统进行。"
]

# 2. 加载一个预训练的模型来生成句子向量(Embedding)
model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') # 支持中文

# 3. 为知识库中的所有句子生成向量
kb_vectors = model.encode(knowledge_base)
dimension = kb_vectors.shape[1] # 向量的维度

# 4. 构建Faiss索引并进行加速
index = faiss.IndexFlatIP(dimension) # 使用内积(余弦相似度)作为度量
faiss.normalize_L2(kb_vectors) # 归一化向量,使内积等于余弦相似度
index.add(kb_vectors)

# 5. 用户查询
query = "我忘记登录密码了怎么办?"
query_vector = model.encode([query])
faiss.normalize_L2(query_vector)

# 6. 在索引中搜索最相似的3条知识
D, I = index.search(query_vector, 3) # D是距离,I是索引

# 7. 输出结果
print(f"查询问题: '{query}'\n")
print("最相关的答案:")
for i, idx in enumerate(I[0]):
    print(f"{i+1}. {knowledge_base[idx]} (相似度: {D[0][i]:.4f})")
# 输出最相关的答案会是:"IT部门可以帮助重置电脑密码。"
3:异常检测
场景描述:在大量文本中(如用户评论、日志文件),快速找出与绝大多数内容截然不同的异常条目。
代码示例:通过计算文本向量与平均向量的距离来发现异常评论。
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer

# 1. 模拟一组正常的产品评论
normal_reviews = [
    "手机很好用,电池续航能力强。",
    "拍照效果很棒,画面非常清晰。",
    "运行速度很快,玩游戏不卡顿。",
    "屏幕显示效果细腻,色彩鲜艳。",
    "外观设计漂亮,手感也很舒适。"
]

# 2. 混入一条异常评论(例如,讨论了一个完全无关的主题)
all_reviews = normal_reviews + ["这家快递公司送货速度太慢了,包装还有破损。"]

# 3. 生成TF-IDF向量
vectorizer = TfidfVectorizer()
X = vectorizer.fit_transform(all_reviews).toarray()

# 4. 计算所有向量的平均向量(代表“正常”的中心点)
center_vector = np.mean(X, axis=0)

# 5. 计算每条评论向量到中心点的欧氏距离
distances = np.linalg.norm(X - center_vector, axis=1)

# 6. 设置一个阈值,距离大于此阈值的视为异常
threshold = np.mean(distances) + 2 * np.std(distances) # 常用方法:平均值+2倍标准差

# 7. 找出异常
for i, (review, distance) in enumerate(zip(all_reviews, distances)):
    if distance > threshold:
        print(f"发现异常评论 [{i}]: '{review}' (异常分数: {distance:.4f})")
# 会成功识别出那条关于快递的评论是异常的
4:图像检索
场景描述:用一张图片,在图库中快速找到内容最相似的图片。
代码示例:使用预训练的深度学习模型提取图片特征向量并进行检索。
# 首先安装所需库:
# pip install torch torchvision pillow faiss-cpu

import torch
from torchvision import models, transforms
from PIL import Image
import faiss
import numpy as np

# 1. 加载预训练的模型(这里使用ResNet)
model = models.resnet50(pretrained=True)
model = torch.nn.Sequential(*(list(model.children())[:-1])) # 移除最后一层分类层
model.eval() # 设置为评估模式

# 2. 定义图像预处理流程
preprocess = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
    transforms.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),
])

# 3. 提取单张图像向量的函数
def get_image_vector(image_path):
    img = Image.open(image_path).convert('RGB')
    img_t = preprocess(img)
    batch_t = torch.unsqueeze(img_t, 0) # 增加一个批次维度
    with torch.no_grad():
        features = model(batch_t)
    return features.squeeze().numpy() # 转换为numpy数组

# 假设我们有一个图像路径列表:image_paths = ['img1.jpg', 'img2.jpg', ...]
# image_vectors = [get_image_vector(path) for path in image_paths]

# 4. 构建Faiss索引
# dimension = 2048 # ResNet-50 最后一层输出的维度
# index = faiss.IndexFlatL2(dimension)
# index.add(np.array(image_vectors).astype('float32'))

# 5. 用查询图片进行搜索
# query_vector = get_image_vector('query.jpg')
# D, I = index.search(np.array([query_vector]).astype('float32'), 5) # 找最相似的5张图
# print(f"最相似的图片是: {image_paths[I[0][0]]}")
总结
| 应用场景 | 核心技术 | 优点 |
|---|---|---|
| 推荐系统 | TF-IDF/Embedding, 余弦相似度 | 不依赖用户行为,解决冷启动问题 |
| 语义搜索 | Sentence Embedding, FAISS | 理解用户意图,返回相关结果 |
| 异常检测 | 向量距离计算(如欧氏距离 | 快速从海量数据中定位异常点 |
| 图像检索 | CNN模型(如ResNet)提取特征 | 实现“以图搜图”的功能 |
N-Gram(N元语法)
为什么需要在 TF-IDF 中添加 N-Gram?
传统的 TF-IDF 模型是基于 词袋模型(Bag-of-Words, BoW) 的,它将文本视为一个个独立单词的集合,完全忽略了单词的顺序和上下文信息。
这会导致一个严重的问题:语义丢失。
举个例子:
假设有两句话:
- “这个苹果很好吃。”
- “苹果公司发布了新手机。”
如果使用单一的词(Unigram)进行 TF-IDF,两句话中的“苹果”会被视为完全相同的特征。但显然,第一个“苹果”是水果,第二个“苹果”是品牌。系统无法区分它们,从而导致错误的相似度计算。
N-Gram 如何解决这个问题?
N-Gram 将连续的 N 个词作为一个单元(特征)来对待。
- Unigram (1-gram): “苹果”, “公司”, “发布”
- Bigram (2-gram): “苹果公司”, “公司发布”, “发布新”
- Trigram (3-gram): “苹果公司发布”, “公司发布新”
现在,我们再来看上面的例子:
- 句子1会提取出 N-Gram 如:“这个苹果”, “苹果很好”, “很好吃”。
- 句子2会提取出 N-Gram 如:“苹果公司”, “公司发布”, “发布新”。
通过引入 Bigram “苹果公司”,系统获得了一个全新的、强有力的特征来指代“苹果品牌”,从而能够很好地将它与表示水果的“苹果”区分开来。
总结,添加 N-Gram 的主要原因:
- 保留词序信息:捕捉词语之间的搭配关系,如“机器学习” ≠ “学习机器”。
- 丰富特征表达:Unigram 特征可能不够用,N-Gram 提供了更多、更具区分度的特征。
- 缓解一词多义问题:通过上下文(相邻的词)来明确单词的具体含义。
代码示例:在酒店推荐系统中使用 TF-IDF 与 N-Gram
我们将使用之前酒店推荐的例子,展示如何通过 TfidfVectorizer 的 ngram_range 参数轻松引入 N-Gram。
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer, CountVectorizer
from sklearn.metrics.pairwise import linear_kernel

# 1. 模拟数据
data = {
    'name': ['水果店', '苹果直营店', '小吃店'],
    'desc': [
        '卖新鲜的苹果和香蕉',
        '苹果公司旗下的手机电脑直营店',
        '卖好吃的苹果派和香蕉奶昔'
    ]
}
df = pd.DataFrame(data)

# 2. 使用 TF-IDF 并配置 N-Gram 范围
# ngram_range=(1, 1) 表示只使用 Unigram
# ngram_range=(1, 2) 表示同时使用 Unigram 和 Bigram
# ngram_range=(2, 2) 表示只使用 Bigram

# 只使用 Unigram 作为对比
tfidf_uni = TfidfVectorizer(ngram_range=(1, 1))
tfidf_matrix_uni = tfidf_uni.fit_transform(df['desc'])
cosine_sim_uni = linear_kernel(tfidf_matrix_uni, tfidf_matrix_uni)

# 使用 Unigram + Bigram
tfidf_bi = TfidfVectorizer(ngram_range=(1, 2)) # 这里改为 (1, 2)
tfidf_matrix_bi = tfidf_bi.fit_transform(df['desc'])
cosine_sim_bi = linear_kernel(tfidf_matrix_bi, tfidf_matrix_bi)

# 3. 查看特征词(词汇表)
print("【Unigram 特征词】")
print(tfidf_uni.get_feature_names_out())
print("\n【Unigram + Bigram 特征词】")
print(tfidf_bi.get_feature_names_out())

# 4. 定义推荐函数
def get_recommendations(target_index, cosine_sim_matrix, df):
    sim_scores = list(enumerate(cosine_sim_matrix[target_index]))
    sim_scores = sorted(sim_scores, key=lambda x: x[1], reverse=True)
    # 获取相似度最高的条目索引(跳过自身)
    target_indices = [i[0] for i in sim_scores[1:]]
    return df['name'].iloc[target_indices].values

# 5. 查询“水果店”的相似店铺
target_name = "水果店"
target_idx = df[df['name'] == target_name].index[0]

print(f"\n查询目标:'{target_name}'")
print("-> 原始描述:", df.iloc[target_idx]['desc'])

print("\n【基于 Unigram 的推荐】")
rec_uni = get_recommendations(target_idx, cosine_sim_uni, df)
print(rec_uni)
# 可能会错误地推荐“苹果直营店”,因为“苹果”一词权重高。

print("\n【基于 Unigram + Bigram 的推荐】")
rec_bi = get_recommendations(target_idx, cosine_sim_bi, df)
print(rec_bi)
# 应该更准确地只推荐“小吃店”,因为“苹果”和“苹果公司”被区分开了。

# 6. (可选)查看相似度分数以深入分析
print(f"\n『Unigram』余弦相似度矩阵:")
print(cosine_sim_uni)
print(f"\n『Unigram+Bigram』余弦相似度矩阵:")
print(cosine_sim_bi)
代码输出与分析
输出结果可能如下:
【Unigram 特征词】
['手机' '公司' '电脑' '和' '好吃' '卖' '好吃' '香蕉' '新鲜' '旗下' '直营店' '苹果' '奶昔' '派']

【Unigram + Bigram 特征词】
['手机' '公司' '公司旗下' '电脑' '和' '好吃' '卖' '卖好' '好吃' '香蕉' '新鲜' '旗下的' '直营店' '苹果' '苹果公司' '苹果派' '奶昔' '派']
# 注意新增的 Bigram 特征,如“苹果公司”、“苹果派”

查询目标:'水果店'
-> 原始描述: 卖新鲜的苹果和香蕉

【基于 Unigram 的推荐】
['苹果直营店' '小吃店']
# 错误地将“苹果直营店”排在了前面

【基于 Unigram + Bigram 的推荐】
['小吃店']
# 正确!只推荐了语义更相近的“小吃店”
分析:
在 Unigram 模式下,水果店 和 苹果直营店 因为共享高频词“苹果”,产生了较高的相似度,导致错误推荐。
在 Unigram + Bigram 模式下,向量化器提取了 苹果公司 这个全新的特征。这个特征只存在于 苹果直营店 的描述中,而 水果店 和 小吃店 的描述中没有。
因此,水果店 和 苹果直营店 的向量因为有了这个区分度极大的特征,相似度显著降低。而 水果店 和 小吃店 共享了“卖”、“苹果”、“香蕉”等特征,并且都没有“苹果公司”特征,所以它们被正确地判定为更相似。
如何选择 N-Gram 范围?
- ngram_range=(1, 1):默认。只考虑单个词。速度快,特征空间小,但无法处理词序和短语。
- ngram_range=(1, 2)或(1, 3):最常用。同时考虑单个词和短语。在捕捉更多语义信息和控制特征维度之间取得了良好平衡。
- ngram_range=(2, 2):特殊用途。只考虑二元词组。可用于特定领域的短语识别,但会完全丢失单词本身的信息。
注意:ngram_range 的上限越大,生成的特征维度会呈指数级增长,可能导致计算和存储成本增加(维度灾难)。通常 (1, 2) 或 (1, 3) 是一个很好的起点,需要通过实验来权衡效果和性能。
Word2Vec
是什么?
Word2Vec 是 Google 在 2013 年推出的一种词嵌入(Word Embedding) 技术。它的核心思想是:“一个词的含义可以由它周围的词来定义”(分布式假设)。
简单来说,Word2Vec 通过分析大量文本,将每个单词映射到一个固定长度的向量(通常是几百维),使得语义相近的单词在向量空间中的位置也相近。
核心思想类比:
想象一下社交网络:
- 如果你和某个人有大量共同好友,那么你们很可能属于同一个圈子(语义相近)
- Word2Vec 做的就是类似的事情:通过单词的"邻居"(上下文)来学习它的"社交关系"(向量表示)
能做什么?
- 语义相似度计算:找到与给定词意思相近的词(“手机”≈“移动电话”)
- 词语类比推理:解决"国王 - 男人 + 女人 = ?"这类问题(首尔:韩国 ≈ 东京:日本)
- 文本特征提取:作为机器学习模型的输入特征
- 文档分类:通过词向量的平均或组合表示整篇文档
- 推荐系统:将物品视为"词",用户行为序列视为"句子"
局限:静态词向量无法处理一词多义(“苹果”公司 vs 水果),也无法利用上下文动态变化;无法处理训练时未出现的新词, 需要大规模语料才能训练出高质量词向量,后续 BERT 等上下文模型能解决这点,但 Word2Vec 训练更快、资源更省,仍然非常实用。
Word2Vec 的两种模型架构
- CBOW (Continuous Bag-of-Words)
- 目标:通过上下文预测当前词
- 特点:训练速度快,对高频词效果更好
- 比喻:给你一句话的上下文,让你猜中间缺失的词
- Skip-gram
- 目标:通过当前词预测上下文
- 特点:对低频词效果更好,能更好地处理稀有词
- 比喻:给你一个词,让你猜它周围可能出现的词
怎么用?
环境准备
# 环境准备
pip install gensim jieba
训练流程与关键超参
- 准备语料:足够大且与任务同域(中文需分词)
- 分词&清洗:大小写统一、去除多余符号、可选择去停用词/数值归一化
- 训练:选择 CBOW/Skip-gram、窗口大小、维度等
- 评估与可视化:近邻词、类比题、下游验证
- 保存与复用:.save() 或导出 .kv(KeyedVectors)
常用超参(gensim)
| 参数 | 说明 | 推荐值 |
|---|---|---|
| vector_size | 词向量的维度 | 100–300 常见,更高维=更好表达但更耗资源 |
| window | 上下文窗口大小 | 5–10 常见;大窗口更偏语义,小窗口更偏句法 |
| min_count | 最低词频(过滤噪声) | 5-10 |
| sg | 训练算法:0=CBOW,1=Skip-gram | 根据需求选择 |
| negative | 负采样个数 | 5–15 |
| hs | 损失函数:0=负采样, 1=用层次 Softmax(与 negative 二选一) | 0(负采样) |
| sample | 高频词的下采样阈值 | 1e-3~1e-5 |
| epochs | 训练轮数 | 5–20 常见 |
| workers | 并行线程数 | CPU核心数 |
示例:训练中文词向量
#################### 训练中文词向量 ####################

from gensim.models import Word2Vec
from gensim.models.word2vec import LineSentence
import jieba
import multiprocessing

# 1. 准备训练数据(这里使用简单示例,实际应用中需大量文本)
corpus = [
    "机器学习是人工智能的一个重要分支",
    "深度学习是机器学习的一个子领域",
    "自然语言处理是人工智能的一个应用方向",
    "计算机视觉让机器能够看懂世界",
    "强化学习通过试错来学习最优策略"
]

# 2. 中文分词处理
seg_corpus = []
for text in corpus:
    words = jieba.cut(text)
    seg_corpus.append(list(words))

print("分词结果:", seg_corpus)

# 3. 训练 Word2Vec 模型
model = Word2Vec(
    sentences=seg_corpus,      # 分好词的文本
    vector_size=100,           # 词向量维度
    window=5,                  # 上下文窗口大小
    min_count=1,               # 忽略出现次数少于min_count的词
    workers=multiprocessing.cpu_count(),  # 使用多核加速
    sg=1                       # 1=Skip-gram, 0=CBOW
)

# 4. 保存模型
model.save("word2vec.model")

# 5. 使用模型
# 查找相似词
print("\n与'机器学习'最相似的词:")
similar_words = model.wv.most_similar('机器学习', topn=3)
for word, score in similar_words:
    print(f"{word}: {score:.4f}")

# 计算词向量相似度
similarity = model.wv.similarity('机器学习', '深度学习')
print(f"\n'机器学习'与'深度学习'的相似度: {similarity:.4f}")

# 词语类比:中国 - 北京 + 东京 = ?
result = model.wv.most_similar(positive=['中国', '东京'], negative=['北京'], topn=3)
print(f"\n中国 - 北京 + 东京 ≈ {result[0][0]} (相似度: {result[0][1]:.4f})")

# 获取词向量
vector = model.wv['机器学习']
print(f"\n'机器学习'的词向量维度: {vector.shape}")
print(f"前10个维度值: {vector[:10]}")


# 使用预训练模型
# 加载预训练模型(需要先下载)
# 中文预训练模型可以从 https://github.com/Embedding/Chinese-Word-Vectors 下载
from gensim.models import KeyedVectors

# 加载预训练词向量(示例使用二进制格式)
# pretrained_model = KeyedVectors.load_word2vec_format('zh.wikipedia.word2vec.300d.bin', binary=True)

# 使用方式与上面相同
# similar_words = pretrained_model.most_similar('机器学习', topn=5)
示例:训练大规模语料
#################### 训练大规模语料 ####################
from gensim.models import Word2Vec
import logging

# 设置日志
logging.basicConfig(format='%(asctime)s : %(levelname)s : %(message)s', level=logging.INFO)

# 使用 LineSentence 读取大文件(每行一个句子,已分好词)
# sentences = LineSentence('corpus.txt')

# 训练模型
model = Word2Vec(
    sentences=seg_corpus,  # 替换为 sentences 可处理大文件
    vector_size=300,
    window=5,
    min_count=5,
    workers=multiprocessing.cpu_count(),
    epochs=10,             # 迭代次数
    sample=1e-5,           # 下采样频繁词
    hs=0,                  # 0=使用负采样, 1=使用层次softmax
    negative=5,            # 负采样数量
)

# 保存模型
model.save('word2vec_large.model')
增强推荐系统
# 将用户浏览历史视为"句子",商品视为"词"
user_history = [
    ['手机', '耳机', '充电宝'],
    ['书本', '钢笔', '笔记本'],
    ['牛奶', '面包', '鸡蛋']
]

# 训练Word2Vec模型
model = Word2Vec(user_history, vector_size=50, window=3, min_count=1)

# 获取商品相似度
similar_products = model.wv.most_similar('手机', topn=5)
print("买了手机的用户也可能喜欢:", [product for product, score in similar_products])
文档分类
import numpy as np
from sklearn.svm import SVC

# 将文档中的所有词向量取平均,作为文档向量
def get_document_vector(model, words):
    vectors = [model.wv[word] for word in words if word in model.wv]
    if len(vectors) > 0:
        return np.mean(vectors, axis=0)
    else:
        return np.zeros(model.vector_size)

# 准备训练数据
documents = [['机器学习', '算法', '模型'], ['文学', '小说', '诗歌']]
labels = [0, 1]  # 0=科技, 1=文学

# 训练Word2Vec
model = Word2Vec(documents, vector_size=100, window=5, min_count=1)

# 获取文档向量
X = [get_document_vector(model, doc) for doc in documents]

# 训练分类器
clf = SVC()
clf.fit(X, labels)

# 预测新文档
new_doc = ['人工智能', '神经网络']
new_vector = get_document_vector(model, new_doc)
prediction = clf.predict([new_vector])
print("文档类别:", "科技" if prediction[0] == 0 else "文学")
Word2Vec 和 Embedding 到底是什么关系?是不是一回事?
Embedding 是一种技术思想和目标,是方法论。【“交通工具”】
Embedding(嵌入) 是一个统称,指的是把离散的符号(如单词、用户ID、商品ID)映射为连续的低维向量表示。
用更直白的话说:
任何“索引表 + 向量矩阵”的方式,都可以叫 Embedding。
在深度学习框架里,nn.Embedding(PyTorch)、Embedding(Keras/TensorFlow)就是一个 可训练的查表层,输入离散索引 → 输出连续向量。
Word2Vec 是实现这个目标的一种具体、著名的方法。【“汽车”】
- Word2Vec 是一种具体的 Embedding 学习方法,它用 CBOW / Skip-gram + 负采样/层次 Softmax 来训练词向量。
- 训练完成后,Word2Vec 给你一个词表和对应的向量矩阵,本质就是一个 词的 embedding 表。
也就是说:
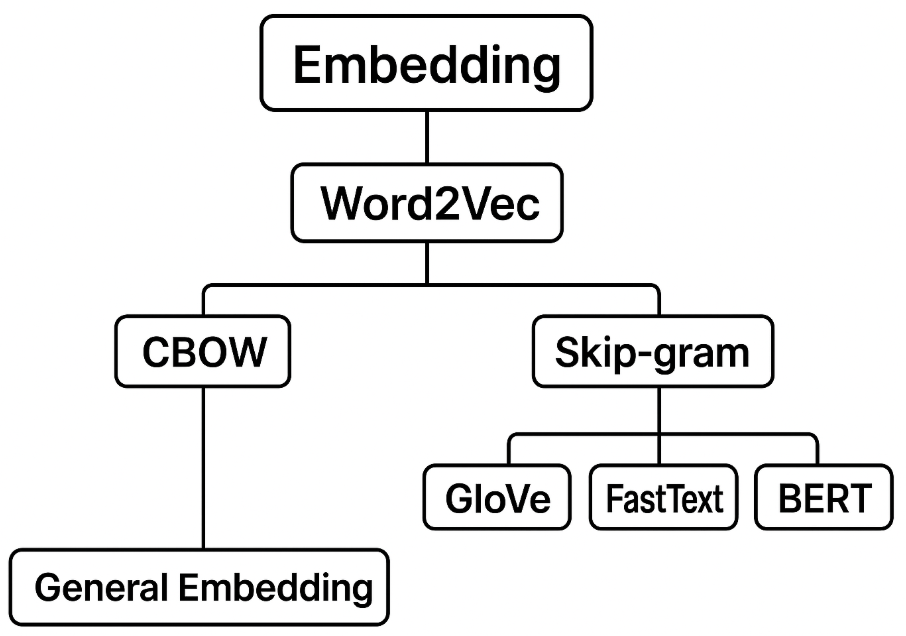
- Word2Vec ⊂ Embedding
- Word2Vec 训练好的词向量 = 一种 Embedding 表达。
关系图:
二者的区别
| 对比点 | Word2Vec | Embedding(泛指) |
|---|---|---|
| 范围 | 只针对“词”的表示方法 | 可以表示任何离散ID(词、用户、商品、标签…) |
| 来源 | 用无监督语料训练得到(预测上下文/中心词) | 可以随机初始化,在下游任务中端到端训练 |
| 是否固定 | 训练好后常作为预训练词向量加载 | 可以随模型一起继续更新 |
| 典型框架 | gensim、原版C代码 | PyTorch / TF 内置层 |
| 是否动态 | 静态词向量(一词一向量) | 既可以是静态,也可以是上下文动态(BERT里的embedding会随句子变化) |
代码示例:从不同角度看
假设我们有这样一段文本,我们想得到单词“king”的向量表示。
- 使用 Word2Vec 算法实现 Embedding:
from gensim.models import Word2Vec

# 训练语料
sentences = [["king", "is", "a", "man"], ["queen", "is", "a", "woman"], ...]

# 使用 Word2Vec 这个【具体算法】来学习【词嵌入】
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, sg=1)

# 获取单词 "king" 的【嵌入向量】
king_vector = model.wv['king']
print(king_vector) # 输出一个100维的稠密向量
- 使用另一种算法(如GloVe)实现同样的 Embedding 目标:
(注意:Gensim库也支持加载GloVe模型)
from gensim.models import KeyedVectors

# 加载预先用 GloVe【算法】训练好的【词嵌入】模型
glove_model = KeyedVectors.load_word2vec_format('glove.6B.100d.txt', binary=False)

# 同样获取单词 "king" 的【嵌入向量】
king_vector_glove = glove_model['king']
- 在推荐系统中,为商品学习 Embedding(概念相同,对象不同):
# 假设我们将每个用户的购买序列看做一个“句子”,商品看做“词”
user_purchase_sequences = [
    ['item_A', 'item_B', 'item_C'],
    ['item_D', 'item_A', 'item_E'],
    ...
]

# 我们依然可以使用 Word2Vec 的【思想】来学习【商品嵌入】
item_model = Word2Vec(user_purchase_sequences, vector_size=50, window=3, min_count=1)

# 获取商品 "item_A" 的【嵌入向量】
item_a_vector = item_model.wv['item_A']
结论
所以,不要将Word2Vec等同于Embedding。
- 当你在说 Embedding 时,你是在说 “我们需要一种用向量表示事物并捕捉其关系的方法”。
- 当你在说 Word2Vec 时,你是在说 “我们使用Word2Vec这个特定工具来生成词向量”。
从零实现 Skip-gram + 负采样 + 可视化(PyTorch 简化版)
# pip install torch matplotlib scikit-learn
import torch
import torch.nn as nn
import random
from collections import Counter
import math

import matplotlib.pyplot as plt
from sklearn.manifold import TSNE

# -----------------------------
# 1) 构建训练语料与样本
# -----------------------------

# 一个极小的示例语料,每句话是分好词的 list
corpus = [["我","爱","机器学习"], ["机器","学习","很好玩"], ["深度","学习","很","强大"]]

# 统计词频,构建词表
vocab = Counter([w for s in corpus for w in s])
idx2word = [w for w,c in vocab.items() if c>=1]  # 词表(按出现顺序)
word2idx = {w:i for i,w in enumerate(idx2word)}  # 词 → 索引映射
V = len(idx2word)                                # 词表大小

# 构造中心词-上下文词的训练对 (c, o)
pairs = []
window = 2  # 窗口大小:每个中心词取前后 2 个词为上下文
for sent in corpus:
    idxs = [word2idx[w] for w in sent]  # 把句子转成索引序列
    for i, c in enumerate(idxs):       # 遍历句子中的每个词作为中心词
        for j in range(max(0, i-window), min(len(idxs), i+window+1)):
            if j!=i:                   # 跳过中心词本身
                pairs.append((c, idxs[j]))  # 保存 (中心词, 上下文词)

# 为负采样准备分布:词频^0.75(论文推荐)
pow_freq = [vocab[idx2word[i]]**0.75 for i in range(V)]
Z = sum(pow_freq)  # 归一化因子
neg_prob = [f/Z for f in pow_freq]  # 每个词的采样概率

# 简单负采样函数:从词表中按 neg_prob 分布采 K 个词
def sample_negative(k):
    return torch.multinomial(torch.tensor(neg_prob), k, replacement=True).tolist()

# -----------------------------
# 2) 定义模型
# -----------------------------

embed_dim = 50  # 词向量维度

# 输入词向量矩阵:中心词用这个 embedding 查向量
in_embed = nn.Embedding(V, embed_dim)

# 输出词向量矩阵:上下文词用这个 embedding 查向量
out_embed = nn.Embedding(V, embed_dim)

# Skip-gram + 负采样的损失函数
def sg_neg_loss(center, context, K=5):
    """
    center: [B] 中心词索引
    context: [B] 上下文词索引
    K: 每个样本采多少个负样本
    """
    bsz = center.size(0)                      # batch 大小
    v_c = in_embed(center)                    # [B, D] 中心词向量
    u_o = out_embed(context)                  # [B, D] 上下文词向量

    # 正样本损失:log σ(v_c · u_o)
    pos_loss = torch.log(torch.sigmoid((v_c * u_o).sum(dim=1)))

    # 负样本:随机采 K 个词
    negs = [sample_negative(K) for _ in range(bsz)]  # [[K], [K], ...]
    negs = torch.tensor(negs, dtype=torch.long)      # [B, K]
    u_k = out_embed(negs)                            # [B, K, D]

    # 对负样本的损失:log σ(-v_c · u_k)
    # v_c.unsqueeze(1) -> [B,1,D] 与 [B,K,D] 相乘 -> [B,K]
    neg_loss = torch.log(torch.sigmoid(-(v_c.unsqueeze(1) * u_k).sum(dim=2))).sum(dim=1)

    # 总损失 = -(正样本 + 负样本),取平均
    return -(pos_loss + neg_loss).mean()

# -----------------------------
# 3) 训练
# -----------------------------

# 优化器:同时优化 in_embed 和 out_embed 的参数
opt = torch.optim.Adam(list(in_embed.parameters())+list(out_embed.parameters()), lr=1e-3)

batch = 16   # batch size
epochs = 200 # 训练轮数

# 把 (c,o) pair 转成 tensor 格式,方便训练
data = [(torch.tensor(c), torch.tensor(o)) for c,o in pairs]

for ep in range(epochs):
    random.shuffle(data)  # 每个 epoch 打乱训练样本
    for i in range(0, len(data), batch):
        batch_pairs = data[i:i+batch]                 # 取一个 batch
        c = torch.stack([p[0] for p in batch_pairs])  # [B]
        o = torch.stack([p[1] for p in batch_pairs])  # [B]
        loss = sg_neg_loss(c, o, K=5)                 # 计算 loss
        opt.zero_grad()                               # 梯度清零
        loss.backward()                               # 反向传播
        opt.step()                                    # 参数更新
    if (ep+1)%50==0:  # 每隔 50 轮打印一次损失
        print(f"epoch {ep+1} loss={loss.item():.4f}")

# -----------------------------
# 4) 使用训练好的词向量
# -----------------------------

# 通常做法:取 in_embed 和 out_embed 相加,得到最终的词向量
embeddings = in_embed.weight.data + out_embed.weight.data

# 定义相似词查询函数(基于余弦相似度)
def most_similar(word, topn=5):
    if word not in word2idx: return []
    wv = embeddings[word2idx[word]]  # 当前词的向量
    sims = torch.nn.functional.cosine_similarity(wv.unsqueeze(0), embeddings)
    idxs = torch.topk(sims, k=min(topn+1, V)).indices.tolist()  # 取 topN
    return [(idx2word[i], float(sims[i])) for i in idxs if idx2word[i]!=word][:topn]

# 测试:查询与“学习”最相似的词
print(most_similar("学习"))


# 取最终 embeddings
X = embeddings.numpy()

# 用 t-SNE 将高维向量降到 2D
tsne = TSNE(n_components=2, random_state=42, init="pca", learning_rate="auto")
X_2d = tsne.fit_transform(X)

# 设置中文字体(Windows 一般用 SimHei,Mac 用 PingFang/Heiti)
plt.rcParams['font.sans-serif'] = ['SimHei']   # 黑体
plt.rcParams['axes.unicode_minus'] = False     # 正常显示负号
# 绘制散点图
plt.figure(figsize=(8, 6))
plt.scatter(X_2d[:, 0], X_2d[:, 1], alpha=0.7)

# 在点旁边加上词语
for i, word in enumerate(idx2word):
    plt.text(X_2d[i, 0] + 0.02, X_2d[i, 1] + 0.02, word, fontsize=12)

plt.title("Word2Vec Skip-gram Embeddings 可视化 (t-SNE)", fontsize=14)
plt.show()
############################# 输出: #####################################

epoch 50 loss=6.0417
epoch 100 loss=5.8905
epoch 150 loss=2.7959
epoch 200 loss=2.0941
[('很好玩', 0.210693359375), ('爱', 0.08076764643192291), ('机器学习', 0.06475493311882019), ('我', -0.010878738015890121), ('机器', -0.044963665306568146)]
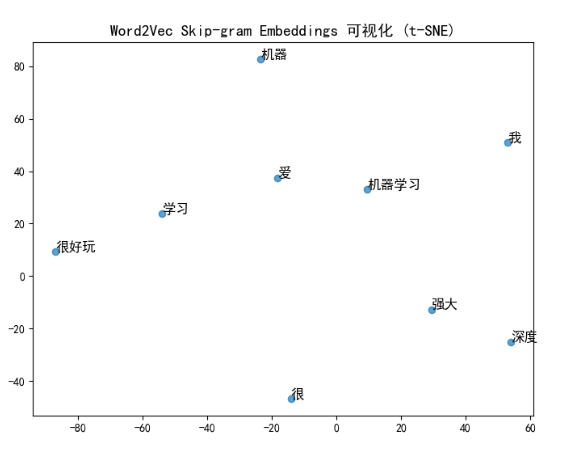
用 t-SNE 把学到的词向量降到 2D,并画图展示不同词的分布
plt.show() 图如下:
向量数据库
向量数据库是一类专门用于存储、索引和快速检索高维向量(embeddings)的数据库。现代 NLP/视觉/语音模型会把文本、图片等转换为固定长度的浮点向量(embedding),向量数据库的任务是高效地完成近似或精确最近邻搜索(ANN / k-NN)、管理元数据、以及支持批量写入/查询和持久化等功能。它优化了大规模(百万到十亿量级)向量的存储与检索,提供低延迟、可扩展性的查询。
常见向量数据库:
- FAISS(Facebook AI Similarity Search)
源 C++ 库,带 Python 包装,擅长在单机(CPU/GPU)上做高性能相似度搜索与聚类。提供多种索引结构(Flat、IVF、PQ、HNSW、OPQ、GPU 加速等),适合研究与自部署场景。对大规模离线索引、参数调优非常灵活。 - Milvus
开源的分布式向量数据库(由 Zilliz 维护),强调可水平扩展 / 集群 / 高可用,并整合存储引擎、持久化、副本、分区等数据库特性,适合生产级大规模部署。它也支持多种索引类型并能与数据库/搜索生态集成。 - Pinecone
商业托管向量数据库(SaaS),强调“开发者体验”和托管运维:自动扩容、索引管理、向量 + 元数据混合搜索、混合 dense+sparse 搜索等。适合不想操心基础设施的团队。 - Weaviate
| 方面 | FAISS | Milvus | Pinecone |
|---|---|---|---|
| 部署 | 本地/自建(库/服务) | 集群/自建 & 云 | 托管 SaaS |
| 横向扩展 | 需自建 | 原生支持 | 提供 |
| 适合 | 研究/自定义调优 | 大规模生产 | 快速上手 & 省运维 |
| 许可证/付费 | 开源 | 开源 | 商业 |
向量数据库 vs 传统关系型/文档型数据库
| 特性 | 向量数据库 | 关系型数据库 (RDBMS,如 MySQL、PostgreSQL) | 文档型数据库 (如 MongoDB, CouchDB) |
|---|---|---|---|
| 数据模型 | 高维浮点向量 + 元数据 | 表格 (行/列) | JSON/BSON 文档 |
| 典型用途 | 语义检索、推荐、图像/音频/文本相似度搜索 | 事务型应用、财务、订单、库存、CRM | 半结构化数据存储,灵活 schema,Web/日志/IoT |
| 查询方式 | 近似最近邻 (ANN)、相似度 (余弦、内积、L2 距离) | SQL (精确匹配、JOIN、聚合) | 文档查询 (key-value, 嵌套字段、索引) |
| 索引结构 | HNSW、IVF、PQ、LSH 等 | B+ 树、Hash、GiST | 倒排索引、B 树 |
| 检索目标 | 找“最相似”的对象(模糊/语义匹配) | 找“完全匹配”或范围内的数据 | 找符合字段条件的文档 |
| 事务/一致性 | 一般弱事务支持(部分支持 ACID,但有限) | 强 ACID 支持 | 弱事务,通常最终一致性 |
| 性能优化重点 | 高维向量存储、压缩、并行检索、GPU 加速 | 查询优化器、索引、事务隔离 | 水平扩展、索引灵活性 |
| 扩展性 | 专门设计支持大规模 embedding (百万~十亿向量) | 垂直扩展为主,也支持分片/集群 | 原生水平扩展,支持分布式存储 |
| 应用场景 | 智能搜索、推荐系统、对话系统、抄袭检测、RAG | 银行、ERP、交易、财务、库存管理 | 日志系统、内容管理、应用后端、IoT |
FAISS 工具使用(核心思路 + Python 示例)
运行前安装依赖(在 shell 中):
pip install faiss-cpu sentence-transformers numpy
(如果你有 GPU,也可安装 faiss-gpu)
# faiss_example.py
import numpy as np
import faiss
from sentence_transformers import SentenceTransformer

# 1) 准备数据与 embedding 模型
docs = [
    "机器学习是一门研究如何让计算机从数据中学习的学科。",
    "深度学习使用神经网络来解决复杂问题。",
    "向量数据库用于高效检索 embedding。",
    "Python 是数据工程常用语言。",
    "向量数据库是一类专门用于存储、索引和快速检索高维向量(embeddings)的数据库"
]
model = SentenceTransformer(r"C:\Users\henry.xiao\.cache\modelscope\hub\models\sentence-transformers\all-MiniLM-L6-v2")  # 小快模型
embs = model.encode(docs, convert_to_numpy=True, show_progress_bar=False)


# 2) 归一化(用于余弦相似度)
def normalize(x):
    norms = np.linalg.norm(x, axis=1, keepdims=True)
    return x / (norms + 1e-10)


embs = normalize(embs).astype('float32')

# 3) 建立 FAISS 索引(IndexFlatIP 用内积查找,结合上面的归一化即可实现余弦)
d = embs.shape[1]
index = faiss.IndexFlatIP(d)  # 精确索引(适合小数据)
index.add(embs)  # 添加向量

# 4) 查询
query = "向量数据库是一类专门用于存储、索引和快速检索高维向量(embeddings)的数据库"
q_emb = model.encode([query], convert_to_numpy=True)
q_emb = normalize(q_emb).astype('float32')
k = len(docs)
distances, indices = index.search(q_emb, k)
print("Query:", query)
for score, idx in zip(distances[0], indices[0]):
    print(f"score={float(score):.4f}\t doc={docs[idx]}")
## 输出,跟query完全一样的才会输出1,
Query: 向量数据库是一类专门用于存储、索引和快速检索高维向量(embeddings)的数据库
score=1.0000	 doc=向量数据库是一类专门用于存储、索引和快速检索高维向量(embeddings)的数据库
score=0.8792	 doc=向量数据库用于高效检索 embedding。
score=0.4447	 doc=机器学习是一门研究如何让计算机从数据中学习的学科。
score=0.3324	 doc=深度学习使用神经网络来解决复杂问题。
score=0.2711	 doc=Python 是数据工程常用语言。
Query: 向量数据库是一类专门用于存储、索引和快速检索高维向量的数据库
score=0.6720	 doc=向量数据库用于高效检索 embedding。
score=0.6536	 doc=向量数据库是一类专门用于存储、索引和快速检索高维向量(embeddings)的数据库
score=0.6118	 doc=机器学习是一门研究如何让计算机从数据中学习的学科。
score=0.5022	 doc=深度学习使用神经网络来解决复杂问题。
score=0.4182	 doc=Python 是数据工程常用语言。

######## #### #### ####  原因分析:#### #### #### #### #### #### ####
"向量数据库是一类专门用于存储、索引和快速检索高维向量的数据库"
而 doc[4] 是
"向量数据库是一类专门用于存储、索引和快速检索高维向量(embeddings)的数据库"
差别:doc[4] 有个 括号里的“embeddings”。
轻量模型 all-MiniLM-L6-v2 对中英文混合、括号符号、专业术语不太稳健,结果可能会导致:
Query 与 doc[4] 没能完全对齐(模型可能弱化了括号部分),
Query 与 doc[2] 的简短句子反而得到更高分(因为更“泛化”)。
文本抄袭自动检测(思路 + 实现示例)
使用Embedding相似查找工具Faiss:
- 文本特征提取 => 计算TF-IDF
- 使用Faiss精确查找IndexFlatL2
- 向index添加数据index.add(data)
- 指定cpindex=3352,查找相似的TopN篇文章
# 导入必要的库
import re  # 正则表达式库,用于文本处理
import numpy as np  # 数值计算库
import pandas as pd  # 数据处理库
import jieba  # 中文分词库
from sklearn.feature_extraction.text import CountVectorizer, TfidfTransformer  # 文本特征提取
from sklearn.model_selection import train_test_split, cross_validate  # 数据集分割和交叉验证
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score  # 评估指标
from sklearn.naive_bayes import MultinomialNB  # 朴素贝叶斯分类器
from sklearn.metrics.pairwise import cosine_similarity  # 余弦相似度计算
import pickle  # 序列化/反序列化工具
from tqdm import tqdm  # 进度条显示
from pprint import pprint  # 美化输出
import os  # 操作系统接口

# 加载停用词表
with open('chinese_stopwords.txt','r', encoding='utf-8') as file:
    stopwords=[i[:-1] for i in file.readlines()]  # 读取停用词并去除每行末尾的换行符

# 加载新闻数据集
news = pd.read_csv('sqlResult.csv',encoding='utf-8')  # 读取CSV文件
print(news.shape)  # 输出数据集形状
print(news.head(5))  # 输出前5行数据

# 处理缺失值
print(news[news.content.isna()].head(5))  # 输出内容为空的新闻
news=news.dropna(subset=['content'])  # 删除内容为空的行
print(news.shape)  # 输出处理后的数据集形状

# 定义分词函数
def split_text(text):
    text = text.replace(' ', '')  # 去除空格
    text = text.replace('\n', '')  # 去除换行符
    text2 = jieba.cut(text.strip())  # 使用jieba进行中文分词
    result = ' '.join([w for w in text2 if w not in stopwords])  # 去除停用词并用空格连接
    return result

# 测试分词函数
print(news.iloc[0].content)  # 输出第一条新闻内容
print(split_text(news.iloc[0].content))  # 输出分词后的结果

# 检查是否已存在处理好的语料库文件
if not os.path.exists("corpus.pkl"):
    # 对所有文本进行分词处理
    corpus=list(map(split_text,[str(i) for i in news.content]))
    print(corpus[0])  # 输出第一条处理后的文本
    print(len(corpus))  # 输出语料库大小
    print(corpus[1])  # 输出第二条处理后的文本
    # 保存处理结果到文件
    with open('corpus.pkl','wb') as file:
        pickle.dump(corpus, file)
else:
    # 如果已存在处理结果,直接加载
    with open('corpus.pkl','rb') as file:
        corpus = pickle.load(file)

# 创建TF-IDF特征矩阵
countvectorizer = CountVectorizer(encoding='gb18030',min_df=0.015)  # 初始化计数向量器,设置最小文档频率
tfidftransformer = TfidfTransformer()  # 初始化TF-IDF转换器

countvector = countvectorizer.fit_transform(corpus)  # 将文本转换为词频矩阵
print(countvector.shape)  # 输出词频矩阵形状

tfidf = tfidftransformer.fit_transform(countvector)  # 将词频矩阵转换为TF-IDF矩阵
print(tfidf.shape)  # 输出TF-IDF矩阵形状

# 创建标签:1表示新华社新闻,0表示其他来源
label=list(map(lambda source: 1 if '新华' in str(source) else 0,news.source))

# 分割训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(tfidf.toarray(), label, test_size = 0.3, random_state=42)
clf = MultinomialNB()  # 初始化朴素贝叶斯分类器
clf.fit(X=X_train, y=y_train)  # 训练模型

# 预测测试集
y_predict = clf.predict(X_test)

# 定义评估函数
def show_test_reslt(y_true,y_pred):
    print('accuracy:',accuracy_score(y_true,y_pred))  # 准确率
    print('precison:',precision_score(y_true,y_pred))  # 精确率
    print('recall:',recall_score(y_true,y_pred))  # 召回率
    print('f1_score:',f1_score(y_true,y_pred))  # F1分数

# 显示评估结果
show_test_reslt(y_test, y_predict)

# 使用模型检测所有新闻
prediction = clf.predict(tfidf.toarray())
labels = np.array(label)
# 创建预测结果和真实标签的DataFrame
compare_news_index = pd.DataFrame({'prediction':prediction,'labels':labels})
# 找出预测为新华社但实际不是的新闻索引(可能抄袭)
copy_news_index=compare_news_index[(compare_news_index['prediction'] == 1) & (compare_news_index['labels'] == 0)].index
# 找出真实的新华社新闻索引
xinhuashe_news_index=compare_news_index[(compare_news_index['labels'] == 1)].index
print('可能为Copy的新闻条数:', len(copy_news_index))  # 输出可能抄袭的新闻数量

# 检查是否已存在聚类标签文件
if not os.path.exists("label.pkl"):
    # 使用K-means对文章进行聚类
    from sklearn.preprocessing import Normalizer
    from sklearn.cluster import KMeans
    normalizer = Normalizer()  # 初始化归一化器
    scaled_array = normalizer.fit_transform(tfidf.toarray())  # 归一化TF-IDF矩阵

    # 使用K-Means进行聚类
    kmeans = KMeans(n_clusters=25,random_state=42)
    k_labels = kmeans.fit_predict(scaled_array)  # 获取聚类标签
    # 保存聚类结果
    with open('label.pkl','wb') as file:
        pickle.dump(k_labels, file)
    print(k_labels.shape)  # 输出聚类标签形状
    print(k_labels[0])  # 输出第一个聚类标签
else:
    # 加载已有的聚类结果
    with open('label.pkl','rb') as file:
        k_labels = pickle.load(file)

# 检查是否已存在ID到类的映射文件
if not os.path.exists("id_class.pkl"):
    # 创建索引到类别的映射字典
    id_class = {index:class_ for index, class_ in enumerate(k_labels)}
    # 保存映射关系
    with open('id_class.pkl','wb') as file:
        pickle.dump(id_class, file)
else:
    # 加载已有的映射关系
    with open('id_class.pkl','rb') as file:
        id_class = pickle.load(file)

# 检查是否已存在类到ID的映射文件
if not os.path.exists("class_id.pkl"):
    from collections import defaultdict
    # 创建类别到索引集合的映射字典(只包含新华社新闻)
    class_id = defaultdict(set)
    for index,class_ in id_class.items():
        if index in xinhuashe_news_index.tolist():  # 只处理新华社新闻
            class_id[class_].add(index)
    # 保存映射关系
    with open('class_id.pkl','wb') as file:
        pickle.dump(class_id, file)
else:
    # 加载已有的映射关系
    with open('class_id.pkl','rb') as file:
        class_id = pickle.load(file)

# 输出每个聚类中的文档数量
count=0
for k in class_id:
    print(count, len(class_id[k]))
    count +=1

# 定义查找相似文本的函数
def find_similar_text(cpindex, top=10):
    # 计算与同一类中所有新华社新闻的余弦相似度
    dist_dict={i:cosine_similarity(tfidf[cpindex],tfidf[i]) for i in class_id[id_class[cpindex]]}
    # 按相似度降序排序并返回前top个结果
    return sorted(dist_dict.items(),key=lambda x:x[1][0], reverse=True)[:top]

import editdistance  # 导入编辑距离计算库

# 指定要检查的新闻索引
cpindex = 3352  # 在copy_news_index中的索引

# 查找相似新闻
similar_list = find_similar_text(cpindex)
print(similar_list)  # 输出相似新闻列表
print('怀疑抄袭:\n', news.iloc[cpindex].content)  # 输出怀疑抄袭的新闻内容

# 获取最相似的原文
similar2 = similar_list[0][0]
print('相似原文:\n', news.iloc[similar2].content)  # 输出相似原文内容

# 计算两篇新闻的编辑距离
print('编辑距离:',editdistance.eval(corpus[cpindex], corpus[similar2]))

# 定义查找相似句子的函数
def find_similar_sentence(candidate, raw):
    similist = []
    cl = candidate.strip().split('。')  # 按句号分割候选文本
    ra = raw.strip().split('。')  # 按句号分割原始文本
    # 计算所有句子对之间的编辑距离
    for c in cl:
        for r in ra:
            similist.append([c,r,editdistance.eval(c,r)])
    # 按编辑距离排序并获取最相似的5个句子对
    sort=sorted(similist,key=lambda x:x[2])[:5]
    # 输出相似句子对
    for c,r,ed in sort:
        if c!='' and r!='':
            print('怀疑抄袭句:{0}\n相似原句:{1}\n 编辑距离:{2}\n'.format(c,r,ed))

# 比较抄袭新闻和相似原文的句子
find_similar_sentence(news.iloc[cpindex].content, news.iloc[similar2].content)
############ 控制台输出:#################################
怀疑抄袭:
   中国5月份56座城市新建商品住宅价格环比上涨,4月份为58座上涨。5月份15个一线和热点二线城市房地产市场基本稳定,5月份房地产调控政策效果继续显现。
  统计局:15个一线和热点二线城市房价同比涨幅全部回落
  国家统计局城市司高级统计师刘建伟解读5月份房价数据
  5月份一二线城市房价平均涨幅继续回落
  国家统计局今日发布了2017年5月份70个大中城市住宅销售价格统计数据。对此,国家统计局城市司高级统计师刘建伟进行了解读。
  一、15个一线和热点二线城市新建商品住宅价格同比涨幅全部回落、9个城市环比下降或持平
  5月份,因地制宜、因城施策的房地产调控政策效果继续显现,15个一线和热点二线城市房地产市场基本稳定。从同比看,15个城市新建商品住宅价格涨幅均比上月回落,回落幅度在0.5至6.4个百分点之间。从环比看,9个城市新建商品住宅价格下降或持平;5个城市涨幅在0.5%以内。
  二、70个大中城市中一二线城市房价同比涨幅持续回落
  5月份,70个城市中新建商品住宅和二手住宅价格同比涨幅比上月回落的城市分别有29和18个。其中,一二线城市同比涨幅回落尤其明显。据测算,一线城市新建商品住宅和二手住宅价格同比涨幅均连续8个月回落,5月份比4月份分别回落2.2和1.7个百分点;二线城市新建商品住宅和二手住宅价格同比涨幅分别连续6个月和4个月回落,5月份比4月份分别回落0.8和0.5个百分点。
  三、70个大中城市中房价环比下降及涨幅回落城市个数均有所增加
  5月份,70个城市中新建商品住宅价格环比下降的城市有9个,比上月增加1个;涨幅回落的城市有26个,比上月增加3个。二手住宅价格环比下降的城市有7个,比上月增加2个;涨幅回落的城市有30个,比上月增加8个。

相似原文:
   国家统计局19日发布数据,5月份,15个一线和热点二线城市新建商品住宅价格同比涨幅全部回落,其中9个城市环比下降或持平。这9个价格环比下降或持平的城市为:北京、上海、南京、杭州、合肥、福州、郑州、深圳、成都。
  “5月份,因地制宜、因城施策的房地产调控政策效果继续显现,15个一线和热点二线城市房地产市场基本稳定。”国家统计局城市司高级统计师刘建伟说,从同比看,15个城市新建商品住宅价格涨幅均比上月回落,回落幅度在0.5至6.4个百分点之间。从环比看,9个城市新建商品住宅价格下降或持平;5个城市涨幅在0.5%以内。
  国家统计局当天还发布了5月份70个大中城市住宅销售价格统计数据。刘建伟介绍,5月份,70个大中城市中新建商品住宅和二手住宅价格同比涨幅比上月回落的城市分别有29和18个。其中,一二线城市同比涨幅回落尤其明显。据测算,一线城市新建商品住宅和二手住宅价格同比涨幅均连续8个月回落,5月份比4月份分别回落2.2和1.7个百分点;二线城市新建商品住宅和二手住宅价格同比涨幅分别连续6个月和4个月回落,5月份比4月份分别回落0.8和0.5个百分点。
  此外,70个大中城市中房价环比下降及涨幅回落城市个数均有所增加。统计显示,5月份,70个大中城市中新建商品住宅价格环比下降的城市有9个,比上月增加1个;涨幅回落的城市有26个,比上月增加3个。二手住宅价格环比下降的城市有7个,比上月增加2个;涨幅回落的城市有30个,比上月增加8个。
思路2:
- 预处理
- 加载停用词表
- 对 content 做分词、去停用词(可选,embedding 模型一般直接用原文也可以,但停用词清理有助于噪声降低)
- 向量化
- 用 SentenceTransformer(比如 m3e-base 或 all-mpnet-base-v2)生成向量
- 存入 FAISS 索引
- 相似度检索
- 输入目标 id,取出文章内容 → 生成 embedding
- 用 FAISS 检索相似文章(排除自己)
- 返回相似度分数 + 原文信息
# plagiarism_check.py
import pandas as pd
import numpy as np
import faiss
import jieba
from sentence_transformers import SentenceTransformer

# 1) 加载停用词表
def load_stopwords(path="chinese_stopwords.txt"):
    with open(path, "r", encoding="utf-8") as f:
        return set([w.strip() for w in f if w.strip()])

stopwords = load_stopwords("chinese_stopwords.txt")

def preprocess(text):
    """中文分词 + 去停用词"""
    words = jieba.cut(text)
    return " ".join([w for w in words if w not in stopwords and w.strip()])

# 2) 读取文章数据
# df = pd.read_csv("sqlResult.csv",encoding="utf-8")
try:
    df = pd.read_csv("sqlResult.csv", encoding="utf-8")
except UnicodeDecodeError:
    df = pd.read_csv("sqlResult.csv", encoding="gbk")  # Windows 默认

# 只取必要字段
df = df[["id", "author", "source", "content", "title", "url"]].dropna(subset=["content"])

# 3) 加载 embedding 模型(推荐更强的中文模型)
model = SentenceTransformer(r"C:\Users\henry.xiao\.cache\modelscope\hub\models\AI-ModelScope\m3e-base")  # 或 all-mpnet-base-v2

# 对所有文章做 embedding
contents = df["content"].apply(preprocess).tolist()
embs = model.encode(contents, convert_to_numpy=True, show_progress_bar=True)
embs = embs / np.linalg.norm(embs, axis=1, keepdims=True)
embs = embs.astype("float32")

# 4) 建立 FAISS 索引
d = embs.shape[1]
index = faiss.IndexFlatIP(d)
index.add(embs)

# 5) 查找可能抄袭的文章
def find_similar(target_id, topk=5, threshold=0.8):
    row = df[df["id"] == target_id]
    if row.empty:
        print(f"❌ 未找到 id={target_id}")
        return

    text = preprocess(row.iloc[0]["content"])
    q_emb = model.encode([text], convert_to_numpy=True)
    q_emb = q_emb / np.linalg.norm(q_emb, axis=1, keepdims=True)
    q_emb = q_emb.astype("float32")

    D, I = index.search(q_emb, topk+1)  # +1 因为会包含自己
    results = []
    for score, idx in zip(D[0], I[0]):
        if df.iloc[idx]["id"] == target_id:
            continue  # 排除自己
        results.append({
            "id": int(df.iloc[idx]["id"]),
            "title": df.iloc[idx]["title"],
            "author": df.iloc[idx]["author"],
            "source": df.iloc[idx]["source"],
            "url": df.iloc[idx]["url"],
            "similarity": float(score)
        })
    # 过滤相似度阈值
    results = [r for r in results if r["similarity"] >= threshold]
    return results

# === 测试 ===
if __name__ == "__main__":
    suspicious = find_similar(3352, topk=10, threshold=0.75)
    print("📑 可能相似/抄袭的文章:")
    for r in suspicious:
        print(f"[{r['similarity']:.3f}] {r['id']} - {r['title']} ({r['author']}, {r['source']})")
        print("   ", r['url'])
############控制台输出##本地CPU跑的,非常慢############# 有结果了,再更新。。。
Batches:  20%|██        | 546/2721 [1:27:32<5:40:42,  9.40s/it]

Batches: 100%|██████████| 2721/2721 [3:48:45<00:00,  5.04s/it]
📑 可能相似/抄袭的文章:
[0.998] 3347 - (香港回归二十周年·香港之美·图文互动)(7)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188437-?pageflag=init&imageOrVedioTypeGdsId=
[0.997] 3342 - (香港回归二十周年·香港之美·图文互动)(11)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188442-?pageflag=init&imageOrVedioTypeGdsId=
[0.997] 3351 - (香港回归二十周年·香港之美·图文互动)(2)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188436-?pageflag=init&imageOrVedioTypeGdsId=
[0.996] 3345 - (香港回归二十周年·香港之美·图文互动)(8)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188439-?pageflag=init&imageOrVedioTypeGdsId=
[0.996] 3349 - (香港回归二十周年·香港之美·图文互动)(4)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188435-?pageflag=init&imageOrVedioTypeGdsId=
[0.996] 3348 - (香港回归二十周年·香港之美·图文互动)(5)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188451-?pageflag=init&imageOrVedioTypeGdsId=
[0.995] 3344 - (香港回归二十周年·香港之美·图文互动)(9)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188445-?pageflag=init&imageOrVedioTypeGdsId=
[0.995] 3341 - (香港回归二十周年·香港之美·图文互动)(12)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188441-?pageflag=init&imageOrVedioTypeGdsId=
[0.995] 3340 - (香港回归二十周年·香港之美·图文互动)(13)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188449-?pageflag=init&imageOrVedioTypeGdsId=
[0.995] 3350 - (香港回归二十周年·香港之美·图文互动)(3)高效、便利、快捷——香港公共交通体验 (王玺, 新华社)
    http://home.xinhua-news.com/gdsdetailxhsnew/2188447-?pageflag=init&imageOrVedioTypeGdsId=

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)