PyTorch 机器学习基础(过拟合与欠拟合)
过拟合与欠拟合
前面已经介绍了机器学习的一般流程,即模型确定后,开始训练模型,然后对模型进
行评估和优化,这个过程往往是循环往复的。在训练模型过程中,经常会出现刚开始训练
时,训练和测试精度不高(或损失值较大),然后通过增加迭代次数或通过优化,训练精
度和测试精度继续提升,如果出现这种情况,当然最好。但随着我们训练迭代次数的增加
或不断优化,也有可能会出现训练精度或损失值继续改善,但测试精度或损失值不降反升
的情况,如图5-4所示。
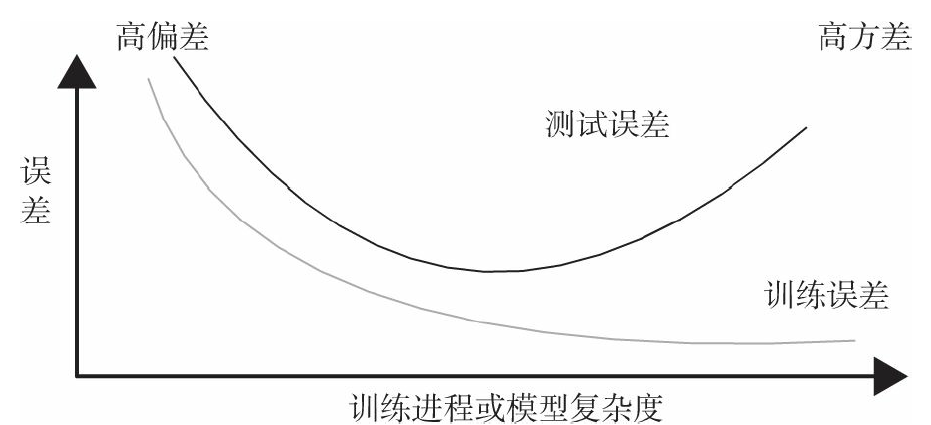
出现这种情况,说明我们的优化过头了,把训练数据中一些无关紧要甚至错误的模式
也学到了。这就是通常说的出现过拟合了。那如何解决这类问题?机器学习中有很多解决
方法,这些方法又统称为正则化,接下来我们介绍一些常用的正则化方法。
权重正则化
如何解决过拟合问题呢?正则化是其中一个有效方法。正则化不仅可以有效地降低高
方差,还有利于降低偏差。那何为正则化?在机器学习中,很多被显式地用来减少测试误
差的策略,统称为正则化。正则化旨在减少泛化误差而不是训练误差。为使大家对正则化
的作用及原理有个直观印象,先看如图5-5所示的正则化示意图。
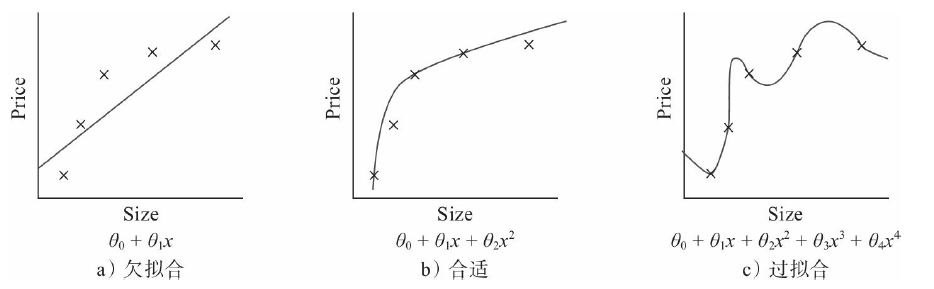
图5-5是根据房屋面积(Size)预测房价(Price)的回归模型。正则化是如何解决模
型过复杂这个问题的呢?主要是通过正则化使参数变小甚至趋于原点。如图5-5c所示,其
模型或目标函数是一个4次多项式,因它把一些噪声数据也包括进来了,所以导致模型很
复杂,实际上房价与房屋面积应该是2次多项式函数,如图5-5b所示。
如果要降低模型的复杂度,可以通过缩减它们的系数来实现,如把第3次、4次项的系
数θ3\theta_3θ3、θ4\theta_4θ4缩减到接近于0即可。
那在算法中如何实现呢?这个得从其损失函数或目标函数着手。
假设房屋价格与面积间模型的损失函数为:
minθ12m∑i=1m(hθ(x(i))−y(i))2\min_{\theta} \frac{1}{2m} \sum_{i=1}^{m} \left( h_{\theta}(x^{(i)}) - y^{(i)} \right)^2θmin2m1i=1∑m(hθ(x(i))−y(i))2
这个损失函数是我们的优化目标,也就是说我们需要尽量减少损失函数的均方误差。
对于这个函数我们对它添加一些正则项,如加上10000乘以θ3\theta_3θ3的平方,再加上10000乘
以θ4\theta_4θ4的平方,得到如下函数:
minθ12m∑i=1m(hθ(x(i))−y(i))2+10000⋅θ32+10000⋅θ42\min_{\theta} \frac{1}{2m} \sum_{i=1}^{m} \left( h_{\theta}(x^{(i)}) - y^{(i)} \right)^2 + 10000 \cdot \theta_3^2 + 10000 \cdot \theta_4^2θmin2m1i=1∑m(hθ(x(i))−y(i))2+10000⋅θ32+10000⋅θ42
这里取10000只是用来代表它是一个“大值”。现在,如果要最小化这个新的损失函数,应要让θ3\theta_3θ3和θ4\theta_4θ4尽可能的小。因为如果你在原有损失函数的基础上加上10000乘以θ3\theta_3θ3这
一项,那么这个新的损失函数将变得很大,所以,当要最小化这个新的损失函数时,将使
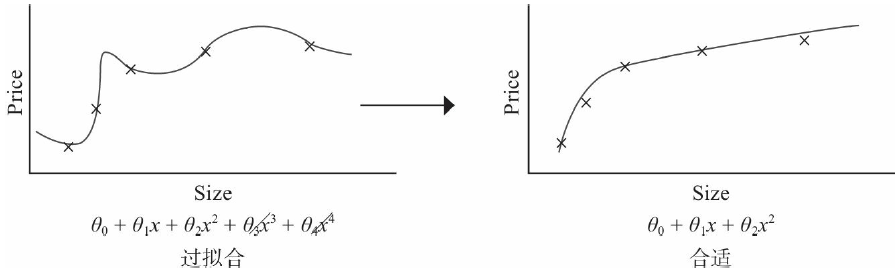
θ3\theta_3θ3的值接近于0,同样θ4\theta_4θ4的值也接近于0,就像我们所忽略的这两个值一样。如果做到这一
点(θ3\theta_3θ3和θ4\theta_4θ4接近于0),那么将得到一个近似的二次函数,如图5-6所示。
希望通过上面的简单介绍,能让读者有个直观理解。传统意义上的正则化一般分为L0,L1,L2,L∞L_{0}, L_{1}, L_{2}, L_{\infty}L0,L1,L2,L∞
PyTorch如何实现正则化呢?这里以实现L2L_{2}L2为例,神经网络的L2L_{2}L2正则化称为权重衰减
(Weight Decay)。torch.optim集成了很多优化器,如SGD、Adadelta、Adam、Adagrad、
RMSprop等,这些优化器自带的一个参数weight_decay,用于指定权值衰减率,相当于L2L_{2}L2
正则化中的λ参数,也就是下式中的λ。
minθ12m∑i=1m(hθ(x(i))−y(i))2+λ∥W∥2\min_{\theta} \frac{1}{2m} \sum_{i=1}^{m} \left( h_{\theta}(x^{(i)}) - y^{(i)} \right)^2 + \lambda \| W \|^2θmin2m1i=1∑m(hθ(x(i))−y(i))2+λ∥W∥2
Dropout正则化
Dropout是Srivastava等人在2014年发表的一篇论文中,提出了一种针对神经网络模型
的正则化方法Dropout(A Simple Way to Prevent Neural Networks from Overfitting)。
那Dropout在训练模型中是如何实现的呢?Dropout的做法是在训练过程中按一定比例
(比例参数可设置)随机忽略或屏蔽一些神经元。这些神经元会被随机“抛弃”,也就是说
它们在正向传播过程中对于下游神经元的贡献效果暂时消失了,反向传播时该神经元也不
会有任何权重的更新。所以,通过传播过程,Dropout将产生和L2L_{2}L2范数相同的收缩权重的
效果。
随着神经网络模型的不断学习,神经元的权值会与整个网络的上下文相匹配。神经元
的权重针对某些特征进行调优,进而产生一些特殊化。周围的神经元则会依赖于这种特殊
化,但如果过于特殊化,模型会因为对训练数据的过拟合而变得脆弱不堪。神经元在训练
过程中的这种依赖于上下文的现象被称为复杂的协同适应(Complex Co-Adaptations)。
加入了Dropout以后,输入的特征都是有可能会被随机清除的,所以该神经元不会再
特别依赖于任何一个输入特征,也就是说不会给任何一个输入设置太大的权重。由于网络
模型对神经元特定的权重不那么敏感。这反过来又提升了模型的泛化能力,不容易对训练
数据过拟合。
Dropout训练的集成包括所有从基础网络除去非输出单元形成子网络,如图5-7所示。
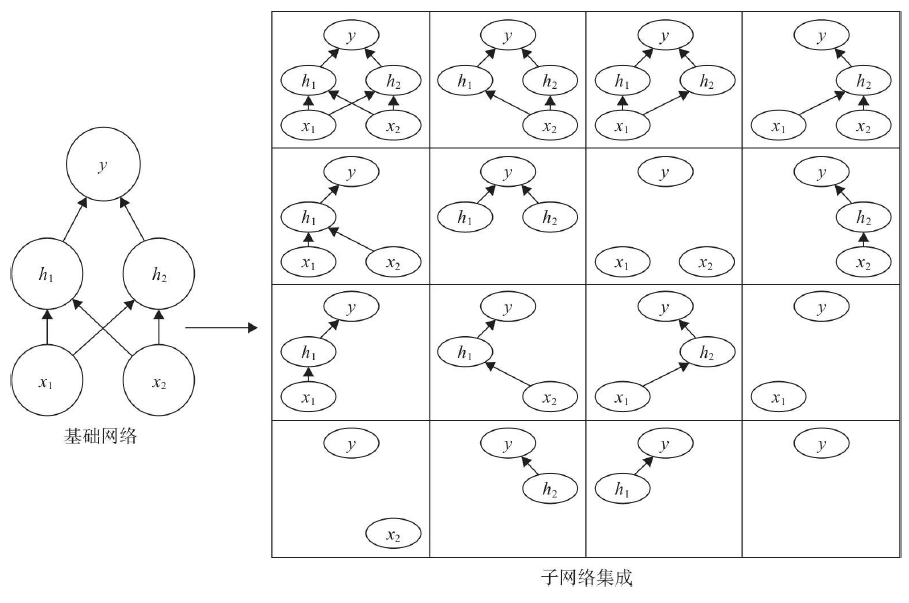
Dropout训练所有子网络组成的集合,其中子网络是从基本网络中删除非输出单元所
构建的。我们从具有两个可见单元和两个隐藏单元的基本网络开始,这4个单元有16个可
能的子集。图5-7展示了从原始网络中丢弃不同的单元子集而形成的所有的16个子网络。
在这个例子中,所得的大部分网络没有输入单元或没有从输入连接到输出的路径。当层较
宽时,丢弃所有从输入到输出的可能路径的概率变小,所以这个问题对于层较宽的网络不
是很重要。
较先进的神经网络基于一系列仿射变换和非线性变换,我们可以将一些单元的输出乘
零,这样就能有效地删除一些单元。这个过程需要对模型进行一些修改,如径向基函数网
络,单元的状态和参考值之间存在着一定区别。为简单起见,在这里提出乘零的简单
Dropout算法,被简单地修改后,可以与其他操作一起工作。
Dropout在训练阶段和测试阶段是不同的,一般在训练中使用,测试时不使用。不过
在测试时,为了平衡(因训练时舍弃了部分节点或输出),一般将输出按Dropout Rate比
例缩小。
如何或何时使用Dropout呢?以下是一般原则。
1)通常丢弃率控制在20%~50%比较好,可以从20%开始尝试。如果比例太低则起不
到效果,比例太高则会导致模型的欠学习。
2)在大的网络模型上应用。
当Dropout应用在较大的网络模型时,更有可能得到效果的提升,模型有更多的机会
学习到多种独立的表征。
3)在输入层和隐藏层都使用Dropout。
对于不同的层,设置的keep_prob也不同,一般来说神经元较少的层,会设keep_prob
为1.0或接近于1.0的数;神经元较多的层,则会将keep_prob设置得较小,如0.5或更
小。
4)增加学习速率和冲量。
把学习速率扩大10~100倍,冲量值调高到0.9~0.99。
5)限制网络模型的权重。
大的学习速率往往会导致大的权重值。对网络的权重值做最大范数的正则化,被证明
能提升模型性能。
以下是我们通过实例来比较使用Dropout和不使用Dropout对训练损失或测试损失的影
响。数据还是房屋销售数据,构建网络层,添加两个Dropout,具体构建网络代码如下:
net1_overfitting = torch.nn.Sequential(
torch.nn.Linear(13, 16),torch.nn.ReLU(),
torch.nn.Linear(16, 32),
torch.nn.ReLU(),
torch.nn.Linear(32, 1),
)
net1_dropped = torch.nn.Sequential(
torch.nn.Linear(13, 16),
torch.nn.Dropout(0.5), # drop 50% of the neuron
torch.nn.ReLU(),
torch.nn.Linear(16, 32),
torch.nn.Dropout(0.5), # drop 50% of the neuron
torch.nn.ReLU(),
torch.nn.Linear(32, 1),
)
获取测试集上不同损失值的代码如下:
writer.add_scalars('test_group_loss',{'origloss':orig_loss.item(),'droploss':drop_loss.item()}, epoch)
把运行结果,通过tensorboardX在Web显示,可看到图5-8的结果。
批量正则化
上文已经介绍了数据归一化,这个通常是针对输入数据而言。但在实际训练过程中,
经常出现隐含层因数据分布不均,导致梯度消失或不起作用的情况。如采用sigmoid函数
或tanh函数为激活函数时,如果数据分布在两侧,这些激活函数的导数就接近于0。这样
一来,BP算法得到的梯度也就消失了。如何解决这个问题?
Sergey Ioffe和Christian Szegedy两位学者提出了批标准化(Batch Normalization)方
法。Batch Normalization不仅可以有效地解决梯度消失问题,而且还可以让调试超参数更
加简单,在提高训练模型效率的同时,还可让神经网络模型更加“健壮”。那么Batch
Normalization是如何做到这些的呢?首先,我们介绍一下BN的算法流程。
输入:微批次(mini-batch)数据B={x1,x2,⋯ ,xm}B=\{ x_{1},x_{2},\cdots ,x_{m}\}B={x1,x2,⋯,xm}
学习参数:γ,β类似于权重参数,可以通过梯度下降等算法求得。
其中xi\mathrm{x}_\mathrm{i}xi 并不是网络的训练样本,而是指原网络中任意一个隐藏层激活函数的输入,这
些输入是训练样本在网络中前向传播得来的。
输出:
{yi=NBγ,β(xi)}\{y_i = \mathrm{NB}_{\gamma, \beta}(x_i)\}{yi=NBγ,β(xi)}
#求微批次样本均值:
μB←1m∑i=1mxi\mu_B \leftarrow \frac{1}{m} \sum_{i=1}^{m} x_iμB←m1∑i=1mxi
#求微批次样本方差:
σB2←1m∑i=1m(xi−μB)2\sigma_B^2 \leftarrow \frac{1}{m} \sum_{i=1}^{m} (x_i - \mu_B)^2σB2←m1∑i=1m(xi−μB)2
#对xi\mathrm{x}_\mathrm{i}xi 进行标准化处理:
[
\hat{x}_1 \leftarrow \frac{x_i - \mu_B}{\sqrt{\sigma_B^2 + \in}}
]
#反标准化操作:
[ y_i = \gamma \hat{x}1 + \beta \equiv NB{\gamma, \beta}(x_i) ]
BN是对隐藏层的标准化处理,它与输入的标准化处理Normalizing Inputs是有区别的。Normalizing Inputs是使所有输入的均值为0,方差为1。而Batch Normalization可使各
隐藏层输入的均值和方差为任意值。实际上,从激活函数的角度来看,如果各隐藏层的输
入均值在靠近0的区域,即处于激活函数的线性区域,这样不利于训练好的非线性神经网
络,而且得到的模型效果也不会太好。式(5-6)就起这个作用,当然它还有将归一化后
的x还原的功能。那么BN一般用在哪里呢?BN应作用在非线性映射前,即对x=Wu+b做规
范化时,在每一个全连接和激励函数之间。
何时使用BN呢?一般在神经网络训练时遇到收敛速度很慢,或梯度爆炸等无法训练
的状况时,可以尝试用BN来解决。另外,在一般情况下,也可以加入BN来加快训练速
度,提高模型精度,还可以大大地提高训练模型的效率。BN具体功能如下所示。
1)可以选择比较大的初始学习率,让训练速度飙升。之前还需要慢慢地调整学习
率,甚至在网络训练到一半的时候,还需要想着学习率进一步调小的比例选择多少比较合
适。现在我们可以采用初始很大的学习率,然而学习率的衰减速度也很快,因为这个算法
收敛很快。当然,这个算法即使你选择了较小的学习率,也比以前的收敛速度快,因为它
具有快速训练收敛的特性。
2)不用再去理会过拟合中Dropout、L2\mathrm{L}_{2}L2正则项参数的选择问题,采用BN算法后,你
可以移除这两项参数,或者可以选择更小的L2\mathrm{L}_{2}L2正则约束参数了,因为BN具有提高网络泛
化能力的特性。
3)再也不需要使用局部响应归一化层。
4)可以把训练数据彻底打乱。
下面仍以房价预测为例,比较添加BN层与不添加BN层,两者在测试集上的损失值比
较。下例为两者网络结构代码。
net1_overfitting = torch.nn.Sequential(
torch.nn.Linear(13, 16),
torch.nn.ReLU(),
torch.nn.Linear(16, 32),
torch.nn.ReLU(),
torch.nn.Linear(32, 1),
)
net1_nb = torch.nn.Sequential(
torch.nn.Linear(13, 16),
nn.BatchNorm1d(num_features=16),
torch.nn.ReLU(),
torch.nn.Linear(16, 32),
nn.BatchNorm1d(num_features=32),
torch.nn.ReLU(),
torch.nn.Linear(32, 1),
)
权重初始化
深度学习为何要初始化?传统机器学习算法中很多并不是采用迭代式优化,因此需要
初始化的内容不多。但深度学习的算法一般采用迭代方法,而且参数多、层数也多,所以
很多算法不同程度上会受到初始化的影响。
初始化对训练有哪些影响?初始化能决定算法是否收敛,如果算法的初始化不适当,
初始值过大可能会在前向传播或反向传播中产生爆炸的值;如果太小将导致丢失信息。对
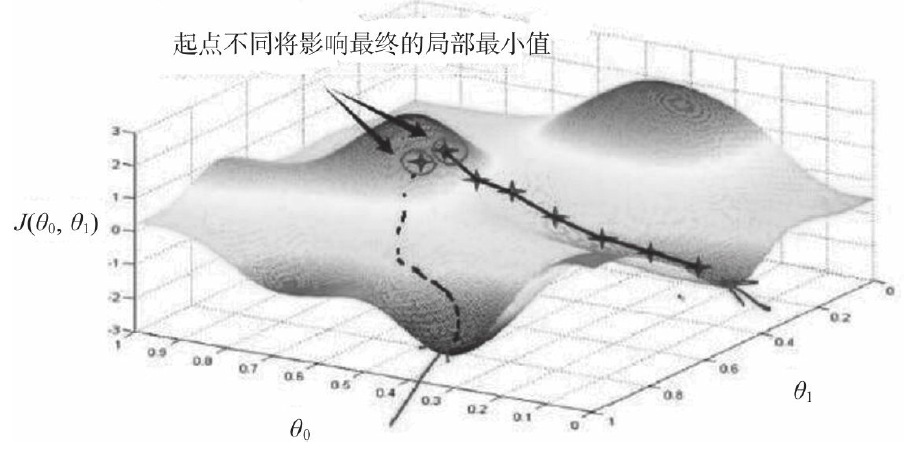
收敛的算法适当的初始化能加快收敛速度。初始值的选择将影响模型收敛局部最小值还是
全局最小值,如图5-10所示,因初始值的不同,导致收敛到不同的极值点。另外,初始化
也可以影响模型的泛化。
如何对权重、偏移量进行初始化?初始化这些参数是否有一般性原则?常见的参数初
始化有零值初始化、随机初始化、均匀分布初始、正态分布初始和正交分布初始等。一般
采用正态分布或均匀分布的初始值,实践表明正态分布、正交分布、均匀分布的初始值能
带来更好的效果。
继承nn.Module的模块参数都采取了较合理的初始化策略,一般情况使用其缺省初始
化策略就足够了。当然,如果想要修改,PyTorch也提供了nn.init模块,该模块提供了常
用的初始化策略,如xavier、kaiming等经典初始化策略,使用这些初始化策略有利于激活
值的分布呈现出更有广度或更贴近正态分布。xavier一般用于激活函数是S型(如
sigmoid、tanh)的权重初始化,而kaiming则更适合于激活函数为ReLU类的权重初始化。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)