联邦学习论文分享:Contrastive Private Data Synthesis via Weighted Multi-PLMFusion
摘要
本文提出了WASP 框架:通过 Top-Q 投票机制和多模型动态加权对比式生成,提升差分隐私合成数据的质量和数量,解决了数据稀缺、生成噪声和预训练模型偏差的问题,并且在多个数据集和模型上验证了有效性。
引言
1. 背景与现有方法
-
AI 模型(大语言模型 LLM + 小任务模型 STM) 的强大之处,依赖于 高质量训练数据。
-
现实问题:这些数据往往来源于用户(医疗记录总结、减肥对话机器人、指令微调等),存在严重 隐私风险。
-
解决思路:差分隐私 (DP) 合成数据,即生成一个“假数据集”,分布类似真实数据,但保护了隐私。
-
现有两大方法:
-
DP Fine-tune Generator:在私有数据上用 DP-SGD 微调预训练模型 ,计算开销大,需大量数据。
-
Private Evolution (PE):不需要微调,只用 API + DP 指导生成 , 更轻量、适合闭源和开源模型。
-
2. 现有 PE 方法的挑战
即便 PE 有优势,但还存在 三大问题:
-
私有样本数量有限:需要上千样本才能稳定,而实际可能只有几百个 ,这 导致估计不准、生成分布偏差。
-
生成数据噪声多:不可避免产生低质量样本,影响下游任务性能。
-
PLM(预训练语言模型) 选择风险:不同模型表现差异大,单一模型可能不适合所有任务;现有方法基本都是单模型。
3. WASP 方法与贡献
为了解决以上挑战,提出 WASP 框架(Weighted multiple PLMs, contrastive generation):
-
Top-Q 投票机制:从原来的 Top-1 投票扩展为 Top-Q(带衰减权重),提升少量私有样本下的分布估计精度。
-
对比式生成 (contrastive generation):利用投票结果选出高质量 & 低质量样本,把两者放进对比提示,让模型更贴近高质量、远离低质量。
-
多模型动态加权 (multi-PLM weighting):让多个 PLMs 协作,动态分配权重,优先利用表现更好的模型,减少单模型偏差。
-
迭代生成:过程可反复执行,生成大规模 DP 数据,不额外增加 API 查询成本。
相关工作
1. DP Synthetic Dataset(差分隐私合成数据)
-
目标:生成一个 差分隐私保护的合成数据集,既能模仿真实的私有数据分布,又避免泄露敏感信息。
-
现有方法:
-
DP-SGD 微调 PLM:在私有数据上对预训练语言模型进行 DP 微调,可以有效,但问题是:
-
计算代价高
-
需要大量高质量私有样本
-
闭源大模型(GPT 系列)没法微调
-
-
API 调用 PLM(不微调):
-
一类方法:在 DP 保护下,迭代生成合成数据
-
一类方法:直接生成私有大数据集的 DP 副本
-
问题:有的方法需要“大规模的初始化数据集”,现实中往往难以获取
-
解决方案(Lin et al., PE 方法):只用与任务相关的合成样本作为起点 → 再通过 DP 保护的方式,让私有样本找到最接近的合成样本,并指导数据集扩展
-
应用:图像生成、文本生成、联邦学习场景,都被证明有效
-
局限:大多只用 单个 PLM 作为生成器
-
-
2. PLM Fusion(PLM 融合)
-
动机:多个预训练语言模型组合,比单模型更强。
-
现有做法:
-
训练时融合:PLM 当“教师”,通过 token-level 融合指导目标模型
-
推理时融合:多数投票、logits 平均
-
问题:都需要真实的训练/测试数据输入到模型,这样 存在隐私风险
-
-
新方案(FuseGen):
-
在 zero-shot 下做 PLM 融合
-
只用模型 API 合成数据,不直接接触真实私有样本 ,这样可以保护隐私
-
局限:所有 PLM 一视同仁,忽略了不同模型在不同任务上的能力差异
-
前提知识
1. Differential Privacy (DP) 定义
-
邻居数据集 (Neighboring Datasets):如果两个数据集 D 和 D′ 只相差一个样本 ,则它们就是邻居。
-
(ε, δ)-DP:一个机制 M 满足差分隐私,如果对于任何邻居数据集 D,D′,以及任何可能的输出集合 EEE,都有:
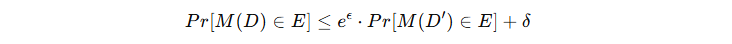
意思是:在有无某个用户数据的情况下,输出分布几乎一样(差别受 ε, δ 控制)。
-
后处理不增加隐私损失:如果输出已经满足 (ε, δ)-DP,对其再做任何函数处理,仍然满足相同的隐私保证。
2. Gaussian Mechanism(高斯机制)
-
为了保证 (ε, δ)-DP,可以在输出统计量上 加高斯噪声:
-
噪声服从
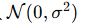
-
σ\sigmaσ 取值公式:
-
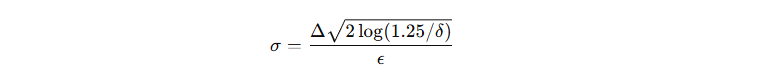
其中 Δ 是机制 MMM 的 敏感度(即单个样本能引起的最大输出变化)。
方法
问题定义
1. 研究目标
-
要生成一个 差分隐私合成数据集
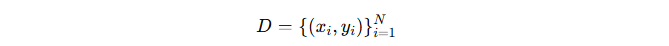
规模为 N。
-
可用的真实私有数据集很小:
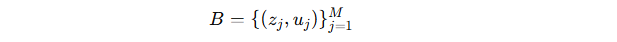
其中:
-
M = 私有样本数量(通常只有几百条,假设数据稀缺场景)。
-
zj= 特征,uj= 标签。
2. 方法思路
-
使用 K 个 PLM(预训练语言模型),通过 API 调用 来生成合成数据。
-
用 高斯机制 来保证差分隐私,防止泄露真实数据。
-
合成数据 D 生成后,用它来训练一个 小型任务模型 (STM),再在真实测试集 A 上评估效果。
-
注意:测试集 A 从未出现在训练过程中。
-
3. 扩展性
-
框架可以推广到 联邦学习 (Federated Learning) 场景:
-
各数据源都有很少的私有样本。
-
大家通过 安全聚合 (secure aggregation) 协作完成任务。
-
私有数据不会被集中化,仍然受 DP 保护。
-
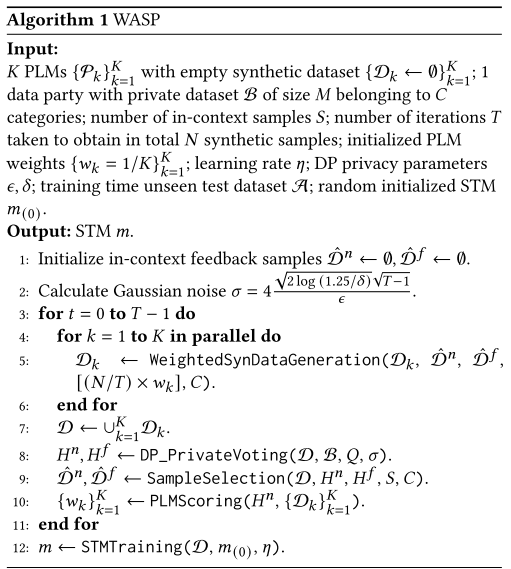
大致流程
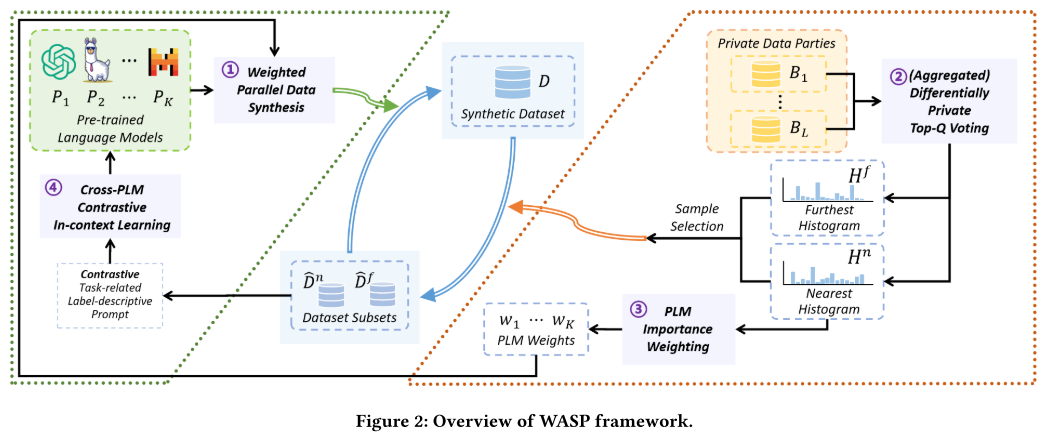
每一轮迭代分为 4 个关键步骤:
-
合成数据生成
-
给定任务,用 零样本 (zero-shot) prompt 去提示每个预训练语言模型 (PLM) Pk。
-
每个 PLM 生成一份合成数据子集 Dk,大小为 Nk。
-
这些数据 不包含真实私有数据 B 的直接信息。
-
-
差分隐私 Top-Q 投票
-
将所有生成的数据集合并:
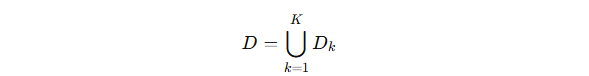
-
用私有数据集 B 对 D 中的样本进行 DP 保护的 Top-Q 投票,来判断哪些是高质量/低质量的合成样本。
-
投票是基于样本和私有数据分布的相似性。
-
-
对比学习 (Contrastive In-context Learning)
-
把高质量和低质量样本一起放入 prompt,形成 对比式提示。
-
下一轮生成时,PLMs 会更偏向生成高质量样本、远离低质量样本。
-
-
动态权重调整
-
根据投票结果,调整每个 PLM 的权重 wk。
-
权重决定了下一轮中各 PLM 生成的数据量 Nk。
-
这样性能更好的 PLM 会被赋予更大权重。
-
迭代完成 T 轮之后:
-
得到累积的 DP 合成数据集 D。
-
用它来训练小型任务模型 (STM) m。
数据生成方式
-
样本生成方式
-
每个 PLM Pk 根据权重 wk,生成
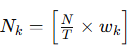 个合成样本。
-
总目标是生成 N 个样本,分配在 T 次迭代里完成。
-
公式:
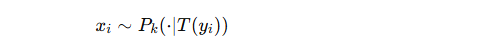
表示样本由 PLM 在给定提示 T(yi) 下生成,yi是标签,T()是一个提示词框架,在提示词中嵌入标签,并传给语言模型,让其生成样本。
-
-
提示设计 (Prompt Design)
-
初始迭代:使用 zero-shot prompt(只描述任务和类别)。
-
后续迭代:用 few-shot 对比提示 (contrastive prompt),其中包含前面步骤筛选的高质量和低质量样本,帮助模型生成更优样本。
-
-
权重设置 (Weights Assignment)
-
初始迭代:所有 PLM 权重相等 {wk=1/K}。
-
后续迭代:根据各个 PLM 在特定任务上的能力 动态分配权重(表现好的 PLM 生成更多样本)。
-
-
结果
-
各 PLM 的输出子集 Dk 会被合并成整体合成数据集 D=⋃kDk。
-
然后送到私有数据方用于下一步 DP 投票。
-
投票机制
-
问题背景
-
如果私有样本太少,用传统的 “1 样本 = 1 投票” 方法,分布估计会很不准,导致生成的合成数据不够接近真实数据。
-
-
Top-Q 投票机制
-
每个私有样本 (zj,uj) 会和相同类别的合成样本 (xi,yi) 计算距离:
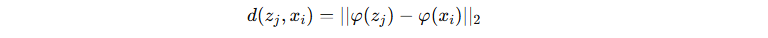
这里 φ是预训练好的句向量模型(用于语义表示)。
-
每个私有样本会给:
-
Top-Q 最近的合成样本 投票(认为是高质量候选)
-
Top-Q 最远的合成样本 投票(认为是低质量候选)
-
-
投票有 递减权重:第1个最近样本权重 1,第2个 1/2,第3个 1/4,以此类推。这样能利用排名信息,同时保证 DP 敏感度可控。
-
-
加入差分隐私
-
在投票直方图(Nearest Histogram HnH_nHn,Furthest Histogram HfH_fHf)上加入 高斯噪声,确保整体满足 (ϵ,δ)-DP。
-
-
筛选高低质量样本
-
根据加噪后的投票结果:
-
高质量集 D^n :在 Hn 里得票最高的样本(离私有样本最近的)。
-
低质量集 D^f :在 Hf里得票最高的样本(离私有样本最远的)。
-
-
这两个集合不限制来源,可以混合来自不同 PLM 生成的样本。
-
语言模型加权
-
问题背景
-
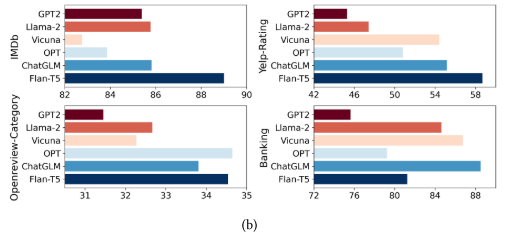
以往的多 PLM 融合方法(API-based multi-PLM fusion)往往假设所有 PLM 生成能力一样,给它们相同权重。
-
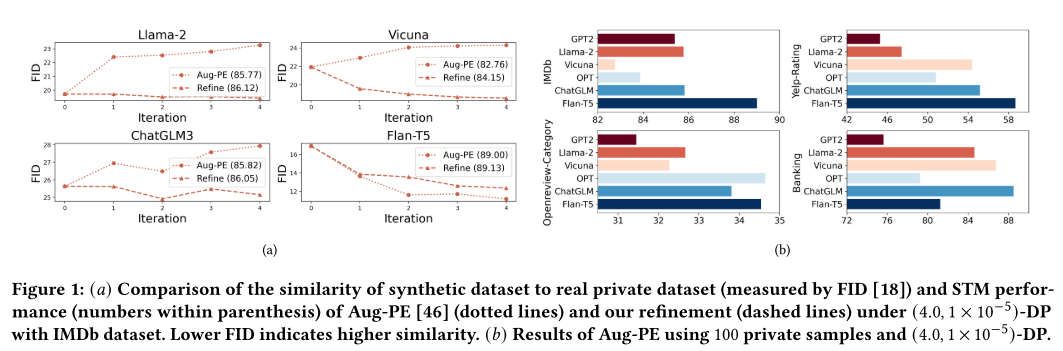
但实验(Figure 1(b))表明:不同 PLM 的生成质量差别很大,有的 PLM 更“懂”任务,有的偏差大。
-
因此需要根据 PLM 生成数据的质量 动态分配权重。
-
-
权重的定义方式
-
在上一阶段 Top-Q 投票 中,得到了 Nearest Histogram Hn,它反映了每个合成样本和私有样本的接近程度。
-
可以把 Hn[i]理解为 “样本 i 的质量得分”。
-
-
权重计算方法
-
先把每个样本的得分标准化:
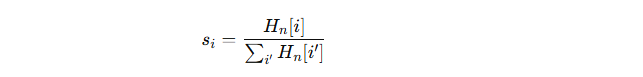
(即样本 i 在所有样本中的相对质量得分)。
-
然后把属于某个 PLM Pk 的样本得分 si 加起来,算出该 PLM 的整体贡献,再除以它生成样本的数量,得到该 PLM 的权重 wk:
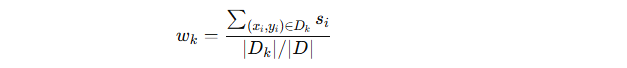
其中 ∣Dk∣ 是 PLM Pk 生成的样本数量,∣D∣ 是总样本数。
-
最终 wk 代表了 PLM Pk 在下一轮生成中应分配多少比例的生成任务。
-
跨模型对比上下文学习
-
问题背景
-
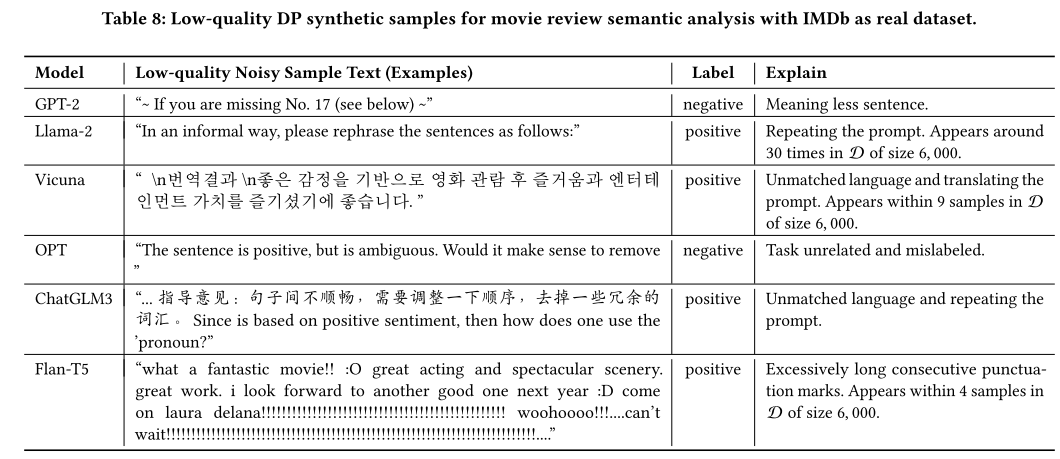
即使有 DP 投票机制,生成的数据集中仍然可能存在低质量样本。
-
因此,需要在下一轮生成时 显式地利用高/低质量样本的对比信息 来提升生成质量。
-
-
方法核心:对比式 ICL
-
从前面阶段得到的高质量样本集 D^n 和低质量样本集 D^f 中,挑选一些作为 in-context 样例,组成对比式提示(contrastive prompt)。
-
提示 T(⋅) 包含三部分信息:
-
分析高质量 vs. 低质量样本的差异。
-
生成的新样本要 更接近真实分布(比高质量样本还要好,同时比低质量样本远离)。
-
新样本要在表达上 保持多样性,不要只是复制已有的高质量样本。
-
-
-
多样性设计
-
为了避免生成千篇一律的样本,在构造对比示例时:
-
随机抽取 50% 来自低质量集合
 ,50% 来自高质量集合
 ,形成对比上下文。
-
每次生成时使用 多个示例 (S) 一起作为演示(demonstrations),而不是像传统 PE 那样只修改一个已有样本。
-
-
这样可以引导 PLM 生成 多样化但高质量 的新样本。
-
联邦学习场景
-
问题背景
-
单数据方(single-party)场景,可能并不多。
-
在现实中,很多场景(如医疗公司合作)是 联邦式的,每个数据方的数据量都很有限,但希望 协作生成合成数据。
-
-
数据方设置
-
假设有 L 个数据方 Cl,每个拥有本地私有数据集
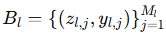
-
目标:多个数据方协作生成 DP 合成数据,同时 保护各自本地数据隐私。
-
-
联邦式 DP Top-Q 投票
-
服务端生成样本后,发送给每个客户端,每个数据方 Cl 使用自己的本地数据进行 差分隐私 Top-Q 投票。
-
为保证隐私,噪声标准差调整为
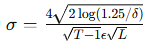 。
-
产生本地最近和最远投票直方图
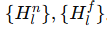 。
-
-
安全聚合(Secure Aggregation)
-
各数据方将本地直方图安全聚合后发送给中央服务器:
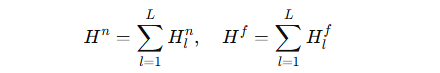
-
服务器只能看到 聚合后的直方图,无法访问单个数据方的原始投票,从而保护隐私。
-
-
威胁模型与隐私保证
-
假设服务器是 honest-but-curious(诚实但好奇),只使用聚合信息。
-
若所有数据方参与聚合,可保证 样本级 (ε, δ)-DP,WASP 也可扩展到 用户级 DP
-
补充
安全聚合(Secure Aggregation)并不是客户端先把自己的直方图完全暴露给服务器再求和,而是一种加密/掩码技术,保证服务器只能得到各方直方图的总和,却看不到单个客户端的原始直方图。
1. 掩码(Masking)
每个客户端 Cl 在发送自己的直方图 Hln 时,会先加上一个随机掩码 RlR_lRl:
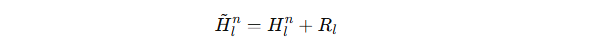
掩码 Rl 会与其他客户端的掩码相互抵消,保证总和正确但单个直方图不可见。
2. 相互抵消
-
每对客户端共享一个随机向量 Rl,m,客户端 lll 将 Rl,m 加到自己的掩码上,同时客户端 m 将 Rl,m 从自己的掩码中减去。
-
这样所有掩码在聚合时相互抵消:
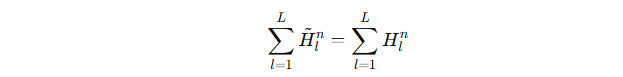
而服务器无法知道每个 Hln 的具体值。
3. 聚合结果
-
服务器只收到每个客户端加了掩码的直方图,但在求和后掩码抵消,得到正确的总和:
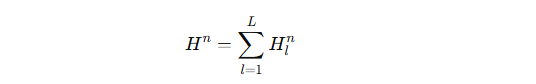
-
服务器无法单独看到某个客户端的直方图,从而实现 客户端数据隐私保护。
实验
设置
使用的模型(Models)
-
开源 PLMs:GPT-2-xl、Llama-2-7b-chat-hf、Vicuna-7b-1.5v、OPT-6.7b、ChatGLM3-6b-base、Flan-T5-xl。
-
闭源 PLMs:GPT-3.5-turbo-instruct、GPT-4-turbo-preview、GPT-4o。
-
STM(下游小模型):预训练 BERT(bert-base-uncased),在合成数据 D 上微调。
-
句向量嵌入模型:sentence-t5-base 用作句子表示。
使用的数据集(Datasets)
共 6 个任务,涵盖文本分类、评分预测等:
-
IMDb:电影评论(2 类)
-
Yelp-Category:商业评论类别(10 类)
-
Yelp-Rating:商业评论评分(5 类)
-
Openreview-Category:论文评论研究领域分类(12 类)
-
Openreview-Rating:论文评论评分分类(5 类)
-
Banking:在线银行问答领域分类(10 类)
-
每个任务的训练集用于抽取私有样本 B,测试集用于评估 STM。
对比方法(Baselines)
-
Aug-PE:原始 PE 算法(文本专用)
-
Pre-Text:PE 在联邦私有数据场景下的应用
-
OnlyPrivate:仅用私有数据训练 STM(不使用 DP),作为性能上限
-
FuseGen:零样本生成合成数据,不访问私有样本
实验实现细节(Implementation Details)
-
默认每个任务使用 100 个私有样本。
-
联邦场景:10 个数据方,总共 300 个私有样本,数据非 i.i.d. 且不平衡,使用 Dirichlet 分配(α=1.0\alpha = 1.0α=1.0)。
-
DP 合成数据:所有 PLMs 共生成 6000 个样本,迭代 5 轮。
-
DP 级别为样本级。
结果
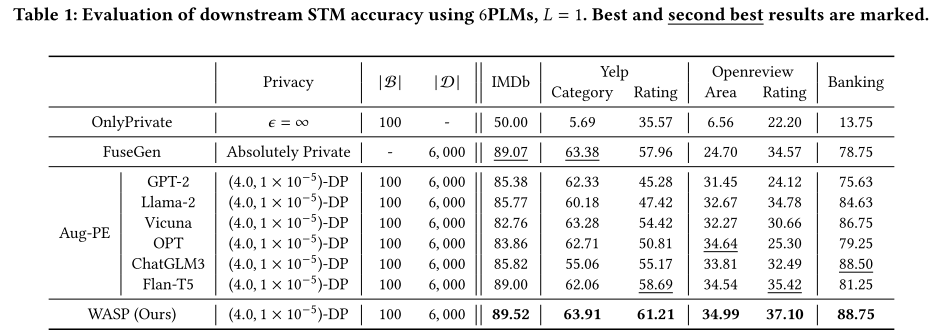
1. 单数据方实验(Single Data Party Setting)
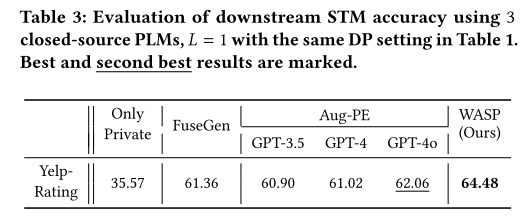
-
结果概述:WASP 在 6 个开源 PLMs 和 3 个闭源 PLMs 上均优于所有基线方法(Aug-PE、FuseGen、OnlyPrivate),在各任务上表现稳健。
-
闭源 vs 开源 PLMs:闭源 GPT 系列在使用 Aug-PE 时性能更好,这是因为这些模型能力更强。
-
Aug-PE 的局限:
-
当私有样本有限时,Aug-PE 对 PLM 选择敏感,不同任务最优 PLM 不同(如 IMDb 用 OPT 表现差,Openreview-Rating 用 GPT-2 表现差)。
-
FID 值较高,说明生成的数据与真实数据分布相差较大。
-
-
WASP 的优势:
-
表现稳定、FID 值低,说明在少量私有样本下也能生成高质量数据。
-
对 PLM 不敏感,无需事先选择最优 PLM。
-
-
FuseGen 对比:零样本生成方法无法访问私有样本,性能不如 WASP。
-
OnlyPrivate 对比:仅用私有数据训练 STM 性能很差,即便不使用 DP,说明私有样本数量不足以直接训练可用模型。
2. 联邦数据方实验(Federated Data Setting)
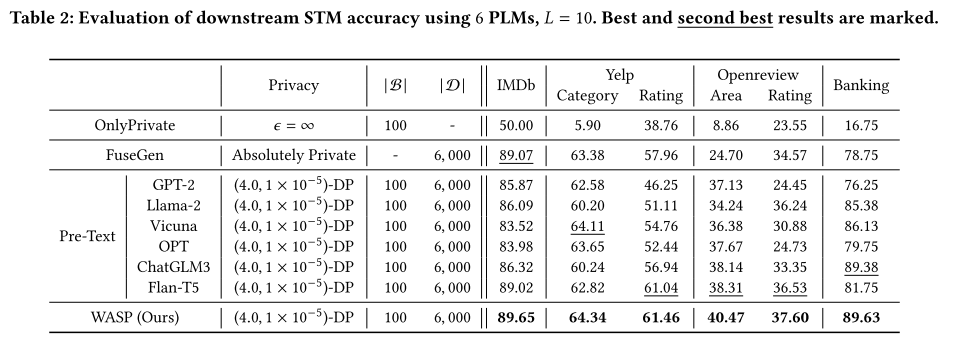
-
设置:10 个数据方,总私有样本 300 个。
-
结果:WASP 在各任务和不同设置下均优于 Pre-Text(针对联邦数据的基线方法),证明其在联邦场景下同样有效。
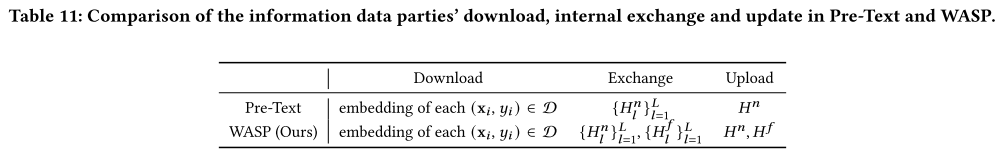
-
通信开销:上传额外直方图带来的通信增加很小(Table 11),说明方法在实际部署中开销可控。
消融实验
1. PLM 数量(𝐾)对性能的影响
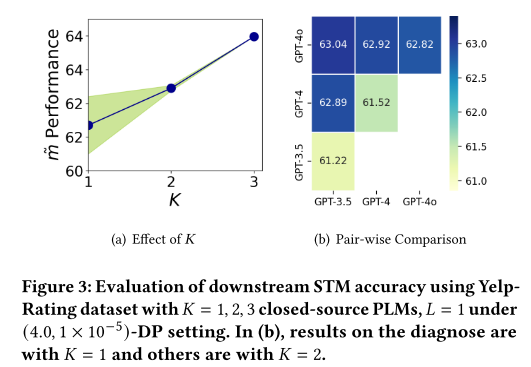
-
增加参与的 PLM 数量会同时提高 STM 性能并降低随机性(STD)。
-
两两组合的 PLM 性能总是优于单个 PLM,说明 WASP 利用多个 PLM 的集体优势比依赖单一 PLM 更稳健。
-
结论:WASP 是 PLM-agnostic 的,能缓解选择最优 PLM 的风险。
2. Contrastive ICL 与 PLM Importance Weighting
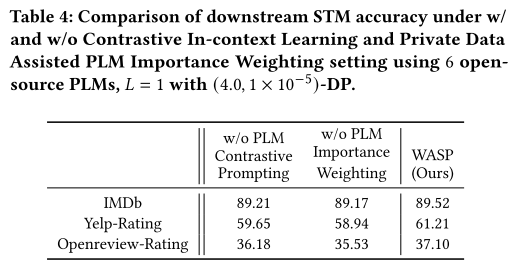
-
去掉 Contrastive ICL(只选高质量样本作为示例):
-
IMDb 任务下降 0.31%,Yelp-Rating 和 Openreview-Rating 下降更明显(1.56% 和 0.92%)。
-
说明:低质量样本作为负反馈示例对提升生成质量很重要。
-
-
去掉 PLM Importance Weighting(每个 PLM 平等生成样本):
-
IMDb 下降 0.35%,Yelp-Rating 和 Openreview-Rating 下降 2.27% 和 1.57%。
-
说明:根据每个 PLM 的任务能力进行加权生成可以有效提升性能。
-
3. 每个私有样本的投票数(𝑄)
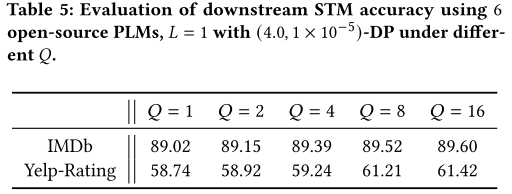
-
增加每个私有样本投票数能更准确地估计私有数据分布,提升 STM 性能。
-
当 𝑄 > 8 时,性能提升趋于平缓。
4. 私有样本数量(𝑀)的敏感性分析
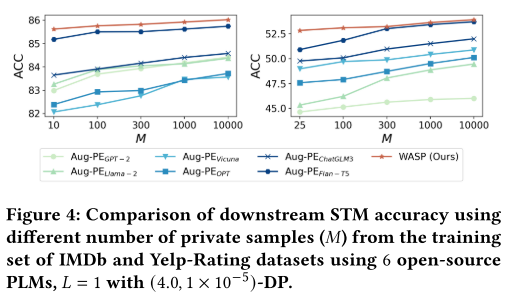
-
在不同 𝑀 下,WASP 始终优于 Aug-PE。
-
当私有样本较少(𝑀 < 1000)时,性能差距更大,说明 WASP 对少量数据的适应性更强。
5. 隐私预算(𝜖)的敏感性分析
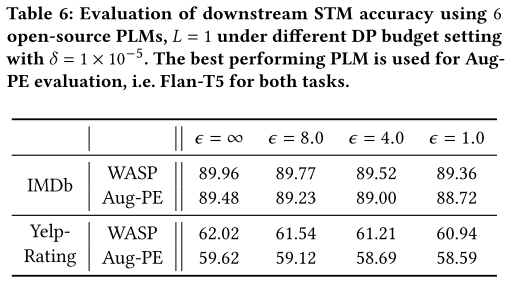
-
随着 𝜖 从 ∞ → 8.0 → 4.0 → 1.0 收紧,STM 性能略微下降。
-
WASP 在严格隐私约束下仍能保持高性能,与基线方法表现类似。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 34
 0
- 0


 已为社区贡献3条内容

所有评论(0)