【机器学习入门】2.1 经验误差(检验误差)——搞懂这篇,才知道你的模型好不好用
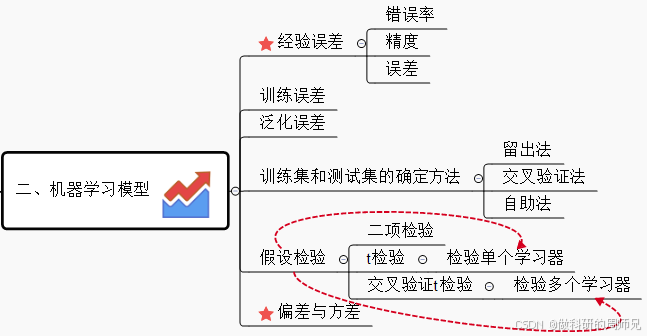
刚入门机器学习的同学,可能会遇到这样的困惑:我用数据训练了一个模型(比如挑西瓜的模型),怎么判断它好不好用?是 “训练时全对” 就够了吗?其实不然 —— 就像学生 “作业全对不代表考试能考好”,模型 “训练时误差小” 也不代表能应对新数据。这篇文章就围绕 “检验误差” 展开,从基础概念到评估方法,再到模型比较和偏差方差,帮你彻底搞懂 “如何判断模型性能”,内容严格贴合教学目标,全是入门必懂的核心知识点。
一、先搞懂基础概念:误差、错误率、精度
在讲 “检验误差” 之前,我们得先把最基本的 “误差相关术语” 掰扯清楚 —— 这些是后续所有分析的 “语言基础”,文档里也把它们放在了最前面,可见其重要性。我们用 “挑西瓜” 的经典案例贯穿,避免纯公式的枯燥。
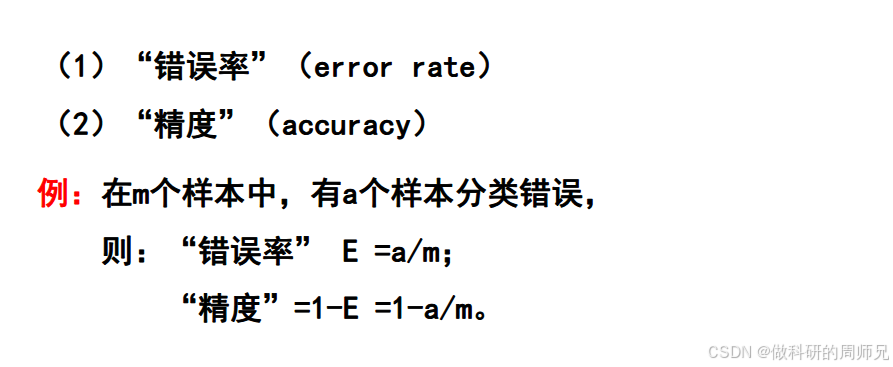
1.1 错误率(Error Rate):模型 “犯错的比例”
定义
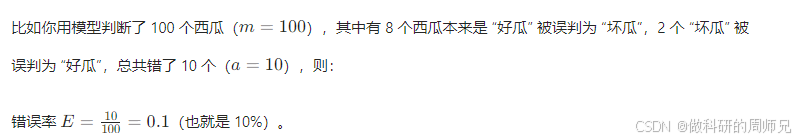
错误率是指模型在样本集中分类错误的样本数占总样本数的比例,是衡量模型 “犯错频率” 最直观的指标。
公式

案例:挑西瓜的错误率计算
关键注意点
- 错误率是 “比例”,取值范围在 0~1 之间(0 表示全对,1 表示全错);
- 错误率只适用于 “分类任务”(比如判断好瓜 / 坏瓜、垃圾邮件 / 正常邮件),回归任务(比如预测房价)不用错误率,后面会讲其他指标。
1.2 精度(Accuracy):模型 “做对的比例”
定义
精度是指模型在样本集中分类正确的样本数占总样本数的比例,其实就是 “1 - 错误率”,更符合我们日常 “看正确率” 的习惯。
公式
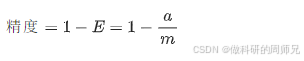
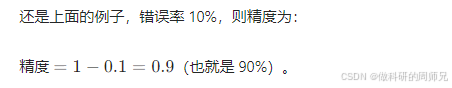
案例:延续挑西瓜的计算
关键误区:精度高就一定是好模型吗?
不一定!比如在 “疾病诊断” 场景中,1000 个样本里只有 10 个病人(990 个健康人),模型只要把所有样本都判为 “健康人”,精度就能达到 99%,但这个模型完全没用(漏诊了所有病人)。这就是 “类别不平衡” 导致的精度陷阱,入门时一定要注意 —— 不能只看精度,后续会学 F1 分数、召回率等更全面的指标。
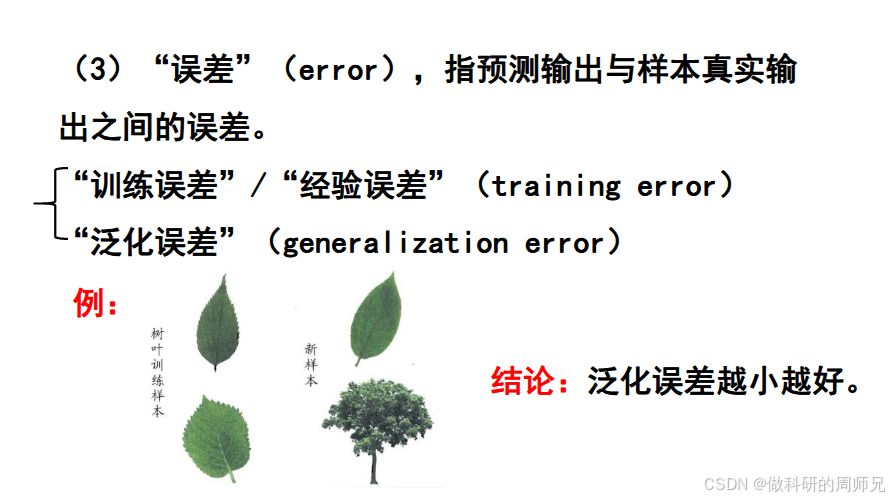
1.3 误差(Error):预测值与真实值的 “差距”
定义
误差是一个更广义的概念,指模型的预测输出与样本真实输出之间的差异—— 不管是分类任务还是回归任务,都能用 “误差” 来描述。文档里把误差分为两类:训练误差和泛化误差,这是重中之重,必须吃透。
两类核心误差:训练误差 vs 泛化误差
我们用 “学生学习” 的类比来理解,保证一次记住:
| 误差类型 | 定义 | 类比(学生学习) | 核心作用 |
|---|---|---|---|
| 训练误差(经验误差) | 模型在 “训练集” 上的误差(用训练数据算的误差) | 学生做 “课后作业” 的错误率 | 反映模型对训练数据的 “拟合程度” |
| 泛化误差 | 模型在 “从未见过的新样本” 上的误差 | 学生考 “期末考试” 的错误率 | 反映模型的 “实际有用性”(关键指标) |
案例:用 “树叶分类” 理解(文档提到的例子)
假设你用 100 片树叶训练 “枫叶 / 银杏叶” 分类模型:
- 训练时,模型在 100 片树叶上只错了 5 片,训练误差 = 5%;
- 但用 10 片新采的树叶测试时,模型错了 3 片,泛化误差 = 30%。
结论(文档重点强调):泛化误差越小越好!
训练误差小不代表模型好(比如学生死记硬背作业答案,作业全对但考试不会),只有泛化误差小,模型才能在真实场景中用(比如医生用诊断模型给新病人看病,推荐系统给新用户推商品)。后续所有 “检验误差” 的方法,核心目标都是 “准确估计泛化误差”。
二、评估方法:如何准确估计泛化误差?
知道了 “泛化误差最重要”,接下来的问题是:我们没有 “未来的新样本”,怎么估计泛化误差?文档里重点讲了两种经典方法:留出法和交叉验证法。这两种方法都是通过 “划分现有数据集” 来模拟 “训练 - 测试” 过程,从而估计泛化误差。
2.1 留出法(Hold-Out):最简单的 “分一分,测一测”
定义
留出法是指将整个数据集直接划分为两个互斥的子集:训练集(用于训练模型)和测试集(用于测试泛化误差),训练好的模型在测试集上的误差,就作为泛化误差的估计值。
步骤(用 “100 个西瓜” 案例)
- 划分数据集:把 100 个西瓜分成两部分,比如 70 个作为训练集(占 70%),30 个作为测试集(占 30%);
- 训练模型:用 70 个训练集西瓜,训练 “挑西瓜模型”(学习色泽、根蒂、敲声与好瓜的关系);
- 测试误差:用训练好的模型判断 30 个测试集西瓜,计算错误率(比如错了 6 个,测试误差 = 6/30=20%);
- 估计泛化误差:把测试误差(20%)近似看作泛化误差。
关键注意点(入门必避坑)
- 划分要 “分层抽样”:比如原数据集中好瓜占 60%(60 个)、坏瓜占 40%(40 个),则训练集和测试集里的好瓜 / 坏瓜比例也要保持 6:4(训练集 42 个好瓜 + 28 个坏瓜,测试集 18 个好瓜 + 12 个坏瓜)。如果随机划分导致测试集全是坏瓜,测试误差就完全不准了;
- 比例要合理:训练集不能太小(否则模型学不到足够规律),测试集也不能太小(否则误差估计不稳定)。常见比例是 “7:3”“8:2”,文档里没有指定比例,但行业通用这两种;
- 结果有随机性:不同的划分方式(比如这次选前 70 个,下次选后 70 个)会得到不同的测试误差,所以通常会多次划分取平均值,减少随机性影响。
2.2 交叉验证法(Cross-Validation):更稳定的 “多轮测试”
留出法的问题是 “依赖一次划分,结果不稳定”—— 比如运气好,测试集都是简单样本,误差就小;运气差,测试集都是难样本,误差就大。交叉验证法通过 “多轮划分、多轮测试” 解决了这个问题,是工业界更常用的方法,文档里也重点讲解。
核心思想
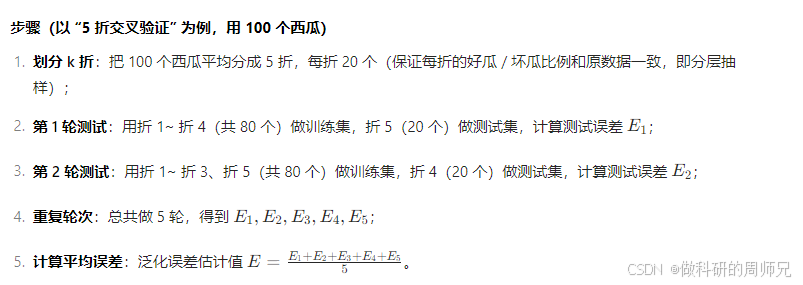
把数据集分成 k 个大小相似的互斥子集(称为 “折”,Fold),每次用k-1个子集做训练集,1 个子集做测试集,总共做 k 轮测试,最后把 k 轮的测试误差取平均值,作为泛化误差的估计值 —— 这就是 “k 折交叉验证”(k-Fold Cross-Validation)。
常见 k 值选择
- 最常用的是 “10 折交叉验证”:兼顾稳定性和计算成本(轮次不多,结果也比较可靠);
- 特殊情况:当数据集很小时(比如只有 50 个样本),可以用 “留一法(Leave-One-Out,LOO)”—— 即 k=m(m 是样本数),每次只留 1 个样本做测试,其他都做训练集。留一法的优点是误差估计最准确(每个样本都当过上测试集),但缺点是计算量大(m 轮训练,m 大时用不了)。
交叉验证法 vs 留出法(表格对比)
| 对比维度 | 留出法 | 交叉验证法(k 折) |
|---|---|---|
| 误差估计稳定性 | 差(依赖一次划分) | 好(多轮平均,减少随机性) |
| 计算成本 | 低(只训练 1 次) | 高(训练 k 次,k 越大成本越高) |
| 数据利用率 | 低(测试集不参与训练) | 高(每个样本都参与过训练和测试) |
| 适用场景 | 快速验证、数据量大时 | 数据量中等、需要准确估计误差时 |
三、比较检验方法:如何判断 “两个模型谁更好”?
当你训练了两个模型(比如模型 A 和模型 B),模型 A 的测试误差 18%,模型 B 的测试误差 20%—— 能直接说 A 比 B 好吗?不一定!因为这个误差差异可能是 “随机导致的”(比如测试集里 A 刚好遇到简单样本)。文档里讲的 “二项检验、t 检验、交叉验证 t 检验”,就是用来 “科学判断误差差异是否显著” 的方法,避免我们被随机结果误导。
这部分内容稍微有点抽象,我们重点讲 “为什么用” 和 “怎么用”,避免复杂公式,贴合入门学生的接受度。
3.1 核心问题:误差差异是 “偶然” 还是 “必然”?
比如你抛硬币,模型 A 猜 “正面” 对了 18 次,模型 B 对了 20 次 —— 这 2 次的差异可能是运气,不是模型能力的差异。比较检验方法的核心就是:通过统计学方法,判断两个模型的误差差异是否 “显著大于随机波动”,如果是,才能说一个比另一个好。
3.2 三种检验方法:适用场景 + 简单理解
1. 二项检验(Binomial Test):判断 “单个模型是否比随机好”
- 适用场景:当模型的预测结果是 “二分类”(比如好瓜 / 坏瓜、对 / 错),且我们想知道 “模型是否比随机猜测更有效” 时使用。
- 简单理解:比如二分类任务中,随机猜测的错误率是 50%(抛硬币),如果模型的错误率是 30%,二项检验会计算 “模型达到 30% 错误率的概率”—— 如果概率小于 0.05(统计学上的 “显著性水平”),就说明模型不是 “靠运气”,确实比随机好。
- 入门用法:不用自己算公式,Python 的
scipy.stats.binom_test函数可以直接出结果,输入 “错误样本数、总样本数、随机错误率”,就能得到显著性 P 值(P<0.05 则模型有效)。
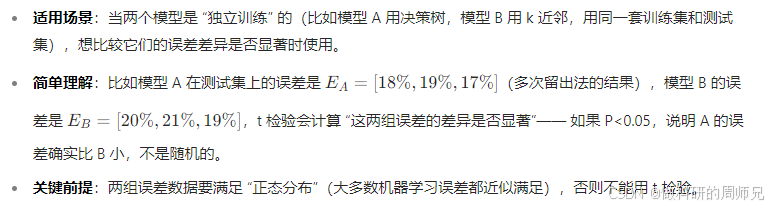
2. t 检验(t-Test):比较 “两个独立模型” 的误差
3. 交叉验证 t 检验(Cross-Validation t-Test):比较 “两个关联模型” 的误差
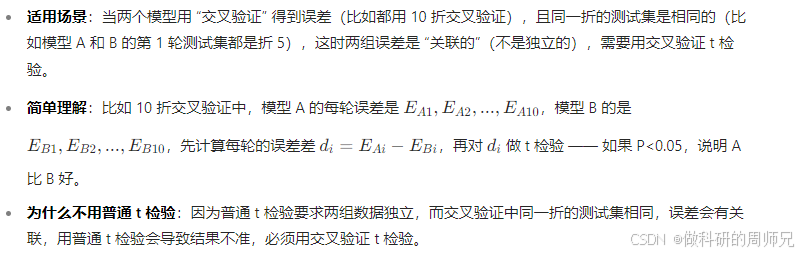
3.3 入门者的实用建议
- 不用死记公式:实际工作中,Python 的
scipy.stats库已经实现了这些检验方法(比如 t 检验用ttest_ind,交叉验证 t 检验可以用ttest_rel),重点是知道 “什么时候用什么检验”; - 显著性水平选 0.05:这是统计学界的通用标准,P<0.05 表示 “差异显著”,P≥0.05 表示 “差异是随机的”;
- 先看趋势再做检验:如果两个模型的误差差异很小(比如 A 是 18%,B 是 18.5%),即使检验结果显著,实际意义也不大 —— 检验方法是 “辅助工具”,不能脱离业务场景看。
四、偏差与方差:为什么模型会有误差?
知道了 “如何测误差” 和 “如何比模型”,我们还要知道 “误差从哪里来”—— 文档里提到的 “偏差” 和 “方差”,就是解释 “模型误差根源” 的核心概念。理解它们,能帮你后续知道 “怎么优化模型”(比如欠拟合是偏差大,过拟合是方差大)。
4.1 偏差(Bias):模型 “没学会” 的误差
定义
偏差是指模型的 “平均预测结果” 与样本 “真实结果” 之间的差异,反映的是模型对 “数据规律的拟合能力”—— 简单说,就是模型 “没学会” 核心规律导致的误差。
类比:打靶
如果一个人打靶,子弹都集中在靶心的左边(平均位置离靶心远),这就是 “偏差大”—— 说明他没掌握 “瞄准靶心” 的规律(比如姿势不对,总是偏左)。
机器学习中的案例
比如用 “线性模型” 预测 “房价”,但房价和面积、房龄的关系是 “非线性的”(面积越大,房价增长越快),线性模型只能学出 “直线关系”,平均预测值和真实房价差很多 —— 这就是 “偏差大”,对应的问题是 “欠拟合”(模型太简单,学不会复杂规律)。
4.2 方差(Variance):模型 “学太杂” 的误差
定义
方差是指模型在 “不同训练集” 上的 “预测结果波动程度”,反映的是模型对 “训练数据噪声的敏感程度”—— 简单说,就是模型 “学了太多无关的细节” 导致的误差。
类比:打靶
如果一个人打靶,子弹散落在靶心周围(平均位置离靶心近,但单个子弹偏离大),这就是 “方差大”—— 说明他对 “环境干扰太敏感”(比如风一吹就偏,手一抖就歪)。
机器学习中的案例
比如用 “深度很深的决策树” 挑西瓜,模型不仅学了 “色泽 = 青绿、根蒂 = 蜷缩” 这些核心规律,还学了 “某个西瓜上有 3 条纹路、某个西瓜根蒂上有个小斑点” 这些无关细节(训练集中的噪声)。换一个训练集(比如另 100 个西瓜),模型的预测结果就会大不一样 —— 这就是 “方差大”,对应的问题是 “过拟合”(模型太复杂,学了噪声)。
4.3 偏差 - 方差权衡(Bias-Variance Tradeoff):核心矛盾
定义
偏差和方差是 “此消彼长” 的关系:
- 模型越简单(比如线性模型、浅决策树):偏差越大(学不会复杂规律),方差越小(对训练集不敏感);
- 模型越复杂(比如深度神经网络、深决策树):偏差越小(能学复杂规律),方差越大(对训练集敏感,易过拟合)。
图示理解(入门必记)
误差
^
|  高偏差(欠拟合)→ 偏差降低 → 低偏差
|    ↗                ↗
|   ↗                ↗
|  ↗                ↗  ↘
| ↗                ↗      ↘  高方差(过拟合)
|↗_______________________→ 模型复杂度
       方差增大
结论
机器学习的核心目标之一,就是 “找到偏差和方差的平衡点”—— 让总误差(偏差 + 方差 + 不可避免的噪声)最小,这也是后续 “模型调优”(比如正则化、剪枝)的核心思路。
五、总结:检验误差的 “完整逻辑链”
看到这里,你已经掌握了检验误差的所有核心知识点,我们用一条逻辑链串起来,帮你形成体系:
- 目标:判断模型好不好用 → 核心看 “泛化误差”;
- 如何估计泛化误差:用 “留出法”(快速)或 “交叉验证法”(准确)划分数据集,用测试误差近似泛化误差;
- 如何比较模型:用 “二项检验” 判断单个模型是否有效,用 “t 检验” 比较独立模型,用 “交叉验证 t 检验” 比较交叉验证的模型,避免随机误差误导;
- 如何优化误差:通过 “偏差” 和 “方差” 定位误差来源 —— 欠拟合(偏差大)就换复杂模型,过拟合(方差大)就正则化 / 加数据。
对于入门学生,不用一开始就掌握所有公式的推导,但一定要理解 “每个方法的用途和场景”—— 比如知道 “数据量小时用交叉验证法”“比较两个交叉验证的模型用交叉验证 t 检验”“过拟合是方差大”,这些是后续实战的基础。
下一章我们会进入 “模型调优” 的实战内容,而检验误差是调优的 “标尺”—— 只有先知道模型哪里不好,才能知道怎么改。如果这篇文章里有哪个概念没搞懂,欢迎在评论区留言,我们一起拆解!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 26
 0
- 0


 已为社区贡献1条内容

所有评论(0)