联邦学习论文分享:Recent Advances on Federated Learning: A Systematic Survey
摘要
本文摘要主要介绍一下联邦学习的功能:相比于传统训练,联邦学习更像是一种可以提供隐私保护的collaborative learning(不翻译成中文,以免概念混淆)。然后指出,本文的优势和贡献:提供一个分类方法,并分类一下近期比较流行的联邦算法;介绍一下流行的联邦学习框架如FedML等;介绍下近期流行的联邦算法的优缺点和未来发展趋势。
个人思考:那么联邦学习和分布式训练是否有什么区别。分布式训练,可以对模型进行拆分,也可以对数据进行拆分。数据并行,就是每个机器上都有一个完整模型,数据拆分,发送给每一个机器,每台机器进行独立的训练,然后将本机器内模型训练得到的梯度汇总给同一台机器;还有模型并行,可能不能把整个模型放到一个GPU卡中,就把模型拆开,模型中不同层又可以放在不同的计算设备上,计算得到张量也可以放在不同计算设备上,还有不同的一个batch数据进行流水线的并行,模型并行的通信和计算都比较复杂。
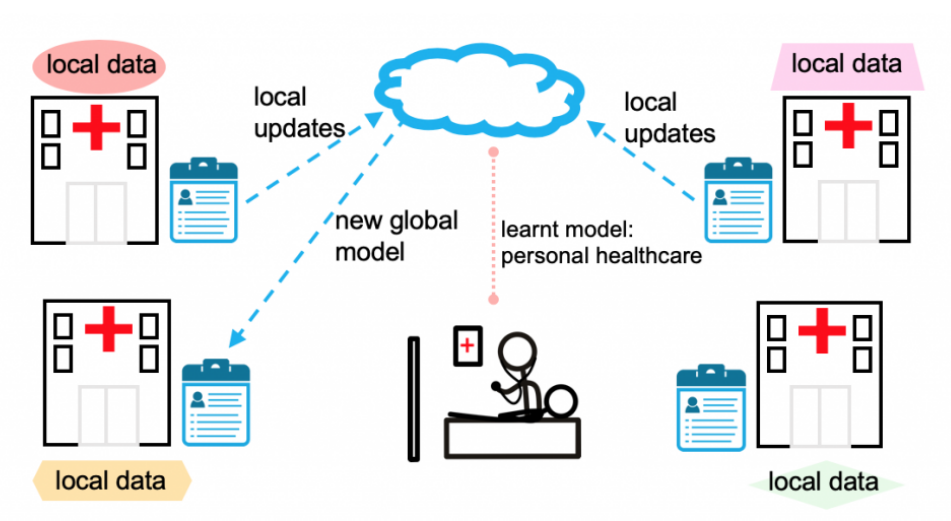
那么联邦学习,可以举个例子,我想训练出一个关于医疗的大模型,但是医疗数据往往都带有病患隐私信息,还是挺保密的,且数据往往独立分布在不同的医疗机构中。比如眼科医院,那么关于眼科的数据就很多,但是其他方面数据少;综合医院,各个科的数据都有,数量都比较均衡。传统式模型训练,会先聚集眼科医院的数据,综合医院的数据等等,在某中心训练机构,融合成一个庞大规模的数据集,然后使用这些数据选择分布式或其他方式训练出医疗大模型。
而联邦学习,希望这些数据集不要跑出本地(眼科数据集不要出眼科医院,只要数据通过网络传输就有泄露的风险)。联邦学习更希望眼科医院本地自己根据眼科数据训练一个模型,综合医院自己训练一个模型,这些医院就作为一个个的客户端。然后有一个服务端,统一调度这些客户端训练,客户端只需上传模型训练中的梯度数据或者是进行加密算法处理后(加噪声等)的梯度数据或模型参数数据到服务端,服务端再会根据某些聚合算法处理所有客户端上传来的数据,训练出一个更强大的更综合的比本地模型好的全局模型。
引言
本文的引言部分,感觉上是对摘要进行了扩充。首先,讲述了为什么会诞生出联邦学习,它能解决什么样的问题;其次,介绍了一下最基本的联邦学习的训练范式,就是联邦学习到底怎么训练模型的;然后,引言介绍了一些之前的关于联邦学习的综述,它们有哪些缺点,所以“导致我为什么要写这篇联邦学习综述”;最后,再次强调本文的一些“创新”,也就是一些贡献。
简单介绍一下联邦学习最基本普通的训练范式(以后的联邦算法可能复杂的多)。每个医院作为客户端有自己的本地数据集,还有一个云端(设备)作为服务端。服务端首先创建一个模型(全局模型),分发给每个客户端,客户端收到模型后(变为本地模型),根据本地数据训练,每轮每批次的更新都会产生本地模型的参数更新。然后,客户端将更新的参数都发给服务端,服务端接收到来自所有客户端的更新的模型参数,通过聚合等算法,更新自己服务端内部的全局模型;然后,服务端再次将更新后的全局模型发送给所有客户端,客户端接收到模型(变为本地模型)后再次根据本地数据集训练,更新、上传......循环往复下去,直到模型的性能达到预定标准。
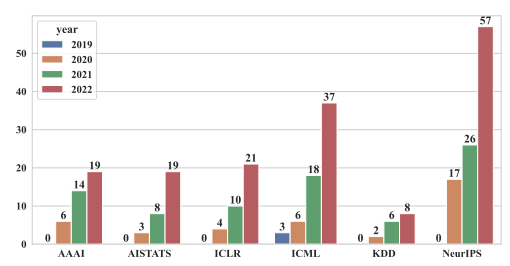
证明了,联邦学习自2020年后,开始火热起来,涌现了许多优秀论文,需要一个更新更全面的综述。
前提知识
本段主要讲了两个点,第一个点就是用公式去重新描述一遍联邦学习的基本训练范式(没有什么难度,这里也不多说);第二个点,粗略介绍了一下现今联邦学习遇到那些困难点,主要有三个:异构问题(heterogeneity problem),隐私泄露问题(privacy leakage),不公平性(unfairness)。这一段很明显是承上启下的段落。因为本文提出的分类方法就是根据联邦学习的基本训练范式和目前所遇困难进行划分的。
联邦学习的方法
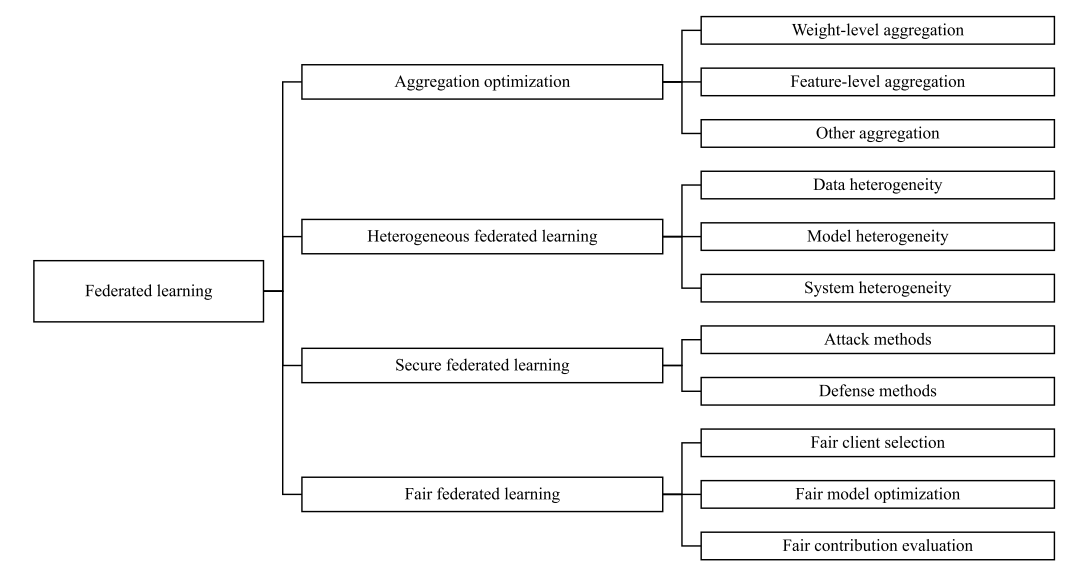
分类
先看本文的分类明细,为什么有Aggregation optimization这一大类,因为在联邦学习的训练范式中,服务端会有一个聚合算法,aggregation algorithm,来处理接收到的所有客户端上传的模型参数,所以如何处理这些模型参数,就可以划分出许多不同的方法。
为什么有Heterogeneous federated learning这一大类。因为在联邦学习会遇到异构问题,比如数据的异质性,体现在数据分布不一致,比如客户端A拥有数据集A,客户端B拥有数据集B,两个数据集的类别和类别个数一致,但是可能数据集A中类别1,2,3的数据量特别大其他类很少,而数据集B中类别4,5,6数据量特别大,其他类很少;抑或每个客户端之间的数据量相差甚远等等,这些都源于这些数据本身就独立存在于不同的机构中(数据孤岛)。还有模型异构问题,比如说客户端A用bert训练,客户端B用textcnn训练,那么这样客户端上传的更新的模型参数是不一致的,甚至代表着不同的语义信息,这需要如何处理。其次还有系统异构问题,比如客户端A有钱,GPU卡多,网络基础设施十分好,而客户端B没钱,GPU卡也少,网络也慢,这样不仅会导致客户端会考虑到本地资源设施使用不同的模型,而且在联邦学习中,资源多的那个客户端可能训练更快更好,但是还要等那个资源少的客户端训练完,并慢吞吞的将模型参数上传到服务端,而且可能上传的模型参数质量也一般,可能会拉低整体水平。
为什么有secure federated learning这一大类。因为当客户端通过网络上传更新的模型参数给服务端时,模型参数可能会泄露,攻击者如果知道模型结构和部分参数,就能反演出样本(甚至图像、人脸、文本);其次是,可能攻击者也并不需要这些隐私数据,就是投放一点数据分布极不一致或者脏数据,导致模型训练方向逐渐偏差,训练不出好模型。尽管数据传递时,没有上传本地私有数据集,但还是需要一些手段或者算法来保护的。
为什么有fair federated learning这一大类。其实联邦学习中的不公平性和前面的数据异质问题有很大关联。在联邦学习中,本地私有数据集大,数据质量好的客户端A就对全局模型贡献大,而另一旁那几个本地私有数据集小的客户端B、C对全局模型的贡献小到可以忽略不计,那么最终训练成的全局模型用于客户端A就十分有效,而用于客户端B、C时,效果可能还不如自己本地训练的模型。这就是所谓的不公平,大家一起训练,但最后的结果只对你有效,对我无效。
Aggregation optimization
weight-level
权重级别的聚合优化,也可以看做是模型参数的权重优化。最经典也是最早的联邦算法,FedAvg就是权重级别的聚合优化。FedAvg这个联邦算法中,服务端和每个客户端的模型是同一种模型,且结构一致。通俗来讲,服务端就是将收集到每个本地模型参数求和平均得到新的全局模型。它简单有效,但是缺点也很大。
举一个例子,客户端A和客户端B都是CNN模型,但是由于客户端A和客户端B的本地数据集分布不一致,可能客户端A的本地模型中的第一个卷积核是提取纹理特征,而客户端B的本地模型中的第一个卷积核是提取空间特征了。那么当客户端A和客户端B的两个本地模型进行FedAvg求和平均的时候,二者的第一个卷积核明明是提取不同的特征,但是却因为是处于两个模型的同一位置,被放在一起求和平均,这样明显是不太合理的,也会导致全局模型的性能下降。
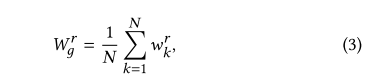
显然,像FedAvg这种location-based,基于位置的方法不太好。根据其他研究员发现的权重置换不变性(把模型第一层参数放第二层,第二层参数放第一层,总体性能没有多大变化),接下来的联邦算法就想办法对权重进行对齐,提取纹理特征的卷积核和提取纹理的卷积核一起求和平均,提取空间特征的卷积核和提取空间特征的卷积核放在一起求和平均,也就诞生了后来的FedMA和PFNM这种权重级别的注重权重对齐的算法。
feature-level
前面的权重级别的聚合算法,到后面主要注重于“权重对齐”,也就是找出不同客户端模型中“功能相近”的神经元,把它们匹配起来。那么就依赖于一个 距离度量 (distance metric)(比如欧式距离、余弦相似度)来匹配神经元,但这些度量未必能很好地反映神经元内部特征信息。而且会增大消耗。
特征级别的聚合算法,如经典的Fed-Square,更关注特征表示的对齐,更符合语义,同时在效率和性能上都有提升。至于每个算法具体是如何实现的,还需认真看该算法的论文。
other aggregation
很显然,前面提到的权重级别、特征级别的聚合优化关注“对齐/匹配”这件事上,但也有一些是用其他方法,如鲁棒聚合 (Robust Aggregation),梯度校正机制 (Gradient Correction),贝叶斯方法 (Bayesian Approaches)的聚合优化算法。
Heterogeneous federated learning
data heterogeneity
多任务学习
1. 什么是多任务学习 (Multi-task Learning)
-
定义:多任务学习就是同时学习多个相关任务 (tasks),希望通过共享知识来提升整体效果。
-
核心思想:任务之间不是完全独立的,可以通过 共享表示 (shared representation) 或 参数正则化 来捕捉任务间的关系。
-
例子:
-
在 NLP 里,一个模型同时做分词、词性标注和命名实体识别;
-
在 CV 里,一个模型同时做目标检测和语义分割。
-
本质:通过让任务“合作”,提高每个任务的泛化性能。
2. 为什么可以把联邦学习类比成多任务学习
在 联邦学习 中:
-
每个客户端 (client) 的数据分布可能不同(non-IID);
-
可以把 每个客户端的学习任务 看作是一个单独的 task;
-
那么 联邦学习就天然可以建模为一个多任务学习问题。
比如:
-
客户端 A 的数据是老年人医疗影像,客户端 B 的数据是年轻人影像;
-
直接做 FedAvg 会得到一个平均模型,可能对两个群体都不够好;
-
但如果把它们看作 两个相关但不同的任务,就能通过 MTL 的方式进行优化。
3. 多任务学习如何解决数据异质性问题
关键点:多任务学习能显式地建模 任务间的差异和共享。
-
在联邦学习里,这意味着它能 平衡“个性化”与“共享知识”:
-
全局共享:利用所有客户端的共同知识;
-
本地个性化:保留每个客户端特有的数据分布。
-
元学习
1. 什么是元学习 (Meta-learning)?
-
定义:元学习常被称作 “学习如何学习 (learning to learn)”。
-
区别:
-
普通机器学习:学的是某个任务的知识(比如识别猫狗)。
-
元学习:学的是“如何快速适应新任务”的能力。
-
-
常见思想:通过在很多不同任务上训练,学到一个 初始化模型 或 学习策略,使得模型在遇到新任务时,只需要少量数据或少量迭代就能快速适应。
举个例子:
如果一个人学会了骑自行车、滑板、滑雪,他再学滑冰会更快。这就是“学会了学习”。
2. 为什么元学习可以解决联邦学习中的数据异质?
联邦学习中的核心挑战是:
-
客户端数据分布不同 (non-IID),比如:
-
一个用户的数据是老年人照片,另一个是年轻人照片;
-
眼科医院的数据主要是关于眼部的一些数据,妇科医院的数据主要是关于妇科疾病的一些数据。
-
-
普通的 FedAvg 会得到一个平均的全局模型,这对任何单个客户端来说都可能 不够个性化。
元学习的优势:
-
它本身就是为了 处理任务之间差异 而设计的。
-
在 联邦雪中,可以把 每个客户端 看做成 一个任务;
-
用元学习方法训练一个 全局初始化模型,让它能够在每个客户端上 快速个性化适应。
迁移学习
1. 迁移学习 (Transfer Learning, TL) 在 联邦学习中的作用
-
定义:把在 源任务 (source task) 学到的知识迁移到 目标任务 (target task),特别适用于两个任务的数据分布不同但存在相关性。
-
在 FL 中的场景:
-
联邦学习通常先训练一个 全局模型 (global model)。
-
迁移学习思路:把全局模型当作 “源模型”,再在每个客户端上用其本地数据 fine-tune,得到 个性化客户端模型。
-
它为什么可以缓解数据异质性的原因:
-
全局模型保证了共享的基础能力;
-
fine-tune 让每个客户端根据自己的分布进行适配;
-
所以既 共享知识,又 保留个性化。
2. 域适应 (Domain Adaptation, DA) 在 FL 中的作用
-
定义:当源域 (source domain) 和目标域 (target domain) 的数据分布不同,但任务相同,比如:
-
源域是猫猫的图片,目标域是狗狗的图片;
-
源域是英文文本,目标域是中文文本。
-
-
在 FL 中的挑战:
-
不同客户端的数据分布差别非常大(domain shift)。
-
全局模型直接迁移可能效果很差。
-
-
那么域适应是如何起到作用的:
-
利用 对抗学习 (adversarial adaptation) → 让源域和目标域的特征分布尽可能接近。
-
表示分解 (representation disentanglement) → 把特征分为共享部分(domain-invariant)和特定部分(domain-specific)。
-
这样,客户端可以共享“稳定特征”,同时保留各自的特定信息。
-
3. 知识蒸馏 (Knowledge Distillation, KD) 在 FL 中的作用
-
定义:把一个 “大模型/教师模型 (teacher)” 的知识压缩/迁移到一个 “小模型/学生模型 (student)” 上。
-
在 FL 中的场景:
-
各客户端模型可能 架构不同(模型异构,不同客户端采用不同的模型) 或 性能不均衡;
-
不能直接参数聚合(因为权重维度不一样)。
-
-
解决方案:
-
通过知识蒸馏,客户端只需要共享 输出 (soft labels / logits),而不是参数或数据。
-
这样,学生模型能够从多个教师模型的预测中学习到知识,而不用暴露隐私。
-
它能够缓解异质性的原因:
-
不要求模型结构相同,因为传递的不是模型参数,而是软标签信息,可以共享知识;
-
蒸馏的是 预测分布,而不是参数,避免了直接权重平均导致的“不对齐”;
-
使得不同架构、不同分布的数据客户端也能共享知识。
基于聚类
1. 核心思想
-
不同客户端的数据分布可能差别很大,直接平均模型(如 FedAvg)容易导致 全局模型性能下降。
-
聚类思想:将客户端划分成多个 分布相似的群组 (clusters),每个群组训练一个局部的全局模型。
-
聚类后:
-
组内数据分布相对同质 → 模型收敛更稳定
-
组间差异不影响 → 避免全局平均带来的性能损失
-
3. 这类方法是如何缓解数据异质性
-
减少none-iid数据(数据分布不一致)冲击:
-
把数据分布相似的客户端聚在一起训练,组内数据接近同分布 → 组内模型收敛快、性能高。
-
避免不同分布的客户端混合平均模型导致梯度冲突。
-
-
组内聚合 + 组间独立:
-
聚类后的组内进行 FedAvg 或其他聚合,组间模型独立更新。
-
每个客户端可以得到 更适合自己分布的模型 → 个性化效果更好。
-
-
动态适应:
-
有些算法可以动态识别和调整聚类 → 即使客户端分布随时间变化,也能自适应。
-
model heterogeneity
模型异构,说的就是由于客户端的硬件资源,数据特点的不一致,客户端会选择最合适自己的本地模型,导致不同客户端使用不同的模型。对于这个问题,前面有提到过,迁移学习和知识蒸馏可以缓解这种问题。
system heterogeneity
系统异构,前面提到过,就是每个客户端的训练资源,网络传输速度等不对等,可能GPU多的、网络设备好的客户端能够更快速进行完本地模型的训练,上传模型参数给服务端,上传完之后,它自己需要等待其他客户端训练完,上传完模型参数,服务端完成聚合后再次开始训练,所以浪费了很多时间和能源。
通常,会使用“client select”,每一轮训练并不是所有的客户端都训练,而是会根据一些算法选择出部分客户端进行本轮训练,下一轮可能会更换客户端进行训练。总结来说,联邦学习通过 精细化客户端选择、动态截止时间、自适应更新 等策略,让训练过程更高效、更稳健,同时减少慢节点对全局训练的拖累。
Secure federated learning
攻击方法
1. 后门攻击(Backdoor Attack)
-
目标:通过在训练数据或模型中注入恶意“触发器”(trigger),这个“触发器”也就是所谓的“后门”,让模型在遇到特定输入时触发这个“后门”,输出攻击者期望的错误结果,而在其他正常数据上表现正常。
-
特点:难以被常规测试发现,因为攻击只在特定触发条件下生效。
-
在联邦学习中的实现:
-
模型替换(Model Replacement):攻击者直接修改上传到服务器的模型,使全局模型带有后门,而不是修改原始数据。
-
边界样本后门(Edge-case Backdoors):攻击模型对训练或测试数据中不常见的输入(长尾分布)进行误分类。
-
分布式后门攻击(DBA):将触发模式分散到不同客户端中训练,更隐蔽、更持久。
-
Neurotoxin:针对训练中不常变动的参数进行微调,提高后门持久性。
-
2.梯度攻击(Gradient Attack)
-
目标:通过分析共享的梯度或模型更新,反推出客户端的训练数据,侵犯用户隐私。
-
方法示例:
-
利用“dummy inputs & labels”(虚假输入和标签)优化,使生成的梯度接近真实梯度,从而重构原始数据。
-
从聚合梯度/更新中重建用户参与矩阵,破坏现有安全聚合协议。
-
递归梯度攻击(R-GAP):深度递归算法可在 CNN 或全连接层上重构训练数据。
-
生成式梯度泄露(Generative Gradient Leakage):即使在防御机制下,也可能泄露隐私信息。
-
3.模型中毒攻击(Model Poisoning Attack)
-
目标:通过篡改客户端的本地模型或训练数据,诱导全局模型输出攻击者指定的错误标签。
-
方法示例:
-
数据中毒:在本地训练时,将某些标签翻转或修改,误导全局模型。
-
本地模型中毒:直接修改本地模型参数上传,破坏鲁棒聚合机制。
-
防守方法
1.基于差分隐私的防御(DP-based Defense)
-
核心思想:在模型参数或梯度中加入随机噪声,使攻击者难以通过共享信息反推出用户隐私。
-
方法示例:
-
NbAFL:在客户端本地模型参数上加噪声,然后再上传聚合。
-
离散高斯噪声机制(Kairouz et al.):离散化数据后加入离散高斯噪声,再进行安全聚合。
-
多维Skellam机制:利用泊松随机变量测量差异,结合模运算进行安全聚合,提高隐私-精度权衡和通信效率。
-
作用:显然这个防守方法是针对于梯度攻击的
2.基于同态加密的防御(HE-based Defense)
-
核心思想:利用同态加密(Homomorphic Encryption, HE)在服务器端聚合加密后的模型参数,无需解密就能计算全局更新,从而保护客户端模型信息。
-
方法示例:
-
加密FL用于实体解析与逻辑回归:在加密域计算聚合,保证隐私并加速收敛。
-
部分同态加密框架:结合优化机制,避免在服务器端暴露模型。
-
BatchCrypt:高效批量加密与聚合,提出分析模型选择最优截断阈值,显著加速训练并降低通信开销。
-
作用:防止后门注入和模型/梯度泄露。
3.基于可信执行环境的防御(TEE-based Defense)
-
核心思想:通过硬件隔离机制(Trusted Execution Environment)在受信任区域执行敏感计算,保证数据和模型在硬件层面的安全性。
-
方法示例:
-
DarkneTZ:将DNN分为敏感和非敏感层,敏感层在TEE内执行,防御成员推理攻击,几乎无性能损失。
-
PPFL:在TEE中进行本地训练,采用分层贪心策略(Layer-wise Training)解决TEE内存限制问题,可逐块训练模型。
-
TEESlice:在TEE执行隐私敏感的模型切片,其余在普通AI加速器上执行,兼顾安全和低延迟。
-
作用:提供硬件级别的隐私保护,抵御梯度泄露和成员推理攻击,同时保持训练和推理效率。
Fair federated learning
什么是不公平性
在联邦学习中,由于客户端在算力、网络状况和数据量上的差异,如果直接用性能高的客户端参与训练,可能出现三种情况:
-
Over-representation(过度代表):高性能客户端被频繁选中,训练对它们的数据过度偏向。
-
Under-representation(低度代表):性能一般或弱的客户端很少被选中,它们的数据贡献很小。
-
Never-representation(从未被选中):性能最弱的客户端甚至永远没有机会参与训练。
这种不公平不仅会导致某些客户端数据被忽略,还可能让全局模型对高性能客户端的数据偏倚,影响整体性能。模型在高质量或数据量大的客户端上表现很好,但在弱客户端上表现差。模型无法很好泛化到某些少数群体,导致预测偏差。通常使用fair client selection和fair model optimiztion,来缓解。
当然,也会出现另一种情况:高贡献客户端得到的奖励不足;低贡献客户端“搭便车”,得到与贡献不符的好处。数据量多的客户端A参与联邦学习,其他许多客户端BCD数据量少,且数据分布不一致,这些客户端BCD拉低了最终全局模型对客户端A的奖励(全局模型性能可能还不如客户端A在本地训练),而其他客户端BCD它们参与了联邦学习,从其他数据多贡献多的客户端那里得到了更多知识,使得客户端BCD从全局模型中获利颇多(全局模型性能远高于它们的本地模型)。通常使用fair contribution evaluation来缓解。
fair Client Selection
核心思想:在保证全局模型效果的同时,让各类客户端都有合理的参与机会,缓解模型偏向。
-
平衡服务端利益和客户端利益
并不是每个客户端被选中的概率完全相同,而是兼顾:-
客户端的本地数据重要性(统计贡献)
-
客户端自身的计算能力与网络状况(系统约束)
-
(1) Fairness factors(公平因子)
-
设计选择策略,增加低性能或小数据量客户端被选中的机会。
-
示例:
-
CMAB(组合多臂赌博机):动态调整选择概率,减少类别或客户端的偏差。
-
Lyapunov 队列优化:保证长期参与率高于某阈值。
-
Reputation-based fairness:结合客户端历史表现(成功传输次数)和声誉决定选择概率。
-
(2) Client customization(客户端定制)
-
根据客户端能力调整模型或训练流程,让弱客户端也能参与:
-
Federated Dropout (FD):为每个客户端分配适合算力的子模型,而不再是统一分配相同的模型。
-
Adaptive Federated Dropout (AFD):基于激活分数动态生成最适合的子模型。
-
Ordered Dropout (OD):对算力相似的客户端使用同一子模型,并用知识蒸馏增强小模型能力。
-
ThrowRightAway (TRA):针对网络差的客户端减少重传,提高训练速度。
-
FedProx:允许客户端根据自身资源进行部分训练,支持不同本地轮次。
-
fair model optimiztion
通俗来说,就是服务端的 全局模型优化 时加入公平性约束。
(1) Objective function-based(基于目标函数)
-
核心思想:在定义损失函数或优化目标时,显式考虑公平性。通过修改优化目标,让模型“公平地”考虑每个客户端或群体的数据贡献。
典型方法:
-
AFL(Agnostic Federated Learning)
-
优化全局模型在客户端混合分布上的表现,防止模型只照顾部分客户端。
-
缺点:适用于客户端数量较少。
-
-
q-FFL
-
在 AFL 基础上增加权重参数 q,对客户端损失进行重加权,提升可扩展性。
-
-
fedMGDA+
-
多目标优化:同时优化每个客户端的损失,增强模型稳健性和公平性。
-
-
Ditto
-
通过个性化策略,提高全局模型的公平性与鲁棒性。
-
-
AgnosticFair / FCFL
-
面向 group fairness(群体公平)
-
AgnosticFair:加上公平性约束,使模型在未知测试分布下依然公平。
-
FCFL:多目标优化,最小化表现最差客户端的损失,并平滑考虑所有客户端,同时加入公平约束。
-
(2) Gradient-based(基于梯度)
-
核心思想:在聚合客户端梯度时,调整梯度方向和权重,减少客户端之间的冲突。通过梯度层面优化,缓解不同客户端对全局模型贡献的不平衡。
典型方法:
-
FedFV(Federated Fair Averaging)
-
检测客户端梯度间的冲突(使用余弦相似度)。
-
调整梯度的方向和大小,迭代消除冲突,使全局模型优化对各客户端更公平。
-
潜在问题:估计的梯度可能与最新更新不完全兼容。
-
fair contribution evaluation
(1) Self-reported information(自报信息)
-
核心思想:客户端主动提供数据量、数据质量、成本等信息,由服务器据此评估贡献。
-
特点:简单易用,但假设客户端可靠,不适用于不可信环境。
-
典型方法:HFFL(Hierarchically Fair Federated Learning)
-
利用“多劳多得”原则进行奖励分配。
-
公共可验证因素作为贡献依据,确保公平性。
-
(2) Individual evaluation(个体评估)
-
核心思想:根据客户端在特定任务上的表现来评估贡献,而不是全局模型性能。
-
特点:关注个体表现,更注重公平性。
-
典型方法:CFFL(Collaborative Fair Federated Learning)
-
使用 声誉机制(reputation)评价每个客户端上传梯度的质量。
-
奖励与贡献挂钩,客户端只获得与其贡献匹配的模型更新。
-
(3) Utility game(效用博弈)
-
核心思想:将客户端看作博弈玩家,贡献值对应博弈收益。
-
分配方案:
-
Egalitarian(平均分配):团队收益均分给成员;
-
Marginal gain(边际增益):玩家加入团队带来的收益;
-
Marginal loss(边际损失):玩家离开团队会造成的损失(最常用)。
-
-
典型方法:deletion method
-
去掉某客户端的数据,重训练模型,计算全局性能差异,差异越大,贡献越高。
-
(4) Shapley value(沙普利值)
-
核心思想:来自合作博弈理论,考虑 所有可能的加入顺序,公平计算每个客户端的边际贡献。
-
特点:
-
能真实反映客户端对模型的贡献;
-
顺序无关,保证公平;
-
计算复杂度高(O(2^n)),需要优化算法提高效率。
-
未来发展趋势
1.Dynamic Federated Learning(动态联邦学习)
-
问题背景:
-
现有 FL 假设客户端数据 静态不变。
-
实际场景中,客户端数据可能 连续变化(例如传感器数据实时采集)。
-
-
面临挑战:
-
灾难性遗忘(Catastrophic Forgetting):模型学习新数据时可能忘掉之前知识。
-
-
研究方向:
-
将 增量学习(Incremental Learning) 与 FL 结合。
-
目标:在不断学习新知识的同时保持对旧知识的识别能力。
-
2.Decentralized Federated Learning(去中心化联邦学习)
-
问题背景:
-
传统 FL 依赖 中心服务端 聚合模型。
-
第三方服务端可能 不可信,上传参数存在安全风险。
-
-
面临挑战:
-
如何在 无服务端参与 的情况下完成 FL。
-
-
研究方向:
-
目前已有尝试(如 He et al. 针对逻辑回归),但通用去中心化 FL仍是开放问题。
-
3. Scalability of Federated Learning(联邦学习的可扩展性)
-
问题背景:
-
大多数研究关注算法性能优化,但忽略 大规模参与者下的可扩展性。
-
-
面临挑战:
-
在合作场景中可能存在 大量客户端,需要高效指导协作和资源分配。比如,移动设备的联邦学习。孤岛式的联邦学习,可能参与训练的节点并不多,但每个节点中拥有大量的私有数据;而移动设备有很多,但每个移动设备中的私有数据并不多,即参与训练的节点很多,但是每个节点的数据量不多。
-
-
研究方向:
-
研究如何在 参与方数量增多 时仍保持 FL 性能和效率。
-
4. Unified Benchmark(统一基准)
-
问题背景:
-
目前缺少 统一的数据集和评价标准。
-
不同研究使用不同数据集,横向 FL(Horizontal FL)和纵向 FL(Vertical FL)也各自独立测试。
-
-
面临挑战:
-
缺乏标准化评测,导致 结果难以公平比较。
-
-
研究方向:
-
建立统一基准数据集和评价体系,便于社区对算法进行 公平、可比性评估。
-

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献3条内容

所有评论(0)