机器学习:线性回归,岭回归,拉索回归,逻辑回归,K-means
一、线性回归算法
-
需要掌握的知识点【重点】:
-
损失函数
-
梯度下降
-
学习率
-
-
回顾一下:在以前学习数学的时候,我们就学习过线性回归,只是说,之前学习的线性回归中,一定能够通过方程找到一个确定的答案,比如 y=bx+a
-
对于我们机器学习而言,如果数据的分布,没有实际上的规律,也就是说,他可能是分布在某一条线的周围,那么我们就需要去寻找一条直线,把样本数据的特征值带进去计算出来的结果【预测的结果】尽可能的接近样本数据的真实值,即 y预测要接近于y真实
-
我们的线性回归算法,就是去寻找这一条直线,直线中就存在很多的未知数,这些未知数就是某一个特征的【权重参数】,即某个特征对于结果的一个贡献度,最后在加上一个偏置项【常数】
-
线性函数和线性回归方程:
-
线性函数:严格的要求输入 x 是一次项的,比如 y=ax+b,对于 y=x^2+b 非线性的
-
线性回归方程:不需要看输入,看我们的权重是否是一次项,比如 y=ax^2+b,线性回归方程;y=a^2x^2+b 非线性的回归方程
-
-
在机器学习中,线性回归算法,主要就是去寻找一条内容尽可能拟合所有数据的一个方程,这个方程需要满足每一个预测的结果和真实的结果要贴近,即所有的预测结果-真是结果的值需要最小化
-
我们把预测结果-真是结果这个内容最小化,定义为损失函数,常见的损失函数MSE(均方误差损失),他的公式
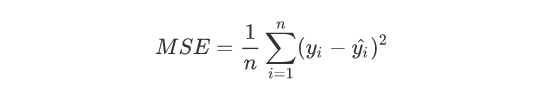
-
我们就通过最小化损失函数,从而算出线性回归中的参数信息
-
如何让损失函数最小化?有一些策略
-
为了最小化损失函数,我们采取对于不同的变量求偏导,令偏导数等于0,寻找极值
-
损失不是针对于某一个样本而言的,而是考虑的全部样本,一个样本的真实值于预测值之间的差值,我们称为残差
-
目前学习一个损失函数,均方误差损失,后面的分类问题,需要使用交叉熵损失函数来实现,分类问题和回归问题,使用的损失函数是有区别的,但是都是需要最小化的
-
线性回归方法思路:
-
先随机给一个权重参数,然后通过这个权重参数去预测数据集中的值,然后用这个预测值和真实值之间进行比较(使用均方误差),我们就去优化均方误差,让均方误差最小化,等同于得到了最好的权重参数
-
-
损失函数可以不可以基于预测的结果和真实的结果计算出来一个值?可以计算,算出来的这个值就是均方误差损失值,那么我们就要不断的去优化权重的取值,从而让MSE计算出来的值变小【损失越小,证明我们预测结果越准确】
-
重要概念:
-
机器学习的线性回归:就是寻找一条最佳的直线,能够更多的拟合数据
-
残差:真实值与预测值之间的一个差值,yTrue-yFalse
-
RSS:残差平方和,就是所有的参数的平方在求和
-
损失函数:损失函数就是用来衡量模型预测结果与真是结果之间的一个总体样本上的差值情况,在这里我们先选择了 MSE 损失函数
-
均方误差MSE:1/n RSS
-
因为我们想要保证模型预测的结果更加正确【接近真实值】,那么我们在训练模型的时候,就应该考虑模型训练的数据集上的预测结果和实际的结果之间的差值最小化,即我们就通过这种思想,来代替了传统解方程的思想。想要最小化损失函数,其实就是根据函数的结果去修正初始化的参数信息
-
切线的斜率
-
切线的斜率分为几种情况:4 种情况,设切线的斜率为 k
-
k = 0:平行于 x 轴
-
k 不存在:垂直于 x 轴
-
k > 0:切线过第一和第三象限
-
k < 0:切线要过第二和第四象限
-
梯度下降思想
-
如果我们按照之前的方程,去求梯度的方式求解最佳的w值,可能由于的不同的损失函数,导致求解出来的极值并不是最佳的w值
-
如果我们的特征信息比如有1000个,那么需要去求解1000次偏导数???这个事情是可以做的,但是他会极大的影响计算机的计算效率
-
所以针对于上述的两个问题,提出来了一个新的方案,来代替原来的方案去计算w的值,这个方案就叫梯度下降
-
梯度下降的知识点一:针对于不同的特征之间,做不同的计算,比如特征有 w1,w2,分别求解w1,w2,优化w1,w2
-
梯度表示的就是损失函数对于参数的偏导数
-
梯度下降?为什么是下降?而不是上升?
-
整理:
-
梯度下降中切线斜率的意义,大小,正负
-
梯度下降中更新参数 w 的公式的理解:w = w - a*梯度
-
a 就是学习率,尝试去画一下学习率大的可能发生后果,学习率小的时候可能发生的后果
-
复习
-
梯度下降?以为我们在更新权重w的时候,需要找到最佳的w的值,那么就应该使用 w新 = w旧-a*梯度值,这里的梯度值看作是w点的切线的斜率,那么斜率就有正负,无论在左边还是右边都要往低处移动,所以我们就是按照往梯度下降的地方进行移动
-
为什么可以使用数学解析式来实现权重的更新,为什么还需要使用梯度下降?
-
计算复杂度的问题
-
W = (X^TX)^-1X^TY,这个 (X^TX)^-1一定可以执行吗?如果说一个矩阵可逆,需要满足det(矩阵)!=0,如果是 2x2 的矩阵,就是对角线的乘积的差不能等于0,如果等于0了称为奇异矩阵。但是呢我们使用梯度下降的思想,就可以完成这样的操作
-
-
使用梯度下降思想之后,我们更新权重的公式就变成了
-
w 是原来的权重参数
-
a 是学习率
-
如果学习率太大:每次更新 w 变化大,可能会发生震荡,反复横跳
-
如果学习率太小:每次更新 w 变化小,但是可能进入局部最优解
-
学习率的设置是一个非常重要的事情,一般情况下都是给上比较小的值,比如0.1 0.01 0.001,可以动态的改变的这个值
-
-
梯度值就等于 w 这个点上的切线的斜率 w' = w - ·梯度值
-
全局最优解和局部最优解
-
如何产生的?如何去解决这个问题?
早停机制
-
如果训练模型1000次,但是在500次-600次的时候,发现模型基本上已经收敛,更新不动了,那么模型训练就会自动停止
截距
-
对于线性方程而言,截距一般情况都是需要存在的,即使对计算效率产生影响,但是它的加入能够提升方程的泛化能力,如果没有截距,方程必须过原点,有的话可以不过原点
梯度下降的方法
-
指的是如何使用训练数据集来求解我们的梯度值,进而更新权重
-
批量梯度下降:每次计算梯度值的时候,使用全部的训练数据集去计算,然后取平均值
-
好处:准确
-
弊端:计算量大,因为每一次都需要计算处理全部数据集
-
-
随机梯度下降:每一次计算梯度值的时候,随机选择一个训练数据集的样本,更新
-
好处:快,计算量小
-
弊端:不太准确,因为一个样本信息不能代表全部样本信息
-
-
小批量梯度下降:上述两种办法的折中方法,就把每一个小批次(batch、batch_size)的数据集用来计算梯度值
-
什么是批次:
-
-
认识3个单词 ---- 假设训练数据集有 1000 个数据
| epochs | batch(batch_size) |
|---|---|
| 轮次,就是模型需要学习训练数据集多少次,如果设置为1,表示模型只需要去学习1000个数据 1 次 | 他就是指的是,在每一个轮次中,分为多少次完成训练,这个多少次就去取决于设置的batch参数的大小,batch参数意义就是每一轮次中每一个小批次中取多少条数据训练,比如1000个数据,batch=16,就需要63个数据完成一次训练【1000/16向上取整】<br>如果这个参数设置过大,他根据数据集处理,需要更多的显存,如果你的计算机硬件设备跟不上,那么就会导致无法设置过大的batch,batch过大、过小都不好,一般选择2的倍数 |
-
需要掌握的内容就是思想,能够描述出三种方案分别是如何进行的
-
更新权重参数的步骤:假设以及初始化权重参数和学习率
-
第一步:首先需要找到当前点【数据信息】的梯度值
-
第二步:使用原来的权重参数值减去学习率乘以梯度值,得到新的权重值
-
第三步:循环执行,知道epochs【自己设置的参数】结束
-
-
为什么要用数据集去计算梯度值?
-
损失函数怎么来的?计算预测值和真实值之间的差值
我们利用这些思想来拟写相关的最小批量梯度代码:
import numpy as np
from sklearn.datasets import fetch_california_housing
from sklearn.linear_model import SGDRegressor
from sklearn.model_selection import train_test_split
import math
data = fetch_california_housing()
np.set_printoptions(suppress=True)
X, y = data.data, data.target
# 划分数据集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
#估计器SGDRegressor:
np.set_printoptions(suppress=False)
sgdr = SGDRegressor(loss='squared_error', penalty='l2',
alpha=0.001, eta0=0.01,
fit_intercept=True,max_iter=1000)
#设置批量大小
#设置每批数据大小
#设置轮次数,每一轮完成batchs次批
#sgdr.max_iter来自估计器的最后一个数值max_iter=1000
batchs = 16
#math.ceil()向上取整
batch_num = math.ceil(len(X_train)/ batchs)
epochs = sgdr.max_iter
print('每个epoch的batch数:',batchs)
print('每个epoch的样本数:',batch_num)
print('轮次数:',epochs)
for epoch in range(epochs):
for i in range(batch_num):
X_batch = X_train[i*batchs: (i+1)*batchs]
y_batch = y_train[i*batchs: (i+1)*batchs]
sgdr.partial_fit(X_batch, y_batch)
print(f'第{epoch}/{epochs}次训练已完成')
print(sgdr.score(X_test, y_test))
print('权重参数:\n',sgdr.coef_)
print('截距:\n',sgdr.intercept_)
重要内容
-
什么是梯度?
-
梯度就是一个向量,有大小有方向,梯度的大小就是当前点的斜率【偏导数的值】,梯度的方向就是函数增长最快的方向
-
-
方向导数
-
梯度下降为什么要使用?
-
梯度下降的目的?
-
使用梯度下降更新权重参数的公式
-
学习率:比如你想下山,你走一步的步长就理解为学习率,学习率过大,可能你一下子就走到了对面那座上的山腰,如果学习率太小,那么你要花费很多事件才可以走到山脚【一般是0.01】
-
梯度值如何计算的?偏导数在某一个点的值,也就是这点的斜率
-
在哪一个点来计算这个梯度值?权重参数理解为就是一个向量,他又目前的方向,这个点就是这个权重参数当前所在的位置
-
我们当前如何权重是w,那么我们是不是可以基于我们的w计算出来预测值,进而计算出来损失函数,我们要最小化损失函数,那么就相当于去找到权重参数的最优解,那么在求解梯度的过程中,梯度值 = 损失函数对于某一个特征权重的偏导数
-
损失函数值的计算依赖于什么?
依赖于真实值和当前的w权重计算出来的预测值
-
我们想要最小化损失函数,应该使用当前的权重去和数据集计算当前的预测值,然后和真实值之间计算损失值
-
所以梯度值的计算就依赖于数据集中的内容
-
-
三种梯度下降的方法 --- 求解梯度值的时候使用的数据集的样本数量
BGD
-
使用场景:
-
小数据集:当数据集较小时,批量梯度下降是一个不错的选择,因为它能保证较好的收敛性和准确性
-
不需要实时更新:如果模型不需要实时更新,例如在离线训练场景下,批量梯度下降是一个合理的选择
-
-
优点:
-
准确性高:由于使用所有训练样本来计算梯度,所以得到的梯度是最准确的,这有助于更稳定地收敛到全局最小值
-
收敛稳定:在每次更新时都会向最陡峭的下降方向移动,因此收敛路径相对平滑
-
-
缺点:
-
需要对所有训练样本进行处理才能更新一次权重,对于大数据集来说,这会导致每次迭代都非常慢
-
SGD
-
公式:i 表示样本数,j 表示特征数
-
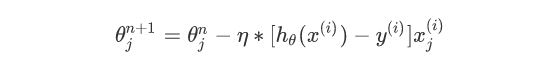
-
SGD 基本步骤:
-
初始化参数:
-
选择一个初始点作为参数向量θ的初始值
-
-
选择样本:
-
随机选取一个训练样本(x^i , y^i)
-
-
计算梯度:
-
使用所选样本 (x^i , y^i)来近似计算损失函数 J(θ)的梯度
-
-
更新参数:
-
根据梯度的方向来更新参数。更新公式为:【 是学习率,决定了每次迭代时参数更新的步长】
-
θ^{n+1} = θ^{n} - a* J(θ)的梯度
-
-
重复步骤 2 到 4:
-
对所有的训练样本重复此过程,直到完成一个完整的 epoch(即所有样本都被访问过一次)
-
-
重复多个 epoch:
-
重复上述过程,直到满足某个停止条件,比如达到最大迭代次数或者梯度足够小
-
-
输出结果:
-
输出最小化损失函数后的最优参数θ
-
-
-
注意事项:
-
学习率 a:需要适当设置,太大会导致算法不收敛,太小则收敛速度慢
-
随机性:每次迭代都从训练集中随机选择一个样本,这有助于避免陷入局部最小值
-
停止条件:可以是达到预定的最大迭代次数,或者梯度的范数小于某个阈值
-
-
优点:
-
计算效率高:每次只用一个样本进行梯度计算,因此每次迭代的速度很快
-
能够逃离局部最优解:由于随机梯度下降算法每次仅使用一个样本进行梯度计算和参数更新,因此它有可能跳出局部最优解,找到全局最优解。这通常是因为随机梯度下降算法在搜索过程中具有更大的随机性
-
-
缺点:
-
收敛路径不稳定:随机梯度下降的一个关键优势在于它能够快速地进行迭代并适应较大的数据集。然而,由于每次只使用一个样本进行更新,梯度估计可能较为嘈杂,这可能导致更新过程中出现较大的波动。在实际应用中,可以通过减少学习率(例如采用学习率衰减策略)来解决这个问题
-
mBGD
-
使用场景
-
中等规模数据集:当数据集大小适中时,小批量梯度下降是一个很好的折衷方案,既能够高效处理数据,又能够保持良好的收敛性
-
在线学习:在数据流式到达的场景下,小批量梯度下降可以有效地处理新到来的数据批次
-
分布式环境:在分布式计算环境中,小批量梯度下降可以更容易地在多台机器上并行执行
-
-
优点:
-
计算效率:相比于批量梯度下降,小批量梯度下降每次更新只需要处理一部分数据,减少了计算成本
-
梯度估计:相比于随机梯度下降,小批量梯度下降提供了更准确的梯度估计,这有助于更稳定地接近最小值
-
内存需求:相比批量梯度下降,小批量梯度下降降低了内存需求,但仍然比随机梯度下降要高
-
收敛速度与稳定性:小批量梯度下降能够在保持较快的收敛速度的同时,维持相对较高的稳定性
-
-
缺点:
-
设置合适的批量大小:需要选择一个合适的批量大小,太小的话可能会引入较高的方差,太大则会增加计算负担
-
仍需调参:虽然比 SGD 更稳定,但仍需要调整如批量大小和学习率等超参数
-
-
梯度下降优化
| 步骤 | 名称 | 目的 | 说明 | 常见方法 | 是否可选 |
|---|---|---|---|---|---|
| 1 | 标准化(Standardization) | 使不同特征具有相同的尺度,加快梯度下降收敛速度 | 梯度下降对特征尺度敏感,特征差异大会导致收敛慢或震荡 | - Z-Score(均值为0,标准差为1) - Min-Max(缩放到 [0,1]) | 强烈建议 |
| 2 | 正则化(Regularization) | 防止模型过拟合,提高泛化能力 | 在损失函数中加入惩罚项,限制模型复杂度 | - L1 正则化(Lasso) - L2 正则化(Ridge) - ElasticNet(L1+L2) | 可选,视情况而定 |
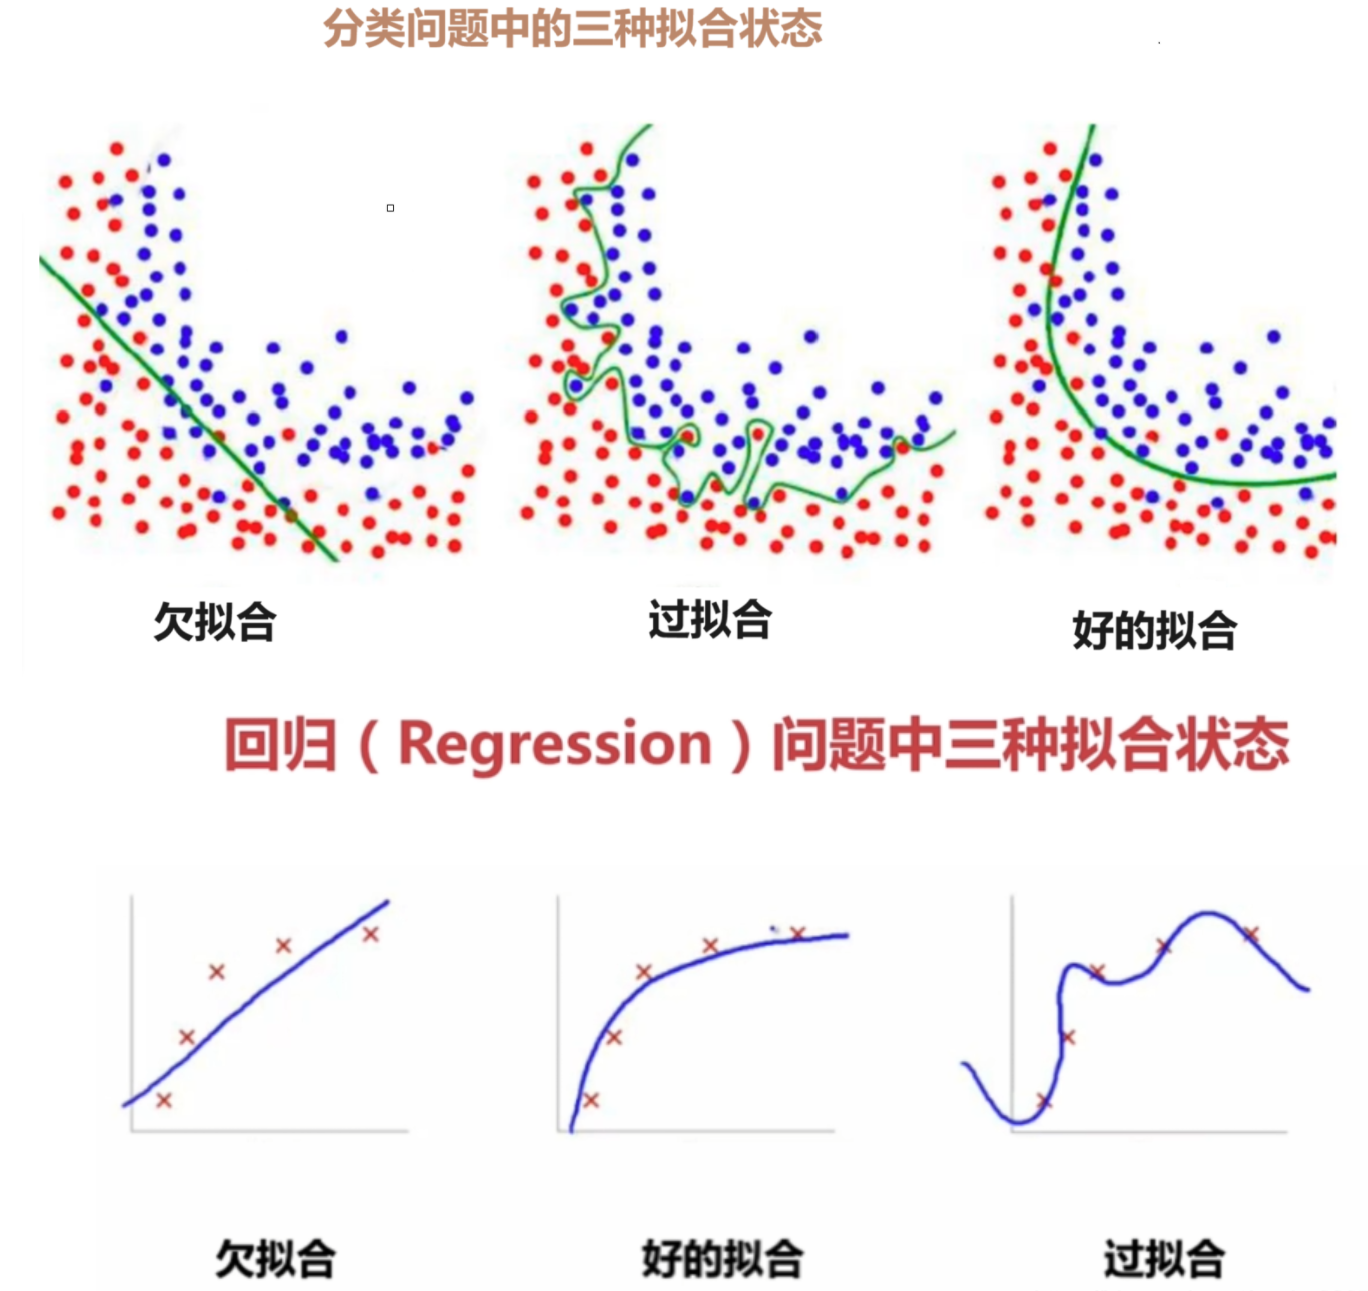
欠拟合和过拟合
欠拟合
-
欠拟合是指模型在训练数据上表现不佳,同时在新的未见过的测试数据上也表现不佳。这通常发生在模型过于简单,无法捕捉数据中的复杂模式时。欠拟合模型的表现特征如下:
-
训练误差较高
-
测试误差高
-
模型可能过于简化,不能充分学习训练数据中的模式
-
-
造成欠拟合的主要原因是由于没有选择好合适的特征值
-
解决欠拟合的方法包括:
-
增加模型的复杂度,如增加模型的层数、节点数或特征数
-
寻找更丰富的特征集合
-
过拟合
-
过拟合是指模型在训练数据上表现得非常好,但在新的未见过的测试数据上表现较差。这通常发生在模型过于复杂,以至于它不仅学习了数据中的真实模式,还学习了噪声和异常值。过拟合模型的表现特征如下:
-
训练误差非常低
-
测试误差较高
-
模型可能过于复杂,以至于它对训练数据进行了过度拟合
-
-
解决过拟合的方法包括:
-
增加训练数据量,以减少噪声和异常值的影响
-
使用正则化技术,如 L1 正则化和 L2 正则化,来约束模型参数的大小
-
简化模型复杂度,如减少模型的层数、节点数或特征数
-
使用交叉验证等技术来选择最佳的模型参数
-
L1 正则化和 L2 正则化
正则化就是防止过拟合,增加模型的鲁棒性,鲁棒是 Robust 的音译,也就是强壮的意思。就像计算机软件在面临攻击、网络过载等情况下能够不死机不崩溃,这就是软件的鲁棒性,鲁棒性调优就是让模型拥有更好的鲁棒性,也就是让模型的泛化能力和推广能力更加的强大。
泛化能力(Generalization Ability)是机器学习和人工智能领域的核心概念,指模型在从未见过的新数据(未参与训练的数据)上表现良好的能力。简单来说,就是模型学到的知识能否有效迁移到新场景、新样本中。推广能力和泛化是一个性质。
正则化的本质就是牺牲模型在训练集上的正确率来提高推广、泛化能力,W 在数值上越小越好,这样能抵抗数值的扰动。同时为了保证模型的正确率 W 又不能极小。故而人们将原来的损失函数加上一个惩罚项,这里面损失函数就是原来固有的损失函数,比如回归的损失函数通常是 MSE、分类的损失函数通常是 cross entropy 交叉熵,在损失函数后加上一部分惩罚项来使得计算出来的模型 W 相对小一些来带来泛化能力
常用的惩罚项有 L1 正则项、L2 正则项:
-
,对应曼哈顿距离
-
,对应欧氏距离,不常用,计算复杂
-
,更常用形式,它更容易计算梯度(导数简单),也更容易优化
在normalize对应API中的参数我们也引入过正则化:
from sklearn.preprocessing import normalize
#normalize参数:
#norm:归一化的方式
#norm='l1':每一条数据的和为1
#norm='l2':每一条数据的平方和为1
#norm='max':最大值归一化,每一条数据的最大值为1
#axis:归一化的轴
#axis=0:以每一列(特征)为单位进行归一化
#axis=1:以每一行(样本)为单位进行归一化
l1 = normalize(data,norm='l1',axis=1)
二、岭回归算法(了解思想,会用API即可)
1、概述
-
岭回归(Ridge Regression)是一种线性回归技术,它通过在损失函数中加入一个正则化项来解决多重共线性问题。岭回归在普通最小二乘法的基础上添加了一个 L2 范数惩罚项,这样可以减小模型的方差,从而提高模型的泛化能力
-
损失函数公式:
-
:所有的权重系数
-
λ:惩罚型系数,又叫正则项力度
-
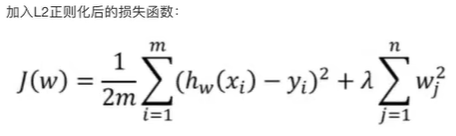
-
-
优点:
-
岭回归不会将权重压缩到零,这意味着所有特征都会保留在模型中,但它们的权重会被缩小
-
适用于特征间存在多重共线性的情况
-
岭回归产生的模型通常更为平滑,因为它对所有特征都有影响
-
2、API
-
sklearn.linear_model.Ridge()是 sklearn 提供的实现岭回归的一个模型,参数如下
| 参数名 | 类型 | 默认值 | 含义说明 |
|---|---|---|---|
alpha | float | 1.0 | 正则化强度,即 λ。值越大,正则化作用越强,防止过拟合。 |
fit_intercept | bool | True | 是否计算偏置项(截距 intercept_)。若为 False,则数据应已中心化。 |
solver | str | 'auto' | 求解系数的方法,可选:'auto', 'svd', 'cholesky', 'lsqr', 'sparse_cg', 'sag', 'saga', 'lbfgs'。默认自动选择最优方法。 |
normalize | bool | True | 是否对特征进行标准化(均值为0,方差为1)。如果在特征工程中已标准化,应设为 False。 |
max_iter | int | None | 最大迭代次数,仅在使用迭代求解器(如 'sag', 'saga', 'lsqr')时有效。默认根据数据自动选择。 |
-
solver可选值及其适用场景
| solver 名称 | 适用场景 | 说明 |
|---|---|---|
'auto' | 默认 | 自动根据数据类型和问题选择最合适的求解器 |
'svd' | 小数据集 | 使用奇异值分解,适合特征数较少的数据 |
'cholesky' | 中等数据集 | 使用 Cholesky 分解,数值稳定但计算较慢 |
'lsqr' | 大数据集 | 支持稀疏矩阵,迭代法,推荐用于大规模数据 |
'sparse_cg' | 大数据集 | 共轭梯度法,适合稀疏数据 |
'sag' | 大数据集 | 随机平均梯度下降,适合大数据和L2正则 |
'saga' | 大数据集 | 'sag' 的改进版,支持 L1 正则 |
'lbfgs' | 大数据集 | 优化算法,适用于多元逻辑回归等模型 |
-
属性
| 属性名 | 含义 |
|---|---|
coef_ | 模型训练后的权重系数(即回归系数 w) |
intercept_ | 偏置项(截距),当 fit_intercept=True 时存在 |
-
案例代码:
from sklearn.datasets import fetch_california_housing
from sklearn.metrics import mean_squared_error
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
# 获取数据
housing = fetch_california_housing(data_home='./')
data = housing.data
target = housing.target
# 数据集划分
X_train, X_test, y_train, y_test = train_test_split(data, target, test_size=0.2, random_state=42)
# 标准化
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)
# 岭回归模型
model = Ridge(alpha=0.5, max_iter=10000)
model.fit(X_train, y_train)
# 模型评估
print("权重系数为:\n", model.coef_)
print("偏置为:\n", model.intercept_)
y_predict = model.predict(X_test)
print("预测的数据集:\n", y_predict)
error = mean_squared_error(y_test, y_predict)
print("均方误差为:\n", error)
-
运行结果:
权重系数为:
 [ 0.85435493  0.12258513 -0.29431025  0.3391337  -0.00229496 -0.04083106
 -0.89654804 -0.86945607]
偏置为:
 2.071946937378619
预测的数据集:
 [0.71929761 1.76393157 2.70948388 ... 4.46862328 1.18774155 2.00931149]
均方误差为:
 0.5558731986895832
三、拉索回归算法(了解思想,会用API即可)
1、概述
-
拉索回归(Lasso Regression)是一种线性回归的扩展方法,它通过在损失函数中加入L1 正则化项来提高模型的泛化能力,同时具备特征选择的功能
-
Lasso回归的目标是最小化以下损失函数:
-
优点:
-
拉索回归可以将一些权重压缩到零,从而实现特征选择。这意味着模型最终可能只包含一部分特征
-
适用于特征数量远大于样本数量的情况,或者当特征间存在相关性时,可以从中选择最相关的特征
-
拉索回归产生的模型可能更简单,因为它会去除一些不重要的特征
-
-
拉索回归和岭回归对比
-
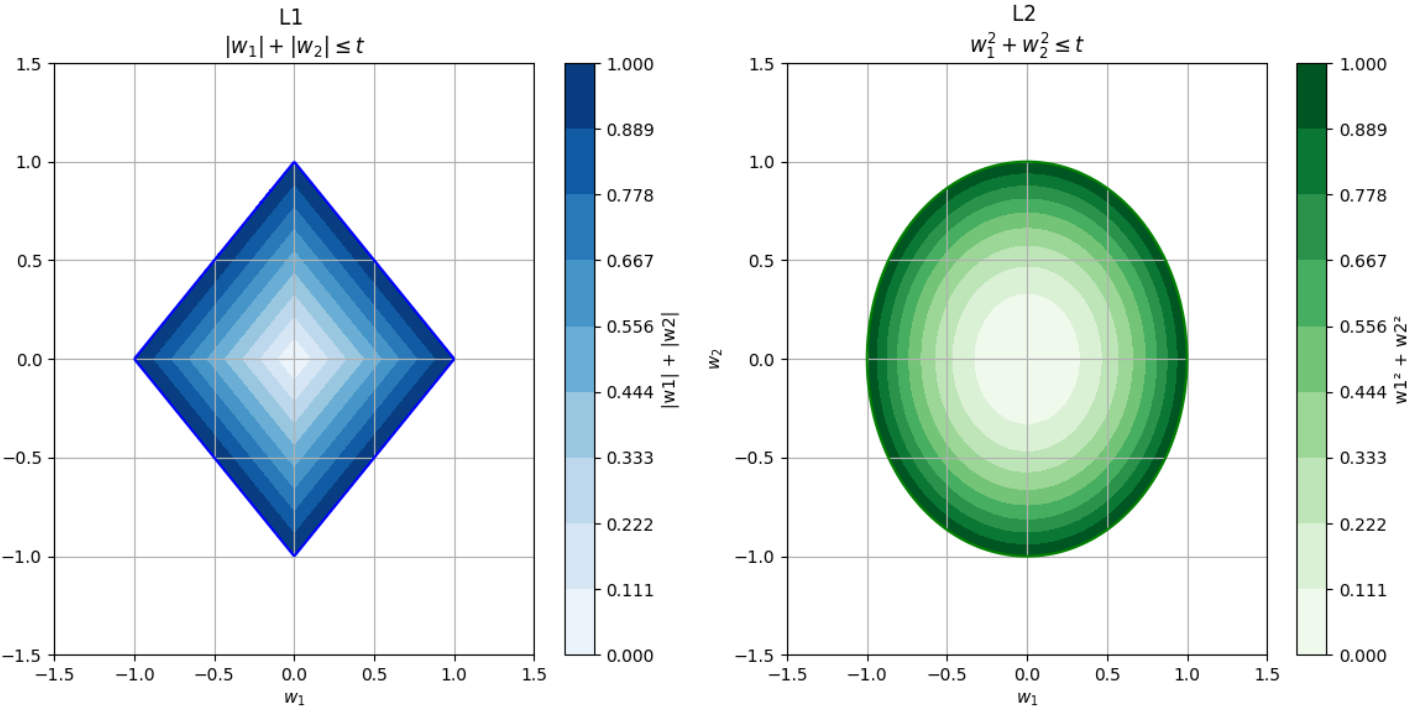
正则化区域几何图形
-
-
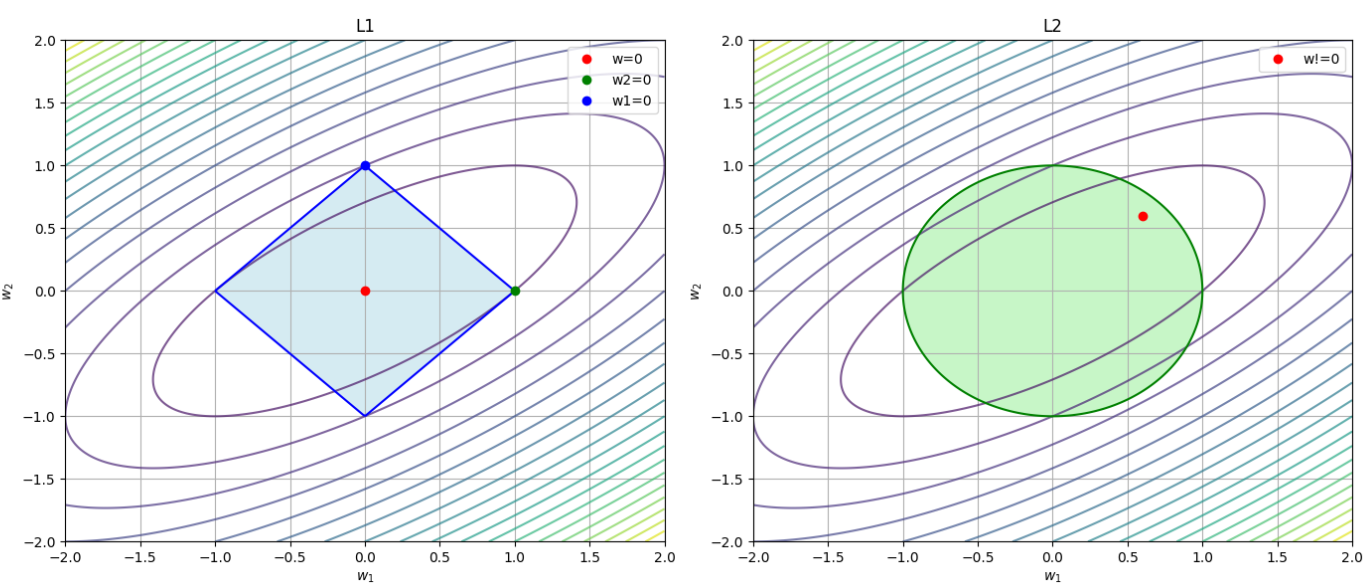
L1正则化(Lasso):基于权重的绝对值之和(即1-范数),在权重空间中形成一个多面体(如菱形或八面体)。这些多面体具有明确的顶点,这些顶点位于坐标轴上,使得某些权重容易被压缩至零,实现了特征选择
-
L2正则化(Ridge):由于其基于权重的平方和(即2-范数),在权重空间中形成了一个圆形或球形的约束区域。这种平滑的约束不易导致权重变为零
-
-
2、API
-
sklearn.linear_model.Lasso()是 sklearn 提供的实现拉索回归的一个模型,参数如下
| 参数名 | 类型 | 默认值 | 含义说明 |
|---|---|---|---|
alpha | float | 1.0 | 正则化强度,即 λλ,必须是非负数。值越大,正则化越强,系数越稀疏。 |
fit_intercept | bool | True | 是否计算模型的截距项(intercept)。如果为 False,则数据应已中心化。 |
precompute | bool 或 array-like | False | 是否使用预计算的 Gram 矩阵来加速计算。如果是数组,则使用该矩阵。 |
copy_X | bool | True | 是否复制输入数据 X,防止在训练过程中被修改。 |
max_iter | int | 1000 | 坐标下降法的最大迭代次数。 |
tol | float | 1e-4 | 收敛精度阈值。当系数更新的无穷范数变化小于该值时认为收敛。 |
warm_start | bool | False | 如果为 True,则重用上一次调用 fit() 的系数作为初始值。 |
positive | bool | False | 如果为 True,强制所有系数为非负数(适用于非负最小二乘问题)。 |
random_state | int 或 RandomState 实例 | None | 控制随机数生成器的种子,用于随机坐标选择(当 selection='random' 时)。 |
selection | str, {'cyclic', 'random'} | 'cyclic' | 特征更新顺序:<br> - 'cyclic':按顺序循环更新特征;<br> - 'random':每次随机选择一个特征更新。 |
-
属性
| 属性名 | 类型 | 含义说明 |
|---|---|---|
coef_ | ndarray | 模型训练后的系数向量(权重),形状为 (n_features,) 或 (n_targets, n_features) |
intercept_ | float 或 ndarray | 截距项(bias),如果 fit_intercept=True 则存在。 |
n_iter_ | int | 实际运行的迭代次数。 |
n_features_in_ | int | 拟合时输入的特征数量。 |
feature_names_in_ | ndarray of shape (n_features_in_,) | 输入特征的名称(如果输入是 pandas DataFrame 且版本支持)。 |
-
案例代码:
from sklearn.datasets import fetch_california_housing
from sklearn.linear_model import Lasso
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error
# 加载波士顿房价数据集
data = fetch_california_housing(data_home="./")
X, y = data.data, data.target
# 划分训练集和测试集
X_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 创建Lasso回归模型
model = Lasso(alpha=0.1) # alpha是正则化参数
model.fit(X_train, y_train)
# 得出模型
print("权重系数为:\n", model.coef_)
print("偏置为:\n", model.intercept_)
# 模型评估
y_predict = model.predict(x_test)
print("预测的数据集:\n", y_predict)
error = mean_squared_error(y_test, y_predict)
print("均方误差为:\n", error)
-
运行结果:
权重系数为:
 [ 3.92693362e-01  1.50810624e-02 -0.00000000e+00  0.00000000e+00
  1.64168387e-05 -3.14918929e-03 -1.14291203e-01 -9.93076483e-02]
偏置为:
 -7.698845419807466
预测的数据集:
 [1.04628114 1.61196314 2.30822511 ... 4.17618895 1.64031173 1.81210646]
均方误差为:
 0.6135115198058131
四、Logistic回归算法
1、概述
-
逻辑回归算法(Logistic Regression),它是一个分类算法(其实不算回归算法),主要用来解决的是二分类问题,比图像识别、垃圾邮件处理、预测天气、疾病诊断等
-
逻辑回归算法是通过估计事件发生的概率来预测类别,并根据这个概率决定最终的分类结果
2、Sigmoid函数
-
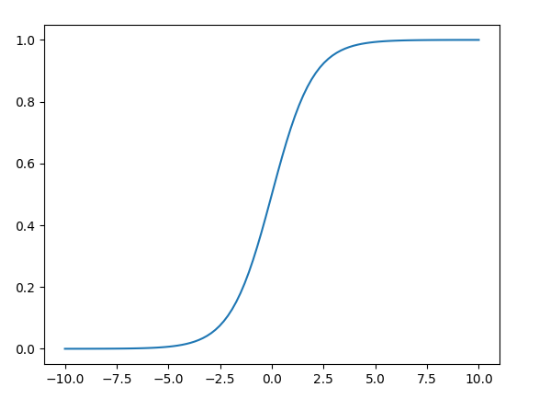
逻辑回归的核心思想:使用一个 Sigmoid 函数来将线性组合的输出映射到 [0, 1] 区间内,表示某一类事件发生的概率。该函数图像的数学表达式如下:
-
Sigmoid 函数的形式为:其取值范围在 (0,1) 之间,当 x=0 时,该函数的取值为 0.5,随着 x 的增大,对应的函数值将逼近于 1,称为正例;而随着 x 的减小,其函数值将逼近于 0,称为负例。根据中间的 0.5 作为分界线把数据分为二类,即当 y > 0.5 属于一类,当 y < 0.5 属于一类
-
-
二分类问题一般都是通过 0 和 1 表示不同的类别,所以逻辑回归二分类问题会把正例设置为 1,负例设置为 0
3、损失函数
-
总体:
-
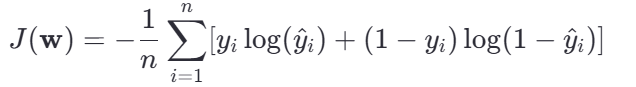
-
分段:
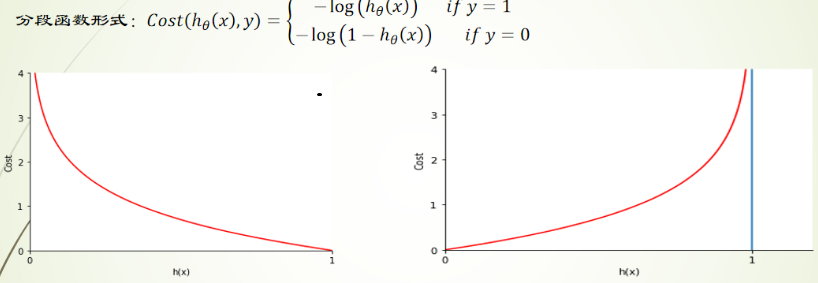
-
- 当时,损失函数简化为,我们希望模型预测为正类的概率尽可能大
-
所以,当真实标签是 1 时,模型预测为 1 的概率越低,损失越大
-
如果接近 0,那么接近 1,损失很大
-
如果接近 1,那么接近 0,损失小
-
当时,损失函数简化为,我们希望模型预测为负类的概率尽可能大
-
如果接近 0,那么接近 0,损失小
-
如果接近 1,那么接近 -∞,损失很大
-
所以,当真实标签是 0 时,模型预测为 1 的概率越高,损失越大
-
4、API
-
sklearn.linear_model.LogisticRegression是sklearn.linear_model.LogisticRegression中用于实现逻辑回归算法的类,LogisticRegression()用来创建模型对象,参数如下:
| 参数名 | 类型 | 默认值 | 含义说明 |
|---|---|---|---|
penalty | str 或 None,可选:'l1'、'l2'、'elasticnet'、'none' | 'l2' | 指定正则化类型:<br> - 'l1':L1正则化(Lasso),鼓励稀疏性;<br> - 'l2':L2正则化(Ridge),默认值;<br> - 'elasticnet':L1+L2混合正则化;<br> - 'none':不使用正则化。 |
C | float | 1.0 | 逆正则化强度。值越大,正则化越弱(即模型更倾向于拟合训练数据);值越小,正则化越强(模型更简单,防止过拟合)。 |
max_iter | int | 100 | 最大迭代次数,用于优化算法(如梯度下降)收敛。当模型未收敛时,可以适当增加此值。 |
solver | str | 'lbfgs' | 优化算法选择,不同 solver 支持不同的正则化类型:<br> - 'liblinear':支持 L1 和 L2,适合小数据集;<br> - 'lbfgs':默认,支持 L2 和 'none';<br> - 'saga':支持 L1、L2 和 ElasticNet,适合大数据集。 |
fit_intercept | bool | True | 是否添加截距项(bias)。 |
random_state | int 或 RandomState 实例 | None | 控制随机数生成器,用于需要随机性的算法(如 'saga' 求解器或 'elasticnet')。 |
multi_class | str,可选:'auto'、'ovr'、'multinomial' | 'auto' | 多分类处理方式:<br> - 'ovr':一对多(One-vs-Rest);<br> - 'multinomial':直接优化多分类损失函数。 |
-
predict_proba是逻辑回归模型中一个非常重要的方法,它返回每个样本属于每个类别的概率估计,与predict方法的区别
| 方法名 | 返回值类型 | 返回值含义 | 是否包含概率 |
|---|---|---|---|
predict(X) | 一维数组 | 每个样本的预测类别标签(0 或 1) | ❌ |
predict_proba(X) | 二维数组 | 每个样本属于每个类别的概率(如 [0.8, 0.2]) | ✅ |
-
案例代码:
from sklearn.linear_model import LogisticRegression
from sklearn import datasets
from sklearn import model_selection
from sklearn.metrics import accuracy_score
from sklearn.preprocessing import StandardScaler
import numpy as np
# 鸢尾花数据集
iris = datasets.load_iris()
# 删除第三类鸢尾花
data = iris['data']
target = iris['target']
data = data[target != 2]
target = target[target != 2]
# 划分训练集数据和测试集数据
X_train, X_test, y_train, y_test = model_selection.train_test_split(
data,
target,
random_state=42
)
# 创建模型
model = LogisticRegression(max_iter=1000)
# 训练模型
model.fit(X_train, y_train)
# 权重
print(model.coef_)
# 偏置
print(model.intercept_)
# 模型得分
print("模型得分:\n", model.score(X_test, y_test))
# 预测分类对应的概率
proba = model.predict_proba(X_test)
print("预测分类对应的概率:", proba)
-
运行结果:
[[ 0.44451889 -0.83493191  2.18024035  0.91771904]]
[-6.37062771]
模型得分:
 1.0
预测分类对应的概率: [[0.00131876 0.99868124]
 [0.0168257  0.9831743 ]
 [0.00334379 0.99665621]
 [0.9681417  0.0318583 ]
 [0.94085396 0.05914604]
 [0.97035722 0.02964278]
 [0.99308972 0.00691028]
 [0.03341405 0.96658595]
 [0.97354682 0.02645318]
 [0.97790287 0.02209713]
 [0.95381819 0.04618181]
 [0.95903846 0.04096154]
 [0.00471857 0.99528143]
 [0.98517651 0.01482349]
 [0.00997426 0.99002574]
 [0.98050496 0.01949504]
 [0.00231911 0.99768089]
 [0.001408   0.998592  ]
 [0.97334143 0.02665857]
 [0.95974935 0.04025065]
 [0.00792767 0.99207233]
 [0.02306954 0.97693046]
 [0.95816672 0.04183328]
 [0.98318739 0.01681261]
 [0.02809199 0.97190801]]
五、K-means算法(yolo锚框的基础)
1、无监督学习
-
无监督学习(Unsupervised Learning)计算机根据样本的特征或相关性,实现从样本数据中训练出相应的预测模型
-
无监督学习模型算法中,模型只需要使用特征矩阵X即可,不需要真实的标签y,聚类算法是无监督学习中的代表之一
-
聚类算法:
-
数据集中,拥有数据特征,但是没有具体的标签
-
将数据划分成有意义或有用的簇
-
聚类算法追求“簇内差异小,簇外差异大”。而这个 “差异”便是通过样本点到其簇质心的距离来衡量
-
-
聚类算法和分类算法的区别:
-
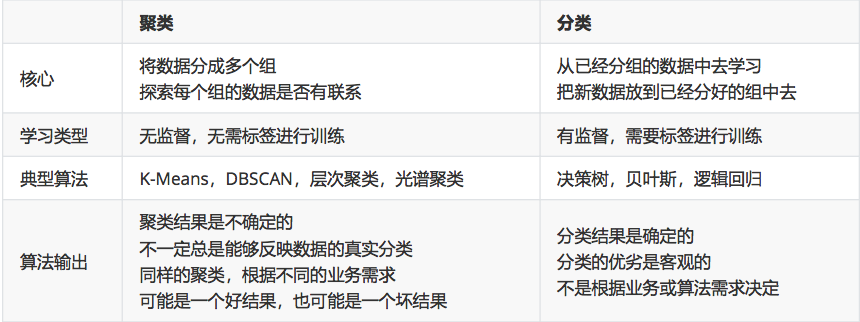
2、K-means 算法
-
K-means 是一种流行的聚类算法,主要用于无监督学习中对未标记的数据进行分类。该算法的目标是将数据集中的样本划分为K个簇,使得簇内的样本彼此之间的差异最小化。这种差异通常通过簇内所有点到该簇中心点的距离平方和来衡量
| 属性 | 含义 |
|---|---|
| 簇 | Kmeans算法将一组N个样本的特征矩阵X划分为K个无交集的簇,直观上看来簇是一个又一个聚集一起的数据,在一个簇中的数据就认为是同一类,簇就是聚类的结果表现,其中簇的个数是一个超参数 |
| 质心 | 每个簇中所有数据的均值u,通常被称为这个簇的"质心",在二维平面中,簇的质心横坐标是横坐标的均值,质心的纵坐标是纵坐标的均值 |
-
K-means 算法的基本步骤:
-
随机抽取
k个样本作为最初的质心,这可以通过随机选取数据集中的K个样本或者使用一些启发式方法来实现 -
计算每个样本点与
k个质心的距离(通常是欧氏距离),将样本点分配到最近的一个质心,生成k个簇 -
对于每个簇,计算所有被分该簇的样本点的平均值作为新的质心
-
当质心的位置不再发生变化或者迭代结束,聚类完成
-
2.1 确定 k 值
-
采用最小簇内节点平方偏差之和算法(Within Cluster Sum of Squares,WCSS)进行确定,WCSS 越小,表示簇内样本越相似,聚类效果越好
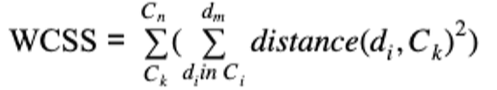
-
比如有一个数据集,绘制 wcss-k 图出来的图形如下:曲线下降剧烈的点,称之为肘点,k 值优先选择肘点
-
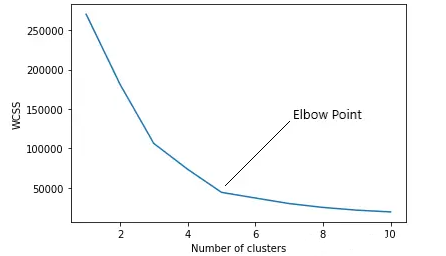
2.2 API
-
K-means 算法输入的是 k 值和样本数据结合,输出的是 k 个簇的集合
-
sklearn.cluster.KMeans类是scikit-learn库提供的一个用于执行K-means聚类算法的工具。它提供了一个易于使用的接口来执行聚类操作,并且内置了多种优化选项,KMeans()用来实例化模型对象,参数如下:参数名 类型 默认值 含义说明 n_clustersint 8要创建的簇(cluster)数量,即你期望将数据分成几类 initstr({'k-means++', 'random'})或数组或可调用函数 'k-means++'初始化质心的方式: - 'k-means++':使用启发式方法选择初始质心,加快收敛速度; -'random':随机选择初始质心n_initint 10运行 K-Means 算法的次数。每次使用不同的初始质心,最终选择具有最低惯性值(inertia)的模型作为结果 max_iterint 300单次运行中最大的迭代次数。即每次 K-Means 运行最多进行多少次迭代,防止陷入无限循环 -
属性
属性名 类型 含义说明 cluster_centers_ndarray 存储每个聚类的中心点坐标,形状为 (n_clusters, n_features)labels_ndarray 存储每个数据点的聚类标签,形状为 (n_samples,) -
-
make_blobs方法是 Sklearn 库中sklearn.datasets模块提供的一个函数,用于生成一组二维或高维的数据簇。这些数据簇通常用于聚类算法的测试。具体来说:
| 类别 | 名称 | 类型 | 含义说明 |
|---|---|---|---|
| 参数 | n_samples | int | 指定生成的样本数量 |
centers | int | 定义数据集中簇的中心数量(即类别数) | |
random_state | int 或 None | 设置随机数生成器的种子,确保每次运行结果一致(可重复性) | |
| 返回值 | X | ndarray | 形状为 (n_samples, n_features) 的数组,表示生成的样本数据 |
y | ndarray | 形状为 (n_samples,) 的数组,表示每个样本所属的簇标签(中心索引)<br>(可选返回,可用 _ 忽略) |
算法演示:
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs
from sklearn.model_selection import train_test_split
import numpy as np

X,y = make_blobs(n_samples=1000, n_features=2, centers=4, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
#估计器KMeans参数:
# n_clusters:聚类中心数量
# init:初始化方法
# max_iter:最大迭代次数
# random_state:随机种子
kmeans = KMeans(n_clusters=4)
kmeans.fit(X_train)
print('模型得分:\n',kmeans.score(X_test))
test = np.array([[0.5,5],[-1,6]])
print('预测结果:\n',kmeans.predict(test))
机器学习外层的知识森林就到此结束了,后续我们会深入学习的森林,也就是继续探讨机器学习的【深度学习】部分。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 27
 0
- 0


 已为社区贡献2条内容

所有评论(0)