机器学习:模型选择与调优,贝叶斯,决策树,随机森林与阶段性回顾
一、模型选择和调优
-
模型性能的验证:使用交叉验证实现
-
保留交叉验证:把数据集按照一定的比例进行划分,比如8:2、7:3,然后大量的数据集用来做训练,少部分数据集做模型性能测试,这样的验证方法存在一定的问题:假设二分类问题,其中一个类别占总数据集的80%,那么在数据集划分的时候,有可能把80%占比的类别全部会分到训练集,导致训练过程中没有第二个类别,但是测试中只有第二个类别
-
k-折交叉验证:就是把数据集换分为k-flod(k个折子),比如我们把数据集划分为10flod,第一训练就把第一个flod作为验证集,剩余的2-10作为训练集,第二次训练把第2个flod作为验证集,剩余的1,3-10作为训练集,以此类推,直到每一个flod都用于训练和验证。最终就是把10次2验证结果的平均值作为模型性能输出指标。
from sklearn.model_selection import cross_val_score from sklearn.datasets import load_iris from sklearn.neighbors import KNeighborsClassifier iris = load_iris() data, target = iris.data, iris.target knn = KNeighborsClassifier(n_neighbors=5) #使用k-flod交叉验证,参数介绍: # estimator:估计器对象 # X:数据集 # y:标签 # cv:交叉验证的次数 result = cross_val_score(knn, data, target, cv=5) print("k-flod交叉验证结果:", result) print("k-flod交叉验证结果平均值:", result.mean()) k-flod交叉验证结果: [0.96666667 1. 0.93333333 0.96666667 1. ] k-flod交叉验证结果平均值: 0.9733333333333334存在问题:如果数据集存在极端的情况下,比如某一个类别数据比较少,那么可能会导致某一个flod里面只有这个类别的全部信息,而没有其他类别信息,也会导致模型验证不准确
-
分层k-折交叉验证:**k-折交叉验证加了一个方案,保证原始数据集中如果A:B:C=1:2:1,那么在划分为k-flod之后,每个flod中也保证数据集的比例是A:B:C=1:2:1
iris = load_iris() X, y = iris.data, iris.target # knn knn = KNeighborsClassifier(n_neighbors=3) # 创建分层k折交叉验证对象,参数: #n_splits:默认值5,fold数量,至少为2 #shuffle:默认值False,是否在分批之前对每个类的样本进行打乱数据 #random_state:随机数种子 skf = StratifiedKFold(n_splits=5, shuffle=False, random_state=None) total = 0 # 调用 split 方法,得到每一批次的训练数据集和验证数据集的索引值 --- 批次的思想,把数据换分成多少分,分成几次完成 for i, (train_index, test_index) in enumerate(skf.split(X, y)): # 得到每一批次中的训练集数据和验证集数据内容 x_train, x_test, y_train, y_test = X[train_index], X[test_index], y[train_index], y[test_index] print(y_train) print(y_test) # # 获取每一次验证的得分 # knn.fit(x_train, y_train) # # 模型得分 ---- 每一个小批次的得分,并不可以使用一个小批次的结果来代表最终的结果 # score = knn.score(x_test, y_test) # print(f"第{i+1}次准确率:", score) # total += score # print("平均每一次的准确率:", total/skf.get_n_splits(X, y)) -
-
模型超参数的选择和设置
-
比如我们的knn模型,需要设置一个参数,k 值,如果我们没有经验,啥也不知道,数据集的情况也不了解,那么我们就好像碰运气一样,需要不断的去测试 k 值,找到最合适的 k 值。问题:每一次设置 k 值,我们是不是都需要运行一次代码。那么有没有一种办法,我们只要设置 k 值的范围区间,运行一次代码,让他自己去找到设置 k 值范围区间模型效果最好的 k 值。
-
提供的方案叫做网格搜索,就是把需要设置的超参数的数据内容,提供给网格搜索对象,它会自动的去帮我们找到最佳的
iris = load_iris() data, target = iris.data, iris.target #鸢尾花分类 ---knn模型 --- 不设置超参数k ,让网格搜索帮我们设置 knn = KNeighborsClassifier() #超参数可选择情况 param_grid = {'n_neighbors': [1, 3, 5, 7, 9]} #网格搜索对象 #estimator: 模型 #param_grid: 超参数可选择的区间 #cv: 交叉验证次数 grid_search = GridSearchCV(estimator=knn, param_grid=param_grid,cv=2) #调用fit方法,进行网格搜索 grid_search.fit(data, target) #打印结果 #最佳超参数 print("best_params_:", grid_search.best_params_) #最佳估计器 print("best_estimator_:", grid_search.best_estimator_) #最佳模型得分 print("best_score_:", grid_search.best_score_) best_params_: {'n_neighbors': 9} best_estimator_: KNeighborsClassifier(n_neighbors=9) best_score_: 0.9533333333333334 -
-
模型的保存和加载
-
记住以下这两个即可:
-
import joblib #保存模型 joblib.dump(knn, "knn.pkl") #读取模型 joblib.load('knn.pkl')具体例子:
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
import numpy as np
from sklearn.neighbors import KNeighborsClassifier
wine = load_wine()
data, target = wine.data, wine.target
np.set_printoptions(suppress=True)
print(data[:5])
print(wine.target_names)
X_train, X_test, y_train, y_test = train_test_split(data, target, test_size=0.2, random_state=42)
knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(X_train, y_train)
import joblib
#保存模型
joblib.dump(knn, "knn.pkl")
import joblib
import numpy as np
knn = joblib.load('knn.pkl')
my_data = np.array([[15,1.5,3.0,18,115,2,3,0.20,3,6,1.5,4,1001]])
#预测
result = knn.predict(my_data)
print(result)
二、阶段复习
-
使用别人写好了的算法,此阶段记住sklearn 库里面的算法API怎么调用就可以了
-
调用别人的 API 之前,需要知道这个 API 的作用,是如何计算的【原理】
-
加载数据集
-
核心API:
sklearn.datasets模块 -
from sklearn.datasets import load_iris, fetch_california_housing
iris = load_iris()  # 加载内置小数据集
housing = fetch_california_housing()  # 加载网络数据集
数据集是否需要数值转换(特征提取)
非数值特征→数值特征
from sklearn.feature_extraction import DictVectorizer
dict_vec = DictVectorizer(sparse=False)  # 字典特征提取
data = dict_vec.fit_transform([{'city': '北京', 'temperature': 100}])
文本→数值
from sklearn.feature_extraction.text import TfidfVectorizer #norm:就是把结果在使用正则化技术进行正则化之后在输出,默认使用的是l2范数 tv = TfidfVectorizer(norm="l2") text_data = tv.fit_transform([ 'This is the first document.', 'This document is the second document.']) print(result.toarray()) print(tv.get_feature_names_out()) -
-
特征工程(预处理与降维)
标准化/归一化
from sklearn.preprocessing import StandardScaler, MinMaxScaler # 标准化(均值0,方差1) std_scaler = StandardScaler() data_std = std_scaler.fit_transform(data) # 归一化(缩放到[0,1]) mm_scaler = MinMaxScaler() data_mm = mm_scaler.fit_transform(data) #normalize归一化: #norm:归一化的方式 #norm='l1':每一条数据的和为1 #norm='l2':每一条数据的平方和为1 #norm='max':最大值归一化,每一条数据的最大值为1 #axis:归一化的轴 #axis=0:以每一列(特征)为单位进行归一化 #axis=1:以每一行(样本)为单位进行归一化 l1 = normalize(data,norm='l1',axis=1)降维
from sklearn.decomposition import PCA
pca = PCA(n_components=2)  # 保留2个主成分
data_pca = pca.fit_transform(data)
数据集划分
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=0.2, random_state=42
交叉验证划分
from sklearn.model_selection import StratifiedKFold skf = StratifiedKFold(n_splits=5, shuffle=True) # 分层k折(保持类别比例) for train_index, test_index in skf.split(X, y):模型训练与优化
基础模型训练
from sklearn.neighbors import KNeighborsClassifier knn = KNeighborsClassifier(n_neighbors=5) knn.fit(X_train, y_train) # 拟合训练数据→得到模型超参数优化
from sklearn.model_selection import GridSearchCV param_grid = {'n_neighbors': [1,3,5,7,9]} grid_search = GridSearchCV(estimator=knn, param_grid=param_grid, cv=2) grid_search.fit(data, target) # 自动搜索最优参数模型评估
准确率得分
score = knn.score(X_test, y_test)  # 测试集准确率
print(grid_search.best_score_)  # 交叉验证最优得分
混淆矩阵/ROC
from sklearn.metrics import confusion_matrix, roc_auc_score y_pred = knn.predict(X_test) cm = confusion_matrix(y_test, y_pred) # 混淆矩阵 auc = roc_auc_score(y_test, y_pred_proba) # AUC值模型保存与加载
import joblib
# 保存模型
joblib.dump(knn, 'knn.pkl')
# 加载模型
loaded_knn = joblib.load('knn.pkl')
预测(推理)
类别预测:
y_pred = knn.predict(X_new) # 输出类别标签(如0,1,2)概率预测:
y_proba = knn.predict_proba(X_new) # 输出每个类别的概率(如[[0.8, 0.1, 0.1]])大概关键流程:
-
数据准备:加载→特征提取→预处理(标准化/降维)
-
模型训练:划分数据集→选择 estimator→调用
fit() -
优化评估:交叉验证→网格搜索→指标检测
-
部署应用:保存模型→加载模型→推理预测
三、贝叶斯算法
-
使用概率来估计数据的类别信息
-
条件概率:在B发生了的时候,A发生的概率,数学符号P(A|B)
P(A|B)=P(A∩B) / P(B)
-
P(A∩B):就是AB同时发生的概率
-
P(B):B发生的概率
-
独立事件:事件A和事件B两个发生的时候,互不影响 :
P(A∩B) = P(A)*P(B)
然后还要记住变种式子:
P(A∩B)=P(A∣B)⋅P(B)=P(B∣A)⋅P(A)
-
贝叶斯定理:
P(A∣B)= P(B∣A)P(A) / P(B)
-
在这个公式中:
-
:在事件 B 发生的条件下,事件 A 发生的概率(后验概率,即更新后的信念)
-
:在事件 A 发生的条件下,事件 B 发生的概率(似然,即观测数据的可能性)
-
:事件 A 的先验概率(未考虑 B 时的初始概率)
-
:所有情况下 B 发生的总概率
-
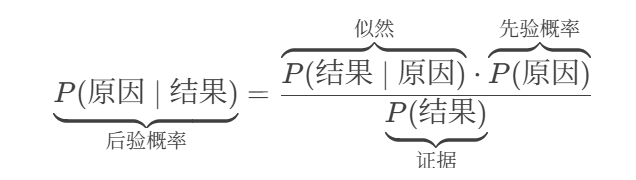
-
假设我们收到了一封邮件,有可能是垃圾邮件、有可能不是垃圾邮件, 假设垃圾邮件中存在词语国外高新业务
-
先验概率:根据你自己目前的经验,收到邮件之后,我认为它是垃圾邮件的一个概率值
-100封,有20封,即为20%
-
似然:假设邮件已经是垃圾邮件 的条件下,其中出现"国外高新业务"这个词的概率。
-20封垃圾邮件中,有5封包含"国外高新业务" 5/20 = 25%
-
证据: 所有邮件中出现"国外高新业务"的总概率(包括垃圾和非垃圾邮件),用来做"归一化"。
-假设总共有六份国外高新业务,即6/100=6%
-
后验概率 :当我以后看到"国外高新业务"后,也就是已经确定邮件是国外高新业务的条件下,觉得该邮件是垃圾邮件的概率。
-
(0.25×0.2) / 0.06 ≈ 0.833
-
-
-
案例:
-
以下是一个样本数据内容:
样本 职业 收入水平 生活质量 1 AI 程序员 低 低 2 嵌入式程序员 高 高 3 AI 程序员 高 高 4 AI 程序员 低 高 5 前端程序员 高 低 6 前端程序员 低 低 7 嵌入式程序员 高 高 如果按照贝叶斯定理来算,由于嵌入式收入水平均为高会导致
P(生活质量高|嵌入式程序员,收入水平低) = 0
这是异常的,收入水平低不一定意味着过不了高质量生活。
我们就需要考虑属性独立的情况。
-
-
朴素贝叶斯
朴素的意思就是假设特征与特征之间是相互独立 ,即
-
代入贝叶斯公式: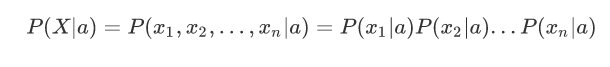
-
意思是要对P(嵌入式程序员,收入水平低)进行相互独立的计算,即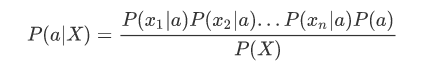
计算P(嵌入式程序员|生活质量高)和P(收入水平低|生活质量高)
可以得到:
P(嵌入式程序员,生活质量高)/P(生活质量高)=
2/7 / 4/7 = 1/2
P(收入水平低,生活质量高)/P(生活质量高) =
1/7 / 4/7 = 1/4
P(a)=P(生活质量高)=4/7
我们的计算可以忽略P(X),因为我们最终就是比较后验概率,随意后验概率同时乘以一个相同的内容,大小比较结果是不会变化的。
所以对于我们比较结果,可以不需要考虑P(x)来接着计算。
即可得到1/2 *1/4 * 4/7 =1/14
-
拉普拉斯平滑系数
当计算出来的概率可能会出现 0 值的情况时,使用拉普拉斯平滑系数来避免这种情况【零概率陷阱】
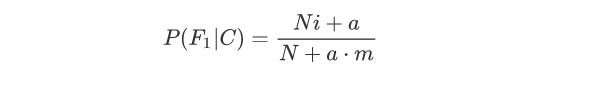
-
我们以 P(收入水平低∣生活质量高)为例子
=P(收入水平低,生活质量高) / P(生活质量高)= 1/4
由于原始数据中只有1个收入水平低,生活质量高样本
但有2个生活质量的样本,即高低:
利用拉普拉斯平滑修正:
(1+1)/ (4+2) = 1/3
-
决策树
-
预测目标变量的值
内部节点:代表一个特征
决策树的深度:所有节点的最大层次数,根节点为第 0 层
-
ID3 算法:基于信息熵和信息增益来判定所选择的节点
-
信息熵:用来描述数据集中数据的混乱程度,信息熵越高,数据越混乱,信息熵越低,数据越纯净
计算举例:
-
正常交易(No):90条
-
欺诈交易(Yes):10条
-
-
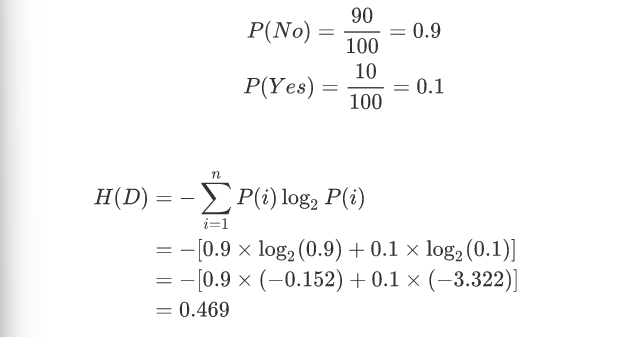
-
结果解析
| 数据分布 | 熵值 | 含义 |
|---|---|---|
| 正常: 100%, 欺诈: 0% | 0.0 | 完全确定无欺诈 |
| 正常: 90%, 欺诈: 10% | 0.469 | 低不确定性,欺诈较少 |
| 正常: 50%, 欺诈: 50% | 1.0 | 最大不确定性,无法判断交易性质 |
| 正常: 10%, 欺诈: 90% | 0.469 | 低不确定性,欺诈占多数 |
-
信息增益
信息增益的公式:
-
H(D):数据集 D 的初始信息熵(划分前的混乱程度)
-
H(D∣A):在特征 A 的条件下,D 的加权平均条件熵(划分后的混乱程度)
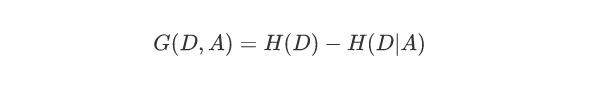
那如何计算G(D,A)呢?
| 样本 | 工作 | 房 | 信誉 | 贷款结果 |
|---|---|---|---|---|
| 1 | 是 | 是 | 好 | 批准 |
| 2 | 否 | 是 | 不好 | 批准 |
| 3 | 是 | 否 | 不好 | 批准 |
| 4 | 否 | 是 | 不好 | 批准 |
| 5 | 否 | 是 | 一般 | 拒绝 |
| 6 | 是 | 是 | 一般 | 批准 |
| 7 | 否 | 否 | 好 | 拒绝 |
| 8 | 否 | 否 | 一般 | 拒绝 |
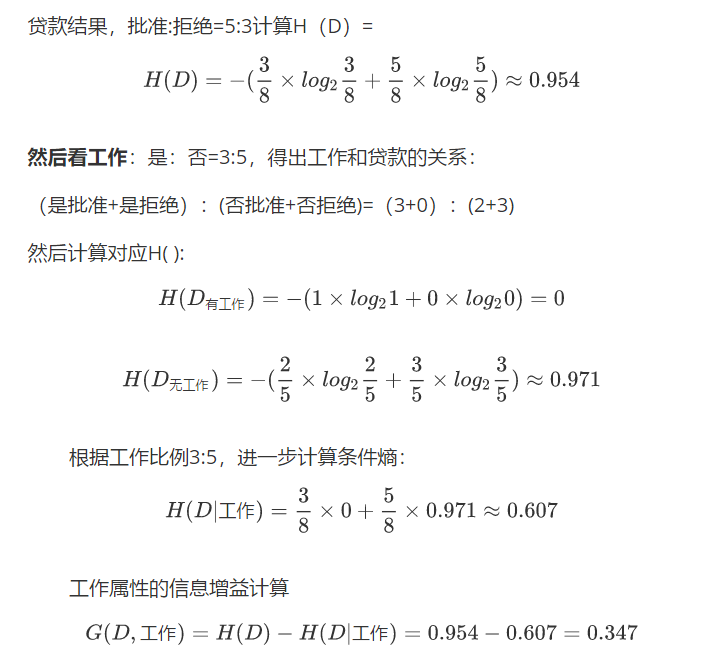
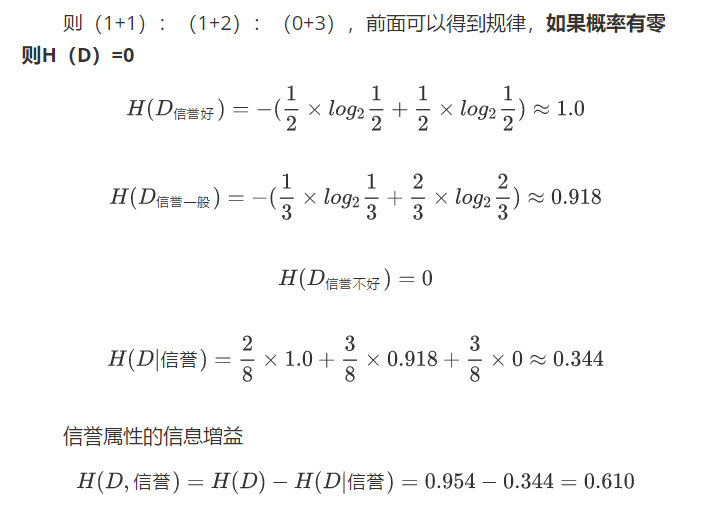
来看一个三个值的 看信誉增益计算: 好:一般:不好=2:3:3
四. 决策树算法实践
决策树算法:就是基于树的数据结构思想,来做分类(回归)的一个算法,通过节点的特征信息,做出数据的类别的判定在构建的决策树的过程中,我们可以采取信息增益、gini指数的方式来实现,对应ID3算法和CART算法
使用决策树算法实现判定titanic事故中,某个人是否可以存活titanic数据集是一个csv文件,如果要获取其中的数据,pandas 读取
了解每一列数据是什么内容 --- 就是特征信息
pclass --- 座位的登录,1st 2nd 3rdage --- 年龄,有的人年龄为空,我们就需要做数据集的处理,这里采取使用所有人的平均年龄作为填充sex --- 性别,male 男性、female女性
标签
survived --- 是否存活,1存活,0死亡
我们通过泰坦尼克号相关文件 'titanic.csv' 作为实践项目源:
# 读取数据集
data = pd.read_csv("titanic.csv")
"""
fillna --- 填充空缺的数据内容,即没有值的地方,使用设置的值填充上去
获取age的平均值,mean()方法
"""
data['age'].fillna(value=data['age'].mean(), inplace=True)
"""
pandas 从 dataFrame 同时取出多个列,需要使用[[列名....]]
loc 方法也可以实现
"""
X = data[['pclass', 'age', 'sex']]
# X = data.loc[:, ['pclass', 'age', 'sex']]
# 把 X 转成 [{第一条数据},{第二条数据},{第三条数据}] --- dataFrame 转 dict
"""
to_dict 方法:把 dataFrame 转 dict,但是会发现,使用列名作为key,列对应的值做为value
orient='records':把每一行看作是一条数据,每一条数据就是一个以各自列名作为key,列值作为value的字典,放在一个列表中
"""
X = X.to_dict(orient='records')
y = data['survived']
# 划分数据集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
# 由于数据集中存在字符,所以我们需要把字符转为机器可以识别的数字
dv = DictVectorizer(sparse=False)
# 提取训练集信息,进行数据转换
X_train = dv.fit_transform(X_train)
# 利用训练集的信息,直接执行数据转换
X_test = dv.transform(X_test)
print(X_train[:5])
print(dv.get_feature_names_out())
# 是否需要正则化?看具体情况,这里是不需要的
# 创建决策数据的估计器
"""
DecisionTreeClassifier 的参数:
criterion:默认gini,选择的算法,可以选择{"gini", "entropy"}
max_depth:最大的深度
random_state:随机数种子,设置了max_depth才生效
"""
dtc = DecisionTreeClassifier()
params_grid = {
"max_depth": [1, 2, 3]
}
# 使用网格搜索来设置 max_depth 值
gsc = GridSearchCV(estimator=dtc, param_grid=params_grid, cv=5)
# 投喂
gsc.fit(X_train, y_train)
# 得到最佳模型
print(gsc.best_estimator_)
print(gsc.score(X_test, y_test)) # 0.8297872340425532
# 保存模型
joblib.dump(gsc, "titanic.pkl")
dtc = DecisionTreeClassifier() # 调用决策树算法作为网格搜索API的估计器
import joblib
import numpy as np
model = joblib.load('grid.pkl')
data1 = np.array([[30,1,0,0,1,0]])
data2 = np.array([[30,0,1,0,1,0]])
data3 = np.array([[30,0,0,1,1,0]])
print(model.predict(data1))
print(model.predict(data2))
print(model.predict(data3))
data = input('请输入数据: ').split(' ')
data_n = np.array((data1))
print(model.predict(data_n))
通过预测数据,让训练好的模型自己判断该数据的角色是否存活,也可以自己输入数据
五、随机森林算法
-
随机森林算法使用很多个决策树来构建的
-
这些决策树是如何构建的?
-
一棵决策树:它是通过在数据集中(数据集大小为N),有放回的取出N个数据(一个一个的取,取出来的数据集中有重复的),所选择的特征也是随机的,并不是所有的特征信息,比如特征为k,那么选择的特征就是m<k,训练出来一个决策树
-
N棵决策树:因为随机,所以可以生成多个决策树。每一棵的构建方式和上一步一样,它们是并行的构建出来的
-
-
并行和串行:
-
并行:一起执行
-
串行:看上去像一起执行,但是他不是一起执行的,是一个一个的执行的
-
-
输出结果:
-
分类:就是统计每一棵树的结果,选择类别数量最大的那个
-
回归:所有树的平均值
-
-
猜想随机森林算法的API的超参数
-
树的数量
-
树的深度
-
生成树的算法
-
-
思想: 在数据集中,样本数为N,有放回的执行N次,取出N个数据,然后随机选择特征信息,用这两个数据训练出来多棵树
每棵树:样本数据内容、特征信息可能是不一样的,但是样本数据由于是有放回的取出,所以有一定重复。随机森林在构建的时候,就会构建多棵树,并行构建。输出:
-
回归:每一棵树输出结果的平均数
-
分类:统计每一棵数输出的类别信息,选择最多的那个最为结果
代码改动:把之前实现的titanic的决策树算法,改成随机森林算法【只需要把决策树的估计器换成随机森林的估计器,然后修改网格搜索的超参数设置】
API:
from sklearn.ensemble import RandomForestClassifier
参数设置:
-
n_estimators: 构成随机森林的决策树的数量 -
criterion: 决策树生成选择的算法 -
max_depth: 决策树的深度
实现代码:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction import DictVectorizer
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV
import joblib
# 读取数据集
data = pd.read_csv("titanic.csv")
"""
filina --- 填充空缺的数据内容,即没有值的地方,使用设置的值填充上去获取age的平均值,mean()方法
"""
data['age'].fillna(value=data['age'].mean(), inplace=True)
"""
pandas 从 dataFrame 同时取出多个列,需要使用[列名...]
loc 方法也可以实现
"""
X = data[['pclass', 'age', 'sex']]
# X = data.loc[:, ['pclass', 'age', 'sex']]
# 把 X 转成 [第一条数据], (第二条数据), (第三条数据)] --- dataFrame 转 dict
"""
to_dict 方法: 把 dataFrame 转 dict, 但是会发现,使用列名作为key,列对应的值做为value
orient='records': 把每一行看作是一条数据,每一条数据就是一个以各自列名作为key,列值作为value
的字典,放在一个列表中
"""
X = X.to_dict(orient='records')
y = data['survived']
# 划分数据集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
# 由于数据集中存在字符,所以我们需要把字符转为机器可以识别的数字
dv = DictVectorizer(sparse=False)
# 提取训练集信息,进行数据转换
X_train = dv.fit_transform(X_train)
# 利用训练集的信息,直接执行数据转换
X_test = dv.transform(X_test)
print(X_train[:5])
print(dv.get_feature_names_out())
# 是否需要正则化?看具体情况,这里是不需要的
# 创建决策数据的估计器
rfc = RandomForestClassifier()
params_grid = {
"n_estimators": [10, 20, 30], # 构成随机森林的决策树的数量
"max_depth": [1, 2, 3], # 决策树的深度
}
# 使用网格搜索来设置随机森林超参数
gsc = GridSearchCV(estimator=rfc, param_grid=params_grid, cv=5)
# 投喂
gsc.fit(X_train, y_train)
# 得到最佳模型
print(gsc.best_estimator_)
print(gsc.score(X_test, y_test)) # 0.8388662613981763
# 保存模型
joblib.dump(gsc, "titanic_rfc.pkl")
def predict_model(data):
# 加载模型
model = joblib.load('./titanic_rfc.pkl')
return model.predict(data)
if __name__ == '__main__':
"""
优化,实现控制台输入以下内容,输出预测结果:
请输入年龄:
请输入是否为1等座,是输入1,否输入0:
请输入是否为2等座,是输入1,否输入0:
请输入是否为3等座,是输入1,否输入0:
请输入是否为男性,是输入1,否输入0:
请输入是否为女性,是输入1,否输入0:
预测结果:
"""
age = int(input("请输入年龄:"))
first_class = int(input("请输入是否为1等座,是输入1,否输入0:"))
second_class = int(input("请输入是否为2等座,是输入1,否输入0:"))
third_class = int(input("请输入是否为3等座,是输入1,否输入0:"))
male = int(input("请输入是否为男性,是输入1,否输入0:"))
female = int(input("请输入是否为女性,是输入1,否输入0:"))
data = np.array([[age, first_class, second_class, third_class, male, female]])
result = predict_model(data)
print("预测结果:", result)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 56
 0
- 0


 已为社区贡献2条内容

所有评论(0)