【Python爬虫基础-2】网络请求
·
【Python爬虫基础-2】网络请求
1、urllib简介
-
urllib是Python自带的标准库中用于网络请求的库,无需安装,直接引用即可
-
通常用于爬虫开发、API(应用程序编程接口)数据获取和测试
-
urllib库的4大模块
- urllib.request :用于打开和读取URL
- urllib.error:包含提出的例外(异常)urllib.request
- urllib.parse:用于解析URL
- urllib.robotparser:用于解析robots.txt文件
-
urllib.parse应用
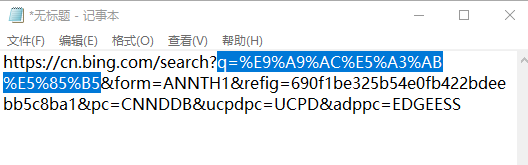
在浏览器搜索“马士兵”,将地址栏中地址复制到记事本,地址中的中文被编码成“%E9%A9%AC%E5%A3%AB%E5%85%B5”。
示例代码:
#urllib.parse  用于解析url
import urllib.parse
kw={'wd':'马士兵'}
#编写
result=urllib.parse.urlencode(kw)
print(result)
#解码
res=urllib.parse.unquote(result)
print(res)
输出结果:
wd=%E9%A9%AC%E5%A3%AB%E5%85%B5
wd=马士兵
2、发送请求
- urllib.request库
- 模拟浏览器发起一个HTTP请求,并获取请求响应结果
- urllib.request.urlopen 的语法格式
- urlopen(url,data=None,[timeout,]*,cafile=None,capth=None,cadefault=False,context=None )
- 参数说明
- url: url参数是str类型的地址,也就是要访问的URL,例如:
https://www.baidu.com - data: 默认值为None,urllib判断参数data是否为None从而区分请求方式。或参数data为None,则代表请求方式为Get,反之请求方式为Post,发送Post请求。参数data以字典形式存储数据,并将参数data由字典类型转换成子类类型才能完成Post请求
- url: url参数是str类型的地址,也就是要访问的URL,例如:
- urlopen函数返回的结果是一个http.client.HTTPResponse对象
Get请求示例代码:
import urllib.request
url='https://www.lingdianshuwu.com/'
#发送请求
resp = urllib.request.urlopen(url)  #data参数为None,则代表请求方式为Get
html = resp.read().decode('gbk')  #decode 将bytes类型转成str类型
print(html)
Post请求示例代码:
import urllib.request
import urllib.parse

url='https://www.xslou.net/login.php'

data={'username':'18600000000','password':'562314951','action':'login'}

#发送请求
resp = urllib.request.urlopen(url,data=bytes(urllib.parse.urlencode(data),encoding='utf-8')) #encoding='utf-8'是对上面请求参数data数据的编码
html = resp.read().decode('utf-8')
print(html)
- Request请求
有一些网站的服务器采用了反爬策略,如果使用传统的urlopen去发送请求的时候,可能会得不到数据。为了应对这种简单的反爬方式,我们通常需要加入headers,然后去伪装成浏览器。
示例代码:
import urllib.request
url='https://movie.douban.com/'
#发送请求
resp = urllib.request.urlopen(url)
print(resp)
返回结果:响应状态码418, 发送请求遇到服务器端反爬虫 ,服务器拒绝响应数据
urllib.error.HTTPError: HTTP Error 418:
- 如果在请求中需要加入headers(请求头)、指定请求方式等信息,那么就可以利用更强大的Request来构建一个请求。
- 语法 :urllib.request.Reqest(url,data=None,headers={},method=None)
headers请求头示例代码:
import urllib.request
url = 'https://movie.douban.com/'

#请求头模拟浏览器
header = {'user-agent':
'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/139.0.0.0 Safari/537.36 Edg/139.0.0.0'}

#构建请求对象
req = urllib.request.Request(url,headers=header)

#使用urlopen打开请求
resp = urllib.request.urlopen(req)

#从响应结果中读取数据
html = resp.read().decode('utf-8')
print(html)
- urlopen()方法源代码
- 打开方式:按住ctrl键, 鼠标在urlopen上单击即可打开urlopen源代码。
urlopen源代码:
_opener = None
def urlopen(url, data=None, timeout=socket._GLOBAL_DEFAULT_TIMEOUT,
            *, cafile=None, capath=None, cadefault=False, context=None):

    global _opener   #全局变量
    if cafile or capath or cadefault:
        import warnings
        warnings.warn("cafile, capath and cadefault are deprecated, use a "
                      "custom context instead.", DeprecationWarning, 2)
        if context is not None:
            raise ValueError(
                "You can't pass both context and any of cafile, capath, and "
                "cadefault"
            )
        if not _have_ssl:
            raise ValueError('SSL support not available')
        context = ssl.create_default_context(ssl.Purpose.SERVER_AUTH,
                                             cafile=cafile,
                                             capath=capath)
        # send ALPN extension to indicate HTTP/1.1 protocol
        context.set_alpn_protocols(['http/1.1'])
        https_handler = HTTPSHandler(context=context)
        opener = build_opener(https_handler)
    elif context:
        https_handler = HTTPSHandler(context=context)
        opener = build_opener(https_handler)
    elif _opener is None:
        _opener = opener = build_opener()
    else:
        opener = _opener
    return opener.open(url, data, timeout)
- 构建自己的opener发送请求
import urllib.request
url = 'https://www.baidu.com'

header = {'user-agent':
'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/139.0.0.0 Safari/537.36 Edg/139.0.0.0'}
#构建请求对象
req = urllib.request.Request(url,headers=header)

#获取opener对象
opener = urllib.request.build_opener()

resp = opener.open(req)
print(resp.read().decode())
3、IP代理
3.1 为什么需要使用IP代理
- 假如一个网站他会检测某一段时间某个IP的访问次数,如果访问次数过多,它会禁止你的访问,所以你可以设置一些代理服务器来帮助你做工作,每隔一段时间换一个代理。
3.2 IP代理的分类
- 透明代理:目标网站知道你使用了代理并且知道你的源IP地址,这种代理显然不符合我们这里使用代理的初衷。
- 匿名代理:匿名程序比较低,也就是网站知道你使用了代理,但是并不知道你的源IP地址。
- 高匿代理:这是最保险的方式,目录网站即不知道你使用了代理更不知道你的源IP。
3.3 IP代理的方式
- 免费代理IP:
- 大象代理:收费
- 快代理:收费
3.4 IP代理的使用
代理使用示例代码:
from urllib.request import build_opener
from urllib.request import ProxyHandler

proxy = ProxyHandler({'https':'60.2.44.182:30963'})

opener=build_opener(proxy)

url='https://www.xslou.net/'

resp = opener.open(url)
print(resp.read().decode('utf-8'))
查看本机ip地址:
win+R输入cmd ,在命令行输入ipconfig 查看本机IP
4、使用Cookie
4.1 为什么需要使用Cookie
- 解决http的无状态性
4.2 使用步骤
- 实例化MozillaCookieJar(保存cookie)
- 创建handler对象(cookie的处理器)
- 创建opener对象
- 打开网页(发送请求获取响应)
- 保存cookie文件
4.3 案例:获取百度贴吧的cookie并保存到文件中
示例代码:
import urllib.request
from http import cookiejar

filename = 'cookie.txt'

#获取cookie
def get_cookie():
    #(1)实例化一个MozillaCookieJar  (用于保存cookie)
    cookie = cookiejar.MozillaCookieJar(filename)
    #(2)创建handler对象
    handler = urllib.request.HTTPCookieProcessor(cookie)
    #(3)创建opener对象
    opener = urllib.request.build_opener(handler)
    #(4)请求网址
    url = 'https://tieba.baidu.com/'
    #添加请求头,避免403错误
    header = {'user-agent':
                  'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/139.0.0.0 Safari/537.36 Edg/139.0.0.0'}
    #用Request包装URL和请求头
    req = urllib.request.Request(url, headers=header)
    #发送请求
    resp = opener.open(req)

    #(5)存储cookie文件
    cookie.save()

#读取cookie
def use_cookie():
    #实例化MozillaCookieJar
    cookie = cookiejar.MozillaCookieJar()
    #加载cookie文件
    cookie.load(filename, ignore_discard=True, ignore_expires=True)
    try:
        # 加载cookie文件(需先调用get_cookie()生成文件)
        cookie.load(filename, ignore_discard=True, ignore_expires=True)
        print("加载的Cookie信息:")
        for item in cookie:
            print(f"{item.name} = {item.value}")  # 更清晰地打印Cookie键值对
    except FileNotFoundError:
        print("Cookie文件不存在,请先运行get_cookie()")

if __name__ == '__main__':
    #get_cookie()  #获取cookie
    use_cookie()
我们再次向服务器去发送请求的时候,可以携带cookie数据,它就会认为你这次发的请求和上次发的请求,是来源于同一个客户端发送过来的。
我们经常使用cookie去记录用户的登录数据。
5、错误解析
5.1 异常处理主要用到的两大类
- urllib.error.URLError:用于捕获由urllib,request产生的异常,使用reason属性返回错误原因。
reason 示例代码:
import urllib.request
import urllib.error

url = 'http://www.google.com'  #错误的网址
#url = 'http://www.google.cn'  #正确的网址
try:
    resp = urllib.request.urlopen(url)
except urllib.error.URLError as e:
    print(e.reason)
输出结果:产生的错误被捕获
[WinError 10060] 由于连接方在一段时间后没有正确答复或连接的主机没有反应,连接尝试失败。
- urllib.error.HTTPError:用于处理HTTP与HTTPS请求的错误,它有三个属性
- code:请求返回的状态码
- reason:返回错误的原因
- headers:请求返回的响应头信息
urllib.error.HTTPError:示例代码:
import urllib.request
import urllib.error

url = 'http://movie.douban.com'  #错误的网址
try:
    resp = urllib.request.urlopen(url)
except urllib.error.HTTPError as e:
    print('原因:',e.reason)
    print('响应状态码:',str(e.code))
    print('响应头数据:',e.headers)
输出结果:
原因:
响应状态码: 418
响应头数据: Date: Sun, 09 Nov 2025 09:35:15 GMT
Content-Length: 0
Connection: close
Server: dae
X-Content-Type-Options: nosniff
6、requests库
- Requests是Python一个很实用的HTTP客户端,完全满足如今网络爬虫的需求。
6.1 requests库的安装
- pip 命令安装
- windows操作系统:pip install requests
- Linux操作系统:sudo pip install requests
- 源码安装:
- 下载requests源码:http://mirrors.aliyun.com/pypi/simple/requests/
- 下载文件到本地之后,解压到Python安装目录,之后打开解压文件
- 运行命令行输入python setup.py install即可安装
pip install 安装包名称
6.2 request库常用的方法
| 序号 | 方法 | 描述 |
|---|---|---|
| 1 | requests.request(url) | 构造一个请求,支持以下各种方法 |
| 2 | requests.get() | 发送Get请求 |
| 3 | requests.post() | 发送Post请求 |
| 4 | requests.head() | 获取HTML的头部信息 |
| 5 | requests.put() | 发送Put请求 |
| 6 | requests.patch | 提交局部修改的请求 |
| 7 | requests.delete() | 提交删除请求 |
- 最常用的方法为get()和post()分别用于发送Get请求和Post请求
6.3 requests库的使用
- 语法结构:
requests.get(url,params=None) - 参数说明:
- url:需要爬取的网站的网址
- params:请求参数
- 该方法的结果为Response对象,包含服务器的响应信息
response对象的常用属性:
| 序号 | 属性或方法 | 描述 |
|---|---|---|
| 1 | response.status_code | 响应状态码 |
| 2 | response.content | 把response对象转换为二进制数据 |
| 3 | response.text | 把response对象转换为字符串数据 |
| 4 | response.encoding | 定义response对象的编码 |
| 5 | response.cookies | 获取请求后的cookie |
| 6 | response.url | 获取请求网址 |
| 7 | response.json() | 内置的JSON解码器 |
| 8 | response.headers | 以字典对象存储服务器响应头,字典键不区分大小写 |
6.4 get请求
- 不带参数的get请求
案例:爬取百度主页http://www.baidu.com
示例代码
#发送不带参数的get请求
import requests
url='http://www.baidu.com'
resp=requests.get(url)
#设置响应的编码格式
resp.encoding='utf-8'
cookie=resp.cookies  #获取请求后的cookie信息
headers=resp.headers
print('响应的状态码:',resp.status_code)
print('请求后的cookie:',cookie)
print('获取请求的网址:',resp.url)
print('响应头:',headers)
print('响应内容:',resp.text)
- 带参数的get请求
案例:360搜索
示例代码:
#带参数的get请求
import requests
url='https://www.so.com/s'
params={'q':'python'}
resp=requests.get(url,params=params)
#设置响应的编码格式
resp.encoding='utf-8'
print('响应内容:',resp.text)
- 获取JSON数据
案例:百度美女图片
获取源数据的url地址:按F12进入开发者模式,在网络(Network),点击XHR(Ajax请求),获取请求url地址。
示例代码:
#获取JSON请求
import requests
url='
https://image.baidu.com/search/acjson?tn=resultjson_com&word=%E7%BE%8E%E5%A5%B3&ie=utf-8&fp=result&fr=&ala=0&applid=7533452209569297436&pn=30&rn=30&nojc=0&gsm=3c&newReq=1'
resp=requests.get(url)
json_data=resp.json()
print(json_data)
- 获取二进制数据
案例:下载百度loge
示例代码:
#获取二进制数据
import requests
url='https://gips0.baidu.com/it/u=838505001,1009740821&fm=3028&app=3028&f=PNG&fmt=auto&q=100&size=f254_80'
resp=requests.get(url)

#存储
with open('logo.png','wb') as file:
    file.write(resp.content)
6.5 post请求
- 语法结构
request.post(url,data=None,json=None) - 参数说明:
- url:需要爬取的网站的网址
- data:请求数据
- json:json格式的数据
- 案例:登录小说楼
示例代码:
#登录小说楼
import requests
url='https://www.xslou.net/login.php'
data={'usename':'18600000000','password':'562314951','action':'login'}
resp=requests.get(url,data=data)
resp.encoding='utf-8'
print(resp.status_code)
print(resp.text)
- session请求
import requests
url='https://www.xslou.net/login.php'
data={'usename':'17899319391','password':'123456789','action':'login'}

#使用session发送请求
session = requests.session()
resp = session.post(url,data=data)
resp.encoding='gbk'

#推荐小说
hot_url='https://www.xslou.com/modules/article/uservote.php?id=71960'
resp2=session.get(hot_url)
resp2.encoding='gbk'
print(resp2)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献1条内容

所有评论(0)