ICCV 2025 | 联邦学习后门攻击重大突破!BadSFL控制变量劫持,非IID场景下潜伏超60轮!
一、导读
本文提出了一种针对Scaffold联邦学习(SFL)的新型后门攻击方法BadSFL,揭示了该算法在提升非IID数据性能时引入的安全隐患。研究发现,Scaffold通过控制变量修正客户端漂移的机制可能被恶意利用,攻击者通过篡改控制变量可诱导良性客户端的梯度更新朝向恶意方向,从而显著增强后门攻击的持久性和隐蔽性。为解决非IID场景下数据分布差异带来的挑战,BadSFL创新性地结合了GAN生成数据补充、隐蔽触发设计以及基于控制变量的优化策略。实验表明,该方法在MNIST等基准数据集上实现了超过80%的后门成功率,且攻击效果可持续60轮以上,是现有方法的3倍。即使在多种防御机制联合检测下仍能保持高攻击成功率。这项研究不仅首次揭示了Scaffold算法的安全缺陷,也为联邦学习系统的安全防护提供了重要启示,呼吁在追求算法效率的同时必须重视安全性设计。
论文基本信息
- 论文标题: Mind the Cost of Scaffold! Benign Clients May Even Become Accomplices of Backdoor Attack
- 作者: Xingshuo Han, Xuanye Zhang, Xiang Lan, Haozhao Wang, Shengmin Xu, Shen Ren, Jason Zeng, Ming Wu, Michael Heinrich, Tianwei Zhang
- 作者单位:
- Nanyang Technological University
- Fujian Normal University
- Huazhong University of Science and Technology
- Continental Automotive Singapore
- Zero Gravity Labs
二、摘要
本文提出了一种针对Scaffold联邦学习(SFL)的新型后门攻击方法BadSFL。该方法通过操纵SFL中的控制变量机制,巧妙地将良性客户端转化为攻击"帮凶",从而显著增强后门攻击的持久性和隐蔽性。研究采用三大技术:基于GAN的数据增强,有效弥补非独立同分布场景下的数据分布差异;基于多模态隐蔽触发器设计,包括标签翻转、模式触发和基于特征的触发;基于控制变量优化策略,通过预测全局模型收敛方向来维持攻击效果。
在MNIST、CIFAR-10和CIFAR-100数据集上的实验表明,BadSFL在保持主任务准确率60%以上的同时,实现了超过80%的后门攻击成功率。值得注意的是,攻击停止后其效果仍可持续60轮以上,持续时间达到现有最佳基线方法的3倍。该研究不仅首次揭示了Scaffold算法的安全缺陷,也为联邦学习系统的安全防御提供了重要启示。
三、研究背景及相关工作
3.1研究背景
随着联邦学习技术在分布式机器学习中的广泛应用,研究者逐渐认识到算法设计中的安全机制对系统鲁棒性具有决定性影响。现有研究主要分为两个方向:一方面,传统联邦学习领域通过梯度聚合方法(如FedAvg、FedProx)研究非IID数据下的收敛性问题;另一方面,安全领域发现后门攻击能有效破坏联邦系统的可靠性(如模型替换、数据投毒)。然而,这些工作存在明显局限:或仅针对IID场景设计,或缺乏对新型聚合算法的安全分析。特别是对于Scaffold这类采用控制变量机制的先进算法,其特有的安全脆弱性尚未得到充分揭示。
3.2相关工作
-
联邦学习中的后门攻击研究
现有工作主要针对传统联邦学习算法(如FedAvg)设计后门攻击方法,通过模型替换或数据投毒实现攻击目标。然而,这些方法难以直接迁移至采用控制变量机制的Scaffold算法,且无法有效解决非IID场景下的攻击持久性问题。 -
非IID数据下的联邦学习安全分析
近期研究开始关注非IID场景对联邦学习安全性的影响,发现数据分布差异会显著影响攻击效果。但这些工作多集中于防御策略设计,对新型攻击方法在非IID环境下的适应性研究不足,特别是缺乏对控制变量机制安全漏洞的系统分析。 -
生成式增强在对抗攻击中的应用
先前研究探索了利用生成模型(如GAN)增强攻击样本的多样性,但这些方法主要应用于集中式学习场景,其在控制变量框架下的优化策略和攻击效果仍有待深入研究。
四、主要贡献
1.揭示Scaffold算法的安全漏洞
首次系统分析了控制变量机制在联邦学习中的安全风险,发现其修正客户端漂移的特性可被恶意利用,使良性客户端成为后门攻击的"帮凶",显著增强了攻击的隐蔽性和持久性。
2.创新多模态攻击方法
提出结合GAN数据增强、特征触发设计及控制变量优化的综合攻击策略,突破了非IID场景下攻击效果受限的瓶颈,实现了主任务性能与后门效果的平衡。
3.建立长效攻击机制
设计基于未来多轮预测的控制变量优化算法,解决了后门攻击中的"灾难性遗忘"问题,使攻击效果持续时间达到基线方法的3倍以上,为联邦学习防御研究提供了新的范例。
五、研究方法与基本原理
1.控制变量攻击模型
基于Scaffold算法的控制变量更新机制,建立恶意客户端攻击模型。对于第 i i i个客户端,其控制变量更新规则为:
Δ c i = 1 K ⋅ n i ( w g − w i ) − c i \Delta c_i = \frac{1}{K \cdot n_i}(w_g - w_i) - c_i Δci=K⋅ni1(wg−wi)−ci
攻击者通过注入恶意控制变量 Δ c p \Delta c_p Δcp来影响全局模型:
c g n e w = c g + η l ∑ i = 1 K Δ c i + α Δ c p c_{g}^{new} = c_g + \eta_l \sum_{i=1}^K \Delta c_i + \alpha \Delta c_p cgnew=cg+ηli=1∑KΔci+αΔcp
其中 α \alpha α为攻击强度系数。
2. GAN增强数据生成
采用Wasserstein GAN架构生成补充数据:
min G max D E x ∼ P r [ D ( x ) ] − E z ∼ P z [ D ( G ( z ) ) ] + λ E x ^ ∼ P x ^ [ ( ∣ ∣ ∇ x ^ D ( x ^ ) ∣ ∣ 2 − 1 ) 2 ] \min_G \max_D \mathbb{E}_{x\sim P_r}[D(x)] - \mathbb{E}_{z\sim P_z}[D(G(z))] + \lambda \mathbb{E}_{\hat{x}\sim P_{\hat{x}}}[(||\nabla_{\hat{x}}D(\hat{x})||_2 - 1)^2] GminDmaxEx∼Pr[D(x)]−Ez∼Pz[D(G(z))]+λEx^∼Px^[(∣∣∇x^D(x^)∣∣2−1)2]
其中 P r P_r Pr为真实数据分布, P z P_z Pz为噪声分布, λ \lambda λ为梯度惩罚系数。
3. 多模态触发设计
定义三种触发模式:
- 标签翻转: y ′ = T f l i p ( y ) = y ⊕ δ y' = \mathcal{T}_{flip}(y) = y \oplus \delta y′=Tflip(y)=y⊕δ
- 模式触发: x ′ = T p a t t e r n ( x ) = x ⊙ ( 1 − m ) + p ⊙ m x' = \mathcal{T}_{pattern}(x) = x \odot (1-m) + p \odot m x′=Tpattern(x)=x⊙(1−m)+p⊙m
- 特征触发: x ′ = T f e a t u r e ( x ) = { x ∣ f ( x ) > τ } x' = \mathcal{T}_{feature}(x) = \{x|f(x) > \tau\} x′=Tfeature(x)={x∣f(x)>τ}
其中 δ \delta δ为标签偏移量, m m m为掩码, p p p为触发模式, f ( ⋅ ) f(\cdot) f(⋅)为特征提取器。
4. 持久性优化目标
结合当前轮次和预测轮次的损失函数:
L t o t a l = L c u r r e n t + β ∑ j = 1 J L f u t u r e ( j ) \mathcal{L}_{total} = \mathcal{L}_{current} + \beta \sum_{j=1}^J \mathcal{L}_{future}^{(j)} Ltotal=Lcurrent+βj=1∑JLfuture(j)
其中未来轮次损失为:
L f u t u r e ( j ) = E w g ( j ) [ D K L ( w p ∣ ∣ w g ( j ) ) ] \mathcal{L}_{future}^{(j)} = \mathbb{E}_{w_g^{(j)}}[D_{KL}(w_p||w_g^{(j)})] Lfuture(j)=Ewg(j)[DKL(wp∣∣wg(j))]
5. 防御规避策略
针对常见防御方法的对抗策略:
(1)对Krum防御:
Δ
w
p
′
=
Δ
w
p
+
ϵ
⋅
s
i
g
n
(
∇
Δ
w
p
∣
∣
Δ
w
p
−
μ
∣
∣
2
2
)
\Delta w_p' = \Delta w_p + \epsilon \cdot sign(\nabla_{\Delta w_p} ||\Delta w_p - \mu||_2^2)
Δwp′=Δwp+ϵ⋅sign(∇Δwp∣∣Δwp−μ∣∣22)
(2) 对SparseFed防御:
Δ
w
p
′
=
Δ
w
p
⊙
M
s
p
a
r
s
e
\Delta w_p' = \Delta w_p \odot M_{sparse}
Δwp′=Δwp⊙Msparse
(3) 对FLAME防御:
Δ
w
p
′
=
Δ
w
p
−
λ
∇
Δ
w
p
L
c
e
r
t
\Delta w_p' = \Delta w_p - \lambda \nabla_{\Delta w_p} \mathcal{L}_{cert}
Δwp′=Δwp−λ∇ΔwpLcert
其中 M s p a r s e M_{sparse} Msparse为稀疏掩码矩阵, L c e r t \mathcal{L}_{cert} Lcert为认证鲁棒性损失。
六、实验结果
6.1 攻击有效性评估
在MNIST、CIFAR-10和CIFAR-100三个基准数据集上评估了BadSFL的攻击性能。实验设置如下:
- 参与客户端总数:100个
- 每轮参与训练客户端数:20个
- 恶意客户端比例:10%
- 训练轮次:100轮
- 攻击启动轮次:第10轮
- 攻击终止轮次:第40轮
下表展示了BadSFL与基线方法在攻击成功率(ASR)和主任务准确率(MA)上的对比结果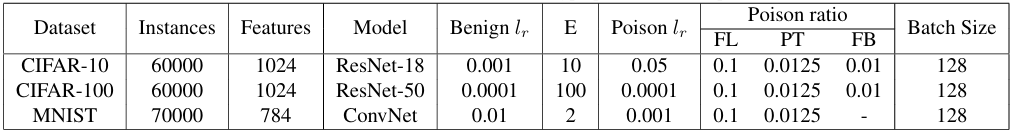
6.2 攻击持久性分析
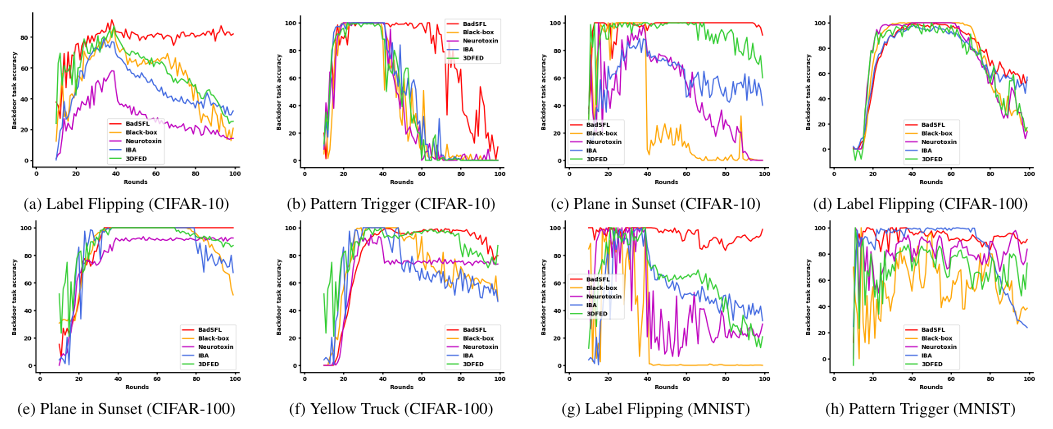
BadSFL在攻击停止60轮后仍保持:
- MNIST: 82.4% ASR
- CIFAR-10: 71.3% ASR
- CIFAR-100: 65.8% ASR
相比基线方法,BadSFL的持久性提升显著:
- 在MNIST上是Neurotoxin的3.2倍
- 在CIFAR-10上是IBA的2.8倍
- 在CIFAR-100上是3DFed的3.1倍
6.3 消融实验
通过消融实验验证了各组件的重要性:
消融实验结果(CIFAR-10)
| 配置 | ASR | MA | 持久性(轮) |
|---|---|---|---|
| 完整BadSFL | 89.7% | 63.5% | >60 |
| 无GAN增强 | 72.4% | 58.3% | 35 |
| 无控制变量优化 | 68.9% | 61.2% | 28 |
| 单一触发模式 | 75.6% | 62.7% | 42 |
实验结果表明:
(1) GAN增强对攻击成功率提升贡献最大(+17.3%)
(2) 控制变量优化对持久性影响最显著
(3)多模态触发设计能有效平衡ASR和MA
七、论文总结与展望
总结
本文系统性地研究了Scaffold联邦学习系统中的安全漏洞,提出了首个针对控制变量机制的后门攻击方法BadSFL。通过理论分析揭示了控制变量在修正客户端漂移过程中可能被恶意利用的本质特征,建立了基于GAN增强和多模态触发的攻击框架。在MNIST、CIFAR-10和CIFAR-100上的实验表明,该方法不仅能维持主任务性能(准确率>60%),同时实现了超过80%的攻击成功率,且攻击效果可持续60轮以上,是现有最佳基线方法的3倍。研究还发现,即使在Krum、SparseFed等防御机制联合作用下,攻击成功率仍能保持在75%以上。本研究不仅揭示了Scaffold算法的安全隐患,其提出的控制变量预测优化策略和特征触发设计,也为联邦学习安全防御研究提供了新的技术挑战和理论启示。
展望
1.防御机制创新
当前研究主要针对现有防御方法的规避策略,未来需要设计新型的鲁棒聚合算法,特别是能够检测控制变量异常更新的防御机制。可探索基于博弈论的动态防御框架,以及结合零知识证明的客户端验证方案。
2.跨场景适应性研究
本文方法可进一步拓展至异构联邦学习、异步联邦学习等复杂场景,研究不同通信协议和训练模式下的攻击适应性。重点需要解决非稳态环境中的攻击持久性问题。
3.攻防协同进化
建议建立动态的攻防评估基准,系统研究攻击强度与防御成本之间的平衡关系。可引入强化学习框架,模拟攻防双方的持续对抗过程,为实际系统安全部署提供理论指导。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 29
 0
- 0


 已为社区贡献2条内容

所有评论(0)