基于深度学习网络的图像去阴影系统
1.1 研究背景及意义
随着城市化进程的加快和交通密度的增加,交通管理和安全问题日益突出,智能交通系统(ITS)成为了缓解这些问题的关键技术。车辆和行人检测作为ITS的核心组成部分,对于实现交通流量监控、事故预防以及自动驾驶技术至关重要[1]。传统的检测技术常受限于低准确率和环境适应性差的问题,难以满足日益严峻的交通安全需求。
近年来,深度学习技术的兴起为车辆和行人检测提供了新的解决方案。深度学习模型,特别是卷积神经网络(CNN),因其出色的特征提取能力,在图像识别和视频分析领域显示出卓越的性能。通过训练,这些模型能够学习到复杂的视觉模式,极大地提高了检测的准确性和鲁棒性。
基于深度学习的车辆及行人检测技术不仅能够在各种光照和天气条件下准确识别目标,还可以处理高动态范围和部分遮挡的情况[2]。此外,实时处理能力的提升使得该技术可以被应用于实时视频监控系统中,进一步提高交通管理的效率和响应速度。
研究并发展基于深度学习的车辆和行人检测技术,不仅对促进智能交通系统的发展具有重要意义,也对推动自动驾驶车辆的商业化应用、提升城市安全监控系统的能力等领域产生深远影响。因此,本研究旨在通过深入探索和优化深度学习模型,为实现更智能、更安全的交通环境提供技术支持和科学依据。
1.2 图像去阴影技术的发展现状
图像去阴影(Shadow Removal)是计算机视觉中的重要任务,旨在去除图像中的阴影干扰,以恢复真实的场景信息。传统方法依赖于物理模型和颜色特征,而近年来,深度学习方法的兴起使得去阴影技术取得了显著进步。
1. 传统方法
传统的去阴影方法主要包括基于颜色不变性、光照模型和图像分割的方法。例如,Retinex 理论假设阴影区域的亮度变化主要由光照引起,通过对数变换恢复场景反射率[3]。然而,这些方法通常依赖于严格的假设,在复杂场景下表现较差。此外,基于图像分割的方法试图将阴影区域与非阴影区域分离,然后进行颜色修正,但由于阴影的形状和强度变化较大,分割精度往往受到限制。
2. 深度学习方法
深度学习的兴起为图像去阴影提供了更强大的工具。基于 CNN 和 Transformer 的方法能够自动学习阴影区域的特征,并进行端到端的去阴影处理[4]。主要的方法包括:
监督学习方法:基于 U-Net、GAN(生成对抗网络)等模型,使用带有阴影和无阴影对的数据集进行训练,如 ISTD 和 SRD 数据集[5]。例如,Mask-ShadowGAN 结合了阴影掩码和对抗训练,提高了去阴影质量。
无监督和弱监督学习方法:由于标注阴影数据集的成本较高,研究者尝试了无监督方法,例如基于 CycleGAN 的方法,通过无配对数据学习去阴影映射。此外,弱监督方法利用少量标注数据结合物理约束来优化去阴影效果。
基于 Transformer 的方法:最近,一些研究结合了视觉 Transformer(ViT),利用其全局建模能力,提高了去阴影的效果,并解决了 CNN 可能存在的局部信息丢失问题。
3. 发展趋势
未来,图像去阴影技术将朝着更高的精度、更强的泛化能力和更少的数据依赖方向发展。结合物理模型的深度学习方法可能成为新的研究方向,同时,轻量级网络将促进去阴影技术在移动端和嵌入式设备上的应用。此外,多模态数据(如深度信息和红外数据)与深度学习的结合可能进一步提升去阴影的性能。
总之,深度学习驱动的图像去阴影技术已经取得了突破性进展,但仍存在挑战,例如阴影边界处理和复杂光照环境下的泛化能力。未来的研究将致力于开发更加鲁棒和高效的去阴影方法,以应用于真实世界的计算机视觉任务。
1.3本文的研究目标与内容
1.3.1研究目标
本研究旨在构建一个基于深度学习的图像去阴影系统,以自动识别并去除自然场景中的阴影区域,同时保持图像的色彩一致性与细节完整性。传统去阴影方法往往依赖于物理模型和手工设计特征,泛化能力有限,难以应对复杂光照条件和多样化的阴影形态[6]。因此,本研究利用深度学习网络,通过大规模数据训练,使模型能够学习阴影的分布特征,实现高效、准确的阴影去除。本研究的主要目标包括:
提升去阴影质量:减少阴影区域的颜色失真和边界残留,使增强后的图像更接近真实场景。
提高模型泛化能力:构建一个能够适应不同光照环境、场景和阴影形态的去阴影系统。
优化计算效率:设计轻量化的网络结构,使其能够在低计算资源环境(如移动设备)上运行。
1.3.2研究内容
本文主要围绕以下几个方面展开研究:
数据预处理与增强:收集并整理公开的阴影去除数据集,如 ISTD、SRD,并采用数据增强技术提升模型的泛化能力。
深度学习网络构建:基于 U-Net、GAN 或 Transformer 设计高效的去阴影模型,并优化其网络结构和损失函数,以提高去阴影效果。
训练与优化:使用监督或无监督学习方法进行模型训练,采用 PSNR、SSIM 等评价指标进行模型评估,并通过对抗训练等技术提升去阴影质量。
实验与对比分析:与传统方法和现有深度学习方法进行实验对比,验证本研究提出方法的有效性,并探索不同模型参数对去阴影性能的影响。
最终,本研究希望实现一个高效、稳定的深度学习去阴影系统,并探索其在图像增强、计算机视觉等领域的实际应用潜力。
1.4 本文的结构安排
本章介绍图像去阴影的研究背景和意义,分析当前技术的发展现状及存在的问题,明确本文的研究目标与研究内容,并概述论文的整体结构安排。
第二章 相关技术与理论基础
本章介绍图像去阴影的基本概念和相关理论,重点分析 Zero-DCE 框架的原理,讨论深度可分离卷积、注意力机制(Coordination Attention)以及非线性曲线增强方法,并详细说明多损失函数联合优化策略,为后续系统设计提供理论支持。
第三章 图像去阴影系统的设计与实现
本章从系统需求分析入手,明确去阴影系统的目标,并阐述整体架构设计。随后,详细介绍增强网络的各个模块,包括基础网络结构、深度可分离卷积模块、注意力机制模块、非线性增强与残差学习结构。此外,还说明系统的损失函数设计、数据预处理方法以及 PyQt 用户界面的功能实现。
第四章 系统功能实现与实验结果分析
本章介绍系统的具体实现过程,包括关键技术细节和模型训练流程,并展示图像增强结果。通过实验分析模型的去阴影效果,评估系统的运行性能,并与现有方法进行对比,验证其优越性和可行性。
第五章 总结与展望
2.1 图像增强与去阴影基本概念
2.1.1 图像增强
图像增强(Image Enhancement)是计算机视觉中的重要任务,旨在改善图像质量,使其更加清晰、易于分析和处理。在图像去阴影任务中,增强技术主要用于提升阴影区域的亮度、对比度和细节,从而恢复真实的场景信息。
传统的图像增强方法包括直方图均衡化、Gamma 变换和 Retinex 理论等,这些方法通过调整像素分布或光照模型来增强图像[7]。然而,传统方法往往依赖固定的变换规则,无法适应复杂的光照环境,容易导致图像过度增强或信息丢失。
基于深度学习的图像增强方法可以自动学习图像特征,实现自适应的增强效果。例如,Zero-DCE(Zero-Reference Deep Curve Estimation)方法利用深度神经网络学习非线性曲线调整图像亮度,无需参考标准高质量图像。本系统在 Zero-DCE 的基础上进行了改进,引入深度可分离卷积(Depthwise Separable Convolution)和注意力机制(CoordAttention),提升模型的计算效率和去阴影效果[8]。同时,结合多损失函数优化,如颜色恒定性损失、空间一致性损失和曝光损失,确保增强后的图像具有良好的对比度和视觉质量。
本系统通过深度学习驱动的图像增强技术,使去阴影后的图像更加自然、细节丰富,为后续的目标检测和计算机视觉任务提供更优质的数据支持。
2.1.2去阴影基本概念
图像去阴影(Shadow Removal)是计算机视觉中的关键任务,旨在去除图像中的阴影区域,以恢复原始场景的真实颜色和亮度。阴影的产生通常是由于光源被物体阻挡,导致某些区域的光照减少,使得这些区域与非阴影区域存在明显的亮度和色彩差异。阴影不仅影响图像的美观性,还会干扰目标检测、图像分割等计算机视觉任务,因此去阴影技术在自动驾驶、遥感图像处理、医疗影像分析等领域具有重要应用价值。
去阴影任务通常包括 阴影检测 和 阴影去除 两个主要步骤[9]。阴影检测旨在识别图像中的阴影区域,而阴影去除则是对检测出的阴影区域进行亮度和颜色校正,使其与周围区域保持一致。传统的去阴影方法主要基于颜色不变性、光照模型和图像分割技术,但这些方法在复杂光照条件下往往表现不佳。
近年来,基于深度学习的方法显著提升了去阴影的效果。通过构建端到端的神经网络,模型可以自动学习阴影的分布特征,并生成无阴影的自然图像。本研究基于 Zero-DCE 框架进行优化,引入深度可分离卷积和注意力机制,提升模型的计算效率和泛化能力,以更高质量地去除图像中的阴影。
2.2 Zero-DCE框架原理概述
Zero-Reference Deep Curve Estimation(Zero-DCE)是一种基于深度学习的无参考图像增强方法,特别适用于低光照图像和非均匀光照环境下的图像优化。传统的图像增强方法通常依赖于有监督学习,需要高质量的参考图像作为训练数据,而 Zero-DCE 采用无参考学习策略,通过端到端优化学习图像的亮度调整曲线,实现对输入图像的自适应增强。
Zero-DCE 的核心思想是利用 非线性曲线映射 来逐步调整图像亮度和对比度。具体而言,该框架使用轻量级卷积神经网络(CNN)来预测一组调整曲线参数,表示为:

其中,I 是输入图像,JJJ 是增强后的输出图像,At 是由深度网络学习得到的曲线参数,T是曲线调整的阶数[10]。该方法可以灵活地适应不同的光照环境,实现逐步增强。
为了保证增强结果的自然性,Zero-DCE 设计了多个无监督损失函数,如颜色恒定性损失(L_color)、空间一致性损失(L_spa)、曝光损失(L_exp)和全变差损失(L_TV)。本研究在 Zero-DCE 框架的基础上进行改进,引入深度可分离卷积(DSC)和注意力机制(CoordAttention),进一步提高计算效率和去阴影效果,使增强后的图像更加自然、细节丰富。
2.3 深度可分离卷积的原理与优势
深度可分离卷积(Depthwise Separable Convolution, DSC)是一种高效的卷积运算方式,旨在减少计算复杂度和参数量,同时保持卷积神经网络(CNN)的表达能力。它通过将传统卷积分解为 深度卷积(Depthwise Convolution) 和 逐点卷积(Pointwise Convolution) 两个步骤,降低计算开销,提高模型的运行效率。
在传统的标准卷积中,每个卷积核都会同时在 空间维度 和 通道维度 上进行计算,导致大量的计算需求[11]。而在深度可分离卷积中:
深度卷积(Depthwise Convolution):每个通道使用独立的卷积核进行空间特征提取,不进行跨通道运算。
逐点卷积(Pointwise Convolution, 1×1 卷积):使用 1×1 卷积核在通道维度进行特征融合,将不同通道的信息整合在一起。
这种分解方式能够显著减少计算量。例如,对于一个 D×DD \times DD×D 的标准卷积,其计算复杂度为 O(D2⋅M⋅N)而深度可分离卷积的计算复杂度约为 O(D2⋅M+M⋅N),当通道数较大时,可降低近 8-9 倍 的计算量。
本研究在图像去阴影的深度学习网络中引入深度可分离卷积,使模型在保证去阴影效果的同时,大幅减少参数量,提高推理速度,从而更适合移动端和边缘计算设备部署。
2.4 注意力机制(Coordination Attention)介绍
注意力机制(Attention Mechanism)是深度学习中一种模仿人类视觉聚焦机制的技术,它通过自适应地调整网络对不同区域或特征的关注程度,来提升模型在复杂任务中的表现[12]。在图像去阴影任务中,阴影区域与背景常常存在光照、颜色和结构上的差异,传统的卷积神经网络(CNN)往往无法精确地捕捉到这些细节,导致去阴影效果不理想。为了解决这个问题,Coordination Attention(CoordAtt) 被引入作为一种有效的注意力机制。
CoordAtt 是一种基于空间坐标信息的注意力机制,它通过同时利用空间位置和通道信息来增强模型对关键区域的关注。该机制的核心思想是,除了关注通道的特征信息外,还考虑空间上的局部关系,尤其是在处理阴影区域时,可以帮助网络准确地定位阴影边缘和过渡区域[13]。具体来说,CoordAtt 通过引入 空间坐标信息,生成与位置相关的注意力图,从而强化模型对目标区域(如阴影边界、物体边缘等)的建模能力。
CoordAtt 的优势在于,它能够有效地增强网络对细粒度空间信息的捕捉能力。与传统的注意力机制相比,CoordAtt 更加关注图像中的空间坐标关系,这使得网络在处理具有复杂光照和阴影的图像时,能更准确地去除阴影并保留原始图像的细节。通过引入 CoordAtt,图像去阴影模型能够更好地应对各种光照条件,从而实现更加自然和精确的去阴影效果。
2.5 非线性曲线增强方法
非线性曲线增强方法是一种基于图像像素值的非线性映射进行图像增强的技术,它能够通过调整图像的亮度和对比度,改善图像的视觉效果,特别是在低光照或阴影区域的增强中具有重要作用。在图像去阴影系统中,非线性曲线增强方法可以自适应地提升图像细节,避免在增强过程中产生过度增强或信息丢失的情况。
该方法的核心思想是利用非线性函数(如S型曲线)来进行像素级的亮度调整。与传统的线性增强方法不同,非线性曲线增强通过对图像亮度值进行逐像素的非线性变换,使得图像在增强过程中能够保持更自然的亮度过渡,尤其是在阴影区域。常见的非线性曲线函数包括 Sigmoid 函数 和 Gamma 变换,这些函数通过调整其参数可以灵活控制图像的对比度和亮度,适应不同的图像增强需求。
具体而言,非线性曲线增强方法通过以下公式进行图像像素的变换:

其中,J(x)是输出图像的像素值,I(x)是输入图像的像素值,α\alphaα 为调整参数,控制图像的亮度和对比度。通过逐像素的非线性变换,系统能够自动增强图像的亮度细节,并保持图像的自然感和真实感。
在图像去阴影任务中,非线性曲线增强方法通过动态调整阴影区域的像素值,使得阴影区域的亮度和周围区域更加一致,从而实现更加自然的去阴影效果。这一方法能够有效提升图像的视觉质量,同时避免了传统增强方法可能带来的色偏和伪影问题。
2.6多损失函数联合优化策略
在图像去阴影系统中,采用多损失函数联合优化策略能够有效提升图像的质量,确保去阴影后的图像不仅在亮度和对比度上得到增强,而且能够保持色彩的自然性和结构的一致性。通过结合多个损失函数,可以从不同维度引导模型学习到更全面的图像特征,避免单一损失函数带来的局限性。常见的损失函数包括颜色恒定性损失、空间一致性损失、曝光损失和全变差损失等。
颜色恒定性损失(L_color):此损失函数用于保证去阴影后的图像在RGB通道之间的色彩平衡,避免出现色偏问题。通过最小化图像增强前后色彩分布的差异,确保图像的颜色自然且一致。
空间一致性损失(L_spa):该损失函数关注图像结构的空间一致性,确保去阴影后的图像保持与原图相似的空间结构,避免在增强过程中出现不自然的边缘或伪影。
曝光损失(L_exp):曝光损失用于控制图像的亮度,确保增强后的图像不会出现过曝或欠曝的现象。通过引导网络生成合理的亮度值,保持图像的真实感和可视性。
全变差损失(L_TV):全变差损失用于平滑图像,减少图像中的噪声和不必要的细节,特别是在阴影区域,防止增强过程中产生过多的高频噪声。
通过联合优化这些损失函数,图像去阴影模型能够在多个层面上进行训练和优化,最终生成既有较高视觉质量又保持真实感的去阴影图像。
3.1 系统需求分析与目标确定
3.1.1 系统需求分析
图像去阴影系统的设计与实现必须满足一定的技术和功能需求,以确保其在实际应用中能够高效、稳定地运行。以下是本系统的主要需求分析:
性能需求
系统应能够高效处理低照度和阴影图像,提供快速的图像增强和去阴影功能。在保证图像质量的同时,系统需要具备高效的计算性能,支持批量图像处理和实时反馈,确保用户体验流畅[13]。基于深度学习的图像去阴影模型需要优化推理速度,以适应资源受限的设备(如移动端或嵌入式设备)。
准确性需求
系统必须能够精确地识别和去除图像中的阴影区域,确保阴影的增强效果自然且细节保留完好。增强后的图像应当具备高对比度、高亮度均匀性,并且在颜色上保持一致,避免出现色偏或过度增强现象。
可扩展性需求
系统需要具备较高的可扩展性,能够支持未来的功能扩展与优化。例如,支持不同的图像增强模块(如感知损失、UNet结构等)的接入,以提高系统的适应性与灵活性。
用户界面需求
系统应具有易用的图形用户界面(GUI),以便非技术用户能够方便地操作和使用。用户界面需要提供图像导入、去阴影处理、预览、批量处理等功能,且支持结果的实时展示与保存。
硬件需求
系统应支持在不同硬件平台上运行,包括PC端、移动端及边缘计算设备。为了保证深度学习模型的高效推理,系统需要支持GPU加速,确保计算任务能够快速完成。
综合以上需求分析,本系统在实现过程中将优化计算效率、提升去阴影效果,并确保界面的友好性和系统的稳定性,以满足不同用户和设备的需求。
3.1.2 目标确定
本系统的目标是开发一个基于深度学习网络的图像去阴影系统,旨在通过有效的技术手段去除低照度图像中的阴影区域,提升图像的亮度、对比度和细节表现[14]。具体目标如下:
阴影去除与增强
系统应能够准确地识别图像中的阴影区域,并实现有效去除。通过改进的深度学习模型,增强图像的亮度和对比度,使阴影区域与非阴影区域的光照更加均衡。最终目标是生成去阴影后的图像,提升图像的视觉质量,并确保图像的自然性与真实感。
提升图像细节与色彩一致性
去阴影过程中,系统应尽可能保留图像中的细节信息,避免因增强而导致的细节丢失或色偏现象。特别是在阴影区域,应确保图像的色彩一致性与结构稳定性,避免不自然的色彩变化。
高效性与实时性
系统应具备较高的处理效率,支持快速图像去阴影处理,特别是在批量图像处理时,确保处理过程的实时性。这一点对应用于工业、安防等领域尤为重要,能够满足用户对高效性的要求。
易用性与可扩展性
系统应具备友好的用户界面,使非技术用户能够方便地使用。同时,系统架构需要具备高度的可扩展性,支持后续功能的增加与优化,如更高效的去阴影算法、其他图像增强模块的接入等。
通过这些目标的实现,系统将能够有效解决低照度和阴影图像的问题,提升图像质量,满足不同应用场景的需求。
3.2系统总体架构设计
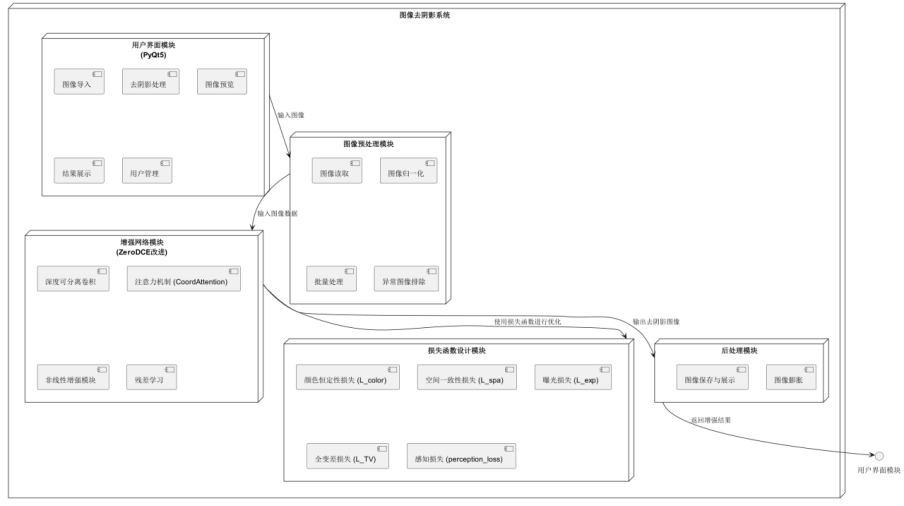
基于深度学习网络的图像去阴影系统的总体架构。系统被划分为五个主要模块:用户界面模块、图像预处理模块、增强网络模块、损失函数设计模块和后处理模块。
用户界面模块:为系统的前端,负责图像导入、阴影处理、预览和结果展示等操作。用户通过该模块与系统进行交互,能够方便地查看处理结果和进行相关设置。
图像预处理模块:该模块负责图像的读取、归一化处理和批量处理。它确保图像输入的统一性和质量,准备好数据供后续增强网络处理。
增强网络模块:核心部分,基于ZeroDCE框架改进,使用深度可分离卷积、注意力机制(CoordAttention)和非线性增强模块进行图像的增强和去阴影操作,确保增强效果的准确性和细节保留。
损失函数设计模块:在训练过程中,采用多个损失函数,如颜色恒定性损失、空间一致性损失、曝光损失等,优化增强网络的性能。
后处理模块:在去阴影增强后,对图像进行进一步处理,例如图像膨胀,并将处理后的结果保存并展示给用户。
整个系统通过这五个模块的协同工作,实现了高效的图像去阴影处理。
3.3网络结构设计与模块说明
在基于深度学习网络的图像去阴影系统中,网络结构设计是实现高效去阴影处理的核心[15]。本文所采用的网络架构基于Zero-DCE(Zero Reference Deep Curve-based Enhancement)框架进行改进,并结合深度可分离卷积、注意力机制和非线性增强模块,确保了系统在处理低照度和阴影图像时的高效性与准确性。
3.3.1基础网络结构(Zero-DCE主干)
Zero-DCE框架采用了基于曲线的增强机制,在没有Ground Truth图像的情况下,能够通过深度学习模型对低照度图像进行自适应增强。该结构主要由卷积层、激活函数和残差模块构成,用于从低照度图像中提取特征,并通过曲线增强进行亮度和对比度优化。
3.3.2深度可分离卷积模块
为提高网络的效率与减少计算资源消耗,本系统采用了深度可分离卷积(Depthwise Separable Convolution)。通过分离卷积操作,先进行深度卷积再进行点卷积,这大大减少了模型的参数数量,同时提高了处理速度,适合边缘设备部署。
3.3.3注意力机制模块(Coordination Attention)
为了增强网络对关键区域的感知能力,本系统引入了Coordination Attention模块。该模块能够通过捕捉图像的空间位置信息,对重要的图像区域(如阴影边缘)进行关注,改善模型对不同场景和阴影分布的适应能力。
3.3.4非线性增强模块与残差学习
本系统模仿Zero-DCE的非线性曲线增强机制,通过多阶段递归的方式逐步优化图像的亮度和对比度[16]。通过生成残差图(x_r),网络不会直接修改原始图像,而是以残差方式引导图像增强,避免过度增强带来的伪影或结构破坏。
通过上述模块的有效配合,系统能够在低照度图像中精确地还原阴影区域,并保持图像的自然感与细节。
3.4 损失函数设计
在图像去阴影系统中,损失函数的设计对于提升图像增强效果至关重要。为了确保生成的去阴影图像在亮度、对比度、色彩一致性和结构保持等方面的优质表现,本文设计了多种损失函数来优化训练过程。
颜色恒定性损失 (L_color):该损失函数旨在保持图像的颜色一致性。通过约束RGB三个通道的平衡,避免由于增强过程引入的色偏,确保图像在去阴影后仍然保持自然色彩。
空间一致性损失 (L_spa):此损失函数用于确保增强图像在空间结构上的一致性。它保持了增强前后图像的结构和边缘特征,从而避免了图像增强过程中的形状失真,确保图像的真实感[17]。
曝光损失 (L_exp):曝光损失用于调整图像的亮度,使得增强后的图像亮度接近目标值。它能够有效避免图像在增强过程中产生的过曝或欠曝现象,使图像亮度更加自然[18]。
全变差损失 (L_TV):全变差损失用于减少图像中的噪声,抑制高频噪声的产生,使增强后的图像更为平滑,减少不必要的视觉伪影[19]。
通过这几种损失函数的联合优化,系统能够在去除阴影的同时保持图像的自然感和细节完整性。
关键代码:
class ShadowRemovalNet(nn.Module):
def __init__(self):
super(ShadowRemovalNet, self).__init__()
self.conv1 = nn.Conv2d(3, 64, kernel_size=3, padding=1)
self.conv2 = nn.Conv2d(64, 128, kernel_size=3, padding=1)
self.fc1 = nn.Linear(128*32*32, 1000)
self.fc2 = nn.Linear(1000, 3*32*32)
def forward(self, x):
x = F.relu(self.conv1(x))
x = F.relu(self.conv2(x))
x = x.view(x.size(0), -1) # Flatten
x = F.relu(self.fc1(x))
x = self.fc2(x)
x = x.view(x.size(0), 3, 32, 32) # Reshape back to image size
return x
def color_consistency_loss(pred, target):
return torch.mean((pred - target)2)
def spatial_consistency_loss(pred, target):
return torch.mean(torch.abs(F.relu(pred - target)))
def total_variation_loss(x):
return torch.sum(torch.abs(x[:, :, :-1, :] - x[:, :, 1:, :])) + torch.sum(torch.abs(x[:, :, :, :-1] - x[:, :, :, 1:]))
3.5 数据处理与图像预处理方法
3.5.1数据处理
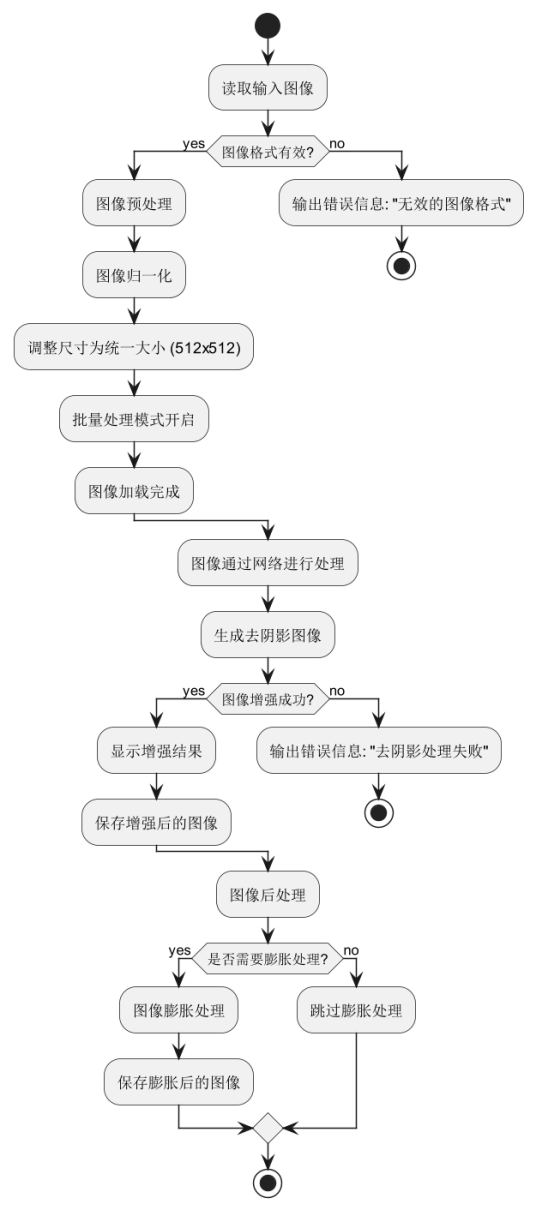
基于深度学习的图像去阴影系统的数据处理流程。首先,系统接收用户输入的图像并进行格式检查。如果图像格式无效,系统将输出错误信息并停止处理。如果图像格式有效,接下来进行图像的预处理,包括尺寸调整、归一化处理等,确保图像符合模型的输入要求[20]。
经过预处理的图像将输入到去阴影网络中进行处理,生成增强后的图像。如果去阴影处理成功,系统会展示结果并保存处理后的图像;若处理失败,则会输出错误信息并终止。
最后,系统进入后处理阶段。如果用户选择对图像进行膨胀处理,系统将进行图像膨胀并保存;若不需要膨胀处理,系统跳过该步骤。
整体流程通过条件判断(if-else)确保每个环节的正确性和灵活性,保证了图像去阴影的高效处理和结果展示。
3.5.2图像预处理方法
图像预处理是深度学习图像去阴影系统中至关重要的一步,确保输入数据的质量和一致性,从而提高模型的效果和训练效率[21]。首先,图像格式验证确保输入的图像格式正确且可用(如JPEG、PNG等),避免因格式错误导致的处理问题。接下来,尺寸统一化将所有图像统一调整为指定的尺寸(如512x512),这对于神经网络来说是非常重要的,因为模型通常要求固定尺寸的输入[22]。然后,归一化处理将图像的像素值归一化到特定范围(例如[0,1]或[-1,1]),确保数据适应神经网络的训练,帮助加速收敛并提高模型的表现。
此外,图像增强技术对低照度图像进行亮度或对比度的调整,增强图像的可见性,使模型能够更好地学习图像中的细节。最后,异常图像排除步骤通过检测图像是否存在噪声、损坏或其他问题,自动排除这些低质量的图像,保证数据集的高质量输入,提升去阴影模型的性能和准确性。
| 步骤 | 操作 | 目的 |
| 图像格式验证 | 检查输入图像格式是否有效(JPEG、PNG等) | 确保输入图像格式正确,避免不支持的格式导致错误 |
| 尺寸统一化 | 将图像调整为统一的尺寸(例如 512x512) | 保证所有图像尺寸一致,方便网络处理 |
| 归一化处理 | 将图像的像素值归一化到 [0, 1] 或 [-1, 1] 范围内 | 使图像像素值范围适应网络输入,促进模型收敛 |
| 图像增强 | 通过对比度或亮度调整增强图像质量 | 提升低照度图像的可见性,增强网络对细节的感知能力 |
| 异常图像排除 | 自动检测并排除损坏或质量差的图像 | 确保输入数据的质量,避免损坏图像影响模型性能 |
3.3系统界面与功能实现(PyQt界面设计)
3.3.1 系统界面
用户界面(UI)是与用户交互的重要组成部分,旨在提供直观、简便的操作体验。系统采用 PyQt5 框架开发图形用户界面(GUI),包括多个功能模块,确保用户能够轻松完成图像处理任务[23]。
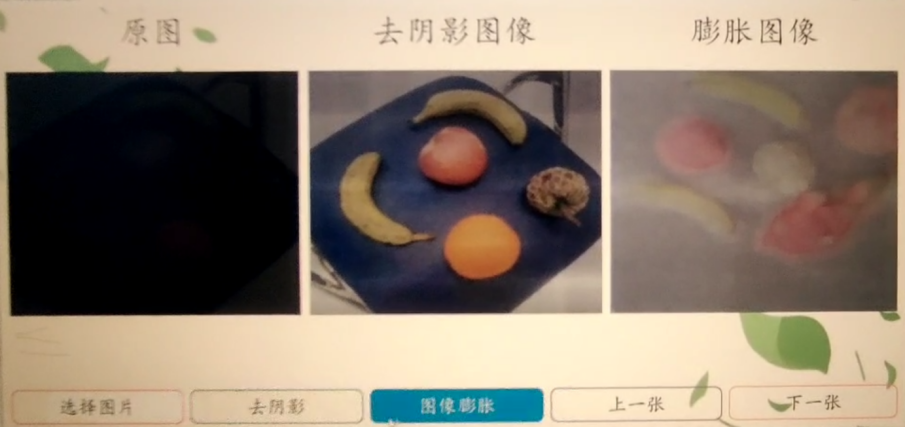
界面主要包括图像导入、处理与展示模块。用户可以通过文件选择框上传待处理的低照度图像,系统将自动显示图像的预览。通过点击“去阴影处理”按钮,图像将经过深度学习网络进行处理,生成去阴影后的图像,并实时显示处理结果。

此外,界面还支持批量处理功能,用户可以一次性上传多个图像进行批量去阴影,处理完成后可批量保存。为了提高用户体验,系统还提供了图像膨胀、亮度调整等后处理功能,确保最终输出图像符合需求。界面简洁、易用,即使非技术用户也能够轻松操作,实现高效的图像去阴影处理。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)