向量数据库从基础到实战:概念解析、Milvus 部署与人事政策数据检索实践
1、什么是向量数据库
向量数据库(Vector Database)是一种专门用于存储、管理和检索向量(Vector/Embedding) 的数据库系统。
1.1 什么是向量
向量是高维数值数组(如 128 维、768 维),由文本、图像、音频等非结构化数据通过嵌入模型(Embedding Model)转换而来,可直观反映数据的语义特征(如 “猫” 和 “小猫” 的向量距离很近)。
2、向量数据库能干什么
传统数据库(关系型、文档型)擅长处理结构化查询(如 “查询价格> 100 的商品”),但无法理解数据的语义关联。
例如:对 “推荐一款适合新手的相机”,传统数据库无法通过关键词匹配到 “入门级相机”“初学者适用机型” 等语义相关的内容;
向量数据库则能将 “新手相机” 转换为向量,与数据库中 “入门级相机” 的向量计算相似度,快速找到语义最接近的结果。
2.2 向量数据库的核心功能
1、高效存储高维向量
支持存储百万至数十亿级别的高维向量(常见维度 384-2048 维),并针对向量的稀疏性、高维度特性优化存储结构(如压缩编码),降低存储成本。
2、相似度检索
核心能力是计算 “用户查询向量” 与 “数据库中向量” 的相似度(常用余弦相似度或欧氏距离),返回 Top N 最相似结果。
例如:
余弦相似度:取值 [-1,1],越接近 1 表示语义越相似;
欧氏距离:数值越小,向量越接近。
3、索引加速检索
直接计算海量向量的相似度会非常缓慢(复杂度 O (n)),向量数据库通过索引算法优化检索效率,常见索引包括:
HNSW(Hierarchical Navigable Small World)(分层导航小世界):目前最主流的索引,通过构建多层 “小世界网络”,实现毫秒级检索(适合高维向量);
IVF(Inverted File)(倒排文件):将向量聚类到多个 “桶” 中,先检索相似桶再计算内部向量,平衡速度与精度;
FLAT(暴力检索):无索引,直接计算所有向量相似度,精度最高但速度最慢(仅用于小规模数据)。
4、元数据过滤
支持为向量附加元数据(如文档类型、时间戳、权限标签),检索时可结合元数据筛选(如 “只检索 2024 年后的技术文档”),兼顾语义相关性与业务规则。
5、动态更新与扩展性
支持向量的实时插入、删除、更新,且多数向量数据库(如 Milvus、Weaviate)提供分布式部署能力,可横向扩展以应对数据量增长。
2.3 典型应用场景
检索增强生成(RAG):存储企业文档的向量,用户提问时快速召回相关文档片段,作为 LLM 的上下文。
智能推荐:将用户行为、商品特征转换为向量,通过相似度匹配推荐 “兴趣相似的商品 / 内容”。
图像 / 视频检索:将图像转换为特征向量,实现 “以图搜图”(如相册中搜索 “海边日落” 的照片)。
自然语言处理:语义搜索(如 “查找和‘如何优化供应链’意思相近的文章”)、文本聚类、情感分析等。
生物信息:存储基因序列、蛋白质结构的向量,快速匹配相似生物特征。
3、与传统数据库 / 搜索引擎的区别
传统关系型数据库(如 MySQL):处理结构化数据(表、行、列),依赖 SQL 查询,无法计算向量相似度。
文档型数据库(如 MongoDB):存储非结构化文档(JSON),支持关键词检索,但不理解语义(如 “猫” 和 “小猫” 视为不同关键词)。
搜索引擎(如 Elasticsearch):基于关键词倒排索引,擅长文本匹配,但语义理解能力弱(需结合向量插件扩展,如 ES 的dense_vector类型)。
向量数据库:专为高维向量设计,核心是语义相似度检索,是 AI 时代处理非结构化数据的 “刚需” 工具。
4、数据组织概念
在向量数据库中,点(Point) 和集合(Collection) 是核心的数据组织概念,它们和 ID、维度、有效负载(Payload) 共同构成了向量数据的存储和管理体系。我们可以结合 “传统数据库” 的概念做类比:
一、先明确基础要素:ID、向量(含维度)、Payload
这三个是构成 点的核心组件,先简单回顾:
ID:向量的唯一标识符(类似传统数据库的 “主键”),用于精准定位和区分每个向量(比如doc_123)。
向量(含维度):高维数值数组(如[0.12, 0.34, …, 0.78]),维度是数组的长度(如 768 维),代表数据的语义特征。
Payload(有效负载):向量的 “附加元数据”(类似传统数据库的 “其他字段”),可以是文本、数字、时间等(比如文档的原文、来源、创建时间、权限标签等)。
二、点(Point):向量数据库的 “最小存储单位”
点 是 ID、向量、Payload 的组合体,是向量数据库中存储的 “最小单元”,类比传统数据库中的 “一行记录(Row)”。
举个栗子:
假设你有一段企业文档片段 ——“本公司年假政策:入职满 1 年可享受 5 天年假”,将它处理后形成的 “点” 可能是这样的:
ID:policy_annual_leave_001(唯一标识这个片段)

向量:[0.21, 0.56, 0.33, ..., 0.89](768 维,由文本转换而来)

Payload:{ "text": "本公司年假政策:入职满1年可享受5天年假", "source": "hr_manual_2024.pdf", "page": 15, "update_time": "2024-01-01" }(附加信息)
作用:每个 “点” 对应一个具体的 “语义单元”(如文档片段、图像特征、音频片段等),通过 ID 唯一区分,向量用于语义检索,Payload 用于补充说明和过滤。
三、集合(Collection):向量的 “容器”
集合(Collection):向量的 “容器”,类比传统数据库的 “表(Table)”
集合 是多个 “点” 的组合,用于将具有相同特征的向量归类存储(类似传统数据库中 “表” 的作用)。
集合的核心特征:
-
统一的向量维度:一个集合中的所有点,向量维度必须相同(比如都是 768 维)。
原因:向量相似度计算(如余弦相似度)要求参与计算的向量维度一致,否则无法比较。 -
共享的索引配置:集合会定义检索时使用的索引算法(如 HNSW、IVF),所有点共享这个索引(类似传统数据库中表的索引配置)。
-
相同的业务属性:通常用于存储同一类数据(比如 “产品手册集合”“员工制度集合”“客户反馈集合”)。
再举个栗子:
一家公司的向量数据库可能有 3 个集合:
- Collection 1:product_manuals(产品手册集合)
存储所有产品说明书的片段向量,每个点的 Payload 包含 “产品型号”“发布时间” 等。 - Collection 2:hr_policies(人事政策集合)
存储所有员工制度的片段向量,每个点的 Payload 包含 “政策类型”“生效日期” 等。 - Collection 3:customer_complaints(客户投诉集合)
存储所有客户反馈的片段向量,每个点的 Payload 包含 “客户 ID”“投诉时间” 等。
集合的作用:
-
数据分类管理:避免不同类型的向量混合存储(比如产品数据和人事数据分开),让检索更高效(查询时可指定只在某个集合中检索)。
-
优化检索性能:同一集合的向量维度相同、索引一致,检索时无需处理维度不匹配的问题,效率更高。
-
权限隔离:可针对集合设置访问权限(如 “hr_policies” 只允许 HR 部门查询)。
总结:从 “要素” 到 “集合” 的层级关系
最顶层:集合(Collection)→ 类似“表”,管理一类向量

中间层:点(Point)→ 类似“行记录”,每个点包含3个核心要素

最底层:ID + 向量(含维度) + Payload → 点的组成部分
如何使用向量数据库:
- 首先会创建一个或多个集合(根据业务分类);
- 然后向集合中插入 “点”(每个点包含 ID、向量、Payload);
- 查询时,指定集合,数据库会在该集合内计算向量相似度,返回匹配的点,并可通过 Payload 筛选(如 “只返回 2024 年后的政策”)。
这样的结构既保证了语义检索的灵活性,又兼顾了数据管理的有序性,是向量数据库能高效处理海量非结构化数据的基础。
5、搭建并使用向量数据库
1. 常见的向量数据库有那些
| 类型 | 代表产品 | 特点 | 适用场景 |
|---|---|---|---|
| 开源 | Milvus(米洛斯) | 分布式架构,支持百亿级向量,多索引算法,生态完善(Python/Java SDK) | 企业级大规模应用(如 RAG、推荐) |
| 开源 | Chroma | 轻量易部署,API 简洁,适合快速上手(无需复杂配置) | 原型开发、小规模数据 |
| 开源 | FAISS(Facebook) | 单机高性能,索引算法丰富,但需自行搭建存储层(无分布式原生支持) | 科研、单机场景 |
| 开源 | Weaviate | 支持 Graph 结构,可结合知识图谱,自带嵌入模型集成 | 需关联数据关系的场景 |
| 商业服务 | Pinecone | 全托管,无需维护基础设施,按存储和查询量计费 | 快速上线,不想维护服务器 |
| 商业服务 | Qdrant Cloud | 支持地理空间向量检索,适合位置相关场景(如附近推荐) | 混合地理 + 语义检索 |
| 数据库扩展 | PostgreSQL + PGVector | 基于 PostgreSQL 插件,适合已用 PostgreSQL 的企业,低成本集成 | 中小型应用,复用现有数据库 |
2.部署milvus
部署 milvus 单机版
1,安装 Docker Desktop
直接在windows上,安装 Docker Desktop: 访问 https://www.docker.com/products/docker-desktop/
下载并安装 Docker Desktop。安装完成后,确保 Docker 正在运行。
2,部署步骤
- 下载 Milvus Docker Compose 配置文件
打开 PowerShell 或 CMD,然后运行以下命令下载 Milvus 的 Docker Compose 配置文件。
这个命令会将 milvus-standalone-docker-compose.yml 文件下载并保存为当前目录下的 docker-compose.yml。
Invoke-WebRequest -Uri "https://github.com/milvus-io/milvus/releases/download/v2.3.9/milvus-standalone-docker-compose.yml" -OutFile "docker-compose.yml"
你也可以直接在浏览器中打开链接,然后将内容保存为 docker-compose.yml。
- 启动 Milvus
在 docker-compose.yml 文件所在的目录下,运行以下命令启动 Milvus:
docker compose up -d
这个命令会下载所需的 Docker 镜像并启动 Milvus 服务。-d 参数表示在后台运行。
3. 验证 Milvus 状态
你可以使用以下命令检查 Milvus 服务的运行状态:
docker compose ps
如果所有服务都显示 Up,则表示 Milvus 已成功启动。
类似这种:
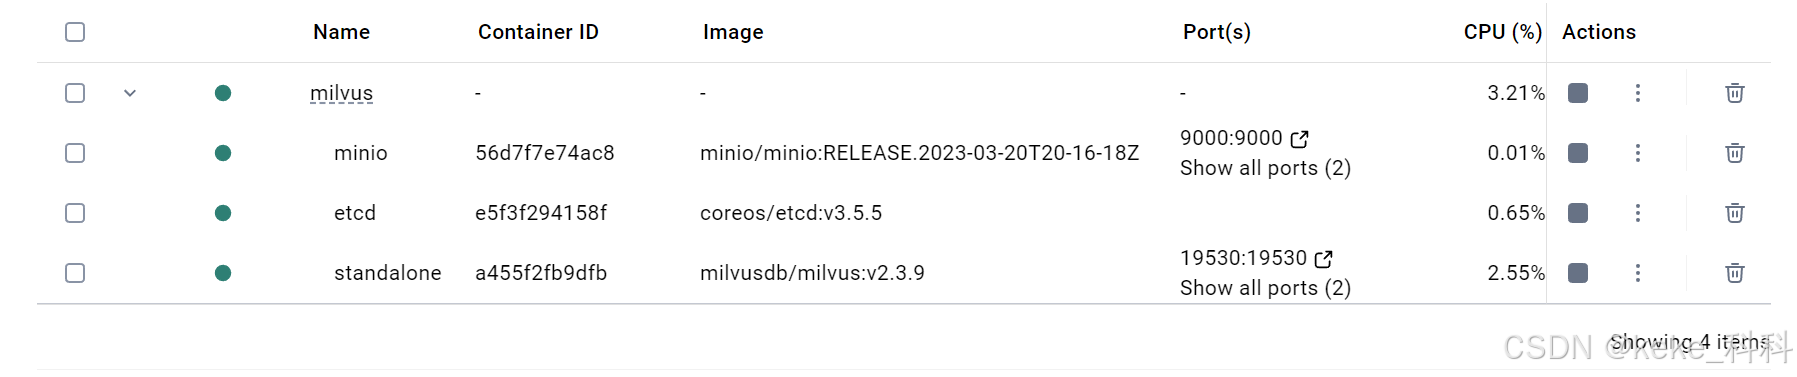
部署完成
3,安装可视化工具 attu
github可以直接下载安装包:https://github.com/zilliztech/attu/releases
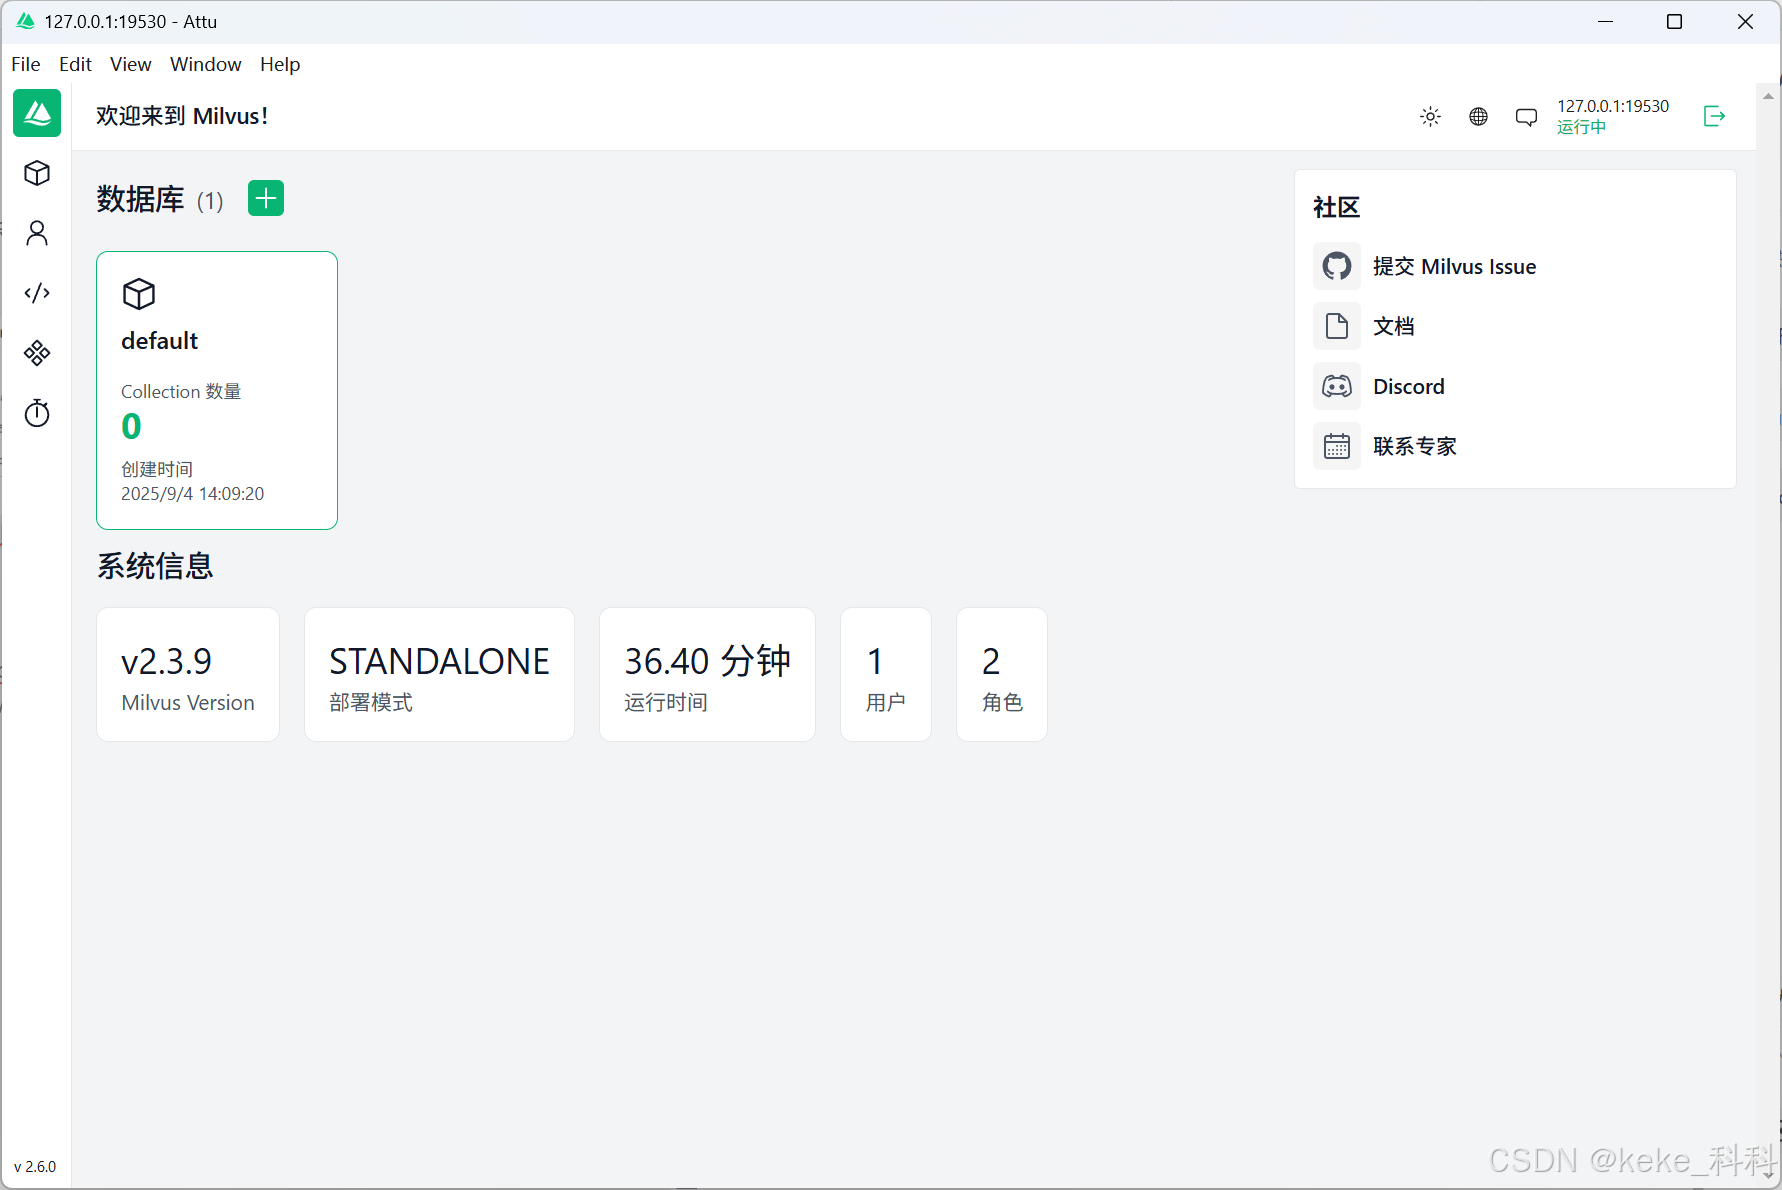
1,创建数据库
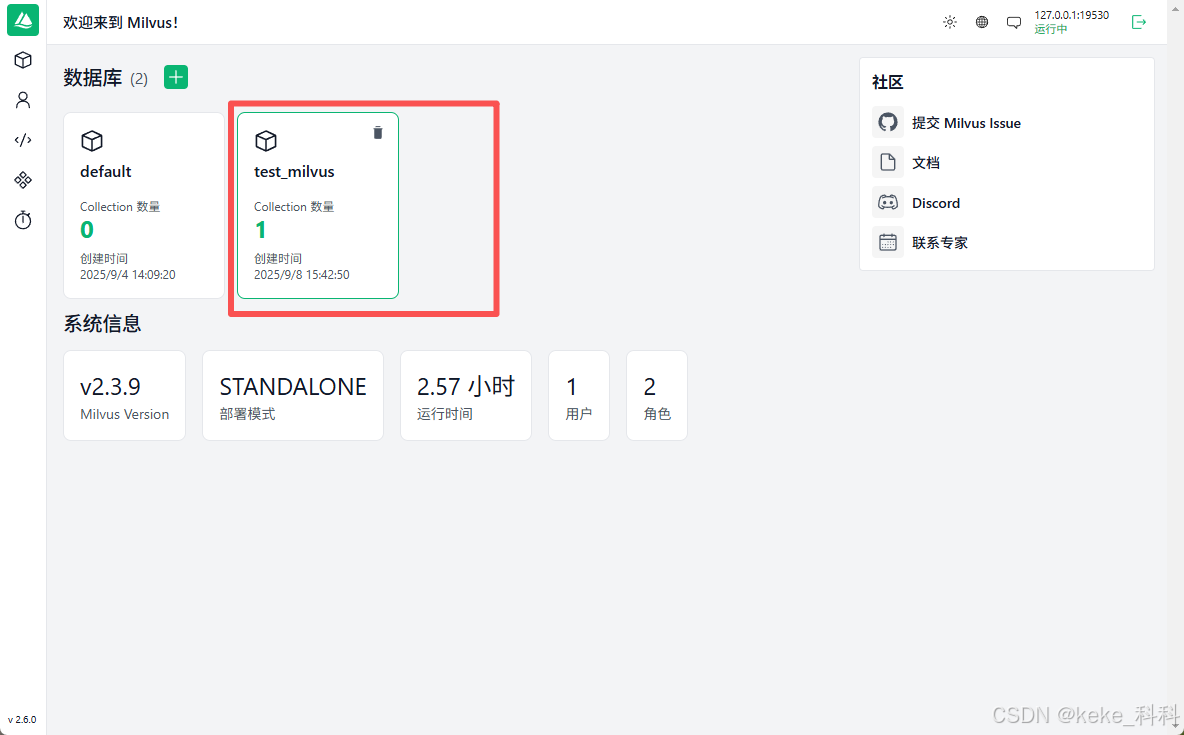
2,创建 Collection ,用之前的栗子。
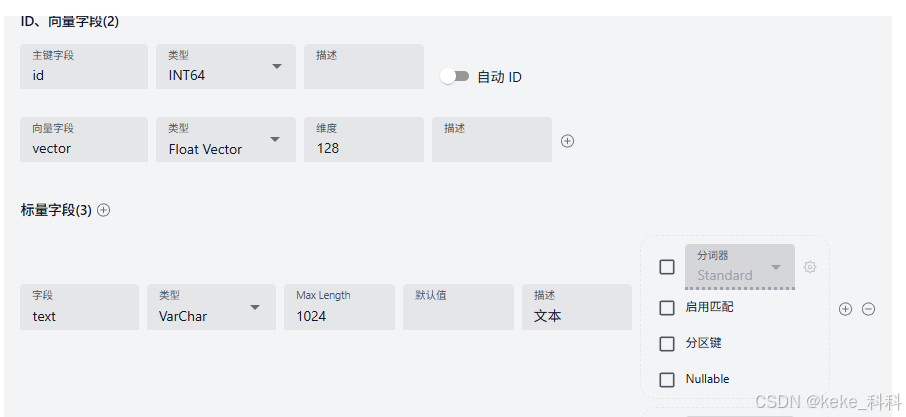
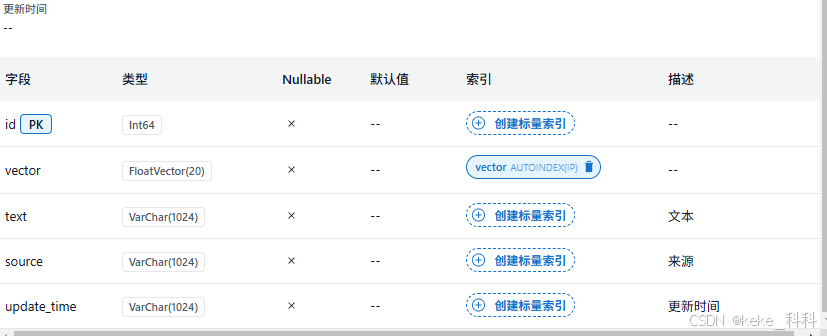
3,插入数据,,使用json文件的形式。
[
  {
    "vector": [0.12, 0.35, 0.21, 0.48, 0.09, 0.52, 0.33, 0.18, 0.41, 0.29, 0.55, 0.15, 0.38, 0.45, 0.22, 0.07, 0.51, 0.30, 0.19, 0.43],
    "text": "本公司年假政策:入职满1年可享受5天年假,连续工作满3年增至10天,满5年及以上每年可享15天年假,年假可分多次申请使用。",
    "source": "人力资源部",
    "update_time": "2025-09-08"
  },
  {
    "vector": [0.25, 0.42, 0.17, 0.39, 0.56, 0.11, 0.47, 0.28, 0.34, 0.50, 0.14, 0.40, 0.23, 0.53, 0.16, 0.37, 0.49, 0.20, 0.54, 0.13],
    "text": "病假申请规定:员工因病需请假,1天内病假需提前2小时提交申请并附门诊证明;3天及以上病假需提前1天提交住院/诊断证明,病假期间工资按公司制度发放。",
    "source": "人力资源部",
    "update_time": "2025-09-05"
  },
  {
    "vector": [0.31, 0.12, 0.46, 0.24, 0.58, 0.08, 0.44, 0.32, 0.26, 0.57, 0.10, 0.36, 0.27, 0.48, 0.06, 0.59, 0.35, 0.21, 0.41, 0.29],
    "text": "婚假福利政策:员工结婚可申请10天婚假,需在结婚登记日起1年内使用,申请时需提交结婚证复印件,婚假期间享受全额工资。",
    "source": "人力资源部",
    "update_time": "2025-09-03"
  },
  {
    "vector": [0.42, 0.25, 0.18, 0.39, 0.51, 0.15, 0.47, 0.23, 0.38, 0.54, 0.19, 0.40, 0.28, 0.56, 0.11, 0.37, 0.49, 0.22, 0.53, 0.14],
    "text": "加班调休规则:工作日加班1小时以上可累计调休,1小时加班折算0.5天调休,调休需在加班后3个月内申请使用,逾期自动失效。",
    "source": "人力资源部",
    "update_time": "2025-09-01"
  }
]
4,加载后查看数据
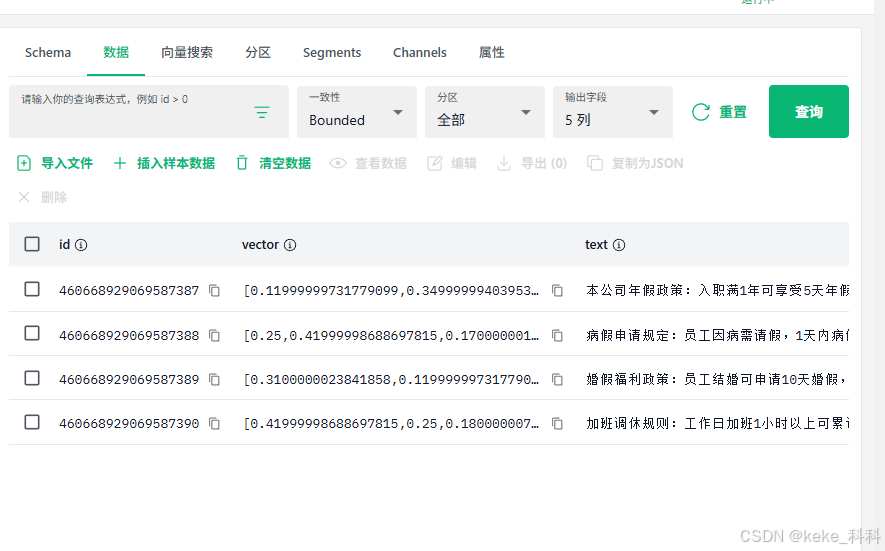
5,执行搜索
1,复制一个向量 vector的值。
2,点击搜索
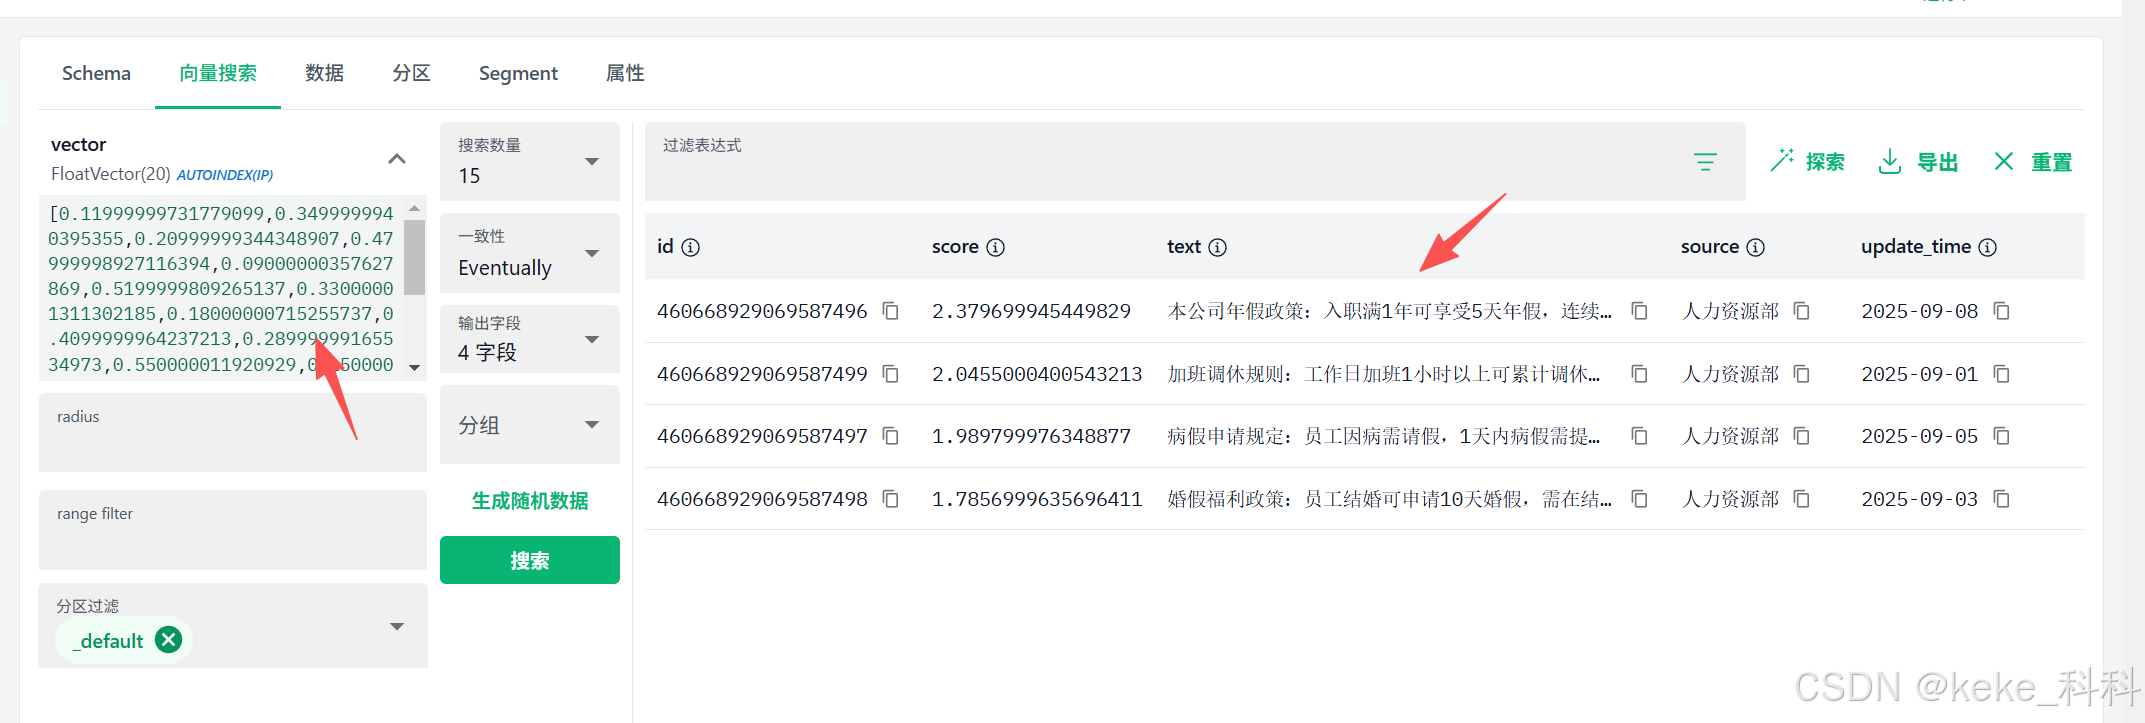
6,探索数据关系
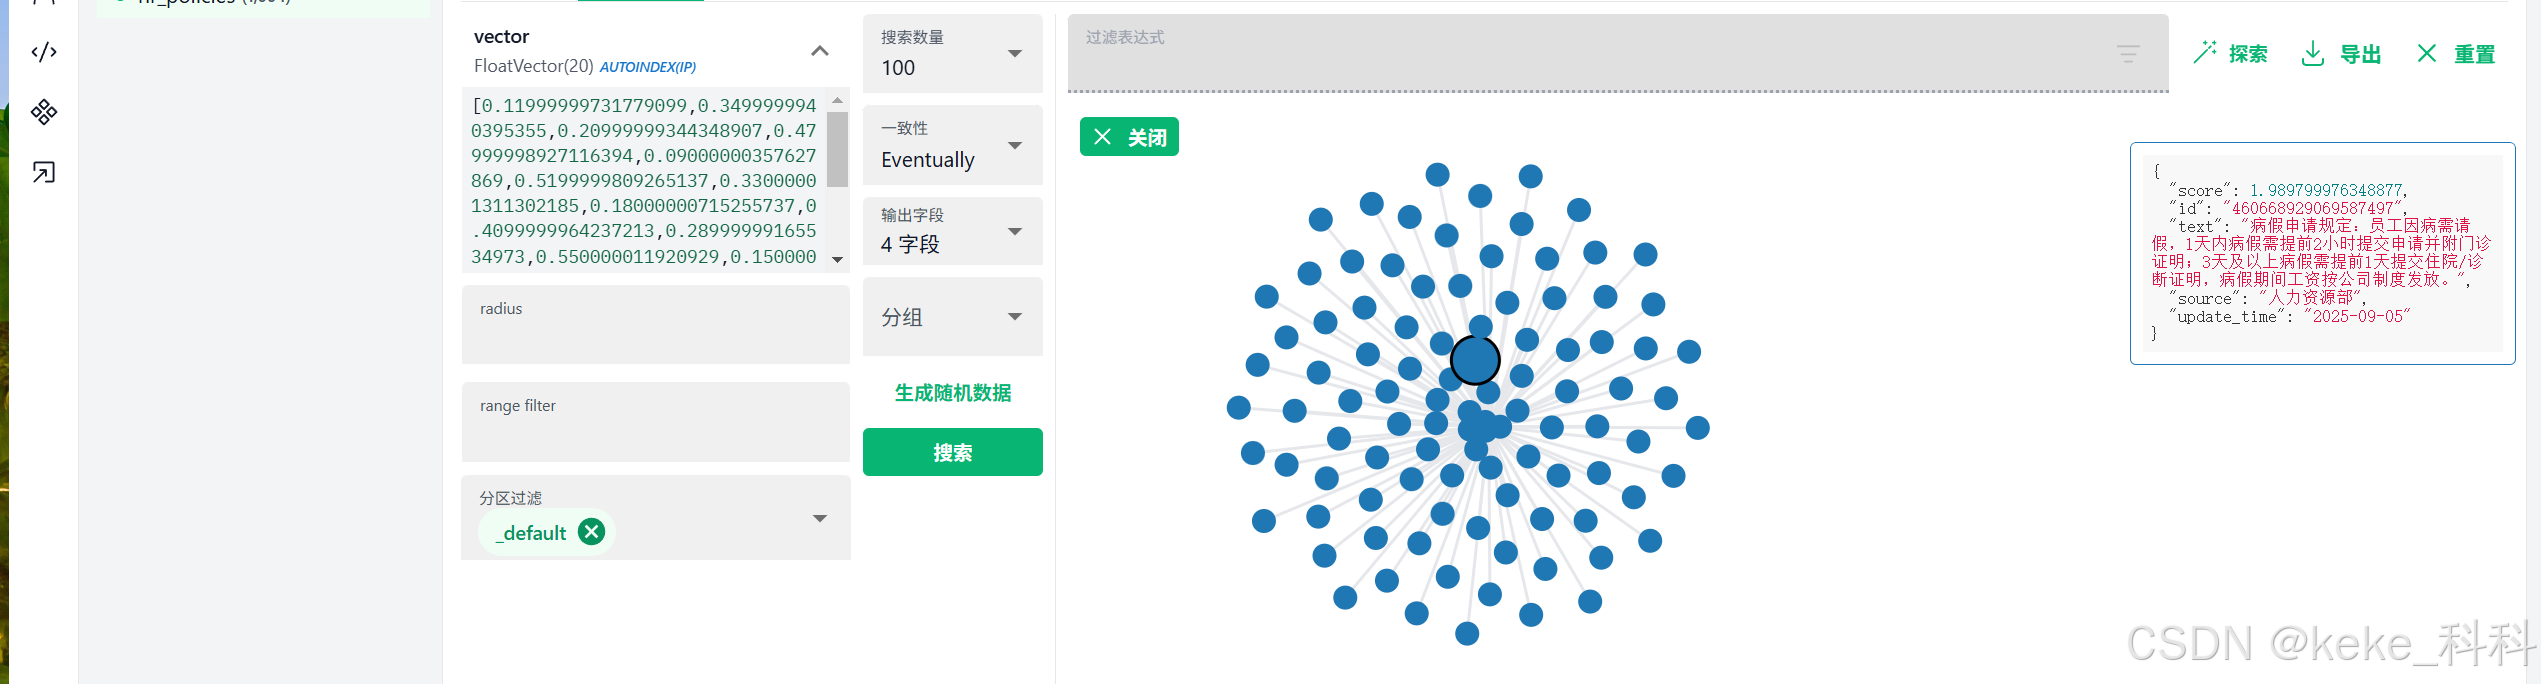
单击结果面板中的 "探索 "按钮,可将查询向量与搜索结果之间的关系可视化为类似知识图谱的结构。
1,中心节点代表搜索向量。
2,连接的节点代表搜索结果,点击它们将显示相应节点的详细信息。
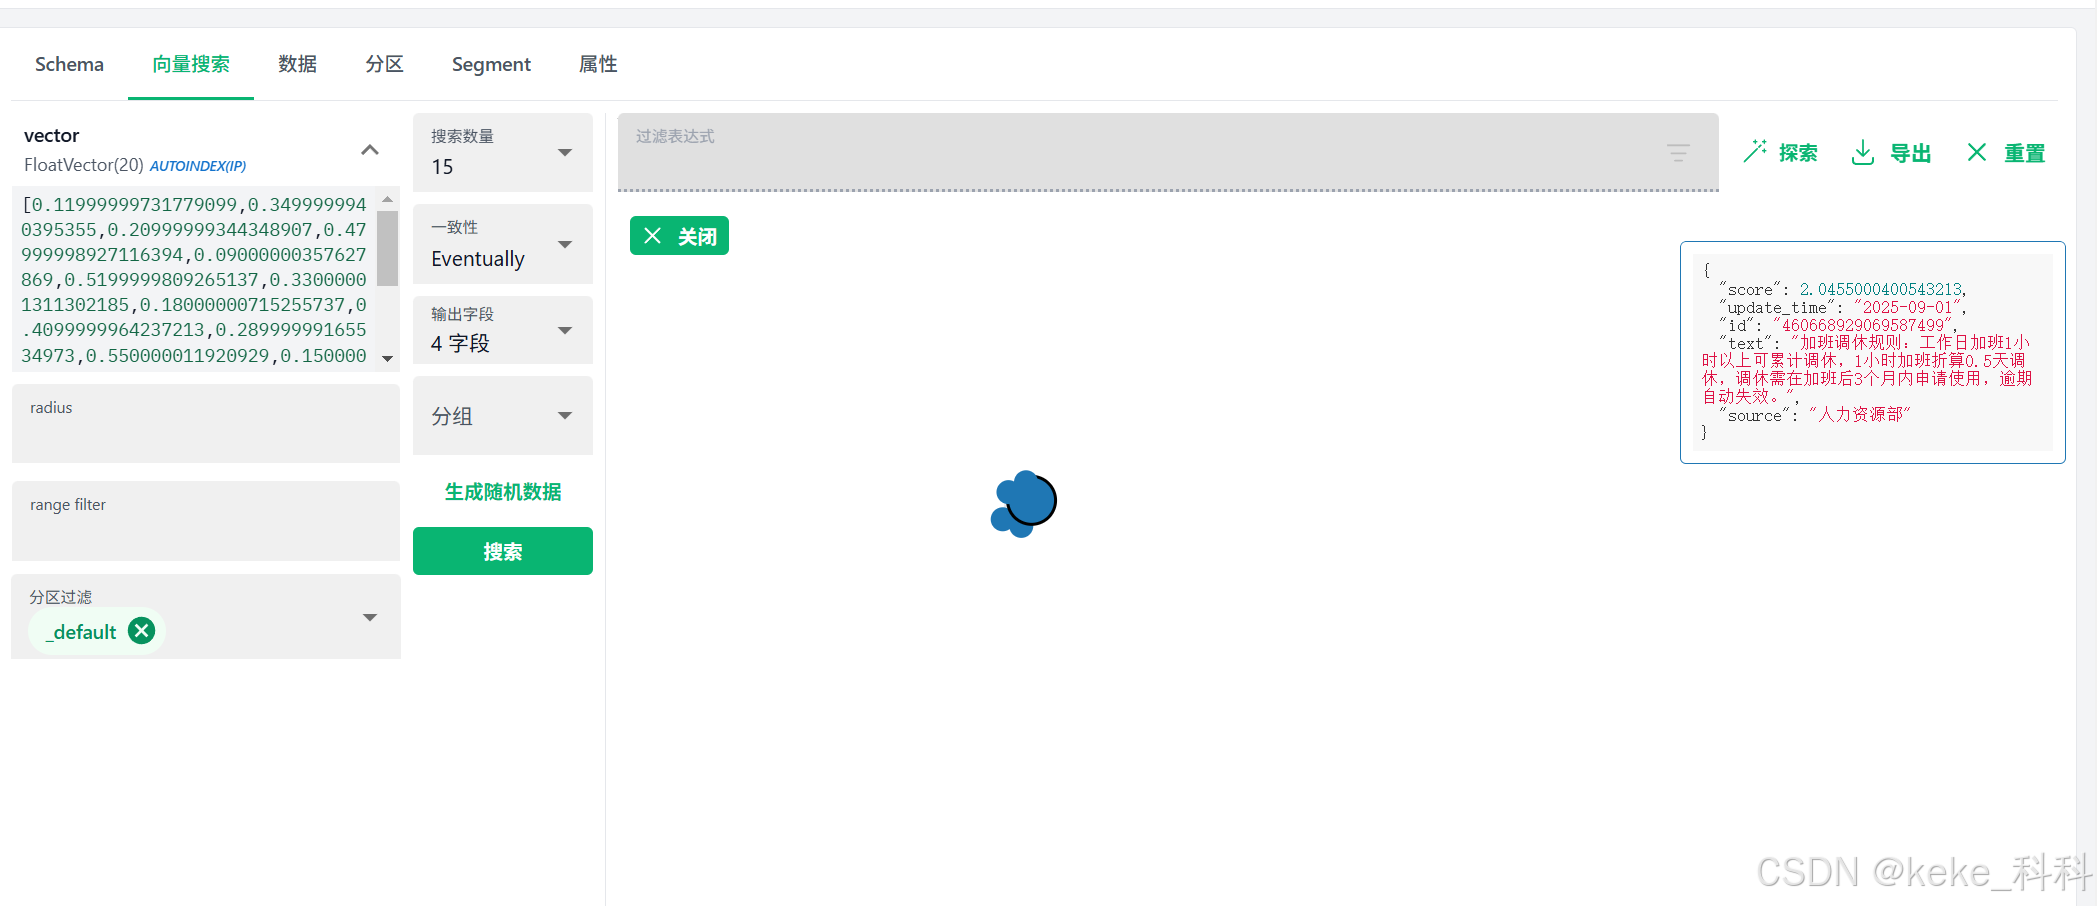
我导入1000条数据后
6、总结
本文围绕 “向量数据库是什么、能做什么、如何用” 的核心逻辑,从理论到实战完成了全流程讲解。
通过本文内容,探索 AI 与数据库的结合,以此为基础进一步扩展,充分发挥向量数据库在非结构化数据处理中的核心价值。
参考文档:milvus快速入门

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 29
 0
- 0


 已为社区贡献4条内容

所有评论(0)