自动驾驶---神经网络之GRU
1 前言
在之前的博客中笔者介绍过LSTM《自动驾驶---LSTM模型用于轨迹预测》用于轨迹预测。在神经网络的系列博客,笔者先阐述自动驾驶大模型中的轨迹解码部分,常用的神经网络结构包括MLP(已经阐述)以及GRU。
本篇博客主要给朋友们普及GRU网络的相关知识。
2 GRU
传统 RNN 通过 “循环连接” 处理时序数据(如文本、语音、时间序列),但当序列过长时,早期信息会逐渐被遗忘(梯度消失),导致模型无法捕捉长距离依赖关系(例如,文本中 “他” 与前文提到的 “小明” 的指代关系)。
GRU(Gated Recurrent Unit,门控循环单元)是一种改进的循环神经网络(RNN),旨在解决传统 RNN 在处理长序列数据时的 “梯度消失” 或 “梯度爆炸” 问题,同时简化了 LSTM(长短期记忆网络)的结构,兼顾性能与计算效率。
GRU 通过门控机制控制信息的 “更新” 与 “保留”,既能记住重要的长期信息,又能及时更新新信息,同时结构比 LSTM 更简洁(仅含两个门控单元),训练速度更快。
笔者主要通过结构、原理、训练等方面进行阐述:
2.1 GRU 的基本结构
GRU 的核心是重复单元(Recurrent Unit),每个单元在处理时序数据时,会根据当前输入和上一时刻的状态,动态调整需要保留的历史信息和需要更新的新信息。
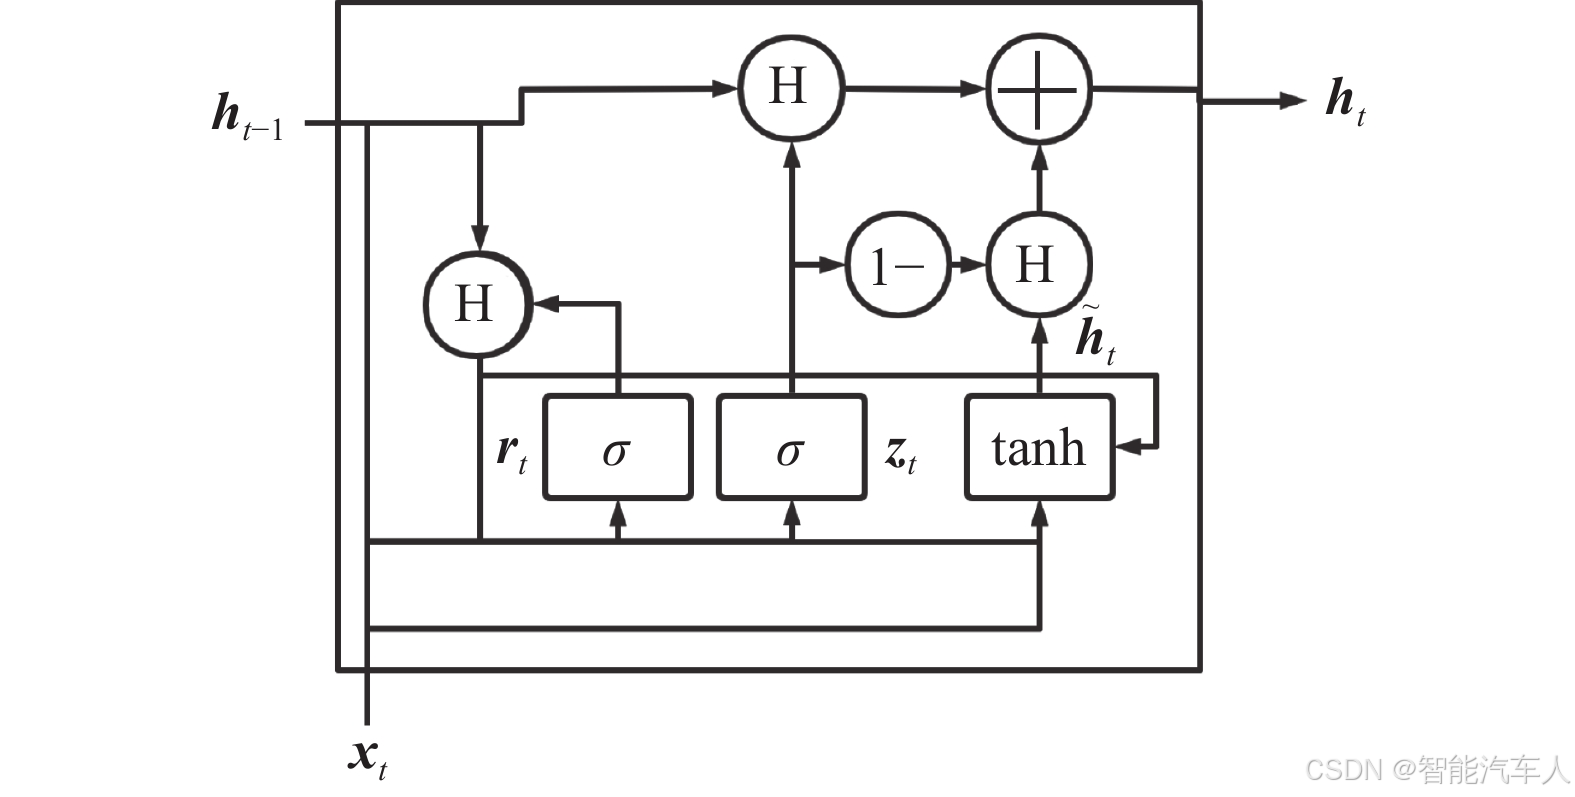
单个 GRU 单元的输入、输出与状态关系如下:
- 输入:当前时刻的输入
+ 上一时刻的隐藏状态
(记录历史信息);
- 输出:当前时刻的隐藏状态
(同时作为单元输出,传递给下一时刻);
- 核心机制:通过重置门和更新门控制信息流动。
2.2 GRU 的计算过程
GRU 的计算过程可分为 4 步:重置门计算、更新门计算、候选隐藏状态计算、最终隐藏状态更新。
(1)重置门(Reset Gate):决定保留多少历史信息
重置门用于控制 “是否忽略上一时刻的隐藏状态 ”,输出范围为
,公式如下:
其中:
表示将上一时刻状态与当前输入拼接(向量 concatenate);
是重置门的权重和偏置(模型需要学习的参数);
是 Sigmoid 激活函数(输出 0~1,0 表示完全忽略,1 表示完全保留)。
作用:若 ,则模型倾向于 “忘记” 历史信息,仅用当前输入
计算新状态;若
,则保留更多历史信息。
(2)更新门(Update Gate):决定更新多少新信息
更新门用于控制 “新信息与历史信息的融合比例”,输出同样为 ,公式如下:
其中:
和
是更新门的权重和偏置(需学习的参数);
越接近 1,表示越倾向于用新信息更新状态;越接近 0,表示越倾向于保留历史信息。
(3)候选隐藏状态(Candidate Hidden State):计算新信息
基于重置门的结果,计算 “候选的新状态”,表示当前输入与筛选后的历史信息的融合,公式如下:
其中:
表示元素级乘法(Hadamard 乘积),
表示用重置门筛选后的历史信息;
是激活函数(输出范围
),用于引入非线性;
和
是候选状态的参数。
(4)最终隐藏状态更新:融合历史与新信息
当前时刻的隐藏状态 由两部分组成:
- 第一项
:表示 “保留的历史信息”(
- 第二项
:表示 “更新的新信息”(
直观理解:更新门 像一个 “开关”,决定历史信息和新信息的 “权重”,最终状态
是两者的加权融合。
2.3 GRU 的整体计算流程
假设处理一个长度为 T 的时序序列 ,GRU 的计算步骤为:
- 初始化隐藏状态
(或随机值);
- 对每个时刻
:
- 输入
- 计算重置门
和更新门
- 计算候选状态
;
- 更新当前状态
;
- 输入
- 最终输出可根据任务选择:
- 序列标注(如词性标注):使用每个时刻的
- 序列分类(如文本情感分析):使用最后时刻的
。
- 序列标注(如词性标注):使用每个时刻的
2.4 GRU 的训练
GRU 的训练与 RNN 类似,核心是BPTT(Backpropagation Through Time,随时间反向传播),步骤如下:
- 前向传播:计算每个时刻的隐藏状态
;
- 计算损失:用损失函数(如交叉熵)衡量预测值与真实标签的差距;
- 反向传播:通过链式法则计算损失对每个参数(权重
等)的梯度;与传统 RNN 相比,GRU 的门控机制使梯度更稳定(减少梯度消失);
- 参数更新:用优化器(如 Adam)根据梯度调整参数,最小化损失。
2.5 GRU 对比 LSTM
GRU 是 LSTM 的简化版本,两者核心目标一致(解决长距离依赖),但结构不同:
| 对比维度 | GRU | LSTM |
|---|---|---|
| 门控单元 | 2 个(重置门、更新门) | 3 个(输入门、遗忘门、输出门) |
| 状态变量 | 仅 1 个隐藏状态 | 2 个(隐藏状态 |
| 计算效率 | 参数量少,训练更快 | 参数量多,训练较慢 |
| 适用场景 | 数据量较小、需要快速训练的任务 | 数据量较大、对长距离依赖要求更高的任务 |
2.6 GRU 的适用场景
GRU 擅长处理时序数据,典型应用包括:
- 自然语言处理(NLP):文本分类、机器翻译、情感分析、命名实体识别;
- 语音处理:语音识别、语音合成;
- 时间序列预测:股票价格预测、天气预测、设备故障预警;
- 视频分析:动作识别(将视频帧视为时序序列)。
3 总结
GRU 通过重置门和更新门动态控制信息的保留与更新,解决了传统 RNN 的长距离依赖问题,同时比 LSTM 结构更简单、计算效率更高。作为时序建模的核心工具之一,GRU 在 NLP、语音处理等领域被广泛应用,也是理解更复杂模型(如 Transformer)的基础。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献13条内容

所有评论(0)