RLVR的枷锁:深度分析强化学习为何难破基础模型局限
摘要:近期在大型推理模型方面的进展突出了“可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)”作为一种提升人工智能能力的有前景的方法,尤其是在解决复杂逻辑任务方面。然而,目前尚不清楚 RLVR 是否真正扩展了模型的推理边界,还是仅仅放大了基础模型已经知晓的高奖励输出,以提高精确度。本研究通过理论和实证调查,为 RLVR 的潜在限制提供了新的见解。首先,我们提出了一个新的理论视角:RLVR 受到基础模型支持的限制——无法采样初始概率为零的解决方案——并且作为一种保守的权重调整机制运行,这可能会限制完全原创解决方案的发现。我们还识别出了一种熵 - 奖励权衡:尽管 RLVR 可靠地提高了精确度,但它可能会逐渐缩小探索范围,甚至可能忽略那些正确但未得到充分代表的解决方案。广泛的实证实验验证了,尽管 RLVR 一致地提高了 pass@1(即前 1 名答案的通过率),但在更大的采样预算下,经验支持的收缩通常超过了经验支持的扩展,未能恢复基础模型之前能够访问到的正确答案。有趣的是,我们还观察到,尽管 RLVR 有时会增加单个标记(token)级别的熵——导致在每个生成步骤中出现更大的不确定性——但答案级别的熵却在下降,这表明这些看似更不确定的路径最终会收敛到一个更小的不同答案集合上。综合这些发现,揭示了 RLVR 在扩展推理范围方面的潜在限制。打破这种“隐形束缚”可能需要未来的算法创新,例如明确的探索机制,或者将概率质量引入未得到充分代表的解决方案区域的混合策略。
一、RLVR的辉煌与争议
论文题目:The Invisible Leash: Why RLVR May Not Escape Its Origin
论文地址:https://arxiv.org/pdf/2507.14843
近年来,大模型在复杂推理任务中取得突破性进展,其中强化学习与可验证奖励(RLVR) 技术功不可没。通过对预训练基础模型(通常经思维链微调)施加强化学习优化,RLVR能显著提升数学推理、代码生成等任务的准确率。以DeepSeek-R1和ProRL为代表的模型,在MATH、Minerva等基准测试中刷新纪录,看似成为解锁AI推理能力的"万能钥匙"。
但研究界始终存在一个尖锐争议:RLVR究竟是扩展了模型的推理边界,还是仅仅在强化基础模型已有的能力模式?
现有方法的三大痛点
- 性能悖论:多项研究发现RLVR模型在低采样预算(如pass@1)表现优异,但在高采样(k>1024)时pass@k得分反而低于基础模型
- 奖励信号可靠性:部分工作指出RLVR可能利用虚假奖励信号(如格式偏好)而非真正推理能力提升性能
- 泛化局限:在基础模型表现差的领域(如Reasoning Gym),RLVR的改进效果往往不稳定
斯坦福大学团队最新研究通过理论证明和实证分析,揭示了RLVR技术的支持保留特性——这层"隐形枷锁"使其难以真正突破基础模型的能力边界。
二、方法总览:RLVR的支持动态理论
RLVR本质是保守的概率重分配机制:它通过强化高奖励路径提升精度,但受限于基础模型的支持范围,导致经验支持收缩始终大于扩展,最终形成"高精度但窄覆盖"的性能曲线。
2.1 核心理论框架
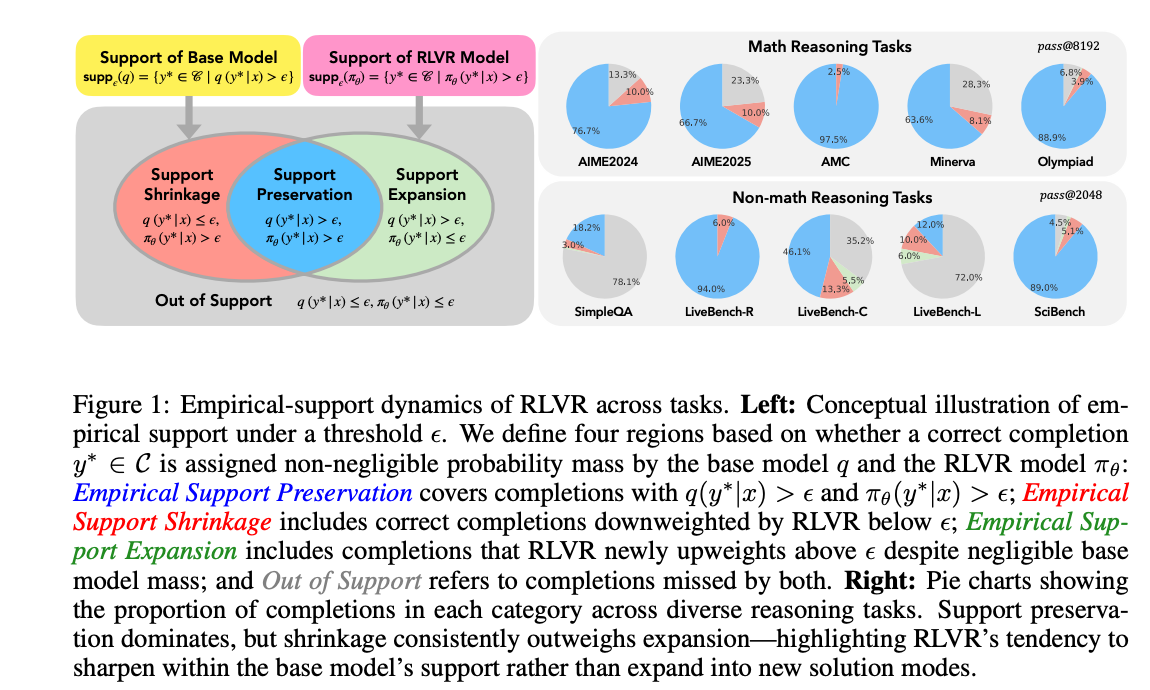
该框架定义了四种经验支持区域:
- 支持保留(蓝色):基础模型和RLVR模型均能生成的正确解(q(y*|x)>ε且πθ(y*|x)>ε)
- 支持收缩(红色):基础模型能解但RLVR丢失的解(q(y*|x)>ε但πθ(y*|x)≤ε)
- 支持扩展(绿色):仅RLVR能解的新解(q(y*|x)≤ε但πθ(y*|x)>ε)
- 超出支持:两者均无法解决的问题
右侧饼图显示跨任务的支持分布:在数学推理任务中,支持保留占比66.7%-97.5%,而收缩始终大于扩展,揭示RLVR倾向于在基础模型支持范围内"精雕细琢"而非探索新解空间。
2.2 关键结论
- 支持保留特性:RLVR本质是基础模型支持范围内的概率重分配,无法突破初始支持边界
- 精度-覆盖权衡:提升pass@1的代价是收缩经验支持,导致高采样预算下性能下降
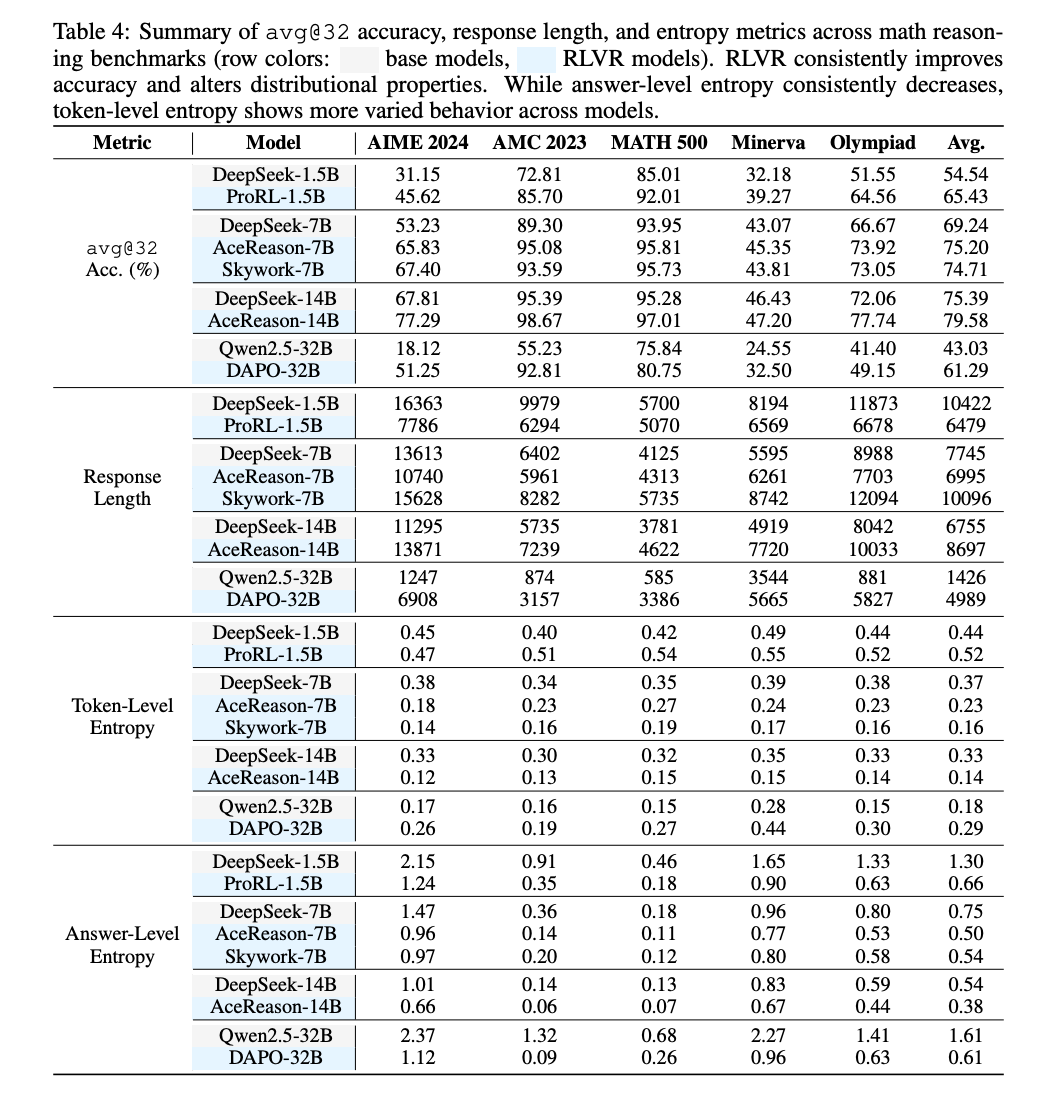
- 熵解耦现象:token级熵与答案级熵的分离表明,局部随机性不等同于全局探索能力
三、深度拆解:RLVR为何难以突破局限
3.1 支持保留定理:零概率解的永恒枷锁
理论核心:任何RLVR模型都无法生成基础模型概率为零的解。数学上可表述为:
supp(πθ(·|x)) ⊆ supp(q(·|x))这意味着如果基础模型对某个正确解分配零概率(如全新推理路径),RLVR永远无法发现它。就像小狗无法挣脱拴在树上的皮带,RLVR被牢牢限制在基础模型的初始支持范围内。
3.2 变分推断视角:最小化KL散度的保守更新
从变分推断角度看,RLVR优化本质是在满足奖励约束下,寻找与基础模型KL散度最小的分布:
π*(y|x) ∝ q(y|x)·exp(βR(x,y))这种更新策略倾向于最小化对基础分布的偏离,导致RLVR更可能"微调"而非"革新"基础模型的推理模式。实验显示,即使在KL-free极限下(β→∞),RLVR也只是对基础模型的正确解子集进行重归一化,而非探索新解。
3.3 熵-奖励权衡:精度提升的隐性代价
研究发现RLVR存在显著的熵-奖励权衡:
- 答案级熵下降:ProRL-1.5B在AIME2024的答案熵从2.15降至1.24,表明输出多样性显著降低
- token级熵上升:部分模型token熵增加(如从0.45→0.47),显示局部决策不确定性提高
- 响应长度缩短:平均响应长度从10422 tokens压缩至6479 tokens,推理过程更简洁但可能丢失关键路径
这种"局部随机化但全局收敛"的现象,导致RLVR模型看似在生成时更"犹豫",最终却只输出少数几种解,形成"局部探索而全局保守"的矛盾行为。
四、实验结果:数据揭示的三大发现
4.1 支持收缩普遍大于扩展
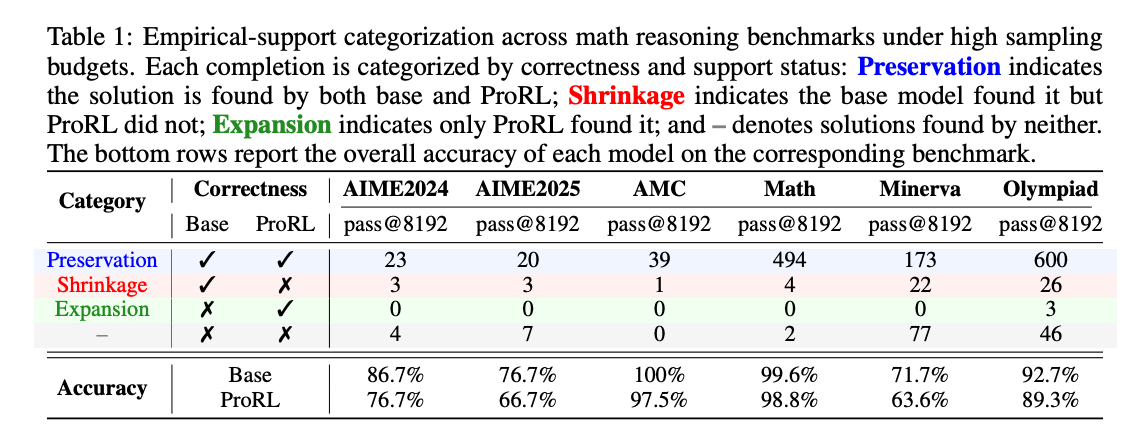
在高采样预算(k=8192)下的数学推理任务中:
- 支持保留占绝对主导:Olympiad任务中600个解被双方共同发现
- 收缩远大于扩展:Minerva任务中RLVR丢失22个基础模型能解的问题,却仅新增0个
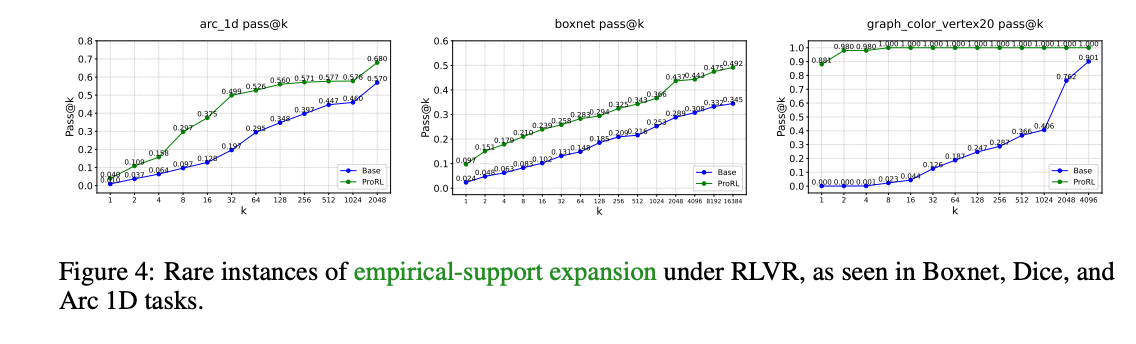
- 扩展案例罕见:仅在Olympiad任务中发现3个扩展解,且均来自基础模型的长尾分布
4.2 Pass@k曲线的"交叉现象"
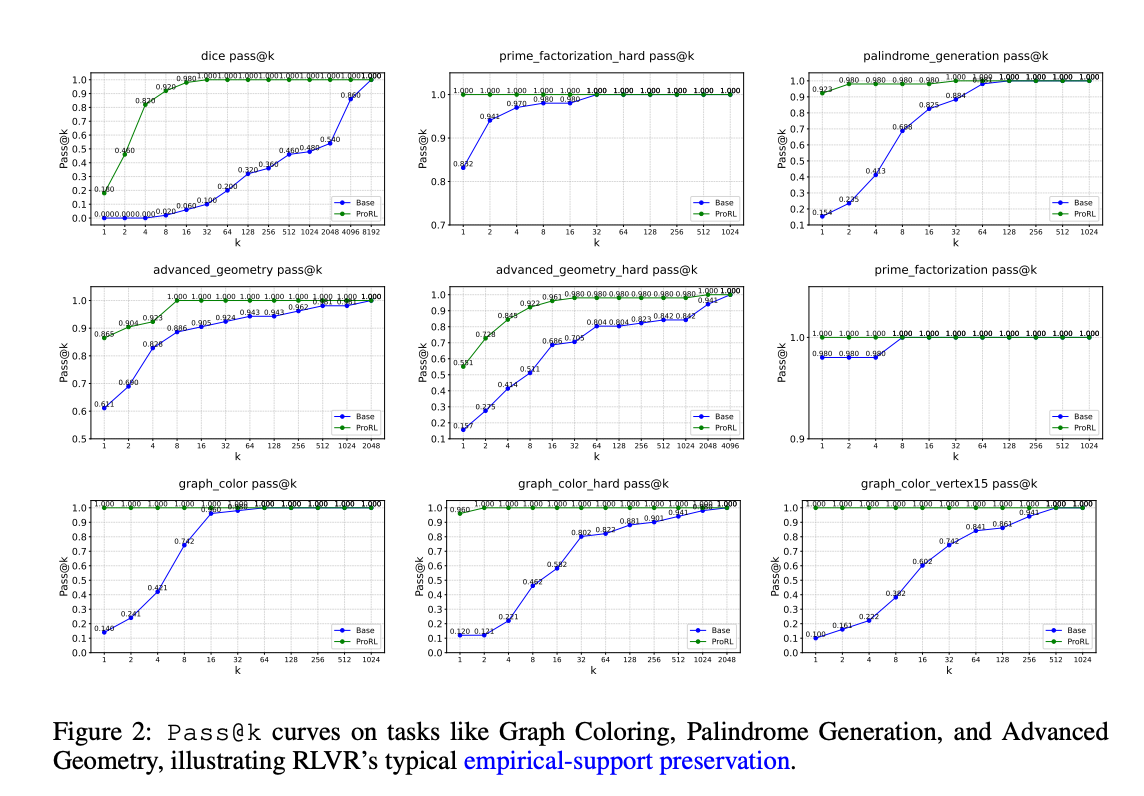
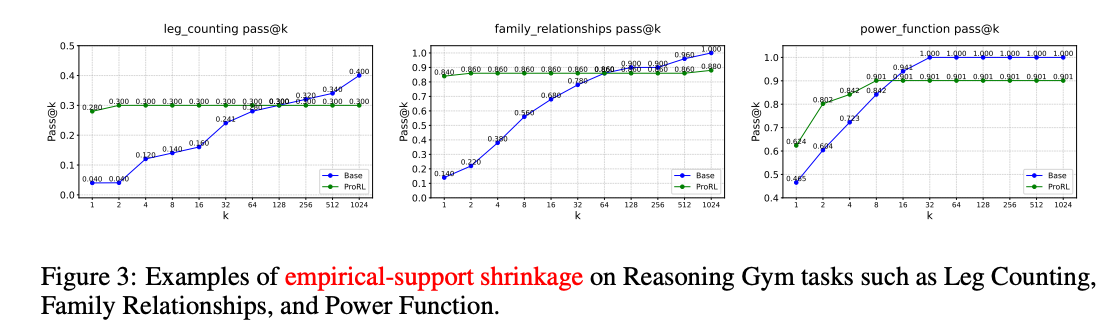
三种典型曲线模式:
- 标准保留型(graph_color):RLVR快速收敛至高精度,但高k时被基础模型超越
- 显著收缩型(leg_counting):RLVR在k=1024时pass@k比基础模型低15%
- 罕见扩展型(arc_1d):仅在基础模型表现极差的任务中,RLVR实现持续扩展
4.3 困惑度分析验证支持限制
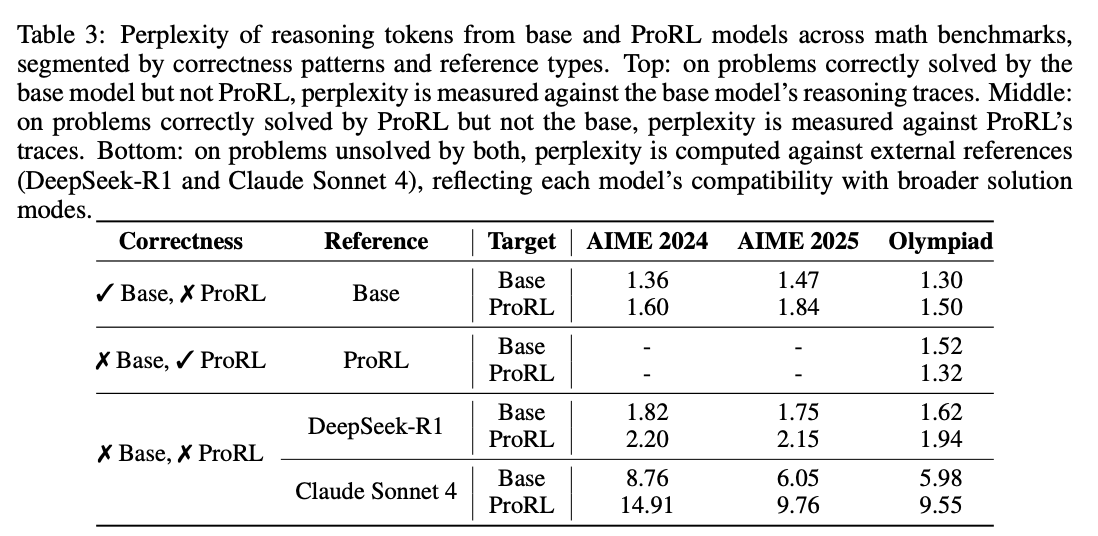
当使用外部参考解(DeepSeek-R1和Claude Sonnet 4)评估时:
- RLVR模型的困惑度显著高于基础模型(如Claude参考下从5.98→9.55)
- 在扩展案例中,RLVR的困惑度仅略高于基础模型,表明这些"新解"实际来自基础模型的长尾分布
五、未来工作:打破枷锁的可能路径
5.1 改进方向
- 显式探索机制:引入专门的探索分布πe,通过混合策略(πθ'=(1-γ)πθ+γπe)注入新解
- 支持扩展训练:使用生成式模型(如扩散模型)预先生成基础模型难以发现的解
- 动态KL约束:随训练进程调整KL散度预算,平衡精度与探索
5.2 个人观点
- 多模型协作:结合RLVR的高精度与基础模型的广覆盖,构建动态集成系统
- 分层奖励设计:不仅奖励最终答案,还对中间推理步骤给予探索奖励
- 领域自适应:在基础模型表现差的领域(如抽象推理),采用无监督预训练+RLVR的两阶段方案

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献5条内容

所有评论(0)