Python----大模型(RAG 的智能评估-Ragas)
一、Ragas的介绍
RAGAs (Retrieval-Augmented Generation Assessment) 它是一个框架,它可以帮助我们来快速评估RAG系统的性能,为了评估 RAG 系统,RAGAs 需要以下信息:
question:用户输入的问题。
answer:从 RAG 系统生成的答案(由LLM给出)。
contexts:根据用户的问题从外部知识源检索的上下文即与问题相关的文档。
reference: 人类提供的基于问题的真实(正确)答案ground_truths。 这是唯一的需要人类提供的信息。
安装:
pip install ragas==0.2.6
二、Context Precision 上下文精度
上下文精度是一个指标,用于衡量,它计算为上下文中每个块的 precision@k 的平均值。Precision@k 是等级 k 的相关块数与等级 k 的 块总数的比率。
模块包导入
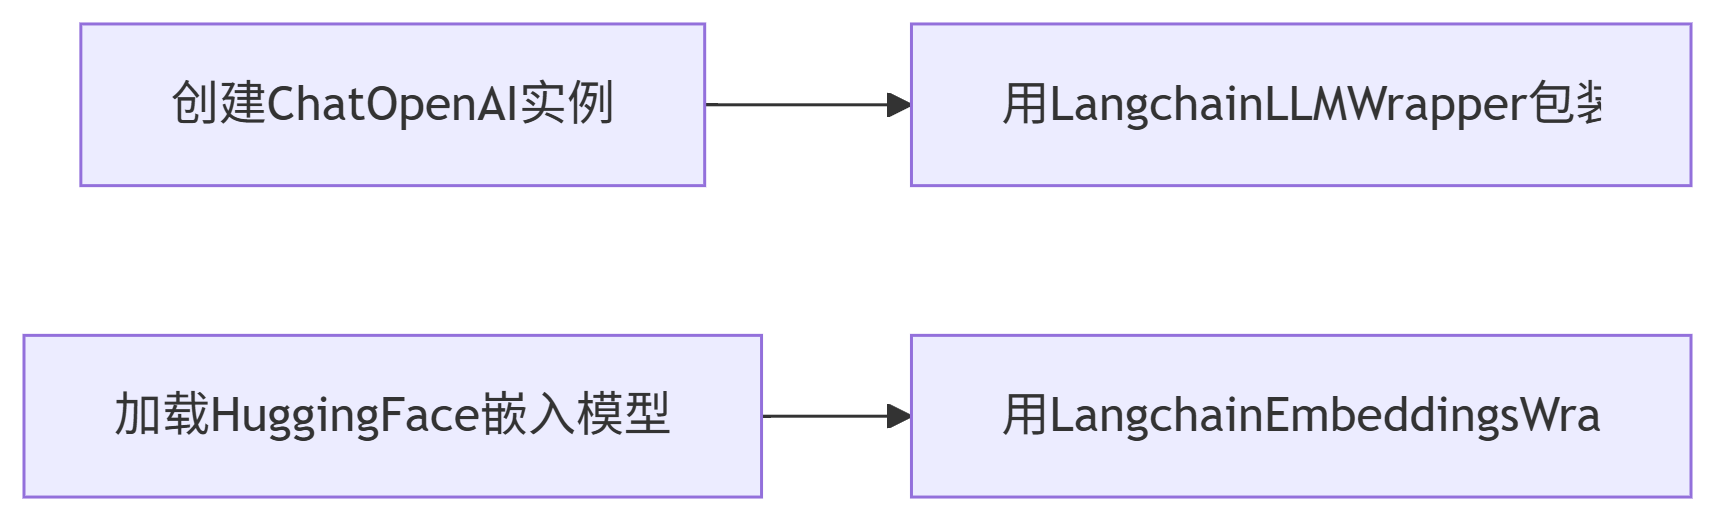
from langchain_openai import ChatOpenAI  # LangChain的OpenAI聊天模型接口
from ragas.llms import LangchainLLMWrapper  # Ragas的LLM包装器,用于兼容LangChain模型
from langchain_huggingface import HuggingFaceEmbeddings  # HuggingFace嵌入模型
from ragas.embeddings import LangchainEmbeddingsWrapper  # Ragas的嵌入模型包装器
from ragas.metrics._context_precision import LLMContextPrecisionWithReference  # 上下文精确度评估指标
from ragas import SingleTurnSample  # 单轮对话样本容器
| 模块/组件 | 功能说明 | 关键参数 |
|---|---|---|
| ChatOpenAI | LangChain的OpenAI兼容接口 | base_url指定本地模型API端点 |
| LangchainLLMWrapper | 将LangChain模型适配为Ragas可用的格式 | 必须包装后才能用于Ragas评估 |
| HuggingFaceEmbeddings | 加载HuggingFace文本嵌入模型 | model_name指定中文优化模型路径 |
| LangchainEmbeddingsWrapper | 嵌入模型适配器 | 使LangChain模型兼容Ragas框架 |
| LLMContextPrecisionWithReference | 评估检索内容与回答的相关性 | 考虑: 1. 回答准确性 2. 上下文支持度 |
| SingleTurnSample | 单轮对话数据容器 | 包含: - 用户问题 - LLM回答 - 标准答案 - 检索上下文 |
模型初始化阶段
# 初始化语言模型(通过LangChain接口)
chat_model = LangchainLLMWrapper(ChatOpenAI(
    api_key='EMPTY',  # 使用本地API时密钥可置空
    base_url='http://127.0.0.1:10222/v1',  # 本地模型API地址
    model='Qwen2.5-7B-Instruct'  # 使用的模型名称(通义千问7B指令版)
))

# 初始化嵌入模型(通过LangChain接口)
embedding = LangchainEmbeddingsWrapper(
    HuggingFaceEmbeddings(
        model_name='/home/AI_big_model/models/AI-ModelScope/bge-large-zh-v1___5'  # 中文嵌入模型路径
    )
)
评估器配置阶段
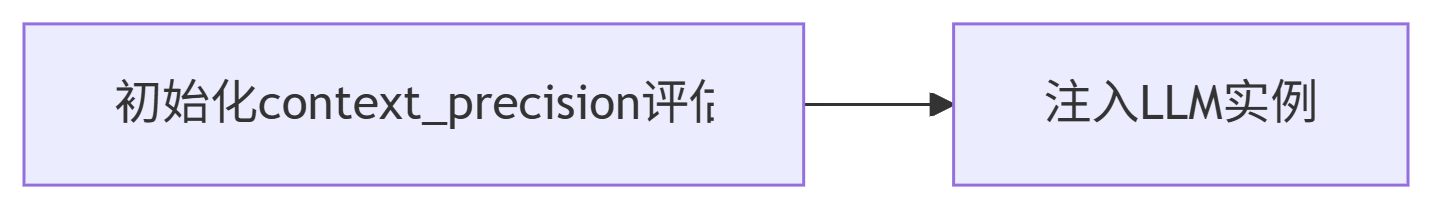
# 创建上下文精确度评估器(需要传入LLM实例)
context_precision = LLMContextPrecisionWithReference(llm=chat_model)
样本评估阶段
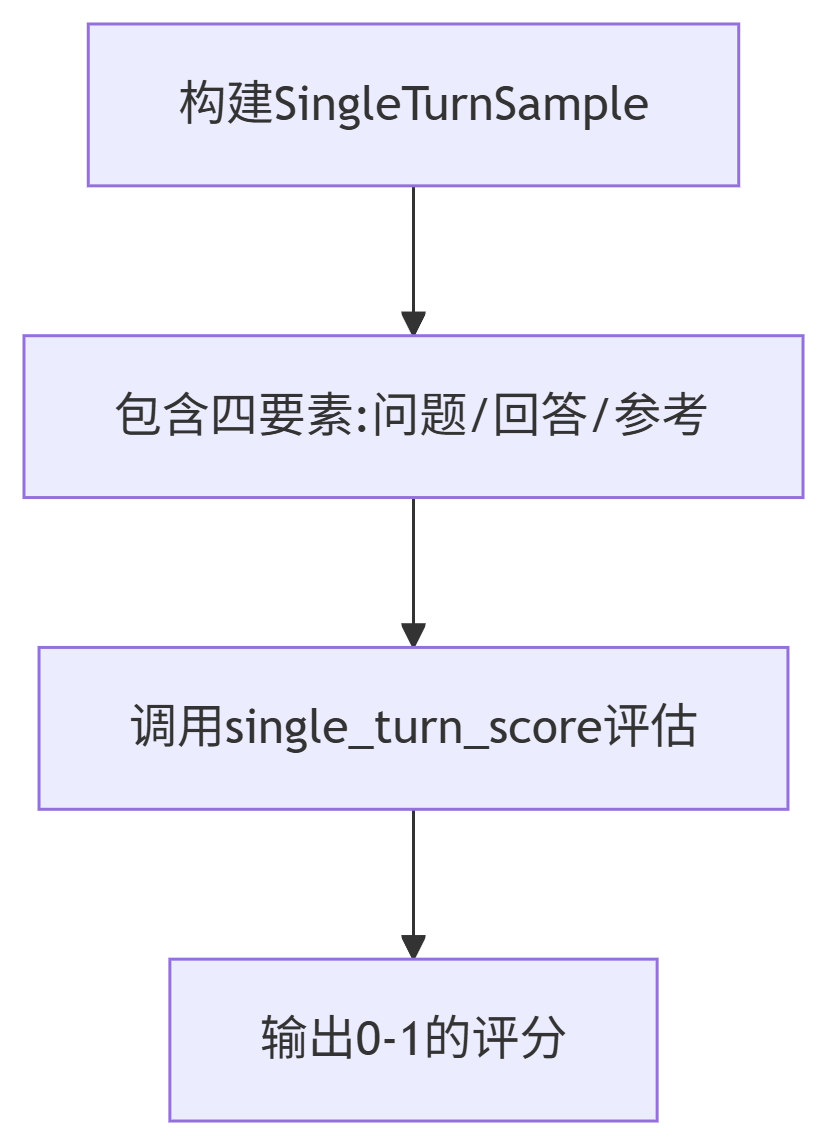
# 构建测试样本(模拟单轮问答场景)
sample = SingleTurnSample(
    user_input="故宫位于哪里?",  # 用户的提问(模拟输入)
    response="故宫在北京。",  # LLM生成的回答(待评估)
    reference="故宫位于北京。",  # 标准答案(人工标注的参考答案)
    retrieved_contexts=[
        "北京是中国的首都",  # 检索到的上下文1(知识库返回)
        "故宫位于北京"  # 检索到的上下文2(知识库返回)
    ]
)

# 执行评估并打印结果(0-1之间的分数,越高表示精确度越好)
print(context_precision.single_turn_score(sample))
二、状态转移矩阵
2.1、什么是状态转移矩阵
状态转移矩阵(State Transition Matrix)常见于马尔可夫链、自然语言处理(NLP)等领域。它描述了系统从一个状态转移到另一个 状态的概率或代价。
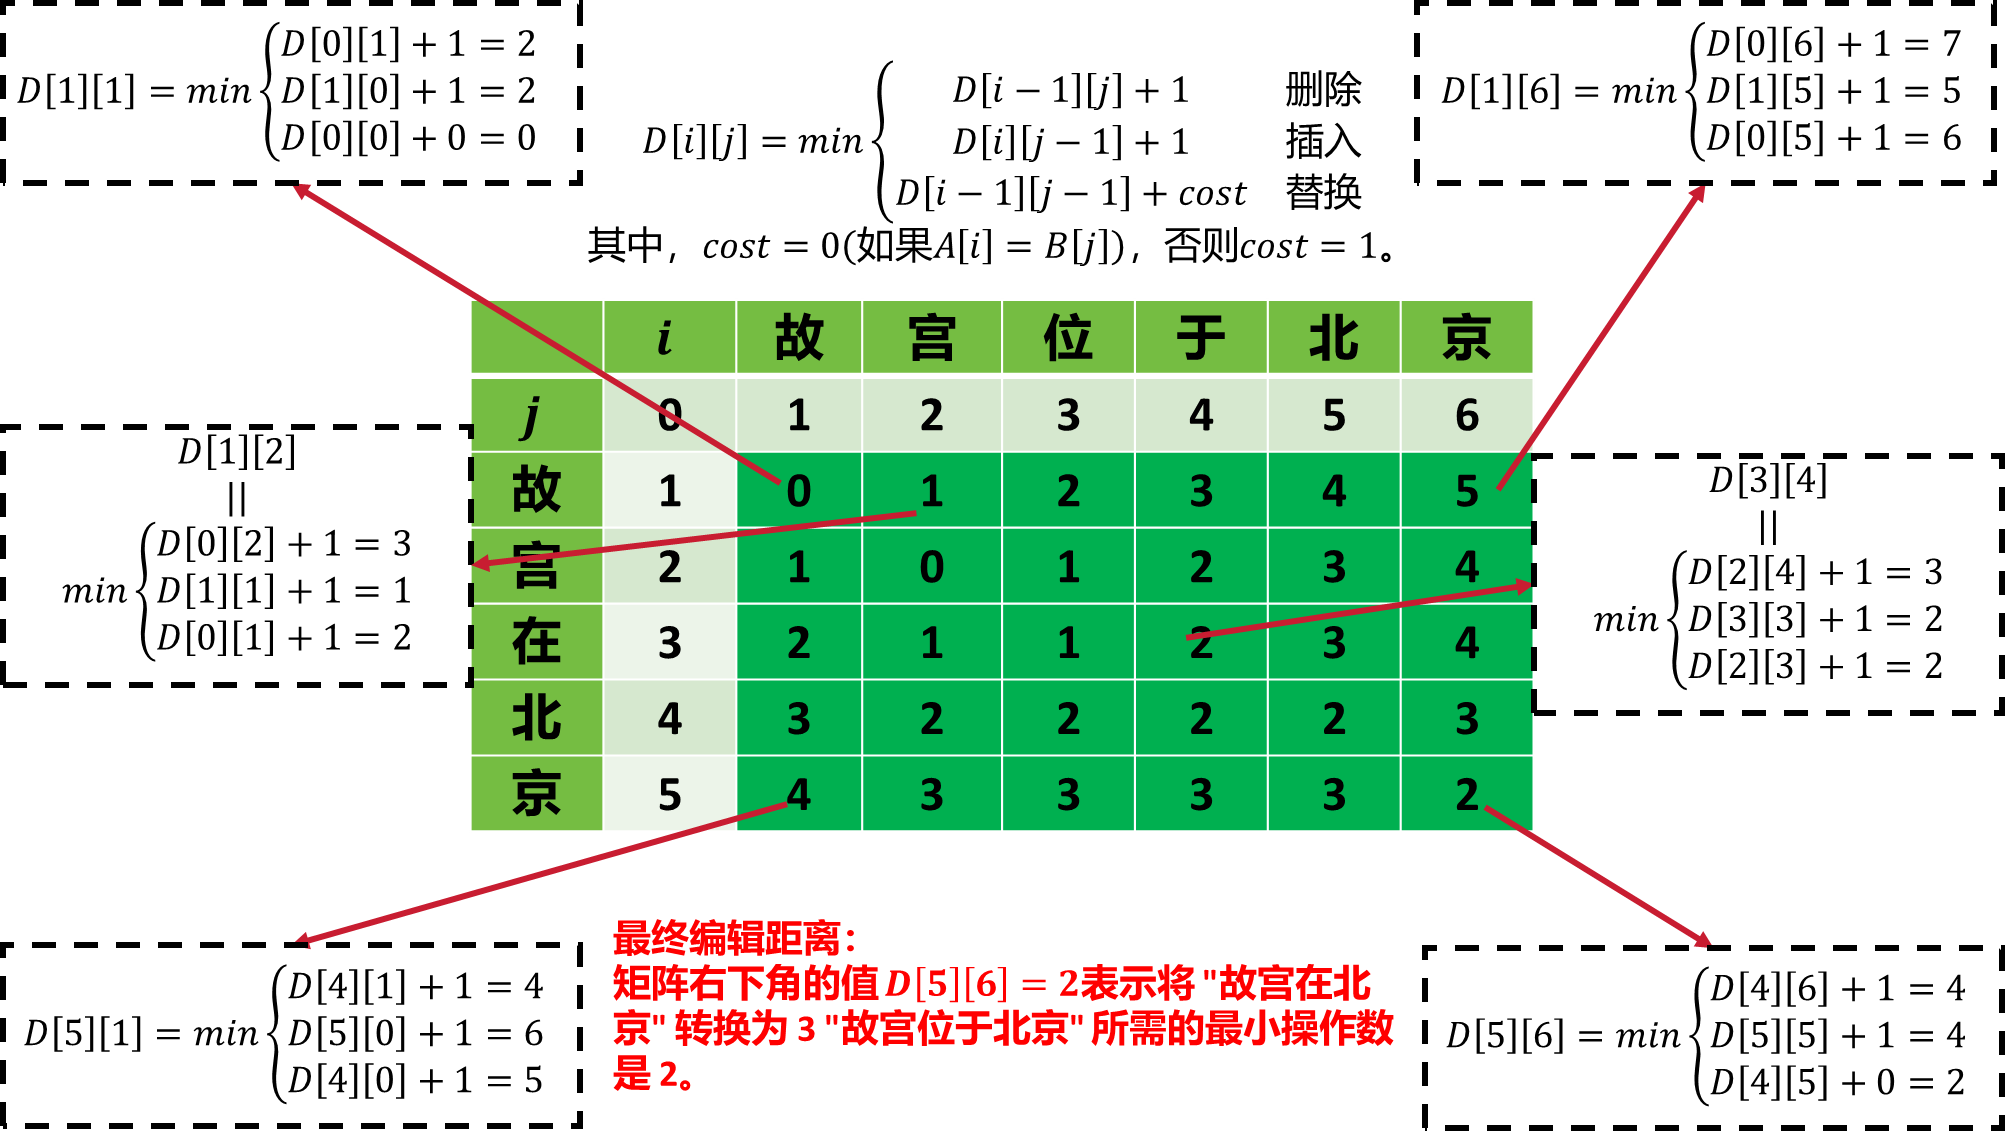
2.2、编辑距离(Levenshtein距离)
编辑距离是指将一个字符串转换为另一个字符串所需的最少编辑操作次数。编辑操作包括:
1. 插入一个字符(Insertion)
2. 删除一个字符(Deletion)
3. 替换一个字符(Substitution)
2.3、状态转移矩阵与编辑距离的关系
当计算两个字符串的编辑距离时,可以构建一个动态规划(DP)表格,类似于状态转移矩阵。矩阵中的每个元素 表示将第一个 字符串的前 个字符转换为第二个字符串的前 个字符所需的最少编辑次数。
2.4、计算
三、Non LLM Based Context Precision 不基于大模型的上下文精度(传统方法-编辑距离)
编辑距离(Edit Distance),也称为Levenshtein距离,是由俄罗斯科学家 Vladimir Levenshtein 在 1965 年提出的。它衡量的是将一 个字符串转换为另一个字符串所需要的最少单字符编辑操作次数。这些编辑操作包括插入(insertion)、删除(deletion)和替换。
strA = "故宫在北京"
strB = "故宫位于北京"

def edit_distance(strA:str, strB:str) -> int:
    m, n = len(strA) + 1, len(strB) + 1
    dp = [[0] * n for _ in range(m)]
    # print(dp)

    # 初始化dp数组
    for i in range(m):
        dp[i][0] = i
    for j in range(n):
        dp[0][j] = j
    # print(dp)
    for i in range(1, m):
        for j in range(1, n):
            if strA[i-1] == strB[j-1]:
                dp[i][j] = dp[i-1][j-1]
            else:
                dp[i][j] = min(dp[i-1][j-1], dp[i-1][j], dp[i][j-1]) + 1
    return dp[-1][-1]

distance = edit_distance(strA, strB)
print(distance)
print(distance / max(len(strA), len(strB)))


# 使用库函数:
from rapidfuzz import distance
print(distance.Levenshtein.normalized_distance(strA, strB))
四、Context Recall 上下文召回
注意:
召回(Recall):逐句检查答案内容的覆盖情况,确保答案中的所有信息都能从上下文中找到来源。
精确度(Precision):整体检查答案与上下文的关联性,确认答案是否依赖上下文提供的信息。
from langchain_openai import ChatOpenAI
from ragas.llms import LangchainLLMWrapper

chat_model = LangchainLLMWrapper(ChatOpenAI(
    api_key='EMPTY',
    base_url='http://127.0.0.1:10222/v1',
    model='Qwen2.5-7B-Instruct'
))

# 计算上下文召回
from ragas.metrics import LLMContextRecall
context_recall = LLMContextRecall(llm=chat_model)

from ragas import SingleTurnSample
sample = SingleTurnSample(
    user_input="故宫位于哪里?",  # 用户的提问
    response="故宫在北京。",  # LLM的回答
    reference="故宫位于北京。",  # 真实答案
    retrieved_contexts=["北京是中国的首都", "故宫位于北京"]  # 知识库相似度提取出的内容
)

print(context_recall.single_turn_score(sample))
五、Response Relevancy 响应相关性
Response Relevancy指标侧重于评估生成的答案与给定问题的相关性。对于不完整或包含冗余信息的答案,分数较低,分数越高表示 相关性越高。 注意响应相关性评估并不考虑事实,而是对答案缺乏完整性或包含冗余细节的情况进行惩罚。为了计算此分数,系统会提示 LLM 多次 为生成的答案生成合适的问题,并计算这些生成的问题与原始问题之间的平均余弦相似度。 其思想就是,如果答案能够很好的解决问题,那么通过答案生成的问题应该和原始问题差不多。
from langchain_openai import ChatOpenAI
from ragas.llms import LangchainLLMWrapper

chat_model = LangchainLLMWrapper(ChatOpenAI(
    api_key='EMPTY',
    base_url='http://127.0.0.1:10222/v1',
    model='Qwen2.5-7B-Instruct'
))

from ragas.embeddings import LangchainEmbeddingsWrapper
from langchain_huggingface import HuggingFaceEmbeddings
embedding = LangchainEmbeddingsWrapper(HuggingFaceEmbeddings(model_name="models/AI-ModelScope/bge-large-zh-v1___5"))

# 计算响应相关性
from ragas import SingleTurnSample
from ragas.metrics import ResponseRelevancy

sample = SingleTurnSample(
    user_input="故宫位于哪里?",
    response="故宫在北京"
)
scorer = ResponseRelevancy(llm=chat_model, embeddings=embedding)
print(scorer.single_turn_score(sample))
六、Faithfulness 忠诚度
Faithfulness指标衡量生成的答案与给定上下文的事实一致性。它是根据答案和检索到的上下文计算得出的。答案缩放到 (0,1) 范 围。越高越好。 如果答案中提出的所有声明都可以从给定的上下文中推断出来,则生成的答案被认为是忠实的。要计算此值,首先从生成的答案中确定 一组陈述。
from langchain_openai import ChatOpenAI
from ragas.llms import LangchainLLMWrapper

chat_model = LangchainLLMWrapper(ChatOpenAI(
    api_key='EMPTY',
    base_url='http://127.0.0.1:10222/v1',
    model='Qwen2.5-7B-Instruct'
))


# 计算忠诚度
from ragas import SingleTurnSample
from ragas.metrics import Faithfulness

sample = SingleTurnSample(
    user_input="爱因斯坦出生于何时何地?",
    response="爱因斯坦于 1879 年 3 月 14 日出生于德国。",
    retrieved_contexts=["阿尔伯特·爱因斯坦(Albert Einstein,生于 1879 年 3 月 14 日)是一位出生于德国的理论物理学家,被广泛认为是有史以来最伟大、最有影响力的科学家之一"],
)

scorer = Faithfulness(llm=chat_model)
print(scorer.single_turn_score(sample))
七、使用Ragas评估RAG系统
| 模块名称 | 关键组件 | 核心功能 | 技术要点 |
|---|---|---|---|
| 模型初始化 | ChatOpenAI ×2 | • 问答生成模型 • 评估专用模型 | • 本地API端点配置 • 双模型隔离 |
| 知识库构建 | TextLoader FAISS | • 文档加载 • 向量检索系统 | • 中文文本分块策略 • 相似度搜索优化 |
| RAG管道 | ChatPromptTemplate RunnablePassthrough | • 提示工程 • 流程编排 | • 多消息模板组合 • LCEL链式语法 |
| 评估准备 | pandas Dataset | • 测试数据加载 • 格式转换 | • 自动生成上下文 • HuggingFace数据集兼容 |
| 质量评估 | ragas.evaluate | • 四项核心指标计算 • 量化评估 | • 基于LLM的元评估 • 嵌入模型辅助 |
模型初始化模块
# 初始化对话模型(用于实际问答生成)
chat_model = ChatOpenAI(
    openai_api_key="EMPTY",  # 本地部署时API密钥可置空
    base_url="http://192.168.103.173:10260/v1",  # 本地模型API地址
    model="Qwen2___5-7B-Instruct"  # 使用的模型名称(通义千问7B指令版)
)

# 初始化评估模型(用于RAGAS评估)
eval_model = ChatOpenAI(
    openai_api_key="EMPTY",
    base_url="http://192.168.103.173:10260/v1",  # 可与对话模型使用相同端点
    model="Qwen2___5-7B-Instruct"  # 评估建议使用与对话相同的模型
)
知识库构建模块
from langchain_huggingface import HuggingFaceEmbeddings

# 初始化嵌入模型(用于文本向量化)
embedding = HuggingFaceEmbeddings(
    model_name="models/AI-ModelScope/bge-large-zh-v1___5"  # 中文优化嵌入模型
)

# 文档加载与处理
from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

# 加载文本文件(知识库源文件)
loader = TextLoader("黑悟空.txt", encoding="UTF-8")  # 指定UTF-8编码读取中文
docs = loader.load()  # 返回Document对象列表

# 文本分块处理(适应模型上下文长度)
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=200,  # 每个文本块的最大字符数
    chunk_overlap=20  # 块之间的重叠字符数(保持上下文连贯)
)
chunks = text_splitter.split_documents(docs)  # 分割后的文档块

# 向量存储与检索器构建
from langchain_community.vectorstores import FAISS

# 创建FAISS向量数据库
vs = FAISS.from_documents(
    chunks,  # 分割后的文档
    embedding  # 使用的嵌入模型
)

# 创建检索器(设置相似度搜索参数)
retriever = vs.as_retriever(
    search_kwargs={"k": 3}  # 返回最相关的3个文档块
)

RAG管道构建模块
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

# 定义系统提示模板
system_prompt = """根据以下已知信息回答用户问题,
已知信息:{context}
"""

# 构建完整提示模板
prompt = ChatPromptTemplate.from_messages([
    ("system", system_prompt),  # 系统角色设定
    ("user", "问题:{question}")  # 用户问题模板
])

# 初始化输出解析器(将模型输出转为字符串)
output_parser = StrOutputParser()

# 构建RAG处理链
rag_chain = (
        {"context": retriever, "question": RunnablePassthrough()}  # 输入处理
        | prompt  # 提示模板应用
        | chat_model  # 调用语言模型
        | output_parser  # 输出标准化
)
评估准备模块
import pandas as pd

# 加载评估数据集(包含问题-标准答案对)
dataset = pd.read_csv("黑悟空.csv")  # 假设包含"问题"和"回答"两列

# 提取评估数据
questions = dataset["问题"].to_list()  # 问题列表
ground_truths = dataset["回答"].to_list()  # 标准答案列表

# 生成测试数据
answers = []  # 存储模型回答
contexts = []  # 存储检索到的上下文

for question in questions:
    # 获取模型回答
    answers.append(rag_chain.invoke(question))

    # 获取检索上下文(用于评估)
    retrieved_docs = retriever.get_relevant_documents(question)
    contexts.append([doc.page_content for doc in retrieved_docs])

# 构建RAGAS评估数据集
from datasets import Dataset

data = {
    "question": questions,  # 问题列表
    "answer": answers,  # 模型生成答案
    "contexts": contexts,  # 检索到的上下文
    "reference": ground_truths  # 人工标注的标准答案
}

dataset = Dataset.from_dict(data)  # 转换为HuggingFace数据集格式
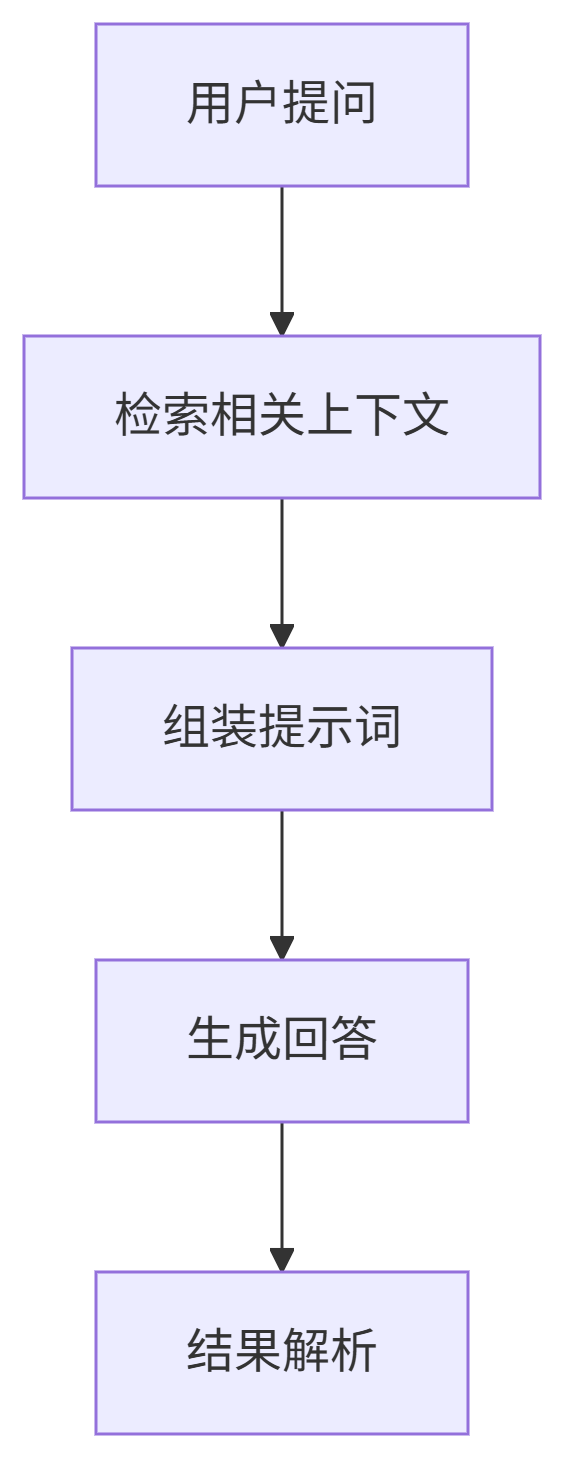
RAG评估模块
from ragas import evaluate
from ragas.metrics import (
    faithfulness,  # 答案忠实度(是否基于上下文)
    answer_relevancy,  # 答案相关性(与问题匹配度)
    context_precision,  # 上下文精确度(检索质量)
    context_recall  # 上下文召回率(覆盖关键信息)
)

# 执行全面评估
result = evaluate(
    dataset=dataset,  # 测试数据集
    metrics=[faithfulness, answer_relevancy, context_precision, context_recall],
    llm=eval_model,  # 用于评估的LLM
    embeddings=embedding  # 用于相似度计算的嵌入模型
)
| 指标名称 | 计算方式 | 理想值 | 优化方向 |
|---|---|---|---|
| Faithfulness | 判断回答是否严格基于上下文 | 接近1.0 | • 改进提示词约束 • 增强检索相关性 |
| Answer Relevancy | 回答与问题的语义相关度 | >0.9 | • 优化问题理解 • 过滤无关上下文 |
| Context Precision | 检索结果中有效内容占比 | >0.8 | • 调整chunk_size • 改进嵌入模型 |
| Context Recall | 标准答案在上下文的覆盖率 | >0.75 | • 扩大检索范围 • 优化知识库结构 |

结果展示模块
# 配置Pandas显示选项
pd.set_option("display.max_columns", None)  # 显示所有列
pd.set_option("display.max_rows", None)  # 显示所有行
pd.set_option("display.max_colwidth", None)  # 完整显示单元格内容

# 转换为DataFrame并打印
df = result.to_pandas()
print(df)
              user_input                                 retrieved_contexts                                           response  ... answer_relevancy  context_precision  context_recall
0      黑熊精最初是如何与金池长老相识的?  [金池一路坐到观音禅院的长老(毕竟学过长生术,活的最久),受人顶礼膜拜,欲望也随之膨胀。\n...  黑熊精最初给了金池长老一些金银财宝,并教给他一些长生的法门,因此觉得这个小和尚蛮有趣,从而与...  ...         0.853627           0.333333             1.0
1       凌虚子和白衣秀士分别是什么妖怪?  [凌虚子手下有个小狼妖,想修习佛教。凌虚子是个心地善良的妖怪,有心成全他,就和黑熊精提,黑熊...                                    凌虚子是狼妖,白衣秀士是蛇妖。  ...         0.938602           0.583333             1.0
2     广谋和广智分别是如何进入观音禅院的?  [凌虚子手下有个小狼妖,想修习佛教。凌虚子是个心地善良的妖怪,有心成全他,就和黑熊精提,黑熊...  广谋和广智进入观音禅院的方式不同:\n\n- 广谋是由凌虚子介绍到观音禅院的。凌虚子手下有个...  ...         0.979287           1.000000             1.0
3         观音禅院被烧毁的原因是什么?  [可是隔墙有耳,他们的计谋被孙悟空听见了。孙悟空将计就计,借了防火罩护住唐僧,又添了把风把观...              观音禅院被烧毁的原因是金池长老和广谋、广智想要杀害唐僧,所以放火烧了禅院。  ...         0.972230           1.000000             1.0
4           黑熊精在取经后做了什么?  [西天取经后,序章故事发生,观音菩萨派黑熊精参与了围剿孙悟空。其实黑熊精不想去,反而善财童子...  取经后,观音菩萨派黑熊精参与了围剿孙悟空。黑熊精摘掉了金箍咒,得到了悟空的六根之一,回到了黑...  ...         0.829615           1.000000             1.0
5  黑熊精尝试通过哪些方式来统一黑风山的妖怪?  [这时的黑风山已有百年的时间群龙无首,黑熊精知道光靠蛮力和吸引力很难统合这些妖怪,于是做了一...  黑熊精尝试通过以下方式来统一黑风山的妖怪:\n\n1. 用南海学来的法术复活了凌虚子,但这个...  ...         0.911906           1.000000             1.0
6          黑风山土地学到了什么技能?  [黑熊精对这些事有种无力感,于是重建观音禅院,想用复活凌虚子的法术复活金池长老,以解寂寞。没...                               黑风山土地学到了定身法和聚形散气等技能。  ...         0.990835           1.000000             1.0
7          老道士为什么教授土地法术?  [土地问你为什么教我这个?老道士说,将来会有一个天命人路过此地,我不方便见他,请你代我把这两...         老道士将来会有一个天命人路过此地,他不方便见天命人,请土地代他把这两招传授给天命人。  ...         0.715526           1.000000             1.0
8      在金池长老死后,他的魂魄变成了什么  [黑熊精对这些事有种无力感,于是重建观音禅院,想用复活凌虚子的法术复活金池长老,以解寂寞。没...         在金池长老死后,他的魂魄复活到了他生前藏着的财物上,变成了一个精神不正常的大头怪物。  ...         0.731164           1.000000             1.0
9        老道士在离开时掉落了什么物品?  [土地问你为什么教我这个?老道士说,将来会有一个天命人路过此地,我不方便见他,请你代我把这两...                                   老道士在离开时掉下了一片菩提叶。  ...         0.845799           1.000000             1.0

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 17
 0
- 0


 已为社区贡献10条内容

所有评论(0)