突破领域壁垒:OWL框架如何重塑多智能体系统的通用性与效率
论文名称:OWL: Optimized Workforce Learning for General Multi-Agent Assistance in Real-World Task Automation
论文地址:https://arxiv.org/pdf/2505.23885
在人工智能快速发展的今天,基于大型语言模型(LLM)的多智能体系统正成为自动化复杂现实任务的核心力量。然而,现有系统往往局限于特定领域,跨领域迁移时需要彻底重构架构并重新训练所有组件,这一痛点严重制约了AI技术的规模化应用。来自香港大学、CAMEL-AI等机构的研究团队提出的WORKFORCE框架与OWL训练方法,通过模块化设计与创新训练策略,为解决这一难题提供了突破性方案。本文将深入解析这一研究成果,探讨其如何推动通用人工智能助手的发展。
一、多智能体系统的困境:领域壁垒与效率瓶颈
近年来,大型语言模型已从单纯的文本预测工具进化为具备规划、工具使用和多步推理能力的自主智能体。多智能体系统(MAS)通过将任务分配给专业化智能体协作完成,进一步提升了复杂任务处理能力。然而,当前多智能体系统的发展面临着两大核心挑战:
-
领域特异性限制跨领域迁移
现有系统设计往往针对特定领域优化,例如MetaGPT依赖软件工程领域的标准化操作流程,难以扩展到医疗、金融等其他领域。将系统部署到新领域时,需要重新设计整个架构,成本极高。 -
全组件重训练导致效率低下
现有方法(如MALT)通常采用固定的"生成器-验证器-优化器" pipeline,迁移到新领域时需重新训练所有组件。这种"牵一发而动全身"的模式严重降低了系统灵活性,增加了计算资源消耗。
这些局限性凸显了对通用化、模块化多智能体架构的迫切需求——能够通过最小化的重训练和重构,快速适应多样化领域。
二、WORKFORCE框架:模块化架构实现跨领域灵活迁移
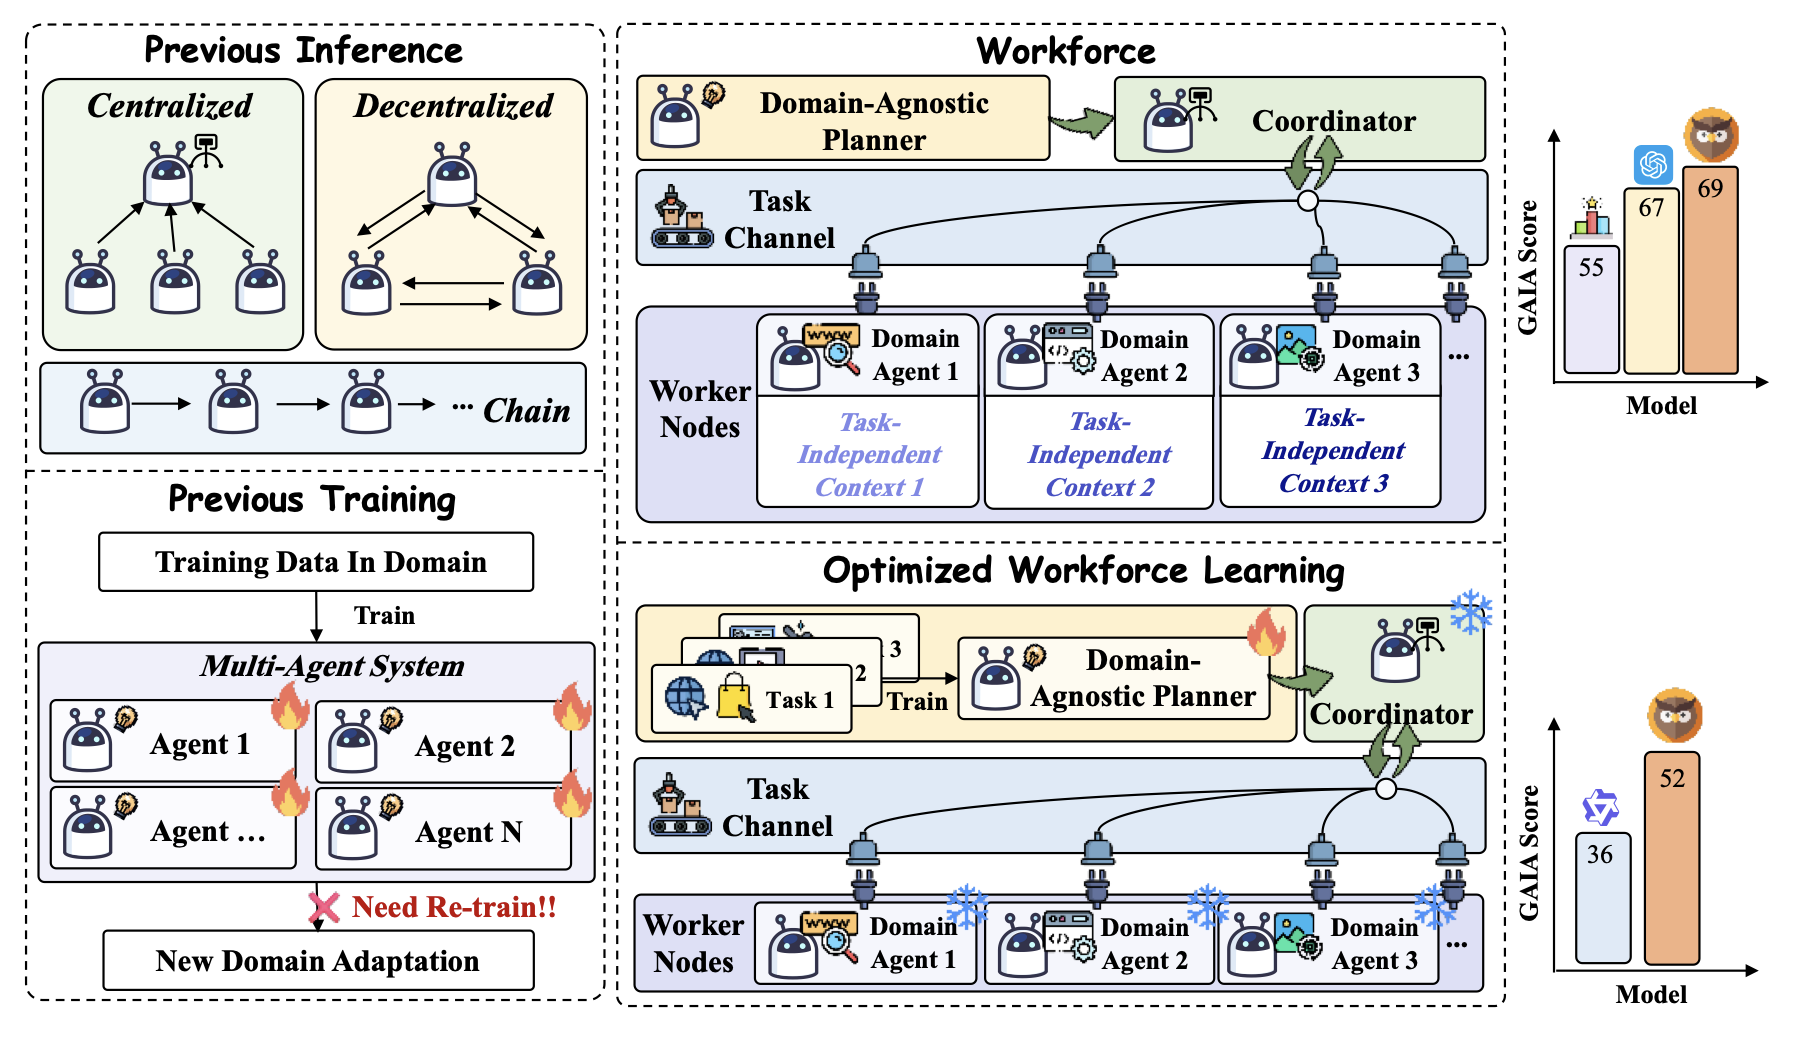
研究团队提出的WORKFORCE框架通过分层设计实现了战略规划与领域特定执行的解耦,其核心创新在于将多智能体系统分解为三个各司其职又有机协作的组件:
1. 领域无关的规划器(Planner)
作为系统的"大脑",Planner负责将高层目标分解为抽象子任务,不依赖具体领域知识。例如,在处理"分析PDF中符合特定条件的求职者"这一任务时,Planner会将其分解为"提取ZIP文件内容"、“识别职位要求”、"编写代码分析数据"等子任务,而无需了解PDF处理或代码执行的细节。
2. 协调器(Coordinator)
作为"调度中心",Coordinator管理子任务分配、依赖关系和中间结果整合。它会根据Worker的能力注册表,将子任务分配给最合适的专业Worker,并跟踪任务进度。例如,将网页搜索任务分配给Web Agent,将文档处理任务分配给Document Processing Agent。
3. 领域特定的工作节点(Workers)
作为"执行团队",Workers是具备领域专长和工具调用能力的专业化智能体。研究团队为GAIA基准测试配置了三类核心Worker:
- Web Agent:负责网页搜索、内容提取和浏览器模拟;
- Document Processing Agent:处理文档和多模态数据(文本、图像、音频等);
- Reasoning/Coding Agent:处理逻辑推理和代码执行任务。
这种模块化设计的优势在于**"即插即用"的扩展性**:适配新领域时,无需修改Planner和Coordinator,仅需添加或替换相应的Worker节点。例如,扩展到金融领域时,可新增具备股市数据分析工具的Financial Worker。
三、创新机制:通信、任务流与动态重规划
WORKFORCE框架通过精心设计的机制确保各组件高效协作:
1. 集中式通信机制
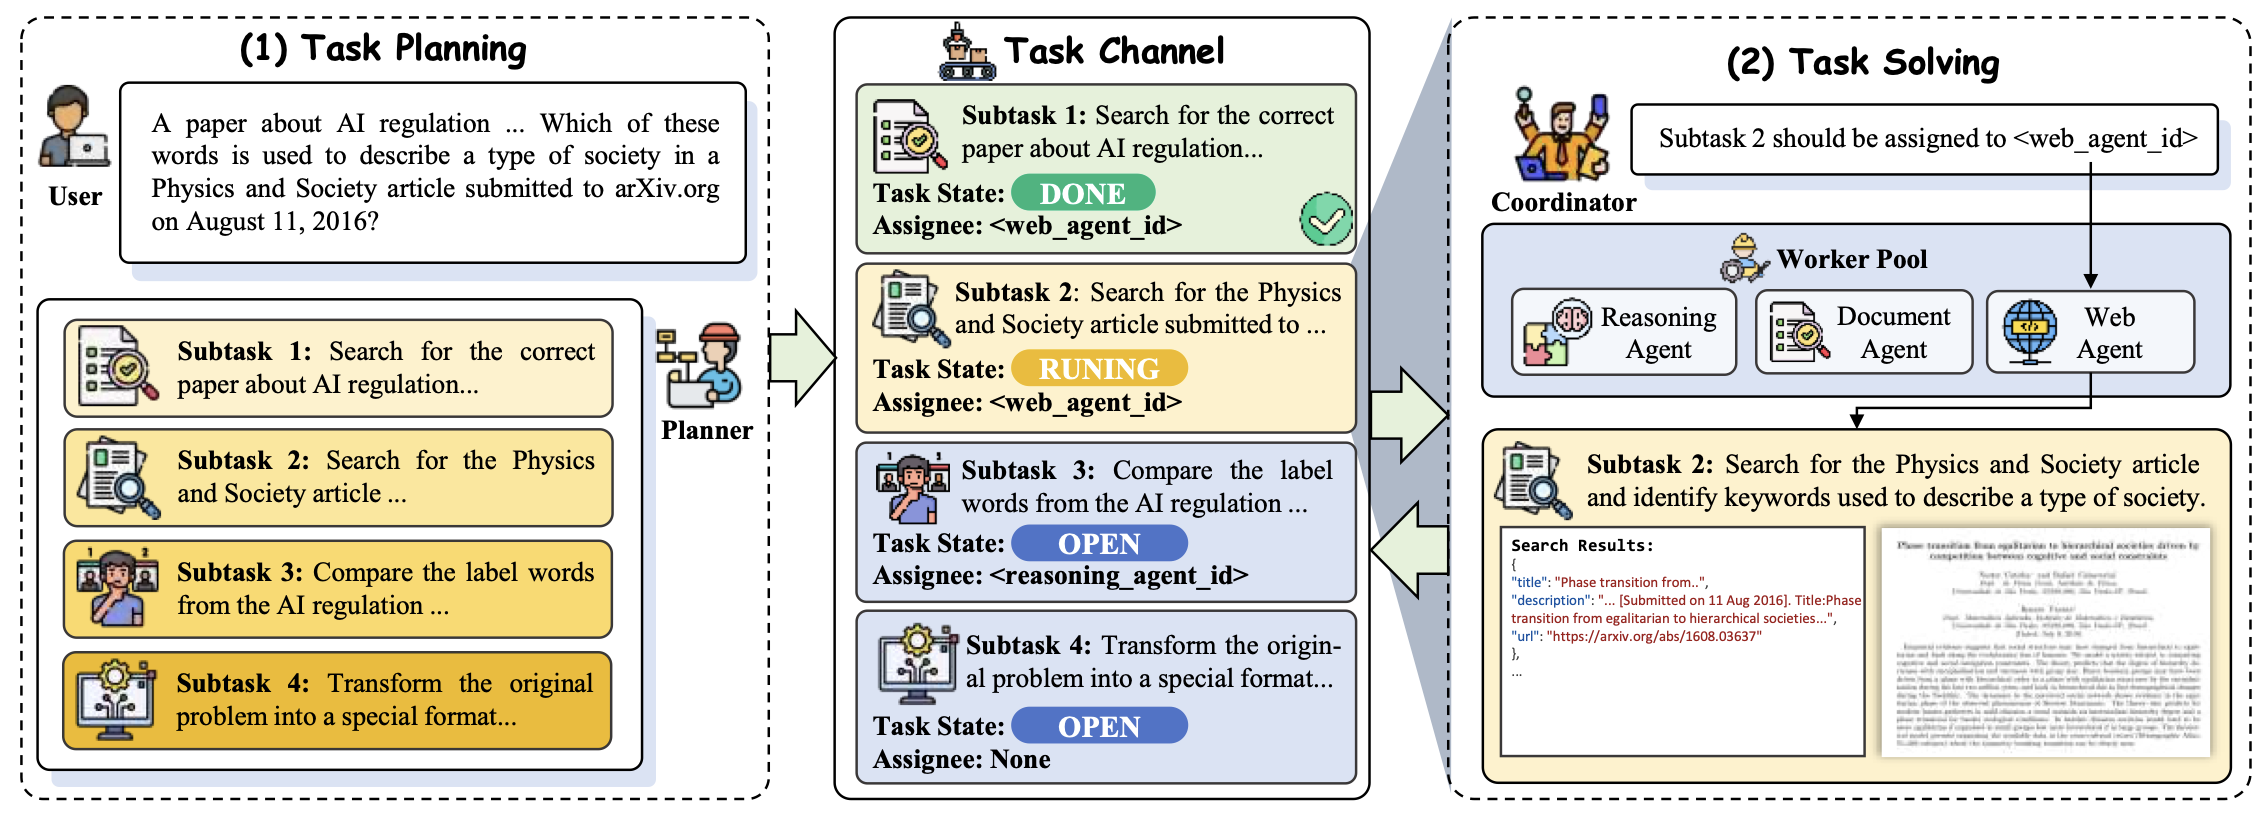
系统通过共享任务通道(Task Channel)实现通信,Coordinator在通道中发布任务和分配信息,Workers完成后仅返回最终结果,工具调用的详细上下文保持在子任务范围内。这种设计简化了系统管理,避免了智能体间直接通信的复杂性,提升了可扩展性。
2. 结构化任务流程
任务处理遵循标准化 pipeline:
- Planner分解任务 → Coordinator分配子任务 → Workers执行并返回结果 → Coordinator整合 → Planner合成最终输出
3. 动态重规划机制
执行过程中,Workers会自我评估子任务是否失败。若检测到失败,Coordinator将失败信息反馈给Planner,触发新的子任务生成。这种机制使系统具备测试时自适应能力,能根据任务复杂度动态调整策略。实验显示,随着重规划次数增加,系统性能持续提升,体现了自我修正和进化的能力。
四、OWL训练方法:优化规划器实现跨领域泛化
为进一步提升系统的跨领域泛化能力,研究团队提出OPTIMIZED WORKFORCE LEARNING(OWL) 训练范式,核心是通过强化学习优化领域无关的Planner,而非所有组件:
1. 两阶段训练策略
- 监督微调(SFT):使用专家演示数据初始化Planner的任务分解能力。研究团队从HotpotQA(多跳推理)、WikiTableQuestions(表格处理)、数学问题和Infinity-MM(多模态)四个数据集收集了1,599条高质量轨迹,每条轨迹包含平均3.41个子任务。
- 强化学习优化:采用直接偏好优化(DPO)算法,通过比较不同轨迹的优劣进一步提升Planner的决策能力。为每个问题生成4条轨迹,基于评估结果构建"优选-次选"对(共1,009对),使Planner学会更有效的任务分解策略。
2. 任务课程设计
为避免Planner过拟合特定领域,训练数据覆盖多维度能力需求:
- 多跳推理(HotpotQA)
- 表格信息处理(WikiTableQuestions)
- 逻辑与计算问题(数学任务)
- 多模态信息协调(Infinity-MM)
这种设计确保Planner掌握可迁移的认知技能,而非领域特定知识。
五、实验验证:性能超越商业系统的开源突破
研究团队在GAIA基准测试(涵盖多领域、多模态推理任务)上的实验结果令人瞩目,充分验证了WORKFORCE与OWL的有效性:
1. 开源系统的巅峰表现
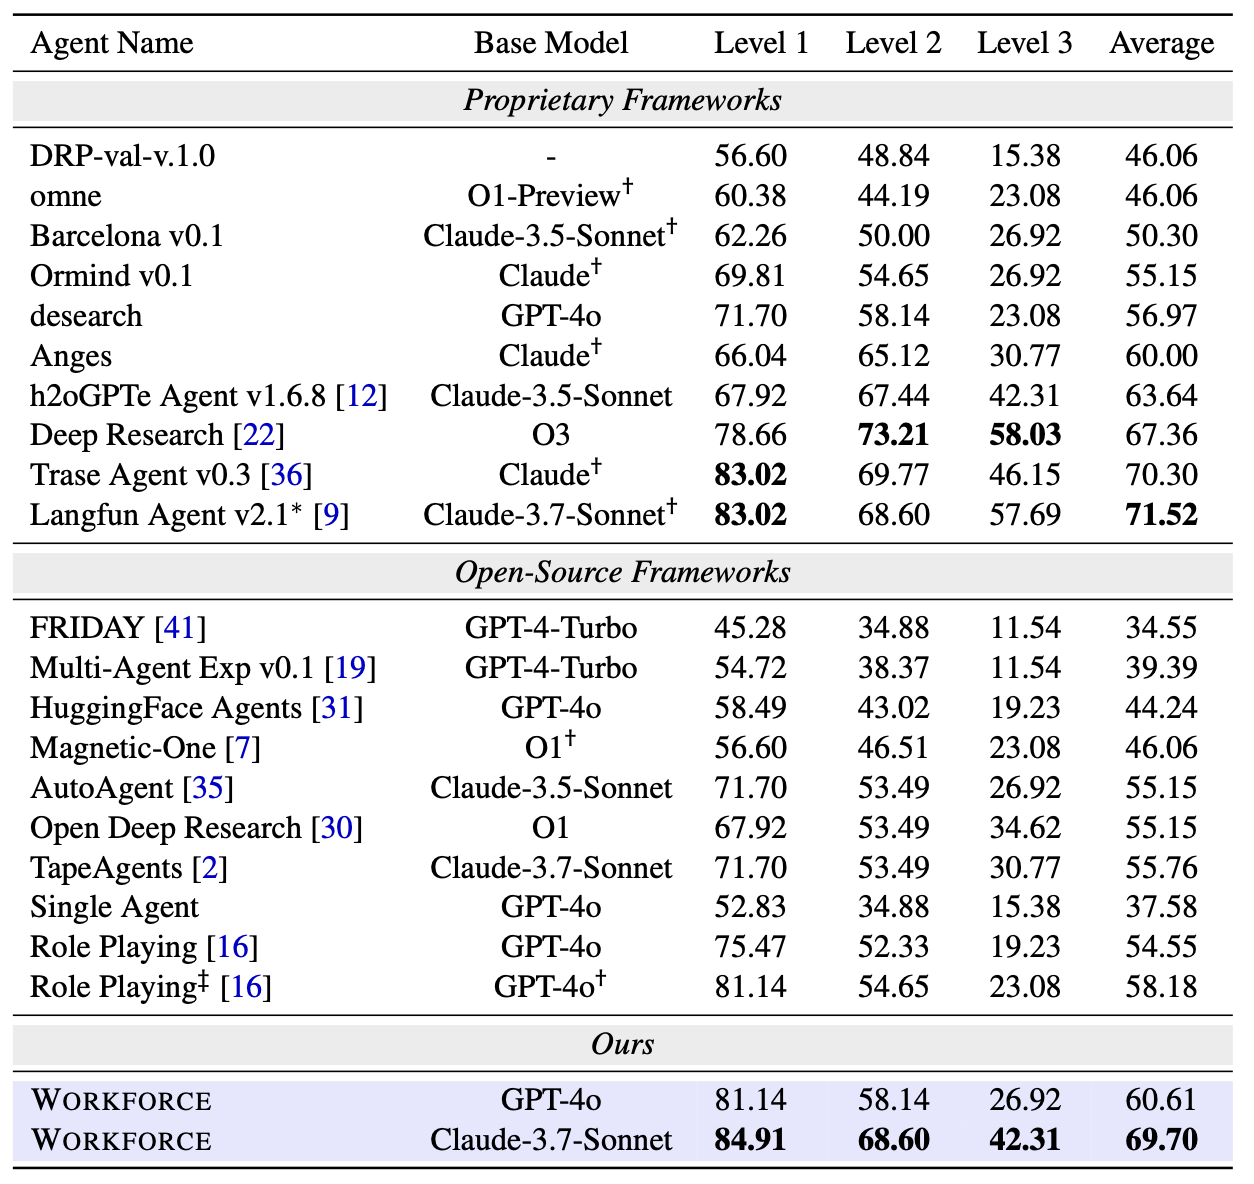
WORKFORCE以69.70%的准确率创下开源系统新纪录,在所有难度级别上均超越现有开源框架。在严格控制变量的情况下,基于GPT-4o的WORKFORCE比单智能体方案高出23.03%,比角色扮演多智能体方案高出6.06%。
2. 超越商业系统的突破性进展
WORKFORCE成为首个超越商业系统的开源框架:
- 比OpenAI的Deep Research高出2.34%;
- 在Level 1任务上超越Langfun Agent v2.1达1.89%;
- 缩小了开源与闭源系统之间的性能鸿沟。
3. OWL训练的显著增益
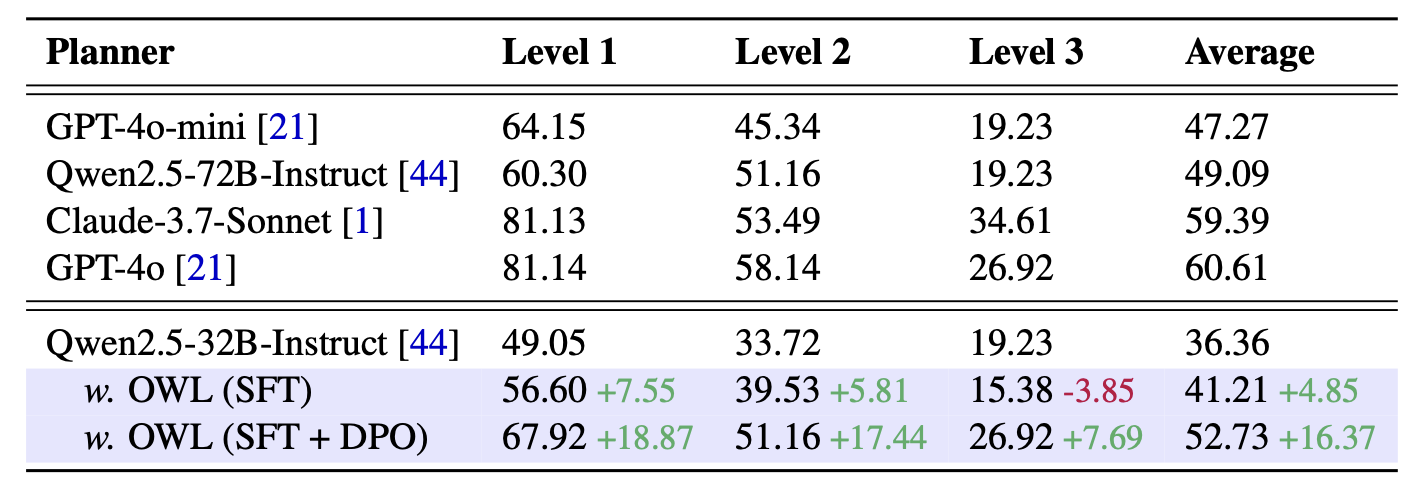
经OWL训练的Qwen2.5-32B模型表现惊艳:
- 准确率提升16.37%,达到52.73%;
- 超越GPT-4o-mini(47.27%)和更大规模的Qwen2.5-72B(49.09%);
- 在高难度Level 3任务上与GPT-4o性能相当。
4. 鲁棒性与扩展性验证
- 跨能力类型稳定性:在网页浏览、多模态处理、推理等能力上均优于基线方案;
- 多能力任务适应性:当任务需要≥3种能力时,WORKFORCE保持稳定性能,而基线系统(如角色扮演)性能下降近一半;
- 训练效率:仅训练Planner即可实现45.45%的准确率,接近同时训练Planner和Workers的46.68%,大幅降低计算成本。
六、局限性与未来展望
尽管取得显著突破,该研究仍存在局限性:
- 性能依赖高质量领域工具,在工具不完善的领域可能出现执行瓶颈;
- 基于真实世界反馈的强化学习受限于网络延迟等因素,训练耗时较长。
未来研究可向以下方向拓展:
- 开发自适应工具学习机制,使Workers能自主提升工具使用能力;
- 探索更高效的强化学习策略,减少对大规模标注数据的依赖;
- 扩展到更多垂直领域(如医疗诊断、工业自动化),验证框架的普适性。
结语:迈向通用人工智能助手的基石
WORKFORCE框架与OWL训练方法通过模块化设计与规划器优化,打破了多智能体系统的领域壁垒,实现了"稳定核心+可变外围"的高效迁移模式。其开源特性(代码、模型和数据完全公开)为学术界和工业界提供了可复用的基础架构,有望加速通用人工智能助手的发展。
从自动化办公到复杂决策支持,这一研究成果为AI技术在真实世界的规模化应用铺平了道路。当多智能体系统能够像人类组织一样灵活协作、跨领域适应时,通用人工智能的愿景正逐步从概念走向现实。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 53
 0
- 0


 已为社区贡献11条内容

所有评论(0)