连未来轨迹都能交互?FINet 这波操作,让自动驾驶安全等级跳级!
写在前头
LeCun在忙什么?
当扎克伯格亲自挂帅Meta的AI项目,以千亿级薪酬搅动硅谷人才格局时,这位Meta麾下最负盛名的AI大佬、图灵奖得主、深度学习"三巨头"之一的Yann LeCun,却意外地保持着低调。他既没有投身LLM基础模型的研发热潮,也在社交网络上逐渐沉寂,甚至引发"是否将离开Meta"的猜测。
但这位技术巨匠或许正在酝酿真正的野心——聚焦于"世界模型"的探索。就在近期,LeCun团队在这一领域的最新突破终于浮出水面:他们提出了基于全身体态的第一人称视频预测模型PEVA,通过融合3D人体姿势轨迹与条件扩散Transformer架构,首次实现了从人类视角对真实环境动态与具身行为的系统性建模。这一进展,或许正是他所追逐的"下一个AI范式"的关键拼图。
另外 我整理了ICCV 2025 计算机视觉相关论文,感兴趣的可以 d d
论文基本信息
论文基本信息
-
论文标题:Future-Aware Interaction Network For Motion Forecasting
-
作者:Shijie Li、Xun Xu、Si Yong Yeo、Xulei Yang
-
作者单位:I2R, A*STAR;Nanyang Technological University
-
发表信息:arXiv:2503.06565v1 [cs.CV] 9 Mar 2025
-
论文链接:https://arxiv.org/abs/2503.06565
-
项目链接:https://github.com/sj-li/FINet
2. 【论文速读】
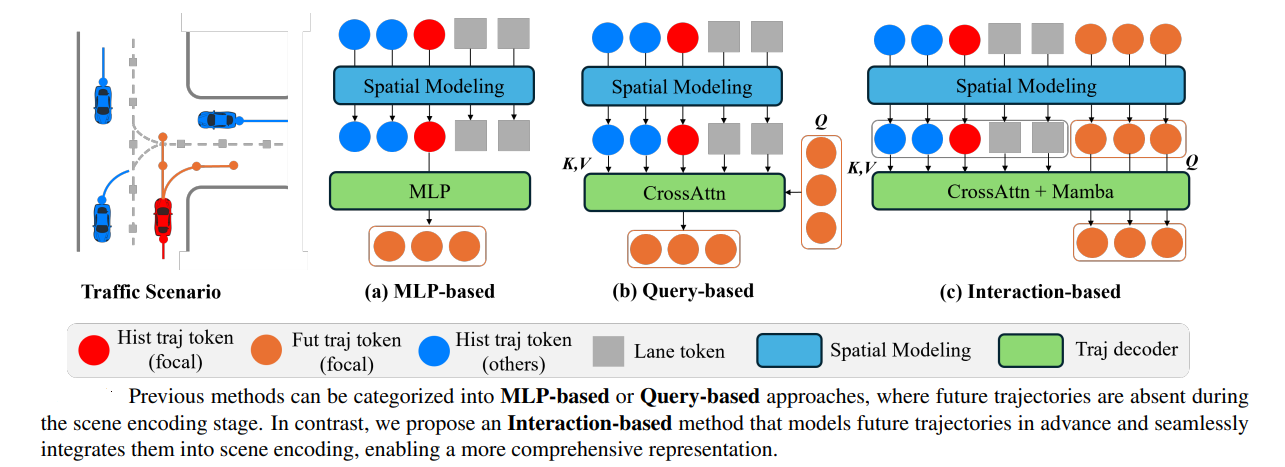
运动预测是自动驾驶系统的关键部分,能生成准确平滑的未来轨迹以保障安全导航。以往方法在场景编码阶段常缺失潜在未来轨迹,且采用的Transformer架构存在二次缩放复杂度问题。
本研究提出未来感知交互网络(Future-Aware Interaction Network),将潜在未来轨迹引入场景编码以实现全面交通表示,并引入状态空间模型(SSM) 中的Mamba进行时空建模,还提出自适应重排序策略(ARS) 以适配Mamba的空间交互建模,同时用Mamba优化未来轨迹的时间一致性。这些改进提升了模型效率及预测的准确性和多样性。
3.【研究背景及相关工作】
3.1 研究背景
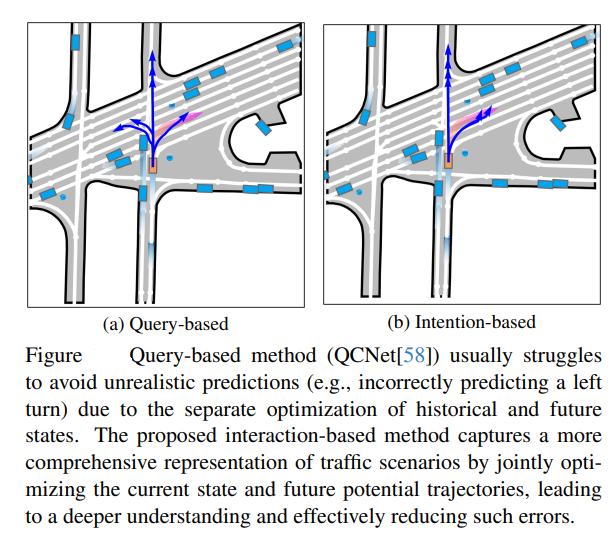
运动预测是自动驾驶系统的关键组成部分,但其面临现实交通场景复杂性和运动预测固有的多模态性等挑战。以往方法在场景编码阶段常缺失潜在未来轨迹,导致历史与未来状态优化分离,可能产生次优结果;同时,常用的Transformer架构虽用于时空建模,但存在计算复杂度随序列长度呈二次缩放的问题,在多智能体场景中效率不足。
3.2 相关工作
运动预测作为时空建模任务,早期采用循环神经网络(RNNs)处理时序信息,结合卷积神经网络(CNNs)处理栅格化地图,但存在细节丢失和效率问题;后来向量化地图表示结合Transformer架构应用,但Transformer依赖位置编码难以捕捉细粒度关系且效率低。状态空间模型(SSMs)如Mamba在长序列处理上表现出线性复杂度和高效性,但在运动预测中的应用尚未探索。
Previous methods
4.【研究方法论】
4.1 轻量级场景编码器(LSEnc)
轻量级场景编码器将输入场景转换为基于令牌的表示,高效地将每个轨迹或车道段映射到单个令牌。
-
代理的历史轨迹通过一组Mamba块处理,以线性复杂度从头到尾顺序处理每个历史轨迹(T_{i}^{hist }),选择最终令牌((t=0))表示整个轨迹,公式为,其中表示代理的语义信息(如车辆或行人)。
-
对于车道图,采用轻量级mini-PointNet高效学习车道嵌入,每个车道段的公式为,表示车道类型,初始化为可学习嵌入。
-
整个场景被转换为包含轨迹令牌()和车道令牌()的基于令牌的表示,公式为,为连接运算符。
4.2 未来感知交互Mamba(FIM)
未来感知交互Mamba提前建模潜在未来轨迹,并将其与当前场景元素进行空间联合优化,使模型能够感知未来状态,学习更全面的表示,提升预测的准确性和多样性。
-
未来轨迹建模:潜在未来轨迹受当前运动状态(,等同于)和驾驶员意图(个可学习令牌)影响,引入归纳偏置,公式为,仅添加到第一个轨迹,再通过Mamba块传播到其他轨迹。
-
自适应重排策略(ARS):将无序场景元素转换为有序序列,通过两个MLP由预测参考点,场景令牌按与的空间距离重排为,并将焦点代理的令牌放在末尾,与未来轨迹令牌拼接为,再通过双向Mamba块建模空间交互;后续阶段由前一阶段的第一个未来轨迹令牌预测参考点,并对与真实未来轨迹终点进行对齐的辅助监督。
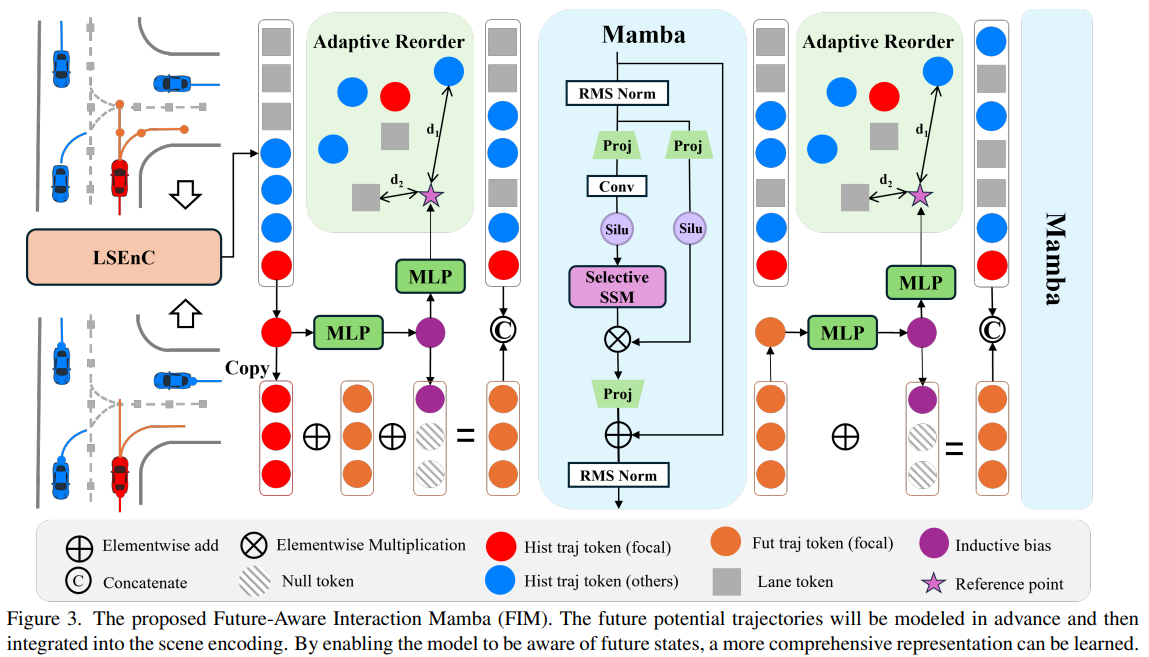
The proposed Future-Aware Interaction Mamba (FIM).
4.3 时间增强解码器(TEDec)
时间增强解码器接收FIM的令牌(分为场景令牌和未来轨迹令牌),解码未来轨迹,确保时间一致性。
-
首先将扩展为序列格式,通过插值从当前状态()过渡到未来状态(),公式为和。
-
然后通过多个CAMBlock(包含交叉注意力层和双向Mamba块)处理,交叉注意力层聚合场景令牌的相关信息,Mamba块按顺序优化轨迹以增强时间依赖性。
-
最后通过两个MLP输出未来轨迹和相应分数,公式为和。
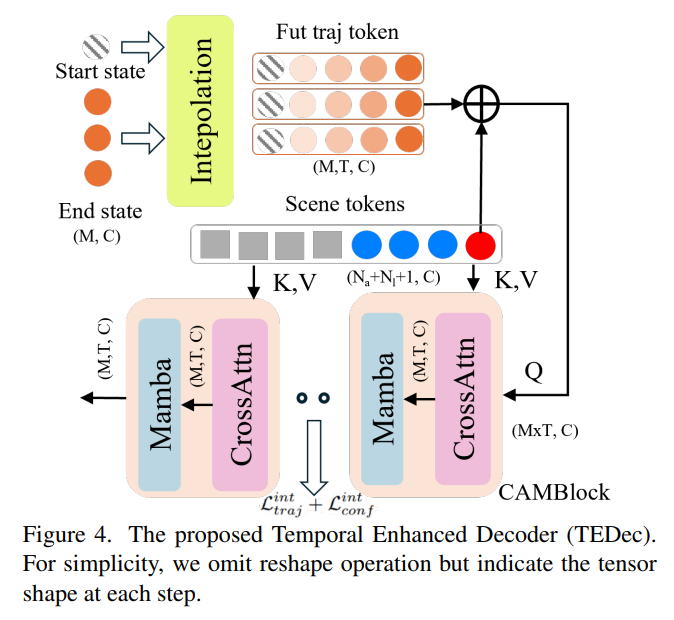
The proposed Temporal Enhanced Decoder (TEDec)
4.4 监督策略
采用多种损失函数进行监督,整体损失公式为,其中:
-
为轨迹回归的平滑L1损失,为置信度分类的交叉熵损失;
-
和为TEDec中间输出的相同损失,用于鼓励解码过程中的一致预测;
-
为第二个预测偏移与真实未来轨迹终点对齐的平滑L1损失。
5.【实验结果分析】
5.1 实验设置
-
数据集:使用了两个广泛采用的运动预测数据集,即Argoverse2和Argoverse1。Argoverse2包含199,908个训练序列、24,988个验证序列和24,984个测试序列,每个序列采样频率为10Hz,包含5秒的历史数据,需要预测未来6秒的轨迹((T_{h}=50),(T_{f}=60));Argoverse1包含205,942个训练样本和39,472个验证样本,总序列时长5秒,由2秒的观测数据和3秒的预测数据组成((T_{h}=20),(T_{f}=30)),同样以10Hz采样。
-
评估指标:采用标准的运动预测评估指标,包括最小平均位移误差(minADE)、最小最终位移误差(minFDE)和Miss Rate(MR)。minADE计算最佳预测轨迹与真实轨迹在所有时间步的平均(\ell_{2})距离;minFDE衡量最终时间步的(\ell_{2})距离;MR是最佳预测终点与真实终点距离超过2.0米的案例比例。每个代理最多评估6条预测轨迹,选取终点误差最小的轨迹作为最佳轨迹。
5.2 与现有方法的对比
-
Argoverse 2数据集:在Argoverse 2测试集上,所提的FINet在多数指标上优于现有方法。例如,相较于ProphNet,FINet在minFDE₆上提升约15%,在minADE₆上提升约4%;与QCNet相比,在minADE₁上提升5%,在minFDE₁上提升6%。且K=1时的性能提升大于K=6,这得益于FINet能通过联合优化当前和未来状态生成更多样化的轨迹及更准确的分数。
-
Argoverse 1数据集:在Argoverse 1验证集上,FINet在minADE₆和minFDE₆上表现最佳,其中minADE₆较之前的方法提升约10%,在MR6上取得第二好的性能,进一步证明了其有效性。
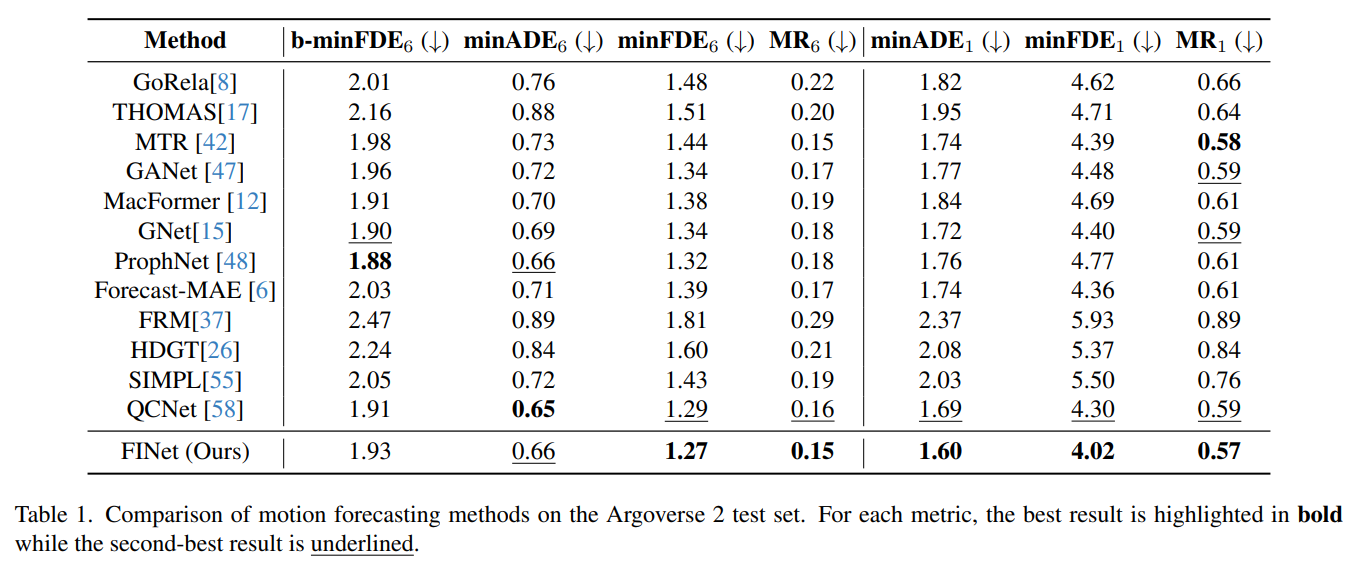
Comparison of motion forecasting methods on the Argoverse 2 test set.
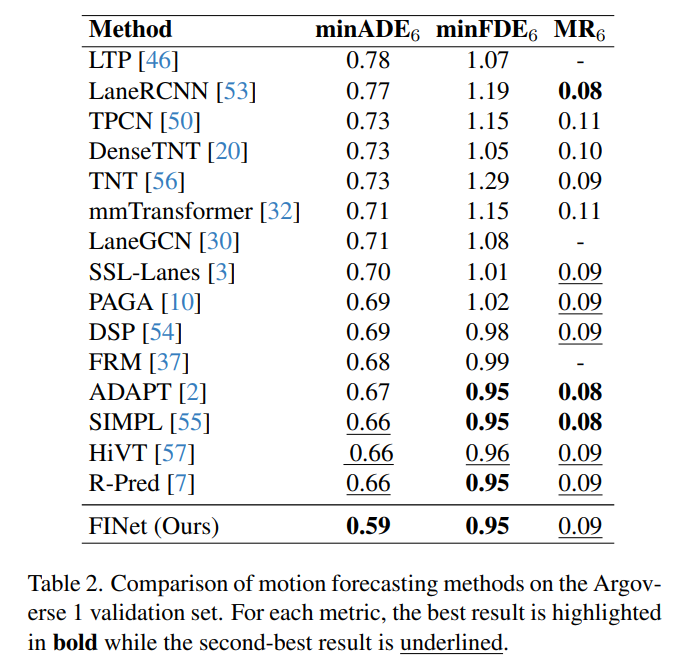
Comparison of motion forecasting methods on the Argoverse 1 validation set.
5.3 效率分析
与纯transformer架构的QCNet相比,FINet在保持更好性能的同时,效率显著提升:模型大小减少52%(3.7M vs. 7.7M),延迟降低68%(17.72ms vs. 54.55ms),GPU内存使用减少81%(0.56G vs. 2.92G),FLOPs减少95%(1.47G vs. 28.0G)。这主要归因于大量使用的Mamba架构,其复杂度随序列长度线性增长。
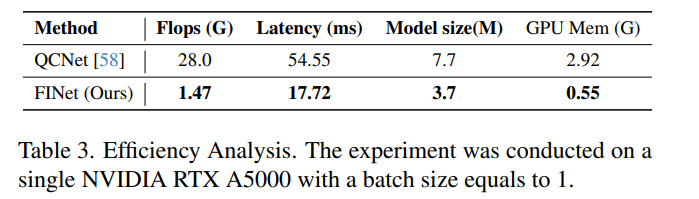
Efficiency Analysis
5.4 消融研究
-
解码器类型影响:基于交互的解码器显著优于MLP-based解码器和Query-based解码器。因为将未来轨迹整合到场景编码中,实现了所有场景元素和未来轨迹的联合优化,得到更丰富的交通表示。
-
归纳偏置影响:仅将归纳偏置应用于第一个未来轨迹令牌时效果最佳,这有助于归纳偏置有效传播,使未来轨迹集更连贯、分布更合理;而省略偏置或应用于所有轨迹令牌会导致性能下降。
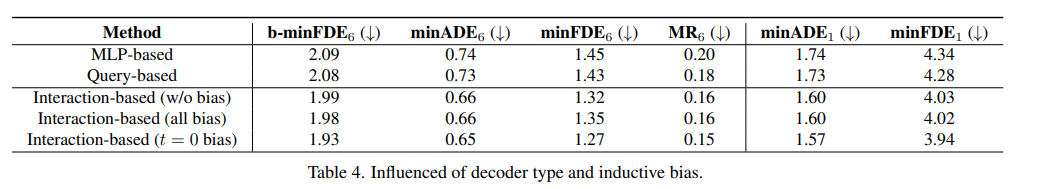
Influenced of decoder type and inductive bias
5.5 定性结果分析
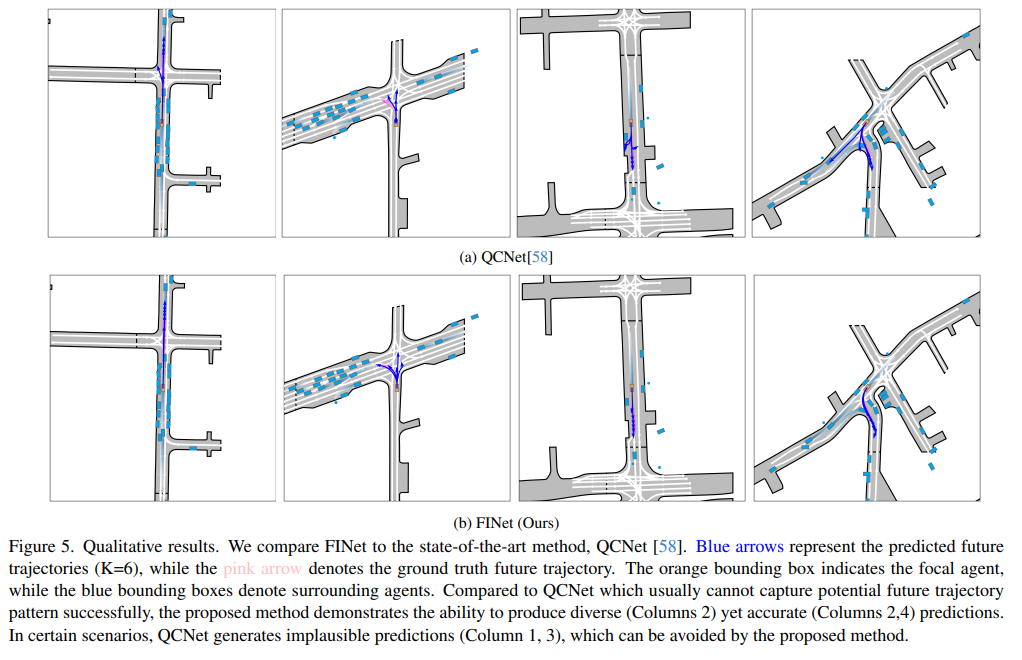
定性可视化结果显示,与QCNet相比,FINet能生成更准确、更多样化的未来轨迹,在某些场景下可避免QCNet产生的不合理预测,更好地捕捉潜在的未来轨迹模式。
6.【总结展望】
6.1 总结
本文提出了一种高效的未来感知交互网络(FINet),这是一种基于交互的运动预测方法。该网络先提前建模未来轨迹并将其整合到场景编码中,实现所有元素的相互感知,以学习全面的交通表示,从而实现准确且优化的轨迹预测;同时融入状态空间模型(SSM)中的Mamba进行时空建模,并通过自适应重排策略将无序数据转换为结构化序列以适配Mamba的空间交互建模,还利用Mamba对生成的未来轨迹进行时间细化,确保预测的一致性。在Argoverse 1和Argoverse 2数据集上的大量实验表明,该方法在性能和效率上均优于以往方法。
6.2 展望
未来可进一步探索更复杂交通场景下模型的泛化能力,例如极端天气或突发交通事件等情况;同时,可研究如何更高效地融合多源信息(如传感器数据)以提升预测精度,此外,针对Mamba在空间建模上的潜在优化空间,也可开展更深入的研究,以推动该方法在实际自动驾驶系统中的更广泛应用。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献2条内容

所有评论(0)