【简单易懂|大数据】数据存储与处理基础(二):图解HDFS数据存取
·
一、HDFS的数据存储流程
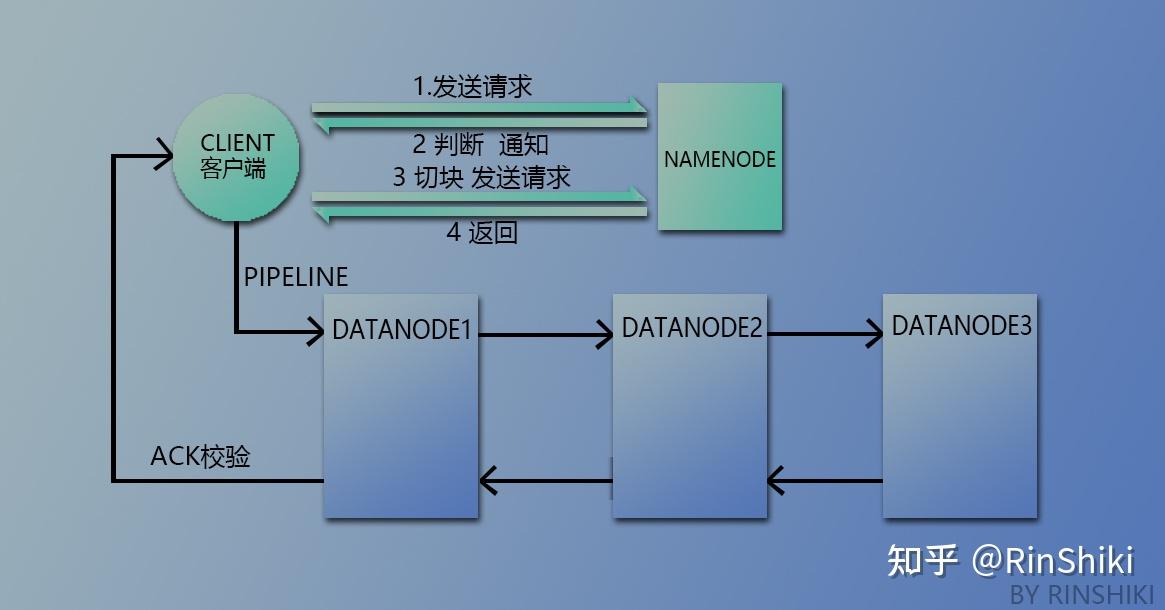
HDFS存储流程图
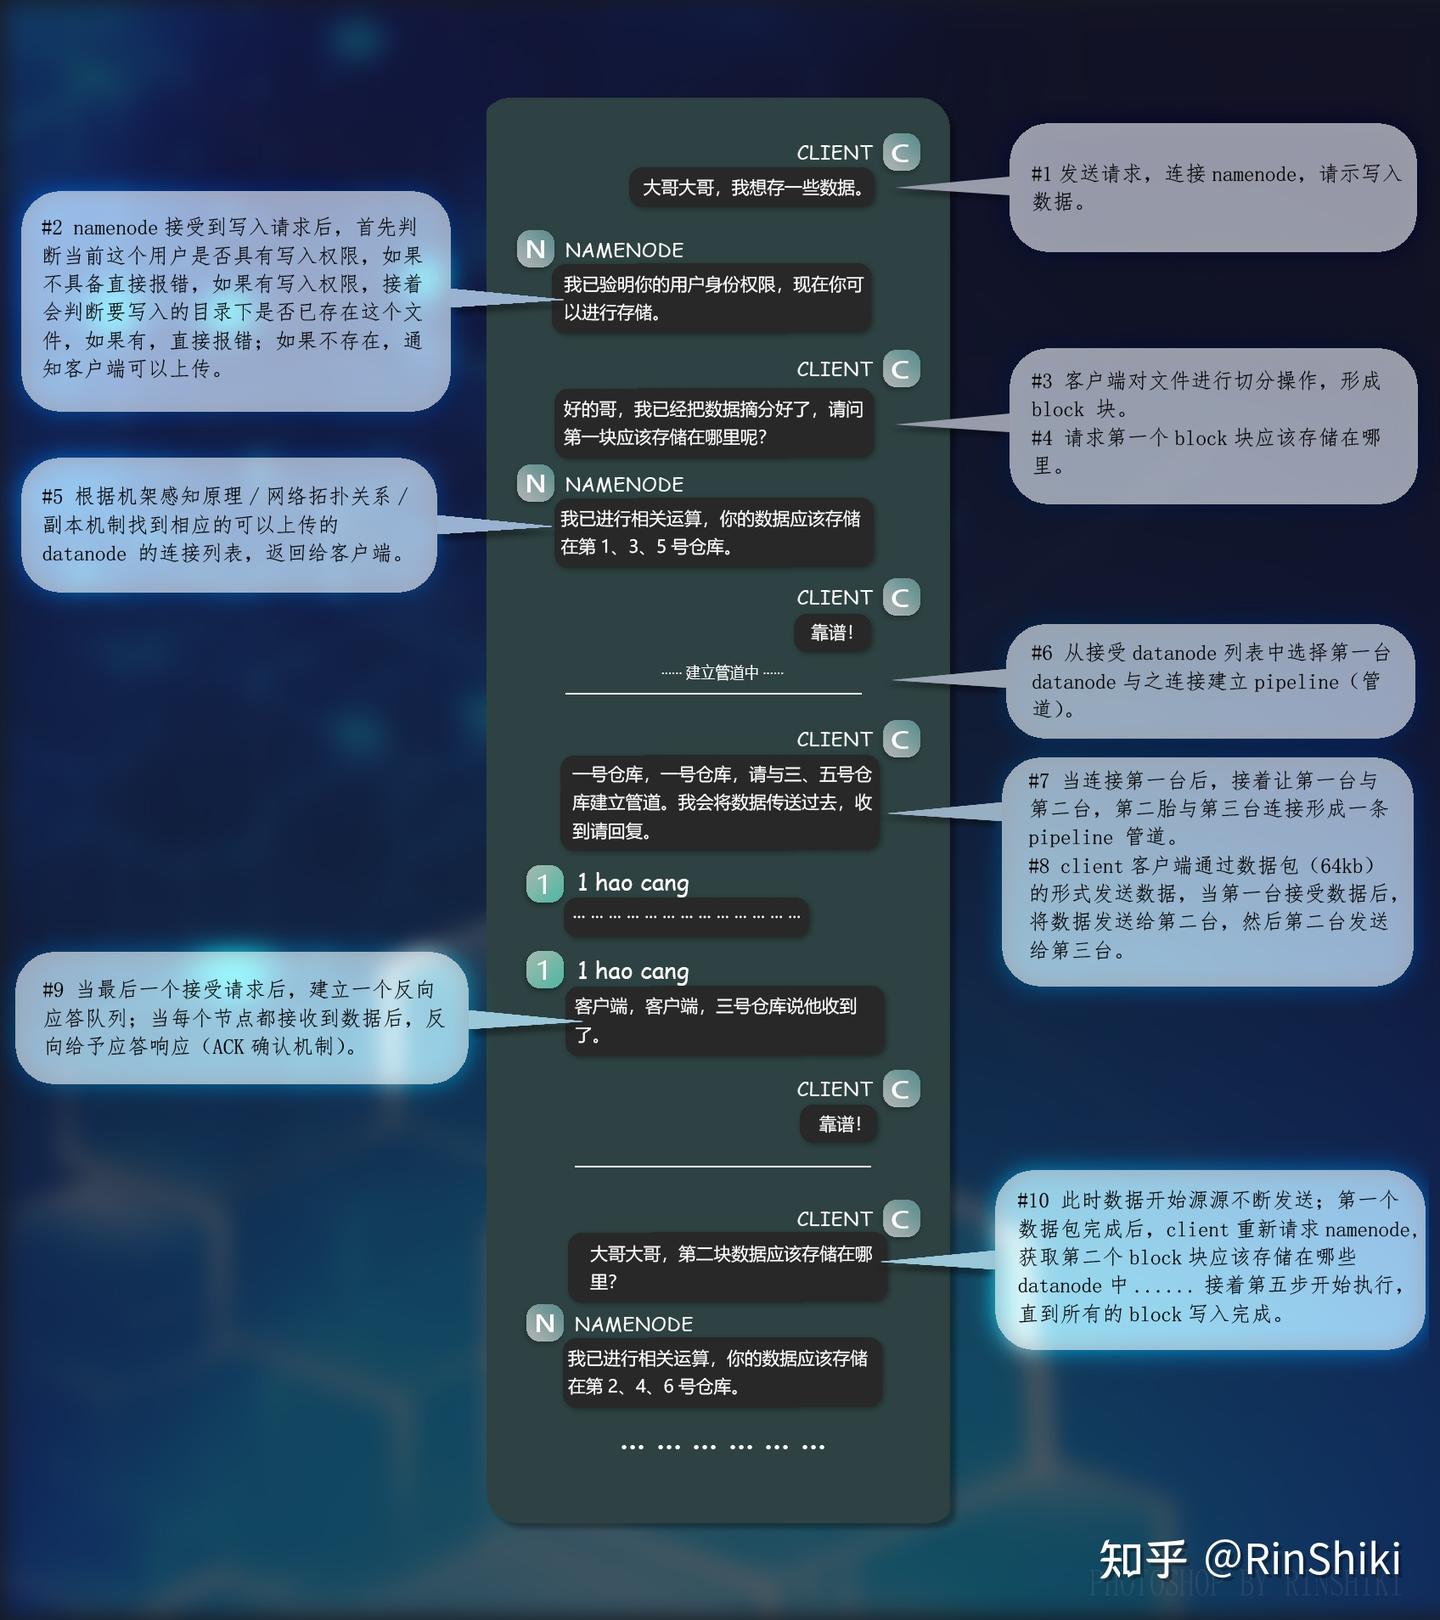
HDFS数据存储流程(对话)
- 用户输入:hdfs dfs -put aa.MP4 /input/aa;
- 客户端(client)向NameNode 发送写入数据的请求;
- Namenode收到客户端的请示之后,开始综合判断:
- 用户是否又写入请求?
- 用户指定的路径是否有这个文件?
- 硬盘剩余空间是否足够容纳文件?是否足够存储型的数据块?
- 综合判定通过之后,应答客户端写入需求。
- 客户端开始执行分块操作,把文件拆分成一个个大小为 128 Mb 的block块。
- 解释:比如aa.mp4大小是400Mb,那么会分成四个128Mb的block块。前三个block块使用完全,最后一个依旧占据128Mb的空间,但仅存储16Mb内容。
- 默认大小是128mb,当然也可以通过配置更改;
- 客户端在切好块之后,向NameNode请求第一个blcok块存储在哪几台datanode机器上。
- NameNode开始分析:
- 根据机架感知原理,匹配相邻或者性能最优的机架等;
- 网络拓扑关系,不同区域的网段,相邻或者性能最优的等;
- 多副本机制,保证数据的可靠性。
- NameNode分析好之后,以列表的形式 例如【datanode1,datanode2,datanode3】返回给客户端;
- 根据NameNode返回的列表信息,开始建立pipeline 管道。
- 分别建立 客户端 与-node1 ,-node1与--node2 , node2与-- node3之间的管道连接。
- 开始传输数据,以每个数据包最小单位64kb开始传输,通过管道:以最小数据包 64kb的形式:
- 分别传输到node1,node1转存给node2,node2转存给node3;
- 以数据流的形式进行流通。
- 一个完整的block传输完毕之后,启动ACK校验,每一个datanode成功的写入数据之后会向namenode报备;
- 客户端会等待namemnode或者通过其他机制,例如心跳机制来验证数据是否正确写入。
- datanode的心跳,和namenode的元数据信息相结合,来跟踪数据库的健康状态。
- 期间如果ack校验不完整。
- 同时HDFS的心跳机制也会捕捉到是哪个节点出现的问题 ;
- 然后开启恢复机制,多副本存储,重新分配新的节点,告诉客户端,让客户端向其发送新的block数据。
- 而原来挂掉的这会被清理掉。
- 由上述步骤,第一个blcok传输完毕。开始第二个block的存入。开始询问namenode,然后重复第7不之后的步骤,直到最后以一个传输完毕。
二、HDFS的数据读取流程
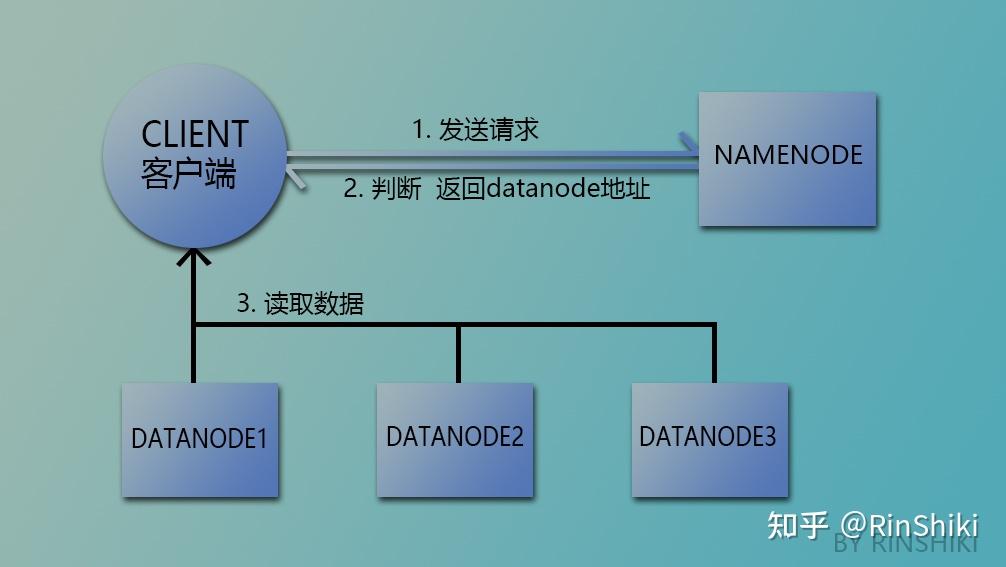
HDFS数据读取流程图
- 连接namenode,发送读取某数据的请求;
- namenode首先判断该用户是否具备读取数据的权限;根据机架感知原理、网络拓扑关系、副本机制,返回部分或者全部datanode的地址;
- 客户端接收部分或者全部block列表后,并行连接datanode节点,开始读取数据;
- 读取完成后,会再次请求namenode剩余datanode节点;直到全部block读取完毕。
- 按照block进行排序、拼接、合并,此时用户就可以看到最终文件。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)