自然语言处理(NLP)核心算法
·
自然语言处理(NLP)的核心技术:Transformer架构与大语言模型(LLM)
Transformer的核心组件包括:
- 多头自注意力机制:“自注意力”模型在处理一个序列中的每个元素时,会参考序列中其他元素的信息来增强当前元素的表示。“多头”该机制并行地运行多次,每次运行可以关注不同的特征或模式,最后将结果合并起来,提高模型的表达能力;
优势:
并行计算:不再受限于序列的时序依赖,大幅提升训练效率。
长程依赖:直接捕获任意距离的元素关联(如句子中第一个词和最后一个词的关系)。 - 前馈神经网络(FFN)的独立性:在神经网络中,每个位置的元素会独立地通过相同的全连接层进行处理,这种方式能够增强模型对输入数据进行非线性的处理和转换能力(非线性变换:模型可以捕捉数据中的复杂关系和模式,而不仅仅是简单的线性关系;复杂和抽象特征);与自注意力机制互补
- 残差连接和层归一化:提升模型的稳定性和训练效果。
残差连接:缓解深层网络的梯度消失问题(如 输出 = 输入 + 子层输出)核心思想:将输入直接传递到后续的层,并与子层的输出相加,从而保留原始信息并帮助梯度更有效地传播。
层归一化:加速训练收敛,稳定数值分布。核心思想:对每一层的输入进行标准化处理,使得数据在训练过程中保持较为稳定的数值分布 - 编码器-解码器架构:
编码器:通过多层自注意力和前馈网络提取输入的高维特征。
解码器:在编码器输出的基础上,通过 掩码自注意力(确保解码时只能看到当前位置之前的序列)和交叉注意力(关注编码器输出)生成目标序列。
掩码语言模型(Masked Language Model, MLM):
这是一种语言表示学习的方法,模型会随机遮蔽输入文本中的一些词语(用特殊标记 [MASK] 代替),然后尝试根据上下文预测这些被遮蔽的词语。这种方法能够帮助模型更好地理解语义和语法结构。
三大NLP预训练模型: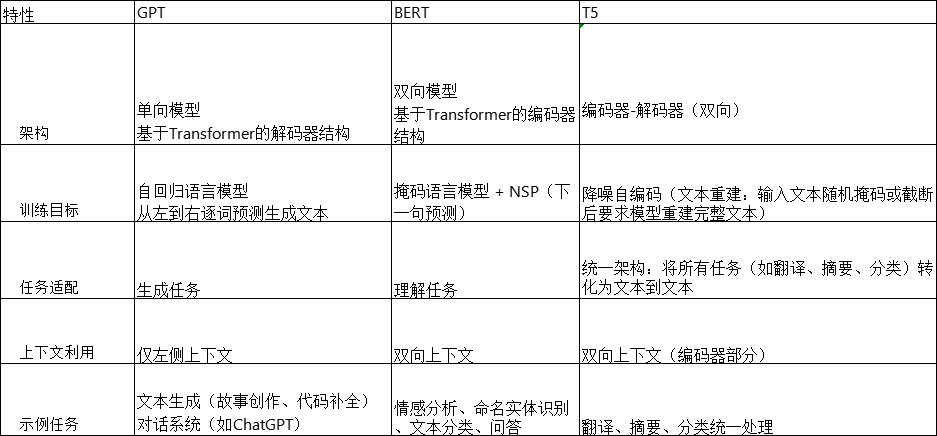 需要生成文本?选 GPT 或 T5。
需要理解文本语义?选 BERT。
希望统一处理多任务?选 T5。
三者均基于Transformer,但设计哲学不同:GPT强调生成能力,BERT侧重理解,T5追求任务通用性
大语言模型(LLM):基于人工智能(AI)和深度学习技术构建的、能够处理和理解自然语言的大规模预训练模型。
1:核心特点:
超大规模参数
参数量通常达到数十亿至万亿级(如GPT-3有1750亿参数),通过庞大的模型容量捕捉语言的复杂性。
预训练+微调范式
预训练:在无标注的通用文本(如书籍、网页)上学习语言通用规律。
微调:针对特定任务(如客服、医疗)用标注数据进一步优化。
上下文理解与生成
支持长文本上下文(如GPT-4的128K token上下文窗口),能基于对话历史生成连贯回复。
多任务通用性
同一模型可处理翻译、问答、写作、代码生成等多样化任务,无需为每类任务单独设计模型。
2:关键技术
Transformer架构
无监督学习:通过预测掩码词(如BERT)或下一个词(如GPT)从数据中自动学习。
提示工程(Prompting):通过设计输入提示(Prompt)引导模型输出所需结果(如“请用学术风格总结下文”)。
代表模型
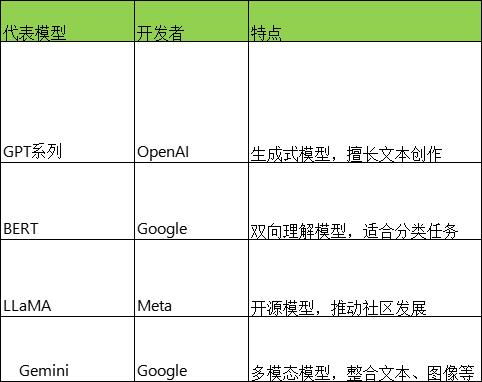
- GPT-4:具备多模态处理能力,可以理解和处理文本与图像等多种类型的数据输入。
可接受图像输入(如分析图表、照片),但输出仍为文本(图像生成由 DALL·E 处理)
3.典型应用场景
内容生成:写作辅助、广告文案、诗歌创作。
智能交互:聊天机器人(如ChatGPT)、虚拟助手。
知识问答:基于训练数据提供信息(但可能包含错误或过时内容)。
代码辅助:GitHub Copilot等代码补全工具。
语言翻译:支持多语言互译,但质量依赖训练数据
关键指标:响应速度、生成质量(BLEU/ROUGE分数:两种常用于评估机器翻译或文本生成质量的指标)、多轮对话能力

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献2条内容

所有评论(0)