大数据Hadoop之——集群环境搭建(了解)
目录
3.1 配置hive-env.sh (位置:/opt/mudule/hive/conf)
3.2 配置hive-site.xml (位置:/opt/mudule/hive/conf) (直连模式配置)
方式4:HS2 + 内嵌MetaStore方式(学习、上课使用)
方式5:HS2 + 独立MetaStore方式(生产使用推荐)
1.2 HS2 + 独立MetaStore在不同服务器
=================================================
=================================================
前期准备
1.查看网卡:
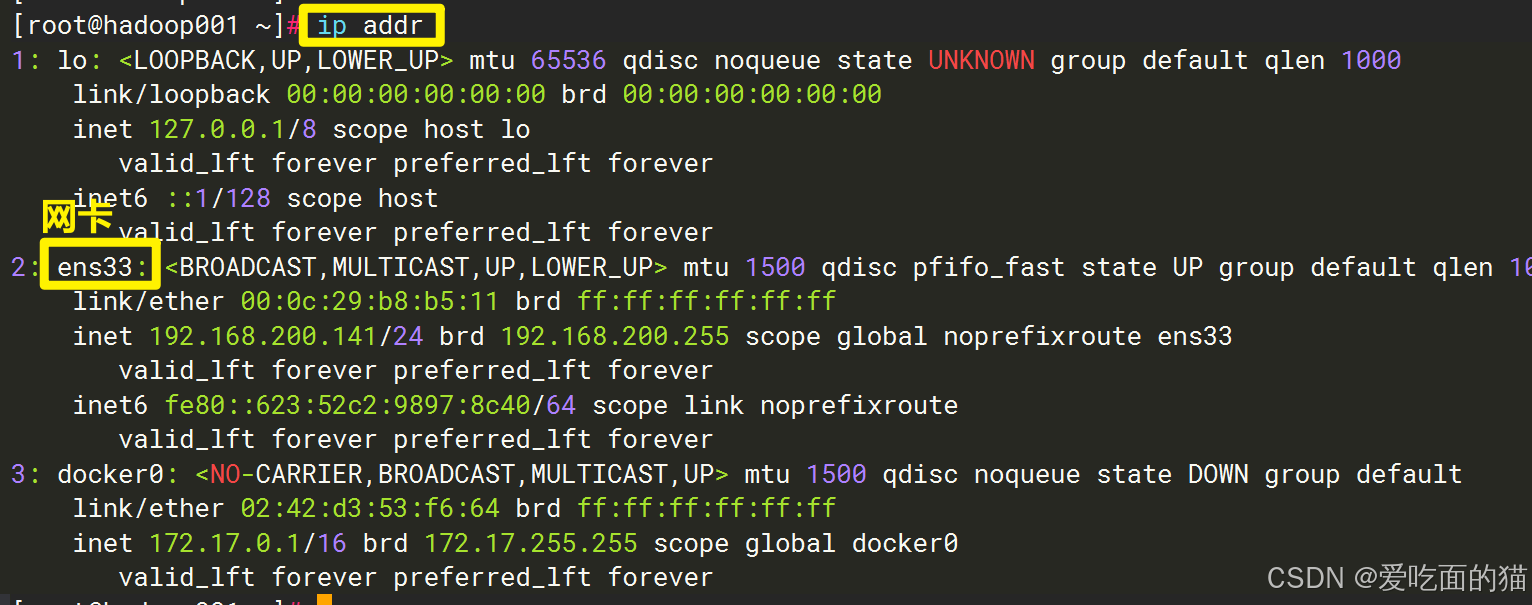
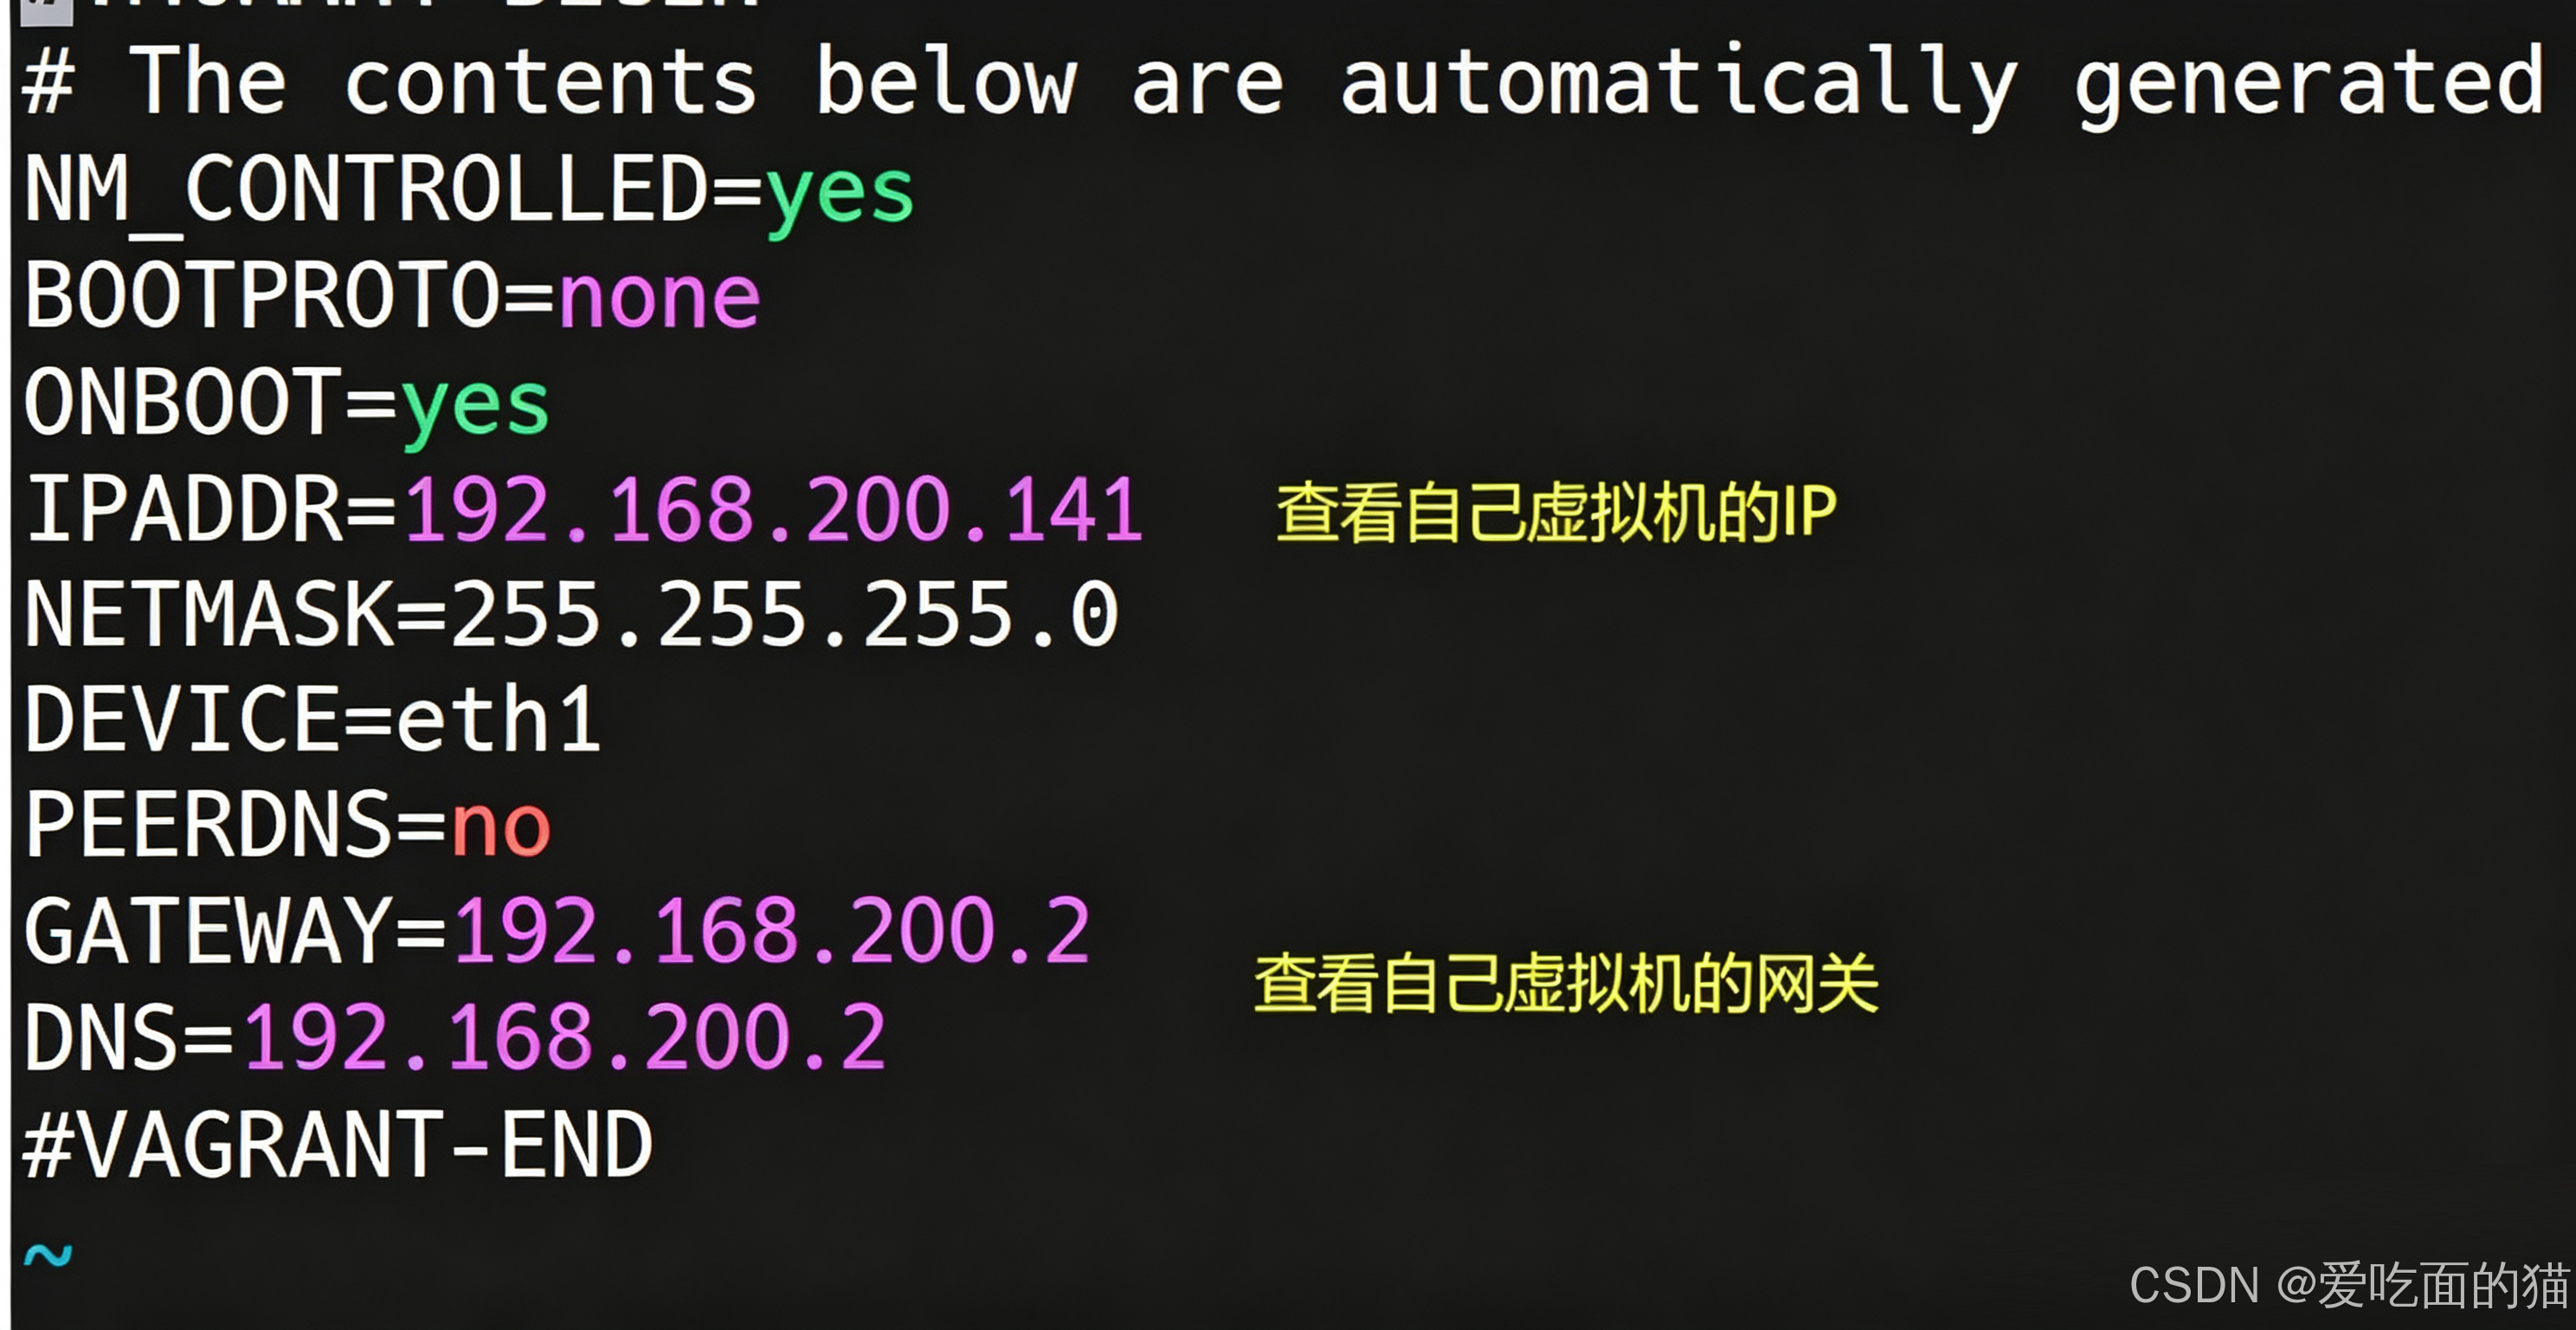
2.配置静态IP
vi /etc/sysconfig/network-scripts/ifcfg-ens32 ---- 根据自己网卡设置。
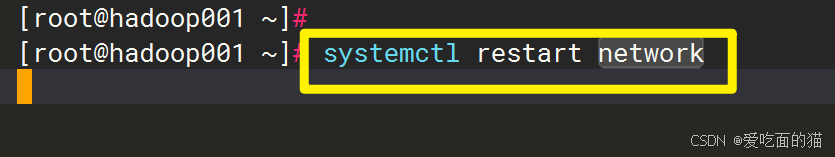
3.重启网络服务
systemctl restart network
#如果是OpenErluer系统则是 systemctl restart NetworkManager
4.设置主机名
设置主机名
hostnamectl --static set-hostname 主机名
例如:
hostnamectl --static set-hostname hadoop001
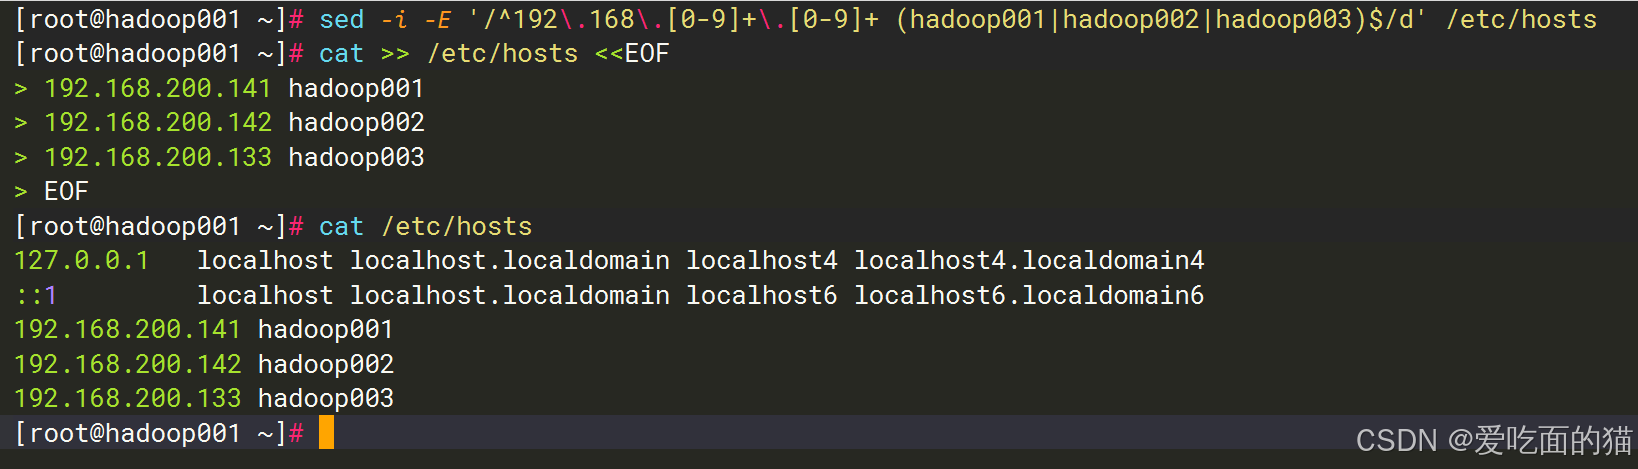
5.配置IP与主机名映射
# 删除旧的3行hadoop主机映射(精确匹配整行)
sed -i -E '/^192\.168\.[0-9]+\.[0-9]+ (hadoop001|hadoop002|hadoop003)$/d' /etc/hosts
# 追加新映射
cat >> /etc/hosts <<EOF
192.168.200.141 hadoop001
192.168.200.142 hadoop002
192.168.200.143 hadoop003
EOFcat /etc/hosts
6.安装暂时免密工具
yum install -y sshpass
7.关闭防火墙
systemctl stop firewalld
systemctl disable firewalld
8.配置免密登录
传送门 或直接下面命令
============================
#生成密钥
ssh-keygen -t rsa -N "" -f /root/.ssh/id_rsassh-copy-id hadoop001
#测试
ssh hadoop001
一、JDK的安装
1、安装jdk
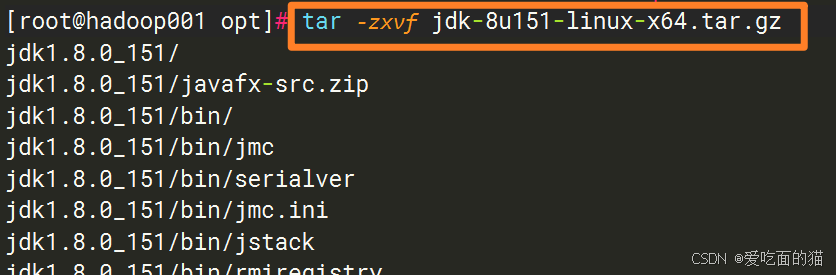
在/opt/model中上传jdk包并解压
tar -zxvf jdk-8u151-linux-x64.tar.gz
重命名,方便配置环境变量,避免更换jdk版本修改配置文件

2、配置Java环境变量
| 系统级(全局) |
| 对所有用户生效 |
| 用户级(个人) |
| 只对当前用户生效 |
|
| ✅ 几乎所有 Linux/Unix 系统都有 | Ubuntu、CentOS、macOS 等 |
|
| ✅ CentOS/RHEL 系统使用 | CentOS、RHEL、Fedora |
|
| ✅ Ubuntu 使用 | Ubuntu、Debian |
|
| ✅ 用户可创建 | 所有支持 Bash 的系统 |
|
| ✅ Ubuntu 默认生成 | Ubuntu、Debian |
|
| ✅ 用户级 shell 配置 | 所有支持 Bash 的系统 |
vi /etc/profile
export JAVA_HOME=/opt/module/java #此处是自己实际的Java安装路径
export CLASSPATH=.:\$JAVA_HOME/lib/dt.jar:\$JAVA_HOME/lib/tools.jar
export PATH=\$PATH:\$JAVA_HOME/bin
3、加载环境变量
source /etc/profile
验证环境变量是否生效:
env | grep HOME
env | grep PATH
4、进行校验

二、hadoop的环境搭建
1、hadoop的下载安装
1.1. 下载
https://archive.apache.org/dist/hadoop/common/hadoop-3.2.2/
下载 hadoop-3.2.2.tar.gz 安装包1.2 上传
使用xshell上传到指定安装路径此处是安装路径是 /opt/module
1.3 解压重命名
tar -xzvf hadoop-3.2.2.tar.gz
mv hadoop-3.2.2 hadoop
1.4 配置环境变量
vi /etc/profile
export JAVA_HOME=/opt/module/java
export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export HADOOP_HOME=/opt/module/hadoop
export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/bin:$HADOOP_HOME/sbin
1.5 加载环境变量
source /etc/profile
验证环境变量是否生效:
env | grep HOME
env | grep PATH
1.6检验安装
hadoop version
出现下图说明安装成功
2、配置文件设置
2.1. 配置 hadoop-env.sh
hadoop伪分布式配置
export HADOOP_OS_TYPE=\${HADOOP_OS_TYPE:-\$(uname -s)}
export JAVA_HOME=/opt/module/java#如果不是root用户,则可以省略下面内容
export HDFS_NAMENODE_USER=root
export HDFS_DATANODE_USER=root
export HDFS_SECONDARYNAMENODE_USER=root
export YARN_RESOURCEMANAGER_USER=root
export YARN_NODEMANAGER_USER=root
2.2. 配置 core-site.xml
<configuration>
<!-- 指定HDFS中NameNode的地址 默认 9000端口-->
<property>
<name>fs.defaultFS</name>
<value>hdfs://hadoop001:9000</value>
<description>配置NameNode的URL</description>
</property><!-- 指定Hadoop运行时产生文件的存储目录 -->
<property>
<name>hadoop.tmp.dir</name>
<value>/opt/module/hadoop/data</value>
</property><!-- 配置hive内容(下面要安装hive,因此需要增加下面内容,否则不添加) -->
<!-- 配置允许哪些主机上的程序可以以root身份发起代理请求 -->
<property>
<name>hadoop.proxyuser.root.hosts</name>
<value>*</value>
</property><!-- 配置允许哪些组的用户可以以root身份发起代理请求 -->
<property>
<name>hadoop.proxyuser.root.groups</name>
<value>*</value>
</property><!-- 配置允许哪些具体用户可以以root身份发起代理请求-->
<property>
<name>hadoop.proxyuser.root.users</name>
<value>*</value>
</property>
</configuration>
2.3. 配置 hdfs-site.xml
<configuration>
<!-- 数据的副本数量 如果是完全分布式的集群模式,则改为3 -->
<property>
<name>dfs.replication</name>
<value>1</value>
</property>
<!-- 指定Hadoop运行时产生文件的存储目录 -->
<property>
<name>dfs.namenode.name.dir</name>
<value>/opt/module/hadoop/data/namenode</value>
</property>
<property>
<name>dfs.datanode.data.dir</name>
<value>/opt/module/hadoop/data/datanode</value>
</property>
<!--设置权限为false-->
<property>
<name>dfs.permissions.enabled </name>
<value>false</value>
</property>
<!-- hdfs的web管理页面的端口 -->
<property>
<name>dfs.http.address</name>
<value>hadoop001:9870</value>
</property>
<!-- 设置secondname的端口,如果是完全分布式的集群模式,则改为hadoop003 -->
<property>
<name>dfs.namenode.secondary.http-address</name>
<value>hadoop001:6002</value>
</property>
</configuration>
2.4. 配置 yarn-site.xml
<configuration>
<!-- 指定MR走shuffle -->
<!-- NodeManager 上运行的辅助服务(auxiliary services),用于支持 MapReduce 的 shuffle 阶段 -->
<!-- 必须启用才能让 YARN 支持 MapReduce 的 shuffle 功能 -->
<!-- 如果你使用的是 Spark 或其他框架,可能不需要这个配置 -->
<property>
<name>yarn.nodemanager.aux-services</name>
<value>mapreduce_shuffle</value>
</property>
<!-- 指定ResourceManager的地址-->
<!-- NodeManager 和 ApplicationMaster 会通过该主机名连接到 ResourceManager-->
<property>
<name>yarn.resourcemanager.hostname</name>
<value>hadoop001</value>
</property>
<!-- 环境变量的继承 -->
<!-- 允许传递给容器的环境变量白名单 -->
<!-- 设置哪些环境变量可以从 NodeManager 传递给启动的应用程序容器(Container) -->
<!-- 默认情况下,YARN 容器不会继承所有的系统环境变量 -->
<!-- 为了保证任务能正常运行,需要将必要的环境变量加入白名单 -->
<!-- 常见如 JAVA_HOME、Hadoop 相关路径等,都是应用程序运行所必需的 -->
<property>
<name>yarn.nodemanager.env-whitelist</name>
<value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
</property>
<!--yarn单个容器允许分配的最大最小内存 -->
<!--如果应用请求的内存小于这个值,YARN 会自动将其提升为这个最小值 -->
<!--示例:如果某个任务只申请 100 MB,但设置了最小为 512,则实际分配 512 MB -->
<property>
<name>yarn.scheduler.minimum-allocation-mb</name>
<value>512</value>
</property>
<!--如果应用请求的内存超过这个值,YARN 会拒绝该请求 -->
<!--这个值不能超过 NodeManager 的总内存容量-->
<property>
<name>yarn.scheduler.maximum-allocation-mb</name>
<value>4096</value>
</property>
<!-- yarn容器允许管理的物理内存大小 -->
<!-- 指定当前 NodeManager 节点可提供给容器使用的最大物理内存总量(单位:MB)-->
<!-- 这个值决定了该节点最多能运行多少个容器,取决于每个容器的内存需求。-->
<property>
<name>yarn.nodemanager.resource.memory-mb</name>
<value>4096</value>
</property>
<!-- 关闭yarn对物理内存和虚拟内存的限制检查 -->
<!-- 是否启用对容器使用的物理内存 进行检查 -->
<!-- 设为 true,YARN 会在容器超出其申请的物理内存时终止它 -->
<!-- 防止某些任务占用过多内存导致整个节点崩溃。 -->
<!-- 推荐生产环境中保持为 true。 -->
<property>
<name>yarn.nodemanager.pmem-check-enabled</name>
<value>true</value>
</property>
<!-- 是否开启虚拟内存检查 -->
<!-- 若设为 true,YARN 会检查虚拟内存使用情况并可能杀掉超限任务 -->
<!-- 有时虚拟内存使用较高是正常的(例如 JVM),所以部分场景下建议关闭此功能 设为Flase -->
<property>
<name>yarn.nodemanager.vmem-check-enabled</name>
<value>false</value>
</property>
</configuration>
2.5. 配置 mapred-site.xml
<configuration>
<!-- mr程序默认运行方式。yarn集群模式 local本地模式--><!-- 设置 MapReduce 应用程序的执行框架为 YARN 即 MR运行的资源调度模式-->
<property>
<name>mapreduce.framework.name</name>
<value>yarn</value>
</property><!-- 以下可以不用配置,作为了解内容
当 YARN 启动 MapReduce (ApplicationMaster、MapTask、ReduceTask)进程提供一致的环境变量,确保找到 MapReduce 的依赖库和资源路径。-->
<!-- MR App Master环境变量。用于告诉 ApplicationMaster 去哪里找 MapReduce 相关的 JAR 包或脚本-->
<property>
<name>yarn.app.mapreduce.am.env</name>
<value>HADOOP_MAPRED_HOME=\${HADOOP_HOME}</value>
</property>
<!-- 为每个 MR 的 MapTask 设置环境变量。-->
<property>
<name>mapreduce.map.env</name>
<value>HADOOP_MAPRED_HOME=\${HADOOP_HOME}</value>
</property>
<!-- 为每个 MR 的 ReduceTask 设置环境变量。-->
<property>
<name>mapreduce.reduce.env</name>
<value>HADOOP_MAPRED_HOME=${HADOOP_HOME}</value>
</property>
</configuration>
3、Hdfs格式化
cd /opt/module/hadoop/
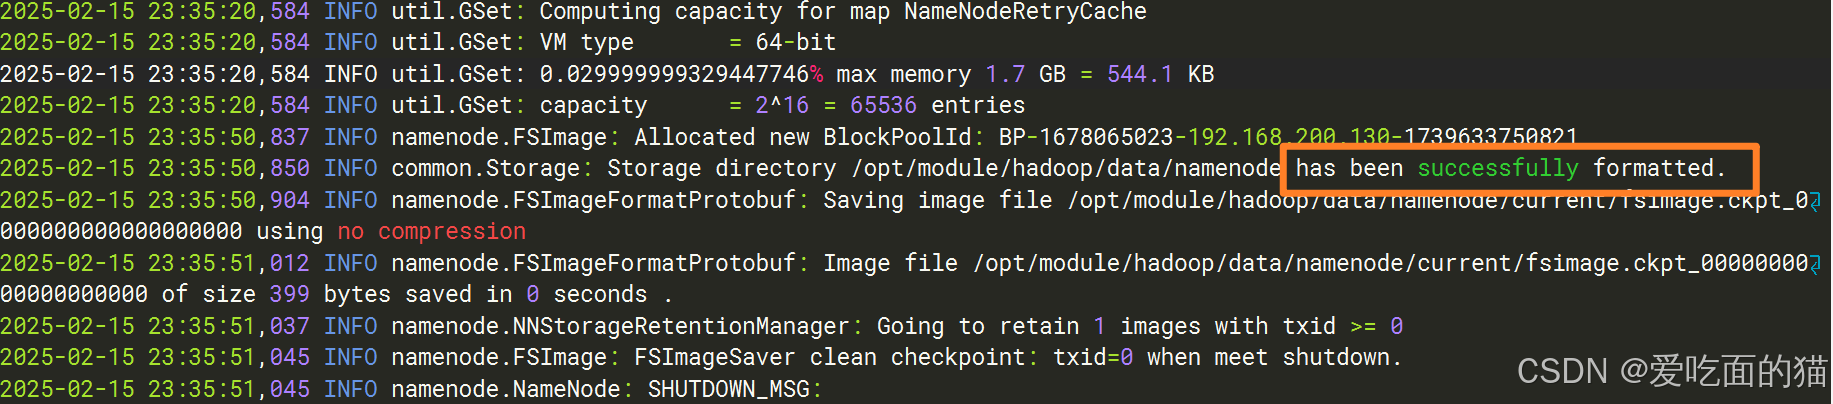
bin/hdfs namenode -format
下图表示初始化成功
4、启动hdfs
启动hdfs分布式文件系统
cd /opt/module//hadoop/sbin
>> start-dfs.sh
使用 jps 查看启动进程

5、访问HDFS系统
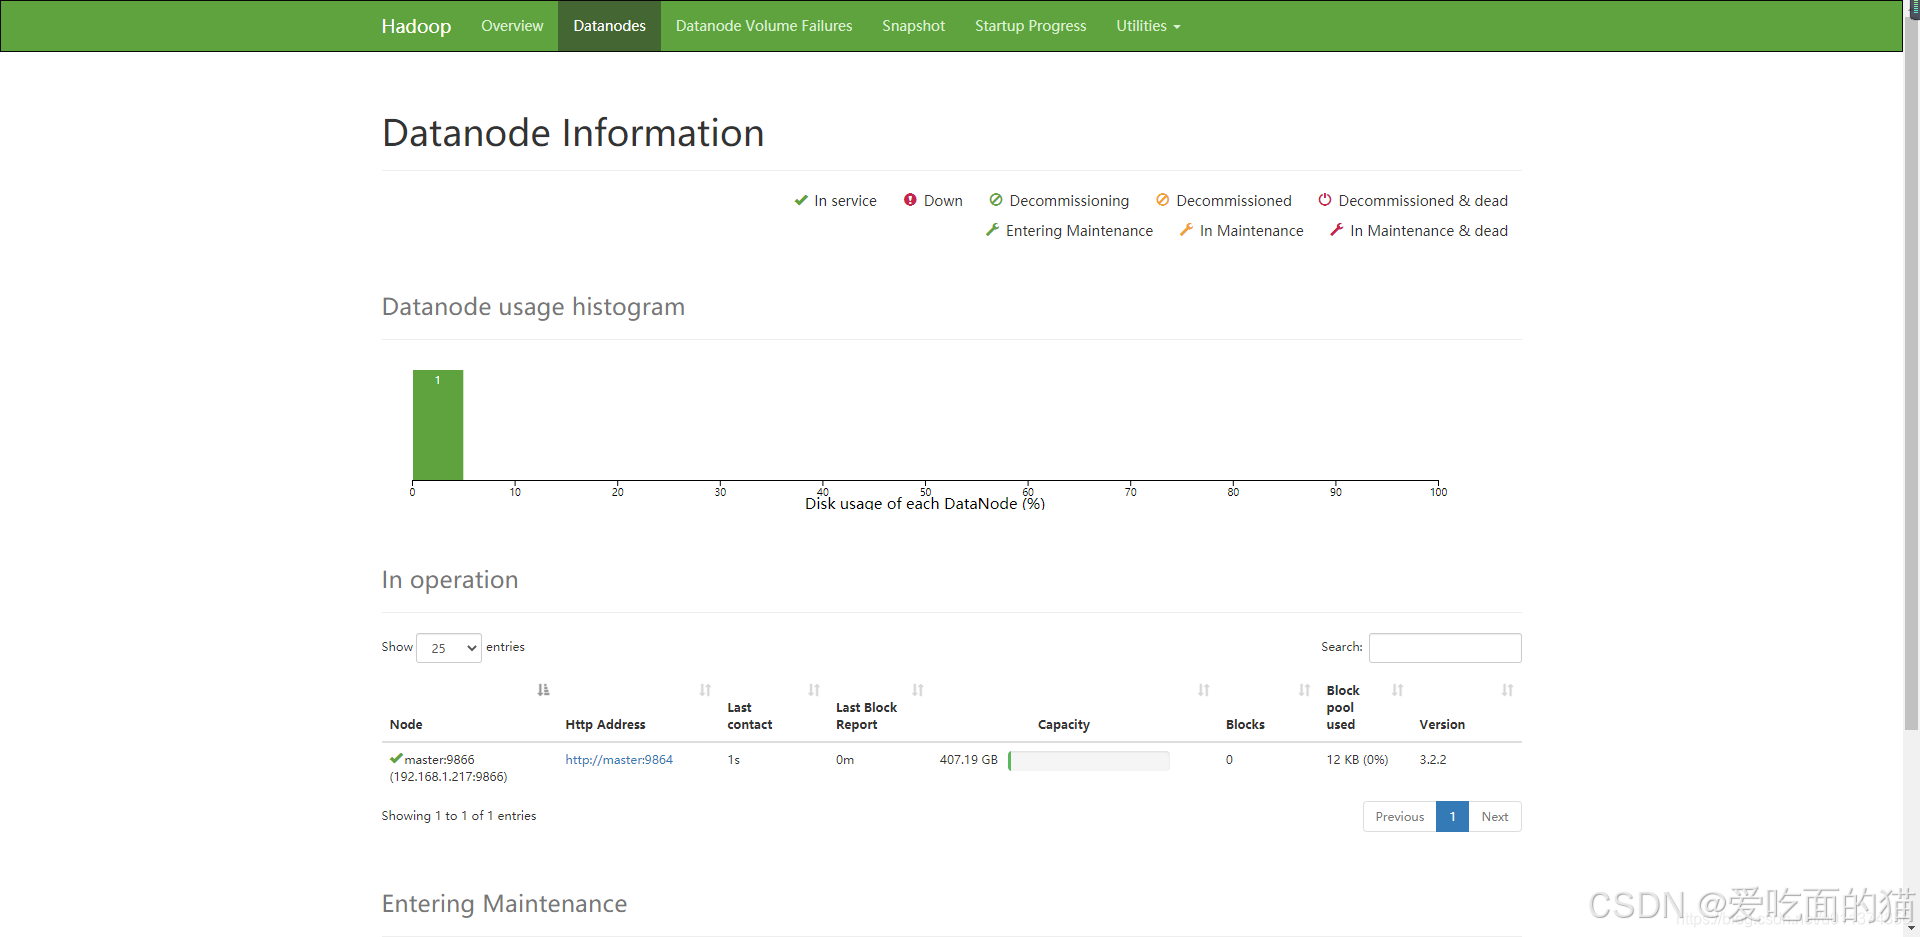
访问HDFS分布式文件系统的web页面,如:http://192.168.200.130:9870/
6、启动yarn
启动Yarn进程。
cd /opt/module/hadoop/sbin
>> start-yarn.sh
使用 jps 查看启动进程
7、访问Yarn平台页面
访问hadoop分布式yarn页面,如:http://192.168.200.130:8088/
到此为主,hadoop的伪分布式搭建完成。
-----------------------------------------------------------------------------------------------------------------------
8、Hadoop的集群模式
8.1.集群规划
| 模块 | hadoop001 | hadoop002 | hadoop003 |
| HDFS子进程 | NameNode DataNode | DataNode | SecondaryNameNode DataNode |
| YARN子进程 | NodeManager | ResourceManager NodeManager | NodeManager |
8.2克隆虚拟机
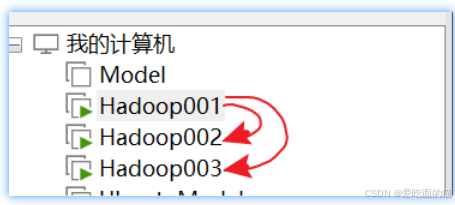
克隆hadoop001 为 hadoop002、hadoop003
8.3修改克隆虚拟机IP
步骤同前期准的步骤1-3
此案例中网卡是 ens33
修改:hadoop002
sed -i 's/^IPADDR=".*"/IPADDR="192.168.200.142"/' /etc/sysconfig/network-scripts/ifcfg-ens33
systemctl restart network修改:hadoop003
sed -i 's/^IPADDR=".*"/IPADDR="192.168.200.143"/' /etc/sysconfig/network-scripts/ifcfg-ens33
systemctl restart network
8.4设置集群免密
在hadoop001节点执行:
sshpass -p "root" ssh-copy-id -o StrictHostKeyChecking=no root@hadoop002
sshpass -p "root" ssh-copy-id -o StrictHostKeyChecking=no root@hadoop003
8.5设置主机名
设置 hadoop002、hadoop003 的主机名
在hadoop001节点执行:
ssh root@192.168.200.142 "hostnamectl set-hostname hadoop002; hostname"
ssh root@192.168.200.143 "hostnamectl set-hostname hadoop003; hostname"验证
ssh hadoop002
8.5.修改hdfs-site.xml
修改主节点hadoop001机数据的副本数量
secondname的主机设置(可选)
<!-- 数据的副本数量 改为3 -->
<property>
<name>dfs.replication</name>
<value>3</value>
</property><!--可选 对于学习来说,可以不改。但实际生产过时会将其规划到 hadoop003 -->
<!-- 设置secondname的端口,完全分布式的集群模式,改为hadoop003 -->
<property>
<name>dfs.namenode.secondary.http-address</name>
<value>hadoop003:6002</value>
</property>
8.6.修改workers
将主节点hadoop001原来的workers中的localhost改为节点主机名
echo '' > \$HADOOP_HOME/etc/hadoop/workers
cat $HADOOP_HOME/etc/hadoop/workers << "EOF"
hadoop001
hadoop002
hadoop003
EOF
8.7.修改mapred-site.xml
修改主节点hadoop001的mapred-site.xml配置历史服务器(可选)
<!-- 历史服务器端地址 -->
<property>
<name>mapreduce.jobhistory.address</name>
<value>hadoop001:10020</value>
</property>
<!-- 历史服务器web端地址 -->
<property>
<name>mapreduce.jobhistory.webapp.address</name>
<value>hadoop001:19888</value>
</property>
8.8.修改yarn-site.xml
修改主节点hadoop001的yarn-site.xml,指定ResourceManager的地址:对于目前初学者来说可以做修改,但在实际生产过程中 resourcemanager 和 namenode是在不同主机上,避免生产过程中资源不足导致内存溢出情况。
指定ResourceManager的地址(可选,但生产环境要修改)
配置日志的聚集(可选)
<!-- 可选 指定ResourceManager的地址-->
<!-- NodeManager 和 ApplicationMaster 会通过该主机名连接到 ResourceManager-->
<property>
<name>yarn.resourcemanager.hostname</name>
<value>hadoop002</value>
</property><!-- 可选 开启日志聚集功能 -->
<property>
<name>yarn.log-aggregation-enable</name>
<value>true</value>
</property>
<!-- 可选 设置日志聚集服务器地址 -->
<property>
<name>yarn.log.server.url</name>
<value>http://hadoop001:19888/jobhistory/logs</value>
</property>
<!-- 可选 设置日志保留时间为7天 -->
<property>
<name>yarn.log-aggregation.retain-seconds</name>
<value>604800</value>
</property>
8.9.分发文件
注意:在分发文件前要做好三台机器的IP与主机名映射 /etc/hosts
进行分发文件
scp -r /opt/module/hadoop/etc/hadoop/workers root@hadoop002:/opt/module/hadoop/etc/hadoop
scp -r /opt/module/hadoop/etc/hadoop/workers root@hadoop003:/opt/module/hadoop/etc/hadoop
# 下面配置如果不修改,则不需分发
scp -r /opt/module/hadoop/etc/hadoop/hdfs-site.xml root@hadoop002:/opt/module/hadoop/etc/hadoop
scp -r /opt/module/hadoop/etc/hadoop/hdfs-site.xml root@hadoop003:/opt/module/hadoop/etc/hadoop
scp -r /opt/module/hadoop/etc/hadoop/mapred-site.xml root@hadoop002:/opt/module/hadoop/etc/hadoop
scp -r /opt/module/hadoop/etc/hadoop/mapred-site.xml root@hadoop003:/opt/module/hadoop/etc/hadoop
scp -r /opt/module/hadoop/etc/hadoop/yarn-site.xml root@hadoop002:/opt/module/hadoop/etc/hadoop
scp -r /opt/module/hadoop/etc/hadoop/yarn-site.xml root@hadoop003:/opt/module/hadoop/etc/hadoop让三台机器文件生效
ssh hadoop001;source /etc/profile
ssh hadoop002;source /etc/profile
ssh hadoop003;source /etc/profilessh hadoop001;
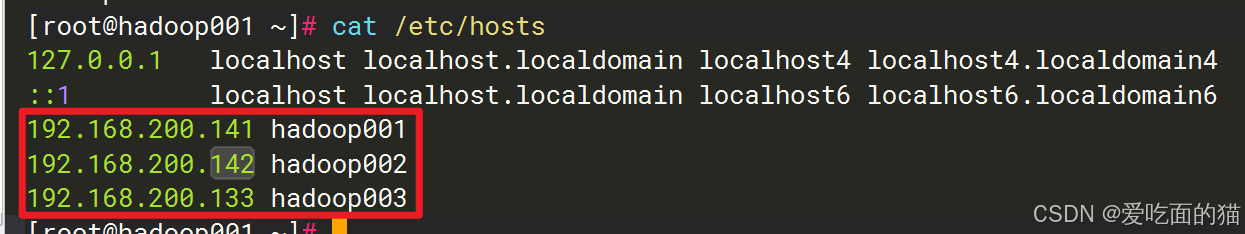
8.8.集群初始化
停止hadoop001的hadoop服务
cd /opt/module/hadoop/sbin
>> stop-all.sh
删除格式化后的目录重新格式化
rm -rf /opt/module/hadoop/data
rm -rf /opt/module/hadoop/logs/*
/opt/module/hadoop/bin/hdfs namenode -format
8.9.集群启动
在hadoop001 上启动HDFS
------------------------------------
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
或者
$HADOOP_HOME/sbin/start-all.sh
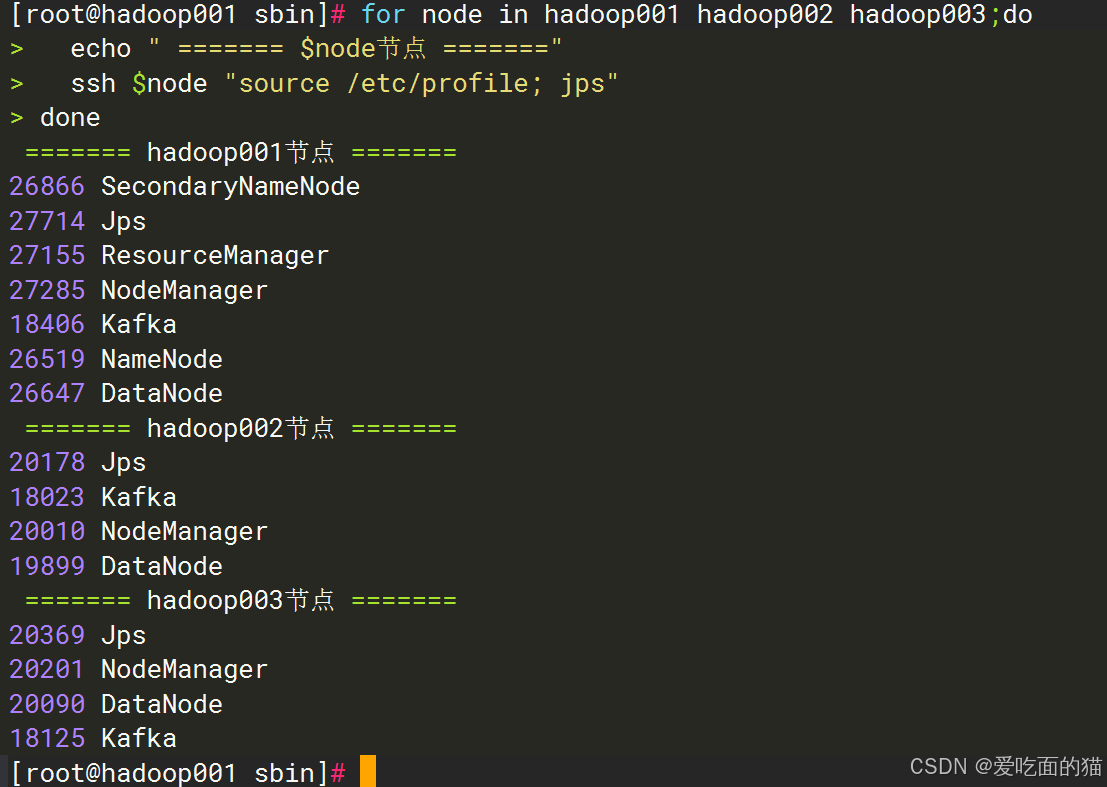
8.10 状态查看
在hadoop001 上执行
------------------------------------
for node in hadoop001 hadoop002 hadoop003;do
echo " ======= $node节点 ======="
ssh $node "source /etc/profile; jps"
done
三、msyql安装
3.1 规划目录
安装包:mysql-8.0.30-linux-glibc2.12-x86_64.tar.xz
规划目录:
软件目录:/opt/module/mysql
数据目录:/opt/module/mysql/data
日志目录:/opt/module/mysql/log
步骤 1:上传压缩包,解压
# 上传解压
cd /opt/module
tar -Jxvf mysql-8.0.30-linux-glibc2.12-x86_64.tar.xz# 重命名
mv mysql-8.0.30-linux-glibc2.12-x86_64 mysql# 创建必须目录
mkdir -p /opt/module/mysql/data
mkdir -p /opt/module/mysql/log
3.2 安装
步骤 1:上传压缩包,解压
# 上传解压
cd /opt/module
tar -Jxvf mysql-8.0.30-linux-glibc2.12-x86_64.tar.xz# 重命名
mv mysql-8.0.30-linux-glibc2.12-x86_64 mysql# 创建必须目录
mkdir -p /opt/module/mysql/data
mkdir -p /opt/module/mysql/log
3.3 配置环境变量
步骤 2:配置环境变量/etc/profile
vi /etc/profile# MySQL8.0
export MYSQL_HOME=/opt/module/mysql
export PATH=\$PATH:$MYSQL_HOME/bin#生效并验证
source /etc/profile
echo \$MYSQL_HOME
3.4 配置mysql文件
步骤 3:创建 my.cnf 配置文件(重要!普通用户必须自定义配置)
❗不要用 /etc/my.cnf(需要 root 权限)
使用目录内自定义配置 \$MYSQL_HOME/my.cnf
vi \$MYSQL_HOME/my.cnf
[mysqld]
# ============== 基础路径配置(服务端核心路径) =============
# MySQL程序根目录,存放bin、lib、share等程序文件
basedir = /opt/module/mysql# 数据存放目录:所有数据库、表、索引、ibd文件都在这里
datadir = /opt/module/mysql/data# Unix本地通信套接字文件
# 本地连接mysql时不经过网络,走这个文件;远程TCP 3306不使用sock
socket = /opt/module/mysql/mysql.sock# mysqld进程启动后,把进程PID写入这个文件,方便stop脚本杀死进程
pid-file = /opt/module/mysql/mysql.pid# ===================== 网络与运行用户 =====================
# MySQL监听端口,默认3306
port=3306# mysqld进程以哪个系统用户运行
# ⚠️重点:你这里写 user=hwadee
# 说明启动mysql进程的操作系统用户是hwadee
# data、log、mysql根目录所有文件夹必须赋予 hwadee 读写权限!
# 很多启动失败报错:Permission denied 都是这里目录权限不匹配!
user=root# ===================== 字符集配置(推荐utf8mb4) =====================
# 服务端默认字符集,utf8mb4支持emoji表情,mysql原生utf8不支持
character-set-server=utf8mb4
# 默认排序、比较规则(大小写不敏感,通用推荐)
collation-server=utf8mb4_unicode_ci# ===================== 错误日志 =====================
# 数据库启动崩溃、sql报错、启动警告全部输出到此日志
log_error = /opt/module/mysql/log/error.log
# ⚠️注意:log目录必须手动提前创建!mysql不会自动新建文件夹!# ===================== 远程访问关键配置 =====================
# bind-address=0.0.0.0
# 含义:监听服务器**所有网卡IP**,允许其他机器远程连接
# 如果写 127.0.0.1,只能本机访问,外部无法连接
bind-address = 0.0.0.0# ============= MySQL8.0 登录认证(重中之重) ================
# MySQL8默认加密方式:caching_sha2_password
# Navicat旧版本、很多客户端不支持这种加密,会报:无法连接/认证插件异常
# 修改默认认证插件为 mysql_native_password(传统加密,所有客户端兼容)
default_authentication_plugin=mysql_native_password[mysql]
# 这一段是【客户端配置】,只对 mysql 命令行工具生效
# mysql -uroot -p 这个命令读取下面配置,不影响后台mysqld服务# 客户端本地连接优先使用这个sock文件
socket = /opt/module/mysql/mysql.sock
# 客户端默认字符集
default-character-set=utf8mb4
3.5 初始化数据库
步骤 4:初始化数据库(关键命令)
#MySQL8.0 初始化命令 mysqld --initialize
cd \$MYSQL_HOME
mysqld --defaults-file=./my.cnf --initialize
#执行成功后,查看 error.log 拿到临时 root 密码
grep 'temporary password' $MYSQL_HOME/log/error.log
如果报错:libaio 缺失,安装依赖(需要 sudo)
sudo yum install -y libaio-devel libaio
3.6 设置开机自启
步骤5:设置开机自启
sudo vi /etc/systemd/system/mysql8.service
注意下面如果是普通用户则root改为普通用户名如 User=hwadee
--------------------------------------------[Unit]
Description=MySQL 8.0.30 (root)
After=network.target[Service]
User=root
Group=root
Type=simple
ExecStart=/opt/module/mysql/bin/mysqld --defaults-file=/opt/module/mysql/my.cnf
ExecStop=/opt/module/mysql/bin/mysqladmin -S /opt/module/mysql/mysql.sock -uroot -proot shutdown
Restart=no[Install]
WantedBy=multi-user.target
----------------------------------------------
# 设置开机自启
sudo systemctl daemon-reload
sudo systemctl enable mysql8
# 操作命令
sudo systemctl start mysql8
sudo systemctl status mysql8
3.7 登录授权
步骤 6:登录数据库
# 输入刚刚获取的临时密码,执行 SQL 修改密码
mysql -S /opt/module/mysql/mysql.sock -uroot -p
步骤 7:修改密码
alter user "root"@"localhost" identified by "root";
use mysql;
UPDATE user SET authentication_string="" WHERE user="root";
FLUSH PRIVILEGES;
update user set Host="%" where User="root";
flush privileges;
alter user "root"@"%" identified by "root";
flush privileges;
步骤 8:授权
use mysql;
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY 'root';
flush privileges;
3.8 远程连接
步骤 9:远程连接
安装 database tool and Sql webstorm
连接 数据库 ip 用户名 密码 数据库名
四、Hive安装
1、下载安装
1.1下载
下载地址:Index of /dist/hive
我们选择apache-hive-3.1.3-bin.tar.gz版本学习
1.2 上传
1.3 解压重命名
2、配置环境变量
vi /etc/profile
export HIVE_HOME=/opt/lmodule/hiveexport PATH=\$PATH:$HIVE_HOME/bin
刷新配置
source /etc/profile
3、配置文件
3.1 配置hive-env.sh (位置:/opt/mudule/hive/conf)
# Set HADOOP_HOME to point to a specific hadoop install directory
export HADOOP_HOME=/opt/module/hadoop# Hive Configuration Directory can be controlled by:
export HIVE_CONF_DIR=/opt/module/hive/conf#Folder containing extra libraries required for hive compilation/execution can be controlled:
export HIVE_AUX_JARS_PATH=/opt/module/hive/lib
3.2 配置hive-site.xml (位置:/opt/mudule/hive/conf) (直连模式配置)
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
<!--MySQL信息-->
<!--数据库连接地址配置-->
<property>
<name>javax.jdo.option.ConnectionURL</name><!--注意:下面的&要变为“&加上amp;” 形式-->
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true</value>
</property>
<!--数据库驱动配置注意:mysql5.x与mysql8.x不同-->
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
</property>
<!--Hive表数据存储在HDFS路径-->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<!--hive的临时数据目录,指定的位置在hdfs上的目录可以不指定有默认目录-->
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property><!-- 直接连接模式使用下面配置,初学者推荐
用户可以通过客户端hive访问 hiveserver2 调用 hiveserver2的内部MetaStore服务
-->
<!--指定HiveServer2所在的host,改为自己主机名-->
<property>
<name>hive.server2.thrift.bind.host</name>
<value>hadoop001</value>
</property>
<!--指定HiveServer2所在的端口hs2端口默认是10000-->
<property>
<name>hive.server2.thrift.port</name>
<value>10000</value>
</property>
<!--不强制执行Metastore模式版本的一致性检查,默认值是true-->
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property><!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
<description>Whether to automatically switch to local mode if the input file size is below threshold.</description>
</property>
<!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto.inputbytes.max</name>
<value>50000000</value>
<description>Maximum input size (in bytes) for auto-local mode.</description>
</property>
<!-- 设置最大输入文件数量(5个) -->
<property>
<name>hive.exec.mode.local.auto.input.files.max</name>
<value>5</value>
<description>Maximum number of input files for auto-local mode.</description>
</property>
</configuration>
说明:
当执行一些复杂sql会报错,下面是问题和解决方案
问题:
Query ID = root_20230914161708_a293bd1f-62bb-4a28-a477-97f71fc745b4
Total jobs = 3
Launching Job 1 out of 3
Number of reduce tasks determined at compile time: 1
In order to change the average load for a reducer (in bytes):
set hive.exec.reducers.bytes.per.reducer=<number>
In order to limit the maximum number of reducers:
set hive.exec.reducers.max=<number>
In order to set a constant number of reducers:
set mapreduce.job.reduces=<number>
前面配置的一下几项是解决问题的配置;
<!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
<description>Whether to automatically switch to local mode if the input file size is below threshold.</description>
</property>
<!-- 设置输入数据量最大字节数(50MB) -->
<property>
<name>hive.exec.mode.local.auto.inputbytes.max</name>
<value>50000000</value>
<description>Maximum input size (in bytes) for auto-local mode.</description>
</property>
<!-- 设置最大输入文件数量(5个) -->
<property>
<name>hive.exec.mode.local.auto.input.files.max</name>
<value>5</value>
<description>Maximum number of input files for auto-local mode.</description>
</property>
配置hive-log4j2.properties (位置:/opt/mudule/hive/conf)
此步骤可以跳过,不配置也可以。
cd /opt/mudule/hive/conf
cp hive-log4j2.properties.template hive-log4j2.properties
vi hive-log4j2.properties
property.hive.log.dir = /opt/module/hive/logs
4、拷贝jar包
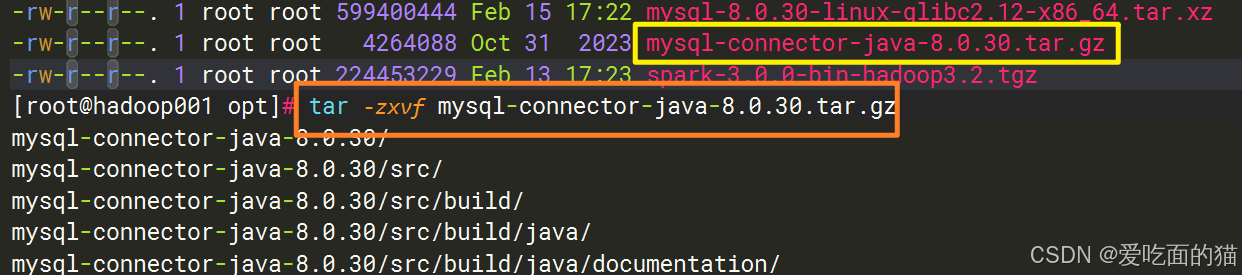
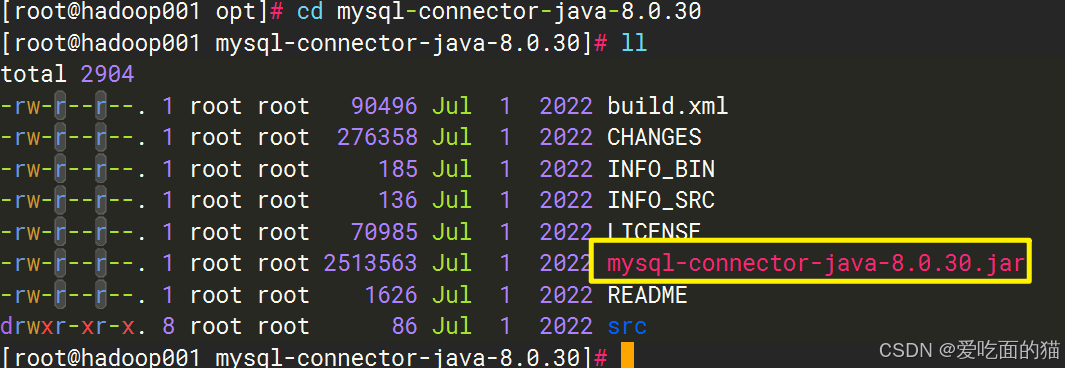
4.1 解压驱动(如果有jar包,直接上传此步省略)
需要提前现在对应的驱动包,并解压
4.2 拷贝mysql驱动
cp mysql-connector-java-8.0.30.jar /opt/module/hive/lib/
4.2 拷贝guava包
#hadoop和hive里面的guava包版本可能不一致,那么用hadoop里面的覆盖掉hive里面的
cp /opt/module/hadoop/share/hadoop/common/lib/guava-27.0-jre.jar /opt/module/hive/lib/#删除hive的旧依赖包:
rm -rf /opt/module/hive/lib/guava-19.0.jar
4.3 删除 hive中的 log4j
删除 Hive 的lib目录中包含log4j-slf4j-impl-2.17.1.jar
rm -rf /opt/module/hive/lib/log4j-slf4j-impl-2.17.1.jar
5、初始化
5.1 启动msyql
# 先查看mysql是否启动
sudo systemctl status mysql
#未启动则进行启动
service mysql start
5.2 启动hadoop
#进入hadoop安装目录启动hadoop
cd /opt/module/hadoop/
sbin/start-all.sh
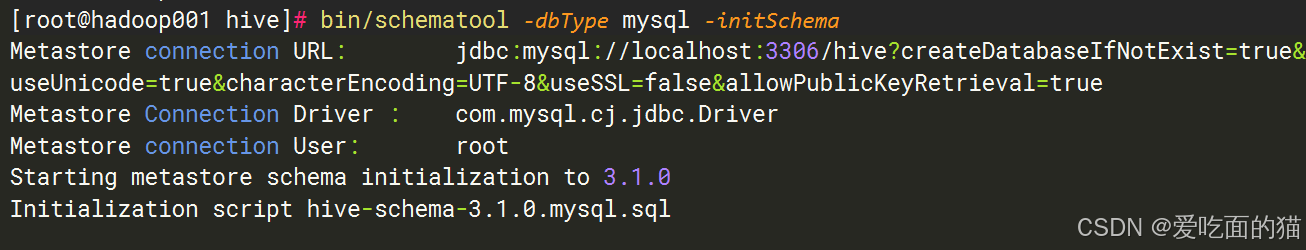
5.3 初始化hive
#进入hive安装目录
cd /opt/module/hive
#执行初始化命令,#初始化Hive
bin/schematool -dbType mysql -initSchema
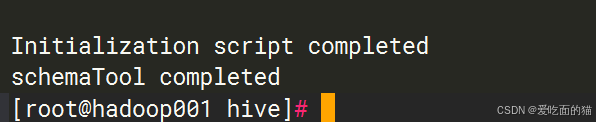
初始化成功
6、启动hive
启动hive
# 启动HiveServer2(直连模式只需启动这一个服务,无需启动MetaStore)
hive --service hiveserver2 > $HIVE_HOME/hiveserver2.log 2>&1 &验证测试:
jps | grep HiveServer2
netstat -nlp | grep 10000
7、测试
测试连接:
#进入hive安装目录
cd /opt/module/hive
beeline
beeline> !connect jdbc:hive://hadoop001:10000
# 用户名输入 root,密码直接回车(留空)# 测试命令 show databases; create table remote_test (id int, name string) row format delimited fields terminated by '\t'; insert into remote_test values (1, 'remote'), (2, 'mode'); select * from remote_test;#测试:
-- 1. 数据库准备
CREATE DATABASE IF NOT EXISTS career_dw
COMMENT '职业分析数据仓库'
LOCATION '/user/hive/warehouse/career_dw.db';
USE career_dw;
-- 2.1 ods_job_info (分区表: dt)
DROP TABLE IF EXISTS tmp_ods_job_info_csv;
CREATE TABLE tmp_ods_job_info_csv (
job_id STRING,
title STRING,
city STRING,
district STRING,
edu_level STRING,
work_years STRING,
salary_min DECIMAL(10,2),
salary_max DECIMAL(10,2),
company_name STRING,
company_scale STRING,
company_industry STRING,
publish_time STRING,
crawl_time STRING,
etl_time STRING
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
LINES TERMINATED BY '\n'
STORED AS TEXTFILE;
-- 在插入前,先重置这些设置,如果是动态分区则改为true和nostrict
SET hive.exec.dynamic.partition = false;
SET hive.exec.dynamic.partition.mode = strict;
SET hive.map.aggr = false;
SET hive.groupby.skewindata = false;
set hive.exec.mode.local.auto=false;
set mapreduce.framework.name=yarn;
-- 然后执行INSERT
INSERT INTO tmp_ods_job_info_csv VALUES ('1002', 'Java后端开发', '上海', '浦东新区', '本科', '1-3年', 18.00, 30.00, '阿里巴巴', '10000人以上', '电子商务', '2026-08-06', '2026-08-07 15:30:00', '2026-08-07 15:30:00');
五、元数据访问配置(初学者忽略)
与 上面 Hive安装 所有安装步骤相同, 不同的是配置文件。
序号 连接组合 需要启动服务 是否支持远程连接 推荐度 进入方式 1 Hive CLI + Hive CLI 内嵌 MetaStore 无需启动metastore服务,直接 hive ❌ 本地专用
无需hive.metastore.uris
⭐ bin/hive 2 Hive CLI + 本地 MetaStore 无需启动metastore服务,直接 hive ❌ 本地专用
配置 hive.metastore.uris
⭐⭐ bin/hive 3 Hive CLI + 独立远程 MetaStore metastore ❌ 本地专用 需要配置 hive.metastore.uris
通过 thrift 访问独立 metastore 进程⭐⭐⭐ 4 Beeline + HS2 + HS2 内嵌 MetaStore hiveserver2 ✅ 支持远程
不配置
hive.metastore.uris
无 uris 才会启用 HS2 内部内嵌元存储⭐(不推荐) 5 Beeline + HS2 + 独立远程 MetaStore metastore + hiveserver2 ✅ 支持远程
需要配置
标准生产架构,HS2 通过 uri 连接独立 metastore⭐⭐⭐⭐⭐
方式1:内嵌metastore方式(了解)
使用metastore内嵌方式访问元数据,则无需安装mysql和配置mysql,直接使用内嵌derby数据库,不需要启动 hiveserver2 服务和配置hiveserver2服务,无需配置和启动 Metastore ,直接进入bin目录执行 hive命令即可。内嵌 Metastore 进程由 Hive CLI 客户端创建。
执行只需要在 bin 目录下执行 hive命令即可。
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
<!--Hive表数据存储在HDFS路径-->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<!--hive的临时数据目录,指定的位置在hdfs上的目录可以不指定有默认目录-->
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property>
<!--不强制执行Metastore模式版本的一致性检查,默认值是true-->
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property><!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
<description>Whether to automatically switch to local mode if the input file size is below threshold.</description>
</property>
</configuration>
方式2: 本地MetaStore方式(了解)
使用本地metastor方式访问元数据,需安装mysql和配置mysql,不需要启动 HiveServer2 服务和配置 HiveServer2,不需要配置和启动独立的 Metastore 服务,内嵌 Metastore 进程由 Hive CLI 客户端创建,直接进入bin目录执行 hive命令即可。
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration><!--MySQL信息-->
<!--数据库连接地址配置-->
<property>
<name>javax.jdo.option.ConnectionURL</name><!--注意:下面的&要变为“&加上amp;” 形式-->
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true</value>
</property>
<!--数据库驱动配置注意:mysql5.x与mysql8.x不同-->
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
</property><!-- ========== 通用配置 ========== --><!--Hive表数据存储在HDFS路径-->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<!--hive的临时数据目录,指定的位置在hdfs上的目录可以不指定有默认目录-->
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property><!-- ========== 其他配置(指向 Metastore 服务 ========== --><!--不强制执行Metastore模式版本的一致性检查,默认值是true-->
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property><!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
<description>Whether to automatically switch to local mode if the input file size is below threshold.</description>
</property>
</configuration>
方式3: 独立MetaStore方式(推荐学习使用)
使用独立metasto嵌方式访问元数据,需安装mysql和配置mysql,不需要启动 HiveServer2 服务和配置 HiveServer2,需要配置和启动独立的 Metastore 服务。
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<configuration>
<!-- ========== MySQL 元数据库连接 ========== -->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
</property><!-- ========== Metastore 服务配置 ========== -->
<!-- Metastore进程对外公布的地址 客户端使用连接-->
<property>
<name>hive.metastore.uris</name>
<value>thrift://hadoop001:9083</value>
</property>
<!-- Metastore 进程绑定的地址 服务端自己使用 -->
<property>
<name>hive.metastore.bind.host</name>
<value>hadoop001</value>
</property>
<!-- Metastore 服务端口 实际监听的端口服务端自己使用 -->
<property>
<name>hive.metastore.port</name>
<value>9083</value>
</property>
<!-- ========== 通用配置 ========== -->
<!--Hive表数据存储在HDFS路径-->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<!--hive的临时数据目录,指定的位置在hdfs上的目录可以不指定有默认目录-->
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property>
<!-- ========== 其他配置(指向 Metastore 服务 ========== -->
<!--不强制执行Metastore模式版本的一致性检查,默认值是true-->
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
<!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
<description>Whether to automatically switch to local mode if the input file size is below threshold.</description>
</property>
</configuration>
启动 Metastore 服务
# 使用您的配置文件
# 在 hadoop001 上启动 Metastore 服务
nohup hive --service metastore > $HIVE_HOME/metastore.log 2>&1 &# 验证服务启动成功
jps | grep -i metastore
# 输出:12345 Metastorenetstat -tlnp | grep 9083
# 输出:tcp 0 0 0.0.0.0:9083 0.0.0.0:* LISTEN 12345/java
启动 Hive CLI
# 直接执行 hive 命令
hive# 测试连接
hive> show databases;
hive> show tables;
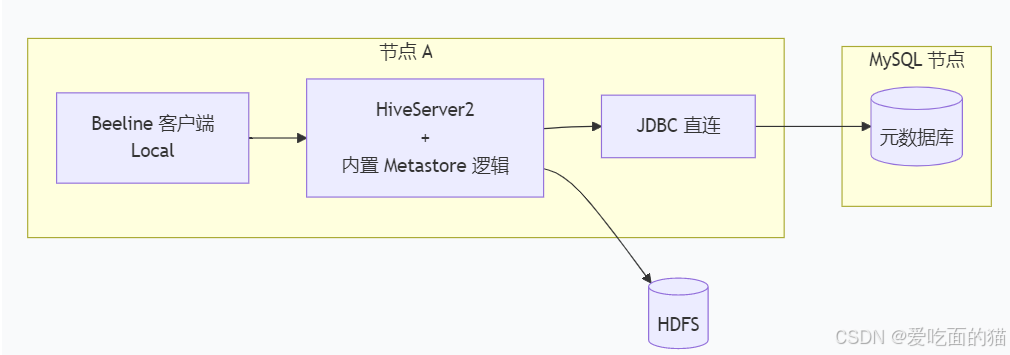
方式4:HS2 + 内嵌MetaStore方式(学习、上课使用)
前面的hive安装过程中的配置使用的就是此方式
需安装mysql和配置mysql,需要启动 HiveServer2 服务和配置 HiveServer2,无需要配置和启动独立的 Metastore 服务,启动 HiveServer2 会内嵌MetaStore进程。 bin/hive 和 beenline都是通过 HiveServer2 进程访问 MetaStore。
访问方式:可以使用 bin/hive 通过Thrift协议访问 HiveServer2,HiveServer2访问Metastore 服务
可以使用beenline 通过JDBC访问 HiveServer2 ,HiveServer2访问Metastore 服务
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<configuration>
<!-- ========== MySQL 元数据库连接 ========== -->
<!-- HiveServer2 内部会启动内嵌 Metastore,直连 MySQL -->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
</property><!-- ========== HiveServer2 配置 ========== -->
<!-- HiveServer2 绑定地址 HiveServer2进程自己使用-->
<property>
<name>hive.server2.thrift.bind.host</name>
<value>hadoop001</value>
</property>
<!-- HiveServer2 端口 HiveServer2进程自己使用-->
<property>
<name>hive.server2.thrift.port</name>
<value>10000</value>
</property>
<!-- 认证方式(测试环境用 NONE) -->
<property>
<name>hive.server2.authentication</name>
<value>NONE</value>
</property><!-- ========== 通用配置 ========== -->
<!-- Hive 数据仓库在 HDFS 的存储路径 -->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<!-- Hive 临时数据目录 -->
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property>
<!-- 不强制执行 Metastore 版本检查 -->
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property><!-- ========== 本地模式优化(可选) ========== -->
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
</property>
</configuration>
启动 HiveServer2 服务
# 启动 HiveServer2(内部会自动启动内嵌 Metastore)
nohup hive --service hiveserver2 > $HIVE_HOME/hiveserver2.log 2>&1 &# 验证服务启动
netstat -tlnp | grep 10000
# tcp 0 0 0.0.0.0:10000 0.0.0.0:* LISTEN 12345/java
Hive CLI 访问
# 直接执行 hive 命令
hive# 测试连接
hive> show databases;
hive> show tables;
Hive beenline 访问
#直接
beeline -u "jdbc:hive2://hadoop001:10000"或者
# 直接执行 beenline 命令
beenline
beeline> !connect jdbc:hive2://hadoop001:10000
方式5:HS2 + 独立MetaStore方式(生产使用推荐)
需安装mysql和配置mysql
需要启动 HiveServer2 服务和配置 HiveServer2,
需要启动 Metastore 服务和配置 Metastore,
bin/hive 和 beenline都是通过 HiveServer2 进程访问 MetaStore。
访问方式:可以使用 bin/hive 通过Thrift协议访问 HiveServer2,HiveServer2访问Metastore 服务
可以使用beenline 通过JDBC访问 HiveServer2 ,HiveServer2访问Metastore 服务
1.1 HS2 + 独立MetaStore在同一服务器
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<configuration>
<!-- ========== MySQL 元数据库连接(Metastore 服务端使用) ========== -->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
</property><!-- ========== Metastore 服务配置 ========== -->
<!-- 对外公布的地址(客户端/HS2 使用) -->
<property>
<name>hive.metastore.uris</name>
<value>thrift://hadoop001:9083</value>
</property>
<!-- 服务绑定地址(Metastore 自己使用) -->
<property>
<name>hive.metastore.bind.host</name>
<value>hadoop001</value>
</property>
<!-- 服务端口(Metastore 自己使用) -->
<property>
<name>hive.metastore.port</name>
<value>9083</value>
</property><!-- ========== HiveServer2 配置 ========== -->
<!-- HS2 绑定地址 -->
<property>
<name>hive.server2.thrift.bind.host</name>
<value>hadoop001</value>
</property>
<!-- HS2 端口 -->
<property>
<name>hive.server2.thrift.port</name>
<value>10000</value>
</property>
<!-- 认证方式(测试环境) -->
<property>
<name>hive.server2.authentication</name>
<value>NONE</value>
</property><!-- ========== 通用配置 ========== -->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property>
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
</property>
</configuration>
启动命令(同一台机器)
# 1. 先启动 Metastore 服务
hive --service metastore &nohup hive --service metastore> $HIVE_HOME/metastore.log 2>&1 &
# 2. 再启动 HiveServer2 服务
nohup hive --service hiveserver2 > $HIVE_HOME/hiveserver2.log 2>&1 &
# 3. 验证服务
netstat -tlnp | grep -E "(9083|10000)"
# tcp 0 0 0.0.0.0:9083 0.0.0.0:* LISTEN 12345/java (Metastore)
# tcp 0 0 0.0.0.0:10000 0.0.0.0:* LISTEN 12346/java (HS2)# 4. 使用 Beeline 连接
beeline -u "jdbc:hive2://hadoop001:10000"
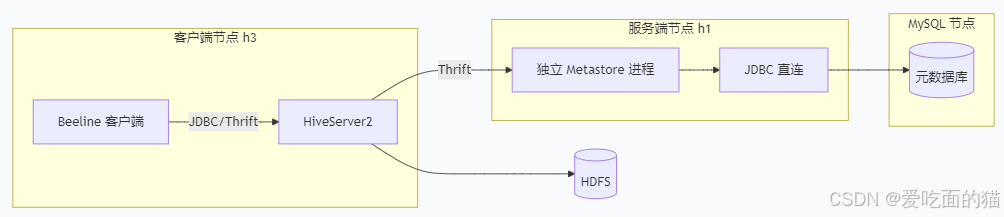
1.2 HS2 + 独立MetaStore在不同服务器
Metastore 服务端配置 (hadoop001)
/opt/hive/conf/hive-site.xml
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<configuration>
<!-- ========== MySQL 元数据库连接 ========== -->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
</property><!-- ========== Metastore 服务配置 ========== -->
<!-- 对外公布的地址(HS2 使用这个地址连接) -->
<property>
<name>hive.metastore.uris</name>
<value>thrift://hadoop001:9083</value>
</property>
<!-- 服务绑定地址(Metastore 自己使用) -->
<property>
<name>hive.metastore.bind.host</name>
<value>hadoop001</value>
</property>
<!-- 服务端口(Metastore 自己使用) -->
<property>
<name>hive.metastore.port</name>
<value>9083</value>
</property><!-- ========== 通用配置 ========== -->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property>
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
</configuration>
启动命令(hadoop001):
# 初始化元数据库(首次)
schematool -dbType mysql -initSchema# 启动 Metastore 服务
nohup hive --service metastore > $HIVE_HOME/metastore.log 2>&1 &# 验证
netstat -tlnp | grep 9083
# tcp 0 0 0.0.0.0:9083 0.0.0.0:* LISTEN 12345/java
HiveServer2 服务端配置 (hadoop002)
/opt/hive/conf/hive-site.xml
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<configuration>
<!-- ========== 连接远程 Metastore ========== -->
<property>
<name>hive.metastore.uris</name>
<value>thrift://hadoop001:9083</value>
</property><!-- ========== HiveServer2 配置 ========== -->
<property>
<name>hive.server2.thrift.bind.host</name>
<value>hadoop002</value>
</property>
<property>
<name>hive.server2.thrift.port</name>
<value>10000</value>
</property>
<property>
<name>hive.server2.authentication</name>
<value>NONE</value>
</property><!-- ========== 通用配置 ========== -->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property>
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
</property>
</configuration>
启动命令(hadoop002):
# 测试 Metastore 连通性
telnet hadoop001 9083# 启动 HiveServer2 服务
nohup hive --service hiveserver2 > $HIVE_HOME/hiveserver2.log.log 2>&1 &# 验证
netstat -tlnp | grep 10000
# tcp 0 0 0.0.0.0:10000 0.0.0.0:* LISTEN 12346/java
客户端配置 (任意机器)
建议在hadoop001的/opt/hive/conf/hive-site.xml上 ,与metastore服务放在同一个配置中
在配置文件中增加:
<configuration>
<!-- 可选:配置默认连接地址 -->
<property>
<name>hive.metastore.uris</name>
<value>thrift://hadoop001:9083</value>
</property>
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
</configuration>
使用 Beeline 连接:
# 直接连接 HiveServer2
beeline -u "jdbc:hive2://hadoop002:10000"# 或交互式连接
beeline
beeline> !connect jdbc:hive2://hadoop002:10000
至此为止全部配置讲解完毕。
后续内容是作为备用。
=================================================
Hive安装至此完,下面为了解内容
=================================================
六、Hive的配置统一注释
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
<!-- ==================== MySQL8 元数据库(Metastore)配置 ==================== -->
<!-- 说明:Hive 使用关系型数据库存储表结构、列信息、分区等元数据,此处配置 MySQL 8 作为元数据库 --><property>
<!-- JDBC 连接 URL,指定 Hive 元数据存储的 MySQL 数据库 -->
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true&serverTimezone=Asia/Shanghai</value>
<!--
参数说明:
- localhost:3306 : MySQL 服务地址和端口
- /hive : 数据库名,存储 Hive 元数据表
- createDatabaseIfNotExist: 若数据库不存在则自动创建
- useUnicode & characterEncoding: 指定 UTF-8 编码,避免中文乱码
- useSSL=false : 关闭 SSL 加密(学习环境简化,生产环境建议开启)
- allowPublicKeyRetrieval : MySQL 8 要求,允许客户端获取公钥
- serverTimezone : 设置时区为上海,避免时间类型字段存储/读取时差问题
-->
</property><property>
<!-- MySQL 8 JDBC 驱动类名 -->
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
<!-- MySQL 8 使用 com.mysql.cj.jdbc.Driver,旧版 MySQL 使用 com.mysql.jdbc.Driver -->
</property><property>
<!-- 元数据库登录用户名 -->
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
<!-- 生产环境建议使用专用低权限账户,仅授予对 hive 数据库的 DDL/DML 权限 -->
</property><property>
<!-- 元数据库登录密码 -->
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
<!-- 生产环境务必修改默认密码,并考虑使用加密存储或环境变量注入 -->
</property><!-- ==================== 【核心】远程元存储(Remote Metastore)配置 ==================== -->
<property>
<!-- Metastore 服务的 Thrift 地址,客户端通过此地址连接远程 Metastore 服务 -->
<name>hive.metastore.uris</name>
<value>thrift://hadoop001:9083</value>
<!--
必须配置项!表示 Metastore 以独立服务模式运行。
- 客户端(如 Hive CLI、Beeline、HiveServer2)通过 Thrift 协议连接到此地址获取元数据
- 多个 Metastore 服务可实现高可用,用逗号分隔:thrift://host1:9083,thrift://host2:9083
- 注意:配置此项后,hive.metastore.local 配置将被忽略(自动失效)
-->
</property><!-- ==================== 元存储模式配置 了解部分 ==================== -->
<property>
<!-- 启用内嵌元存储模式(Embedded Metastore) -->
<name>hive.metastore.local</name>
<value>true</value>
<!--
true : Metastore 运行在 Hive 客户端同一 JVM 中,无需单独启动 metastore 服务(学习环境适用)
false : 独立服务模式,需配置 hive.metastore.uris 指向 Metastore 服务地址(生产环境适用)
注意:该配置在 Hive 3.x 中已标记为废弃,仅用于向后兼容,但此处保留简化单机部署
-->
</property>
<!-- ==================== HDFS 存储路径配置 ==================== --><property>
<!-- Hive 数据仓库的根目录(HDFS 路径) -->
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
<!--
所有 Hive 内部表(Managed Table)的数据文件默认存储在此目录下,
按 数据库名/表名 组织子目录结构
-->
</property><property>
<!-- Hive 执行作业时的临时目录(HDFS 路径) -->
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
<!--
用于存储 MapReduce/Tez/Spark 作业的中间结果、临时文件等,
作业结束后通常由 Hive 自动清理,但需保证目录存在且有读写权限
-->
</property><!-- ==================== HiveServer2 服务配置 ==================== -->
<!-- 说明:HiveServer2 是 Hive 的 JDBC/ODBC 服务端,Beeline 客户端通过它连接 Hive --><property>
<!-- HiveServer2 服务绑定的主机地址 -->
<name>hive.server2.thrift.bind.host</name>
<value>hadoop001</value>
<!--
指定 HiveServer2 监听的主机名或 IP 地址:
- 0.0.0.0 : 监听所有网卡(生产环境常用)
- hadoop001: 绑定到特定主机名(需确保客户端能解析该主机名)
- localhost: 仅本地访问(仅限测试)
-->
</property><property>
<!-- HiveServer2 服务监听的 Thrift 端口 -->
<name>hive.server2.thrift.port</name>
<value>10000</value>
<!--
默认端口 10000,Beeline 客户端通过此端口连接 HiveServer2,
连接命令示例:!connect jdbc:hive2://hadoop001:10000
-->
</property>
<!-- ==================== 元数据版本校验配置 ==================== --><property>
<!-- 关闭 Metastore Schema 版本校验 -->
<name>hive.metastore.schema.verification</name>
<value>false</value>
<!--
false : 不检查元数据库版本与 Hive 客户端版本是否一致(允许跨版本兼容,学习环境常用)
true : 严格校验,版本不匹配时会抛出异常并拒绝启动(生产环境建议开启以确保稳定性)
注意:新版本 Hive 该配置默认值为 true,此处显式设为 false 以绕过版本检查
-->
</property>
<!-- ==================== 事务与并发管理配置 ==================== --><property>
<!-- 事务管理器,此处使用虚拟事务管理器(不启用 ACID) -->
<name>hive.txn.manager</name>
<value>org.apache.hadoop.hive.ql.lockmgr.DummyTxnManager</value>
<!--
DummyTxnManager : 虚拟事务管理器,不提供 ACID 事务支持,但允许普通表使用 INSERT ... VALUES 等插入语法
DbTxnManager : 数据库事务管理器,用于支持 ACID 事务(需配合 hive.support.concurrency=true 且执行引擎改为 tez)
-->
</property><property>
<!-- 关闭并发支持 -->
<name>hive.support.concurrency</name>
<value>false</value>
<!--
false : 不对 Hive 表进行读写锁管理(单用户学习环境适用,可减少不必要的开销)
true : 开启并发锁管理(多用户生产环境需要,配合 Zookeeper 或 DB 锁使用)
-->
</property>
<!-- ==================== 执行引擎配置 ==================== --><property>
<!-- 指定 Hive SQL 的执行引擎 -->
<name>hive.execution.engine</name>
<value>mr</value>
<!--
mr : MapReduce 引擎(稳定,无需额外部署,但速度较慢,适合学习环境)
tez : Tez 引擎(高效 DAG 执行,需额外部署 Tez 组件)
spark : Spark 引擎(内存计算,需额外部署 Spark 集群)
-->
</property>
<!-- ====================本地模式自动优化配置 ==================== -->
<!-- 警告:HiveServer2 环境下必须关闭本地自动模式!否则任务可能异常崩溃 -->
<property>
<!-- 关闭本地执行自动模式 -->
<name>hive.exec.mode.local.auto</name>
<value>false</value>
<!--
⚠️ 重要配置说明:- true : 当满足数据量阈值时,自动切换到本地执行模式
- false : 始终提交到 Hadoop 集群执行(无论数据量大小)- 设置为true,则为开启模式,当数据量较小时,Hive 会在本地 JVM 中执行任务,
跳过 YARN 资源调度,大幅提升响应速度
true配置仅在 Hive CLI(命令行)环境中可设置为 true 以加速小查询。
- HiveServer2 环境必须设置为 false,即始终提交到 Hadoop 集群执行,因为
- HiveServer2 环境下,任务提交到集群执行时没有本地运行的上下文环境,
若开启本地模式(true),可能导致任务在 HS2 本地 JVM 中执行,
引发内存溢出(OOM)或类加载冲突等异常,导致 HS2 服务崩溃。
-->
</property><!-- 本地执行模式的触发阈值参数,用于控制 Hive 何时在本地运行任务
当满足以下两个条件时,Hive 自动切换为本地模式:
-->
<property>
<!-- 本地模式触发的最大输入数据字节数阈值 -->
<name>hive.exec.mode.local.auto.inputbytes.max</name>
<value>50000000</value>
<!--
当输入数据总大小 ≤ 50MB(50,000,000 字节)时,启用本地执行,
超过此阈值则提交到 YARN 集群执行
-->
</property><property>
<!-- 本地模式触发的最大输入文件数阈值 -->
<name>hive.exec.mode.local.auto.input.files.max</name>
<value>5</value>
<!--
当输入文件总数 ≤ 5 个时,启用本地执行,
超过此阈值则提交到 YARN 集群执行
注意:两个阈值需同时满足才会触发本地模式
-->
</property></configuration>
<!-- ==================== 操作日志配置 ==================== -->
<property>
<!-- 开启 HiveServer2 操作日志 -->
<name>hive.server2.logging.operation.enabled</name>
<value>true</value>
<!--
true : 记录每个 Beeline/JDBC 连接执行的 SQL 操作日志,方便排查问题
false : 不记录操作日志(生产环境可关闭以节省存储空间)
日志默认存储路径:/tmp/${user.name}/operation_logs/
可通过 hive.server2.logging.operation.log.location 自定义路径
-->
</property>hive3.5 的Beeline访问配置
七、Hive的简约版安装
hive的简约版:
5、Hive
01、Hive安装
目录:/opt/module
上传解压:tar -zxvf hive-3.1.3.tar.gz
重命名:mv apache-hive-3.1.3-bin hive
配置环境变量;
vi /etc/profile
#HIVE_HOME
export HIVE_HOME=/opt/module/hive
export PATH=$PATH:$HIVE_HOME/bin
使环境生效:
source /etc/profile02、Hive配置
cp hive-default.xml.template hive-site.xm
cp hive-env.sh.template hive-env.sh
1 配置hive-env.sh (位置:/opt/mudule/hive/conf)
export HADOOP_HOME=/opt/module/hadoop
export HIVE_CONF_DIR=/opt/module/hive/conf
export HIVE_AUX_JARS_PATH=/opt/module/hive/lib
2 配置hive-site.xml (位置:/opt/mudule/hive/conf) (直连模式配置)
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>
<configuration>
<!--MySQL信息-->
<!--数据库连接地址配置-->
<property>
<name>javax.jdo.option.ConnectionURL</name>
<!--注意:下面的&要变为“&加上amp;” 形式-->
<value>jdbc:mysql://localhost:3306/hive?createDatabaseIfNotExist=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false&allowPublicKeyRetrieval=true</value>
</property>
<!--数据库驱动配置注意:mysql5.x与mysql8.x不同-->
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.cj.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>root</value>
</property>
<!--Hive表数据存储在HDFS路径-->
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<!--hive的临时数据目录,指定的位置在hdfs上的目录可以不指定有默认目录-->
<property>
<name>hive.exec.scratchdir</name>
<value>/tmp/hive</value>
</property>
<!-- 直接连接模式使用下面配置,初学者推荐-->
<!--指定HiveServer2所在的host,改为自己主机名-->
<property>
<name>hive.server2.thrift.bind.host</name>
<value>hadoop001</value>
</property>
<!--指定HiveServer2所在的端口hs2端口默认是10000-->
<property>
<name>hive.server2.thrift.port</name>
<value>10000</value>
</property>
<!--不强制执行Metastore模式版本的一致性检查,默认值是true-->
<property>
<name>hive.metastore.schema.verification</name>
<value>false</value>
</property>
<!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto</name>
<value>true</value>
<description>Whether to automatically switch to local mode if the input file size is below threshold.</description>
</property>
<!-- 启用本地模式自动切换 -->
<property>
<name>hive.exec.mode.local.auto.inputbytes.max</name>
<value>50000000</value>
<description>Maximum input size (in bytes) for auto-local mode.</description>
</property>
<!-- 设置最大输入文件数量(5个) -->
<property>
<name>hive.exec.mode.local.auto.input.files.max</name>
<value>5</value>
<description>Maximum number of input files for auto-local mode.</description>
</property>
</configuration>3、拷贝jar包
#拷贝mysql驱动
#拷贝guava包 #hadoop和hive里面的guava包版本可能不一致,那么用hadoop里面的覆盖掉hive里面的
#删除hive的旧依赖包
#删除 hive中的 log4j:删除 Hive 的lib目录中包含log4j-slf4j-impl-2.17.1.jar
cp /opt/module/mysql-connector-java-8.0.30.jar /opt/module/hive/lib/
cp /opt/module/hadoop/share/hadoop/common/lib/guava-27.0-jre.jar /opt/module/hive/lib/
rm -rf /opt/module/hive/lib/guava-19.0.jar
rm -rf /opt/module/hive/lib/log4j-slf4j-impl-2.17.1.jar4、初始化
启动msyql
sudo systemctl status mysql8
# sudo systemctl start mysql8
启动hadoop
cd /opt/module/hadoop/
sbin/start-all.sh
haodoop001节点进程:
SecondaryNameNode
ResourceManager
NameNode
NodeManager
hadoop002、hadoop003进程:
datanode
NodeManager
初始化hive
cd /opt/module/hive
bin/schematool -dbType mysql -initSchema5、启动hive
# 启动HiveServer2(直连模式只需启动这一个服务,无需启动MetaStore)
hive --service hiveserver2 > $HIVE_HOME/hiveserver2.log 2>&1 &
验证测试:
jps | grep HiveServer2
netstat -nlp | grep 10000
测试连接:
# 1. 先进入beeline命令行
beeline
# 2. 在beeline> 提示符下执行连接命令
!connect jdbc:hive2://hadoop001:10000
测试:
-- 1. 数据库准备
CREATE DATABASE IF NOT EXISTS career_dw
COMMENT '职业分析数据仓库'
LOCATION '/user/hive/warehouse/career_dw.db';
USE career_dw;
-- 2.1 ods_job_info (分区表: dt)
DROP TABLE IF EXISTS tmp_ods_job_info_csv;
CREATE TABLE tmp_ods_job_info_csv (
job_id STRING,
title STRING,
city STRING,
district STRING,
edu_level STRING,
work_years STRING,
salary_min DECIMAL(10,2),
salary_max DECIMAL(10,2),
company_name STRING,
company_scale STRING,
company_industry STRING,
publish_time STRING,
crawl_time STRING,
etl_time STRING
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
LINES TERMINATED BY '\n'
STORED AS TEXTFILE;
-- 在插入前,先重置这些设置
SET hive.exec.dynamic.partition = false;
SET hive.exec.dynamic.partition.mode = strict;
SET hive.map.aggr = false;
SET hive.groupby.skewindata = false;
set hive.exec.mode.local.auto=false;
set mapreduce.framework.name=yarn;
-- 然后执行INSERT
INSERT INTO tmp_ods_job_info_csv VALUES ('1002', 'Java后端开发', '上海', '浦东新区', '本科', '1-3年', 18.00, 30.00, '阿里巴巴', '10000人以上', '电子商务', '2026-08-06', '2026-08-07 15:30:00', '2026-08-07 15:30:00');
八、其他msyql安装方式
1、卸载旧MySQL文件
若之前安装过其他的sql执行这个步骤。
执行命令
# yum remove mysql mysql-server mysql-lib mysql-server
•再查看当前安装mysql的情况看卸载情况:
# rpm -qa|grep -i mysql
可以看到之前安装的包,然后执行删除命令,全部删除
# rpm -ev MySQL-devel--5.1.52-1.el6.i686 --nodeps
•查找之前老版本MySQL的目录,并删除老版本的MySQL的文件和库
# find / -name mysql
删除查找到的所有目录
#例如:rm -rf /run/lock/subsys/mysql
#例如: rm -rf /etc/selinux/targeted/active/modules/100/mysql # rm -rf /var/lib/mysql
•手动删除/etc/my.cnf
# rm -rf /etc/my.cnf
•再次查询如果无,则删除干净
# rpm -qa|grep -i mysql删除 mariadb
rpm -qa|grep mariadb
rpm -e --nodeps mariadb-libs
rpm -e --nodeps mysql-libs-5.1.52-1.el6_0.1.x86_64
2、Mysql下载安装
1.1 下载
官网网址:MySQL :: Download MySQL Community Server
在这里下载的是如下版本的mysql
https://cdn.mysql.com//Downloads/MySQL-5.7/mysql-5.7.26-linux-glibc2.12-x86_64.tar.gz1.2 上传
使用xshell上传到到linux服务器指定安装路径
此处是安装路径是 /usr/local
1.3 解压重命名
cd /usr/local/
# 如果是xz结尾压缩包用 tar -xvJf,如 tar -xvJf mysql-8.0.30-linux-glibc2.12-x86_64.tar.xz
重命令
tar -xzvf mysql-5.7.26-linux-glibc2.12-x86_64.tar.gz
mv mysql-5.7.26-linux-glibc2.12-x86_64 mysql
3、配置环境变量
vi /etc/profile
export MYSQL_HOME=/usr/local/mysql
export PATH=\$PATH:$MYSQL_HOME/bin使环境生效
source /etc/profile
4、删除用户组
删除用户组
cat /etc/group|grep mysqluserdel mysql
groupdel mysql
5、创建用户和组
groupadd mysql
useradd -r -g mysql mysql
6、创建文件夹
mkdir /usr/local/mysql/data
7、更改权限
更改mysql目录下所有的目录及文件夹所属的用户组和用户,以及赋予可执行权限
chown -R mysql:mysql /usr/local/mysql/data/
chmod -R 755 /usr/local/mysql/data/
chown -R mysql:mysql /usr/local/mysql/
chmod -R 755 /usr/local/mysql/
8、安装依赖包
安装mysql的依赖包
yum install libaio
或者
yum install -y mariadb-server 安装mariadb-server 5.X版本使用
9、初始化
执行初始化命令:
/usr/local/mysql/bin/mysqld --user=mysql --basedir=/usr/local/mysql/ --datadir=/usr/local/mysql/data/ --initialize
#说明
–initialize 初始化(真正开始干活)
–user=mysql 以mysql用户的身份初始化数据库,产生文件都是mysql作为拥有者
–basedir=xxx mysql其安装目录,非常重要
–lower_case_table_names=1 不区分大小写,如果初始化不指定,必须重装才能解决,非常重要
10、记住初始密码

11、将mysql加入到服务中
复制
cp /usr/local/mysql/support-files/mysql.server /etc/init.d/mysql#注意:默认情况下,GBLIC版本的数据库要求安装到/usr/local/mysql目录,其mysql.server脚本中对应的目录也是/usr/local/mysql,这会导致mysql无法启动。所以可以更改其basedir以及datadir两个变量,我们后面在 my.cnf 中配置。
#赋予可执行权限
chmod +x /etc/init.d/mysql
#添加服务
chkconfig --add mysql
#显示服务列表
chkconfig --list mysql
12、配置文件
(1)Mysql5.X版本配置
Mysql是5.x版本使用此配置
vi /etc/my.cnf
[mysqld]
port=3306
user=mysql
basedir=/usr/local/mysql
datadir=/usr/local/mysql/data
socket=/tmp/mysqld.sock
#character config
character_set_server=utf8mb4
explicit_defaults_for_timestamp=true
(2)Mysql8.X版本配置
Mysql是8.x版本使用此配置
8.0版
注意:使用配置前一定要创建好目录
mkdir /usr/local/mysql/tmp
mkdir /usr/local/mysql/log
touch /usr/local/mysql/log/mysqld_safe.err
chown -R mysql:mysql /usr/local/mysql/tmp
chown -R mysql:mysql /usr/local/mysql/log
chown -R mysql:mysql /usr/local/mysql/log/mysqld_safe.err
简单配置(推荐)
vi /etc/my.cnf
[mysql]
user=mysql
default-character-set=utf8
socket=/usr/local/mysql/tmp/mysql.sock[mysqld]
basedir=/usr/local/mysql
datadir=/usr/local/mysql/data
socket=/usr/local/mysql/tmp/mysql.sock
user=mysql
log_timestamps=SYSTEM
collation-server = utf8_unicode_ci
character-set-server = utf8
default_authentication_plugin= mysql_native_password[mysqld_safe]
log-error=/usr/local/mysql/log/mysqld_safe.err
pid-file=/usr/local/mysql/tmp/mysqld.pid
13、设置开机启动
设置开机启动:chkconfig mysql on
启动mysql :service mysql start
如果碰到下面问题可以进行参考
问题报错解决方案
启动报错:
Starting MySQL.2023-06-25T04:58:08.333370Z mysqld_safe error: log-error set to ‘/usr/local/mysql/log/mysqld_safe.err’, however file don’t exists. Create writable for user ‘mysql’.
ERROR! The server quit without updating PID file (/usr/local/mysql/pid/mysqld.pid).解决方案
[root@mysql]# touch /usr/local/mysql/log/mysqld_safe.err
[root@mysql]# chown -R mysql:mysql /usr/local/mysql/log/mysqld_safe.err启动报错:
my_print_defaults: [Warning] World-writable config file ‘/usr/local/mysql/my.cnf’ is ignored.
Starting MySQL.my_print_defaults: [Warning] World-writable config file ‘/usr/local/mysql/my.cnf’ is ignored.
my_print_defaults: [Warning] World-writable config file ‘/usr/local/mysql/my.cnf’ is ignored.
ERROR! The server quit without updating PID file (/usr/local/mysql/data/localhost.localdomain.pid).解决方案
/etc/my.cnf 权限给的是 777,需要改成644,再次重新启动即可。
14、并查看进程
查看进程与状态:
ps -ef|grep mysql;
service mysql status;
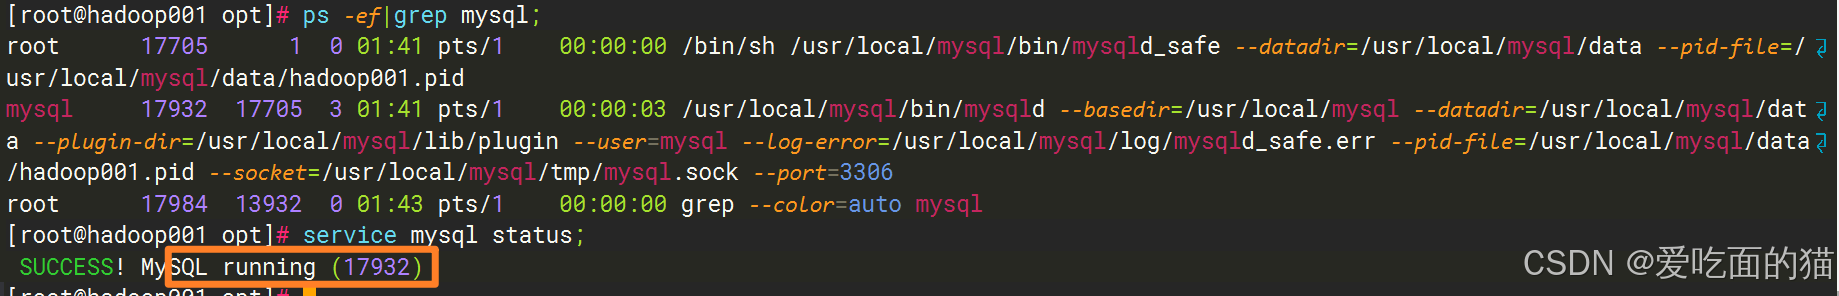
15、创建软连接
ln -s /usr/local/mysql/bin/mysql /usr/bin
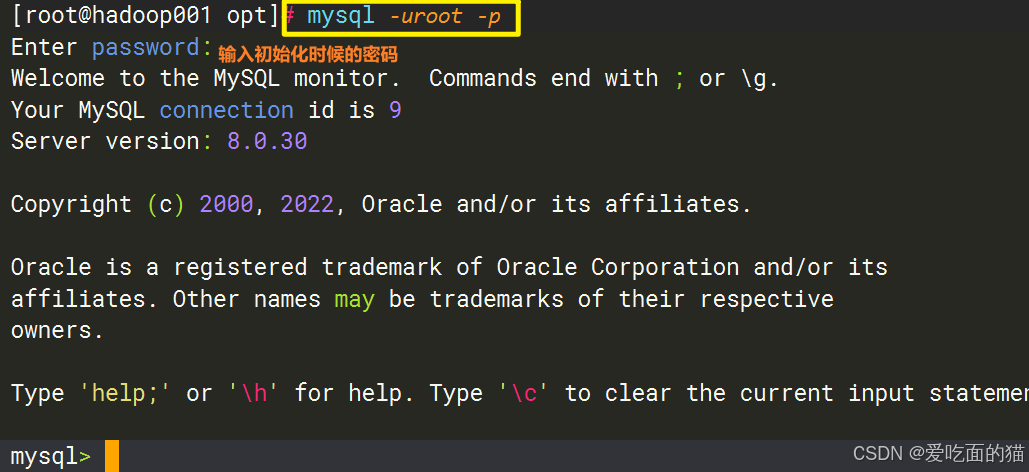
16、登录 Mysql
mysql -uroot -p
输入密码(初始化时候的密码)
注意:如果输入密码报错
Can't connect to local MySQL server through socket '/tmp/mysql.sock' (2)
解决方案
修改配置文件my.cnf 中 socket = /usr/local/mysql/tmp/mysql.sock,并重启mysql:service mysql restart;
17、修改密码
(1)Mysql5.X版本修改密码
Mysql是5.x版本使用此方式修改密码
8.0以下修改密码
修改密码
use mysql;
SET PASSWORD FOR 'root'@'localhost' = PASSWORD('newpassword');
flush privileges;
(2)Mysql8.X版本修改密码
Mysql是8.x版本使用此方式修改密码
8.0以上修改密码
alter user "root"@"localhost" identified by "root";
use mysql;
UPDATE user SET authentication_string="" WHERE user="root";
FLUSH PRIVILEGES;
update user set Host="%" where User="root";
flush privileges;
alter user "root"@"%" identified by "root";
flush privileges;说明:
- UPDATE user SET authentication_string="" WHERE user="root"; 更新user表,将用户名为root的用户的authentication_string字段设置为空字符串。实际上是在清空root用户的密码。
- update user set Host="%" where User="root"; 更新user表,它将用户名为root的用户的Host字段设置为%。即root用户可以从任何主机进行连接。默认情况下,root用户可能只能从localhost进行连接。
- alter user "root"@"%" identified by "root"; 更改用户的认证信息。它指定了用户名为root且来源主机为任意主机(%)的用户,并将其密码设置为root。这是在新版本的MySQL中设置或更改用户密码的推荐方式。
18、授权
(1)Mysql5.X版本授权
Mysql是5.x版本使用此方式授权
授权
8.0以下授权:登录后执行下面命令
grant all privileges on *.* to 'root'@'%' identified by '密码123456' with grant option;
flush privileges;说明:
- all privileges:表示将所有权限授予给用户。也可指定具体的权限,如:SELECT、CREATE、DROP等。
- on:表示这些权限对哪些数据库和表生效,格式:数据库名.表名,这里写“*”表示所有数据库,所有表。如果我要指定将权限应用到test库的user表中,可以这么写:test.user
- to:将权限授予哪个用户。格式:”用户名”@”登录IP或域名”。%表示没有限制,在任何主机都可以登录。比如:”yangxin”@”192.168.0.%”,表示yangxin这个用户只能在192.168.0IP段登录
- identified by:指定用户的登录密码
(2)Mysql8.X版本授权
Mysql是8.x版本使用此方式授权
8.0以上授权
为了用 navicate工具 访问数据库,进行以下设置进行授权:
use mysql;
ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY 'root';
flush privileges;
说明:
- ALTER USER 'root'@'%' IDENTIFIED WITH mysql_native_password BY 'root'; #还原密码验证插件,将MySQL8的密码认证插件由caching_sha2_password更换成mysql_native_password
九、问题与说明:
安装 apache-hive-3.1.3-bin.tar.gz 配套 hadoop-3.2.2.tar.gz 可能会卡顿。如果卡顿,将 hadoop-3.2.2.tar.gz 换为 hadoop-3.0.0 或 hadoop-3.2.1 测试一下。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)