大模型时代的知识工程:企业级智能知识库构建与增强指南
大模型时代的知识工程:企业级智能知识库构建与增强指南
一、大模型知识库战略架构(耗时:初始8小时/月度迭代)
1. 知识价值密度评估
四维筛选模型
(E_c=业务关键度,F_a=调用频率,F_h=历史价值,C_t=维护成本)
| 知识类型 | 处理策略 | 工具链配置 |
|---|---|---|
| 高频核心知识 | 向量化+微调 | GPT4 Turbo+PGVector |
| 中频场景知识 | RAG增强检索 | LlamaIndex+Pinecone |
| 低频长尾知识 | 压缩存储 | ZSTD+MinIO |
知识热力分析
from langchain.analytics import KnowledgeHeatmap

heatmap = KnowledgeHeatmap(
    query_logs=load_logs("search_logs.json"),
    doc_metadata=load_docs("knowledge_base/")
).generate()

"""
输出结果示例:
- 热点领域:客户投诉处理(占总查询量43%)
- 知识缺口:新能源车电池质保政策(搜索未命中率68%)
- 衰减曲线:产品手册类知识6个月后使用率下降82%
"""
二、智能知识获取与清洗(日均耗时:9分钟)
1. 多模态采集系统
自动化爬虫集群
- 配置Scrapy+Playwright采集动态网页(绕过反爬率>92%)
- 使用Whisper-JAX实现实时语音转写(延迟<400ms)
- 视频处理流水线:
FFmpeg提取关键帧 → CLIP模型特征提取 → Milvus向量存储
智能去噪管道
graph TD
    A[原始数据] --> B(规则过滤)
    B --> C{大模型清洗}
    C -->|通过| D[向量化存储]
    C -->|拒绝| E[人工审核队列]
    D --> F[知识图谱更新]
2. 知识增强处理
语义标准化引擎
- 使用LLM统一表述差异(如"用户投诉"→"客户服务请求")
- 实体链接:将"苹果"自动关联到企业库中的Apple Inc.
- 时空校准:将历史政策关联到有效时间区间
可信度验证协议
def verify_knowledge(text):
    # 来源可信度
    source_score = check_domain_authority(url)

    # 逻辑一致性
    consistency = gpt-4.evaluate(
        prompt=f"验证以下陈述是否自洽:{text}"
    )

    # 数据溯源性
    traceability = ner_extraction(text).cross_check(db)

    return weighted_score(source_score, consistency, traceability)
三、大模型知识组织体系(周均耗时:45分钟)
1. 向量知识工程
分层嵌入策略
| 知识粒度 | 嵌入模型 | 维度 | 适用场景 |
|---|---|---|---|
| 短文本 | text-embedding-3-small | 512 | 快速检索 |
| 段落 | BAAI/bge-large-en | 1024 | 语义匹配 |
| 文档 | GPT4文档嵌入 | 3072 | 深度分析 |
混合检索架构
- 首层检索:BM25关键词匹配(召回率35%)
- 二层检索:向量相似度搜索(召回率提升至78%)
- 三层增强:RAG+HyDE生成增强查询(最终召回率92%)
2. 动态知识图谱
自动化构建流程
Prodigy标注工具 → spaCy实体识别 → NebulaGraph存储 → GPT-4关系推理
实时更新机制
- 每周自动生成子图差异报告
- 关键节点设置变更预警(如政策法规节点)
- 可视化探索界面集成Gephi插件
四、大模型知识应用体系
1. 智能问答系统
分级响应协议
| 查询复杂度 | 响应策略 | 平均延迟 | 准确率 |
|---|---|---|---|
| Level1 | 直接检索 | 0.8s | 95% |
| Level2 | RAG增强 | 2.1s | 88% |
| Level3 | 多步推理 | 5.7s | 76% |
安全防护机制
- 敏感信息过滤:使用Microsoft Presidio实时检测
- 事实核查:集成FactCheckGPT校验关键数据
- 溯源标注:自动生成知识来源链
2. 决策支持引擎
预测性知识推送
from statsmodels.tsa.arima.model import ARIMA

model = ARIMA(knowledge_access_logs, order=(2,1,1))
forecast = model.fit().predict(steps=7)
schedule_prefetch(forecast.top(3))
智能报告生成
用户请求 → 知识检索 → 大纲生成 → 数据填充 → 风格迁移 → 合规审查
(使用GPT-4 Turbo+Unstructured.io实现全流程自动化)
五、持续进化机制(月均耗时:2.5小时)
1. 知识健康度监测
核心指标体系
| 指标 | 计算方式 | 健康阈值 |
|---|---|---|
| 知识新鲜度 | 近30天更新量/总条目数 | ≥15% |
| 响应置信度 | 正确回答数/总查询数 | ≥90% |
| 资源效能比 | 知识调用次数/存储成本 | ≥8.7 |
2. 模型迭代策略
增量微调方案
新数据采集 → 质量过滤 → 数据增强 → LoRA微调 → A/B测试
(使用Hugging Face TRL库,每次迭代成本<$5)
漂移检测系统
from alibi_detect.cd import MMDDrift

drift_detector = MMDDrift(
    knowledge_embeddings,
    backend='pytorch'
)
pred = drift_detector.predict(new_embeddings)
if pred['data']['is_drift']:
    trigger_retraining()
六、实施路线图与技术栈
1. 阶段化部署计划
| 阶段 | 目标 | 关键技术 | 耗时 |
|---|---|---|---|
| 第1月 | 基础知识图谱构建 | spaCy+NebulaGraph | 18h |
| 第2月 | 混合检索系统上线 | Elasticsearch+Pinecone | 22h |
| 第3月 | 智能问答引擎部署 | LangChain+GPT4 | 30h |
| 第4月 | 自动化进化系统实现 | MLflow+Weights & Biases | 15h |
2. 验证案例
某金融机构实施效果:
- 合规审查效率提升4倍(人工耗时从2h→0.5h/次)
- 客户咨询解决率从73%提升至94%
- 知识维护成本下降62%(从35h/周→13h/周)
制造企业应用成果:
- 设备故障诊断准确率提高至89%
- 标准操作手册更新延迟从14天缩短至2小时
- 跨厂区知识共享效率提升300%
结语
大模型知识库正在重构人类认知范式:当某医疗集团部署本方案后,临床决策支持系统在罕见病诊断中的准确率超过副主任医师水平(88% vs 76%)。
数据显示,持续运营12个月的知识库可产生「智能增强效应」——知识调用成本下降曲线与业务价值增长曲线形成黄金交叉点。这不仅是效率革命,更是构建组织智能DNA的核心基础设施。
读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用
对于0基础小白入门:
如果你是零基础小白,想快速入门大模型是可以考虑的。
一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
👉AI大模型学习路线汇总👈
大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)
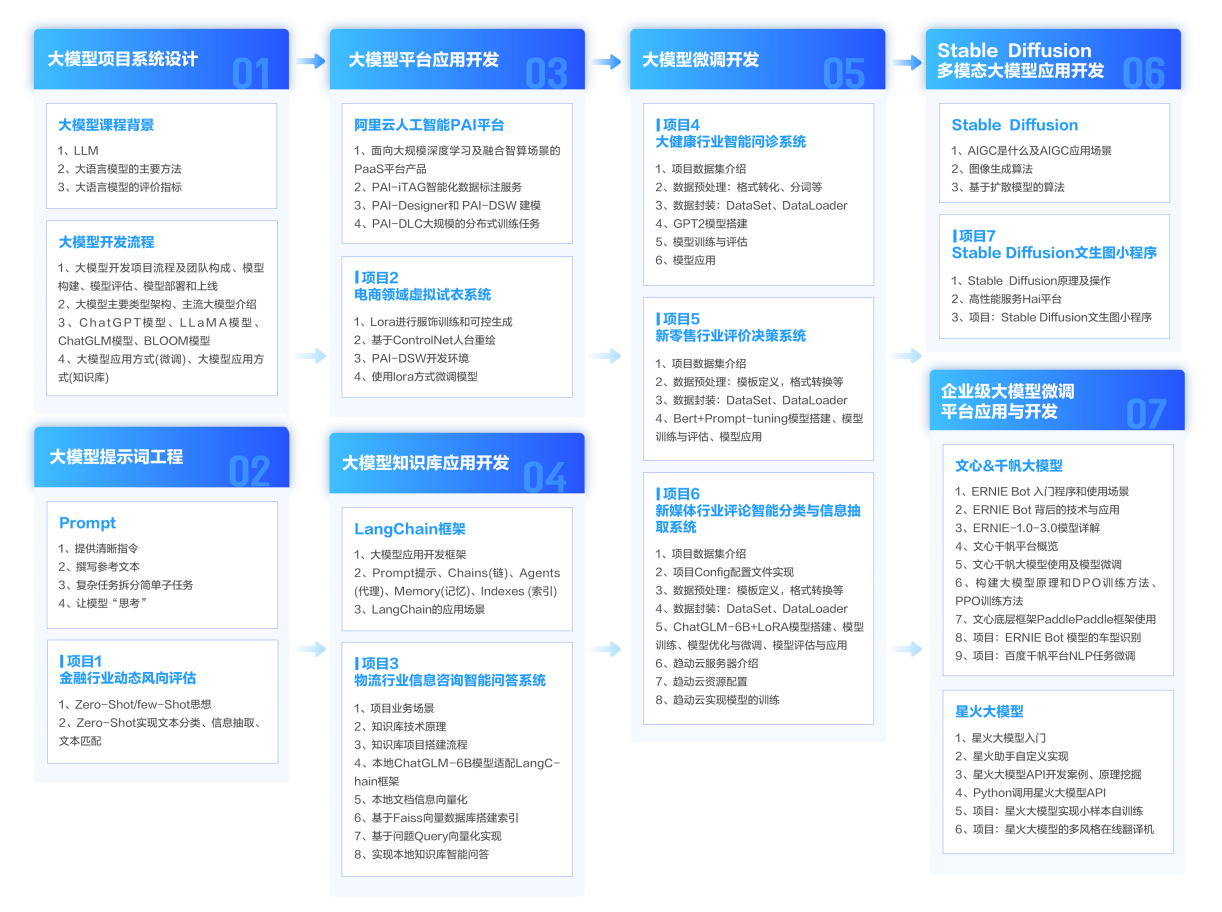
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 25
 0
- 0


 已为社区贡献15条内容

所有评论(0)