大数据Hadoop之——Flume安装与使用(详细)
目录
2.1. flume-file-flume.conf(相当于客户端)
2.2. flume-flume-hdfs.conf(相当于服务端)
2.3. flume-flume-dir.conf(相当于服务端)
2.1. flume-file-flume.conf(相当于客户端)
2.2. flume-flume-console1.conf(相当于服务端)
2.3. flume-flume-console2.conf(相当于服务端)
(1)Flume官网地址:http://flume.apache.org/
(2)文档查看地址:http://flume.apache.org/FlumeUserGuide.html
(3)下载地址:http://archive.apache.org/dist/flume/
Flume是Cloudera提供的一个高可用的,高可靠的,分布式的海量日志采集、聚合和传输的系统。Flume基于流式架构,灵活简单。
Flume最主要的作用就是,实时读取服务器本地磁盘的数据,将数据写入到HDFS。
一、Flume架构

1、Agent
Agent 是一个运行在 Java 虚拟机(JVM)上的程序 ,它就像是一个小快递员。
它的任务是:把数据从一个地方搬运到另一个地方 。
数据在 Flume 中是以“事件(Event)”的形式存在的。
2、Source
Source 是 Agent 的入口 ,相当于快递员的起点站。
它负责接收各种来源的数据,比如:
-
网络日志(netcat)
-
文件内容(taildir、spooling directory)
-
消息队列(如 Kafka、JMS)
-
或者模拟数据(sequence generator)
3、Channel
Channel 就像是快递员的背包 ,用来临时存放 Source 接收到的数据。
它起到一个中转站的作用 ,让 Source 和 Sink 可以各自按照自己的节奏工作。
Flume 提供了两种常用的 Channel【Memory Channel(内存通道)、File Channel(文件通道)】:
-
Memory Channel(内存通道) :
-
数据存在内存里,速度快。
-
但如果程序崩溃或服务器断电,数据可能会丢。
-
-
File Channel(文件通道) :
-
数据写入磁盘,更安全。
-
即使程序关闭或机器重启,数据也不会丢失。
-
4、Sink
Sink 是 Agent 的出口 ,相当于快递员的目的地。
它不断地从 Channel 中取数据,并把这些数据发送出去或者保存起来。
常见的目的地有:
-
HDFS(存储大数据)
-
HBase、Solr(数据库/搜索引擎)
-
日志记录器(Logger)
-
或者发给下一个 Agent 继续处理
5、Event
Event 是 Flume 中传输数据的基本单位 ,就像快递员运送的小包裹。
每个 Event 包含两部分:
-
Header(头信息) :像标签一样,包含一些描述信息(比如数据类型、时间等),是键值对(Key-Value)形式。
-
Body(主体) :真正要传输的数据,是一串字节(byte[]),可以是文本、JSON、图片等。
二、前期准备
1、查看网卡
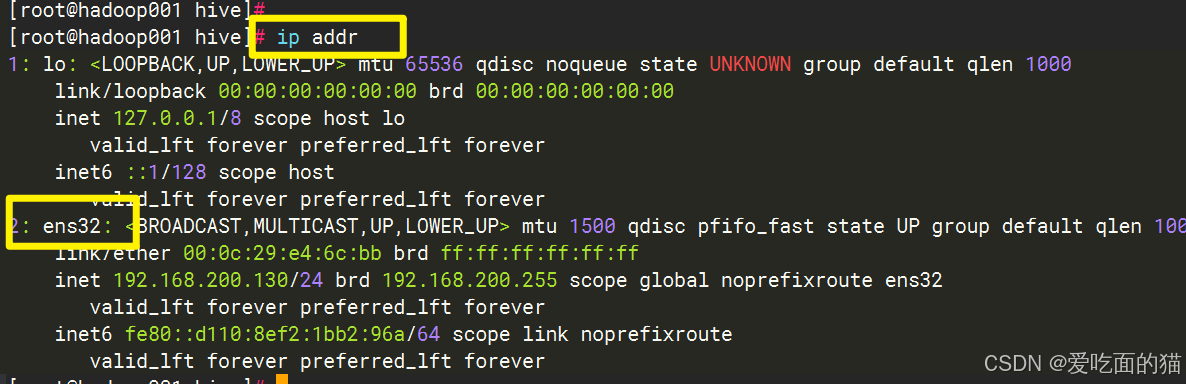
2、配置静态IP
vi /etc/sysconfig/network-scripts/ifcfg-ens32 ---- 根据自己网卡设置。

3、设置主机名
hostnamectl --static set-hostname 主机名
例如:
hostnamectl --static set-hostname hadoop001
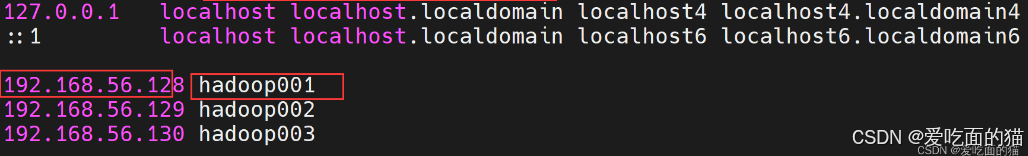
4、配置IP与主机名映射
vi /etc/hosts

5、关闭防火墙
systemctl stop firewalld
systemctl disable firewalld
6、配置免密登录
三、JDK的安装
四、Flume的安装
1、Flume的下载安装
1.1. 下载
https://archive.apache.org/dist/flume/flume-1.9.0/
下载 apache-flume-1.9.0-bin.tar.gz 安装包
1.2 上传
使用xshell上传到指定安装路径此处是安装路径是 /opt/module
1.3 解压重命名
tar -zxvf apache-zookeeper-3.7.1-bin.tar.gz
mv apache-flume-1.9.0-bin flume
1.4 配置环境变量
vi /etc/profile
export JAVA_HOME=/opt/module/java
export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar
export FLUME_HOME=/opt/module/flume
export PATH=$PATH:$JAVA_HOME/bin:$FLUME_HOME/bin
1.5 加载环境变量
source /etc/profile
验证环境变量是否生效:
env | grep HOME
env | grep PATH
1.6 删除guava
将lib文件夹下的guava-11.0.2.jar删除,以兼容Hadoop
rm -rf /opt/module/flume/lib/guava-11.0.2.jar


2、Flume的使用
2.1. 创建 Flume Agent配置文件
Agent = Source + Channel + Sink
Flume可以定义多个Agent,如a1,a2,a3,....
1、创建job文件夹
在flume目录下创建job文件夹并进入job文件夹。
mkdir /opt/module/flume/job
cd /opt/module/flume/job
2、创建 Flume Agent配置文件
在job文件夹下创建Flume Agent配置文件 log-flume-hdfs.conf
配置六大步骤:
01、定义一个名为 a1 的 Flume Agent
02、给 Agent a1 指定使用的组件
03、配置source
04、配置sink
05、配置chanel
06、连接通道
2.2. 编写内容
cd /opt/module/flume/job
vi log-flume-hdfs.conf
#01、02 给 Agent a1 指定使用的组件
#使用的 Source 是 r1
#使用的 Sink 是 k1
#使用的 Channel 是 c1a1.sources = r1
a1.sinks = k1
a1.channels = c1
#03 配置source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /opt/module/test.log
# 04配置sink:类型为hdfs、路径指定hdfs
a1.sinks.k1.type = hdfs
a1.sinks.k1.hdfs.path = hdfs://hadoop001:9000/flume/%Y%m%d/%H#上传文件的前缀
a1.sinks.k1.hdfs.filePrefix = logs-
#下面3行表示每小时创建一个文件夹
#是否按照时间滚动文件夹
a1.sinks.k1.hdfs.round = true
#多少时间单位创建一个新的文件夹
a1.sinks.k1.hdfs.roundValue = 1
#重新定义时间单位
a1.sinks.k1.hdfs.roundUnit = hour
#是否使用本地时间戳,如果使用%Y%m%d/格式必须设为true否则报错
a1.sinks.k1.hdfs.useLocalTimeStamp = true
#积攒多少个Event才flush到HDFS一次
a1.sinks.k1.hdfs.batchSize = 100
#设置文件类型,可支持压缩
a1.sinks.k1.hdfs.fileType = DataStream
#生成新文件的条件:时间60秒,大小约128M、生成环境一般是3600s
#多久生成一个新的文件
a1.sinks.k1.hdfs.rollInterval = 60
#设置每个文件的滚动大小
a1.sinks.k1.hdfs.rollSize = 134217700
#文件的滚动与Event数量无关
a1.sinks.k1.hdfs.rollCount = 0
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
# 06 连接通道:a1源的组件r1使用通道 c1,a源的组件k1使用通道 c1,
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
2.3. 创建脚本
touch /opt/module/genarete_log.sh
chmod 777 /opt/module/genarete_log.sh
vi /opt/module/genarete_log.sh#!/bin/bash
for i in {1..100}; do
echo "$i linux生成1-100的数字的for循环" >> /opt/module/test.log
donetail -10 /opt/module/test.log
2.4. 启动HDFS
/opt/module/hadoop/bin/start-dfs.sh
/opt/module/hadoop/sbin/start-yarn.sh
如果hadoop未安装请走这个门:Hadoop安装传送门
2.5. 启动Flume
启动flume,使用 ncf,即--name agent 名称、--conf 目录 --conf-file 配置文件 顺序不固定
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a1 --conf-file job/log-flume-hdfs.conf
简写:
bin/flume-ng agent --c conf/ --n a1 -f job/log-flume-hdfs.conf
2.6. 执行脚本
执行脚本,在hdfs上查看结果
/opt/module/genarete_log.sh
hdfs dfs -ls /flume

2.7. 结束进程
ps -ef | grep flume | grep -v grep | awk '{print $2}' | xargs kill -9
五、实时监控目录下多个新文件
在上面的基础上进行增加需求,让 flume 监控 /opt/module/flume/upload 录下的多个文件,并上传至HDFS。
1、创建监控目录
mkdir /opt/module/flume/upload
2、创建 Flume Agent 配置文件
在job文件夹下创建Flume Agent 配置文件 flume-dir-hdfs.conf
cd /opt/module/flume/job
vi flume-dir-hdfs.conf
#01、02 给 Agent a2 指定使用的组件
#使用的 Source 是 r2
#使用的 Sink 是 k2
#使用的 Channel 是 c2a2.sources = r2
a2.sinks = k2
a2.channels = c2#03 配置source
a2.sources.r2.type = spooldir
a2.sources.r2.spoolDir = /opt/module/flume/upload
a2.sources.r2.fileSuffix = .COMPLETED
a2.sources.r2.fileHeader = true
#忽略所有以.tmp结尾的文件,不上传
a2.sources.r2.ignorePattern = ([^ ]*\.tmp)# 04配置sink:类型为hdfs、路径指定hdfs
a2.sinks.k2.type = hdfs
a2.sinks.k2.hdfs.path = hdfs://hadoop001:9000/flume/upload/%Y%m%d/%H#上传文件的前缀
a2.sinks.k2.hdfs.filePrefix = upload-
#下面3行表示每小时创建一个文件夹
#上传文件的前缀
a2.sinks.k2.hdfs.filePrefix = upload-
#是否按照时间滚动文件夹
a2.sinks.k2.hdfs.round = true
#多少时间单位创建一个新的文件夹
a2.sinks.k2.hdfs.roundValue = 1
#重新定义时间单位
a2.sinks.k2.hdfs.roundUnit = hour
#是否使用本地时间戳
a2.sinks.k2.hdfs.useLocalTimeStamp = true
#积攒多少个Event才flush到HDFS一次
a2.sinks.k2.hdfs.batchSize = 100
#设置文件类型,可支持压缩
a2.sinks.k2.hdfs.fileType = DataStream#生成新文件的条件:时间60秒,大小约128M、生成环境一般是3600s
#多久生成一个新的文件
a2.sinks.k2.hdfs.rollInterval = 60
#设置每个文件的滚动大小大概是128M
a2.sinks.k2.hdfs.rollSize = 134217700
#文件的滚动与Event数量无关
a2.sinks.k2.hdfs.rollCount = 0# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a2.channels.c2.type = memory
a2.channels.c2.capacity = 1000
a2.channels.c2.transactionCapacity = 100# 06 连接通道:a2源的组件r2使用通道 c2,a2源的组件k2使用通道 c2,
a2.sources.r2.channels = c2
a2.sinks.k2.channel = c2
3、创建脚本
vi /opt/module/genarete_log.sh
#!/bin/bash
rm -rf /opt/module/flume/upload/*
for i in {1..100}; do
echo "$i linux生成1-100的数字的for循环 " >> /opt/module/flume/upload/test01.log
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/upload/test02.log
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/upload/test03.log
donetail -3 /opt/module/flume/upload/test01.log
tail -3 /opt/module/flume/upload/test02.log
tail -3 /opt/module/flume/upload/test03.log
4、启动HDFS
如果已经启动,则忽略
/opt/module/hadoop/bin/start-dfs.sh
/opt/module/hadoop/sbin/start-yarn.sh
如果hadoop未安装请走这个门:Hadoop安装传送门
5、启动Flume
启动flume,使用 cnc,即--conf 目录 --name agent 名称 --conf-file 配置文件 顺序不固定
cd /opt/module/flume
bin/flume-ng agent --c conf/ --n a2 -f job/flume-dir-hdfs.conf
6、执行脚本
执行脚本,在hdfs上查看结果
/opt/module/genarete_log.sh
hdfs dfs -ls /flume
7、结束进程
ps -ef | grep flume | grep -v grep | awk '{print $2}' | xargs kill -9
六、实时监控目录下多个新文件
Exec source适用于监控一个实时追加的文件,不能实现断点续传;Spooldir Source适合用于同步新文件,但不适合对实时追加日志的文件进行监听并同步;而Taildir Source适合用于监听多个实时追加的文件,并且能够实现断点续传。
在上面的基础上进行增加需求,让 flume 监控 /opt/module/flume/files 整个目录的实时追加文件,并上传至HDFS。
1、创建监控目录
mkdir /opt/module/flume/files01
mkdir /opt/module/flume/files02
2、创建 Flume Agent 配置文件
在job文件夹下创建Flume Agent 配置文件 flume-taildir-hdfs.conf
cd /opt/module/flume/job
vi flume-taildir-hdfs.conf
#01、02 给 Agent a3 指定使用的组件
#使用的 Source 是 r3
#使用的 Sink 是 k3
#使用的 Channel 是 c3a3.sources = r3
a3.sinks = k3
a3.channels = c3#03 配置source
a3.sources.r3.type = TAILDIR
a3.sources.r3.positionFile = /opt/module/flume/tail_dir.json
#配置两个文件组变量
a3.sources.r3.filegroups = f1 f2
#监控两个文件目录
a3.sources.r3.filegroups.f1 = /opt/module/flume/files01/.*file.*
a3.sources.r3.filegroups.f2 = /opt/module/flume/files02/.*log.*
# 04配置sink:类型为hdfs、路径指定hdfs
a3.sinks.k3.type = hdfs
a3.sinks.k3.hdfs.path = hdfs://hadoop001:9000/flume/upload/%Y%m%d/%H#上传文件的前缀
a3.sinks.k3.hdfs.filePrefix = upload-
#下面3行表示每小时创建一个文件夹
#是否按照时间滚动文件夹
a3.sinks.k3.hdfs.round = true
#多少时间单位创建一个新的文件夹
a3.sinks.k3.hdfs.roundValue = 1
#重新定义时间单位
a3.sinks.k3.hdfs.roundUnit = hour
#是否使用本地时间戳
a3.sinks.k3.hdfs.useLocalTimeStamp = true
#积攒多少个Event才flush到HDFS一次
a3.sinks.k3.hdfs.batchSize = 100
#设置文件类型,可支持压缩
a3.sinks.k3.hdfs.fileType = DataStream#生成新文件的条件:时间60秒,大小约128M、生成环境一般是3600s
#多久生成一个新的文件
a3.sinks.k3.hdfs.rollInterval = 60
#设置每个文件的滚动大小大概是128M
a3.sinks.k3.hdfs.rollSize = 134217700
#文件的滚动与Event数量无关
a3.sinks.k3.hdfs.rollCount = 0# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a3.channels.c3.type = memory
a3.channels.c3.capacity = 1000
a3.channels.c3.transactionCapacity = 100# 06 连接通道:a3源的组件r3使用通道 c3,a3源的组件k3使用通道 c3,
a3.sources.r3.channels = c3
a3.sinks.k3.channel = c3
3、创建脚本
vi /opt/module/genarete_log.sh
#!/bin/bash
rm -rf /opt/module/flume/files01/*
rm -rf /opt/module/flume/files02/*# 第一个循环:i 从 1 到 100
for i in {1..100}; do
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files01/test01.file.txt
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files01/test02.file.txt
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files02/test01.log
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files02/test02.log
doneecho "查看生成数据 ..."
sleep 2# 查看最后几行日志内容
tail -2 /opt/module/flume/files01/test01.file.txt
tail -2 /opt/module/flume/files01/test02.file.txt
tail -2 /opt/module/flume/files02/test01.log
tail -2 /opt/module/flume/files02/test02.log
echo "生成新数据 ..."
sleep 10for i in {101..200}; do
if [ $i -eq 150 ]; then
echo "$i 等于 150,开始休眠 10 秒..."
sleep 10
else
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files01/test01.file.txt
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files01/test02.file.txt
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files02/test01.log
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/files02/test02.log
fi
donetail -2 /opt/module/flume/files01/test01.file.txt
tail -2 /opt/module/flume/files01/test02.file.txt
tail -2 /opt/module/flume/files02/test01.logtail -2 /opt/module/flume/files02/test02.log
4、启动HDFS
如果已经启动,则忽略
/opt/module/hadoop/bin/start-dfs.sh
/opt/module/hadoop/sbin/start-yarn.sh
如果hadoop未安装请走这个门:Hadoop安装传送门
5、启动Flume
启动flume,使用 cnc,即--conf 目录 --name agent 名称 --conf-file 配置文件 顺序不固定
cd /opt/module/flume
bin/flume-ng agent --c conf/ --n a3 -f job/flume-dir-hdfs.conf
6、执行脚本
执行脚本,在hdfs上查看结果
/opt/module/genarete_log.sh
hdfs dfs -ls /flume
7、结束进程
ps -ef | grep flume | grep -v grep | awk '{print $2}' | xargs kill -9
七、复制和多路复用
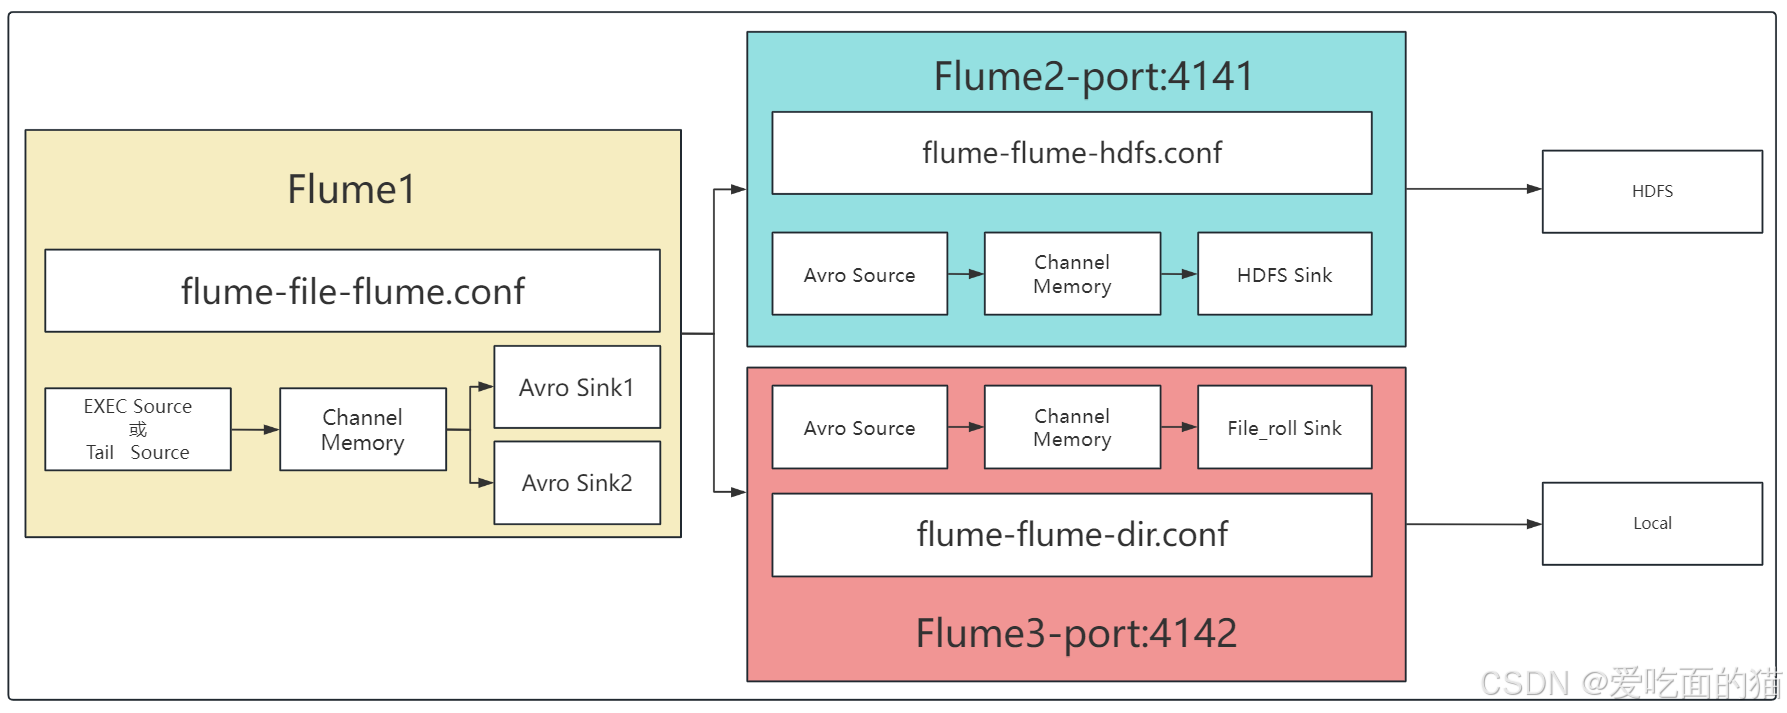
使用Flume1监控文件变动,Flume1将变动内容分别传递给Flume2和Flume3。Flume2负责将数据存储到HDFS。Flume-3负责将数据输出到Local FileSystem。
1、创建监控目录
group1目录用于 放3个 flume 的配置文件
data目录用于 flume2 写出数据到data
mkdir -p /opt/module/flume/job/group1
mkdir -p /opt/module/flume/data
2、编写配置文件
分别编写flume1、flume2、flume3的配置文件
2.1. flume-file-flume.conf(相当于客户端)
监控文件内容,文件为 /opt/module/flume/test.log
cd /opt/module/flume/job/group1
vi flume-file.flume.conf
#给 Agent 指定使用的组件
#使用的 Source 是 r1
#使用的 Sink 是 k1,k2
#使用的 Channel 是 c1,c2a1.sources = r1
a1.sinks = k1 k2
a1.channels = c1 c2
#通道选择器
# 将数据流复制给所有channel,没有配置则默认也是 replicating 副本机制
a1.sources.r1.selector.type = replicating
#02 配置source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /opt/module/flume/test.log
a1.sources.r1.shell = /bin/bash -c
# 04配置sink:flume间串联必须用 avro类型为。指定主机、端口
# sink端的avro是一个数据发送者,都从 hadoop001 发送数据,发送到端口 4141 和 4142
a1.sinks.k1.type = avro
a1.sinks.k1.hostname = hadoop001
a1.sinks.k1.port = 4141
a1.sinks.k2.type = avro
a1.sinks.k2.hostname = hadoop001
a1.sinks.k2.port = 4142
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
a1.channels.c2.type = memory
a1.channels.c2.capacity = 1000
a1.channels.c2.transactionCapacity = 100
# 06 连接通道
a1.sources.r1.channels = c1 c2
a1.sinks.k1.channel = c1
a1.sinks.k2.channel = c2
2.2. flume-flume-hdfs.conf(相当于服务端)
cd /opt/module/flume/job/group1
vi flume-flume-hdfs.conf
#给 Agent 指定使用的组件
a2.sources = r1
a2.sinks = k1
a2.channels = c1
#02 配置source
# source端的avro是一个数据接收服务,接收来自hadoop001上 a1 的4141端口数据
a2.sources.r1.type = avro
a2.sources.r1.bind = hadoop001
a2.sources.r1.port = 4141
# 04配置sink:类型为hdfs、路径指定hdfs,将 数据存储在hdfs上
a2.sinks.k1.type = hdfs
a2.sinks.k1.hdfs.path = hdfs://hadoop001:9000/flume/upload/%Y%m%d/%H
#上传文件的前缀
a2.sinks.k1.hdfs.filePrefix = upload-
#下面3行表示每小时创建一个文件夹
#是否按照时间滚动文件夹
a2.sinks.k1.hdfs.round = true
#多少时间单位创建一个新的文件夹
a2.sinks.k1.hdfs.roundValue = 1
#重新定义时间单位
a2.sinks.k1.hdfs.roundUnit = hour
#是否使用本地时间戳
a2.sinks.k1.hdfs.useLocalTimeStamp = true
#积攒多少个Event才flush到HDFS一次
a2.sinks.k1.hdfs.batchSize = 100
#设置文件类型,可支持压缩
a2.sinks.k1.hdfs.fileType = DataStream
#生成新文件的条件:时间60秒,大小约128M、生成环境一般是3600s
#多久生成一个新的文件
a2.sinks.k1.hdfs.rollInterval = 30
#设置每个文件的滚动大小大概是128M
a2.sinks.k1.hdfs.rollSize = 134217700
#文件的滚动与Event数量无关
a2.sinks.k1.hdfs.rollCount = 0
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a2.channels.c1.type = memory
a2.channels.c1.capacity = 1000
a2.channels.c1.transactionCapacity = 100
# 06 连接通道
a2.sources.r1.channels = c1
a2.sinks.k1.channel = c1
2.3. flume-flume-dir.conf(相当于服务端)
cd /opt/module/flume/job/group1
vi flume-flume-dir.conf
#给 Agent 指定使用的组件
a3.sources = r1
a3.sinks = k1
a3.channels = c2
#02 配置source
# source端的avro是一个数据接收服务,接收来自hadoop001上 a1 的4141端口数据
a3.sources.r1.type = avro
a3.sources.r1.bind = hadoop001
a3.sources.r1.port = 4142
# 04配置sink:类型为file_roll、本地目录 将数据保存在本地
a3.sinks.k1.type = file_roll
a3.sinks.k1.sink.directory = /opt/module/flume/data
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a3.channels.c2.type = memory
a3.channels.c2.capacity = 1000
a3.channels.c2.transactionCapacity = 100
# 06 连接通道
a3.sources.r1.channels = c2
a3.sinks.k1.channel = c2
3、创建脚本
vi /opt/module/genarete_log.sh
#!/bin/bash
# 删除旧文件
rm -rf /opt/module/flume/test.log# 第一个循环:1 到 100
for i in {1..100}; do
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/test.log
doneecho "查看生成数据 ..."
sleep 1# 查看最后两行
tail -2 /opt/module/flume/test.logecho "生成新数据 ..."
sleep 2# 第二个循环:101 到 200
for i in {101..200}; do
if [ $i -eq 150 ]; then
echo "$i 等于 150,开始休眠 3 秒..."
sleep 3
else
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/test.log
fi
done# 再次查看最后两行
tail -2 /opt/module/flume/test.log
4、启动HDFS
如果已经启动,则忽略
/opt/module/hadoop/bin/start-dfs.sh
/opt/module/hadoop/sbin/start-yarn.sh
如果hadoop未安装请走这个门:Hadoop安装传送门
5、启动Flume
启动flume,使用 cnc,即--conf 目录 --name agent 名称 --conf-file 配置文件 顺序不固定
分别打开三个窗口,在三个窗口分别执行
注意:要先启动服务端,在启动客户端,即先启动前2个,在启动最后一个。
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a2 --conf-file job/group1/flume-flume-hdfs.conf
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a3 --conf-file job/group1/flume-flume-dir.confcd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a1 --conf-file job/group1/flume-file-flume.conf
6、执行脚本
新打开一个窗口,执行脚本,在hdfs上查看结果
/opt/module/genarete_log.sh
hdfs dfs -ls /flume
7、结束进程
ps -ef | grep flume | grep -v grep | awk '{print $2}' | xargs kill -9
八、故障转移
使用Flume1监控文件内容变动,Flume1将变动内容通过其sink组中的sink分别对接Flume2和Flume3分别传递给Flume2和Flume3。采用Failover Sink Processor 实现故障转移的功能。Flume2和Flume3分别输出到控制台。
1、创建监控目录
group2目录用于 放3个 flume 的配置文件
data目录用于 flume2 写出数据到data
mkdir -p /opt/module/flume/job/group2
2、编写配置文件
分别编写flume1、flume2、flume3的配置文件
2.1. flume-file-flume.conf(相当于客户端)
监控文件内容,文件为 /opt/module/flume/test.log
cd /opt/module/flume/job/group2
vi flume-file-flume.conf
#给 Agent 指定使用的组件
a1.sources = r1
a1.channels = c1
a1.sinkgroups = g1
a1.sinks = k1 k2
#02 配置source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /opt/module/flume/test.log
a1.sources.r1.shell = /bin/bash -c
#通过 sinkgroups 中的 sinkgroups 设置故障转移
a1.sinkgroups.g1.processor.type = failover
#设置sinks中的k1和ke2的优先级,数值越大优先级越高,其中一个故障则进行故障转移
a1.sinkgroups.g1.processor.priority.k1 = 5
a1.sinkgroups.g1.processor.priority.k2 = 10
#当某个 Sink 失败时,Flume 会给它一个“惩罚时间”,在这段时间内不会尝试重新使用它。
a1.sinkgroups.g1.processor.maxpenalty = 10000
# 04配置sink:flume间串联必须用 avro类型为。指定主机、端口
# sink端的avro是一个数据发送者,都从 hadoop001 发送数据,发送到端口 4141 和 4142
a1.sinks.k1.type = avro
a1.sinks.k1.hostname = hadoop001
a1.sinks.k1.port = 4141
a1.sinks.k2.type = avro
a1.sinks.k2.hostname = hadoop001
a1.sinks.k2.port = 4142
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
a1.channels.c2.type = memory
a1.channels.c2.capacity = 1000
a1.channels.c2.transactionCapacity = 100
# 06 连接通道
a1.sources.r1.channels = c1
a1.sinkgroups.g1.sinks = k1 k2
a1.sinks.k1.channel = c1
a1.sinks.k2.channel = c1
2.2. flume-flume-console1.conf(相当于服务端)
cd /opt/module/flume/job/group2
vi flume-flume-console1.conf
#给 Agent 指定使用的组件
a2.sources = r1
a2.sinks = k1
a2.channels = c1
#02 配置source
# source端的avro是一个数据接收服务,接收来自hadoop001上 a1 的4141端口数据
a2.sources.r1.type = avro
a2.sources.r1.bind = hadoop001
a2.sources.r1.port = 4141
# 04配置sink:Flume输出的Source,输出是到本地控制台
a2.sinks.k1.type = logger
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a2.channels.c1.type = memory
a2.channels.c1.capacity = 1000
a2.channels.c1.transactionCapacity = 100
# 06 连接通道
a2.sources.r1.channels = c1
a2.sinks.k1.channel = c1
2.3. flume-flume-console2.conf(相当于服务端)
cd /opt/module/flume/job/group2
vi flume-flume-console2.conf
#给 Agent 指定使用的组件
a3.sources = r1
a3.sinks = k1
a3.channels = c2
#02 配置source
# source端的avro是一个数据接收服务,接收来自hadoop001上 a1 的4141端口数据
a3.sources.r1.type = avro
a3.sources.r1.bind = hadoop001
a3.sources.r1.port = 4142
# 04配置sink:Flume输出的Source,输出是到本地控制台
a3.sinks.k1.type = logger
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a3.channels.c2.type = memory
a3.channels.c2.capacity = 1000
a3.channels.c2.transactionCapacity = 100
# 06 连接通道
a3.sources.r1.channels = c2
a3.sinks.k1.channel = c2
3、创建脚本
vi /opt/module/genarete_log.sh
#!/bin/bash
# 删除旧文件
rm -rf /opt/module/flume/test.log# 第一个循环:1 到 100
for i in {1..100}; do
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/test.log
echo "生成第$i条数据.........."
sleep 0.5
done
4、启动Flume
启动flume,使用 cnc,即--conf 目录 --name agent 名称 --conf-file 配置文件 顺序不固定
注意,Flume 默认优先使用 log4j.xml,而忽略 -Dflume.root.logger 参数,因此需要先进行备份
mv log4j.xml log4j.xml.bak
分别打开三个窗口,在三个窗口分别执行
注意:要先启动服务端,在启动客户端,即先启动前2个,在启动最后一个。
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a2 --conf-file job/group2/flume-flume-console1.conf -Dflume.root.logger=INFO,console
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a3 --conf-file job/group2/flume-flume-console2.conf -Dflume.root.logger=INFO,console
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a1 --conf-file job/group2/flume-file-flume.conf
6、执行脚本
新打开一个窗口,执行脚本
/opt/module/genarete_log.sh
再将服务端的其中一个窗口关闭,则会故障转移。
九、负载均衡
1、编写配置文件
在 八、故障转移 章节基础上,只需要修改flume-file-flume.conf 文件
修改 a1.sinkgroups.g1.processor.type = load_balance 其他不变
cd /opt/module/flume/job/group2
vi flume-file-flume.conf
#给 Agent 指定使用的组件
a1.sources = r1
a1.channels = c1
a1.sinkgroups = g1
a1.sinks = k1 k2
#02 配置source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /opt/module/flume/test.log
a1.sources.r1.shell = /bin/bash -c
#通过 sinkgroups 中的 sinkgroups 设置负载均衡
a1.sinkgroups.g1.processor.type = load_balance
# 04配置sink:flume间串联必须用 avro类型为。指定主机、端口
# sink端的avro是一个数据发送者,都从 hadoop001 发送数据,发送到端口 4141 和 4142
a1.sinks.k1.type = avro
a1.sinks.k1.hostname = hadoop001
a1.sinks.k1.port = 4141
a1.sinks.k2.type = avro
a1.sinks.k2.hostname = hadoop001
a1.sinks.k2.port = 4142
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
a1.channels.c2.type = memory
a1.channels.c2.capacity = 1000
a1.channels.c2.transactionCapacity = 100
# 06 连接通道
a1.sources.r1.channels = c1
a1.sinkgroups.g1.sinks = k1 k2
a1.sinks.k1.channel = c1
a1.sinks.k2.channel = c1
2、启动Flume
启动flume,使用 cnc,即--conf 目录 --name agent 名称 --conf-file 配置文件 顺序不固定
注意,Flume 默认优先使用 log4j.xml,而忽略 -Dflume.root.logger 参数,因此需要先进行备份
mv log4j.xml log4j.xml.bak
分别打开三个窗口,在三个窗口分别执行 a2 、a3 、a1
注意:要先启动服务端,在启动客户端,即先启动前2个,在启动最后一个。
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a2 --conf-file job/group2/flume-flume-console1.conf -Dflume.root.logger=INFO,console
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a3 --conf-file job/group2/flume-flume-console2.conf -Dflume.root.logger=INFO,console
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a1 --conf-file job/group2/flume-file-flume.conf
3、执行脚本
新打开一个窗口,执行脚本,查看 a2 窗口 和 a3窗口 内容
/opt/module/genarete_log.sh
4、结束进程
ps -ef | grep flume | grep -v grep | awk '{print $2}' | xargs kill -9
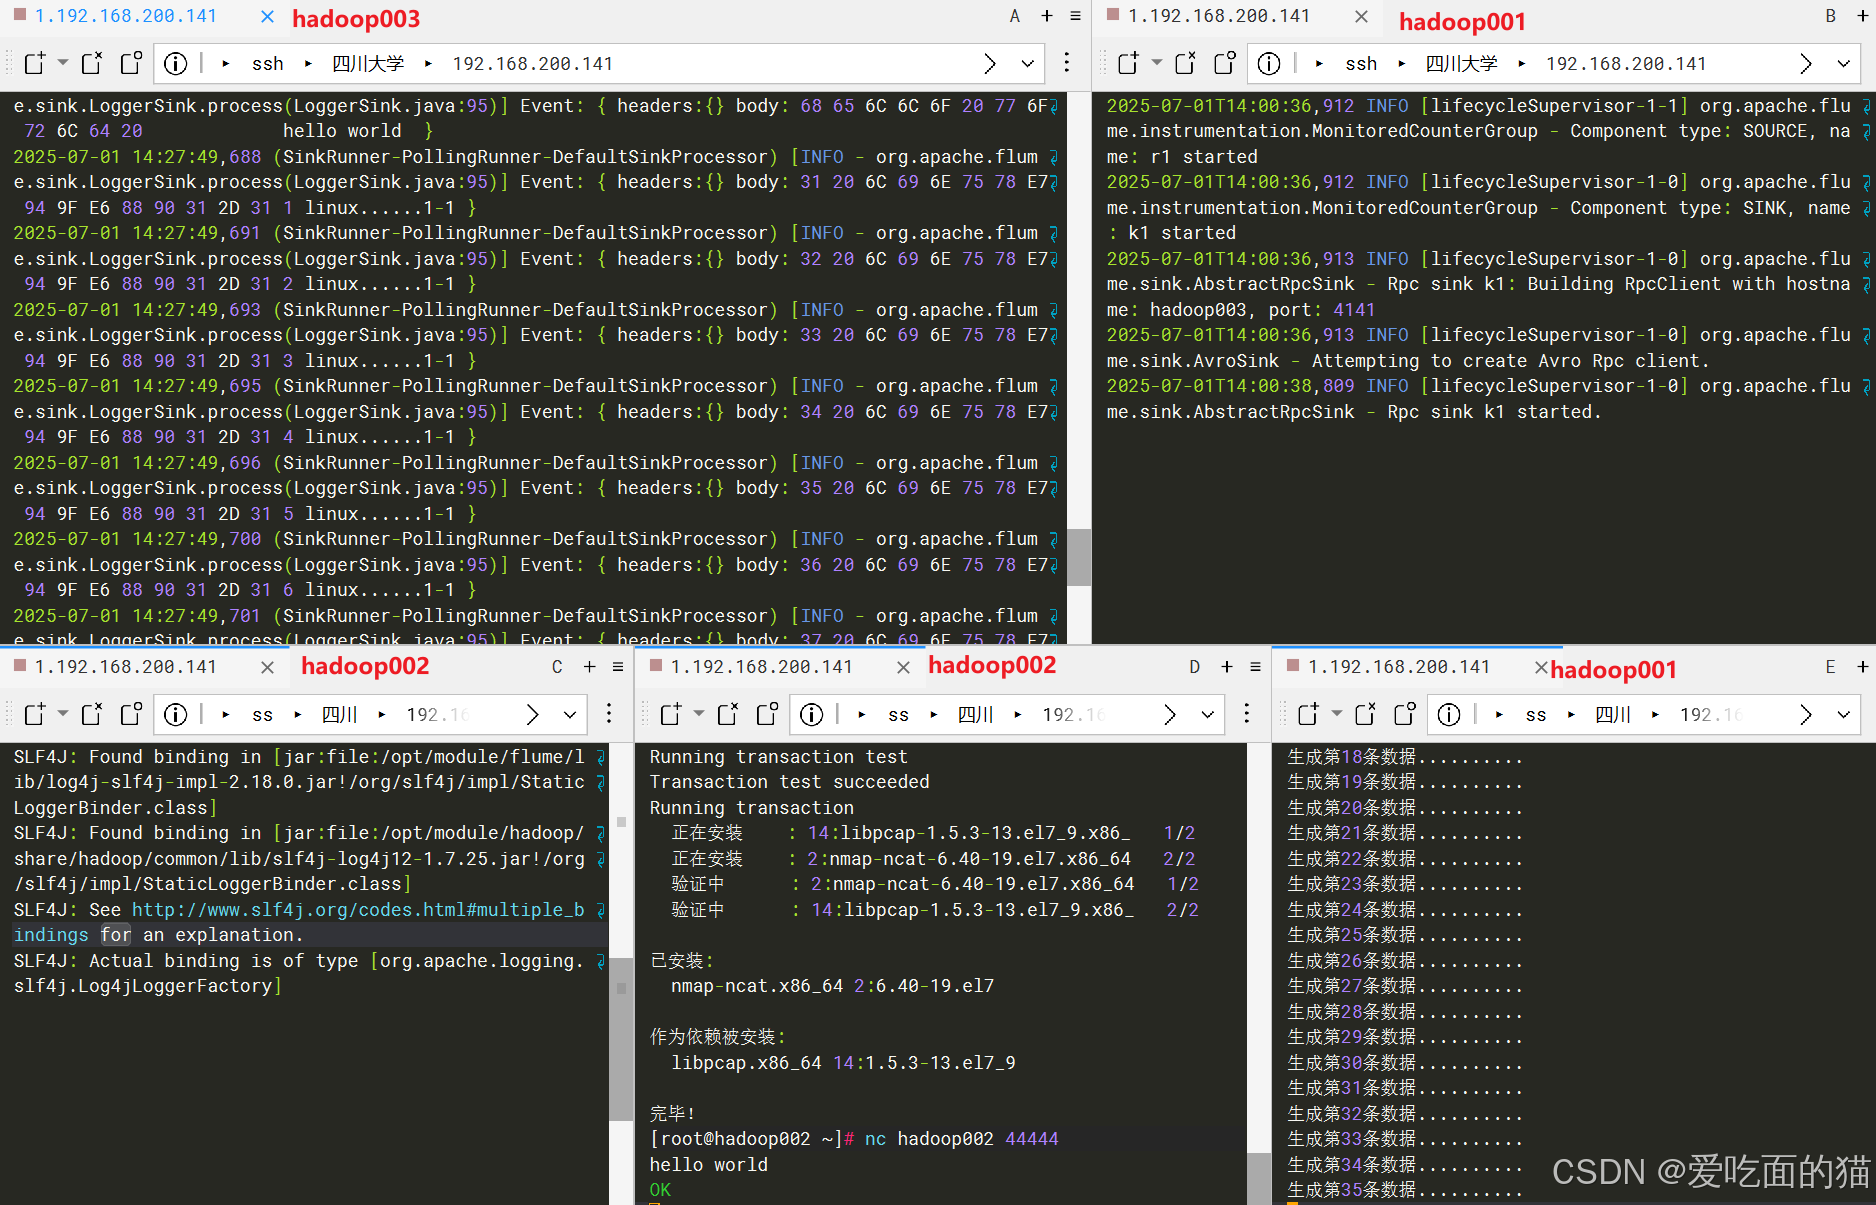
十、多个Flume聚合
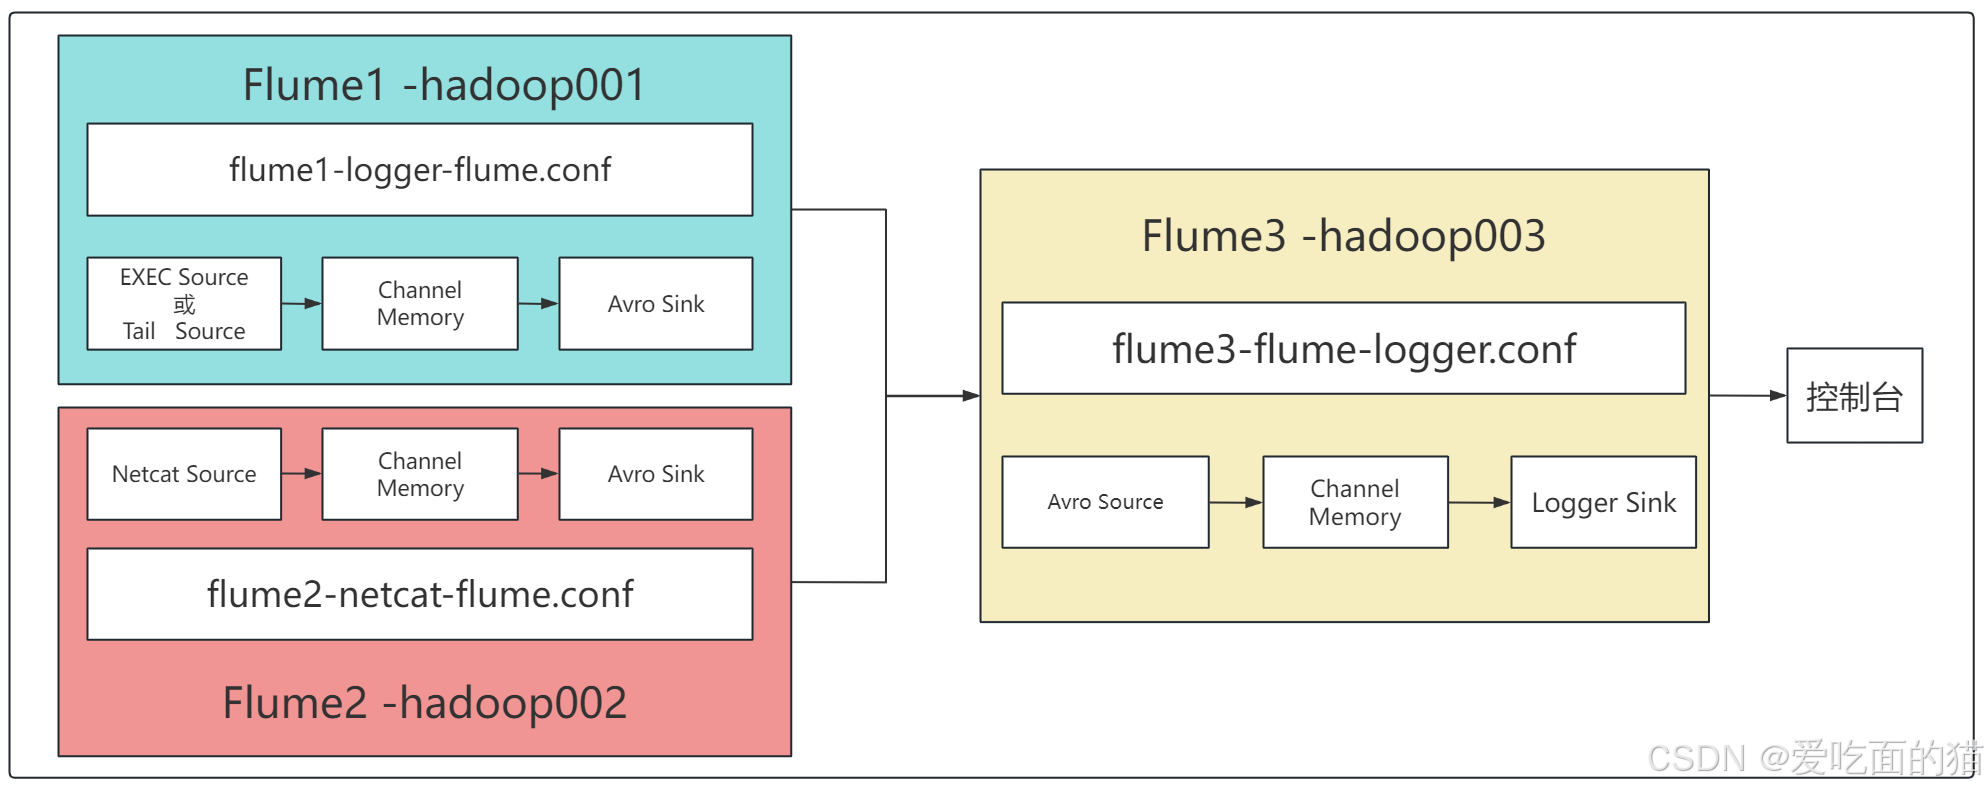
hadoop001上部署 Flume1,监控文件/opt/module/test.log
hadoop002上部署 Flume2,监控某一个端口的数据流
hadoop003上部署 Flume3,Flume1与Flume-将数据发送给hadoop003上的Flume3进行汇总,最终由Flume3将最终数据打印到控制台。
1、分发Flume文件
注意:在分发文件前要做好三台机器的IP与主机名映射 /etc/hosts
进行分发文件
scp -r /opt/module/flume root@hadoop002:/opt/module/flume
scp -r /opt/module/flume root@hadoop003:/opt/module/flume
scp -r /opt/module/java root@hadoop002:/opt/module/java
scp -r /opt/module/java root@hadoop003:/opt/module/java
scp -r /etc/profile root@hadoop002:/etc/profile
scp -r /etc/profile root@hadoop003:/etc/profile
让三台机器文件生效
ssh hadoop001 "source /etc/profile"
ssh hadoop002 "source /etc/profile"
ssh hadoop003 "source /etc/profile"
2、创建监控目录
在 hadoop001、hadoop002、hadoop003 上分别创建目录
group3目录用于 放3个 flume 的配置文件
ssh hadoop001 "mkdir -p /opt/module/flume/job/group3"
ssh hadoop002 "mkdir -p /opt/module/flume/job/group3"
ssh hadoop003 "mkdir -p /opt/module/flume/job/group3"
2、编写配置文件
分别编写hadoop001、hadoop002、hadoop003上的flume1、flume2、flume3的配置文件
2.1. flume3-flume-logger.conf(相当于服务端)
在hadoop003上 配置 flume3-flume-logger.conf
cd /opt/module/flume/job/group3
vi flume3-flume-logger.conf
#给 Agent 指定使用的组件
a3.sources = r1
a3.sinks = k1
a3.channels = c1
#02 配置source
# source端的avro是一个数据接收服务,接收来自hadoop上 a1 和 a2 的4141端口数据
a3.sources.r1.type = avro
a3.sources.r1.bind = hadoop003
a3.sources.r1.port = 4141
# 04配置sink:Flume输出的Source,输出是到本地控制台
a3.sinks.k1.type = logger
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a3.channels.c1.type = memory
a3.channels.c1.capacity = 1000
a3.channels.c1.transactionCapacity = 100
# 06 连接通道
a3.sources.r1.channels = c1
a3.sinks.k1.channel = c1
2.2. flume2-netcat-flume.conf(相当于客户端)
在hadoop002上 配置 flume2-netcat-flume.conf
cd /opt/module/flume/job/group3
vi flume2-netcat-flume.conf
#给 Agent 指定使用的组件
a2.sources = r1
a2.sinks = k1
a2.channels = c1
#02 配置source
#
netcat启动TCP服务器,监听 hadoop002的 44444 端口a2.sources.r1.type = netcat
a2.sources.r1.bind = hadoop002
a2.sources.r1.port = 44444
# 04配置sink
# source端的avro是一个数据发送服务,发送数据到 hadoop003 的 4141端口
a2.sinks.k1.type = avro
a2.sinks.k1.hostname = hadoop003
a2.sinks.k1.port = 4141
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a2.channels.c1.type = memory
a2.channels.c1.capacity = 1000
a2.channels.c1.transactionCapacity = 100
# 06 连接通道
a2.sources.r1.channels = c1
a2.sinks.k1.channel = c1
2.3. flume1-logger-flume.conf(相当于客户端)
在hadoop001上 配置 flume1-logger-flume.conf
监控文件内容,文件为 /opt/module/flume/test.log
cd /opt/module/flume/job/group3
vi flume1-logger-flume.conf
#给 Agent 指定使用的组件
a1.sources = r1
a1.sinks = k1
a1.channels = c1
#02 配置source
a1.sources.r1.type = exec
a1.sources.r1.command = tail -F /opt/module/flume/test.log
a1.sources.r1.shell = /bin/bash -c
# 04配置sink:flume间串联必须用 avro类型为。指定主机、端口
# source端的avro是一个数据发送服务,发送数据到 hadoop003 的 4141端口
a1.sinks.k1.type = avro
a1.sinks.k1.hostname = hadoop003
a1.sinks.k1.port = 4141
# 05 配置通道:方式、最多缓存Event个数、每次事务最多处理的Event个数
# 作为 Source 和 Sink 之间的“中转站”,缓解两者速度不一致的问题
a1.channels.c1.type = memory
a1.channels.c1.capacity = 1000
a1.channels.c1.transactionCapacity = 100
# 06 连接通道
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
3、创建脚本
在hadoop001上 创建脚本 /opt/module/genarete_log.sh
vi /opt/module/genarete_log.sh
#!/bin/bash
# 删除旧文件
rm -rf /opt/module/flume/test.log# 第一个循环:1 到 100
for i in {1..100}; do
echo "$i linux生成1-100的数字的for循环" >> /opt/module/flume/test.log
echo "生成第$i条数据.........."
sleep 0.5
done
4、启动Flume
分别打开三个窗口,在三个窗口分别执行
注意:要先在hadoop003上启动服务端,再在hadoop001上启动客户端,最后hadoop002启动netcat
hadoop003上
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a3 --conf-file job/group3/flume3-flume-logger.conf -Dflume.root.logger=INFO,console
hadoop002
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a2 --conf-file job/group3/flume2-netcat-flume.conf
hadoop001
cd /opt/module/flume
bin/flume-ng agent --conf conf/ --name a1 --conf-file job/group3/flume1-logger-flume.conf
6、执行脚本
在hadoop001上打开一个新窗口,执行脚本
/opt/module/genarete_log.sh
在hadoop002上打开一个新窗口,执行
nc hadoop002 44444
在hadoop003窗口控制台查看效果

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献7条内容

所有评论(0)