AI编程/RAG基础教程(二)快速开发基于本地大模型和 FAISS 的 RAG 程序
前言
检索增强生成(Retrieval-Augmented Generation, RAG)模型已成为构建高效、准确智能问答系统的热门技术。它通过结合信息检索与大型语言模型的优势,有效解决了大模型幻觉、知识时效性等问题,使AI回复更加精准可靠。
本教材将带领大家从零开始,利用AI编程工具——Cursor,快速搭建一套完整的RAG问答系统。我们将采用纯Python编码,后端服务基于FastAPI构建,前端则使用Streamlit实现轻量化展示。
一、RAG项目架构与核心模块设计
在开始编码之前,让我们先明确项目的整体架构和关键模块,这将有助于我们更好地组织代码和理解RAG的工作流程。
我们的RAG系统将遵循以下核心设计原则:
- 数据管理集中化: 设立
data目录,专门用于存放待处理的文档数据(如PDF文件)。后续我们将对这些数据进行读取、清洗、切分以及向量化处理。 - 本地向量库存储: 采用本地向量数据库(如FAISS)存储向量化后的知识片段。索引文件将统一放置在
./indexs目录,便于管理和复用。 - 模块化代码结构:
config目录:存放系统配置文件,如API密钥、模型路径等。logs目录:用于存储运行时日志,方便问题排查和性能监控。src目录:项目的核心代码区域。我们将在此目录下进一步细分模块,例如src/rag_core用于RAG核心逻辑,src/api用于接口定义,src/frontend用于Streamlit前端等,以确保代码的清晰和可维护性。
- API服务接口:
app.py将作为主要的接口服务文件,至少包含以下两个核心接口:/chat:标准的聊天接口,用于接收用户问题并返回AI生成的回答。/chat_stream:流式聊天接口,支持AI回答的实时分块输出,提升用户体验。
RAG核心流程概览:
整个RAG系统将围绕以下通用流程展开:
- 用户输入处理: 当用户输入一个问题时,首先将该问题进行向量化。
- 知识检索: 将用户问题的向量与本地向量库中存储的知识片段向量进行匹配,检索出与问题最相关的 N 条文档片段。
- 大模型增强: 将检索到的相关文档片段作为“上下文信息”,连同用户问题一同输入给大型语言模型(LLM)。
- 生成回复: LLM结合提供的上下文和用户问题,生成一个准确、连贯的回复。
二、使用AI编程工具生成初始代码
现在,让我们利用AI编程工具(以Cursor为例)的强大能力,快速生成项目的基础代码。
首先我们组织一套提示词:
我现在需要从零构建一个简易的RAG系统。
我希望这个项目采用纯python编码,服务用FastAPI编写。
我希望用streamlit的轻量化前端展示效果。我的一些要求如下:
1、需要构建一个data目录用于存放待处理的文档数据:后续将针对这些数据进行读取、清洗、切分以及向量化。
2、如何采用本地向量库,向量化后的索引文件放置在./indexs
3、配置文件目录为config,日志文件目录为logs,核心代码放到src目录,src目录中可以分模块存储代码
4、定义接口服务的文件为:app.py,至少包含以下接口:
一个聊天接口
/chat
一个流式接口
/chat_stream按照通用的RAG流程开始执行:
将用户的输入向量化,然后和向量库中的知识片段的向量进行匹配,返回最相关的n条文档片段,然后丢给大模型进行生成回复。
然后给到一些代码示例(作为RAG核心逻辑的初步演示),这里我们使用教程(一)中的代码示例,为了方便大家理解RAG的核心流程,我们先提供一个独立的Python脚本,它演示了从PDF加载、文档拆分、向量存储、再到大模型问答的完整链条。在实际项目中,这些功能将根据模块化设计进行拆分和整合。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
演示RAG核心流程:PDF -> 文档拆分 -> 向量检索 -> 智能问答
"""

from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import CharacterTextSplitter
from langchain_ollama import OllamaEmbeddings
from langchain_community.vectorstores import FAISS
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser

def main():
    """RAG完整演示"""
    # 步骤1:加载PDF
    loader = PyPDFLoader("./data/pdf/《Deepseek R1 本地部署完全手册》.pdf")
    documents = loader.load()
    # 步骤2:拆分文档
    splitter = CharacterTextSplitter(chunk_size=800, chunk_overlap=100)
    split_docs = splitter.split_documents(documents)

    # 步骤3:创建向量存储
    embeddings = OllamaEmbeddings(model="bge-m3:latest", base_url="http://localhost:11434")
    # 加载本地的Faiss向量文件,allow_dangerous_deserialization 用于控制是否允许在加载向量存储时进行潜在的危险反序列化操作。
    vector_store = FAISS.from_documents(split_docs, embeddings,allow_dangerous_deserialization=True)
    retriever = vector_store.as_retriever(search_kwargs={'k': 3})

    # 步骤4:初始化LLM
    llm = ChatOpenAI(model="qwen3:14b", api_key='ollama', base_url='http://localhost:11434/v1')

    # 步骤5:构建RAG链
    prompt = ChatPromptTemplate.from_messages([
        ("system", "根据以下上下文回答问题:\n{context}"),
        ("human", "{question}")
    ])

    rag_chain = (
        {"context": retriever | (lambda docs: "\n\n".join([d.page_content for d in docs])),
         "question": RunnablePassthrough()}
        | prompt | llm | StrOutputParser()
    )

    # 预设问题演示
    questions = [
        "DeepSeek R1 是什么?",
        "如何进行本地部署?",
        "需要什么硬件配置?"
    ]

    for i, question in enumerate(questions, 1):
        # 流式输出
        for chunk in rag_chain.stream(question):
            print(chunk, end="", flush=True)

    # 交互式问答
    while True:
        question = input("\n❓ 您的问题: ").strip()
        if question.lower() in ['quit', 'exit', '退出']:
            break
        if question:
            print("💬 AI回答: ", end="")
            for chunk in rag_chain.stream(question):
                print(chunk, end="", flush=True)
            print()

if __name__ == "__main__":
    main()
项目依赖 (requirements.txt):
为了确保上述代码能够正常运行,您需要安装以下Python库。请在项目根目录下创建 requirements.txt 文件,并添加以下内容:
langchain_openai
langchain_core
langchain_ollama
langchain_community
faiss-cpu
pypdf
langchain-text-splitters
安装依赖:pip install -r requirements.txt
其他需要的依赖说明:
fastapi和uvicorn: 用于构建后端API服务。streamlit: 用于构建前端展示界面。python-dotenv: 如果您需要从.env文件加载配置,可能需要此库。
请根据cursor生成的确切代码和相关指示,自行补充和安装所需的额外依赖。
三、项目启动与效果展示
按照上述步骤,当cursor成功生成了FastAPI后端和Streamlit前端代码后,我们可以分别启动它们。
后端启动成功界面
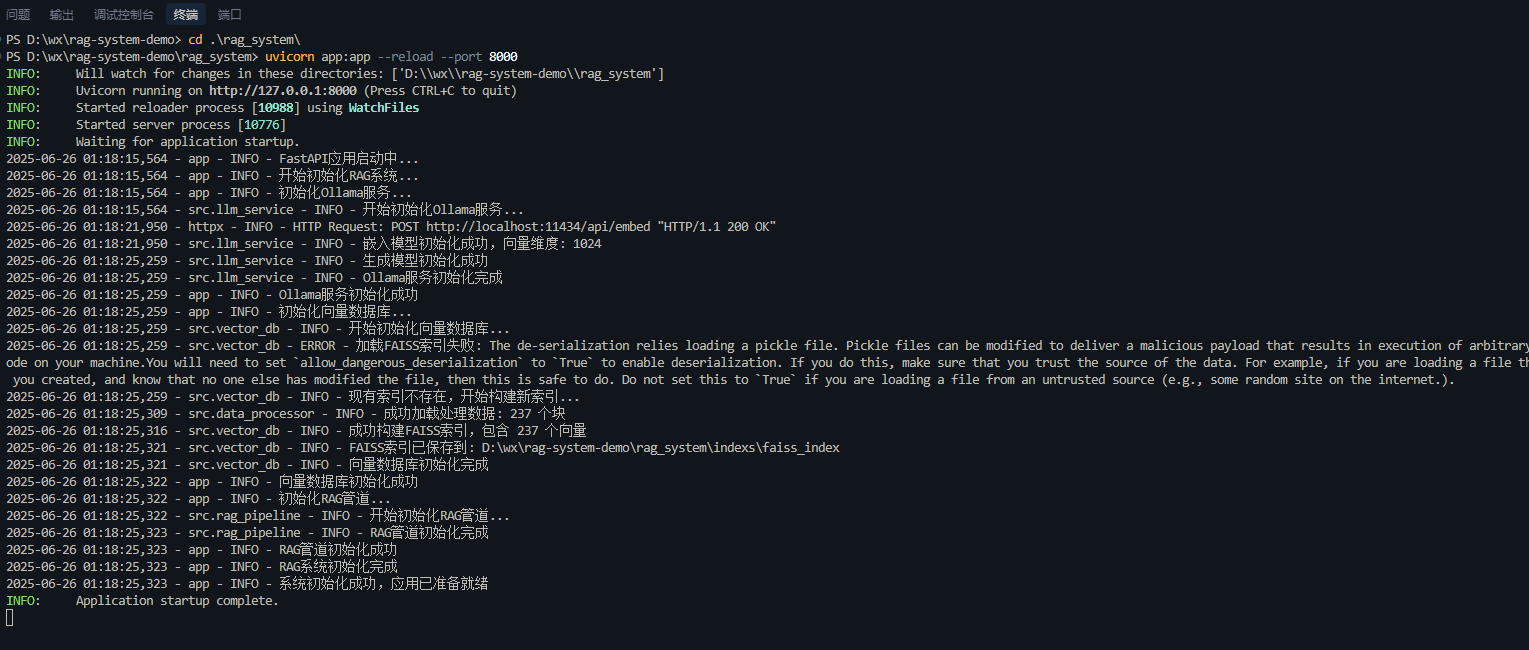
可以看到,后台成功处理了我放在data目录下的PDF文档,切分并生成了237个向量后存储在了本地。
前端启动成功界面:
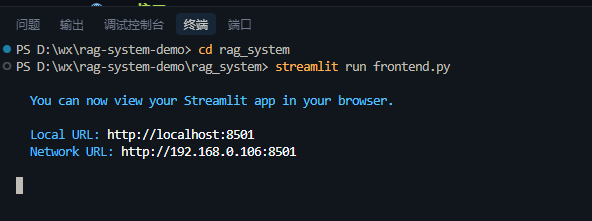
使用浏览器访问:http://localhost:8501/
即可看到前端界面:

我们来问问题试试:

可以RAG系统检索到了一些文档,并且生成了回复。并且我们可以看到前端还展示了检索到的文档片段:
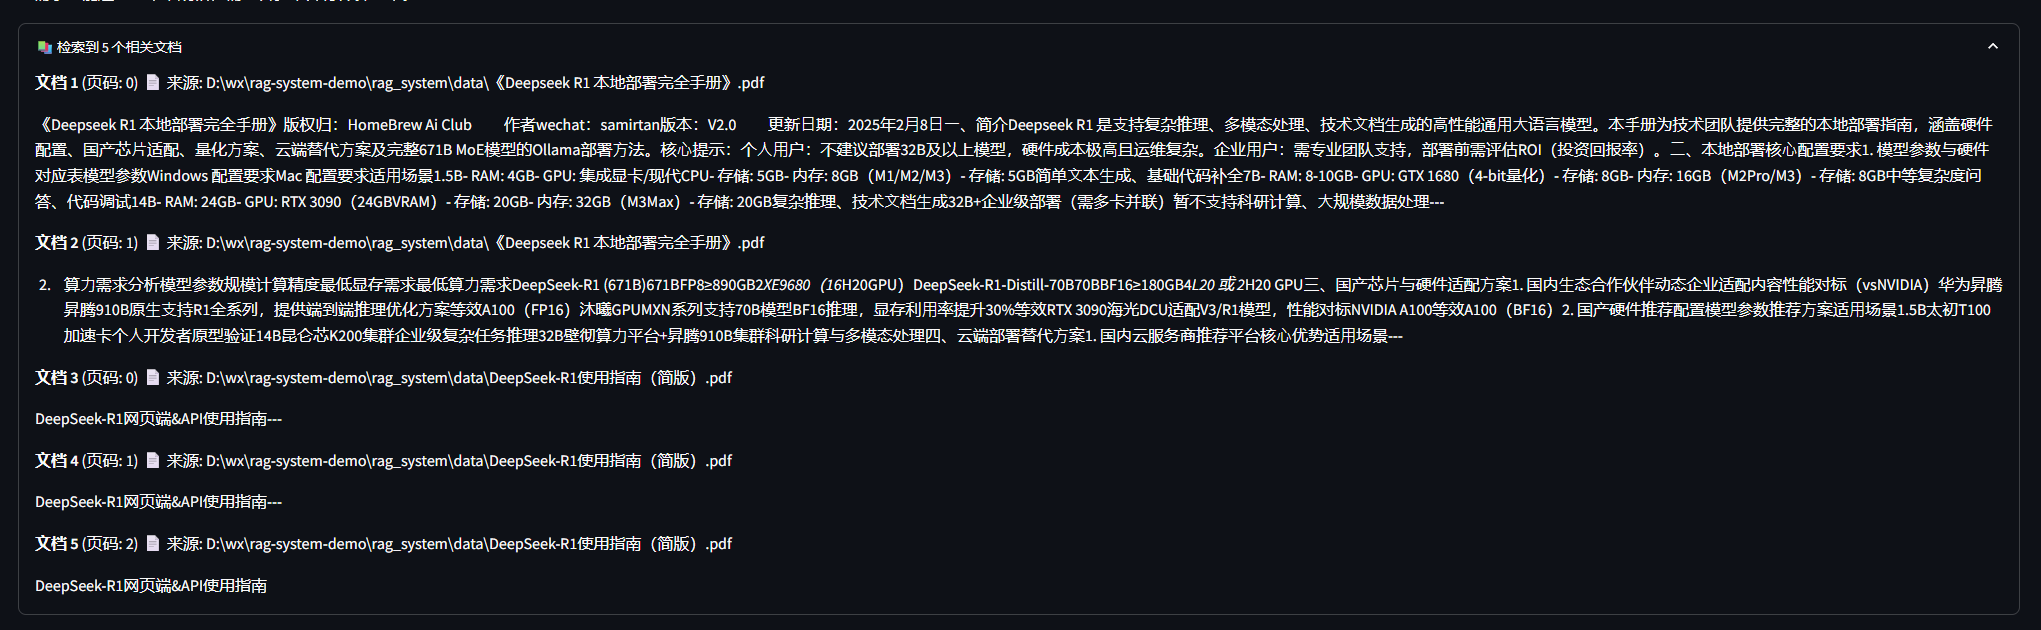
至此,初步的RAG项目代码已经完成构建,这是一套包含前端、后端,包括文档读取、切分和向量化的完整项目示例。
后记
但我们仔细观察,尽管我们已经成功搭建了一个初步的RAG问答系统并实现了基本功能,但从实际的回答效果来看,当前系统的表现并不尽如人意。例如,回复不够准确、不够详细...
为什么会出现这种情况呢? 造成RAG系统回答效果不佳的原因是多方面的,这正是我们在后续课程中需要深入探讨和优化的核心内容。后续教程我们将深入讨论以下问题:
- 文档切分策略: 当前的
chunk_size和chunk_overlap参数是否合理?过大或过小的文本块都可能影响检索效果。 - 嵌入模型选择:
bge-m3模型虽然强大,但它是否最适合我们的特定数据集和应用场景? - 提示词工程: 传递给大模型的提示词是否足够清晰、明确?如何引导大模型更好地利用上下文信息进行回答?
- 数据质量与预处理: 原始PDF文档的质量如何?是否存在难以解析的复杂格式或噪声数据?文档清洗和预处理是否到位?
- RAG链的复杂性: 简单的RAG链可能无法处理复杂的多跳问题或需要推理的场景。是否需要引入更复杂的RAG范式,如子问题分解、多阶段检索等?
如需项目完整的提示词及代码,可以关注我的公众号【AI架构笔记】免费领取。下次我们再会。
🔗 延伸阅读与调优实战:
想解决RAG落地中的准确率问题?我在公众号 【AI架构笔记】 发布了深度配套文章:
>> 《RAG系统调优实战:5个关键策略提升答案准确率》
💡 为什么关注【AI架构笔记】?
-
持续获取 RAG/LLM 架构核心教程与避坑指南
-
深入拆解 大模型应用、Agent系统、推理优化
-
一手资源 开源工具测评、行业方案、学习图谱
👇 扫码立即关注,解锁所有AI架构干货 👇

或微信搜索:AI架构笔记
构建稳定、高效的AI应用,从这里开始!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 27
 0
- 0


 已为社区贡献1条内容

所有评论(0)