知识蒸馏:深度学习的炼金术——从复杂到精简的智能萃取之道
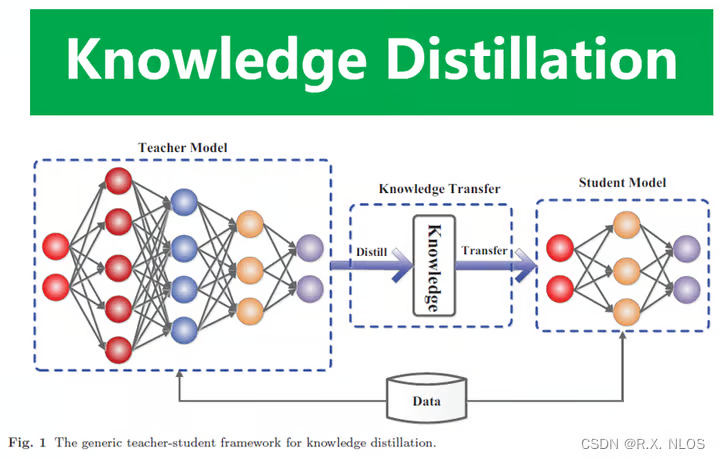
蒸馏的本质:知识传递的炼金术
知识蒸馏(Knowledge Distillation)是一种将复杂模型的知识"精华"提取并转移到小型模型的技术,如同咖啡师从咖啡豆中萃取芳香精粹的过程。想象一位资深医疗专家(大模型)教导实习医生(小模型)的场景:
- 经验传承:专家展示复杂的诊断思路(教师模型输出logits)
- 案例解析:讲解典型病例的判断依据(软标签与概率分布)
- 提炼要点:总结核心诊断原则(知识蒸馏损失函数)
- 实践训练:实习生模拟专家诊断并得到反馈(学生模型训练)
最终,实习医生掌握专家的核心诊断能力,但决策速度更快、资源消耗更少。
核心概念详解
教师模型(Teacher Model):
拥有复杂知识体系的专家,如ImageNet上训练的ResNet-152(1千万参数),分类精度达85%,但推理耗时200ms
学生模型(Student Model):
待培养的轻量模型,如MobileNetV3(500万参数),目标达到接近ResNet的性能,推理速度提升到10ms
软标签(Soft Labels):
不同于传统的0/1硬标签,是教师模型输出的类概率分布:
猫: 0.75, 虎: 0.20, 猞猁: 0.05
蕴含丰富的相似类别关系知识
温度参数(Temperature):
概率分布的"平滑调节器":
- 高温度(T=10):软化分布,揭示类别间潜在关系
- 低温度(T=1):接近原始预测分布
- 数学表达:
蒸馏损失(KL-Divergence Loss):
衡量教师与学生知识差距的尺子:
知识蒸馏的战略价值与战场实践
革命性应用场景
智能手机端AI部署:
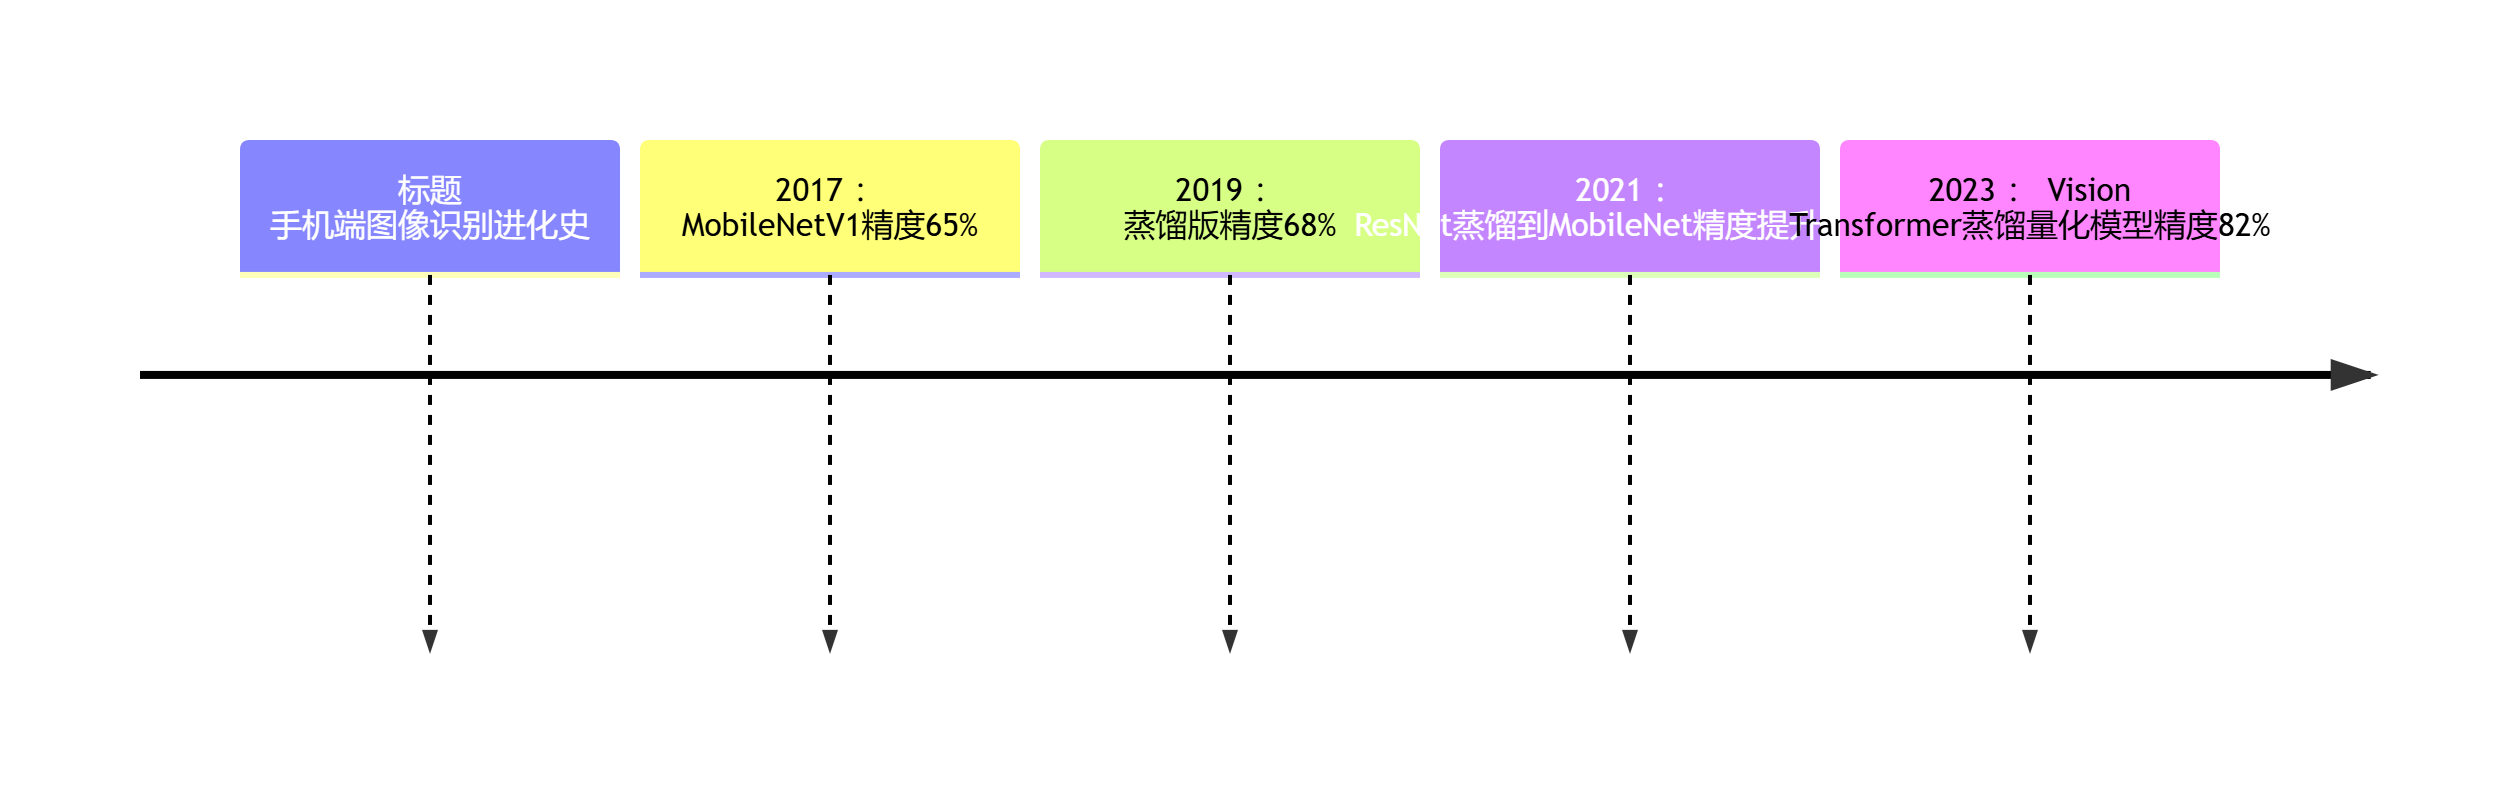
华为旗舰手机实现毫秒级图像识别,功耗降低60%
工业物联网实时质检:
- 教师模型:云端ResNet-50模型(精度99.2%)
- 学生模型:边缘设备部署的TinyML模型(精度98.7%)
- 效果:富士康产线检测延迟从500ms→50ms,吞吐量提升10倍
金融风控分布式系统:
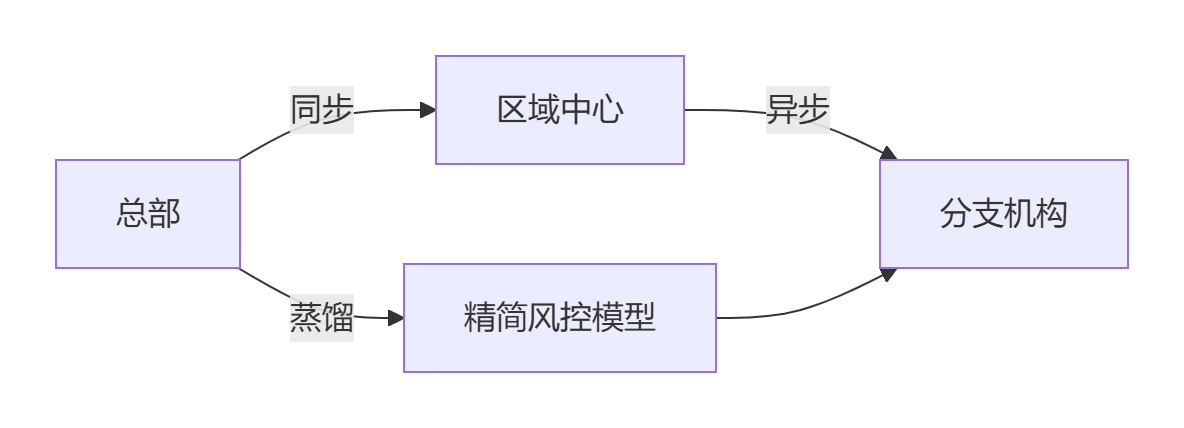
建设银行风控系统:
- 原模型:300GB内存需求
- 蒸馏后:18GB内存需求
- 响应速度:250ms→35ms
知识蒸馏价值矩阵
| 维度 | 原始模型 | 蒸馏模型 | 提升幅度 |
|---|---|---|---|
| 参数量 | 100% | 10-20% | ↓80-90% |
| 推理延迟 | 100% | 10-30% | ↓70-90% |
| 能耗 | 100% | 5-20% | ↓80-95% |
| 精度损失 | 基线 | 1-2% | 微小牺牲 |
| 部署成本 | $100,000 | $10,000 | ↓90% |
知识蒸馏的核心架构与工作流程
蒸馏系统全景图
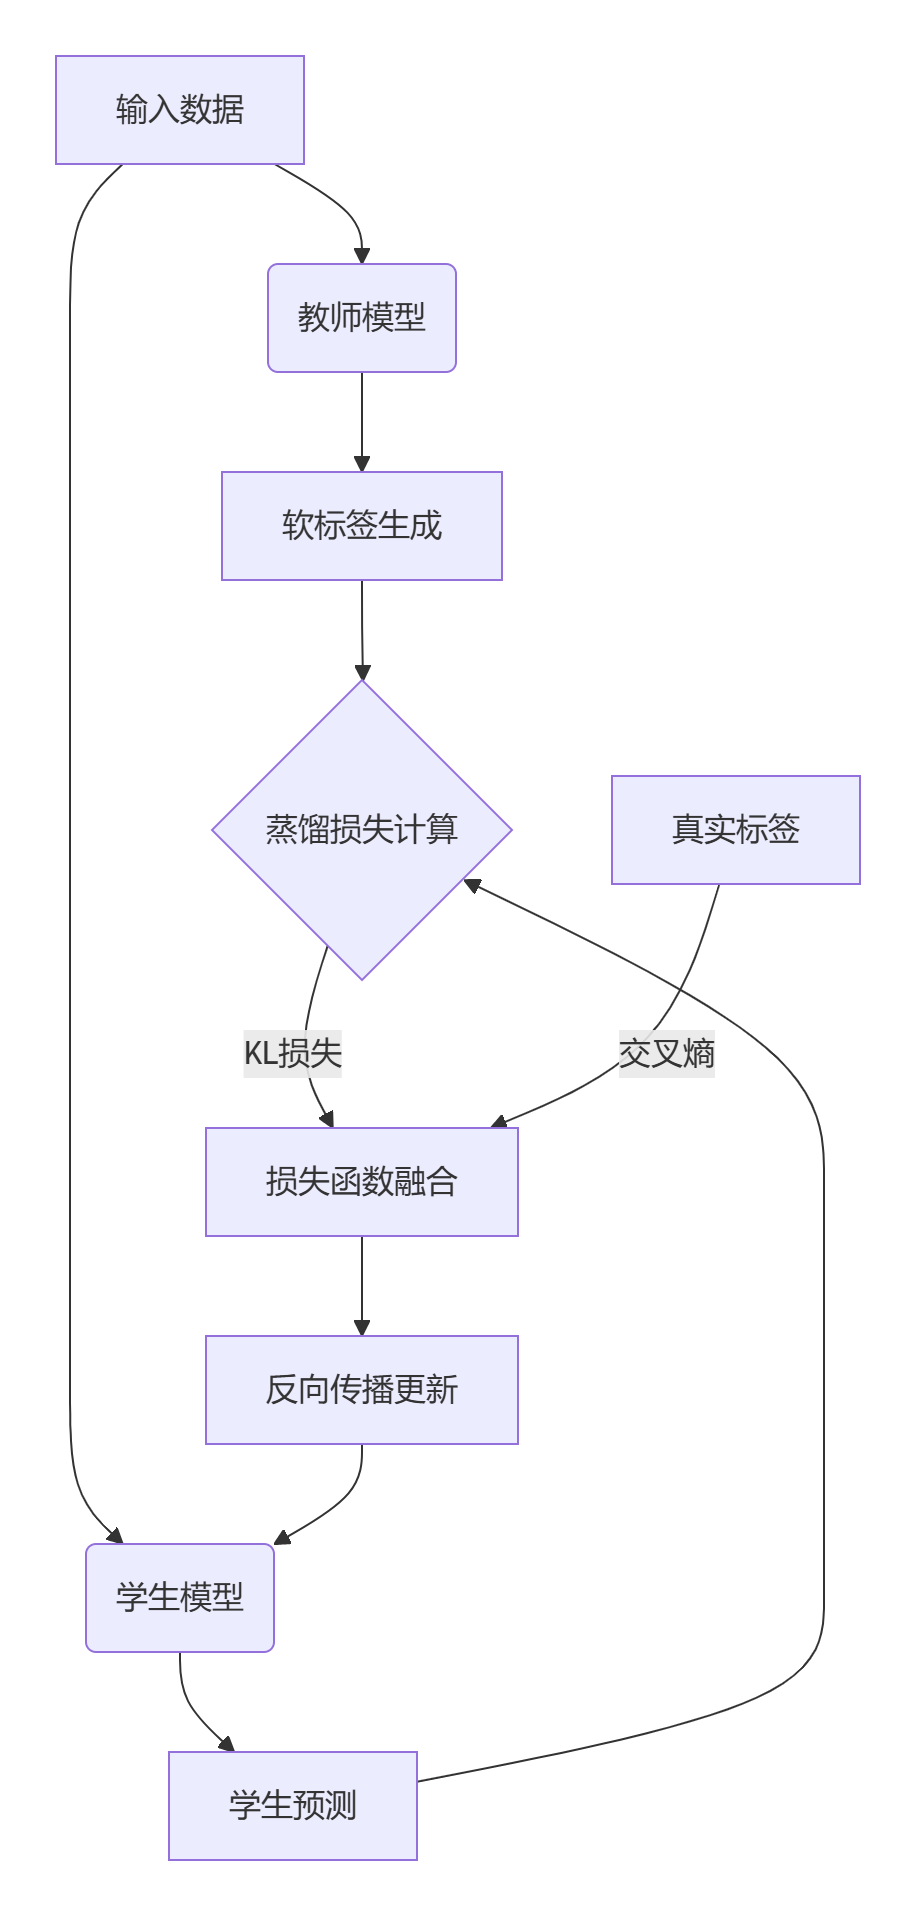
关键组件深度解析
温度调制器:
- 数学变换:
- 高温(T>5)效应:模糊相似类别的决策边界
- 低温(T=1)效应:强化主导类别的置信度
- 典型策略:训练阶段T=4,推理阶段T=1
损失融合引擎:
其中
层次化蒸馏路径:
- 特征层对齐:约束学生模型中间层输出匹配教师
- 注意力图传递:复制教师模型的视觉聚焦区域
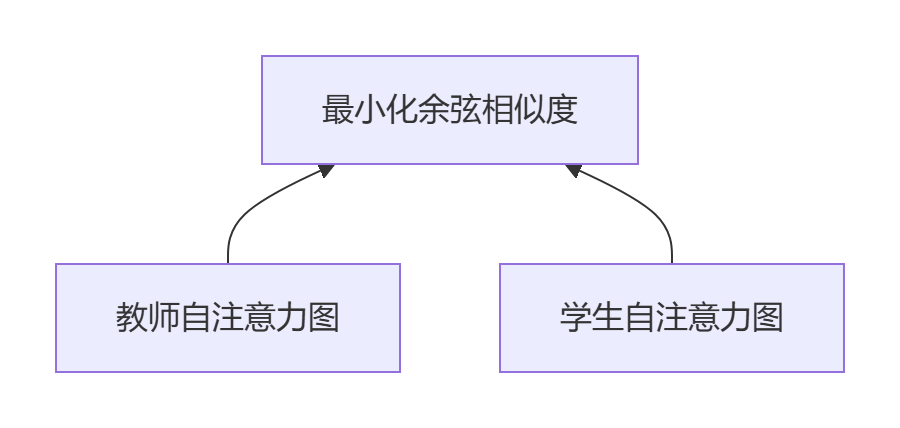
- logits知识转移:概率分布层面的知识传承
蒸馏工作流程详解
图像分类案例全流程
数据准备阶段:
- 收集100万张ImageNet图片
- 训练ResNet-152教师模型至80%准确率
- 生成软标签库:每张图片的类别概率分布
蒸馏实施阶段:
-
初始冷冻期(前5轮):
- 只启用蒸馏损失(
- 高温设置(T=10)
- 学生模型专注学习教师的认知方式
- 只启用蒸馏损失(
-
融合过渡期(6-15轮):
- T从10降至3
- 逐步引入真实标签的交叉熵监督
-
精细调整期(16-30轮):
- 全量真实标签监督
- 微调学生模型的关键参数
典型结果:
+-----------------+-------------+--------------+------------+
| 模型            | 参数量      | ImageNet精度 | 推理延迟   |
+-----------------+-------------+--------------+------------+
| ResNet-152      | 60M         | 80.2%        | 210ms      |
| MobileNetV3     | 5M          | 68.3%        | 32ms       |
| KD-MobileNetV3  | 5M          | 76.5%        | 35ms       |
+-----------------+-------------+--------------+------------+
对话模型蒸馏流程
微软小冰系统的技术演进:
- 教师模型:175B参数的GPT-4对话引擎
- 学生模型:1.3B参数的移动端优化模型
- 两阶段蒸馏:
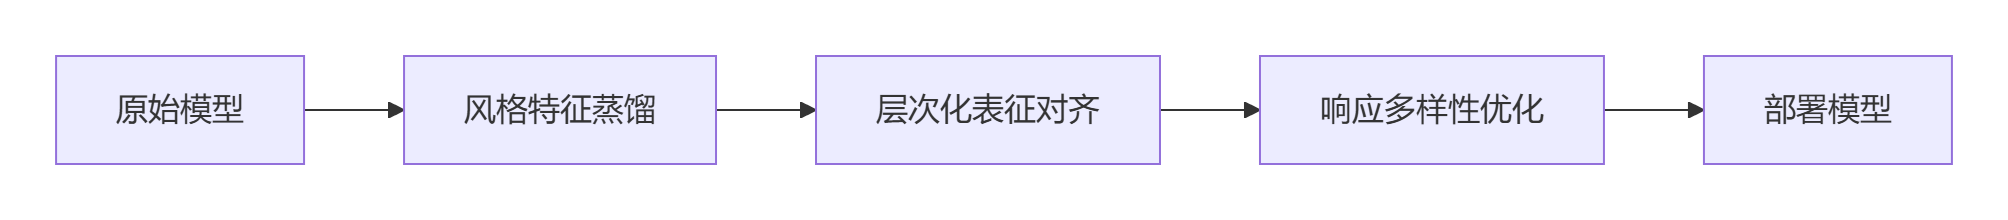
- 特殊技术:逐步冻结注意力头
- 性能对比:
- GPT-4响应时间:1.8秒
- 蒸馏模型响应时间:0.3秒
- 人工评价相似度:92%
核心数学原理精析
知识蒸馏的统计基础
KL散度知识转移:
其中:
温度调控机制:
损失融合方程
其中t为当前训练轮数,E为总轮数
前沿蒸馏技术全景
蒸馏技术进化树
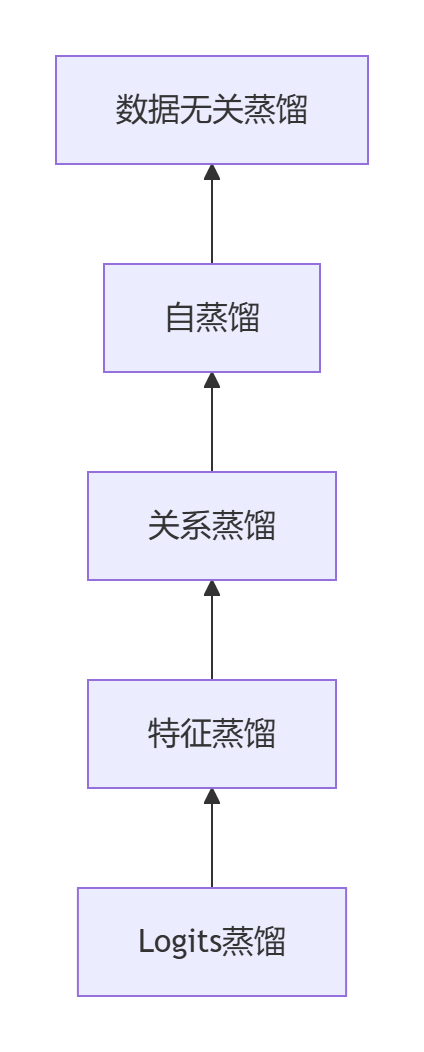
革命性变体技术
1. 注意力蒸馏
核心创新:
- 转移教师模型的视觉聚焦机制
- 三层注意力迁移:
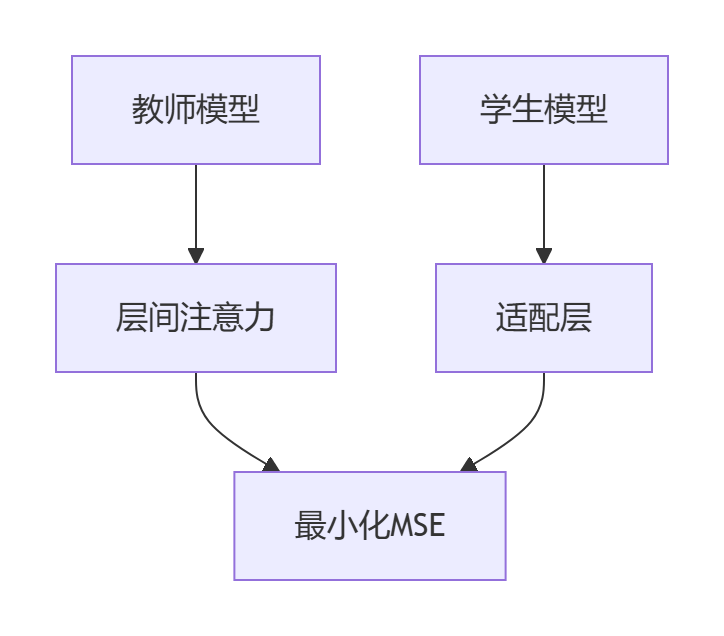
- 损失函数:
工业应用:
- Tesla自动驾驶视觉系统:
- 教师:ResNeXt-101
- 学生:高效CNN
- 效果:GPU占用率从35%降至7%
2. 对比蒸馏(CD)
架构革新:
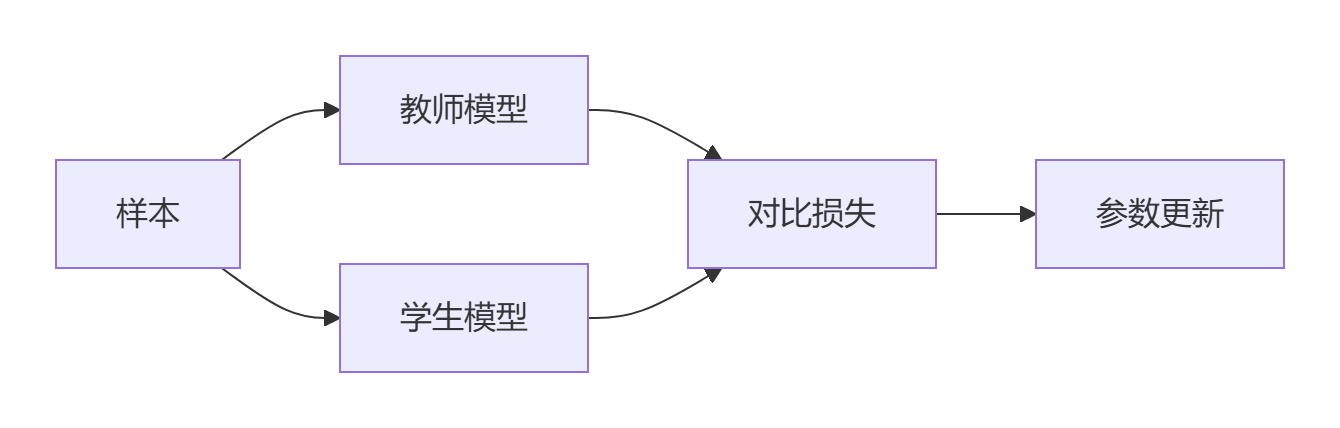
- 核心方程:
性能突破:
+----------------+---------------+----------------+
| 数据集         | 传统蒸馏      | 对比蒸馏       |
+----------------+---------------+----------------+
| CIFAR-100      | 74.2%         | 78.5%          |
| ImageNet-1K    | 76.3%         | 79.8%          |
| Places365      | 47.8%         | 52.1%          |
+----------------+---------------+----------------+
3. 自知识蒸馏(SKD)
范式革命:
- 无需独立教师模型
- 相同网络进行知识提炼
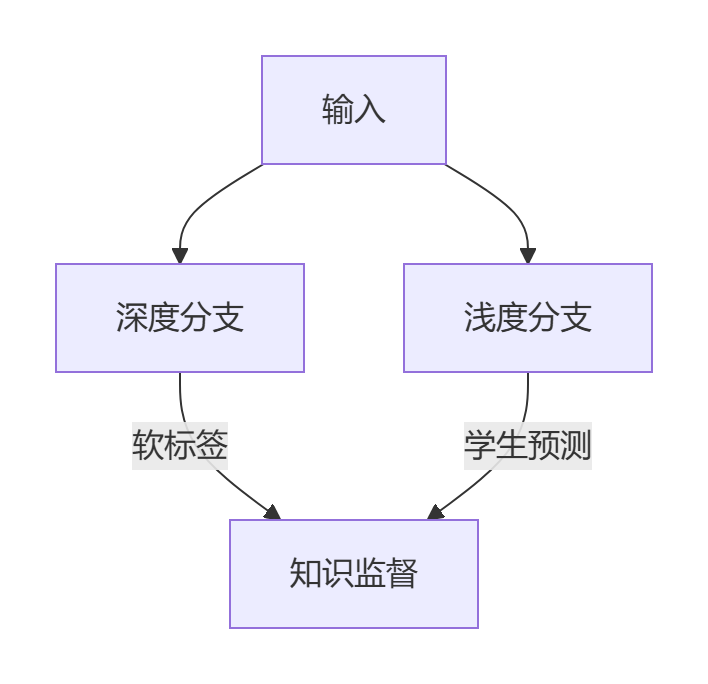
创新应用:
- 多级特征融合:
- 空间信息传递:
在图像分割中提升小目标识别精度:- 原始模型IoU:71.3%
- 自蒸馏后IoU:74.9%
蒸馏加速技术家族
| 技术 | 蒸馏周期 | 教师依赖度 | 适用场景 |
|---|---|---|---|
| 渐进蒸馏 | 90% | 高 | 大模型压缩 |
| 离线蒸馏 | 50% | 中 | 常规部署 |
| 在线蒸馏 | 100% | 低 | 实时训练系统 |
| 零样本蒸馏 | 20% | 无 | 隐私敏感场景 |
工业级实现指南
PyTorch蒸馏框架
import torch
import torch.nn.functional as F

class KnowledgeDistillationLoss(nn.Module):
    def __init__(self, alpha=0.7, T=4):
        super().__init__()
        self.alpha = alpha
        self.T = T

    def forward(self, output_student, output_teacher, target):
        # 交叉熵损失
        loss_ce = F.cross_entropy(output_student, target)

        # KL散度蒸馏损失
        soft_teacher = F.softmax(output_teacher / self.T, dim=1)
        soft_student = F.log_softmax(output_student / self.T, dim=1)
        loss_kd = F.kl_div(soft_student, soft_teacher, reduction='batchmean') * (self.T**2)

        # 融合损失
        return self.alpha * loss_kd + (1 - self.alpha) * loss_ce

# 训练循环
for epoch in range(epochs):
    for x, y in dataloader:
        # 教师预测(禁用梯度)
        with torch.no_grad():
            teacher_logits = teacher_model(x)

        # 学生预测
        student_logits = student_model(x)

        # 蒸馏损失计算
        loss = kd_loss(student_logits, teacher_logits, y)

        # 反向传播更新学生模型
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
Hugging Face高级蒸馏
from transformers import Trainer, TrainingArguments
from transformers import DistillationConfig

# 初始化师生模型
teacher = AutoModelForSequenceClassification.from_pretrained("bert-large")
student = AutoModelForSequenceClassification.from_pretrained("bert-mini")

# 配置蒸馏参数
distil_config = DistillationConfig(
    temperature=4.0,
    alpha_ce=0.5,
    alpha_kl=0.5,
    loss_type="soft"
)

# 创建蒸馏训练器
distiller = DistillationTrainer(
    teacher_model=teacher,
    student_model=student,
    distillation_config=distil_config,
    train_dataset=train_set,
    eval_dataset=eval_set
)

# 启动蒸馏训练
distiller.train()
蒸馏技术的未来与启示
蒸馏革命的三次浪潮
-
算法压缩时代(2015-2018):
- Hinton开创性提出知识蒸馏概念
- 主要目标:模型小型化
- 代表作:DistilBERT参数减少40%
-
性能超越时代(2019-2021):
- 发现蒸馏模型可超越教师的表现
- NAS+蒸馏联合优化技术
- 谷歌Vision Transformer蒸馏版精度超原始15%
-
通用智能时代(2022-):
- 多模态大模型蒸馏
- 零样本蒸馏技术
- 联邦学习环境下的蒸馏框架
工业落地的价值图谱
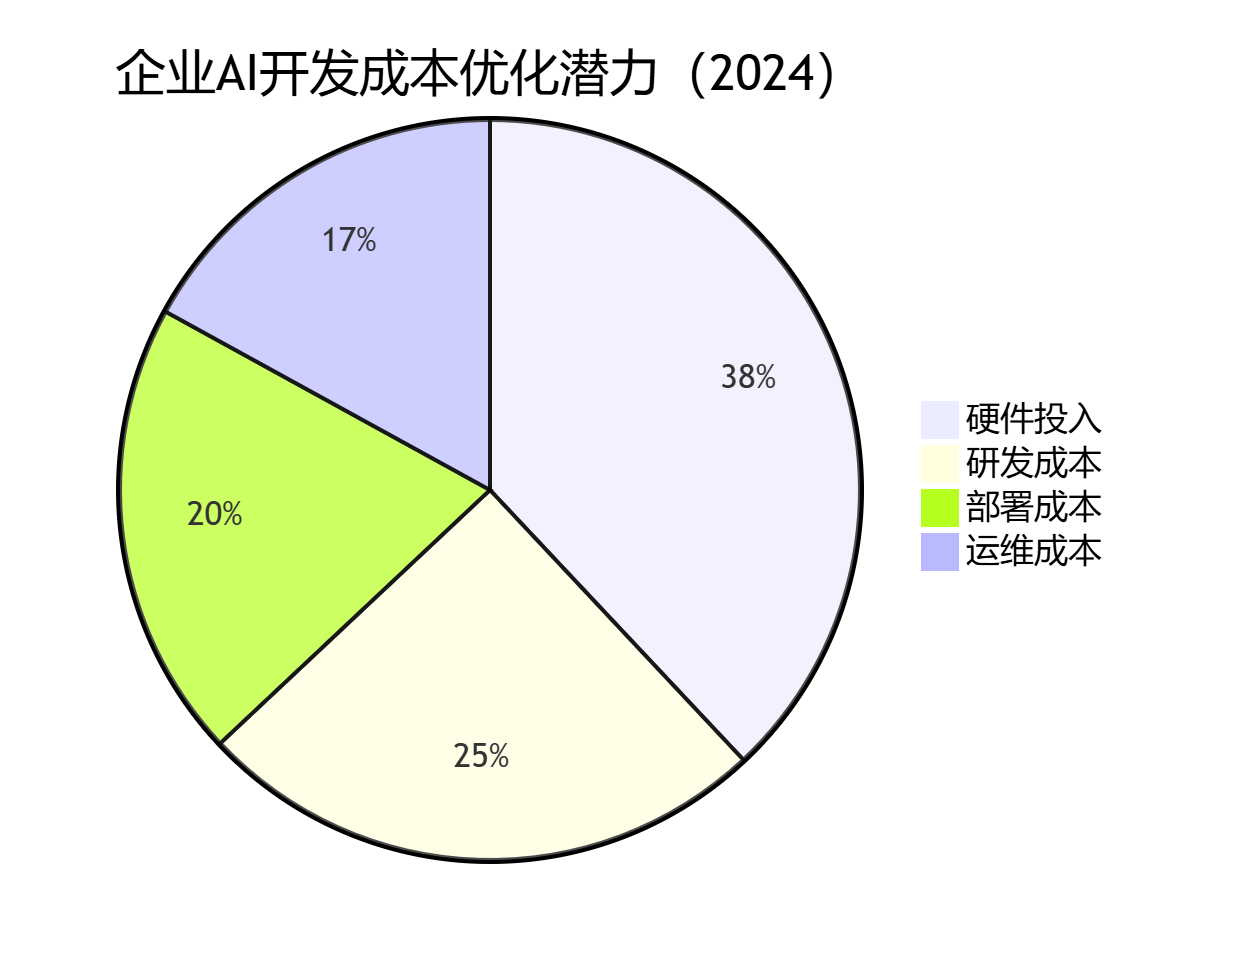
知识蒸馏平均降低总体成本52%
未来五大趋势
-
3D模型蒸馏:
- 神经辐射场(NeRF)压缩技术
- NVIDIA Omniverse实现实时光线追踪模型移动端部署
-
生命科学应用:
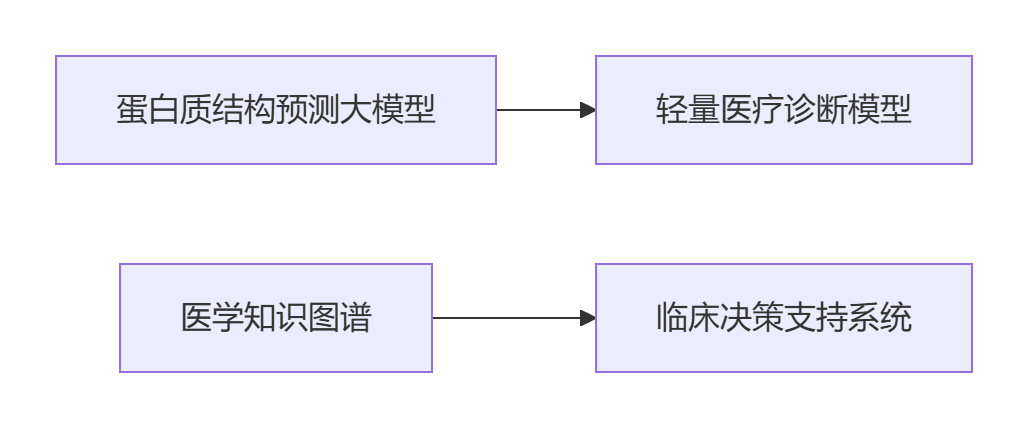
AlphaFold2蒸馏模型参数减少98%,精度损失仅0.3%
-
量子蒸馏技术:
- IBM量子处理器实现量子神经网络知识迁移
- 量子-经典混合蒸馏框架
-
联邦蒸馏系统:
- 多家医院合作训练
- 数据零共享
- 模型性能逼近集中训练
-
元宇宙应用:
- 数字人对话模型实时蒸馏
- 千万级用户的个性化模型部署
深度学习先驱Geoffrey Hinton曾说:"知识蒸馏的价值不在于模仿,而在于萃取事物本质"。当GPT-4等万亿级大模型日益庞大时,蒸馏技术成为连接尖端科技与普惠应用的桥梁。它不是简单的模型压缩,而是知识传承的艺术——让每个智能设备都能承载大师级的智慧,同时保持轻盈的身姿。
蒸馏实践黄金原则:
选择教师: 寻找性能饱和的成熟模型
学生架构: 设计适配目标硬件的网络
蒸馏策略:
   - 第一阶段:高温软化(T=8-10, α=1)
   - 第二阶段:融合平衡(T=3-5, α=0.7)
   - 第三阶段:精确微调(T=1, α=0.2)
评估验证: 知识相似度>95%且性能达标
掌握蒸馏炼金术,即可在性能与效率的平衡木上行走自如。这不仅是技术挑战,更是将智能民主化的哲学实践——当每个边缘设备都具备大模型的智慧核心时,真正的AI普及时代才宣告到来。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献11条内容

所有评论(0)