颠覆认知!用RAG处理表格数据后,我才明白大模型的真实使用门槛
你以为RAG就是调个API、套个框架的事儿?多少开发者信心满满地打开LangChain文档,结果对着Excel表格当场傻眼——说好的’开箱即用’呢?文本问答确实容易上手,可一旦换成财报数据、用户信息表,那些引以为傲的语义搜索突然就失灵了!字段关联看不懂,数值比较犯迷糊,跨行统计更是一团糟。原来RAG的’简单’只是假象,表格处理才是它的终极考场!今天我们就撕开这层窗户纸,让你看看真正的结构化数据增强检索该怎么玩。
一、为什么表格数据是大模型的“拦路虎”?
先说说痛点。大模型天生擅长处理非结构化数据,比如一篇散文、一段聊天记录,它能迅速抓住重点。可表格不一样,表格是结构化的,字段清晰、数据规整,直接丢给模型,它可能会一脸茫然,完全不知道从哪儿下手。
那怎么办呢?其实很简单,核心思路就是把表格“翻译”成大模型能懂的语言,再搭配一个好用的存储和检索方案。听起来有点玄乎?别慌,接下来我会一步步拆解,带你把这事儿弄明白。
二、处理表格的“四步走”全攻略
经过一番研究,我总结了大模型处理表格的四大核心步骤:向量化、存储、索引、检索。每一步都有多种方法可选,我不仅会讲清楚原理,还会直接上代码,方便你动手实践!
👉[CSDN大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)]()👈
第一步:表格数据向量化——让表格“开口说话”
表格不像文本,不能直接喂给模型,得先把它转成向量。这里有三种主流方法,针对不同场景各有妙用:
方法1:逐行向量化——每行变“文章”
思路:把表格的每一行拼接成一句话,用嵌入模型生成向量,再存进向量数据库。
适用场景:想查单行数据,比如“收入最高的科技公司”。
步骤:
- 把每行数据转成文本描述(比如“公司: A公司, 收入: 500万”)。
- 用嵌入模型(比如OpenAI的text-embedding-ada-002)生成向量。
- 存进向量数据库(比如Chroma)。
举个例子:
假设有一张财务表:
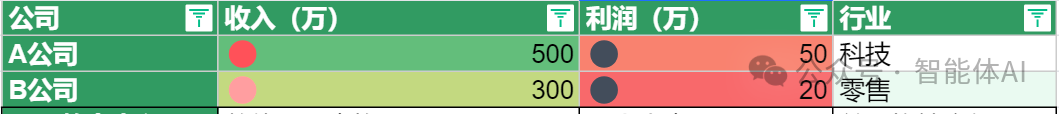
代码实操:
# 安装依赖:pip install chromadb openai
import chromadb
from openai import OpenAI
import os

# 设置OpenAI API密钥
os.environ["OPENAI_API_KEY"] = "你的密钥"
client = OpenAI()

# 表格数据
table_data = [
    {"公司": "A公司", "收入": 500, "利润": 50, "行业": "科技"},
    {"公司": "B公司", "收入": 300, "利润": 20, "行业": "零售"}
]

# 逐行转文本
rows = [f"公司: {row['公司']}, 收入: {row['收入']}万, 利润: {row['利润']}万, 行业: {row['行业']}" for row in table_data]

# 生成向量
def get_embedding(text):
    response = client.embeddings.create(input=text, model="text-embedding-ada-002")
    return response.data[0].embedding

vectors = [get_embedding(row) for row in rows]

# 输出检查
print("第一行文本:", rows[0])
print("第一行向量(前5维):", vectors[0][:5])
输出:
第一行文本:公司: A公司, 收入: 500万, 利润: 50万, 行业: 科技
第一行向量(前5维):[-0.0123, 0.0056, 0.0231, -0.0089, 0.0178]
优点:简单直接,查单行数据特别方便。
缺点:如果想跨行比较(比如算总收入),还得额外处理。
方法2:逐列向量化——分门别类更灵活
思路:把表格的每列单独向量化,存进支持元数据过滤的数据库,查询时按字段筛选。
适用场景:适合“科技行业利润最高的公司”这种按列查的需求。
步骤:
- 对每列生成独立向量(或者只处理关键列,比如文本字段)。
- 用元数据存数值字段,方便后期过滤。
- 存进支持多字段索引的数据库(比如Weaviate)。
代码实操(用Weaviate):
# 安装依赖:pip install weaviate-client
import weaviate
from openai import OpenAI
import os

os.environ["OPENAI_API_KEY"] = "你的密钥"
client = OpenAI()

# 初始化Weaviate客户端(需本地运行Weaviate)
weaviate_client = weaviate.Client("http://localhost:8080")

# 定义Schema
schema = {
    "classes": [{
        "class": "TableData",
        "properties": [
            {"name": "company", "dataType": ["string"]},
            {"name": "income", "dataType": ["number"]},
            {"name": "profit", "dataType": ["number"]},
            {"name": "industry", "dataType": ["string"]},
            {"name": "vector", "dataType": ["number[]"]},
        ],
        "vectorizer": "none"  # 手动提供向量
    }]
}
weaviate_client.schema.create(schema)

# 表格数据
table_data = [
    {"company": "A公司", "income": 500, "profit": 50, "industry": "科技"},
    {"company": "B公司", "income": 300, "profit": 20, "industry": "零售"}
]

# 生成向量并存储
for row in table_data:
    text = f"公司: {row['company']}, 行业: {row['industry']}"
    vector = client.embeddings.create(input=text, model="text-embedding-ada-002").data[0].embedding
    weaviate_client.data_object.create(
        data_object={"company": row["company"], "income": row["income"], "profit": row["profit"], "industry": row["industry"], "vector": vector},
        class_name="TableData"
    )

print("数据存储完成!")
备注:运行前需用Docker启动Weaviate(命令:docker run -p 8080:8080 semitechnologies/weaviate)。
优点:支持按字段筛选,灵活性超强。
缺点:预处理稍微麻烦一点。
方法3:整表嵌入——全局视角看表格
思路:把整个表格转成一段文本,整体向量化。
适用场景:适合“给我所有公司财务数据”这种全局查询。
步骤:
- 把表格转成Markdown或JSON格式的文本。
- 用嵌入模型生成向量。
- 存进数据库。
代码实操(用Chroma):
import chromadb
from openai import OpenAI
import os

os.environ["OPENAI_API_KEY"] = "你的密钥"
client = OpenAI()

# 初始化Chroma
chroma_client = chromadb.Client()
collection = chroma_client.create_collection(name="whole_table")

# 表格数据转文本
table_data = [
    {"公司": "A公司", "收入": 500, "利润": 50, "行业": "科技"},
    {"公司": "B公司", "收入": 300, "利润": 20, "行业": "零售"}
]
table_text = "公司财务表:\n" + "\n".join([f"公司: {row['公司']}, 收入: {row['收入']}万, 利润: {row['利润']}万, 行业: {row['行业']}" for row in table_data])

# 生成向量
vector = client.embeddings.create(input=table_text, model="text-embedding-ada-002").data[0].embedding

# 存储
collection.add(ids=["table_1"], embeddings=[vector], metadatas=[{"text": table_text}])
print("整表存储完成!")
优点:适合整体返回,简单粗暴。
缺点:想查单个单元格不方便,更适合小表格。
第二步:存储到向量数据库——给数据找个“家”
向量化后的数据得有个地方存起来。这里推荐几个主流向量数据库:
- FAISS:本地跑,速度快,适合小规模实验。
- Chroma:轻量级,支持OpenAI嵌入,开箱即用。
- Weaviate:支持元数据过滤,表格数据的好帮手。
- Pinecone:云端服务,适合大规模应用。
实操代码(用FAISS存储逐行向量):
# 安装依赖:pip install faiss-cpu numpy
import faiss
import numpy as np
from openai import OpenAI
import os

os.environ["OPENAI_API_KEY"] = "你的密钥"
client = OpenAI()

# 表格数据
rows = [
    "公司: A公司, 收入: 500万, 利润: 50万, 行业: 科技",
    "公司: B公司, 收入: 300万, 利润: 20万, 行业: 零售"
]
vectors = [client.embeddings.create(input=row, model="text-embedding-ada-002").data[0].embedding for row in rows]
vectors = np.array(vectors).astype('float32')

# 创建FAISS索引
dimension = vectors.shape[1]  # 向量维度
index = faiss.IndexFlatL2(dimension)  # L2距离索引
index.add(vectors)  # 添加向量
print("FAISS索引创建完成,总向量数:", index.ntotal)
第三步:高效检索——快准狠才是王道
存好数据,怎么快速找出来?这里有三种实用技巧:
技巧1:Metadata Filtering——先筛后搜
思路:用元数据条件缩小范围,再用向量搜索。
代码实操(Weaviate查询“科技行业利润最高”):
# 查询
query_text = "科技行业里利润最高的公司"
query_vector = client.embeddings.create(input=query_text, model="text-embedding-ada-002").data[0].embedding

# 先按行业过滤,再按向量搜索
results = weaviate_client.query.get("TableData", ["company", "profit", "industry"])\
    .with_where({"path": ["industry"], "operator": "Equal", "valueText": "科技"})\
    .with_near_vector({"vector": query_vector})\
    .with_limit(5)\
    .do()

# 按利润排序
sorted_results = sorted(results["data"]["Get"]["TableData"], key=lambda x: x["profit"], reverse=True)
print("结果:", sorted_results[0])
输出:
结果:{'company': 'A公司', 'profit': 50, 'industry': '科技'}
技巧2:Hybrid Search——向量+SQL双剑合璧
思路:向量搜索找相似行,SQL排序数值字段。
代码实操(FAISS+Python排序):
# 查询
query_vector = client.embeddings.create(input="收入最高的公司", model="text-embedding-ada-002").data[0].embedding
query_vector = np.array([query_vector]).astype('float32')

# FAISS搜索
D, I = index.search(query_vector, k=2)  # 返回前2个结果
results = [rows[i] for i in I[0]]

# 提取收入并排序
sorted_results = sorted(results, key=lambda x: -int(x.split("收入: ")[1].split("万")[0]))
print("收入最高的公司:", sorted_results[0])
输出:
收入最高的公司:公司: A公司, 收入: 500万, 利润: 50万, 行业: 科技
技巧3:Reranking——二次排序更精准
思路:用交叉编码器对初步结果打分。
代码实操:
# 安装依赖:pip install sentence-transformers
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')
query = "科技行业里收入最高的公司"
candidates = results  # FAISS返回的结果
pairs = [[query, cand] for cand in candidates]
scores = reranker.predict(pairs)
sorted_results = [cand for _, cand in sorted(zip(scores, candidates), reverse=True)]
print("重排序后结果:", sorted_results[0])
第四步:选择合适方案——对症下药
不同的需求,方案也不一样,我整理了个对比表供你参考:
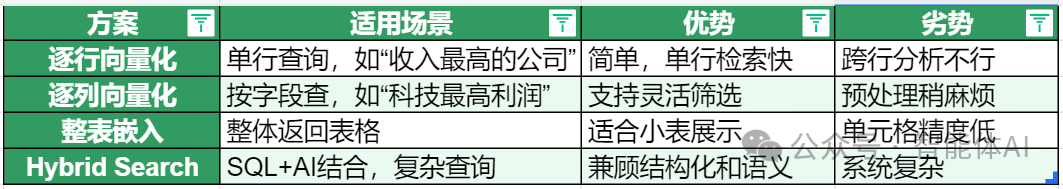
- 小表格:直接转文本+FAISS/Chroma,效率拉满。
- 大表格:逐行存储+Metadata Filtering,Weaviate/Pinecone是不二之选。
- 复杂查询:向量+SQL混搭,既能抓住语义,又能精确计算。
三、最佳实践:一条龙解决表格难题
综合来看,“单行向量化+按列筛选+SQL辅助”是最实用的一套组合拳。具体怎么搞?
- 把每行数据转成文本描述,用大模型生成向量。
- 存到支持元数据的向量数据库,关键列加索引。
- 查询时,先用向量找相似项,再用SQL或Python排序过滤。
举个例子:用户问“科技行业里利润最高的公司”,你可以:
- 用向量搜索“科技行业”相关的行。
- 从结果里挑出利润最高的,答案就是A公司,50万利润。
** **
四、总结
看完这些,你还觉得RAG只是个简单的问答工具吗?表格处理就像一面照妖镜,照出了大多数RAG方案在结构化数据面前的苍白无力。那些只会用现成框架套文本的开发者,遇到多维数据交叉分析、动态条件过滤时哪个不是头皮发麻?但别灰心!掌握了向量化策略与混合检索的奥义,你就能让大模型真正’看懂’表格。记住:真正的RAG高手,从来不是框架的搬运工,而是能根据数据结构量体裁衣的架构师。从今天开始,扔掉那些’万能解决方案’的幻想,踏踏实实练就这手表格处理的硬功夫吧!
读者福利:如果大家对大模型感兴趣,这套大模型学习资料一定对你有用
对于0基础小白入门:
如果你是零基础小白,想快速入门大模型是可以考虑的。
一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。
包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
👉AI大模型学习路线汇总👈
大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)
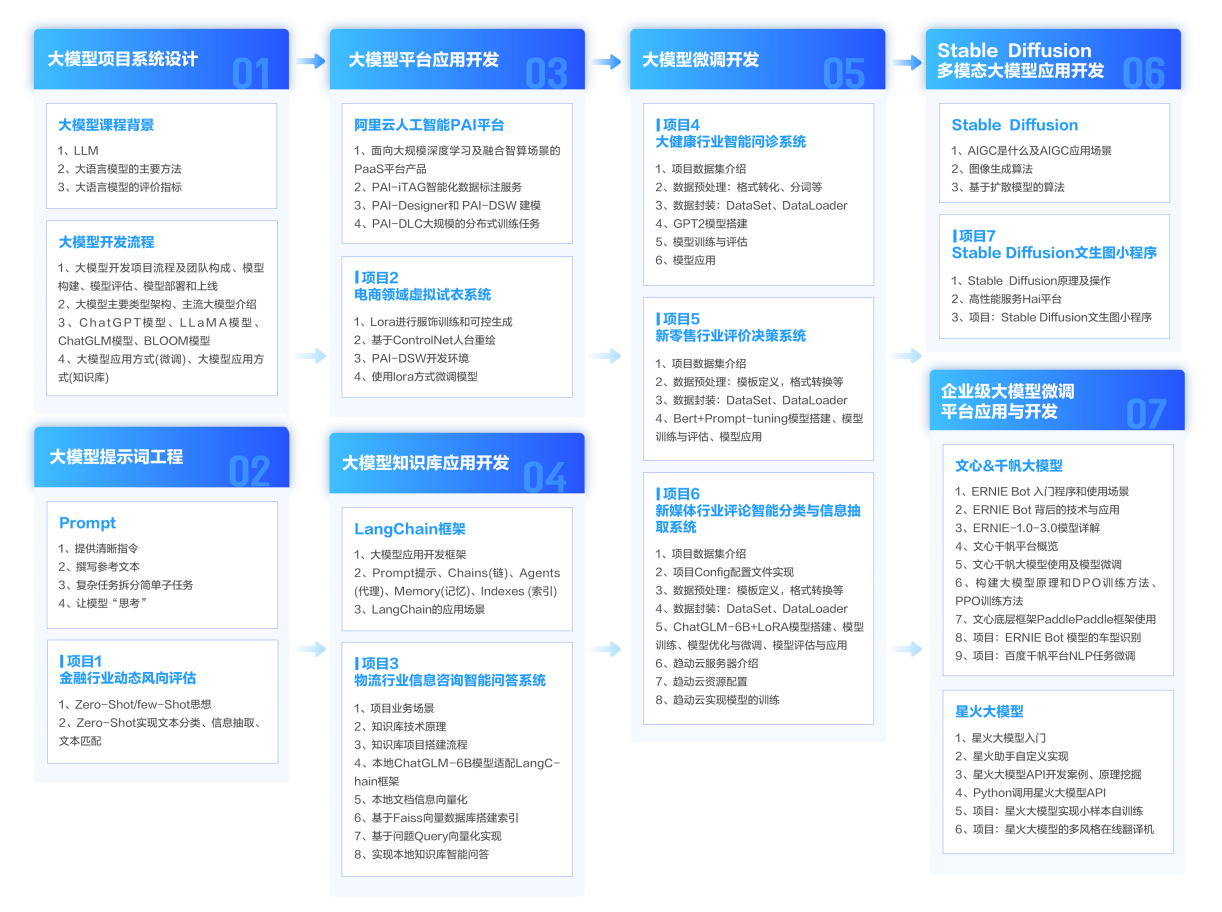
第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;
第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;
第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。
👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献14条内容

所有评论(0)