【爬虫】济南安居客二手房数据爬取 保姆级!
·
因为需要完成大数据作业,需要对二手房的数据进行分析
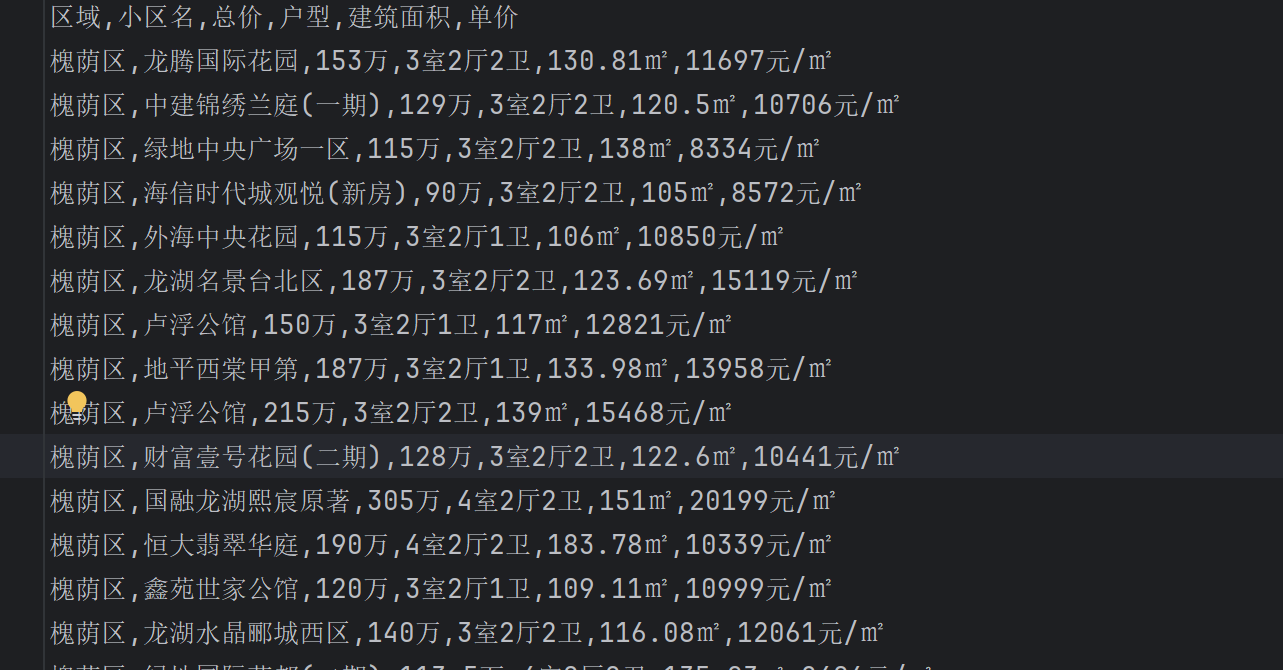
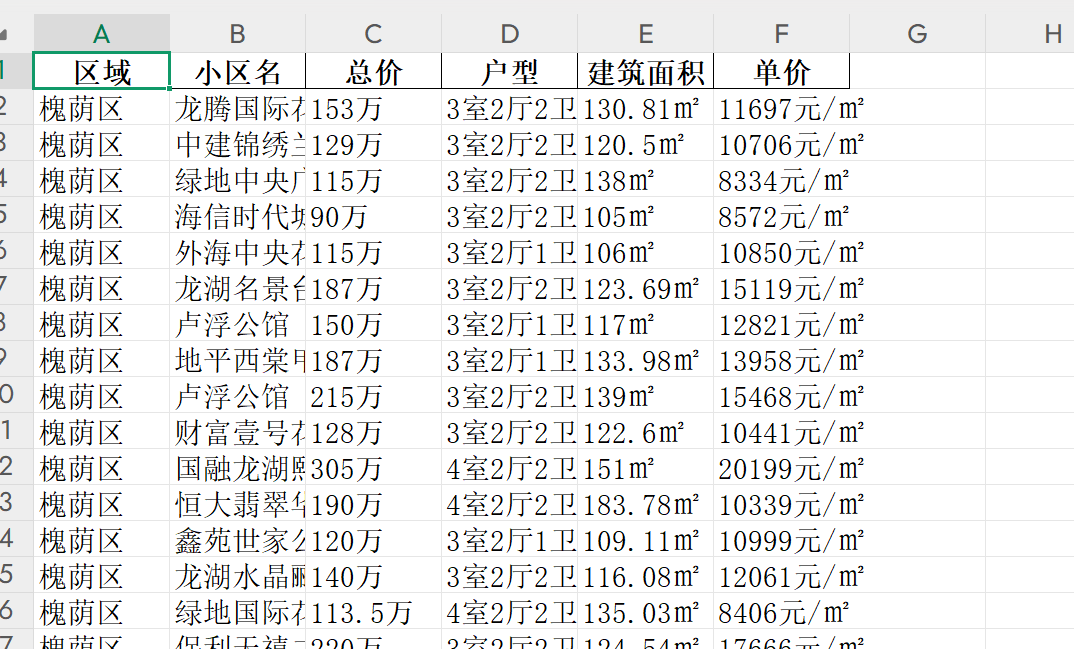
决定爬取济南安居客网站 爬取到二手房的 [区域,小区名,总价,户型,建筑面积,单价]这些数据
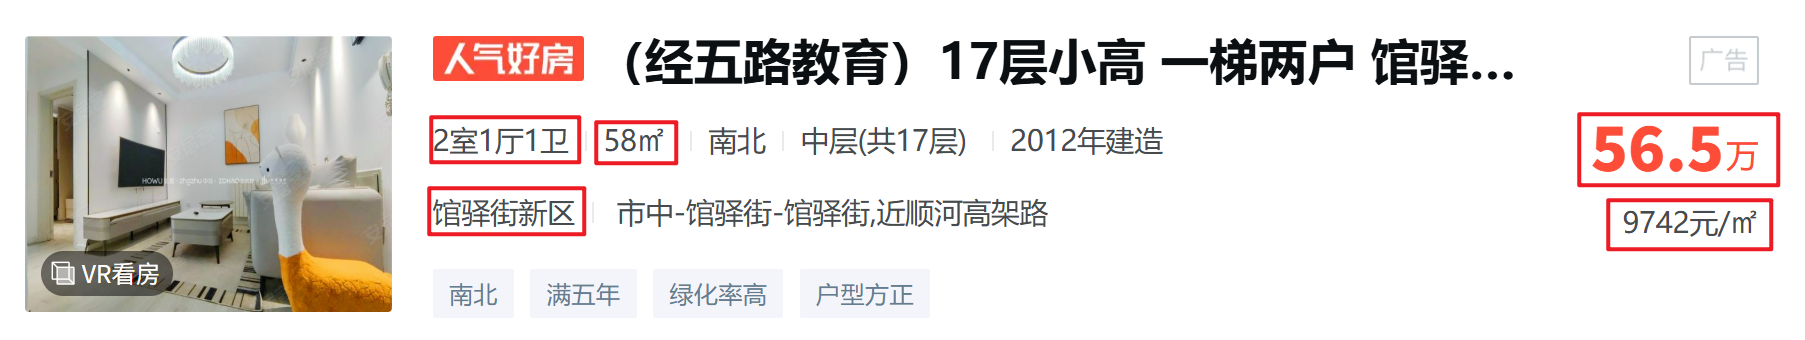
爬取的字段也和网站展示的元素有关系,老师给的示范字段其实还有装修情况,但是这个不好从这个网站拿到所以没有调整了一下获取的字段
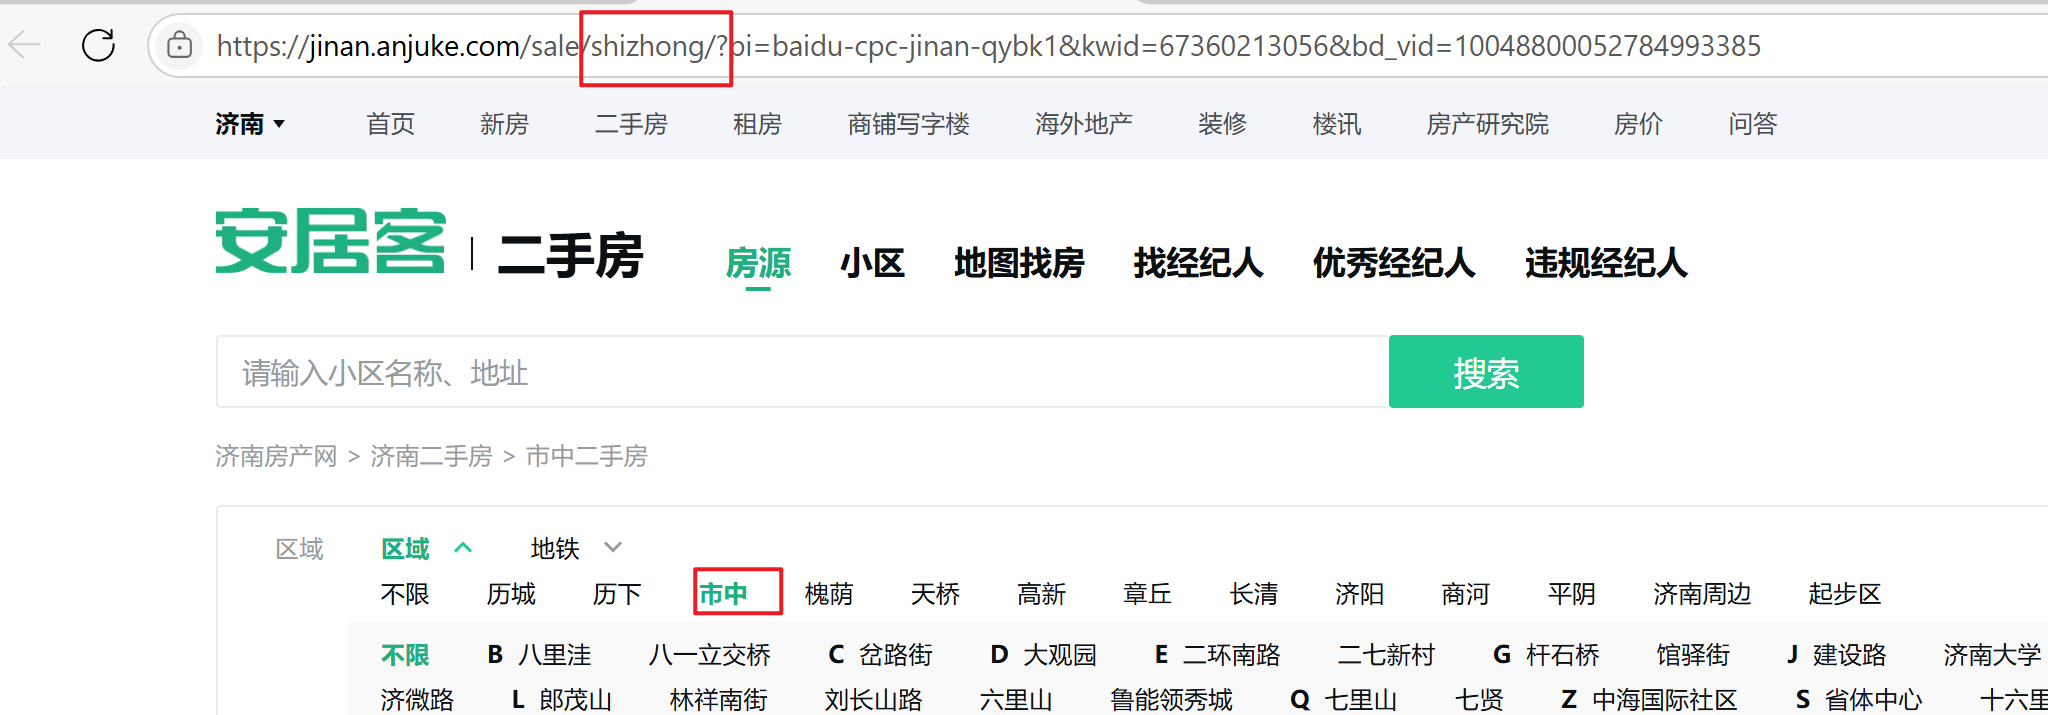
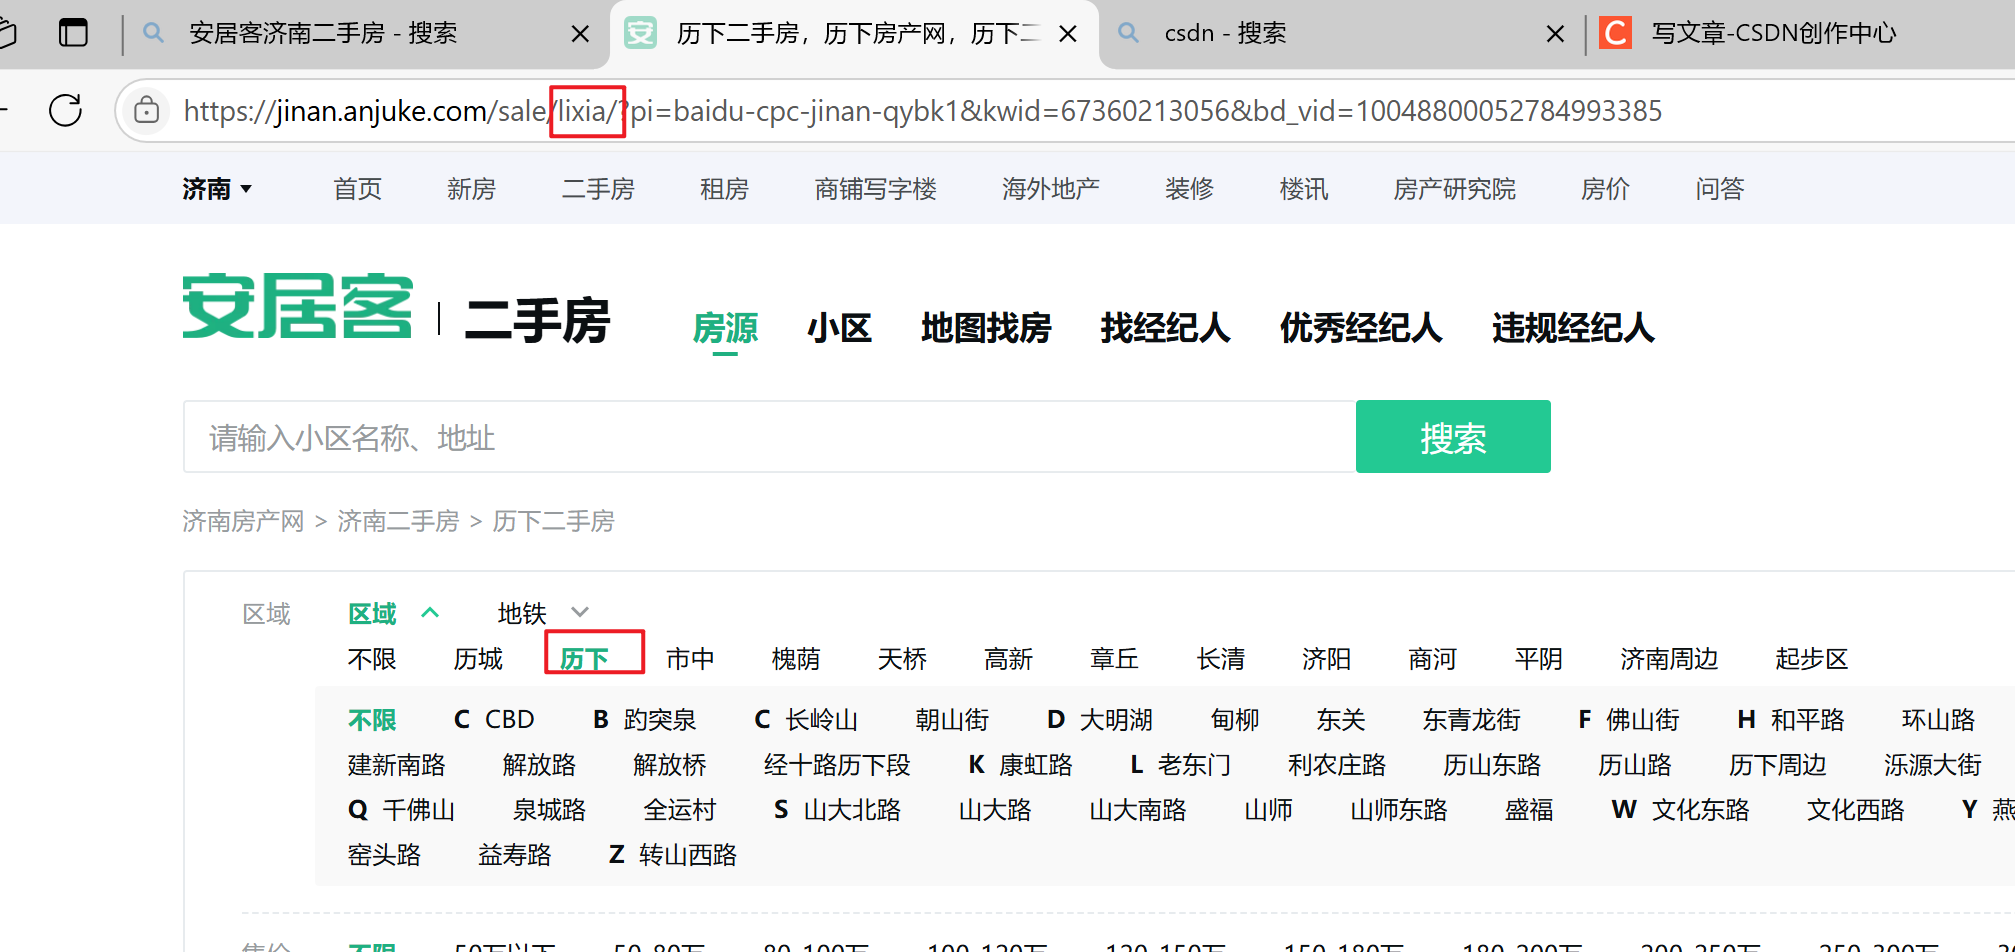
观察这个网站可以发现 选择哪个区哪个区的拼音就会作为路径参数在sale/后面
我们可以根据这个规律 获取到每个区的数据
现在靠大模型生成还是不够的 因为大模型是靠之前上传的文章分析字段 所以我们得自己扒一下字段
我使用的是Edge浏览器开发者模式
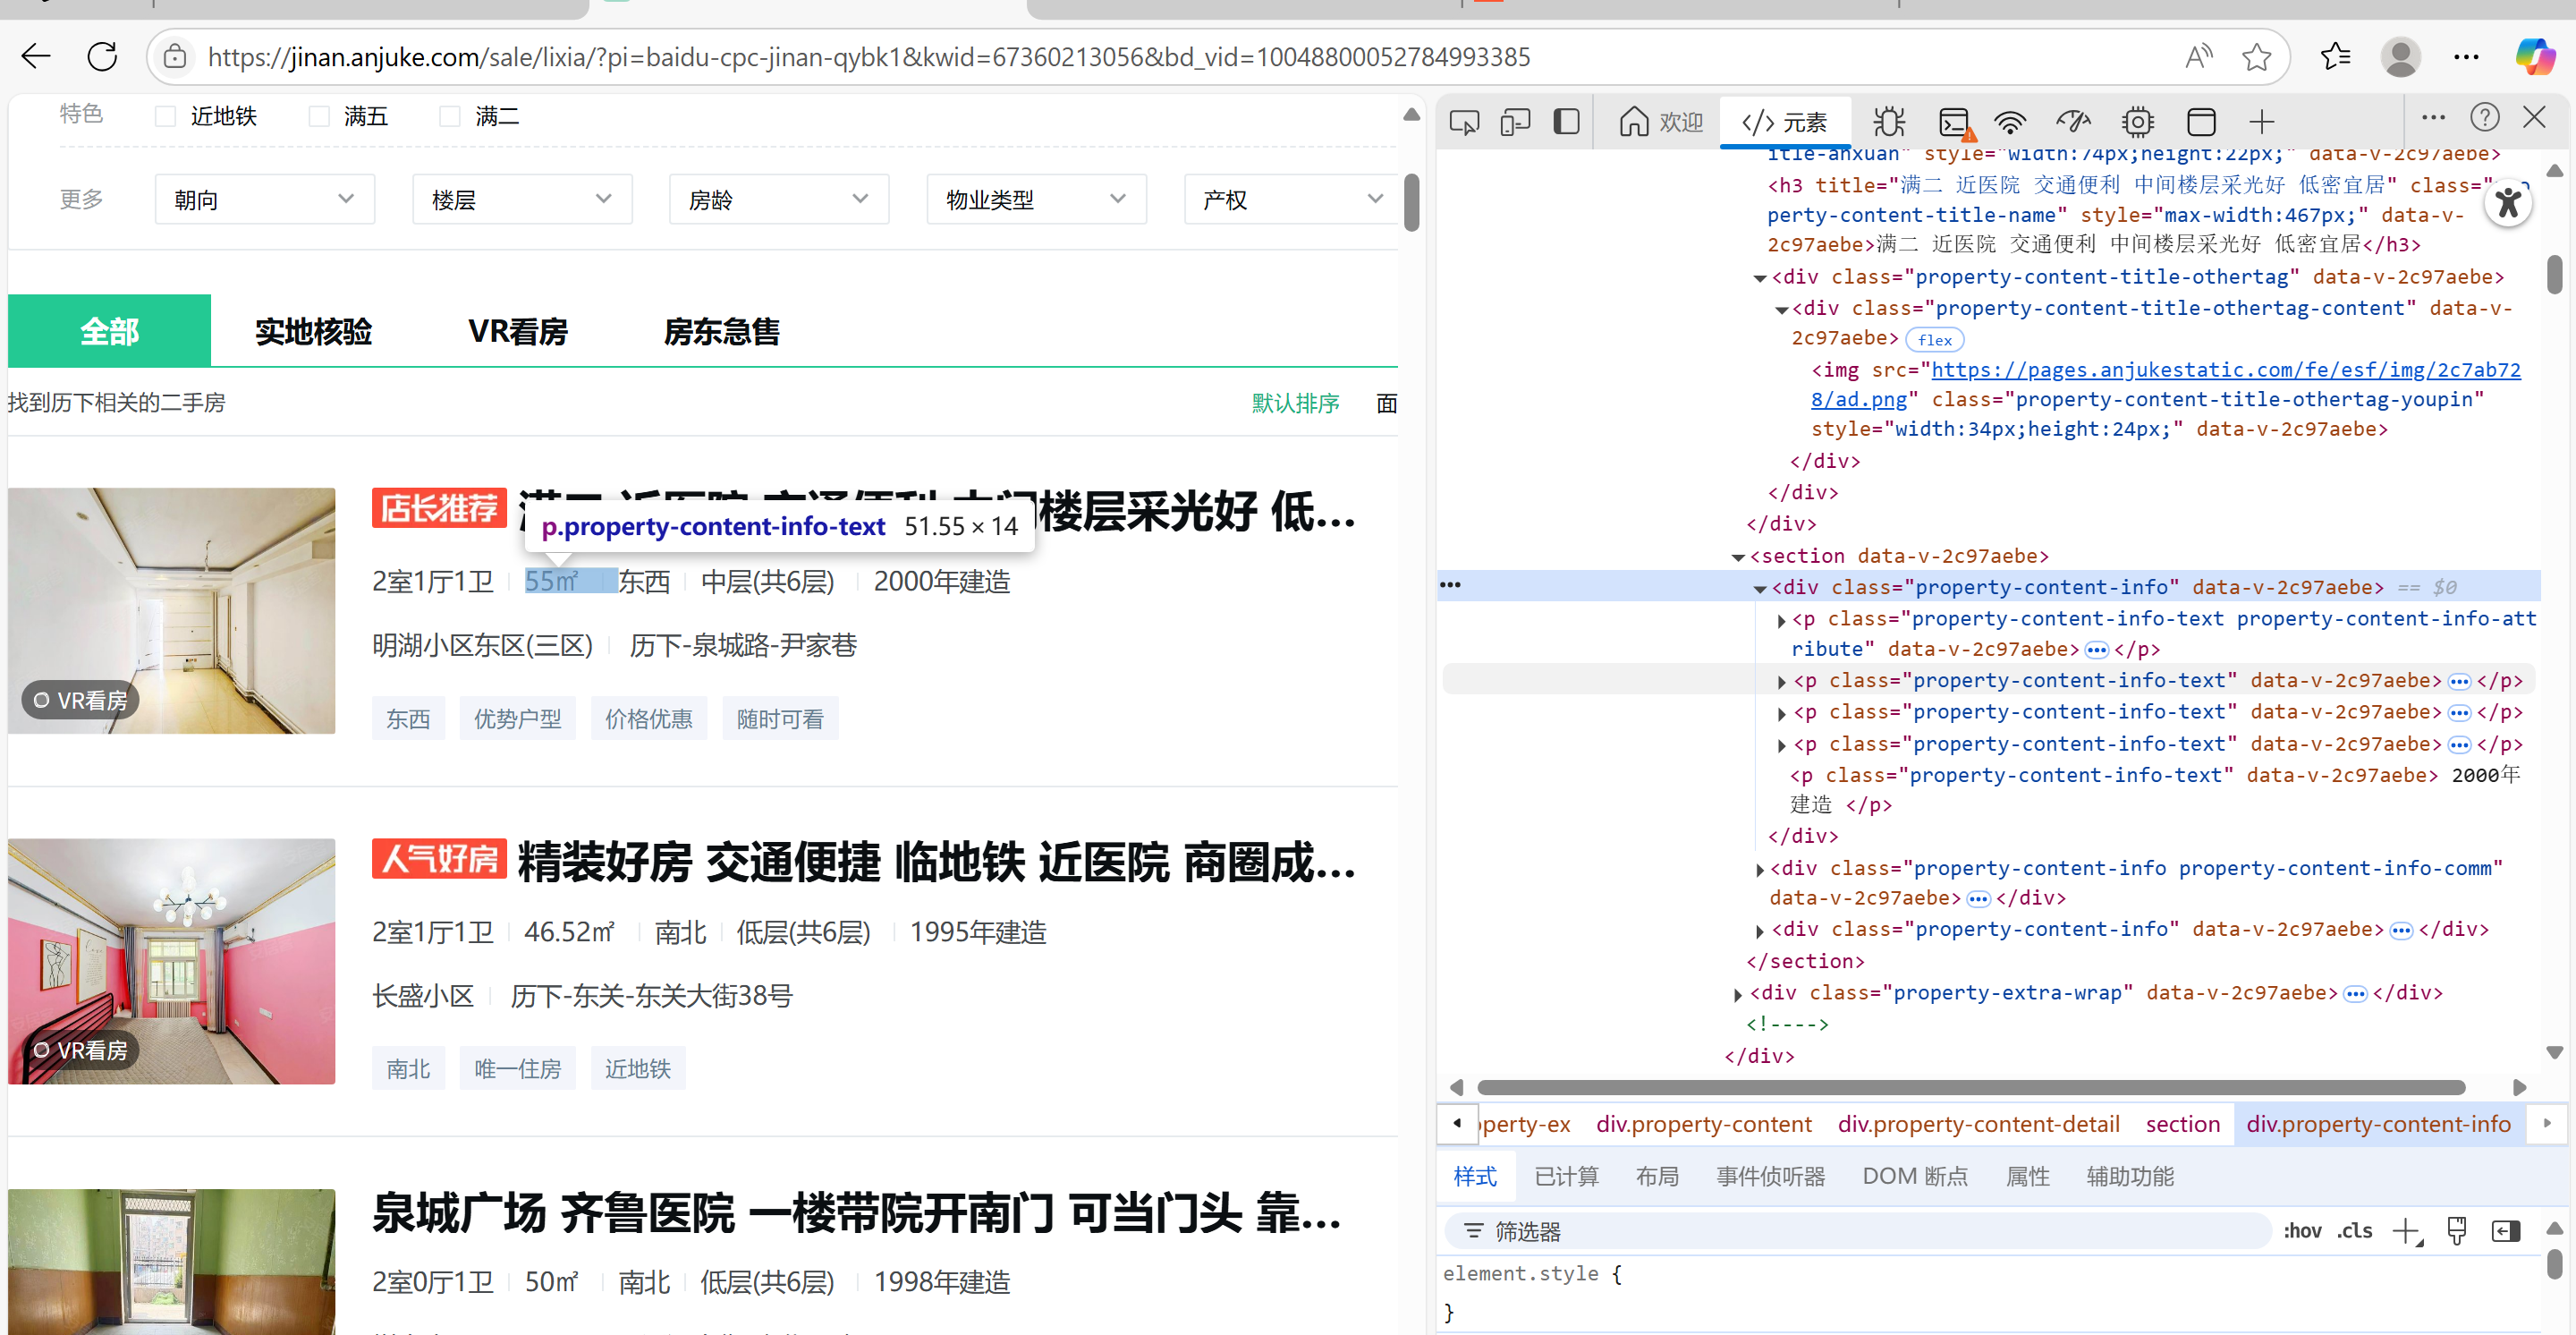
慢慢获取和总结你需要的字段对应的选择器 以及它们的层级关系
下面是我当时总结的内容:
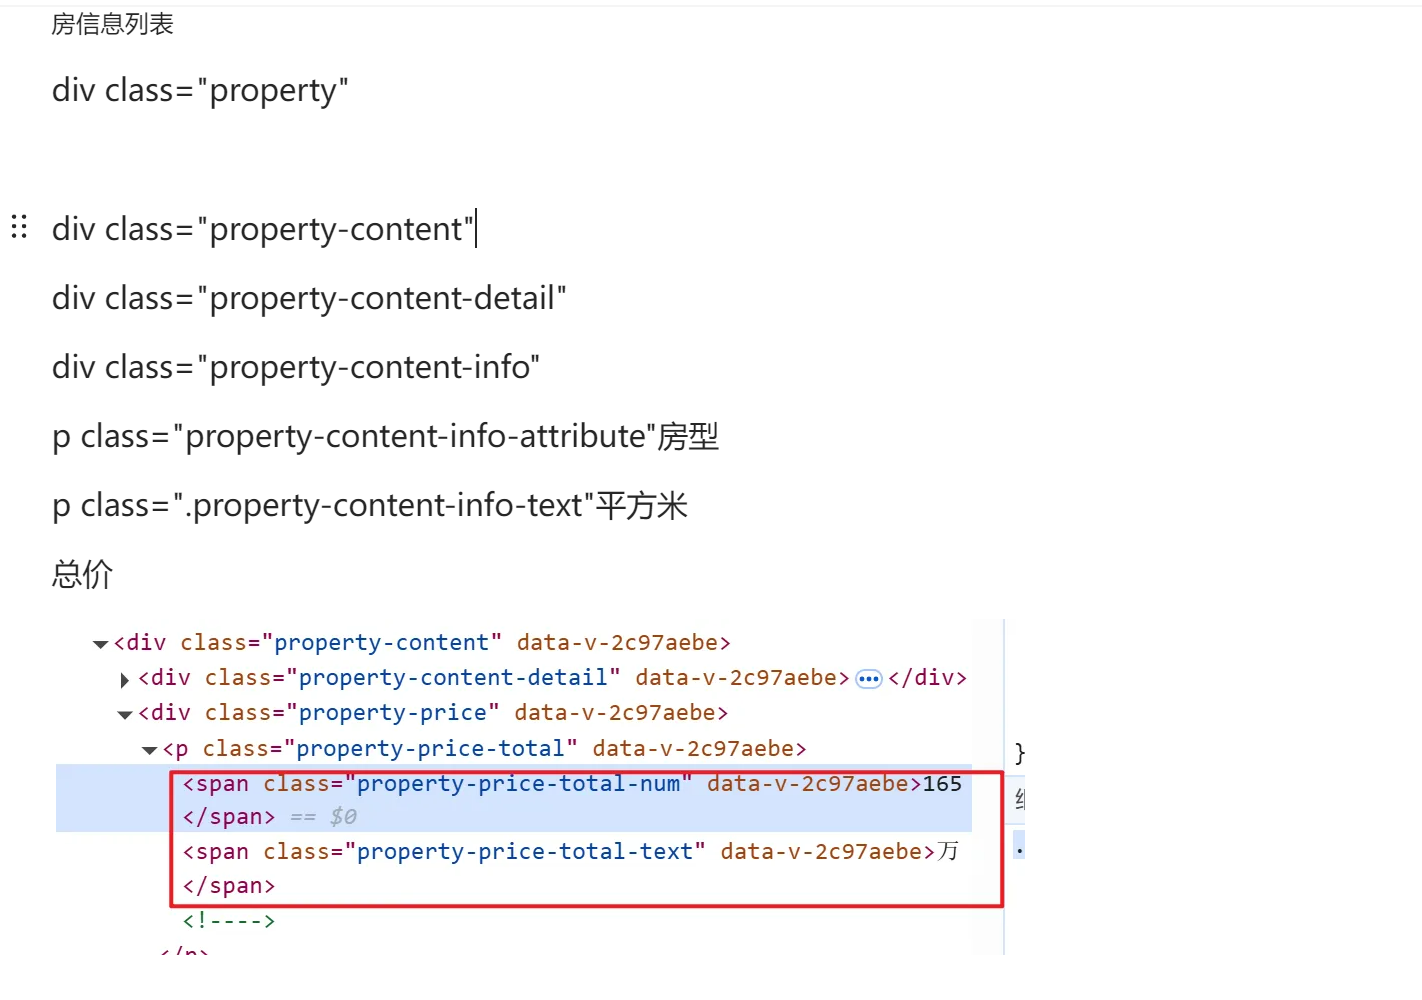
如果你还是不会根据这个写Python的元素获取代码,也可以发给大模型让它帮你总结,也可以大大提高正确性了
下面是字段获取代码
# 获取房源列表
        house_list = html.xpath('//div[contains(@class, "property")]')
        print(f"找到房源列表数量: {len(house_list)}")

        if not house_list:
            print("未找到房源列表,可能是遇到了反爬限制")
            return False

        success = False
        for house in house_list:
            try:
                # 获取基本信息
                title = house.xpath('.//p[contains(@class, "property-content-info-comm-name")]/text()')
                # 修改户型获取方式,使用完整的class名称
                house_type = house.xpath('.//p[contains(@class, "property-content-info-text") and contains(@class, "property-content-info-attribute")]//text()')
                area = house.xpath('.//div[contains(@class, "property-content-info")]//p[contains(@class, "property-content-info-text")][2]/text()')
                # direction = house.xpath('.//div[contains(@class, "property-content-info")]//p[contains(@class, "property-content-info-text")][2]/text()')
                price = house.xpath('.//span[contains(@class, "property-price-total-num")]/text()')
                price_unit = house.xpath('.//span[contains(@class, "property-price-total-text")]/text()')
                price_per_sqm = house.xpath('.//p[contains(@class, "property-price-average")]/text()')
然后因为网站总是有很多反爬机制 你需要使用最好多个真实的cookie 可以多开几个浏览器网站获取,好像也可以清除浏览器数据获取多次cookie,不过我当时这样没用,但是我在谷歌浏览器退出账户又可以获得一个新cookie 最后是让4个cookie上了战场~
还有就算cookie多你这个ip频繁获取还是会被封 所以如果要爬取大量数据的话要切换ip 使用不同的网络 当然使用vpn切换结点会更加方便
以下是完整代码
import requests
from lxml import etree
import pandas as pd
import time
import random
import json
from fake_useragent import UserAgent

class AnjukeSpider:
    def __init__(self):
        self.base_url = "https://jinan.anjuke.com/sale/{}/"
        self.data = []
        self.ua = UserAgent()
        # 济南各区域及其对应的URL参数
        self.areas = {
            "槐荫区": "huaiyin",
            "天桥区": "tianqiao",
            "历城区": "licheng",
            "市中区": "shizhong",
            "历下区": "lixia",
            "高新区": "gaoxin",
            "章丘":"zhangqjn",
            "长清":"changqingb",
            "济阳":"jiyang",
            "平阴":"pingyin",
            "商河":"shanghe",

        }
        # 多个Cookie配置
        self.cookies = []
        self.current_cookie_index = 0

    def add_cookie(self, cookie_str):
        """添加Cookie"""
        self.cookies.append(cookie_str)

    def get_next_cookie(self):
        """获取下一个可用的Cookie"""
        if not self.cookies:
            return ""
        cookie = self.cookies[self.current_cookie_index]
        self.current_cookie_index = (self.current_cookie_index + 1) % len(self.cookies)
        return cookie

    def _get_headers(self):
        """生成随机请求头"""
        return {
            'User-Agent': self.ua.random,
            'Accept': 'text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,image/apng,*/*;q=0.8',
            'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
            'Accept-Encoding': 'gzip, deflate, br',
            'Connection': 'keep-alive',
            'Cookie': self.get_next_cookie(),
            'Upgrade-Insecure-Requests': '1',
            'Cache-Control': 'max-age=0',
            'Sec-Ch-Ua': '"Not A(Brand";v="99", "Google Chrome";v="121", "Chromium";v="121"',
            'Sec-Ch-Ua-Mobile': '?0',
            'Sec-Ch-Ua-Platform': '"Windows"',
            'Sec-Fetch-Dest': 'document',
            'Sec-Fetch-Mode': 'navigate',
            'Sec-Fetch-Site': 'none',
            'Sec-Fetch-User': '?1',
            'Referer': 'https://jinan.anjuke.com'
        }

    def get_page(self, url):
        try:
            if not self.cookies:
                print("警告:未设置任何Cookie,可能会遇到验证码")
                return None

            # 随机延迟5-15秒
            delay = random.uniform(5, 15)
            print(f"等待{delay:.2f}秒后继续...")
            time.sleep(delay)

            current_cookie = self.get_next_cookie()
            print(f"使用第 {self.current_cookie_index + 1} 个Cookie访问...")

            response = requests.get(
                url,
                headers=self._get_headers(),
                timeout=15
            )

            print(f"响应状态码: {response.status_code}")

            # 检查是否被重定向到验证页面
            if "验证" in response.text or "captcha" in response.text:
                print(f"Cookie {self.current_cookie_index + 1} 遇到验证码!切换到下一个Cookie重试...")
                return None

            if response.status_code == 200:
                return etree.HTML(response.text)
            return None
        except Exception as e:
            print(f"获取页面出错: {e}")
            return None

    def parse_house_info(self, html, area_name):
        if html is None:
            print("HTML为空,无法解析")
            return False

        # 获取房源列表
        house_list = html.xpath('//div[contains(@class, "property")]')
        print(f"找到房源列表数量: {len(house_list)}")

        if not house_list:
            print("未找到房源列表,可能是遇到了反爬限制")
            return False

        success = False
        for house in house_list:
            try:
                # 获取基本信息
                title = house.xpath('.//p[contains(@class, "property-content-info-comm-name")]/text()')
                # 修改户型获取方式,使用完整的class名称
                house_type = house.xpath('.//p[contains(@class, "property-content-info-text") and contains(@class, "property-content-info-attribute")]//text()')
                area = house.xpath('.//div[contains(@class, "property-content-info")]//p[contains(@class, "property-content-info-text")][2]/text()')
                # direction = house.xpath('.//div[contains(@class, "property-content-info")]//p[contains(@class, "property-content-info-text")][2]/text()')
                price = house.xpath('.//span[contains(@class, "property-price-total-num")]/text()')
                price_unit = house.xpath('.//span[contains(@class, "property-price-total-text")]/text()')
                price_per_sqm = house.xpath('.//p[contains(@class, "property-price-average")]/text()')

                if price and area:
                    # 处理户型信息,合并所有文本
                    house_type_text = "".join([x.strip() for x in house_type if x.strip()]) if house_type else "暂无数据"

                    info = {
                        '区域': area_name,
                        '小区名': title[0].strip() if title else "暂无数据",
                        '总价': f"{price[0].strip()}{price_unit[0].strip()}" if price and price_unit else "暂无数据",
                        '户型': house_type_text,
                        '建筑面积': area[0].strip() if area else "暂无数据",
                        # '朝向': direction[0].strip() if direction else "暂无数据",
                        '单价': price_per_sqm[0].strip() if price_per_sqm else "暂无数据"
                    }
                    self.data.append(info)
                    success = True
            except Exception as e:
                print(f"解析房源信息出错: {e}")
                continue
        return success

    def save_to_excel(self, filename='jinan_houses.xlsx'):
        if self.data:
            # 转换为DataFrame
            df = pd.DataFrame(self.data)

            # 去重处理
            print("\n去重前数据条数:", len(df))
            df = df.drop_duplicates(subset=['区域', '小区名', '总价', '户型', '建筑面积', '单价'], keep='first')
            print("去重后数据条数:", len(df))

            try:
                # 保存Excel文件
                df.to_excel(filename, index=False)
                print(f"\n数据已保存到Excel文件: {filename}")

                # 保存CSV文件
                csv_filename = filename.replace('.xlsx', '.csv')
                df.to_csv(csv_filename, index=False, encoding='utf-8-sig')  # 使用utf-8-sig编码以支持中文
                print(f"数据已保存到CSV文件: {csv_filename}")

                # 打印统计信息
                print("\n各区域数据统计:")
                print(df['区域'].value_counts())
                print("\n平均房价统计:")
                df['总价'] = df['总价'].str.replace('万', '').astype(float)  # 将总价转换为数值类型
                price_stats = df.groupby('区域')['总价'].agg(['count', 'mean']).round(2)
                price_stats.columns = ['房源数量', '平均总价(万)']
                print(price_stats)
            except Exception as e:
                # 如果保存失败,尝试使用时间戳文件名
                from datetime import datetime
                timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
                new_excel_filename = f"jinan_houses_{timestamp}.xlsx"
                new_csv_filename = f"jinan_houses_{timestamp}.csv"

                print(f"\n保存失败,尝试使用新文件名...")
                df.to_excel(new_excel_filename, index=False)
                print(f"数据已保存到Excel文件: {new_excel_filename}")

                df.to_csv(new_csv_filename, index=False, encoding='utf-8-sig')
                print(f"数据已保存到CSV文件: {new_csv_filename}")
        else:
            print("没有数据可保存")

    def run(self, max_pages=5):
        """爬取指定页数的房源信息"""
        for area_name, area_code in self.areas.items():
            print(f"\n开始爬取{area_name}的房源信息...")
            page = 1
            retry_count = 0

            while page <= max_pages and retry_count < len(self.cookies) * 2:  # 允许每个Cookie重试两次
                url = f"{self.base_url.format(area_code)}p{page}/"
                print(f"正在爬取{area_name}第{page}页...")
                print(f"请求URL: {url}")

                html = self.get_page(url)
                if html is None:
                    retry_count += 1
                    print(f"页面获取失败,第{retry_count}次重试...")
                    time.sleep(random.uniform(20, 30))  # 失败后等待更长时间
                    continue

                if self.parse_house_info(html, area_name):
                    page += 1
                    retry_count = 0
                else:
                    retry_count += 1
                    print(f"解析失败,第{retry_count}次重试...")
                    if retry_count >= len(self.cookies) * 2:
                        print(f"所有Cookie都已尝试,跳过{area_name}的剩余页面")
                        break
                    time.sleep(random.uniform(20, 30))

if __name__ == "__main__":
    spider = AnjukeSpider()

    # 添加多个Cookie
    spider.add_cookie("aQQ_ajkguid=0CF4F28F-1C68-4B16-A4DA-970B4BC323AB; sessid=B21B9984-1581-4705-959A-93EEC5A267C7; ajk-appVersion=; ctid=23; id58=CroOzGg5WPpd3o4lGVa6Ag==; xxzlclientid=f9d9b46a-ef81-4ac2-a0e7-1748588803160; xxzlxxid=pfmxxJpitYyCNLvnLDcvKAgsYIA28Oyd+QfPSkJ9O3eIA1nDw9LqyXekxYAjnYEU85Q2; fzq_h=f76fc2201035501f5ddbf9b037c619bc_1748785208417_d05e17aa29e24fd5b56e27dd00b324d2_3056038055; twe=2; fzq_js_anjuke_ershoufang_pc=b870ebef0affdd899e3346b446ebe2e8_1748789680754_23; obtain_by=1; xxzlbbid=pfmbM3wxMDM0NnwxLjEwLjB8MTc0ODc4OTY4MjY4MjY0MTAyOHx6Tk1TbXhaTHk2ZS9XYU5ORHQvaUhKQTFraGZGWk9tRWRXRnI5MEthbEFvPXw5ZWNhOTA2YjdmM2FkMDdlNWFmNGVjZjU5NGFkYzgyOV8xNzQ4Nzg5Njc5Nzg4XzY5ZGIyZjFlODQyNTQ4YTc4MDlhYWE1NzE0OWZlNWE1XzQ3OTI0OTg2NjgyMDU5NDgwNjM2NzYzOTA2NDk0NTIzODk4ODQzfDc3N2MzNTk3MGE4NjYxZWNkNTM0MzdlYzU5NTVjYjA0XzE3NDg3ODk2ODE3NDFfMjU0")
    spider.add_cookie("aQQ_ajkguid=EB982700-693B-4737-A678-A31712F0D943; sessid=7FFE3DA0-283E-46A0-92E4-D61D9547A29C; ajk-appVersion=; ctid=23; fzq_h=82afe0a4e3e285cfbc7c0fd5a3c3322e_1748843210192_af06ca7ed1a54a3c8b64e4cc168b54cb_3056038055; id58=CroHVmg9OswaLWEAIJtFAg==; twe=2; obtain_by=1; _stat_guid=7D380A5A-E23B-4C81-9291-51815309A5B1; _prev_stat_guid=EB982700-693B-4737-A678-A31712F0D943; _stat_rfpn=Ershou_Web_Property_List_FilterPage; xxzlclientid=f8e2fb3b-3dc0-423a-bece-1748843217514; xxzlxxid=pfmxIrXAXgHyh0W6uk/kXcOl5d1ReaaUGXBD9c2dDfAnCd8g8bMOw/bIa+VYT36t3OS0; xxzlbbid=pfmbM3wxMDM0NnwxLjEwLjF8MTc0ODg0MzIxODg3MDY1NzA4NXxGTW9hWmYyWklQRFQzWnZGSGFGZHVGMG9YQzJkK2NzSUMvMGpud2NwMlQwPXxiMDc0MWEyNzhkMjNhOWQ2MjQxYjhiMjMzOGFlMzFjNF8xNzQ4ODQzMjEyMjkzX2RkOTA5NDdmOGRjZTRmYmZiMDYyZTViNmFlNjZkNjU5XzMwNTYwMzgwNTV8YmYzMGZiYzU3ZTdlOWU0OWZiYTU2MTlmYzM1MDBjZDVfMTc0ODg0MzIxNDQxOF8yNTY=")
    spider.add_cookie("sessid=60193973-B9C7-9720-DCCC-3C932904701A; aQQ_ajkguid=5774BED1-0FD5-3107-177C-B66F8E62F207; twe=2; _stat_guid=3CE0FCA0-B054-4E33-AAA2-40E31E23B95C; _prev_stat_guid=5774BED1-0FD5-3107-177C-B66F8E62F207; id58=OWQb0Wg8ZRJ1fTdNMHdHAg==; 58tj_uuid=58a4eb0c-4807-4d88-9f6a-df1f8a6b9233; new_session=1; init_refer=; new_uv=1; _ga=GA1.2.765973136.1748789453; _gid=GA1.2.598168160.1748789453; _gat=1; als=0; _ga_DYBJHZFBX2=GS2.2.s1748789454$o1$g0$t1748789454$j60$l0$h0; ajk-appVersion=; ctid=23; fzq_h=146f5bb15761ff53a9e399738256cf1d_1748789464839_0e8c46101566452c826af5bd316cf304_47924986682059480636763906494523898843; xxzlclientid=a55679bc-395e-4b0c-858a-1748789471863; xxzlxxid=pfmxSo6aLjgIBPUBKZyl3w1/I1c+H2ahVoXgXgf3lGtU3Nb0xlWZrSZf+SsgYMcqRY1o; _stat_rfpn=Ershou_Web_Property_List_FilterPage; obtain_by=1; xxzlbbid=pfmbM3wxMDM0NnwxLjEwLjB8MTc0ODc4OTQ3OTk0MDE4NTczM3w2L3V2V1ZmUkM5SnhVb2d0WXB0Z2l0VTlQZXpBZ0RXUlNUelI2azVFSGE0PXxjMjFiOTkwOTljMTZmMDM4NjFlNmM4OGE2ZTE5ODgwNl8xNzQ4Nzg5NDc3NTU1XzgzMGRmZGRiZTA4NzQ1MmNiODU4ODBiN2RmNDE0MjhkXzI1NzQ3NDQ5NzN8NjkxNWY3ZTc0NWU2ZDVmMTZhYWRmMjExNzA5Y2QwMjRfMTc0ODc4OTQ3OTQyN18yNTQ=")
    spider.add_cookie("sessid=60193973-B9C7-9720-DCCC-3C932904701A; aQQ_ajkguid=5774BED1-0FD5-3107-177C-B66F8E62F207; twe=2; _stat_guid=3CE0FCA0-B054-4E33-AAA2-40E31E23B95C; _prev_stat_guid=5774BED1-0FD5-3107-177C-B66F8E62F207; id58=OWQb0Wg8ZRJ1fTdNMHdHAg==; 58tj_uuid=58a4eb0c-4807-4d88-9f6a-df1f8a6b9233; new_uv=1; _ga=GA1.2.765973136.1748789453; _gid=GA1.2.598168160.1748789453; als=0; _ga_DYBJHZFBX2=GS2.2.s1748789454$o1$g0$t1748789454$j60$l0$h0; ajk-appVersion=; ctid=23; fzq_h=146f5bb15761ff53a9e399738256cf1d_1748789464839_0e8c46101566452c826af5bd316cf304_47924986682059480636763906494523898843; xxzlclientid=a55679bc-395e-4b0c-858a-1748789471863; xxzlxxid=pfmxSo6aLjgIBPUBKZyl3w1/I1c+H2ahVoXgXgf3lGtU3Nb0xlWZrSZf+SsgYMcqRY1o; _stat_rfpn=Ershou_Web_Property_List_FilterPage; obtain_by=2; xxzlbbid=pfmbM3wxMDM0NnwxLjEwLjB8MTc0ODg0MzA2Mzc5MTc1MDk4MHwvaXBGQXdXWExUbktMdGFrSXZublFmVVJKWTNqWFBGOWhwUjJROWUrVmtrPXw5NWVlMDA1ZGU3ZWQxYTNjYzQ1NWFmODdmMzdjZGJkYl8xNzQ4ODQzMDYwOTMxXzQ4MGE1NWRjM2UwZjQ2YzA4NzIyNGZjOTkwMDNlMjMxXzMwNTYwMzgwNTV8ZjBhM2UyYzgzMmMyMDhmMTY0OGI1NzJmMzEzMGEzZmFfMTc0ODg0MzA2MjYwNV8yNTY=")

    spider.run(max_pages=5)  # 每个区域爬取5页
    spider.save_to_excel()
运行的时候在坚强地与反爬机制对抗,还是有一些心惊胆战的
最后因为网站有大量的重复数据 所以获取到的数据去重之后实际上也只有差不多三千条
获取到的数据部分展示:(csv文件)
(xlsx文件)
但是对于大数据分析够用了
希望对大家有帮助~!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)