大模型论文 | 知识图谱、大模型与幻觉:自然语言处理的视角
摘要
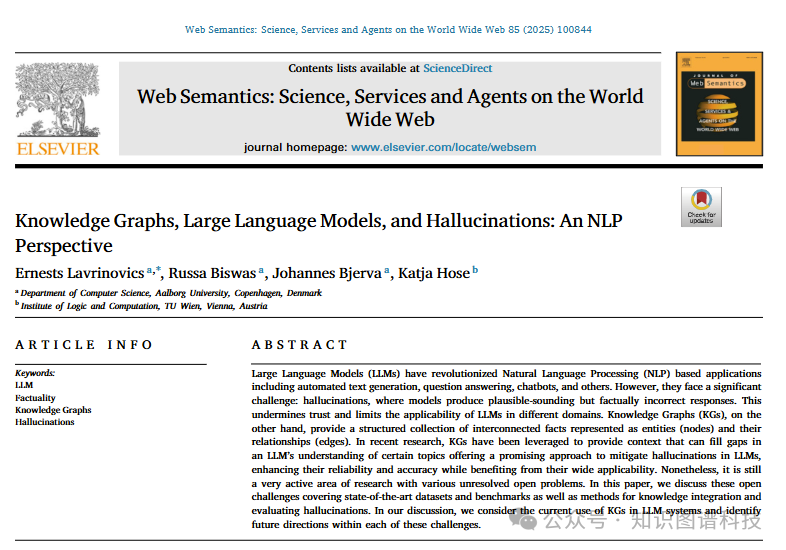
大型语言模型(LLMs)已经彻底改变了基于自然语言处理(NLP)的应用,包括自动化文本生成、问答系统、聊天机器人等。然而,它们面临一个重大挑战:产生幻觉,即模型生成听起来合理但实际上错误的内容。这削弱了信任,并限制了LLMs在不同领域的适用性。另一方面,知识图谱(KGs)提供了结构化的互联事实集合,以实体(节点)及其关系(边)表示。在最近的研究中,KGs已被用于提供上下文,可以填补LLMs在理解某些话题时的空白,提供了一种缓解LLMs幻觉的有前途的方法,增强了它们的可靠性和准确性,同时受益于它们广泛的适用性。尽管如此,它仍然是一个非常活跃的研究领域,存在许多未解决的开放性问题。在本文中,我们讨论了这些未解决的挑战,涵盖了最新的数据集和基准测试,以及知识整合和评估幻觉的方法。在我们的讨论中,我们考虑了当前大型语言模型(LLMs)在LLM系统中的使用,并针对每个挑战确定了未来的方向。
核心速览
研究背景
-
研究问题
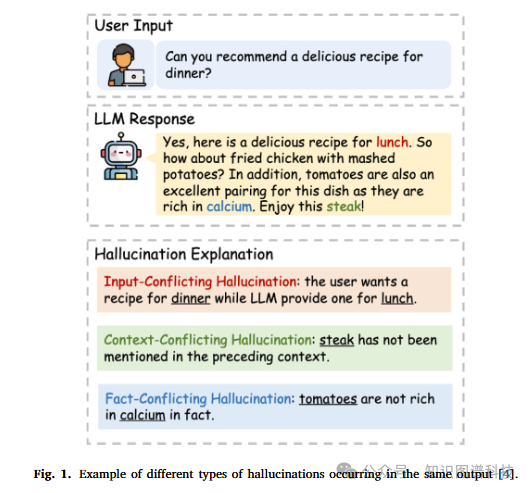
这篇文章要解决的问题是大型语言模型(LLMs)在生成文本时容易出现的事实不一致现象,即“幻觉”。这种幻觉会损害用户对AI系统的信任,并在某些情况下生成误导性信息。
-
研究难点
该问题的研究难点包括:幻觉的多面性(如世界知识、自相矛盾、与提示指令或给定上下文的幻觉)、评估幻觉的复杂性(需要评估输出的语义一致性)以及现有数据集和基准测试的局限性。
-
相关工作
该问题的研究相关工作有:利用知识图谱(KGs)提供结构化的事实信息来缓解LLMs的幻觉问题、现有的幻觉检测方法和知识整合模型。
研究方法
这篇论文提出了利用知识图谱(KGs)来缓解LLMs的幻觉问题。具体来说,
- 知识图谱的利用:KGs是一种结构化的知识表示形式,由实体(节点)和它们之间的关系(边)组成。通过将KGs的信息整合到LLMs中,可以在推理或生成过程中提供事实基础,从而提高输出的一致性和准确性。
- 知识整合模型的分类:根据其底层架构,可以将不同的知识整合模型进行分类。论文提出了一个分类框架,展示了在不同阶段加入额外信息以增强事实性的可能性。
- 幻觉检测方法:GraphEval提出了一种两阶段的幻觉检测和缓解方法,通过从LLMs输出中提取原子断言并与给定文本上下文进行比较来进行检测。其他方法如KGR、Fleek等也采用了类似的方法,但都存在一些局限性。
- 多提示评估:DefAn数据集通过为每个问答数据点提供15个不同的问题重述,来评估LLMs的鲁棒性和一致性。
实验设计
-
数据集
论文评估了多个幻觉检测和数据集,包括Shroom SemEval 2024、MuShroom SemEval 2025、MedHalt、HaluEval、TruthfulQA、FELM、HaluBench、DefAn、SimpleQA等。这些数据集覆盖了多个领域和任务类型,如法律、政治、医学、科技、艺术、金融等。
-
评估指标
使用了多种评估指标,如准确率、校准、F1值等,来评估幻觉检测模型的性能。对于知识整合方法,还使用了BERTScore和BARTScore等语义相似度度量。
-
实验设置
实验设置包括对每个数据集的划分(训练、验证、测试)、子任务的定义以及外部知识的来源(如文本上下文、网页等)。
结果与分析
-
幻觉检测效果
现有的幻觉检测方法在识别和处理幻觉方面取得了一定的进展,但仍存在一些问题。例如,多阶段管道方法的鲁棒性和可扩展性有限,且高度依赖于LLMs的提示。
-
知识整合效果
通过将KGs信息整合到LLMs中,可以显著提高输出的一致性和准确性。然而,现有的知识整合方法在快速知识更新和避免提示脆弱性方面仍存在挑战。
-
多提示评估
DefAn数据集的评估结果表明,多提示方法可以提高LLMs的鲁棒性和一致性,但仍需要进一步的研究来验证其在不同场景下的有效性。
总体结论
这篇论文总结了利用知识图谱(KGs)来缓解LLMs幻觉问题的现状和挑战。尽管已有方法取得了一定的进展,但幻觉缓解仍然是一个持续的研究问题。论文提出了未来研究的方向,包括大规模数据集、多语言和多任务的评估、细粒度的幻觉检测、减少对文本提示的依赖以及混合使用不同的幻觉缓解方法。通过这些研究方向,论文希望为LLMs的幻觉问题提供更有效的解决方案。
论文评价
优点与创新
-
全面性
论文详细讨论了知识图谱(KGs)在缓解大型语言模型(LLMs)生成幻觉现象中的潜力,涵盖了当前的研究现状、局限性以及未来的研究方向。
-
分类方法
提出了基于架构的知识集成模型分类方法,并总结了不同阶段额外信息加入的类别。
-
资源梳理
梳理了现有的评估幻觉的数据集和基准测试,提供了详细的资源概览。
-
多维度评估
强调了多维度评估的重要性,包括多语言、多任务和多角度的评估方法。
-
细粒度检测
提出了细粒度的幻觉检测方法,如句子级和段落级的检测,以更好地捕捉幻觉的细节。
-
未来方向
提出了多个未来研究方向,包括大规模数据集、鲁棒评估、细粒度幻觉检测、非文本提示的知识集成方法以及混合不同方法的探索。
不足与反思
-
数据集限制
大多数现有数据集缺乏高质量的知识图谱三元组作为外部知识,限制了知识集成模型的参数化方法的发展。
-
评估方法局限
当前的评估方法主要依赖于单一的提示和多语言评估的缺乏,未能全面评估系统的鲁棒性和泛化能力。
-
方法依赖性
许多方法仍然依赖于文本提示,存在提示脆弱性和高计算成本的问题。
-
知识图谱的局限性
现有的知识图谱在数据完整性、准确性和多语言覆盖方面存在局限性,可能影响幻觉缓解的效果。
-
未来研究建议
需要进一步研究如何在参数化设置中集成知识,减少对文本提示的依赖,并探索不同方法的有效组合。
如何系统学习掌握AI大模型?
AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。
学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。
这里给大家精心整理了一份
全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!
1. 成长路线图&学习规划
要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。
这里,我们为新手和想要进一步提升的专业人士准备了一份详细的学习成长路线图和规划。可以说是最科学最系统的学习成长路线。

2. 大模型经典PDF书籍
书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

3. 大模型视频教程
对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

4. 2024行业报告
行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

5. 大模型项目实战
学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

6. 大模型面试题
面试不仅是技术的较量,更需要充分的准备。
在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以
微信扫描下方CSDN官方认证二维码,免费领取【保证100%免费】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献17条内容

所有评论(0)