部署基于Qwen 3的智能体化RAG系统
今天我们将学习如何部署由阿里巴巴最新Qwen 3驱动的智能体化RAG(检索增强生成)系统,以下是技术栈组成:
·CrewAI(智能体编排框架)
·Firecrawl(网页搜索工具)
·LightningAI的LitServe(部署框架)
系统流程图展示了智能体化RAG流程:
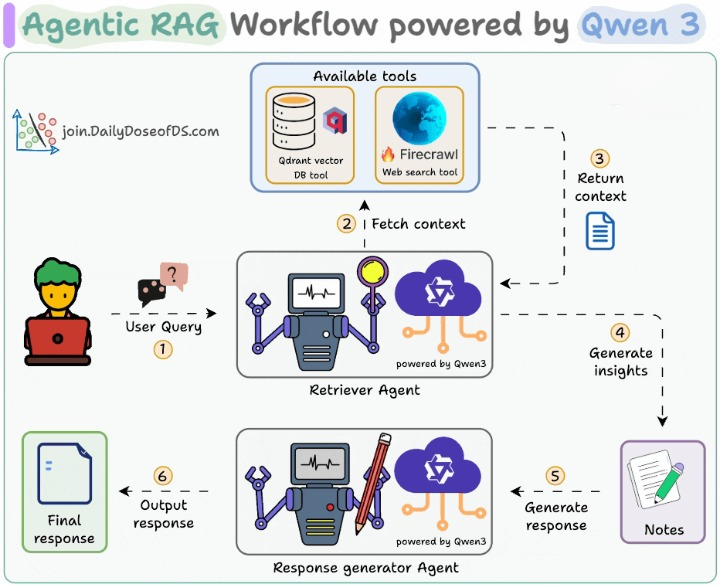
·检索智能体(Retriever Agent)接收用户查询
·调用相关工具(Firecrawl网页搜索或向量数据库工具)获取上下文并生成洞察
·写作智能体(Writer Agent)生成最终响应
现在让我们进入具体实现与部署环节!
分步实现指南
部署智能体化RAG
以下是完整的服务端实现代码:

·setup方法:智能体编排核心逻辑
·decode_request方法:请求数据预处理
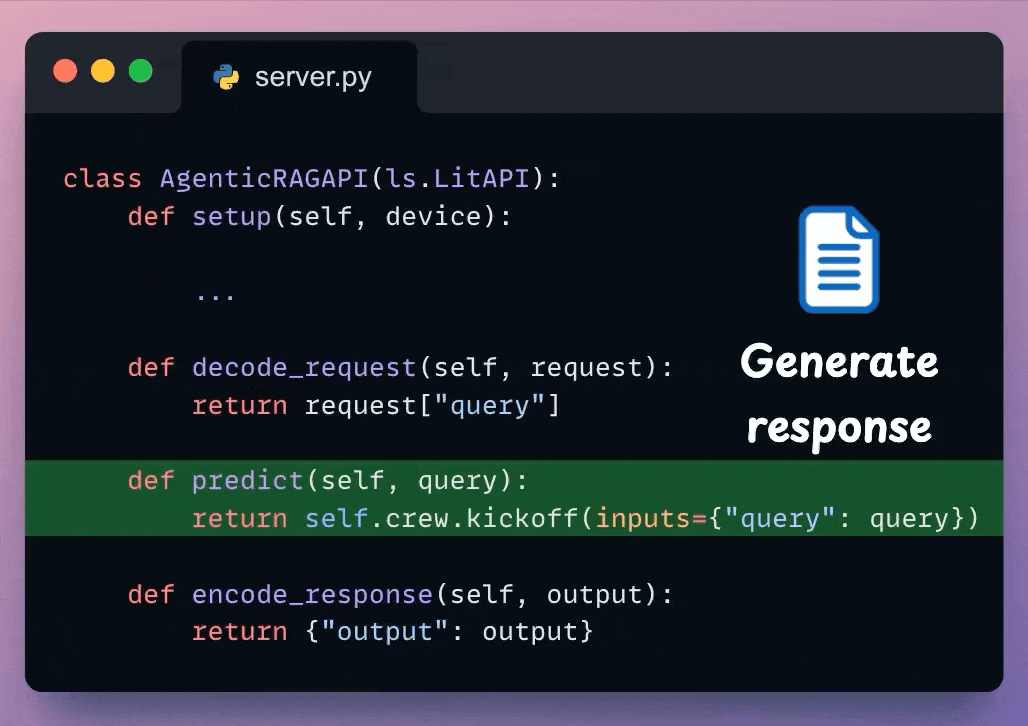
·predict方法:执行Crew工作流
·encode_response方法:响应结果后处理
下面逐步解析关键环节。
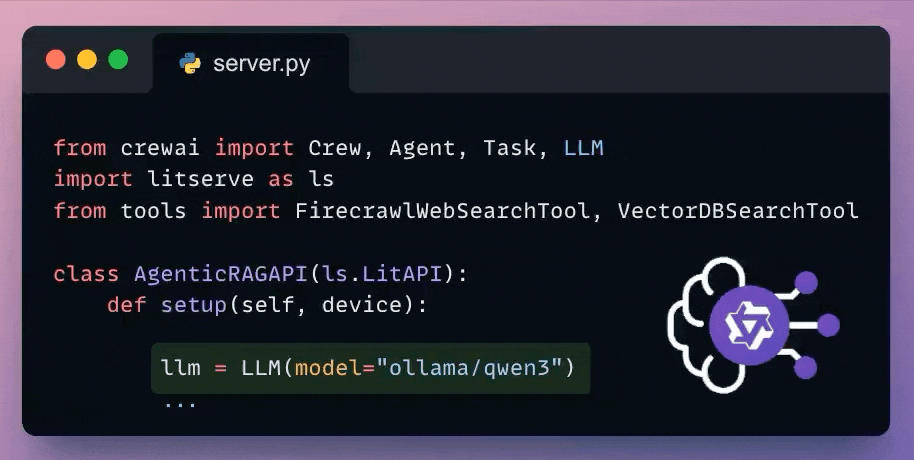
配置大语言模型
CrewAI支持无缝集成主流LLM服务。此处展示通过Ollama配置本地版Qwen 3:
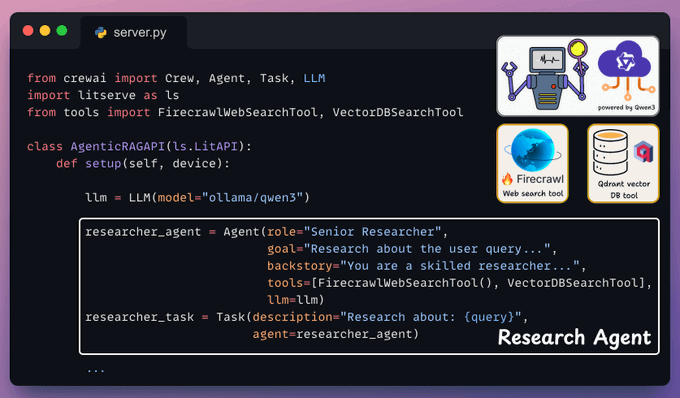
定义研究型智能体及其任务
该智能体负责接收用户查询,并通过向量数据库工具与Firecrawl网页搜索工具获取上下文信息。需将此代码置于LitServe的setup()方法中:
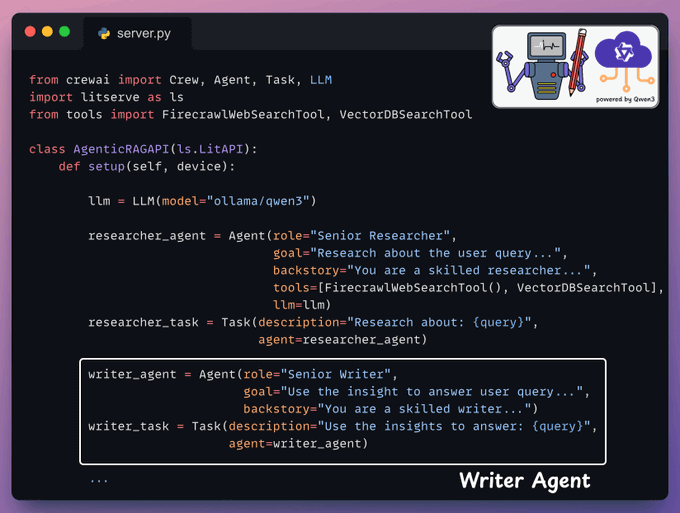
定义写作型智能体及其任务
该智能体接收研究型智能体的洞察信息,生成最终自然语言响应。配置代码同样位于LitServe的setup方法:
组建智能体工作流
完成智能体定义后,使用CrewAI将其编排为完整工作流:

请求解码处理
从入站请求中提取用户查询参数,详见高亮代码段:

预测执行阶段
将解码后的查询输入预定义工作流,生成模型预测结果:
响应编码处理
对输出结果进行格式化处理后返回客户端。注:LitServe内部执行顺序为 decode_request → predict → encode_request:

至此服务端部署完成。以下是使用Python requests库调用API的客户端示例:

部署完成了!
我们已成功通过LitServe部署私有化Qwen 3智能体化RAG系统。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献6条内容

所有评论(0)