深度学习目标检测如何快速入门并水一篇论文?
本期内容主要是告诉大家目标检测这个方向需要学哪些基础知识
以及手把手教大家如何去水一篇深度学习论文
开始之前可以领取我整理的学习资料:包括从零入门深度学习、100+深度学习常用开源数据集、AI 顶会论文合集、深度学习论文即插即用模块、论文资料合集等
需要的兄弟可以到我的公_众_号:迪哥谈Ai,回复:123,免费获取~
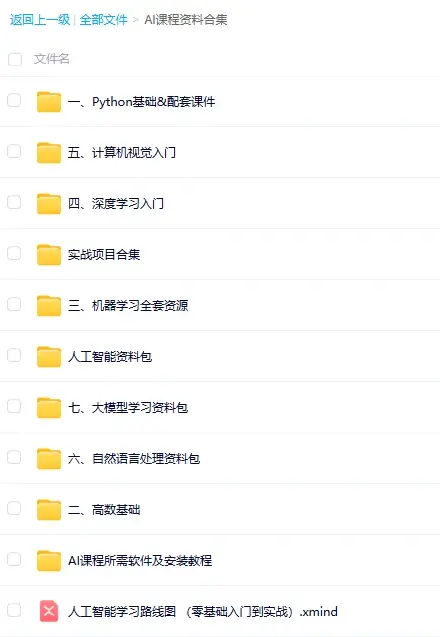
一、基础知识
1、编程语言
①Python 语言:主要用来修改程序,然后调试程序 ,B 站看教程+《Python 编程:从入门到实践》跑案例
②Linux 命令:运行终端输入命令来控制程序的执行 ,只需掌握最常用的那十几个命令:Linux 常用命令
③PyTorch 框架:有效地构建和训练目标检测模型 ,照着网上的源码能跑通就行
2、深度学习目标检测网络原理
①如卷积神经网络:弄清楚基本原理是什么?包含哪些基本结构?这些结构又有
什么作用?
②掌握一些常用的目标检测网络,如 yolo:了解 yolo 源码,并且能够根据源码
找到 yolo 网络结构图的对应的每一部分,这样你改进网络结构的时候才知道是 在源码的哪些地方进行
二.实操
下载目标检测网络的源码和公开的数据集,刚开始的目标就是把程序跑通然后能
完整的训练一遍,主要是学习和熟悉一下预处理这些操作
三、论文
第 1 步:找到 baseline 论文
从本方向的一些开山之作、经典 sota 以及近三年的顶会顶刊文章中选取 1-3 篇作为你的 baseline,可以到 paper with code 下载这些开源代码
一个优质的 baseline 通常具备以下特点:
- 发表的时间是近两到三年的:太老的话,审稿人可能不会认可你的对比方法; 而最新的 SOTA 论文往往过于强大,难以超越且优化难度大(超越 SOTA 并不是发论文的必要条件)可以选择一些文章比较新,但性能比较差的作对比,发个三区四区足够了
- 具备开源代码且有完整的文档(readme),各部分内容详细、清晰, 如训练、测试、损失函数、网络结构等模块界定明确。 (GitHub 上星标较多的更佳,这表明该代码被广泛使用且质量可靠)
- 论文中的公式应清晰明了,方便对照代码理解公式,当你掌握如何将理论公式转化为代码时,就基本入门了
第 2 步:深入剖析 baseline 代码
当你找到了不错的 baseline 论文后,就要深入阅读、使用它的代码了
阅读代码的诀窍:
按照 github 的文档配置好你的环境,(pytorch 和 tf 都特别好配置)
根据 readme 的步骤,下载相应的数据,运行相应的脚本,让它的训练流畅地跑通;(如果在中间报了错,一般都是 library 版本不符)
当你成功运行开源代码或遇到算法相关的 bug 时,可以使用一款优秀的IDE(如 Pycharm)进入 debug 模式。在该模式下,可结合实际数据逐步分析代码。对于看不懂的步骤,可对照论文流程并通过谷歌查询 API 使用方法。很多单独查看难以理解的代码,结合着 tensor shape,或者处理过 后的数据的 shape/value 就能理解
如果时间允许,建议对选定的几篇 baseline 都这样跑一遍,并且用笔记记录下大概流程
第 3 步:搭建自己的 pipeline
可以在第三步选定的 baseline 基础上进行改进,关键在于修改数据读取和预处理部分。此阶段先不要添加自己的模型,先用 baseline 的模型跑通你自己的数据
再把你自己的 idea 加入 pipeline,创新点主要集中在提出更好的模型或者改进训练机制方面,模型或损失函数相关内容在网络上通常能找到结构类似的代码,直接按照他们的格式仿写即可(比如你要做轻量级图像分割,那大概率可以借鉴 Unet)
对 baseline 最简单粗暴的改进就是改网络结构
改网络结构主要有 5 种方式:串联、并联、交互、融合、连接
可以整合不同论文中的模块,比如某篇论文的 A 模块是卷积结构,可用于提取局部特征;另一篇论文的 B 模块是 attention 机制,可提取全局特征;将 AB 并联后就可以说能提取多尺度特征如果效果有提升,就可以做消融实验,论文就有东西可以写了。解释一下为 什么加入 A 效果有提升,为什么加入 B 效果有提升,再说一下新模型的优 缺点。“A 能提取局部特征,B 能提取全局特征,我们设计了这个新模型它综合了 A+B 的.....能力,所以效果得以提升......”
如果你还是很迷茫,可以跟着我来系统学习,感兴趣的话可以添加我的助理了解,还可以试听一下课程,看看是否能够让你更快上手!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献16条内容

所有评论(0)