SPDC-YOLO:一种基于改进的YOLOv8的用于无人机航拍图像的高效小目标检测网络
PART/1
概述
无人机图像中的目标检测在交通安全、应急救援和环境监测等领域具有重要意义。然而,无人机拍摄的图像通常具有多尺度特征、复杂的背景、不均匀的光照以及较低的目标分辨率,这使得无人机图像中的目标检测极具挑战性。为应对这些挑战,本文引入了SPDC-YOLO,这是一种基于YOLOv8构建的新型模型。在主干网络部分,该模型去除了最后一个C2f模块和最终的下采样模块,从而避免了小目标特征的丢失。在颈部网络部分,本文提出了一种新型的特征金字塔,即SPC-FPN,它采用了选择性边界聚合(SBA)模块来融合来自两个不同尺度的特征。在头部网络部分,去除了P5检测头,并提出了一种新的检测头Dyhead-DCNv4,用DCNv4取代了原始Dyhead中的DCNv2,并利用了三种注意力机制来进行动态特征加权。此外,该模型使用了上下文引导模块(CGB)进行下采样,该模块能够结合周围的上下文信息来学习和融合局部特征,并且使用并行补丁感知注意力(PPA)模块取代了原来的C2f模块,以进一步提高特征表达能力。最后,SPDC-YOLO采用EIoU作为损失函数来优化目标定位精度。在公开数据集VisDrone2019上的实验结果表明,与YOLOv8n相比,SPDC-YOLO将平均精度均值(mAP50)提高了3.4%,同时将参数数量减少了103万个。与其他相关方法相比,SPDC-YOLO展现出了更好的性能。
PART/2
背景
近年来,无人机的生产成本逐渐降低,自动化和控制技术不断进步,无人机在农业监测、地质勘探、基础设施检测以及智慧城市等领域的应用稳步增加。小目标检测技术在这些任务中起着至关重要的作用,尤其是在实时监测、目标跟踪和数据分析中,它能够快速、准确地识别小目标。然而,无人机图像通常是从高空拍摄的,往往具有复杂的背景、显著的光照变化,并且包含小目标,这使得小目标检测成为一项重大挑战。
深度学习的发展,尤其是卷积神经网络(CNN),为小目标检测提供了强大的工具。传统的目标检测方法在处理小目标时面临困难,因为它们依赖于手工设计的特征,并且对复杂场景的适应性不足。相比之下,CNN能够通过自动学习特征,有效地识别复杂环境中的目标,从而提高了检测的准确性和鲁棒性。
尽管取得了这些进展,小目标检测仍然面临着目标尺寸小、图像分辨率有限以及背景复杂等挑战。为解决这些问题,人们提出了各种改进方法,例如优化CNN架构、采用多尺度检测,以及应用数据增强技术来提高检测的准确性和速度。多尺度检测能够融合来自不同尺度的特征,有效地提高了小目标的检测精度。
在目标检测领域,YOLO(You Only Look Once)是一种高效的深度学习范式。这种方法将目标检测重新定义为回归任务,通过单次前向传播同时预测目标的空间位置和类别,从而显著提高了检测速度。虽然YOLO在大目标检测方面已被证明是有效的,但它在小目标检测方面也取得了重大进展。通过集成多尺度训练和特征融合技术,YOLO显著提高了小目标检测的准确性和鲁棒性,成为小目标检测领域中不可或缺的工具。
综上所述,随着无人机技术和深度学习的发展,目标检测,尤其是小目标检测,已成为无人机系统中不可或缺的组成部分,并在各个领域的智能应用中展现出巨大潜力。
基于YOLO的小目标检测方法
罗杰等人提出了ESOD-YOLO模型,这是一种基于YOLOv8n的小目标检测框架。它通过用RepNIBMS模块替换C2f模块来改进小目标特征提取,并使用波形特征金字塔网络(WFPN)进行高效的多尺度特征融合,增强了空间和语义信息的整合。
张世杰等人提出了RTSOD-YOLO模型,该模型针对基于无人机检测中的遮挡和复杂背景等挑战。通过将自适应空间注意力机制与三重特征编码(TFE)相结合,该模型优化了小目标检测性能。此外,它还融入了高效的冗余特征生成模块,减少了模型参数并加快了推理速度。
刘炳奇等人提出了RE-YOLO模型,该模型专门为遥感图像设计。通过采用优化的高效模块(REM)和RE_CSP模块进行多尺度特征提取,这种方法在计算复杂度和特征提取性能之间实现了最佳平衡。此外,该模型通过空间提取注意力模块(SEAM)增强了语义信息的捕捉,并通过三分支路径聚合网络(TBPAN)促进了浅层和深层特征的融合,从而改善了上下文信息的同化。 王程程提出了Gold-YOLO模型,该模型通过融入聚集与分配(GD)机制,解决了YOLO框架内不同尺度特征的结合问题。这种机制将卷积操作与自注意力相结合,显著提高了模型有效整合多尺度特征的能力。
王建强等人开发了EAL-YOLO算法,这是一种轻量级且高效的基于注意力的模型。它使用EfficientFormerV2对骨干网络进行优化,并将大分离卷积注意力(LSKA)与空间金字塔池化(SPPF)相结合,以改善特征提取。此外,ASF2-Neck模块提升了小目标检测能力,而轻量级共享卷积检测头(LSCHead)在准确性和计算效率之间取得了平衡,使该模型即使在资源有限的设备上也能表现良好。
在最近的研究中,提出了UAV-YOLO,以解决从空中视角进行小目标检测的挑战(刘明杰等人,2020)。这种方法通过优化网络结构和训练过程,显著提高了检测性能。
图沙尔·维尔马(Tushar Verma)等人提出了SOAR框架,该框架将双向状态空间模型(SSM)与YOLOv9以及可编程梯度信息相结合,有效地提高了航空图像中的小目标检测能力。受他们工作的启发,我们引入了一种增强的特征融合策略,以进一步优化检测性能。
基于无人机的交通监测的最新进展利用深度学习模型进行车辆检测和多目标跟踪。罗伯特·福诺德(Robert Fonod)等人开发了一种强大的轨迹提取流程,该流程集成了目标检测、轨迹稳定和地理配准技术,以实现从航空图像中进行高精度的车辆跟踪。受他们工作的启发,我们采用了类似的地理配准方法来提高轨迹的准确性。
此外,还开发了各种基于YOLO的模型,如HIC-YOLOv5、FFCA-YOLO、TPH-YOLOv5、FE-YOLOv5和CA-YOLO,每个模型都有独特的改进。这些基于YOLO的模型的进步在保持YOLO框架高效率的同时提高了小目标检测的准确性,使得它们在诸如无人机图像等具有挑战性的环境中对小目标的检测特别有效。
PART/3
新算法框架解析
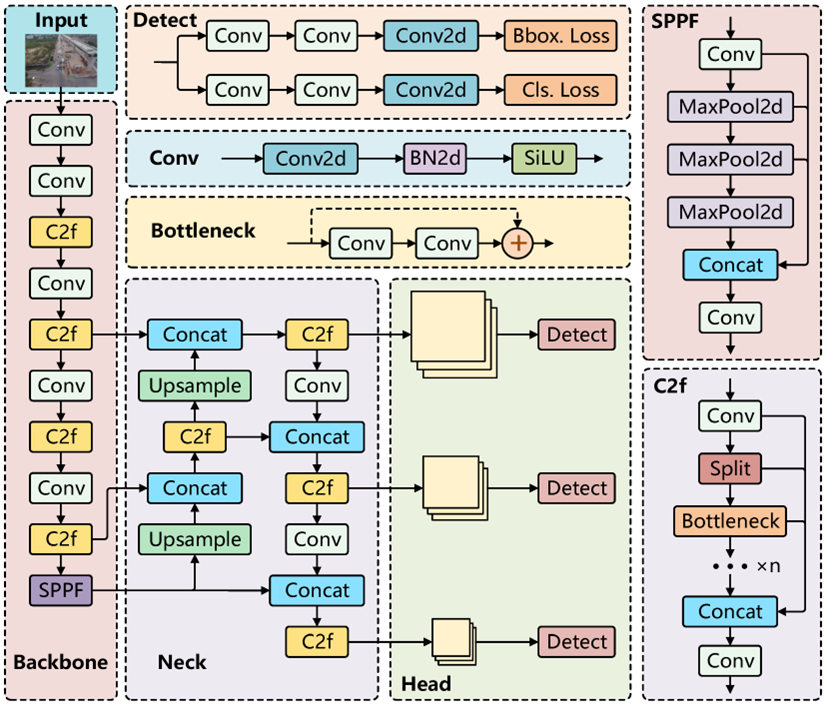
YOLOv8的训练策略也进行了全面优化,包括预训练、微调以及超参数调整等阶段,以确保该模型在各种数据集上都能达到最佳性能。在预训练阶段,使用大规模数据集对模型进行初始化,以促进通用特征的学习。在微调阶段,模型进一步适应特定的目标数据集,增强其检测能力。最后,进行超参数调整以优化模型的配置,提升其整体性能。下图展示了YOLOv8的网络架构。
为了克服YOLOv8在检测小目标方面的局限性,本文提出了一种创新模型——SPDC-YOLO。下图展示了该模型的网络架构。

首先,SPDC - YOLO通过移除原始YOLOv8骨干网络的最后一个卷积模块和最后一个C2f模块来进行优化。这种修改减轻了过度的32倍下采样,有效地减少了小目标特征的损失,并保留了更多的细粒度细节。此外,这种调整降低了模型的参数数量,从而提高了小目标检测的准确性和效率,这对于遥感应用至关重要。
此外,在SPDC - YOLO的颈部,不进行上采样。相反,引入了一种新颖的特征金字塔SPC - FPN,它包含一个称为SBA(选择性边界聚合)的特征融合模块,用于合并浅层和深层特征。这种设计将增强的边界特征与原始特征图融合,生成一个结合了边界和全局上下文信息的新特征图。通过这种方法,SPDC - YOLO能够在保持高分辨率特征图的同时,将深层语义信息与浅层细节相结合,从而提高小目标的检测能力。
最后,提出了一种新颖的检测头Dyhead - DCNv4。这个检测头创新性地将原始Dyhead中的DCNv2模块替换为DCNv4(可变形卷积v4)模块。Dyhead是一种为目标检测任务设计的自适应检测头,通过使用注意力机制优化检测过程。与传统的固定结构检测头不同,Dyhead根据输入特征图的内容动态调整其行为,从而提高检测性能,特别是在具有多尺度和多类别目标的复杂场景中。
此外,SPDC - YOLO结合了一种新颖的下采样模块,即上下文引导块(CGB),它有效地整合了局部和全局上下文信息,以提高小目标检测的精度。该模型还用并行化的补丁感知注意力(PPA)模块替换了C2f模块,增强了对局部细节和多尺度特征的感知,从而提高了在复杂场景中的检测性能。此外,采用了EIOU [48]损失函数,它整合了形状和大小信息来优化边界框回归,产生更精确的边界框预测,并进一步提高检测精度。
总之,所提出的SPDC - YOLO模型通过结合几个关键模块,有效地解决了YOLOv8在小目标检测方面的局限性,从而提高了在多尺度航空遥感图像中小目标的检测性能。
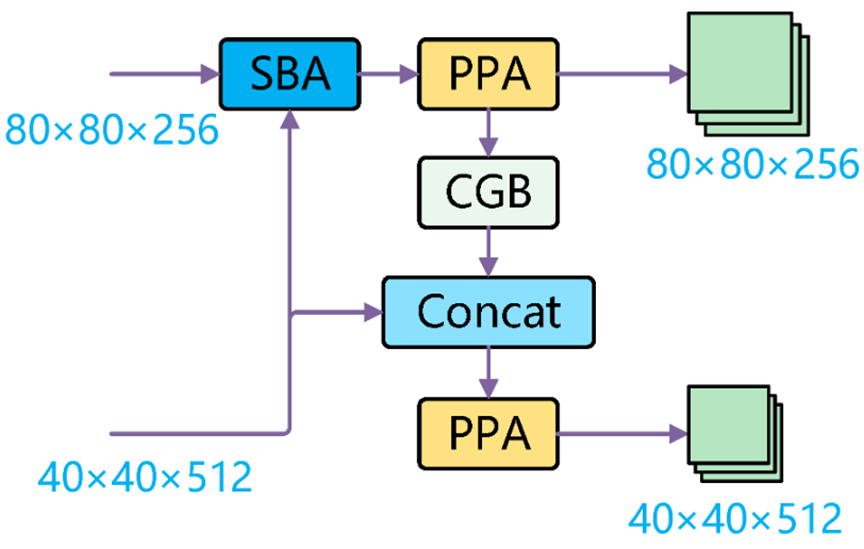
利用选择性边界聚合(SBA)模块融合尺寸为40×40×512和80×80×256的特征图,同时进行通道拼接。然后,得到的融合特征图由并行化补丁感知注意力(PPA)模块进行进一步的特征提取,输出特征图保持80×80×256的尺寸。随后,该特征图通过上下文引导块(CGB)模块下采样到40×40×512的尺寸。下采样后的特征图再与来自并行路径的另一个尺寸为40×40×512的特征图进行拼接,进一步增强了多层特征的融合。最后,拼接后的特征图通过PPA模块进行另一轮特征提取,输出特征图的尺寸仍保持为40×40×512 。
这种特征金字塔网络(FPN)的设计通过选择性边界聚合(SBA)模块增强了多尺度特征表示,同时上下文引导块(CGB)模块有效地整合了上下文信息以助力下采样。此外,并行化补丁感知注意力(PPA)模块增强了网络对特征关系进行建模的能力。这些模块相互协作,提升了网络在检测小目标方面的性能,尤其是在遥感图像分析中。
在SPC-FPN中,选择性边界聚合(SBA)模块(选择性边界聚合[16])被用于有选择地聚合图像中的边界特征,而不是简单地处理整个图像的特征。这种策略使模型能够将更多的注意力集中在可能包含边界相关信息的区域,从而增强了对边界的表征能力。下图展示了SBA模块的结构。
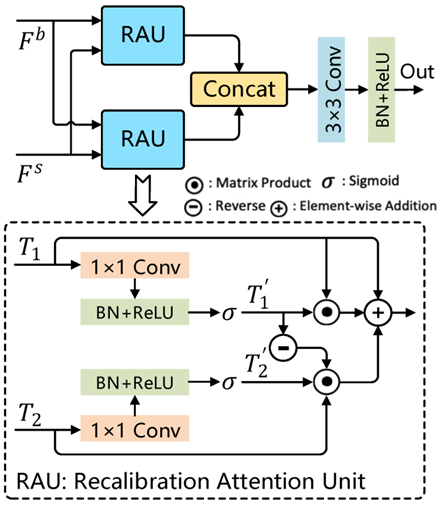
与传统的特征融合方法不同,选择性边界聚合(SBA)模块引入了一种新颖的重校准注意力单元(RAU),旨在在融合之前从两个输入特征集Fb和Fs中自适应地提取互补的特征表示。
如上图所示,浅层特征和深层特征通过不同的路径被送入两个重校准注意力单元(RAU)模块,这使得能够补偿高级语义特征中缺失的空间边界信息,以及低级特征中语义细节的不足。这些重校准注意力单元(RAU)模块生成的输出在被送入一个3X3卷积层之前,会沿着通道维度进行合并。这种聚合策略实现了多个特征图的稳健融合,进一步优化了特征表示。
在标准的YOLOv8架构中,C2f模块首先应用一个卷积层(Conv1)将输入特征图的通道维度加倍。随后是一系列的瓶颈(Bottleneck)模块,用于逐步提取特征。每个瓶颈模块由多个卷积层组成,并且可以配置为有或没有捷径(残差)连接。最后,将原始特征图与瓶颈模块的输出特征图沿通道维度进行拼接。虽然这种设计使模型能够整合多尺度特征信息并生成更丰富的特征表示,但在小目标检测方面存在局限性。低分辨率的特征图往往无法有效地保留小目标的精细细节,导致这些目标的特征表示不完整或不足。
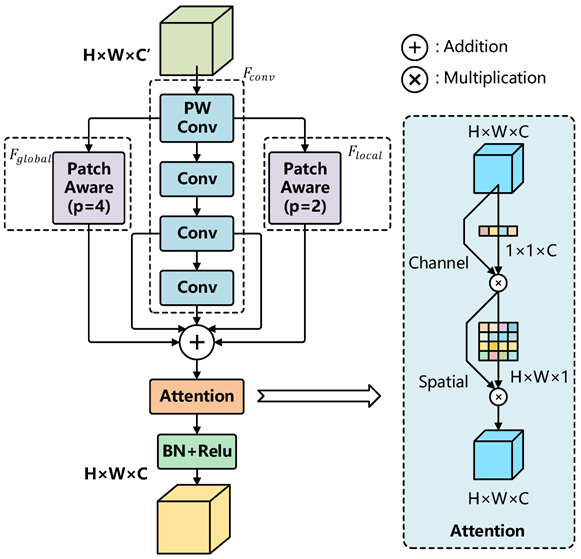
小目标在特征图上仅覆盖有限数量的像素,这使得它们在特征融合过程中容易被忽略。此外,C2f模块对广泛上下文信息的依赖可能会抑制小目标的显著性,特别是在复杂背景下,噪声干扰进一步降低了小目标的突出程度。因此,小目标常常得不到足够的关注,对检测性能产生不利影响。为了解决这些局限性,本文提出的SPDC-YOLO集成了一个新颖的模块,即并行化补丁感知注意力模块(PPA,Parallelized Patch-Aware Attention Module),以取代原来的C2f模块。上图5展示了PPA模块的结构。
优化下采样
为了克服这些挑战,本文引入了一种新的下采样方法,即上下文引导块(CGB),其灵感来自于人类视觉系统利用上下文信息进行场景理解。上下文引导块(CGB)捕获局部特征、周围上下文信息和全局上下文信息,并将它们无缝集成,以提高检测精度。通过有效地融合多尺度特征信息,这种方法增强了模型提取小目标特征的能力,减少了分辨率损失,并保留了关键细节。
上下文引导块(CGB)的工作流程如下图所示。
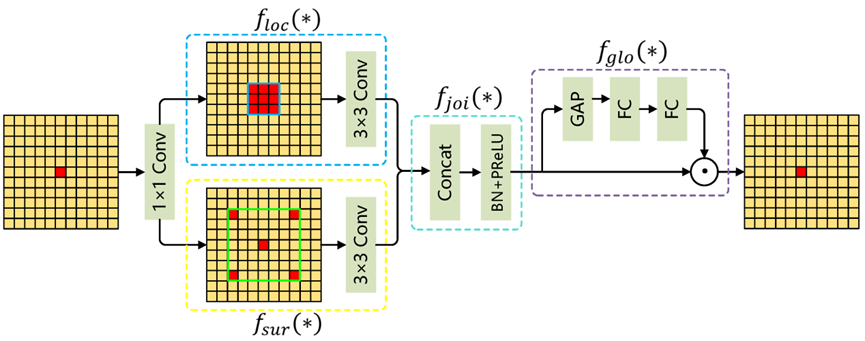
上下文引导块在小目标检测方面具有显著优势,它集成了结合了局部、上下文和全局信息的多尺度特征。这种融合使模型能够捕捉小目标的精细细节,同时理解其周围的上下文信息,从而提高检测精度。全局上下文模块在减轻无关噪声的同时优化关键特征,使模型能够更有效地聚焦于小目标。此外,自适应特征增强机制根据输入内容调整特征权重,使模型能够处理复杂场景,同时保留小目标的细节。这些综合能力提高了小目标检测的准确性和鲁棒性。
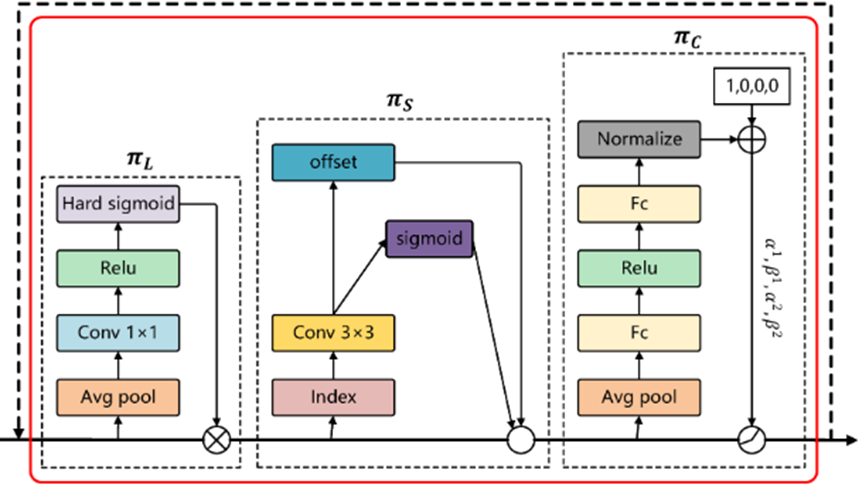
上图展示了动态头部(DyHead)的结构,它由三种核心注意力机制组成:尺度感知注意力(πL)、空间感知注意力(πS)和任务感知注意力(πC)。这些模块按顺序应用于输入特征,能够在每个阶段对特征表示进行动态加权和自适应优化。
PART/4
实验及可视化
实验数据集 本研究采用了VisDrone2019数据集进行验证,该数据集由天津大学机器学习与数据挖掘实验室的AISKYEYE团队精心收集并标注。该数据集被划分为6471张训练图像、548张验证图像以及1610张测试图像,涵盖了10个不同的目标类别。并且该数据集的空间分辨率范围为每像素0.02米至每像素0.1米。训练集中的数据分布情况如下图所示。
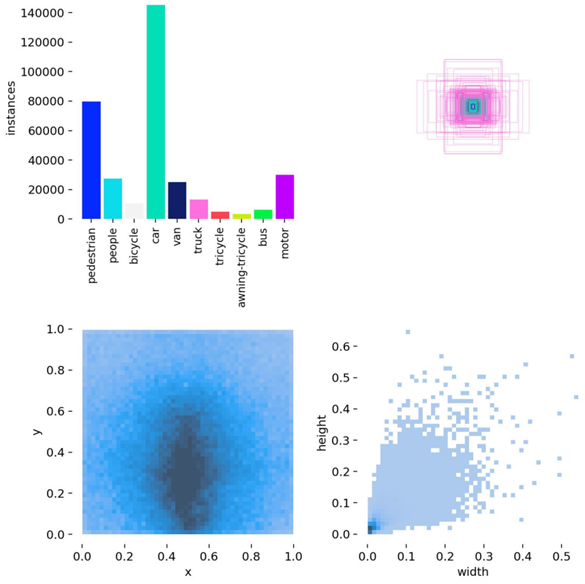
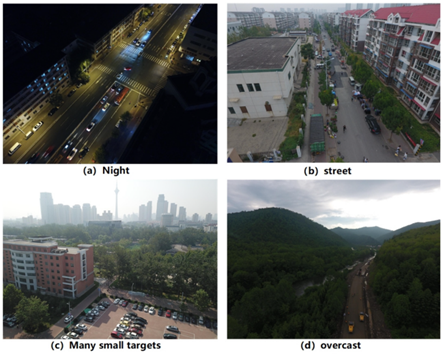
此外,该数据集包含从广泛的城市和农村场景中获取的高分辨率图像,这些场景包括交通繁忙的区域和繁华的街道环境。这些图像是从多个视角拍摄的,具有多样化的背景,从而使该数据集具有高度的真实性。该数据集的示例样本如下图所示。
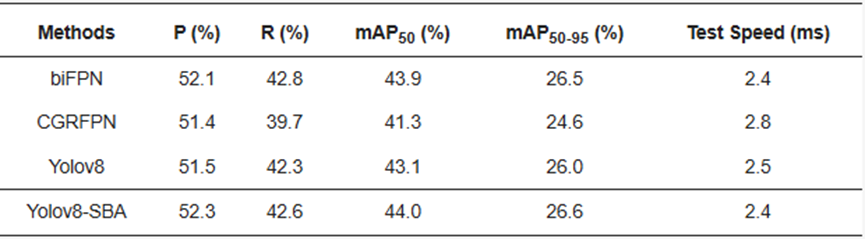
实验结果见上表,该结果展示了在小目标检测中不同方法在各种指标上的对比情况。通过这些对比实验,我们能够清晰地分析出SBA模块在提升小目标检测性能方面的优势。
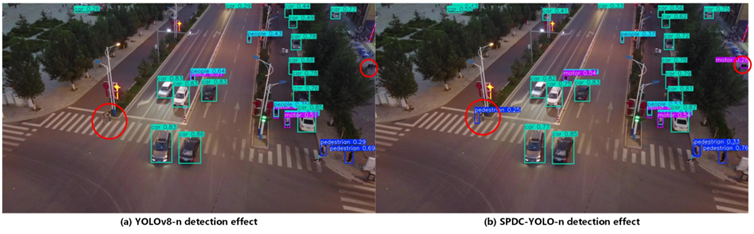
上图展示了一张无人机在黄昏时分拍摄的图像,描绘了一个由于低光照条件而对目标检测构成重大挑战的十字路口。该图像包含三个类别:汽车、摩托车和行人。基线模型YOLOv8难以准确检测人行横道上的行人和路边停放的摩托车。相比之下,所提出的SPDC - YOLO模型成功地检测到了这些具有挑战性的目标。红色圆圈用于突出显示这些难以检测的目标,以便于观察和分析。这些结果证明了SPDC - YOLO在处理复杂检测场景(特别是在低光照条件下)方面的增强能力。
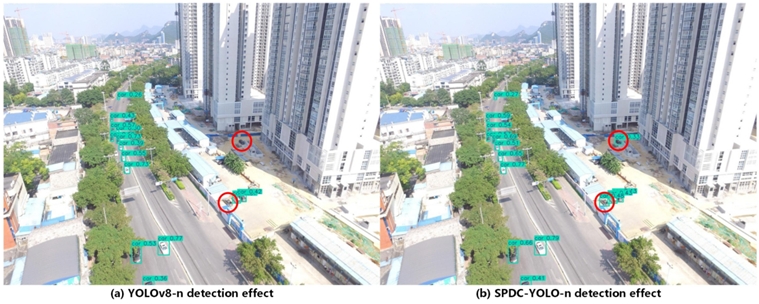
上图展示了一幅在白天拍摄的城市街景俯视图。充足的光照使得在光线良好的区域中,车辆的轮廓和颜色能够更清晰地显现,这有利于目标检测。然而,强烈的光照也可能在一些车辆表面产生眩光,这有可能干扰检测算法。相反,在光照有限的阴影区域,车辆的特征可能不太明显,这使得算法难以准确捕捉颜色和形状等细节。在上图中,YOLOv8n模型未能检测到由红色圆圈标记的车辆,而所提出的SPDC-YOLO模型成功识别出了该车辆。这一结果表明,SPDC-YOLO对不同光照条件具有更强的适应性,使其能够在各种光照场景中保持较高的检测精度和精确的定位能力。
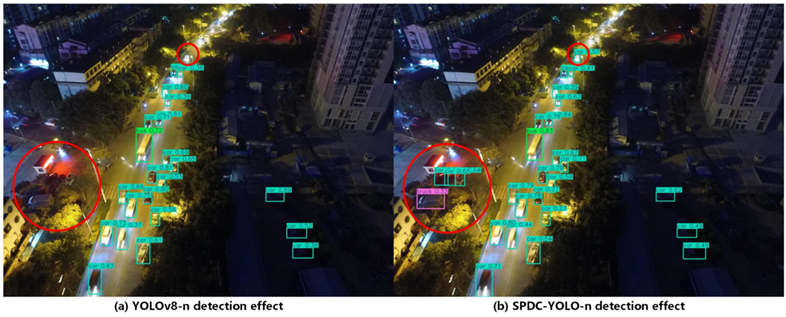
上图展示了一幅夜间由无人机拍摄的城市街道俯视图。图像主要拍摄到了汽车、卡车和公共汽车,车辆的移动形成了光轨,显示出它们的行驶轨迹。值得注意的是,街道上一些未被路灯直接照亮的区域也有若干车辆。整个场景中不均匀的光照显著增加了检测任务的复杂程度。对比图中的(a)和(b)可以发现,基线模型YOLOv8n未能检测到红色圆圈标记的车辆,而本文提出的SPDC-YOLO成功识别出了这些具有挑战性的目标。这一结果进一步证明了SPDC-YOLO在光照不均匀的条件下的优越性能,它有效地提高了在复杂夜间环境中的检测精度。
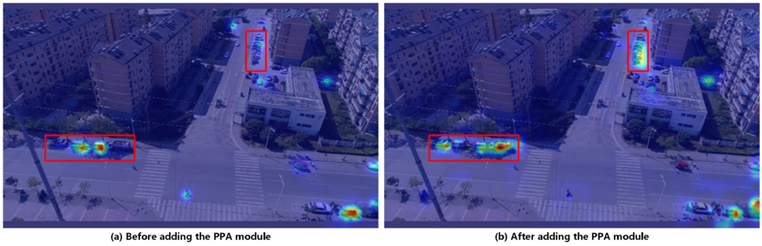
上图所示,由PPA模块增强的模型生成的热力图显示出更广的覆盖区域、更均匀的整体热度强度分布,并且检测到的车辆数量更多。此外,为了更直观地比较相同区域的检测差异,使用红色矩形突出显示了两个模型中的相应区域。对比结果显示,在这些区域中,PPA模块增强的模型表现出更高的热度强度,并且能检测到更多的小目标,这进一步验证了PPA模块在提升小目标检测性能方面的有效性。
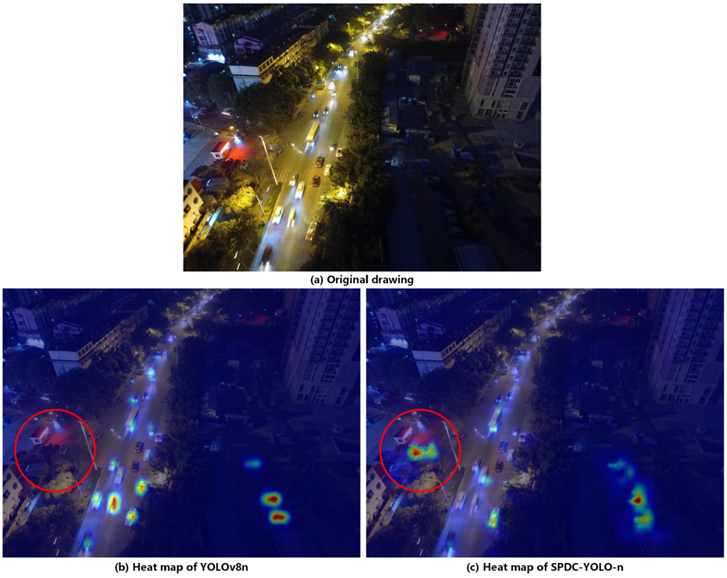
为了更直观地展示SPDC-YOLO在复杂环境中的性能提升,对之前图所示的夜间城市街道场景进行了热力图可视化分析,结果如上图所示。
资料获取
为了方便大家学习,我整理了一份目标检测的资料,包含YOLOv1-v12全系列的论文+代码+项目
除此之外还有100G人工智能学习资料
包含数学与Python编程基础、深度学习+机器学习入门到实战,计算机视觉+自然语言处理+大模型资料合集,不仅有配套教程讲义还有对应源码数据集。更有零基础入门学习路线,不论你处于什么阶段,这份资料都能帮助你更好地入门到进阶。
需要的兄弟可以按照这个图的方式免费获取

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献3条内容

所有评论(0)